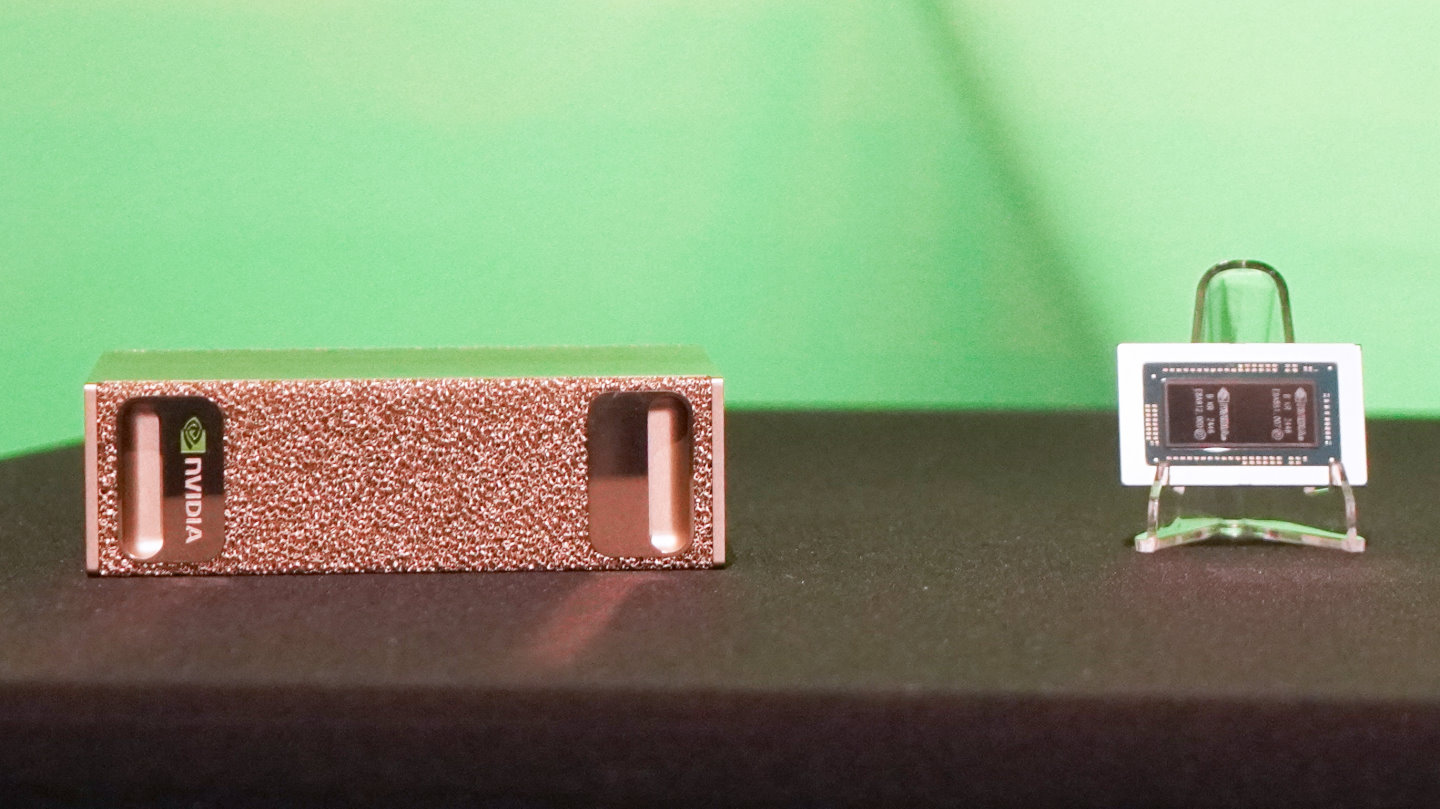
❌

普通视图

发现新文章,点击刷新页面。
今天 — 2026年11月2日T客邦-Techbang

NVIDIA RTX Spark AI功能分析:為Windows筆電獻上代理式AI體驗、透過Pair串連全家AI PC

2026年11月2日 14:30
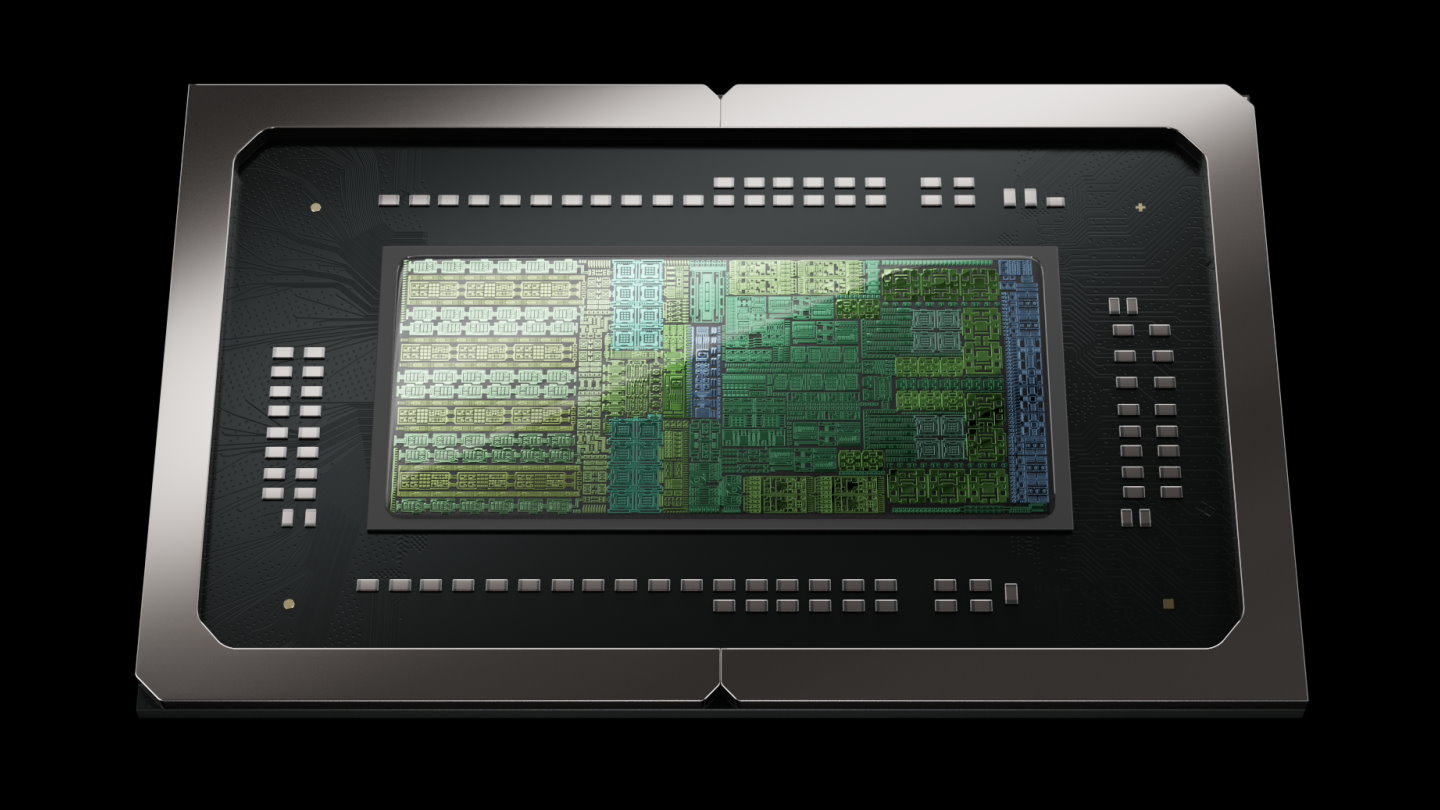
NVIDIA推出的RTX Spark平台最大的特色就是支援Windows 11作業系統與應用程式,讓創作者與開發者能夠享受GPU加速的Windows生態系體驗。Bf12680a4e9fd7c23e410d732e548cc8

NVIDIA推出的RTX Spark平台最大的特色就是支援Windows 11作業系統與應用程式,讓創作者與開發者能夠享受GPU加速的Windows生態系體驗。

NVIDIA搶灘Windows代理式AI方案

代理式AI除了需要效能較高的GPU(繪圖處理器)、NPU(神經處理器)以滿足AI運算的需求之外,也需要核心數量較多的CPU(處理器)以利AI代理主動操作各種傳統應用程式,此外因為可能會同時執行多款參數量較高的AI麼型,對記憶體容量的需求也會比較高。

先前NVIDIA推出的DGX Spark平台能夠滿足上述要件,然而它目前只支援Linux作業系統,AMD則是透過代號為Strix Halo的Ryzen AI Max+ 395等處理器,藉著x86架構CPU、規模更大的內建GPU、支援128 GB記憶體等特色,搶先將代理式AI體驗帶到Windows生態系。

延伸閱讀:
RTX Spark Editor’s Day系列文章目錄
CES2025:NVIDIA Project DIGITS迷你AI工作站拆解,內部GB10 Superchip實體搶先看
【GIGABYTE AI TOP ATOM動手玩(1)】:NVIDIA DGX Spark迷你AI工作站規格分析
AMD更新驅動程式,Ryzen AI Max+ 395處理器於本機執行128B參數大型語言模型

而RTX Spark平台採用與DGX Spark的GB10 SoC,同樣最高支援128 GB記憶體,主要的差別在於由Linux遷移至Windows 11作業系統,讓熟悉Windows生態系遊戲、創作、生產力等軟體的使用者能夠在既有基礎上添加豐富的代理式與生成式AI體驗。

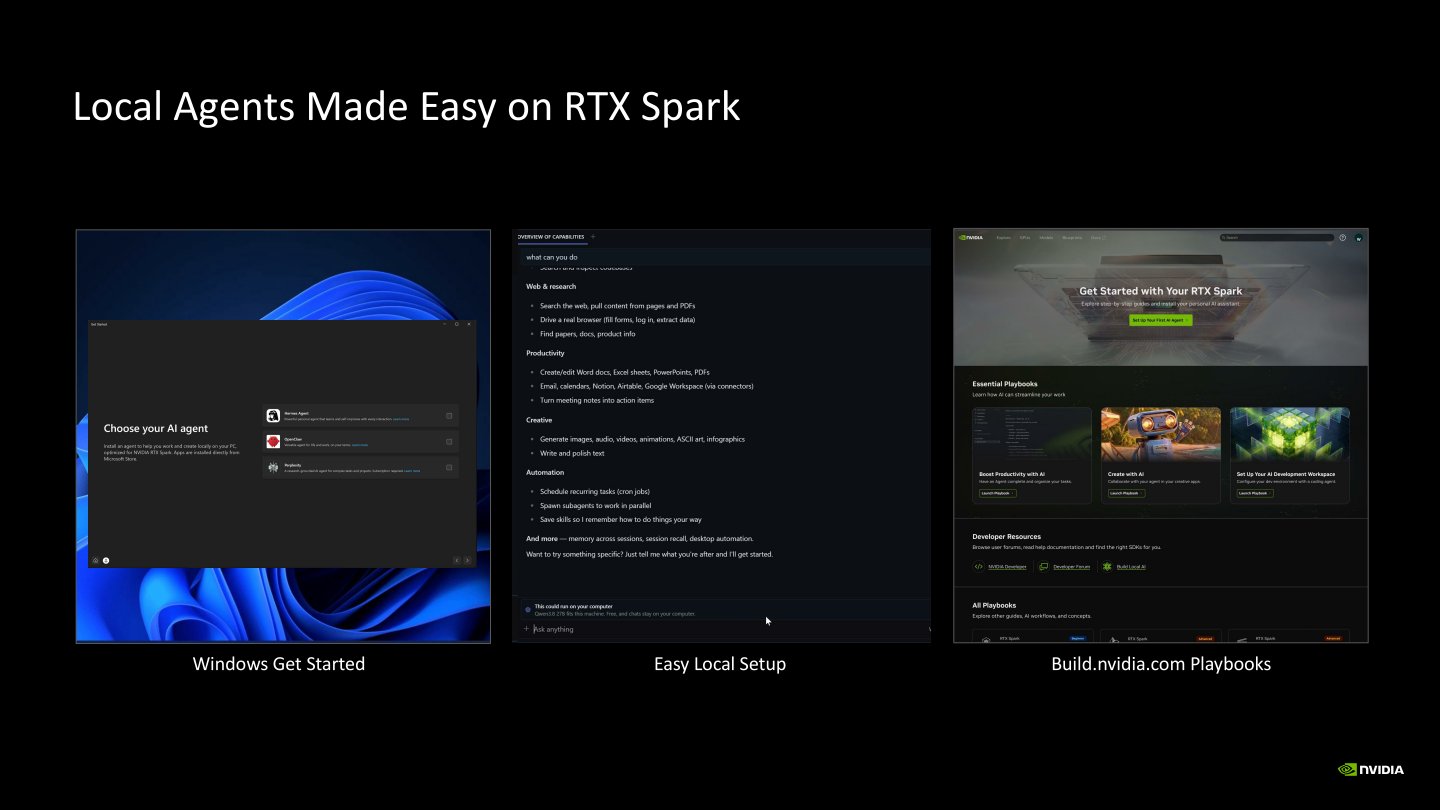
NVIDIA與Microsoft也合作透過Windows Get Started、Easy Local Setup等程式引導使用者快速安裝多種AI軟體,同時NVIDIA也在Built網站上提供許多應用範例,降低使用者的進入門檻。

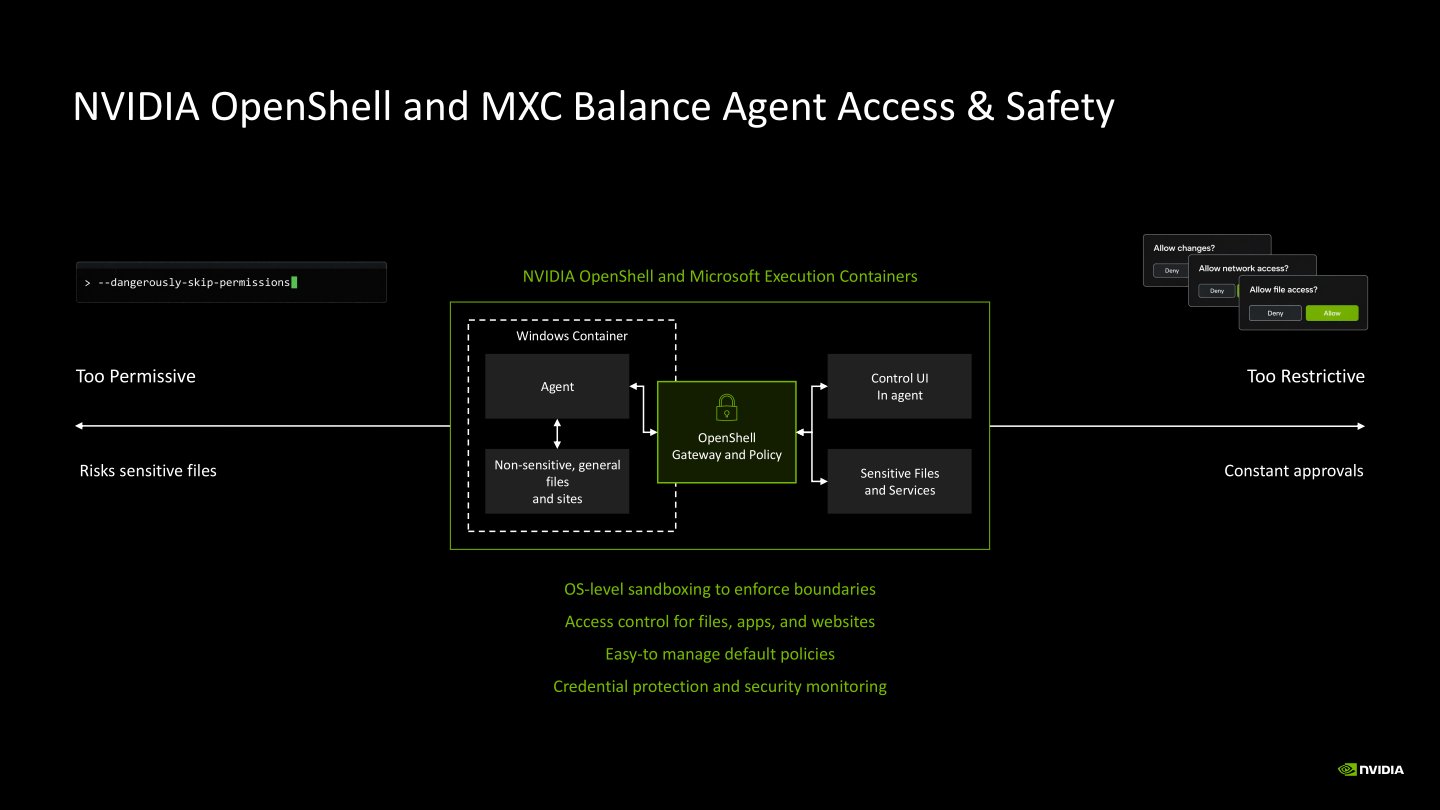
在安全性方面,NVIDIA提供便於管理的OpenShell執行環境,它採用正向表列的權限管理方式,預設會封鎖所有AI代理的操作,需要使用這個確認才能開放權限,將安全性綁定於執行環境而非AI模型或應用程式本身,帶來更可控的資安防護。

另一方面Microsoft也推出MXC容器(Microsoft eXecution Containers,微軟執行容器),建立作業系統層級的隔離式沙盒,並讓AI代理在隔離式沙盒環境中運作,以利管理檔案、App、網路資源的存取權限與管理策略,並提供更強的資安防護與監測。

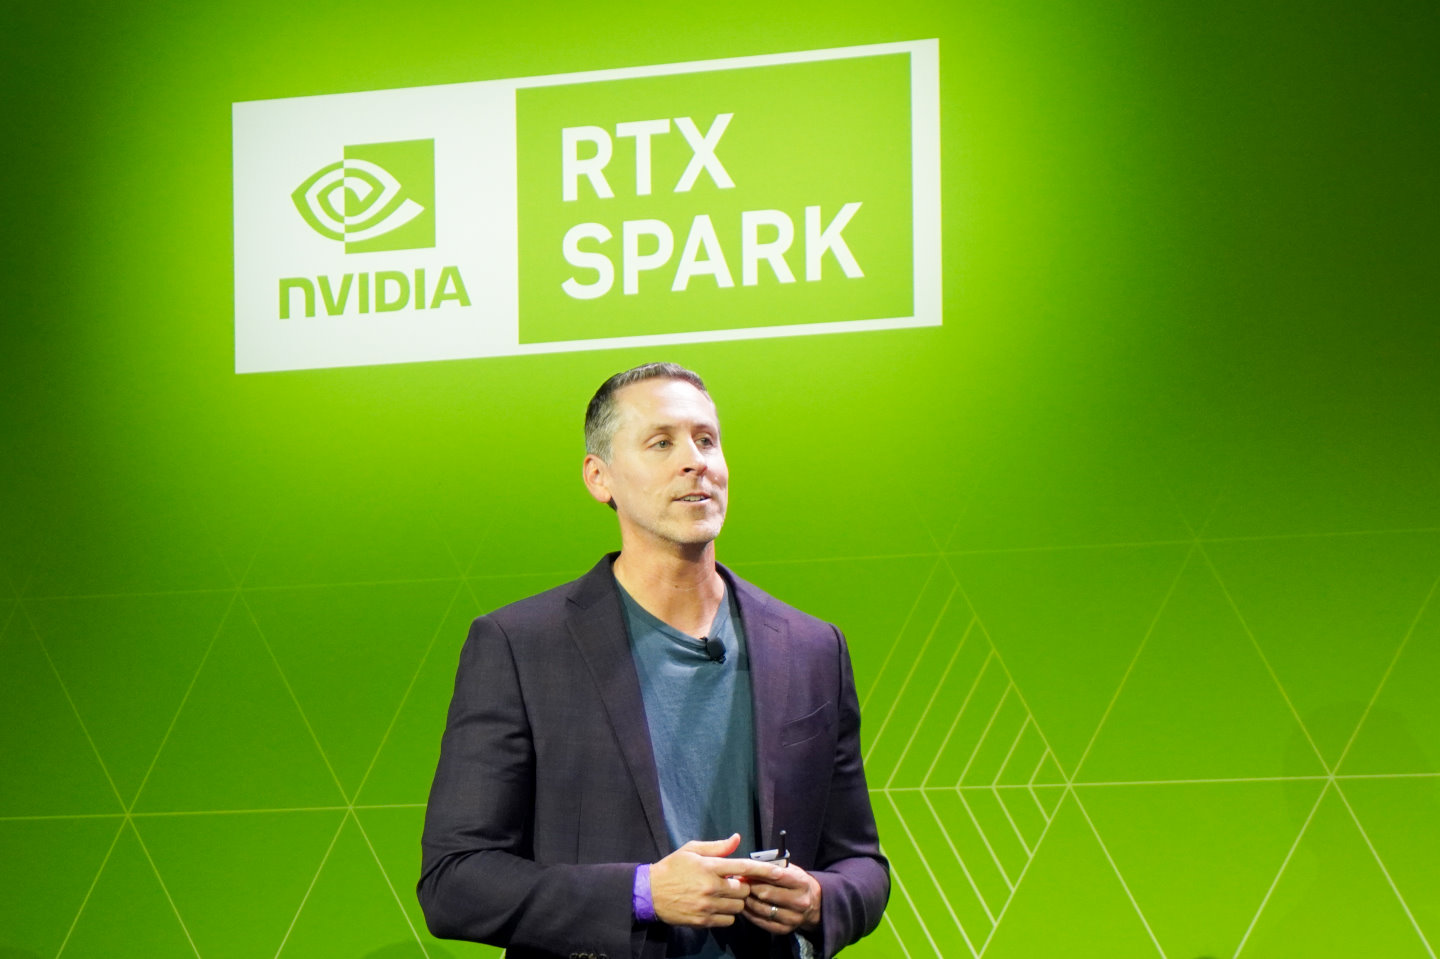
NVIDIA本機AI與遊戲平台副總裁Jason Paul在RTX Spark Editor’s Day活動中說明RTX Spark平台的AI功能。

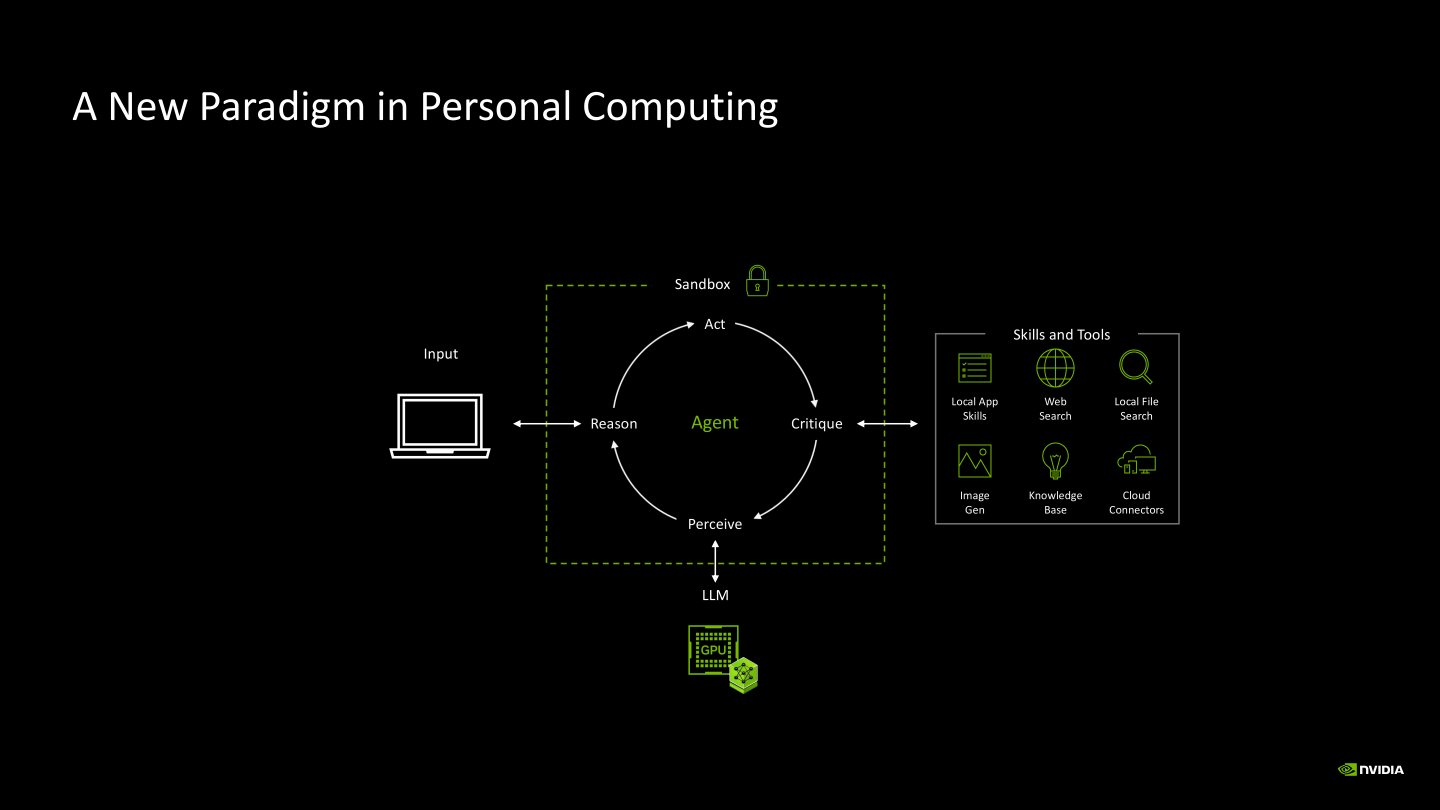
NVIDIA表示代理式AI是未來個人電腦的新支柱,它能在安全的沙盒環境中進行「感知、推裡、行動、評斷」等工作,並透過技能(Skill)與外部工具自動執行更多元的工作。

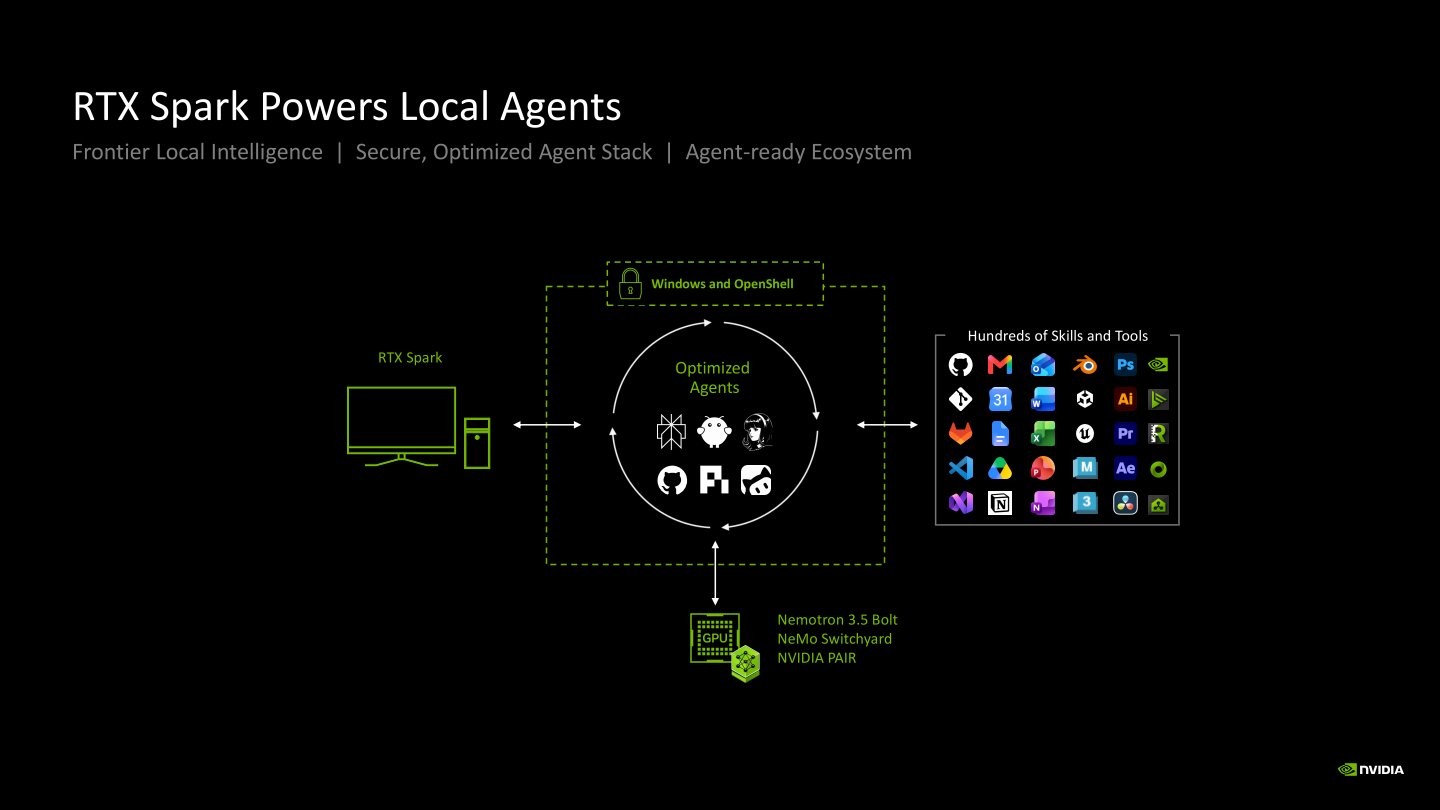
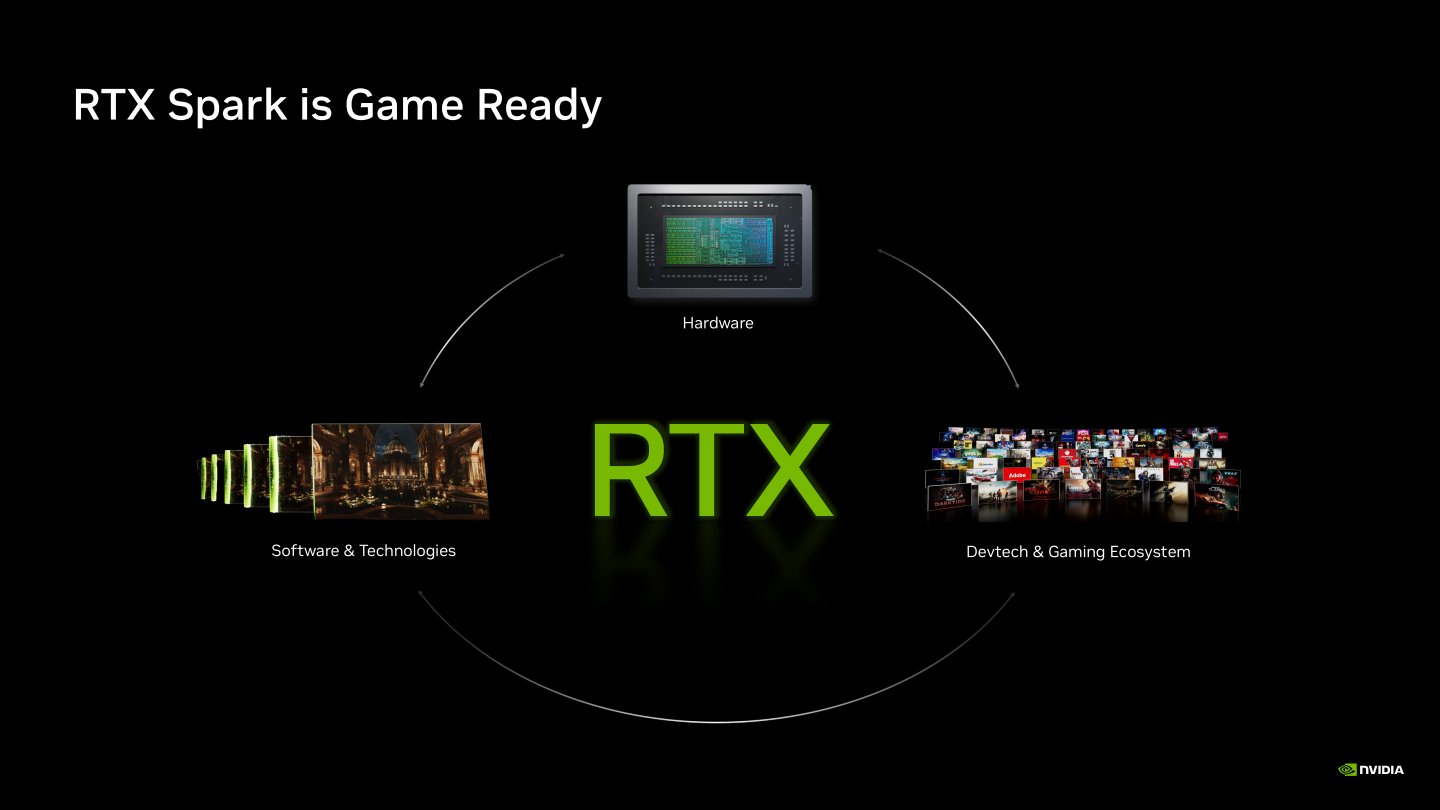
RTX Spark平台透過強大的硬體效能搭配Nemotron 3.5 Bolt本地端模型,以及搭配NeMo Switchyard、Pair等雲端、區域網路分散式AI運算,能夠達成操作圖中右側多種應用程式的能力。

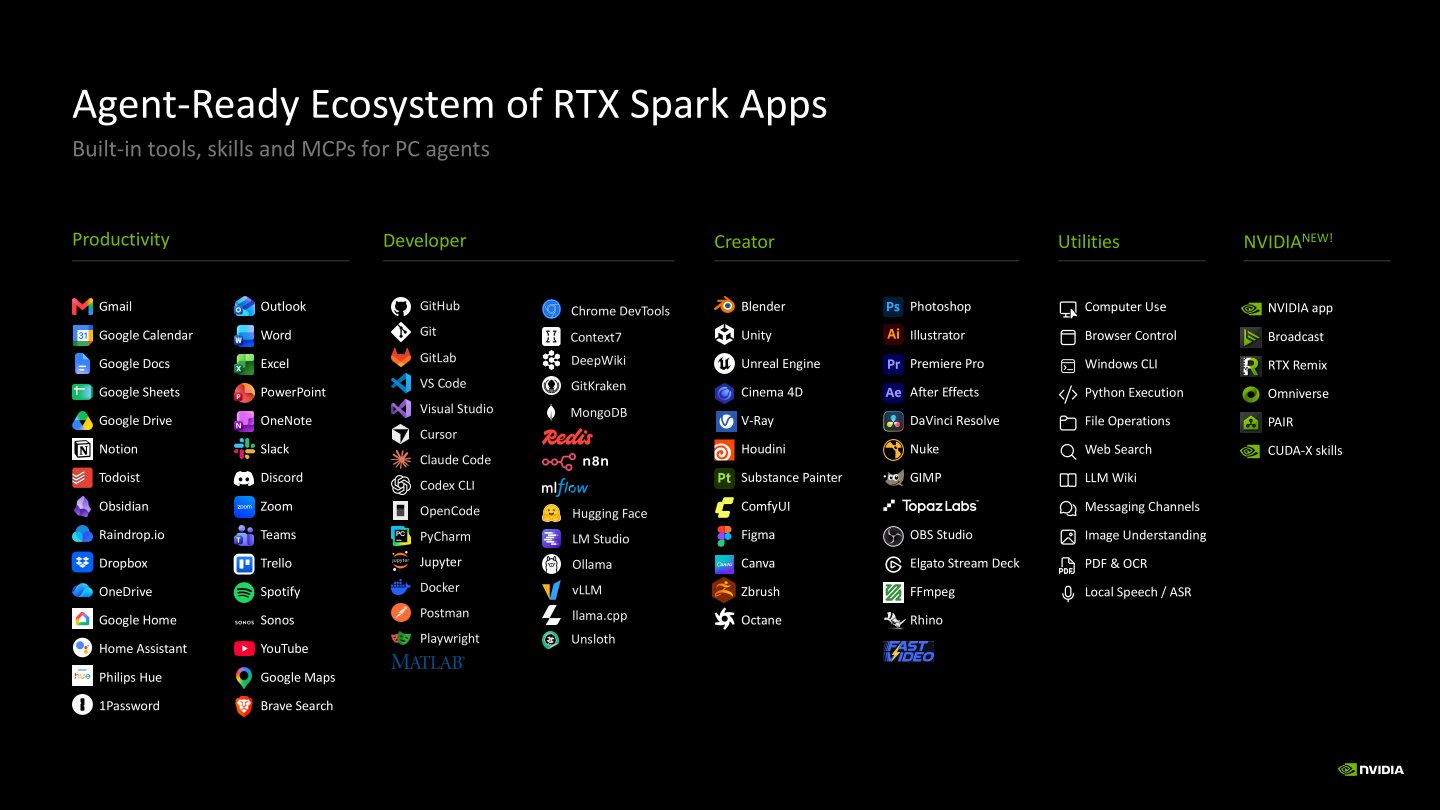
RTX Spark平台的代理式AI能夠支援多款生產力、多媒體創作、程式開發、工具程式,以及NVIDIA自家的App。

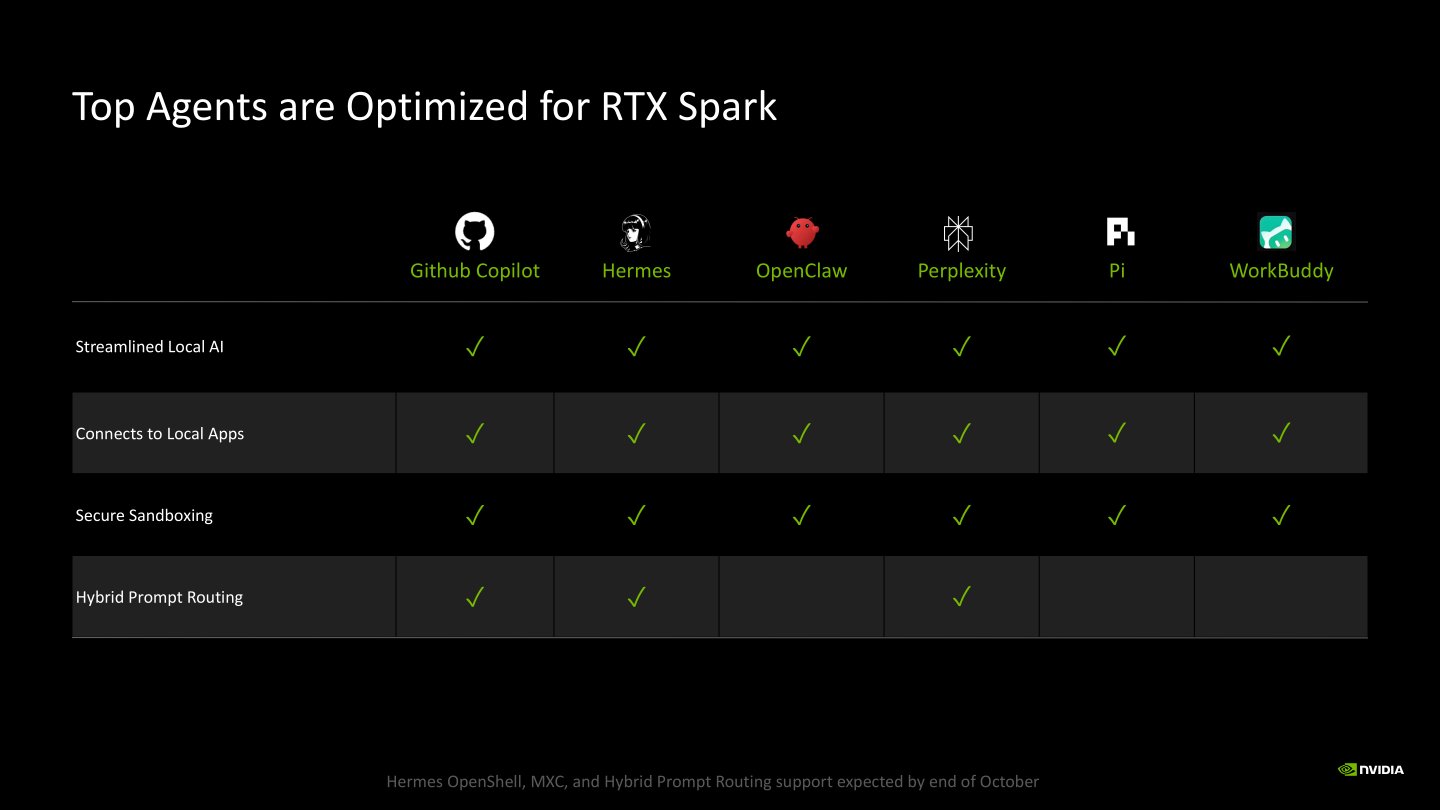
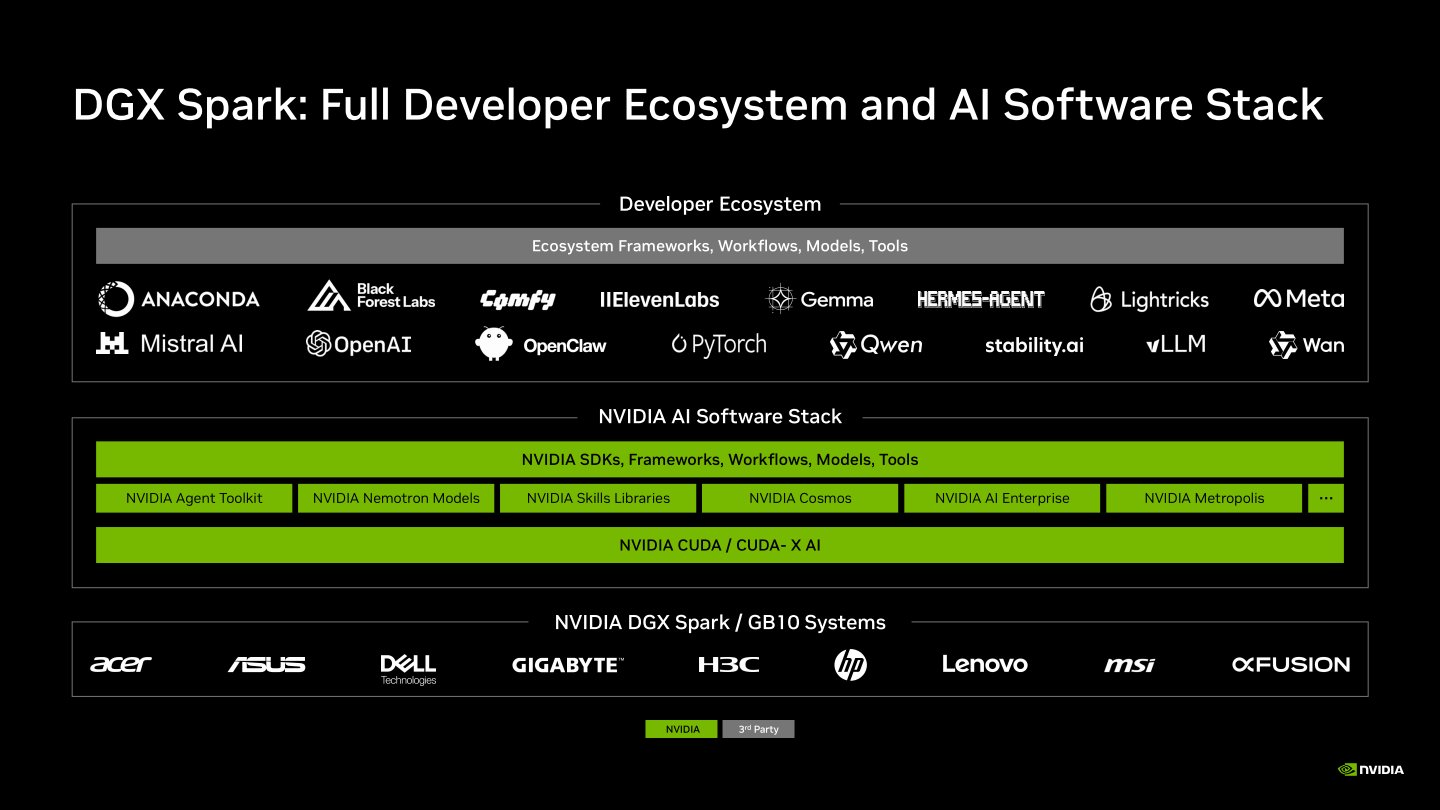
RTX Spark平台也支援Github Copilot、Hermes、OpenClaw、Perplexity、Pi、WorkBuddy等多款代理式AI框架,可串連本機AI與應用程式,並提供安全沙盒環境,部分框架還支援雲端混合運算方式。

NVIDIA與Microsoft合作簡化在Windows作業系統中安裝代理式AI功能的流程,可以透過Windows Get Started、Easy Local Setup等程式快速安裝,也可以在NVIDIA Built網站上找到許多應用範例。

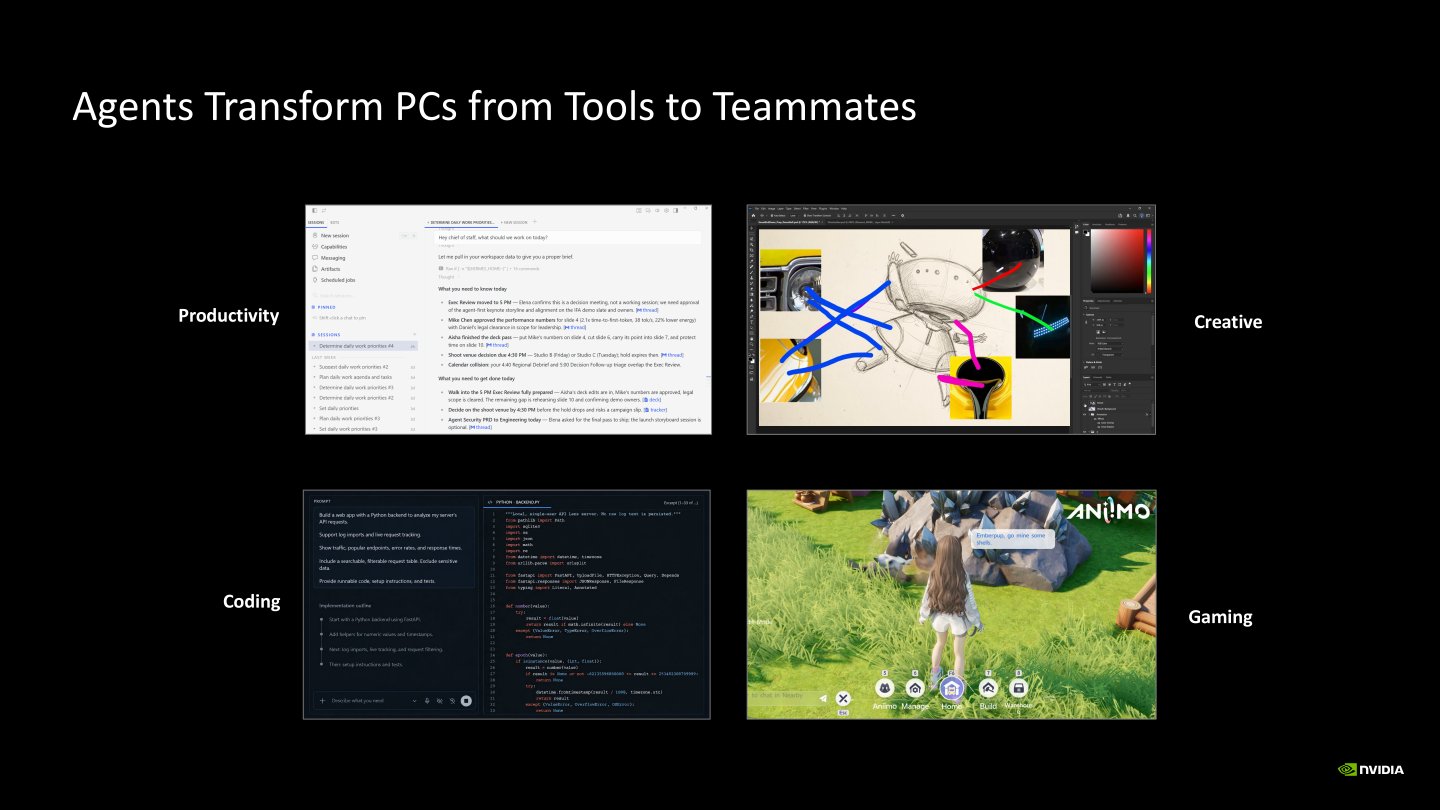
AI代理能夠透過MCP(Model Context Protocol,模型上下文協定)自動操作多種生產力、多媒體創作、程式開發、遊戲等應用軟體,協助使用者提升生產力,並帶來更豐富的遊戲體驗。

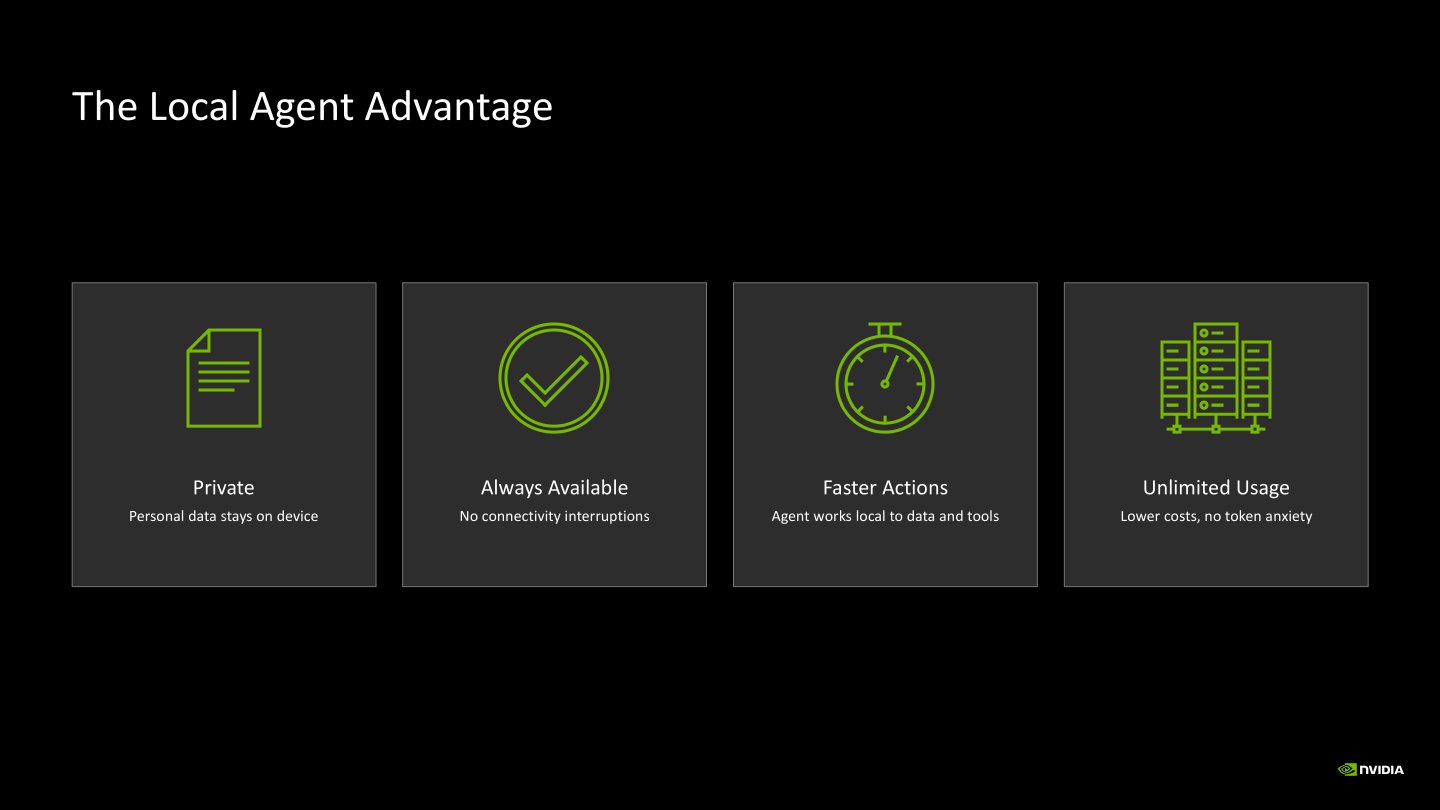
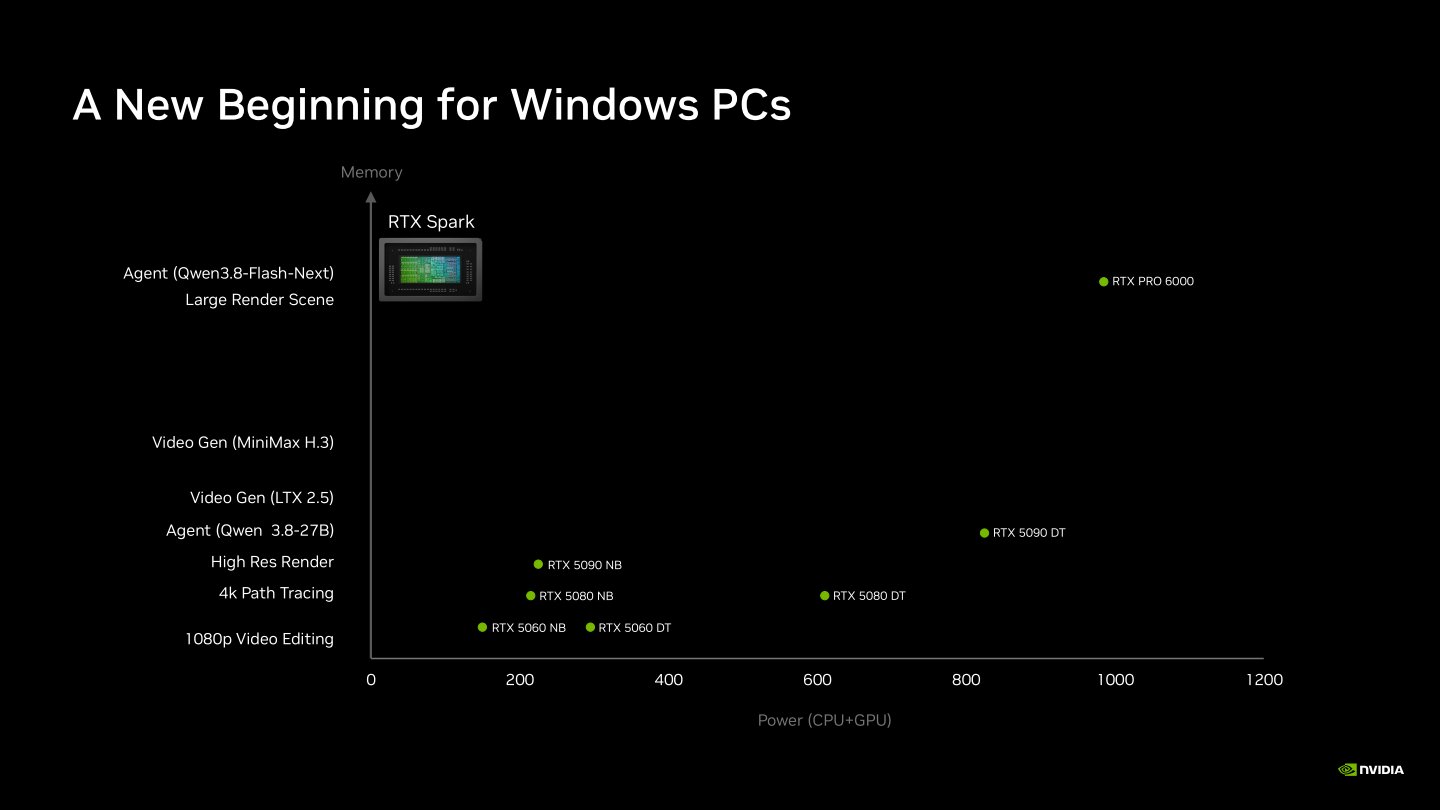
RTX Spark最高支援容量達128 GB的統一架構記憶體,能夠於本機執行代理式AI,具有資安隱私、快速反應、常時可用、無限用量等特色。

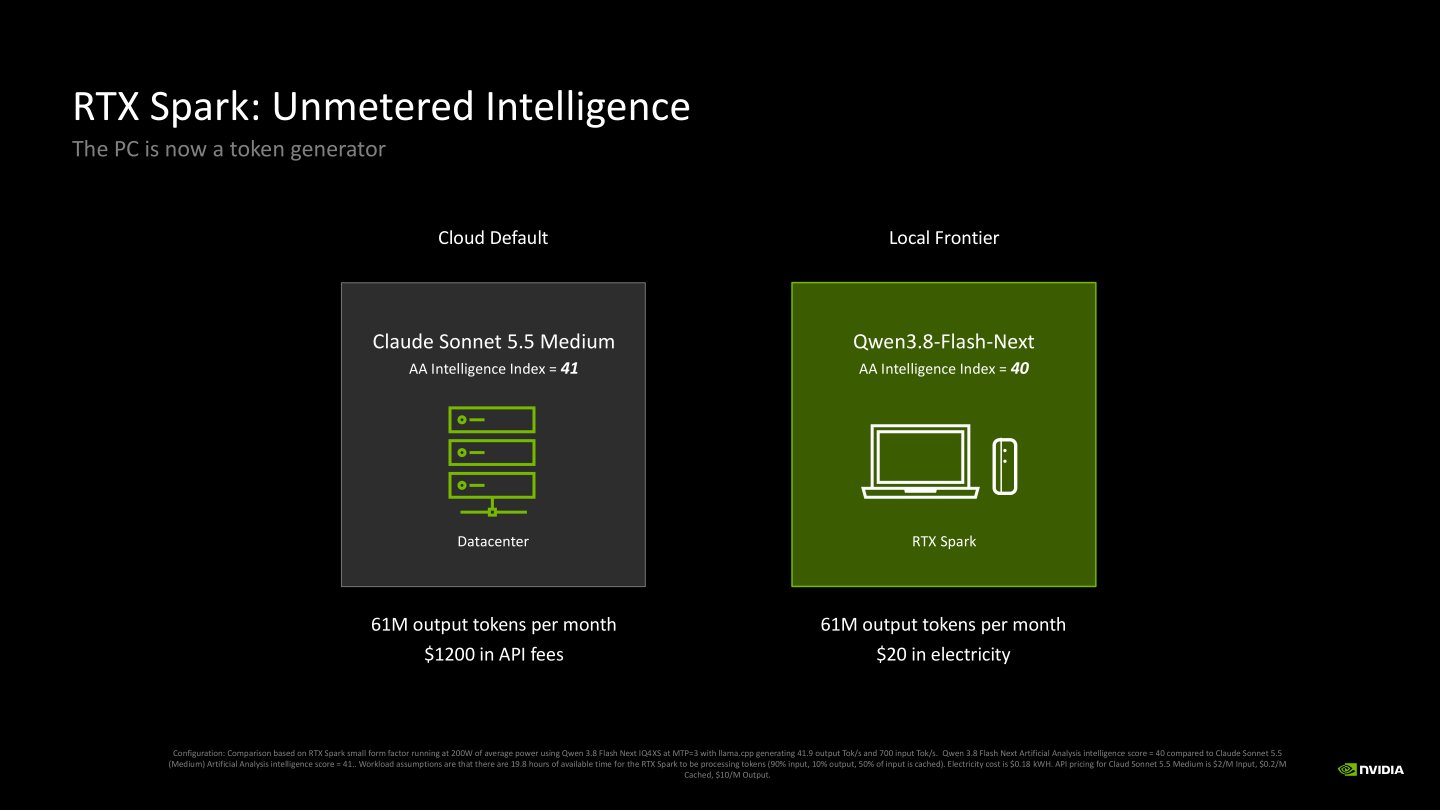
2026年4月時雲端資料中心透過Claude Sonnet 4.7 Max模型在Artificial Analysis Intelligence Index測試取得41分。到了現在Claude Sonnet 5.5 Medium可以得到同樣分數,而在本機端執行的Qwen 3.8-Flash-Next則可取得接近的40分。在同樣每月輸出6,100萬組Token(字詞)的情況下,Claude Sonnet 5.5 Medium雲端服務將產生美金1200元的API費用(約合新台幣39,500元),而RTX Spark平台的成本為美金20元的電費(約合新台幣658元)。

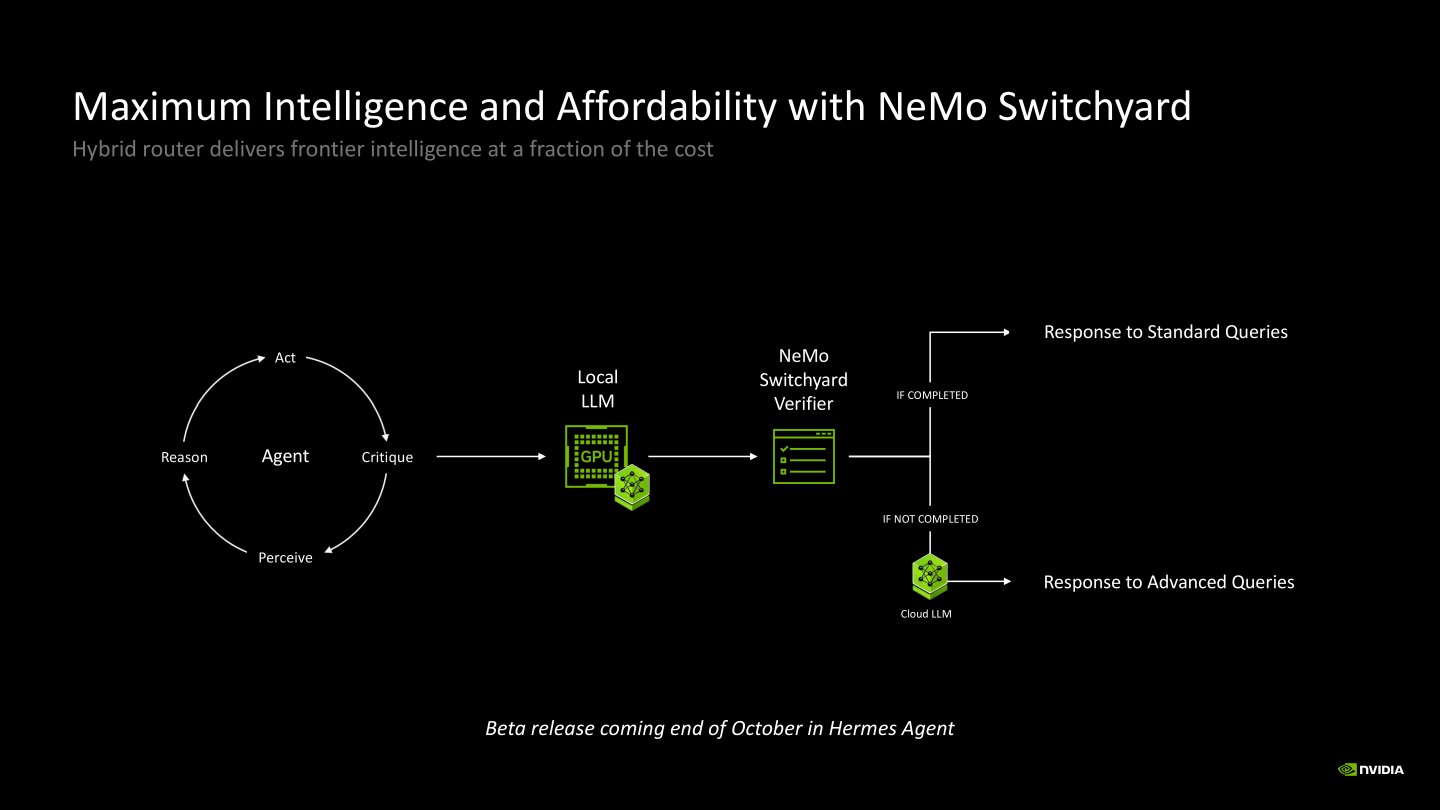
NeMo Switchyard是款混合雲端與本機的函數庫,能夠自動判別本機大語言模型的推論品質,若通過即採用結果以節省費用,若不通過則將需求上傳至雲端處理,雖然會產生Token使用費,但可以得到更精準的結果。

NVIDIA OpenShell執行環境搭配MXC容器(Microsoft eXecution Containers,微軟執行容器)能夠讓代理式AI在作業系統層級的隔離式沙盒環境運作,以利管理檔案、App、網路資源的存取權限與管理策略,並提供更強的資安防護與監測。

活用家中每1塊GPU

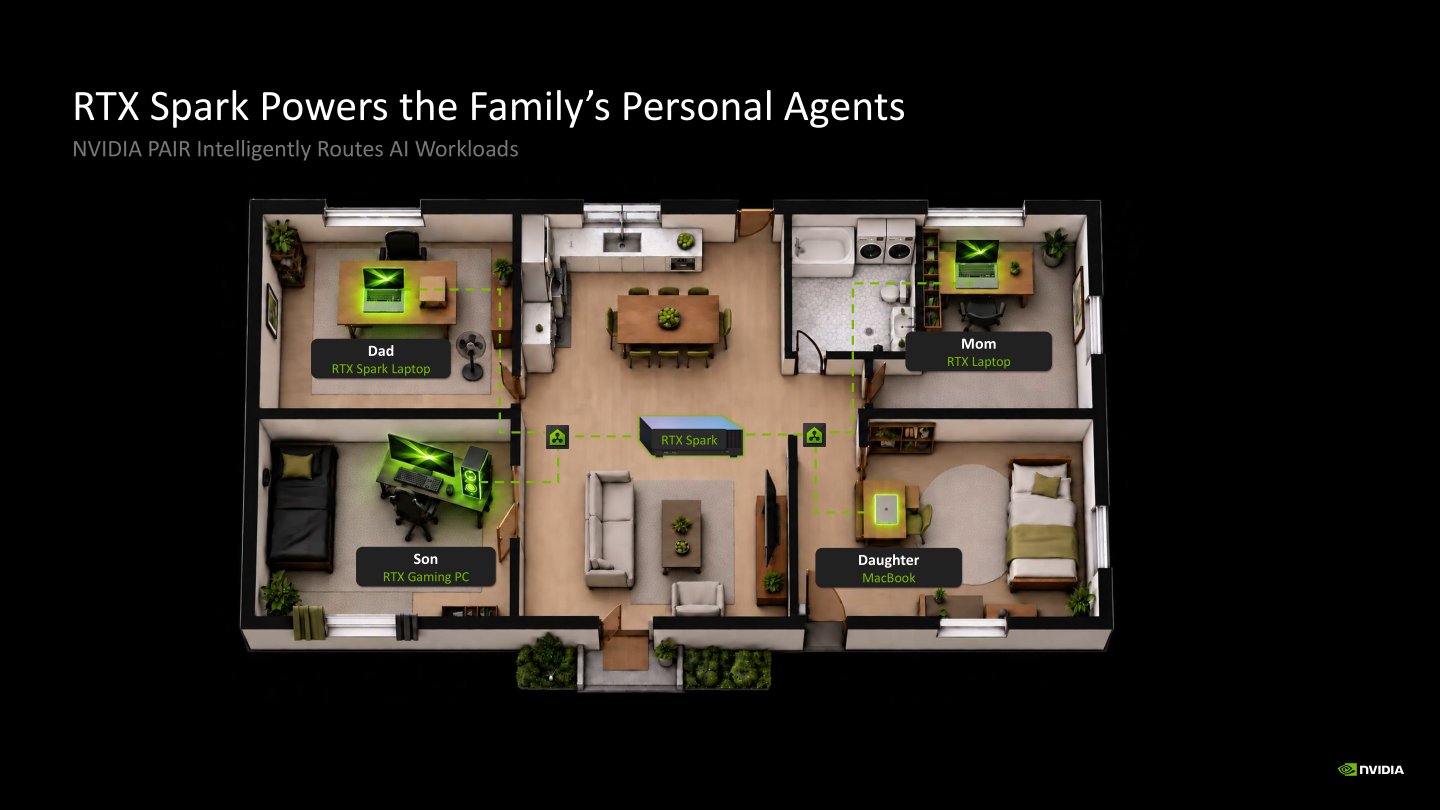
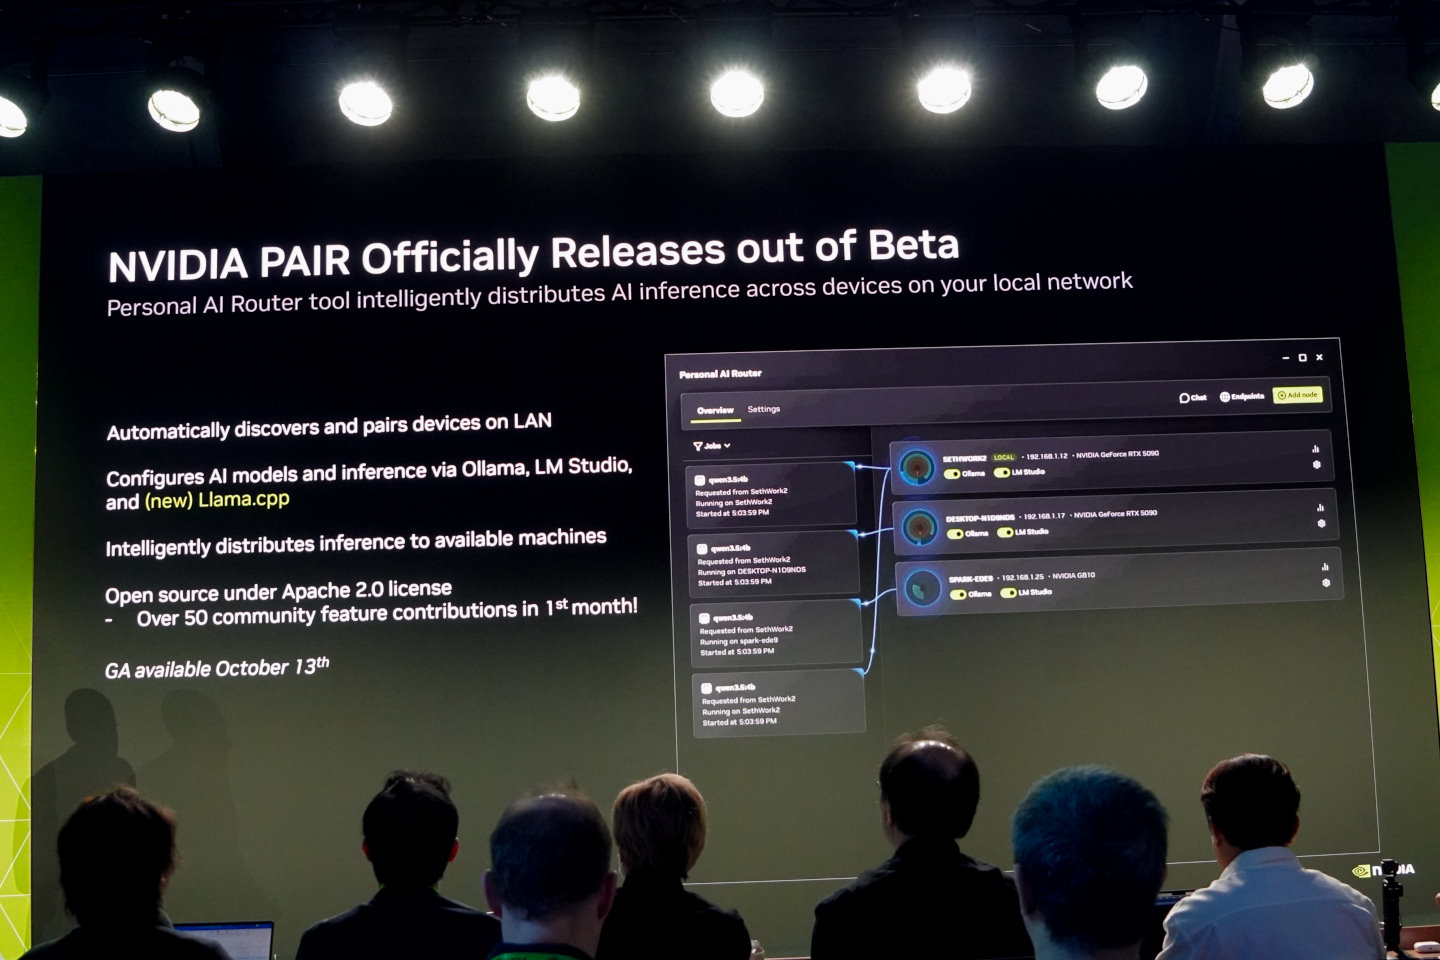
NVIDIA也推出適合應用於家庭區域網路環境的Pair路由功能,支援Windows、Linux、macOS等作業系統,並在推出時即援Ollama與LM Studio等運算框架,能夠將AI運算負載分配到區域網路中的DGX Spark、RTX Spark、搭載GeForce RTX顯示卡或顯示晶片的Windows電腦、macOS裝置等節點,達到分散式運算與靈活調度資源的效果,並確保資料皆在本機端或區域網路中交換,避免隱私或機敏資料外流。

在運作過程中,PAIR會將所有的AI推論運算負載分配至區域網路中的閒置節點,且不受節點作業系統限制,舉例來說可以在Windows電腦上將Ollama大型語言模型框架產生的負載轉移至Linux作業系統的DGX Spark上運算,達到充分利用運算資源的目地。需要注意的是,它只能將多個工作分配給不同裝置,無法將單一工作拆分為多個部分進行分配。

NVIDIA Pair路由功能能夠整合家庭區域網路中的各種桌上型電腦、筆記型電腦、DGX Spark、RTX Spark裝置,將AI運算工作分配至適合的顯示卡、獨立顯示晶片等單元上進行運算。

在RTX Spark Editor’s Day活動現場, Jason Paul以動態方式展示Pair功能。當區域網路中的任何1台電腦發出工作需求後,系統會自動將負擔分配至最適合的節點完成運算並回傳結果,如此一來能夠活用家中每台電腦內的顯示卡、獨立顯示晶片等運算單元。

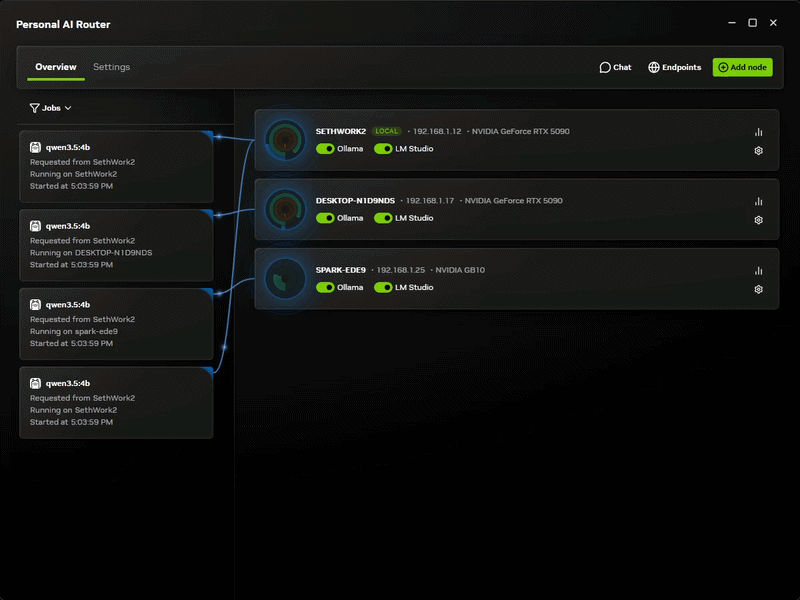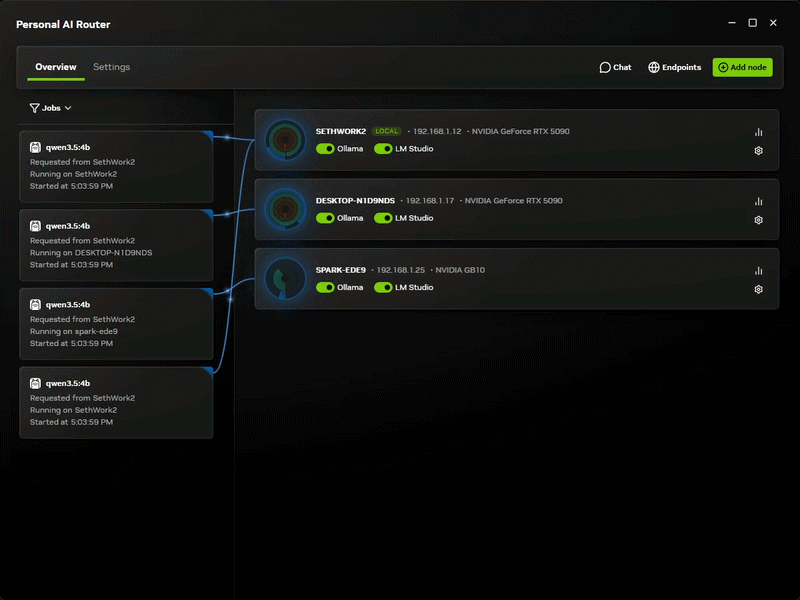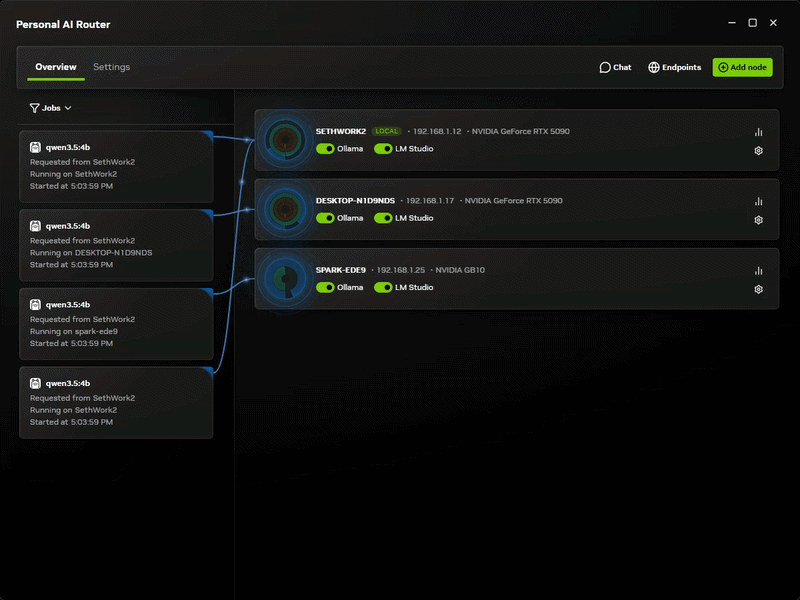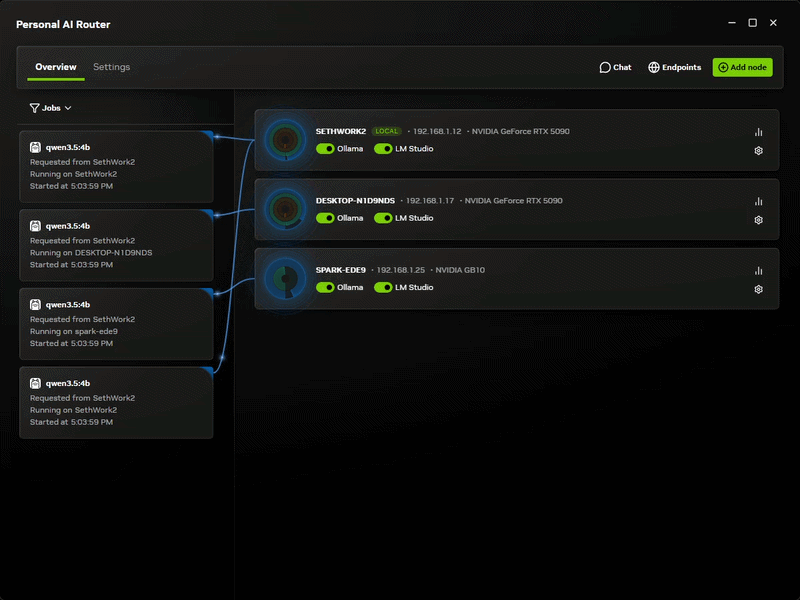
當運算負載產生後,系統會自動挑選最適合的節點接手運算工作。

▲從Pair的運作展示影片可以看到,多個不同的運算負載被分配到3個節點分頭運算。

筆者將在下篇文章中繼續介紹RTX Spark的創作相關功能,後續也預計進行代理式AI的實測,請讀者參考系列文章目錄繼續閱讀。

(回到RTX Spark Editor’s Day系列文章目錄)

加入T客邦Facebook粉絲團
昨天以前T客邦-Techbang

Arm分析代理式AI時代CPU扮演角色,提出效能測試重點

2026年10月27日 13:30
Arm於OCP Global Summit 2026開放運算計畫全球高峰會期間的演說分析CPU效能在代理式AI時代所扮演角色,並說明效能測試與衡量。C103b2741be445f7cc58e69c2e3846d0

Arm於OCP Global Summit 2026開放運算計畫全球高峰會期間的演說分析CPU效能在代理式AI時代所扮演角色,並說明效能測試與衡量。

AI代理的效能需求差異

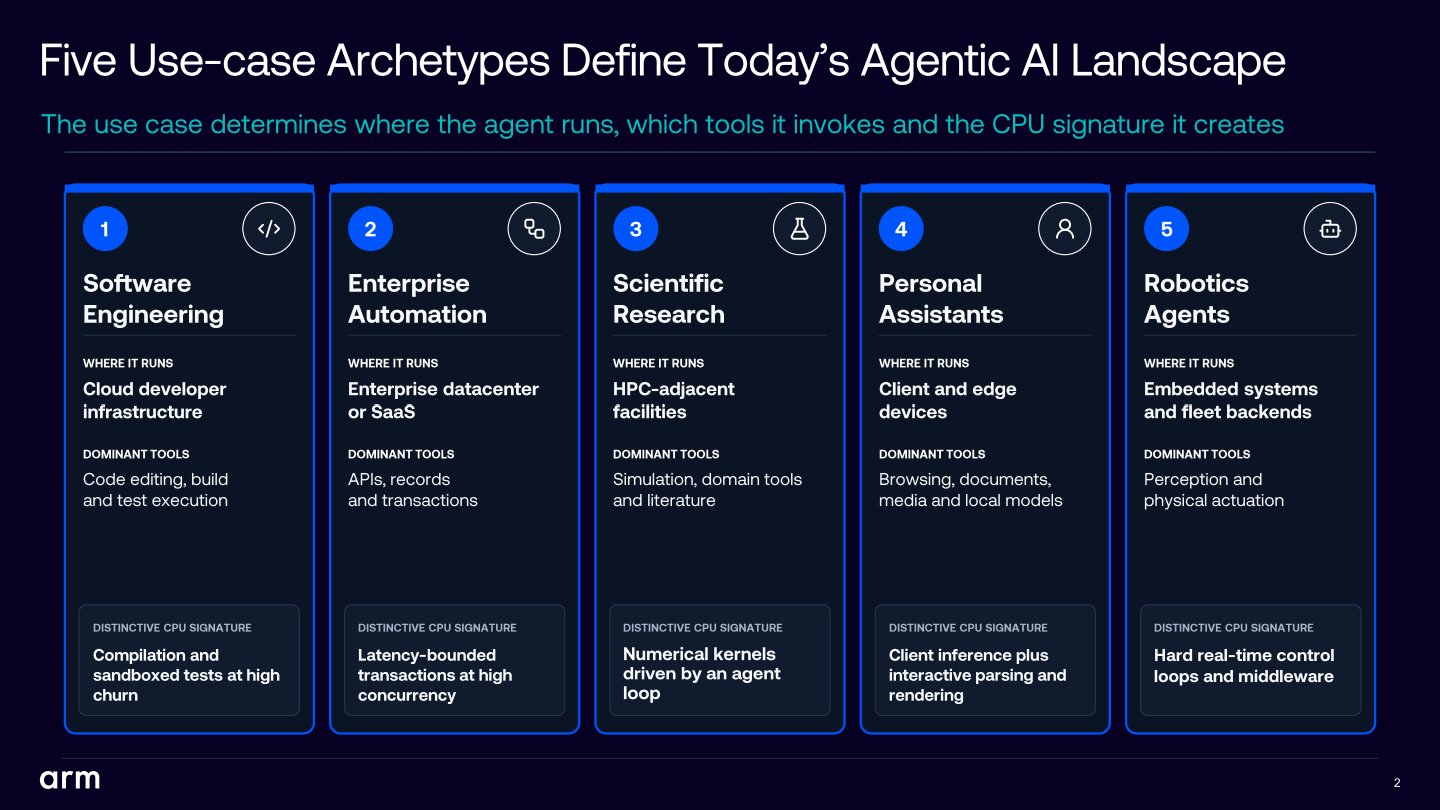
Arm雲端AI解決方案架構總監Ravi Malhotra於OCP Global Summit 2026開放運算計畫全球高峰會的Rethinking CPU Performance for the Agentic AI Era(重新思考代理式AI時代的CPU效能)演說中,分享對代理式AI的趨勢觀查,並提出5種不同的AI使用情境,探討不同類型AI代理對運算基礎設施的差異化需求,以及如何重新定義CPU(處理器)效能測試方式。

延伸閱讀:
Arm Everywhere 2026:瞄準代理式AI運算需求,推出Arm AGI CPU自有品牌處理器
AMD發表最高可容納32,768組CPU核心的Helion機櫃,符合OCP規範強化代理式AI應用
Intel正式發表Intel GPU D系列運算卡,單卡搭載480 GB記憶體可吞300B參數LLM模型

Ravi提出5種目前產業界較為熱門的AI使用情境,筆者將其整理於下。

  1. 軟體工程:開發者利用Codex或Claude Code等AI代理生成程式碼、修正檔,以及進行測試與修正錯誤。
  2. 企業自動化:大型企業將AI代理運用於超大規模的客戶支援、供應鏈和庫存管理等工作。
  3. 科學研究與金融分析:使用多個AI代理進行複雜的模擬運算,並且產生大量特定領域的相關資料。
  4. 個人助理:AI代理自動完成排程、家庭旅行規劃和個人財務管理等任務。
  5. 機器人技術:透過AI驅動機器人自主行動,此技術處於起步階段,未來發展性極具潛力。

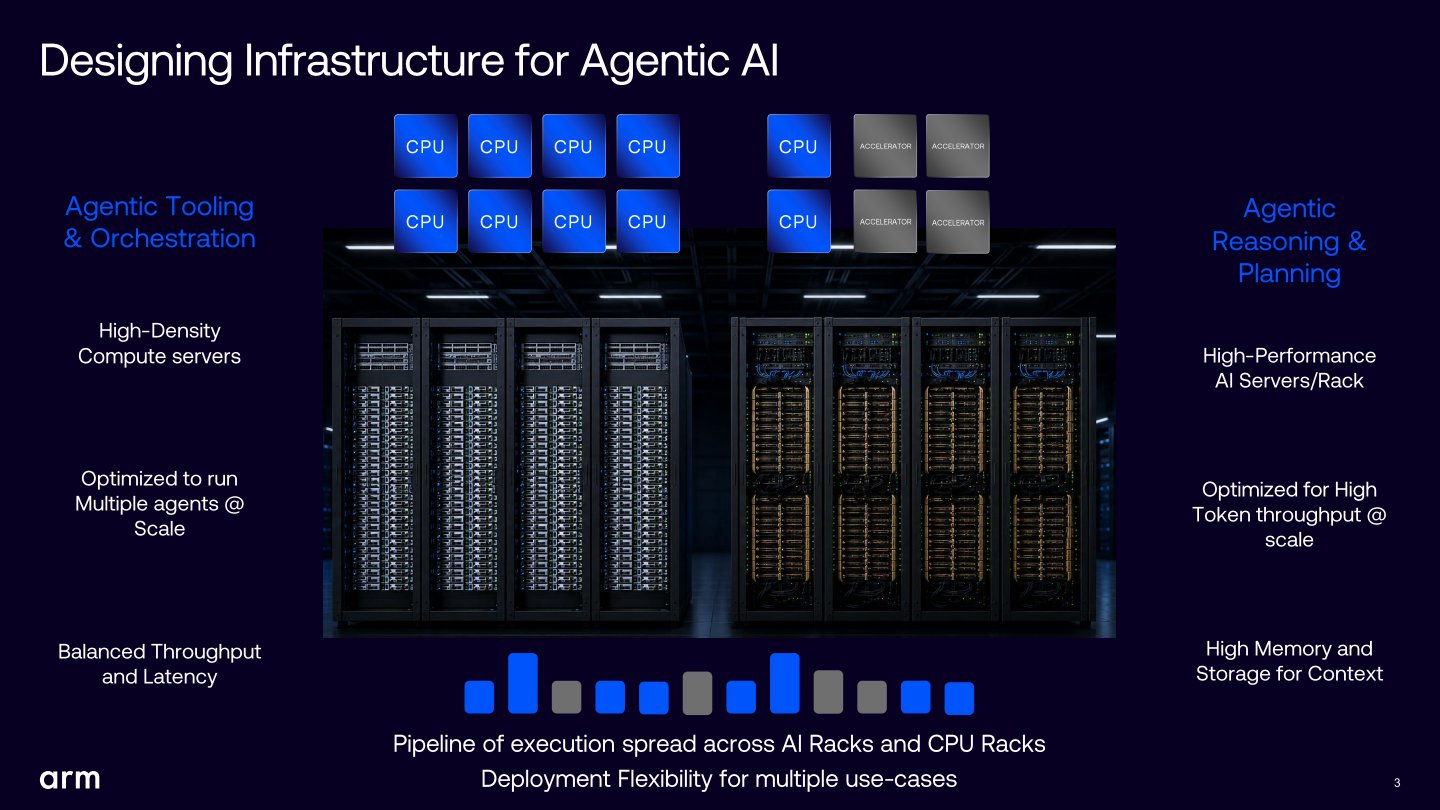
而代理式AI的運作可以粗分為2個階段,第1階段為Token(字詞)生成,主要任務為推論與規劃。這類工作負載通常需要仰賴大型GPU(繪圖處理器)或加速器運算節點,以滿足大規模生成Token,並為AI代理所需的上下文和資料解讀提供充足的記憶體與儲存空間。

第2階段為以推論結果為基礎採取行動,進行工具軟體的操作與編排,通常可在純CPU伺服器上執行,其重點為伺服器需滿足規模化部署,整體基礎設施也需穩定運作。

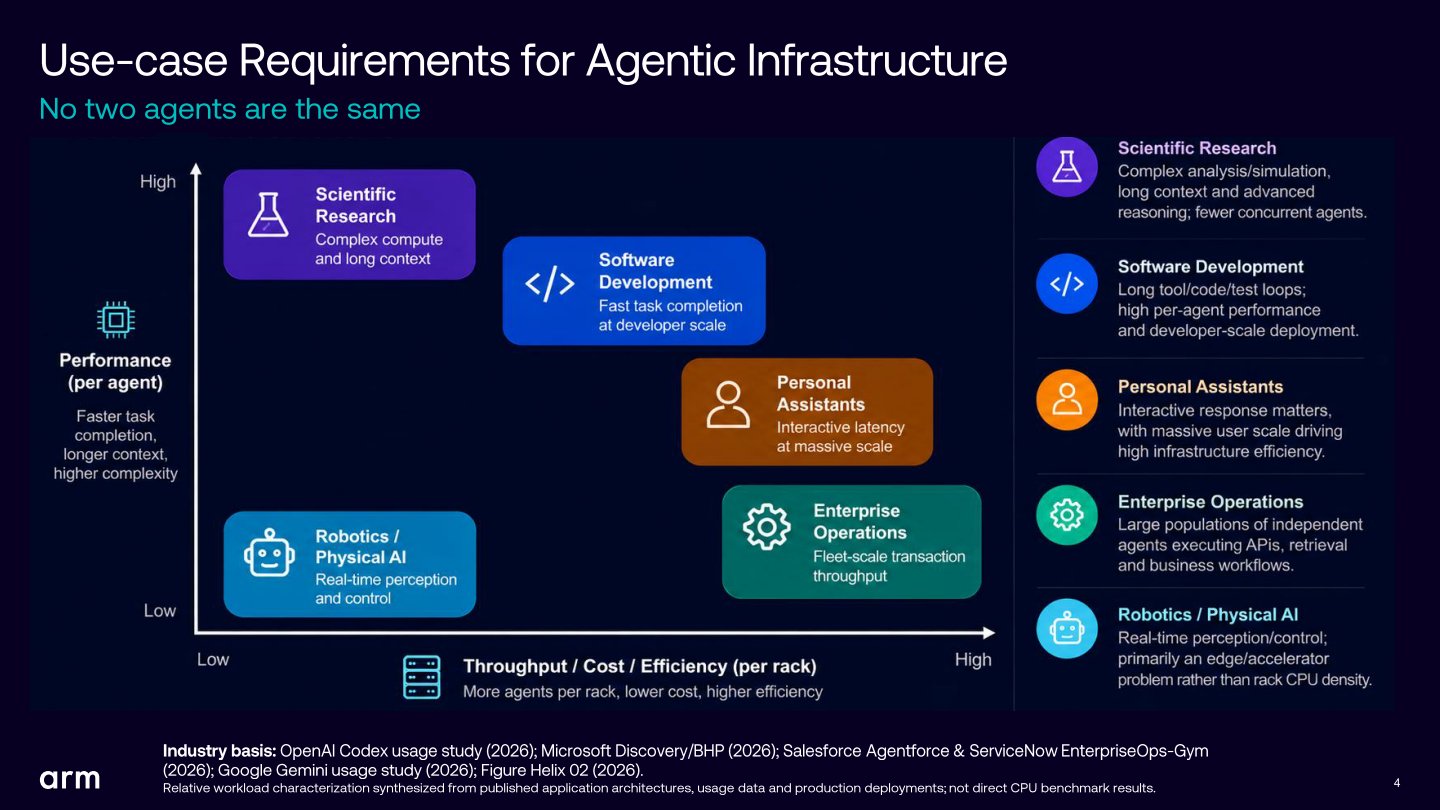
Arm雲端AI解決方案架構總監Ravi Malhotra將目前產業界較為熱門的AI使用情境分為軟體工程、企業自動化、科學研究與金融分析、個人助理、機器人技術等5大類別。

各種使用情境對效能有不同的需求。

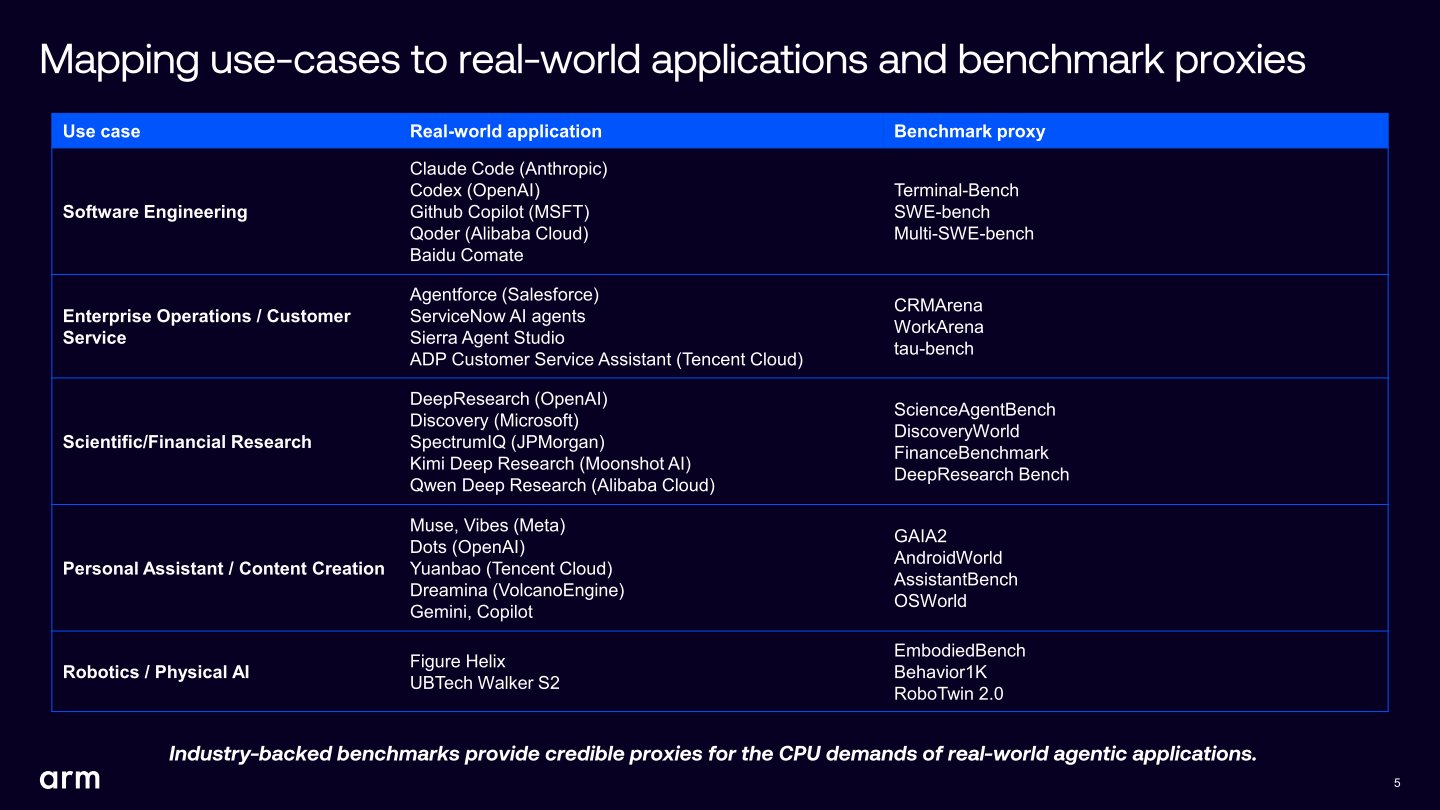
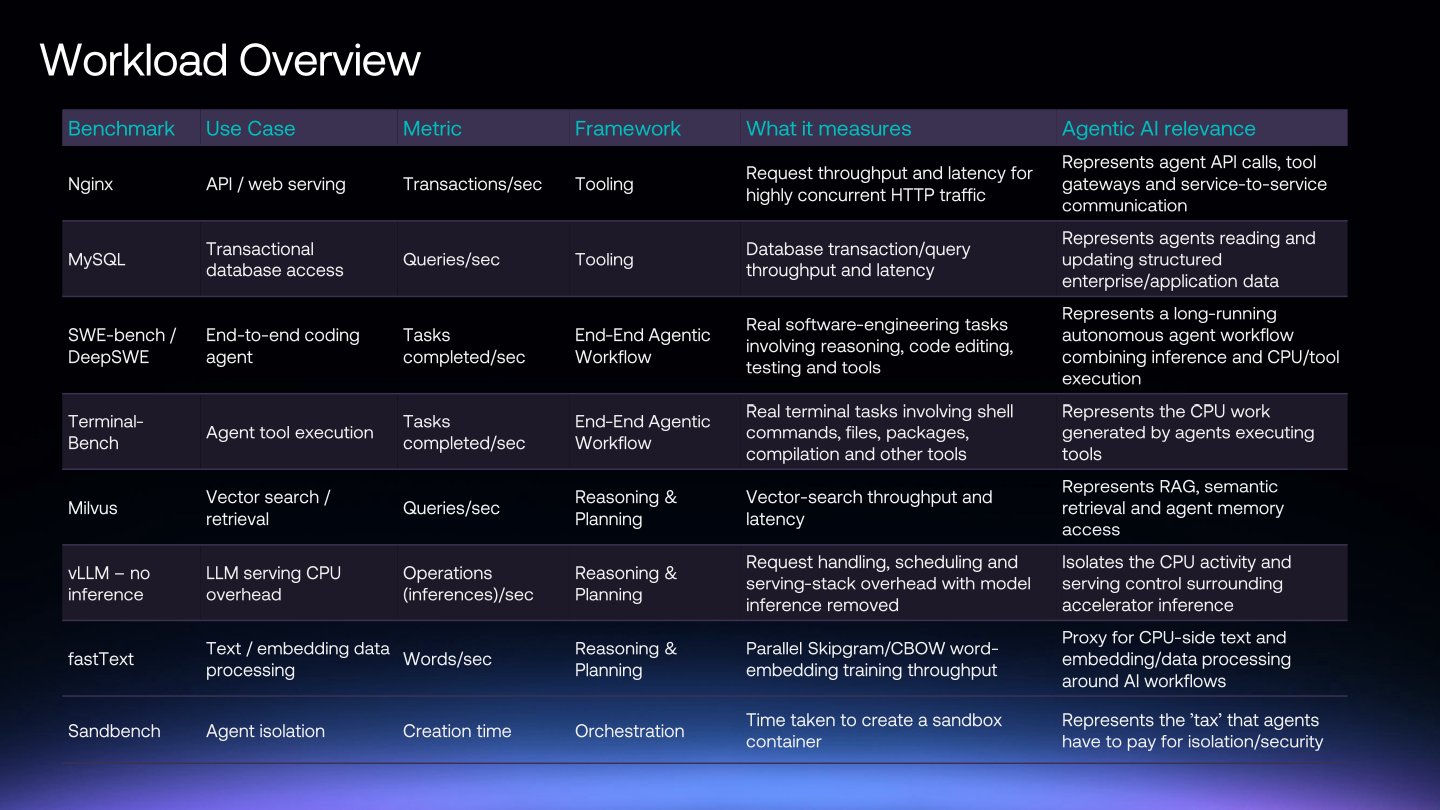
Ravi也提供各情境在真實世界使用的AI服務、應用程式,以及對應的基準測試工具。

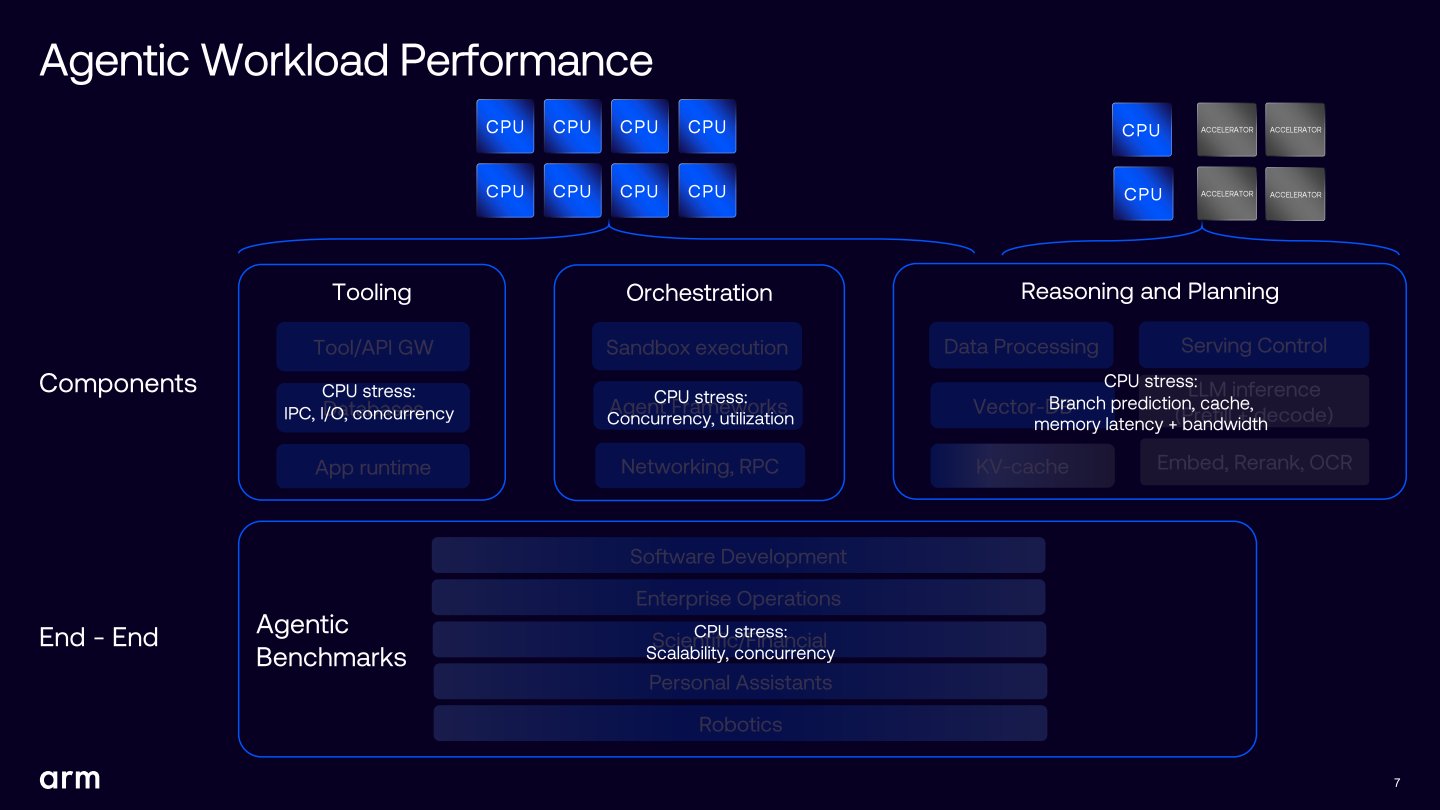
不同的使用情境對效能的需求不同,推論與規劃相關負載需要CPU搭配GPU或加速器的伺服器,而工具軟體的操作與編排則需要純CPU伺服器。

強化持續效能表現

對於前段文章提到的2個階段的關鍵問題在於,需要什麼樣的CPU才能穩定完成這類工作負載?Ravi表示若是仔細研究前述5類使用情境,就會發現彼此的求都各不相同。

軟體工程在進行編譯和測試程式碼所消耗的時間較長,並會消耗大量CPU資源,因此需要單執行緒效能較高的CPU架構。

而企業自動化與個人助理比較常見的工作負載為存取網頁或資料庫等,單次操作工具軟體的持續時間較短,對CPU資源的需求沒那麼高,但是對網路與資料傳輸的需求比較大。

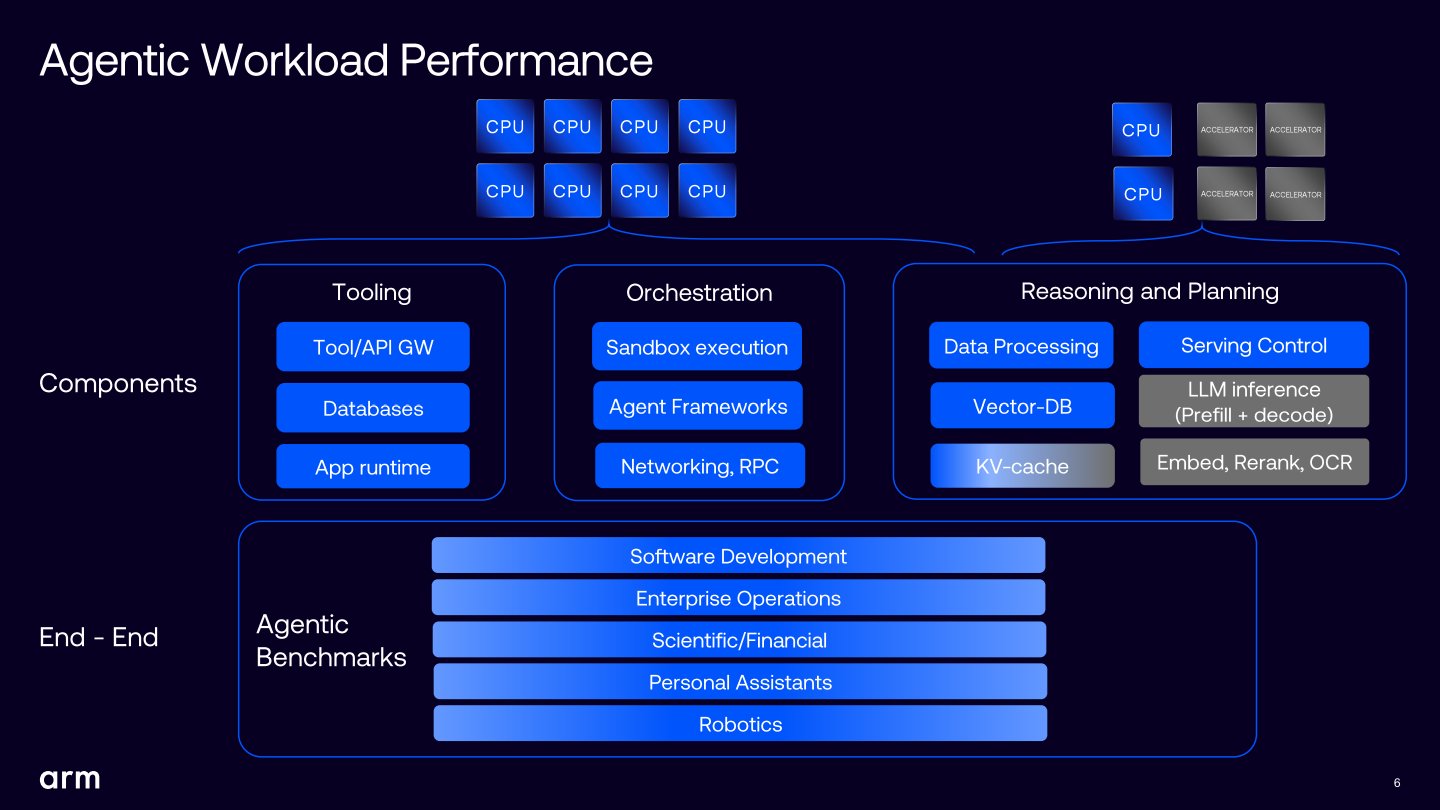
Ravi提到效能測試的方式也可以粗分為2類,其一為從元件角度出發的基準測試,以測試網頁伺服器、資料庫或模型服務的運作速度,也可針對CPU進行如工具呼叫、I/O、平行化等不同負載的測試評估。

例如從編排的角度來說,強調CPU平行化和利用率,而在推論中,充當主節點的CPU著重分支預測、快取、記憶體延遲、記憶體頻寬等單執行緒相關的效能,可以精確呈現單個元件的效能表現,但無法反映在代理式AI工作流程中協同運行的整體表現。

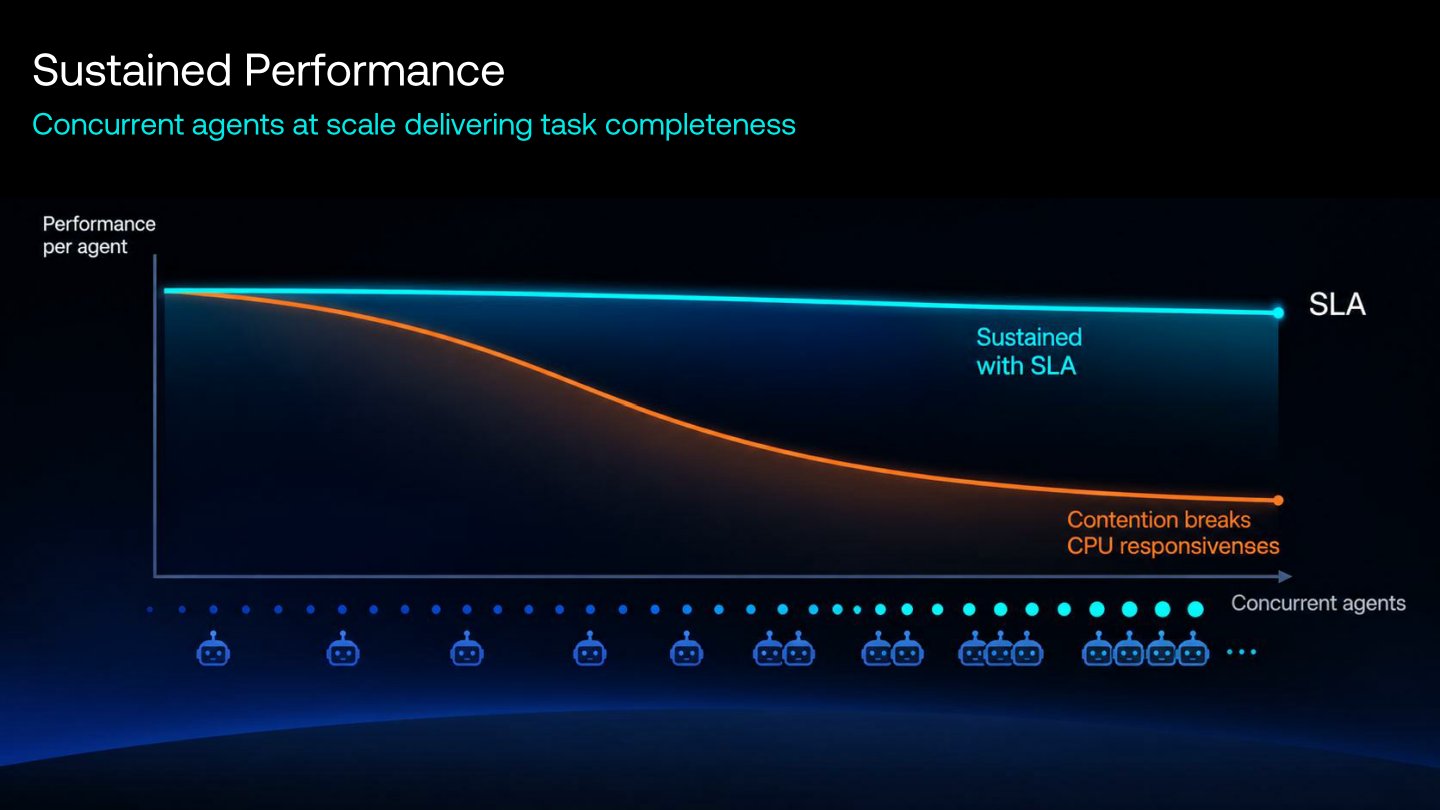
其二是端到端代理式AI基準測試,它更至著重系統的平行化與可擴展性,效能評估不只看單組CPU能夠負擔多少AI代理,也不只單純追求最高吞吐量,還需要在吞吐量與 SLA(Service Level Agreement,服務水準協議)之間取得平衡,達到持續效能輸出。

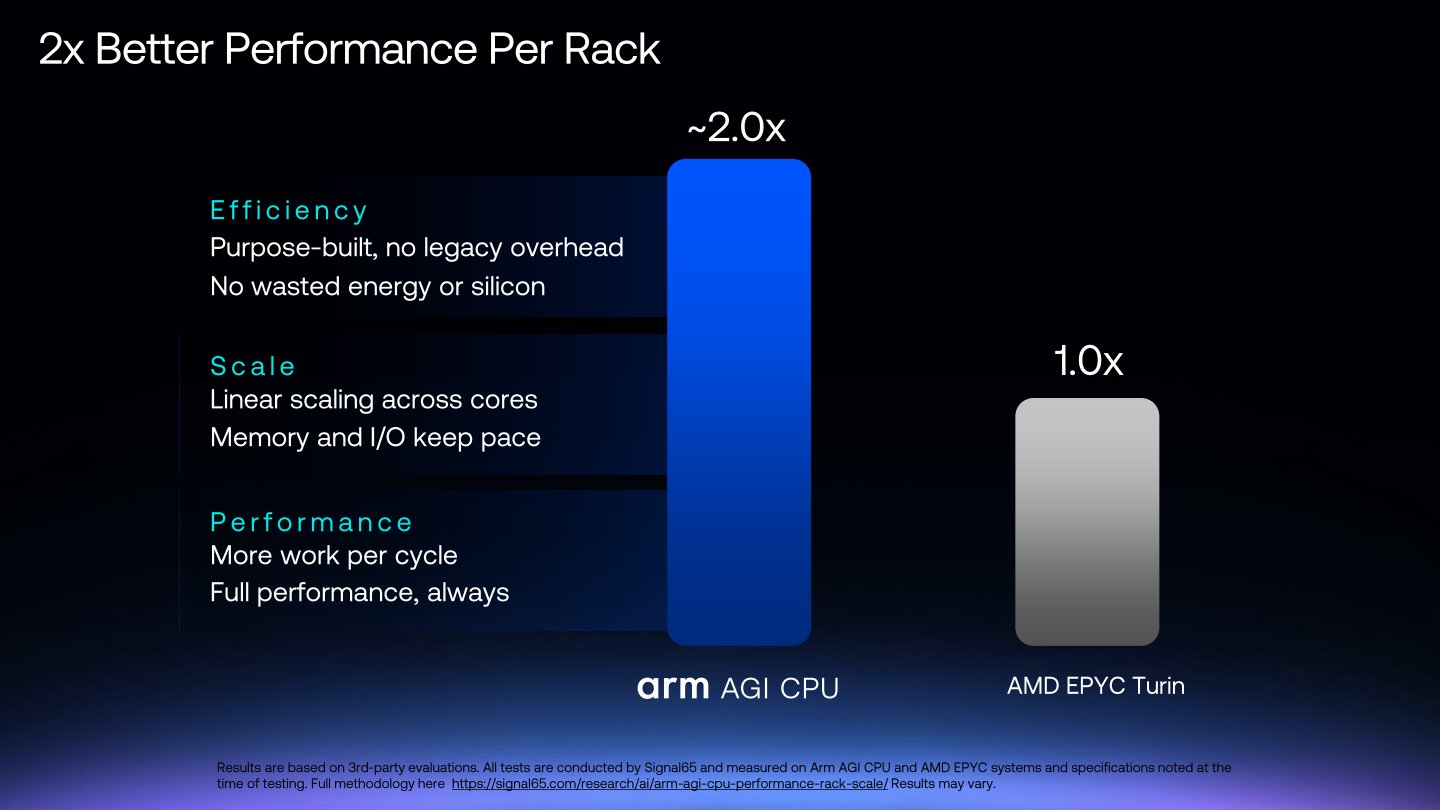
Arm也與獨立技術分析機構Signal65合作發表獨立報告,對比了Arm AGI CPU與代號為Turin AMD第5代EPYC處理器在AI代理工作負載的效能,並將研究重點放在電力效率、可擴展性和效能平衡。報告顯示,在相同功耗下Arm AGI CPU每機櫃AI代理工作負載效能約為EPYC 9755的近2倍。

Ravi也進一步分析工具操作、編排、推論與規劃、端到端等應用的詳細需求。

工具操作偏重CPU的IPC效能與I/O頻寬,編排需要CPU高度利用,推論與規劃則需要CPU的分支預測、快取、記憶體延遲、記憶體頻寬等特性,端到端則靠驗CPU的可擴展性。

Ravi強調需取得SLA(Service Level Agreement,服務水準協議)與效能之間的平衡,才能達到長期穩定的持續效能輸出。

Ravi也提出詳細的測試項目與對應的工作負載。

Arm也與獨立技術分析機構Signal65合作發表獨立報告顯示,在相同功耗下Arm AGI CPU每機櫃AI代理工作負載效能約為EPYC 9755的近2倍。

Arm與ASRock、Lenovo、Supermicro等合作夥伴共同推出多款搭載Arm AGI CPU的產品。

Ravi也強調沒有任何代理式AI的使用情境是完全相同的,尤其是在各項技術快速演進的當下,對於大部分市場來說,Arm AGI CPU的優勢是能夠在效能、可擴展性和電力效率之間取得平衡。

Arm與ASRock、Lenovo、Supermicro等合作夥伴共同推出多款氣冷與液冷散熱方案方與量產平台和商用伺服器,讓客戶能以Arm AGI CPU做為主節點,並搭配外部加速器協同工作。

更多效能測試相關資訊,可以閱讀Arm發表的《How to Define CPU and Software Stack Performance for Agentic AI》白皮書(PDF)。

加入T客邦Facebook粉絲團

NVIDIA RTX Spark遊戲功能掛保證,RTX功能與防作弊系統通通大丈夫

2026年10月20日 16:30
NVIDIA RTX Spark平台搭載的GB10 SoC整合具有6,144組CUDA核心的內建顯示晶片,能夠提供流暢的1440p遊戲體驗。4beecdf53d4fe6ae67ad2419a5c401b7

NVIDIA RTX Spark平台搭載的GB10 SoC整合具有6,144組CUDA核心的內建顯示晶片,能夠提供流暢的1440p遊戲體驗。

x86模擬器搭配原生DirectX 12

RTX Spark平台搭載的GB10 SoC採用Arm架構處理器(CPU),具有Arm Cortex-X925與Arm Cortex-A725核心各10組(共20核心),搭配具有6,144組CUDA核心的Blackwell架構繪圖處理器(GPU),受益於與GeForce顯示卡、GB300 Superchip等產品相同的Blackwell架構,因此RTX Spark也支援所有NVIDIA的軟體堆疊,除了通用運算、AI運算等加速函數庫之外,也包含與遊戲相關的RTX光線追蹤、DLSS升頻、Reflex低延遲、G-Sync可變更新頻率等等技術,提供玩家與x86處理器搭配NVIDIA獨立顯示晶片之電競筆電一致的遊戲體驗。

延伸閱讀:
RTX Spark筆記型電腦效能實測
RTX Spark Editor’s Day系列文章目錄
NVIDIA DLSS 5技術解析:不再只是效能禁藥,AI美肌強化紋理與光影效果
NVIDIA DLSS 5神經渲染效能實測:畫質有感提升但FPS效能砍半

如同前文所述,我們在一般Windows電腦上使用的32bit與64bit的x86架構應用程式與遊戲,可以在Microsoft提供的Prism模擬器協助之下,轉換為RTX Spark平台能夠相容的Arm格式並執行。NVIDIA也與遊戲開發者合作推動原生Arm架構的遊戲,避免模你造成的效能耗損,以提供更流暢的遊戲體驗。

在繪圖功能部分,GB10的Blackwell架構GPU能支援DirectX 12繪圖API,以及光線追蹤、DLSS升頻、DLSS 5神經渲染、ACE遊戲AI角色、RTX Remix遊戲重製等技術,讓更多遊戲與技術能夠在RTX Spark平台順利運作。

另一方面NVIDIA也與許多開發商合作,讓防作弊系統能夠辨識GB10 SoC並正確運作,其中也包含以核心模式(Kernel Mode)運作的防作弊系統,讓玩家可以正常遊玩遊戲,而不會因CPU的架構不同而造成誤判的情況。

需要注意的是RTX Spark平台所使用的Prism模擬器與SteamOS使用的Proton相容層在概念上並不相同。對於x86架構的遊戲而言,RTX Spark平台透過模擬器的方式讓Arm架構CPU執行x86架構的遊戲程式,繪圖部分則可直接使用DirectX、Vulkan等API,在CPU部分的效能耗損可能會比較高,但實際情況會因遊戲而異。

SteamOS基本上還是運作於x86架構CPU上,只是其作業系統為Linux,Proton相容層的功能為將遊戲的系統呼叫(System Call)轉換成與POSIX格式,並透過VKD3D-Proton與DXVK分別將DirectX 12與DirectX 9~11的繪圖API轉換為Vulkan指令以進行繪圖。

RTX Spark平台使用的GB10 SoC採用小晶片(Chiplet)設計,CPU小晶片具有10組Arm Cortex-X925核心與10組Arm Cortex-A725核心,GPU小晶片部分則具有6,144組Blackwell架構CUDA核心,以及第4代RT核心、第5代Tensor核心,2者採用頻寬高達600 GB/s的NVLink-C2C互連技術進行資料交換。

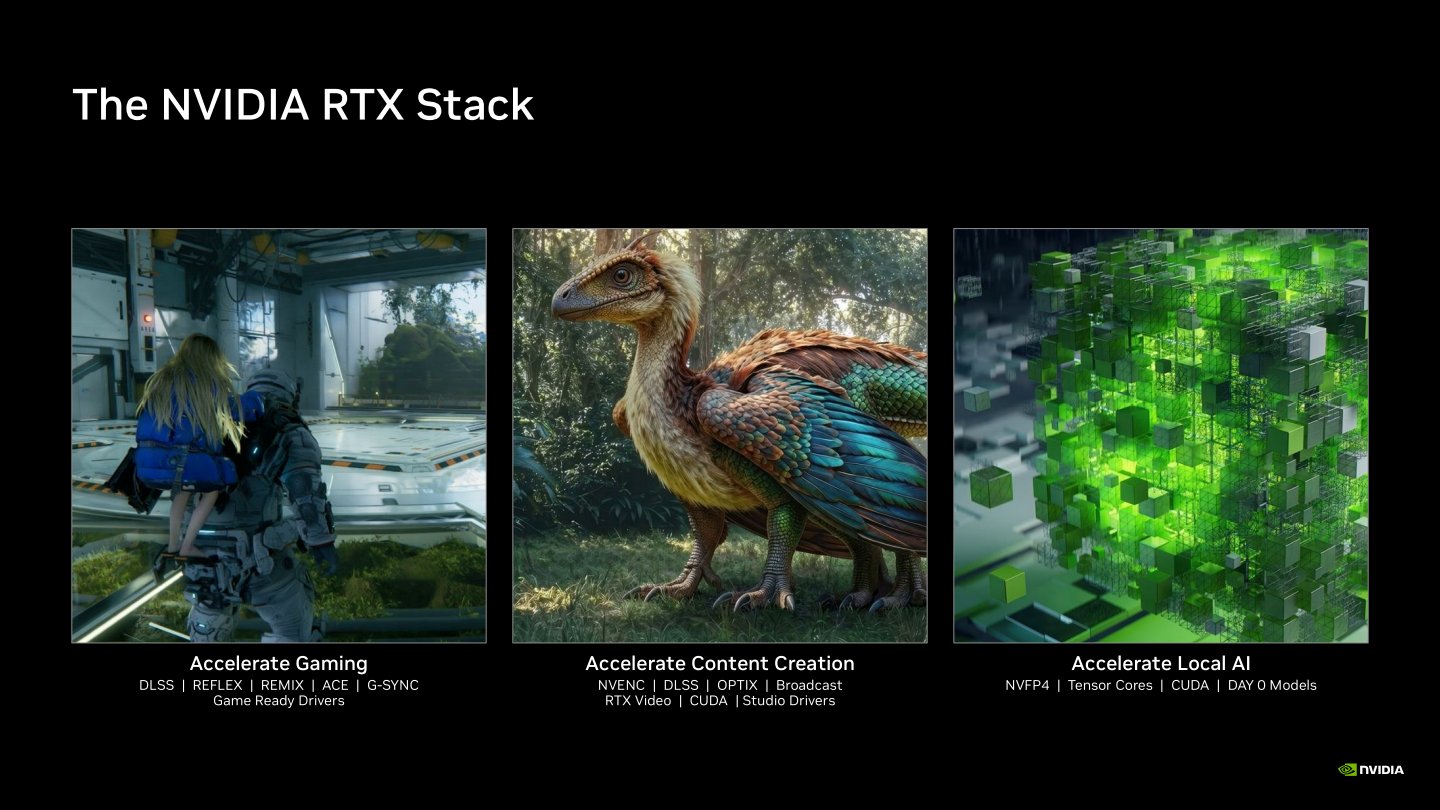
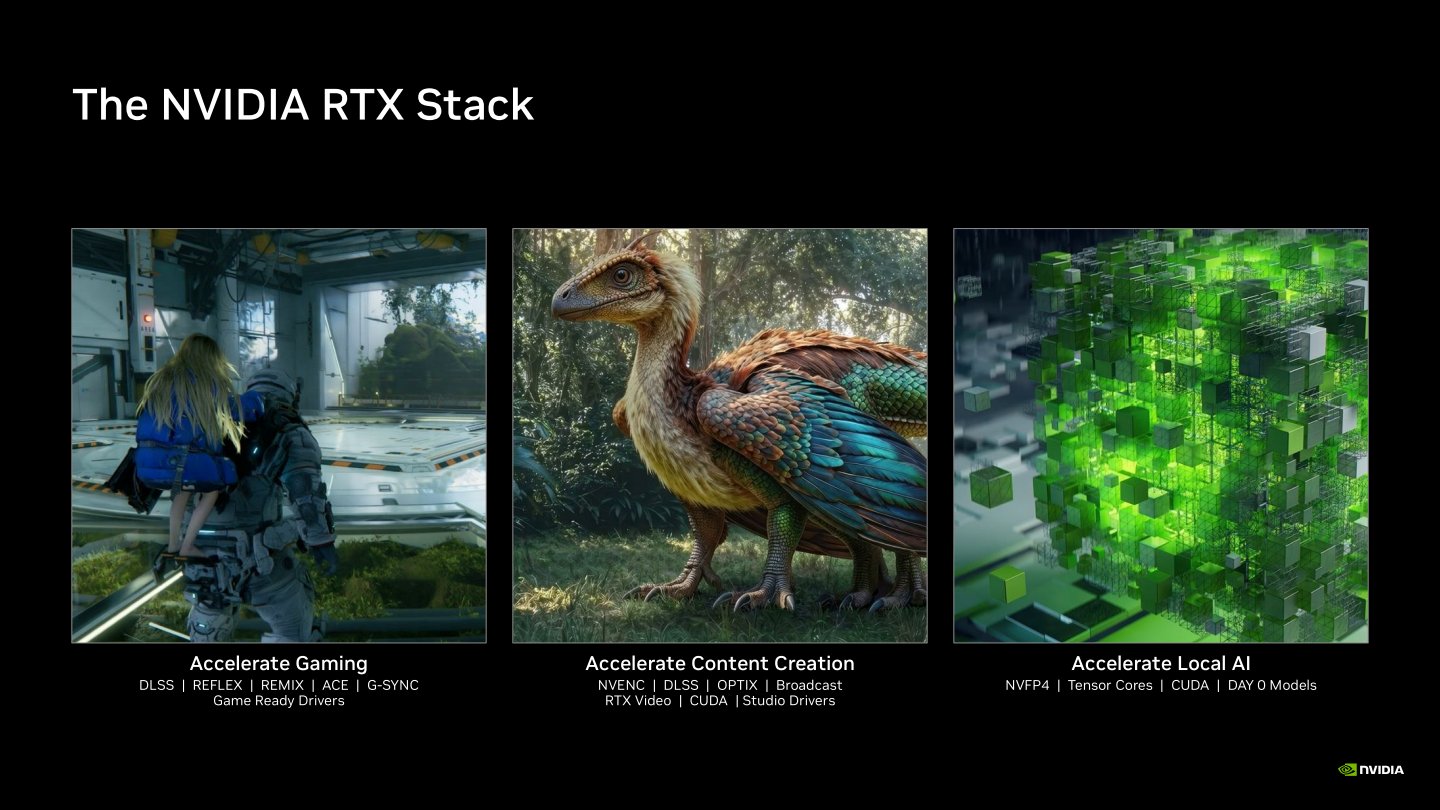
RTX Spark的GPU採用Blackwell架構,能夠支援包含各種GeForce與RTX技術在內NVIDIA軟體堆疊。

舉例來說RTX Spark支援DLSS升頻、Remix遊戲重製、ACE AI角色與助理、G-Sync可變更新頻率、Game Ready驅動程式等技術。此外也支援多媒體創作與AI的加速運算。

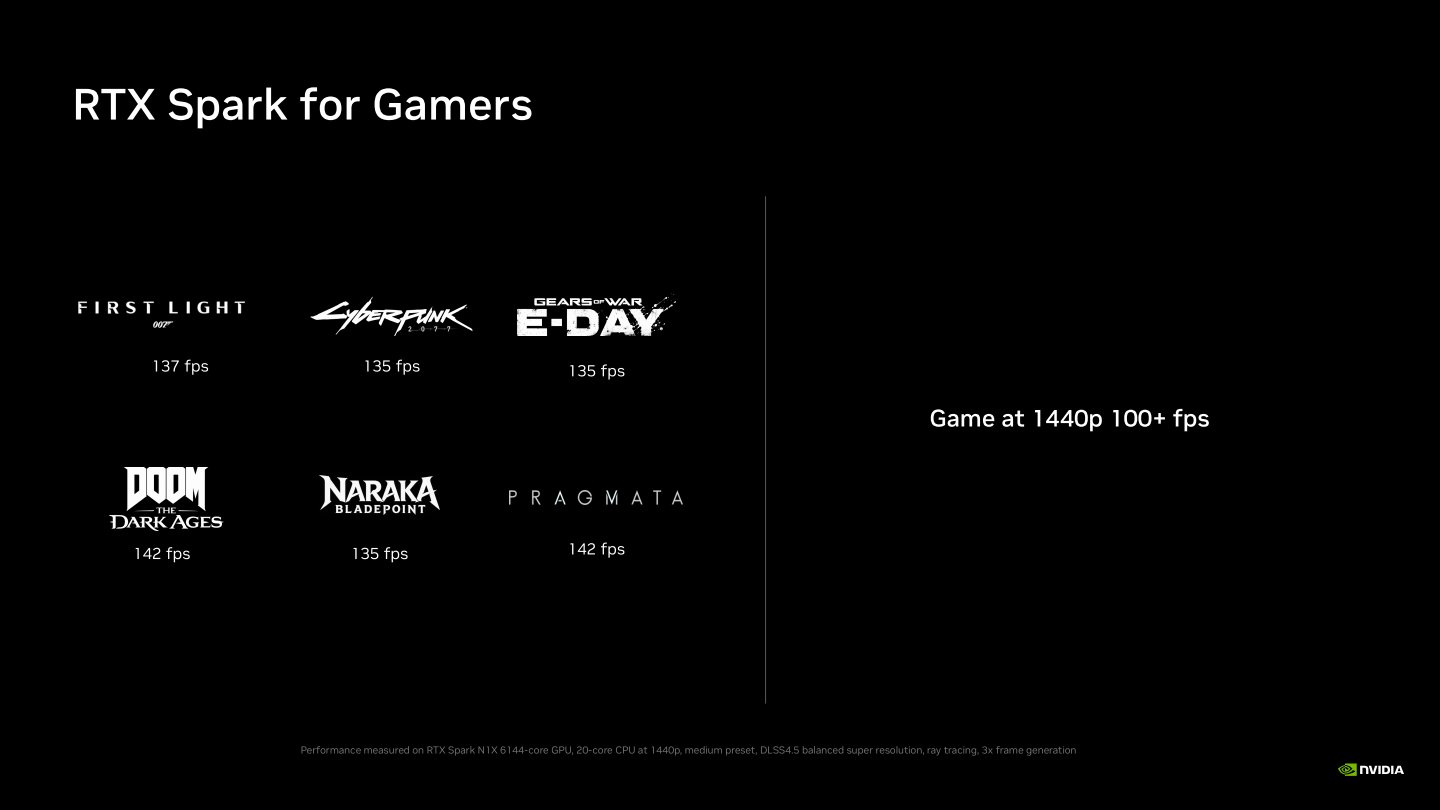
NVIDIA表示RTX Spark的效能可以滿足1440p解析度的遊戲需求。讀者也可以參考先前的效能實測專題,瞭解遊戲體驗。

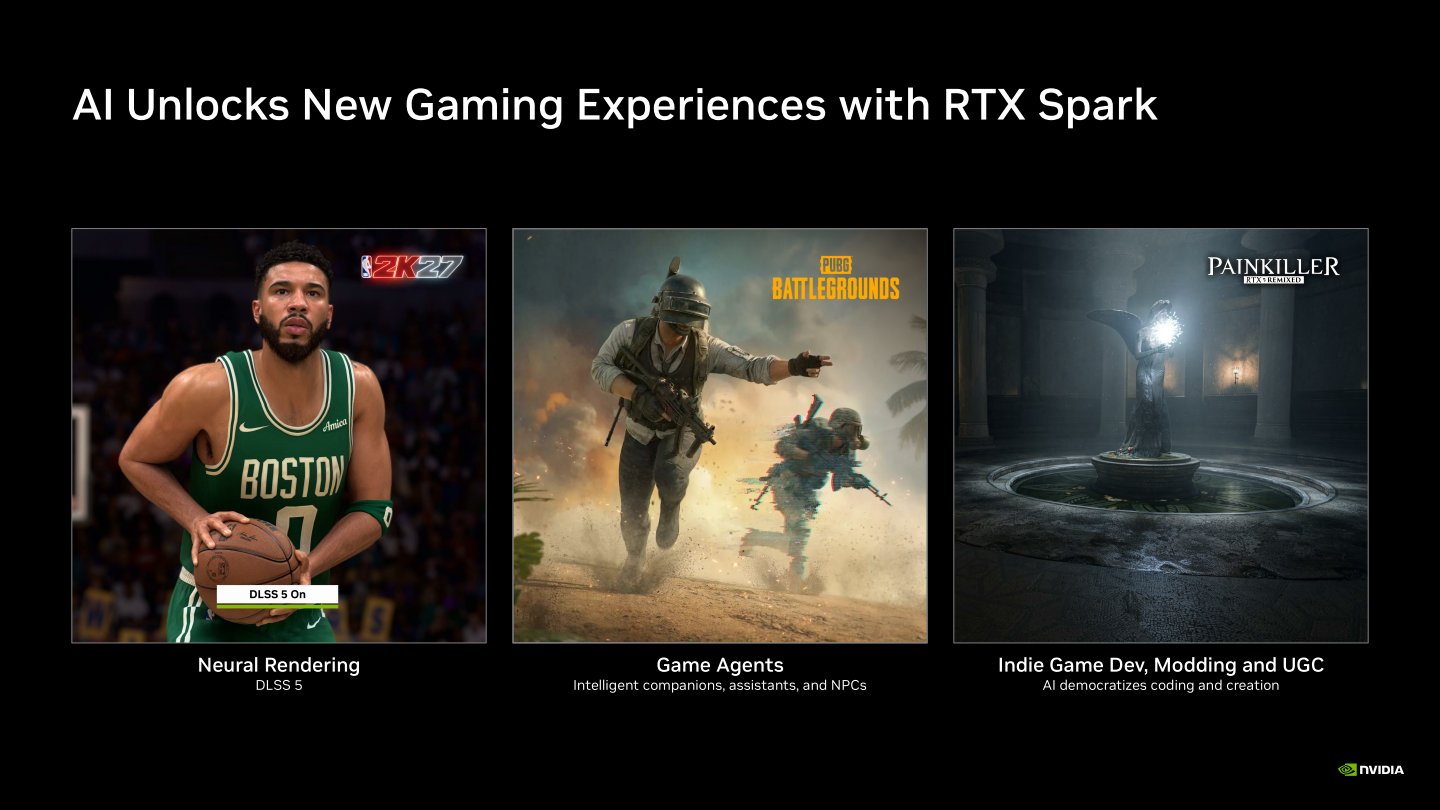
RTX Spark支援許多AI遊戲功能,例如以圖像生成為基礎的DLSS 5神經渲染,還有應用於《絕地求生》的AI隊友,以及應用於遊戲重製的RTX Remix。

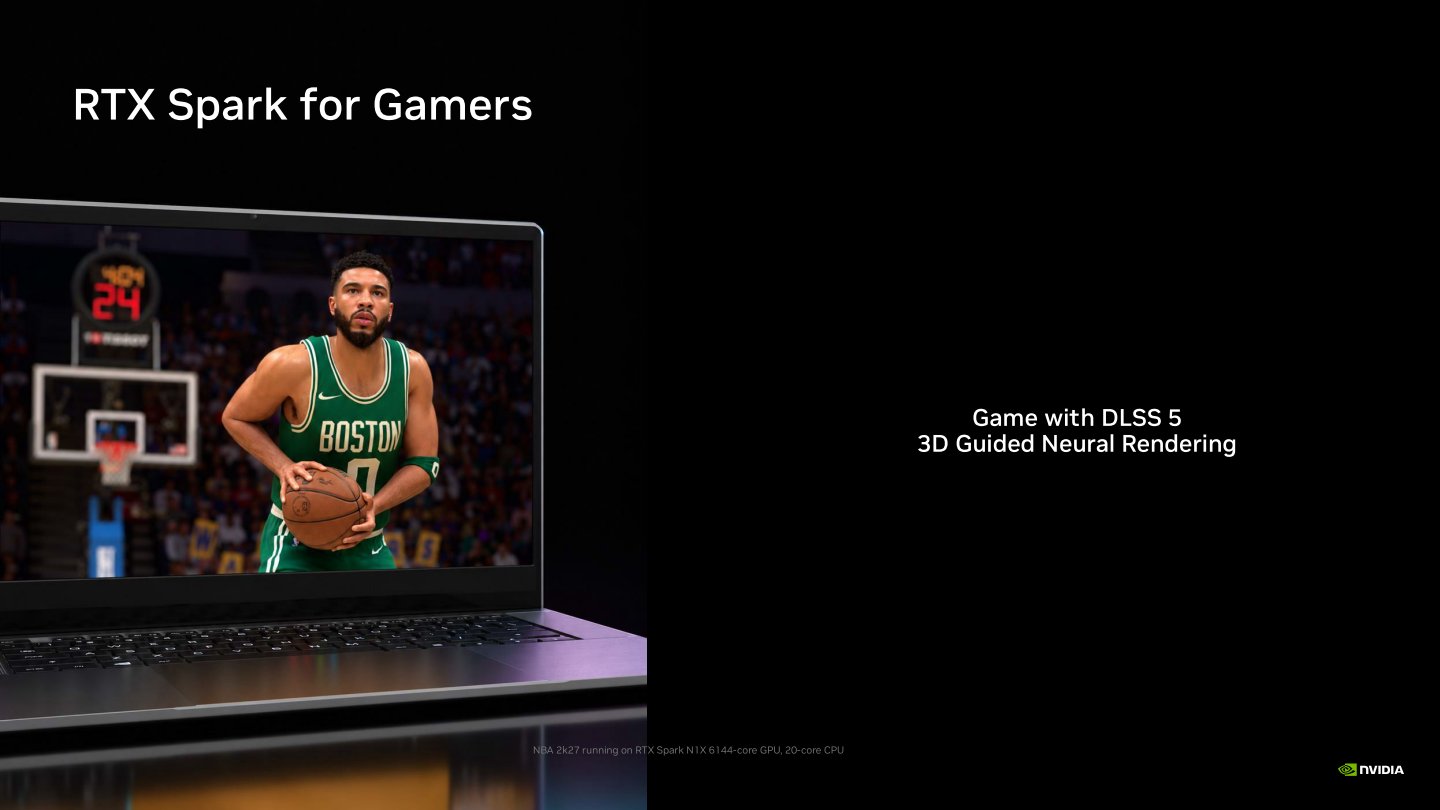
DLSS 5神經渲染透過AI圖像生成的方式強化3D繪製畫面的紋理與光照效果,能夠帶來更逼真的遊戲畫質,詳細介紹可以參考《DLSS 5神經渲染效能實測》一文。

NVIDIANVIDIA也與許多開發商合作,讓RTX Spark平台能夠相容多種不同的防作弊系統,例如使用Easy Anti-Cheat的《戰爭機器:事變日》也能夠正常運作。

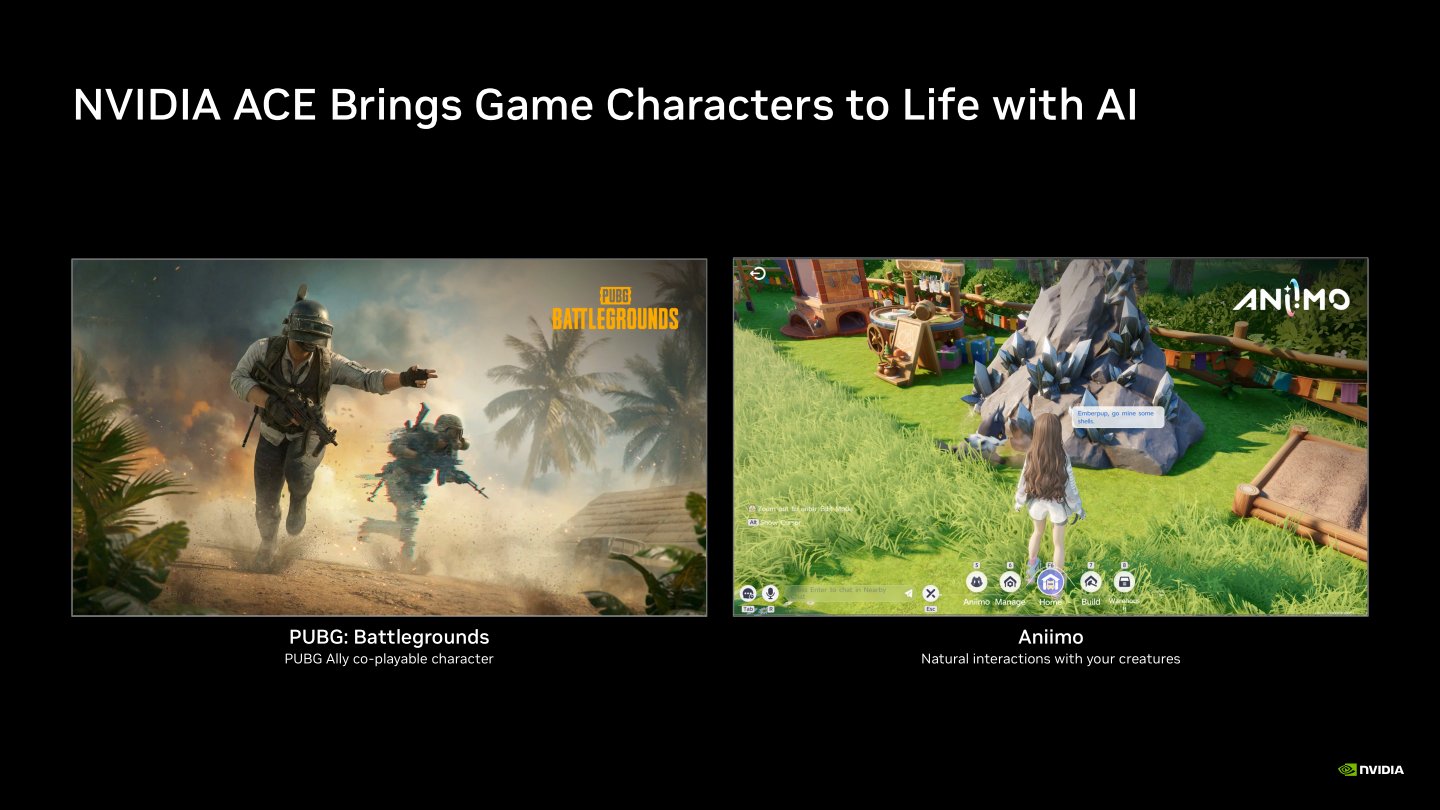
ACE AI助理功能可以在遊戲過程協助玩家查尋攻略、調整電腦設定,如《絕地求生》、《伊莫》等遊戲還將此功能整合至遊戲內,提供AI隊友與AI寵互等更深入的互動體驗。

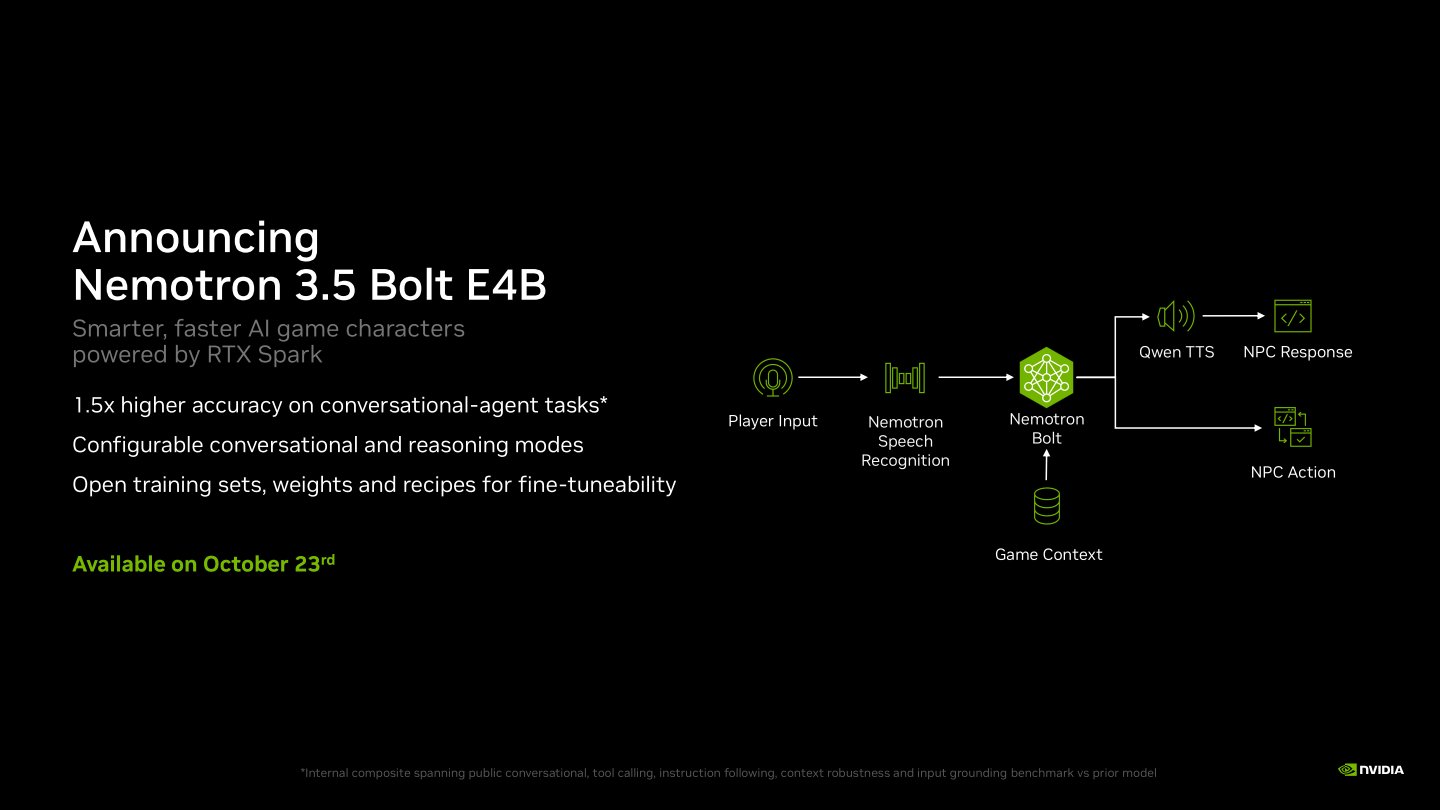
NVIDIA也發表更輕盈的Nemotron 3.5 Bolt E4B大型語言模型(Large Language Model,LLM),提供更精確的語音對話式代理AI功能。

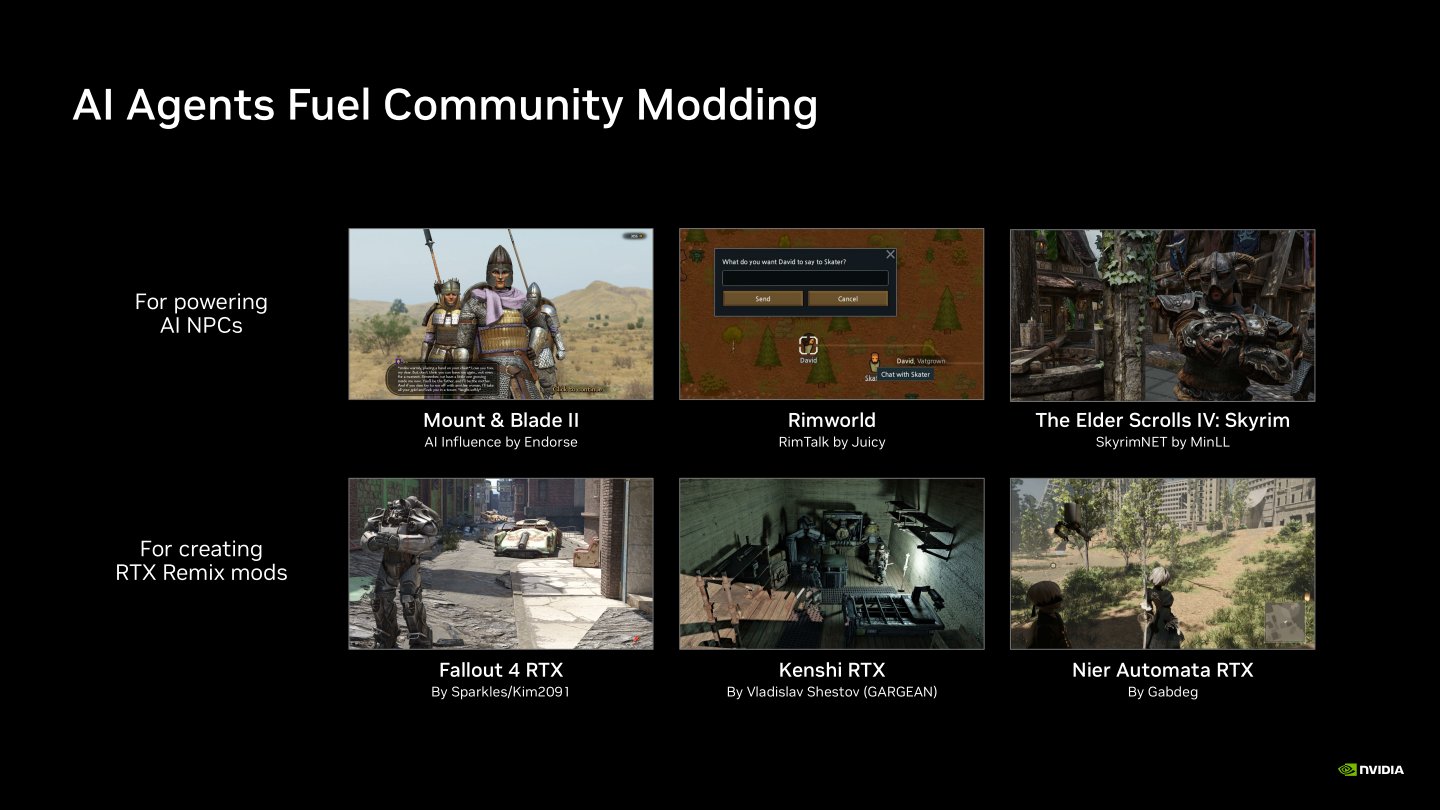
RTX Spark不但支援使用Remix技術進行重製的遊戲,本身的AI功能也可以協助遊戲改造開發社群開發重製版遊戲與修改模組。

效能最佳化、改善DLSS升頻模型效率

為了提升RTX Spark平台的執行效率,Microsoft也改善了Windows作業系統對統一架構記憶體的支援,提高GPU可存取的記憶體容量上限,有助於執行參數量更大的AI模型,以及進行規模更大的3D開發或創作專案。Microsoft同時也改善Windows管理共享記憶體區域中分頁檔容量(Page Size)的方式,支援更大的記憶體分頁以滿足高負載運算的需求,同時讓開發人員能夠靈活對CPU和GPU的記憶體存取進行最佳化。

另一方面,Microsoft也針對RTX Spark進行負載設定檔排程(Workload Profile Scheduling,WPS)進行最佳化,強化Windows執行程式時調度處理器核心的效率。RTX Spark也支援Microsoft電源與散熱框架(Microsoft Power and Thermal Framework,MPTF),能夠協助系統根據工作負載的變化調整效能、功耗和散熱(如風扇轉速)等配置,以帶來更加平衡的效能與續航力體驗。

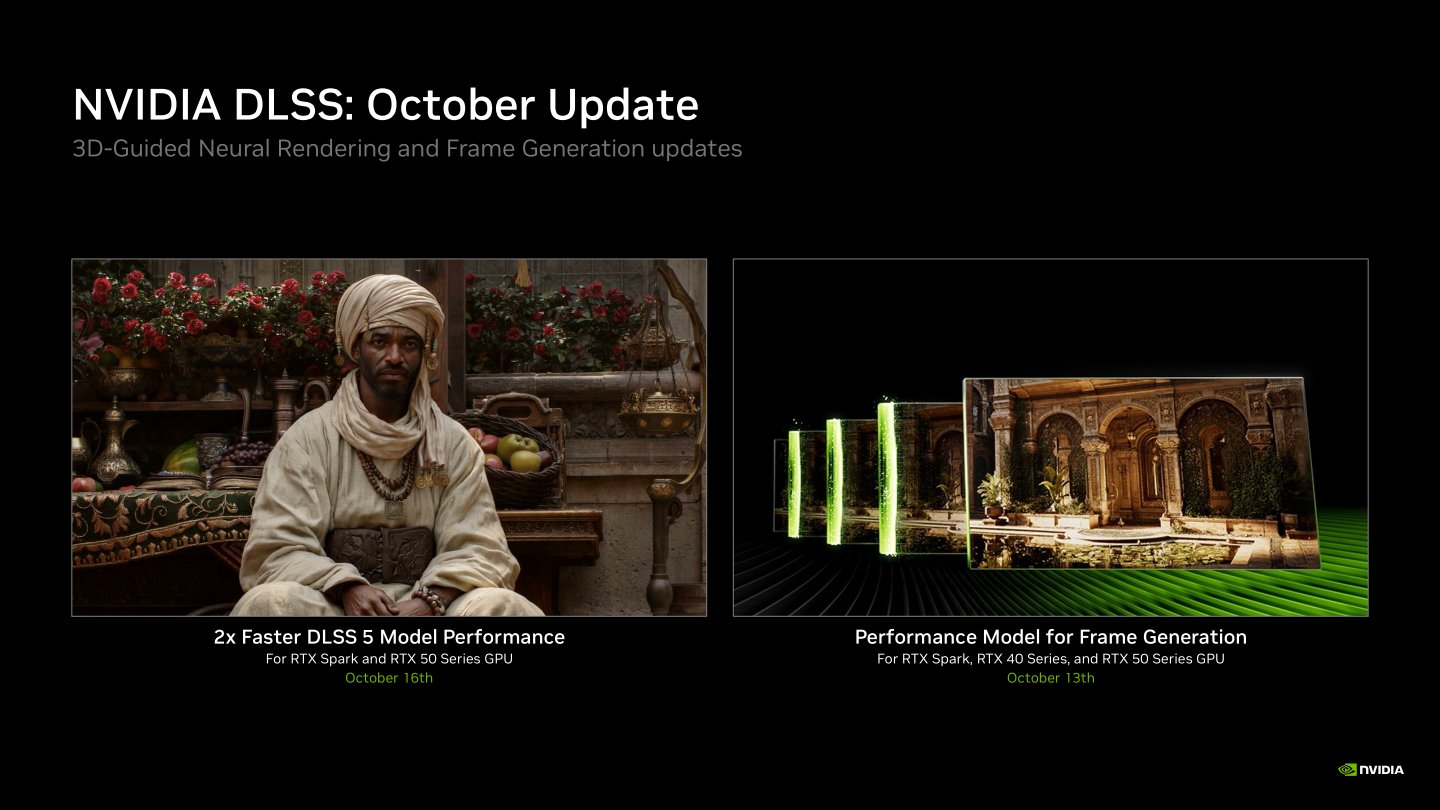
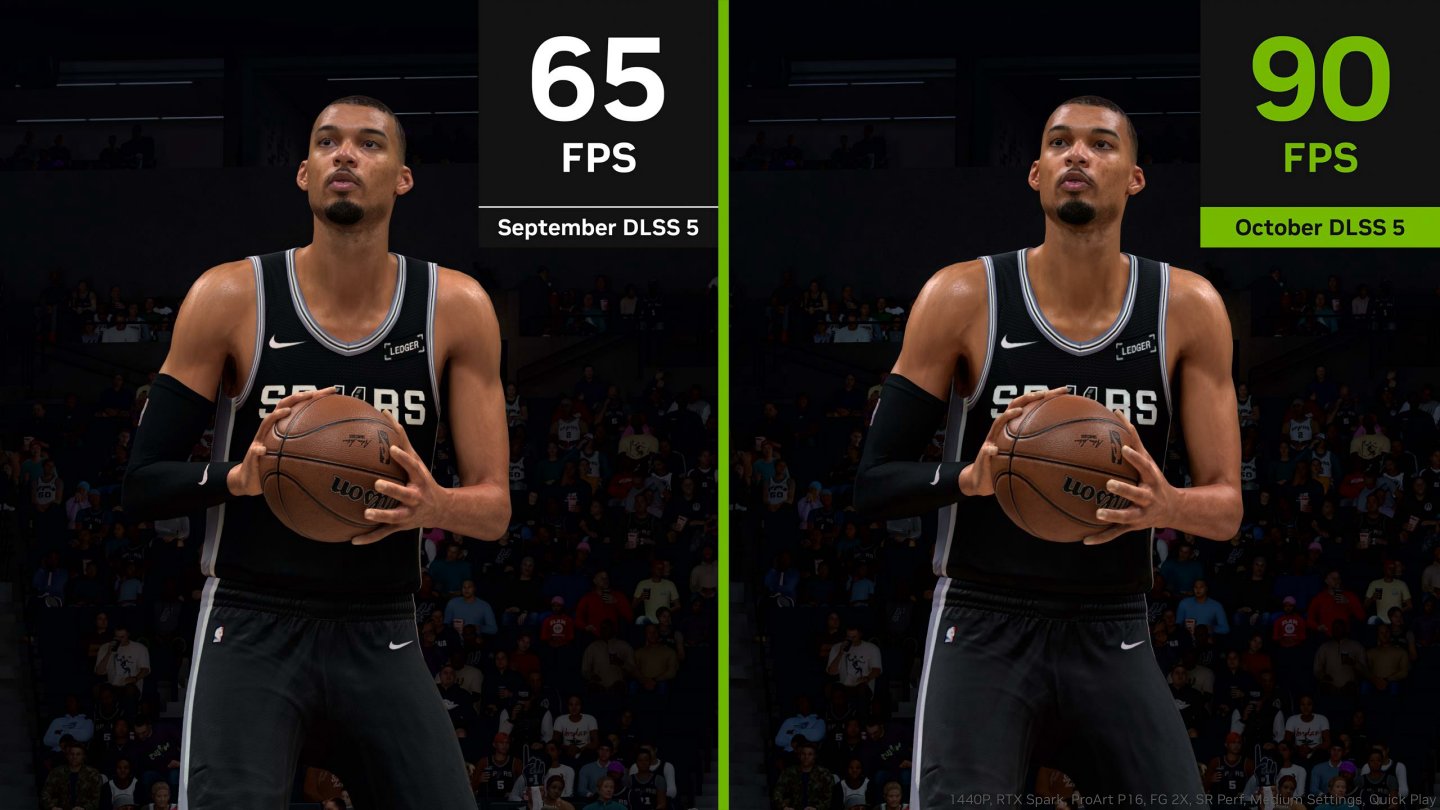
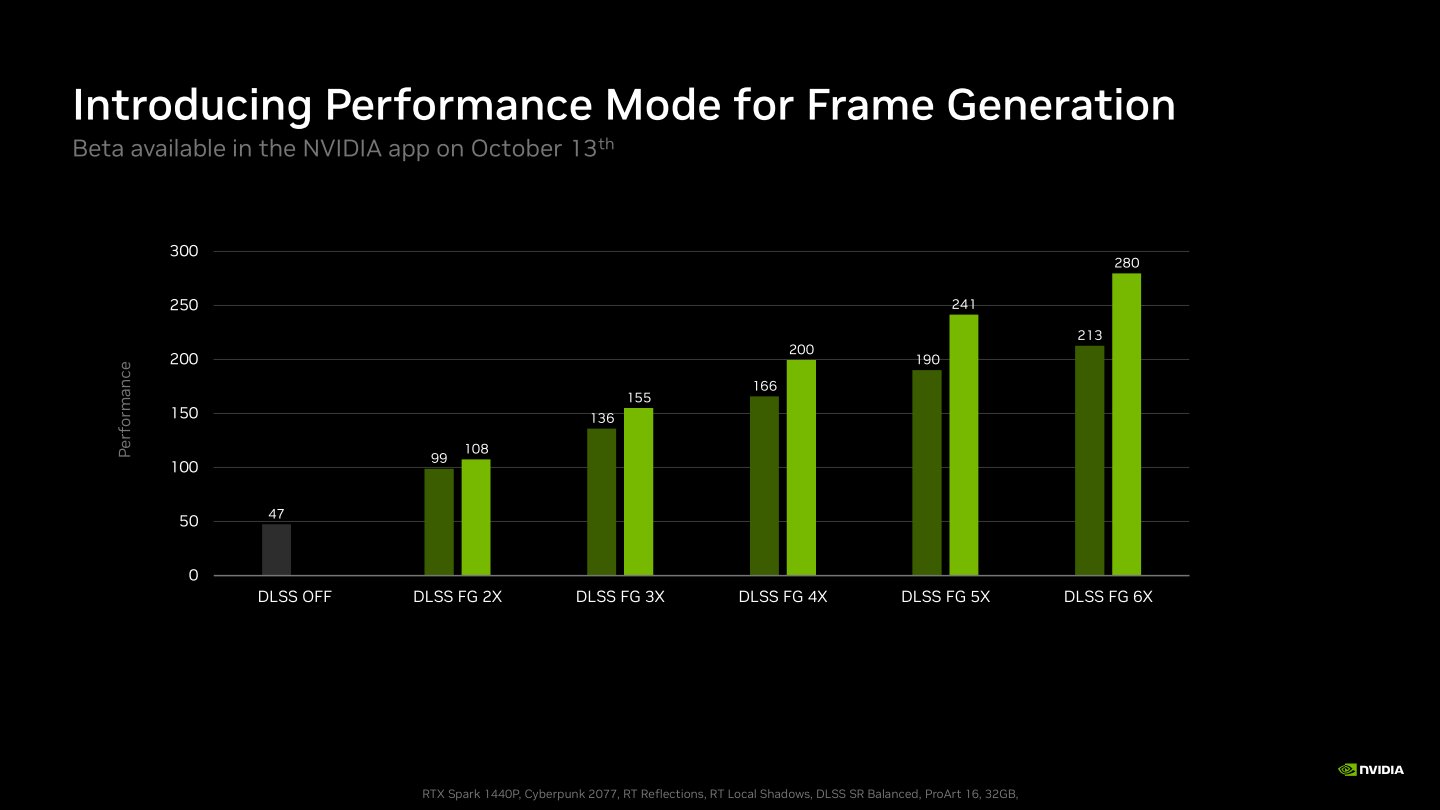
NVIDIA方面則是推出運算效率更高的DLSS 5神經渲染以及畫格生成的新版模型,前者可以將神經渲染的運算效能提升至2倍,支援GeForce RTX 50系列顯示卡與RTX Spark,後者則能改善畫格生成的效率,支援GeForce RTX 40 / 50系列顯示卡與RTX Spark。根據NVIDIA提供的數據,使用新版模型最高分別能夠提升38.46%、31.46%遊戲FPS,帶來更流暢的遊戲視覺體驗。

NVIDIA也在10月推出運算效率更高的DLSS 5神經渲染以及畫格生成的新版模型。

新版DLSS 5神經渲染模型能夠將遊戲FPS效能由65幀提升至90幀,增幅達38.46%。

新版畫格生成模型在使用6X倍率情況下,能將FPS效能由213幀提升至280幀,增幅達31.46%。

筆者已在先前的效能實測專題報導中測試RTX Spark執行多款遊戲的效能,接下來也預計針對最新推出的《戰爭機器:事變日》進行測試,並驗證為內建顯示晶片分配不同容量記憶體對效能的影響。更多相關報導請參考下方目錄連結。

(回到系列文章目錄)

加入T客邦Facebook粉絲團

NVIDIA RTX Spark架構與平台分析:當Windows on Arm遇到最強GPU,遊戲、AI、創作全面暴走!

2026年10月16日 23:28
NVIDIA於RTX Spark Editor’s Day活動中詳細介紹RTX Spark平台的架構、平台、AI功能等特色,讓我們一起來看看這台搭載GB10 SoC的奇行種有什麼過人之處。5c08b2f844e4f9dcde6fd576f7b10a53

NVIDIA於RTX Spark Editor’s Day活動中詳細介紹RTX Spark平台的架構、平台、AI功能等特色,讓我們一起來看看這台搭載GB10 SoC的奇行種有什麼過人之處。

迷你AI超級電腦轉生Windows筆電

NVIDIA於2025年初的CES消費性電子展發表搭載GB10 SoC的DGX Spark迷你AI超級電腦,並於同年10月15日正式上市。到了2026年6月的Computex台北國際電腦展,則是將這顆SoC應用於Windows on Arm平台https://www.techbang.com/posts/129852-nvidia-rtx-spark,與合作夥伴同推出多款RTX Spark迷你電腦與筆記型電腦,並給予N1X的新名稱。簡單來說GB10、DGX Spark、RTX Spark、N1X都是指同款晶片,只是應用於不同產品的產品名稱差異。

延伸閱讀:
RTX Spark筆記型電腦效能實測
RTX Spark Editor’s Day系列文章目錄
【GIGABYTE AI TOP ATOM動手玩(1)】:NVIDIA DGX Spark迷你AI工作站規格分析 
Snapdragon X2系列平台功能解析:為Windows平台打造並整合豐富平台功能,讓筆電也能有智慧手機的流暢體驗

RTX Spark平台與Qualcomm的Snapdragon X2系列平台類似,彼此都是採用Arm架構處理器(CPU),搭配Windows on Arm平台執行Windows作業系統,可以原生支援Arm架構應用程式,並透過Microsoft提供的Prism模擬器支援32bit與64bit的x86架構應用程式,但運作時會因模擬而造成效能耗損。

Snapdragon X2系列平台的設計概念比較像是從智慧型手機的角度出發,將手機的使用者體驗帶到Windows生態系統,提供超長續航力、常時連網,並透過整合式繪圖處理器(GPU)、神經處理器(NPU)提供豐富的AI應用程式等等功能。

而RTX Spark平台則比較像從電腦的角度出發,同樣借助Arm架構處理器省電的優勢,不同之處在於搭配規模更大的GPU,不但能夠帶來充沛的AI運算效能,並足以執行高參數量大語言模型(Large Language Model,LLM),以及圖像、影片生成與代理式AI等重度AI功能,並在遊戲、多媒體創作、3D開發、CAD等應用方面也有出色的效能表現,更像是將傳統Windows生態系中的電競或創作者筆電換上更省電的處理器,同時大幅強化AI效能與功能。

筆者將在本文解析GB10的硬體架構,並在後續文章中介紹RTX Spark平台的遊戲、創作、AI等功能,讀者可以參考RTX Spark Editor’s Day系列文章目錄閱讀其他章節。

NVIDIA於2025年初的CES消費性電子展發表搭載GB10 SoC的DGX Spark迷你AI超級電腦,採用的作業系統為以Linux為基礎的Ubuntu發行版本。

GB10 SoC整合具有10組Arm Cortex-X925核心、10組Arm Cortex-A725核心的處理器,以及6,144組CUDA核心之Blackwell架構內建顯示晶片。

筆者先前也針對GIGABYTE推出的DGX Spark產品AI TOP ATOM進行詳細測試與介紹,並在上面透過模擬器執行Windows 98作業系統。

NVIDIA於2026年10月16日正式推出同樣採用GB10 SoC,並支援Windows 11作業系統的RTX Spark平台筆記型電腦與迷你電腦。

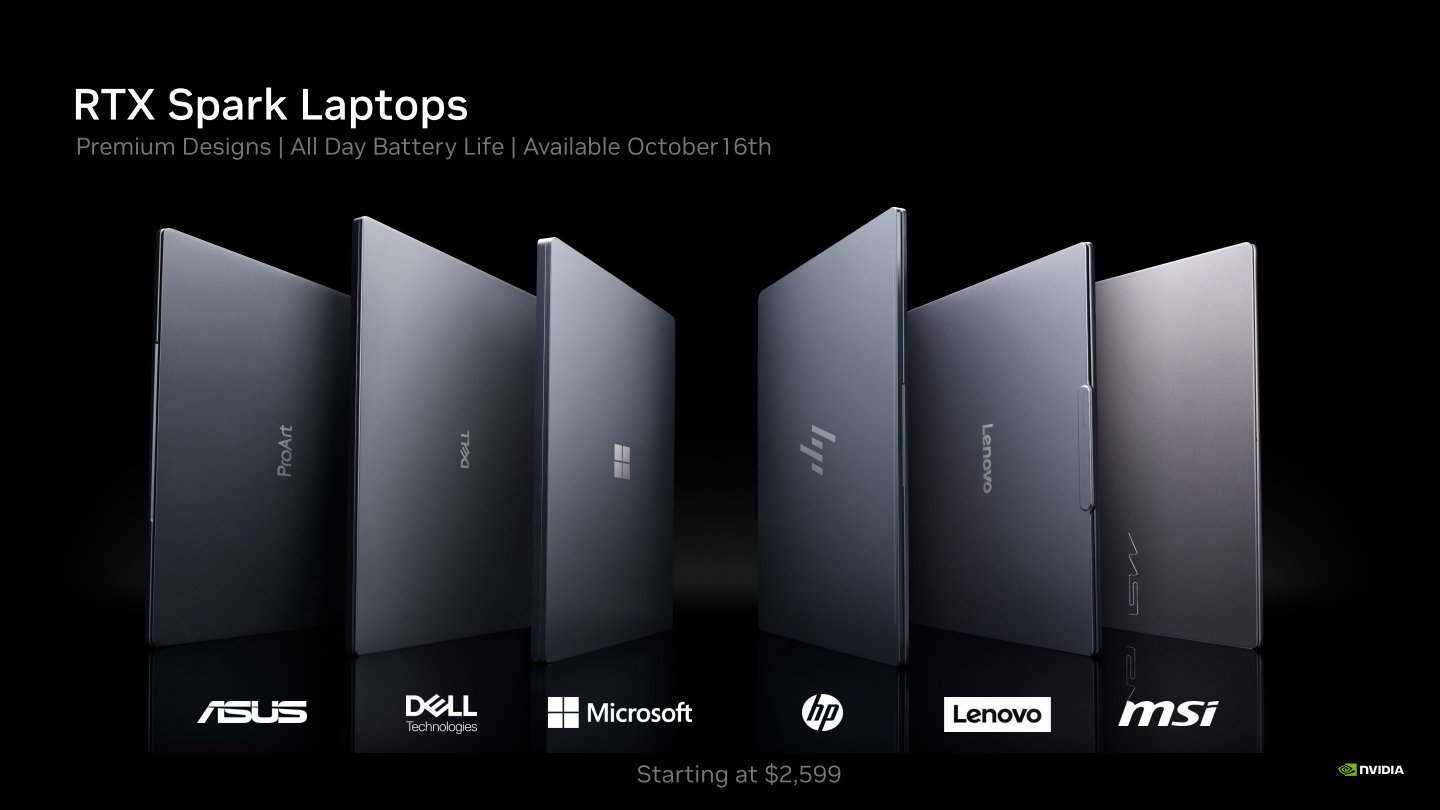
NVIDIA會與Asus、Dell、HP、Lenovo、Microsoft、Msi等合作夥伴共同推出RTX Spark平台筆記型電腦。

NVIDIA也會與Acer、Asus、Dell、GIGABYTE、HP、Lenovo、Microsoft、Msi等合作夥伴共同推出RTX Spark迷你電腦。

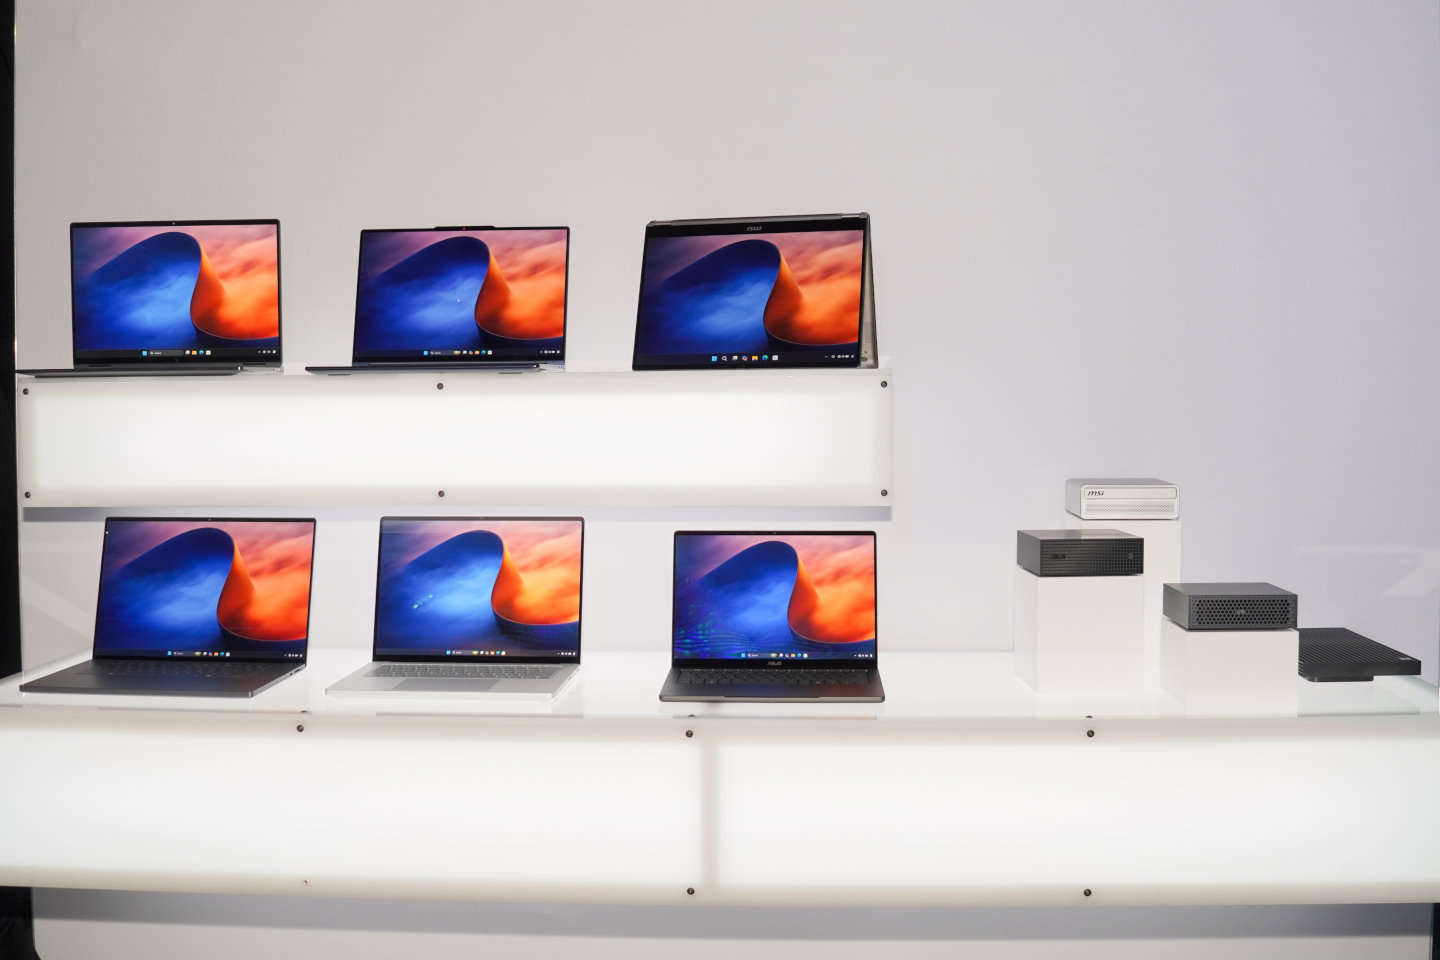
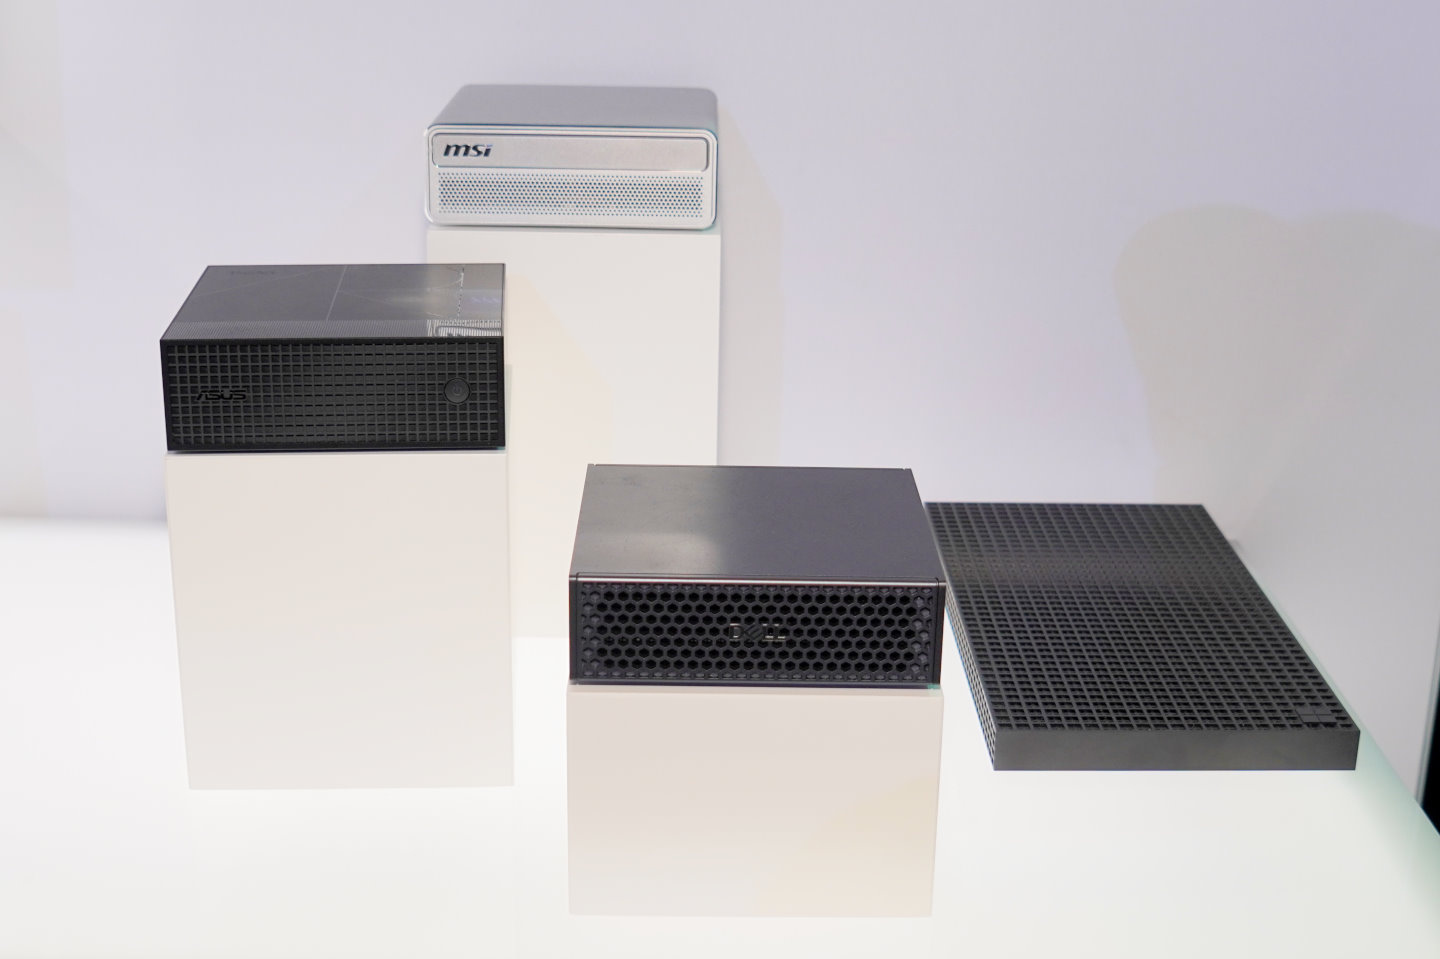
NVIDIA於RTX Spark Editor’s Day活動會場展示多款RTX Spark產品。

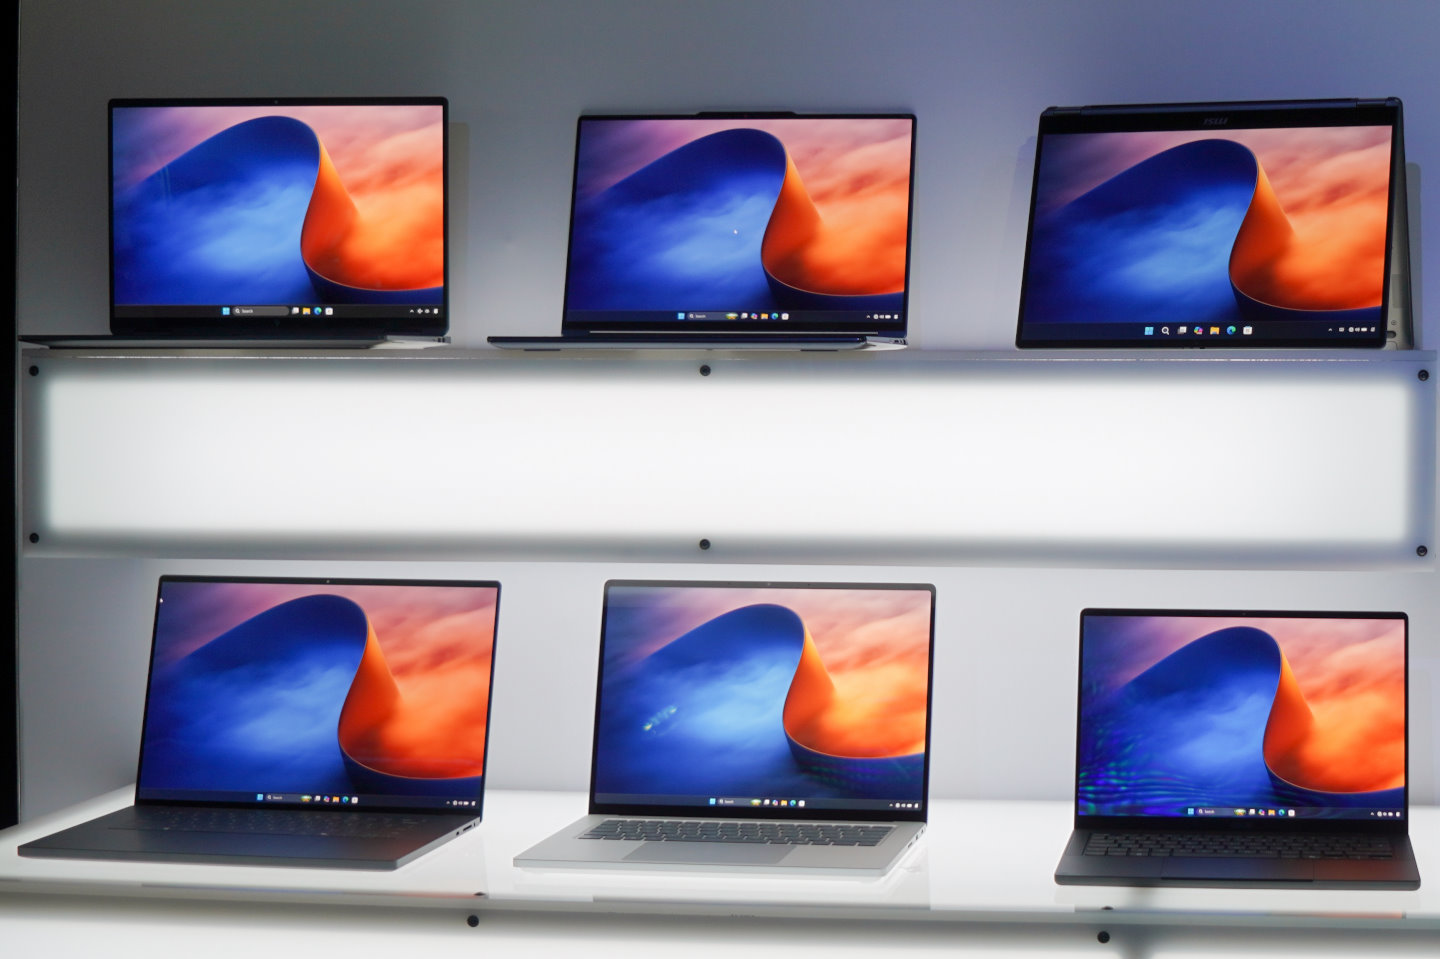
活動現場展開Asus、Dell、HP、Lenovo、Microsoft、Msi等合作夥伴推出的RTX Spark平台筆記型電腦。

此外也展示了Asus、Dell、Msi推出的迷你電腦,以及Microsoft推出的Surface RTX Spark Dev Box。

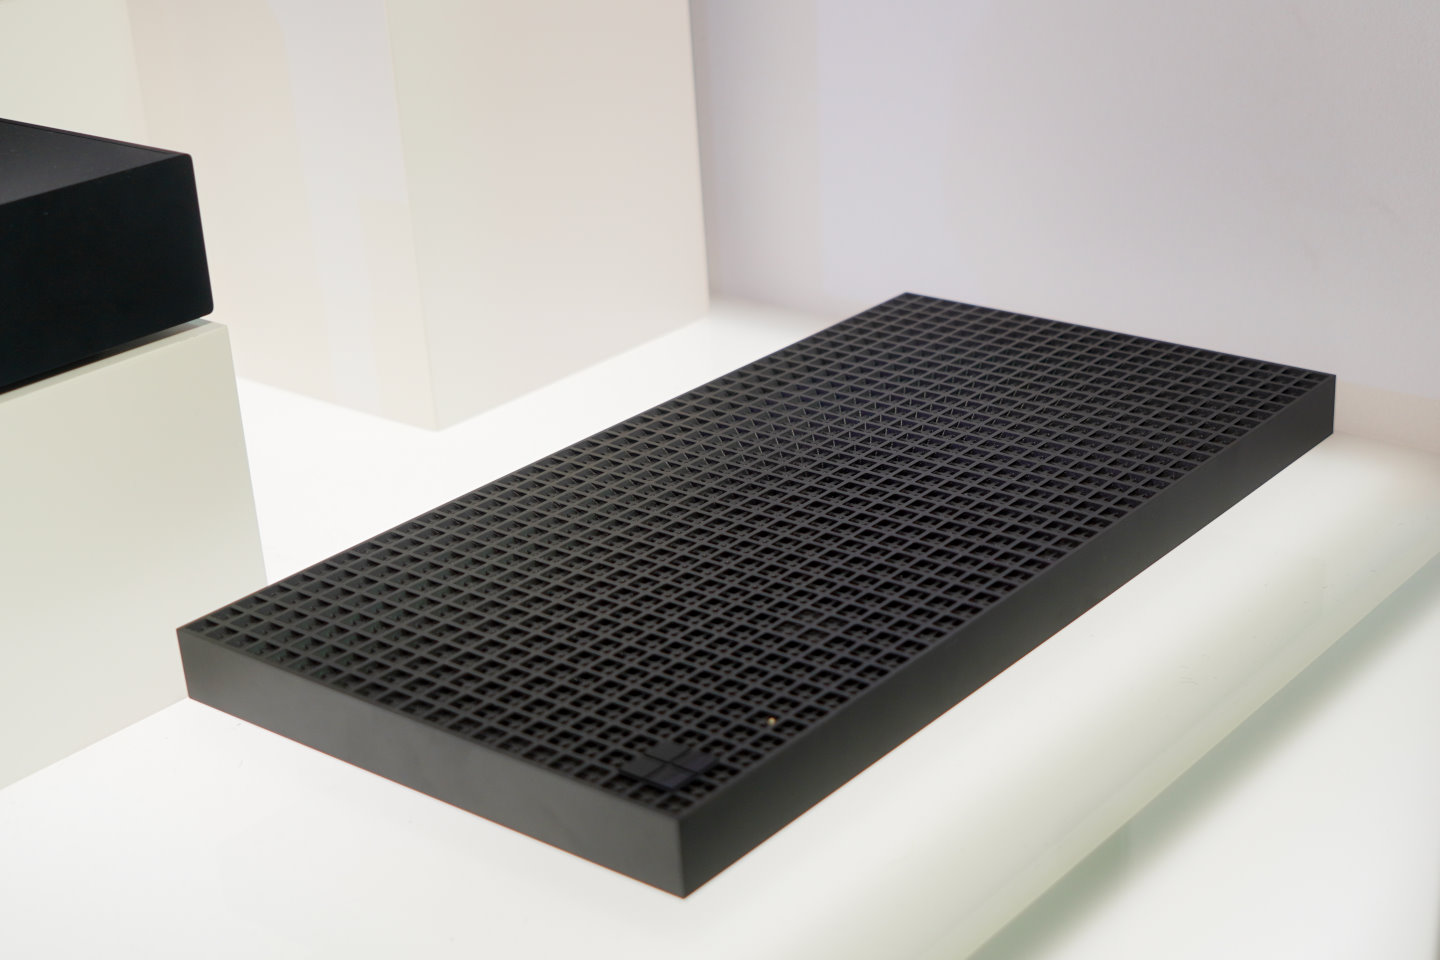
Surface RTX Spark Dev Box的造型相當特別,從上面看過去點像一大片巧克力。

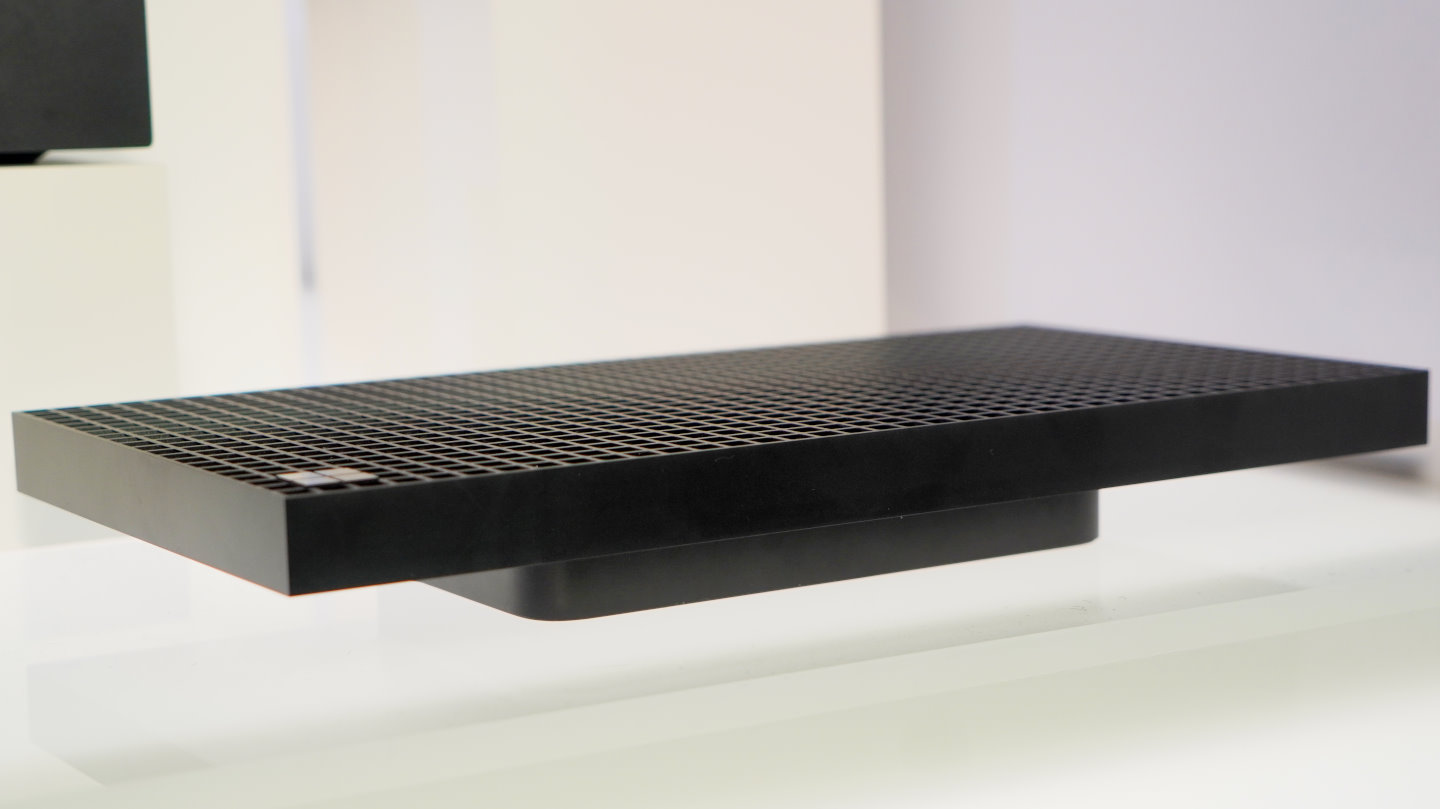
從側面看過去,Surface RTX Spark Dev Box的主體應該為於機身下半部,上半部應為大型散熱片。

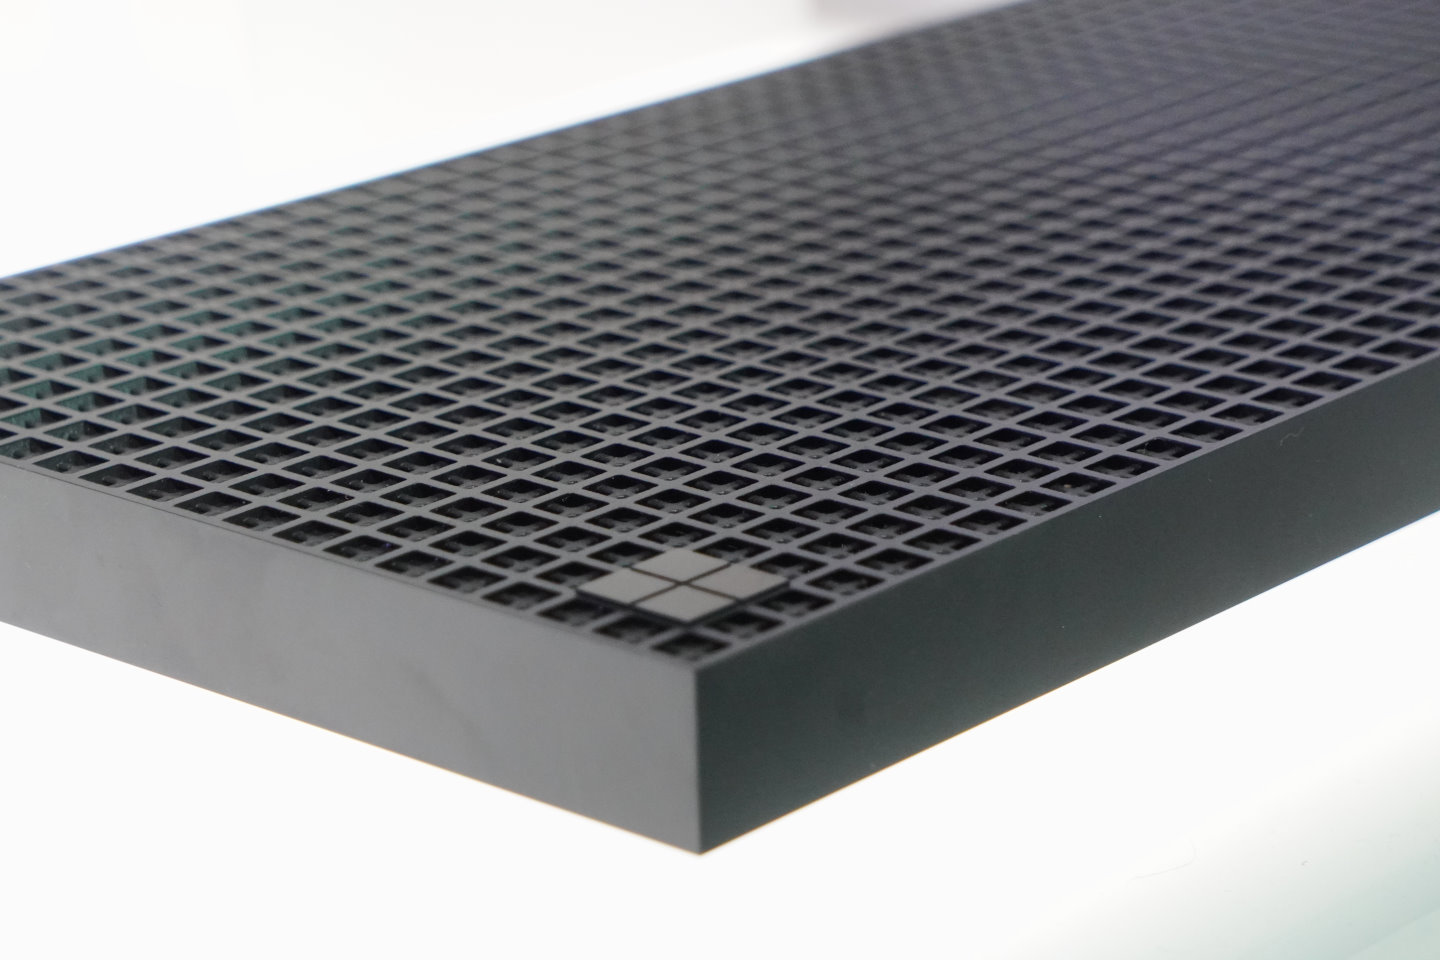
Surface RTX Spark Dev Box的機身採用陽極氧化鋁材質,機身上具有高達1,000個排氣散熱孔。

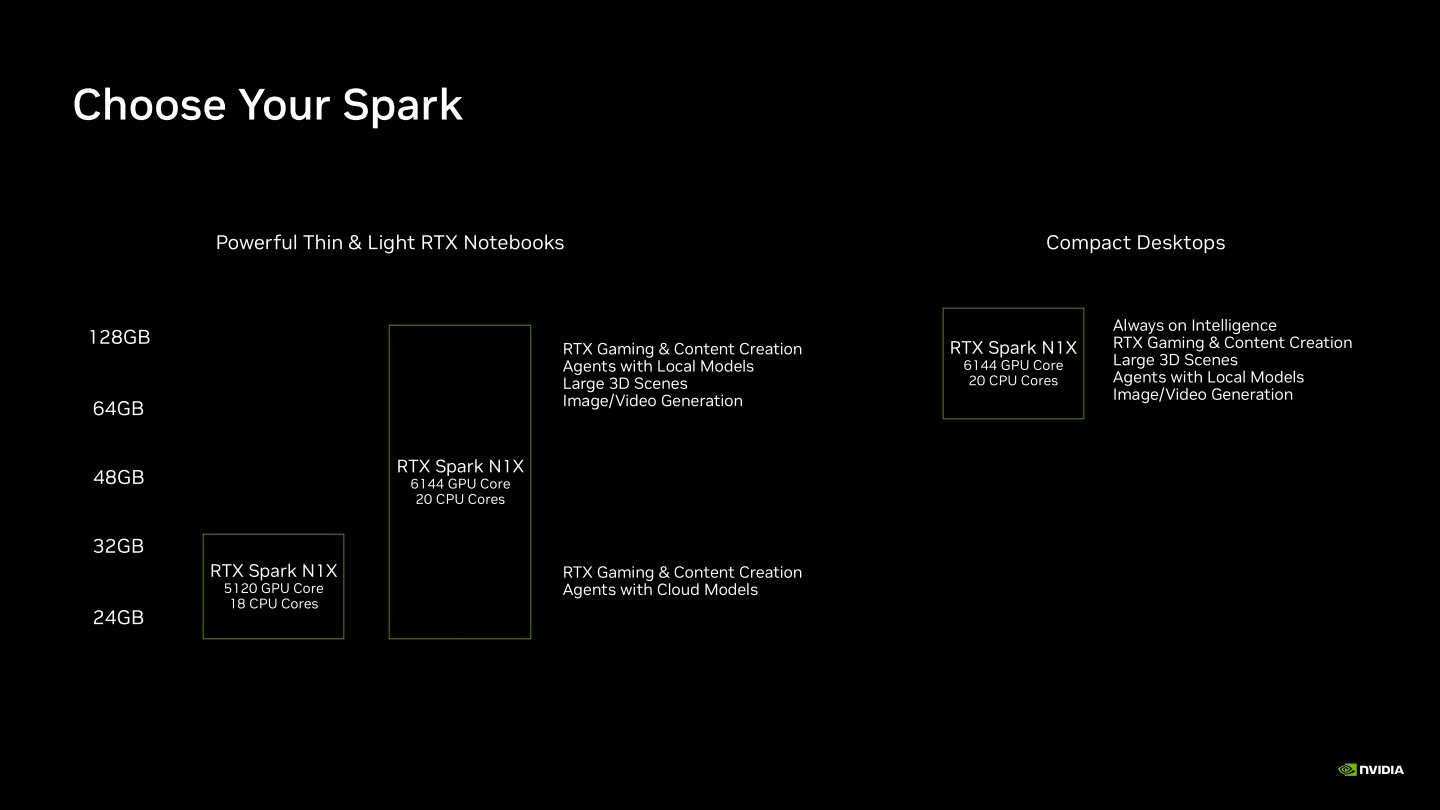
滿血版GB10將會應用於記憶體容量為24 GB ~ 128 GB之間的RTX Spark筆記型電腦,與64 GB ~ 128 GB之間的RTX Spark迷你電腦。具有18組CPU核心與5120組CUDA核心內建顯示晶片的版本則應用於記憶體容量為24 GB ~ 32 GB之間的RTX Spark筆記型電腦。

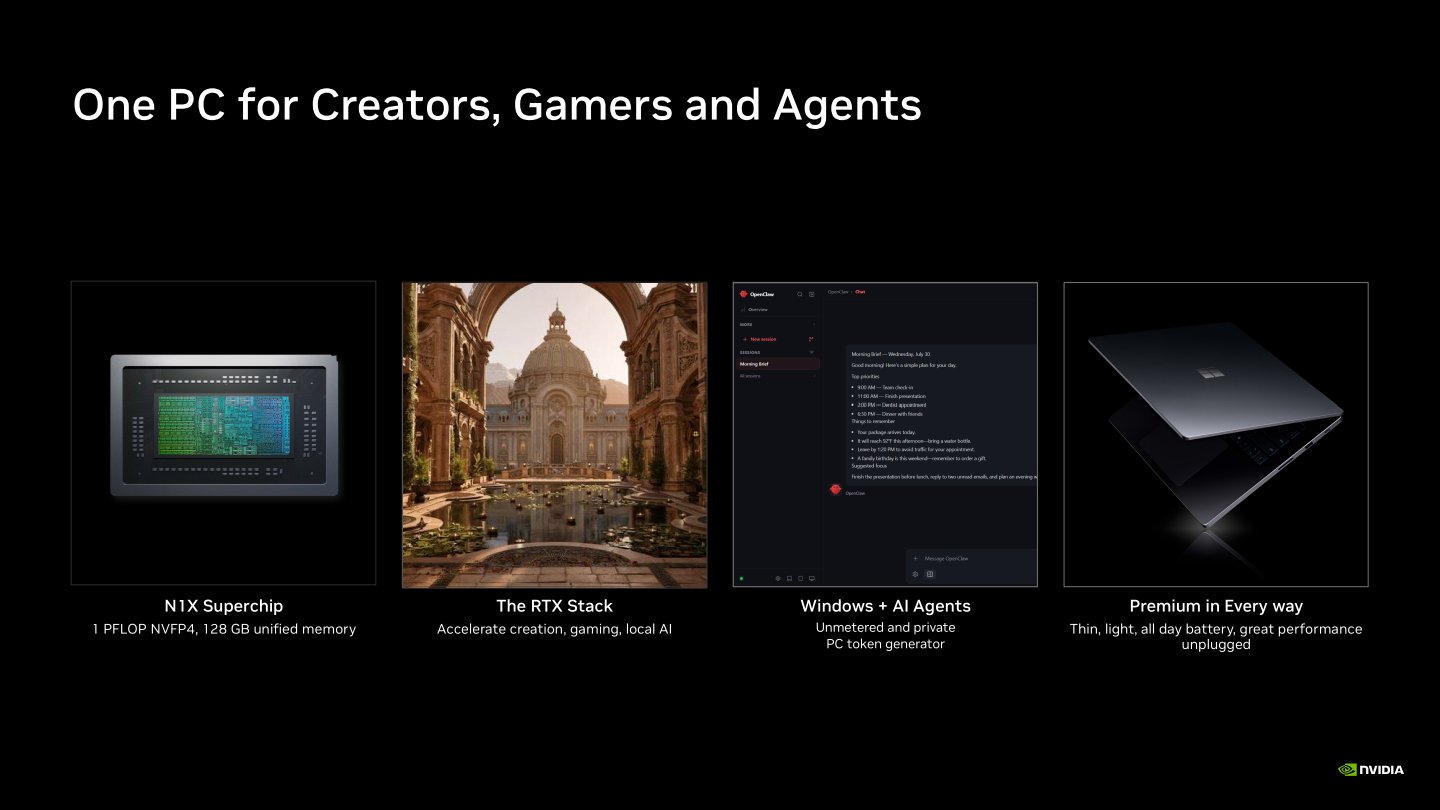
NVIDIA表示RTX Spark能夠滿足創作者、遊戲、代理式AI等多元使用需求。

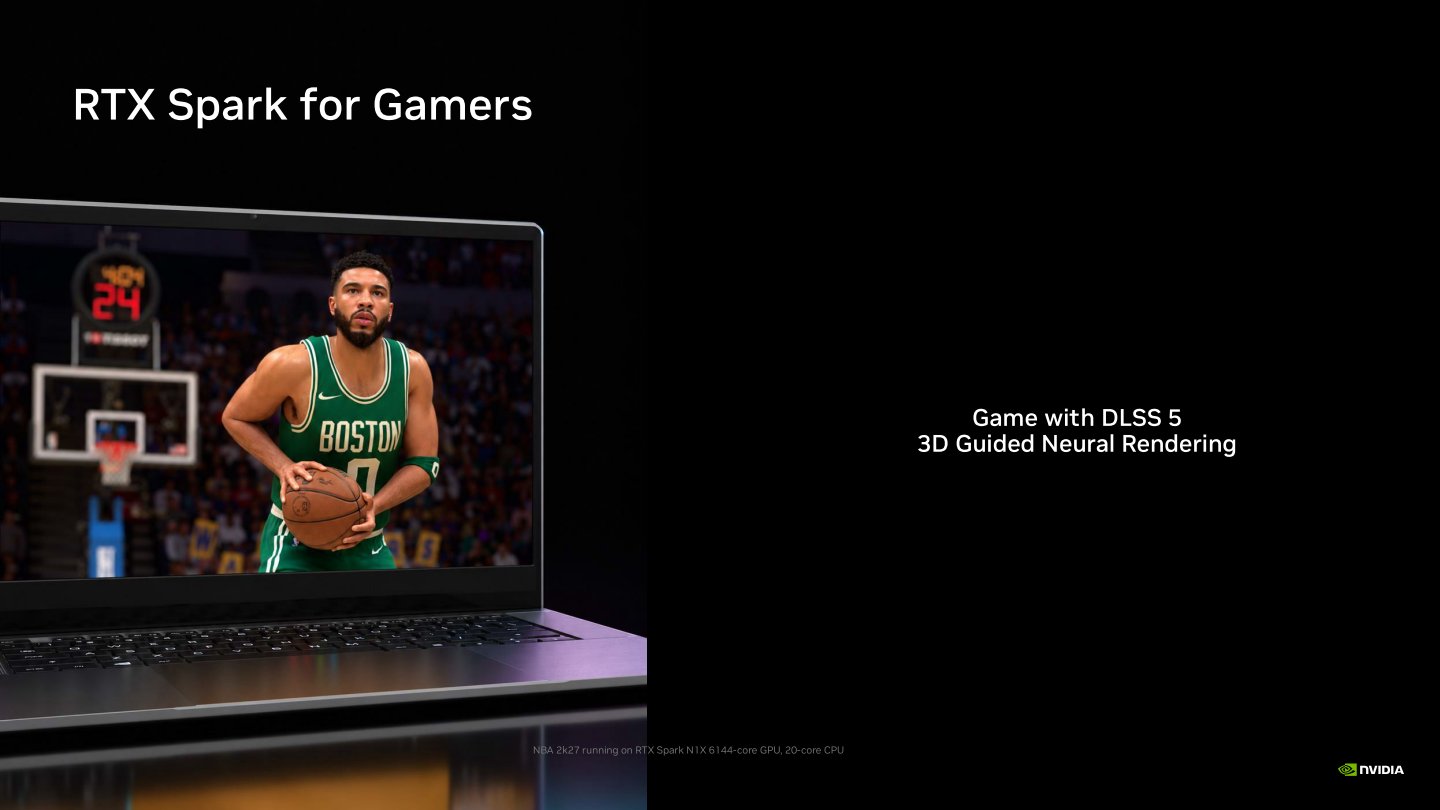
RTX Spark支援所有GeForce RTX遊戲功能,也包含最新的DLSS 5神經渲染等功能。

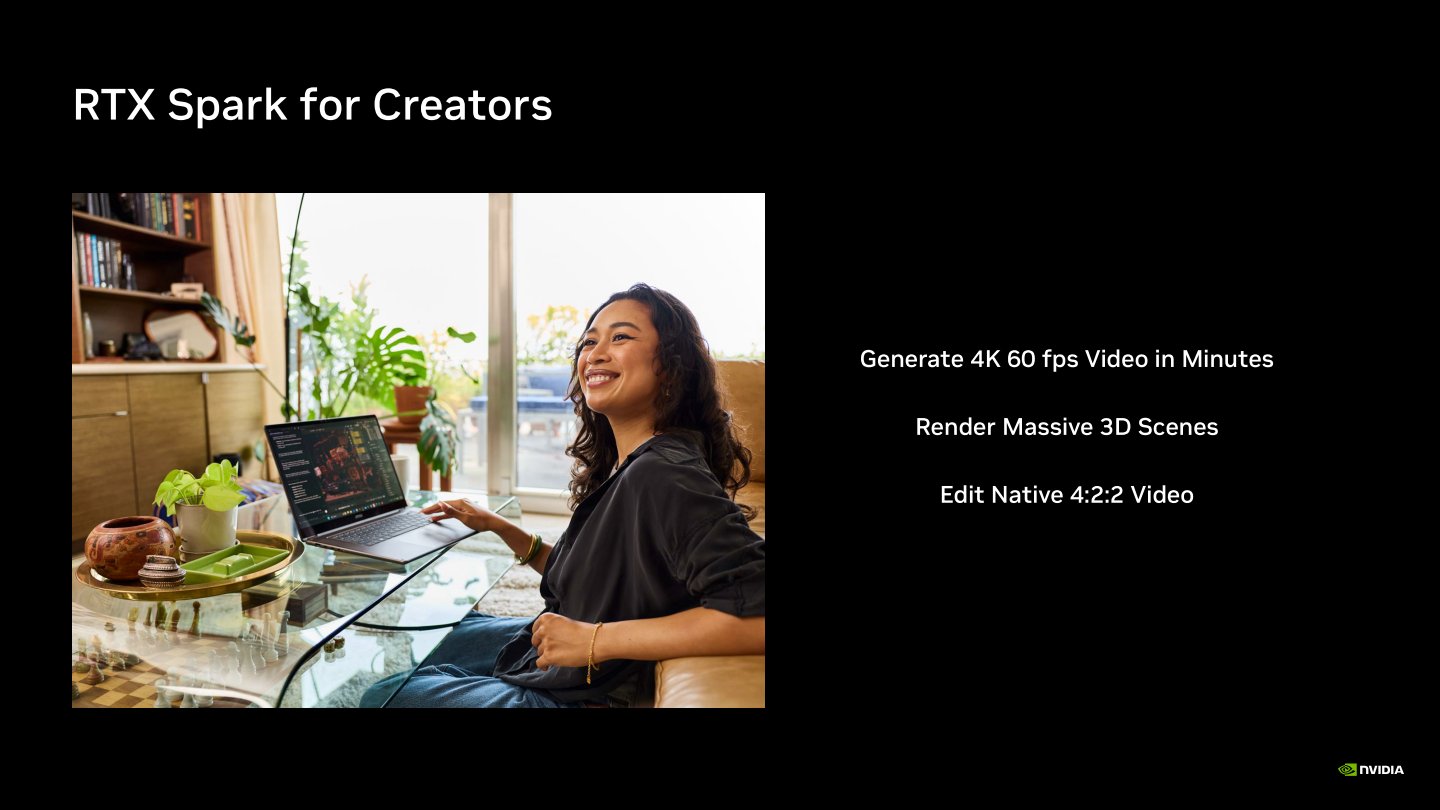
在Blackwell架構的顯示與編解碼引擎協助下,RTX Spark支援多種影片格式的硬體編碼、解碼加速,並支援YCbCr 4:2:2色採取樣模式,同時也具有充沛的GPU加速運算效能,能夠提升創作者的工作效率。

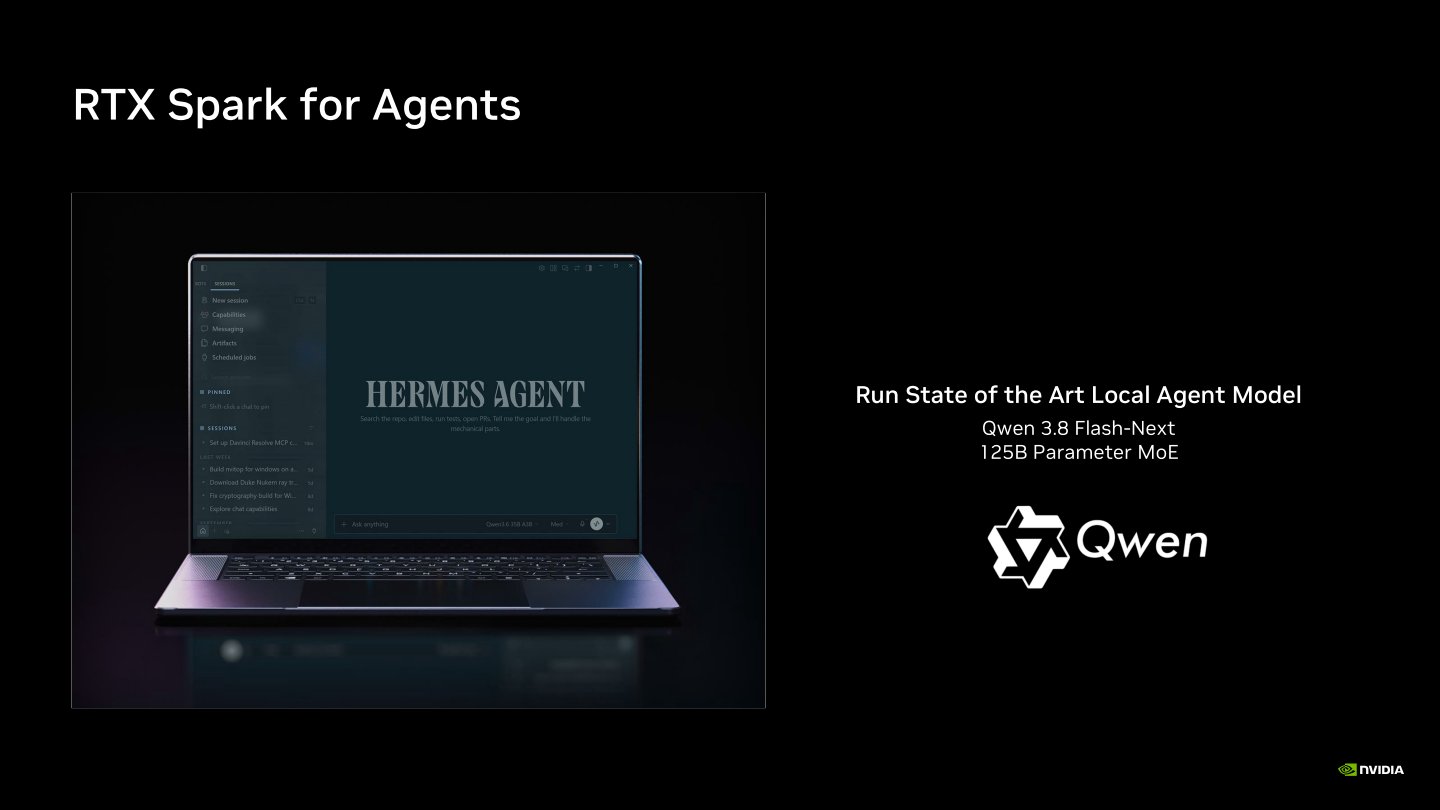
RTX Spark支援容量最高達128 GB的統一架構記憶體,能夠執行參數量高達125B的Qwen 3.8 Flash-Next本機代理式AI模型。

(下頁還有GB10硬體架構分析)

將Grace Blackwell放進Windows筆電

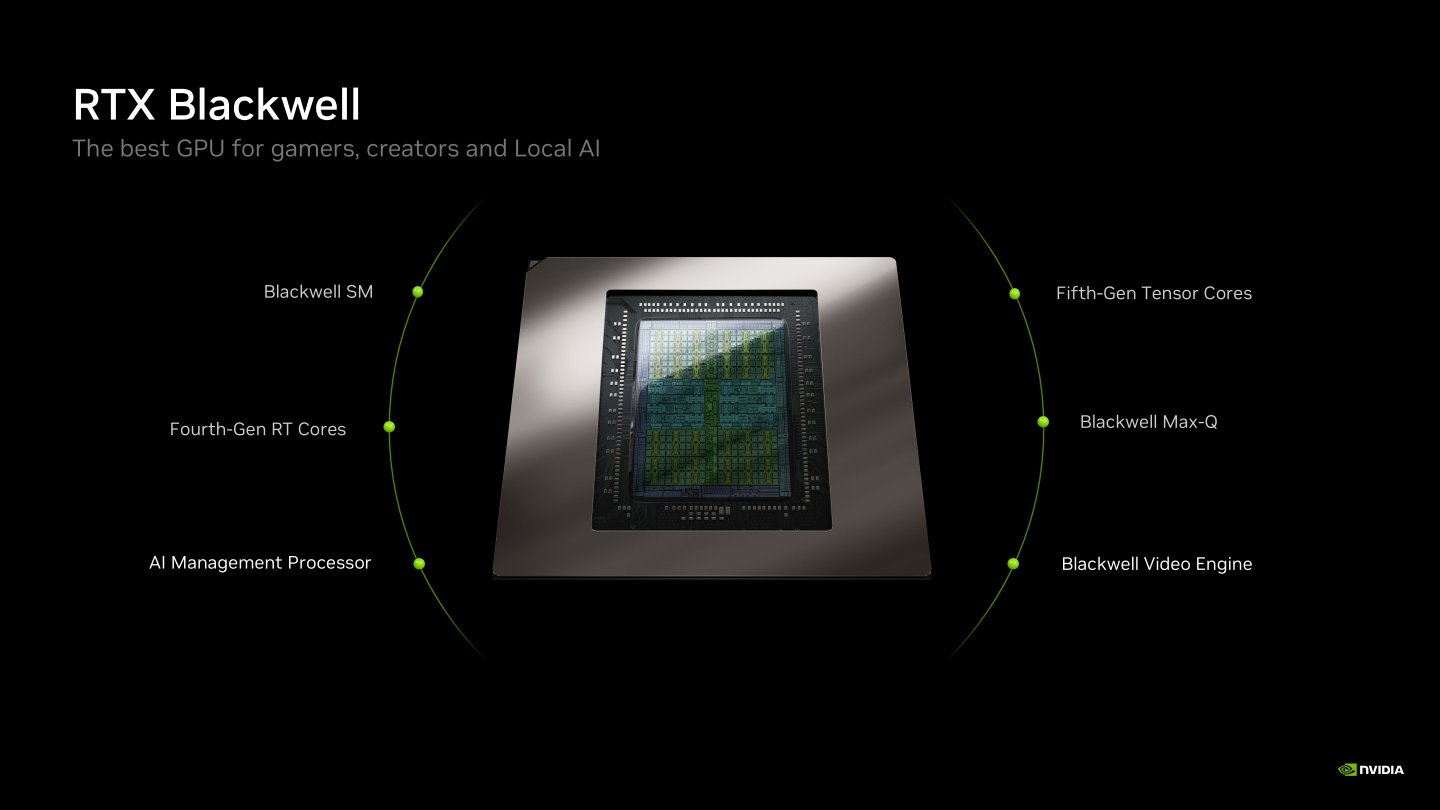
NVIDIA資深產品總監Justin Walker在RTX Spark Editor’s Day活動上說明,RTX Spark所採用的Blackwell繪圖架構集合25年來NVIDIA於GeForce繪圖技術的創新,包含GPU、可程式化渲染器(Programmable Shader)、CUDA統一運算架構(Compute Unified Devices Architecture)、RTX繪圖技術等,同時Blackwell繪圖架構GPU也應用於資料中心加速AI運算,可以說是集3D繪圖、遊戲、AI於一身的運算單元。

RTX Spark所採用的GB10 SoC(即N1X)與資料中心的GB200 Superchip、GB300 Superchip一樣,都是採用Grace架構CPU與Blackwell架構GPU,只不過GB10的規模小了許多。

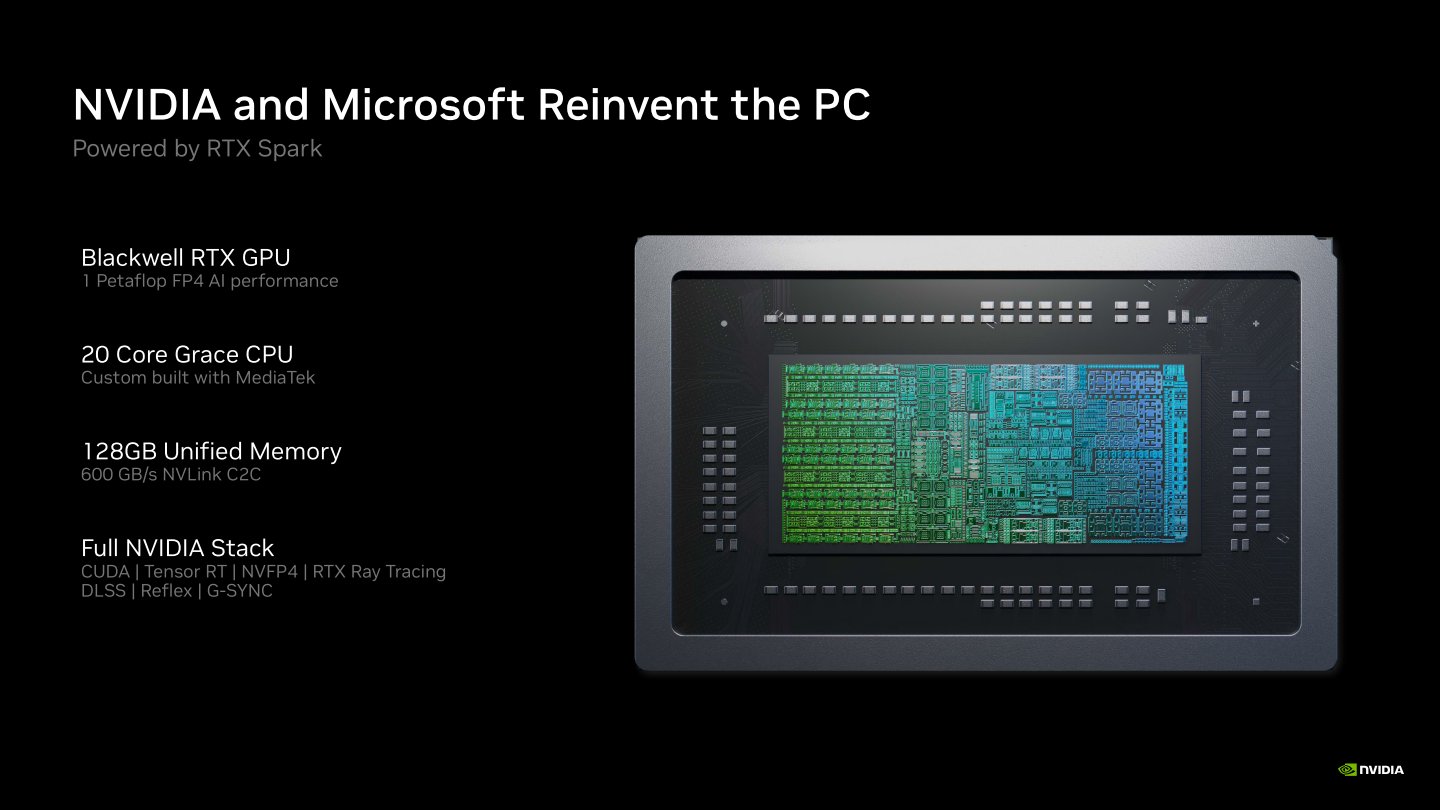
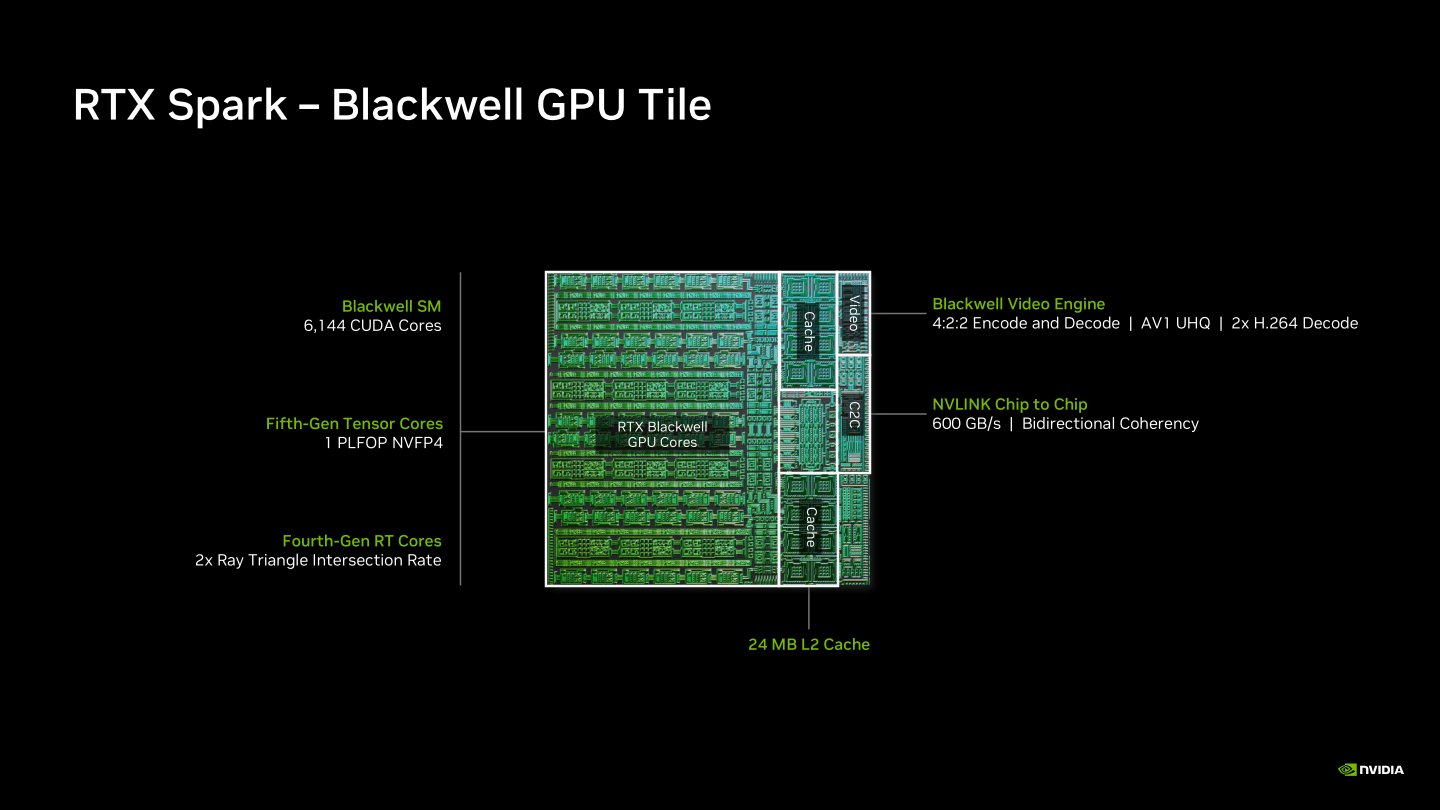
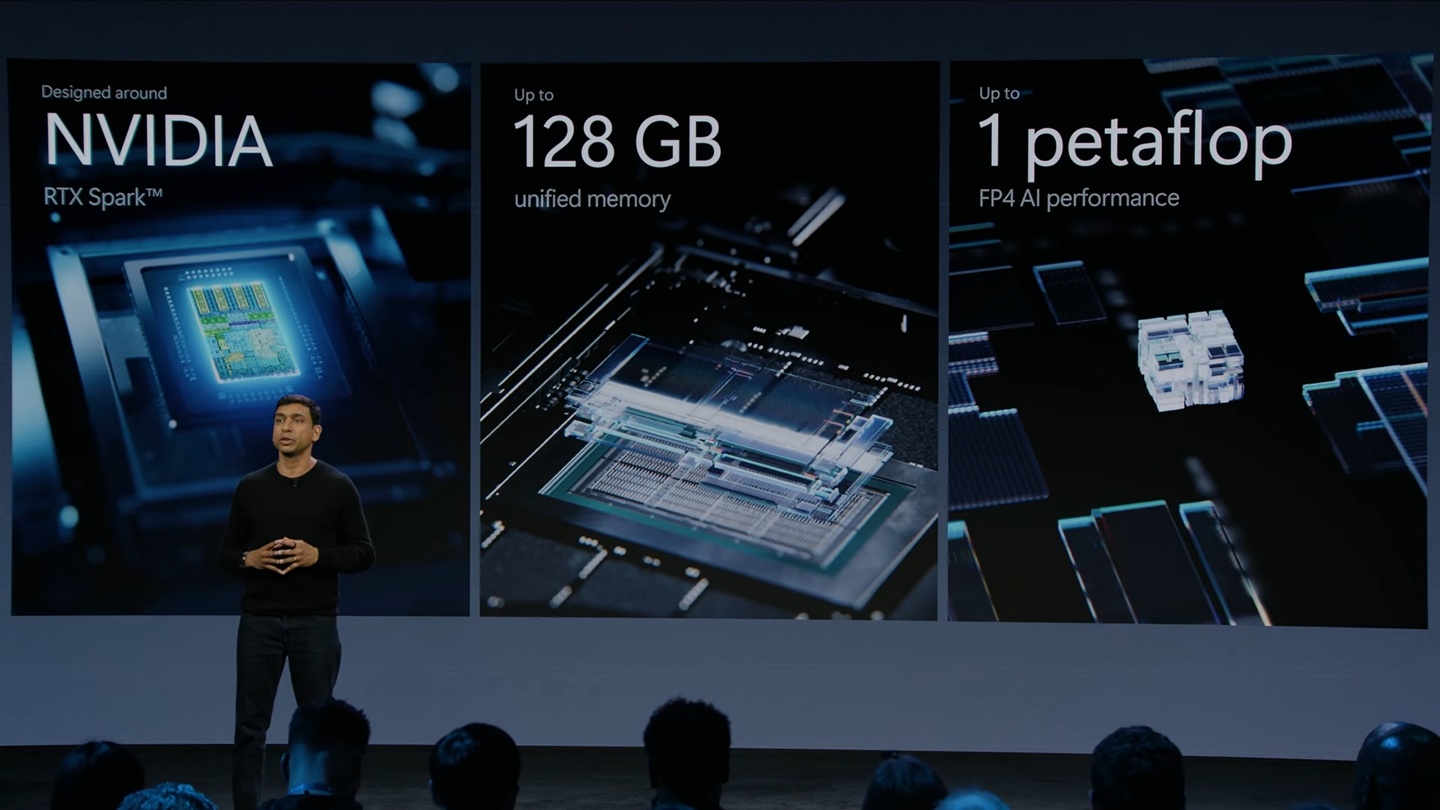
GB10的採用小晶片(Chiplet)設計,CPU小晶片具有10組Arm Cortex-X925核心與10組Arm Cortex-A725核心,GPU小晶片部分則具有6,144組CUDA核心,以及第4代RT核心、第5代Tensor核心,能在FP4資料類型下提供1PFLOS的AI運算效能,2種小晶片採用頻寬高達600 GB/s的NVLink-C2C互連技術進行資料交換。

受益於Blackwell架構GPU,GB10能夠完整支援NVIDIA的軟體堆疊,包含CUDA統一運算架構、TensorRT AI推論執行環境、NVFP4資料類型,以及與遊戲相關的RTX光線追蹤、DLSS升頻、Reflex低延遲、G-Sync可變更新頻率等等技術,能夠相容豐富的現有AI應用程式與遊戲。

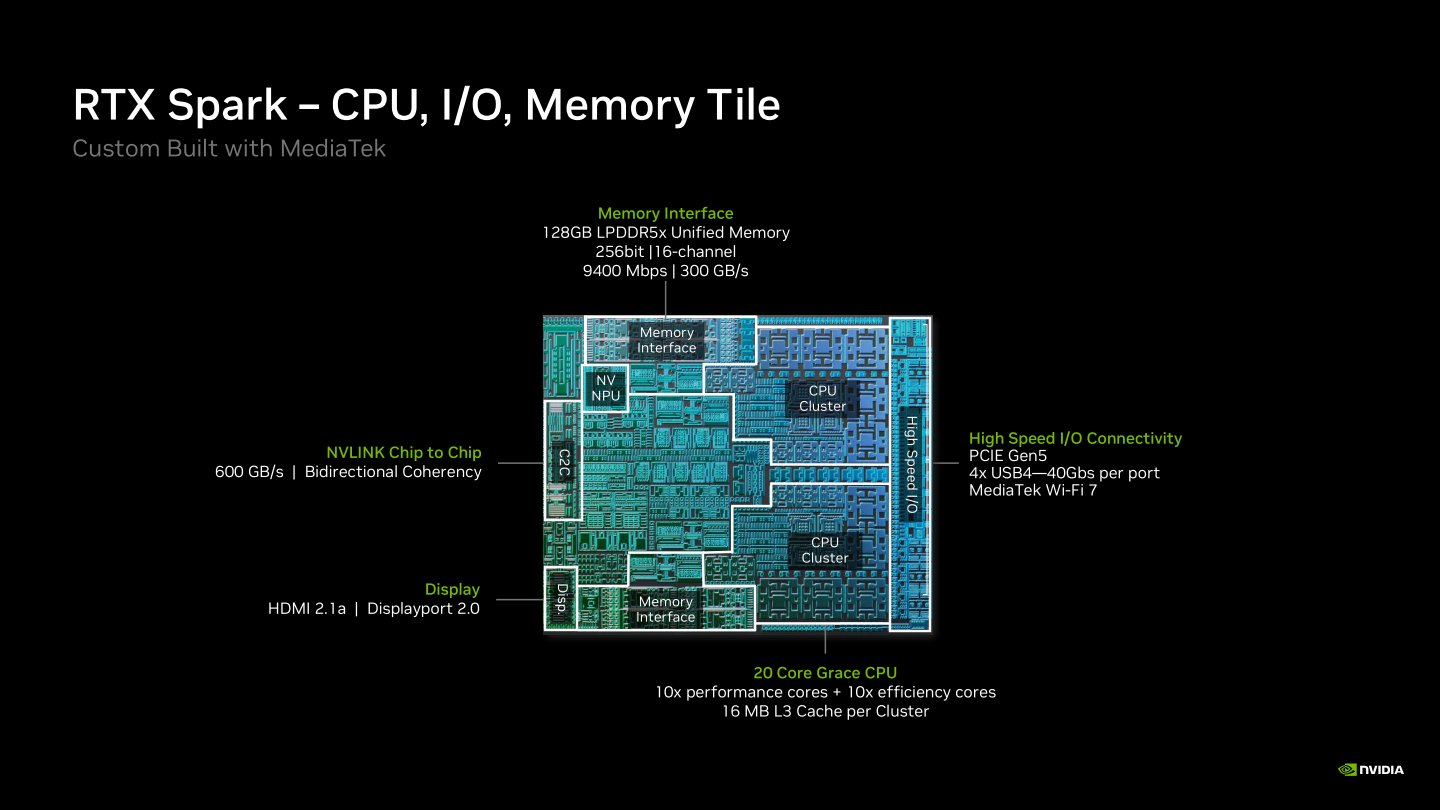
GB10的記憶體子系統支援容量最高達128 GB的LPDDR5x統一架構記憶體,其控制器位於CPU小晶片上,GPU小晶片讀取資料時須透過NVLink-C2C連接至CPU小晶片才能存取記憶體。GB10的NVLink-C2C具有雙向一致性(Bidirectional Coherency)功能,讓CPU與GPU能夠共享統一架構記憶體中的資料,並提升共用資料的存取效能。

這部分與筆記型電腦的獨立顯示晶片類似,當獨立顯示晶片需要存取記憶體時,處理器需先讀取資料,再經由PCIe匯流排傳輸至GPU。GB10將中間的PCIe匯流排替換為NVLink-C2C,並因2種小晶片封裝在同一晶片中,因此距離相當短,能夠讓資料交換的電力效率提升25倍,對於時常需要存取資料的遊戲、AI等應用來說能夠節省許多電力。

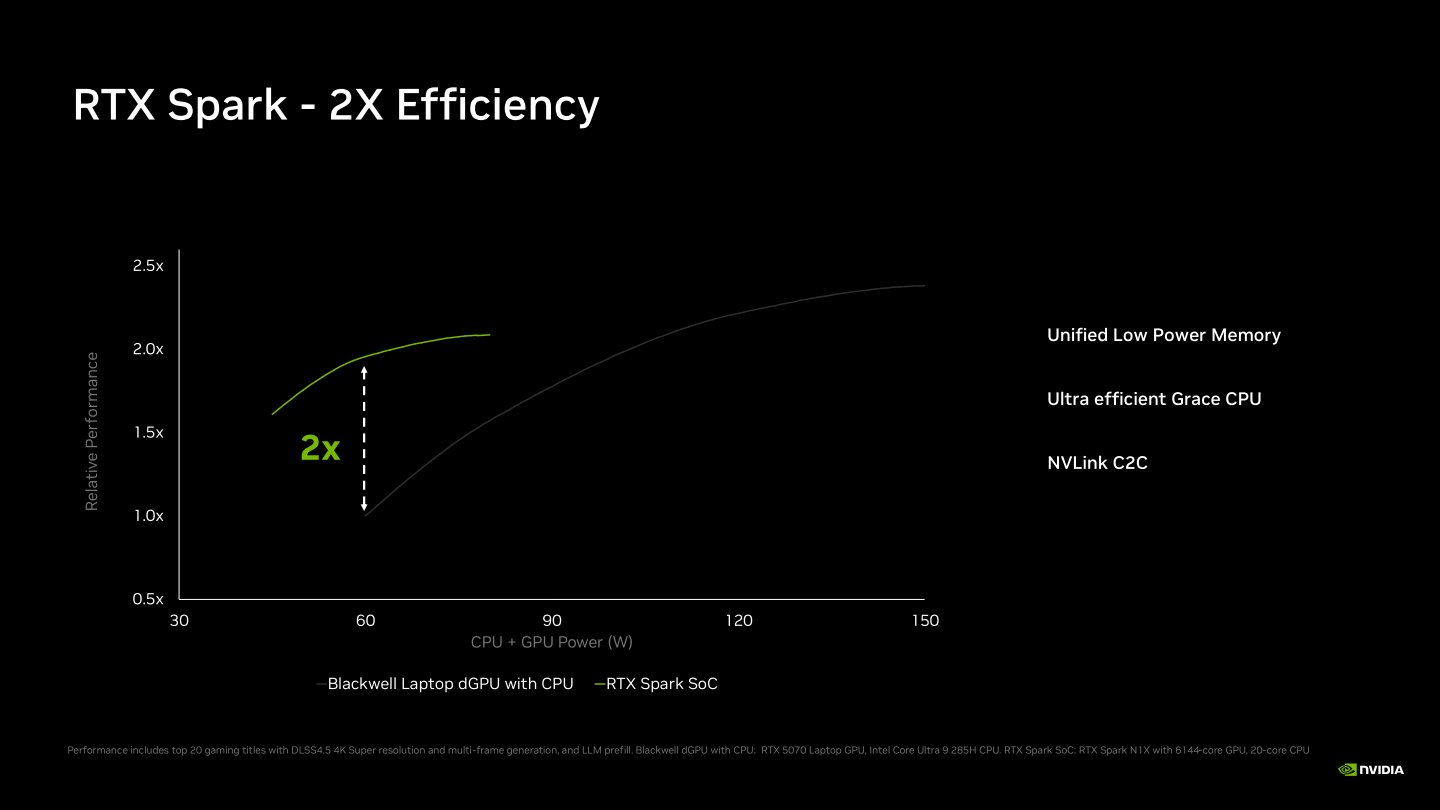
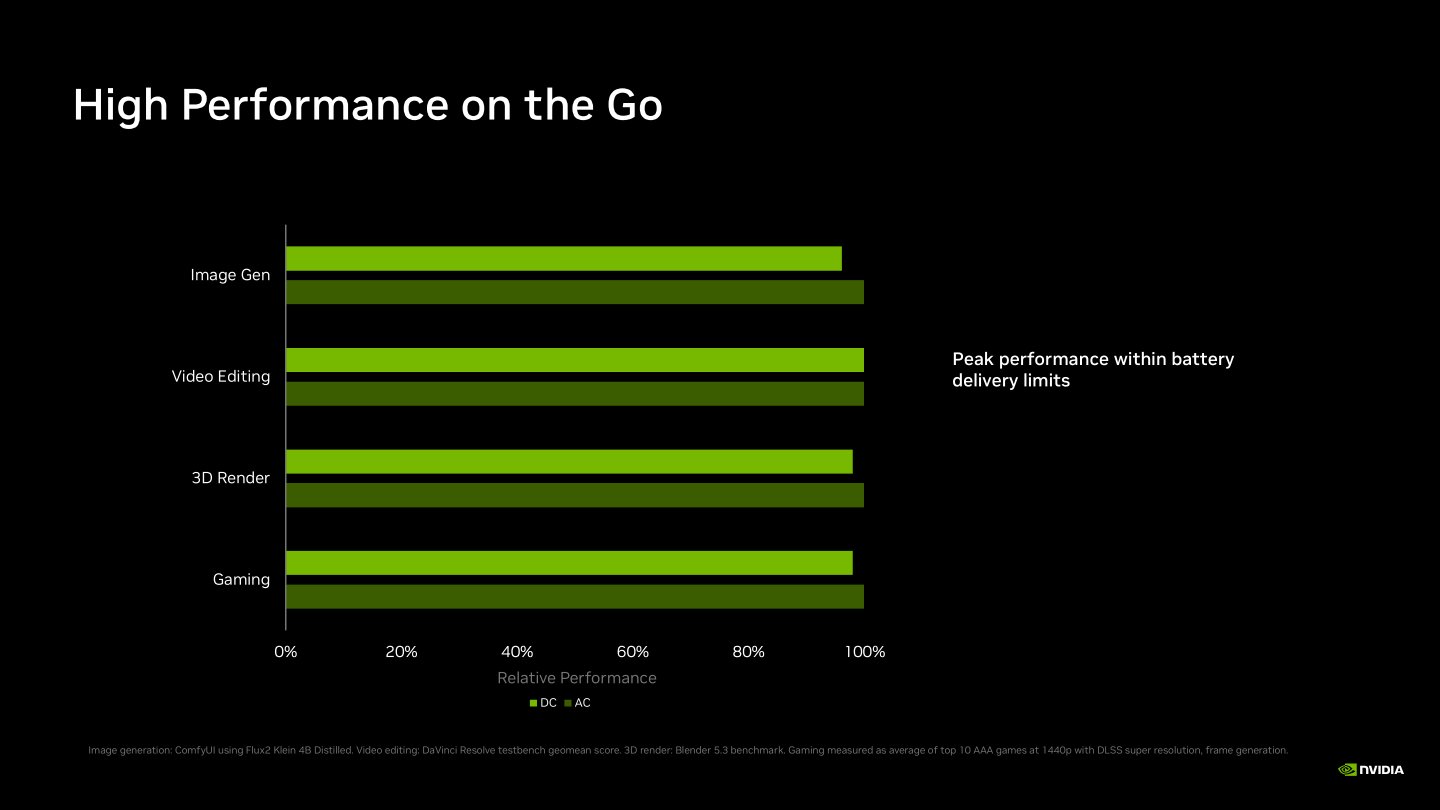
Justin Walker表示GB10在設計之初就將重點放在電力效率,追求在有限的供電條件下發揮最佳效能,而非追求將「油門踩到底」的用最高功耗換取最高效能表現,讓GB10與x86架構處理器搭配顯示卡的組態相比,能夠在消耗60 W電力的情況下得到2倍相對效能表現,並在RTX Spark筆記型電腦以電池供電的情況下,達到接近連接電源的峰值效能表現。

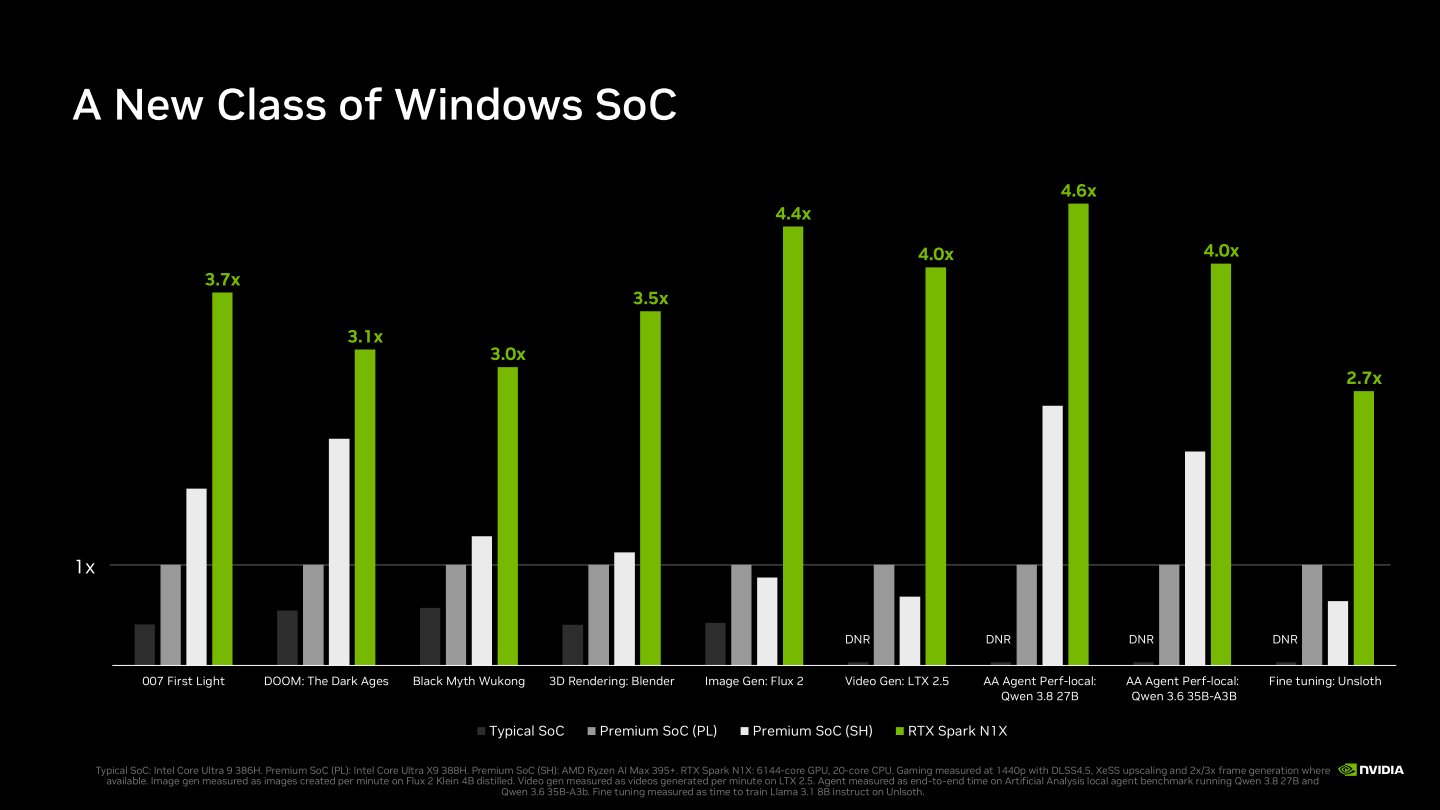
NVIDIA也在簡報中表示GB10是Windows生態系SoC的新分類,根據NVIDIA提供的數據,GB10與競爭對手Intel的Core Ultra 9 386H、Core Ultra X9 388H以及AMD的Ryzen AI Max+ 395相比,在多項遊戲、3D開發、AI圖像與影片生成、代理式AI、模型微調等應用的效能都有顯著領先。

需要注意的是,雖然GB10 SoC具有規模更大的內建顯示晶片,但是執行Windows 11作業系統的RTX Spark平台中的GB10之TDP為80 W,與的Core Ultra 9 386H、Core Ultra X9 388H的TDP上限相同,而Ryzen AI Max+ 395的最高可調整式TDP可達120 W,雖然可以說GB10用「更大張的顯示卡砸死人」有點補講武德,但是彼此仍在相近的電力與功耗條件下進行比較,仍有一定參考價值

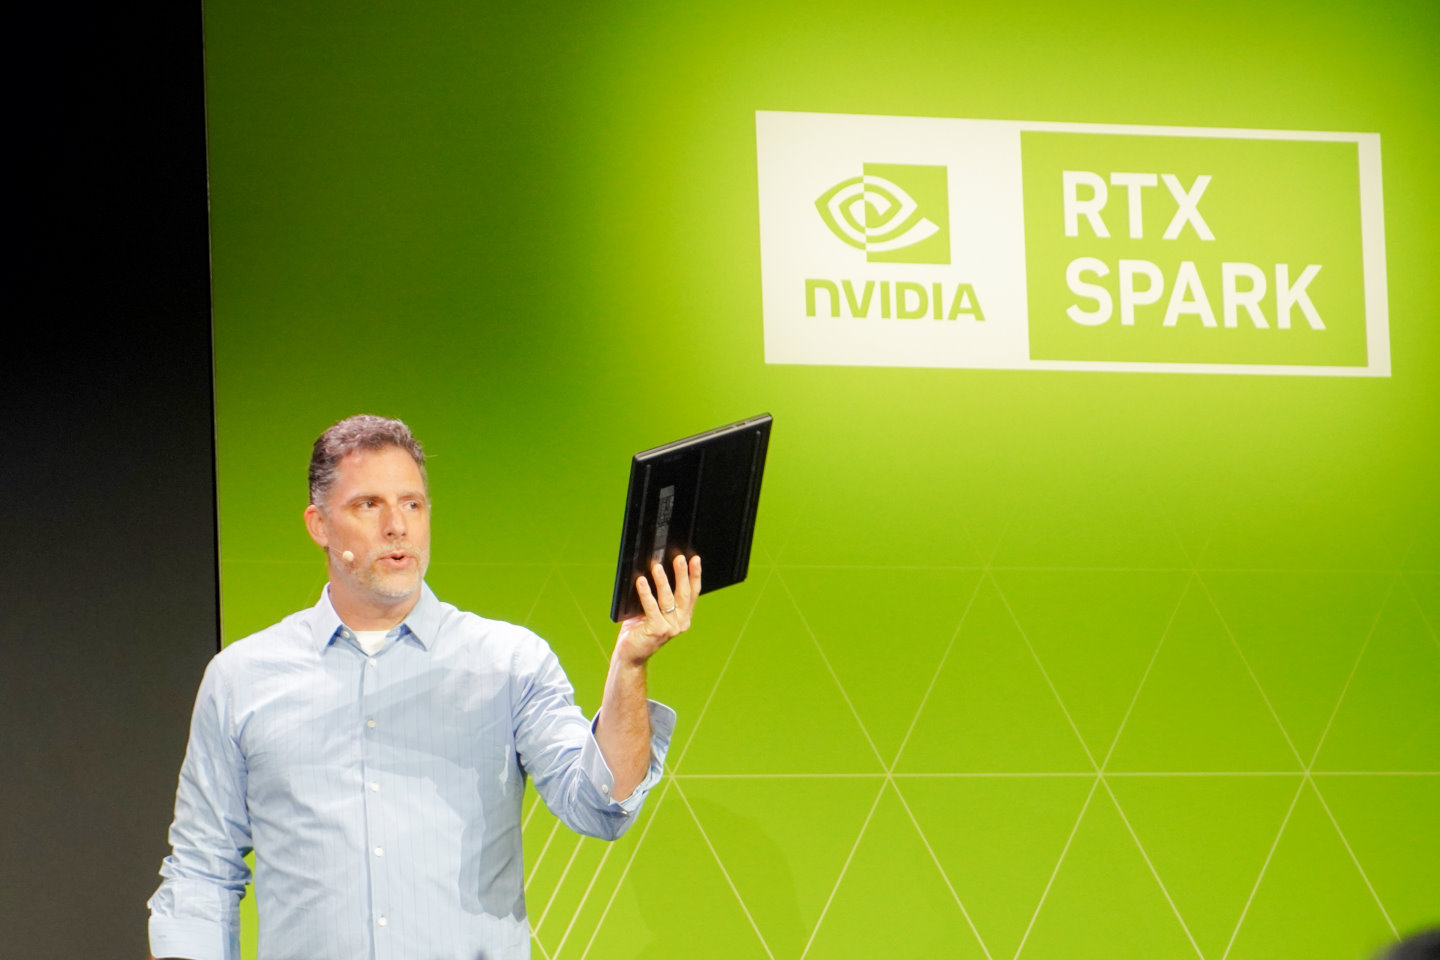
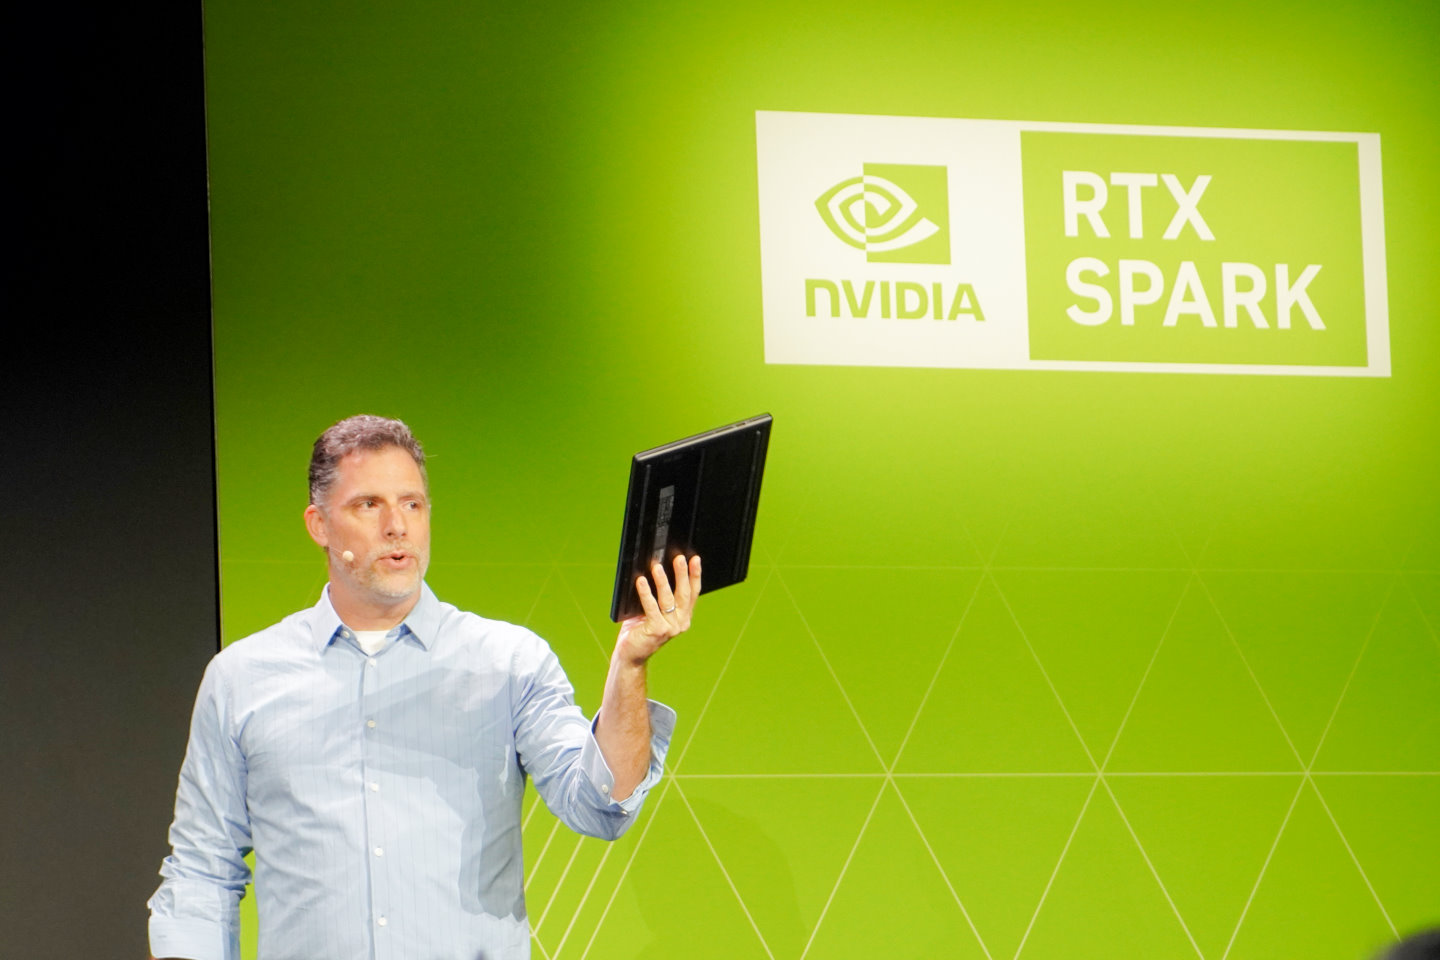
NVIDIA資深產品總監Justin Walker在RTX Spark Editor’s Day活動上展示RTX Spark平台筆記型電腦。

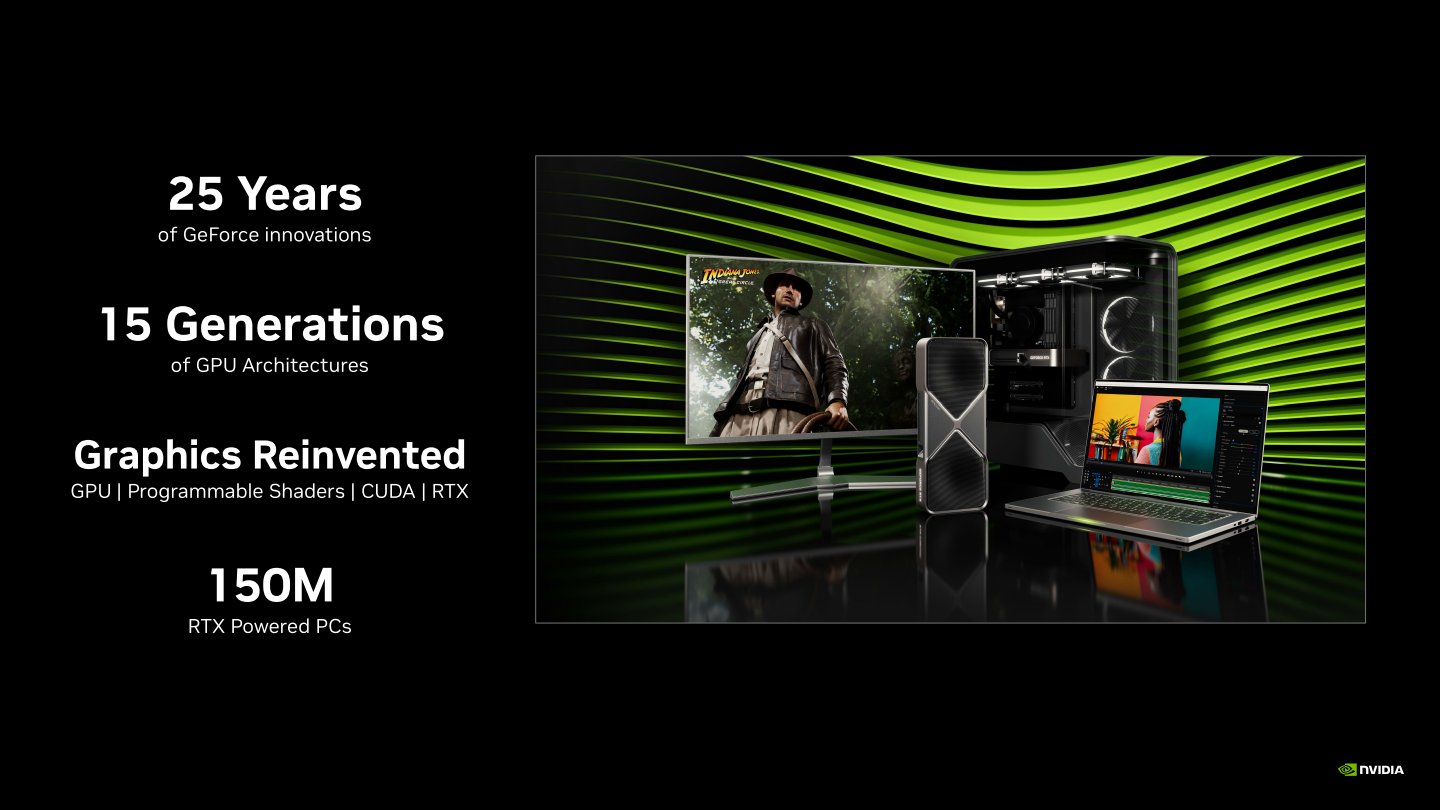
Justin Walker表示NVIDIA在25年中推出15個世代的GPU,並推出GPU、可程式化渲染器、CUDA統一運算架構RTX繪圖技術等創新。

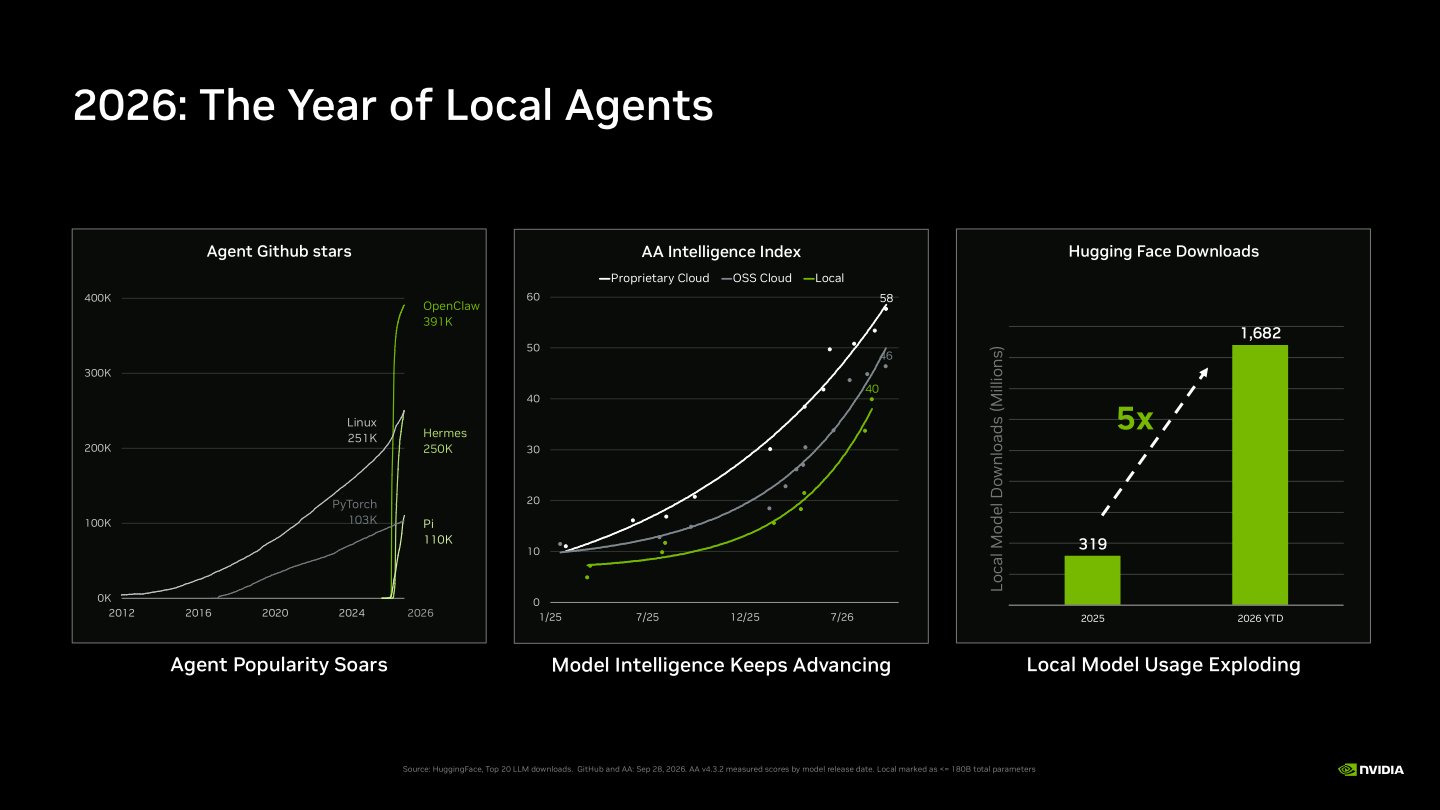
隨著2026年初暱稱「龍蝦」的OpenClaw出現之後,代理式AI應用也走入本機環境與個人電腦。

基本上AI模型的參數量越大,執行時就需求容量越大的記憶體,相對仰賴效能更強、功耗更高的運算單元。RTX Spark平台描準80 W的「低功耗」環境,並支援最高128 GB的記憶體容量,能夠部署Qwen 3.8-Flach-Next AI代理。

RTX Spark平台使用的GB10 SoC具有10組Arm Cortex-X925核心、10組Arm Cortex-A725核心處理器,以及6,144組CUDA核心之Blackwell架構內建顯示晶片,最高支援容量達的128 GB統一架構記憶體,處理器與內建顯示等2組小晶片之間採用NVLink-C2C互連技術。

GB10的CPU小晶片具有2組分別具有5+5核心的CPU叢集,總共具有25 MB L2快取記憶體,以及32 MB L3快取記憶體。此外還有頻寬高達300 GB/s的LPDDR5x-9400記憶體介面,以及PCIe Gen5、4組USB4、Wi-Fi 7等高速I/O介面,HDMI 2.1a與DisplayPort 2.0顯示介面。

GPU小晶片具有6,144組CUDA核心,以及第4代RT核心、第5代Tensor核心,搭載24MB L2快取記憶體以及Blackwell影像引擎,並透過頻寬高達600 GB/s的NVLink-C2C互連技術與CPU小晶片進行資料交換。

GB10的GPU採用最新Blackwell架構,不但具有出色的遊戲與多媒體創作效能,也很適合進行本機AI運算。

GB10完整支援NVIDIA的軟體堆疊,提供多種遊戲、多媒體創作、AI的加速運算與附加功能。

從圖表中可以看到,在60 W功耗的條件下,GB10的相對效能能夠達到與x86架構處理器搭配顯示卡的2倍。但是後者可以在效耗更多電力的情況下持續推高效能表現。

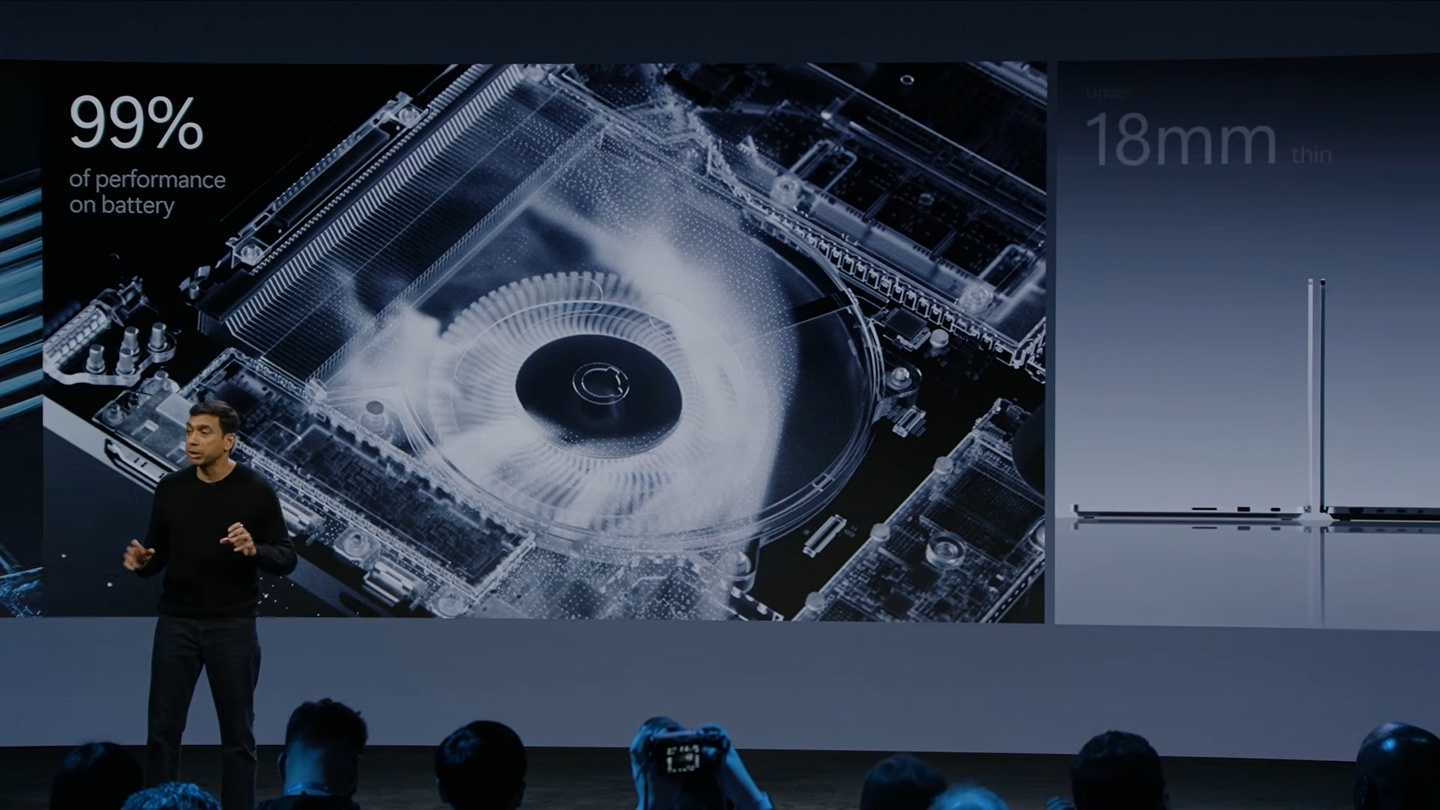
NVIDIA表示RTX Spark筆記型電腦以電池供電的情況下,峰值效能最高能夠維持連接電源的99%。

NVIDIA表示GB10是Windows生態系SoC的新分類,在多項遊戲、3D開發、AI圖像與影片生成、代理式AI、模型微調等應用的效能顯著領先競爭對手。

筆者已經於先前的RTX Spark效能實測專題中測試了它的效能表現,並會在後續文章中繼續分析RTX Spark平台的遊戲、創作、AI等功能,請讀者參考下方目錄繼續閱讀。

(回到RTX Spark Editor’s Day系列文章目錄)

加入T客邦Facebook粉絲團

NVIDIA強襲筆電市場!RTX Spark效能公開,Arm架構搭Blackwell晶片讓遊戲AI全都行

2026年10月15日 20:00
NVIDIA於RTX Spark Editor’s Day活動詳細介紹產品特色,並提供可以搶先於上市前夕測試產品的機會,就讓我們一起來看看這台搭載Arm架構處理器的Windows筆電表現如何。8b81a8a3dd6592dd6c2385b8e5ad22df

NVIDIA於RTX Spark Editor’s Day活動詳細介紹產品特色,並提供可以搶先於上市前夕測試產品的機會,就讓我們一起來看看這台搭載Arm架構處理器的Windows筆電表現如何。

集遊戲、AI、創作於一身

NVIDIA於美國舊金山舉辦的RTX Spark Editor’s Day活動中,詳細介紹RTX Spark平台的架構、平台、AI功能等特色,它採用結合Arm架構Grace CPU(處理器)與Blackwell架構GPU(繪圖處理器)的GB10 SoC,並支援Windows 11作業系統,發揮Arm CPU省電以及NVIDIA GPU高效繪圖、AI的特色,除了具備電競、創作者筆電應有的效能外,也能夠支援在本機執行圖像與影片生成、代理式AI等應用程式,帶來截然不同的使用體驗。

延伸閱讀:
【COMPUTEX 2026】NVIDIA RTX Spark處理器解析:Windows on Arm原生支援、x86模擬,AI遊戲雙重升級!
Snapdragon X2系列平台功能解析:為Windows平台打造並整合豐富平台功能,讓筆電也能有智慧手機的流暢體驗
迷你AI鋼鐵小霸王!NVIDIA DGX Spark推出64GB版抗漲,搭配NVIDIA Sync管理平台可四台串接挑戰運算極限

筆者有幸取得NVIDIA為RTX Spark Editor’s Day活動的參與者提供、能搶先於台灣時間2026年10月15日公開效能數據的測試名額,因此我們調整過去先說明產品軟、硬體架構的慣例,改為先在新聞解禁的時間點發表效能實測,讓讀者能夠在第一時間瞭解產品的表現。至於其他架構說明的專題文章,可參考本文末的系列文章目錄。

這次筆者收到的測試樣品為Asus ProArt P16,搭載具有10組Arm Cortex-X925核心、10組Arm Cortex-A725核心處理器,以及6,144組CUDA核心之Blackwell架構內建顯示晶片的滿血版GB10 SoC,SoC TDP限制為80W,系統會自動平衡處理器與內建顯示晶片的功耗預算。

搭配的記憶體為容量64GB的LPDDR5x-9600,顯示器採用解析度為2880 x 1800的OLED面板,支援120 Hz更新頻率以及VRR、G-Sync等可變更新頻率技術,峰值亮度達1,600 nits,並具有Delta E<1色彩準確度,搭配容量為99.9Wh之電池,機身厚度為1.29 cm,重量為1.77 KG。

NVIDIA資深產品總監Justin Walker在RTX Spark Editor’s Day活動上展示RTX Spark平台筆記型電腦。

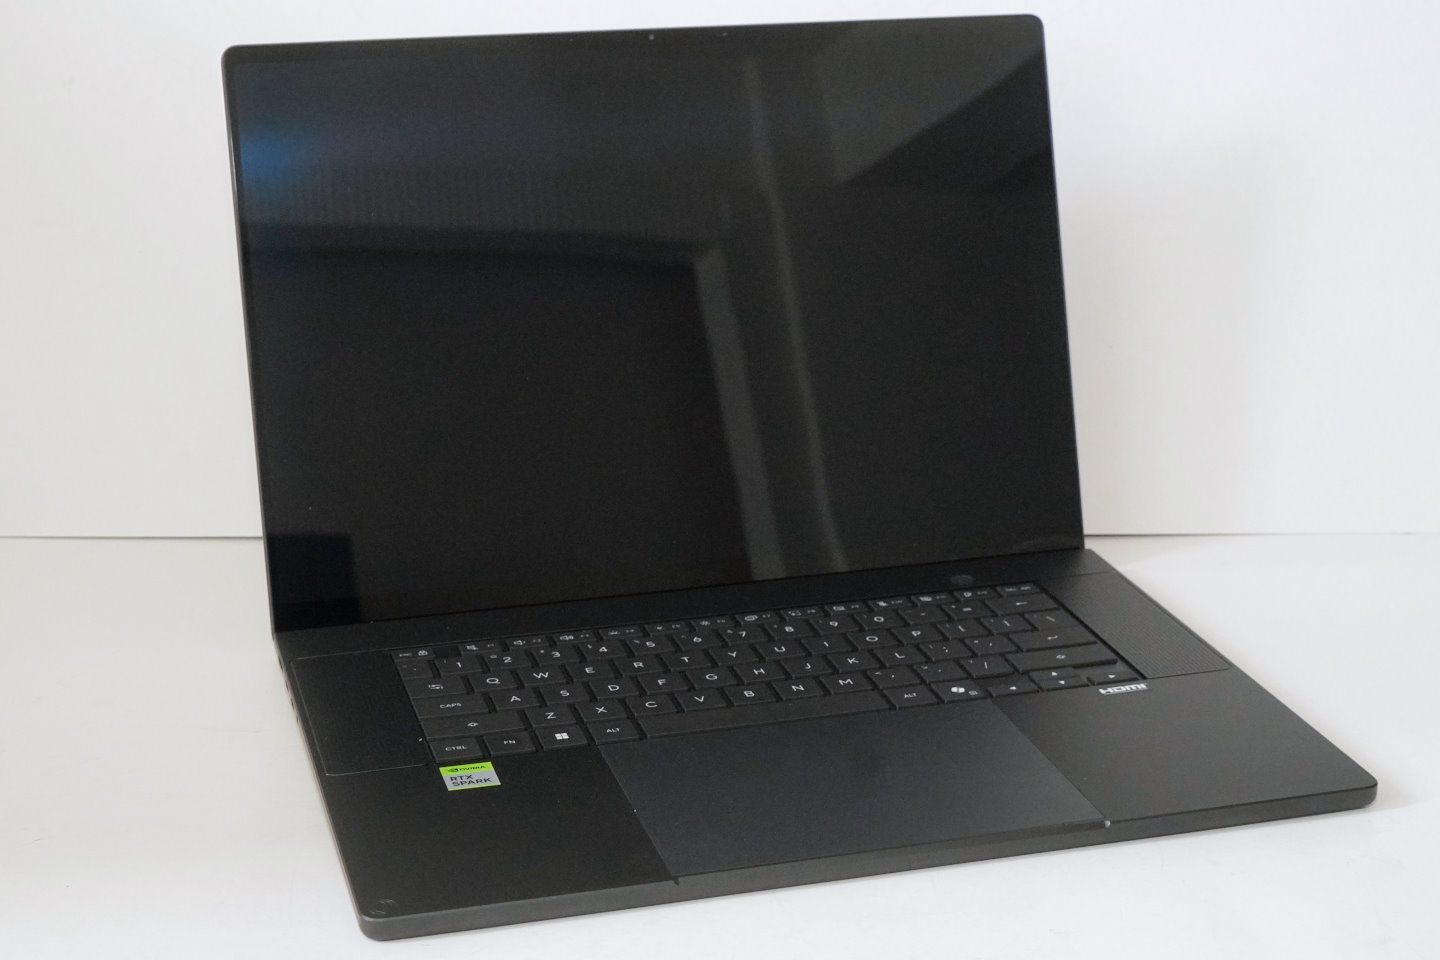
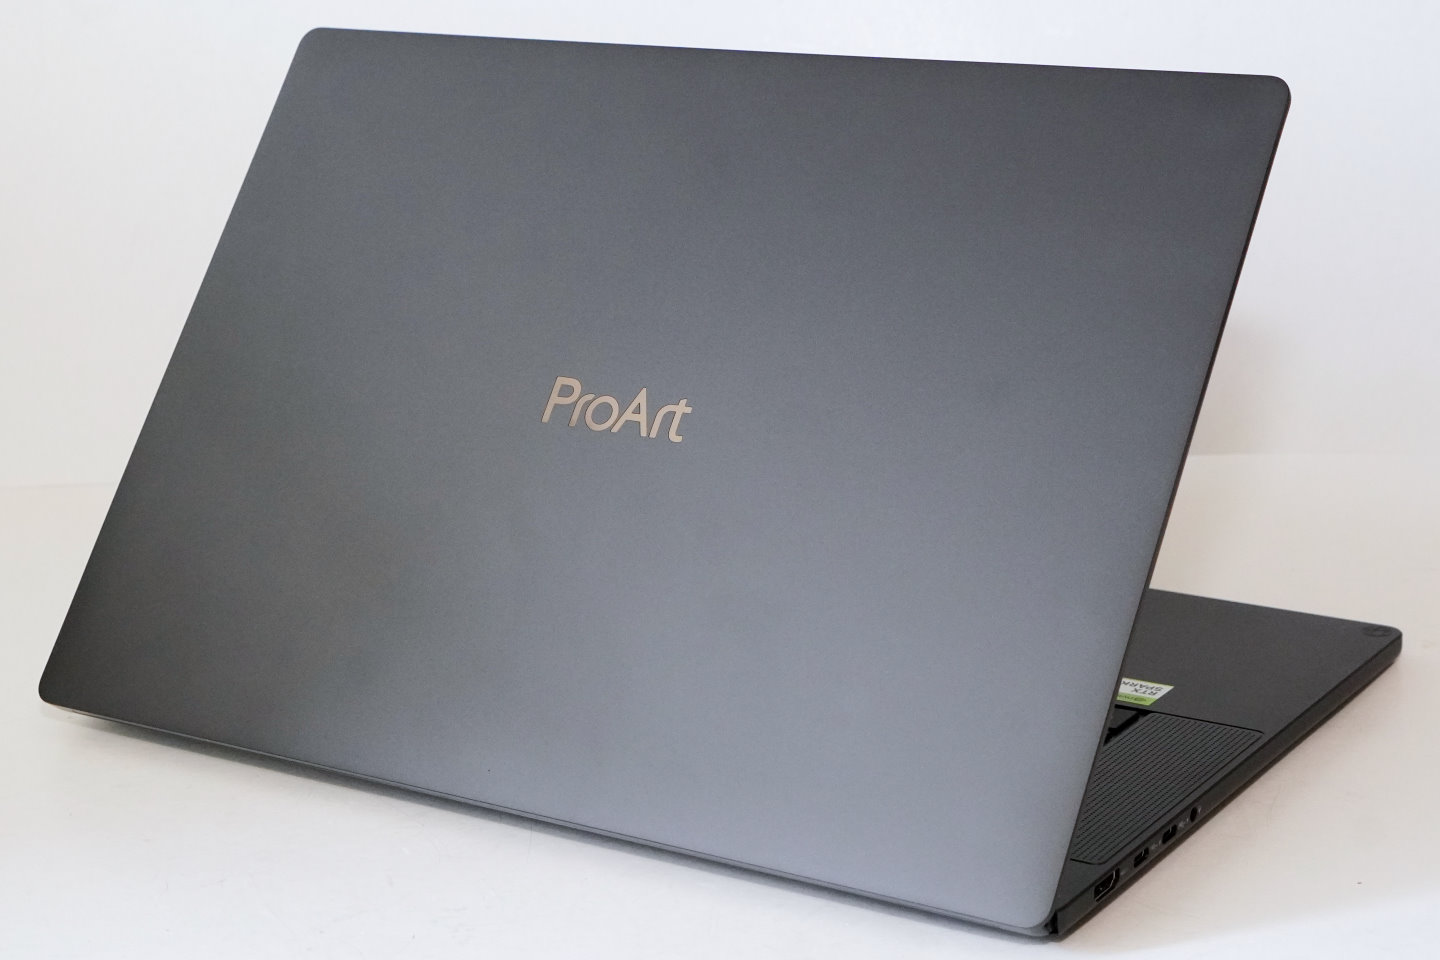
Asus ProArt P16的外觀相當簡潔方正,在鍵盤左右兩側設有揚聲器,鍵盤並不具備數字鍵區。

機身上蓋(A件)具有銀色亮面ProArt字樣。

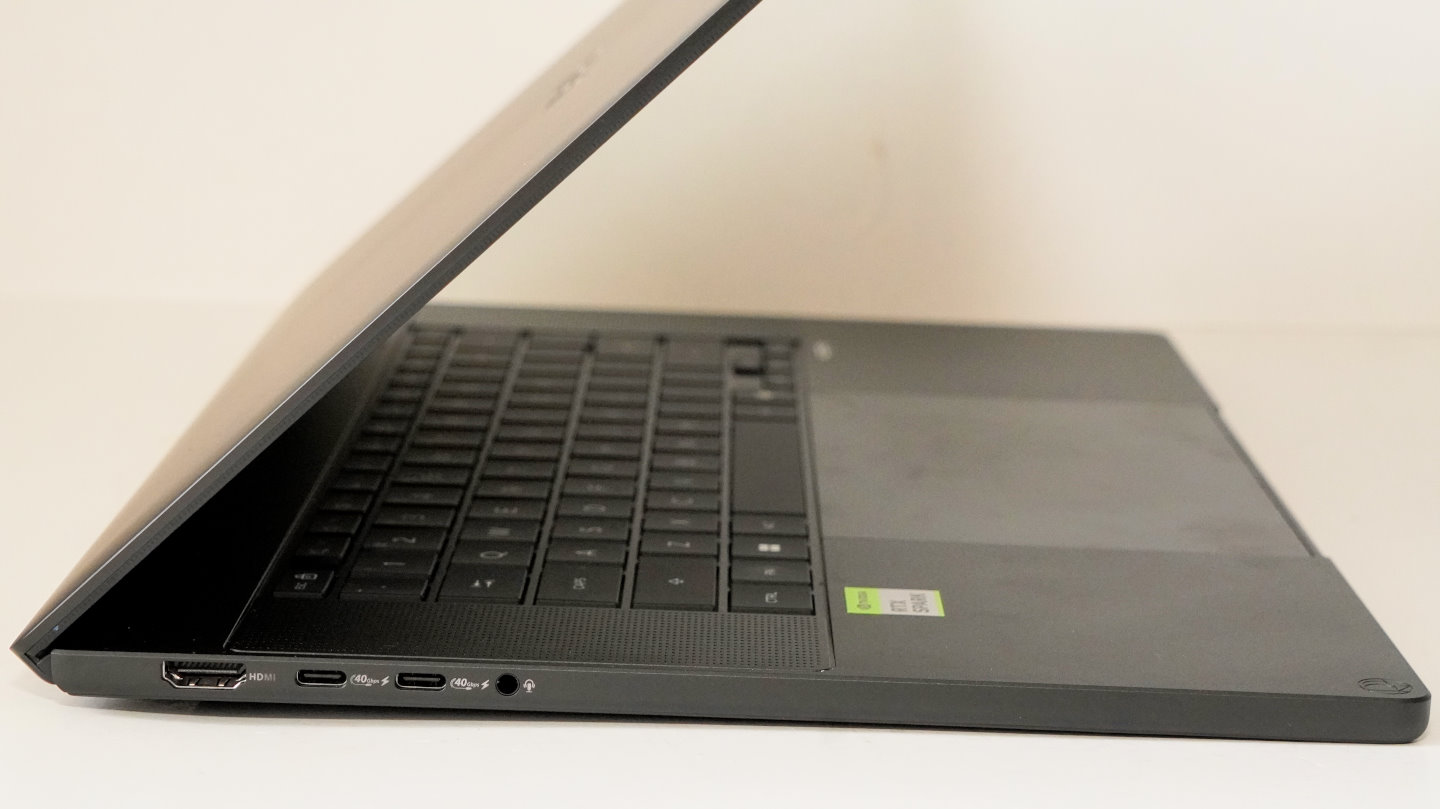
機身左側具有2組全功能USB4 Type-C(支援顯示輸出、電源輸入、40Gbps資料傳輸),以及HDMI 2.1、3.5mm耳機麥克風複合端子各1組。

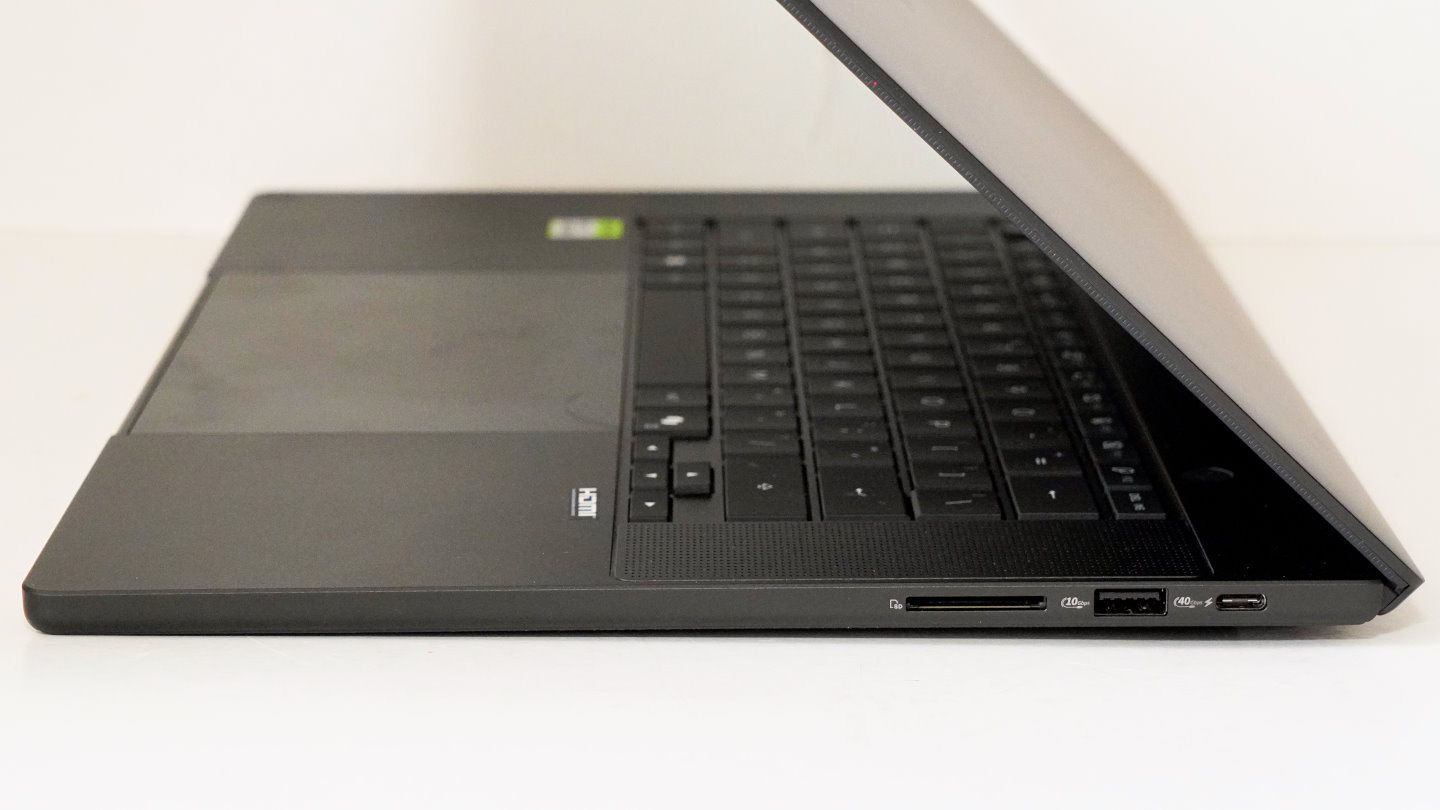
機身右側則有全功能USB4 Type-C、USB 3.2 Gen 2、SD Express 7.0讀卡機各1組。

測試平台規格說明

在開始測試之前,筆者參考NVIDIA提供的測試指南,將Windows電源模式的連接電源狀態設定為「最佳效能」,並將「總是節能模式」、「使用電池時自動啟動節能模式」、「節能模式時調低螢幕亮度」等選項切換至關閉,然後將Asus ProArt Creator Hub控制軟體的電源模式設定為「效能模式」。NVIDIA App中的內建顯示晶片記憶體配額為持預設的30.5GB。

測試過程中除了續航力測試之外皆有插電,而所有成績除了續航力之外僅執行1輪之外,其餘項目都是進行2輪測試,在確定沒有極端值後取平均。

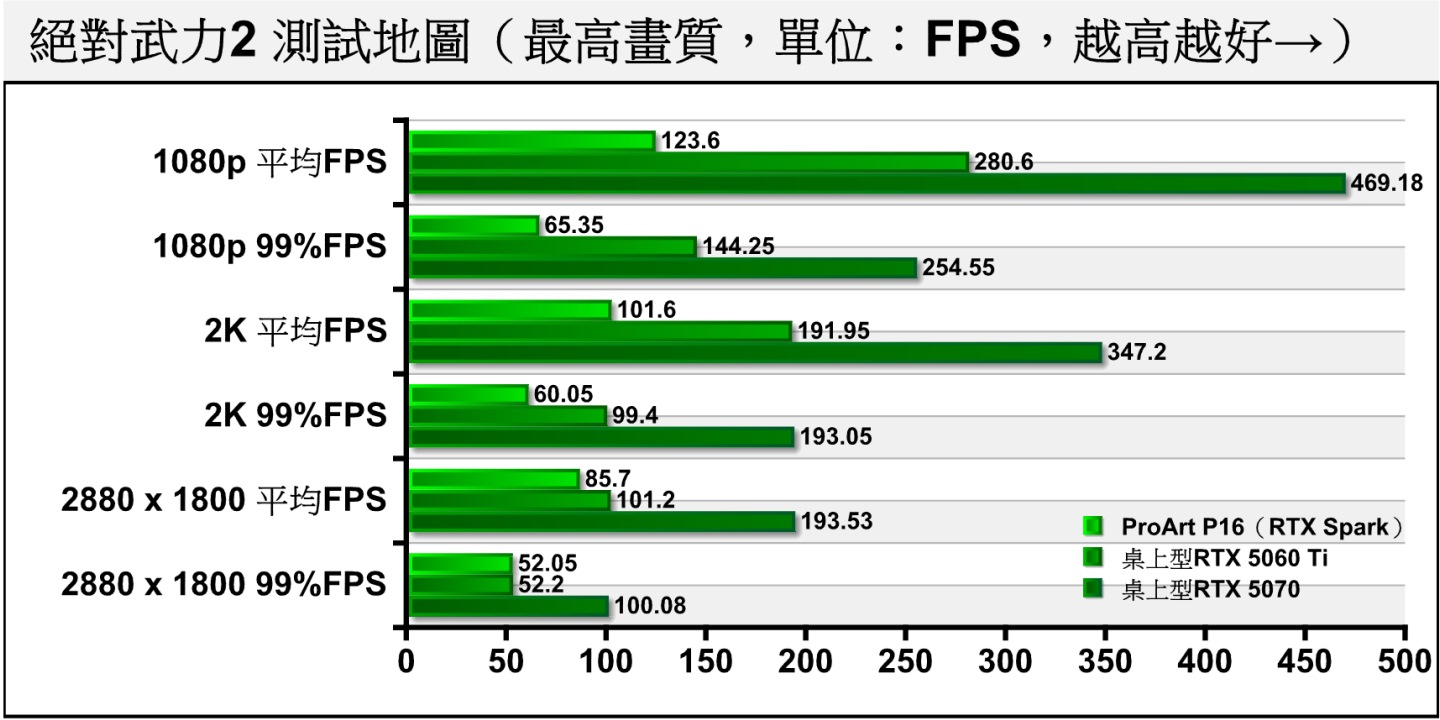
在遊戲測試部分使用遊戲內建的測試模式,而《絕對武力2》使用CS2 FPS Benchmark工作坊地圖進行測試,考量NVIDIA將RTX Spark的遊戲效能表現定位於2K解析度(2160 x 1440)等級,因此進行1080p、2K以及ProArt P16顯示器原生的2880 x 1800解析度搭配最高畫質設定,若有設定範本則套用最高範本,若無則將所有畫質相關項目調至最高,關閉VRS或動態解析度等設定,並僅進行開、關光線追蹤功能的調整。

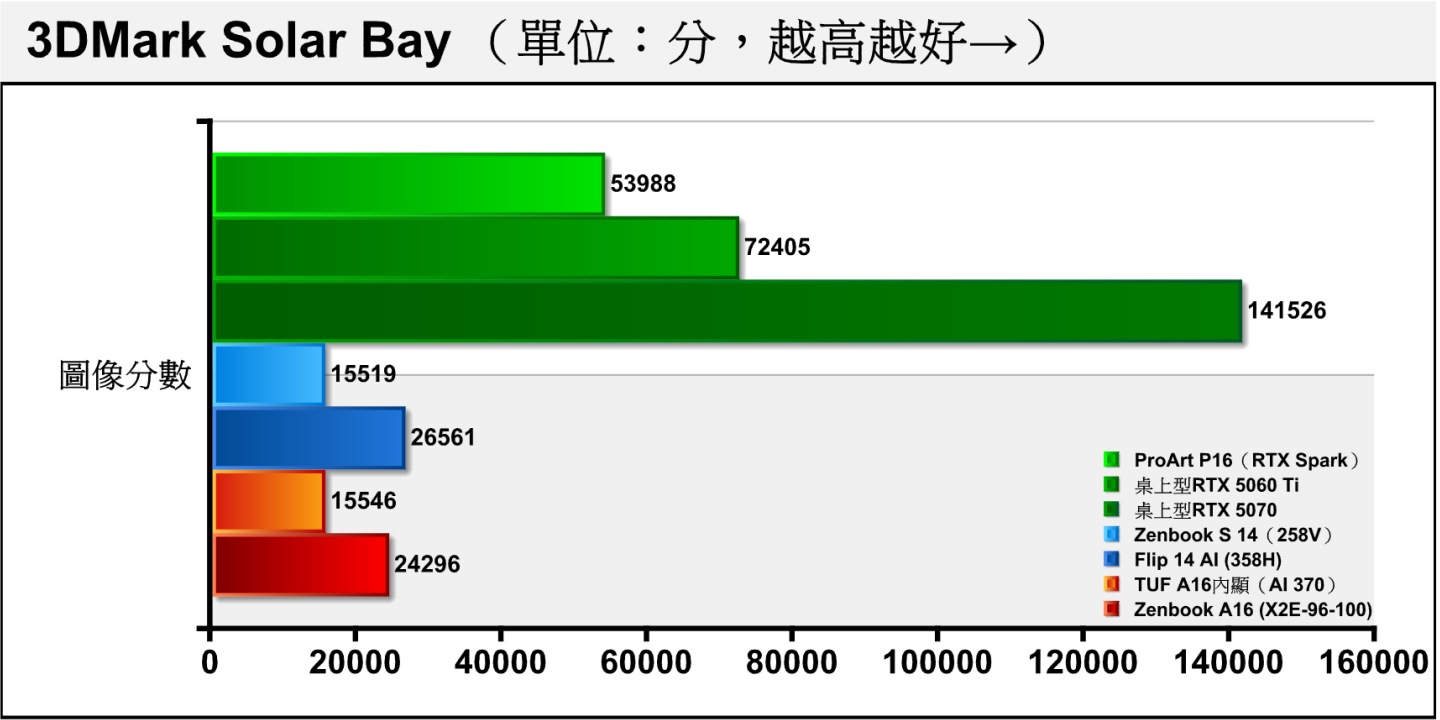
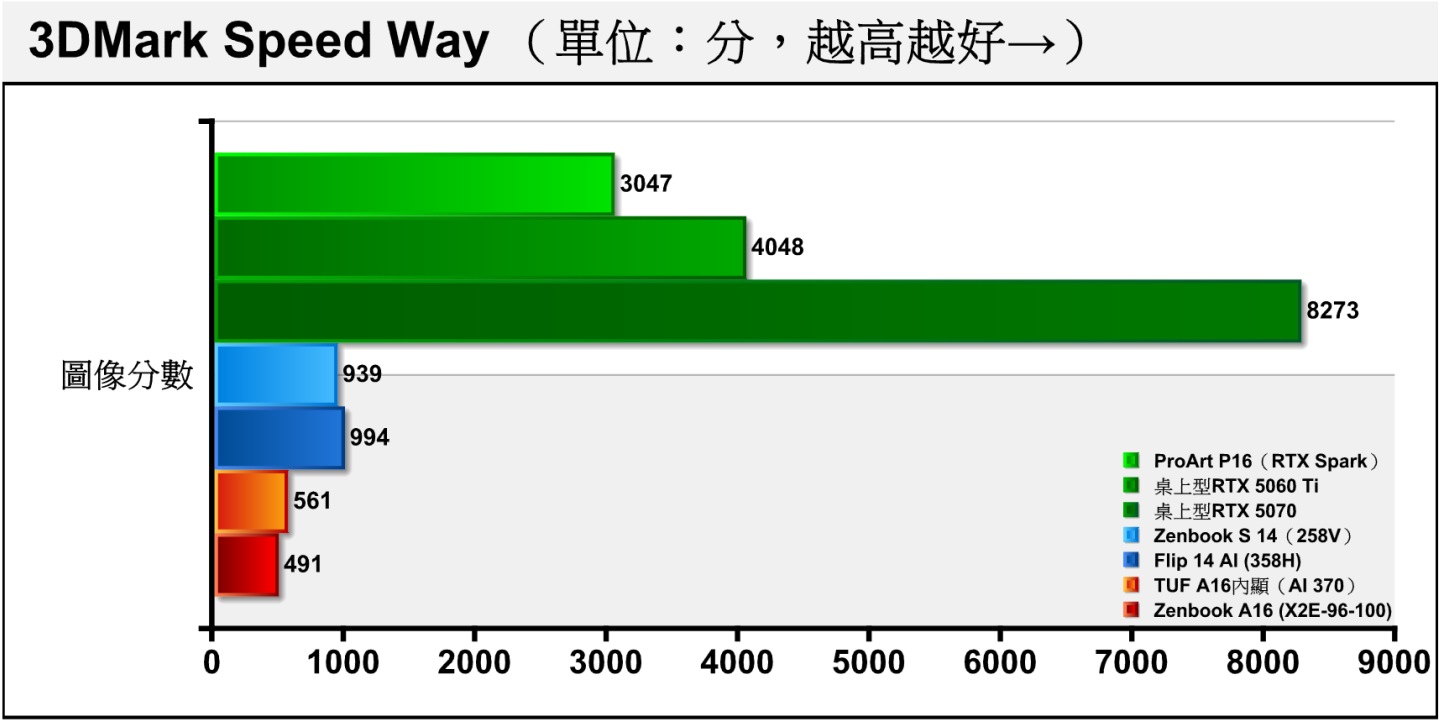
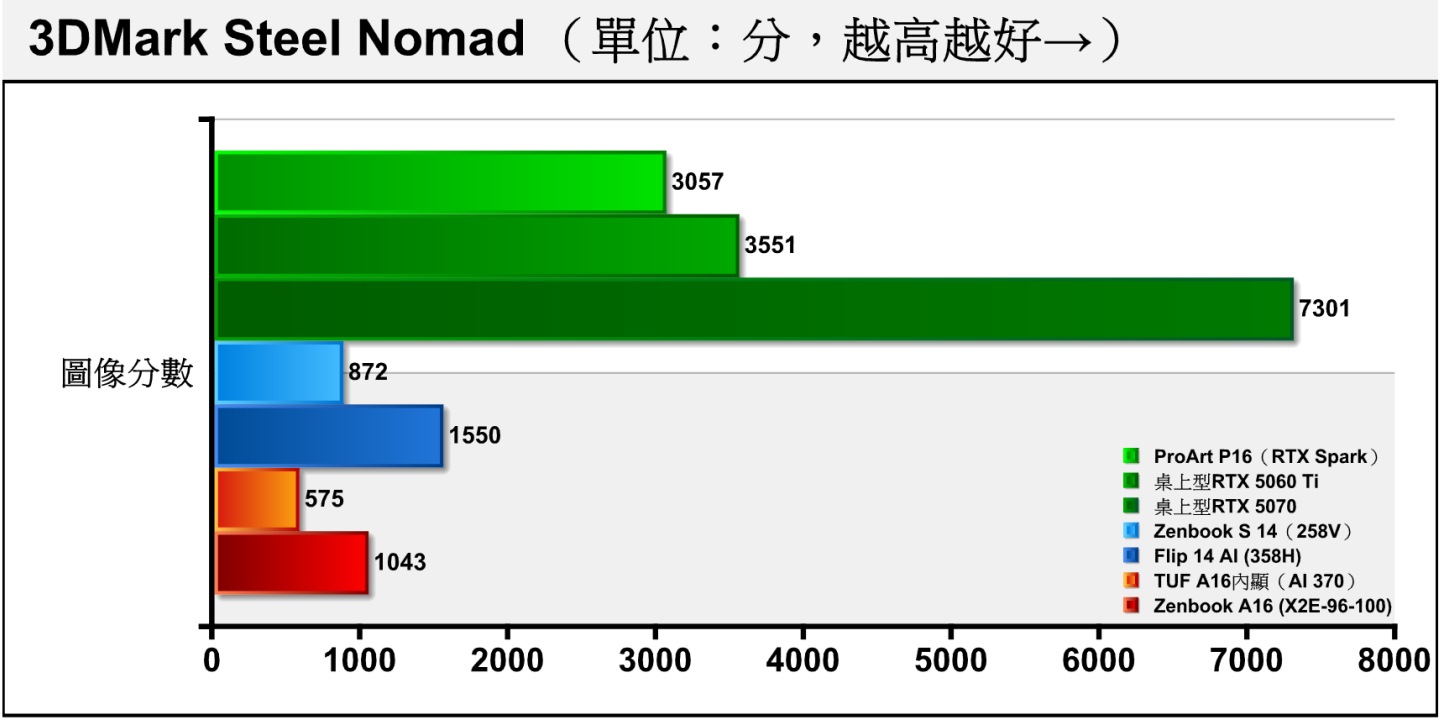
這次的對照組為搭載AMD Ryzen AI 9 HX 370處理器的Asus TUF Gaming A16、搭載Intel Core Ultra 7 358H處理器的MSI Prestige 14 Flip AI+,以及搭載Snapdragon X2 Elite Extreme X2E-96-100 SoC的Asus Zenbook A16。測試數據分別取自《AMD Ryzen 9 AI 9 HX 370效能實測》、《Intel Panther Lake效能實測》、《Snapdragon X2 Elite Extreme效能實測》等專題。

另一方面考量RTX Spark的CPU、GPU配置比較特殊,因此運算方面與的效能與上述3款電腦進行比較,而AI與遊戲部分礙於這次工作時間有限而來不及準備其他行動版平台之測試數據,故以桌上型之GeForce RTX 5070與GeForce RTX 5060 Ti 16GB等顯示卡測試專題的數據進行比較。

其中GeForce RTX 5070的CUDA核心數量與RTX Spark同為6,144組,而GeForce RTX 5060 Ti 16GB則為4,608組,但因桌上型顯示卡TDP分別高達250 W、180 W,均比RTX Spark平台處理器與內建顯示晶片加總僅80W的TDP高出許多,且搭配的處理器為針對遊戲應用強化的AMD Ryzen 7 9800X3D,故可預期遊戲效能表現會有比較大的落差。

測試平台:
處理器:NVIDIA RTX Spark平台(產品代號:GB10,產品名稱N1X)
主機板:Asus H7607BA(UEFI版號:H7607BA.303)
記憶體:LPDDR5x-9400 64 GB
顯示卡:Blackwell架構、6,144組CUDA核心(內建顯示晶片)
儲存裝置:Samsung MZVL81T0HFLB-00BTW 1TB
軟體環境:Windows 11專業版26H1(Build28000.3086),顯示晶片驅動版號:GeForce Game Ready 617.42

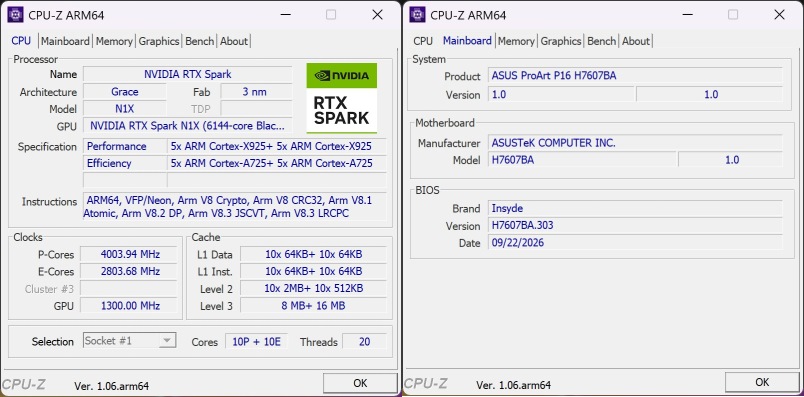
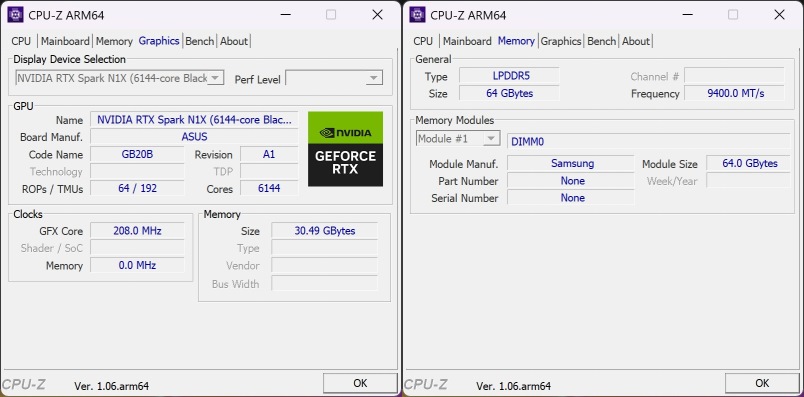
Asus ProArt P16的CPU-Z資訊,處理器名稱顯示NVIDIA RTX Spark。

由於截稿前GPU-Z尚無法正常運作,故內建顯示晶片晶片仍資訊仍由CPU-Z提供,可以看到搭配的記憶體為LPDDR5x-9400 64 GB。

續航力與AI效能測試

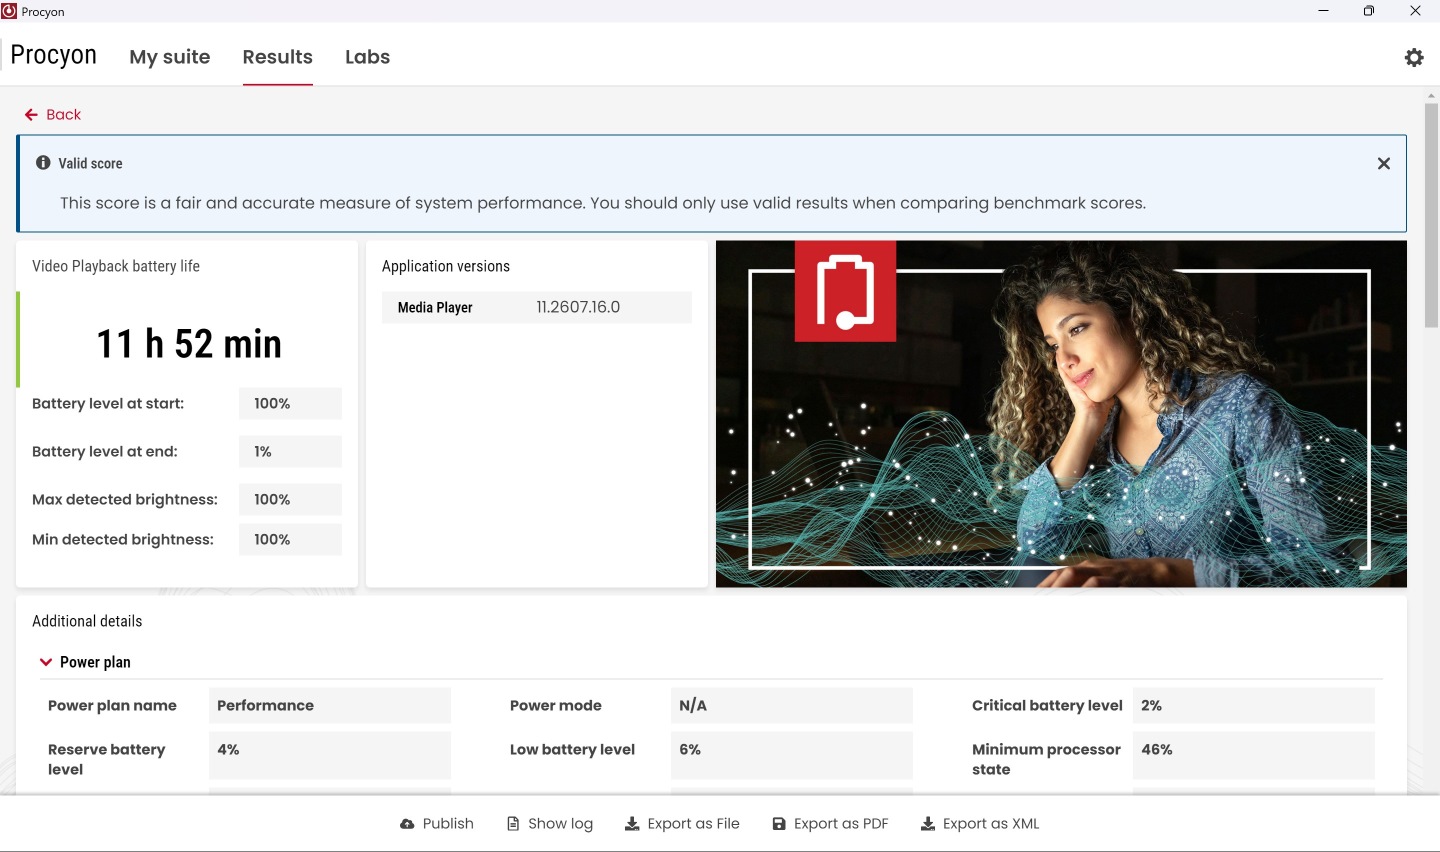
在續航力測試部分,由於PCMark 10的生產力、遊戲續航力測試不支援RTX Spark的Arm架構處理器,故僅以Procyon Video Playback進行續航力測試,過程將螢幕亮度調至最高,關閉Wi-Fi無線網路,關閉鍵盤背光,音量調至靜音。

AI測試部分則使用Procyon AI文字生成與AI圖像生成進行測試,由於AI圖像生成部份因程式版本更新而與先前測試不同,故不列出對照成績。而RTX Spark平台不支援電腦視覺測試1.0,電腦視覺測試2.0雖可執行但無法正確完成測試流程,有待日後版本更新改進此問題。

Asus ProArt P16搭載容量高達99.9Wh之電池,能在螢幕亮度最高的情況下,在Procyon Video Playback續航力測試跑出11小時52分鐘的佳績。

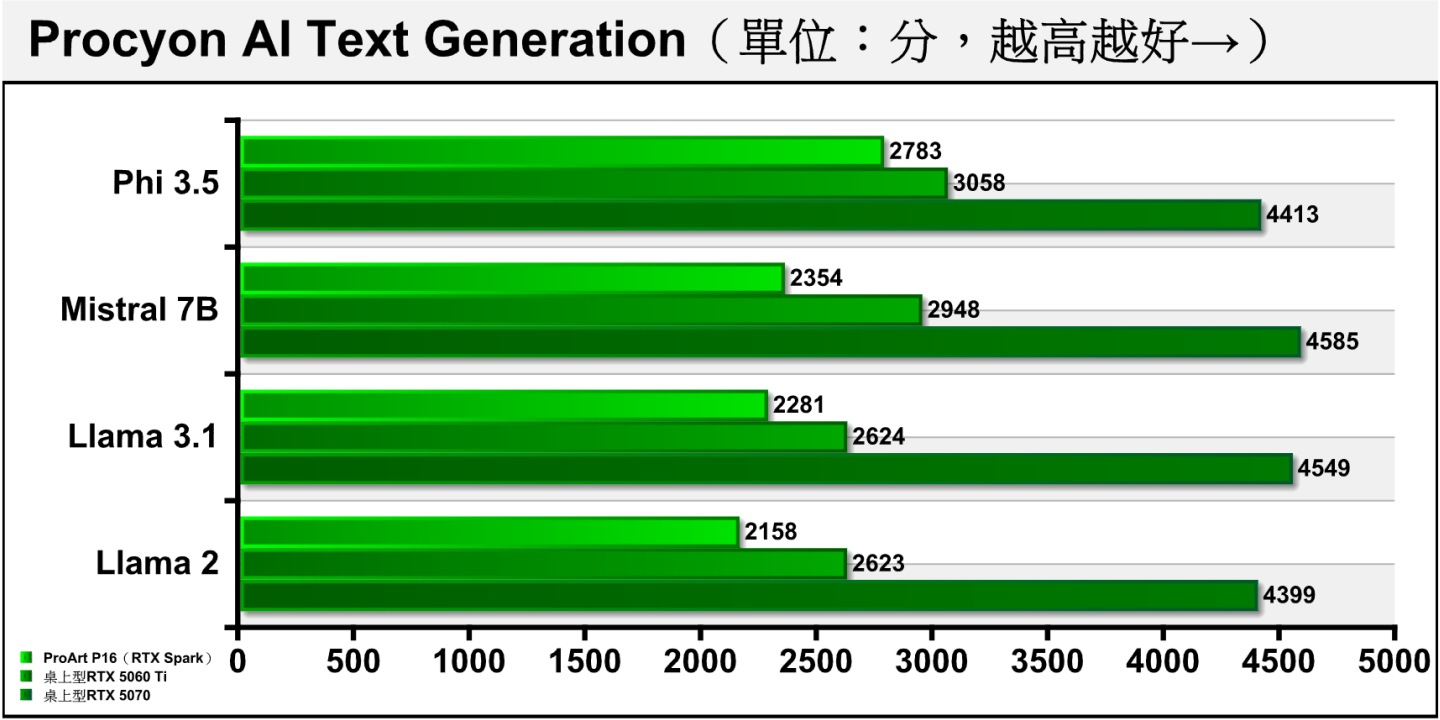
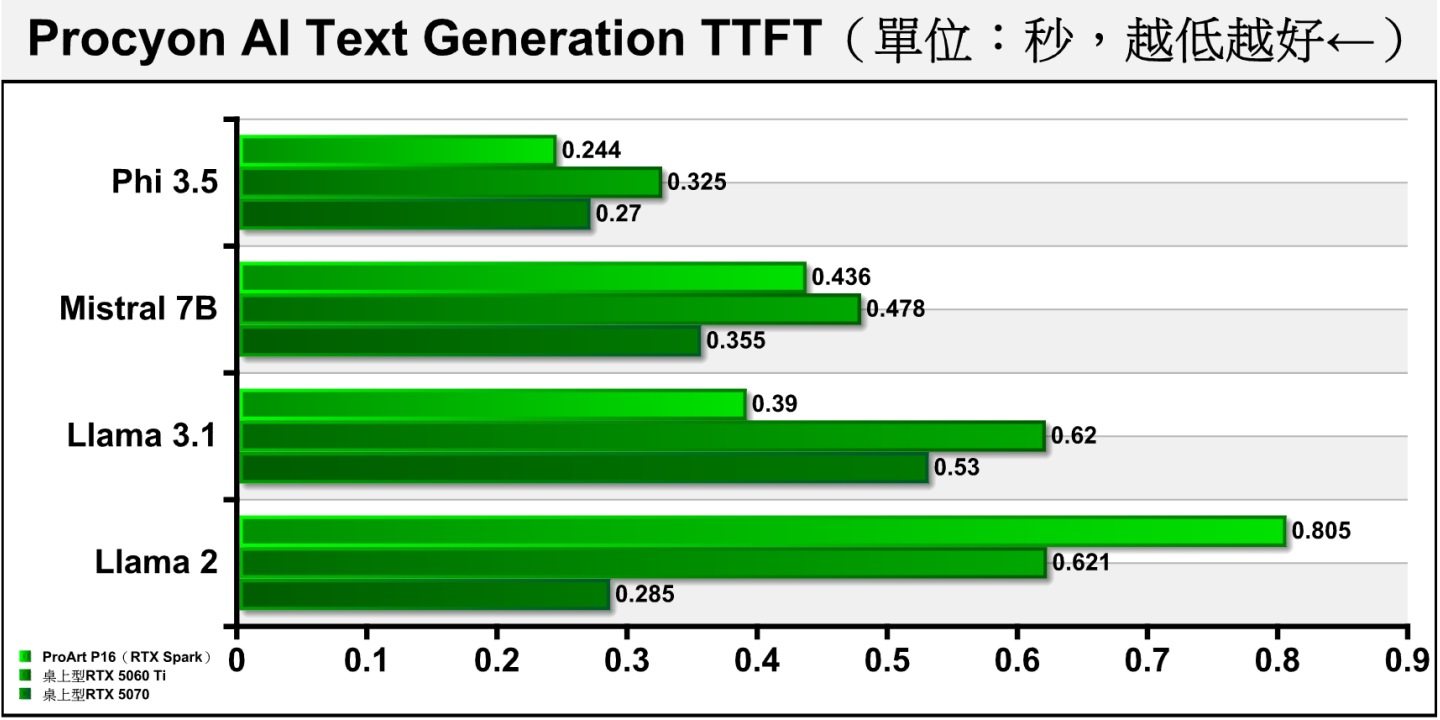
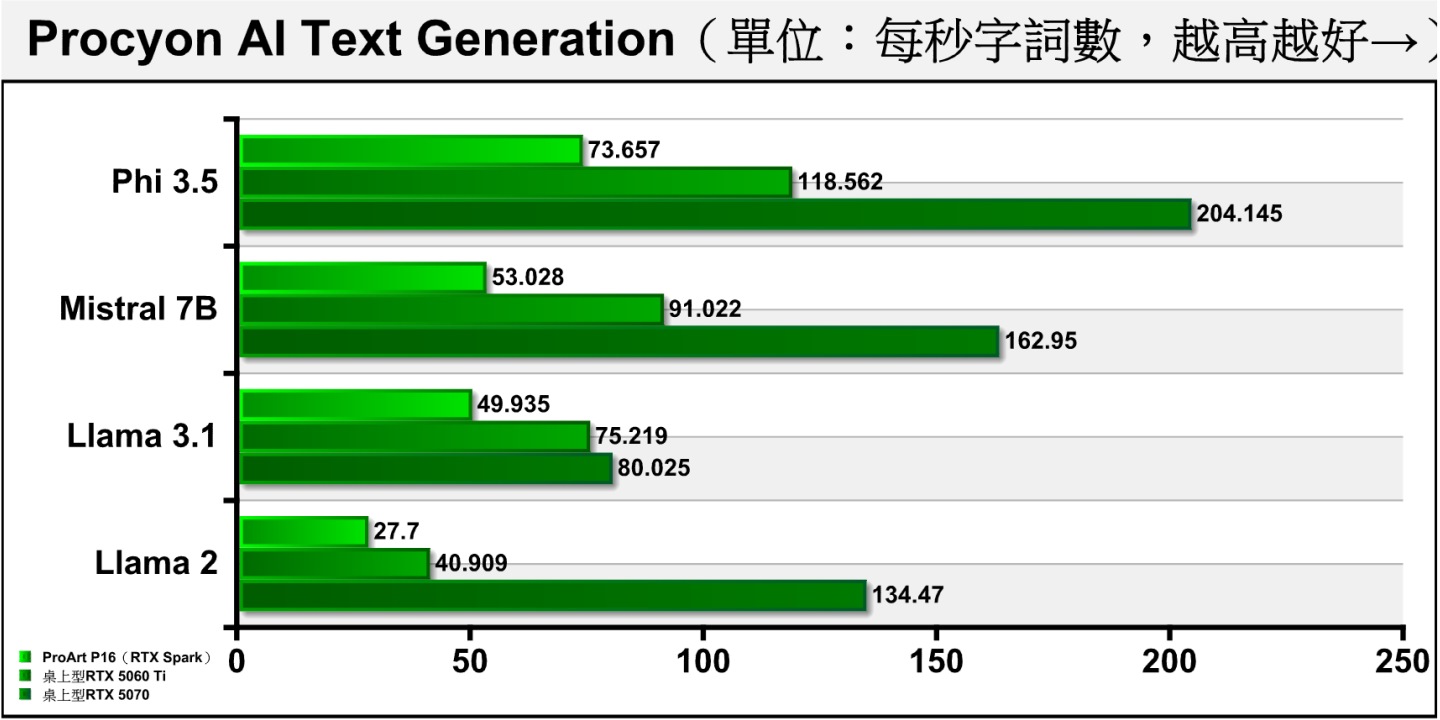
在Procyon AI文字生成測試中,RTX Spark平台為TDP有限的筆記型電腦,筆者因工作時間有限而來不及與其他行動版平台相比,故與桌上型顯示卡之數據對照。

首個Token生成的TTFT時間方面,RTX Spark的表現大約落在桌上型RTX 5060 Ti 與RTX 5070之間,延遲表現不錯。

在Token的生成速度部分,雖然不及桌上型顯示卡,但仍有每秒27.7~73.657組Token的速度,能夠滿足許多本機AI推論的需求。

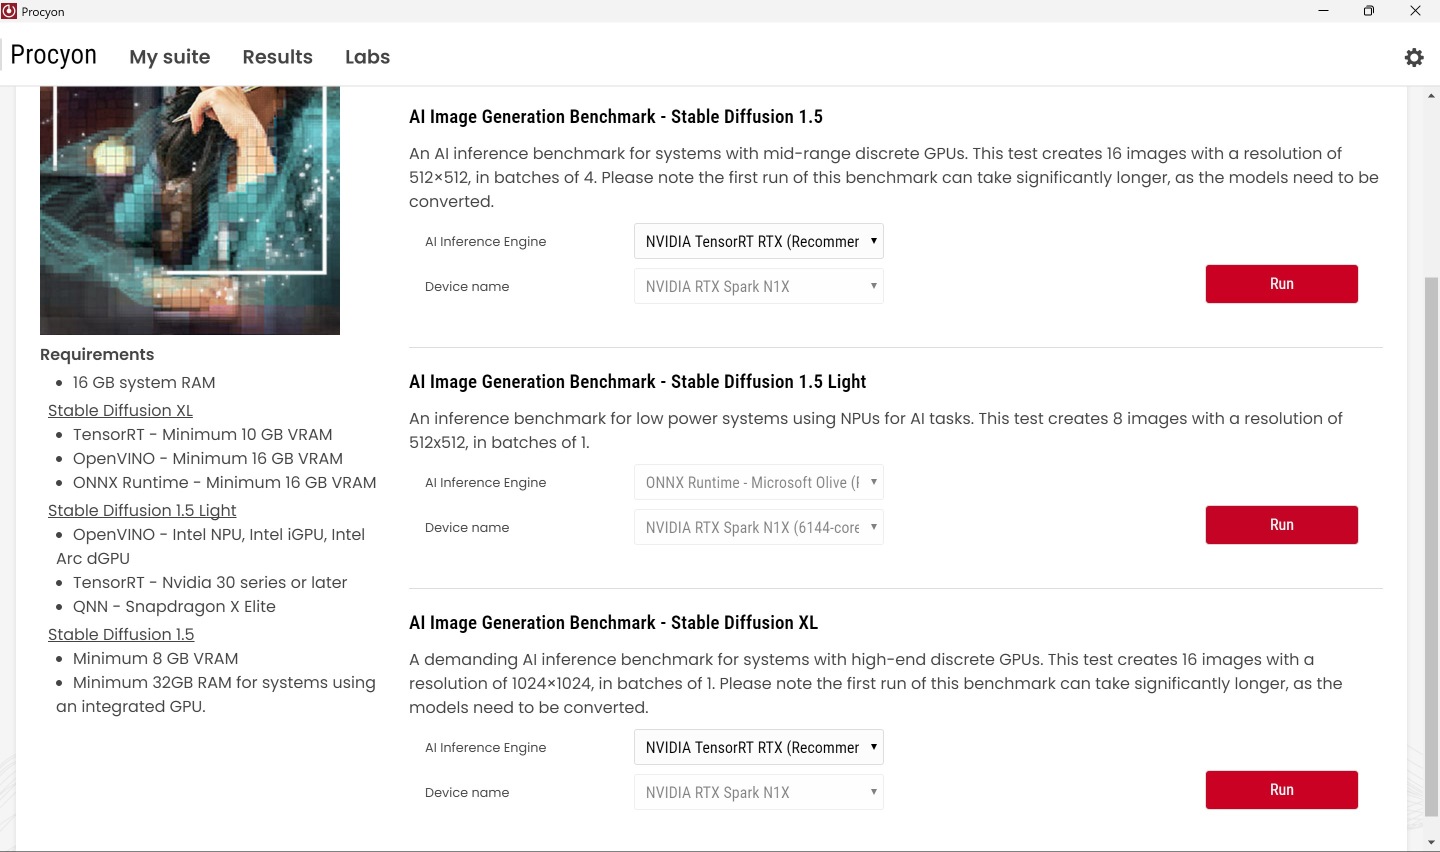
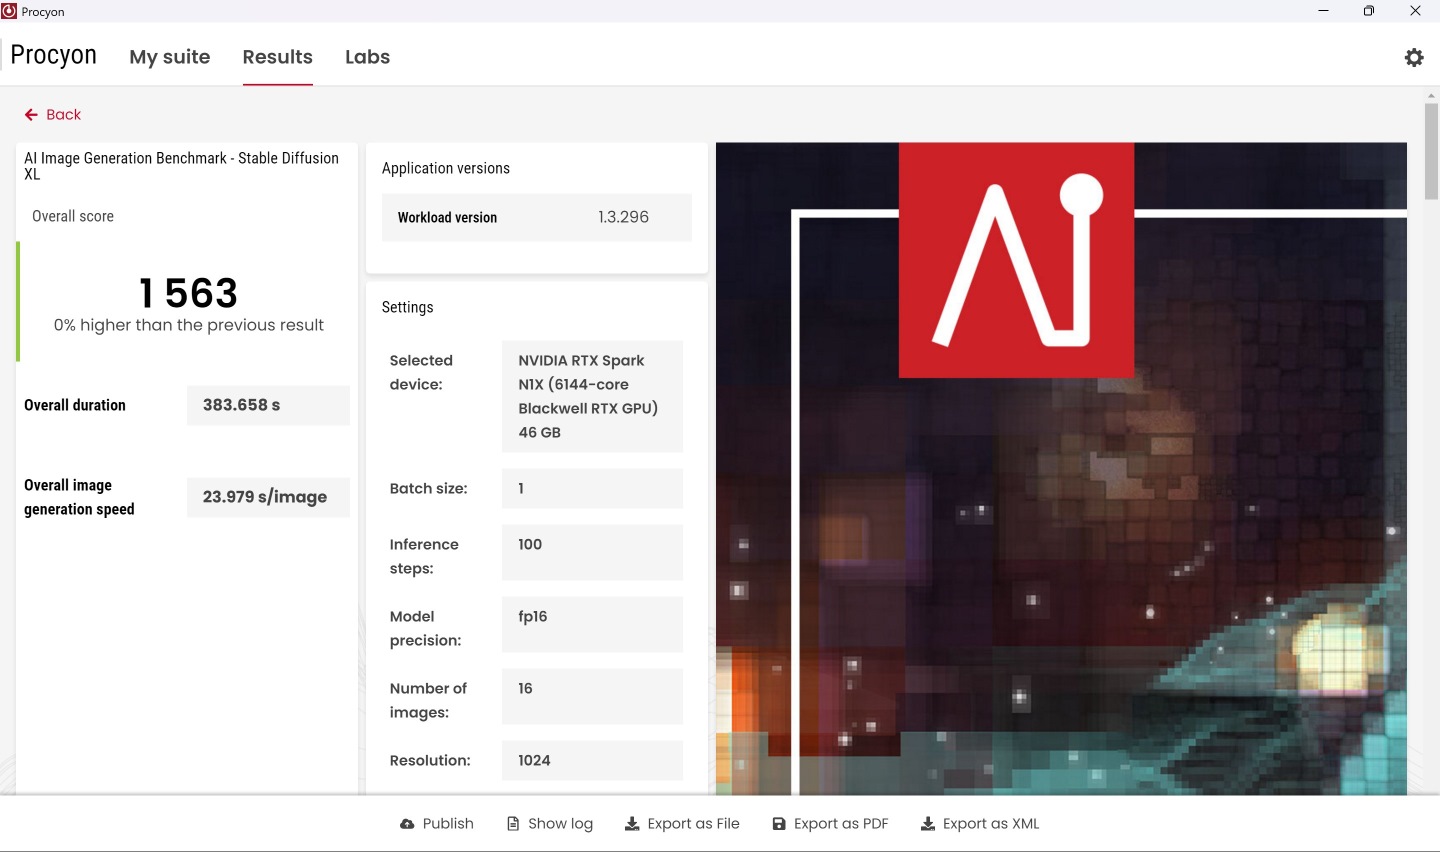
Procyon 提供Stable Diffusion 1.5、Stable Diffusion 1.5 Light、Stable Diffusion XL等3種不同負荷的AI圖像生成測試項目。

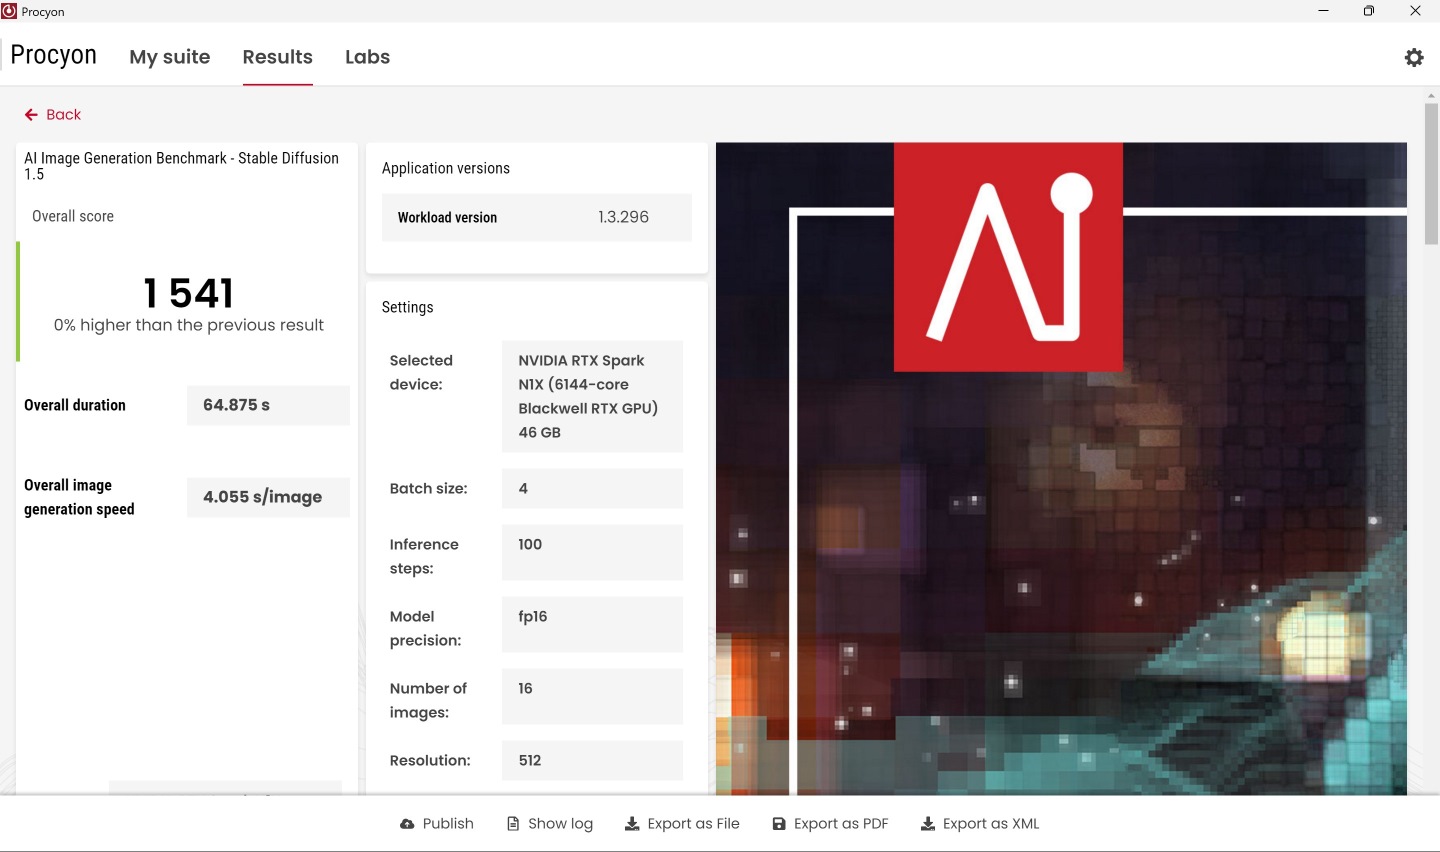
Stable Diffusion 1.5會進行4批次同時生成4張512 x 512的圖片測試(共16張),RTX Spark在2輪測試中,平均速度為每4.057秒生成1張圖片。

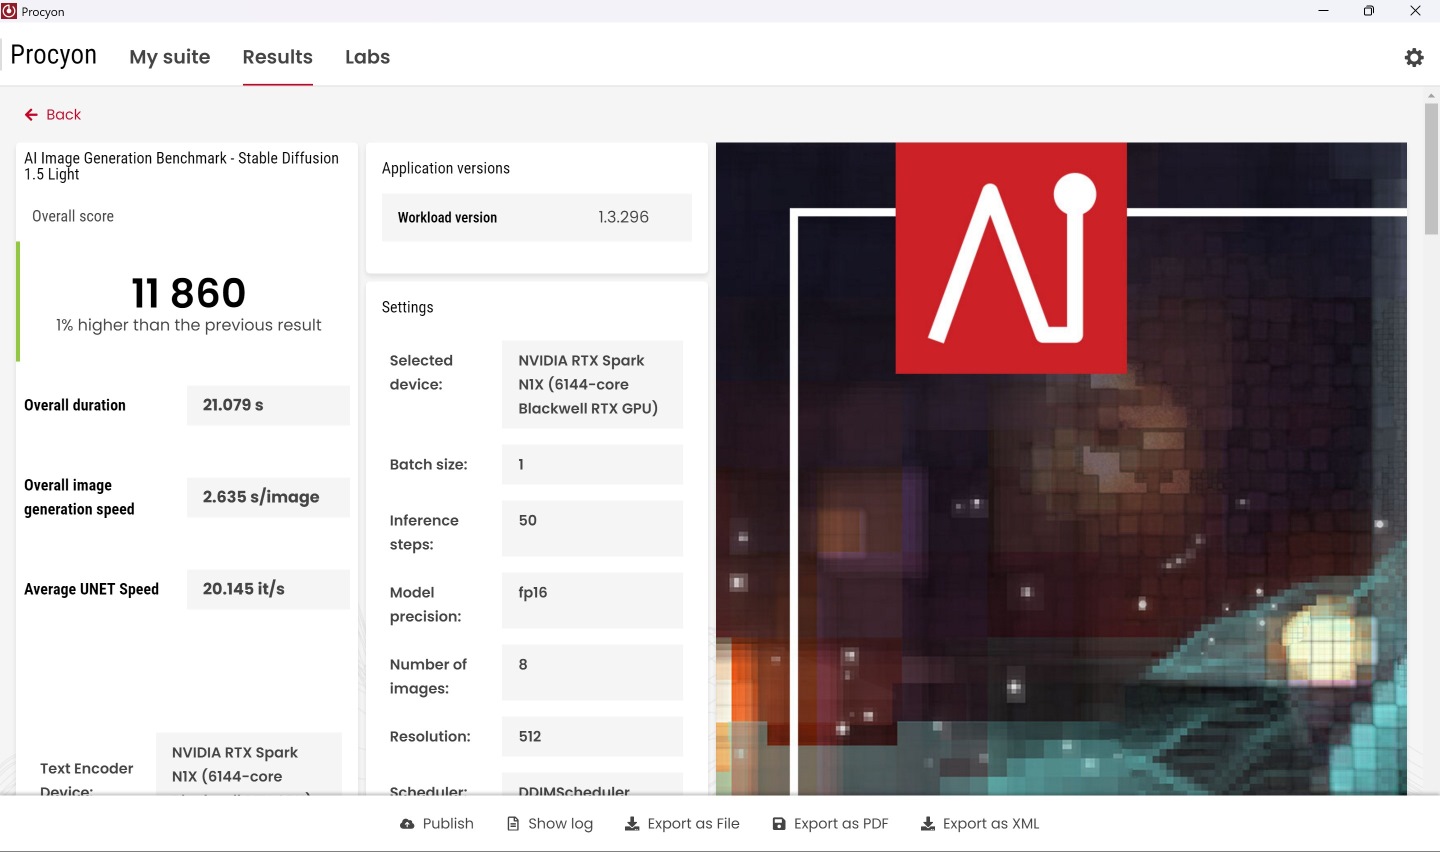
Stable Diffusion 1.5 Light分8次進行單次生成1張解析度為512 x 512的圖片(共8張),平均速度為每2.65秒生成1張圖片。

Stable Diffusion XL則是16次進行單次生成1張解析度為1024 x 1024的圖片(共16張),平均速度為每24秒生成1張圖片。

(下頁還有更多效能測試數據分析)

處理器運算效能與3DMark測試

在接下來的段落中,筆者將針對RTX Spark平台的處理器效能進行測試,並搭配3DMark驗證理論遊戲效能。由於PCMark 10與部份測試工具目前不支援Arm64架構處理器,故無進行此項目的測試。

需要注意的是,RTX Spark能夠支援包含DLSS在內的GeForce RTX功能,但因3DMark目前尚無法正常執行DLSS測試,而暫無測試成績。

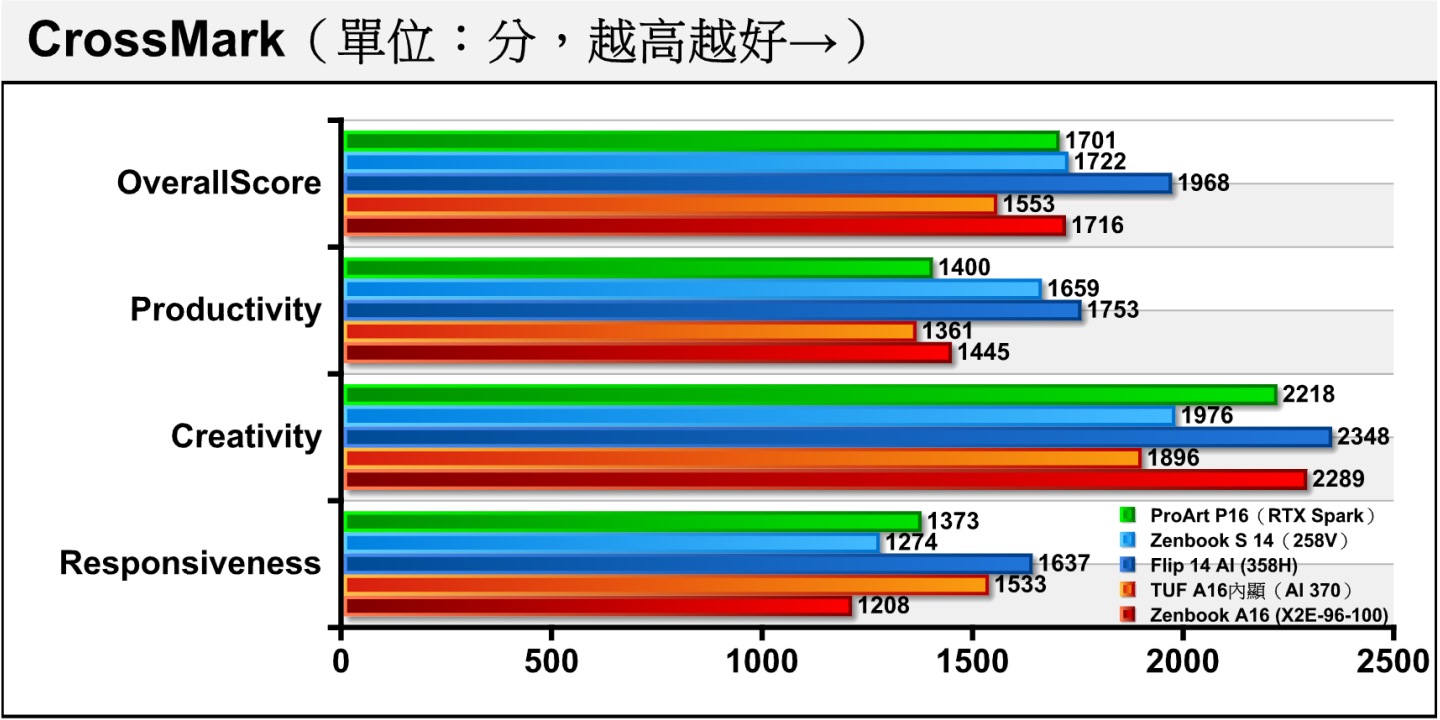
由於RTX Spark平台無法執行PCMark 10測試,故以CrossMark驗證綜合效能表現。整體表現與同為Arm64架構處理器的Snapdragon X2 Elite Extreme X2E-96-100 SoC接近。

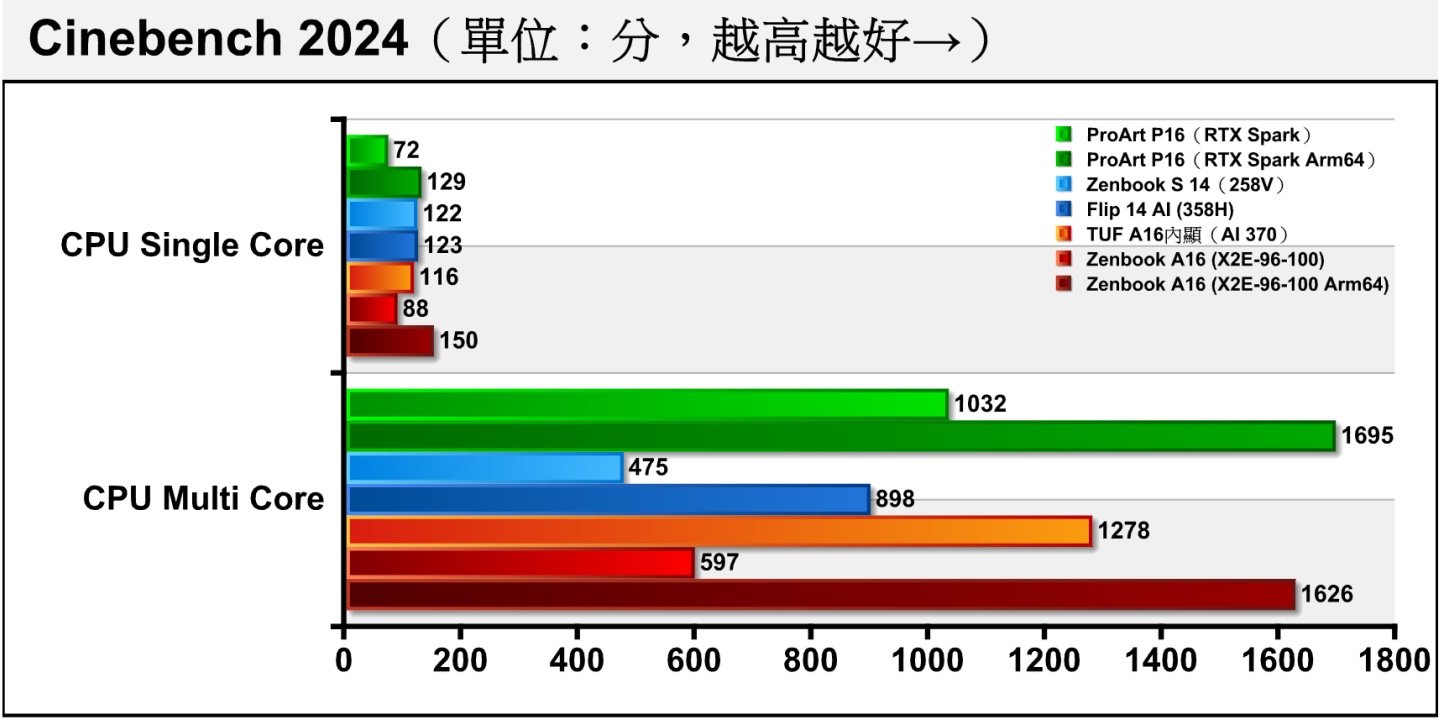
在Cinebench 2024處理器渲染測試中,筆者分別以x64與Arm64版本程式對RTX Spark進行測試,單核心的部分落後X2E-96-100約14%,多核心則領先4.24%。

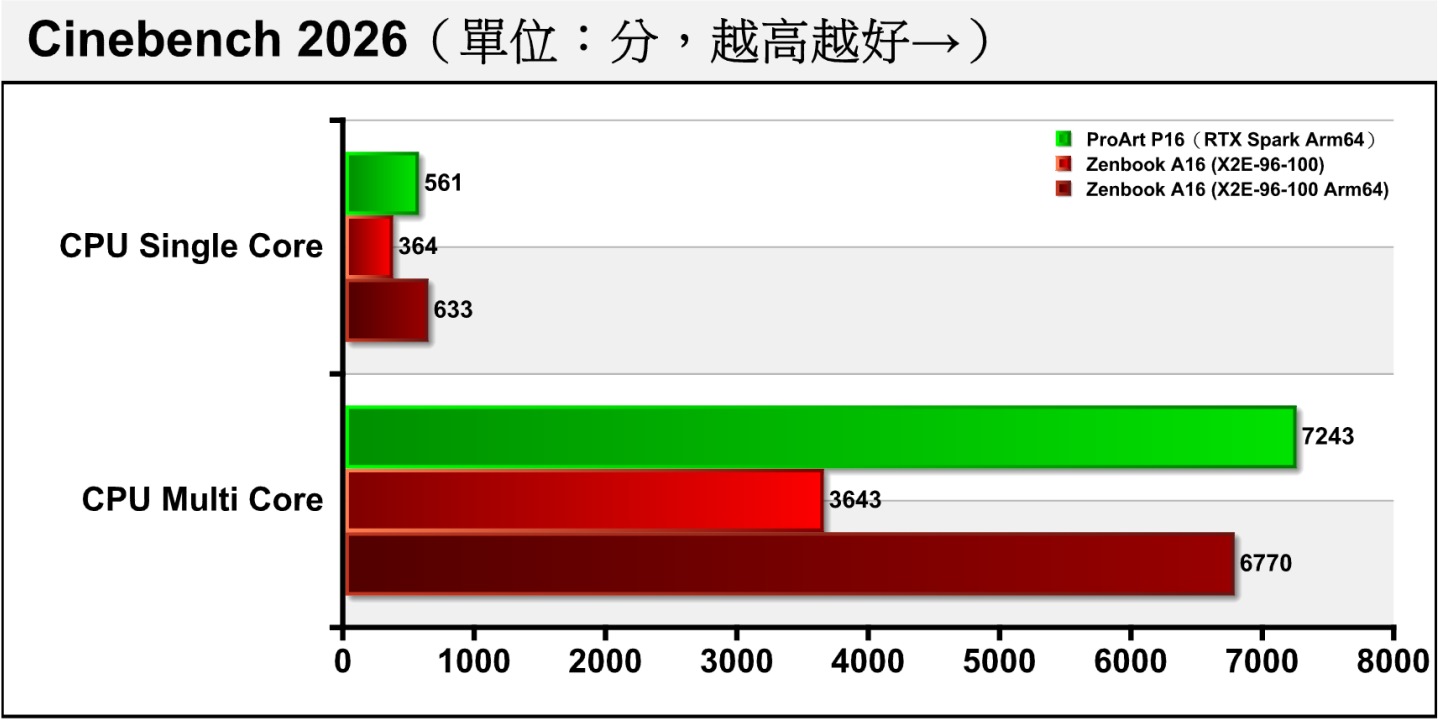
因RTX Spark無法執行x86版本Cinebench 2026,故僅進行Arm64版本測試。單、多核心與X2E-96-100相比分別落後9.95%、領先6.98%。

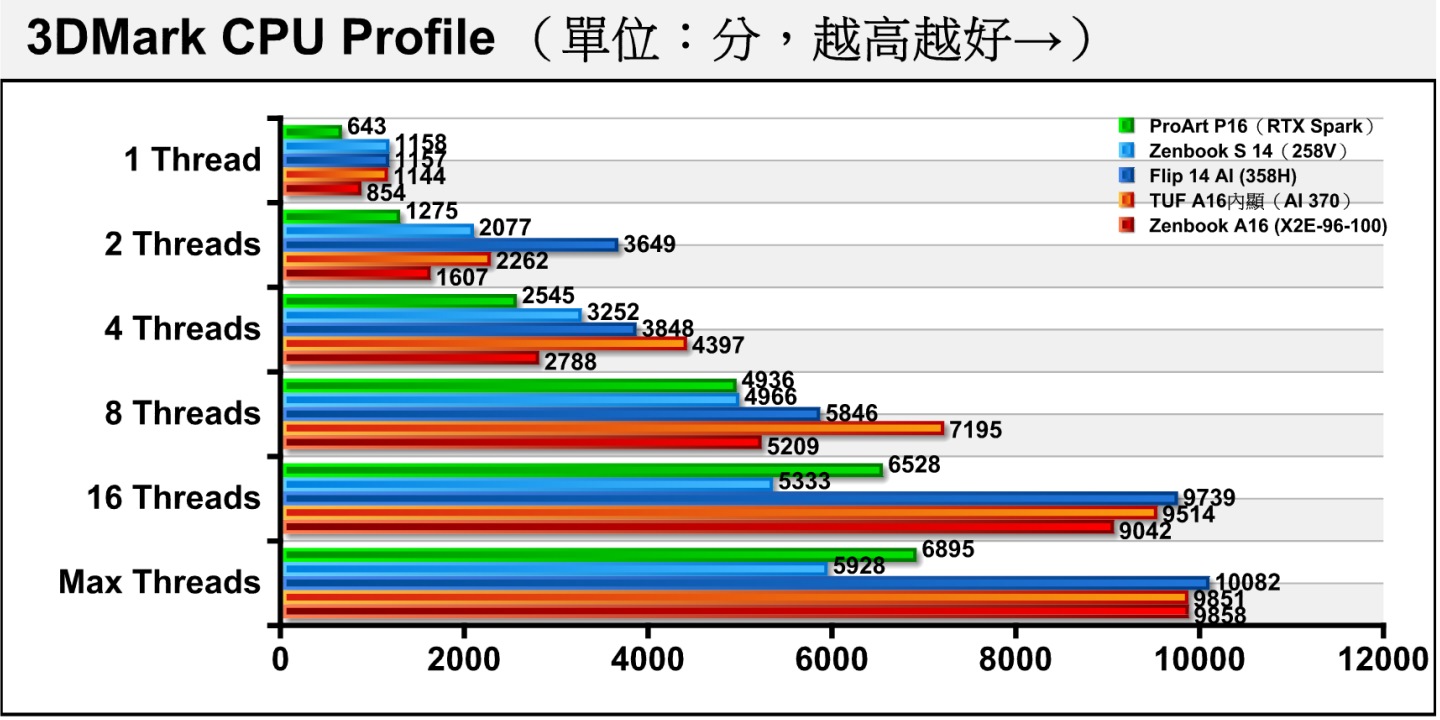
3DMark CPU Profile處理器多工測試能夠看出同處理器在不同負載的效能表現。由於測試使用x64架構,RTX Spark平台在經過Prism模擬器損失較多效能,故表現較為落後。

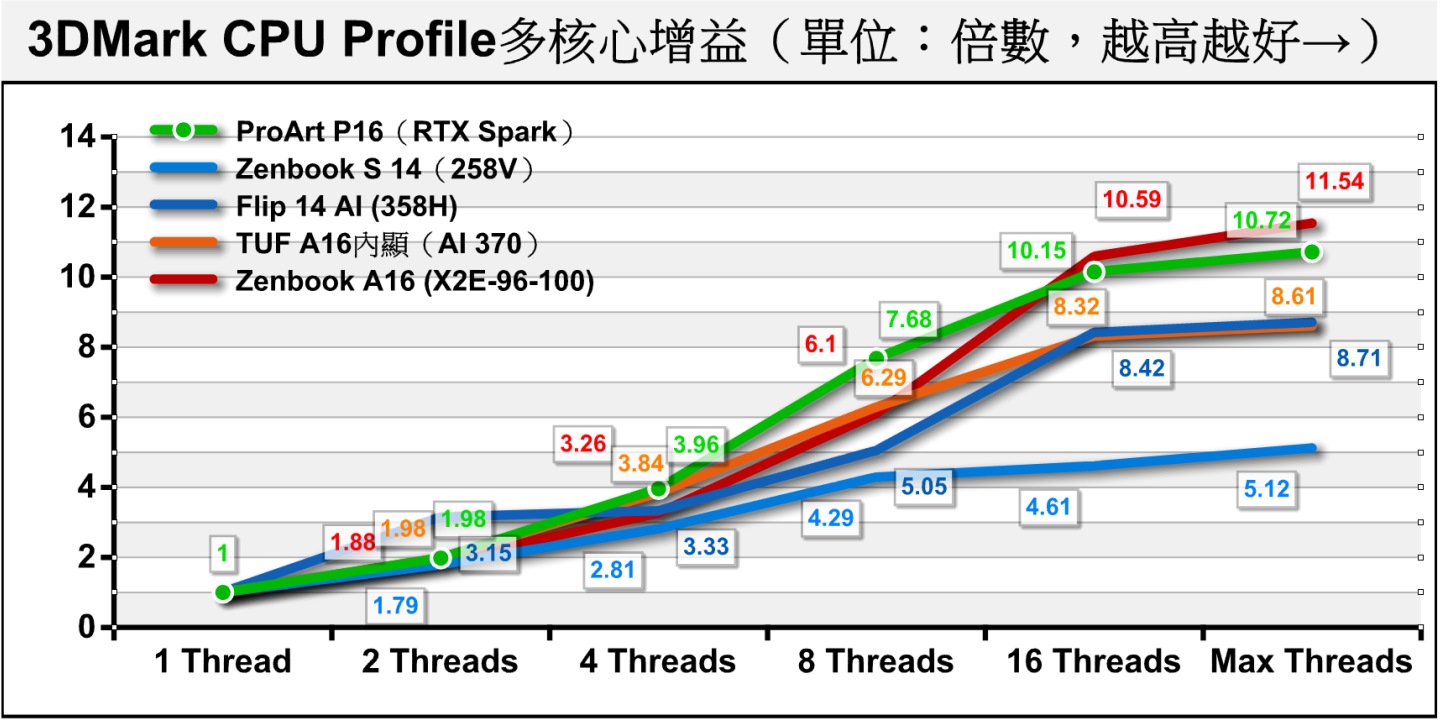
看到多核心增益部分,具有Arm Cortex-X925與Arm Cortex-A725核心各10組的RTX Spark在Max Threads(最高執行緒)的部分能夠輸出單執行緒的10.72效能,考量到大、小核的差異與電力預算,表現不算太差。

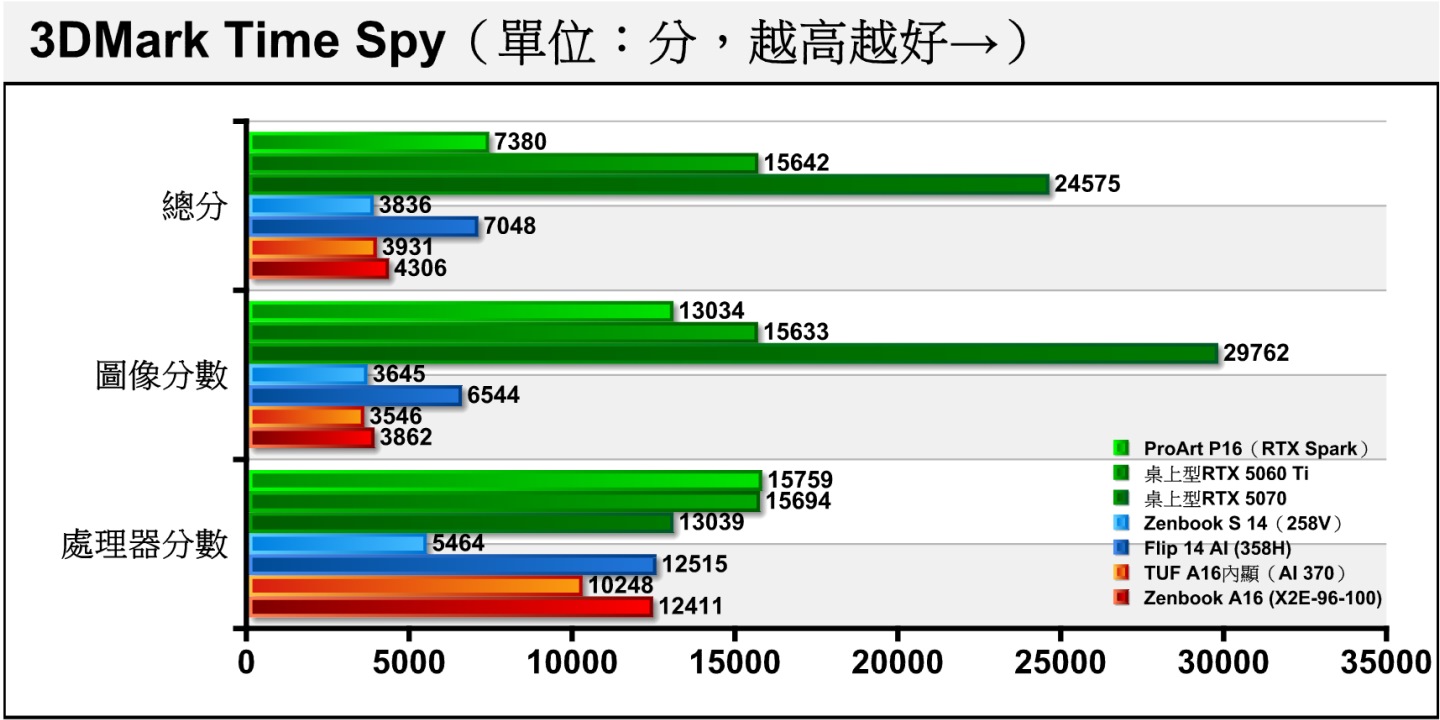
在3DMark部分先看到採用Direct X 12搭配2K解析度的Time Spy,RTX Spark的表現雖然明顯落後桌上型電腦平台,但是受益於較強的內建顯示晶片,表現仍領先Qualcomm  X2 Elite Extreme X2E-96-100。

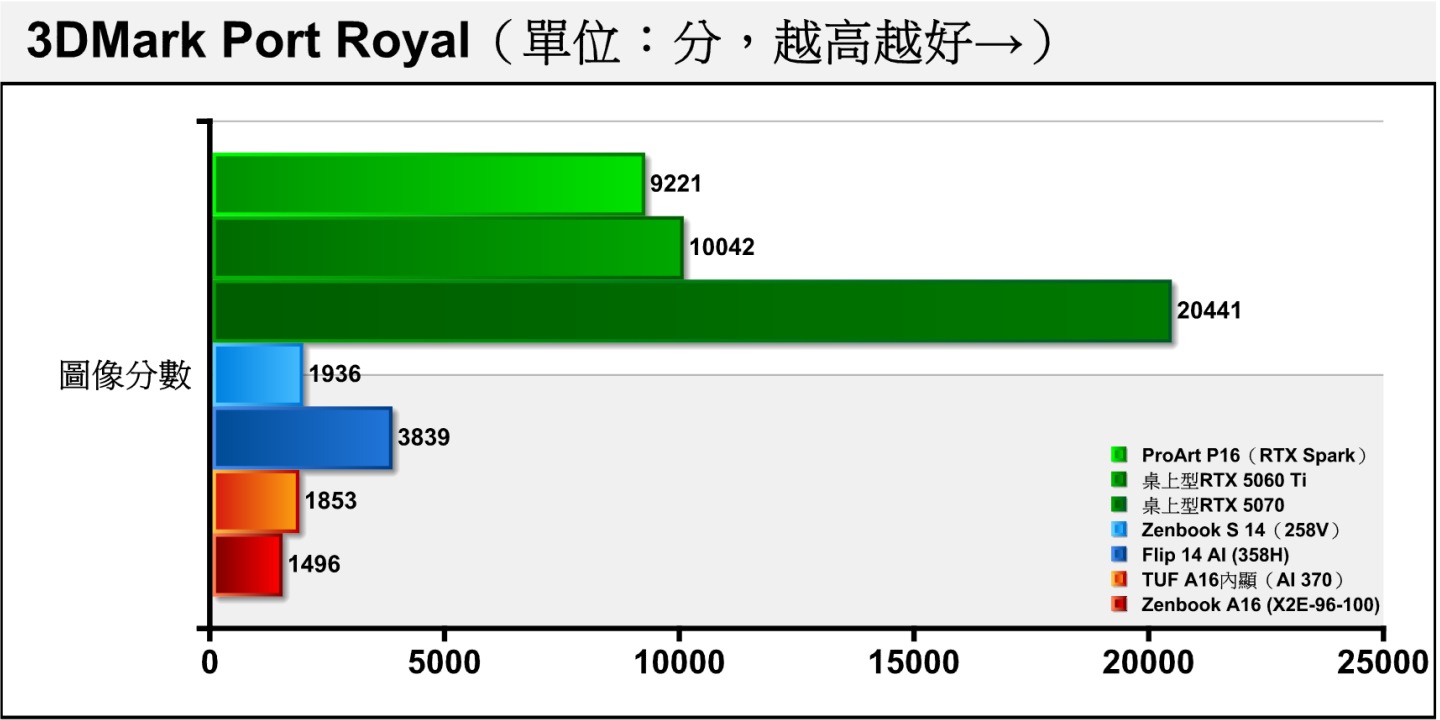
3DMark Port Royal採用DirectX Raytracing(DXR)光線追蹤繪圖技術搭配2K解析度,RTX Spark的表現輕鬆領先Intel Core Ultra X7 358H與X2E-96-100數倍。

3DMark Solar Bay採用Vulkan繪圖API搭配2K解析度,並會使用光線追蹤,但整體負載偏輕,適合應用於行動裝置。具有規模更大內建顯示晶片的RTX Spark同樣遙遙領先。

Speed Way是採用DirectX 12 Ultimate繪API與DirectX Raytracing tier 1.1光線追蹤技術,具有全域照明與反射等效果,並透過Mesh Shaders進行效能最佳化,可以反映最新AAA大作遊戲的效能表現。RTX Spark以3倍以上的成績領先X7 358H。

Steel Nomad採用DirectX 12繪圖API搭配4K解析度,雖然不使用光線追蹤技術,但仍具有較高的繪圖運算負載。RTX Spark同樣輕騎過關。

遊戲效能測試

接下來我們繼續分析RTX Spark平台實際執行遊戲的效能表現,驗證是否能帶來流暢的遊戲體驗。

競技類的《絕對武力2》對於處理器的運算延遲比較敏感,造成RTX Spark平台即便有較佳的顯示效能,也被處理器效能瓶頸(CPU Bound)限制。所幸在2880 x 1800解析度下平均FPS仍有85.7幀,99% FPS也達到52.05,尚能帶來流暢與靈敏的遊戲體驗。

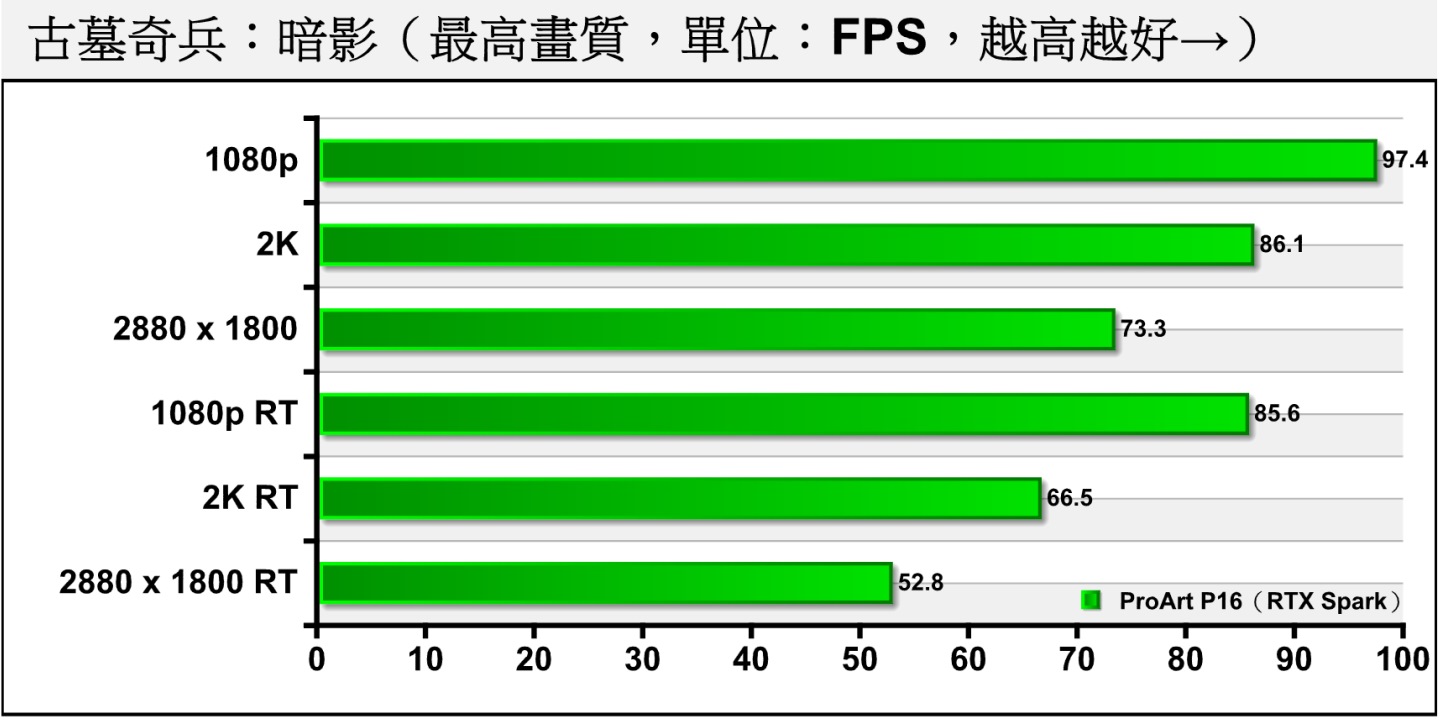
《古墓奇兵:暗影》開啟光線追蹤後,RTX Spark在2880 x 1800解析度的平均FPS為52.8幀,略低於60幀門檻,可以透過G-Sync可變更新頻率功能補償視覺流暢度。

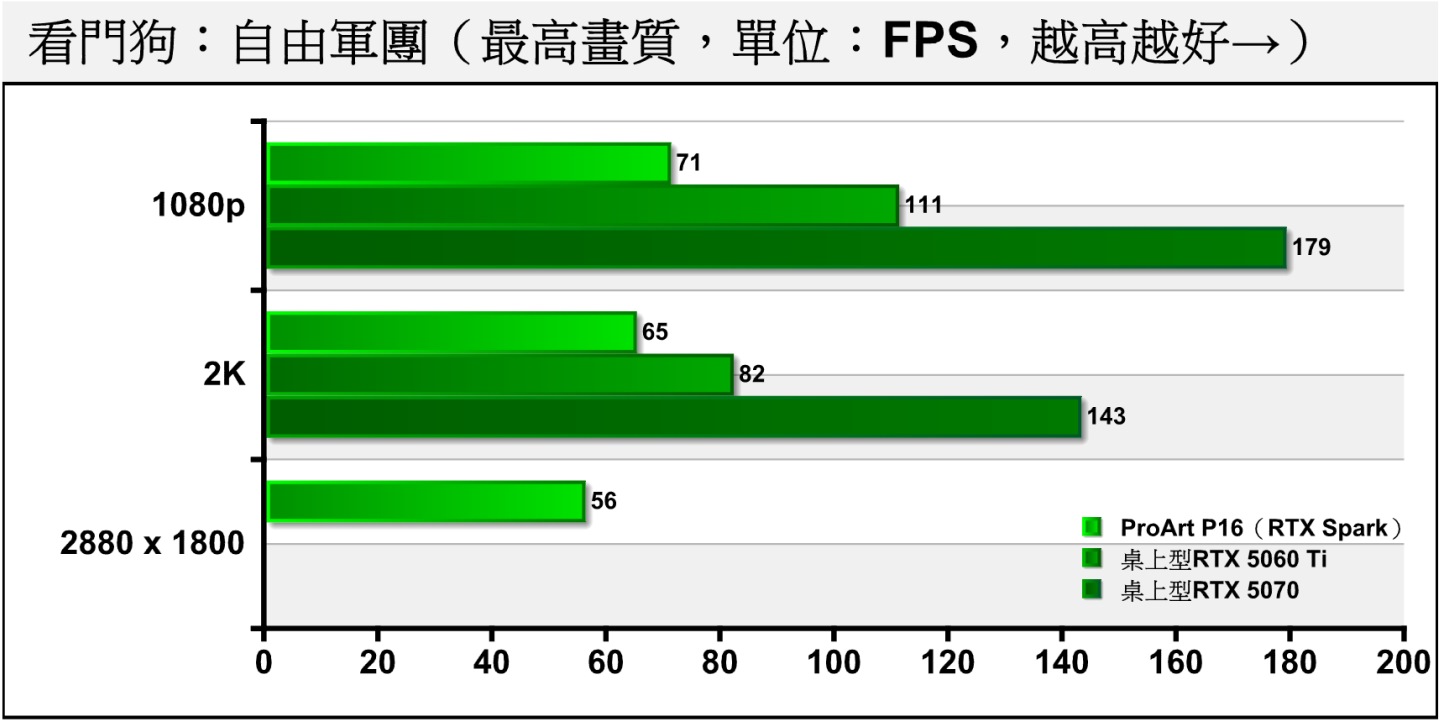
《看門狗:自由軍團》關閉光線追蹤時,RTX Spark在2880 x 1800解析度的平均FPS為56幀,可透過DLSS強化效能表現。

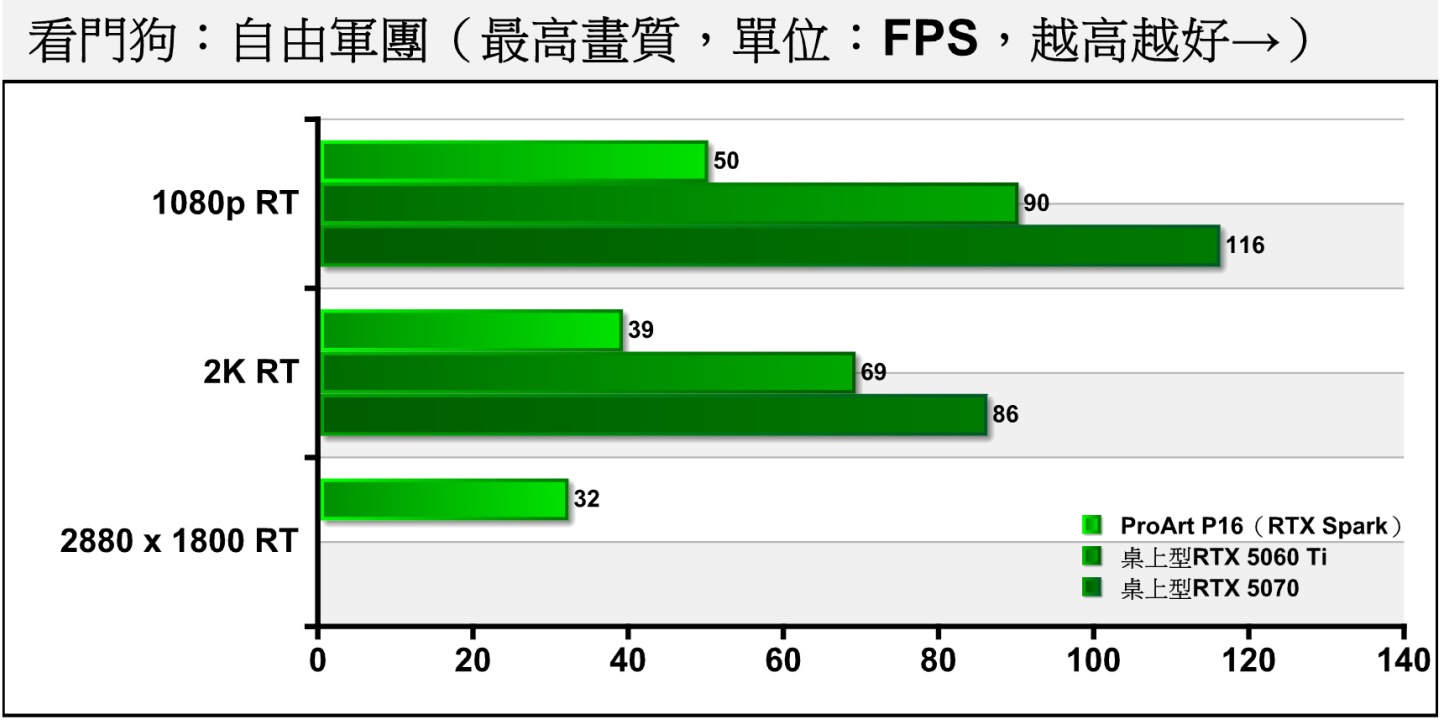
《看門狗:自由軍團》開啟光線追蹤後,平均FPS下滑至32幀,可以考慮調低部分畫質設定改善流暢度。

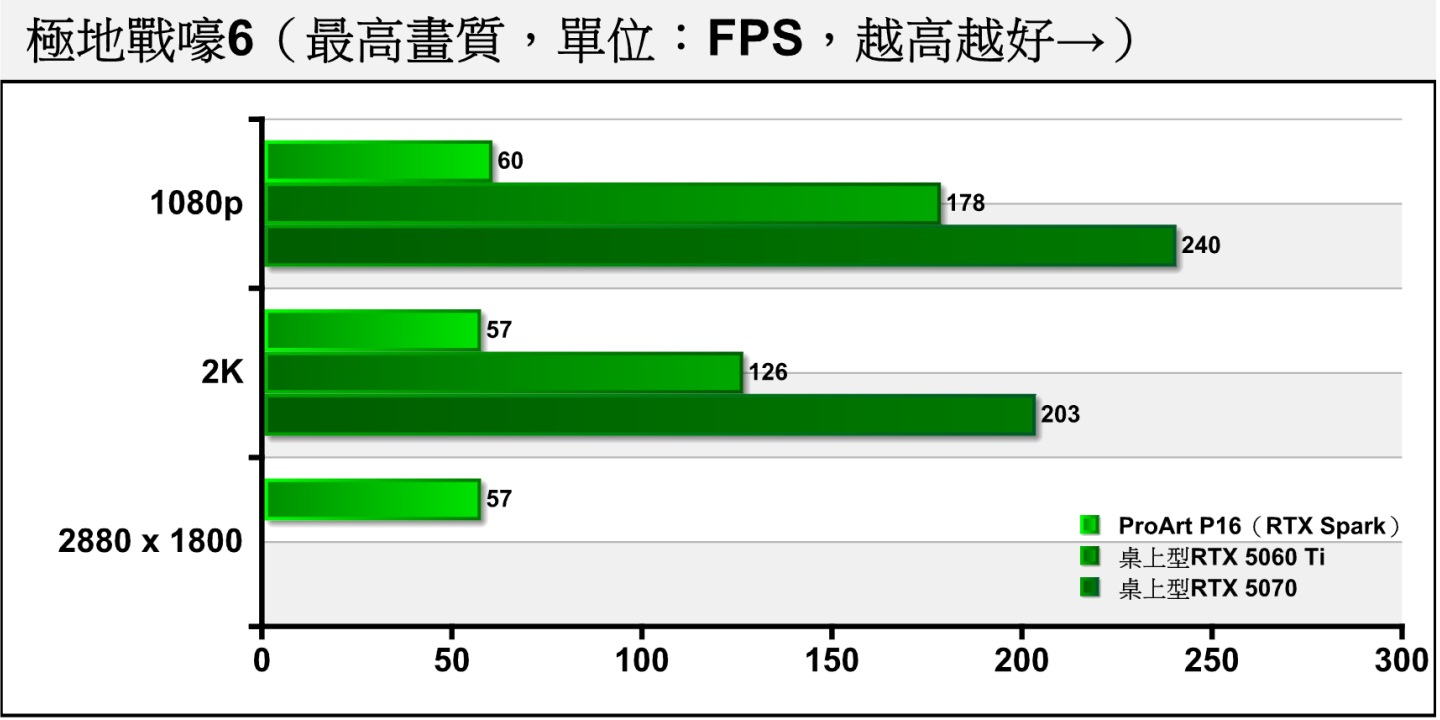
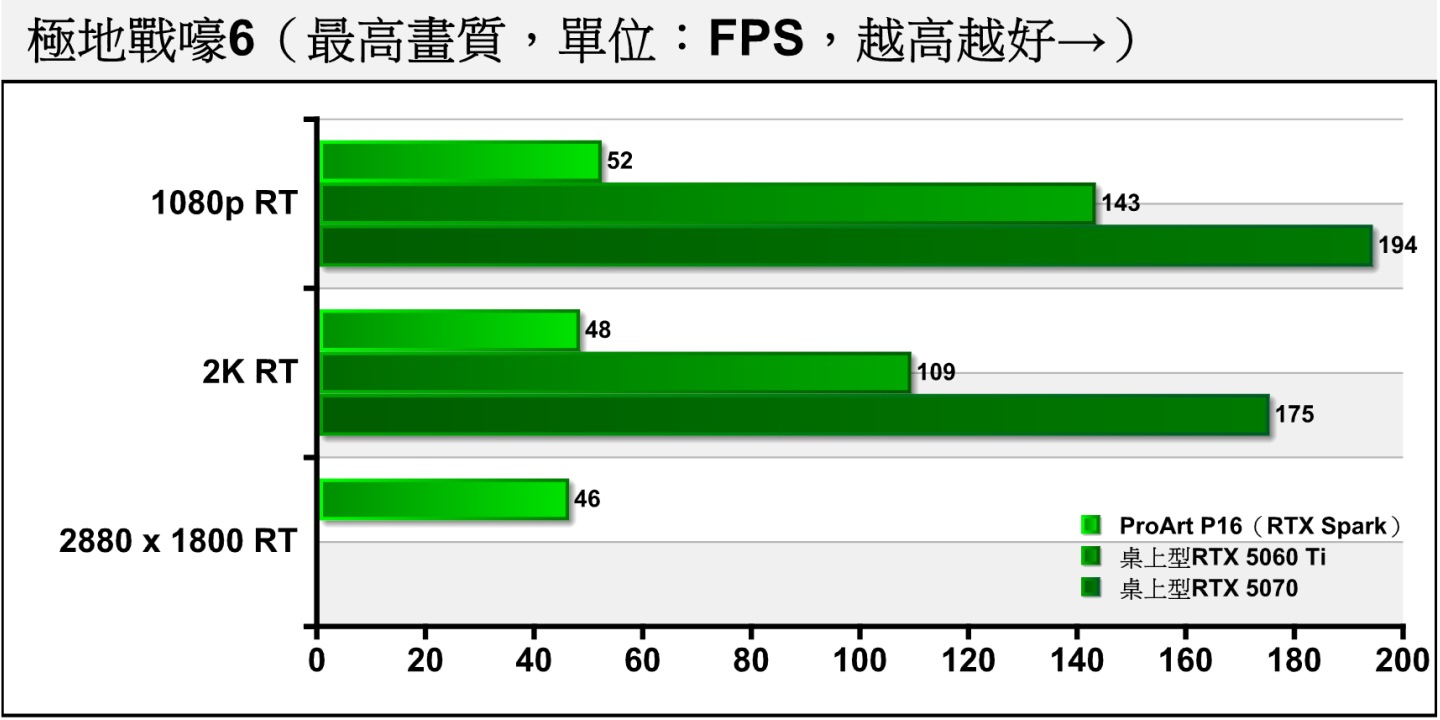
《極地戰嚎6》對處理器延遲也是相當敏感,可以看到3種解析度的平均FPS很接近,代表效能卡在處理器瓶頸。

《極地戰嚎6》開啟光線追蹤後,3種解析度的平均FPS差異也不大。

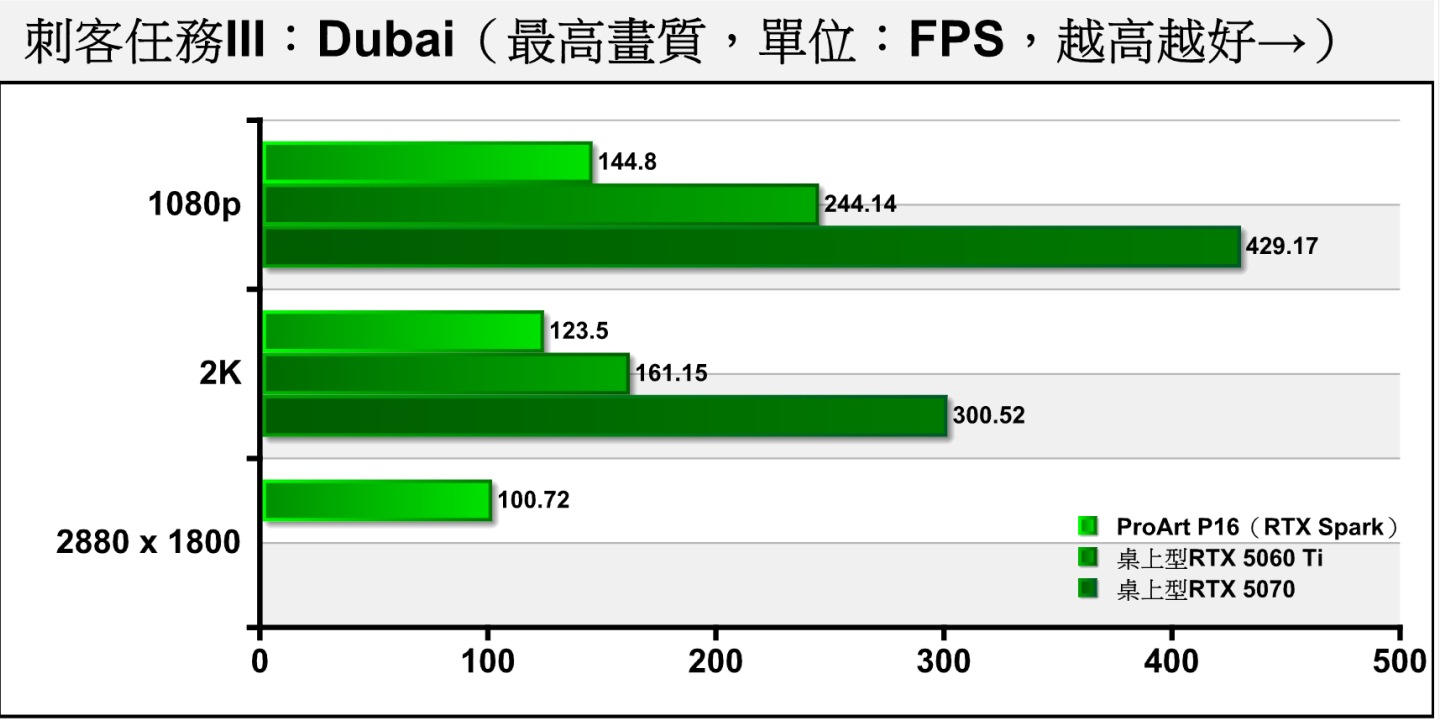
《刺客任務III》Dubai(杜拜)測試項目包含多種場景與NPC角色,整體負擔較低,RTX Spark在2880 x 1800解析度的平均FPS能夠衝上100.72幀。

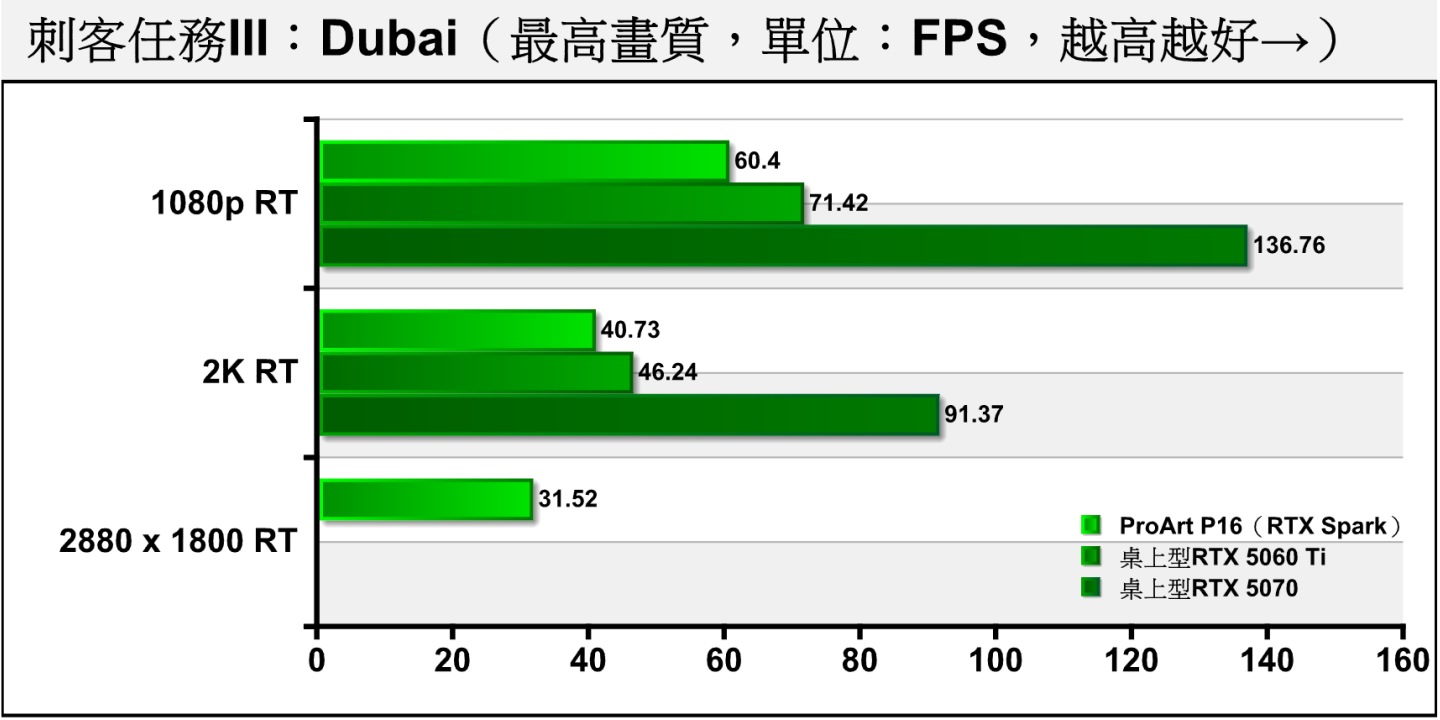
《刺客任務III》Dubai開啟光線追蹤後,平均FPS滑落至31.52幀,落差比較大。

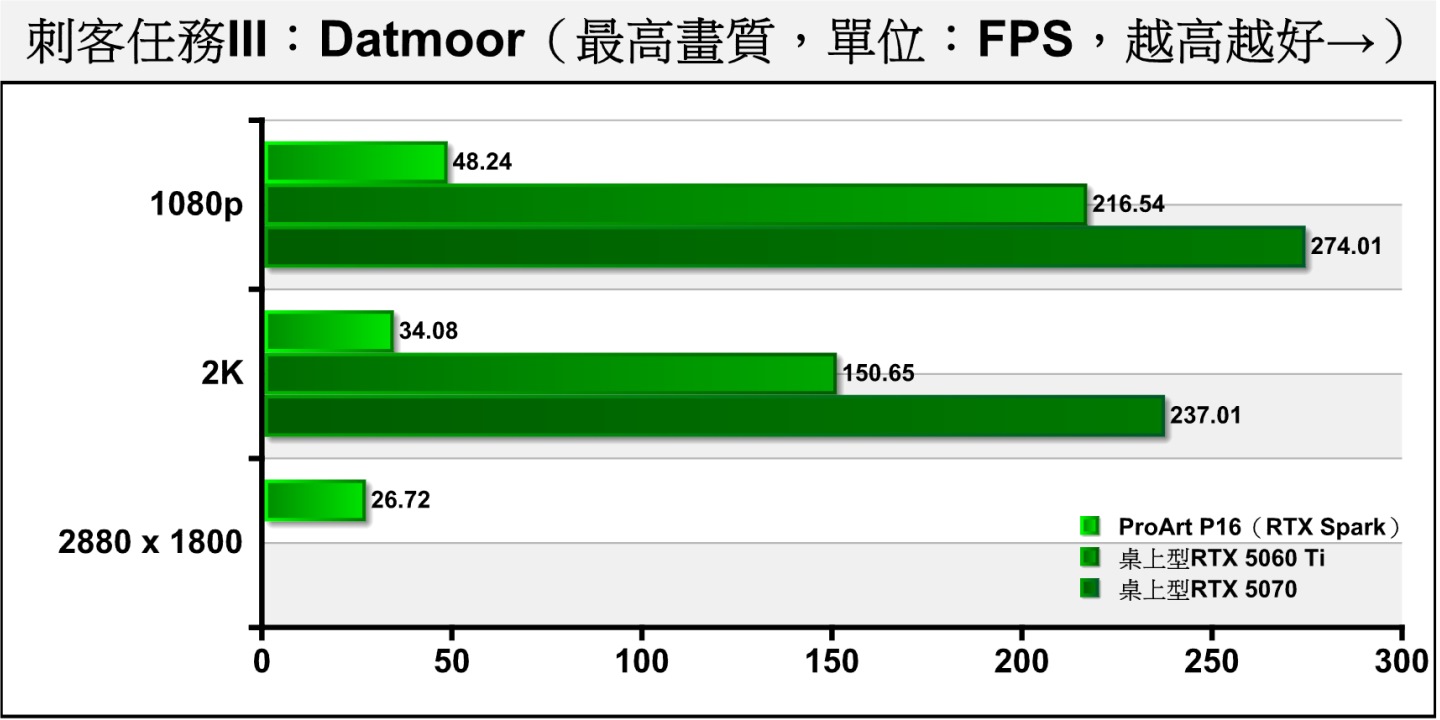
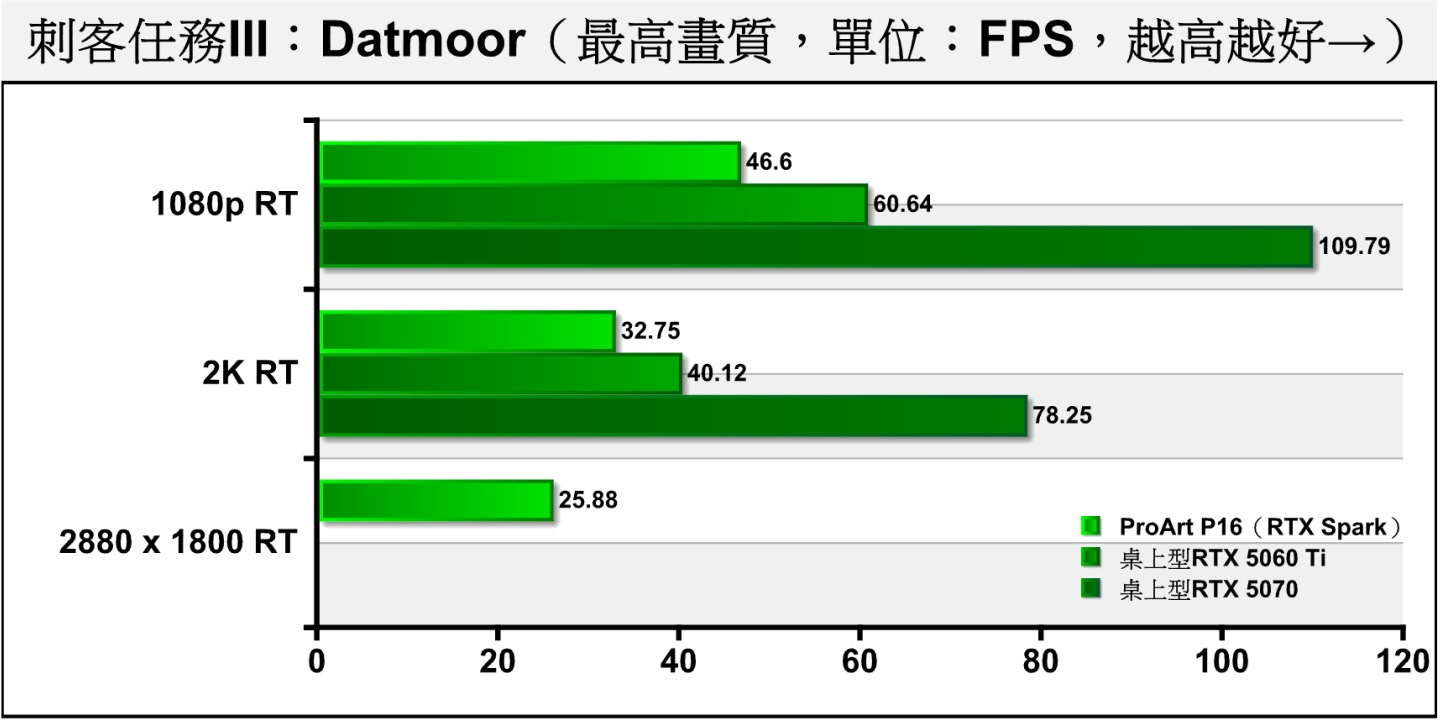
《刺客任務III》Dartmoor(達特穆爾)測試項目則包含許多槍枝射擊與爆炸效果,充滿物理與粒子模擬,對處理器的要求比較高,造成RTX Spark的表現不甚理想。

《刺客任務III》Dartmoor開啟光線追蹤後,RTX Spark的效能並沒有明顯降低,可見效能是被處理器瓶頸所限制。

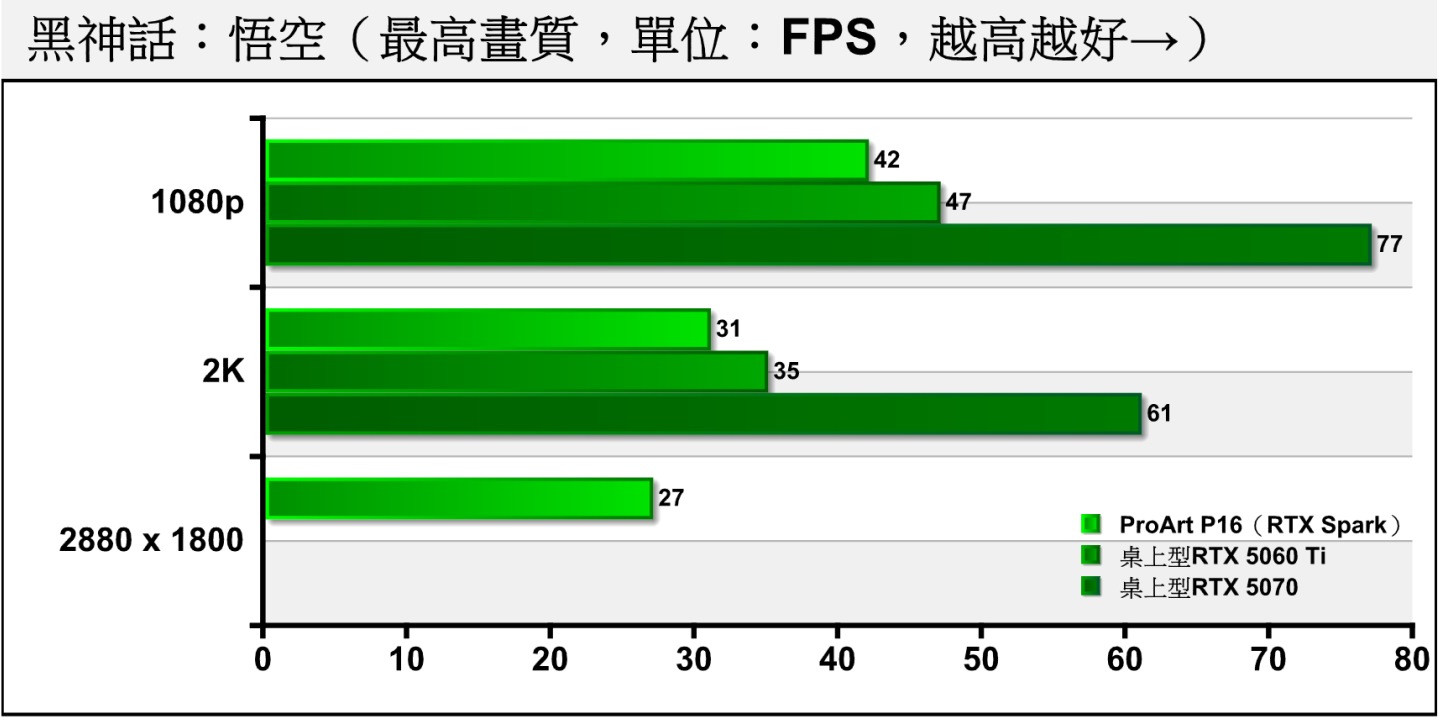
《黑神話:悟空》關閉光線追蹤時,RTX Spark在2880 x 1800解析度的平均FPS為27幀,可以透過DLSS超解析度與畫格生成提高FPS效能與流暢度表體驗。

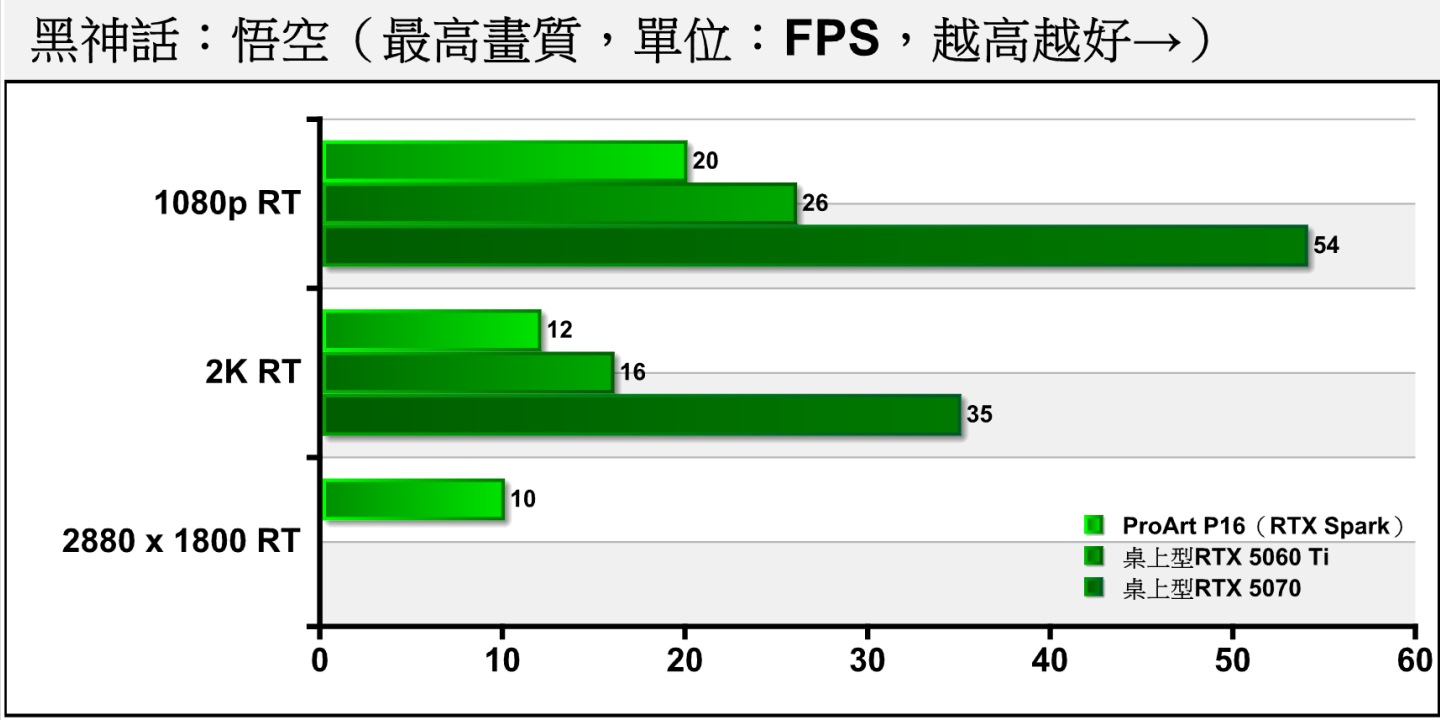
《黑神話:悟空》開啟光線追蹤後平均FPS降至10幀,建議關閉光線追蹤以達到比較流暢的視覺效果。

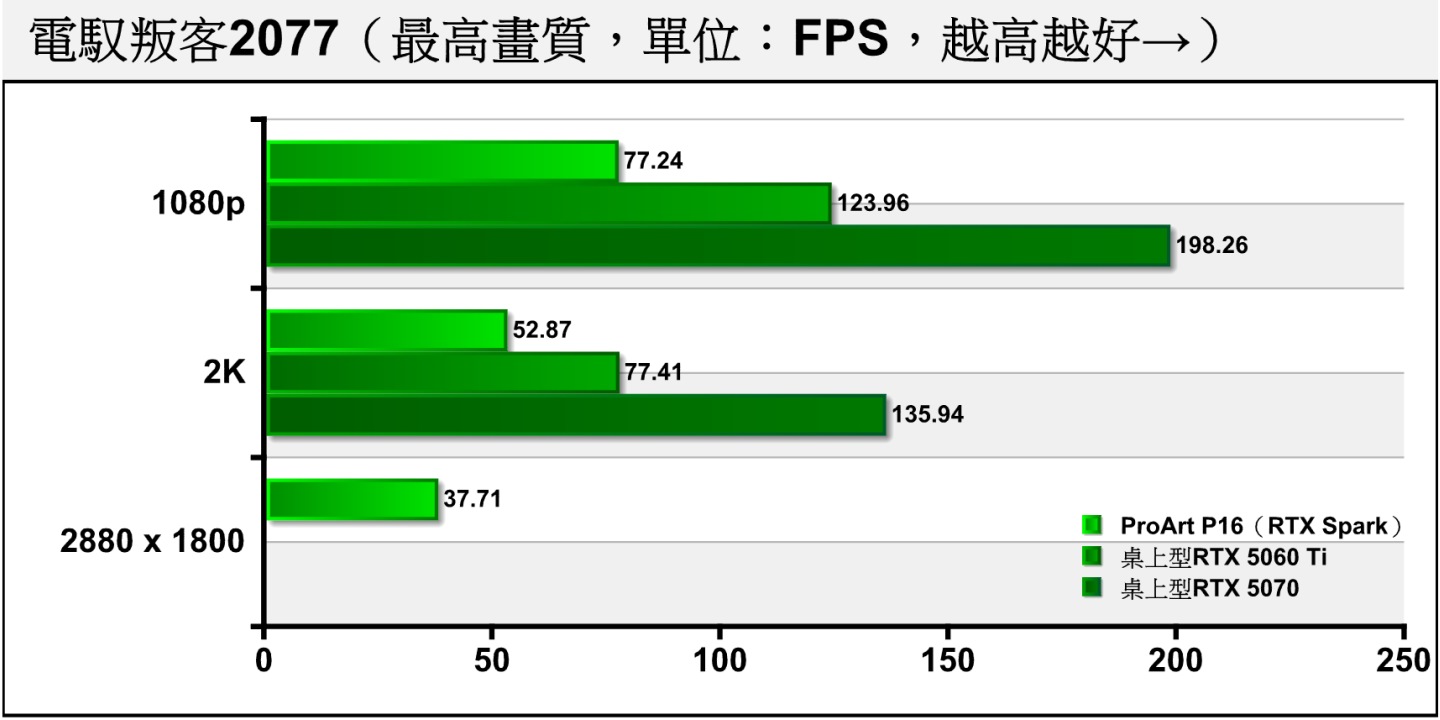
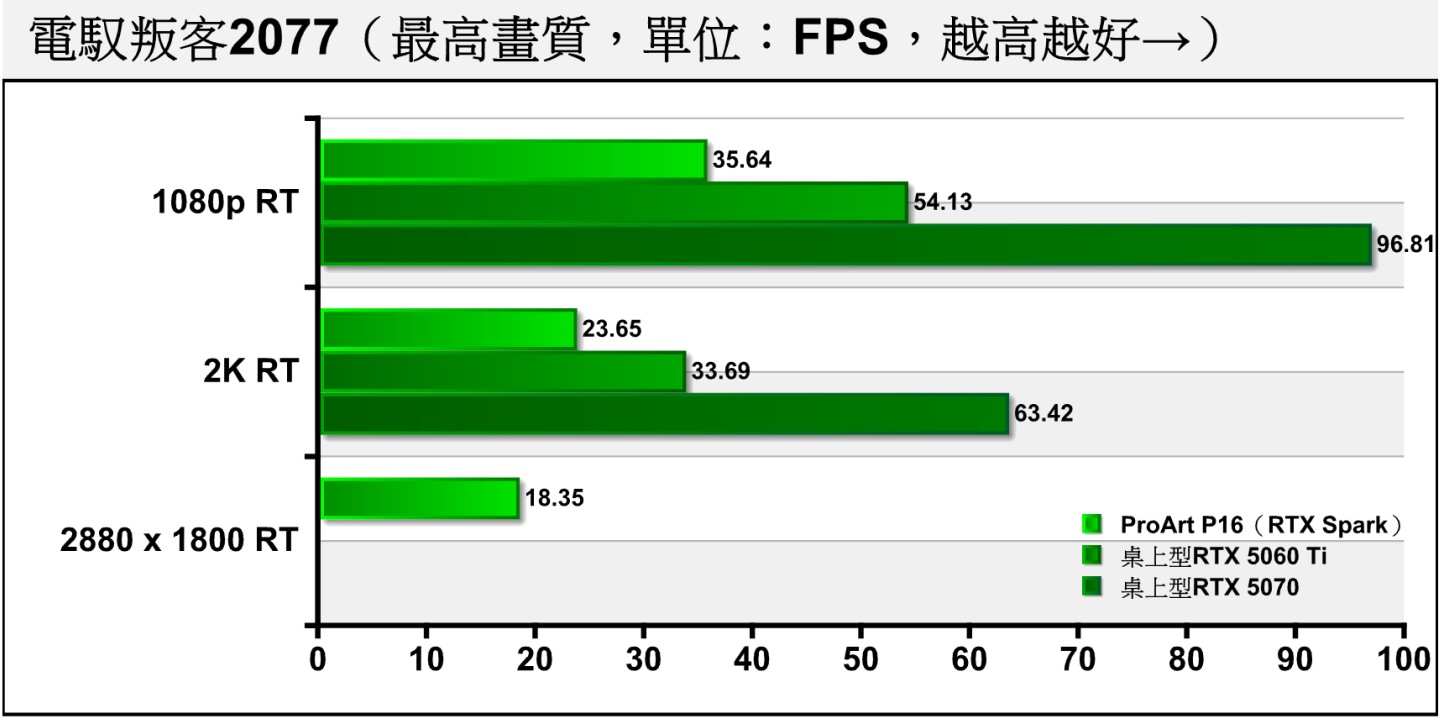
《電馭叛客2077》關閉光線追蹤時,RTX Spark的平均FPS為37.71幀,表現普普。

《電馭叛客2077》開啟光線追蹤後平均FPS降至18.35幀,接下來就是見證DLSS效能禁藥的時刻了!

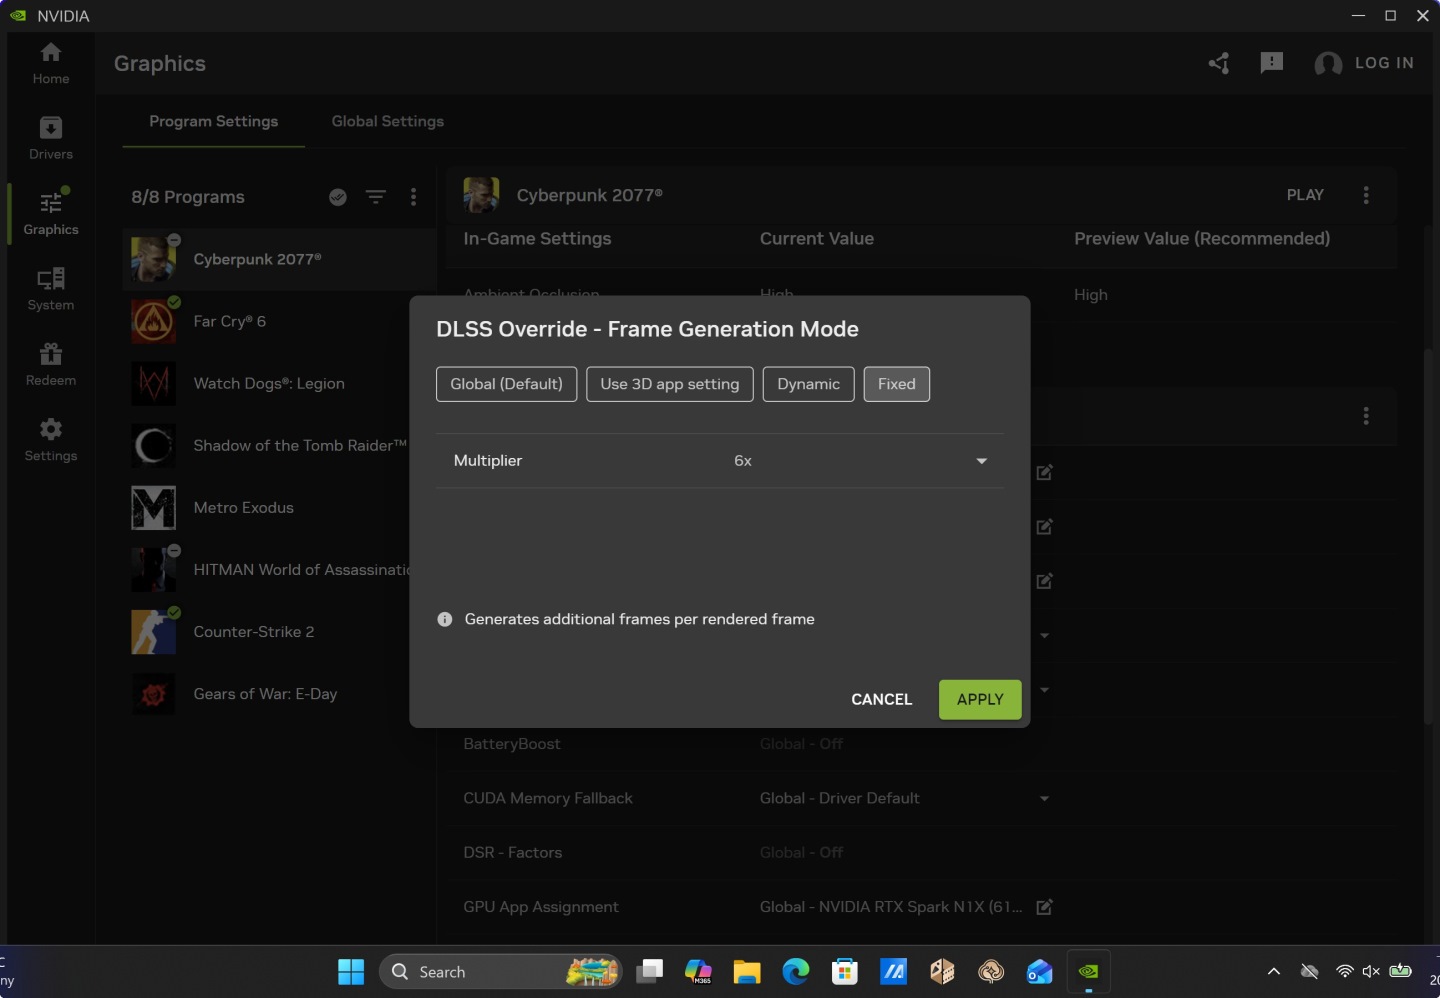
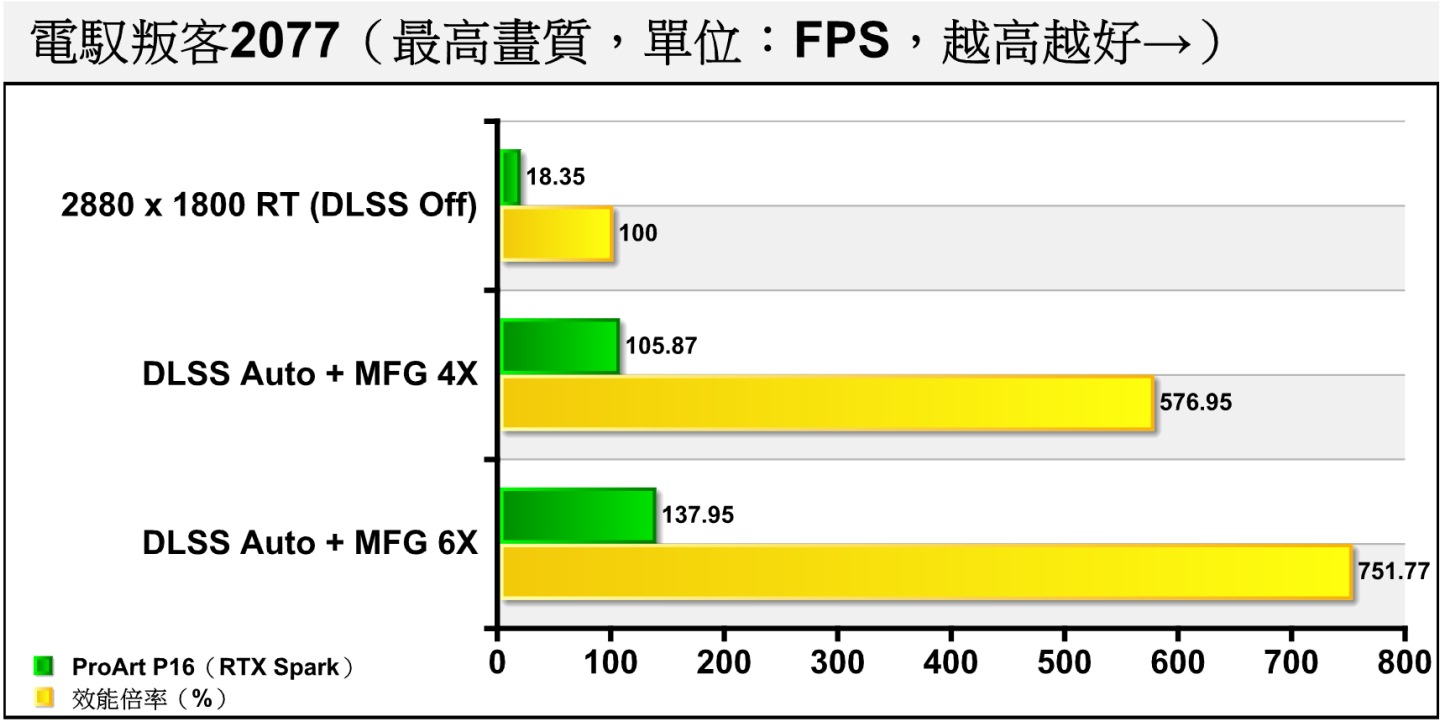
接下來筆者測試《電馭叛客2077》的DLSS升頻效果,使用「Transformer模型」、「自動畫質」搭配多重畫格生成。遊戲中的設定選項可以開啟DLSS 4X多重畫格生成,如果想要開啟6X多重畫格生成的話,則需要到NVIDIA App中使用DLSS覆寫功能設定。

開啟DLSS後,讓開啟光線追蹤時2880 x 1800解析度的平均FPS飆上137.95幀,效能倍率達到原始的7.51倍,效果相當出色!

Windows on Arm的另一條出路

從測試的數據可以看出,RTX Spark平台在效能的表現並非頂尖,但請不要忘記Asus ProArt P16是台重量僅為1.77 KG的筆記型電腦,而且處理器加內建顯示晶片整體能夠分配的TDP總額只有80 W,所以它本來就不是追求極致效能的產品,而是在效能、攜帶性、重量、續航力等表現之間互相妥協的結果,在維持輕薄、長效續航的同時,帶來相對出色的效能表現。

在測試的過程中,仍有如GPU-Z、Cinebench 2026 x86 64位元版等程式無法執行的問題,但所有我們例行測試的遊戲皆可正常執行,《戰慄深隧:流亡》遊戲本身與效能測試工具仍然能夠正常執行,唯測試模式結束後不會出現成績報告,算是一點小小的遺珠,不過整體而言,RTX Spark平台對於x86架構的軟體與遊戲相容性還是相當理想。

筆者先前測試的Qualcomm Snapdragon X2系列平台同樣為使用Arm架構的Windows on Arm筆記型電腦,但是它的設計概念比較像是將智慧型手機的使用者體驗帶到Windows生態系統,提供超長續航力、常時連網的體驗,並支援智慧型手機等級較輕量的AI應用程式與App,本身的定位為輕薄型文書、多媒體娛樂筆記型電腦。

而RTX Spark平台則比較像從電腦的角度出發,在Arm架構處理器上整合規模更大、效能更高的內建顯示晶片,並可支援容量最高達128 GB的記憶體,不但可以做為電競筆電、創作者筆電使用,更可以在本機執行圖像、影片生成,以及部署參數量更高的大語言模型(Large Language Model,LLM),甚至能夠支援代理式AI,對於需要更高顯示記憶體(VRAM)容量的AI應用程式與模型而言,RTX Spark平台在特定應用領域甚至超越x86架構處理器搭配NVIDIA獨立顯示晶片的解決方案。

隨著產品上市與時間持續推進,未來Windows on Arm生態系中預期會有更多原生Arm架構應用程式,x86架構模擬器的相容性與效率也有望持續改善,屆時使用者能夠在不購買新硬體的前提下,透過軟體與驅動程式更新的方式改善特定程式的相容性與效能。

筆者將在後續報導中持續介紹RTX Spark平台的架構與功能,請讀者參考下方目錄繼續閱讀相關內容。


RTX Spark Editor’s Day系列文章目錄
NVIDIA RTX Spark效能實測:Asus ProArt P16不只創作,還是輕薄Windows on Arm電競筆電!(本文)
NVIDIA RTX Spark平台與架構分析:當Windows on Arm遇到最強GPU,遊戲、AI、創作全面暴走!(工作中)
NVIDIA RTX Spark AI與創作功能分析:為Windows筆電獻上代理式AI體驗、透過Pair串連全家AI PC(工作中)
NVIDIA RTX Spark AI功能實測(暫定,規劃中)

加入T客邦Facebook粉絲團

Intel正式發表Intel GPU D系列運算卡,單卡搭載480 GB記憶體可吞300B參數LLM模型

2026年10月14日 17:25
Intel於OCP Global Summit 2026開放運算計畫全球高峰會公布Intel GPU D系列技術細節,強調搭載容量高達480 GB的記憶體,提供1.3 PFLOPS的FP8運算效能。E67cb1f2879c25ee1fb7b80cc69fadfb

Intel於OCP Global Summit 2026開放運算計畫全球高峰會公布代號Crescent Island的Intel GPU D系列最新技術細節,強調搭載容量高達480 GB的LPDDR5x記憶體,提供1.3 PFLOPS的FP8運算效能。

單卡即可滿足大規模LLM推論運算

先前Intel於Hot Chips 2026大會展出採用Xe3P架構的Crescent Island AI推論加速器,這次不但公布更多技術細節,也確定產品名稱為「Intel GPU D系列」。

延伸閱讀:
地表最強PCIe推論卡?Intel Crescent Island正式現身,搭載480GB超大容量記憶體與Xe3P新架構
Intel於Hot Chips 2026展示代理式AI與企業級產品,Diamond Rapids導入Intel 18A-P製程與扇出拓樸
【COMPUTEX 2025】Intel發表Arc Pro B系列運算卡,還有雙GPU魔改卡與Battlematrix工作站

Intel表示隨著開放式模型改變代理式AI的經濟性,市場需要具有更高彈性、成本效益與高能源效率的基礎設置。代理式AI的運作流程涵蓋資訊檢索、推理、協調、工具使用與執行,其中不只是負擔AI運算的GPU(繪圖處理器)或ASIC(Application Specific Integrated Circuit,特定應用積體電路),能夠相容於龐大軟體生態系x86架構CPU(處理器)也扮演關鍵角色。

Intel以成熟的x86軟體生態系為基礎,透過開放且可互通的軟體,結合CPU、GPU、加速器的異質運算,讓不同工作負載能使用最合適的運算單元,進而提升整體工作流程的資源利用率、效能與效率。

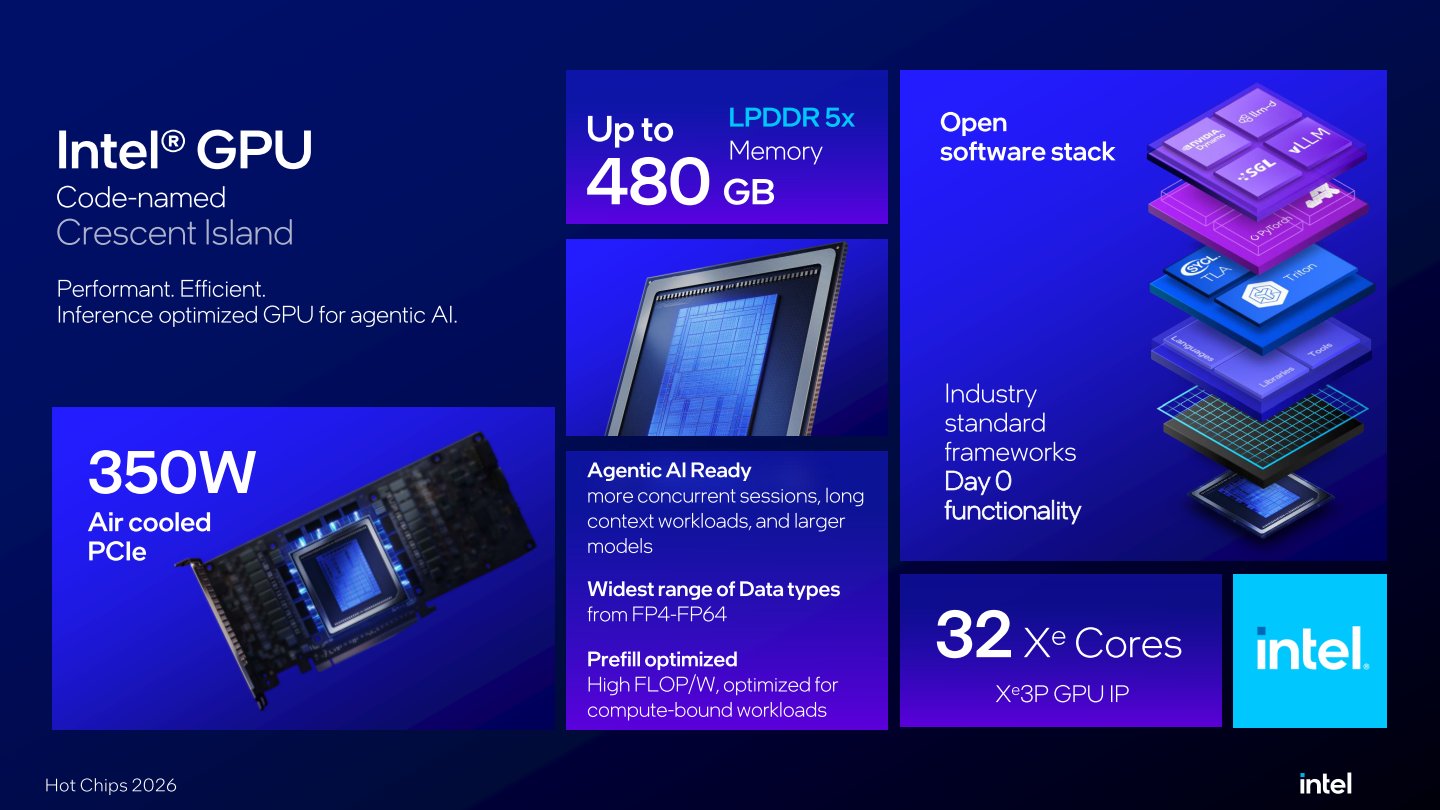
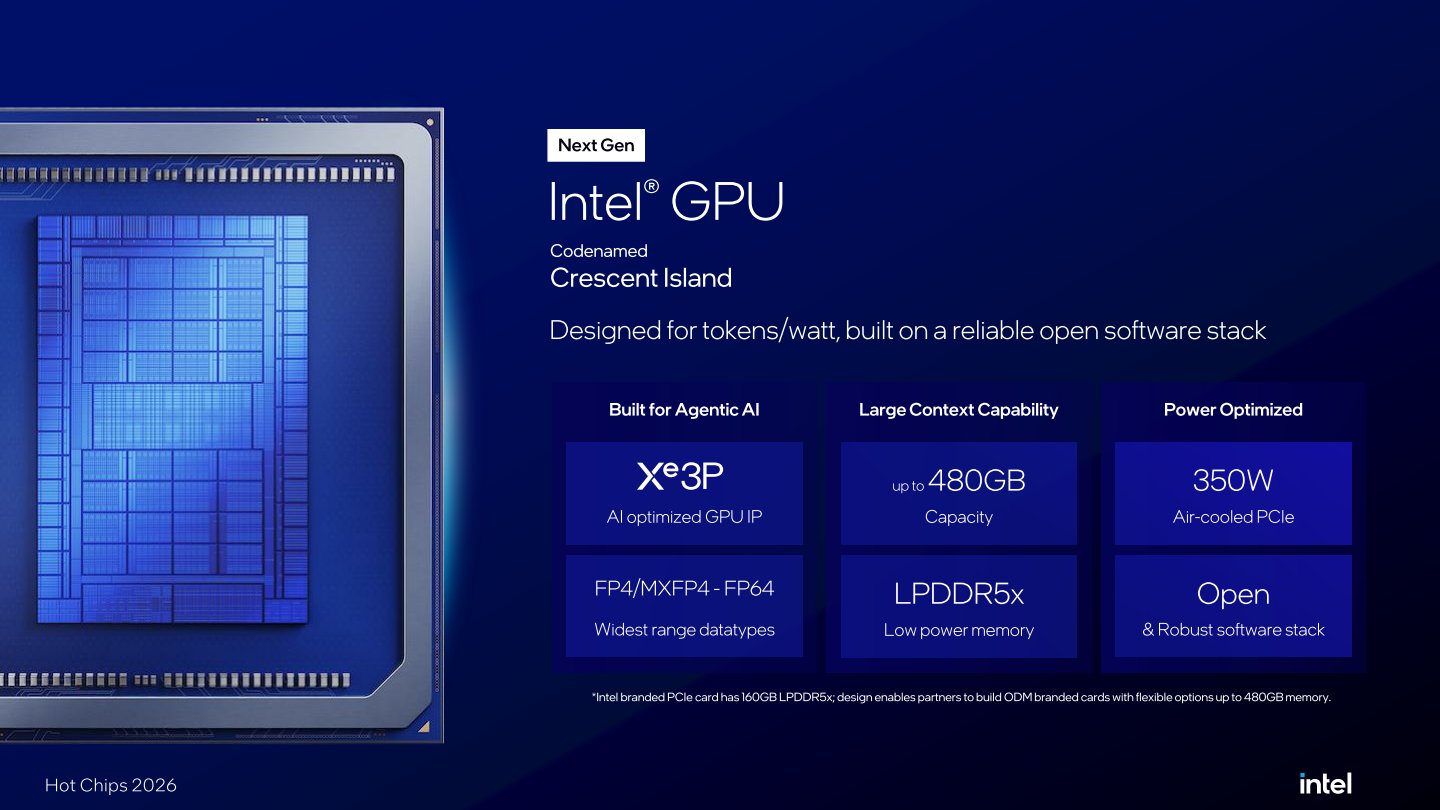
專為高效率、大規模推論設計的Intel GPU D系列採用最新的Xe3P架構,FP8資料類型的理論效能達到1.3 PFLOPS,最高TDP為350 W,可搭配容量最高達480 GB、頻寬為1.5 TB/s的LPDDR5X記憶體,兼顧記憶體容量、運算效能與能源效率,並能夠滿足長時間運作、記憶體密集型的AI推論運算成本效益。

Intel GPU D系列採用共通的Xe軟體基礎,有利於開發人員移植現有應用程式,降低部署新硬體的門檻,並能夠滿足LLM(Large Language Model,大型語言模型)、長上下文工作負載與平行推論服務打造。單卡可支援參數量高達300B的模型,搭載8張運算卡的系統則可支援超過1000B參數的模型,適用於多租戶AI服務、機器人,以及延遲敏感型的工作負載。

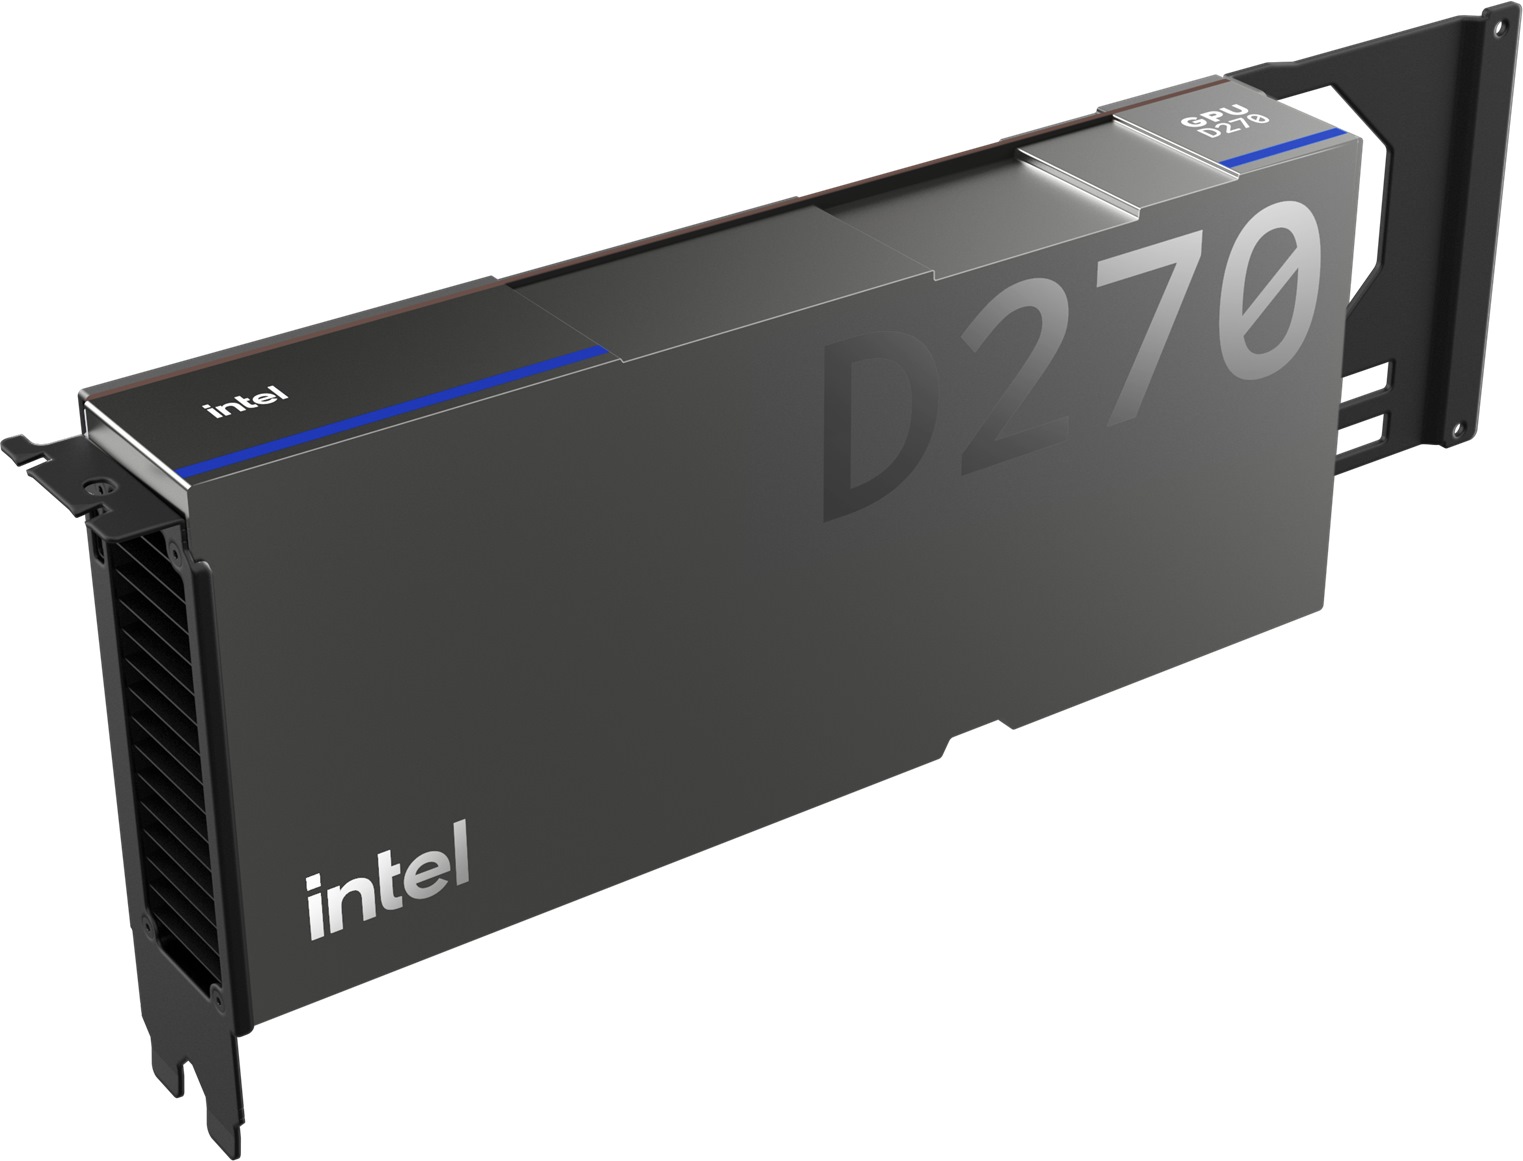
從官方公布的Intel GPU D系列產品圖片可以看出它是針對運算推出的產品,並沒有搭載影音輸出端子。

Intel GPU D系列最大的特色莫過於支援容量最高達480 GB的記憶體。

Intel GPU D系列採用針對AI運算最佳化的Xe3P架構,並支援FP4~FP64以及MXFP4等資料類型運算。

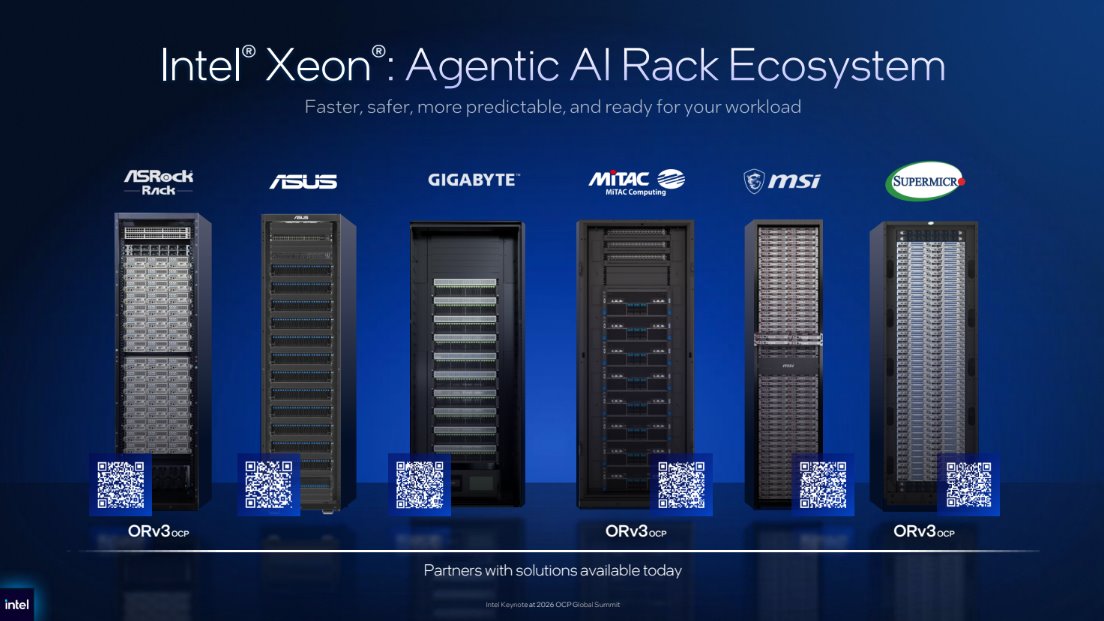
Intel也於開放運算計畫全球高峰會公布與生態系夥伴共同開發、採用Xeon處理器的新款機櫃設計,其中許多設計採用開放運算計畫的Open Rack v3(ORv3)標準,簡化在開放式資料中心基礎設置的部署與整合,滿足代理式AI日益成長的運算需求。

Intel GPU D系列已開始提供客戶樣品,Intel也將持續擴大硬體、軟體與開放生態系,協助企業在既有及新建資料中心基礎架構中部署並擴展AI推論應用。

加入T客邦Facebook粉絲團

GB-Link USB V2雲端Game Boy傳輸線讓原始主機也能網路對戰,還可與模擬器連線

2026年10月12日 15:00
GB-Link USB V2是款支援Game Boy與Game Boy Anvance的傳輸線擴充工具,能夠透過電腦中介進行遠端網路對戰,還可與模擬器連線並使用下載遊玩、E-Reader等功能。C8d123168acdbc60e1f454c05e999711

GB-Link USB V2是款支援Game Boy與Game Boy Anvance的傳輸線擴充工具,能夠透過電腦中介進行遠端網路對戰,還可與模擬器連線並使用下載遊玩、E-Reader等功能。

面對面連線的年代

元祖版Game Boy於1989年推出,其硬體設計的特色除了包含可以透過更換卡匣的方式執行不同遊戲,並在主機上加入通訊端子,讓玩家可以透過傳輸線連接2台主機,進行如《俄羅斯方塊》的對戰,或是在《寶可夢》遊戲中交換彼此收集的寶可夢,帶來了更多元的遊戲進行方式。

延伸閱讀:
用FPGA打造的Game Bub遊戲機,支援GB、GBA實體卡匣還可連線對戰
純硬體模擬,Analogue Pocket透過FPGA相容多款掌上型遊戲機卡匣
AMD Artix UltraScale+ FPGA 成為 ModRetro M64,透過硬體模擬方式完整還原 Nintendo N64 主機

隨後推出的Game Boy Pocket、Game Boy Light等主機為輕量化與加入冷光的版本,1998年推出的Game Boy Color則是加入彩色顯示功能,能夠從32,768色的色盤中同時顯示56色,除了可以執行彩色版遊戲之外,也相於先前的黑白遊戲,上述這些主機的通訊功能皆相同,彼此能使用相同的傳輸線進行對戰或資料傳輸。

2001年推出的Game Boy Advance則採用不同的硬體架構,但保留對先前世代Game Boy、Game Boy Color的遊戲與周邊設備相容性。在進行Game Boy Advance遊戲對戰時需使用新款的專用傳輸線,若是進行Game Boy、Game Boy Color遊戲對戰則需舊款傳輸線,2者不能混用。

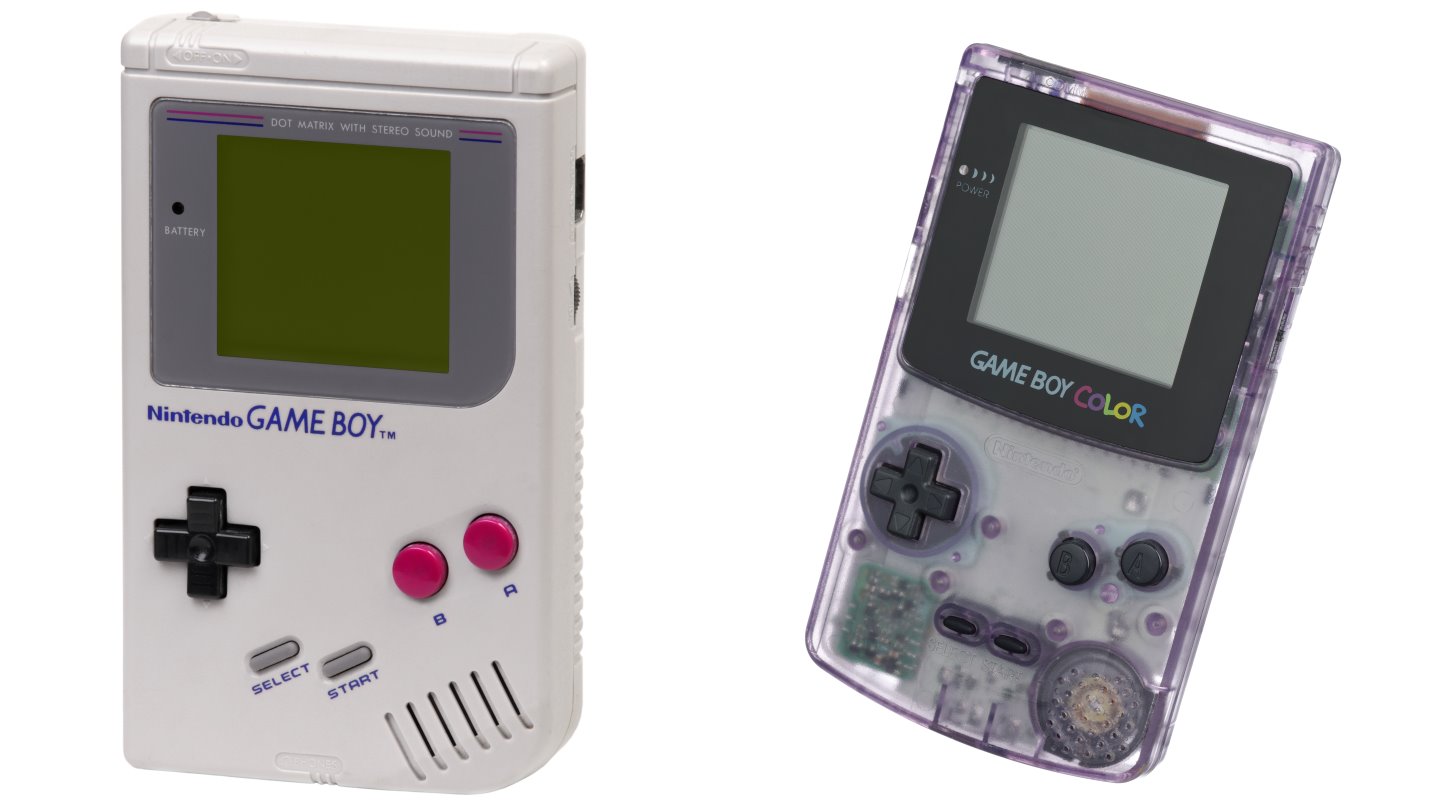
Game Boy(左)與Game Boy Color有點像是1代與1.5代之間的關係,2者遊戲有一定的互換性,惟部分遊戲限定必須於Game Boy Color才能執行。(圖片來源:維基百科,本圖採用創用CC姓名標示-相同方式分享,作者為Evan-Amos,下同)

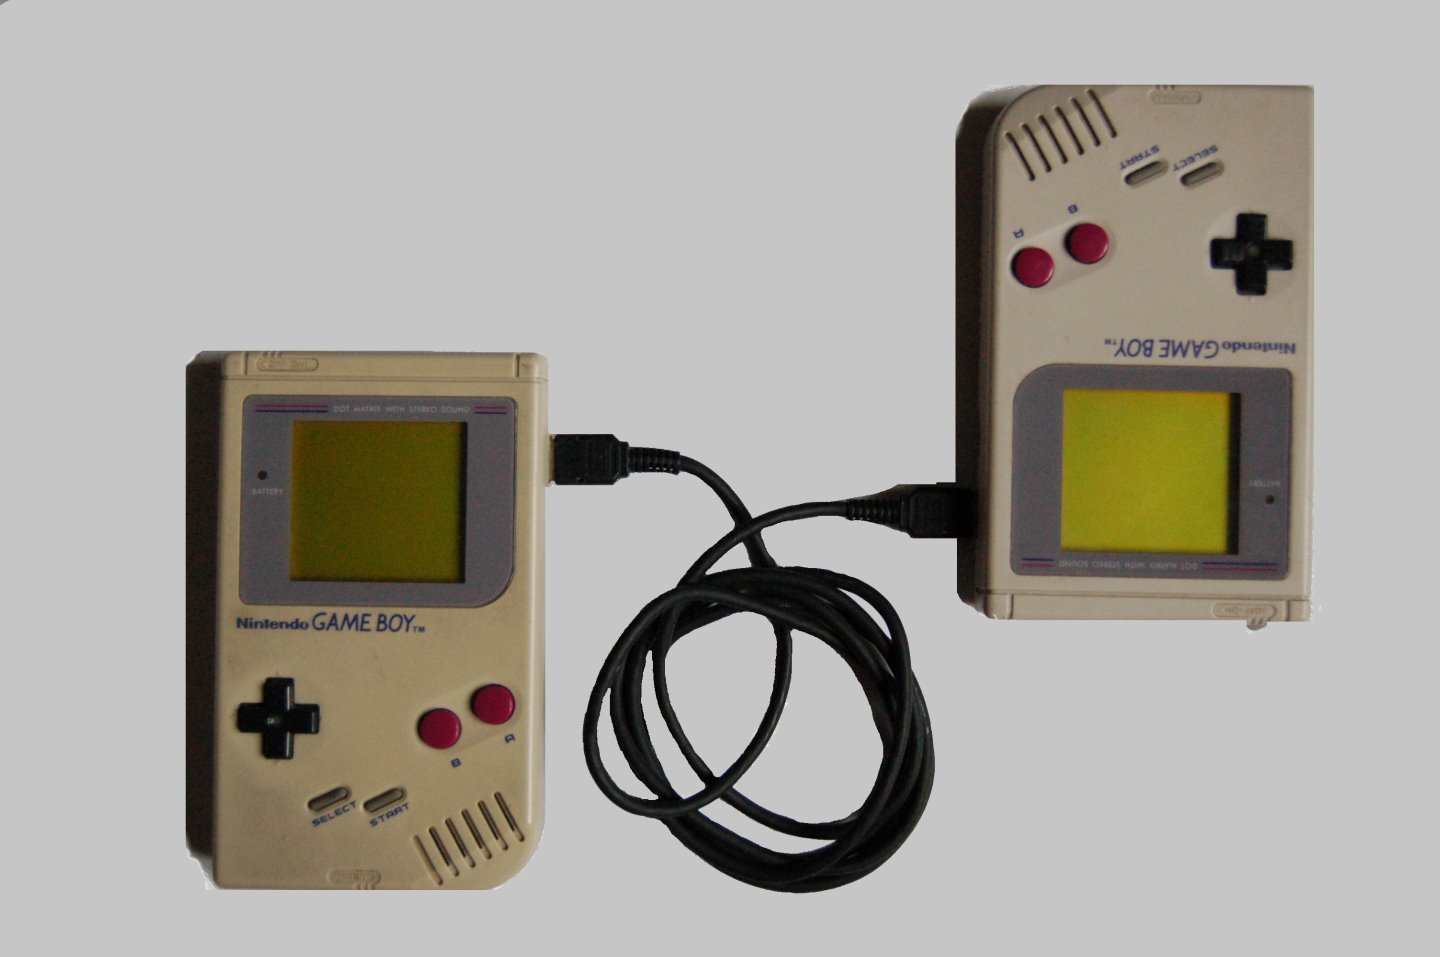
2台Game Boy主機可以透過傳輸線連接,進行雙人對戰遊戲或交換遊戲內的道具。

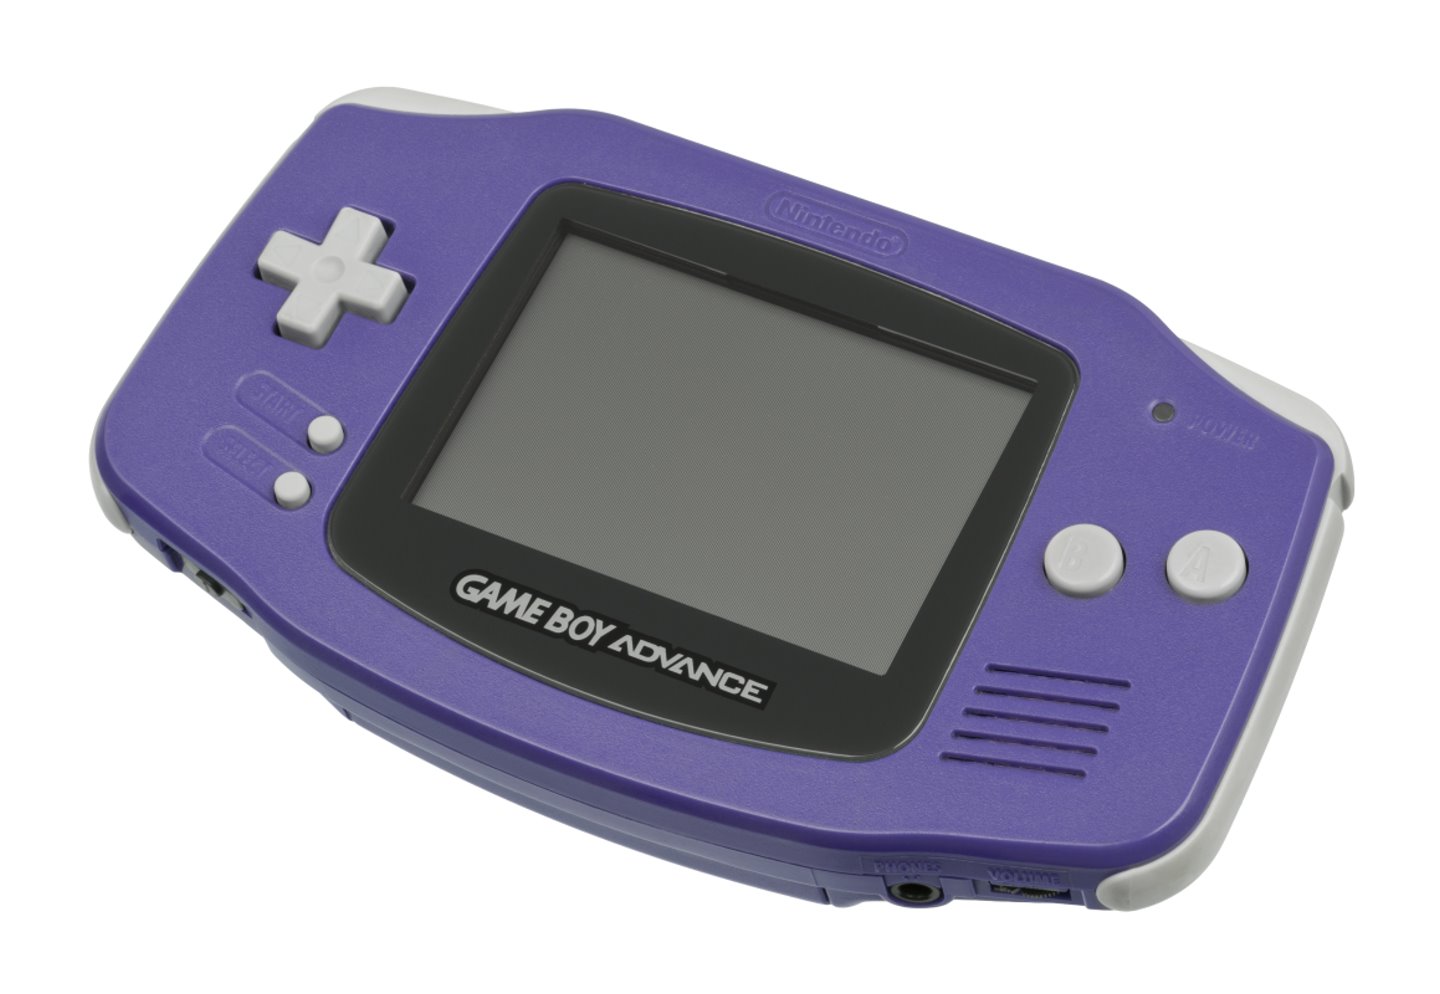
Game Boy Advance則為下一世代的主機,不但可以執行Game Boy Advance遊戲,也能相容Game Boy、Game Boy Color的遊戲與周邊,並且可以與Game Boy主機連線。

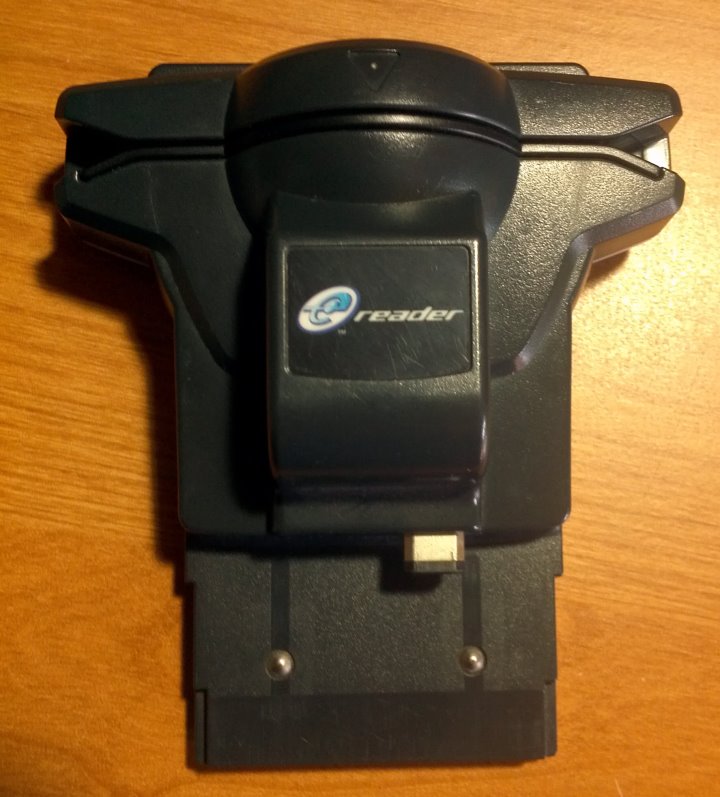
將Nintendo E-Reader插入Game Boy Advance之後,可以透過卡匣上的讀卡機掃瞄專用卡片的條碼並執行附加內容,或是透過傳輸線將附加內容傳送至另一台主機。(圖片來源:維基百科,本圖採用創用CC姓名標示-相同方式分享,作者為Synyster Zombie)

土砲轉接器帶來雲端連線功能

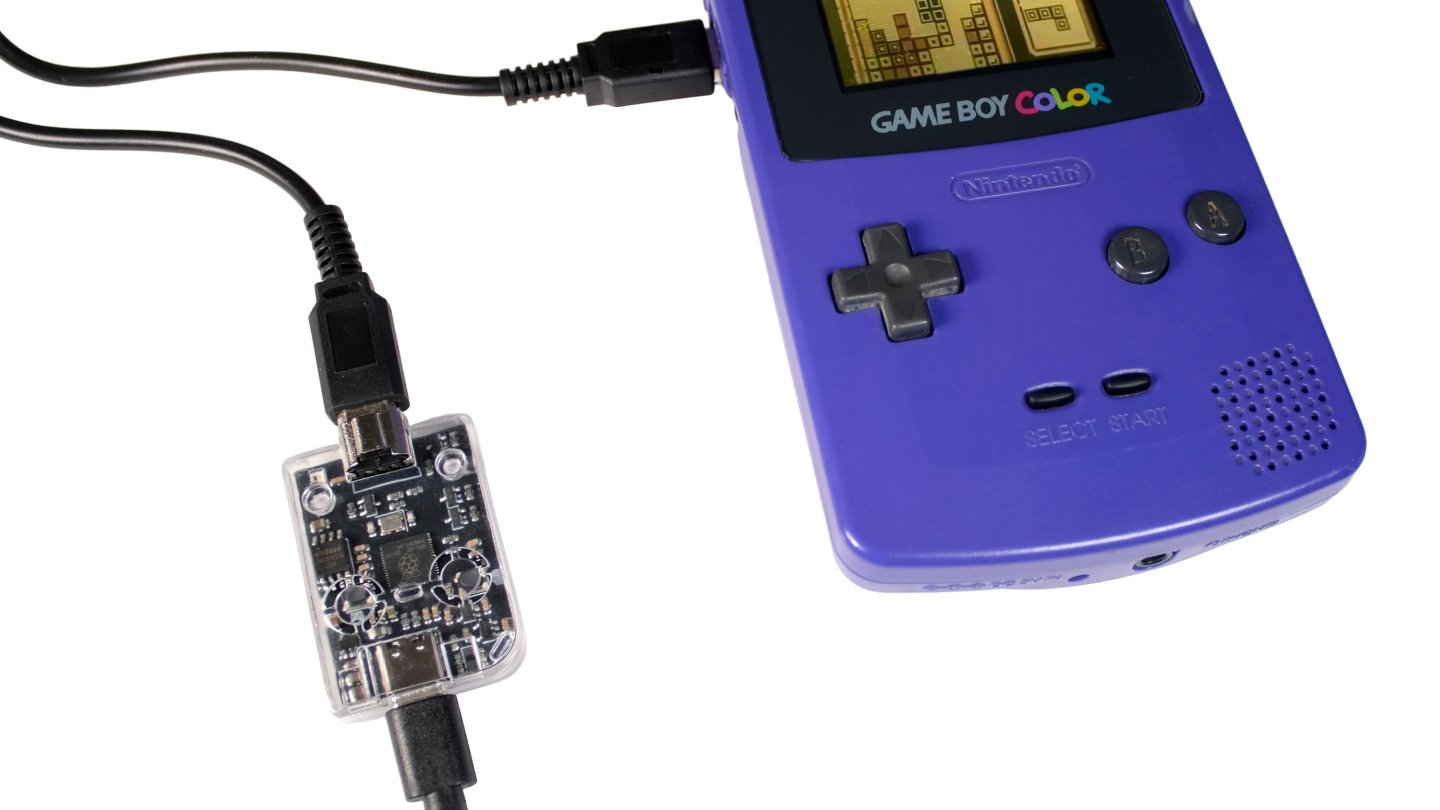
GB-Link USB V2是款由GB-Link團隊研發的硬體轉接器,它以Raspberry Pi RP2040微控制器為硬體核心,能夠將Game Boy、Game Boy Color、Game Boy Advance等主機或是Analogue Pocket、Game Bub等相容FPGA互換機的通訊端子轉接為USB並連接至電腦,玩家可以透過網頁介面操作並與遠端的朋友連線,提供類似線上對戰的遊戲體驗。

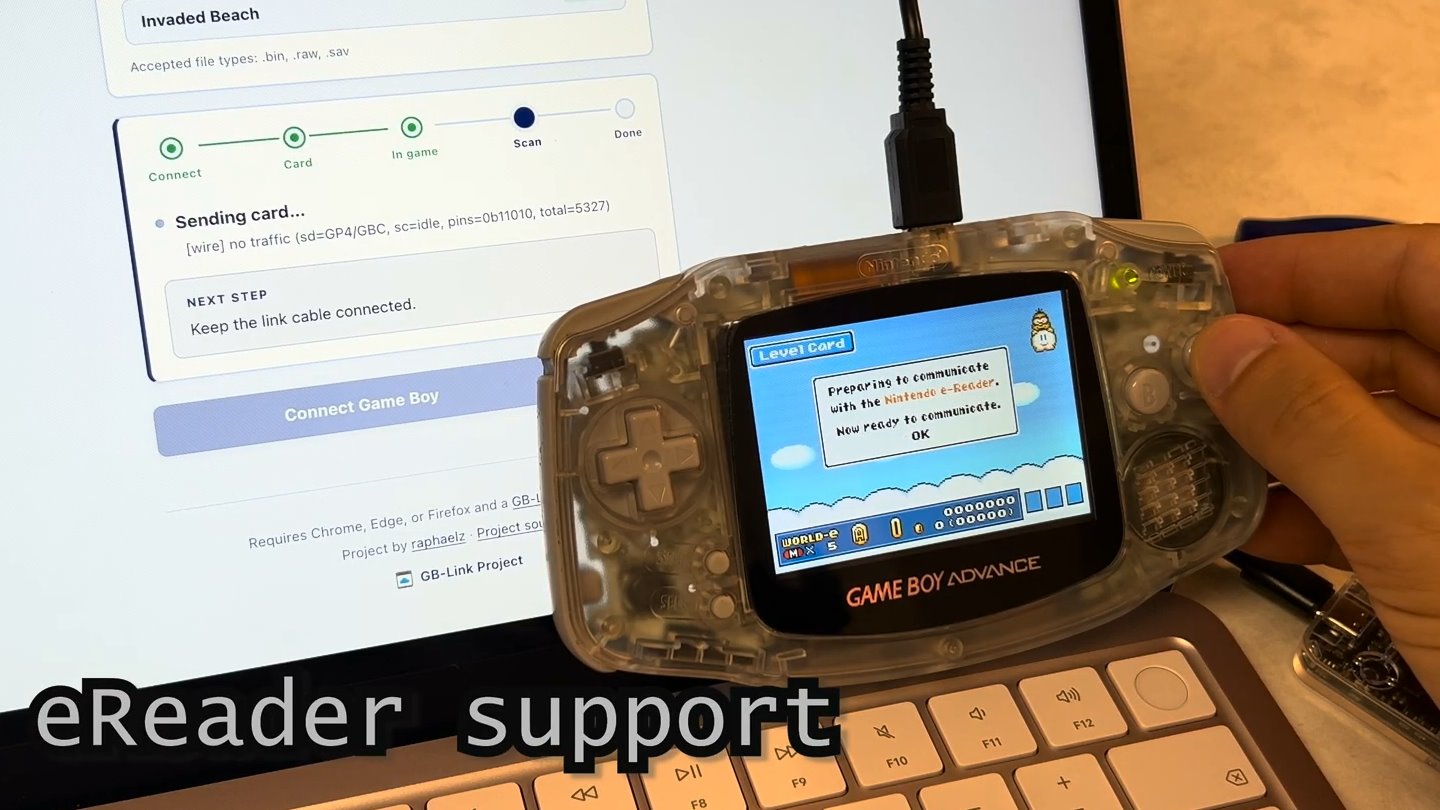
對於Game Boy Advance而言,玩家還可以利用下載遊玩功能,透過GB-Link USB V2將自製程式傳送至主機執行,也能夠直接傳送E-Reader的附加內容,而不需使用E-Reader硬體與卡片。

另一方面GB-Link USB V2也可透過RetroArch模擬器的網路連線橋接功能,讓實體主機與模擬器連線,使用寶可夢第1~3世代的道具交換,以及第3世代的對戰等連線功能。此外也能透過Game Boy印表機模擬功能,將Game Boy攝影機拍攝的照片傳輸至電腦。

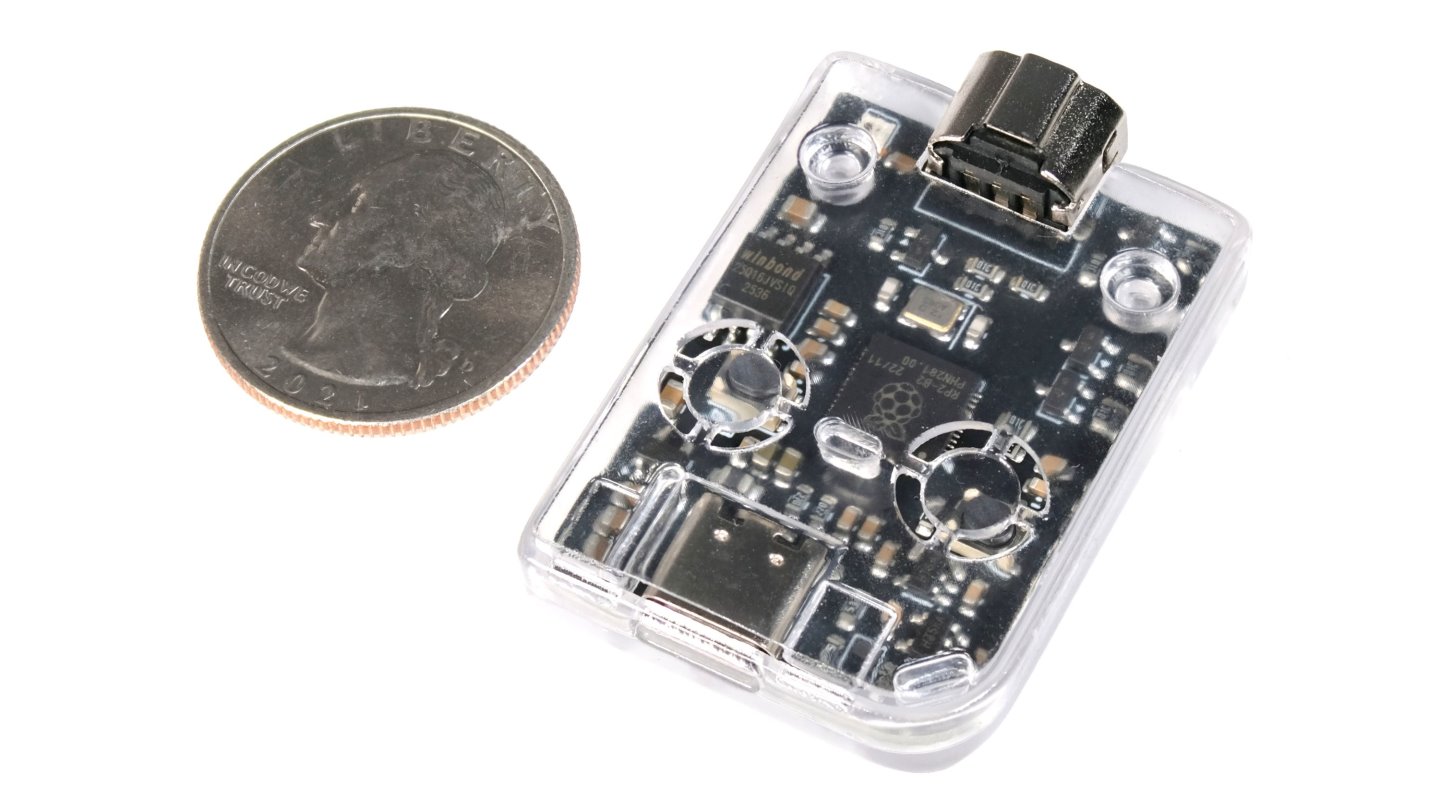
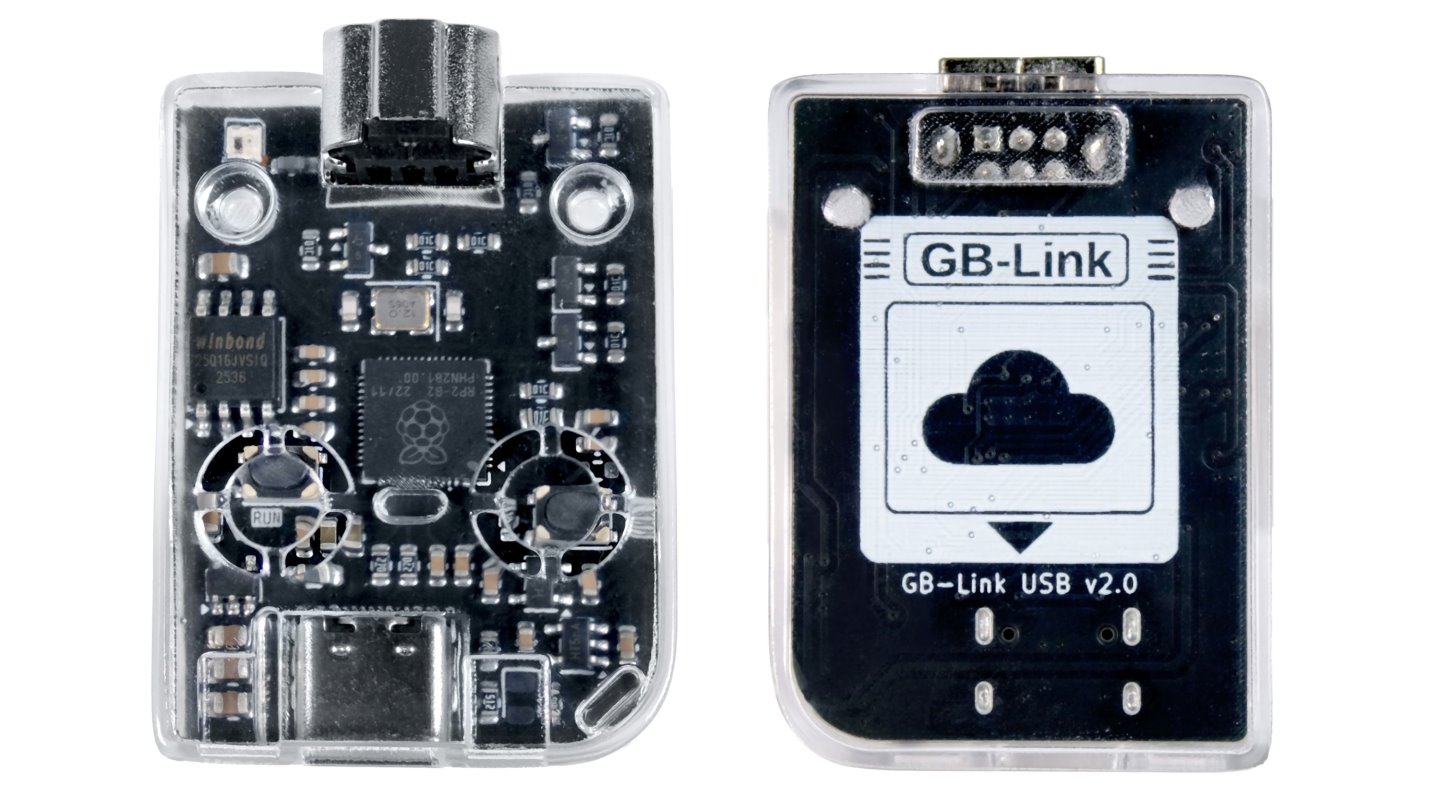
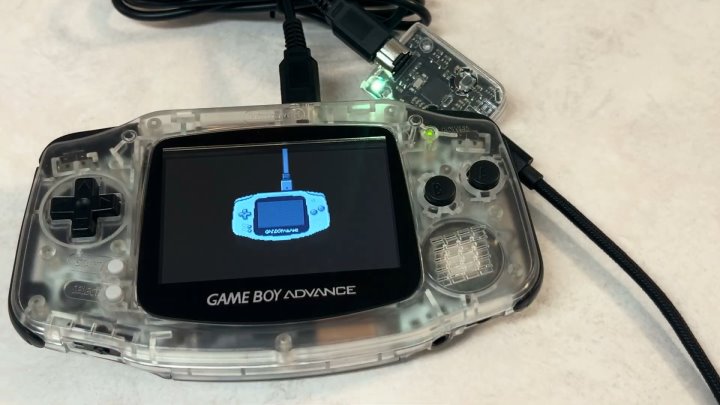
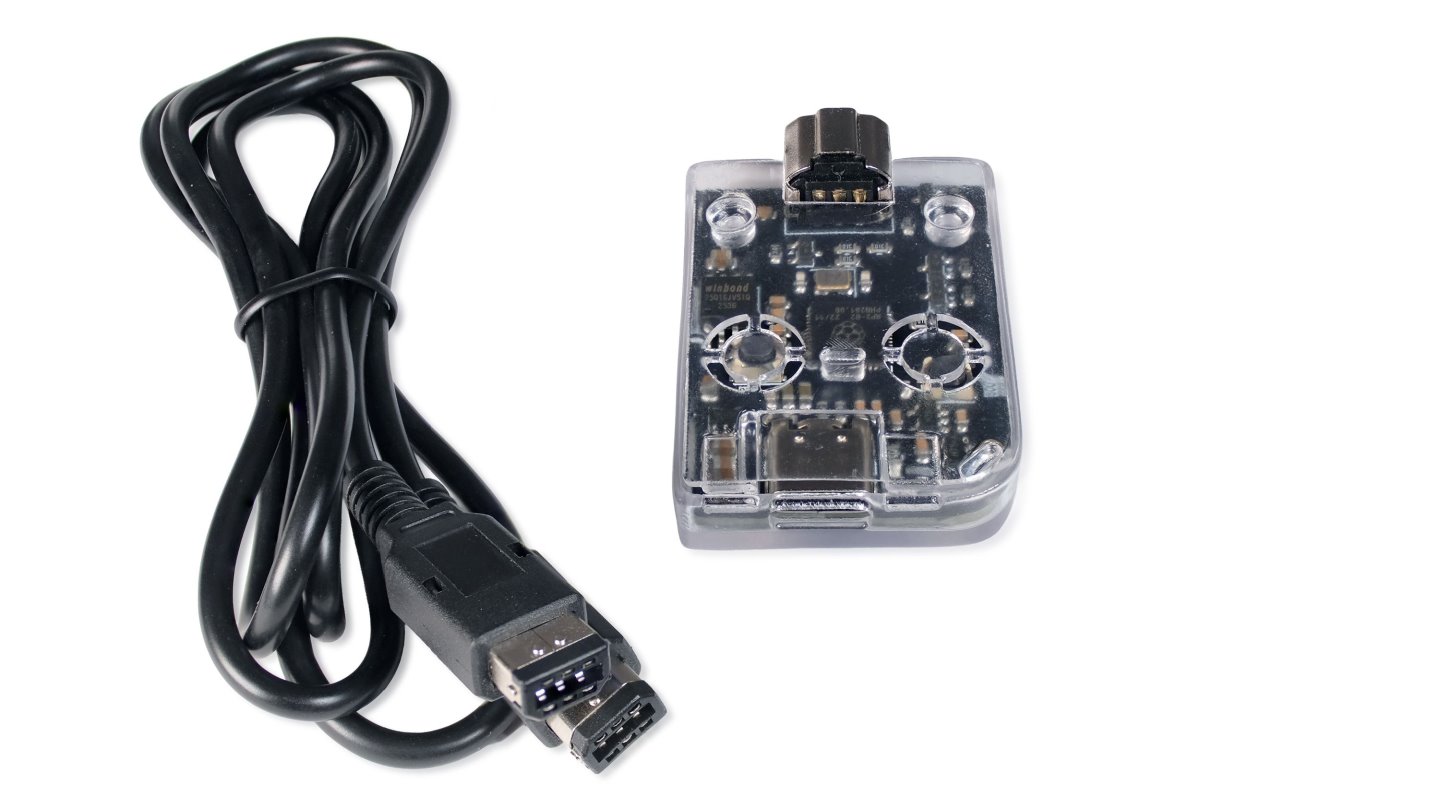
GB-Link USB V2是款由可以將Game Boy與Game Boy Anvance的傳輸線轉接至電腦的轉接器。

其尺寸約為2.92 x 4.25 cm,重量為8.5 g。

它以Raspberry Pi RP2040微控制器為硬體核心,並具有Game Boy Anvance通訊端子與USB Type-C端子。

玩家可以透過GB-Link USB V2將實體主機經由網路與遠端的另一台實體主機連現。

GB-Link USB V2也能用於傳輸Game Boy Advance的下載遊玩與E-Reader等附加內容。

GB-Link USB V2包裝內將附上1條線長120 cm的Game Boy Advance傳輸線。

GB-Link USB V2的預定上市日期為2027年1月14日,預定售價為美金45元(約合新台幣1,450元)。

加入T客邦Facebook粉絲團

Microsoft與NVIDIA共同發表RTX Spark超級AI Surface Laptop Ultra筆電,10/16上市定價美金2,599元起

2026年10月8日 11:57
Microsoft於發表會中與NVIDIA共同宣佈RTX Spark超級AI筆電將於2026年10月16日上市,除了自家的Surface產品之外,也會與其他合作夥伴共同推出多種機型。B4acc6bb3c0a495ed28e02f93e99b01f

Microsoft於「Something new is coming from Windows」發表會中,與NVIDIA共同宣佈RTX Spark超級AI筆電將於2026年10月16日上市,除了自家的Surface產品之外,也會與其他合作夥伴共同推出多種機型。

搭載GB10的效能怪獸

NVIDIA在Computex 2026台北國際電腦展中,正式發表代號為GB10的RTX Spark SoC晶片,它具有Arm架構的Cortex-X925處理器核心以及Cortex-A725核心各10組,搭配具有6,144組CUDA核心的Blackwell架構內建顯示晶片(GPU),最高支援128 GB LPDDR5x統一架構記憶體,能夠帶來強悍的遊戲、3D繪圖、AI運算效能。

延伸閱讀:
【COMPUTEX 2026】NVIDIA RTX Spark處理器解析:Windows on Arm原生支援、x86模擬,AI遊戲雙重升級!
NVIDIA RTX Spark SoC 深度解析:GB10 晶片威力全開,Arm 架構筆電也能爽玩遊戲?
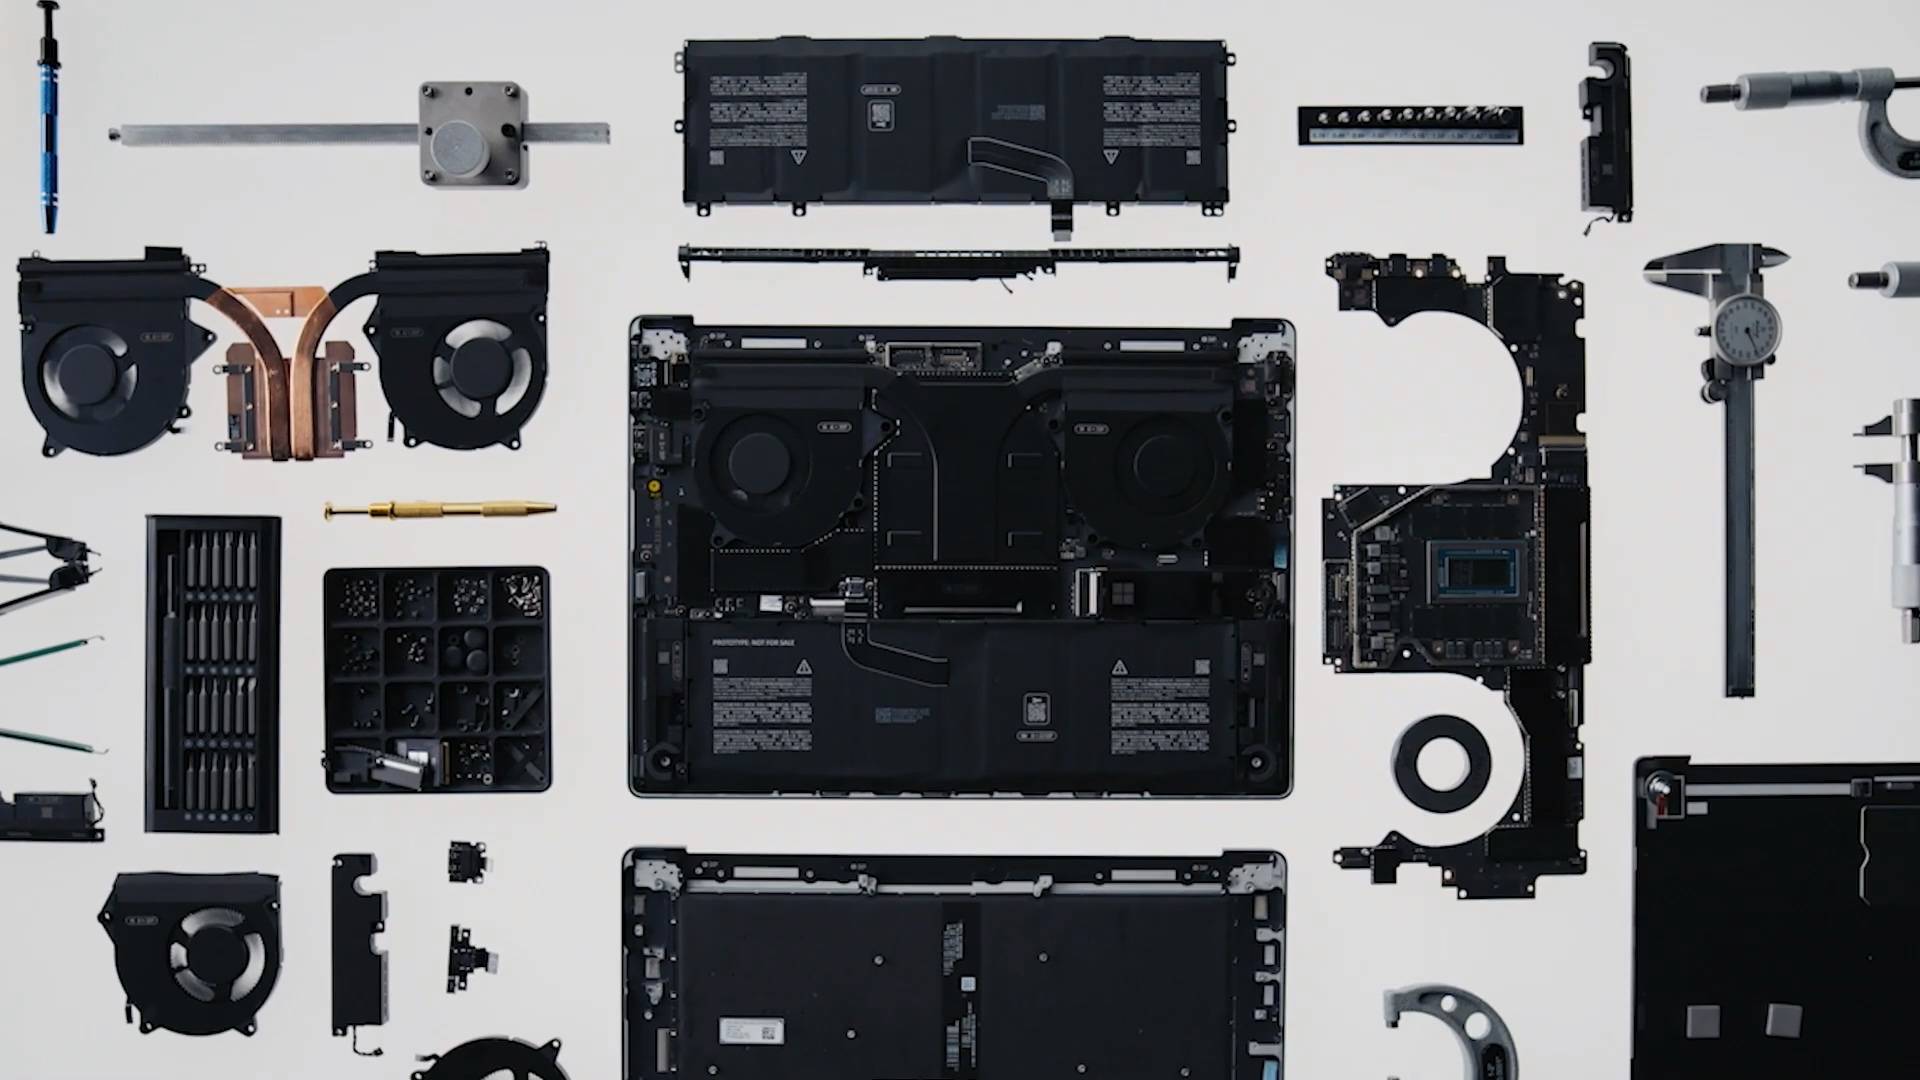
NVIDIA RTX Spark 筆電、迷你電腦齊發:NVIDIA RTX Spark 機構內部分解,超強散熱系統成 AI 運算關鍵

Windows +裝置執行副總裁Pavan Davuluri在活動中正式發表搭載RTX Spark SoC的Surface Laptop Ultra筆記型電腦,並開放接受預購,產品將於2026年10月16日正式上市。

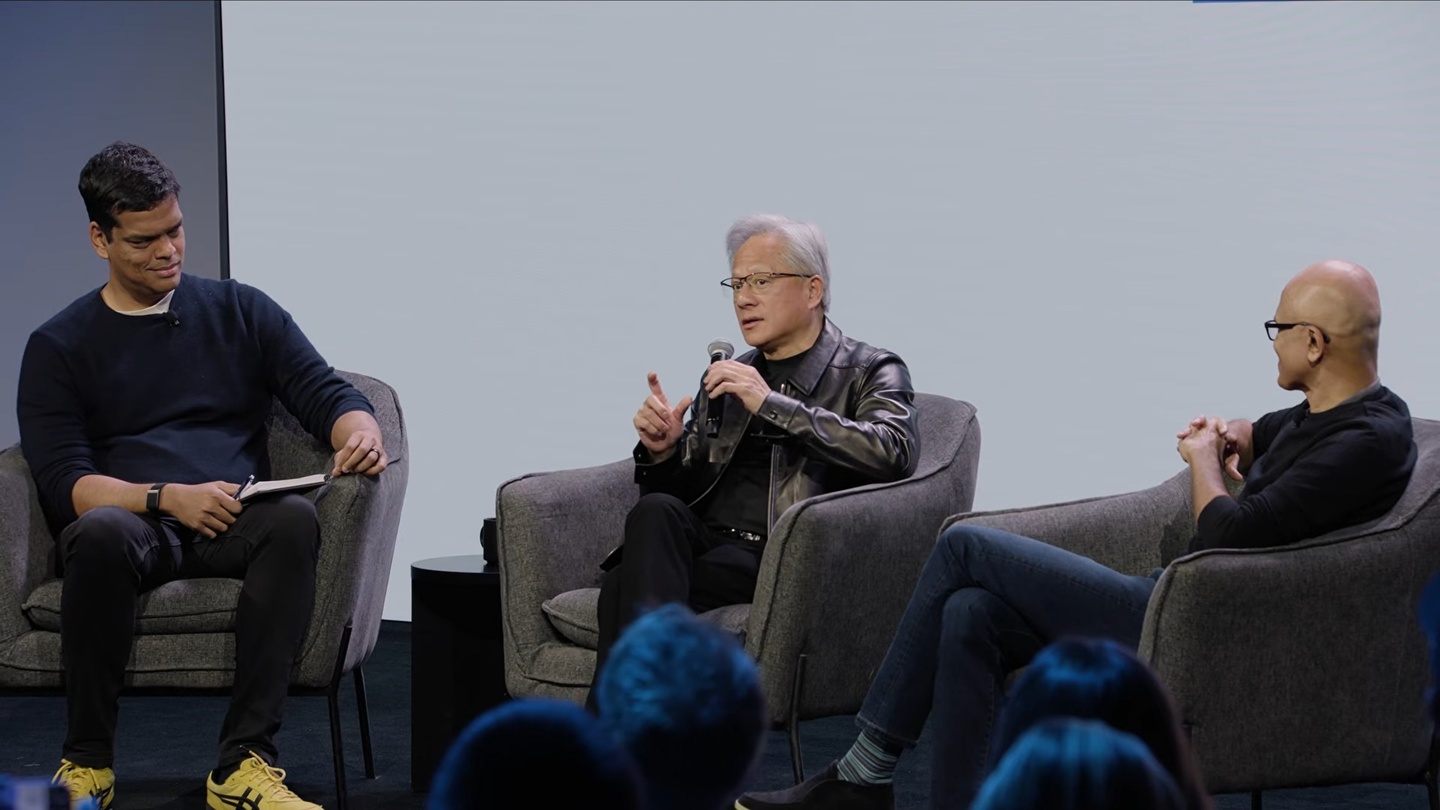
活動也邀請Microsoft執行長Satya Nadella、NVIDIA執行長黃仁勳,以及白宮資深AI政策顧問Sriram Krishnan共同分享對AI趨勢的觀點。黃仁勳表示要是沒有Microsoft的Windows中的DirectX與可程式化渲染器(Programable Shader)等技術,就不會催生出成為AI運算重要基礎的CUDA通用運算技術,可見2間公司的關係相當深厚。

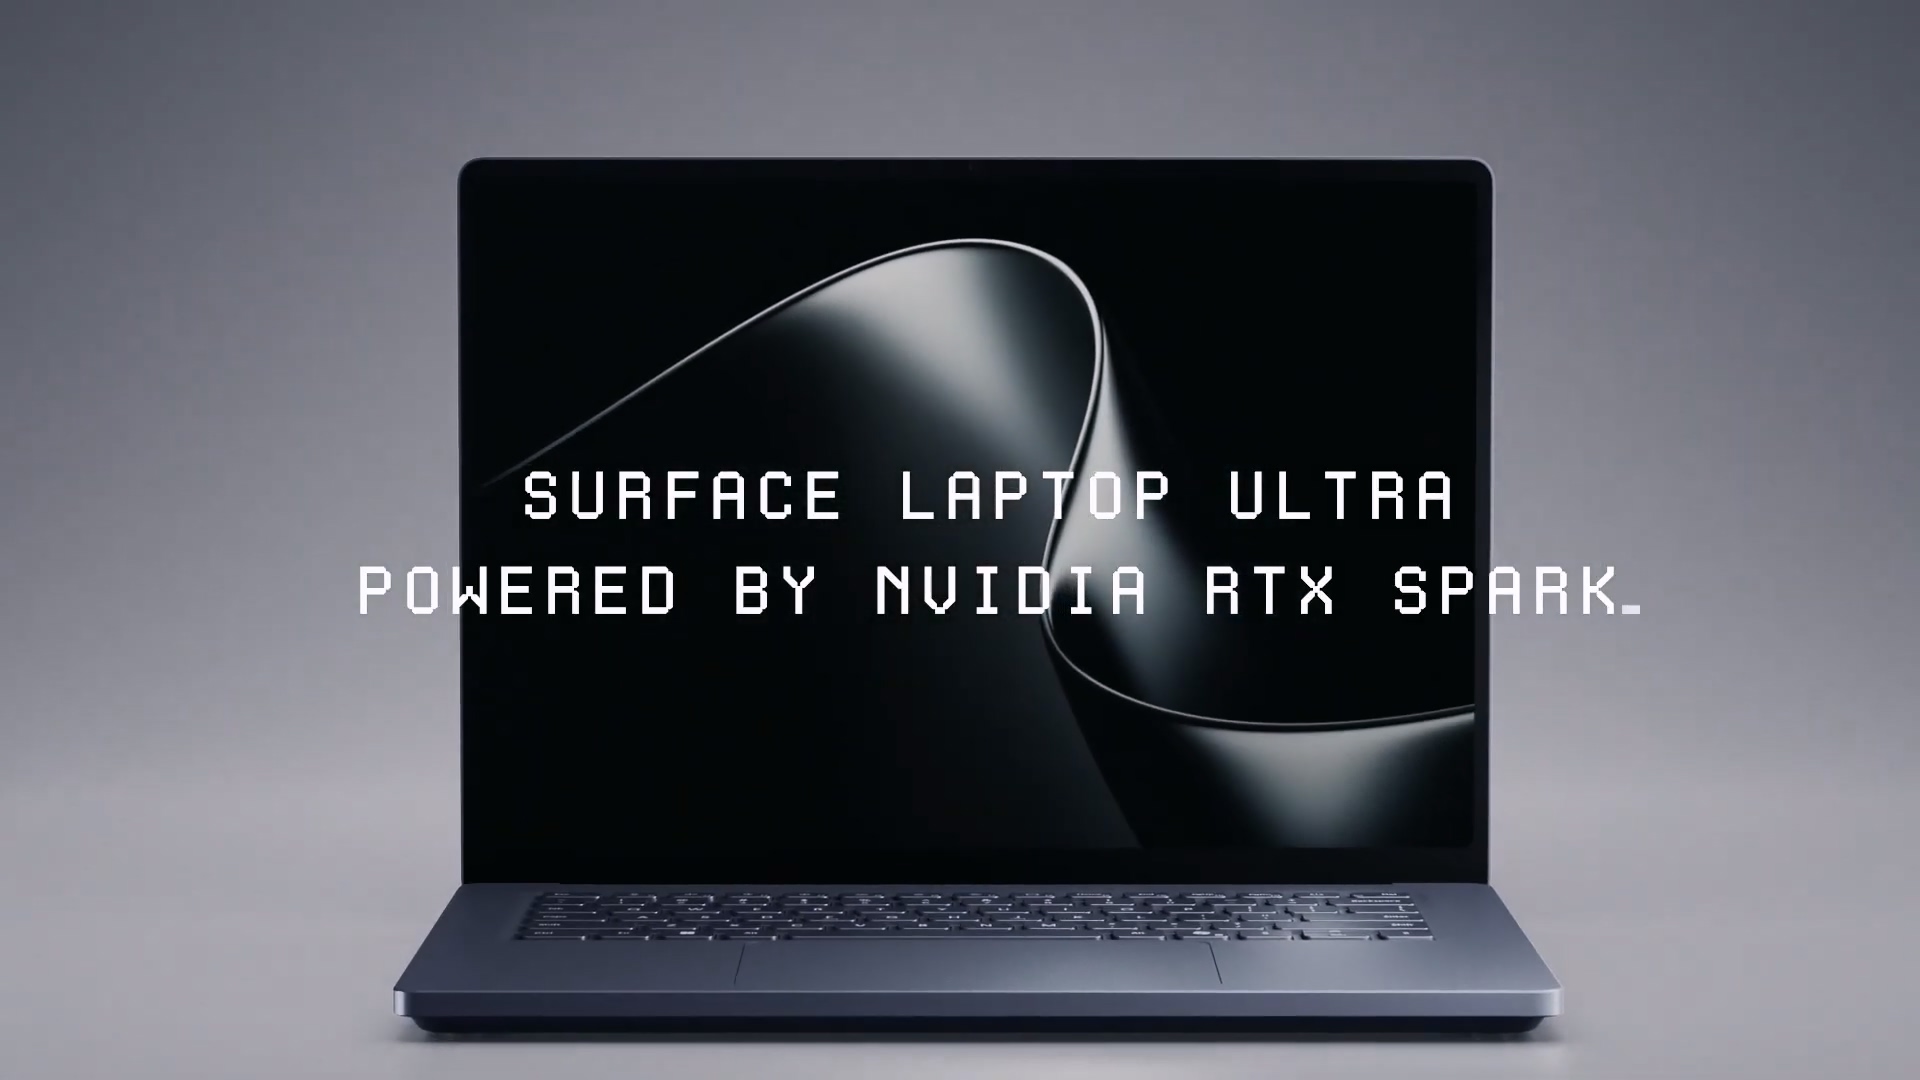
Microsoft於Something new is coming from Windows發表會正式發表搭載RTX Spark SoC的Surface Laptop Ultra筆記型電腦。

Surface Laptop Ultra最大的特色就是採用Arm架構處理器搭配Windows 11作業系統,並透過RTX Spark SoC晶片強悍的內建顯示晶片強化遊戲、3D繪圖、AI使用體驗。

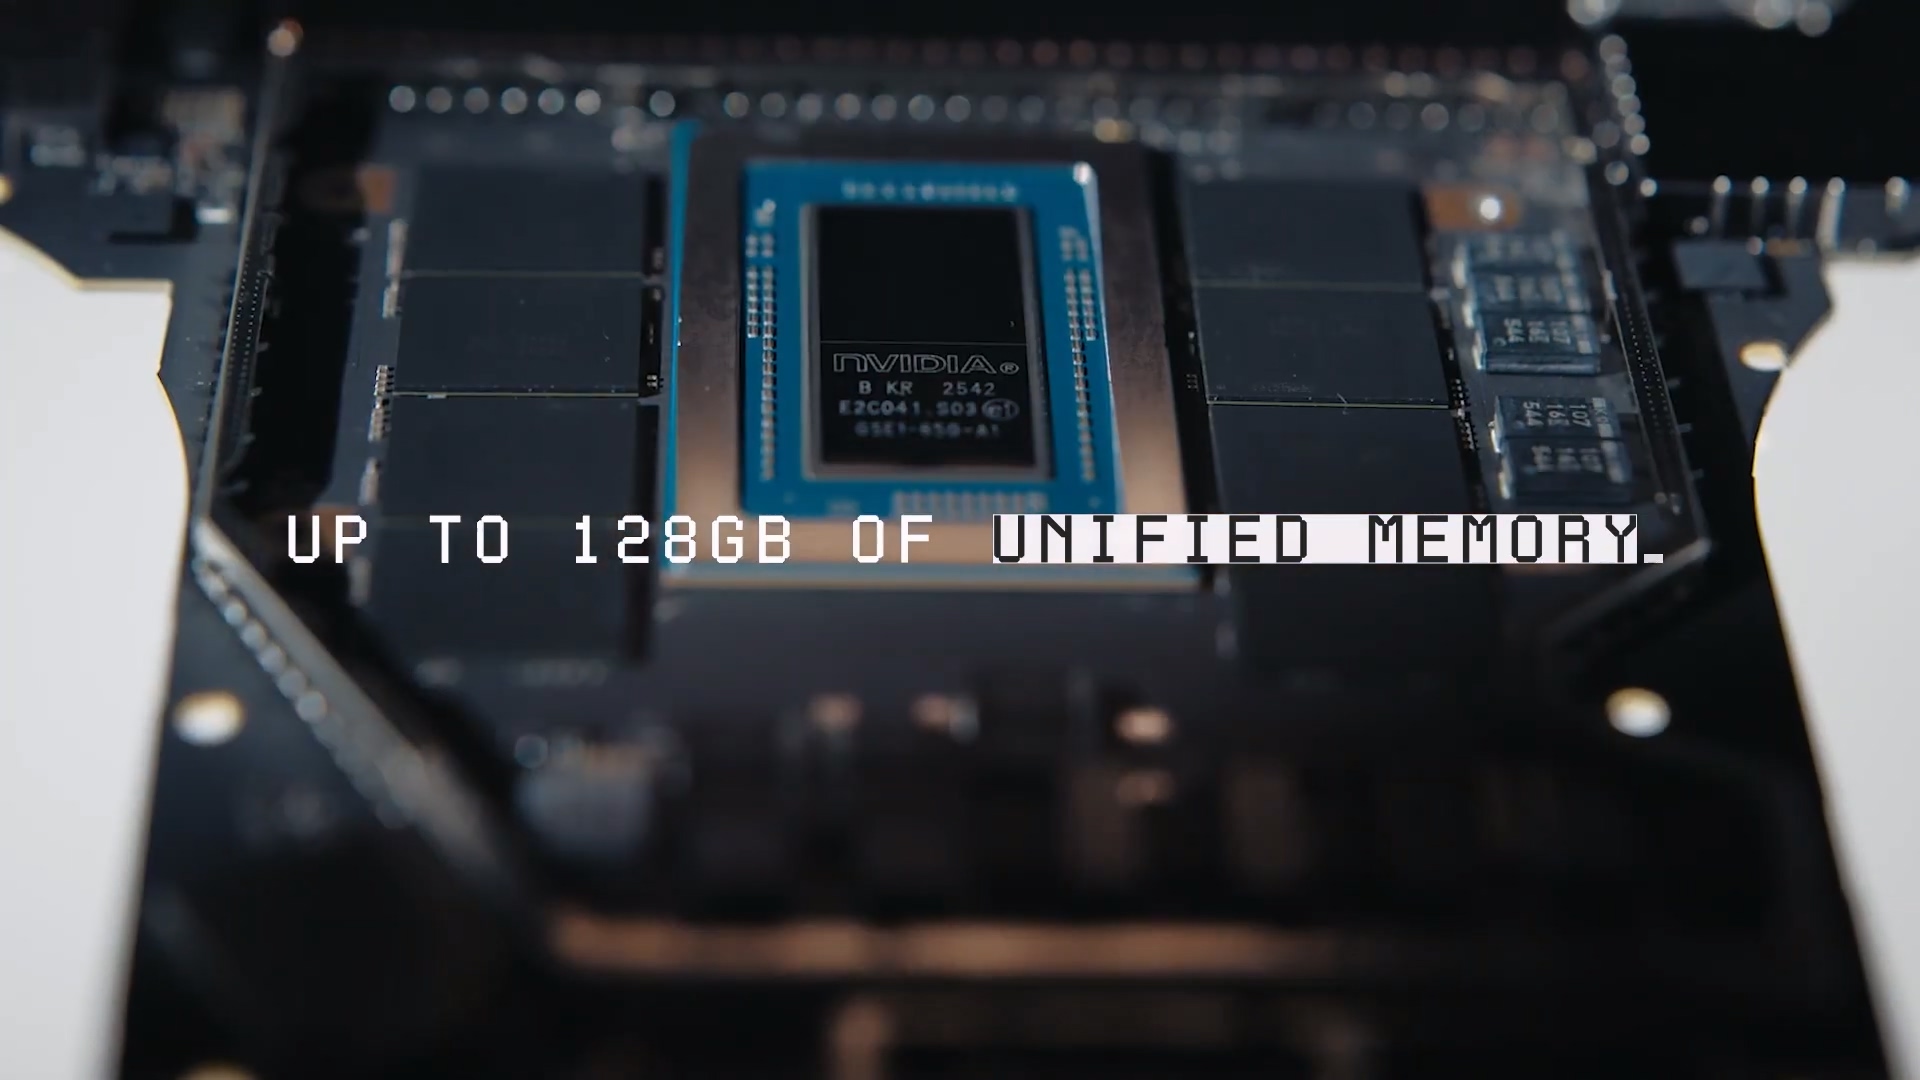
Surface Laptop Ultra最高支援128 GB LPDDR5x統一架構記憶體,有助於執行參數量更大的AI模型。

NVIDIA執行長黃仁勳也於訪談中提到,CUDA通用運算技術的淵源可以回溯至Microsoft的DirectX與可程式化渲染器等技術。

Windows筆電也有磁吸式充電

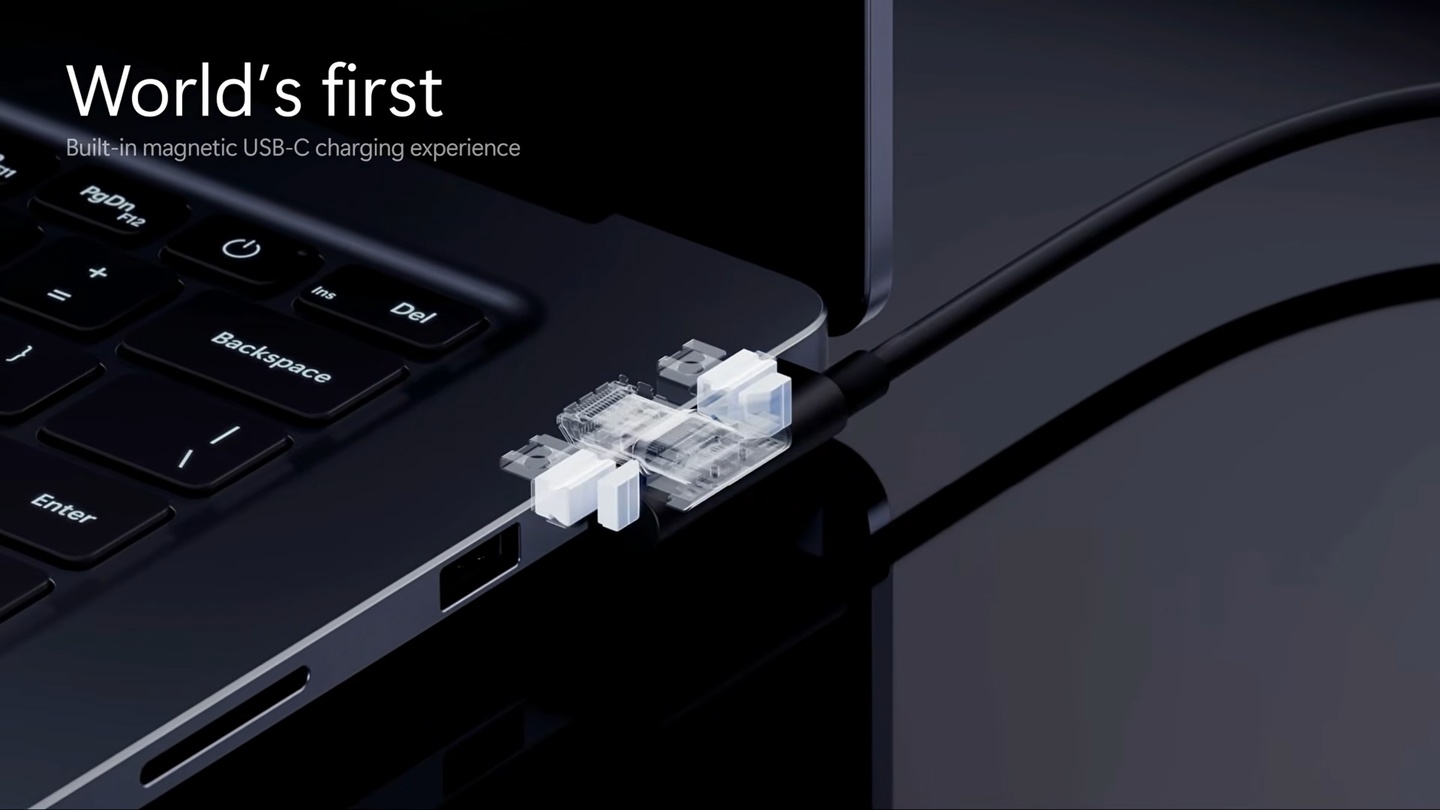
Pavan也在發表會中說明Surface Laptop Ultra的特色,除了搭載RTX Spark So之外,它也強化了散熱設計,整體解熱能力達到先前產品的2.5倍,並搭載具有超高HDR亮度的15吋PixelSense顯示器,其機身厚度為1.8 mm,重量則為2.04 KG,並支援磁吸式USB Type-C充電端子。

搭載18核心處理器、5120 CUDA Core內建顯示晶片搭配24 GB記憶體的版本預定售價為美金2599.99元(約合新台幣83,380元),滿血的20核心處理器、6144 CUDA Core內建顯示晶片搭配128 GB記憶體的版本預定售價為美金5899,99元(約合新台幣189,210元)。

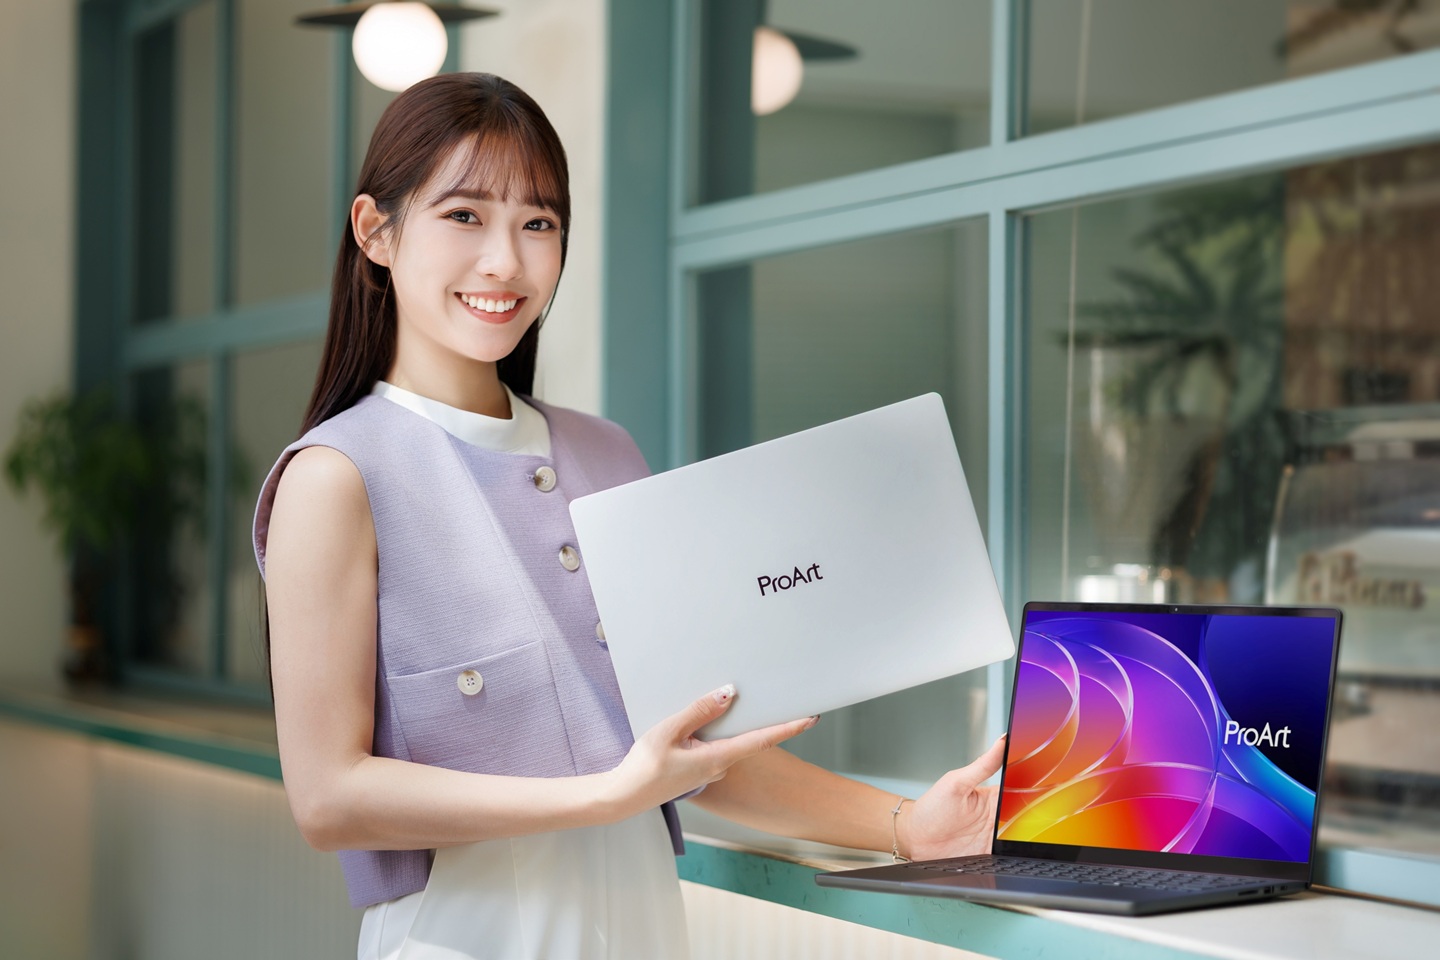
Asus同時也發表了搭載14、16吋OLED面板顯示器的ProArt P14、P16筆記型電腦,前者重量僅1.48 KG、厚度13.9mm,搭載90Wh電池;後者則為1.77 KG、12.9mm,並配備99.9Wh大容量電池, 128 GB容量記憶體版本建議售價分別為新台幣249,999、269,999元,預計10月16日晚上8點正式上市。

Surface Laptop Ultra最高支援128 GB LPDDR5x統一架構記憶體,並可在NVFP4資料類型運算時提供1PFLOF的理論效能。

在使用電池運作的時候,Surface Laptop Ultra能夠維持插電運作的99%效能表現。

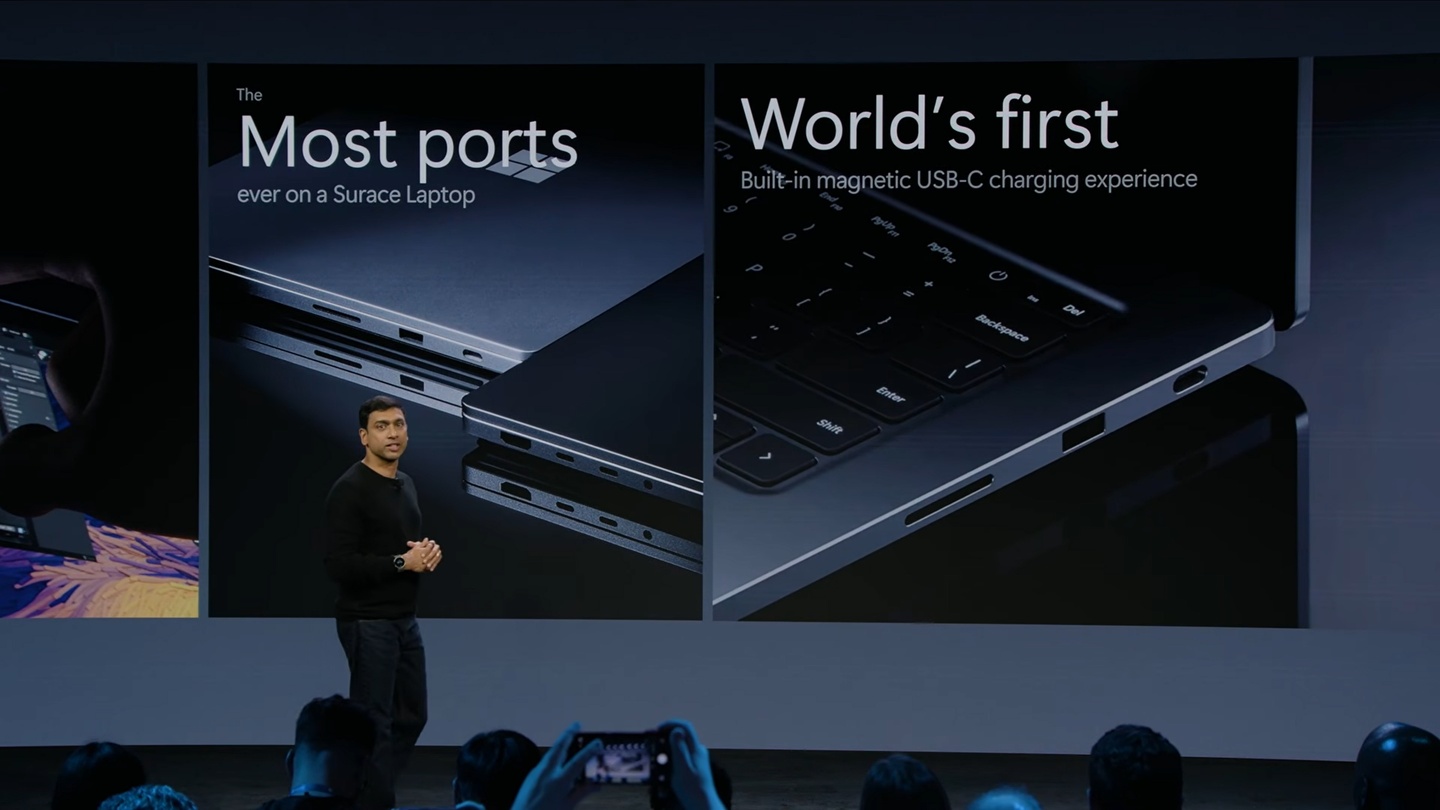
Surface Laptop Ultra提供USB Type-C、HDMI、3.5mm耳機麥克風複合端子、SD讀卡機等豐富I/O功能。

Surface Laptop Ultra也導入世界首款磁吸式USB Type-C充電端子。

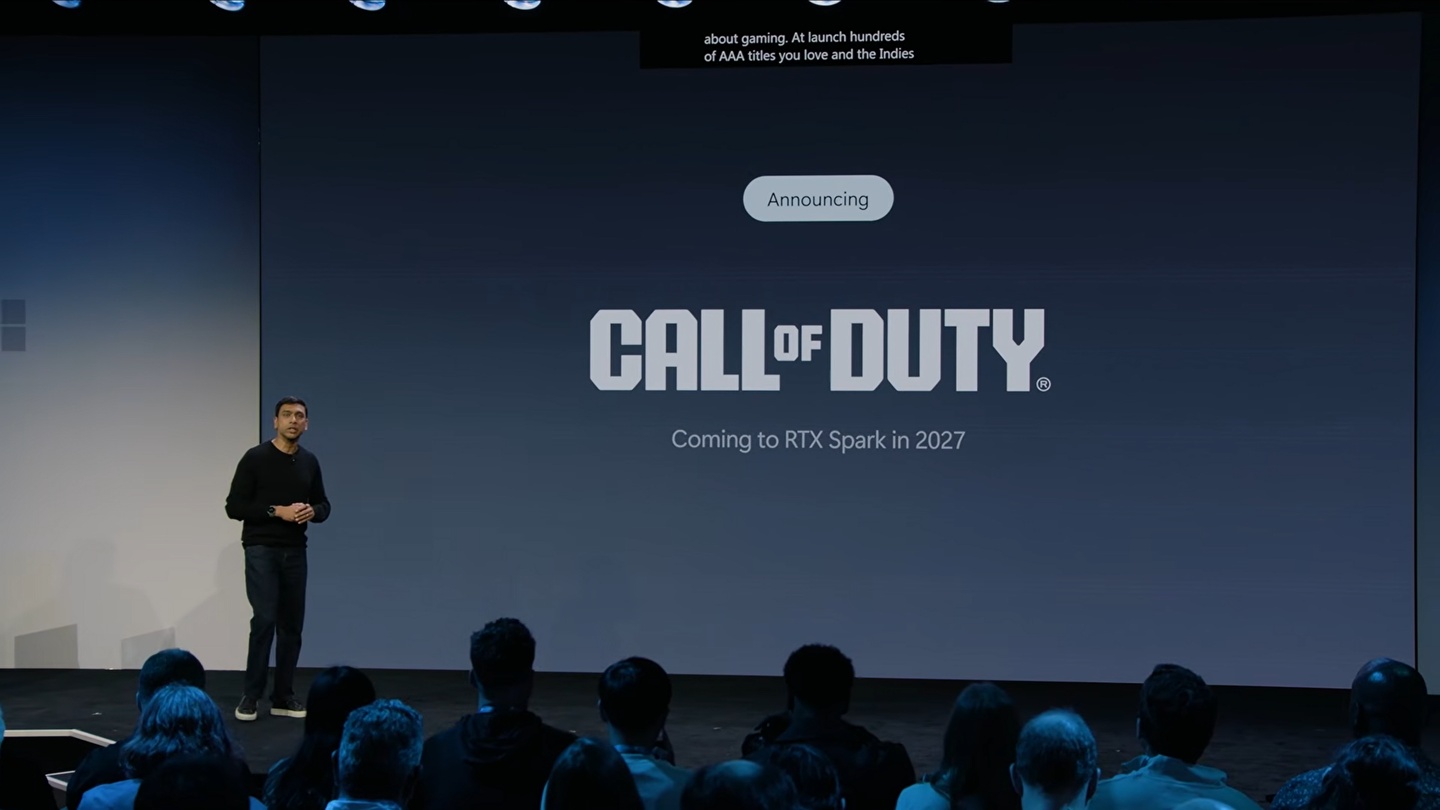
Pavan預告決勝時刻(Call of Duty) 系列作品將會登陸RTX Spark平台,並確保效能最佳化。

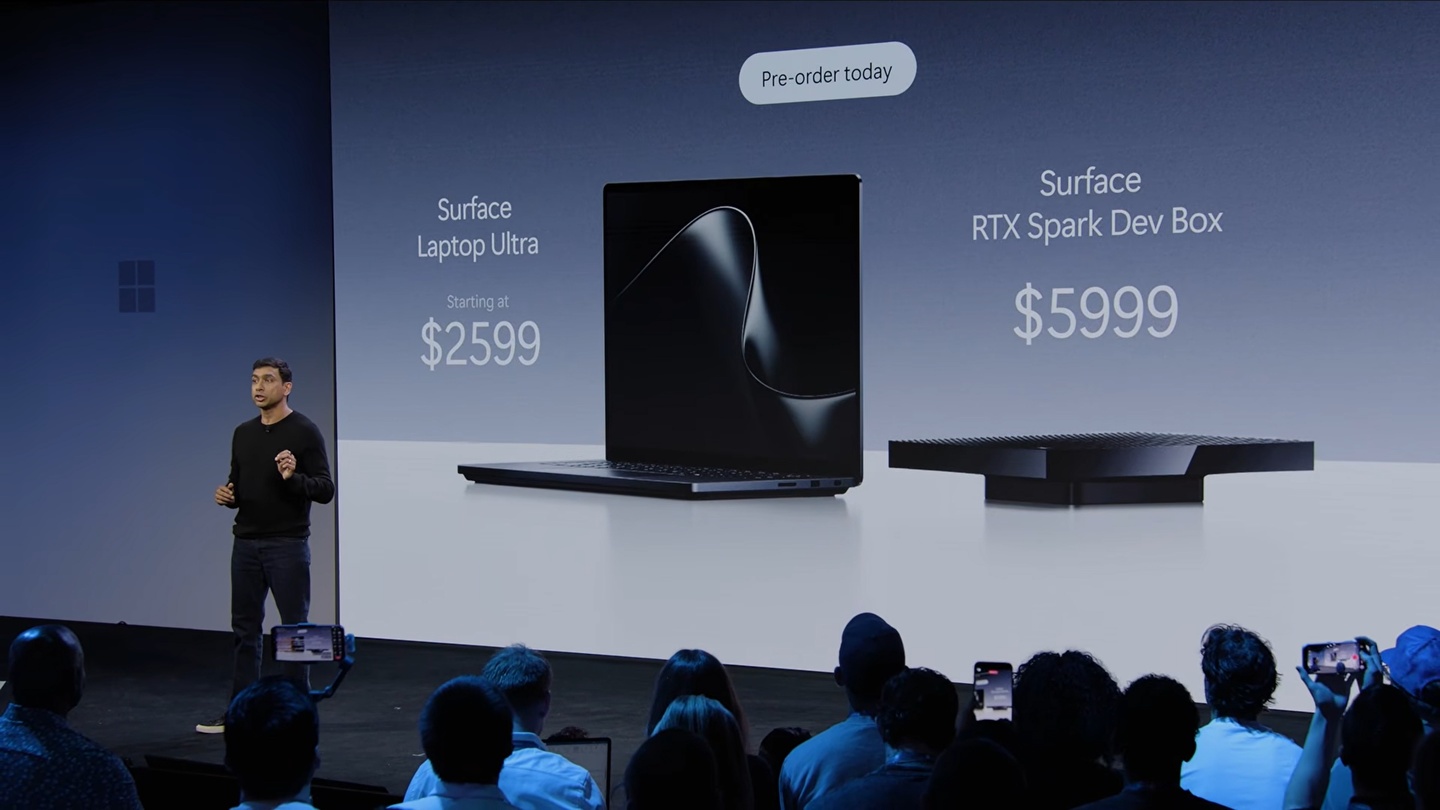
Surface Laptop Ultra的預定售價為美金2599元(約合新台幣83,380元)起。另一方面Microsoft也推出預定售價為美金5999元(約合新台幣192,390元)的RTX Spark Dev Box開發套件。

此外Microsoft與NVIDIA也會與Asus、Dell、HP、Lenovo、Msi等合作夥伴共同推出多款搭載RTX Spark SoC的機種。

Asus ProArt P14、P16筆記型電腦提供14、16吋OLED面板顯示器以及多種記憶體容量選擇。

更多廠商推出的RTX Spar產品可以參考筆者先前於在Computex 2026台北國際電腦展製作的專題報導。

加入T客邦Facebook粉絲團

迷你AI鋼鐵小霸王!NVIDIA DGX Spark推出64GB版抗漲,搭配NVIDIA Sync管理平台可四台串接挑戰運算極限

2026年10月2日 21:00
NVIDIA更新DGX Spark產品陣容,NVIDIA Sync強化多機串聯、64 GB版本價格更親合62db9e0f55acf98825d3731cd2ee1f2f

NVIDIA透過推出NVIDIA Sync管理平台協助使用者建立最多4台DGX Spark構成的運算叢集,並因應記憶體價格波動,推出64 GB版本DGX Spark。

本地端代理式AI運算需求大增

NVIDIA於2025年10月15日正式推出DGX Spark超級AI迷你電腦,其尺寸僅為15 x 15 x 5.05公分,搭載GB10 Grace Blackwell Superchip晶片與容量高達128 GB的統一記憶體,在使用FP4資料類型時能夠達到1PFLOPS浮點數運算效能,並且能夠執行參數量高達200B的AI模型推論運算,或是微調參數量高達70B的AI模型。

延伸閱讀:
CES2025:DGX超級電腦也搞Mini,NVIDIA推出搭載GB10 Superchip的Project DIGITS工作站
CES2025:NVIDIA Project DIGITS迷你AI工作站拆解,內部GB10 Superchip實體搶先看
NVIDIA DGX Spark迷你AI超級電腦開賣,多位合作夥伴推出自有品牌機型

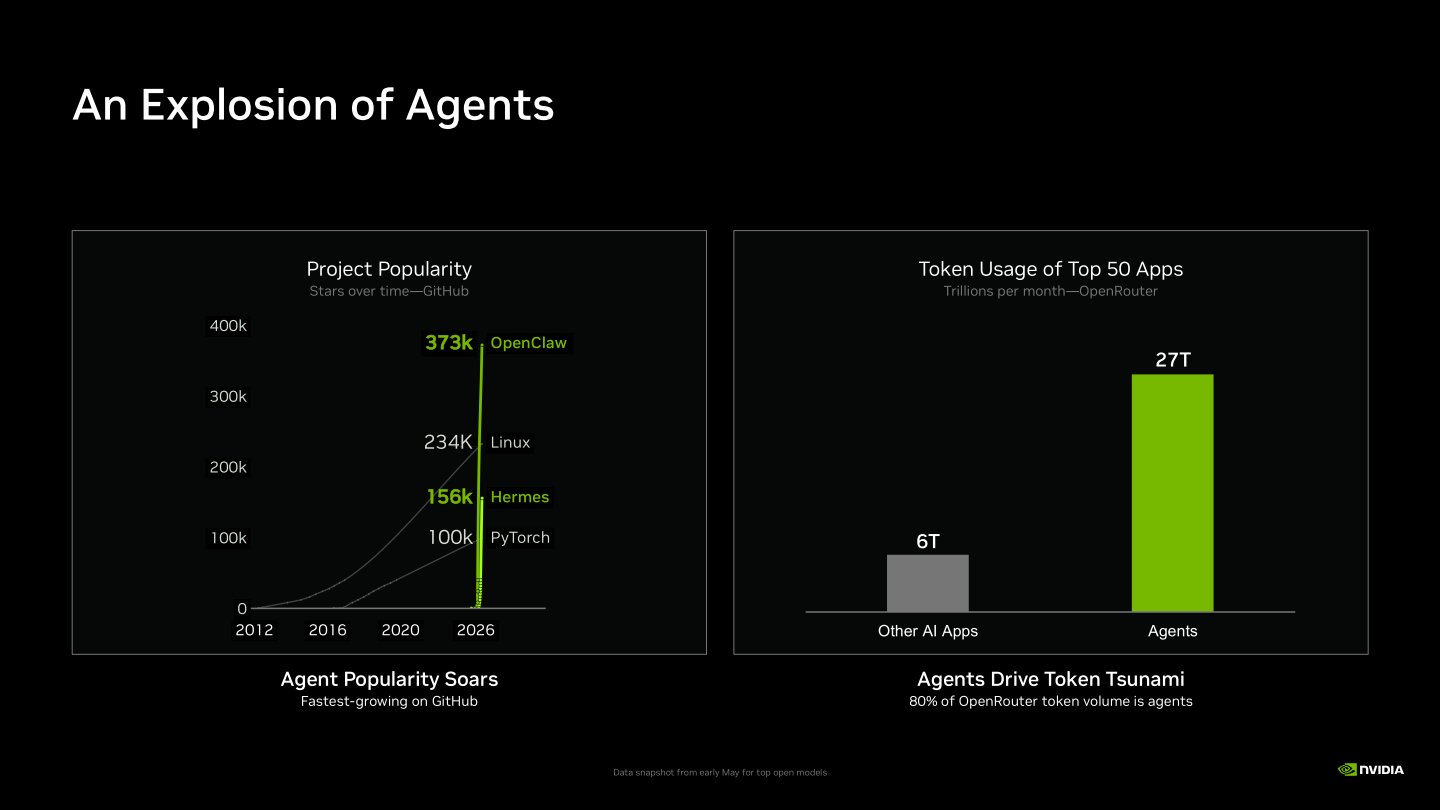
根據NVIDIA的分析,作為代理式AI的代表軟體,OpenClaw(龍蝦)的GitHub專案在短短不到1年內獲得37.3萬個星星(即按讚數量),成長速度甚至超越Linux,可見其熱門程度。

但是另一方面,代理式AI的Token(字詞)用量更大,在OpenRouter路由平台中更是佔據了所有AI運算的80% Token用量,造成使用雲端AI服務的成本上升,進而促進本地端AI的需求提升。

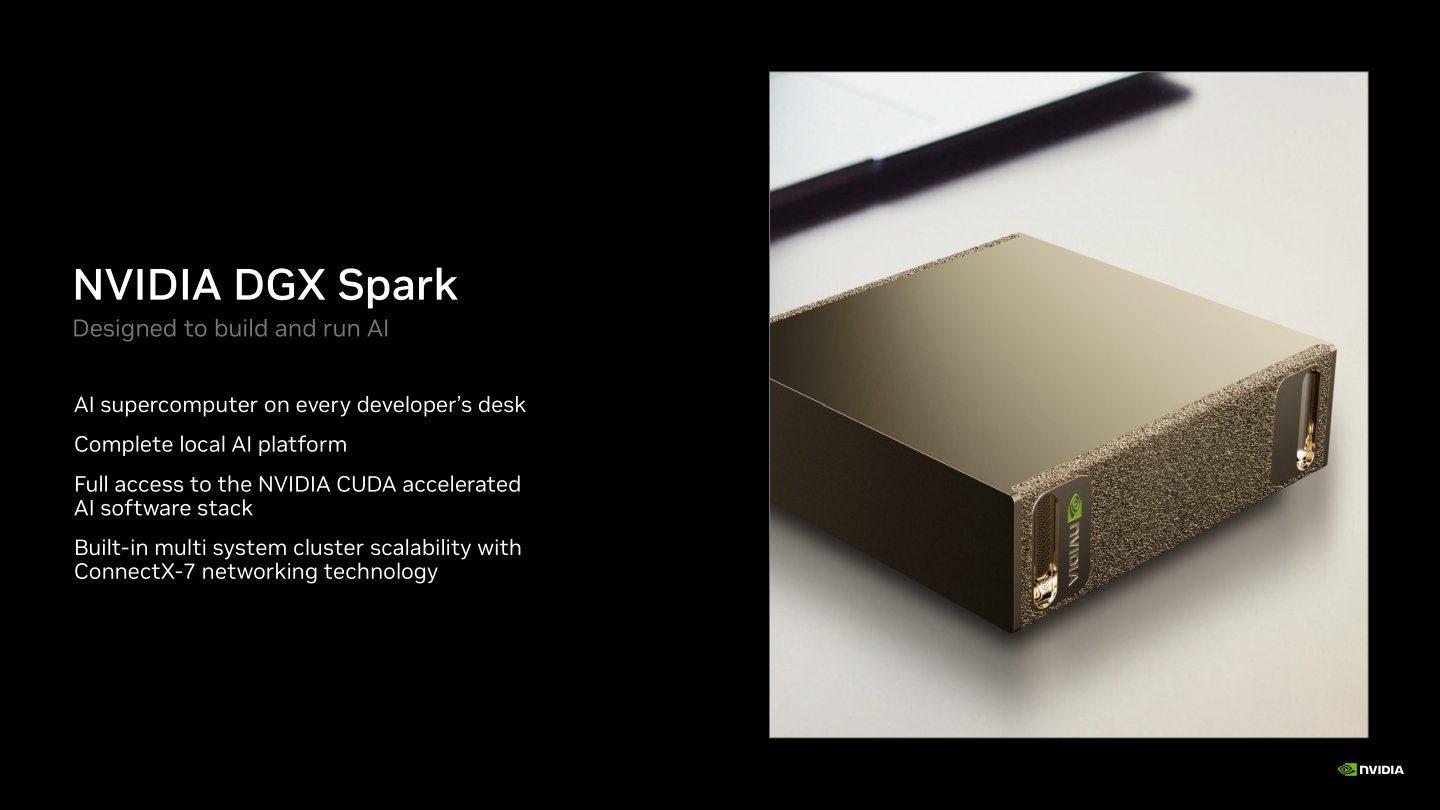
DGX Spark超級AI迷你電腦搭載整合CPU與GPU於一體的GB10 Grace Blackwell Superchip晶片,具有高達到1PFLOPS浮點數運算效能。

OpenClaw的GitHub專案星星累計速度相當驚人,是有史以來成長最快的專案。

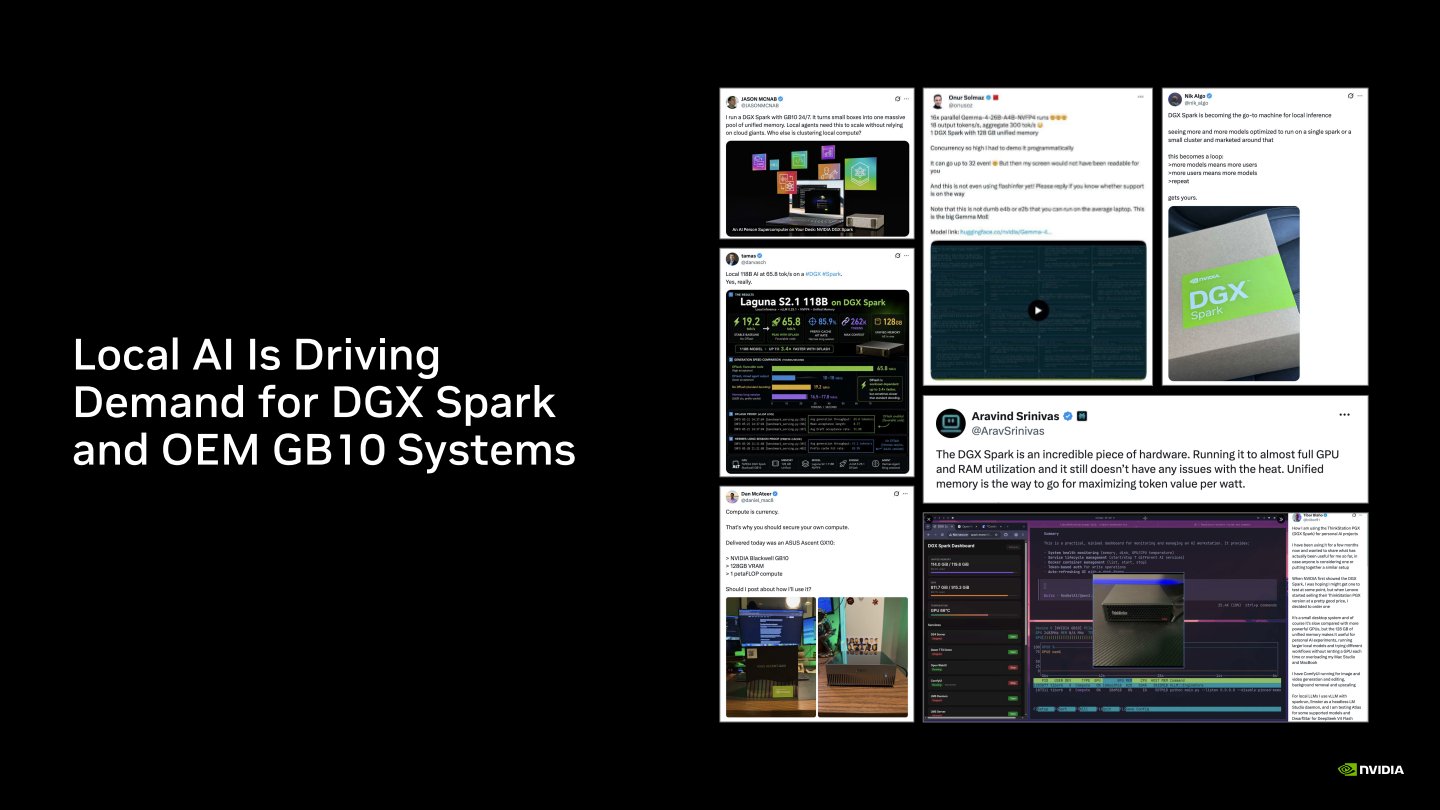
DGX Spark相當適合應用於本地端AI推論運算。

DGX Spark支援完整的CUDA生態系統與AI軟體堆疊,可以降低程式開發與移植的阻力。

降低記憶體抑制價格

由於近期記憶體的價格持續飆漲,造成搭載128 GB LPDDR5x的原始版本DGX Spark建議售價由最初美金3999元(約合新台幣128,670元)調漲至美金4699元(約合新台幣151,190元),在2026年10月2日之後更要一舉調漲至美金6950元(約合新台幣223,615元)。

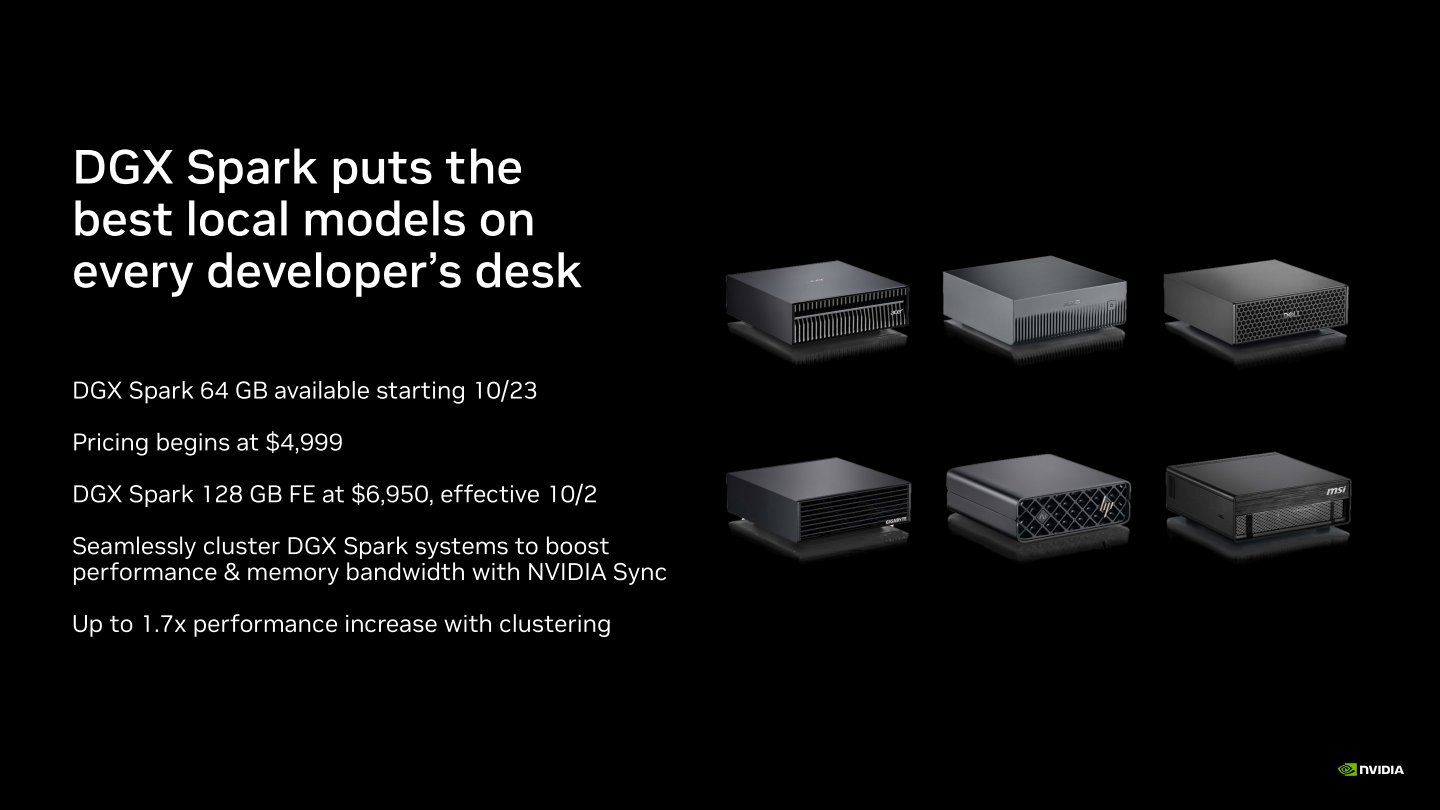
為了降低DGX Spark的購入成本,NVIDIA與OEM合作夥伴推出降記憶體容量減半的64 GB版本DGX Spark。由於調整的規格僅為記憶體,因此不會影響CPU(處理器)與GPU(繪圖處理器)的運算效能,也相容所有128 GB版本的軟體堆疊,主要的影響在於僅能載入參數量較小的AI模型。

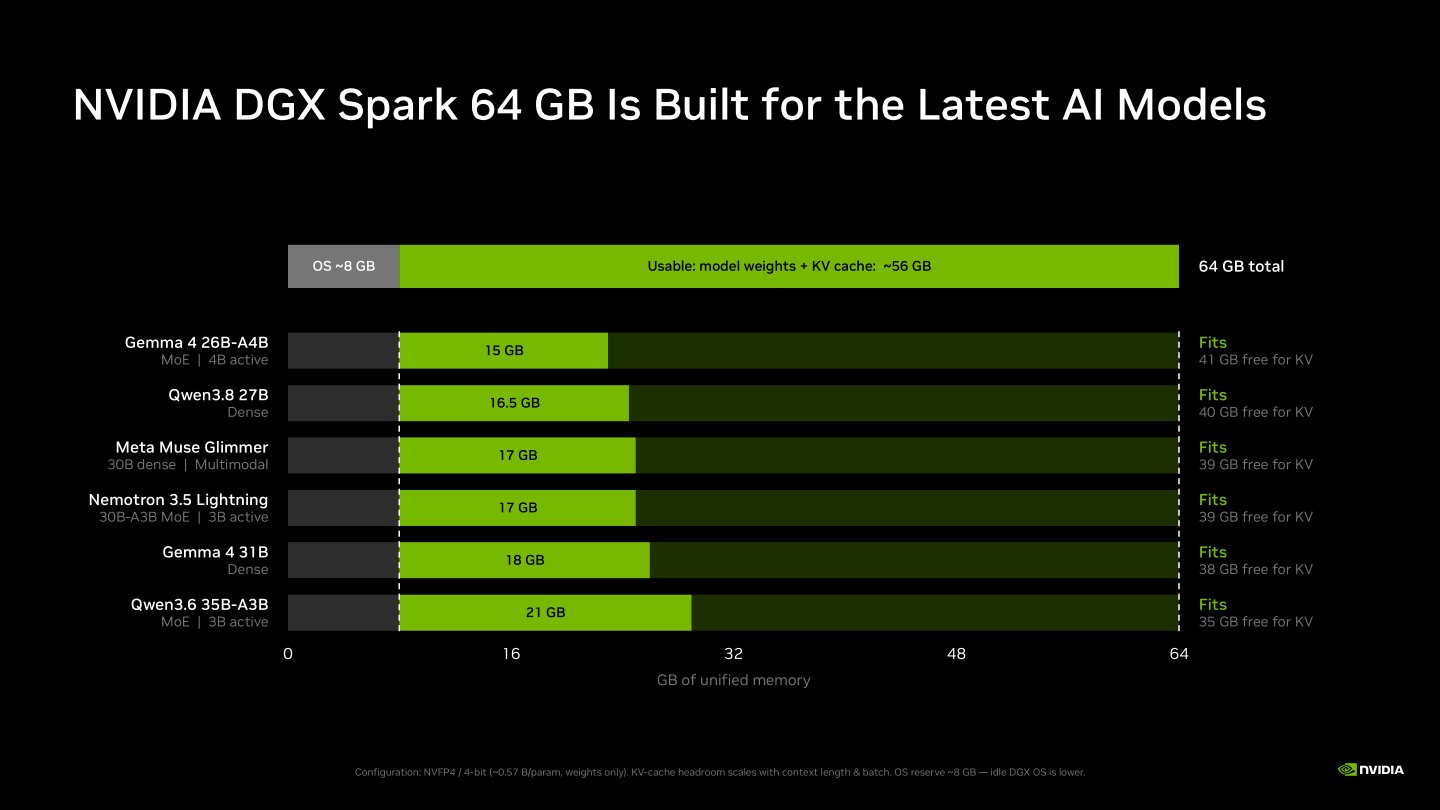
NVIDIA說明的64 GB版本DGX Spark能支援參數量最大達100B的AI模型,並估算作業系統將佔用大約8 GB的容量,因此64 GB版本DGX Spark將保有約56 GB的空間能夠容納模型與KV Cache快取值。在執行多款參數量為26B~35B模型之AI推論運算時,模型本身佔用15 ~ 21 GB不等容量,留下41 ~ 35 GB的閒置記憶體可供KV Cache快取使用。

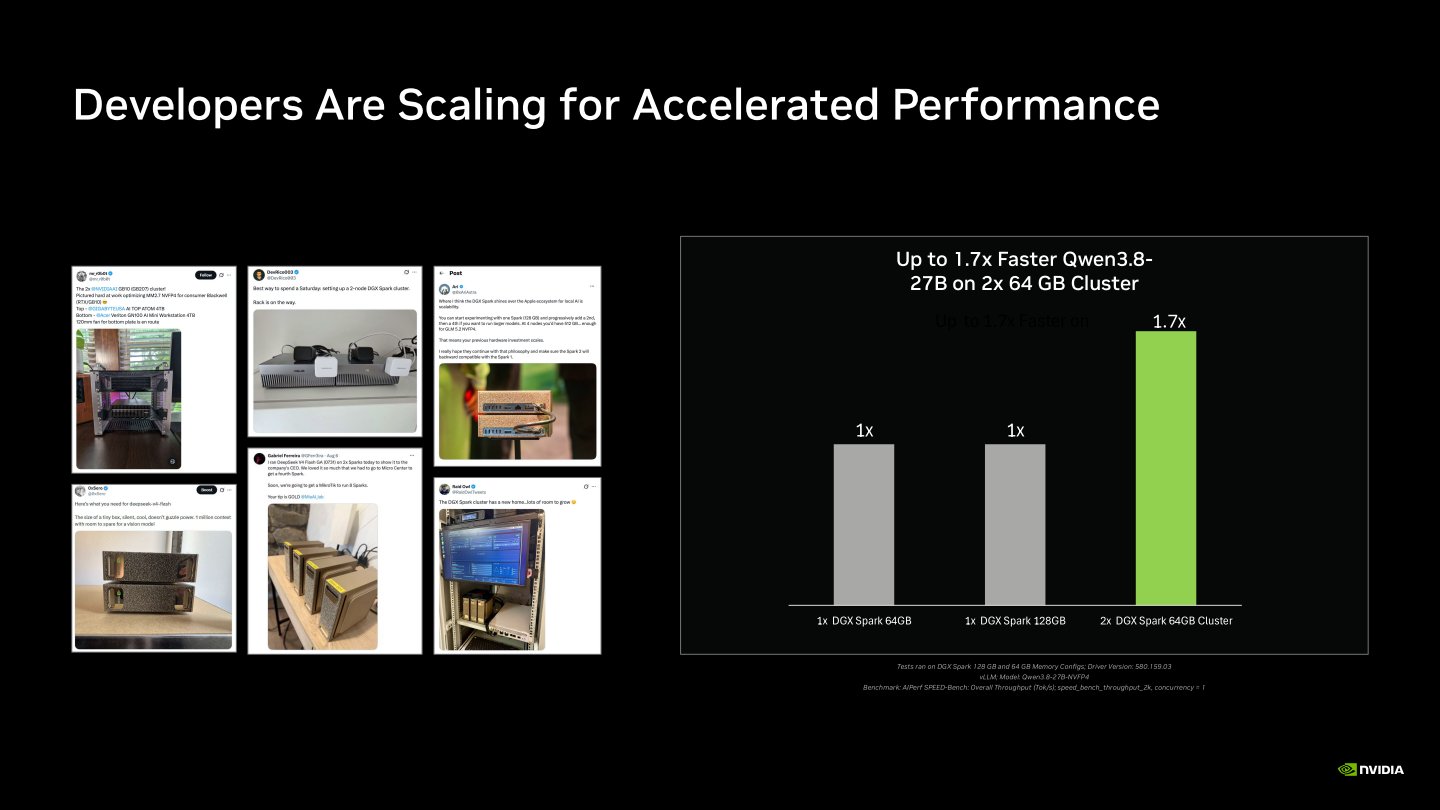
另一方面,使用者也能透過ConnectX網路串接多台DGX Spark進行橫向擴展(Scale-Out),不但能夠擴展記憶體池的總容量,透過組建叢集的方式提升運算效能,根據NVIDIA提供的數據,串接2台64 GB版本DGX Spark時將能讓記憶體池的總容量達到128 GB,以支援參數量最大達200B的AI模型,並可達到1台之1.7倍效能輸出。

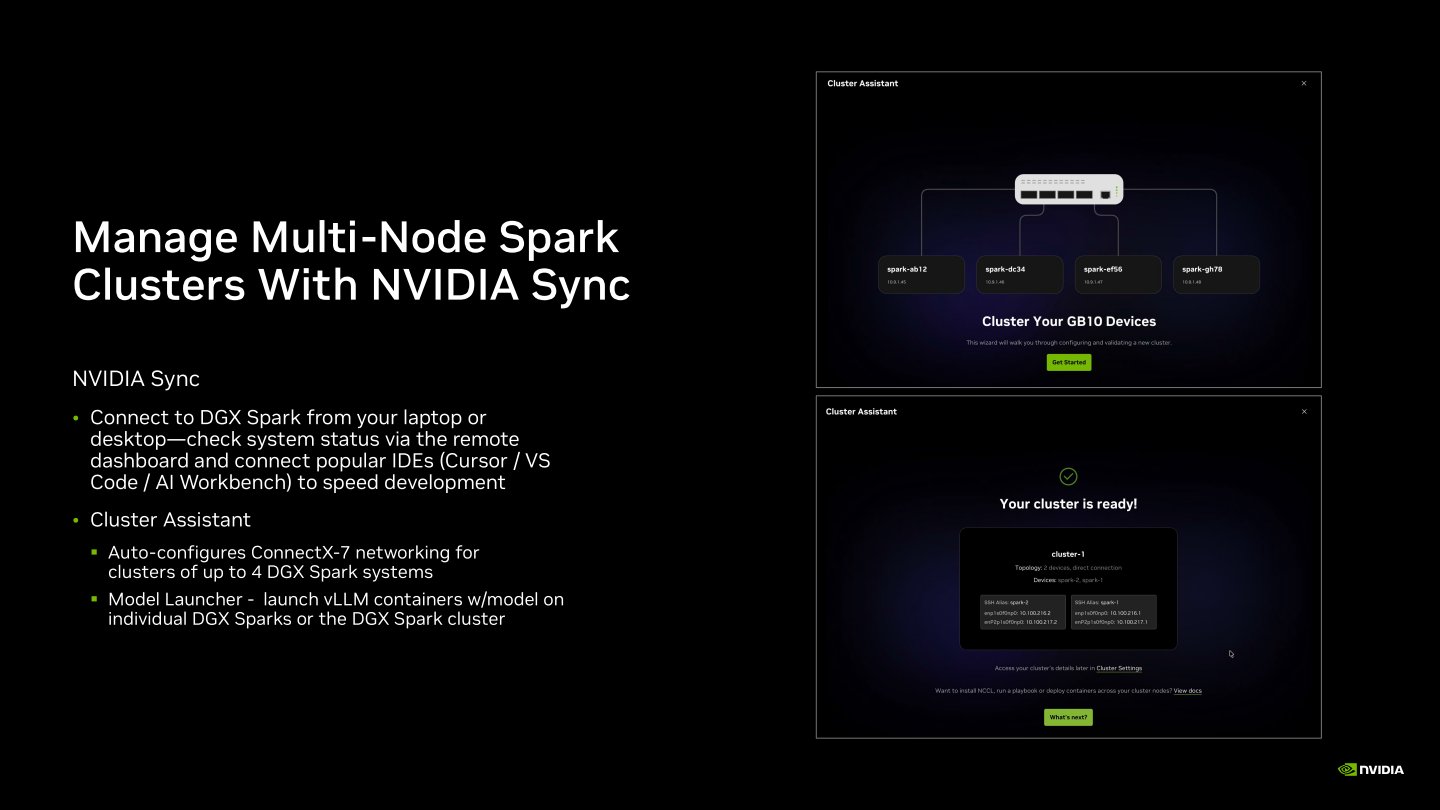
另一方面,NVIDIA也推出NVIDIA Sync管理平台,協助使用者建立最多4台DGX Spark的運算叢集,並自動調整、最佳化ConnectX-7網路,並提供可於其他電腦遠端操作的控制平台,以及整合至其他開發環境的遠端功能,使用者也可以NVIDIA Sync中的模型啟動器管理、啟動vLLM容器,簡化整體管理與操作流程。

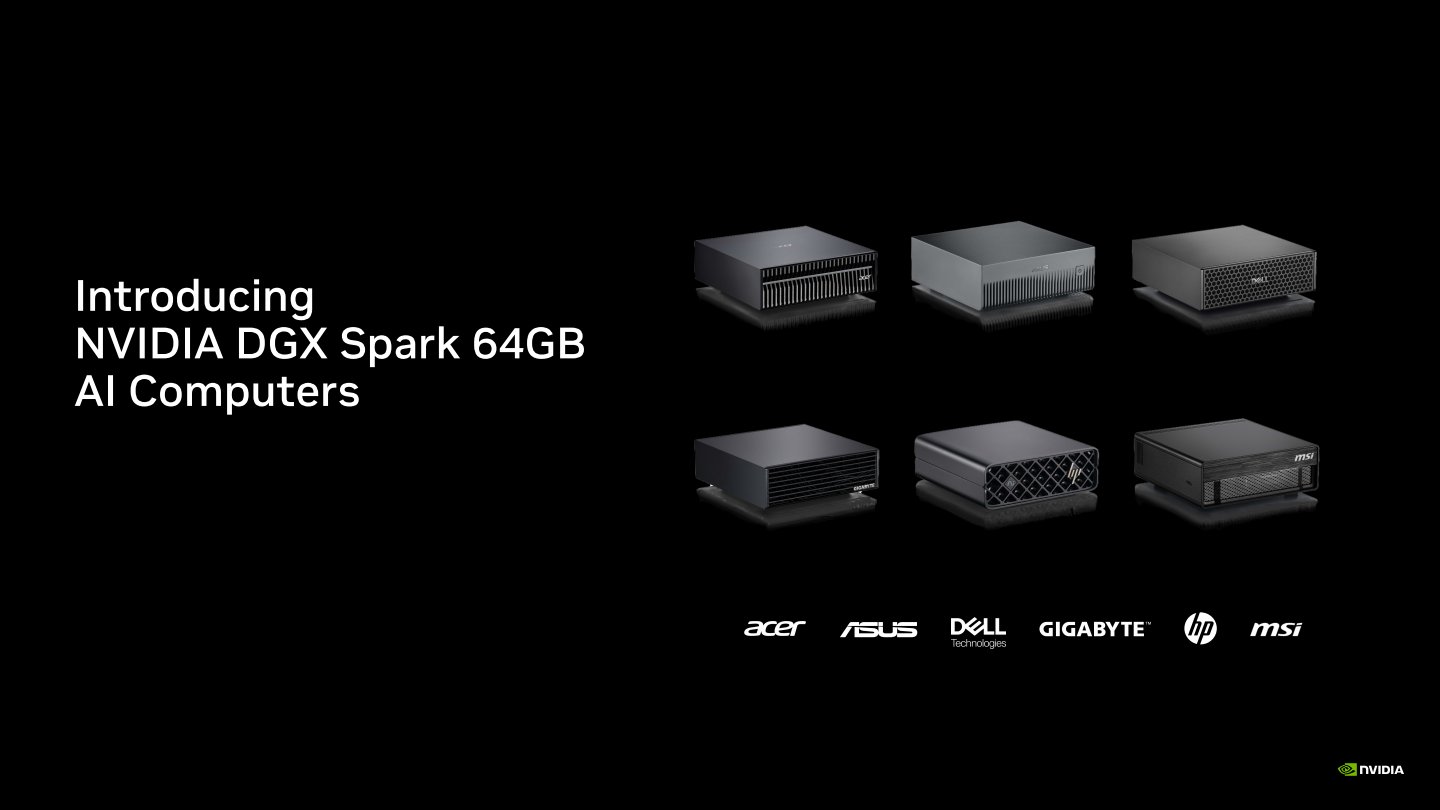
NVIDIA宣佈將與Acer、Asus、Dell、GIGABYTE、HP、Msi等OEM合作夥伴供同推出64 GB版本DGX Spark。

NVIDIA估算作業系統將佔用大約8 GB的容量,因此64 GB版本DGX Spark執行多款參數量為26B~35B模型之AI推論運算時,模型本身佔用15 ~ 21 GB不等容量,留下41 ~ 35 GB的閒置記憶體可供KV Cache快取使用。

串接2台64 GB版本DGX Spark時能將記憶體池總容量擴充至128 GB,並可達到1台之1.7倍效能輸出。

NVIDIA Sync管理平台能夠建立、管理最多4台DGX Spark的運算叢集。

128 GB版本的DGX Spark將於2026年10月2日調整價格,64 GB版本將於10月23日上市。

64 GB版本DGX Spark將於2026年10月23日發售,建議售價為美金4999元(約合新台幣160,840元),NVIDIA將不會推出自家Founders Edition機種,僅會有Acer、Asus、Dell、GIGABYTE、HP、Msi等OEM合作夥伴之機種。

加入T客邦Facebook粉絲團

PaperMono電子紙開發板,自己土砲閱讀器、識別證、門禁卡

2026年9月21日 09:00
PaperMono是款搭載ESP32-S3R8微控制器的開發板,並配有3.97吋觸控電子紙顯示器,能夠作為多種裝置使用。7d36a5c28159ad26efd51f46c51f1df0

PaperMono是款搭載ESP32-S3R8微控制器的開發板,並配有3.97吋觸控電子紙顯示器,能夠作為多種裝置使用。

多重連網功能

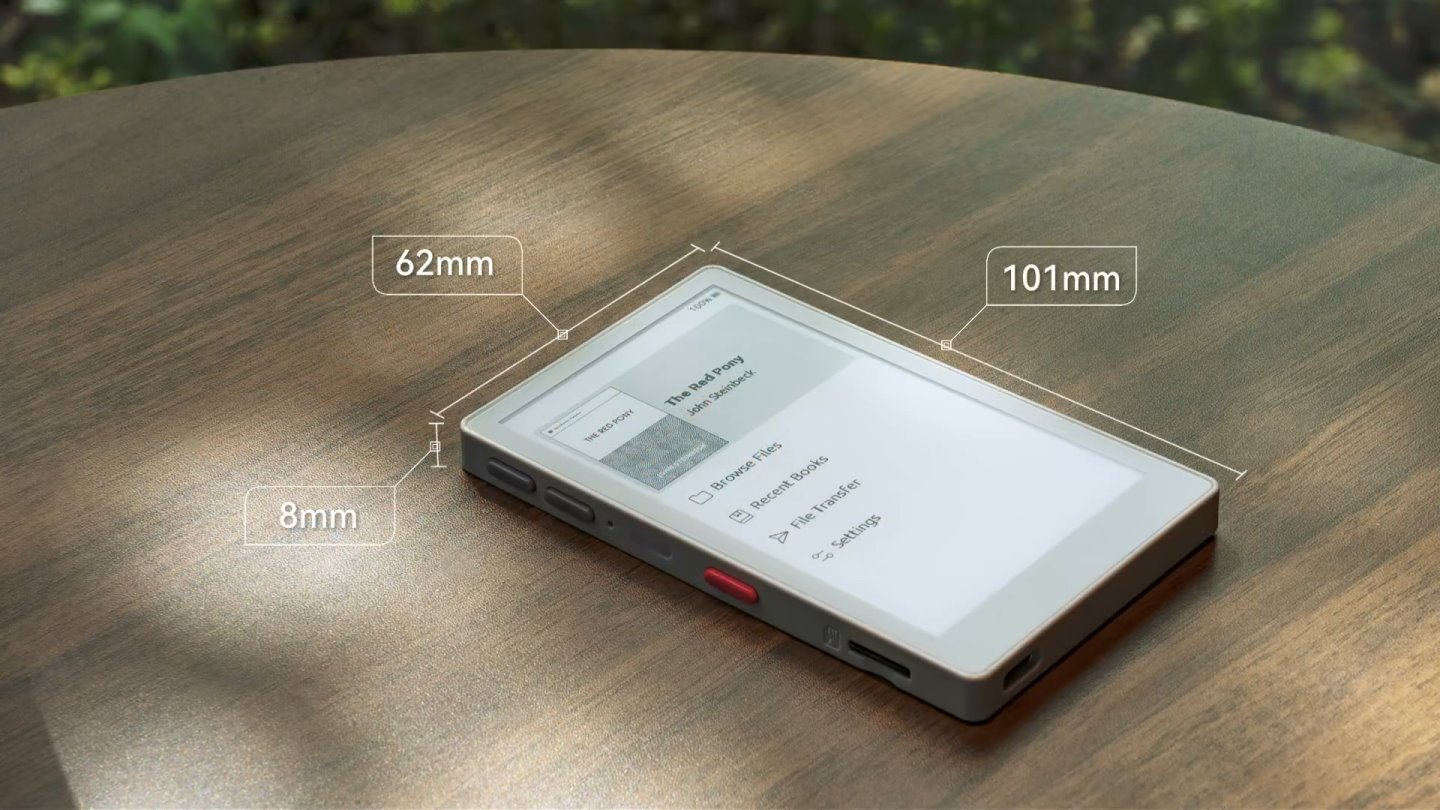
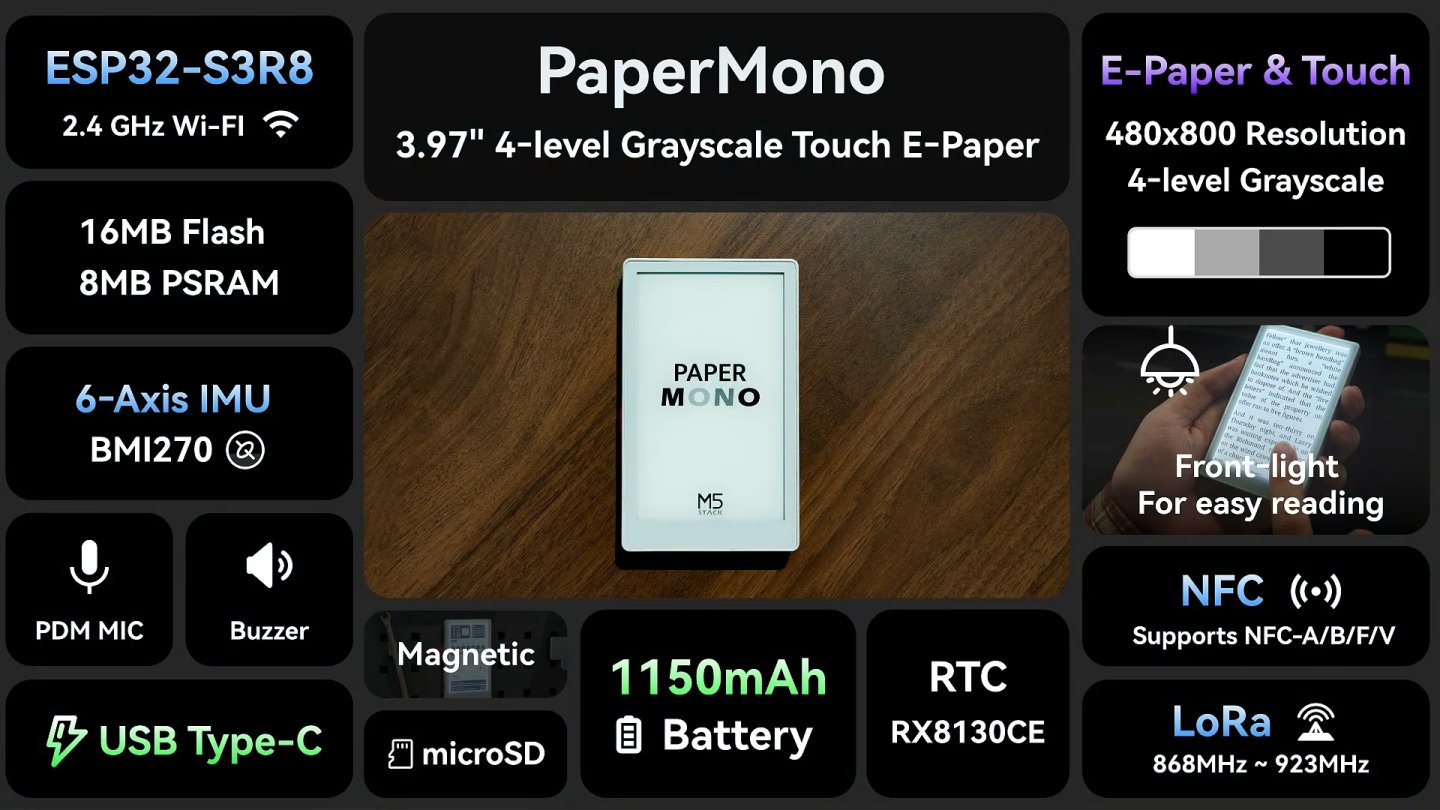
PaperMono的尺寸為6.2 x 10.1 x 0.8 cm,搭載解析度為480 x 800且具有前光功能的4級灰階3.97吋觸控電子紙顯示器,並搭載ESP32-S3R8微控制器,具有16MB Flash ROM、8MB PSRAM儲存媒體,支援2.4GHz頻段的Wi-Fi無線網路,還可選配NFC與LoRa等無線通訊功能,具有豐富的連接能力。

延伸閱讀:
低功耗廣域網路串起物聯網裝置(2):LoRa
Modos Paper Monitor土砲E‑ink電子紙顯示器套件,更新頻率高達75 Hz
ZerryBit E-ink電子紙資訊顯示器,小紅旋鈕操作更靈活

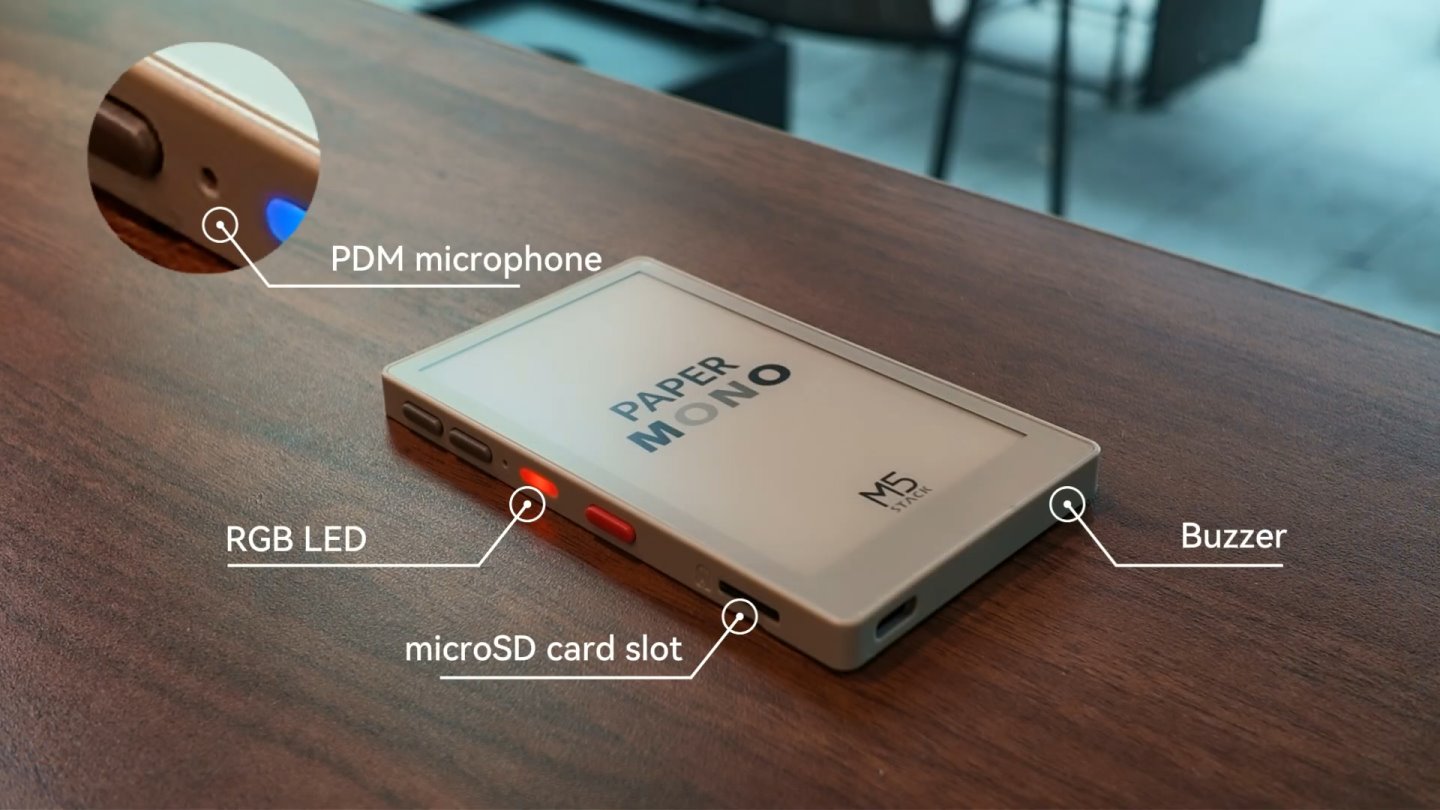
此外PaperMono也內建microSD讀卡機、蜂鳴器、PDM麥克風、六軸動態感應器、多級電源管理系統和1150mAh電池等元件,並具有觸控螢幕、實體按鍵、RGB LED等功能。

PaperMono除了可以做為電子書、閱讀器等裝置之外,電子紙類型的顯示器也讓它適合作為需要長時間顯示資訊的識別證、資訊看板等應用,並透過Wi-Fi、LoRa等通訊方式更新資訊,此外NFC功能也讓它能夠作為門禁卡。

PaperMono是款尺寸為6.2 x 10.1 x 0.8 cm、搭載3.97吋觸控電子紙顯示器的開發板。

它能透過觸控螢幕與3組實體按鍵進行操作,並內建microSD讀卡機、蜂鳴器、PDM麥克風等功能。

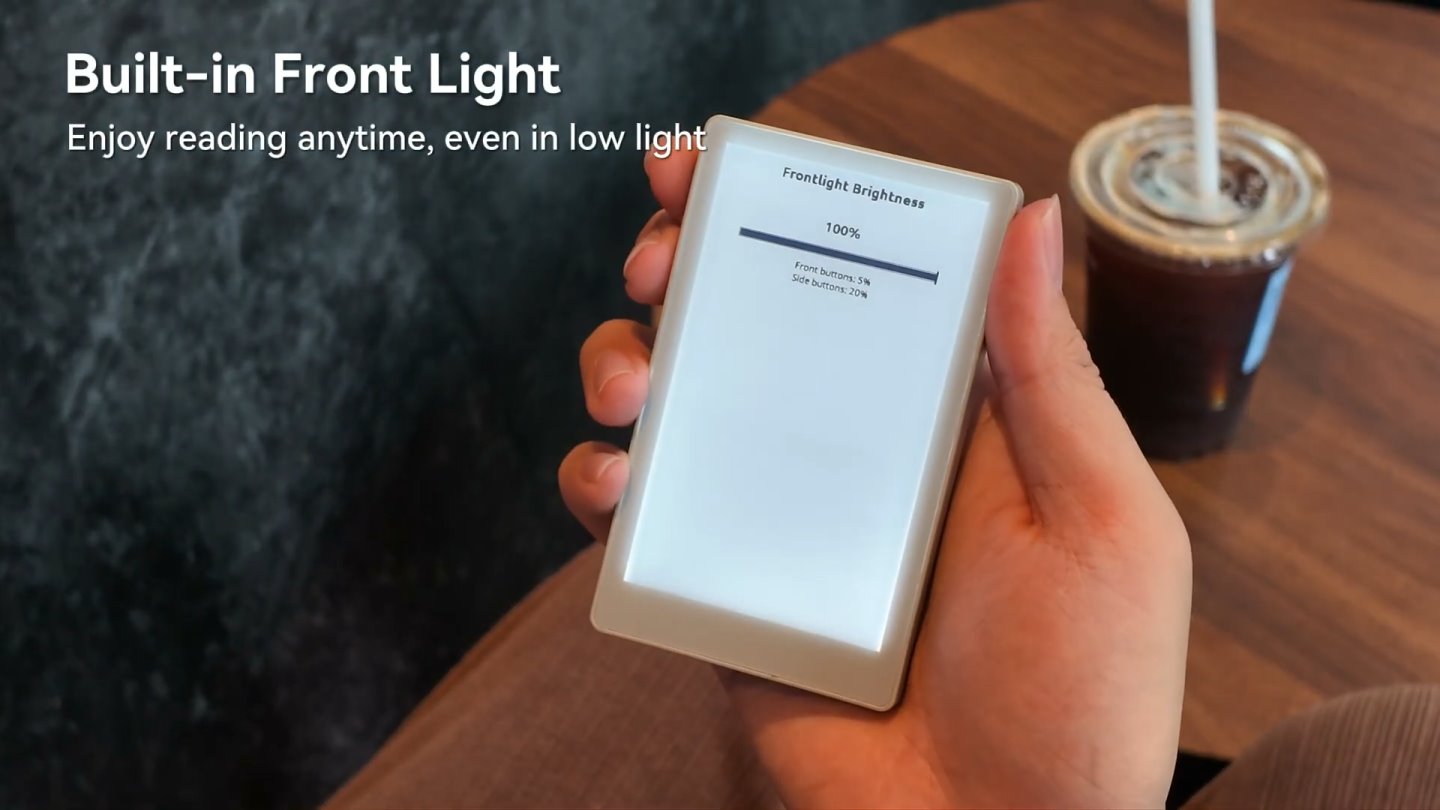
內建的可調式前光功能方便在陰暗處查看畫面資訊。

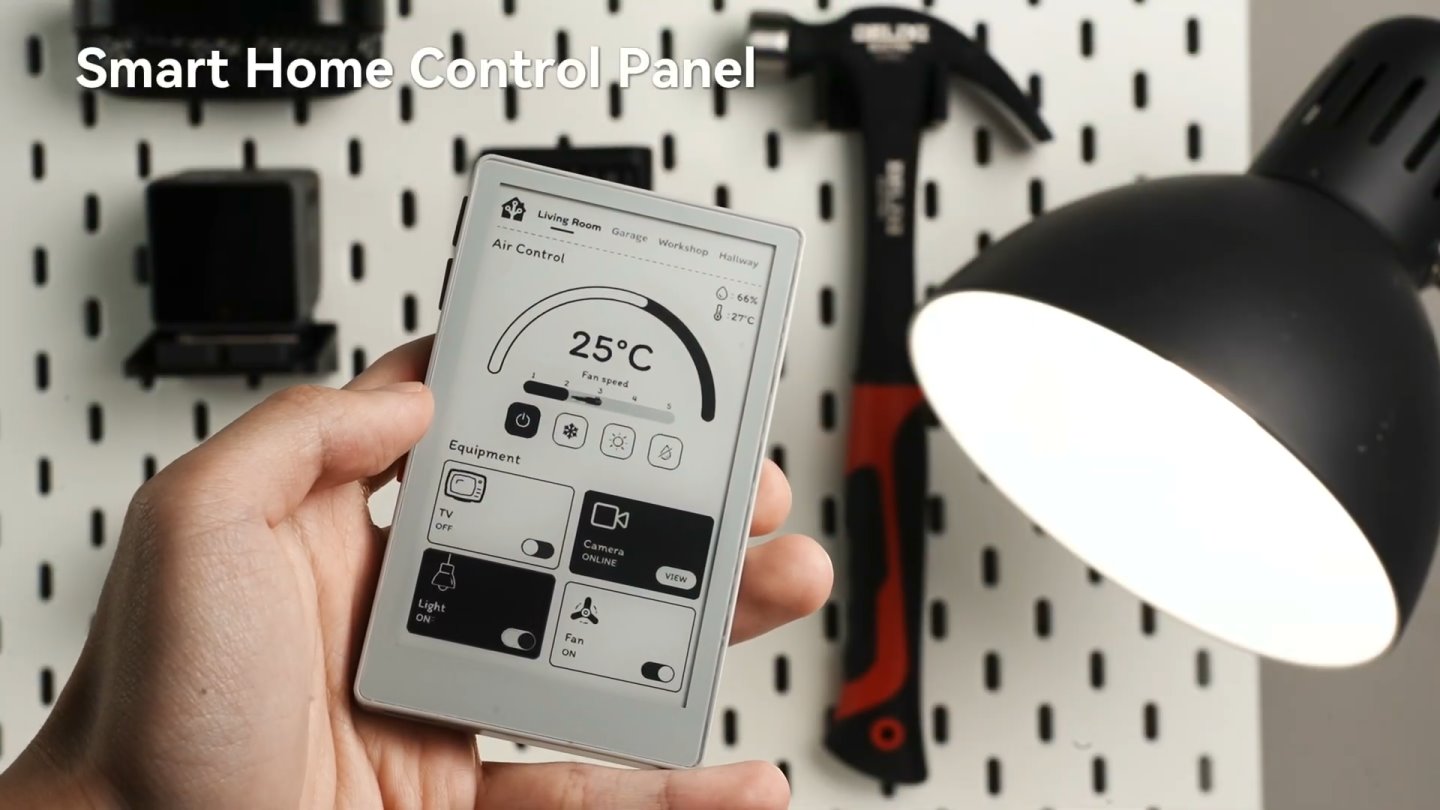
PaperMono支援Wi-Fi、LoRa、NFC等無線通訊功能,也很適合作為資訊看板、智慧居家中樞等應用。

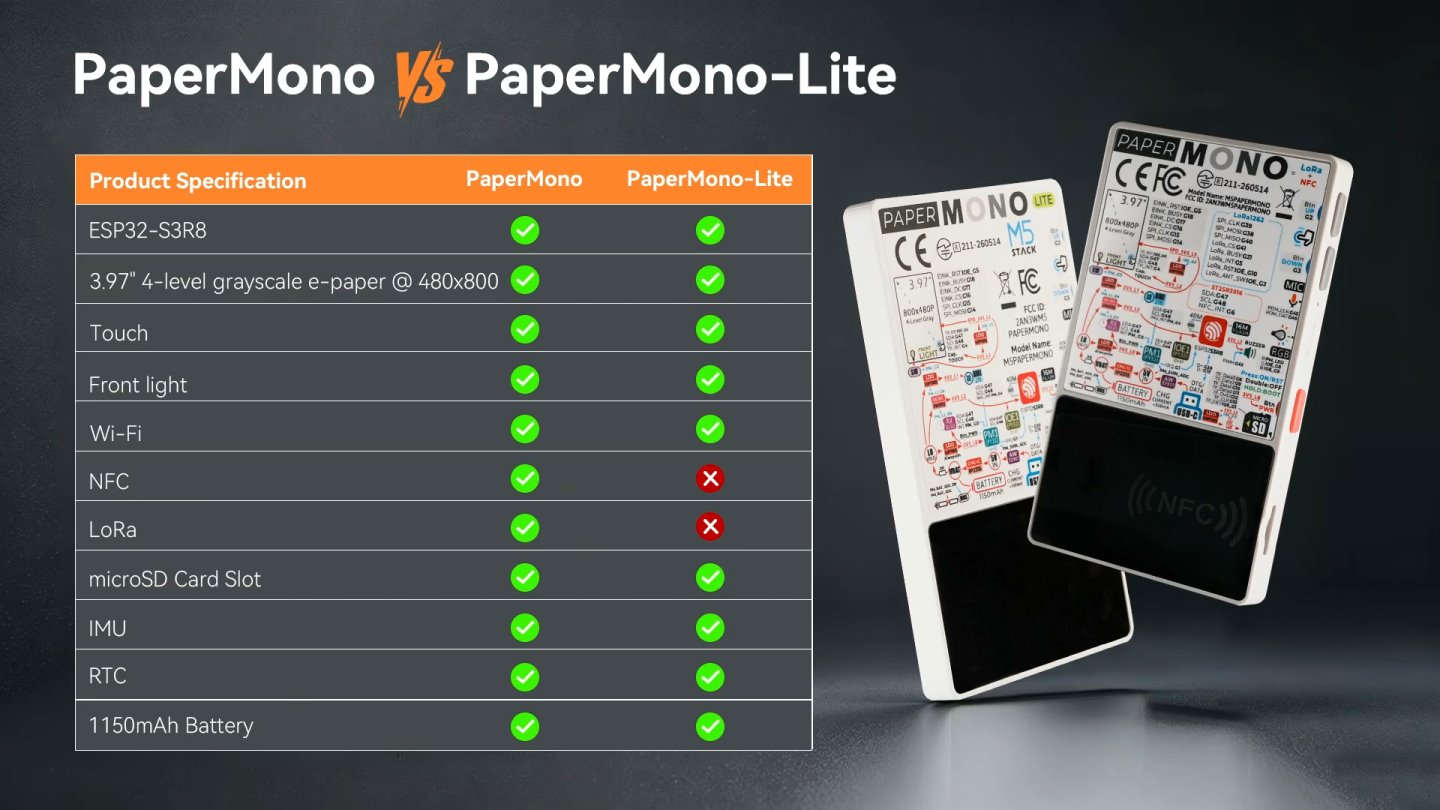
PaperMono規格簡表。

PaperMono一般版具有LoRa、NFC功能,Lite版則取消。

具有LoRa、NFC功能的一般版PaperMono價格為美金65元(約合新台幣2,090元),Lite版則為美金55元(約合新台幣1,770元),現已上市。

加入T客邦Facebook粉絲團

Arm發表實體AI全面設計與Neoverse CSS N4運算子系統,與合作夥伴共同加速AI機器人與雲端運算轉型

2026年9月20日 09:00
Arm於Tech Day 2026發表針對機器人應用的實體AI全面設計生態系,以及針對雲端運算的Neoverse CSS N4運算子系統。Fdd4b48c4055d125e5fdfd63fb92e541

Arm Tech Day 2026除了發表針對行動裝置設計的CSS for Mobile 2行動裝置運算子系統之外,也發表針對機器人應用的實體AI全面設計生態系,以及針對雲端運算的Neoverse CSS N4運算子系統。

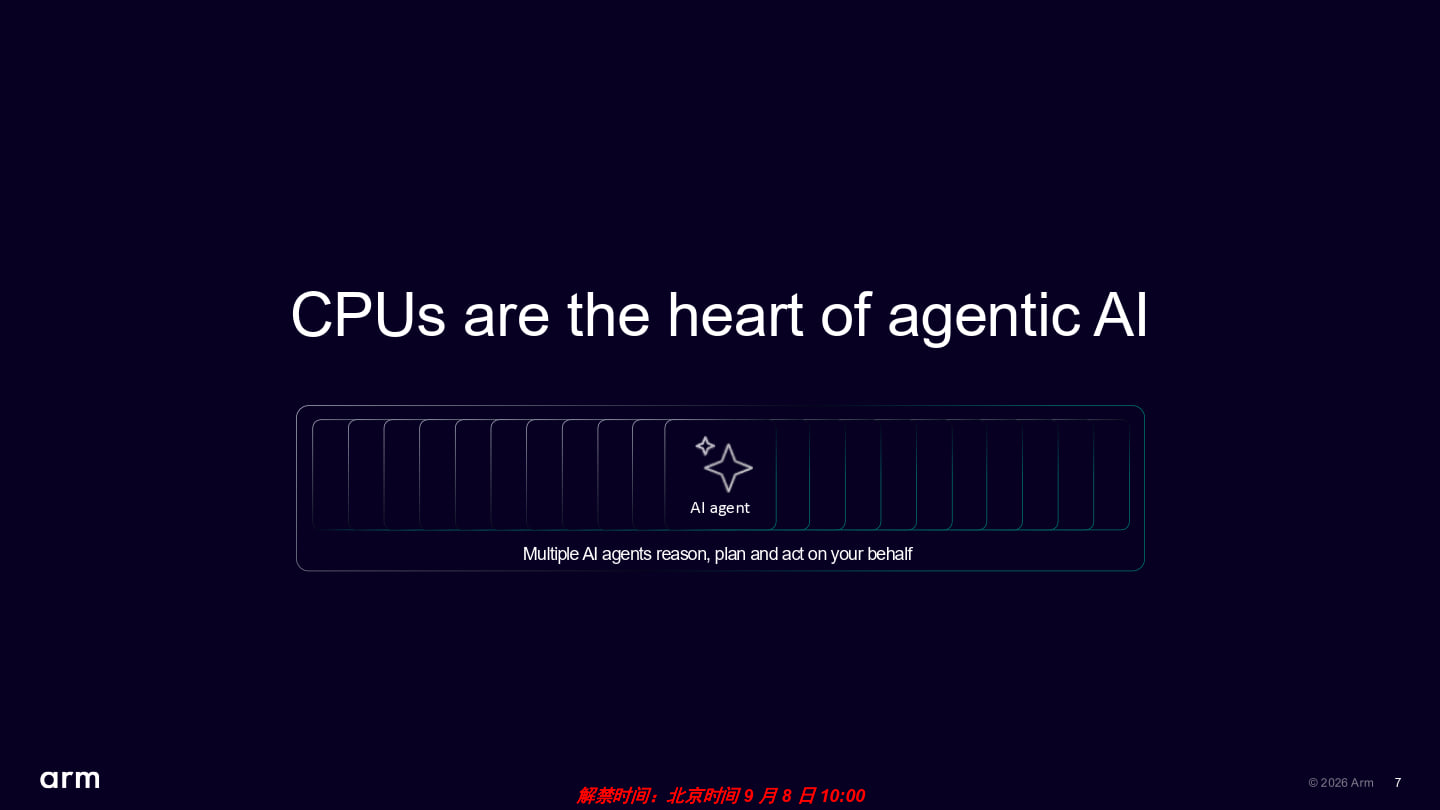
邊緣、實體、雲端都會遇到AI

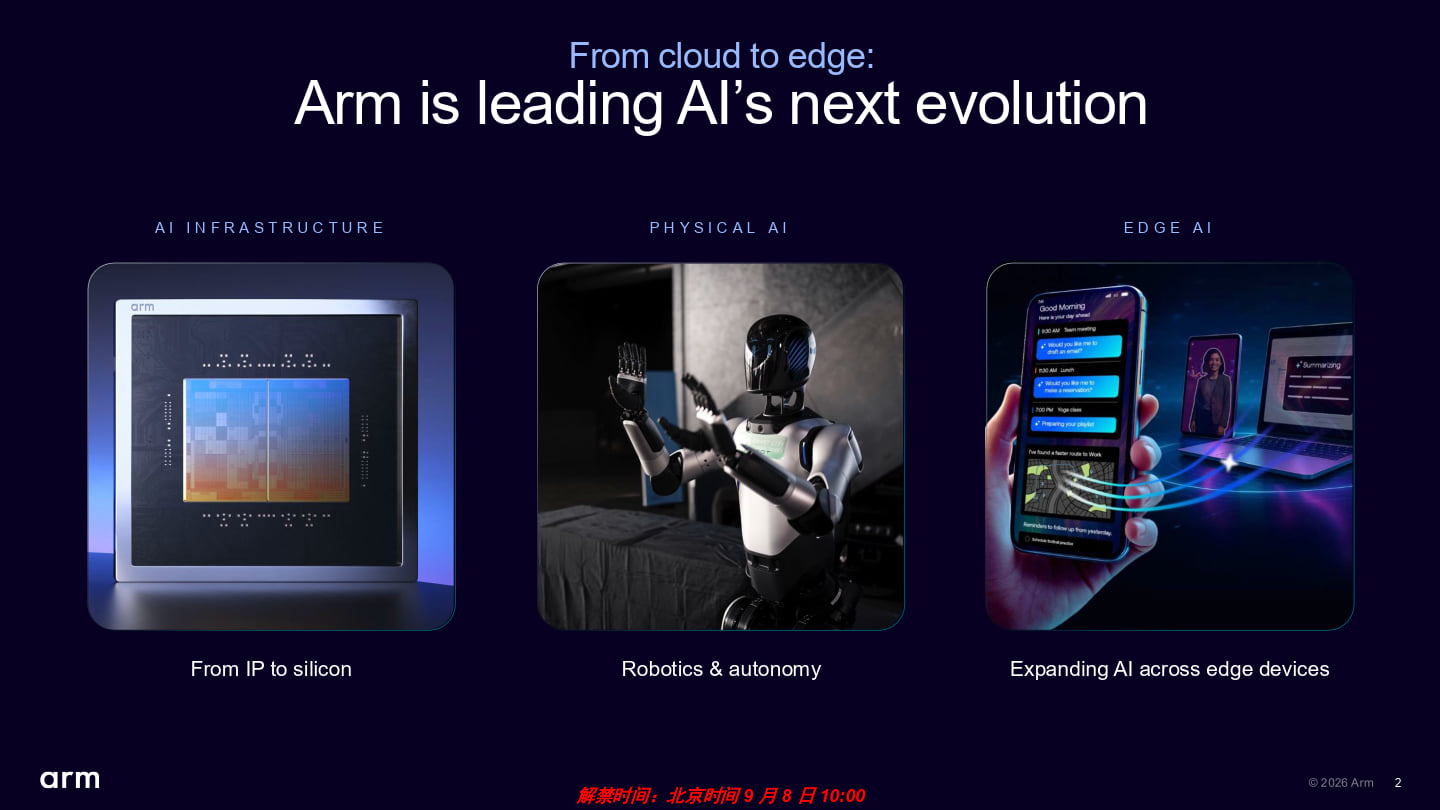
Arm分析在代理式AI的運作過程中,除了有AI推論運算之外,在感知、規劃、評估、驗證等步驟以及操作應用程式、AI工具等過程中,都會消耗更多CPU(處理器)運算資源,所以在筆者先前介紹的CSS for Mobile 2產品說明會中,Arm邊緣AI客戶端運算副總裁James McNiven甚至提出CPU是代理式AI中心的觀點。

延伸閱讀:
【Arm Tech Day 2026】CSS for Mobile 2帶來全新C2-Ultra CPU、G2-Ultra NX GPU,強化手機代理式AI與主機級光線追蹤遊戲體驗
Arm Everywhere 2026:瞄準代理式AI運算需求,推出Arm AGI CPU自有品牌處理器
【COMPUTEX 2026】Arm執行長高喊「Taiwan has built Arm」!聯手NVIDIA RTX Spark大秀代理式AI黑科技

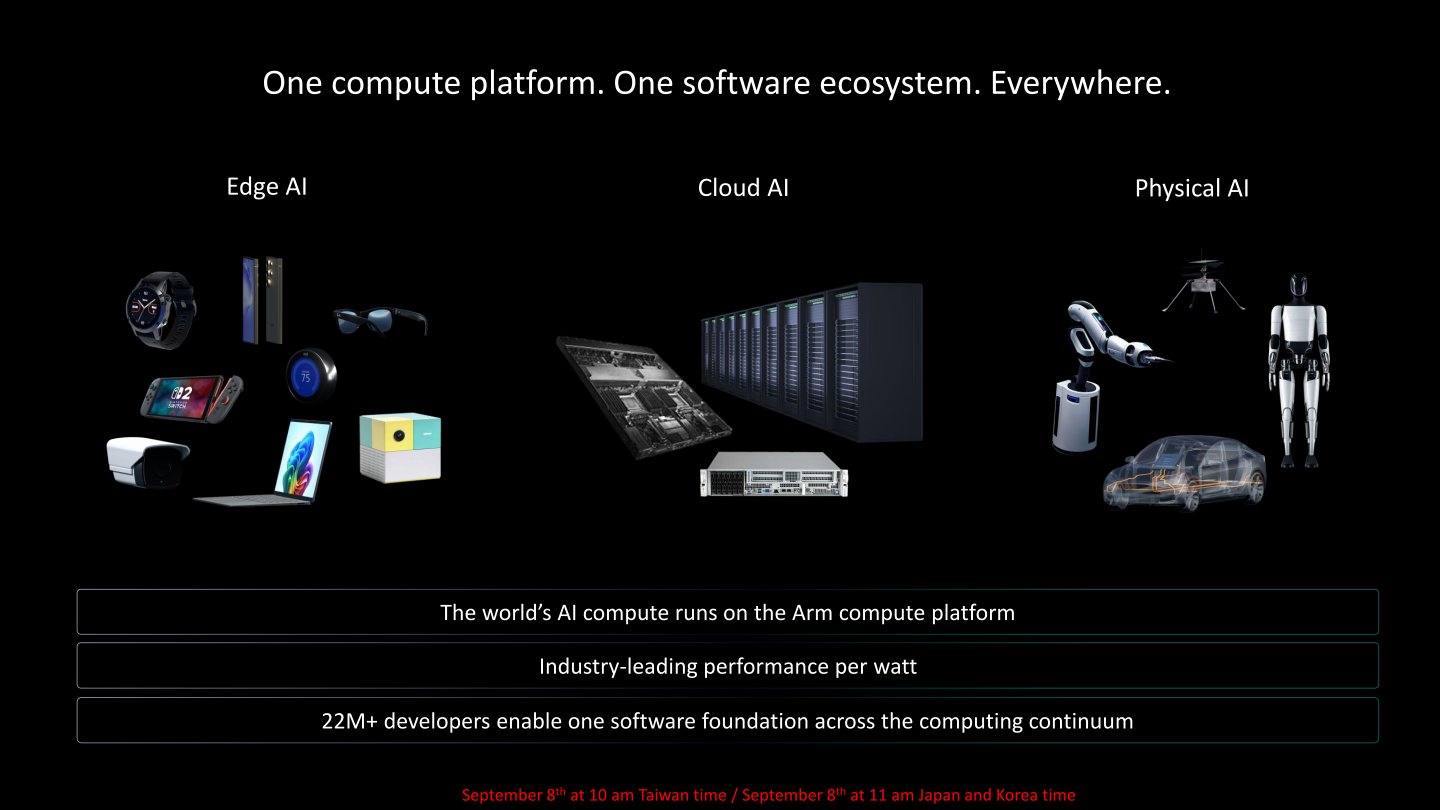
Arm表示自家的優勢為提供多元彈性授權方案,客戶可以依需求選擇適合的授權方案,也可搭配自行研發的運算單元,同時也具有領先業界電力效率切適合緣端、雲端、實體AI等應用場域的CPU,而且這些CPU都採用供統一的運算架構,能夠簡化軟體開發的複雜度。

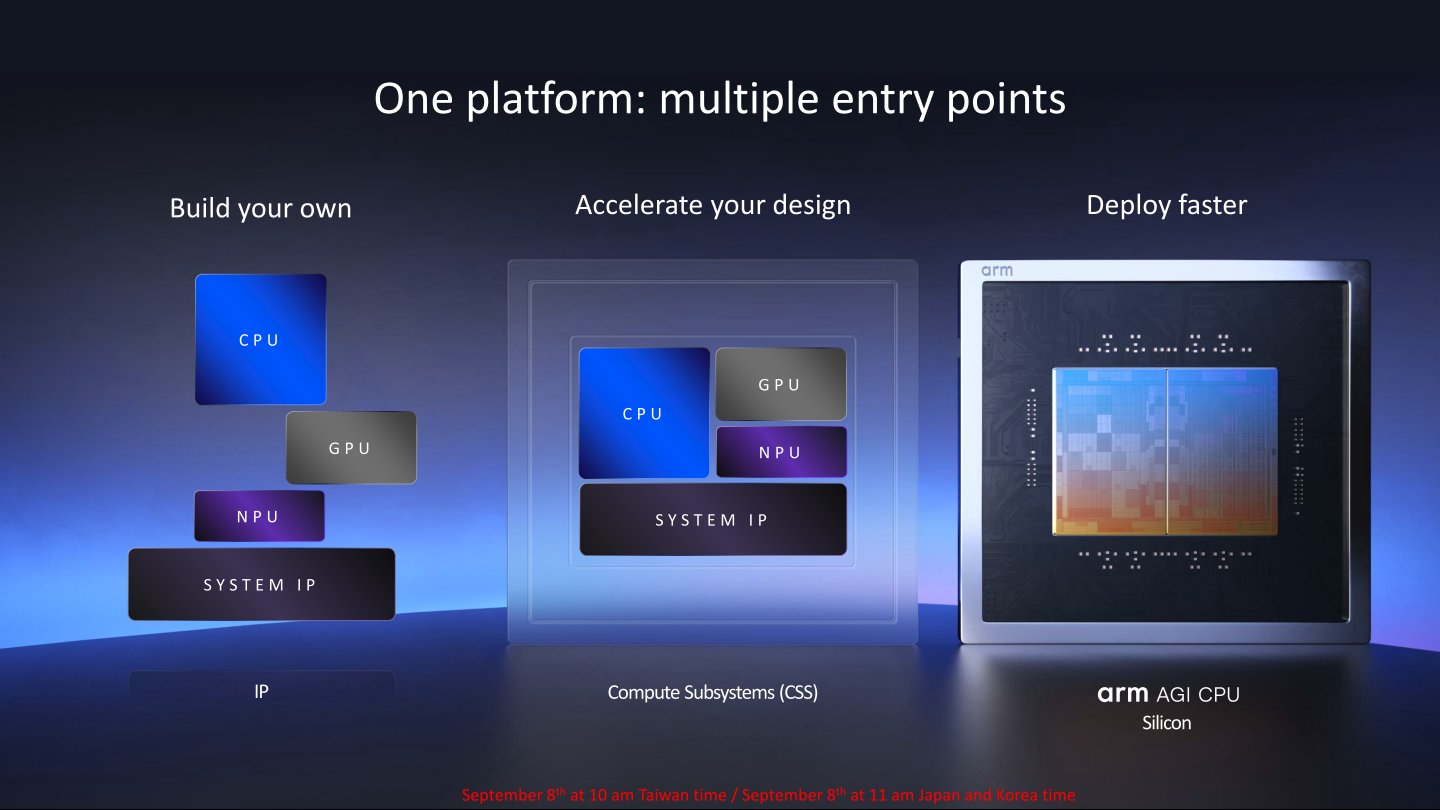
Arm提供多元彈性授權方案,需要最高客製化程度的客戶可以選擇購買IP自行研發,或是購買整合多種IP並可加速開發流成的CSS(運算子系統),也可以直接購買現成Arm AGI CPU晶片加速部署。

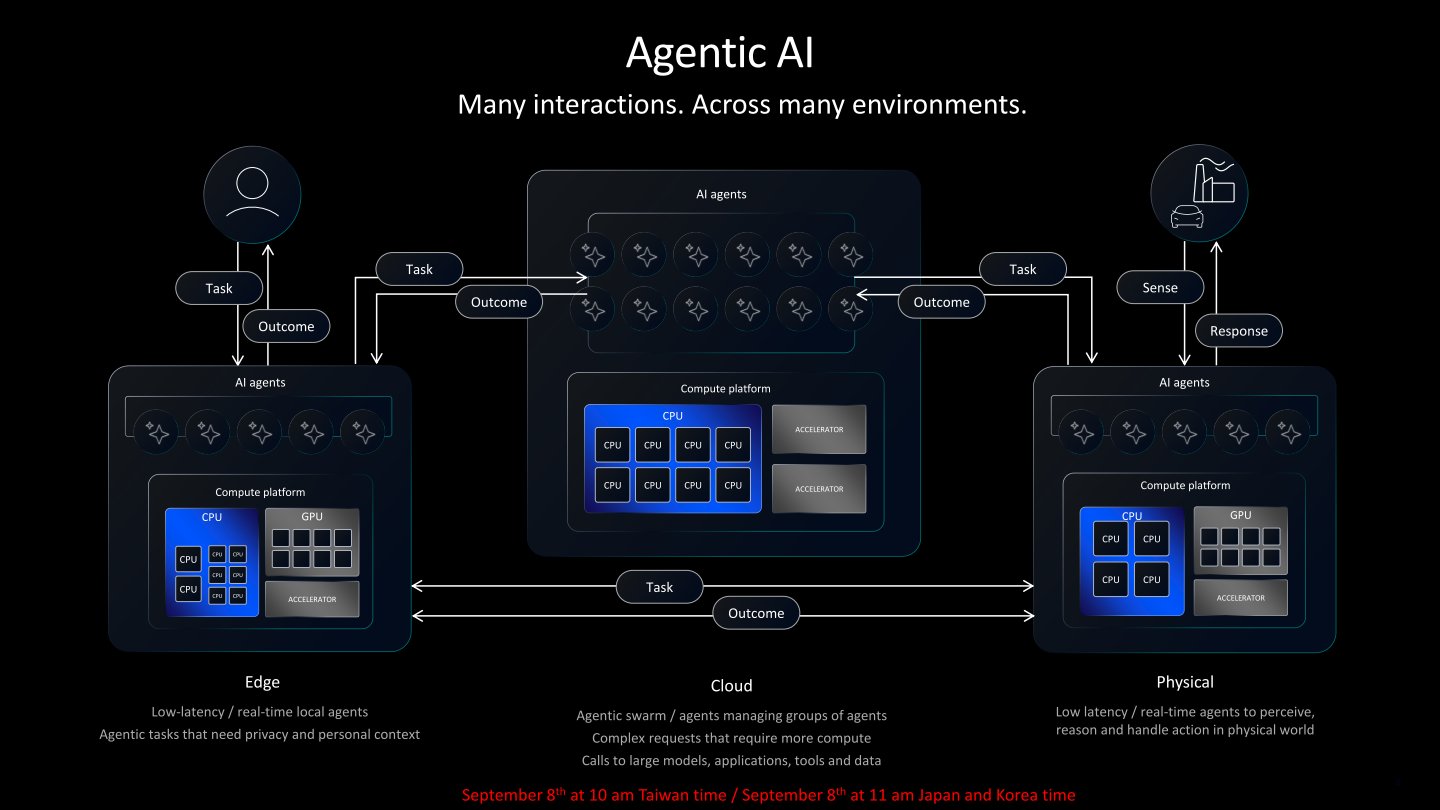
在混合雲端與邊緣端的分散式代理式AI應用中,位於邊緣的個人裝置或實體AI(如機器人)會在接受使用者或環境中的指令後,使用自身運算單元或與雲端伺服器協作,分頭完成低延遲與高負載等不同性質的運算需求。

Arm的優勢為能在邊緣端、雲端、實體AI等不同場域提供統一的運算架構,同時提供領先業界的電力效率,有助於簡化軟體開發。

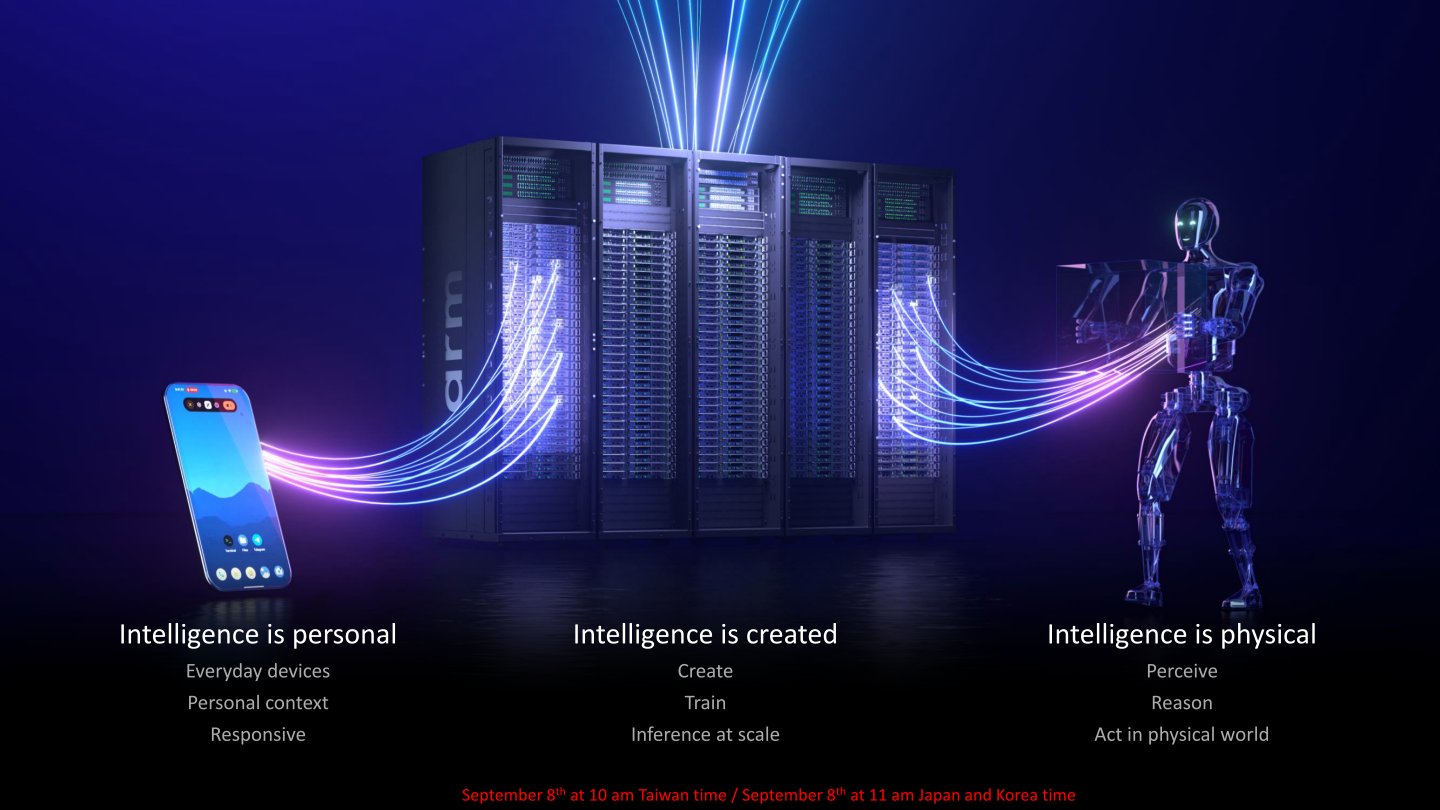
邊緣端AI的特色為提供個人日常低延遲體驗,雲端AI則以大規模基礎建設進行AI模型訊練與高負載推論運算,實體AI則提供機器人、自動駕駛車輛感知與推理能力。

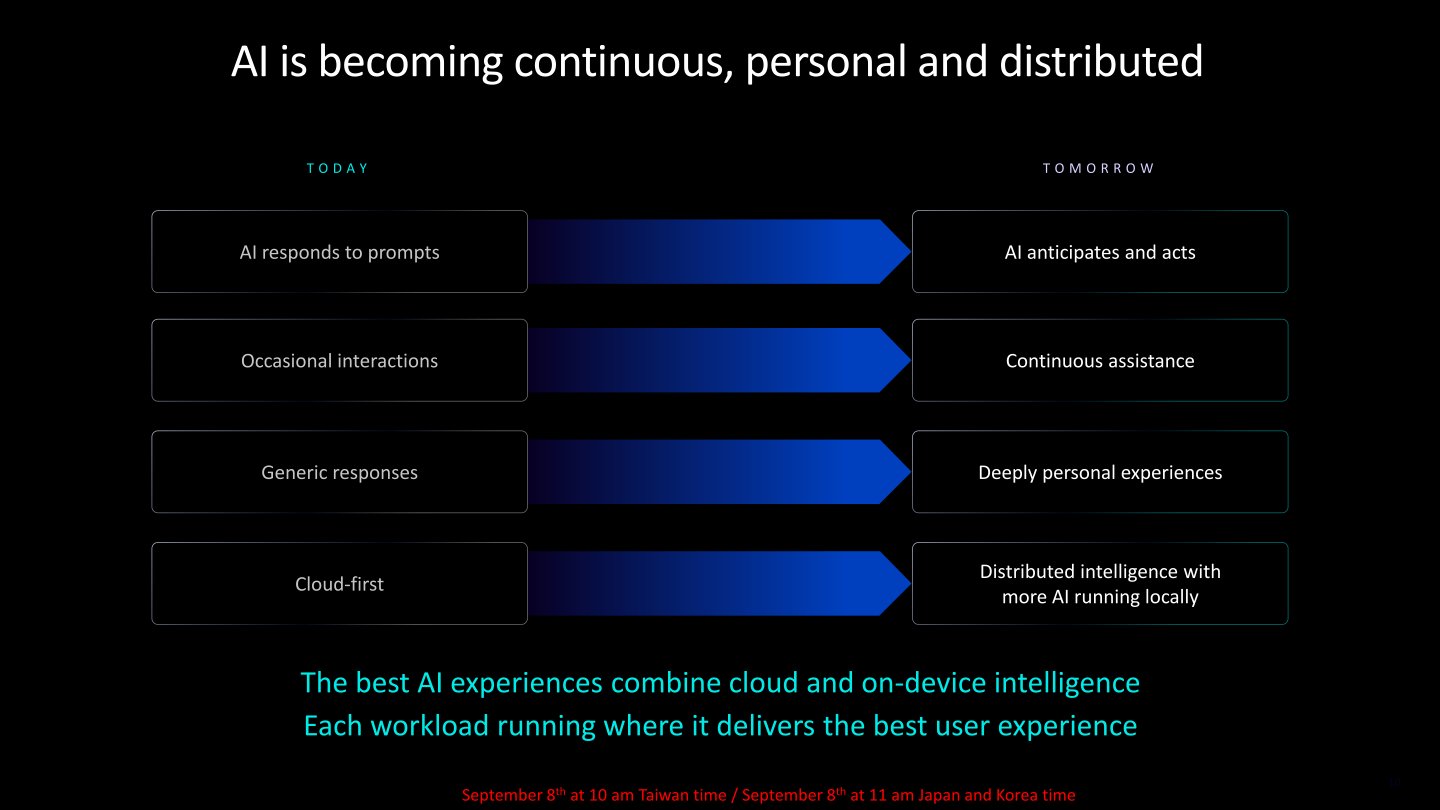
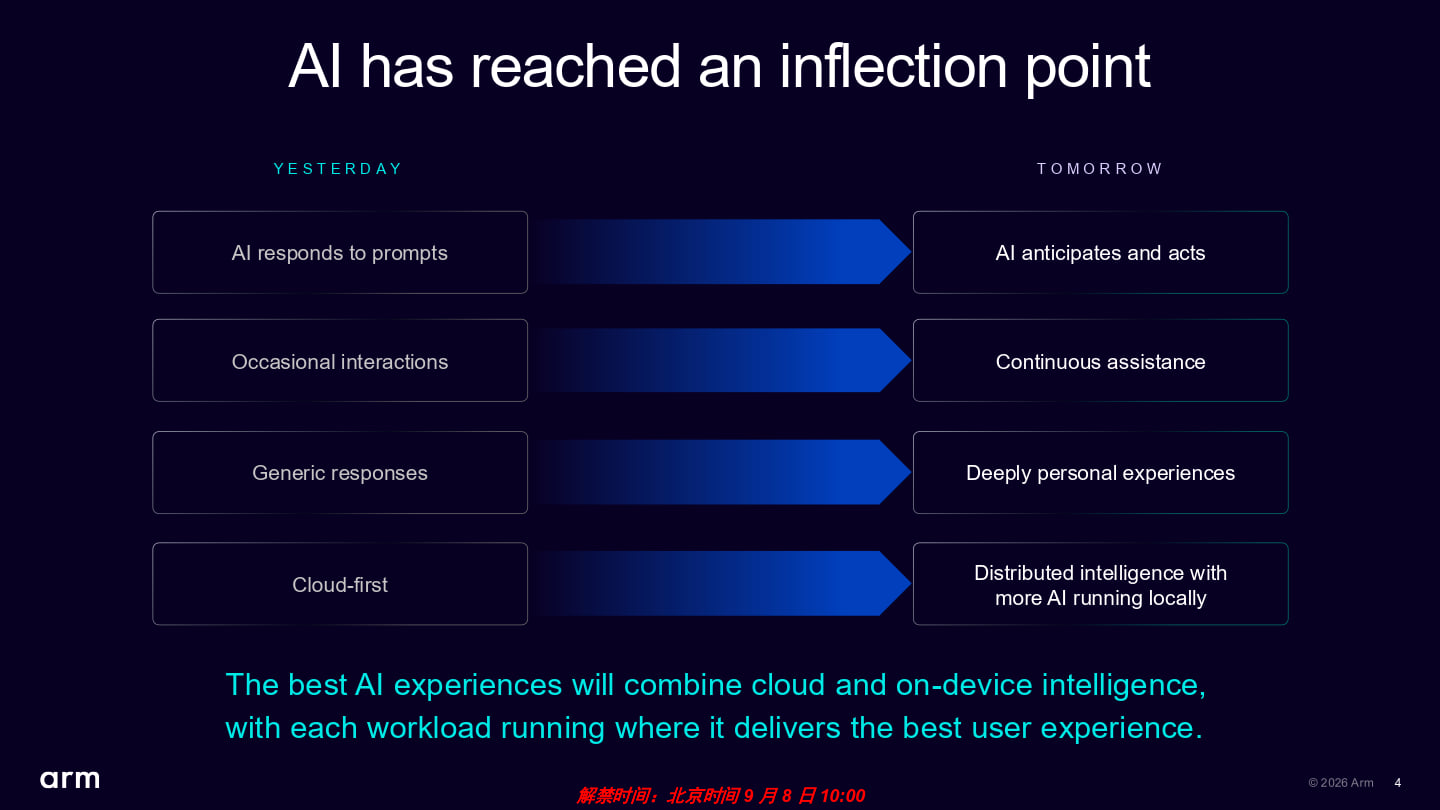
在邊緣端進入到代理式AI的過程中,操作模式也由對提升詞反應、偶爾互動、產生回答、雲端優先,轉換為自主行動、持續互動、深度個人化、分散至終端裝置執行。

推出機器人「全民」檢定

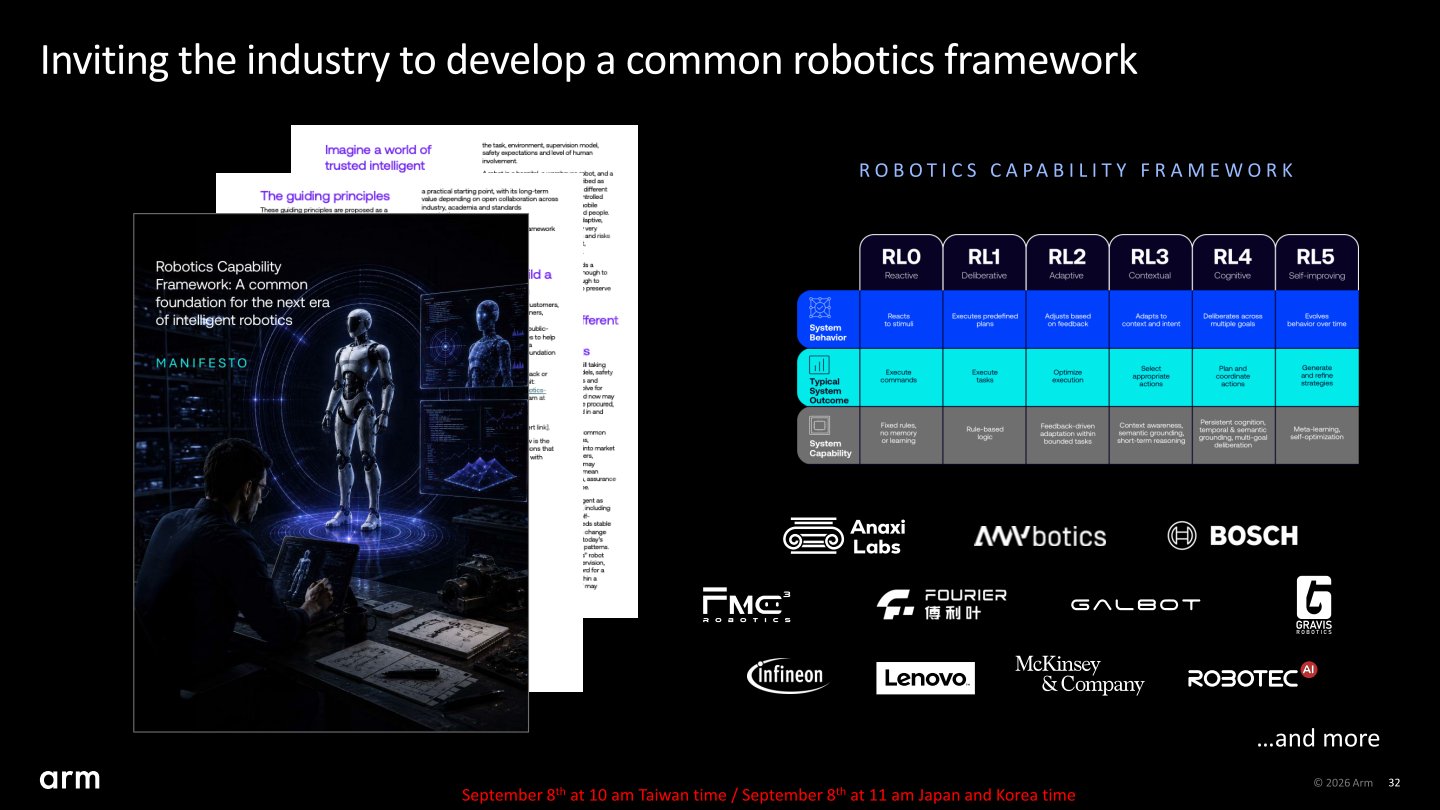
Arm也在這次宣布推出Arm實體AI全面設計(Arm Total Design for Physical AI),與超過80間公司共同開發實體AI技術堆疊,並以生態系首批協作倡議者之一的身份發表機器人能力分級框架(Robotics Capability Framework),共同制定相關協定與定義,以推進機器人能力發展。

機器人能力分級框架將為機器人系統定義由基礎到進階的能力層級,連結真實世界使用場景與機器人行為、輸出及系統需求,內容涵蓋延遲、運算配置、記憶體與功耗限制、確定性與安全性。未來Arm也將邀請更多產業夥伴貢獻專業知識,共同推動這項框架的後續發展。

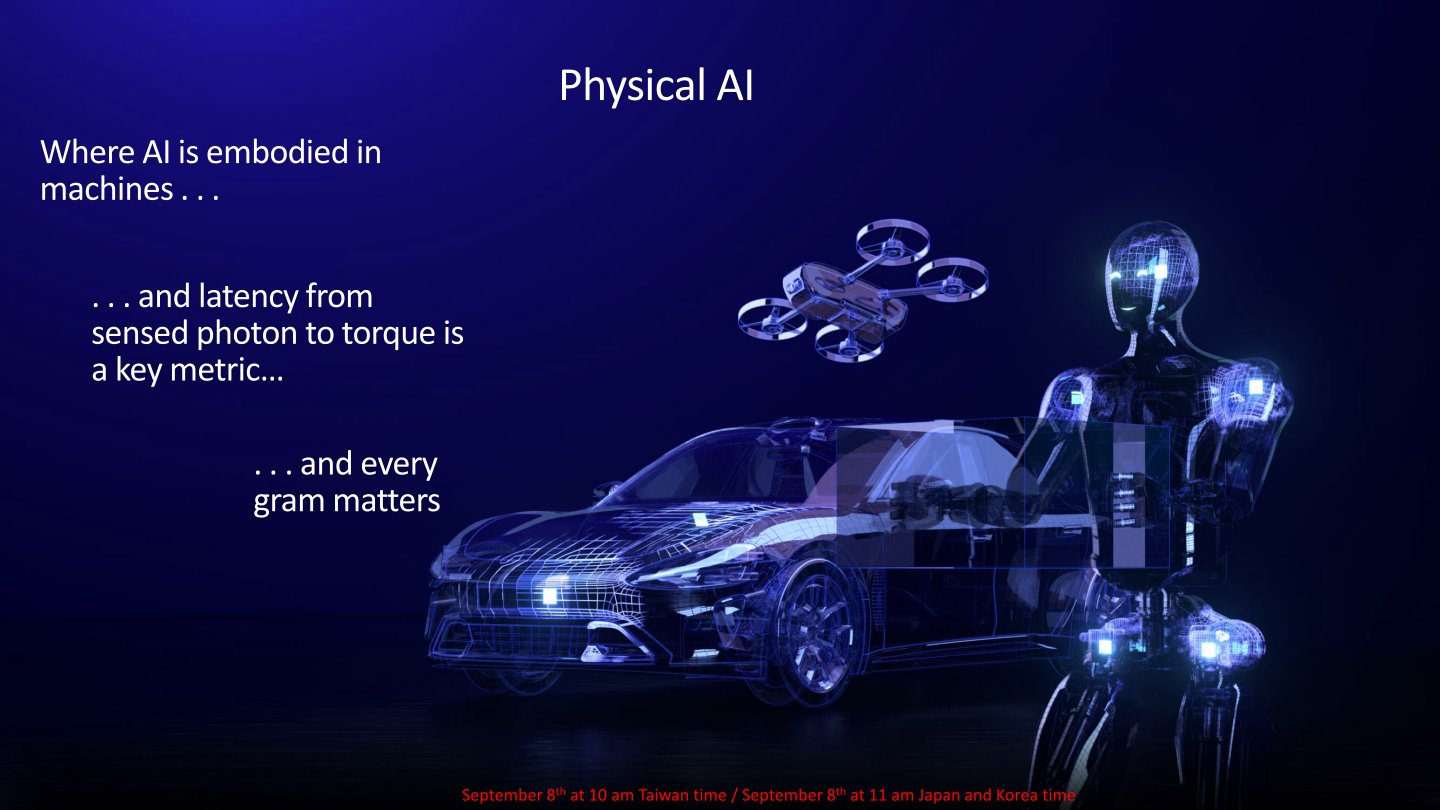
實體AI的應用重點為嵌入至機器人、自動駕駛車輛等裝置,不但需要提供低延遲的運算效能,也要考慮裝置的重量以及電力消耗狀況。

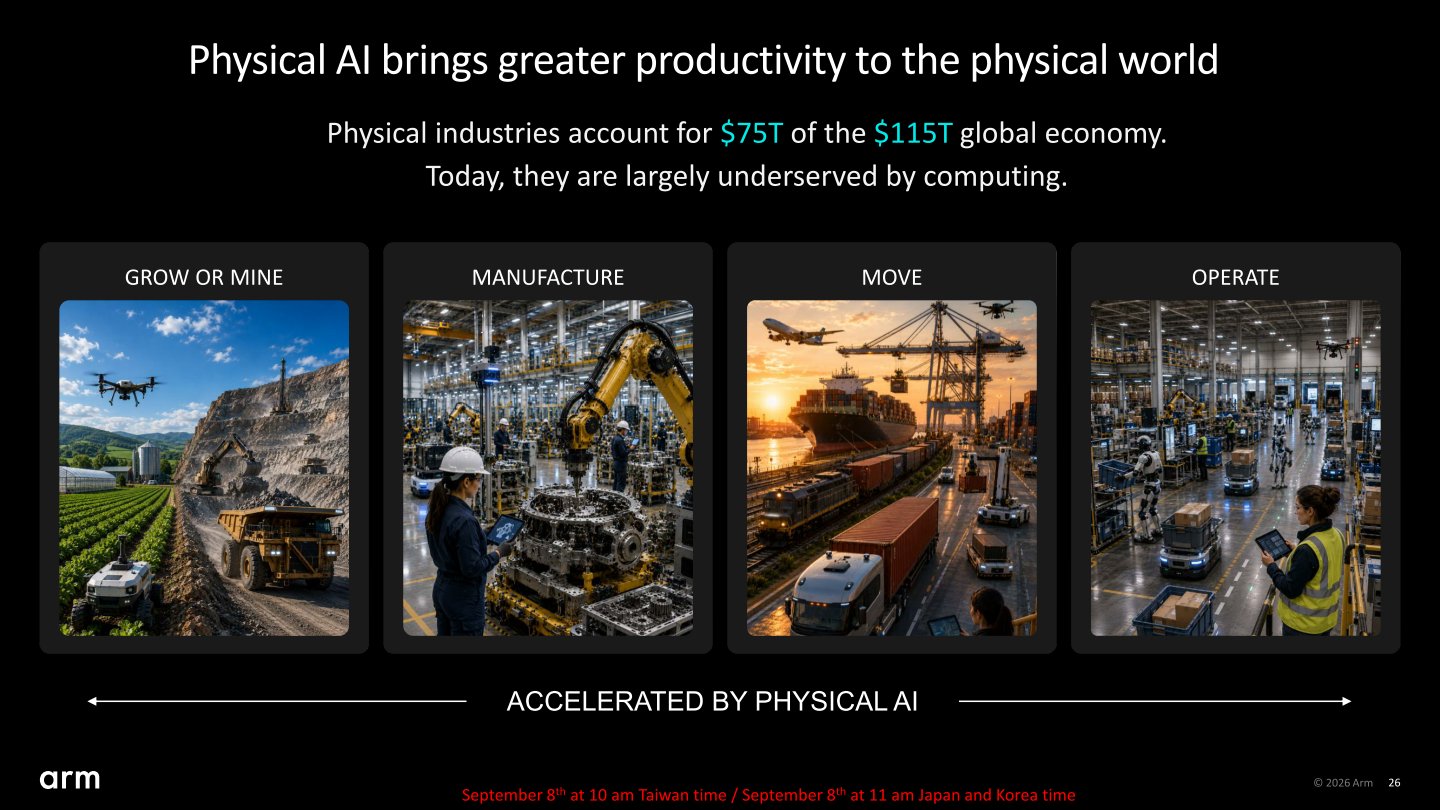
Arm分析目前全球工業的產值達到美金115兆元,其中農業、礦業、製造、運輸、營運等實體部門佔據75兆元。

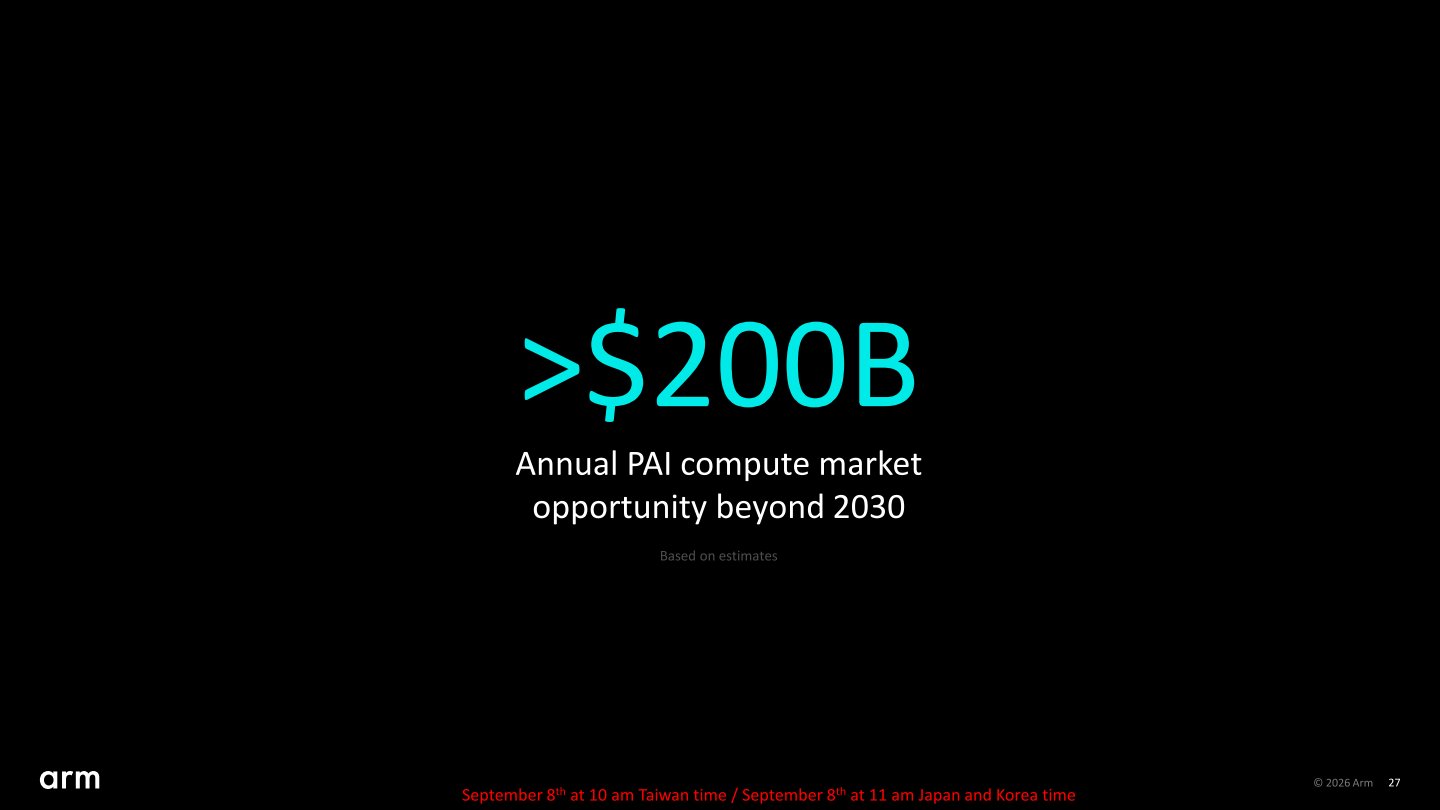
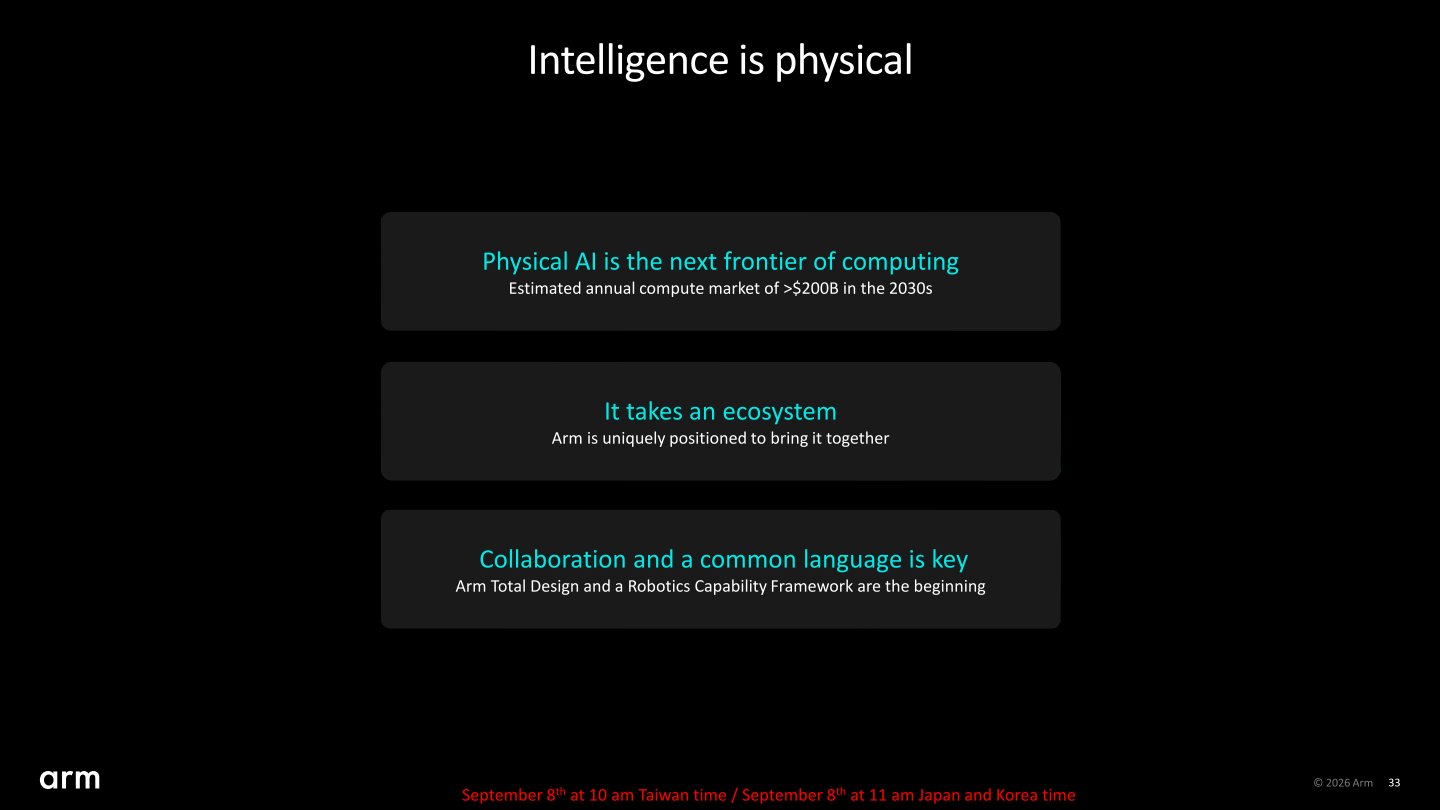
Arm進一步分析2025年的實體AI總潛在市場(Total Addressable Market,TAM)為250億元,並預估到2030年之後會成長至2000億元。

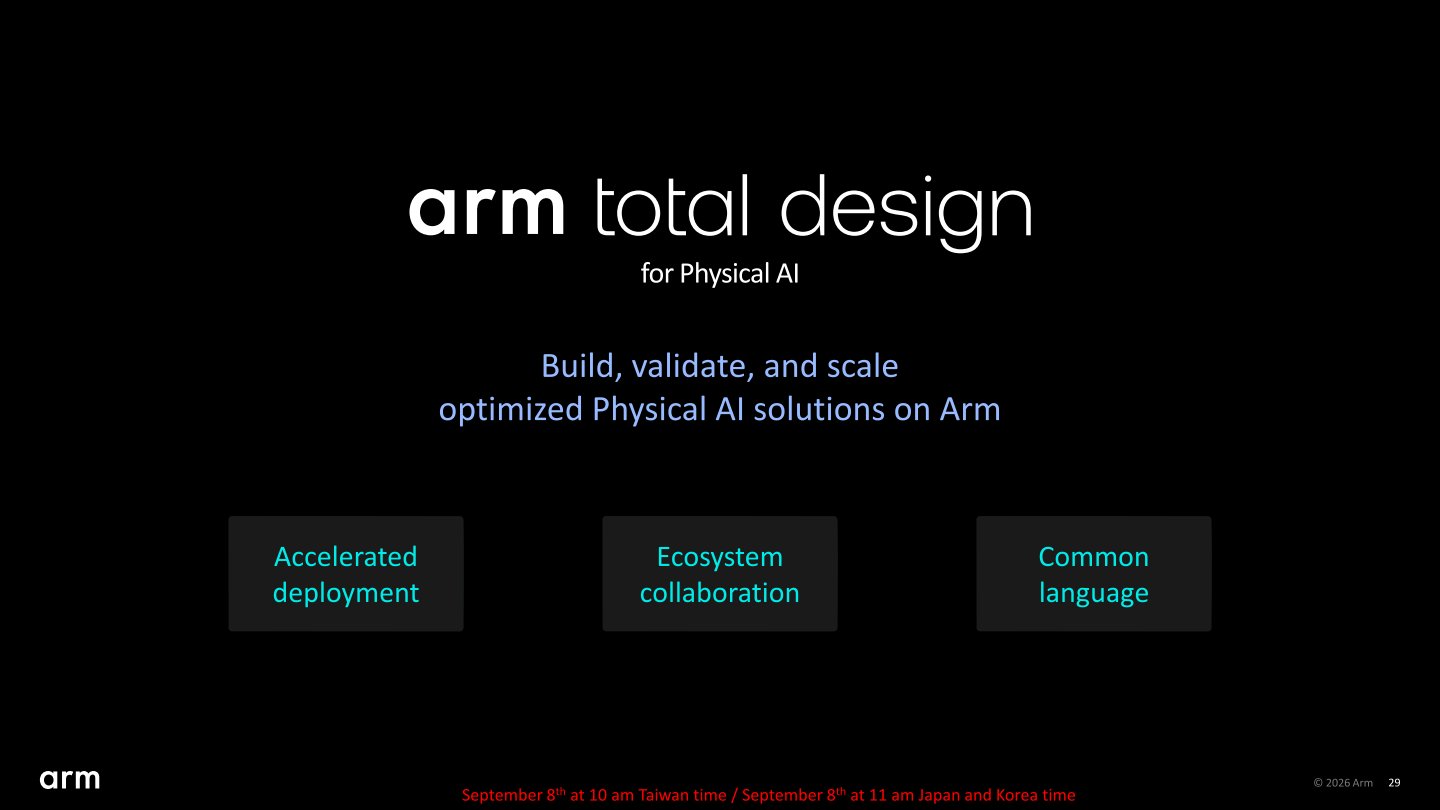
Arm宣佈推出實體AI全面設計方案,協助加速AI部暑、強化生態系合作、制定通訊機制。

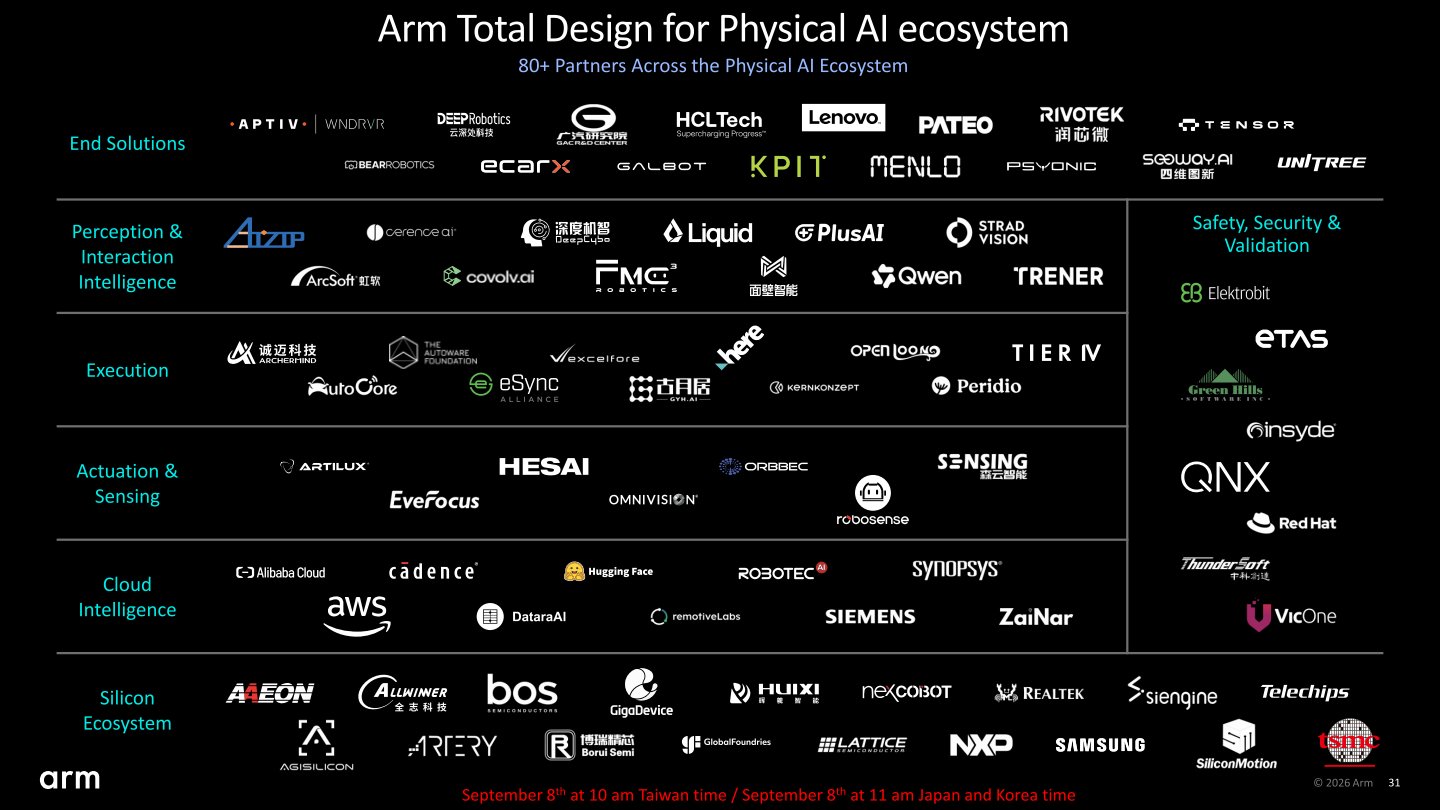
Arm實體AI全面設計生態系集合晶片製造、雲端服務、驅動與感測、執行、人工智慧、終端應用等多種領域的廠商。

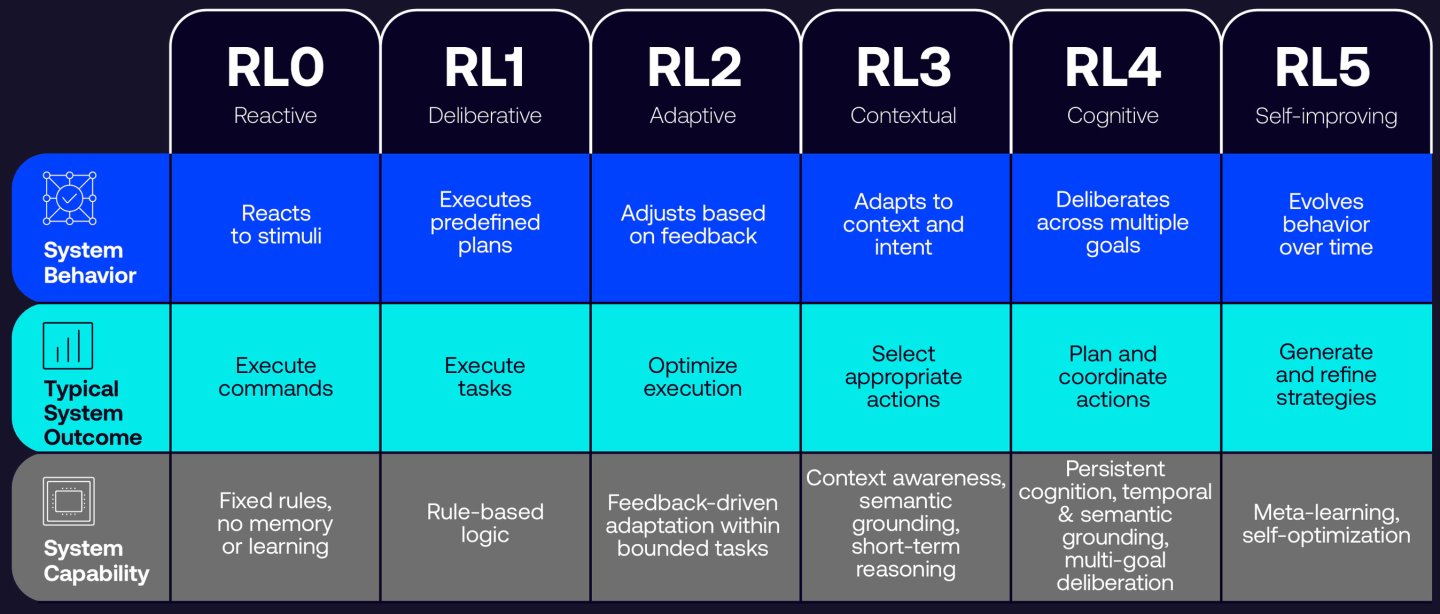
Arm與多位合作夥伴共同提出機器人能力分級框架(Robotics Capability Framework),透過RL0~RL5等不同等級描述機器人的能力。

該宣言將機器人能力從可執行指令的RL0級「回應」,到具有自主生成並微調策略的RL5級「自主改善」。

Arm認為實體AI是下一波運算的趨勢,並將與合作夥伴一起建構生態系統與機器人框架、協定。

強化資料中心代理式AI

Arm指出代理式AI正在重塑AI基礎建設的需求,AI代理會進行推論、擷取資料、呼叫工具並與資料庫及其他代理互動,提高CPU的資源需求。另一方面,隨著各類運算需求更加分歧,造成沒有一體通用的基礎建設方案。

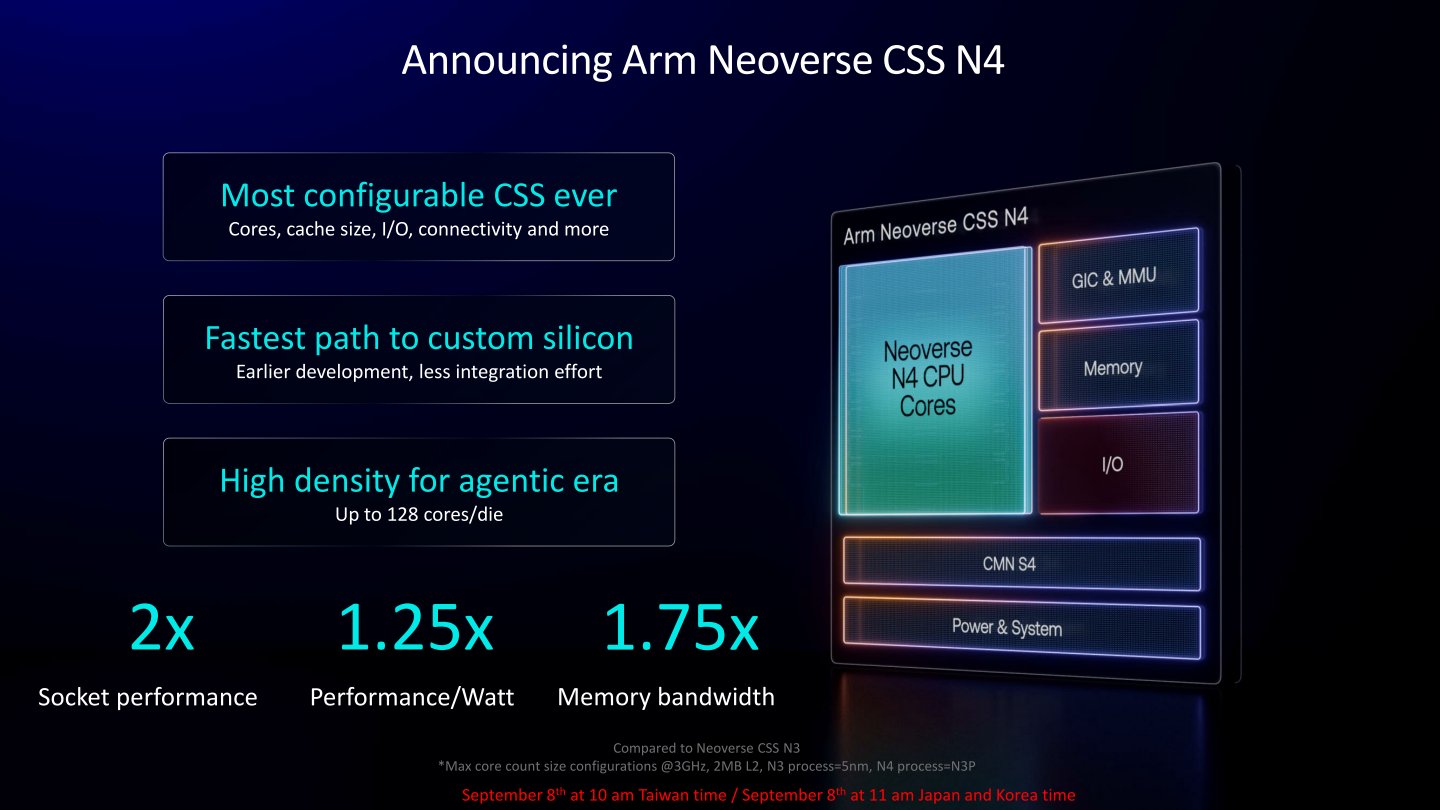
為了解決這個問題,Arm推出全新Neoverse CSS N4運算子系統,協助客戶能彈性選擇最符合其工作負載的IP與授權方案,打造針對最高吞吐量效率最佳化的SoC(System on Chip,系統單晶片)。

Neoverse CSS N4的每組CPU最多可容納128組核心,支援LPDDR6記憶體與 PCIe Gen 7匯流排,相較前代Neoverse CSS N3最多能夠提供2倍效能,最多提高電力效率25%、記憶體頻寬75%,帶來提高運算密度、高速記憶體存取、I/O效能強化等優勢,讓應代理式AI系統享有更高資料頻寬,並可與外部加速器協調與平行化運算等需求。

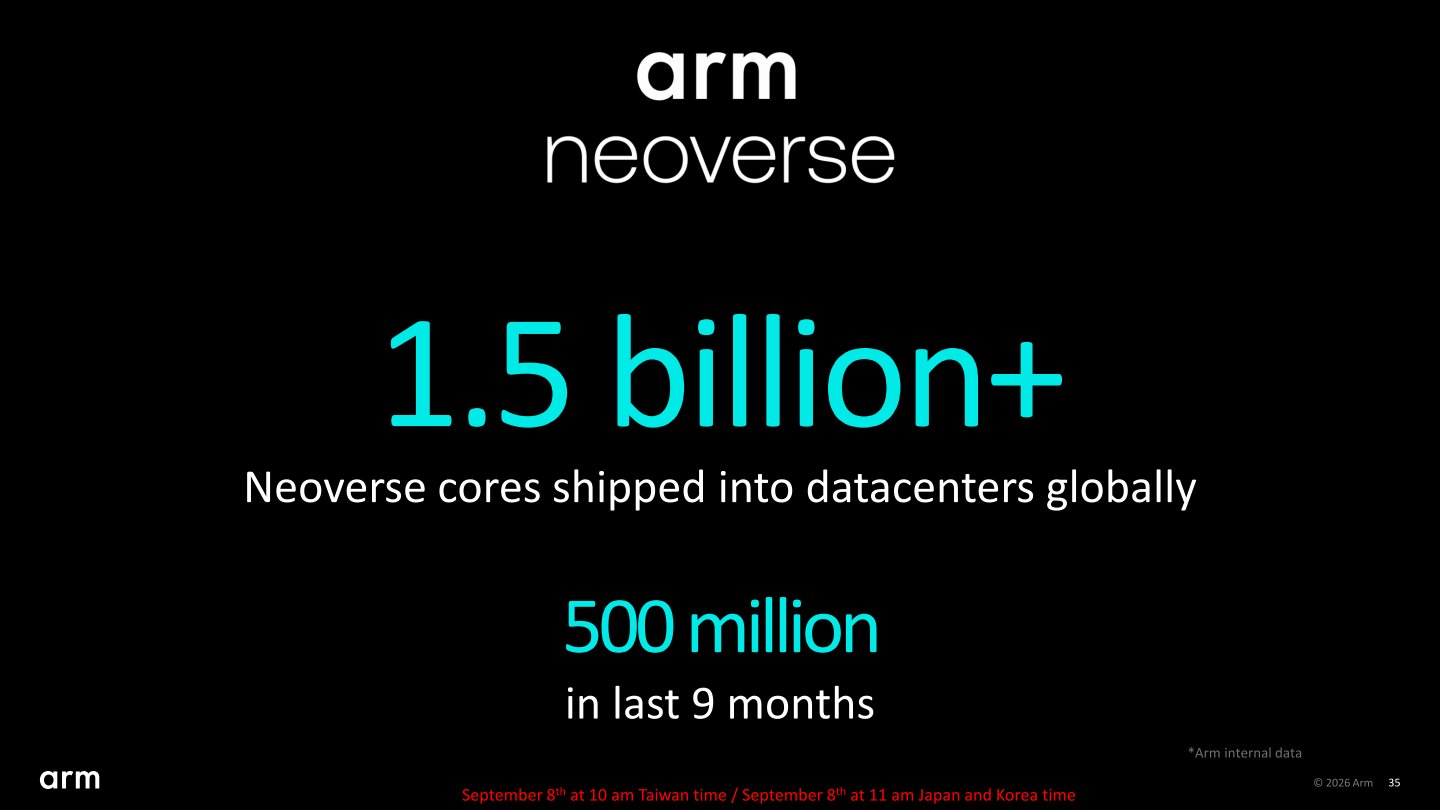
Arm表示Neoverse核心的出貨量至今已超過15億組,其中5億組為近9個月新增。

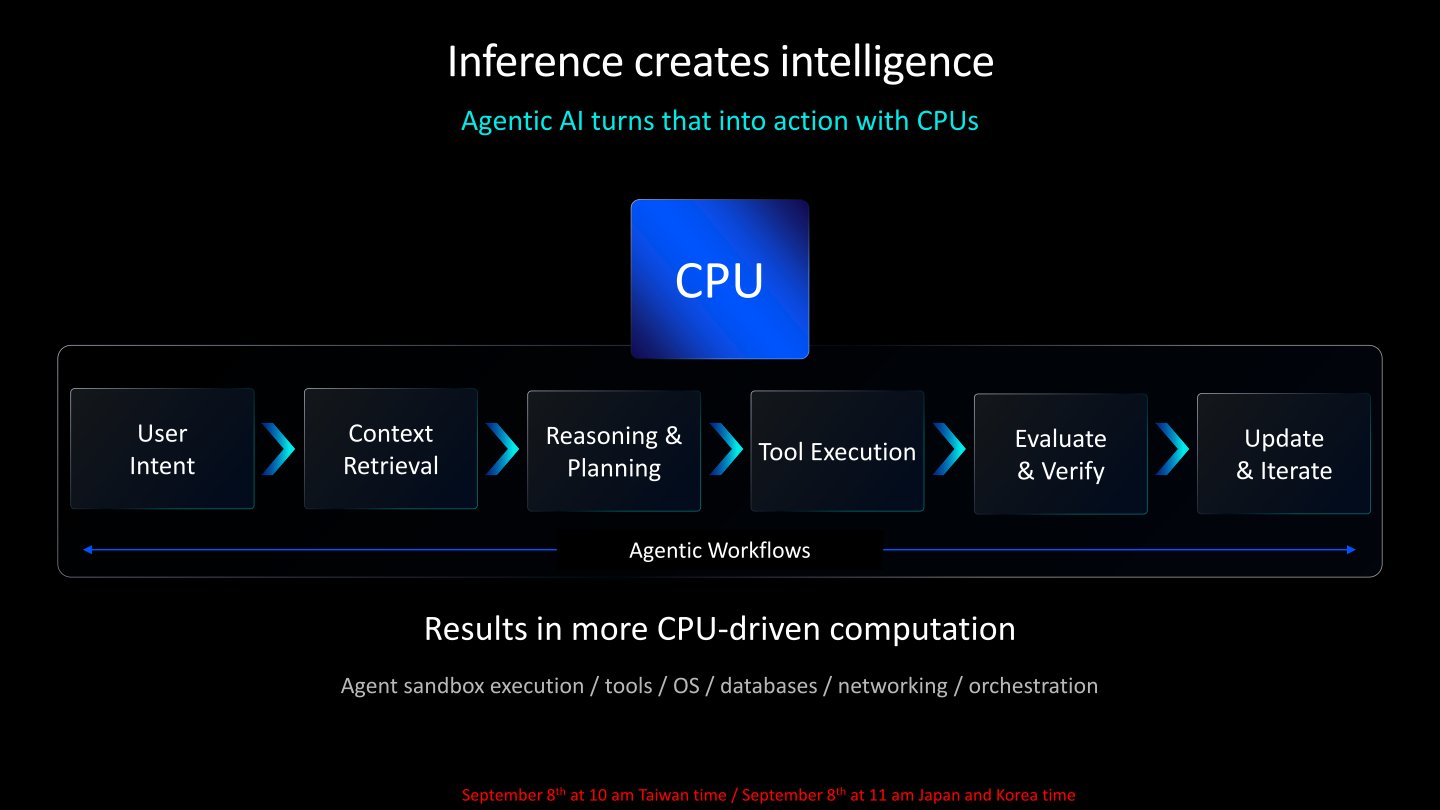
在代理式AI的應用情境可以分為感知使用者意圖、產生指令、推理與規劃、調用工具、評估與驗證、更新與迭代等階段,對於CPU的運算需求大幅增加。

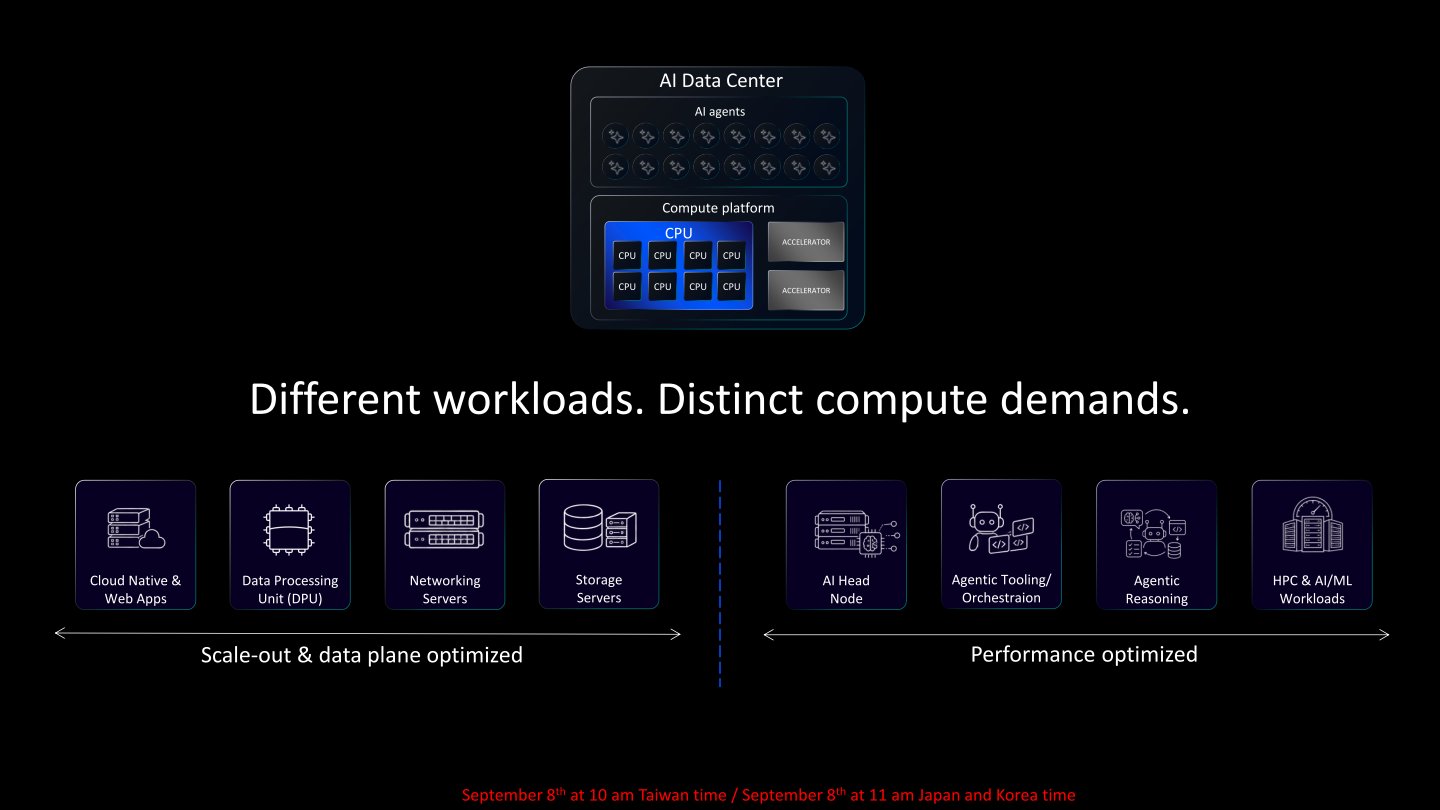
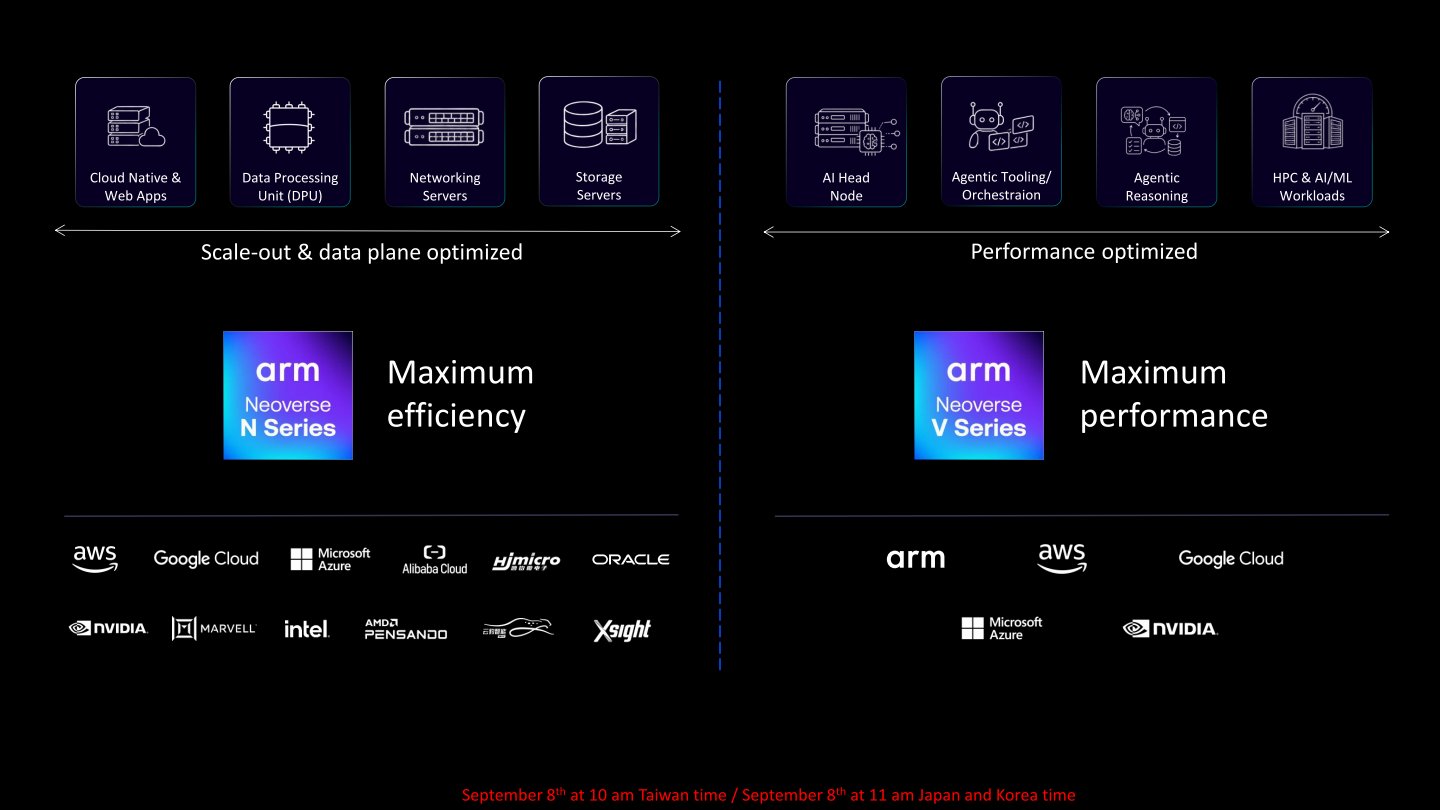
代理式AI有多種清楚的運算需求,能夠靠橫向擴展、資料平面最佳化、執行效能最佳化來改善系統效益。

Arm的Neoverse N系列處理器具有較高的電力效率,適合用於橫向擴展與資料平面最佳化。Neoverse V系列處理器則有較高效能,能夠作為首要運算節點。

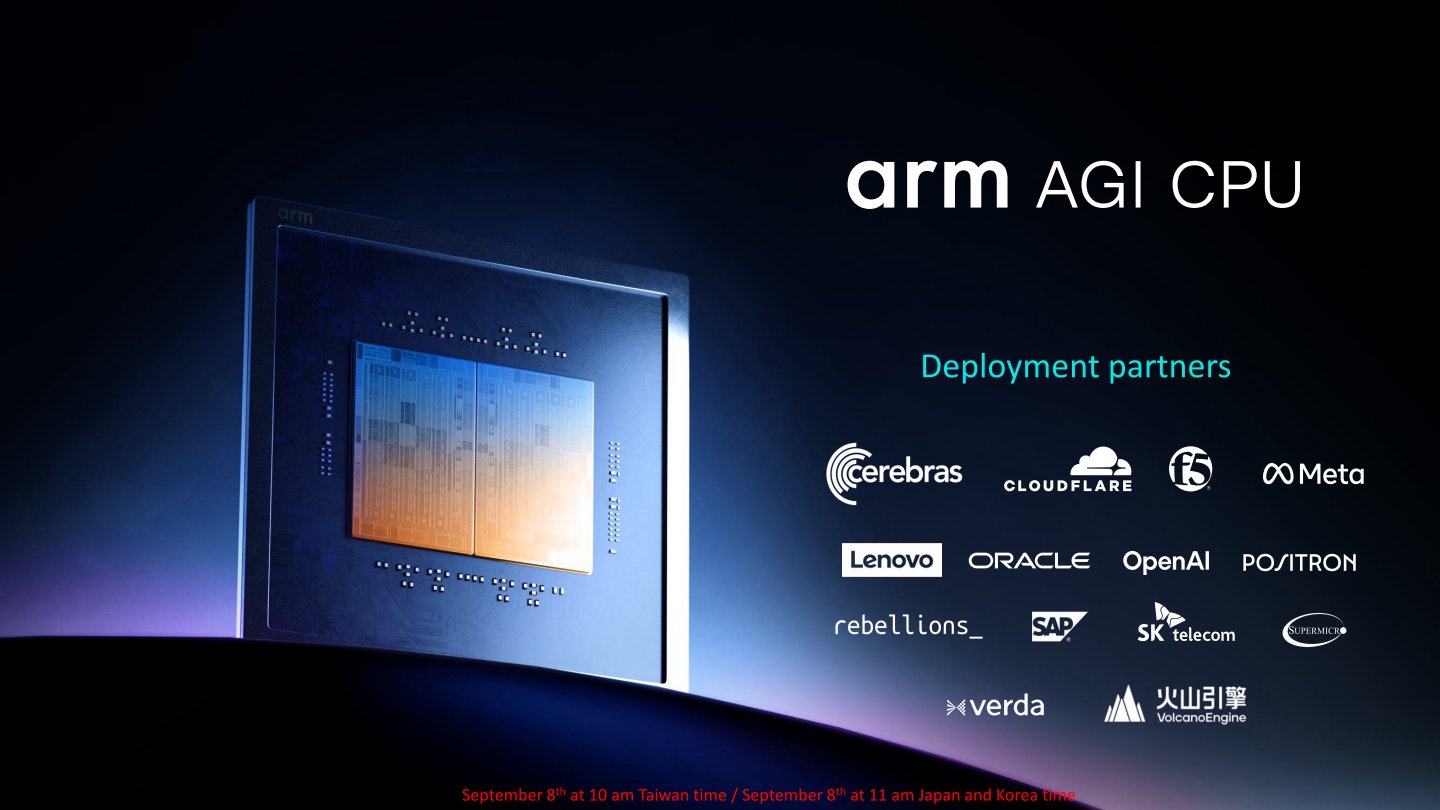
Arm於2026年3月發表AGI CPU,透過直接提供實體晶片的方式加速客戶部署。

Arm這次發表的新產品為Neoverse CSS N4運算子系統,單插槽的效能提升可達2倍。


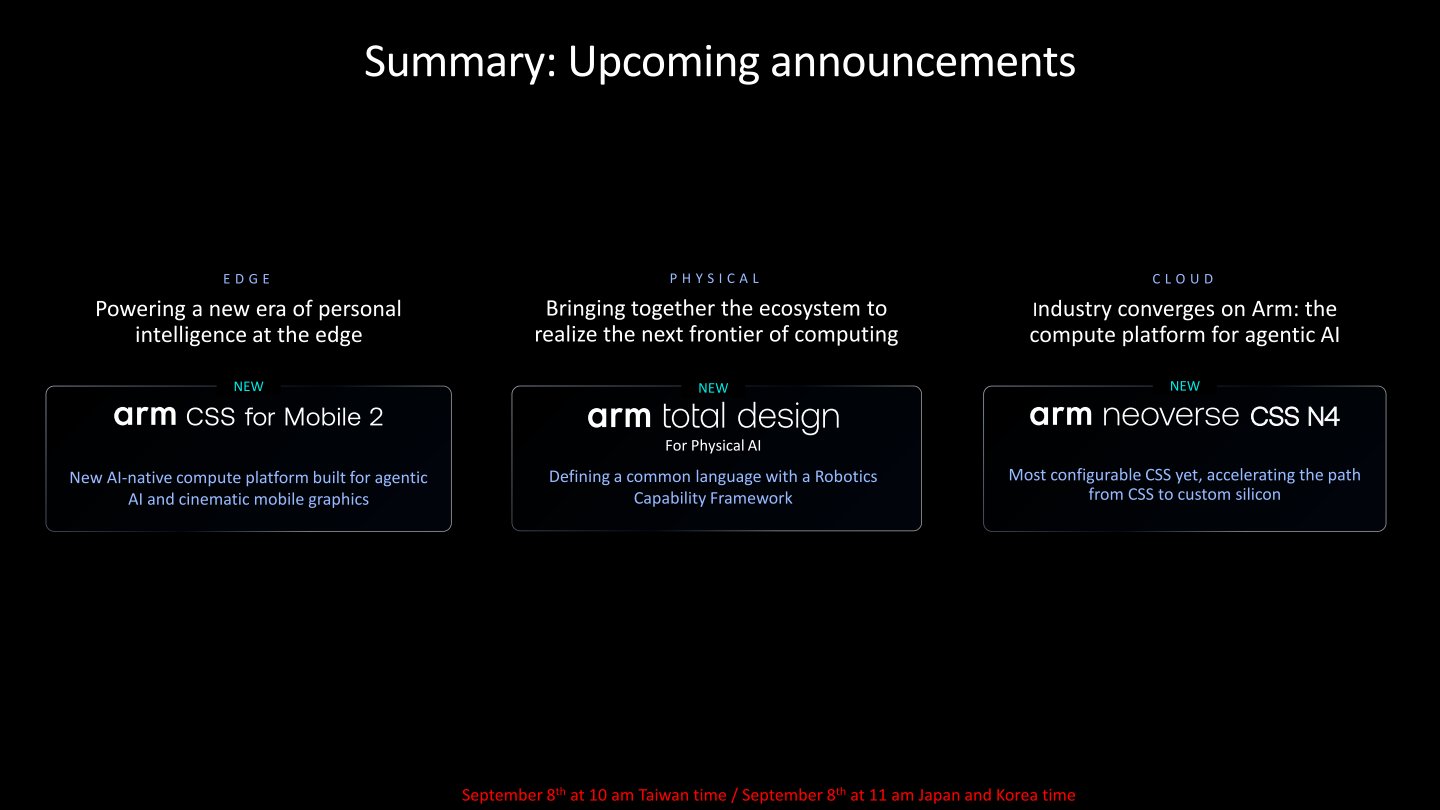
Arm透過CSS for Mobile2以及Total Design for Physical AI、Neoverse CSS N4等產品,提供邊緣、實體、雲端等AI應用更充沛的運算效能。

Arm預測隨著代理式AI持續發展,基礎建設的運作負載將持續增加,如何讓每1瓦電力、每1組個機櫃與每1元的投資發揮最大價值將變得更加重要。產業正逐步以Arm做為次世代代理式AI的共同運算平台,客戶可選擇最符合其基礎架構所需的Arm AGI CPU或Neoverse CSS N4,同時維持效能、效率與軟體相容性的一致基礎。

(Arm Tech Day 2026系列文章目錄)

加入T客邦Facebook粉絲團

光線追蹤大作再出擊,《控制:共振》搭配NVIDIA DLSS 4.5光線重建實測

2026年9月19日 09:00
作為控制系列的第2款作品,《控制:共振》依然透過逼真的光影呈現帶來沈浸式遊戲體驗,並可視為光線追蹤的技術展示,我們來看看它在DLSS 4.5光線重建協助下帶來的畫質與效能表現。5df4a7be9ed046534dbcf96827876284

作為控制系列的第2款作品,《控制:共振》依然透過逼真的光影呈現帶來沈浸式遊戲體驗,並可視為光線追蹤的技術展示,我們來看看它在DLSS 4.5光線重建協助下帶來的畫質與效能表現。

(本文使用之《控制:共振》序號由NVIDIA提供)

光線追蹤秀肌肉

《控制:共振》(Control Resonant)的劇情描述迪倫.法登遭聯邦控制局囚禁多年後,被囚禁他的人派往一個超自然危機最為嚴重的地區,運用自己的新能力迎戰造成曼哈頓重重威脅的神秘宇宙實體。玩家需要跨越扭曲感官之地,涉險進入顛覆方向感的重力異常區域,同時破解重重謎題,在戰鬥中利用各式全新戰術搭配來突破難關。

延伸閱讀:
玩遊戲不再有鬼影!NVIDIA 推出 DLSS 4.5 光線重建功能 全系列 RTX 顯卡都能戰
NVIDIA DLSS 4.5光線重建實測,強化光線追蹤畫質效能不打折
NVIDIA DLSS 5神經渲染效能實測:畫質有感提升但FPS效能砍半

NVIDIA表示《控制:共振》即透過路徑追蹤(即俗稱的全光線追蹤)以及RTX Mega Geometry結構化多邊型技術,並搭配DLSS光線重建與DLSS 4.5動態多畫格生成,在提供沉浸式光影效果,並加速FPS效能表現。

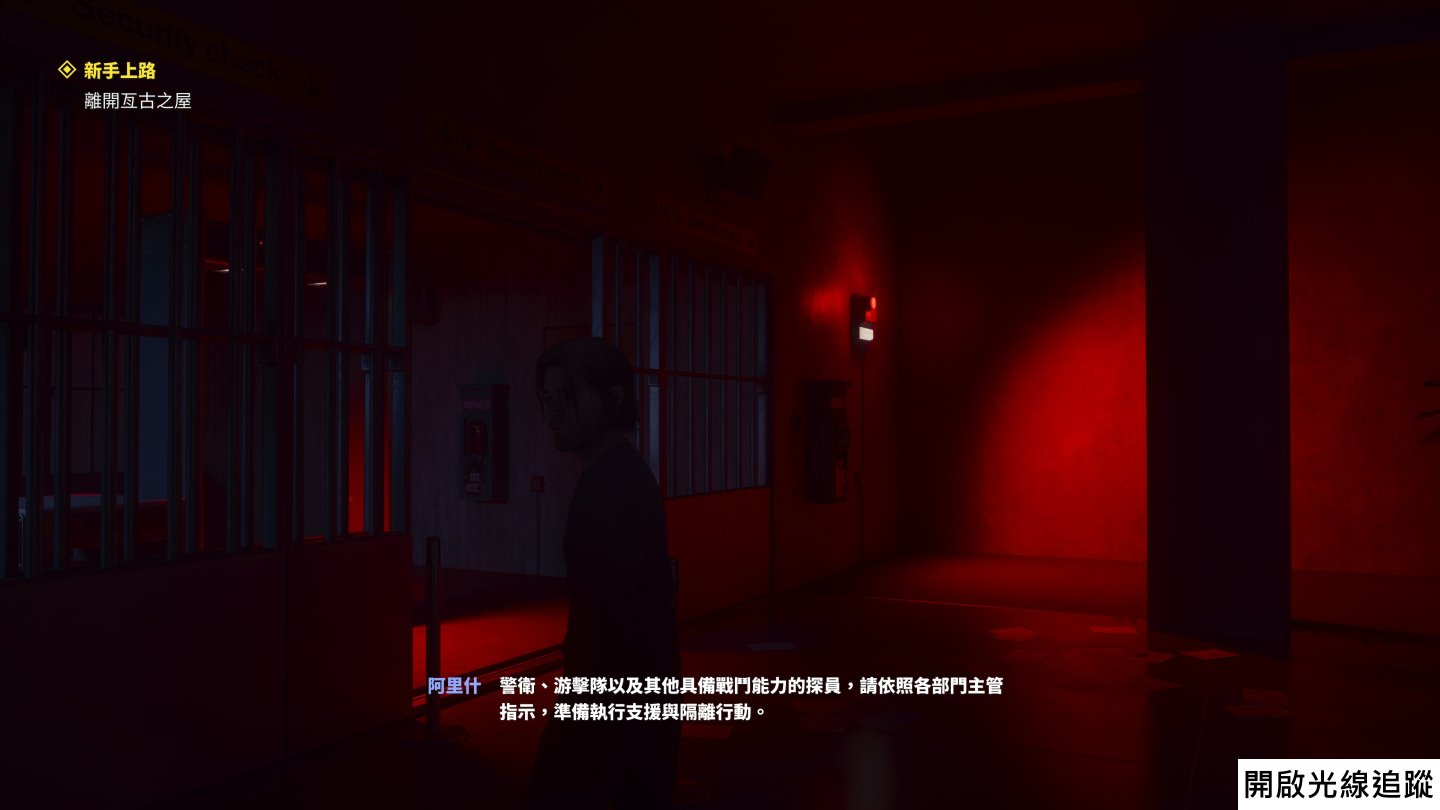
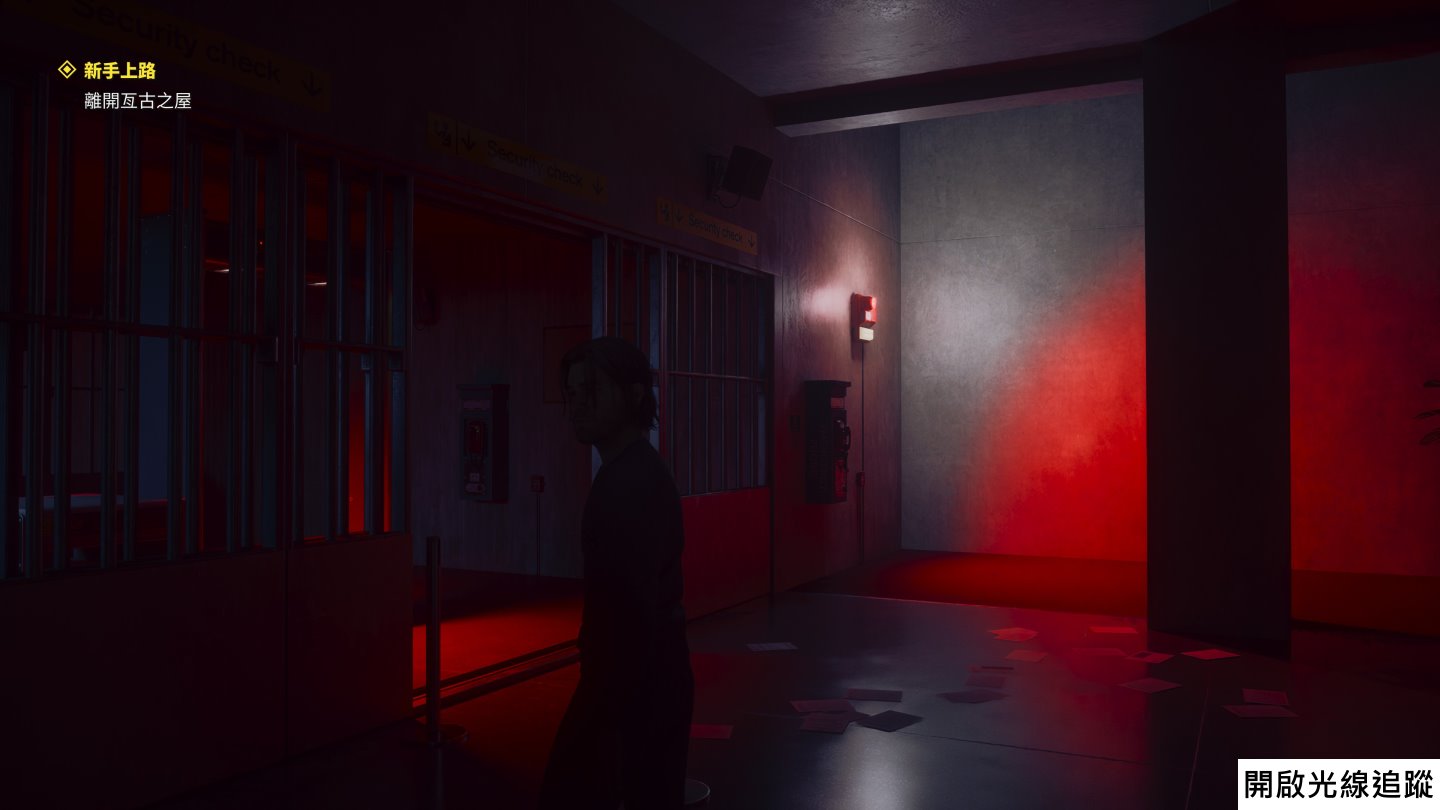
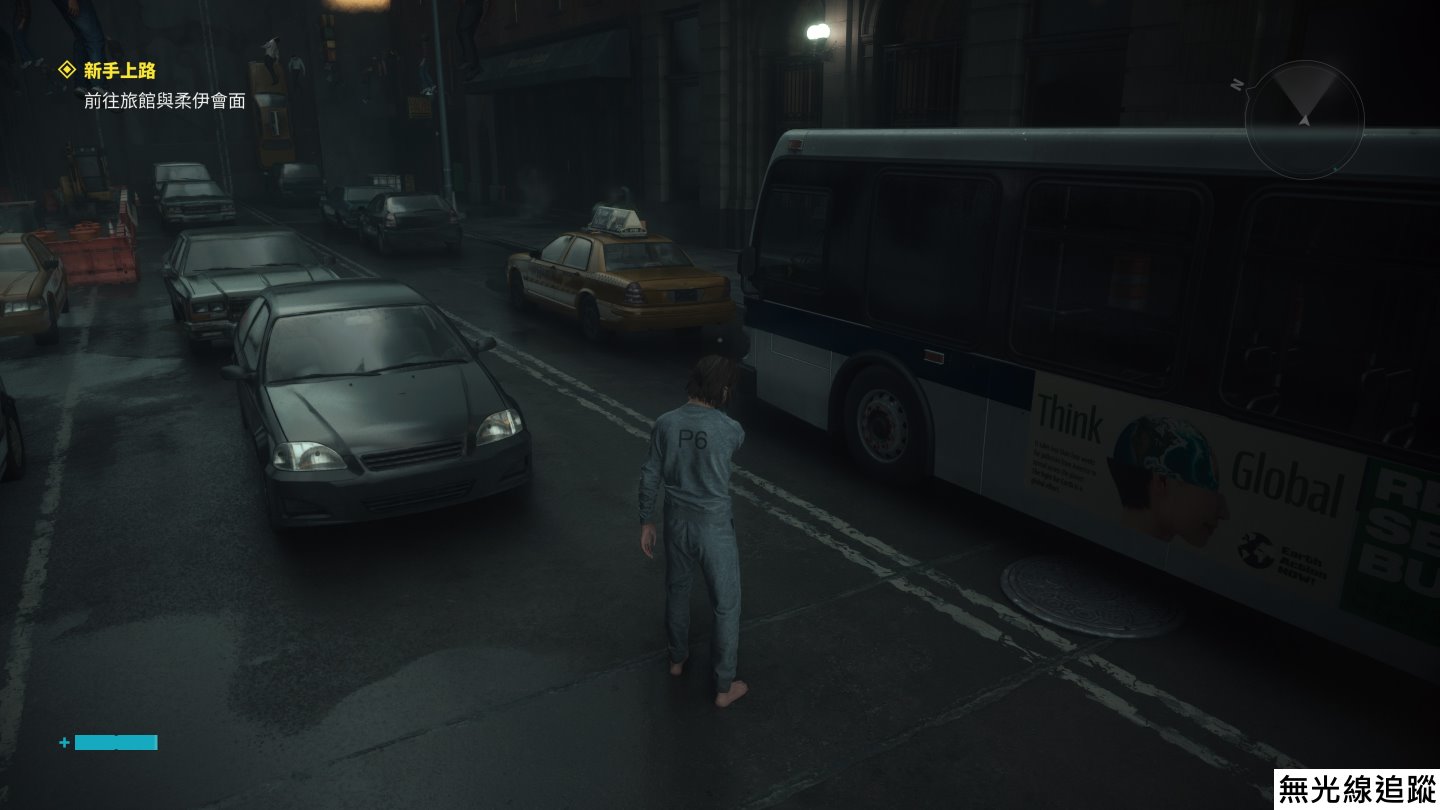
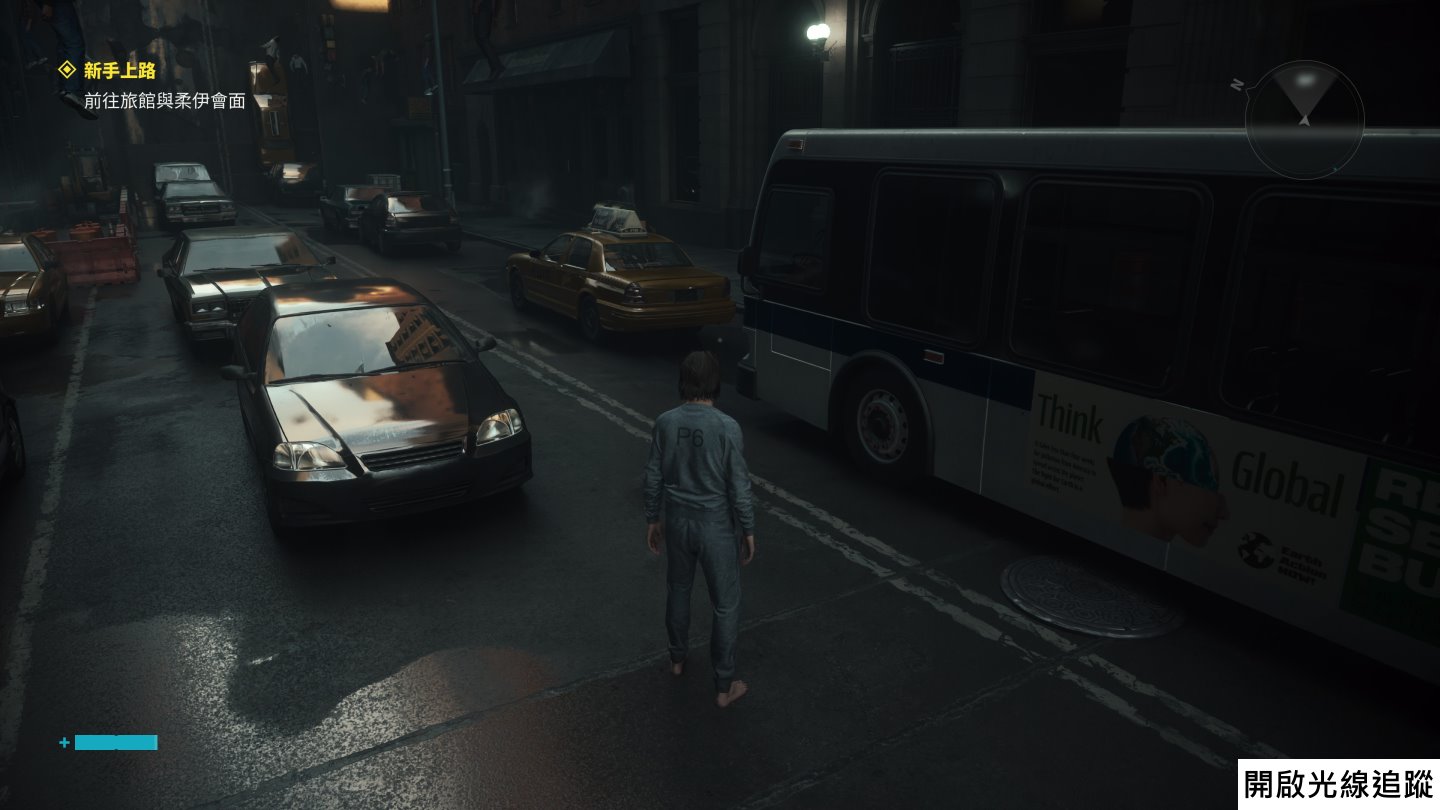
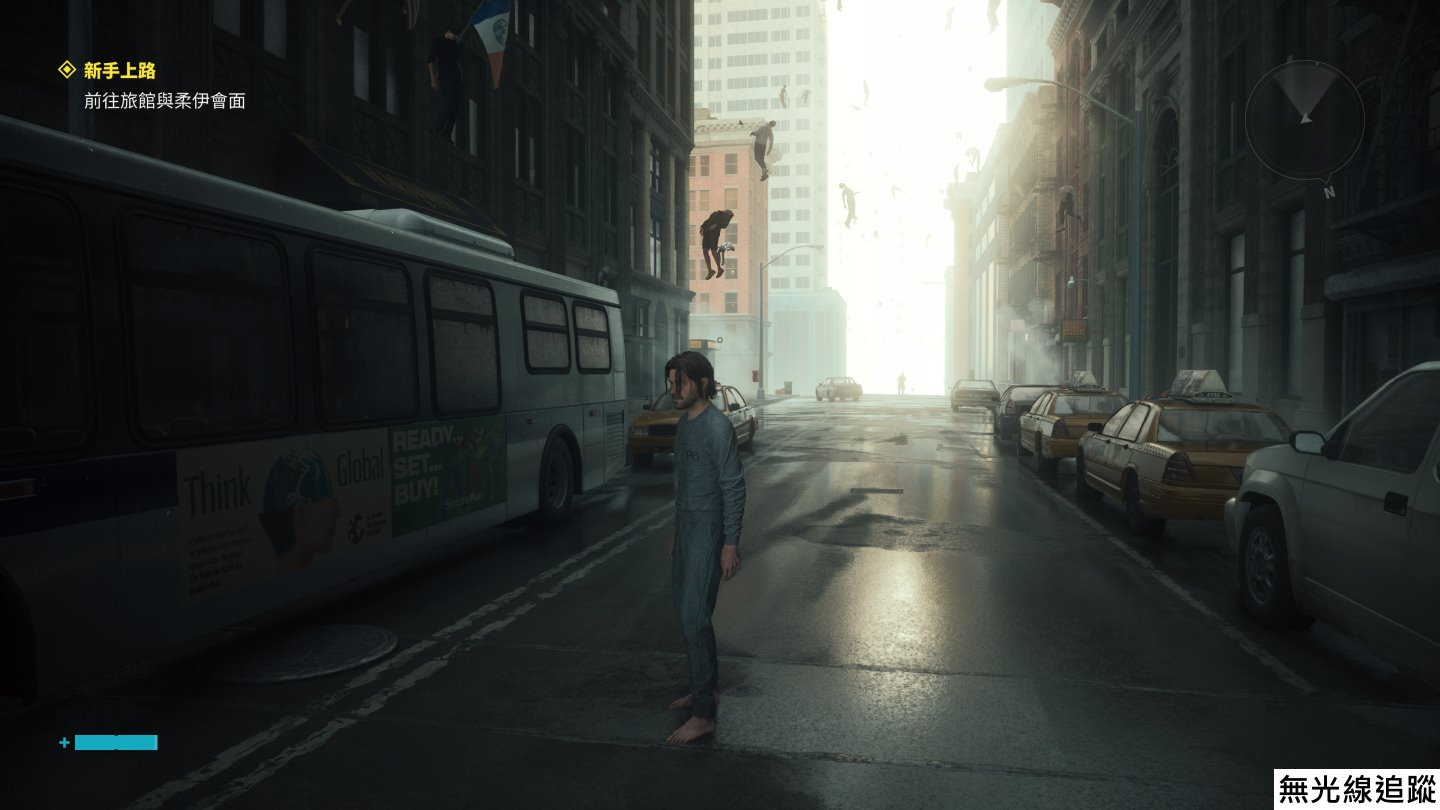
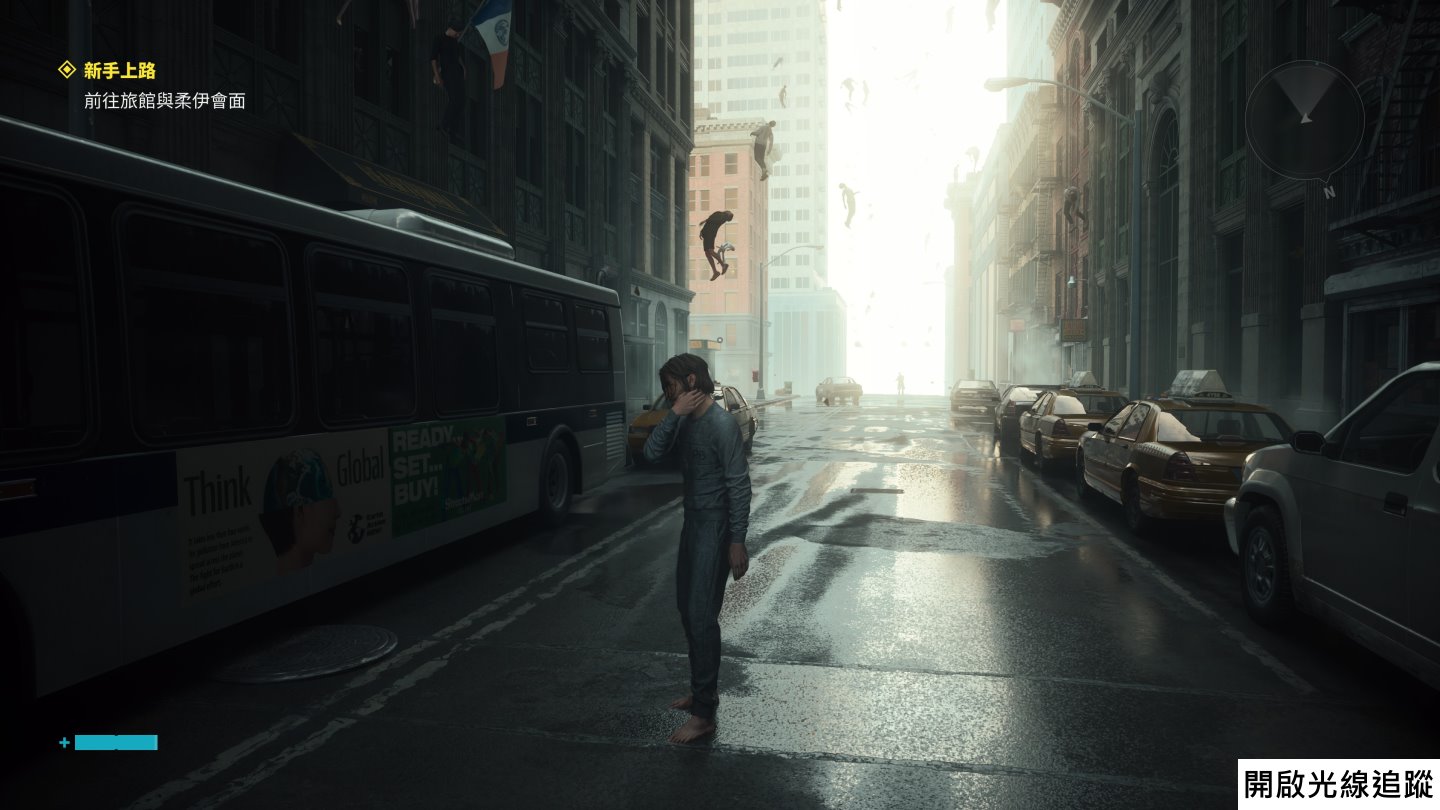
《控制:共振》的實際遊戲畫面與開、關光線追蹤的效果請參考下方圖文說明。

《控制:共振》是款第三人稱動作遊戲,玩家需要在扭曲的空間跳躍、移動,並且擊退敵人。

以室內場景為例,關閉光線追蹤的情況下,空間內的光線比較死板。

白燈開始閃爍後,牆面的光線呈線效果感覺只是用白色覆蓋紅色部分。

▲關閉光線追蹤情況下的紅、白等光閃爍效果。

開啟光線追蹤之後,可以看到光線在空間內反射造成的自然光照效果。

白燈閃爍時,紅色與白色光線互相交融的效果更加逼真。

▲開啟光線追蹤之後,能夠呈現自然的反射與光照。

關閉光線追蹤時,車窗無法反射畫面外的景物。

▲關閉光線追蹤時,車窗沒有任何動靜。

開啟光線追蹤之後,可以從車窗看到後方的景物。

▲開啟光線追蹤之後,可以在車窗上看到背後的建築物與掉落的物品。

關閉光線追蹤時,戶外的光照效果無法呈現間接照明的效果。

▲關閉光線追蹤時,車窗玻璃同樣無法反射景物。

光線追蹤的間接照明技術能夠帶來光線在空間中多次反射的視覺感受。

▲開啟光線追蹤之後,就可以看到車窗即時反射各種物體的動態。

光線重建效能實測

在上面的前半段文章的畫質比較中,筆者保持開啟DLSS超解析度,並將畫面解析度、渲染解析度分別設定為4K與1080p,此外開啟6X畫格生成,將所有畫質相關選項皆調至最高,並比較關閉、開啟光線追蹤的畫面表現。

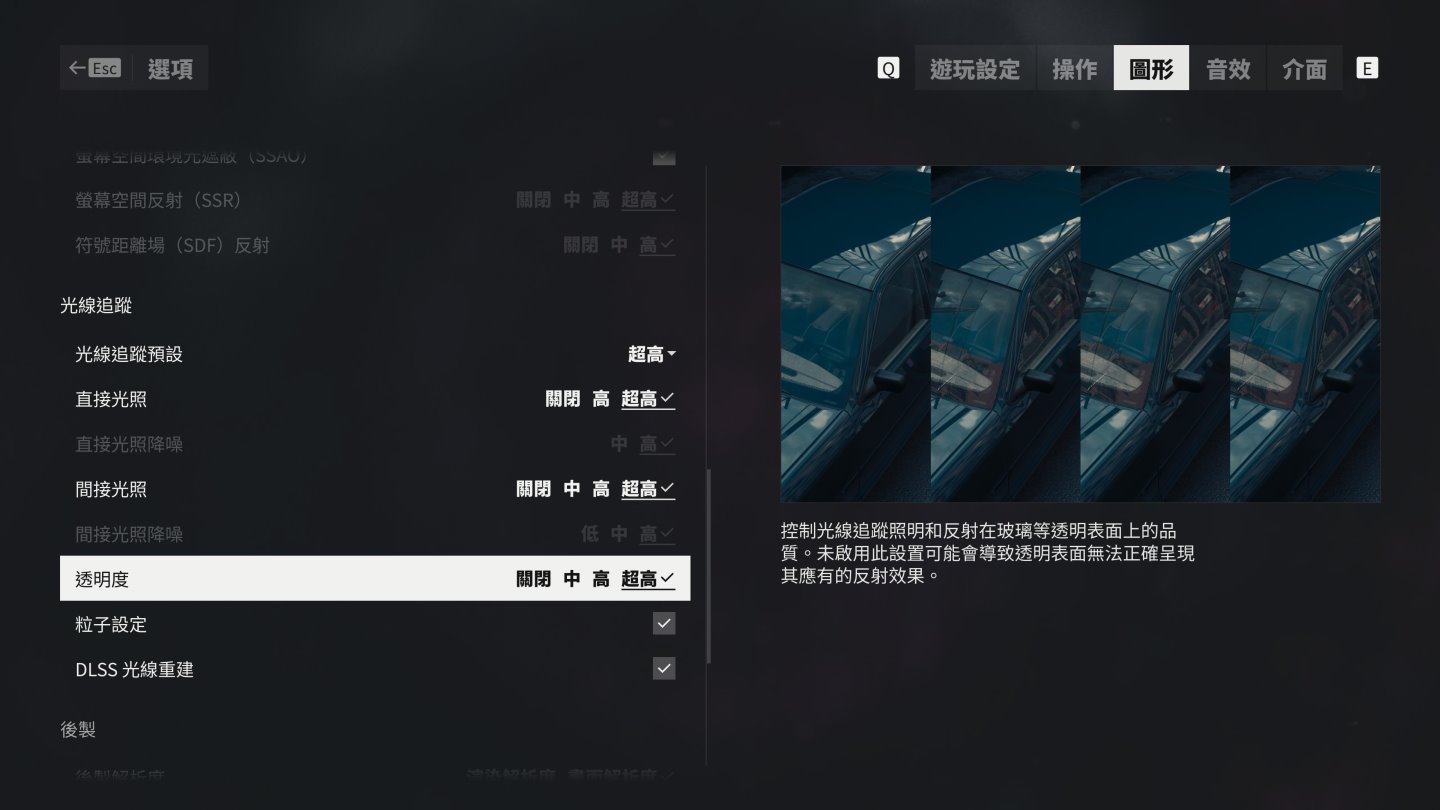
在效能實測部分,由於《控制:共振》強制開啟DLSS超解析度,於是筆者將控制變因設定在畫格生成與光線重建,又因為關閉光線重建時,透明度將無法選擇「超高」所以在效能測試時無論是否開啟光線重建,都將其設定為「高」,其餘條件與畫質比較環節相同。

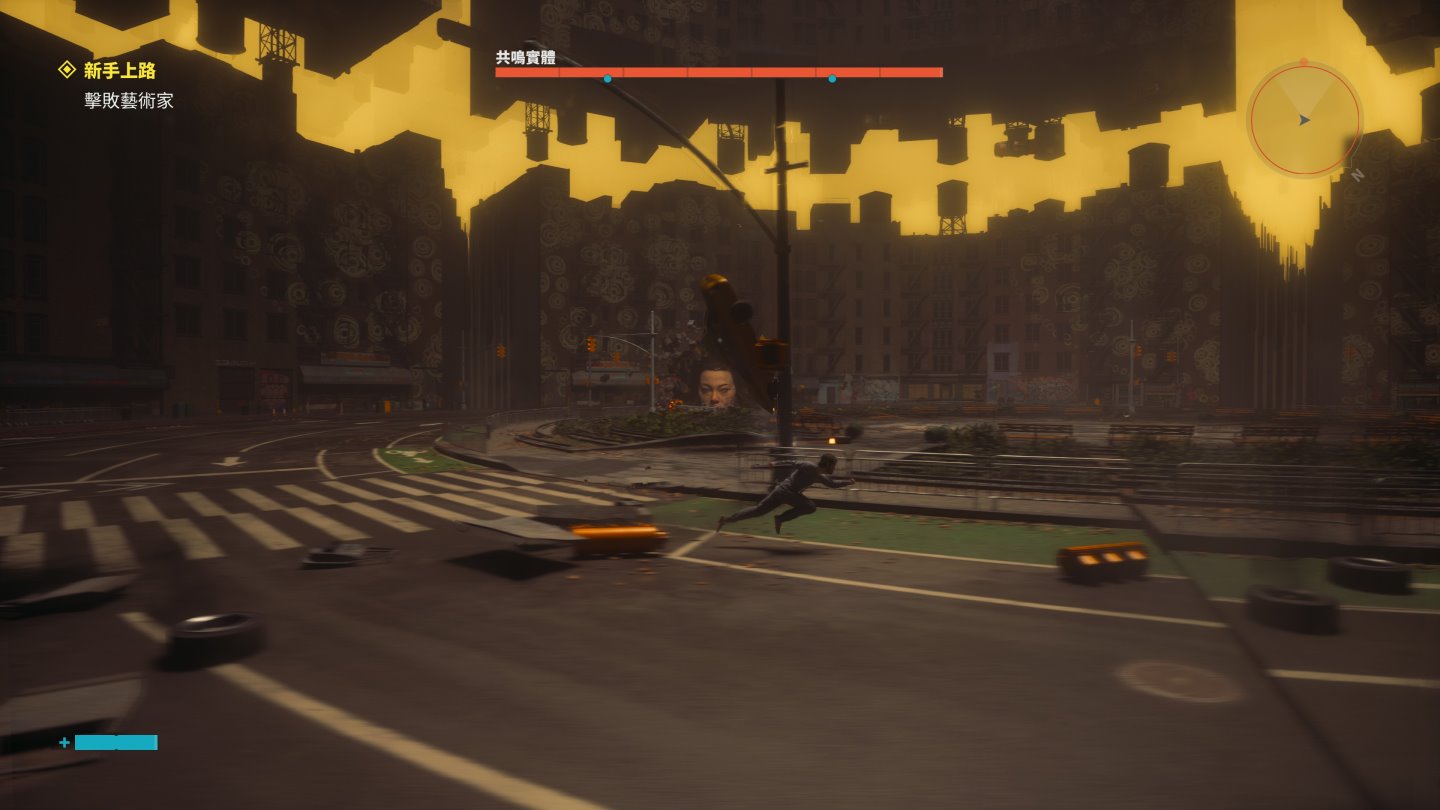
測試的方式為在對上「藝術家」的第1個Boss戰中,持續閃躲對方攻擊,並使用NVIDIA FrameView工具測量30秒遊戲進行中的FPS數據,測試2輪並確認沒有極端值之後,以取平均作為成績。

測試平台:
處理器:AMD Ryzen 7 9800X3D
散熱器:MSI MEG Coreliquid S360
主機板:ASRock X870E Taichi(UEFI版號:4.03.TS04 – AMD AGESA ComboAm5PI 1.2.7.1)
記憶體: G.Skill Trident Z5 Neo RGB 16GBx2(@DDR5-7200)
顯示卡:NVIDIA GeForce RTX 5090 Founders Edition
儲存裝置:Samsung 9100 Pro 1TB(系統碟)、Solidigm P41 Plus 1TB(遊戲碟)
電源供應器:MSI MEG Ai1300P PCIE5
軟體環境:Windows 11專業版25H2(Build 26200.9445),GeForce Game Ready 616.64

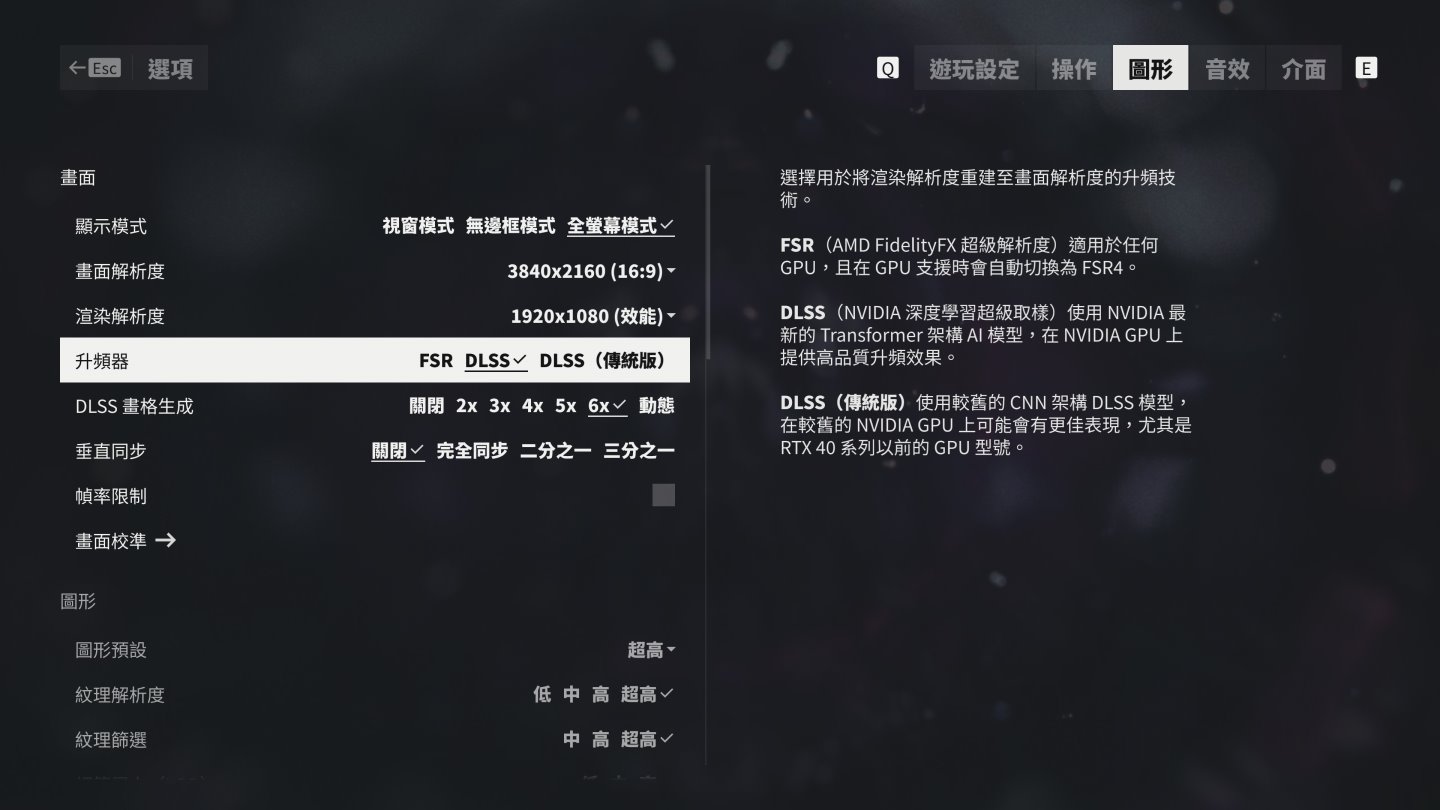
《控制:共振》的圖形設定提供詳細的升頻選項,可以指定超解析度的渲染解析度,以及畫格生成倍率。

光線重建也有獨立開關,但是關閉時透明度將無法選擇「超高」。

效能測試的方式為在Boss戰使用NVIDIA FrameView工具測量2輪30秒FPS數據。

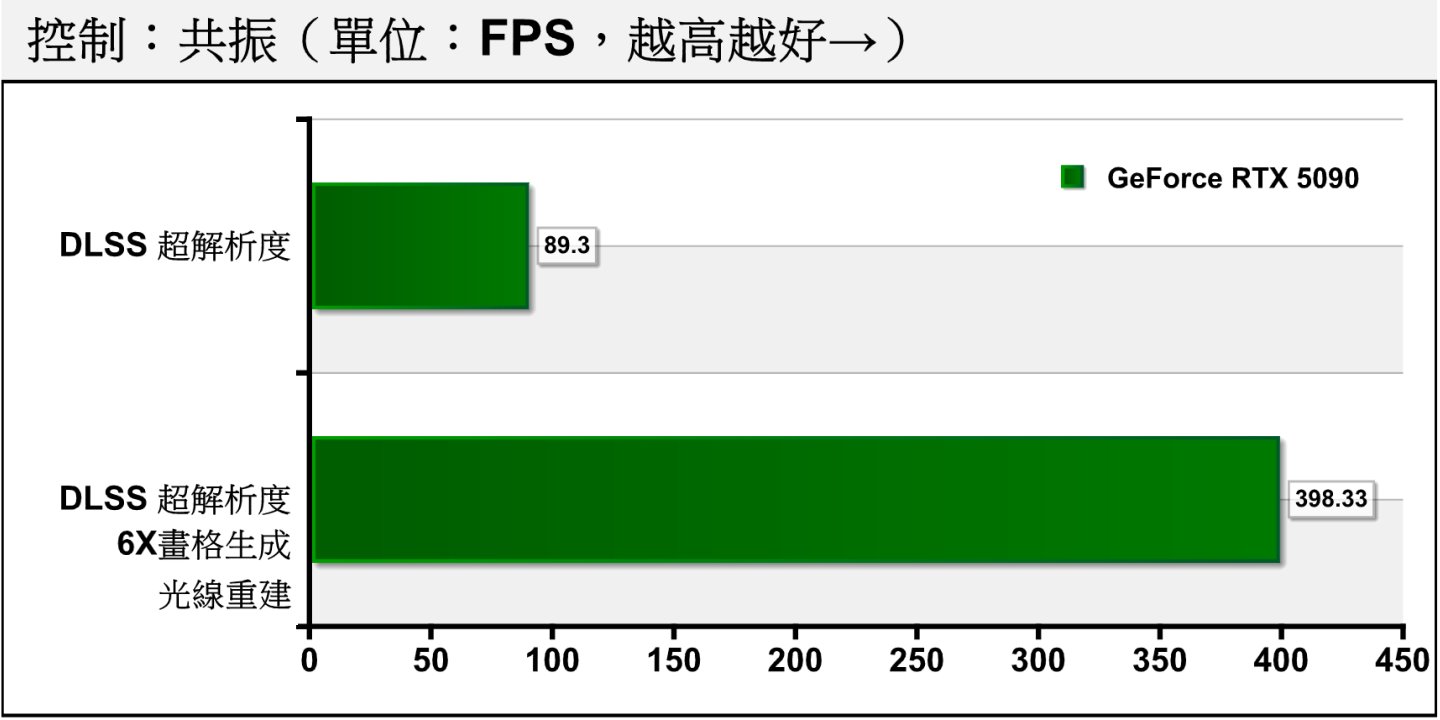
在3種DLSS升頻技術的加持下,GeForce RTX 5090能讓《控制:共振》在4K解析度、最高畫質的條件下達到近400幀的平均FPS。

《控制:共振》預定於2026年9月24日上市,可於Steam平台購買。

加入T客邦Facebook粉絲團

Intel分析從邊緣AI到實體AI策略與解決方案,推出多種運算單元滿足差異化需求

2026年9月17日 09:00
Intel於「從Edge AI 到Physical AI:英特爾策略與解決方案」說明會中,邀請多位專家與分享趨勢分析,並說明多種不同運算單元的特色。3835aa6f32e6c4af8026f6c7b8827dce

Intel於「從Edge AI 到Physical AI:英特爾策略與解決方案」說明會中,邀請多位專家與分享趨勢分析,並說明多種不同運算單元的特色。

XPU異質運算各展所長

Intel表示自身擁有數十年邊緣運算領域的深厚經驗,透過開放生態系架構與標準化藍圖,協助企業在既有基礎建設與邊緣工作流程中無縫導入AI,同時達成控制總持有成本、兼顧能耗效率與推論效能的目標,並與合作夥伴共同在全球完成超過10萬個邊緣應用實際案例。

延伸閱讀:
Intel於Hot Chips 2026展示代理式AI與企業級產品,Diamond Rapids導入Intel 18A-P製程與扇出拓樸
Intel Panther Lake處理器架構解析,3種衍生型號最多可選16核搭12組Xe 3核心
Intel Panther Lake邊緣運算動態展示,將推出工控寬溫版還有迷你單板電腦

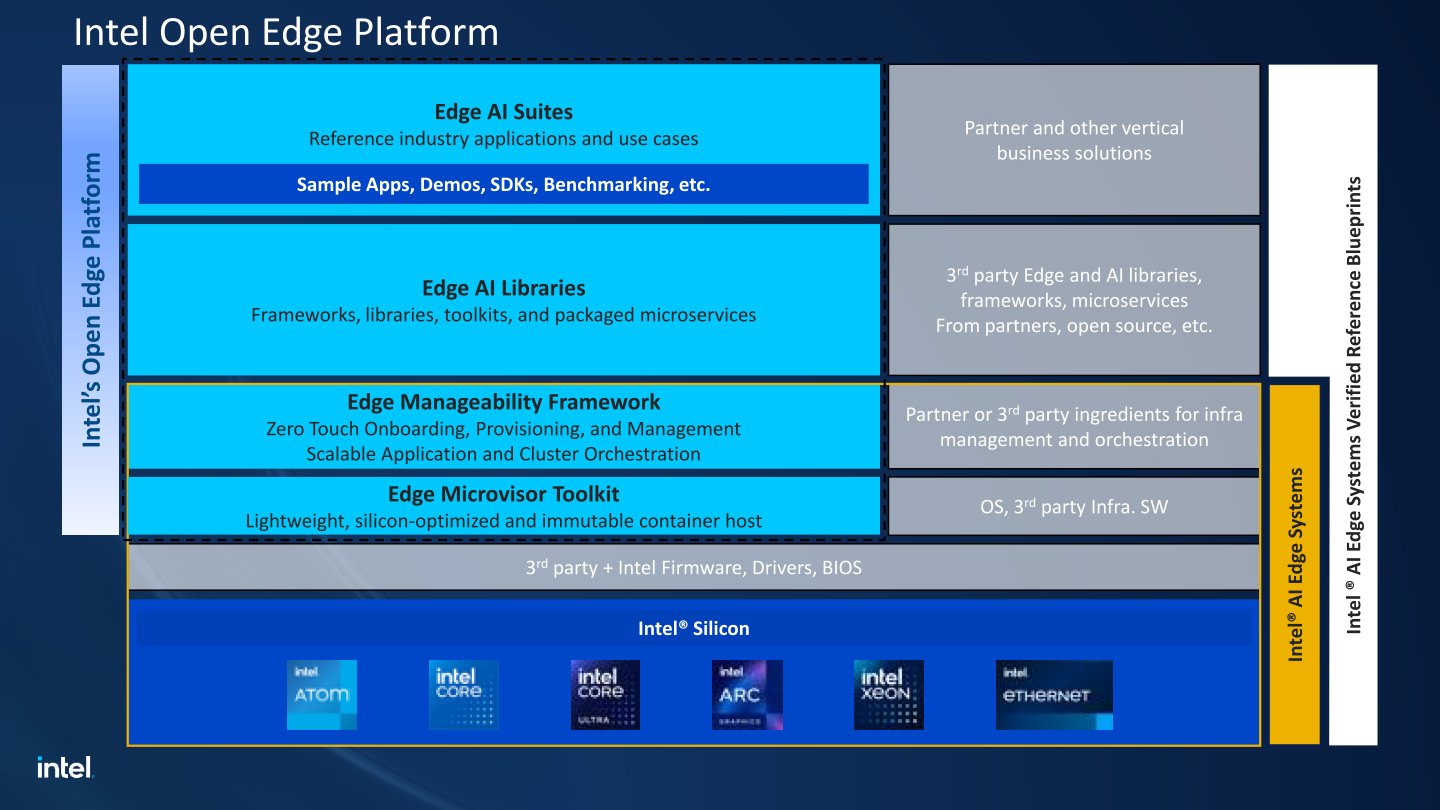
現今許多邊緣AI(Edge AI)與實體AI(Physical AI)的應用仍以傳統機器學習和電腦視覺為主要應用,Intel提供運算單元以滿足不同需求的邊緣AI系統,並透過開放式邊緣平台(Open Edge Platform)、邊緣AI開發套件(Edge AI Suites)加速AI應用程式的開發與部署。,簡化AI與現有基礎架構的整合,協助零售、製造、智慧城市、媒體與娛樂等產業加速邊緣AI轉型。

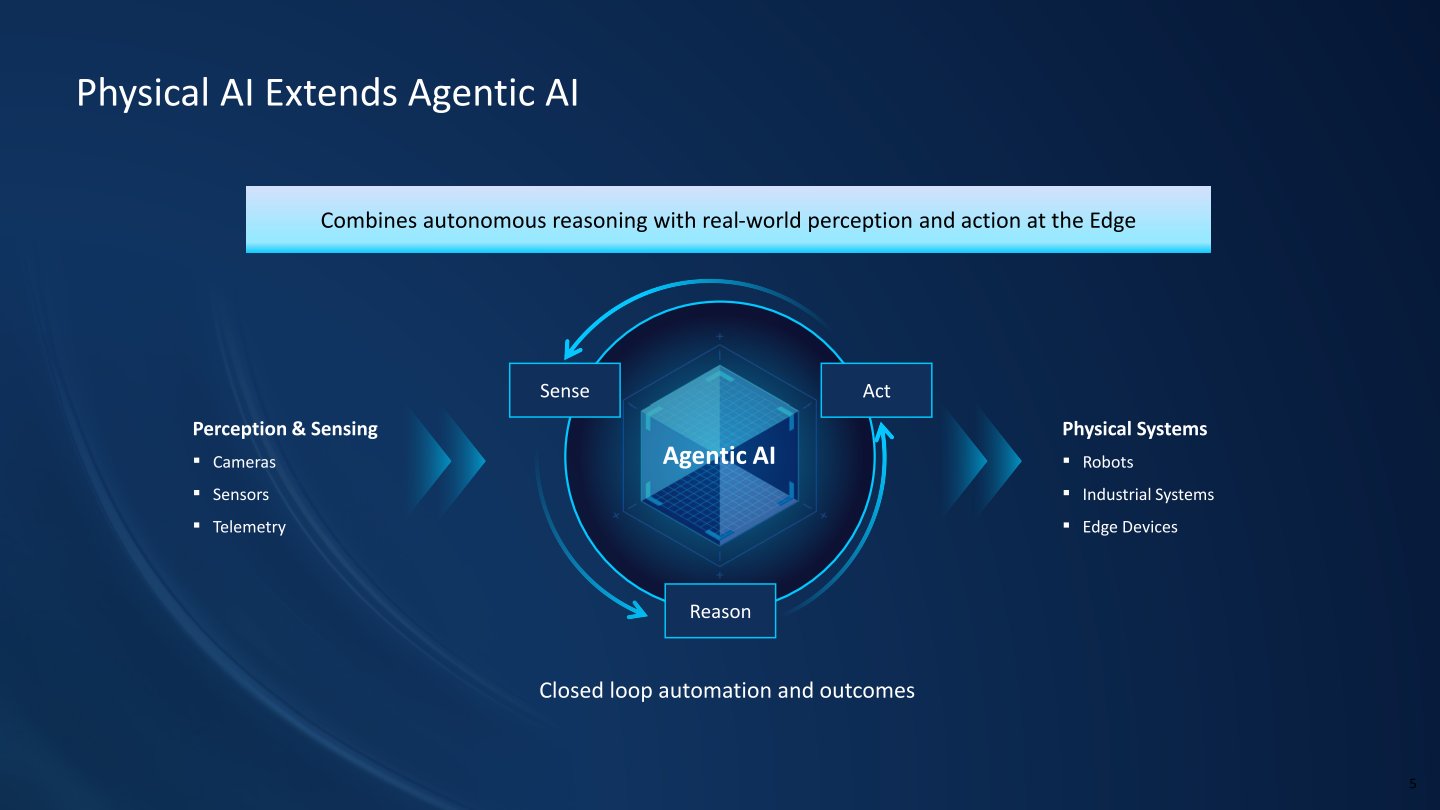
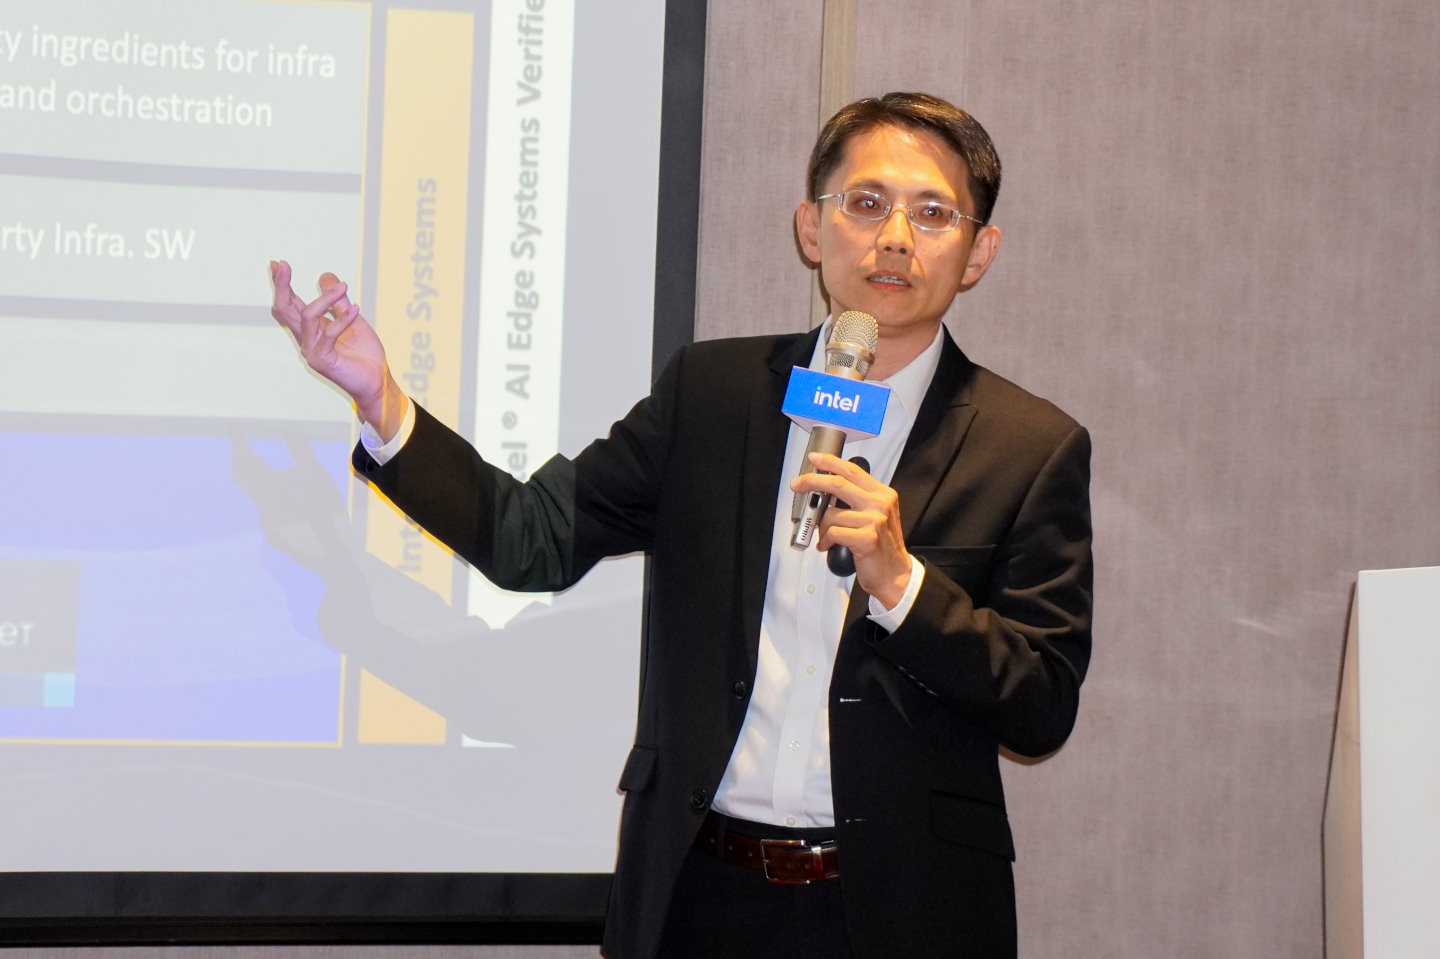
Intel邊緣運算事業群生態系發展部門總經理杜唯揚表示,當技術發展的路線從代理式AI進一步到實體AI,最大的差別在於系統完成推理階段之後,還需要將推理所得到的成果進一步轉換為機器人或各式邊緣裝置的行動。而需要以電腦中的文字、圖像等資訊控制真實世界的裝置,則是需要克服的技術難題。

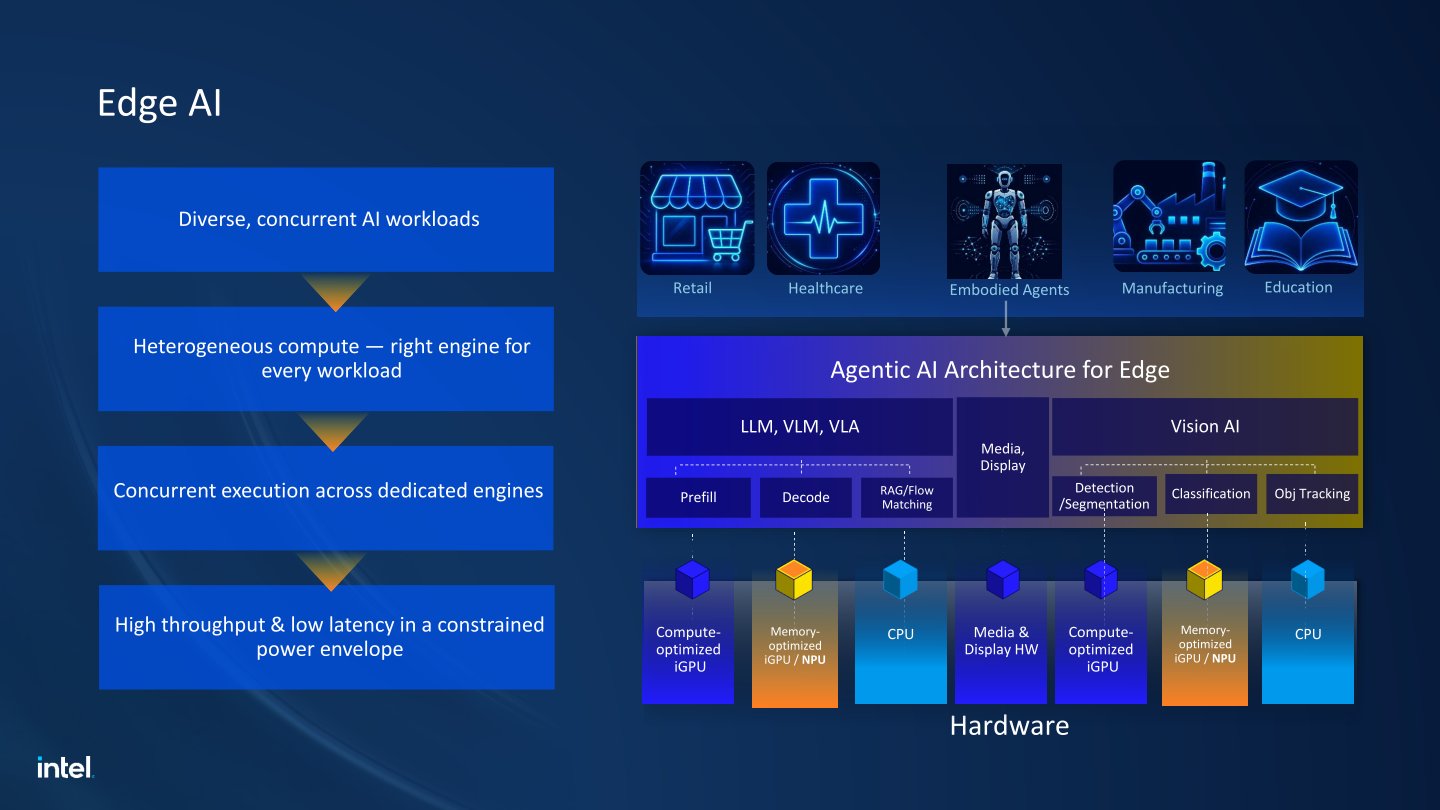
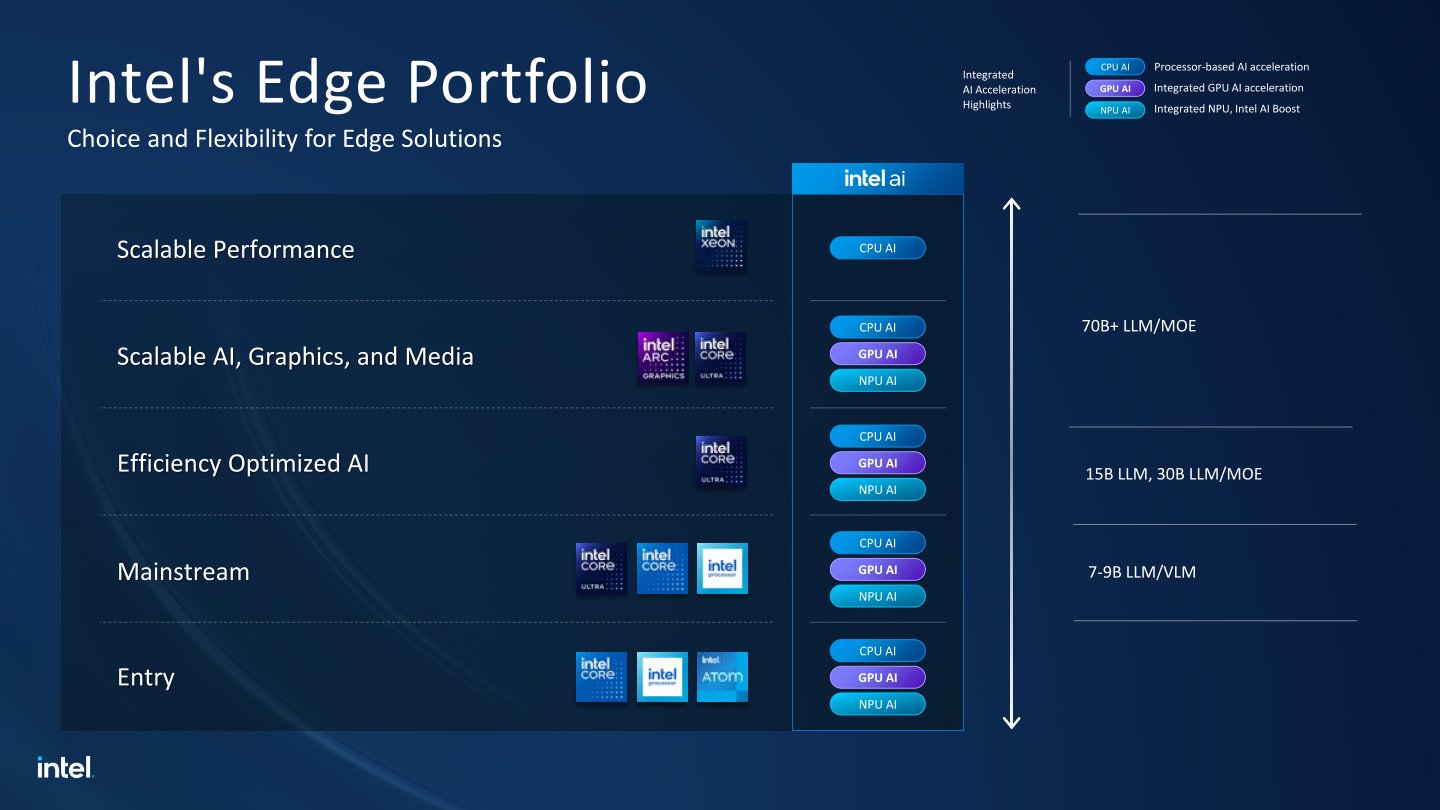
杜唯揚也提到,目前產業遇到的困境並非沒有AI模型可用,而是有太多不同的模型,因此該如何根據需求挑選適合的模型就成了當務之急。另一方面,Intel提供伺服器級的Xeon處理器、中階Core Ultra處理器與Arc顯示卡、輕量的Core處理器與Atom處理器,部分產品中也整合了CPU(處理器)、GPU(繪圖處理器)、NPU(神經處理器)等不同運算單元,分別適合搭配參數量為70B、15B(或30B MOE混合專家模型)、7~9B等量級的模型,以滿足不同需求。

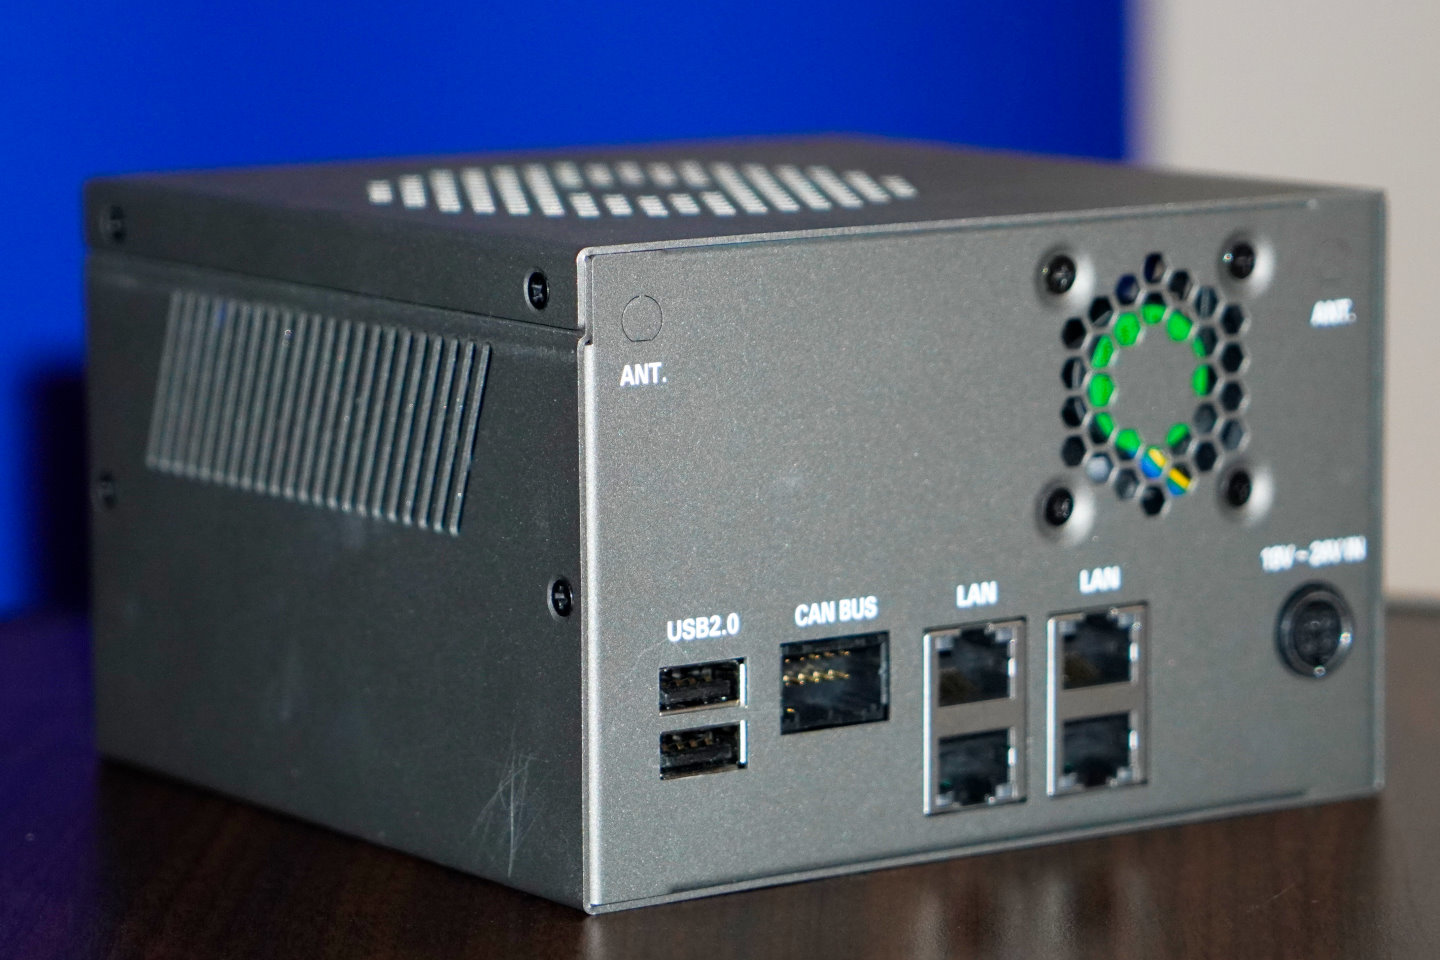
Intel展示為邊緣運算設計的Panther Lake參考平台,提供更多網路與CAN Bus。端子。

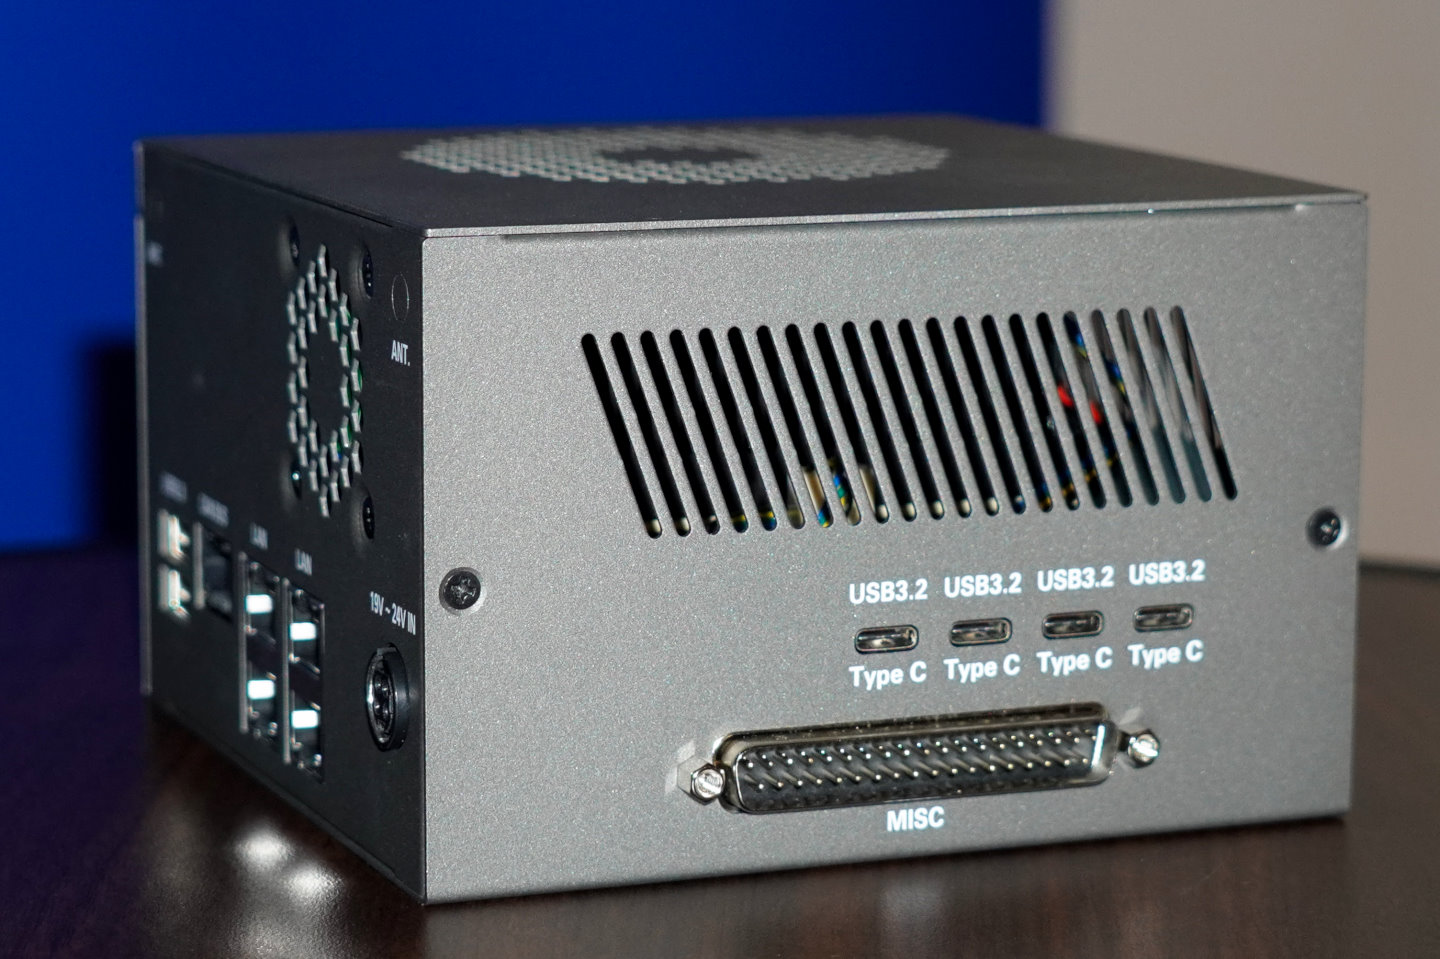
機身另一面也提供4組USB 3.2 Type-C端子以及整合式雜項端子,以滿足工控電腦的擴充需求。

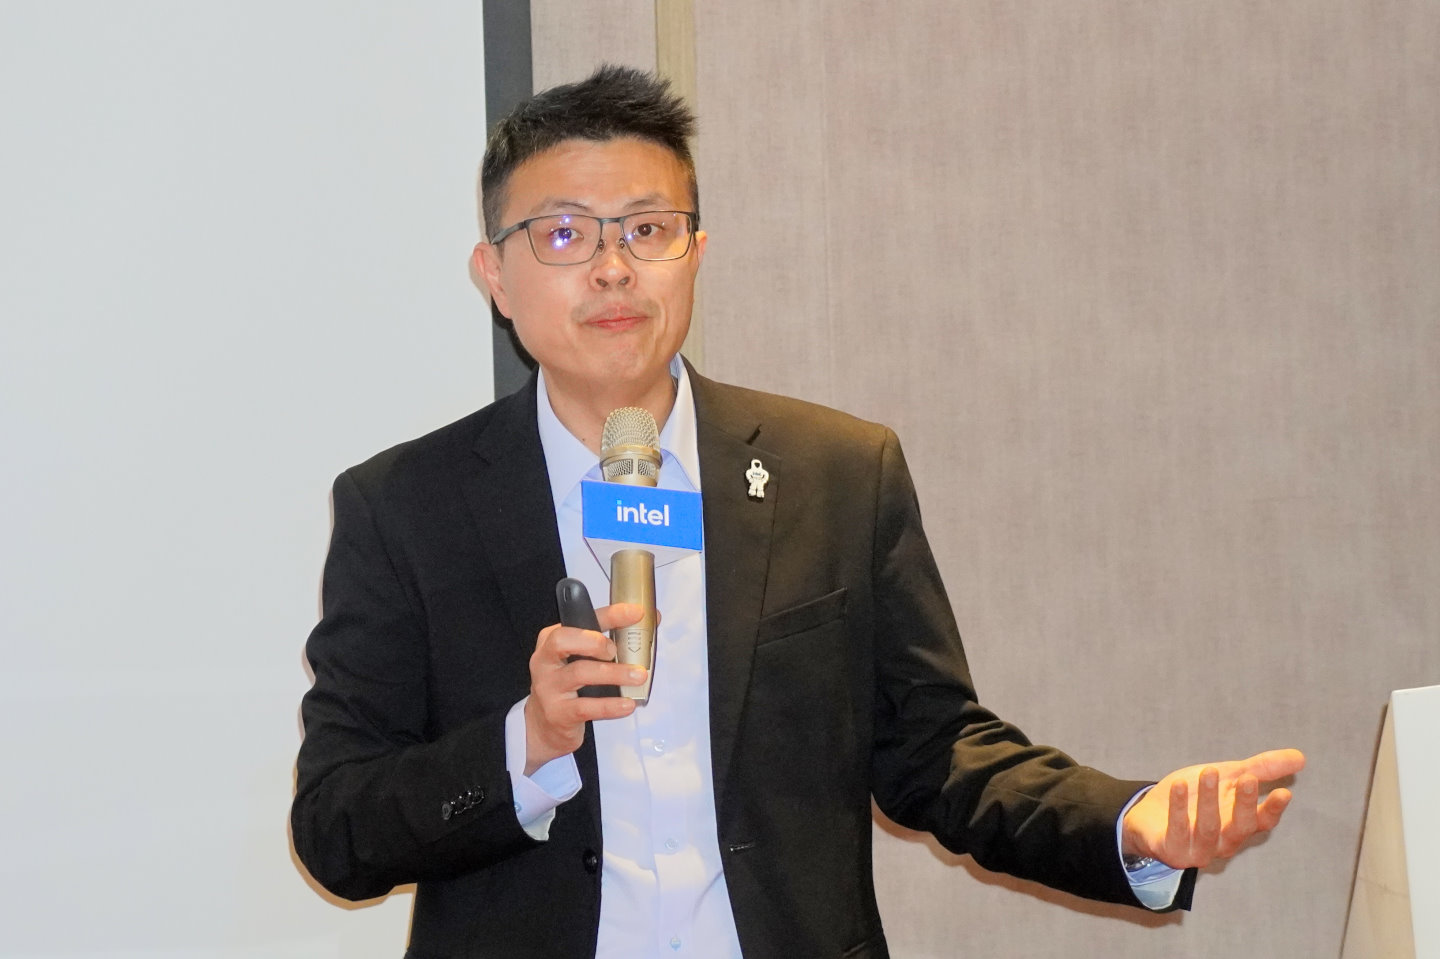
Intel邊緣運算事業群生態系發展部門總經理杜唯揚在說明會上半場為大家解說實體AI的發展趨勢。

杜唯揚提到無論是邊緣AI或實體AI,有越來越多應用都會採納代理式AI的運算框架,而Panther Lake處理器中的CPU、GPU、NPU與媒體引擎能在不同運算負載中發揮所長。

代理式AI的運作重點是會透過攝影機、感應器等元件感知外部資訊後,進行自動化閉環推理運算,最後驅動實體機器人或工業設備做出行動。

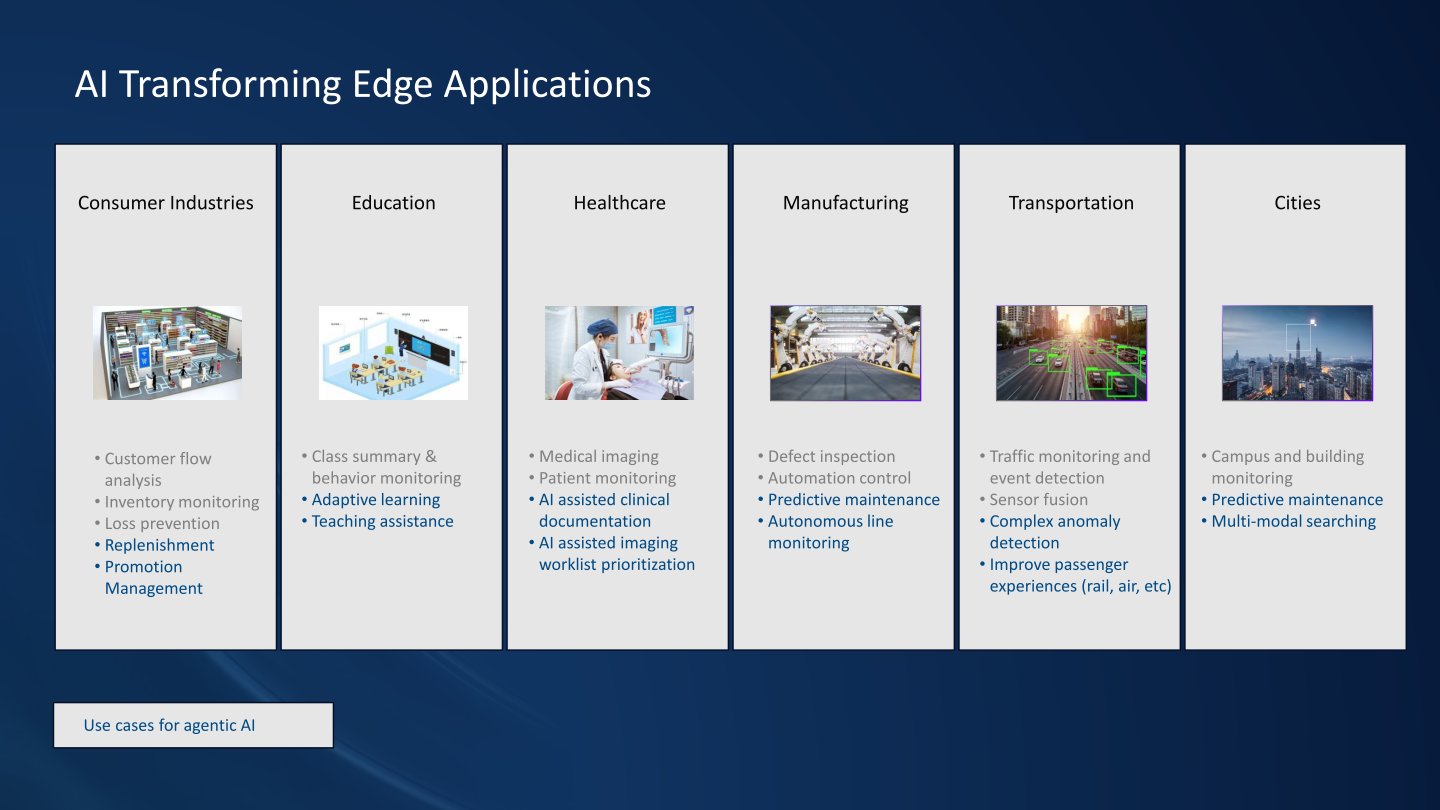
Intel提供多種合作夥伴已經導入AI的轉型成功案例,其中包含零售、教育、醫療、製造業、交通、智慧城市等等。

Intel提供上至伺服器級的Xeon處理器,以及中階Core Ultra處理器、Arc顯示卡,還有輕量的Core處理器、Atom處理器,適合搭配參數量為70B、15B(或30B MOE模型)、7~9B等不同量級的模型。

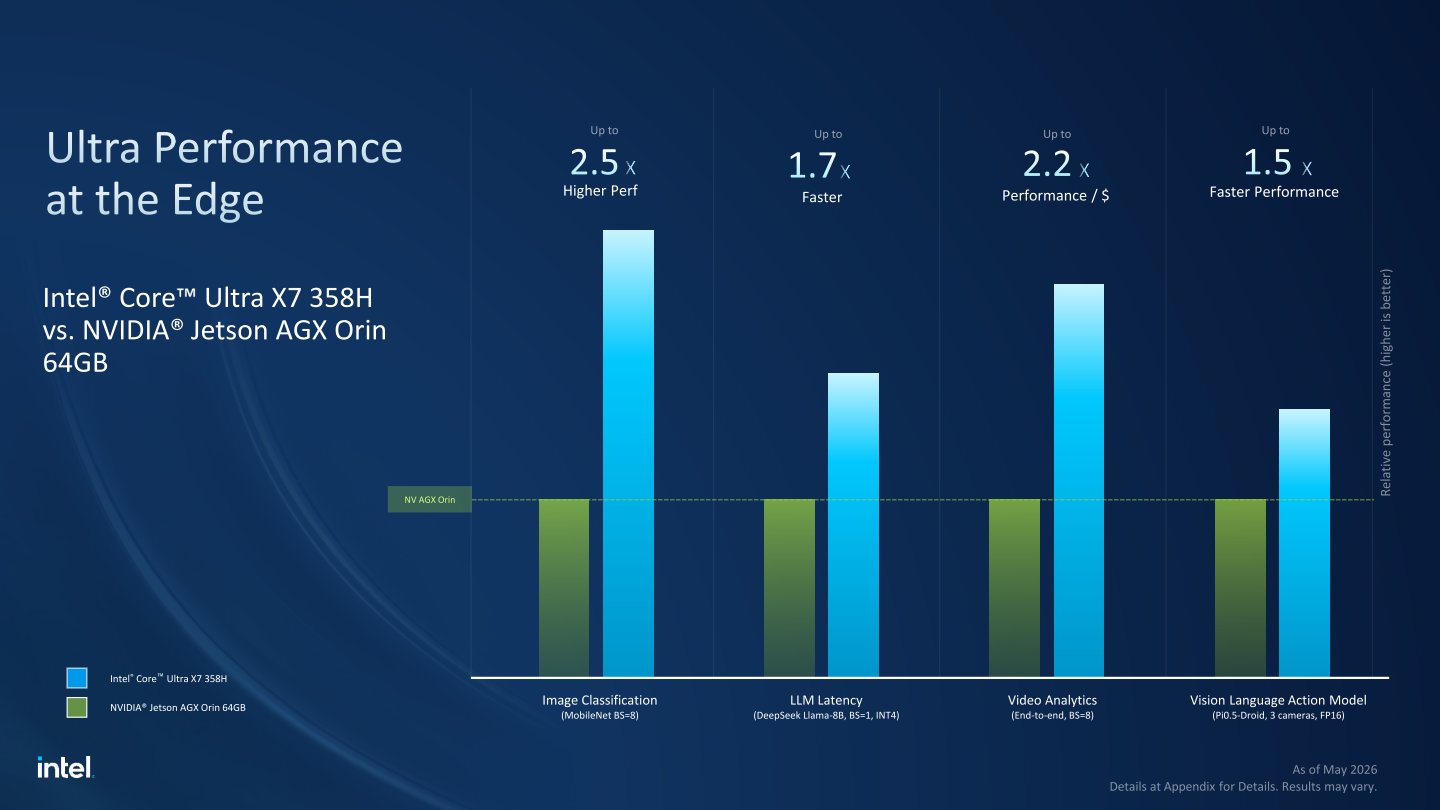
根據Intel提供的數據,Core Ultra X7 358H處理器與競爭對手NVIDIA Jetson AGX Orin平台相比,在多項運算負載的效能表現可達1.5~2.5倍,在影片分析的單位成本效能表現達到2.2倍。

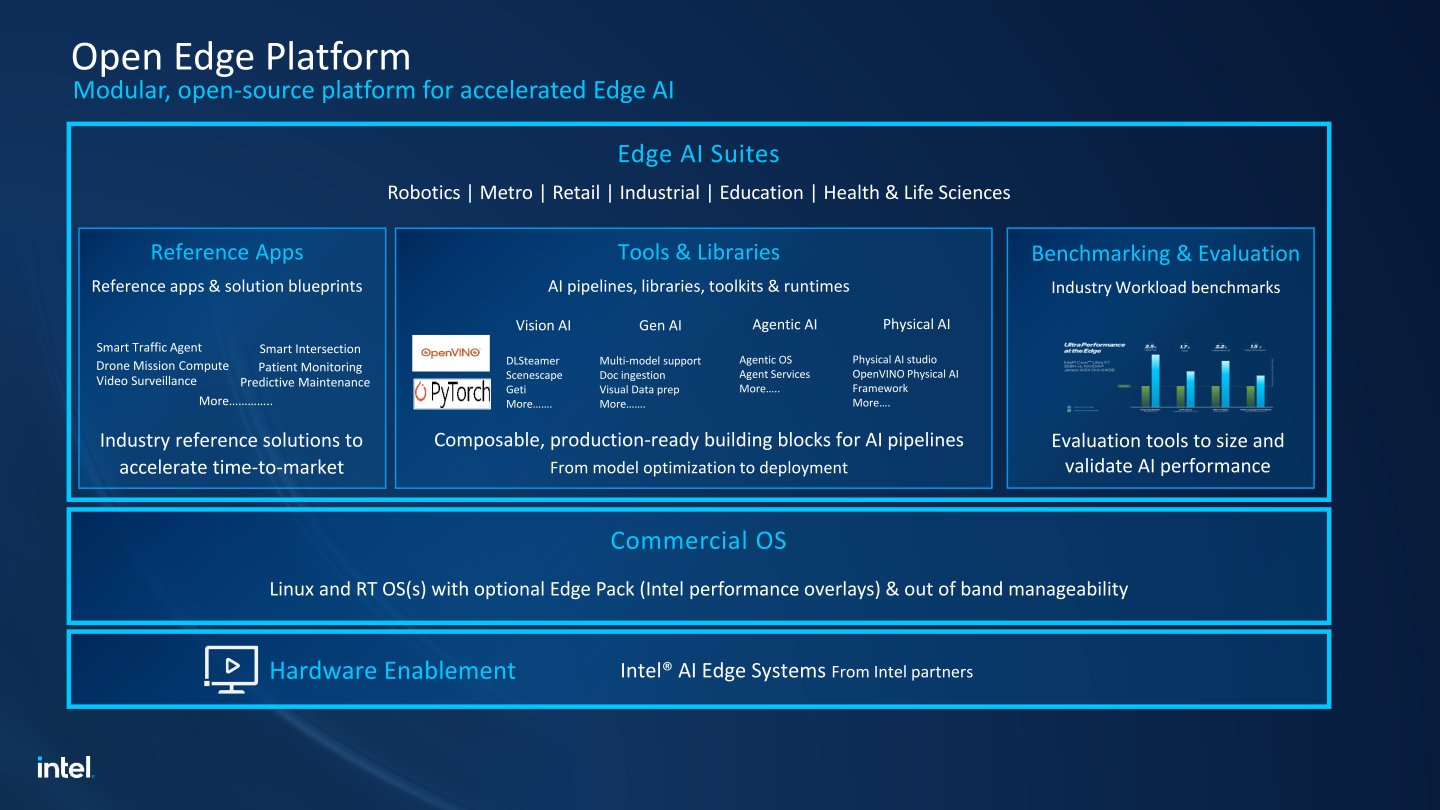
Intel的Open Edge Platform平台提供底層作業繫系統(Linux與RTOS)、中層的工具與函數庫、上層的參考應用程式,讓開發者可以快速將構想轉換為實際方案。

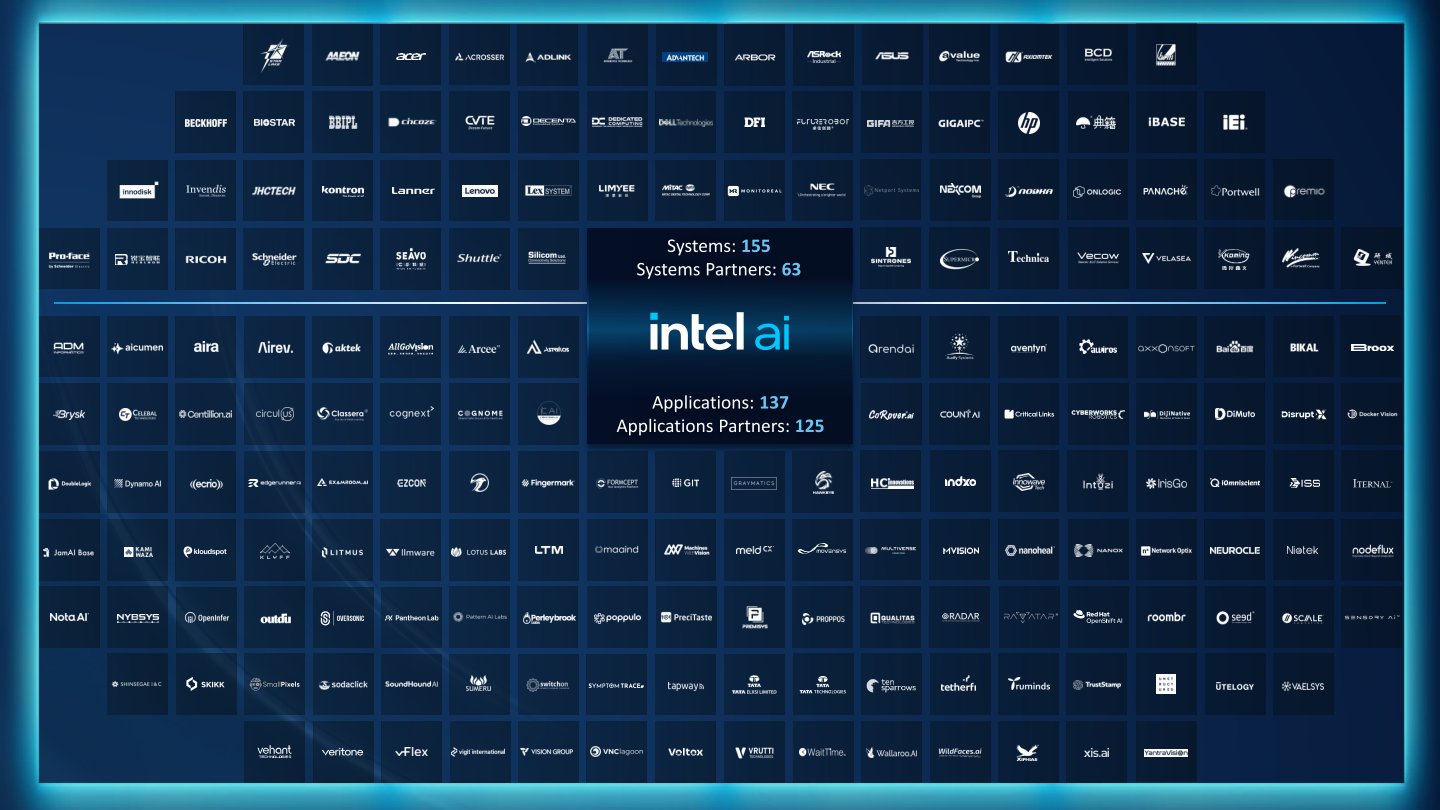
Intel AI以及累積63位系統夥伴並推出155款系統,軟體部分則有125位夥伴推出137款應用程式。

Intel能在邊緣AI領域提供完善的異質運算與大規模營運平台,並加速從開發都收益的流程。

混合傳統與AI運算更具效益

Intel邊緣運算事業群平台研發協理王宗業則是較偏技術的角度,分析Intel在軟體堆疊、開發工具,以及實體AI的硬體平台所具備的優勢。

他特別強調硬體參考平台搭載代號為Panther Lake的Core Ultra系列3處理器,具有最新世代的CPU、GPU、NPU運算單元,分別能夠提供「10 + 120+ 50」全機共180 TOPS的AI運算效能,對於許多邊緣與實體AI應用來說十分充沛。

王宗業也提到混合以規則為基礎(Rule Based)的傳統運算與AI運算的概念,並餐飲業使用機器手臂折毛巾為範例。在折毛巾的部分可以使用傳統運算進行高度重覆性的工作,並依各分店空間與需求不同,透過AI協助辨識將毛巾放置於特定位置,或依指定數量堆疊並裝箱,在完成任物需求的同時,降低Token(字詞)的消耗量以節約成本。

Intel邊緣運算事業群平台研發協理王宗業在說明會下半場分析Intel的技術與優勢。

Intel以處理器、GPU、網路等晶片做為堅實的基礎,並與合作夥伴共同推出開發工具鏈、管理框架、函數庫、軟體套件等資源。

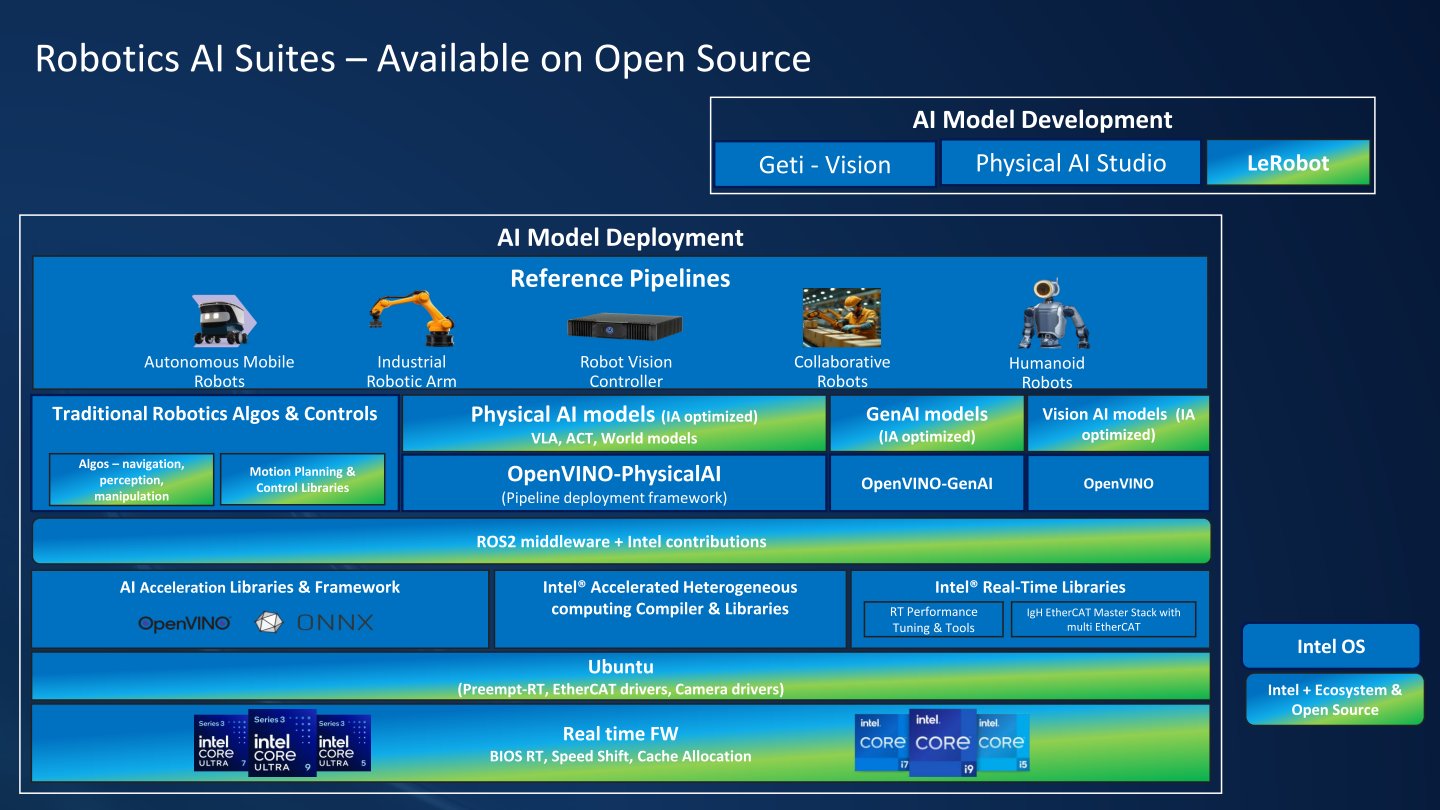
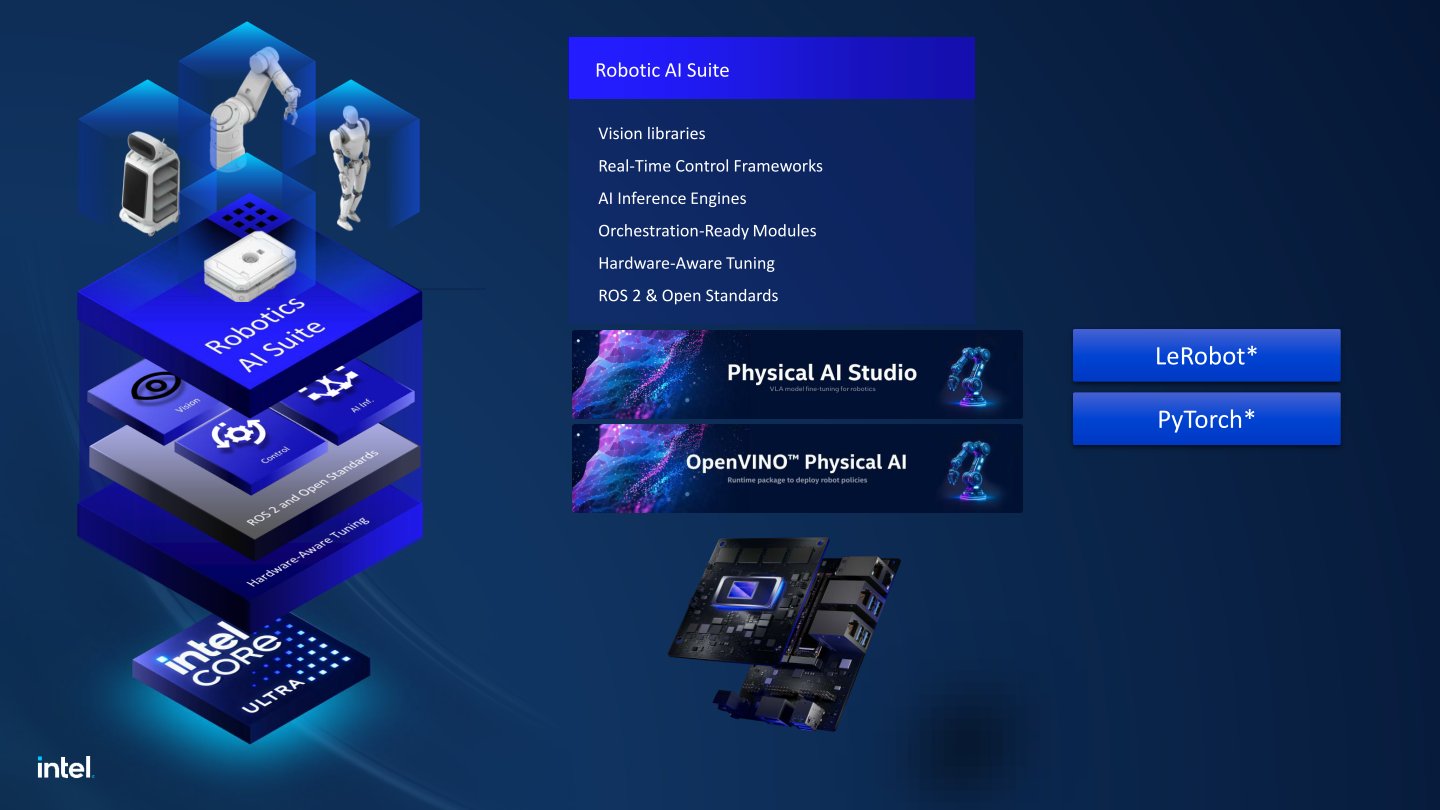
機器人AI軟體套件也是集合Intel與生態系統中多項資源,提供完整的控制、實體AI、電腦視覺等等軟、硬體功能。

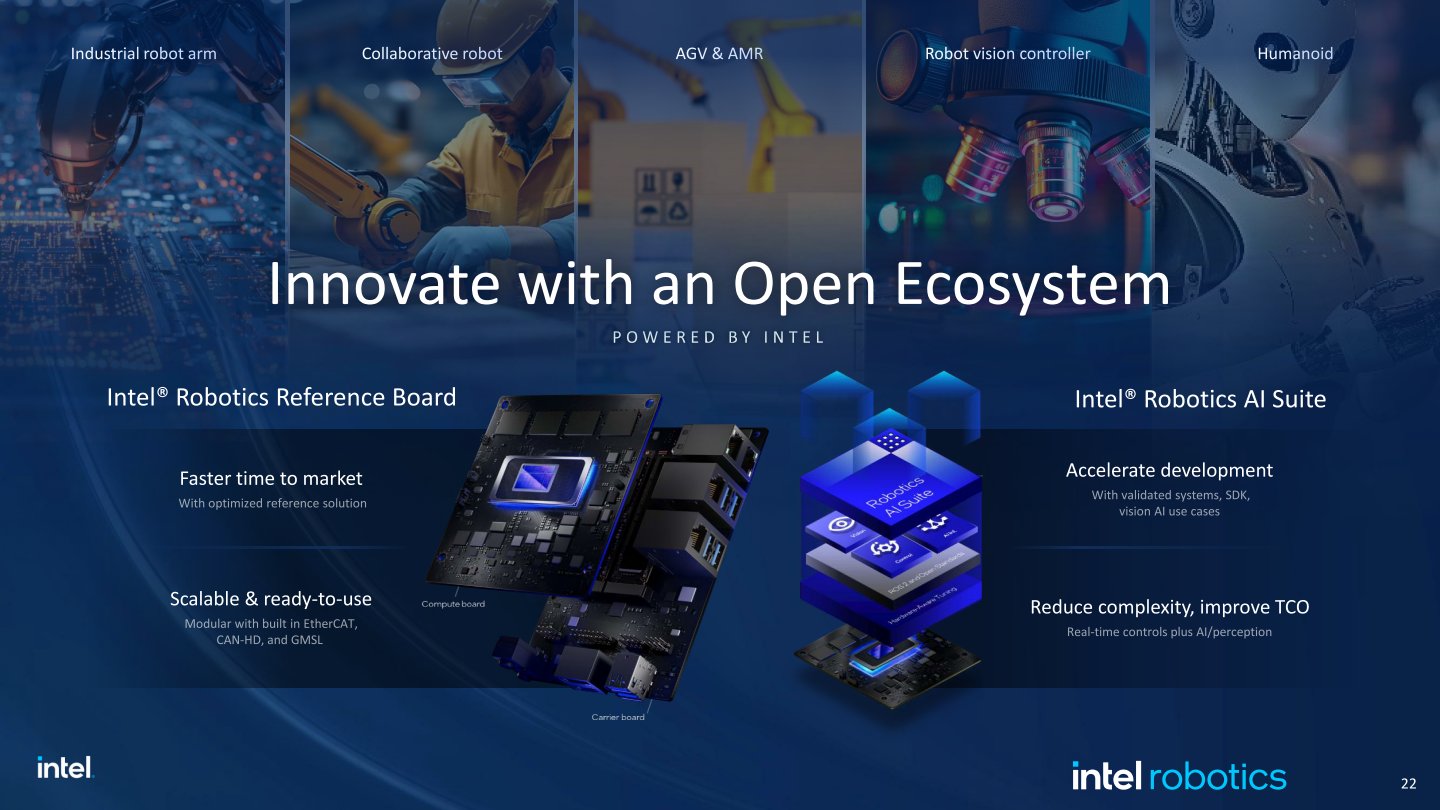
Intel推出採用代號為Panther Lake的Core Ultra系列3處理器的參考平台,能夠應用於工業機械手臂、協作機器人、自動導引車(AGV)、自主移動機器人(AMR)、機器視覺控制器、人型機器人等場域。

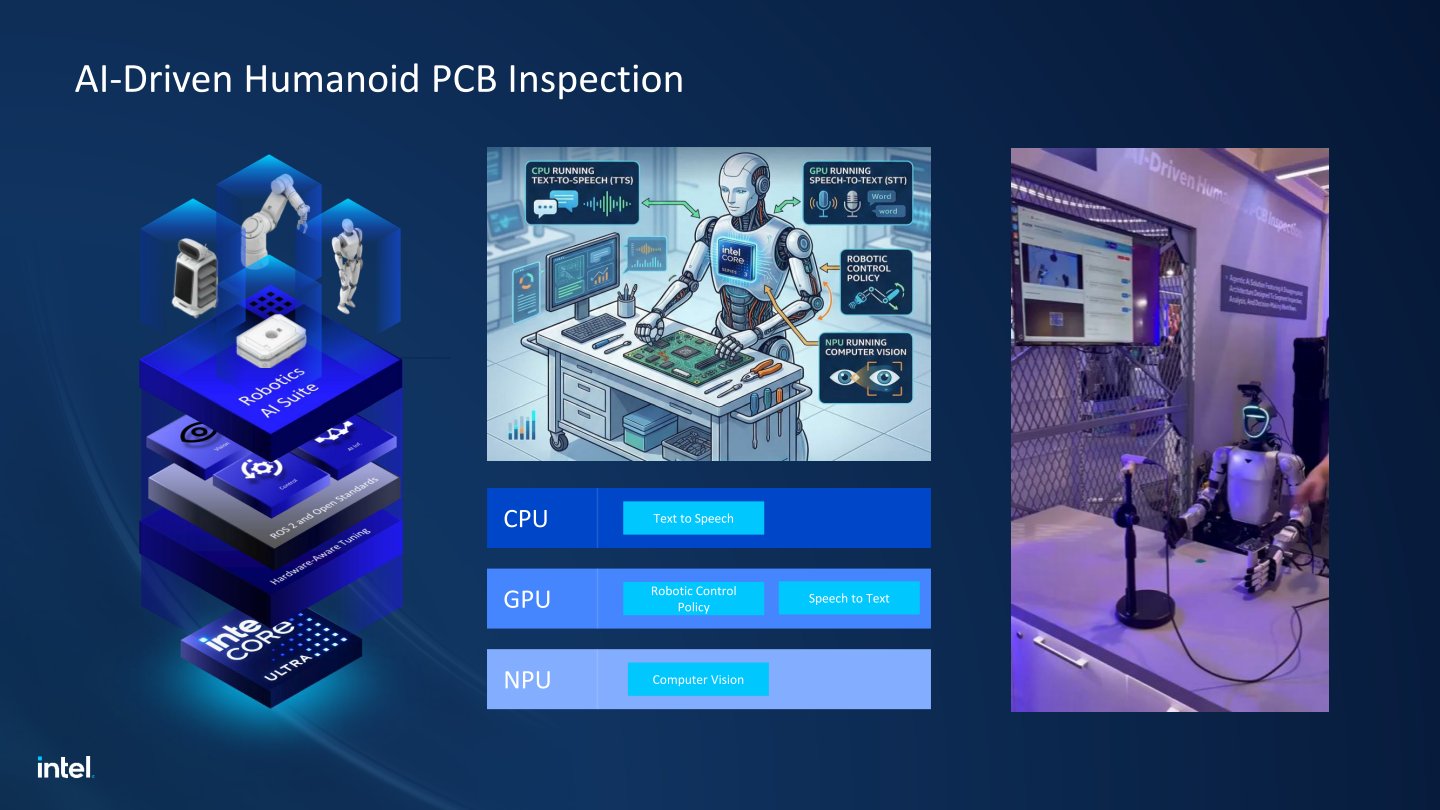
Core Ultra系列3處理器能夠搭配OpenVINO Physical AI、Physical AI Studio以及多款軟體套件,充分活用CPU、GPU、NPU的異質運算單元。

以AI驅動的電腦視覺PCB檢測為例,可以利用CPU進行文字轉語音輸出的運算,GPU則負責規劃機器人動作、語音轉文字輸入,NPU用於持續影像辨識。

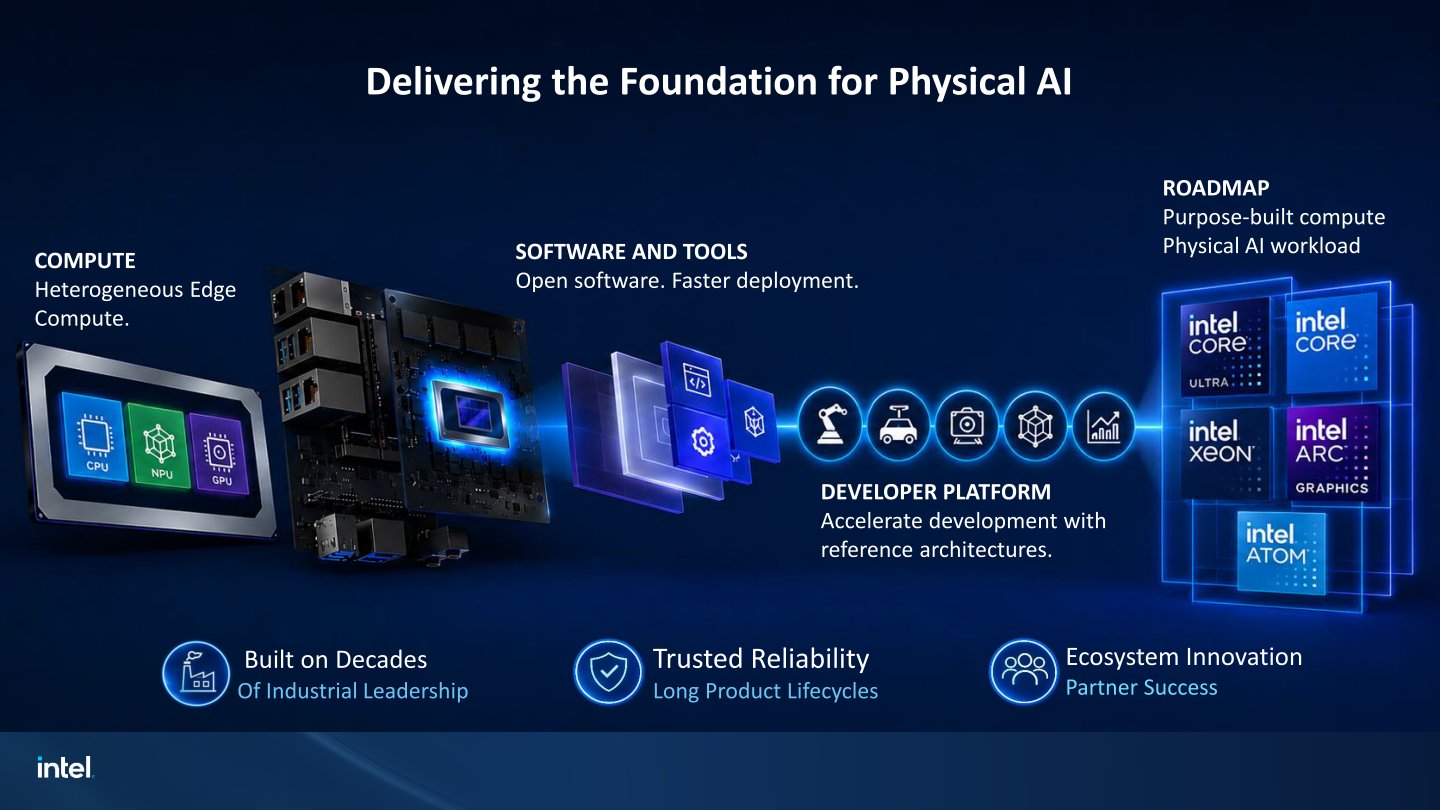
Intel具有數十年的生產資歷、長產品生命週期的可靠度、生態系統創新等優勢,提供多種運算單元與晶片滿足不同AI應用的需求。

Intel表示於2026年1月正式發表的Core Ultra系列3處理器採用最先進Intel 18A節點製程,邊緣運算專用型號通過嵌入式與工業應用認證,並提寬溫、可預測效能表現、支援24×7全天候運作的可靠性,更適合應用於工控領域。

筆者也將於下篇文章整理Intel先前說明Panther Lake、Wildcat Lake等處理器於邊緣運算與自主機器人應用的情況,請讀者參加下方目錄繼續閱讀。

Intel實體AI趨勢分析系列目錄
Intel分析從邊緣AI到實體AI策略與解決方案,推出多種運算單元滿足差異化需求(本文)
Panther Lake、Wildcat Lake發威,Intel說明Core Ultra系列3處理器搭配OpenVINO實體AI框架的邊緣運算與自主機器人優勢(工作中,預計10/1刊登)

加入T客邦Facebook粉絲團

【Arm Tech Day 2026】G2-Ultra NX GPU搭配多種神經繪圖升頻技術,在2 W功耗條件下帶來電腦級遊戲體驗

2026年9月10日 15:00
Arm隨CSS for Mobile 2運算子系統推出全新G2-Ultra NX GPU,帶來更強的繪圖與AI運算效能,並透過多種神經繪圖升頻技術提升遊戲的畫質與流暢度表現。088a12ff5d3e7ed0117b4b054121a10a

Arm隨CSS for Mobile 2運算子系統推出全新G2-Ultra NX GPU,帶來更強的繪圖與AI運算效能,並透過多種神經繪圖升頻技術提升遊戲的畫質與流暢度表現。

AI升頻讓遊戲更流暢

Arm於北京舉辦的Arm Tech Day 2026說明會中,由邊緣AI資深產品經理Deyan Lazarov介紹全新G2-Ultra NX GPU的特色,以及NSS、NFRU、NSSD等透過神經繪圖方式達成的超解析度與畫格生成升頻技術,為行動裝置帶來貼近於桌上型電腦等級的遊戲體驗。

延伸閱讀:
Arm Lumex CSS平台搭配全新C1系列處理器,4種型號隨意混搭最高14核心效能怪獸
Arm發表全新Lumex CSS平台,C1 CPU與Mali G1 GPU為旗艦級手機帶來25%效能增長
Arm發表類神經網路升頻技術,NPU嵌入GPU藉AI提升繪圖效能並節省電力

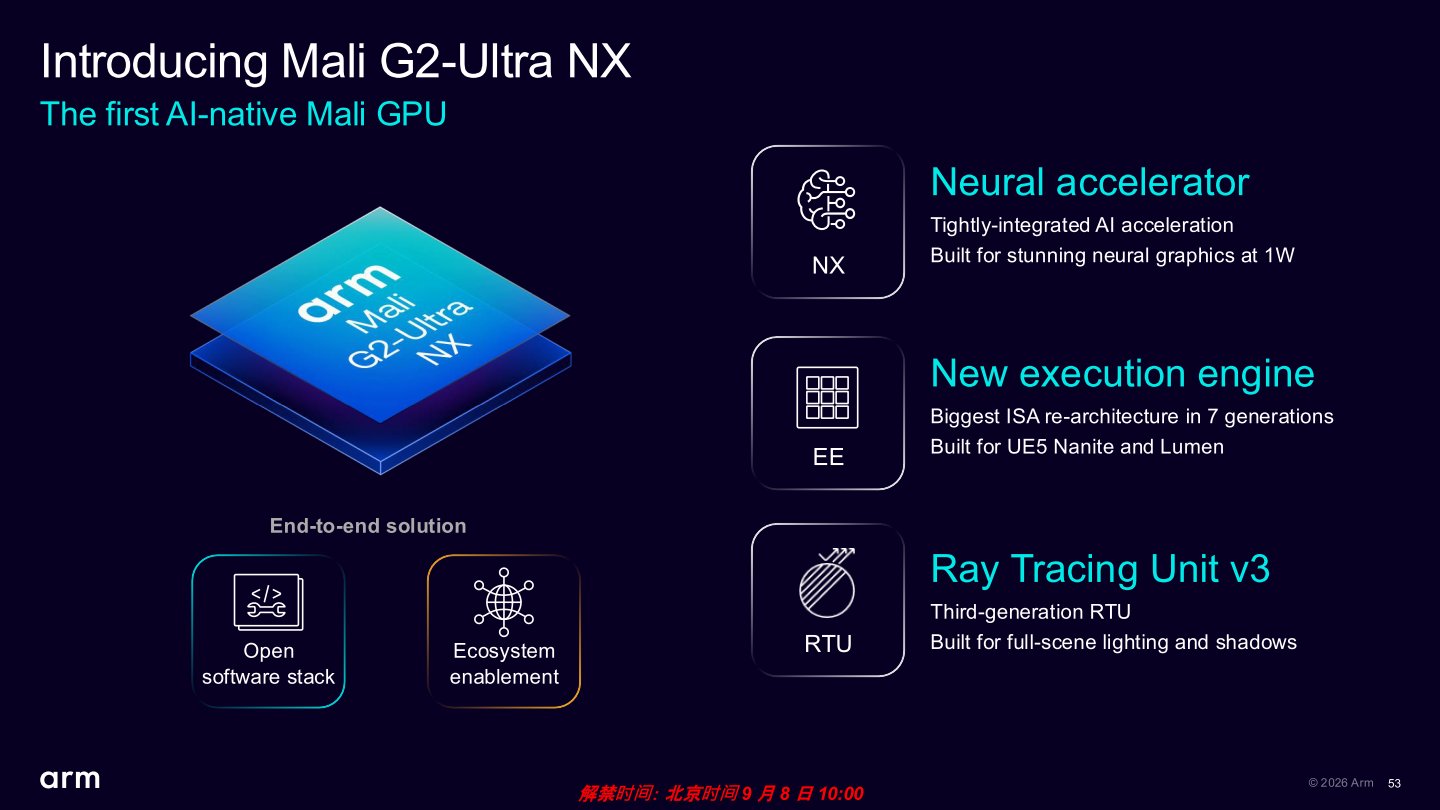
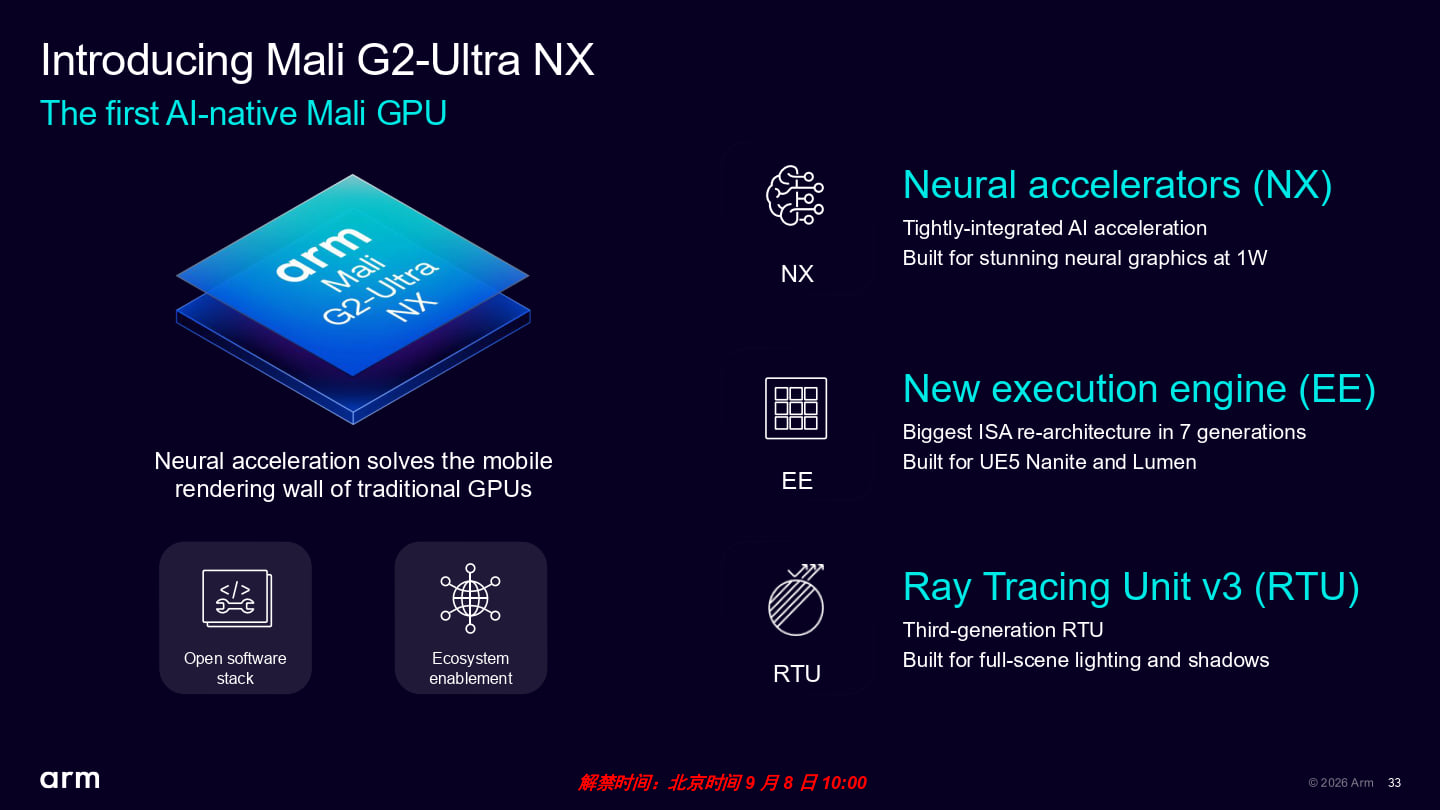
Mali G2-Ultra NX最大的特色就是在設計之初就導入AI原生繪圖的概念,除了具有效能更高的執行單元負責傳統繪圖工作,也加入第3代光線追蹤單元與神經加速器,強化光線追蹤繪圖以及透過AI進行畫面升頻的效能。

行動裝置受到電池以及散熱條件的限制,許多GPU的功率與散熱預算僅有2 W,而不像桌上型電腦顯示卡的TDP可達575 W以上,因此要如何在有線的電力下繪製遊戲畫面就成了一大挑戰。

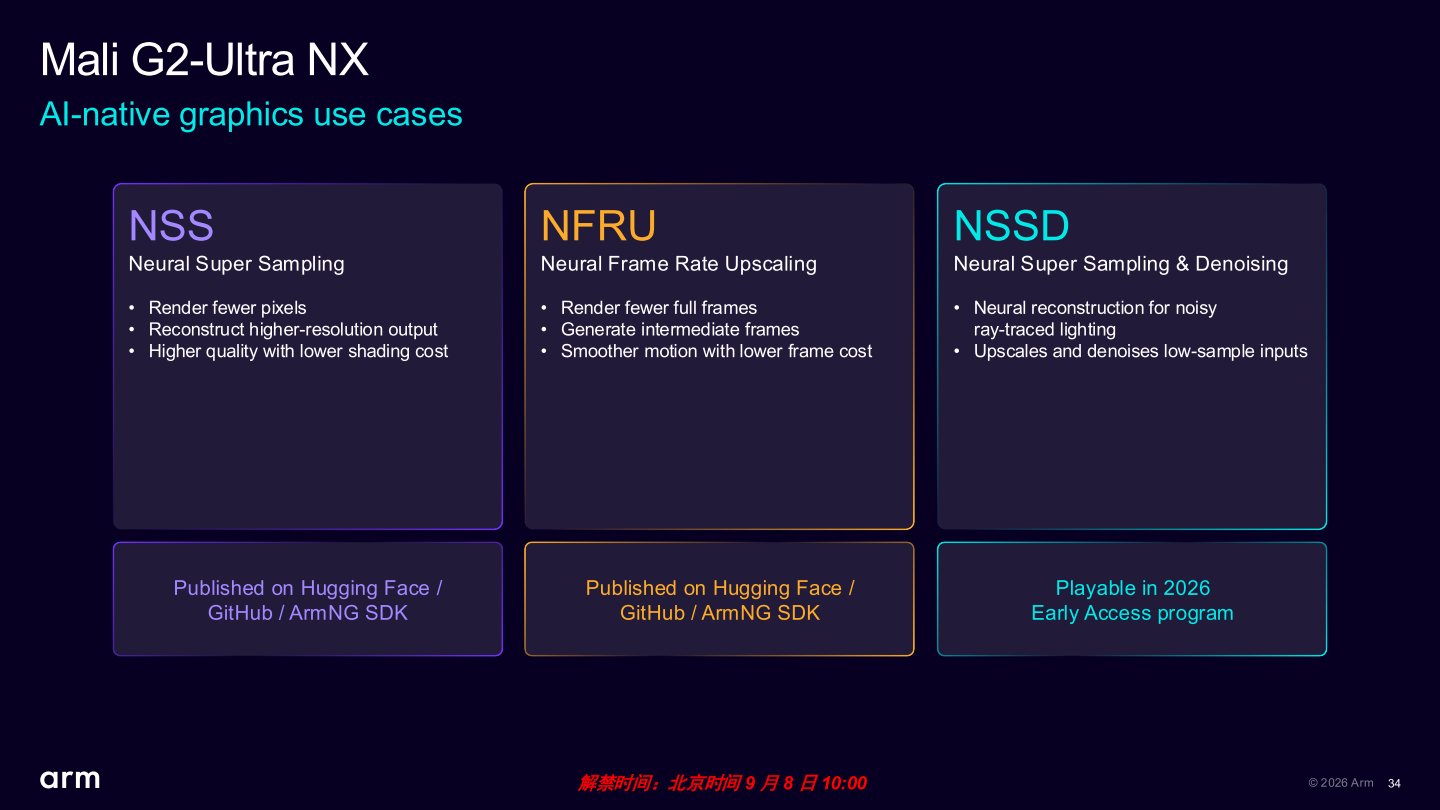
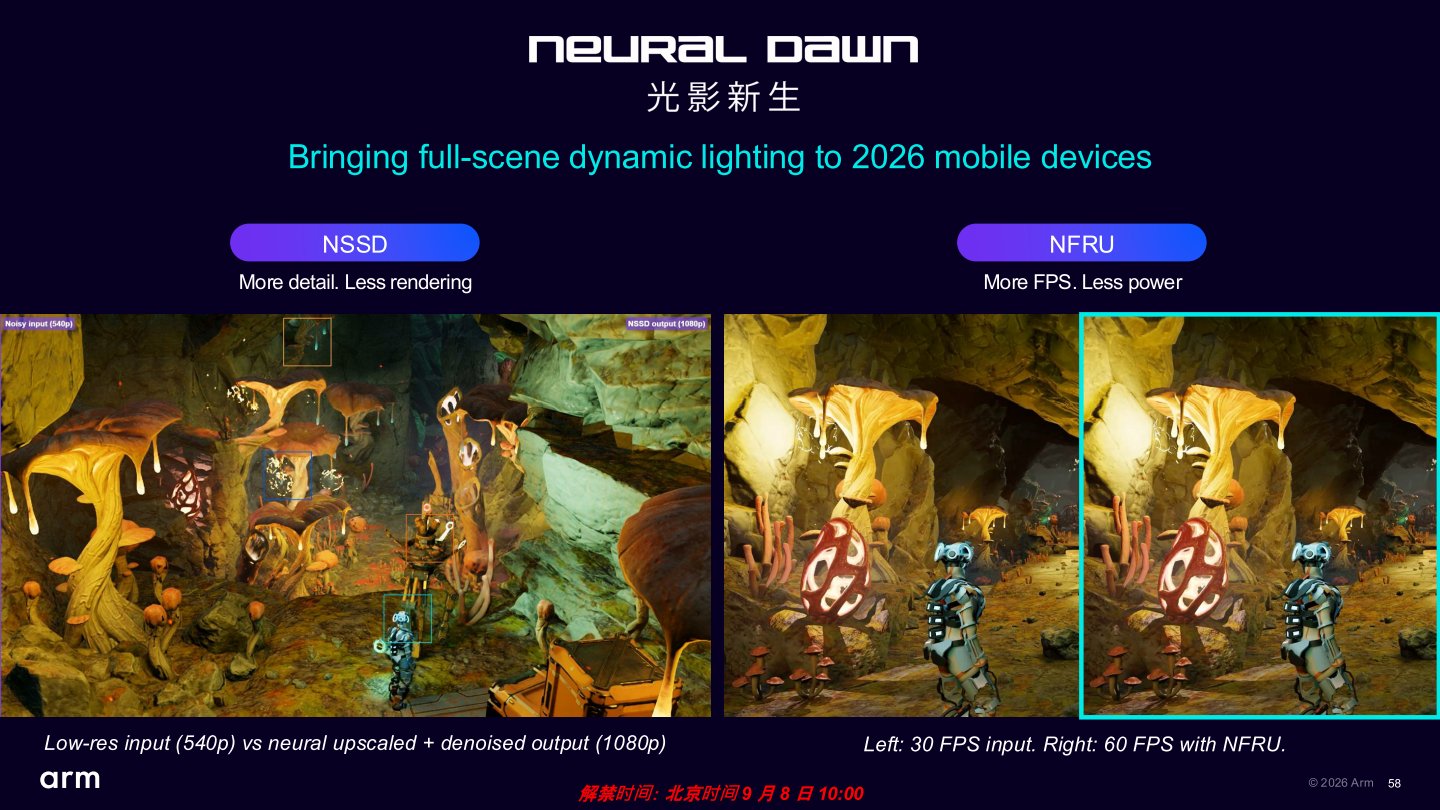
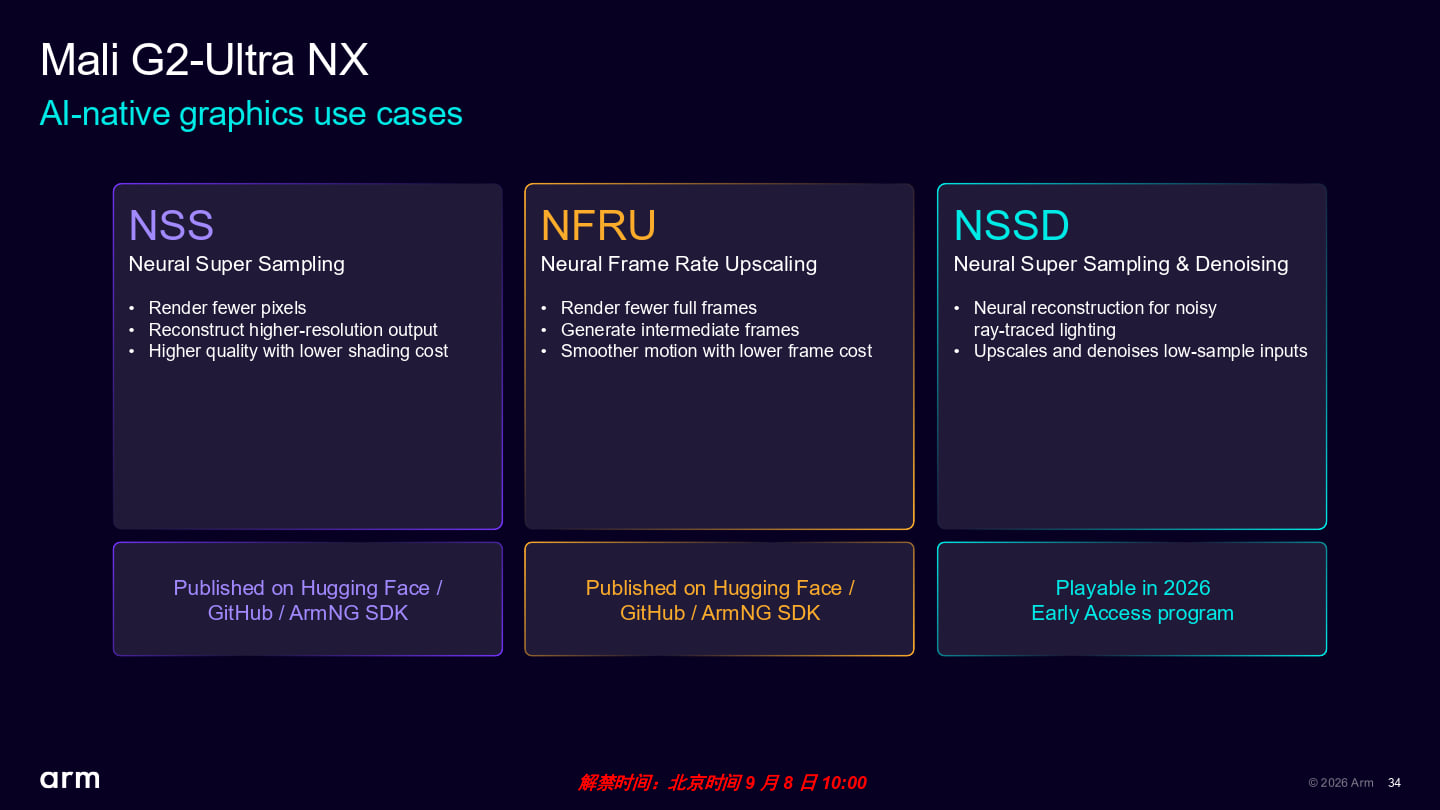
Arm先前推出NSS超解析度(Neural Super Sampling)與NFRU畫格生成(Neural Frame Rate Upscaling)等功能,前者為降低遊戲實際繪製的解析度,並在輸出至螢幕時透過AI演算法提高解析度,功能類似NVIDIA DLSS中的超解析度。後者則是透過AI演算法產生額外1幀生成畫格,對應DLSS的畫格生成等功能,不過目前僅支援2X生成畫格,未來可能會加入3X、4X等更高的生成倍率。

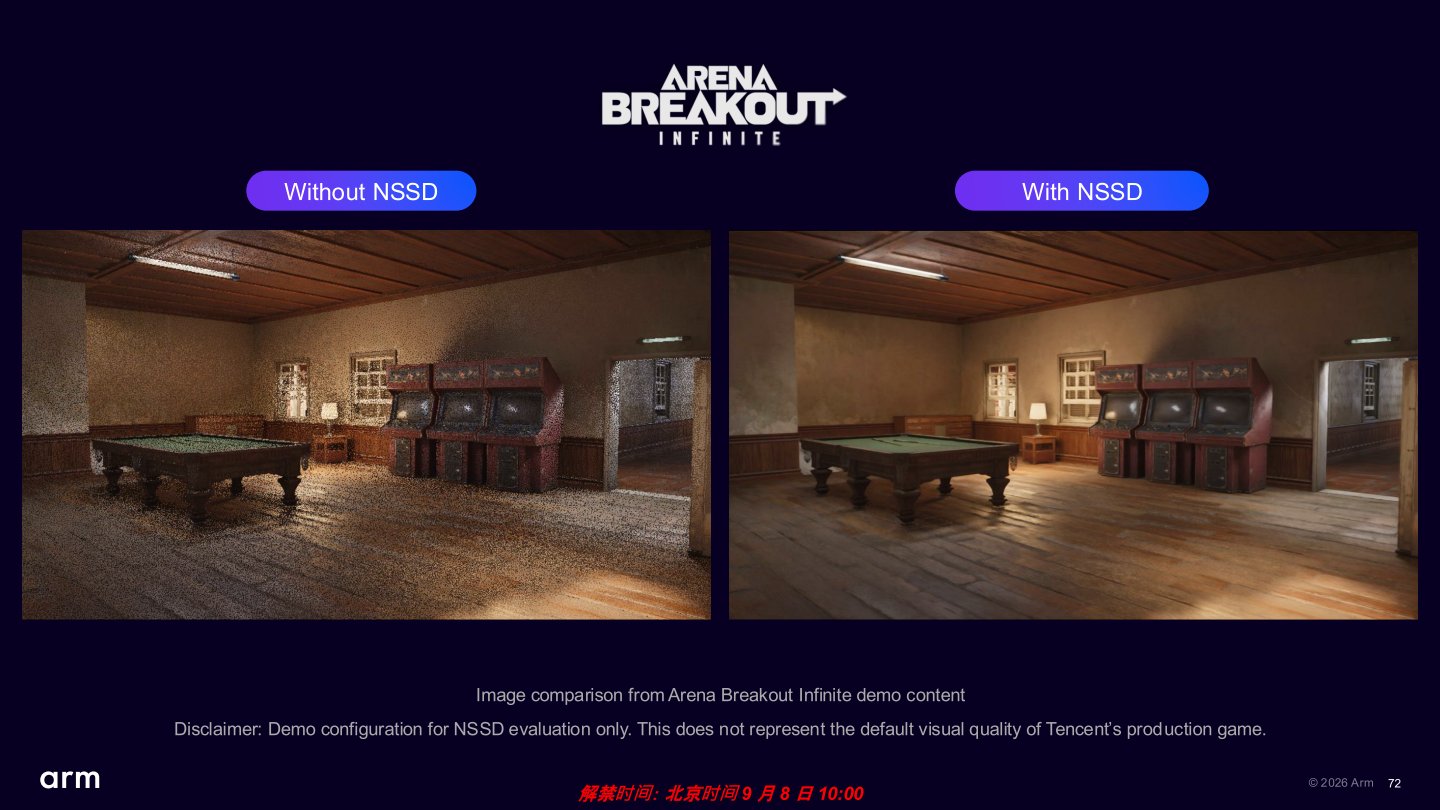
今年推出的NSSD超解析度與降噪(Neural Super Sampling and Denoising)則在NSS的基礎上,結合光線追蹤降噪技術相,能在降低投射光線數量與運算量的同時,維持複雜場景與光照效果的圖像品質,概念類似於DLSS的光線重建。

Arm也於說明會中透過《光影新生》的實際畫面,展示光線追蹤遊戲遊戲的畫質表現,讀者可以在下方影片中親自體驗。

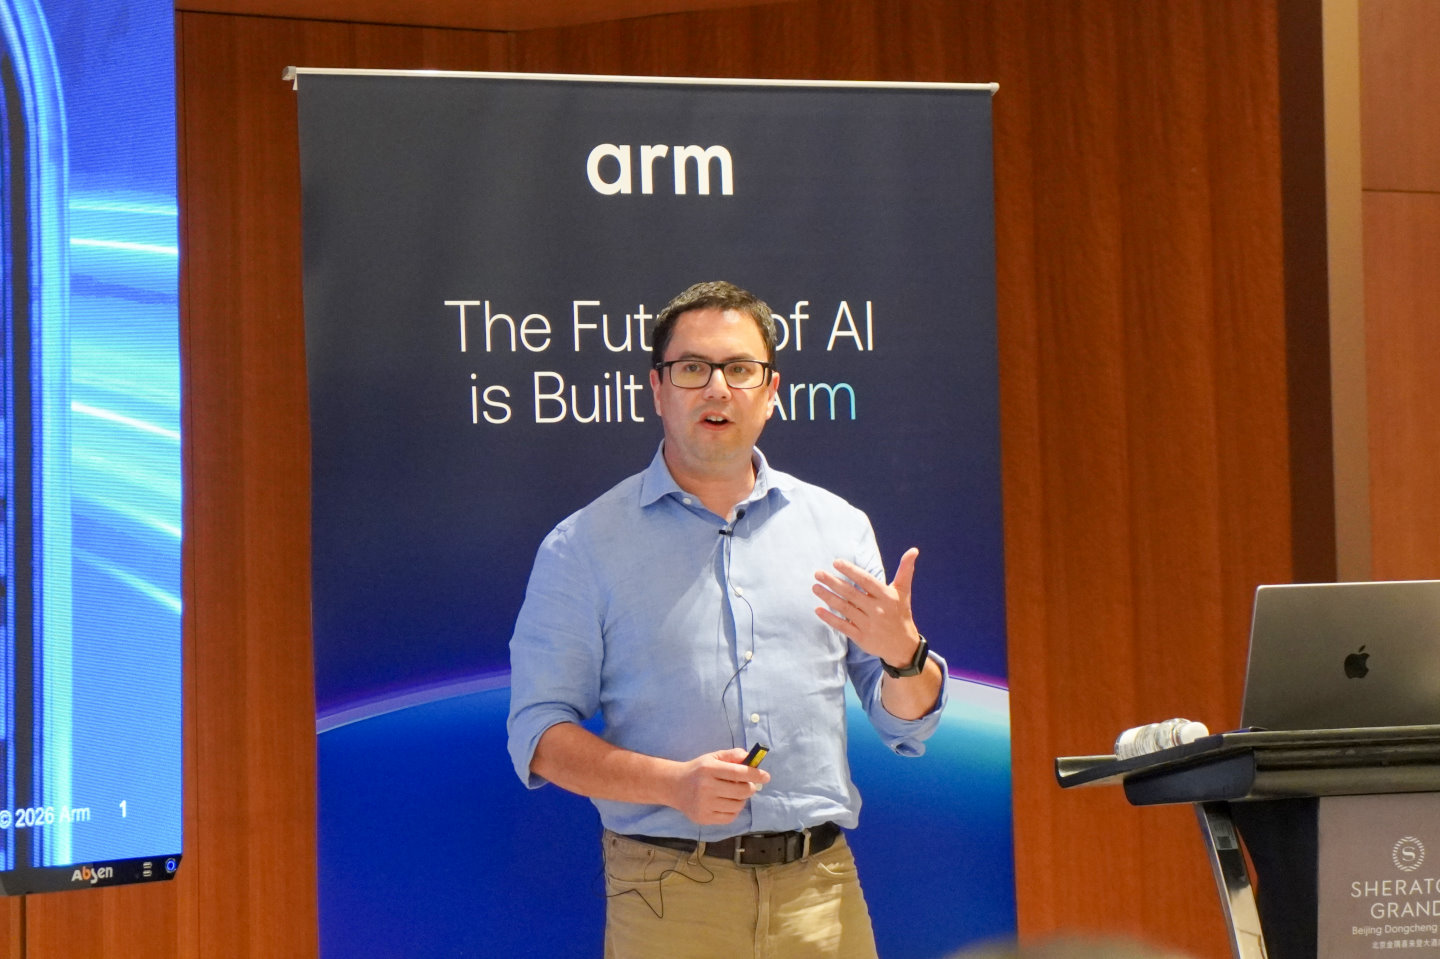
Arm邊緣AI資深產品經理Deyan Lazarov於Arm Tech Day 2026說明會介紹全新G2-Ultra NX GPU的特色。

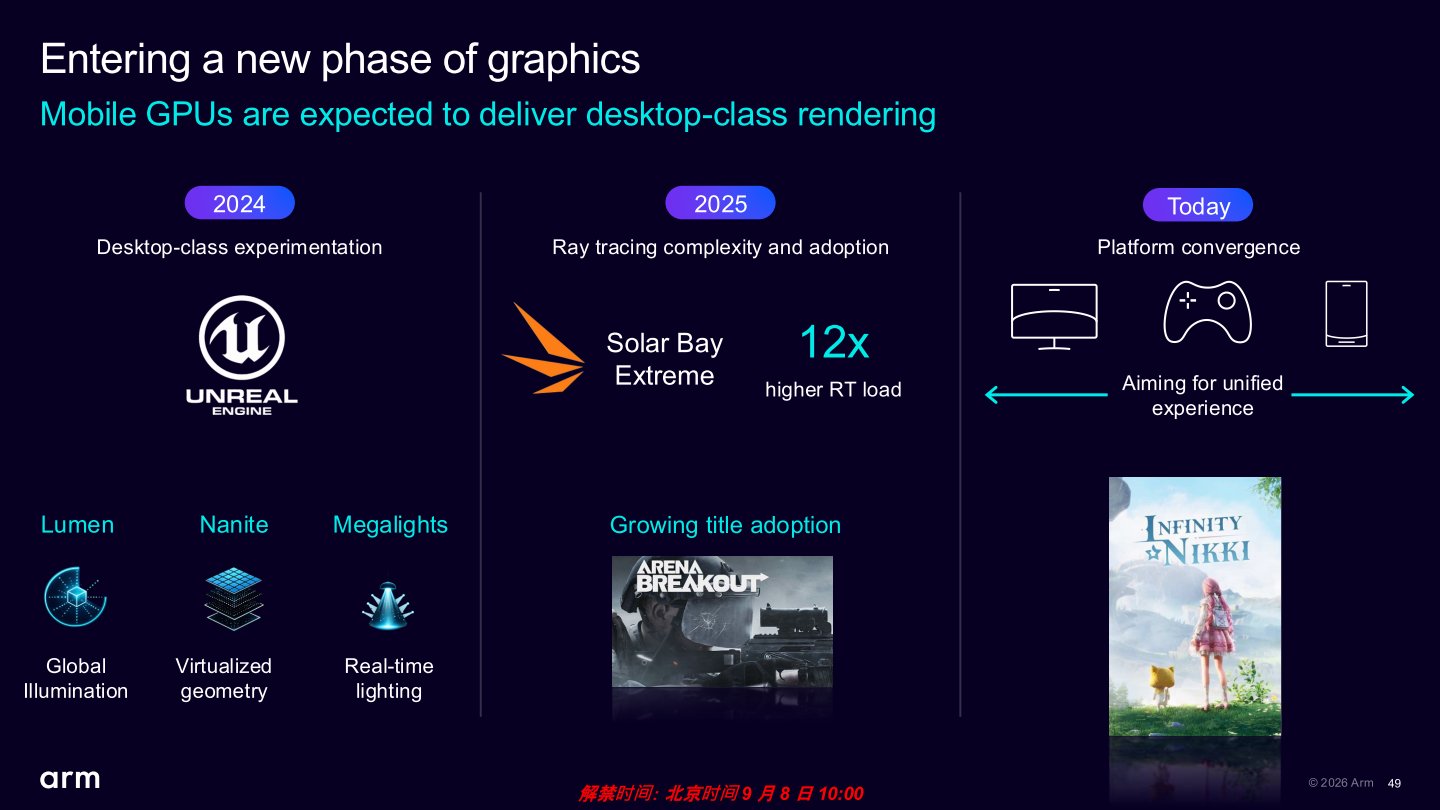
Arm觀察從2024年Unreal遊戲引擎導入Lumen全域照明、Nanite虛擬幾何體、Megalights即時光照等技術,在行動裝置帶來桌上型電腦級遊戲體驗,2025年有越來越多遊戲導入光線追蹤技術,遊戲廠商現今也開始一統電腦、遊戲主機、行動裝置的遊戲體驗。

G2-Ultra NX GPU具有全新執行單元、第3代光線追蹤單元、專為在1 W功耗條件下運作的神經加速器,並具有開放的軟體堆疊並賦能生態系。

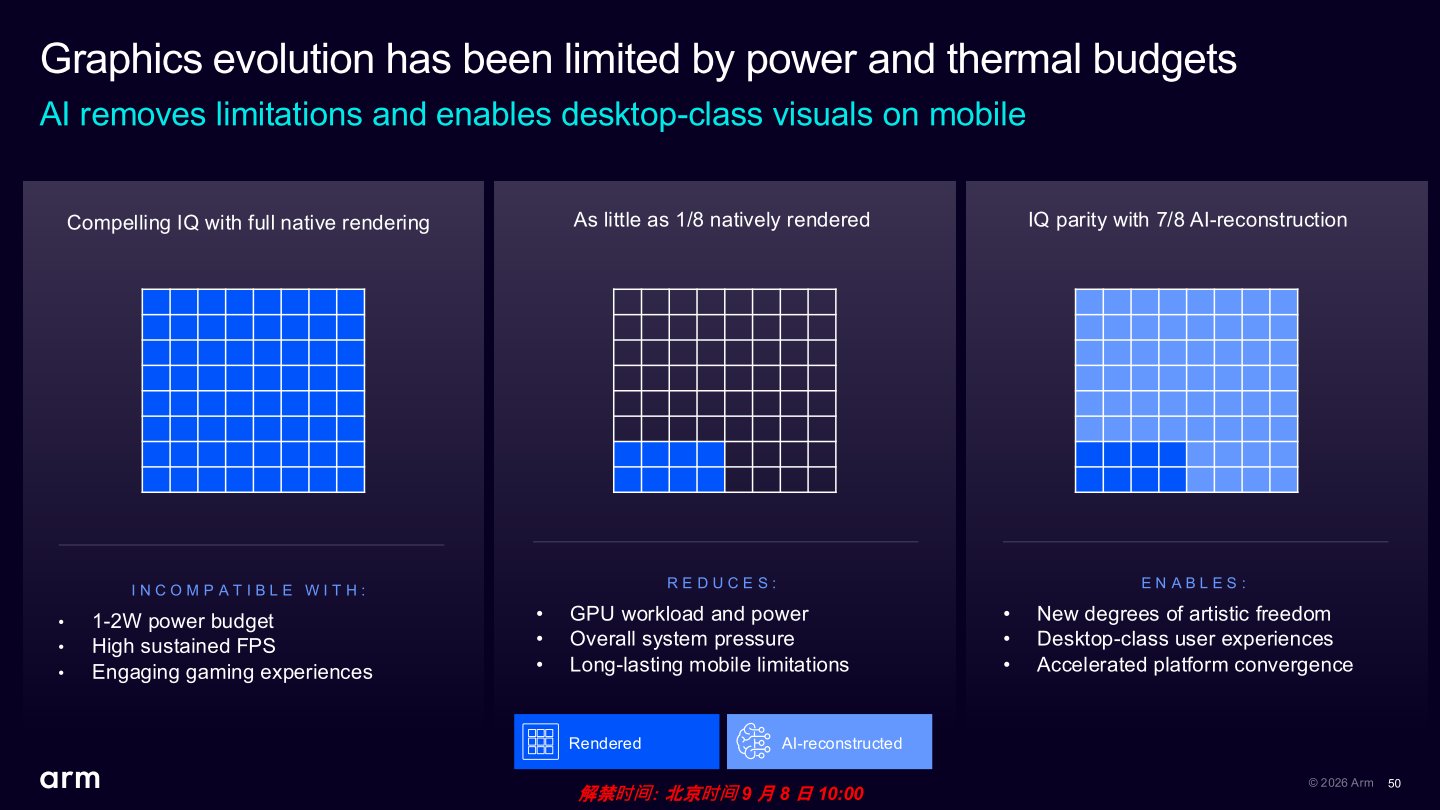
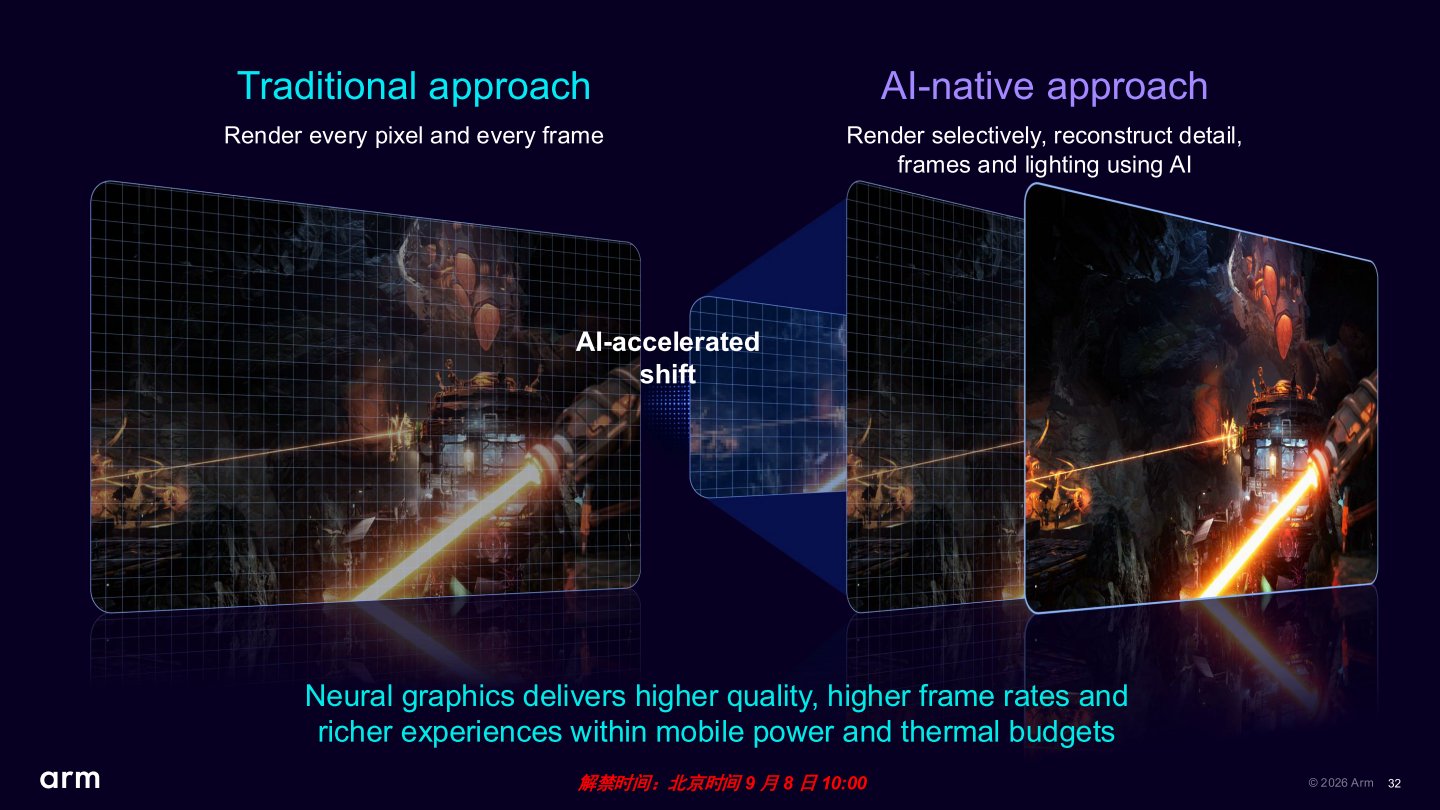
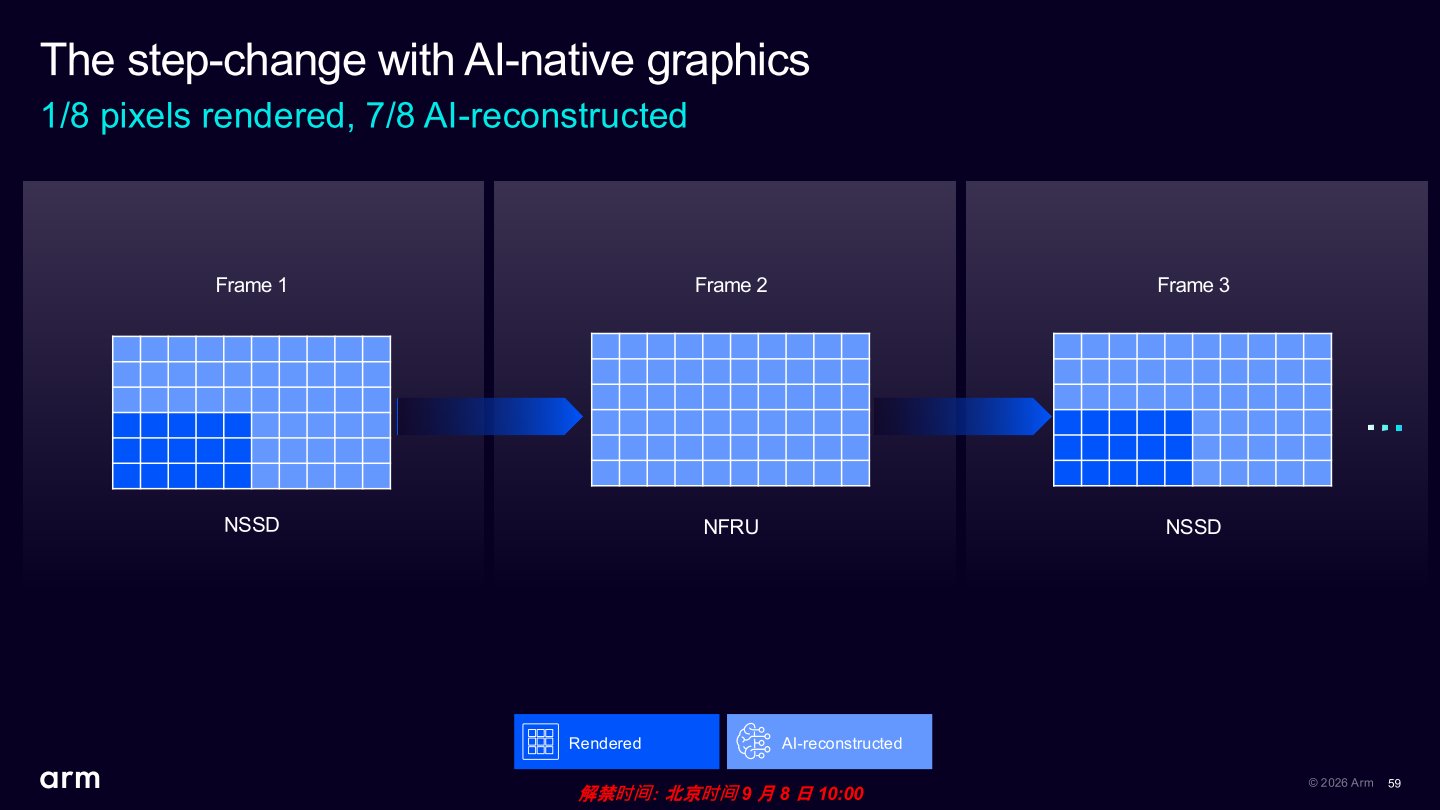
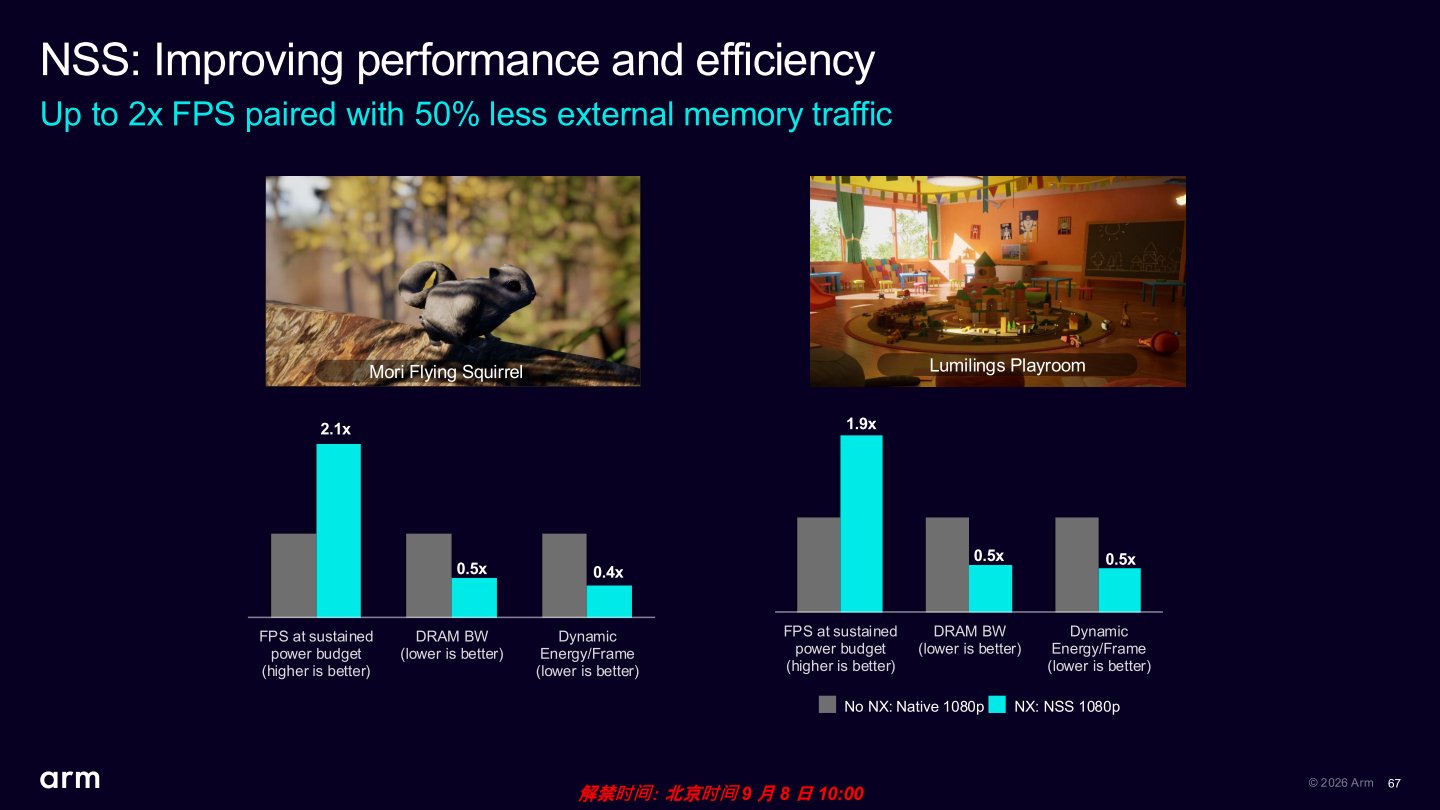
為了要在1~2 W的電力預算中提供穩定高FPS的流暢遊戲體驗,G2-Ultra NX GPU透過超解析度(4倍放大)與畫格生成(2X)等方式,將渲染畫面的實際運算量降低至1/8。

Arm先前推出NSS、NFRU等超解析度、畫格生成等功能,今年將推出強化光線追蹤升頻畫質的NSSD超解析度。

AI原生繪圖的概念是將繪圖資源花在刀口上,繪製最關鍵的圖像資訊,並透過升頻的方式重新構築畫質更高的遊戲畫面。

將上述流程的工作量以圖型方式呈現。GPU僅需實際渲染1/4解析度的資訊(Frame 1左下角的深藍色部分),然後透過NSSD超解析度放大至完整解析度(Frame 1淺藍色部分),之後再透過NFRU畫格生成產生下一個畫格(Frame 2淺藍色部分)。如此週而復始就能達到將實際渲染運算量減少至1/8,其於7/8的畫面都是透過AI由神經繪圖方式生成。

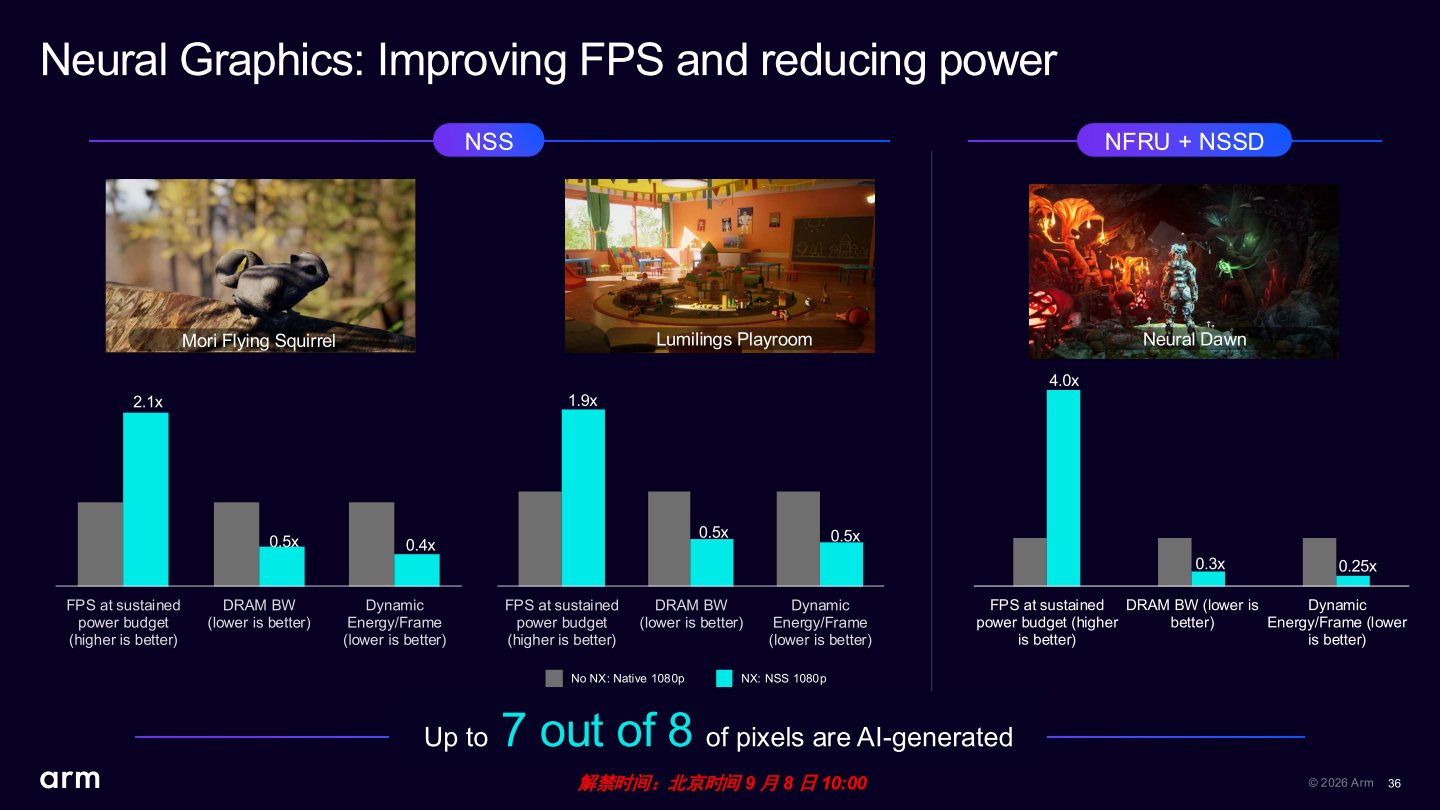
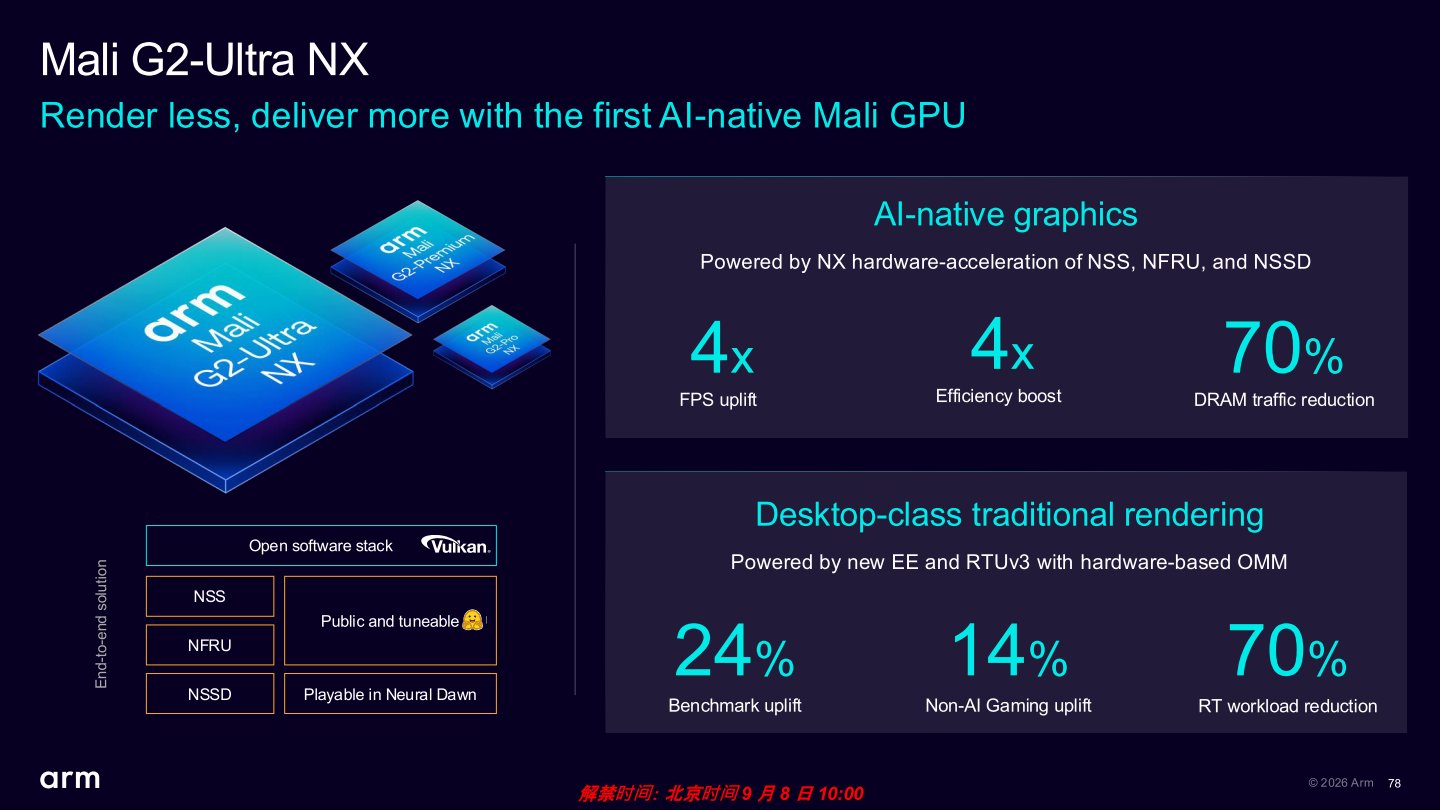
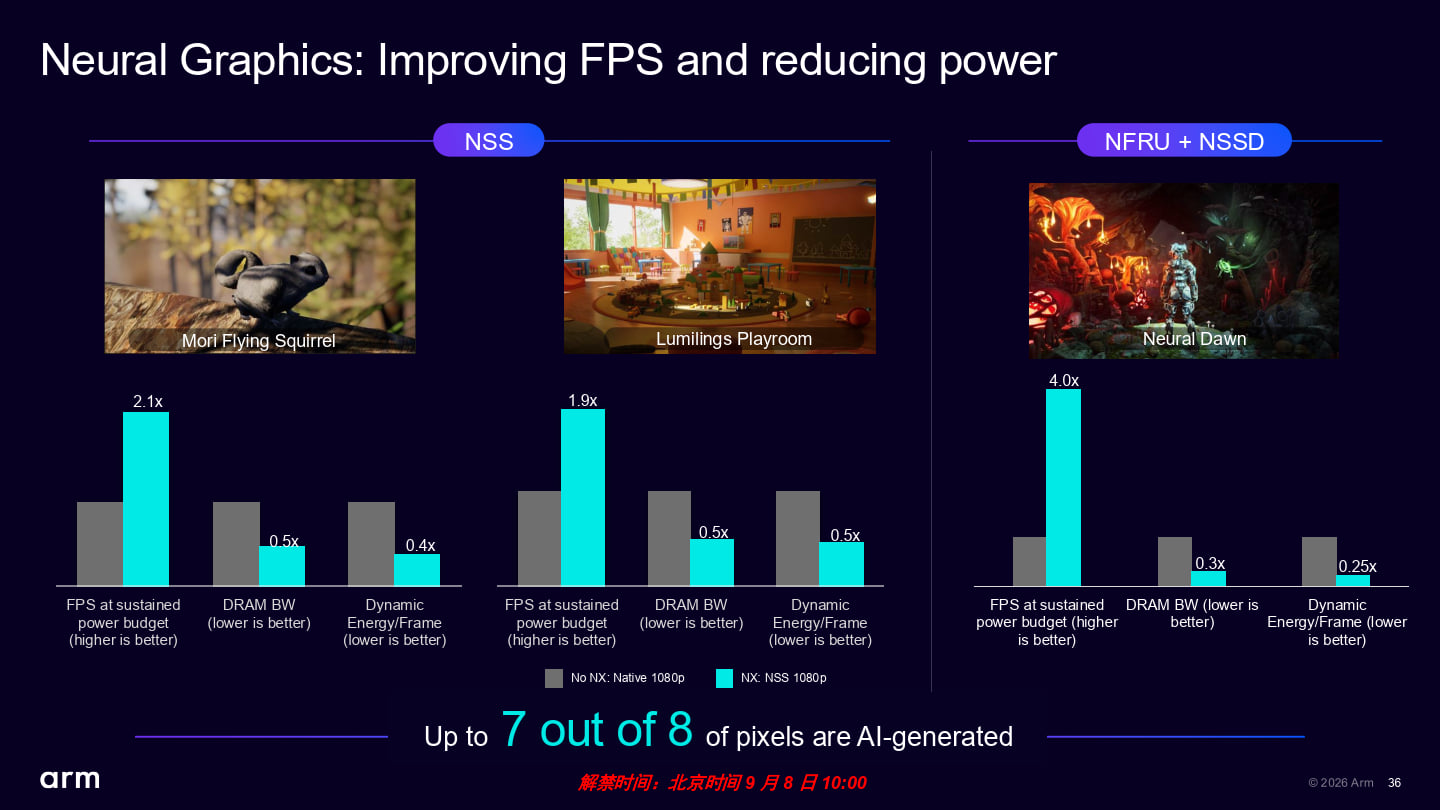
NSS大約可讓FPS效能達到2倍,並節省50%記憶體資料流量,NSSD搭配NFRU則可帶來4倍FPS效能,節省記憶體資料流量高達75%。

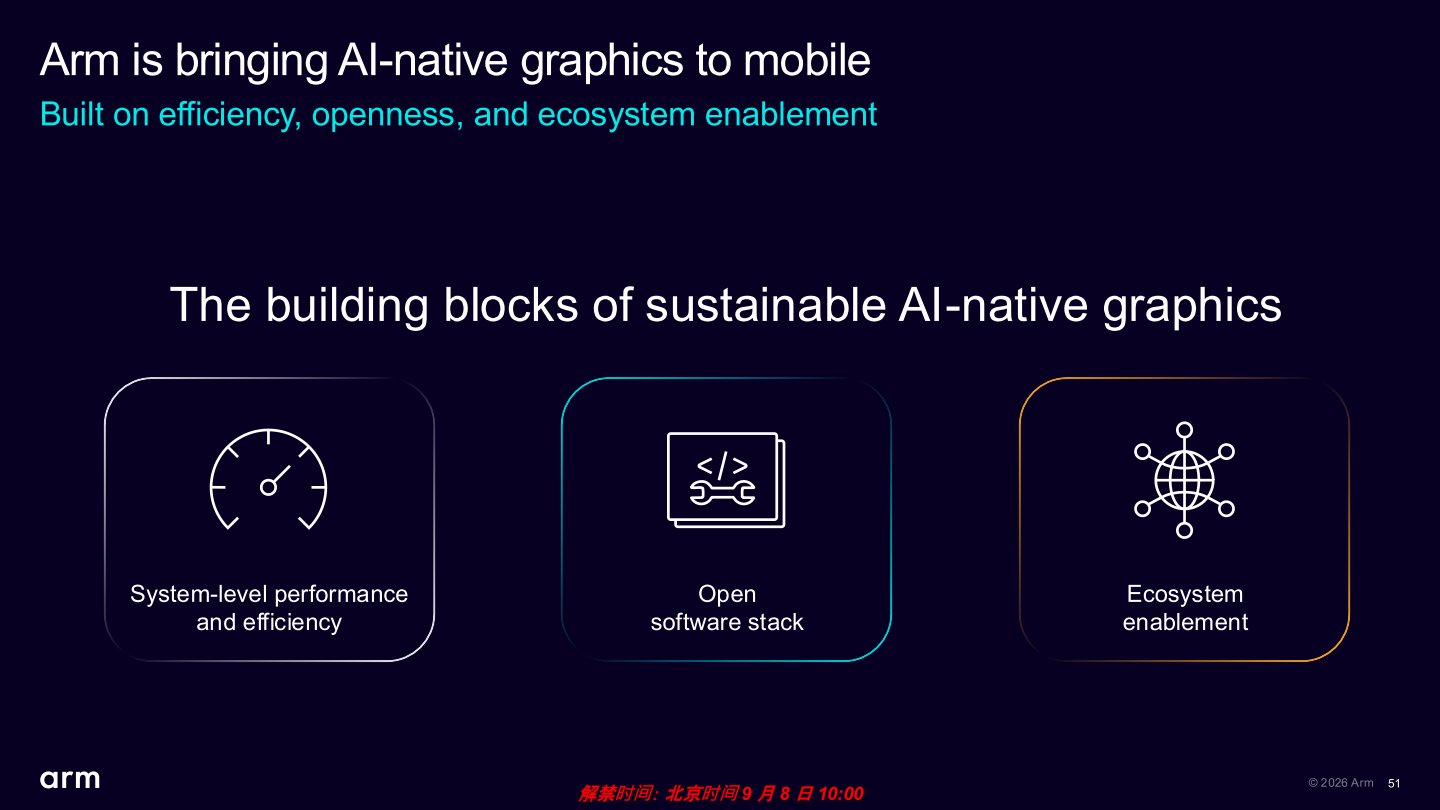
Arm藉由系統級效能與電力效率改善、開放軟體堆疊、賦能生態系等方式,協助打造持續性AI原生繪圖的效能體驗。

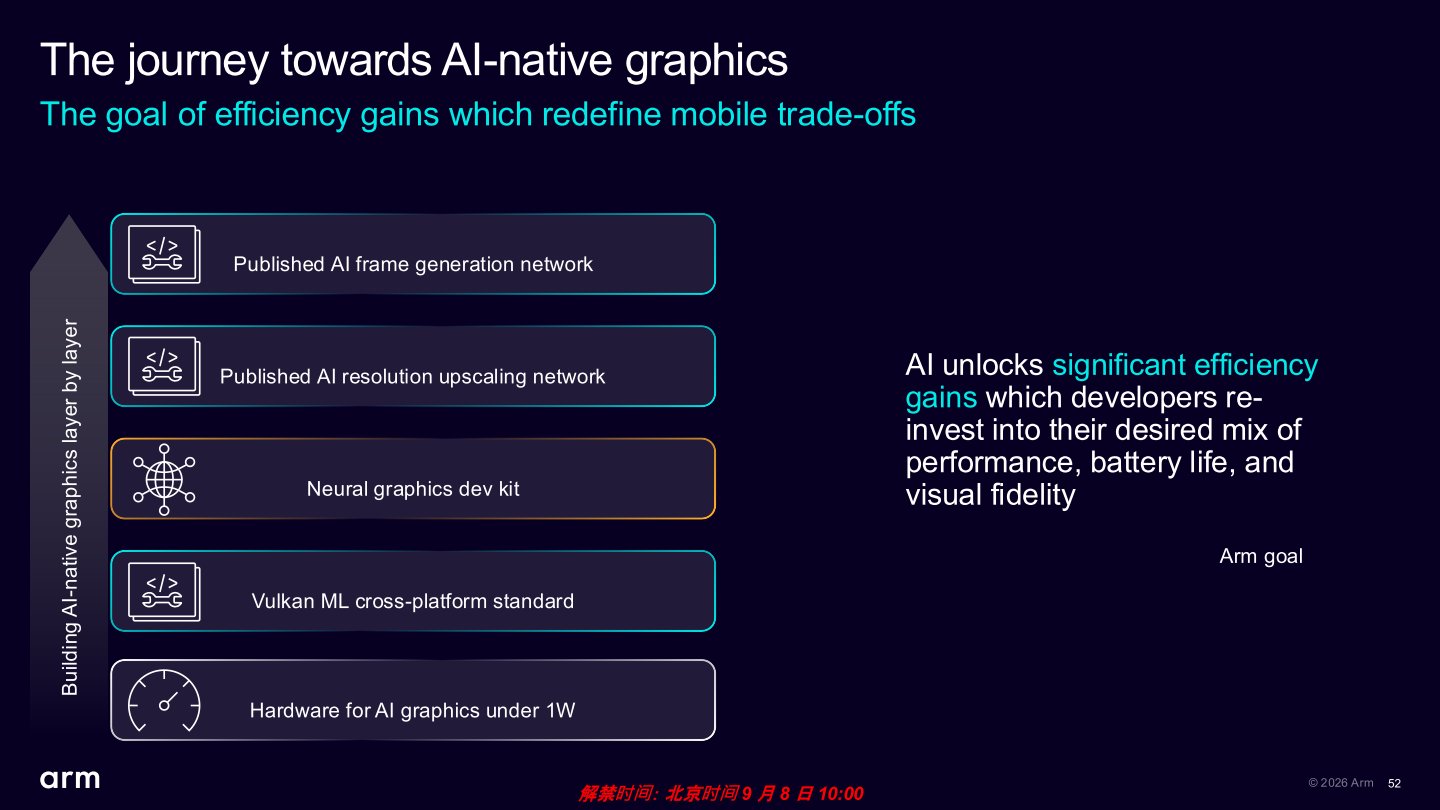
Arm透過消耗1 W以下電力的AI繪圖、跨平台Vulkan ML機器學習API、神經繪圖開發工具、AI超解析度、AI畫格生成的層層架構的技術,達成顯著的電力效率提升,提供遊戲開發者所期望效能、電持續航力、圖像品質等要素的平衡。

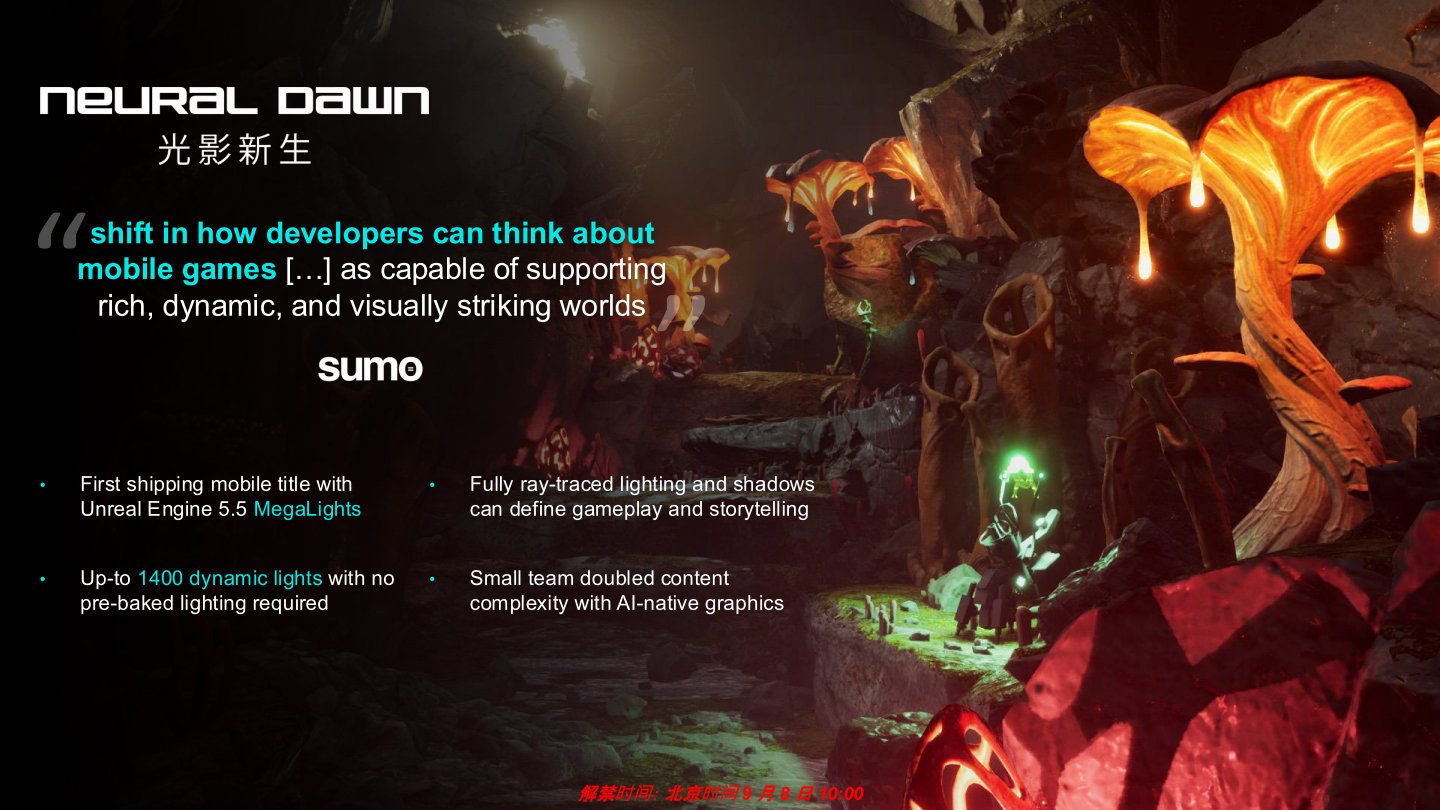
▲光影新生導入是首款導入Arm神經繪圖以及Unreal引擎導入Megalights即時光照技術的手機遊戲。

光影新生支援光線追蹤照明與陰影,最高能夠顯示1400組動態光源。即便遊戲圖像相當複雜,但是在完善開發工具的協助下,20人的團隊從構想到完成遊戲的完整開發流程僅花費18個月。遊戲預計於2026年上市。

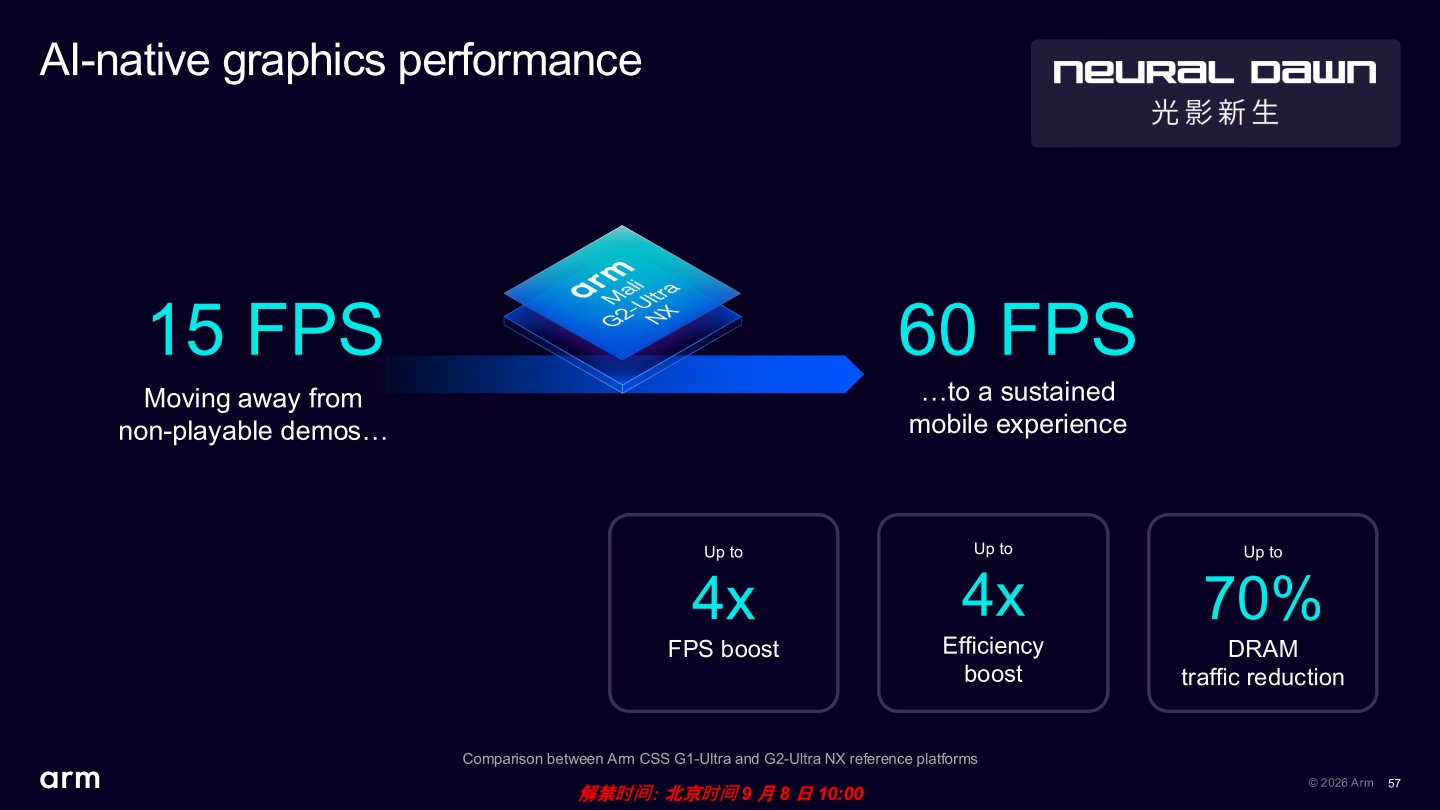
在神經繪圖技術的協助下,光影新生能夠穩定運作於FPS 60幀,達到4倍效能與4倍電力效率提升,並節省70%記憶體資料流量。

光影新生使用NSSD超解析度功能將540p解析度的實際渲染畫面放大至1080p,並透過NFRU畫格生成功能達到產生額外畫格。

(下頁還有更多繪圖技術與效能數據說明)


多種技術強化手機遊戲體驗

Arm表示GPU的峰值效能只能反映行動裝置上的部分體驗,然而持續效能才能來長時間遊戲過程中穩定的畫面表現,因此除了GPU的「輸出馬力」之外,較佳的電力效率代表GPU能夠在固定的散熱和功耗限制下,帶來穩定、流暢且長電池續航力的在更長時間的遊戲體驗。Mali G2-Ultra NX除了導入神經繪圖架構之外,也透過全新的執行引擎與多項技術應對日益複雜的繪圖運算負載,以改善持續效能表現。

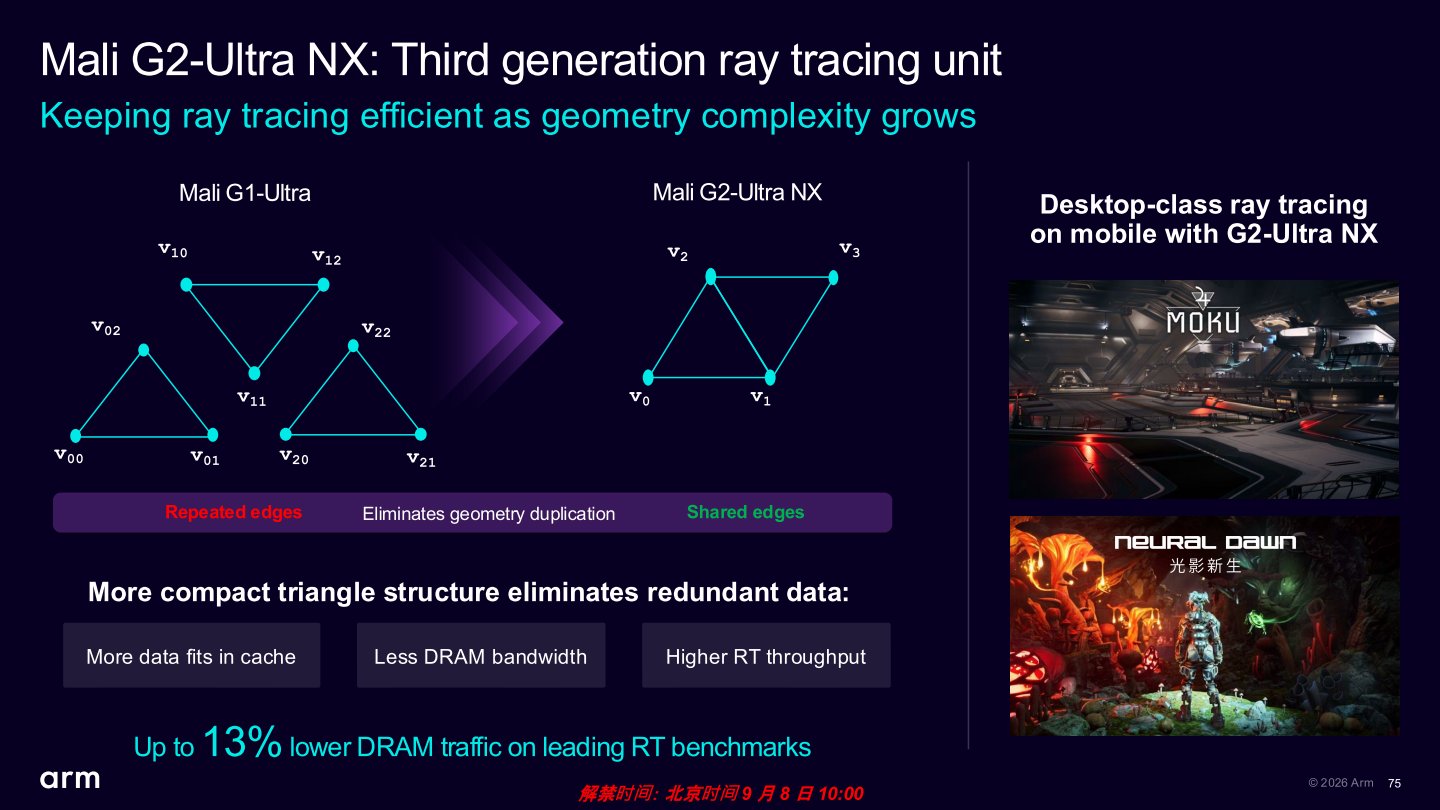
第3代光線追蹤單元支援更複雜的光照、陰影、反射和幾何效果,並透過共用多邊型邊緣繪圖技術降低資料容量,能在主流光線追蹤基準測試中節省13%的記憶體流量,緩解遊戲在複雜場景中的記憶體瓶頸。

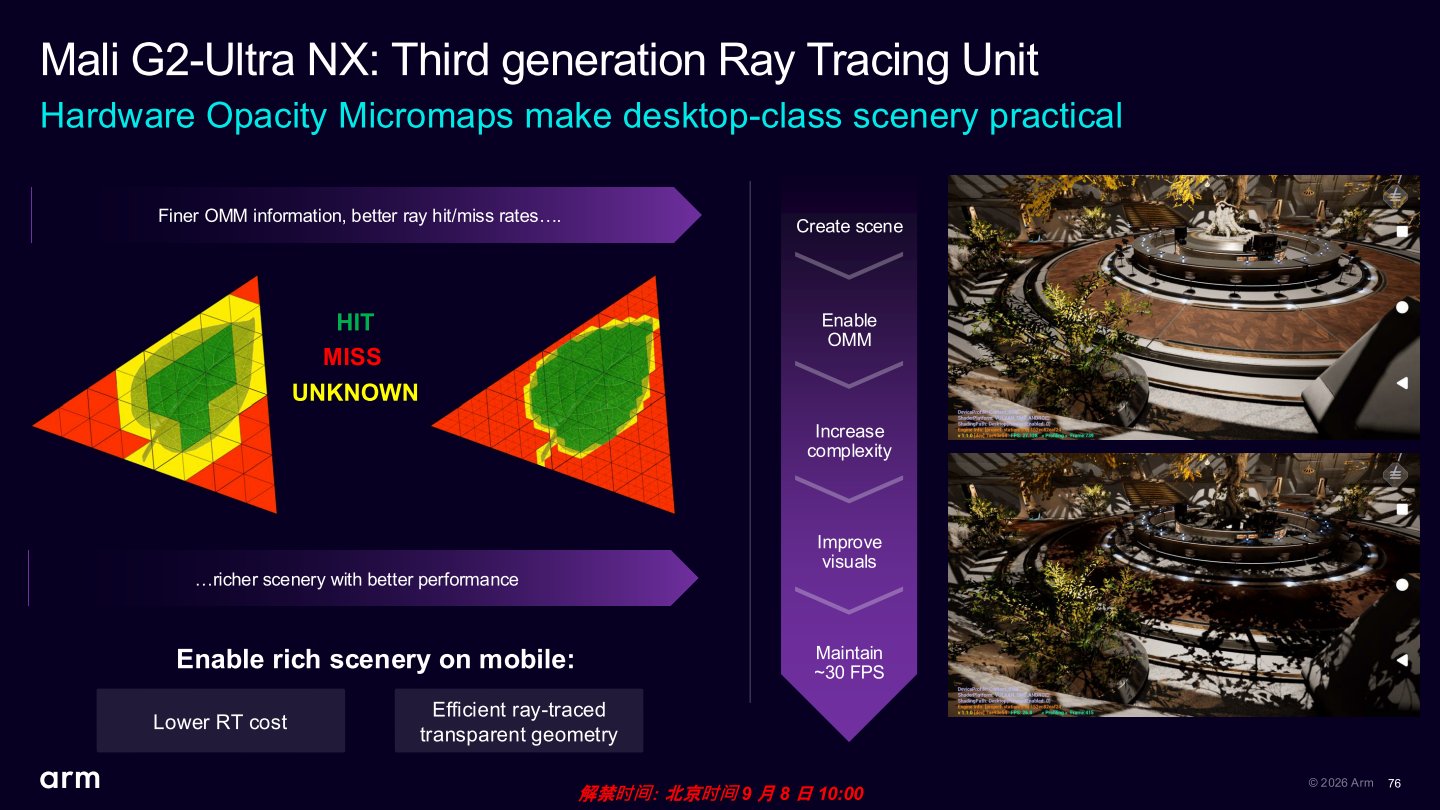
此外它也以硬體方式支援透明度微貼圖(Opacity Micromaps,OMM),能夠提高運算複雜透明幾何物件與光線接觸的效率,帶來30%的FPS效能提升,同時最多降低70%光線追蹤工作負載,進而能夠提供在行動裝置呈現更加豐富的植被、更精細的布料紋理、多層材質表面等複雜場景的能力。

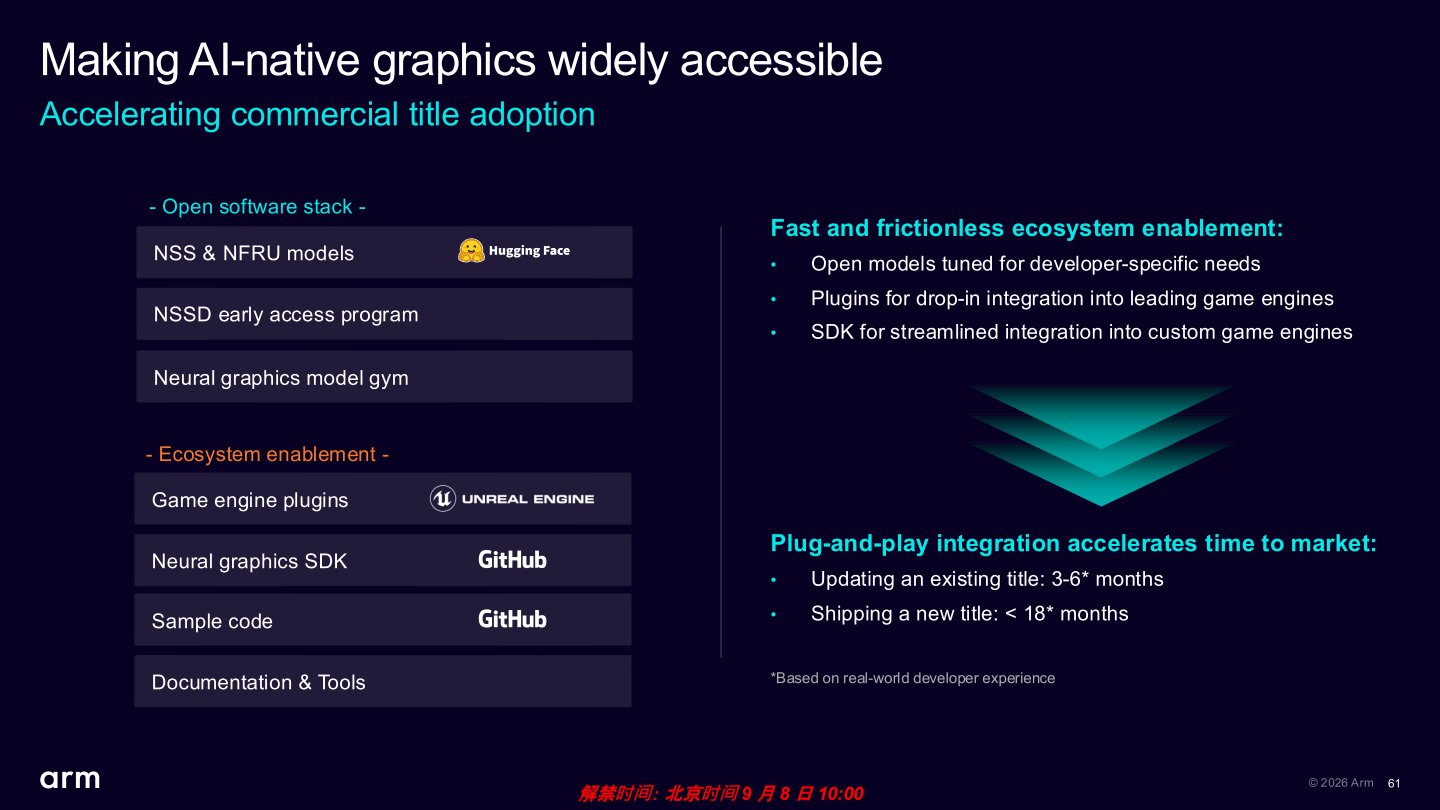
另一個值得注意的重點,是Arm以開源型式提供NSS、NFRU模型以及NSSD的早期預覽版(Early Access)程式,讓遊戲開發者可以針對遊戲的圖像呈現、畫面風格(如擬真或卡通風格)、對應裝置效能等級等等差異進行模型微調或再訓練,給予開發者更大的創作空間。

Arm提供開放的NSS、NFRU模型以及NSSD的早期預覽版(Early Access)程式,開發者可以在Unreal引擎中使用這些功能,或是從GitHub下載相關資源。根據實際開發者回報,大約3~6個月可完成現有遊戲升級光線追蹤,開發全新遊戲也可將開發時程壓縮至18個月以內。

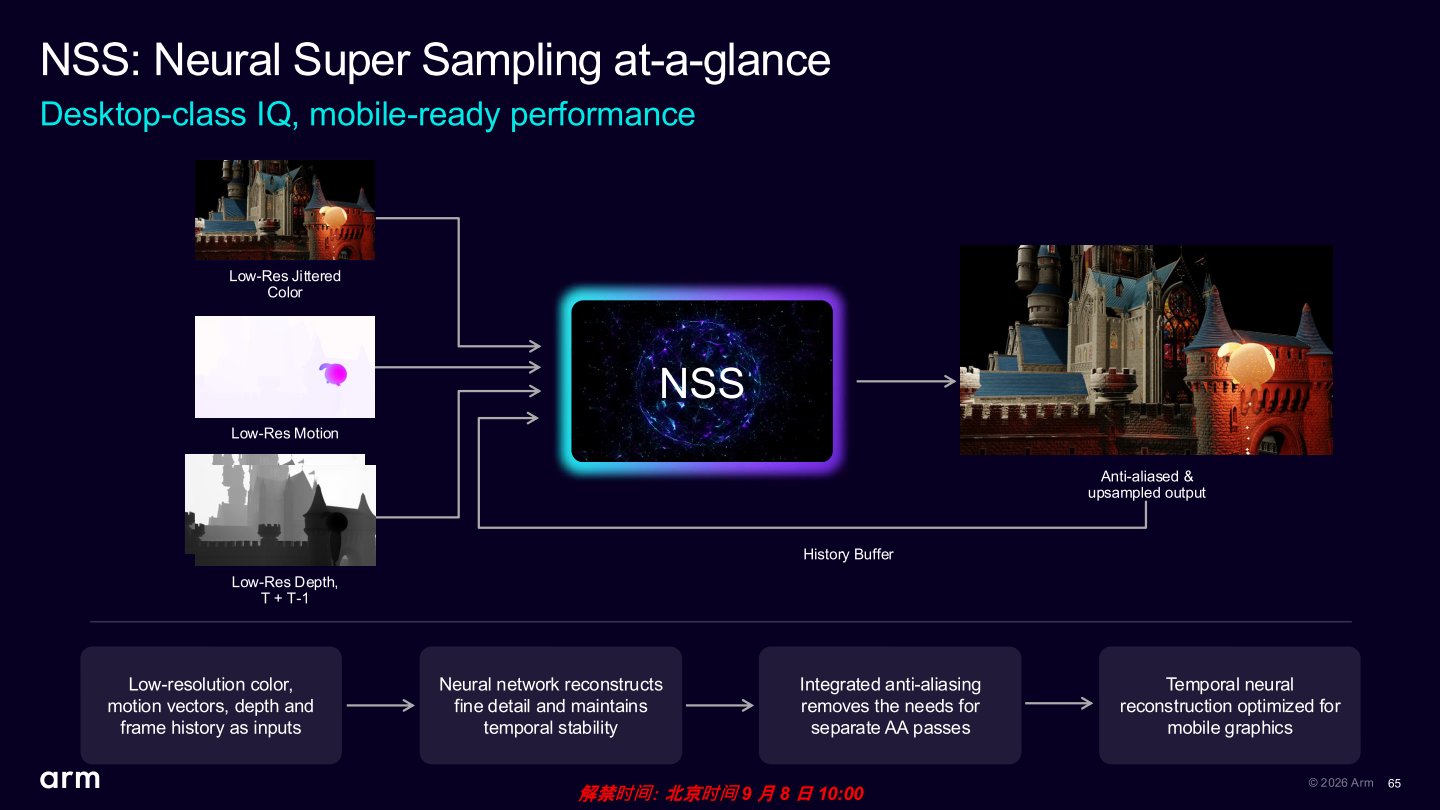
NSS超解析度功能透過降低解析度的實際渲染畫格,以及動態向量、深度圖等資訊,以AI推論方式產生高解析度圖像。

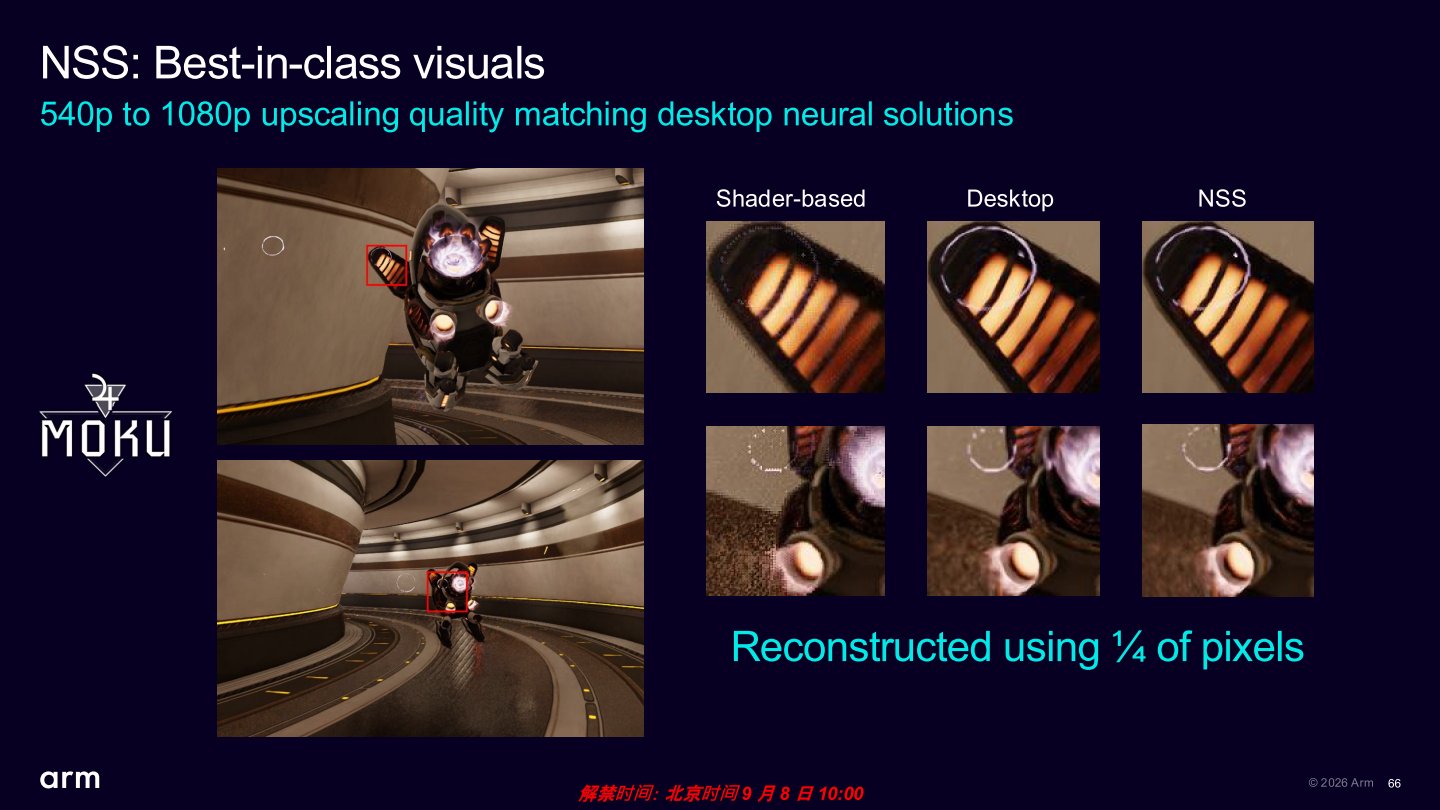
透過NSS升頻的圖像,畫質可以媲美桌上型電腦的表現。

NSS大約可以帶來100% FPS效能提升,並節省50%記憶體資料流量。

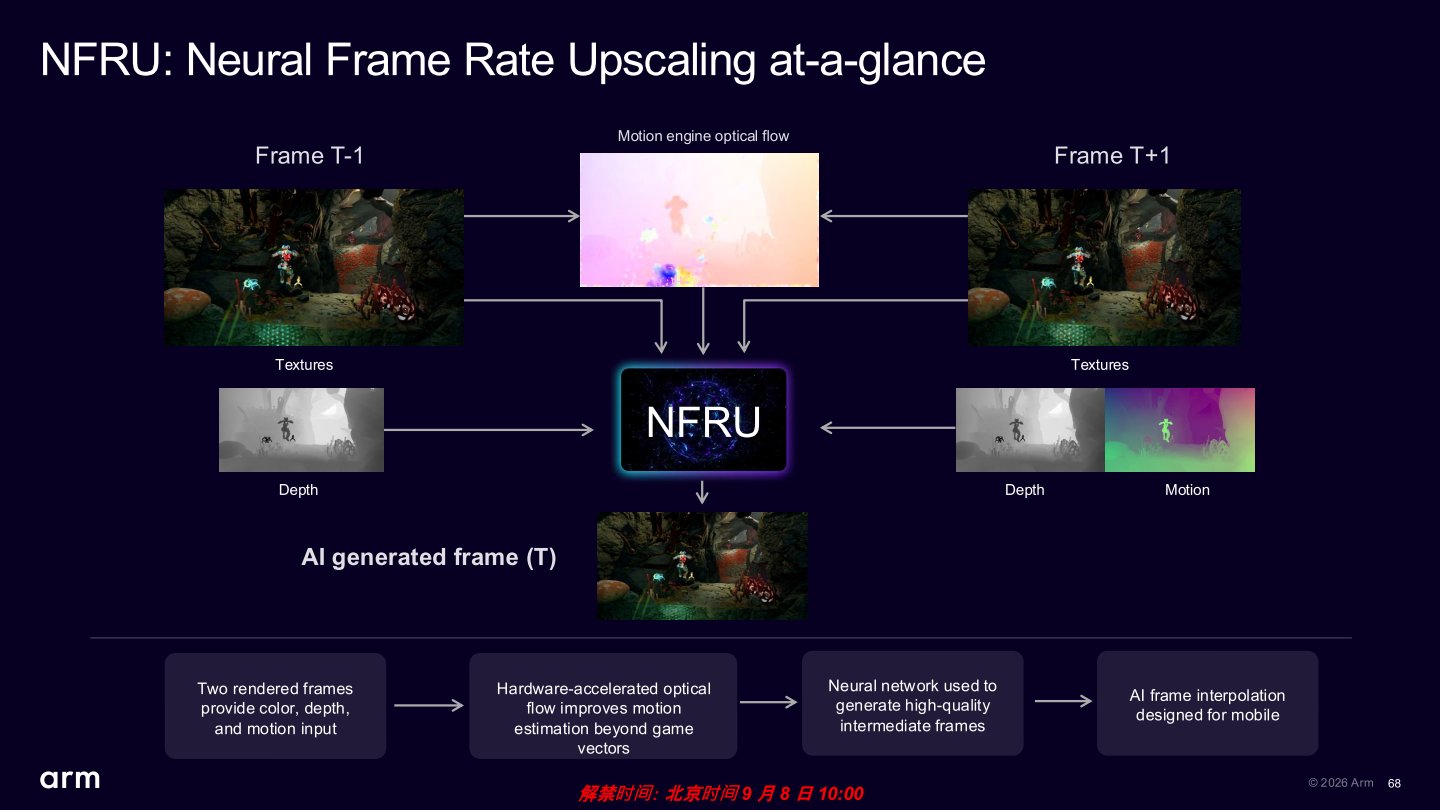
NFRU畫格生成功能則是將前後畫格的材質、深度圖、動態向量以及遊戲引擎提供的光流(Optical Flow)資訊輸入AI模型,以推論方式產生中間畫格。

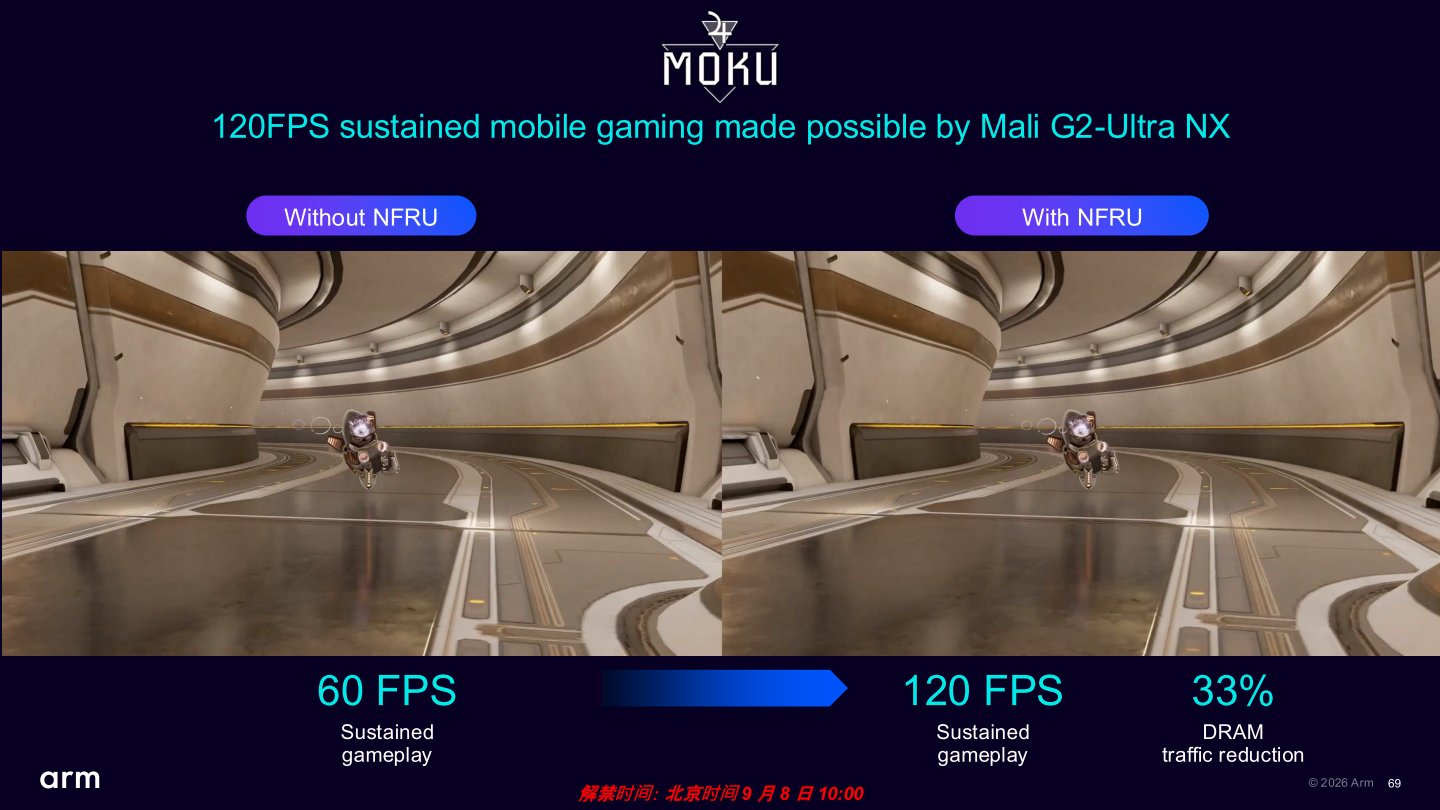
NFRU能夠在帶來2倍的FPS效能的同時,降低33%記憶體資料流量。

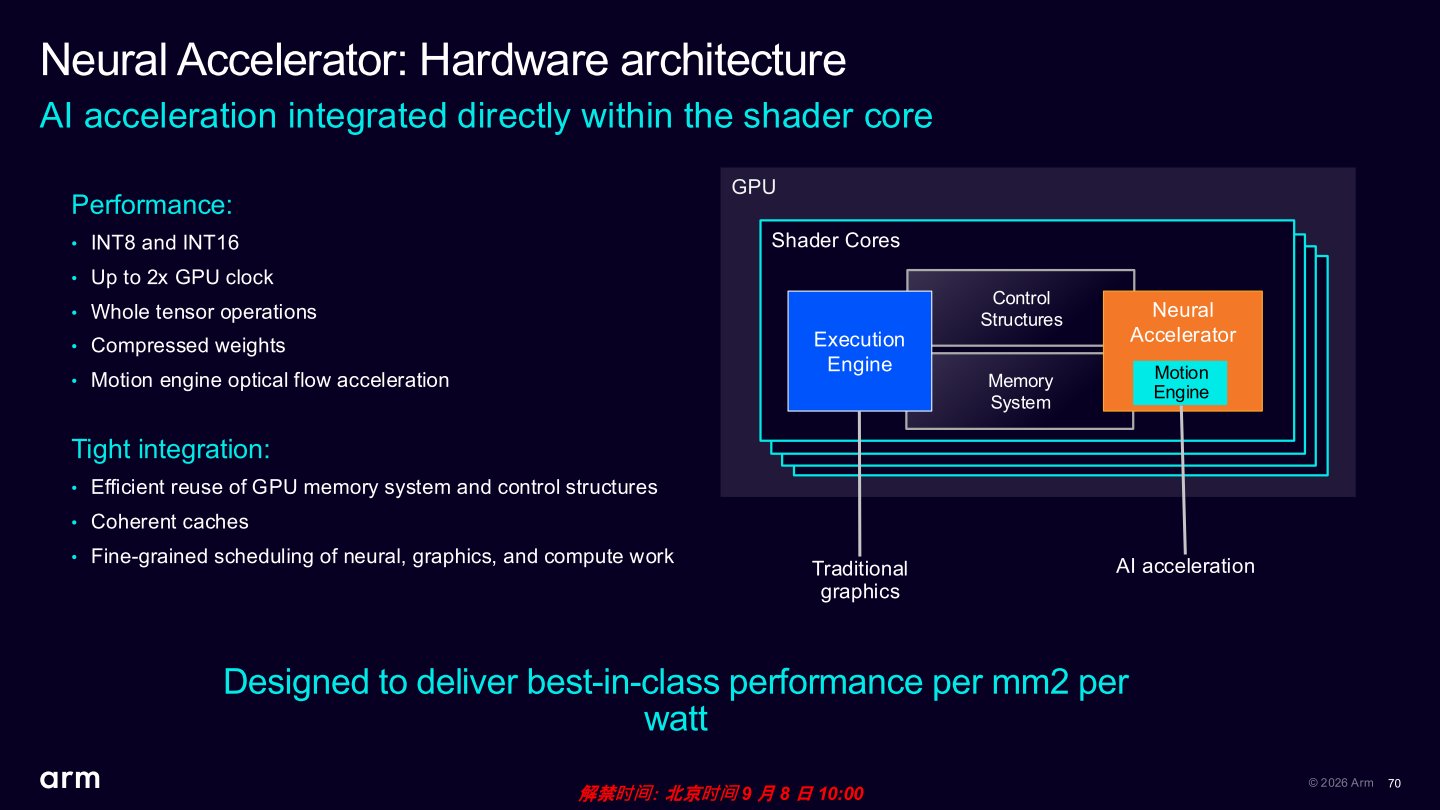
G2-Ultra NX GPU內部的執行引擎負責傳統繪圖功能,神經加速器則專門負責AI運算,支援INT8、INT16等資料類型,並內建畫格生成所需的光流加速功能(Motion Engine Optical Flow Acceleration)。

NSSD超解析度功能與NSS接近,但是多出降噪功能,適合應用於光線追蹤遊戲。

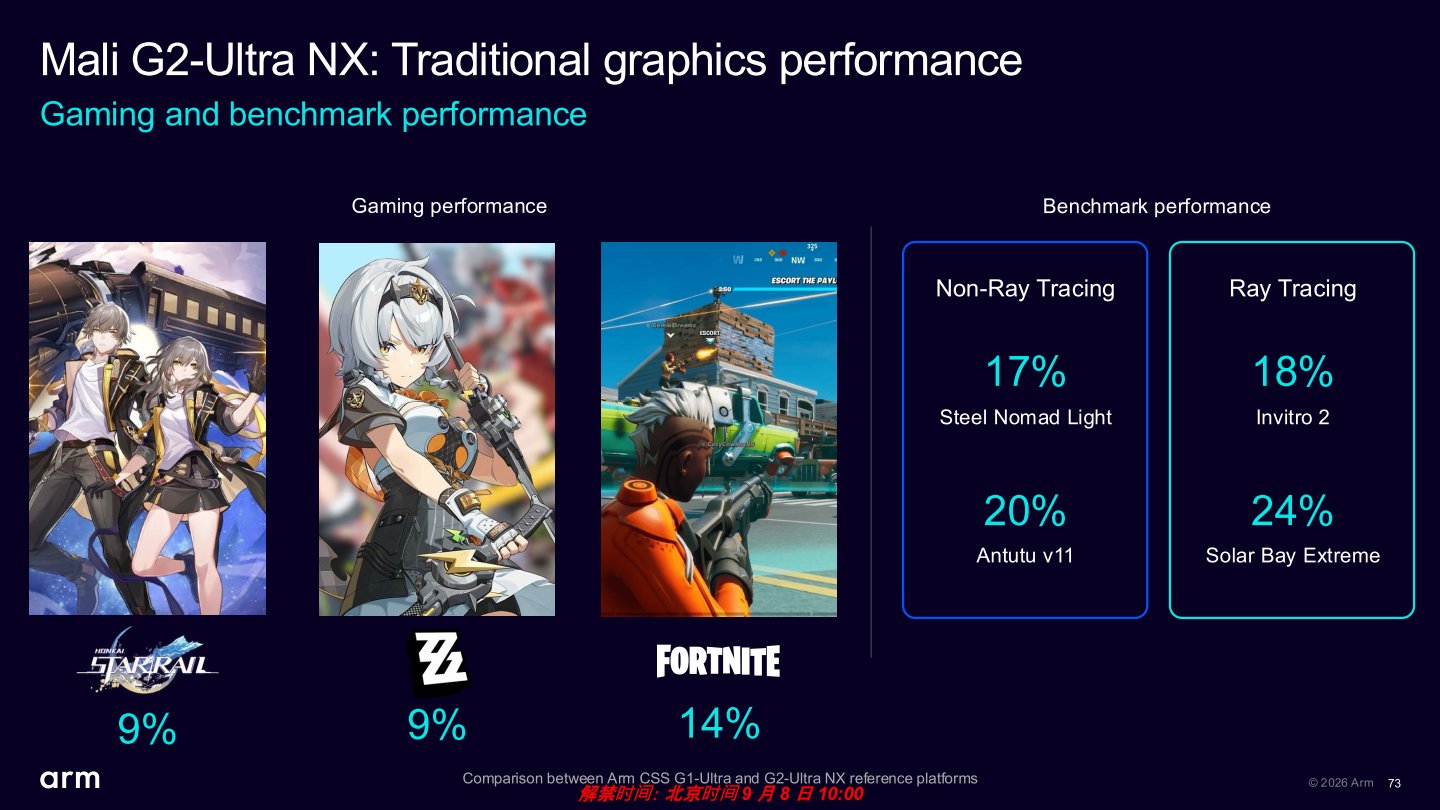
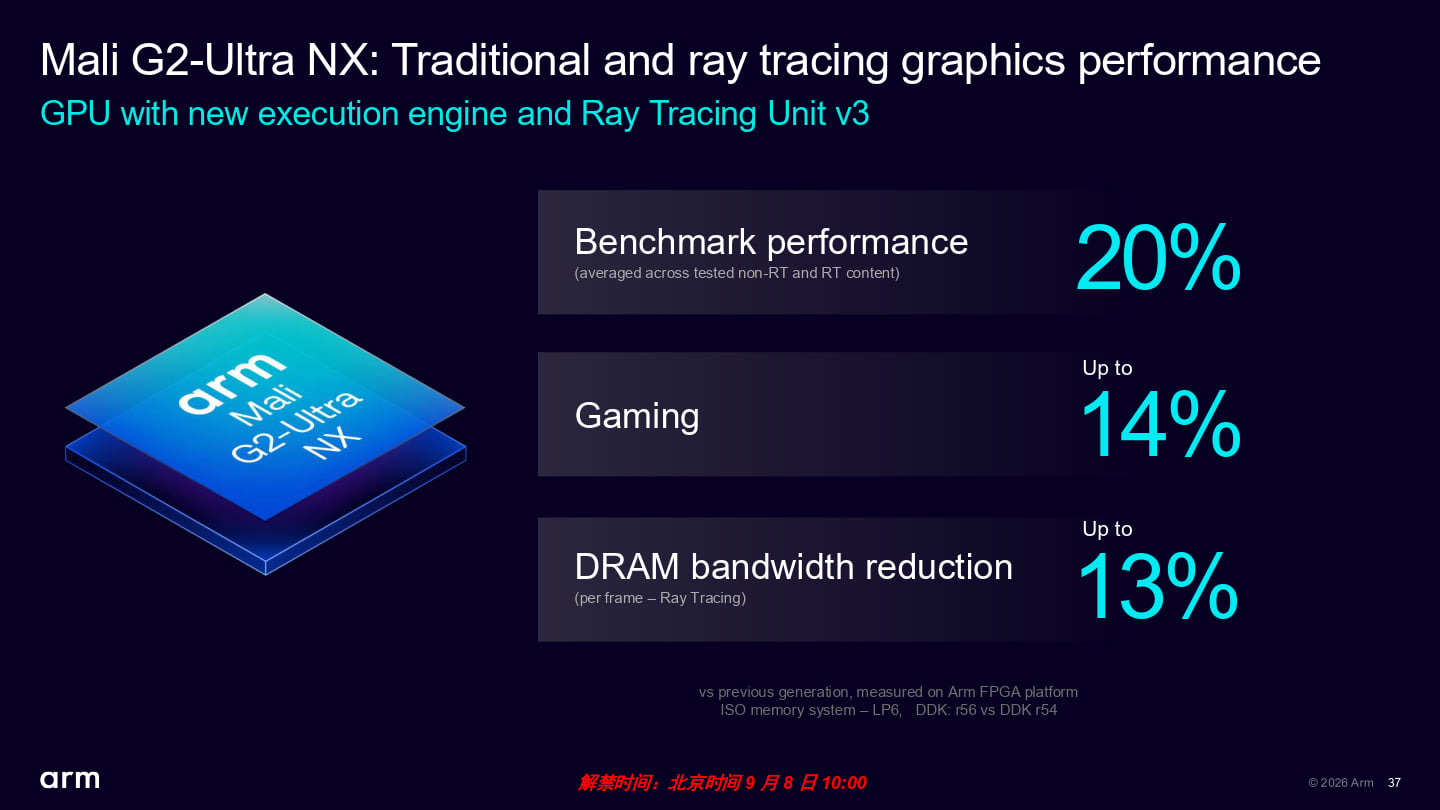
根據Arm提供的數據,G2-Ultra NX在多款遊戲的效能較前代G1-Ultra提高9~14%,效能測試工具成績則提升17~24%。

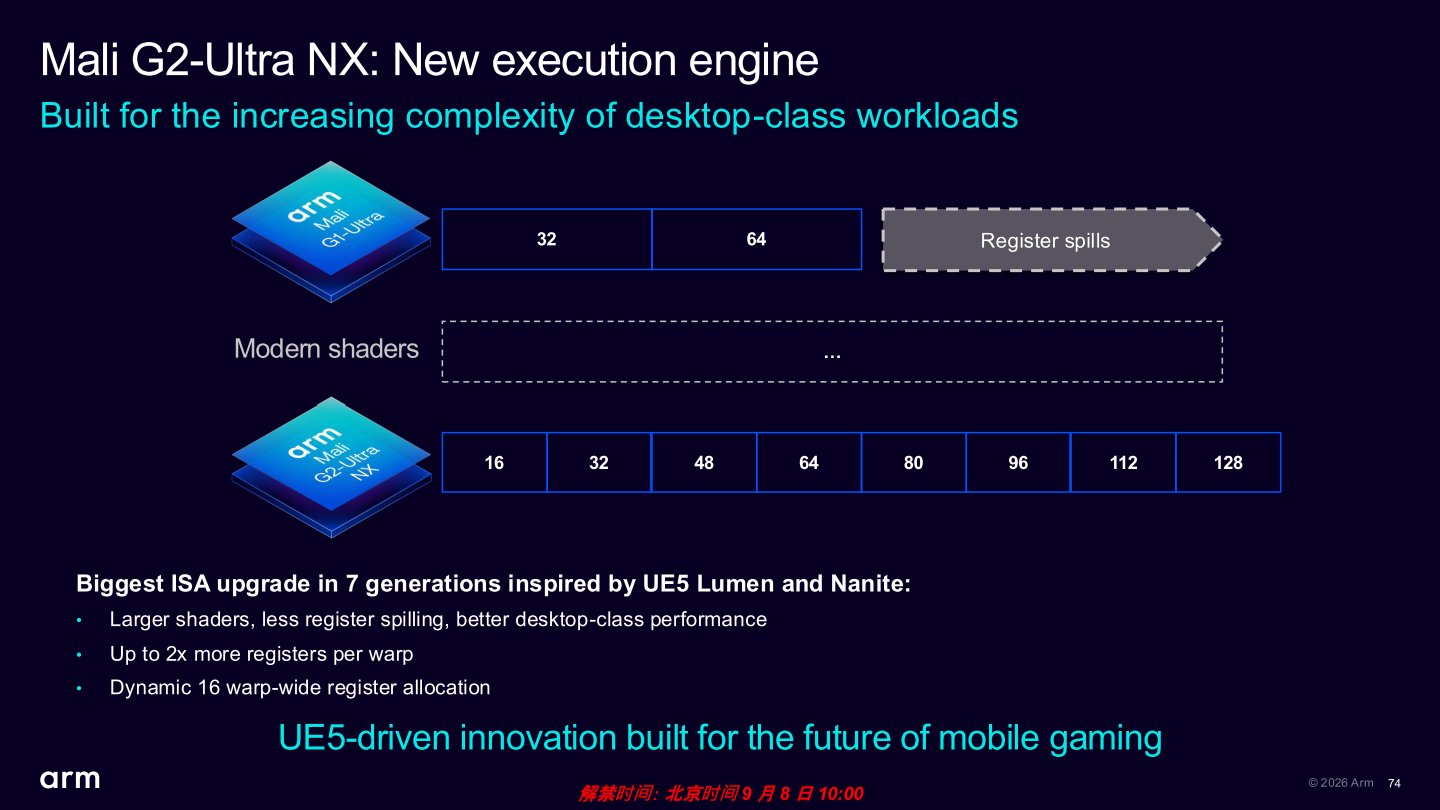
G2-Ultra NX的執行引擎支援更精細的動態暫存器分配機制以減少暫存器溢出,能在著色器(Shader)程式規複雜度提升時減少暫存器溢出,提高資源利用率與整體效能。

G2-Ultra NX的第3代光線追蹤單元支援共用多邊型邊緣繪圖技術,能夠降低資料量並達到更高的光線追蹤吞吐量,在效能實測中能夠節省13%的記憶體流量。

第3代光線追蹤單元也支援透明度微貼圖,提供更精細的光線接觸判定,能夠降低繪圖負擔、提高光線追蹤效率。

G2-Ultra NX的繪圖效能在測試工具中提高24%,在非AI、神經繪圖的遊戲中提高14。若啟用神經繪圖則可讓FPS效能達到4倍之譜。

Arm透過Mali G2-Ultra NX與多種神經繪圖技術提供開發者更充沛的效能,有助於打造更豐富多元的遊戲作品,也讓玩家能在行動裝置上替驗媲美桌上型電腦等級的遊戲體驗,首款搭載Mali G2-Ultra NX GPU的智慧型手機為於2026年9月10日上市的Xiaomi 18 Fold。

(Arm Tech Day 2026系列文章目錄)

加入T客邦Facebook粉絲團

【Arm Tech Day 2026】CSS for Mobile 2帶來全新C2-Ultra CPU、G2-Ultra NX GPU,強化手機代理式AI與主機級光線追蹤遊戲體驗

2026年9月8日 15:00
Arm CSS for Mobile 2運算子系統包含C2-Ultra、C2-Pro等CPU、G2-Ultra NX GPU、系統 IP、軟體及開發者工具,以完整平台的型式改善代理式AI應用體驗。89b071b9d660234de77a4099fd12d816

Arm CSS for Mobile 2運算子系統包含C2-Ultra、C2-Pro等CPU(處理器),以及G2-Ultra NX GPU(繪圖處理器)、系統 IP、軟體及開發者工具,以完整平台的型式改善代理式AI應用體驗。

手機成為AI代理助手

Arm於北京舉辦的Arm Tech Day 2026說明會中發表為智慧型手機、平板電腦等 行動裝置設計的CSS for Mobile 2運算子系統,透過從整體系統層面進行最佳化設計的運算平台,在有限的電力與散熱預算下提供充沛的通用運算、AI、繪圖效能,以滿足代理式AI以及遊戲主機等級的光線追蹤遊戲體驗。

延伸閱讀:
Arm Lumex CSS平台搭配全新C1系列處理器,4種型號隨意混搭最高14核心效能怪獸
Arm發表全新Lumex CSS平台,C1 CPU與Mali G1 GPU為旗艦級手機帶來25%效能增長
Arm發表類神經網路升頻技術,NPU嵌入GPU藉AI提升繪圖效能並節省電力

Arm邊緣AI客戶端運算副總裁James McNiven在說明會中介紹CSS for Mobile 2的設計功能,隨後則由其他專家介紹全新C2系列CPU與G2系列GPU的架構細節,我們先在這篇文章中瞭解CSS for Mobile 2,並在後續文章中深入分析CPU與GPU。

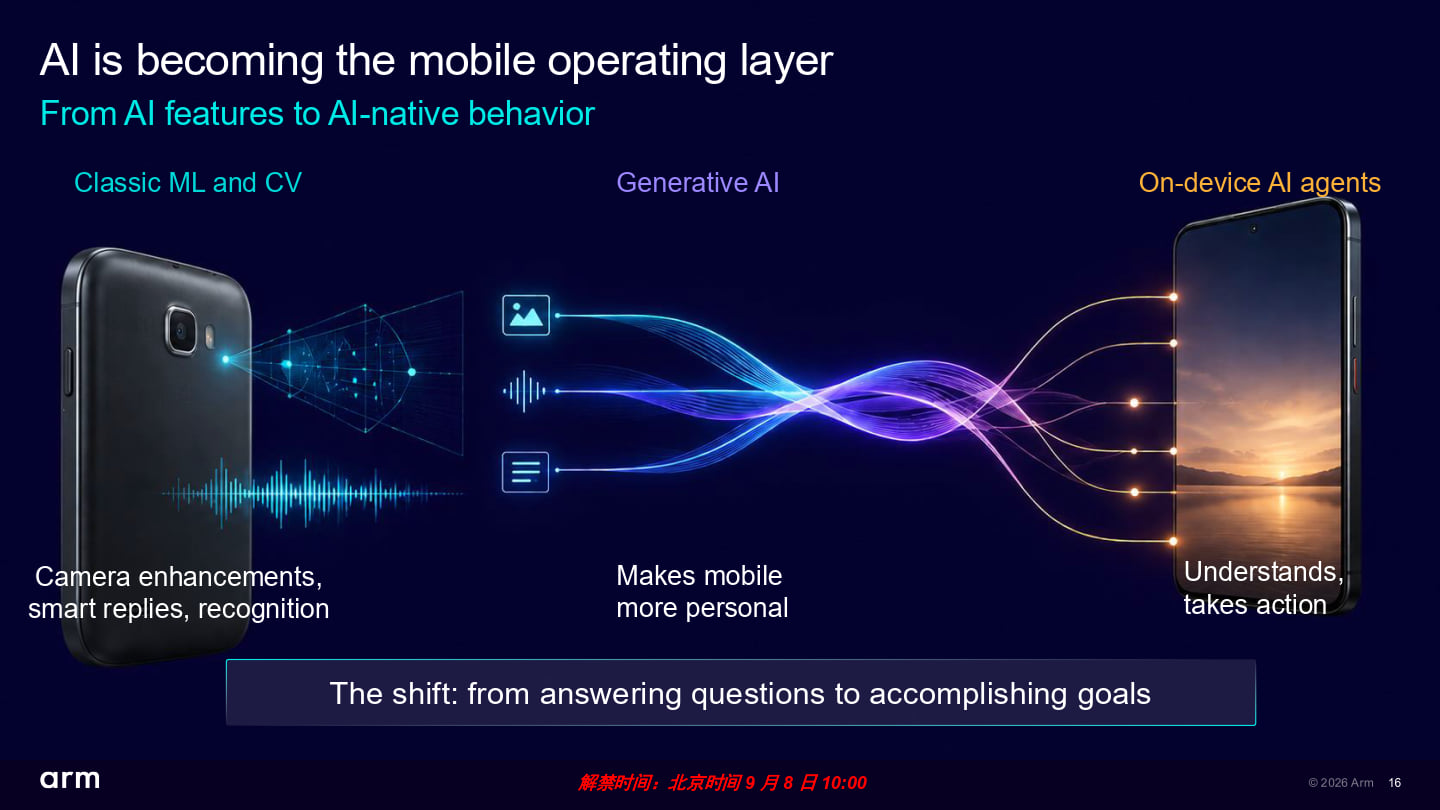
回顧AI技術發展的各個階段,初期階段為功能有限的機器學習應用程式,例如影像辨識、物件分類等等應用,接著到了生成式AI階段,AI應用程式可以透過生成文字的型式回答使用者的問題,或是將參考提示詞進行圖像生成。

進入代理式AI階段後,AI代理系統進化為能夠自主感知、分析使用者的意圖與需求,並擬定解決方案,接著調用系統中的其他AI應用程式或傳統應用程式完成工作,最終將工作成果彙報給使用者。

為了完成上述工作,代理式AI會在使用者單次下達指令後,調用系統中的多個元件以完成意圖分析、資料檢索與處理、模型執行、記憶體存取以及操作應用程式等環節,因此系統需要具備常時在背景運作、充沛的AI運算效能、更多的處理器核心數等能力,以提供理想的使用體驗。

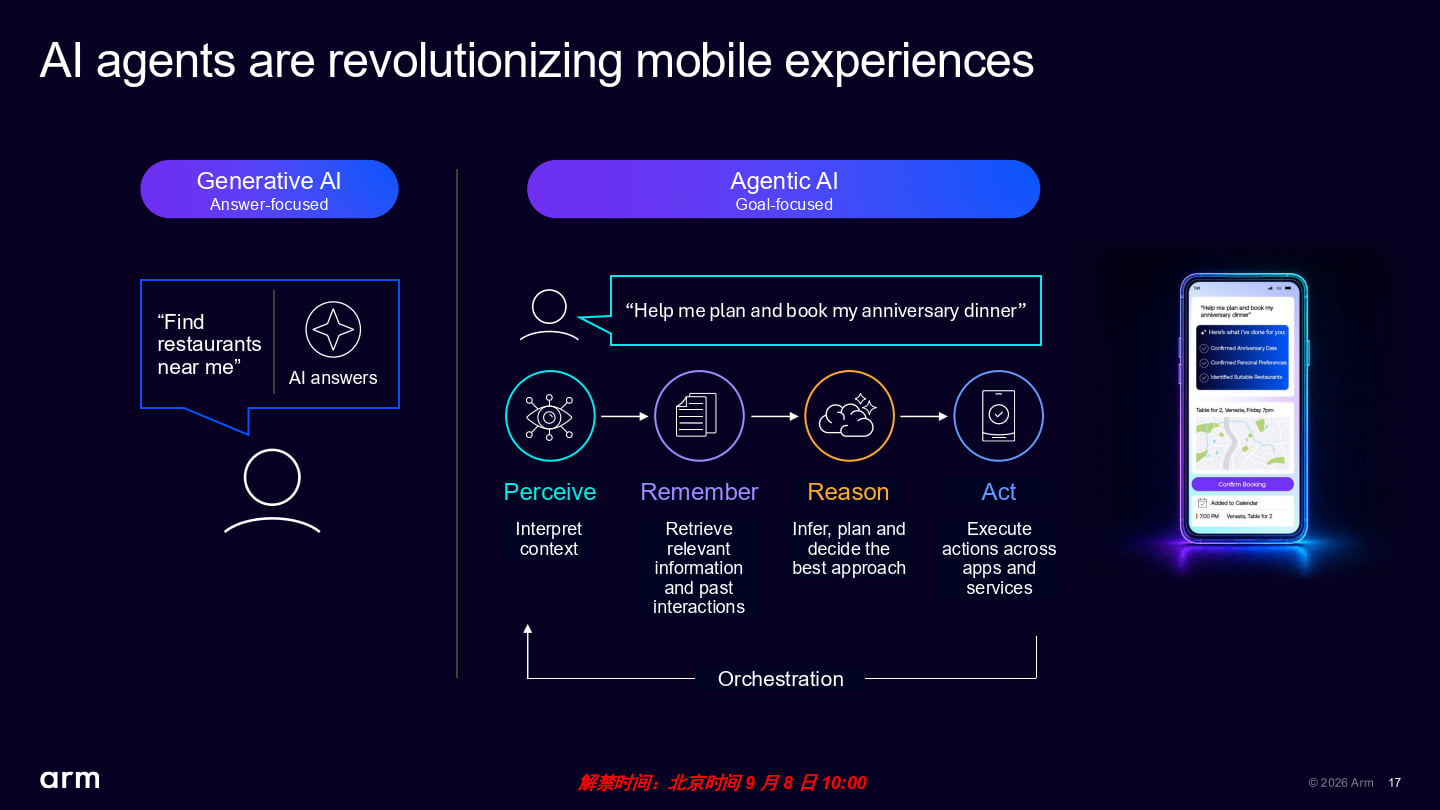
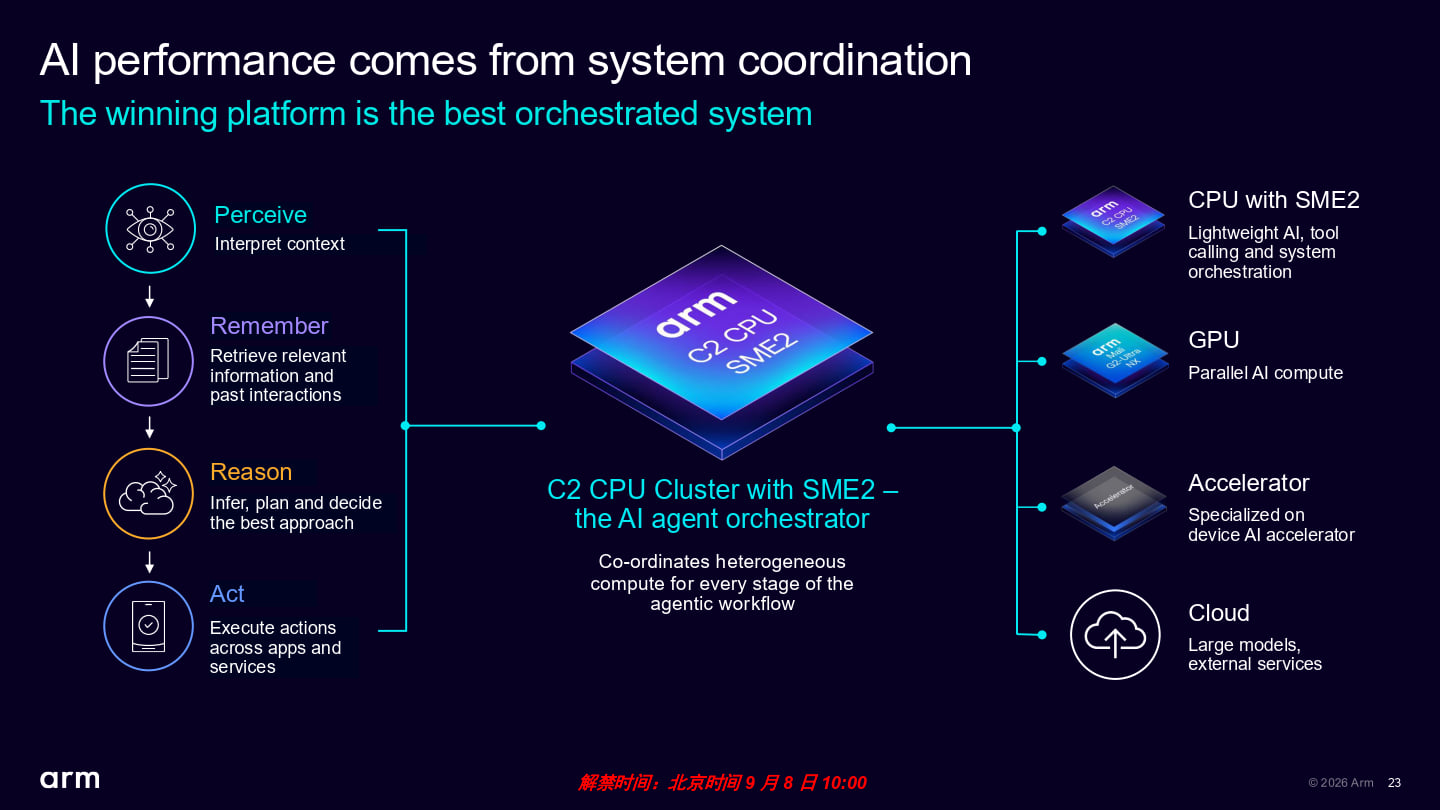
James McNiven將代理式AI的運作流程拆解為下列4個階段,筆者也將後續演說中提到以丈夫為妻子訂結婚10週年紀念晚餐的任務,整合於下列流程說明。

代理式AI運作流程

  1. 感知(Perceive):接收外界資訊並分析指令。例如使用者對手機說「幫我訂結婚10週年餐廳」
  2. 記憶(Remember):搜尋資訊與過去的互動。系統會搜尋手機中的行事曆、相簿等資料,確定結婚紀念日期,以及從過去的相片分析喜歡的餐廳風格與菜色
  3. 推理(Reason):規劃並決定最佳解決方案。系統自動上網搜尋適合的餐廳,並生成操作提示詞
  4. 行動(Act):自動執行提示詞與任務。系統自動完成餐訂位,將行程新增至行事曆,將活動提醒與導航資訊傳給妻子

在上述流程中,除了會進行AI推論運算之外,還有許多查尋資料、開啟App、操作網頁的工作,都會占用CPU的運算資源,而且統整各階段順利進行的編排(Orchestration)工作也仰賴CPU,另一方面也有部分AI運算也會直接交給CPU處理,因此在CPU在代理式AI的重要性不亞於GPU或NPU等運算單元。

Arm邊緣AI客戶端運算副總裁James McNiven在說明會分享AI技術發展的趨勢,並介紹CSS for Mobile 2運算子系統的設計功能。

Arm在AI轉型中扮演重要角色,不但有先前針對資料中心推出的Arm AGI CPU,也有適合應於機器人等物理AI與智慧型手機等邊緣AI的相關產品。

AI沿著單一功能、生成式AI、代理式AI的路徑發展至今,操作模式也由對提升詞反應、偶爾互動、產生回答、雲端優先,轉換為自主行動、持續互動、深度個人化、分散至終端裝置執行。

由於代理式AI需要更多「代理人」操作應該程式、AI工具,因此需要更多處理器核心與運算資源,James McNiven提出CPU是代理式AI中心的觀點。

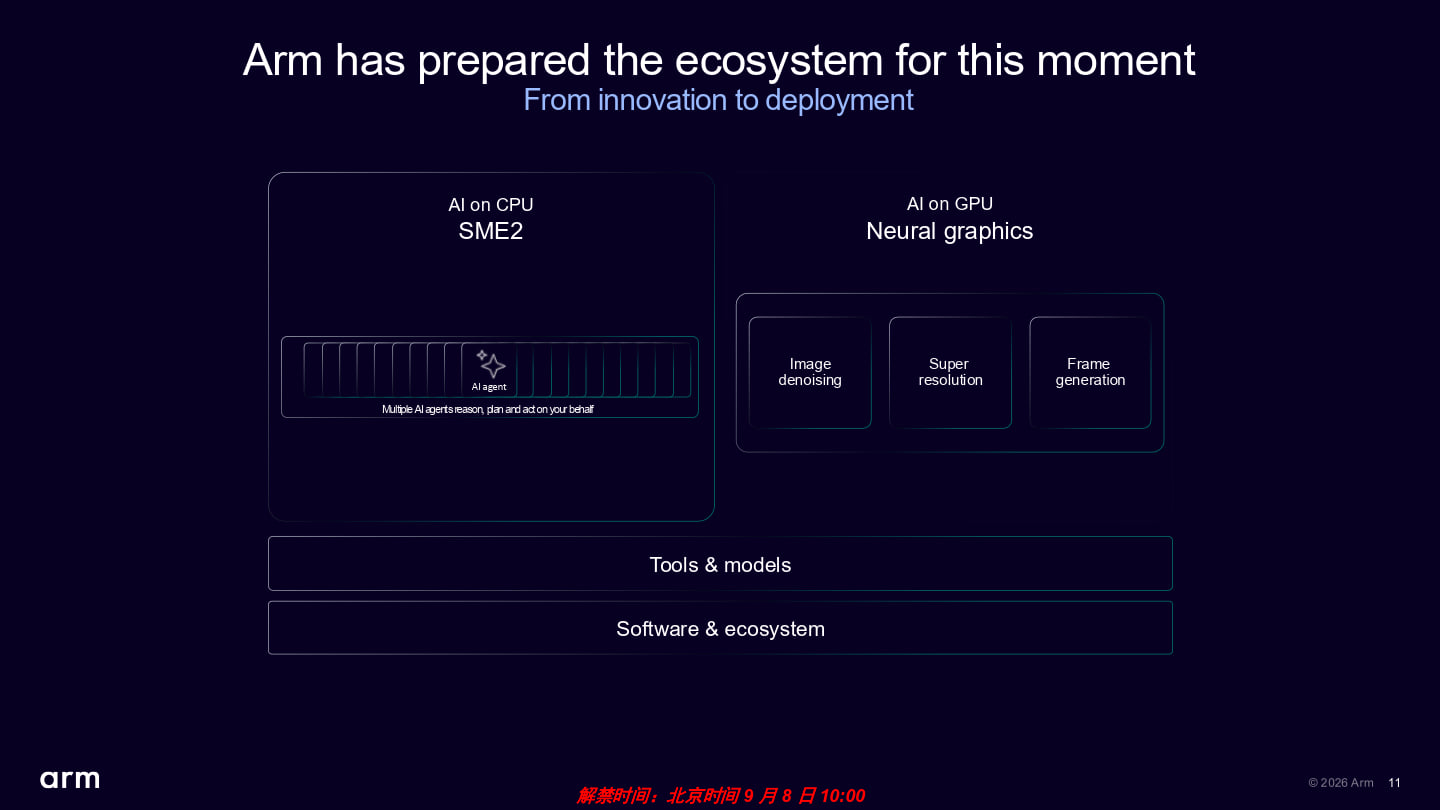
CSS for Mobile 2整合CPU中的SME2引擎、GPU中的AI加速器,以及豐富的工具、AI模型、軟體,透過完整的軟體堆疊協助生態系夥伴加速AI轉型與部署。

行動裝置上的AI功能也從傳統的機器學習影像辨識轉進到生成式AI與代理式AI,讓體驗由「得到答案」進化到「自動完成工作」。

代理式AI的運作流成可以分為感知(Perceive)、記憶(Remember)、推理(Reason)、行動(Act)等階段,對CPU的運算資源需求隨之升高。而其中統整各階段順利進行的編排(Orchestration)工作也仰賴CPU進行。

Arm也推出更多藉由AI加速的神經繪圖功能,筆者將在後續文章中詳細介紹。

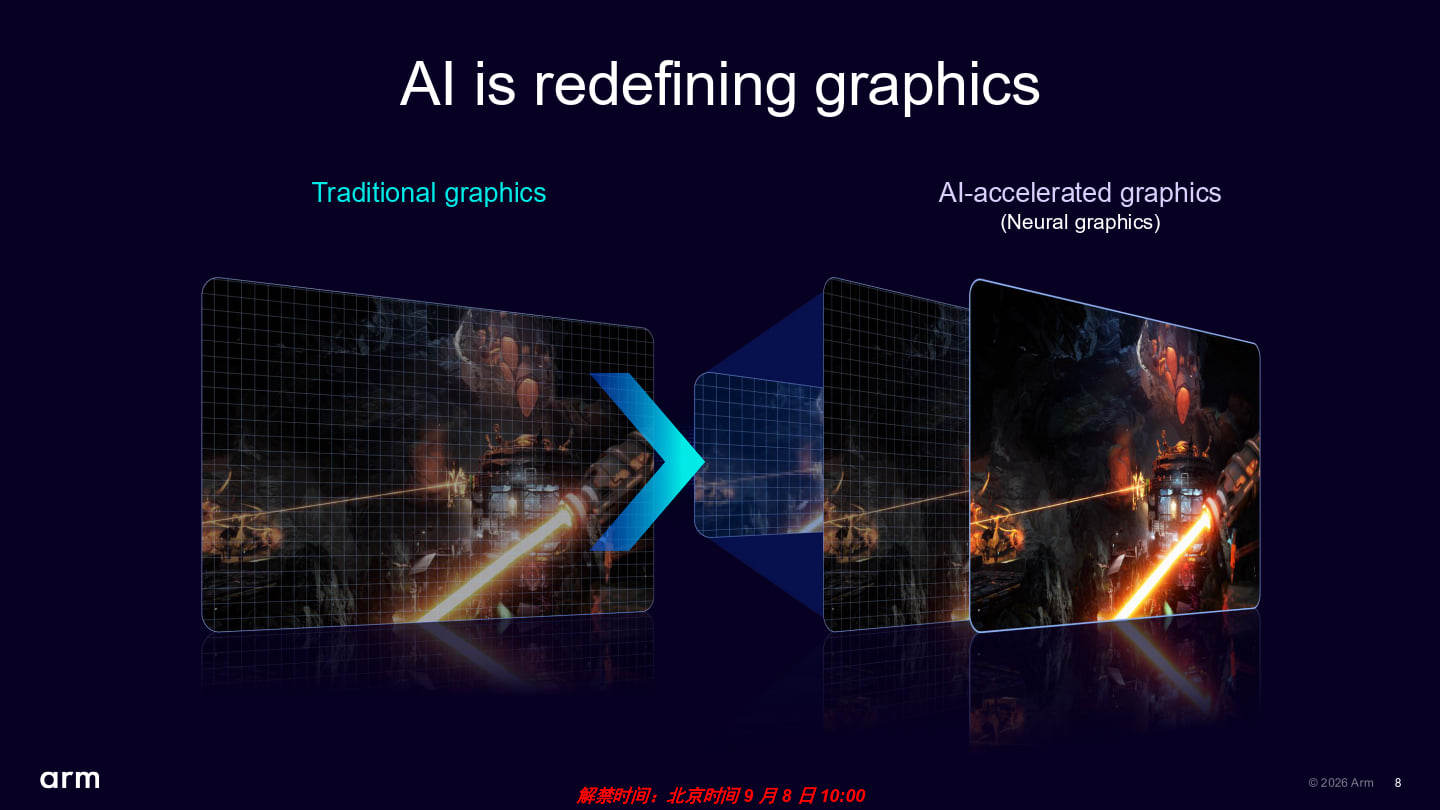
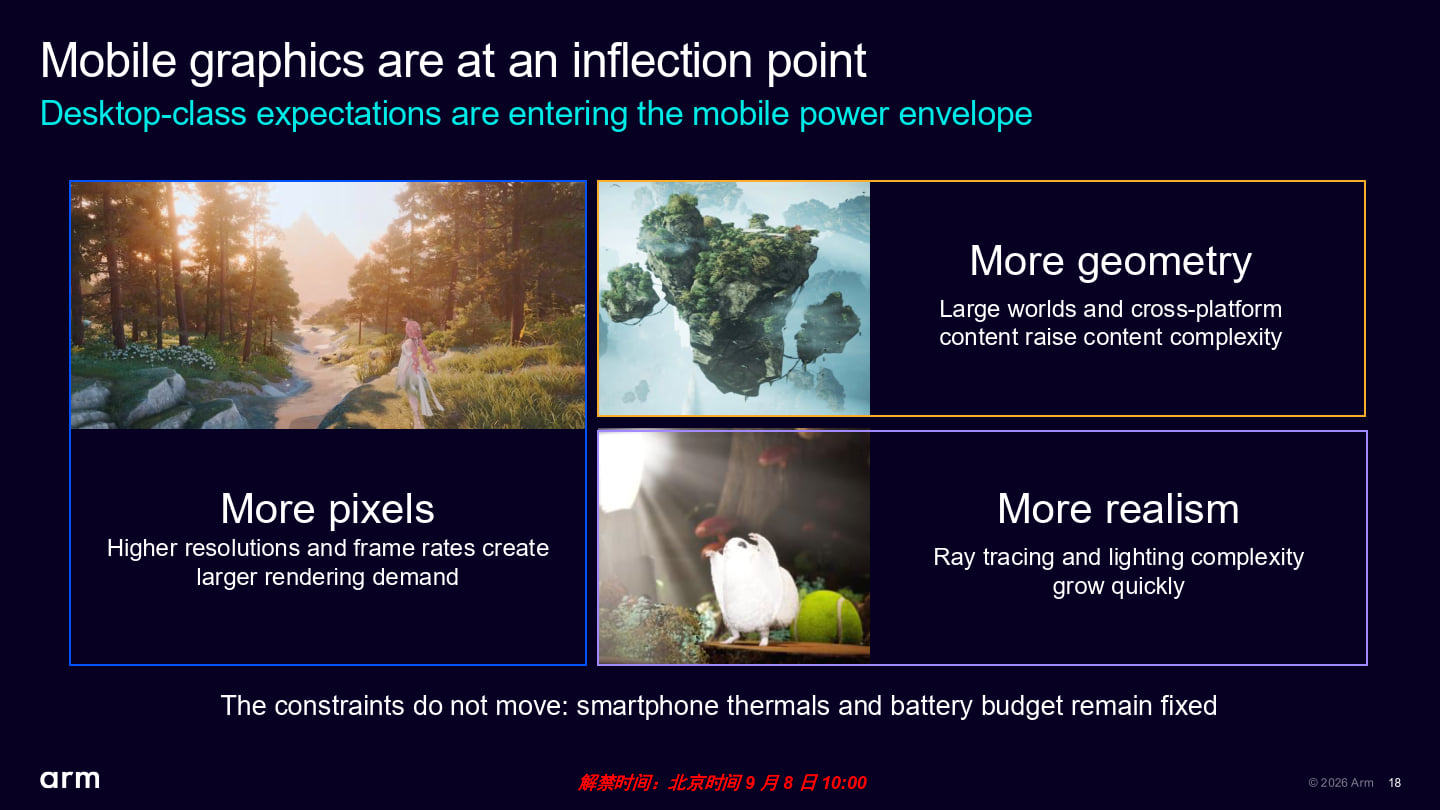
由AI加速的神經繪圖有助於提高遊戲的解析度、複雜幾何、逼真性,將桌上型電腦的遊戲體驗帶至行動裝置。

強化CPU的AI運算效能、也不忘GPU

James McNiven再次說明CPU在行動裝置執行AI應用程式的重要性。首先他提到目前有99%的行動裝置搭載Arm架構CPU,因此在CPU上進行AI推論運算有著明顯的相容性優勢,再加上CPU具有最高的可程式化性質,能夠透過軟體方式支援所有資料類型的浮點數運算,且因為資料可以直接在CPU完成運算,不需搬移至外部GPU或NPU(神經處理器),因此具有延遲較短的優勢。

Arm在CSS for Mobile 2中整合2組SME2引擎(Scalable Matrix Extension 2,第2代可擴展矩陣延伸指令集,主要功能為強化AI運算效能),較前代提供2倍的運算能量,對於AI應用程式有著絕對的助益。

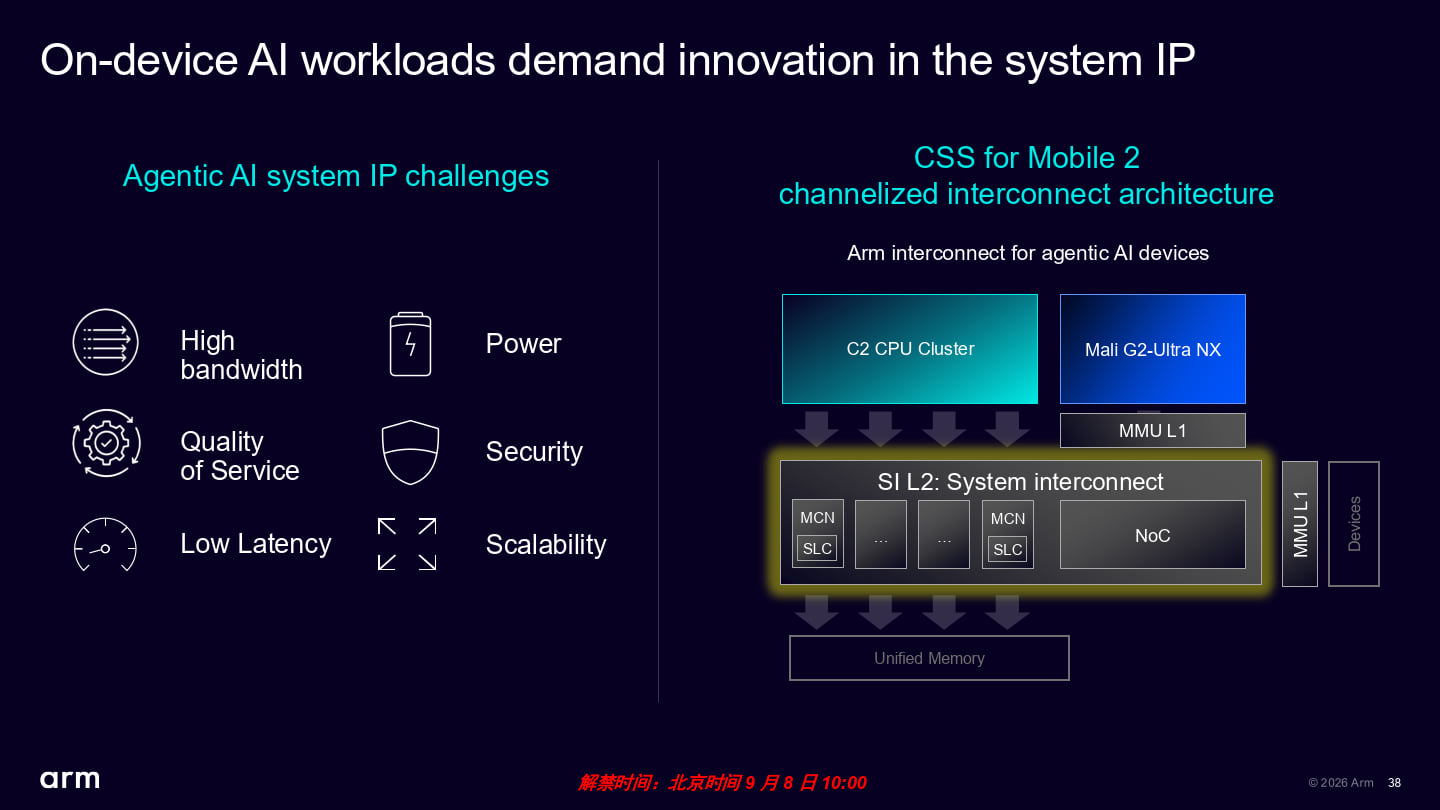
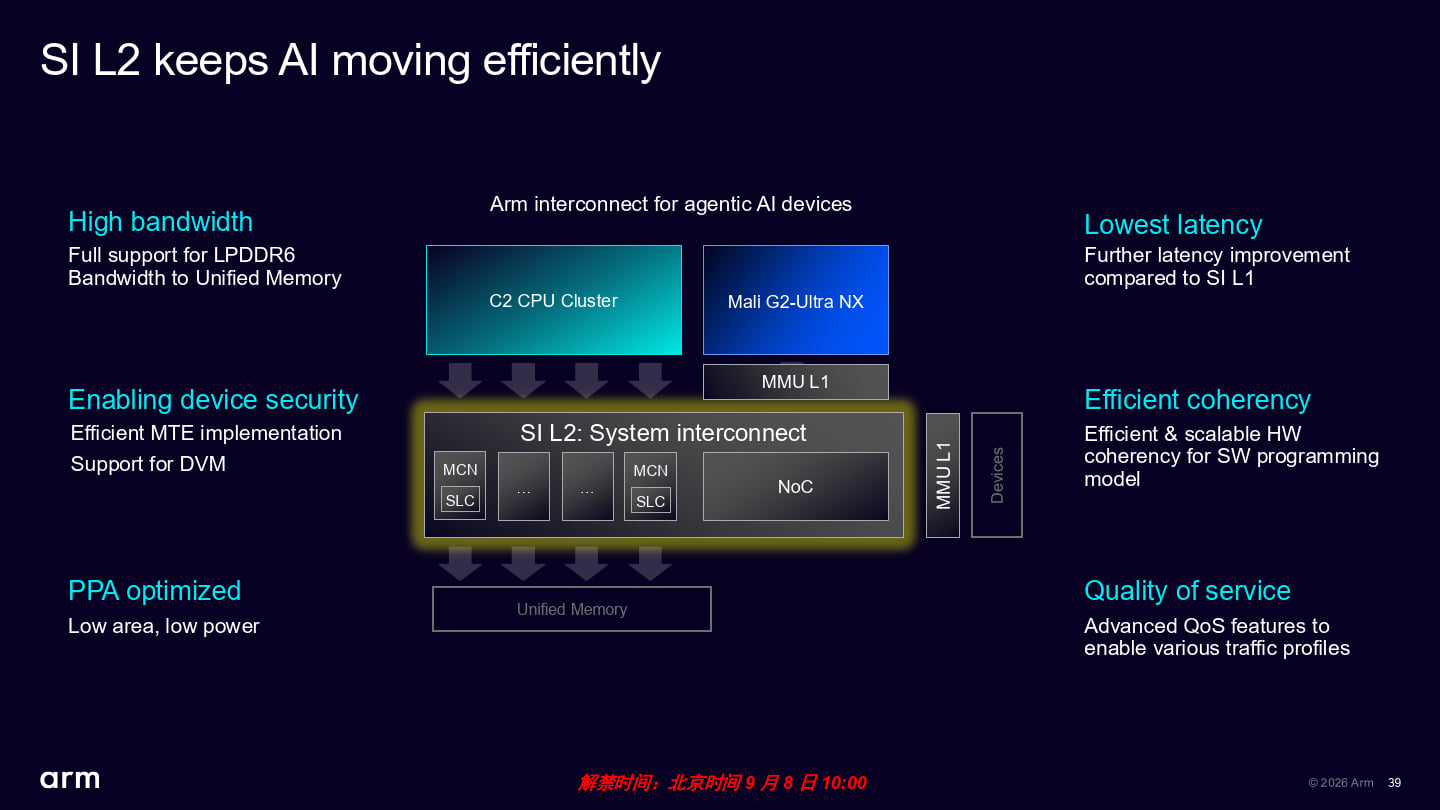
另一方面,代理式AI也將推高系統對記憶體頻寬與延遲的需求,也需要流量控管、功耗、資安、擴展性等功能的改善,對此Arm也推出SI L2系統互連功能因應需求。它最大的改進為在保留支援DDR5、LPDDR5x記憶體的同時新增支援LPDDR6,能為客戶確保硬體搭配的彈性,也能搭配傳輸速度更快的記憶體以改善效能,SI L2也對PPA(Performance效能、Power功耗、Area晶片面積)最佳化,以改善系統的綜合效能並控制成本。

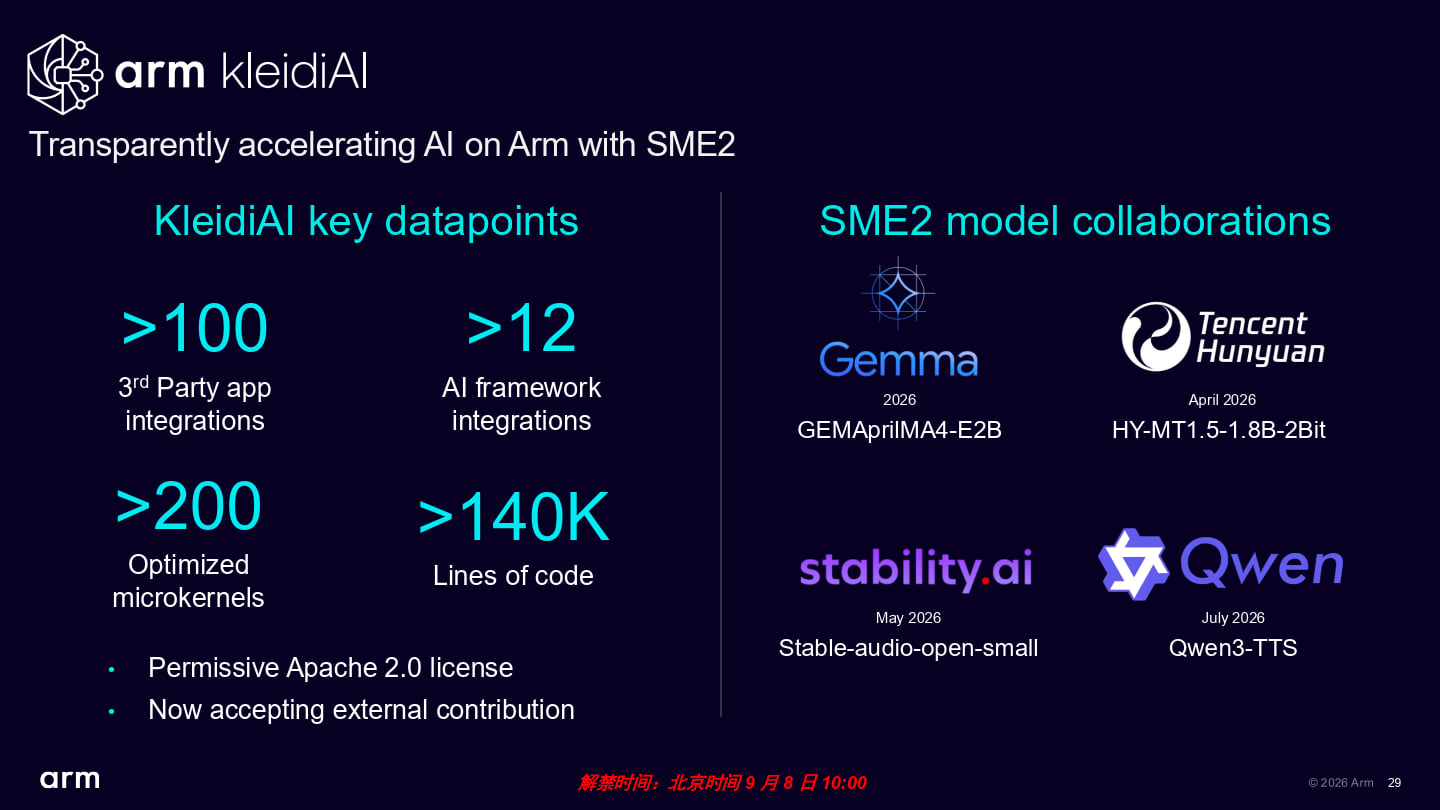
在軟體部分,CSS for Mobile 2同樣支援KleidiAI函數庫,提供與主流AI框架深度整合的開發環境,並可在程式執行時自動調用系統中最適合的CPU、SME2、GPU、NPU等不同的運算單元,充分發揮系統效能。

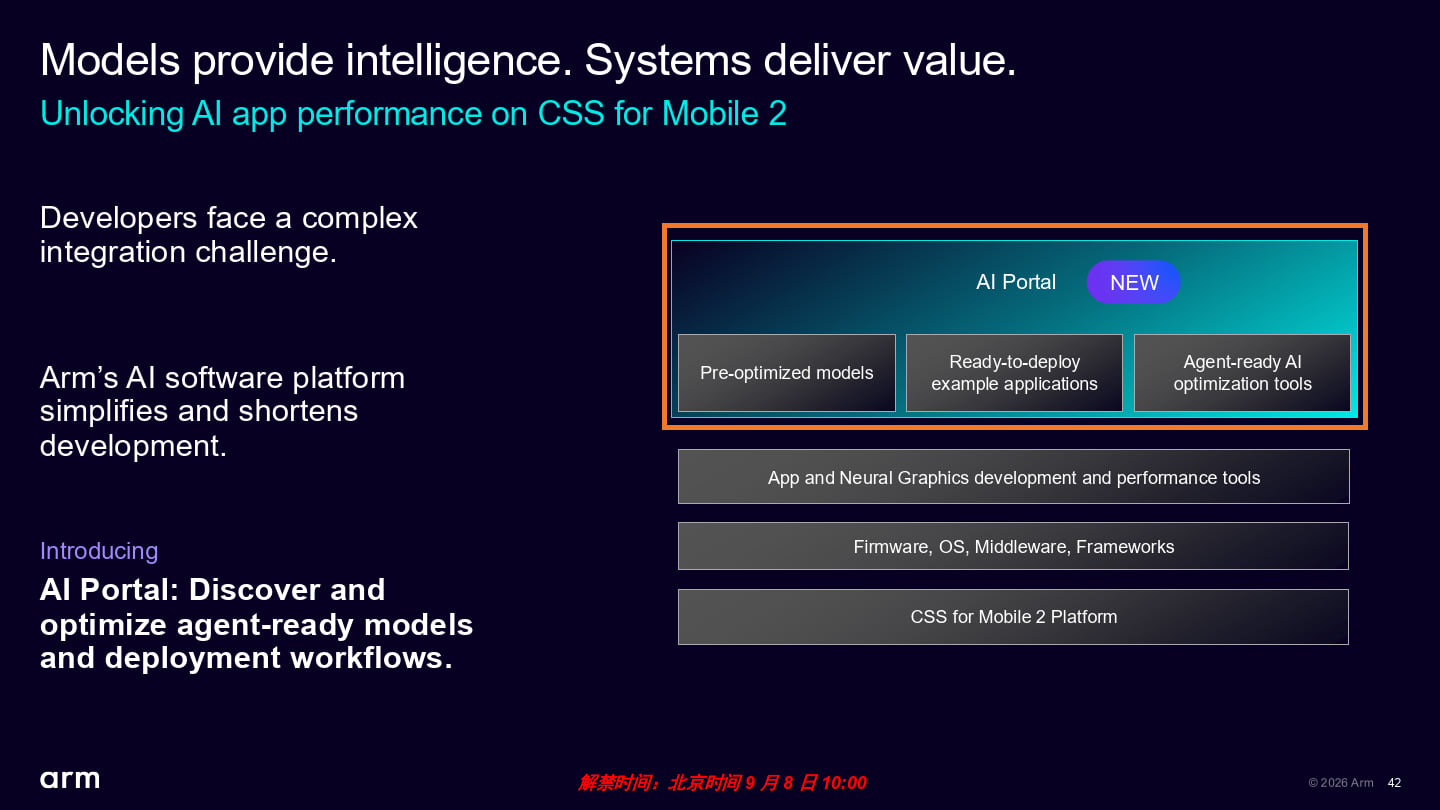
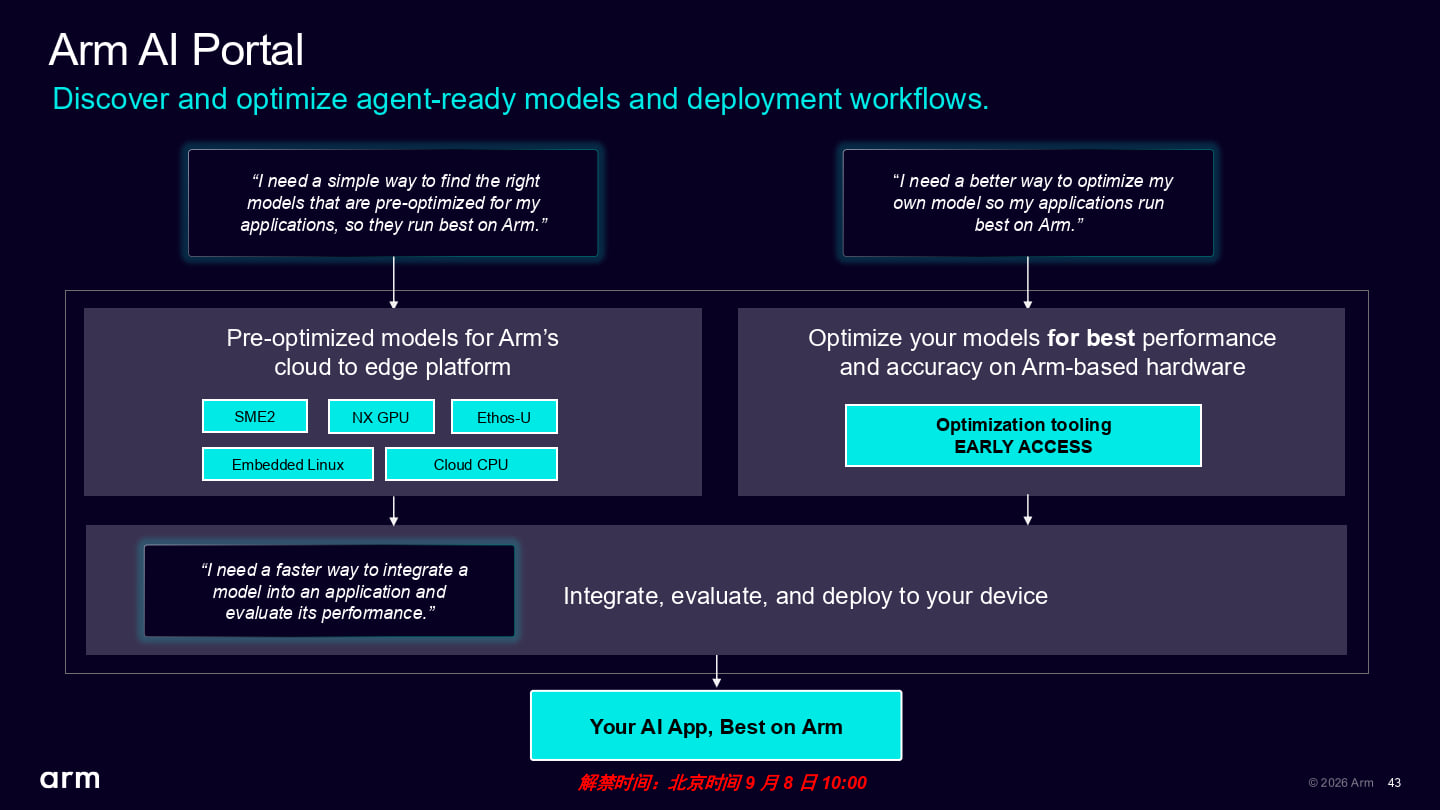
此外Arm也推出全新AI Portal工具,提供經過驗證且預先最佳化模型以及範例程式,協助開發者快速導入AI應用程式,加速從評估到部署的完整開發流程。對於自有模型而言,也可以透過早期預覽版(Early Access)模型最佳化工具,協助開發者對目標裝置進行最佳化。

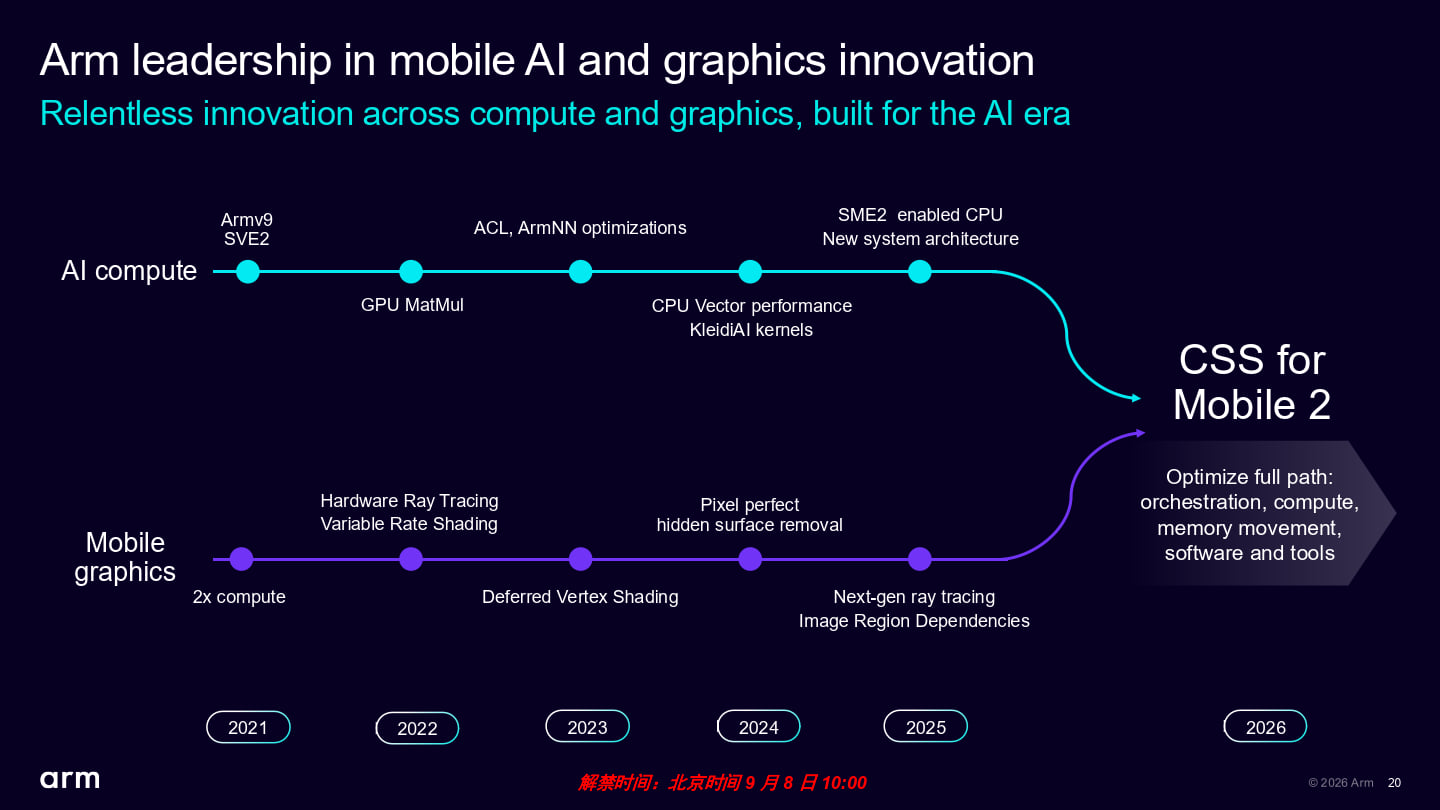
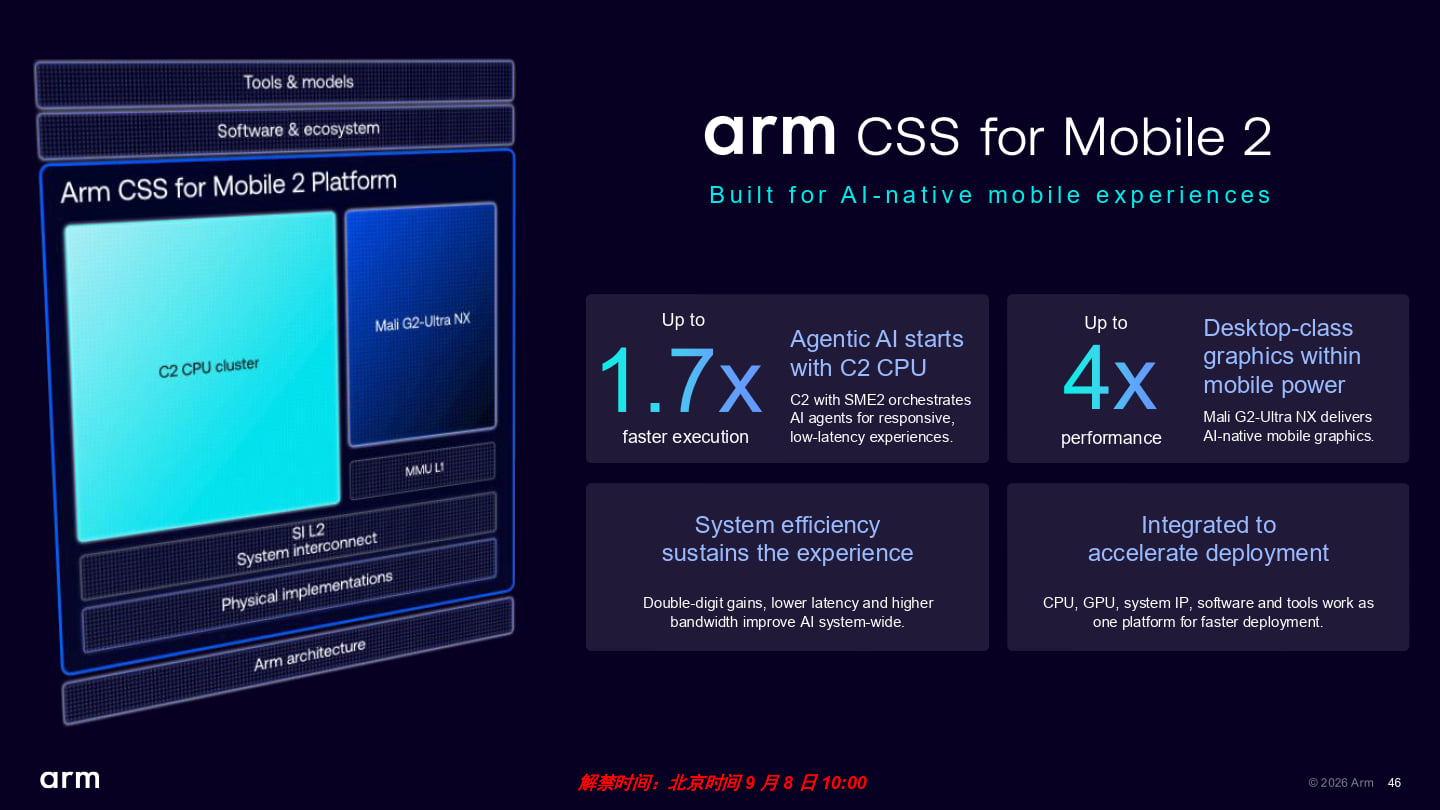
回顧Arm CPU與GPU的發展軌跡,許多AI加速運算與光線追蹤繪圖等技術最終匯流至CSS for Mobile 2。

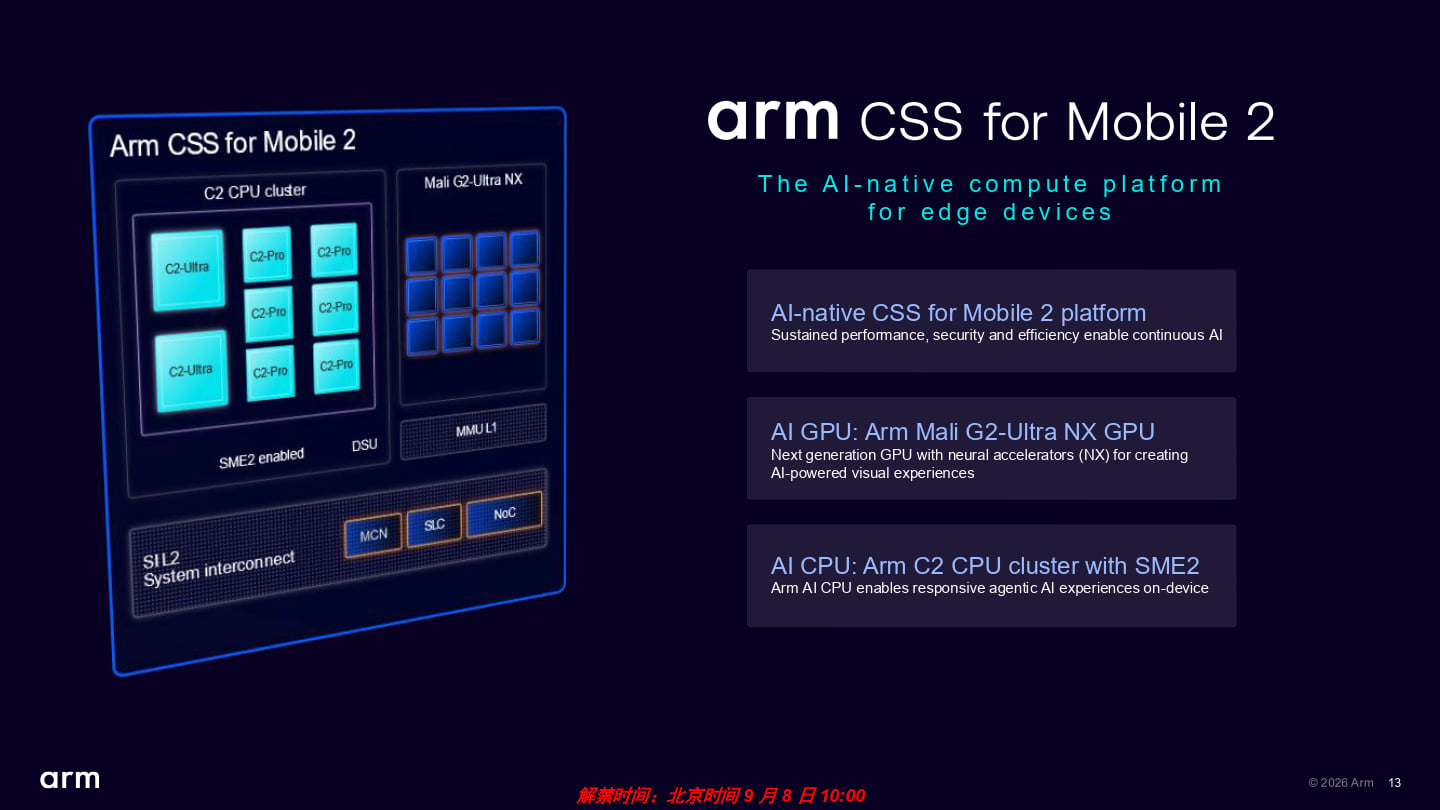
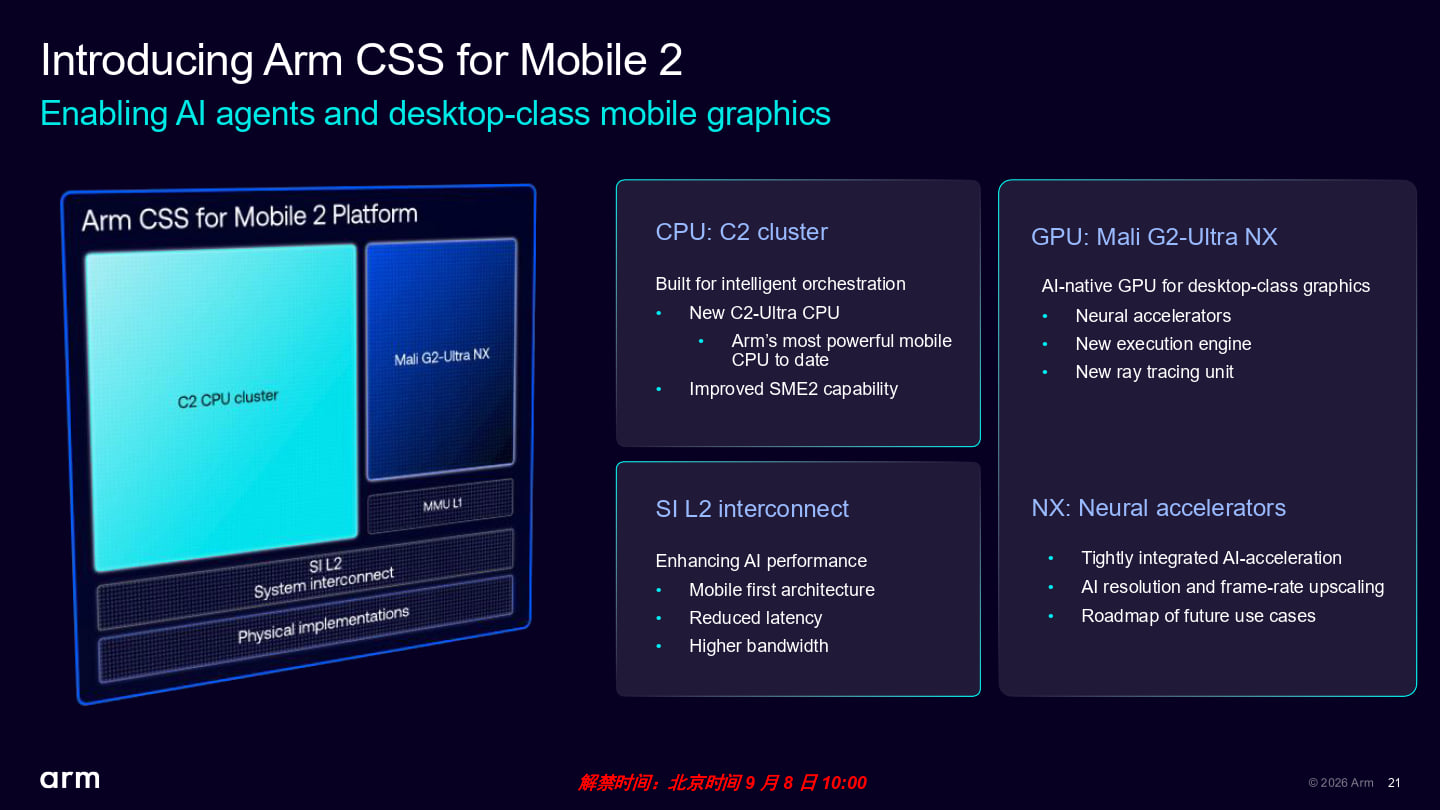
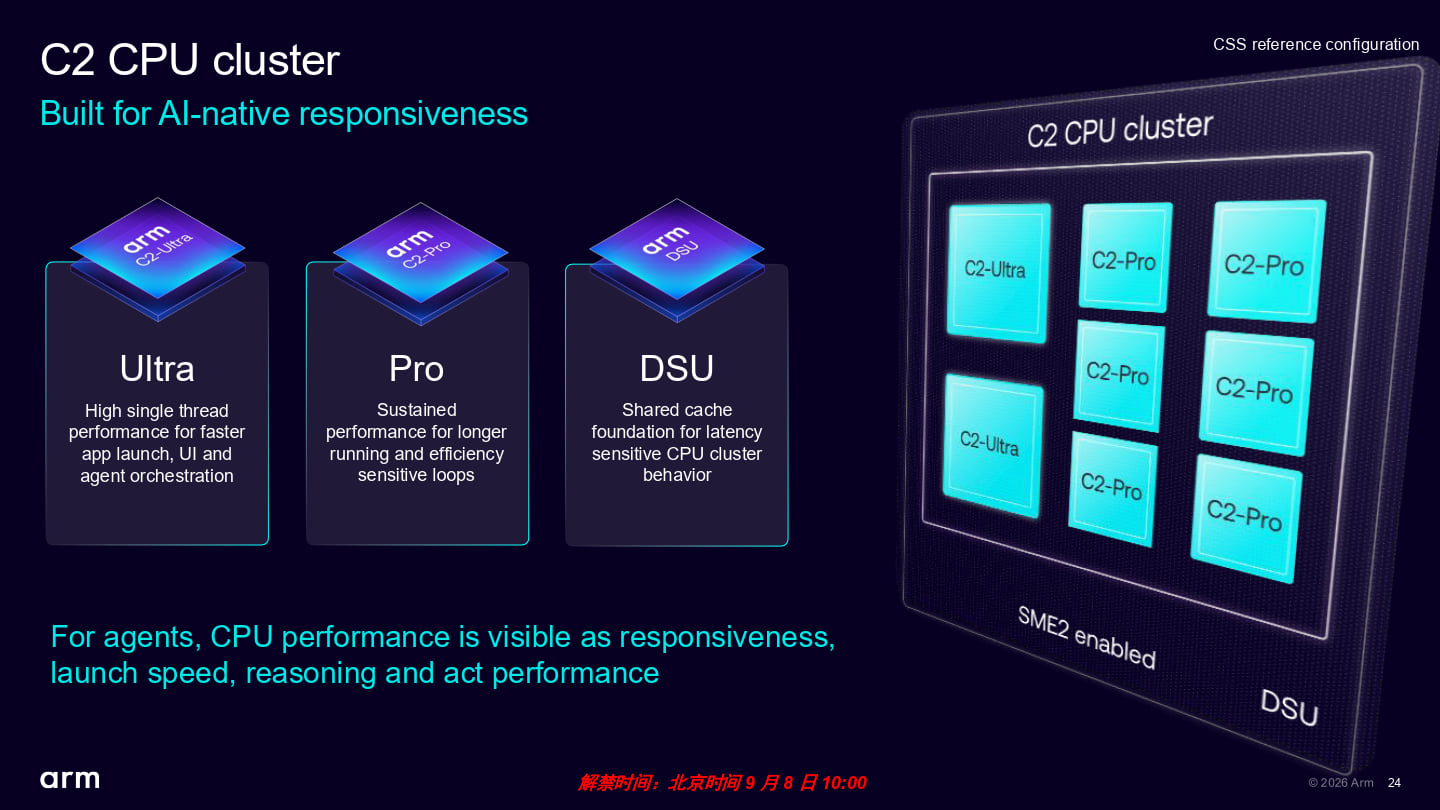
身為AI原生平台,CSS for Mobile 2運具有SME2加速功能的C2 CPU叢集、全新Mail G2-Ultra NX GPU。

CSS for Mobile 2中的C2 CPU叢集包含最新的處理器以及SME2單元,Mail G2-Ultra NX GPU具有更強大的執行單元、光線追蹤單元、神經加速器。而SI L2互連單元則專為行動裝置設計,帶來更高的頻寬與更低的延遲。

C2 CPU叢集搭配SME2能夠透過異質運的方式完成代理式AI的工作流程,還可搭配GPU、加速器(包含NPU或其他種類)、雲端算力等方式帶來更豐富的AI功能。

CSS for Mobile 2世代具有全新的C2-Ultra與改良的C2-Pro CPU核心,以及DSU動態分配單元(DynamIQ Shared Unit)。本世代並沒有新款「Nano」等級的輕量核心。

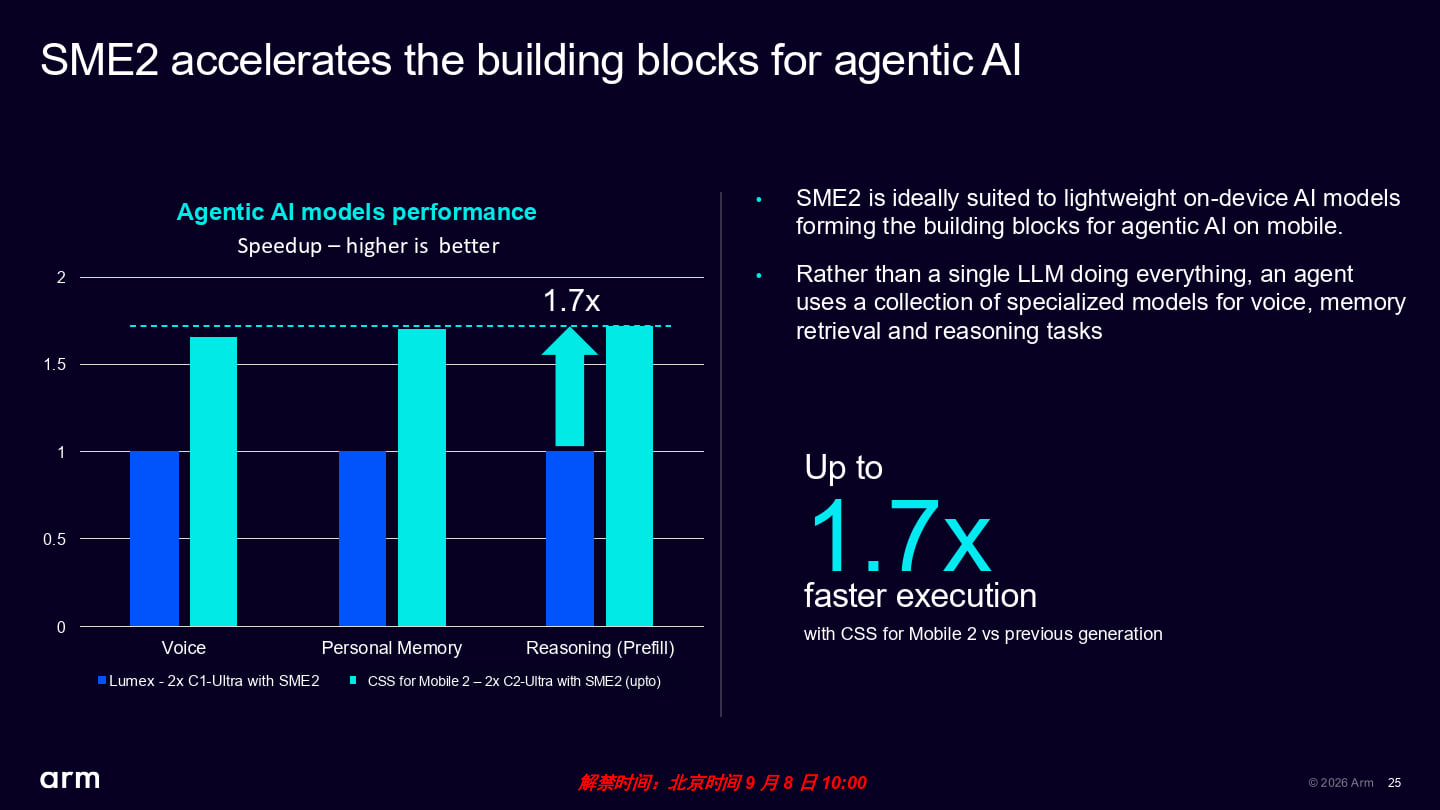
SME2單元相當適合執行裝置端的輕量AI運算,與前代產品相比,在特定運算負載的效能增益達到70%。

SME2能在搭配KleidiAI函數庫開發的AI應用程式發揮最佳化效能,包含GEMAprilMA4-E2B、Hunyuan HY-MT 1.5-1.8B-2Bit等模型也與SME2深度合作。(值得注意的弦外之音是能夠部署參數量達2B以及2Bit精度資料類型的AI模型)

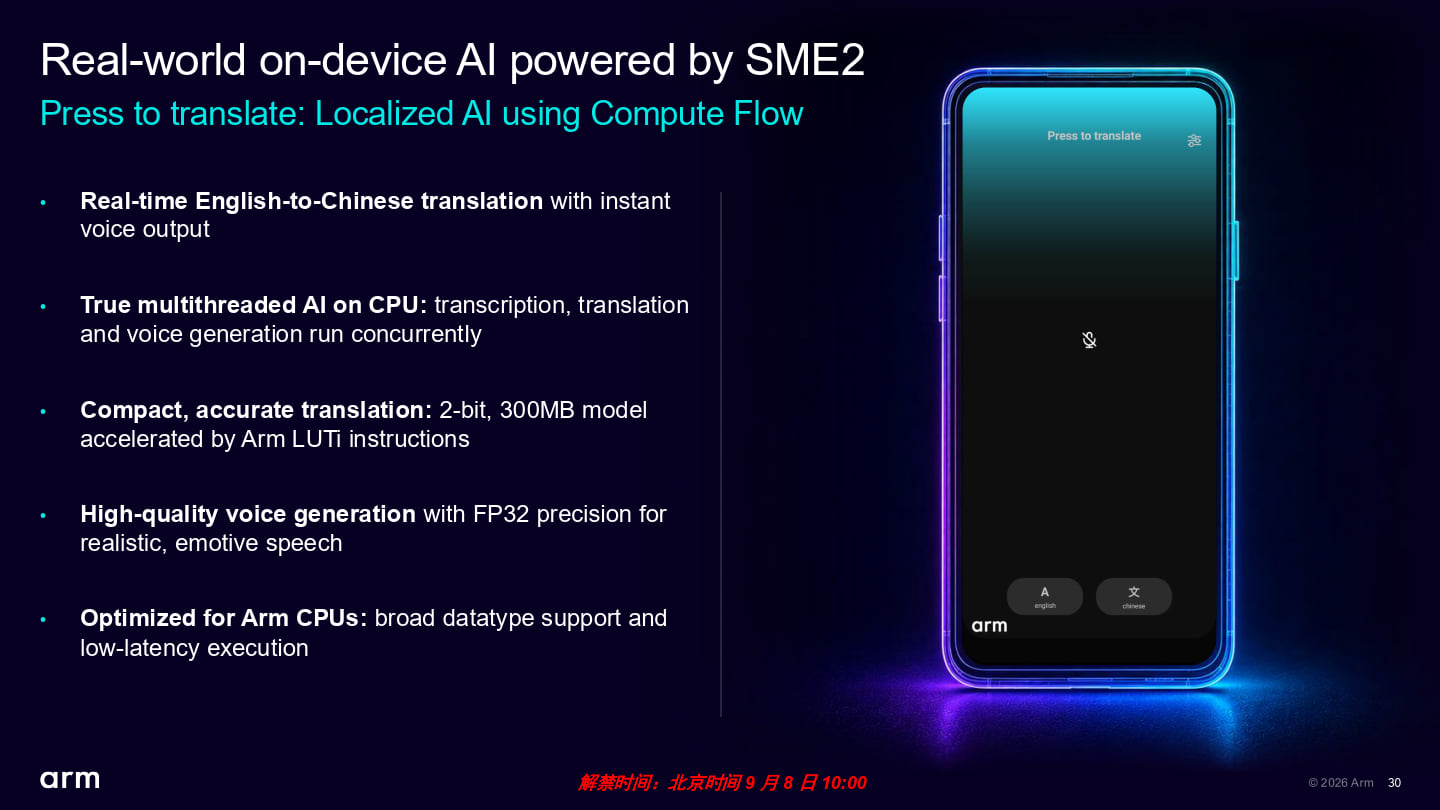
活動中也展示在手機上進行英文語音翻譯為中文語音的展示,使用者對著手機說英文,系統能立刻輸出與原本語調接近的中文語音。過程在CPU上執行語音轉文字、文字翻譯、文字轉語音等3組AI推論運算。

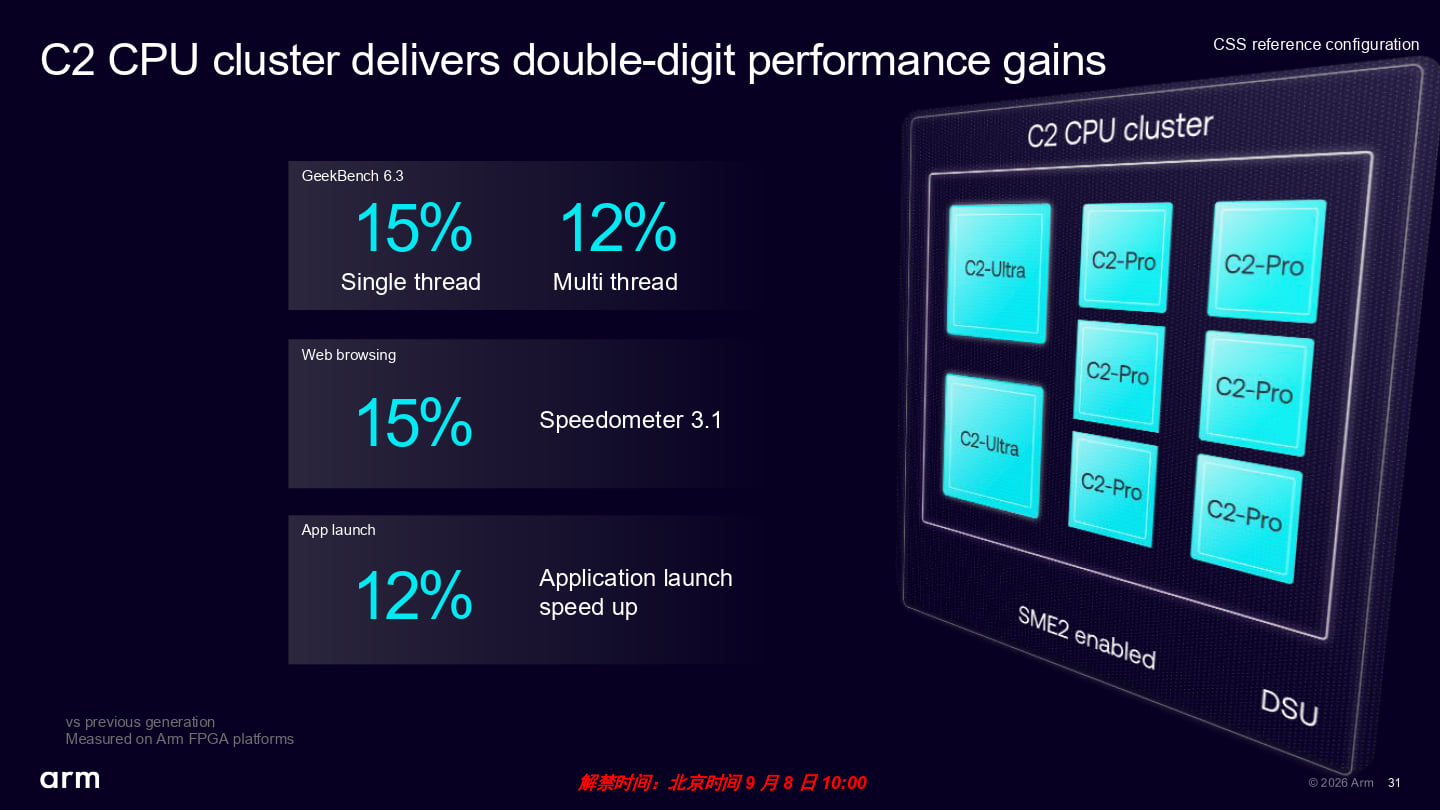
根據Arm提供的數據,搭載2組C2-Ultra核心與8組C2-Pro核心的參考平台與前代產品相比,GeekBench 6.3的單、多核心效能增益達到15%、12%,網頁瀏覽與App啟動效能也提升15%、12%。

CSS for Mobile 2導入首款AI原生的Mali G2-Ultra NX GPU,具有全新執行單元、第3代光線追蹤單元、專為在1 W功耗條件下運作的神經加速器。

Mali G2-Ultra NX GPU提供NSS、NFRU、NSSD等升頻技術,透過超解析度與畫格生成等方式提升遊戲體驗與畫面流暢度。

同時使用NFRU、NSSD升頻技術後,能讓遊戲FPS效能提高至4倍,將記憶體頻寬用量降低至30%,耗電量降低至25%。

根據Arm提供的數據,Mali G2-Ultra NX平均效能提升達20%,遊戲效能提升最高達14%,光線追蹤的記憶體頻寬用量降低13%。

代理式AI會帶來高頻寬、低延遲、流量控管、功耗、資安、擴展性等挑戰,對系統的互連也是一大考驗。

SI L2系統互連針對PPA進行最佳化,除了支援DDR5、LPDDR5x之外,也支援LPDDR6,有助於提高記憶體頻寬。

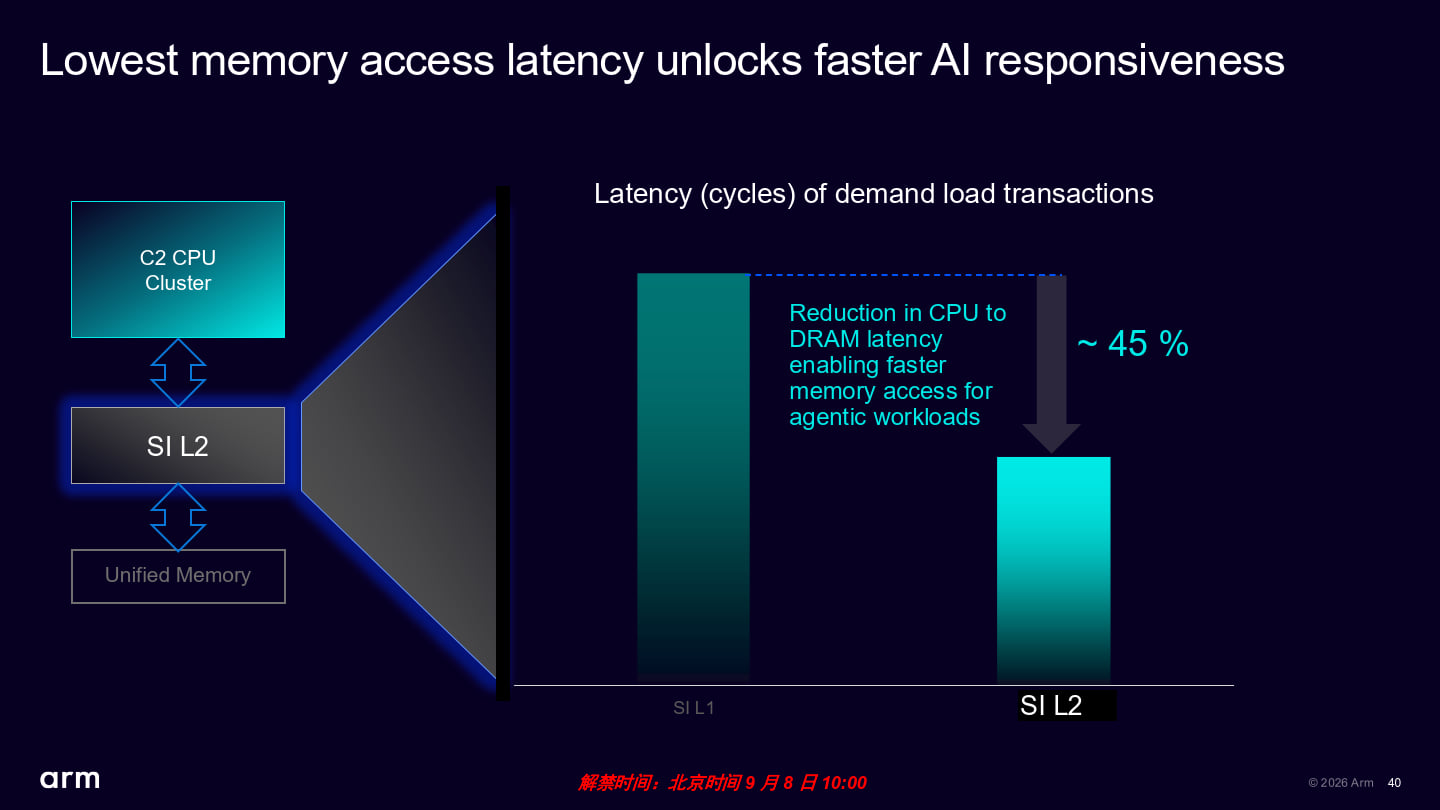
做為CPU與統一架構記憶體中介的SI L2系統互連,能在執行代理式AI時降低45%記憶體延遲,有助於改善效能表現。

Arm也推出AI Portal工具,不但提供預先最佳化模型以及範例程式,也具有代理式AI效能最佳化工具。

開發者可以直接使用AI Portal提供針對SME2、NX GPU、Ethos-U NPU等運算單元最佳化的模型,也可以自行針對不同軟硬體使用情境微調。

整體而言,CSS for Mobile 2帶來最高1.7倍代理式AI效能與4倍遊戲FPS效能,並透過完整軟、硬體堆疊協助生態系夥伴加速AI部署。

在這篇文章中瞭解CSS for Mobile 2的特色後,筆者也會在後續文章中繼續介紹C2-Ultra、C2-Pro等CPU以及G2-Ultra NX GPU,請讀者參考下方目錄繼續閱讀。

Arm Tech Day 2026系列文章目錄
CSS for Mobile 2帶來全新C2-Ultra CPU、G2-Ultra NX GPU,強化手機代理式AI與主機級光線追蹤遊戲體驗(本文)
C2-Ultra CPU進化支援台積電2奈米製程,強化更接地氣的代理式AI助手功能(工作中)
G2-Ultra NX GPU搭配多種神經繪圖升頻技術,在2 W功耗條件下帶來電腦級遊戲體驗(工作中)

加入T客邦Facebook粉絲團

NVIDIA DLSS 5神經渲染效能實測:畫質有感提升但FPS效能砍半

2026年9月4日 14:00
NVIDIA在DLSS 5升頻技術中導入神經渲染功能,可以透過AI圖像生成的方式強化遊戲的紋理與光影等影像細節,讓我們一起來看看它的效果並實測對效能的影響。8a94f70761065402267bd71c4db82ae8

NVIDIA在DLSS 5升頻技術中導入神經渲染功能,可以透過AI圖像生成的方式強化遊戲的紋理與光影等影像細節,讓我們一起來看看它的效果並實測對效能的影響。

(本文使用之《NBA 2K27》序號由NVIDIA提供)

AI幫你開美肌

NVIDIA DLSS是款結合多樣AI與機器學習的升頻技術,能夠提供提升遊戲FPS效能以及強化畫質的效果。在最新推出DLSS 5除了延續先前既有的超解析度(Super Resolution)與畫格生成(Frame Generation)等功能之外,還加入了全新的神經渲染(Neural Rendering)功能,透過AI演算法生成畫面上指定物件或區域的材質紋理與光照效果。更詳細的解說請參考下方專題報導。

延伸閱讀:
NVIDIA DLSS 5技術解析:不再只是效能禁藥,AI美肌強化紋理與光影效果
玩遊戲不再有鬼影!NVIDIA 推出 DLSS 4.5 光線重建功能 全系列 RTX 顯卡都能戰
NVIDIA DLSS 4.5光線重建實測,強化光線追蹤畫質效能不打折

筆者使用《NBA 2K27》進行實際測試,分析神經渲染帶來的畫質提升,以及所產生的效能衝擊。在畫質部分,透過Steam內建的擷圖功能擷取重播模式中的遊戲畫面,並開、關神經渲染功能進行對比。效能則是使用NVIDIA FrameView工具測量30秒遊戲進行中的FPS數據,測試2輪並確認沒有極端值之後,以取平均作為成績。

測試平台:
處理器:AMD Ryzen 7 9800X3D
散熱器:MSI MEG Coreliquid S360
主機板:ASRock X870E Taichi(UEFI版號:4.03.TS04 – AMD AGESA ComboAm5PI 1.2.7.1)
記憶體: G.Skill Trident Z5 Neo RGB 16GBx2(@DDR5-7200)
顯示卡:NVIDIA GeForce RTX 5090 Founders Edition
儲存裝置:Samsung 9100 Pro 1TB(系統碟)、Solidigm P41 Plus 1TB(遊戲碟)
電源供應器:MSI MEG Ai1300P PCIE5
軟體環境:Windows 11專業版25H2(Build 26200.9168),GeForce Game Ready 616.64測試版

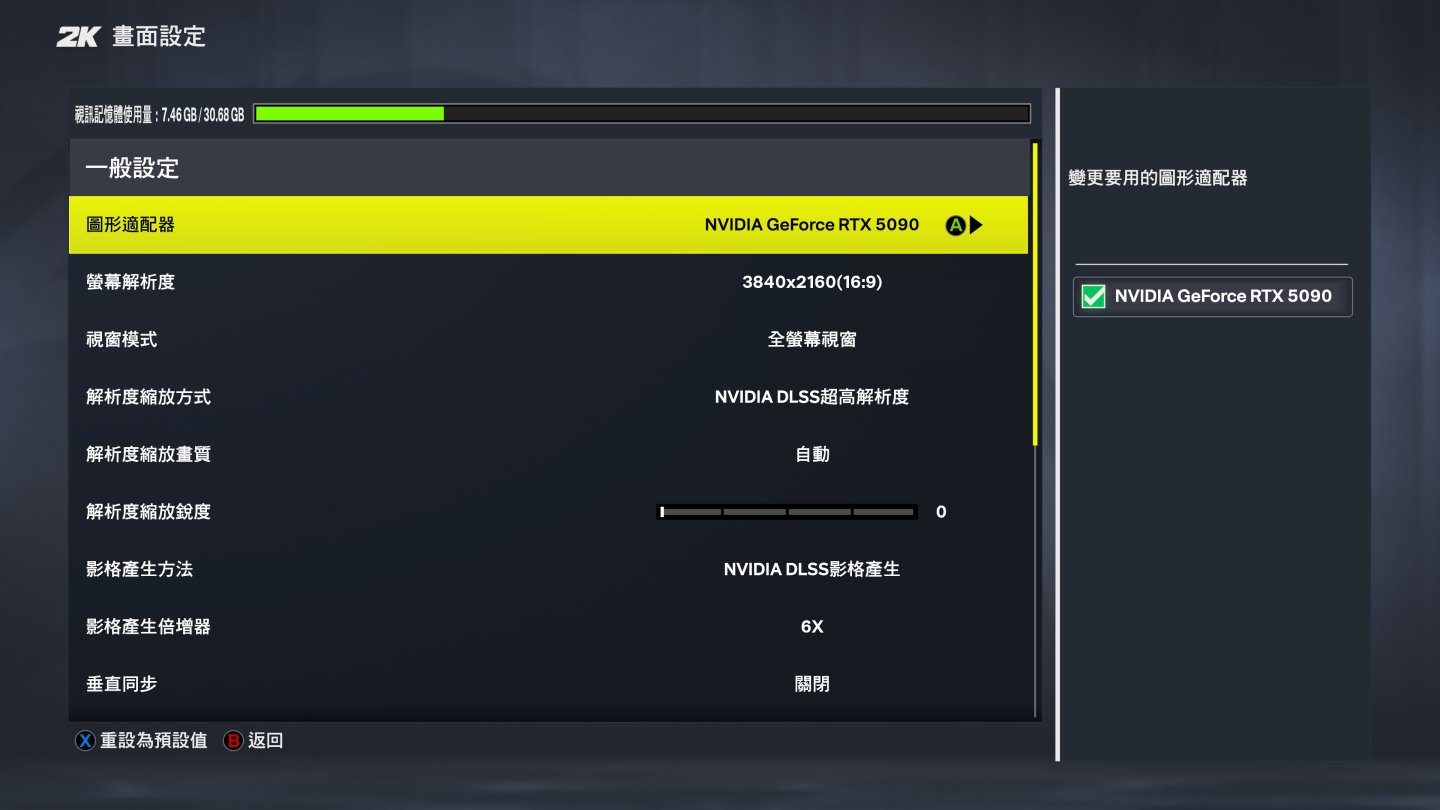
▲《NBA 2K27》是款以NBA美國職業籃球為主題的體育遊戲,提供籃球之城、MyCAREER、MyTEAM等多種遊戲模式。

測試平台使用AMD Ryzen 7 9800X3D處理器搭配NVIDIA GeForce RTX 5090 Founders Edition顯示卡。

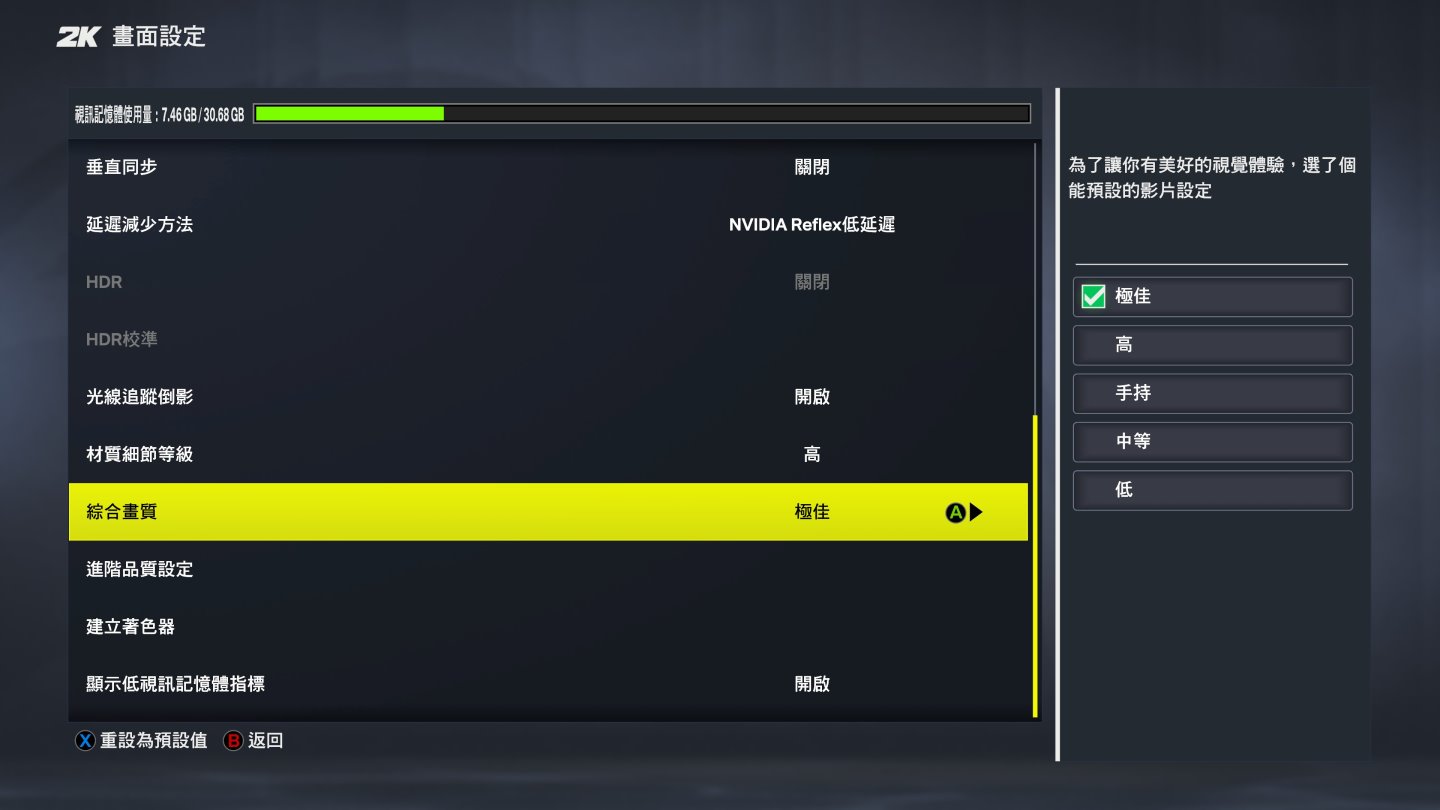
測試過程開啟光線追蹤功能並設定為最高畫質設定。

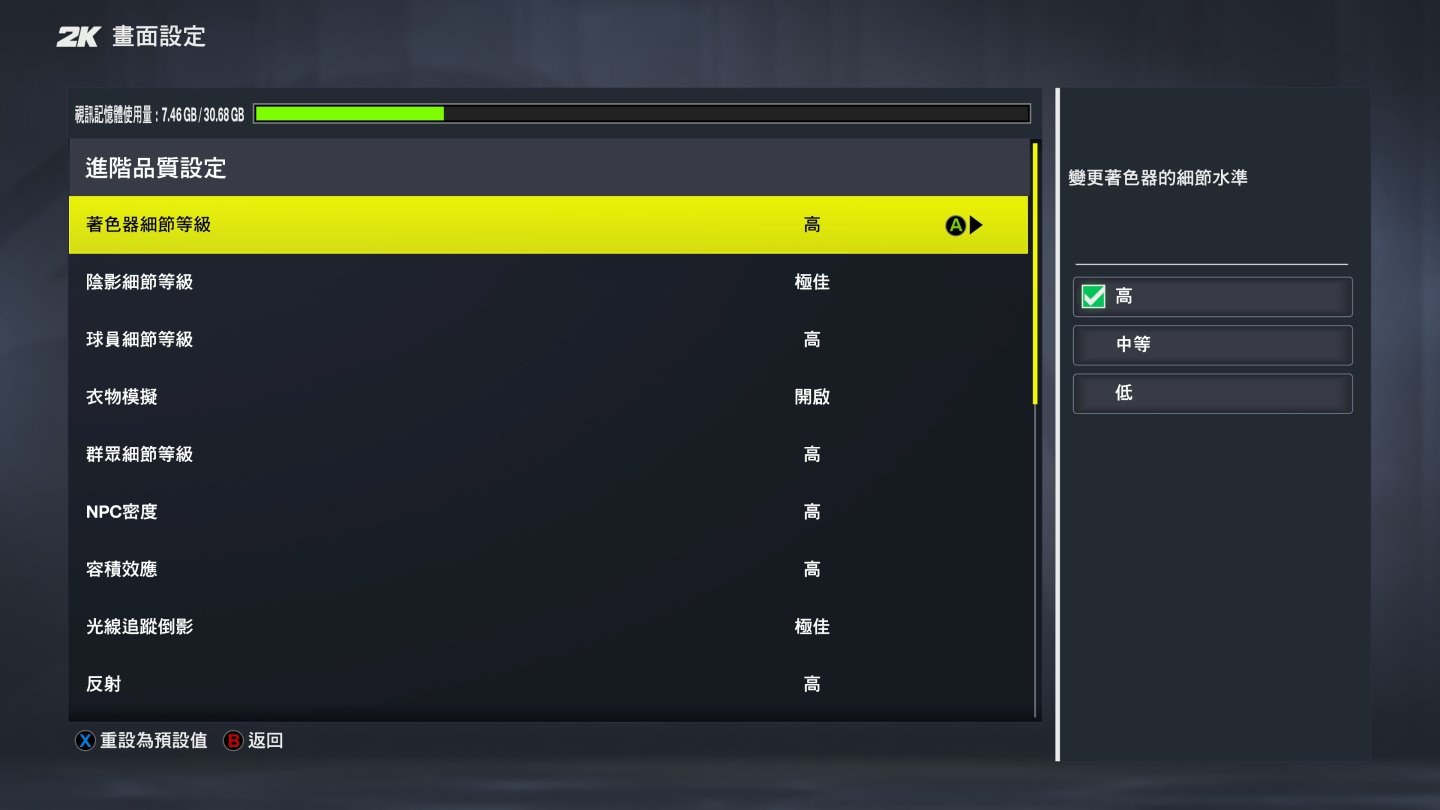
在進階品質設定中,將所有設定選項都調整至最高。

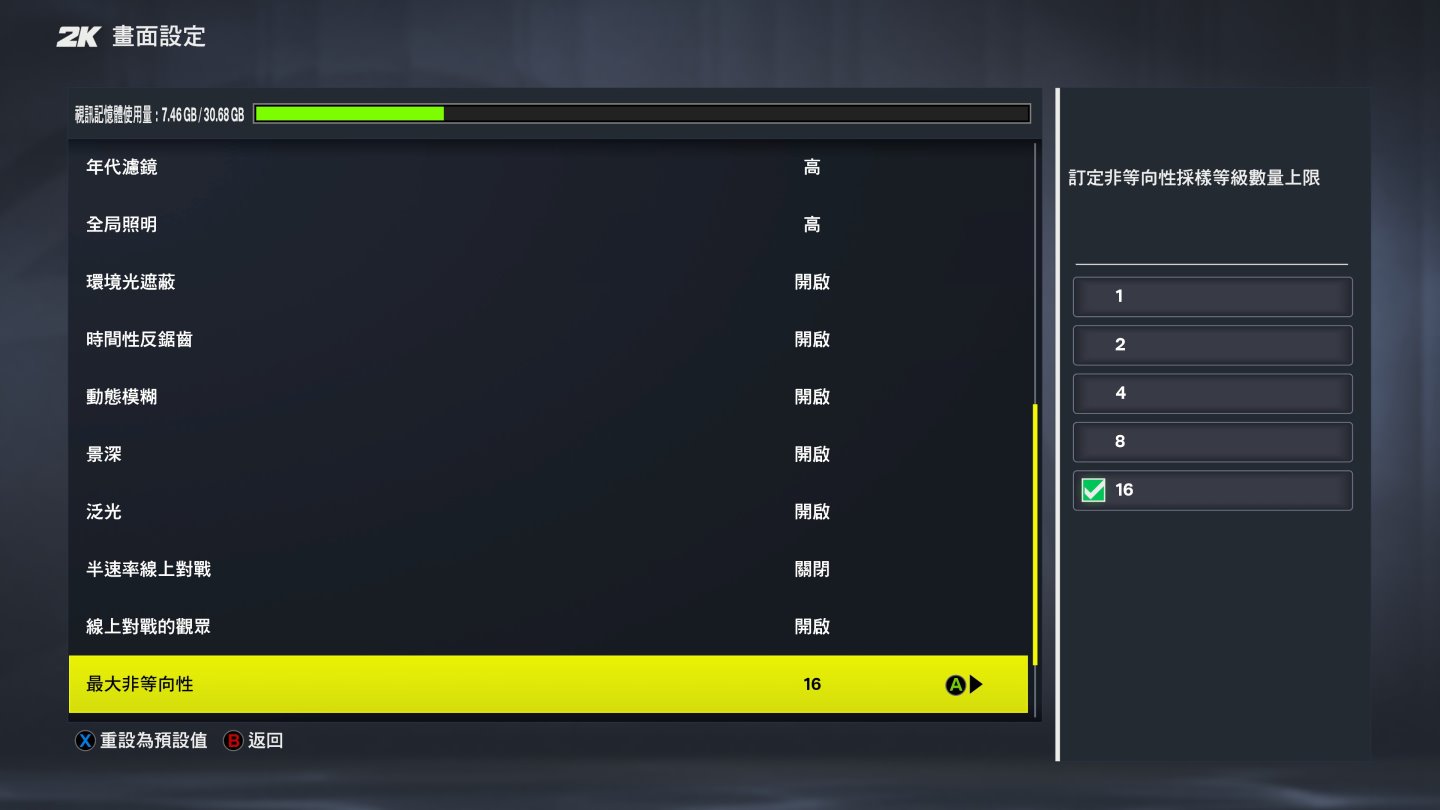
進階品質設定之二,同樣調整至最高。

神經渲染效能實測

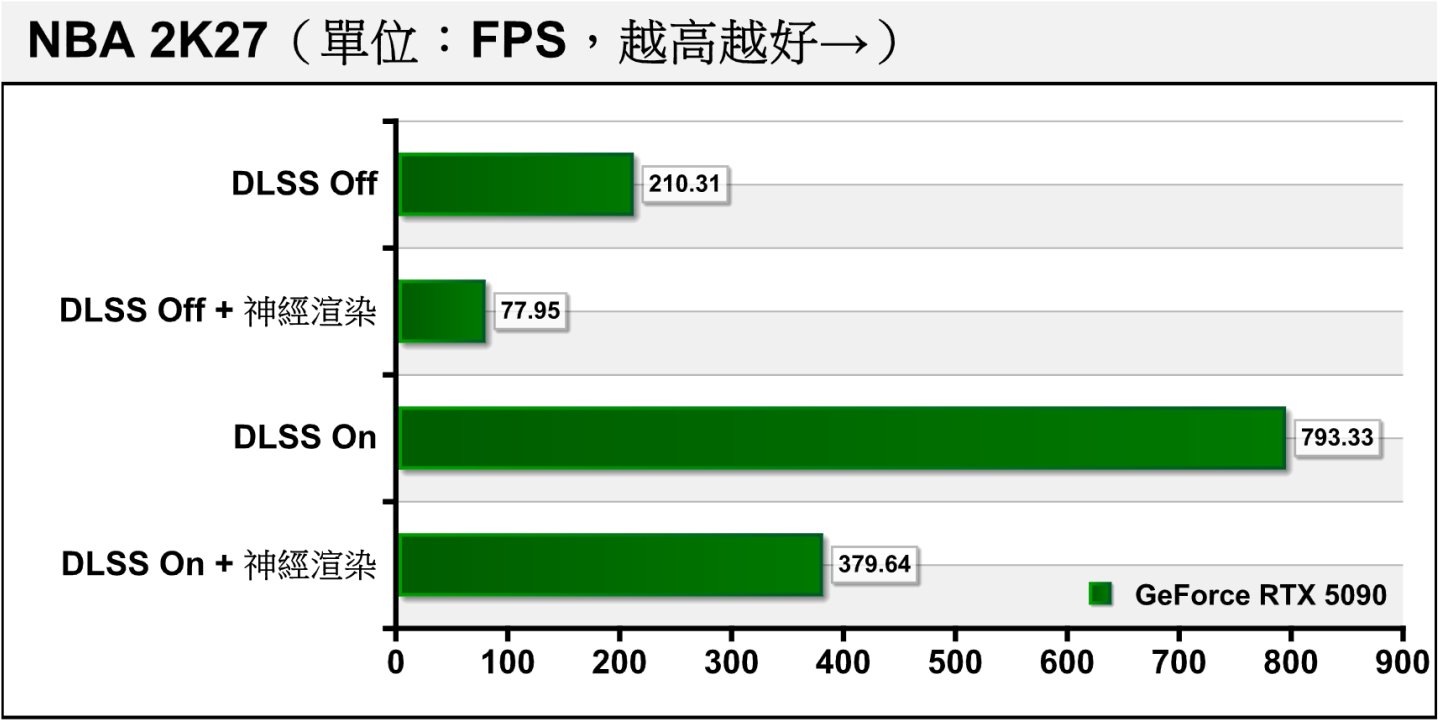
在測試過程中,筆者分別針對開、關超解析度(畫質設定為自動)與多重畫格生成(6X),以及是否啟用神經渲染(Neural Rendering)進行效能測試。並以圖片呈現在開啟超解析度與畫格生成的情況下,神經渲染造成的畫質差異。

值得注意的是,雖然開啟神經渲染會損失大約一半的FPS效能,但是在超解析度、畫格生成的協助下,遊戲的平均FPS仍達379.64幀,已經高於許多顯示器的規格,與其關閉神經渲染讓平均FPS衝上793.33幀,將多餘的效能轉換為肉眼可以分辨的畫質提升,也不失為改善遊戲體驗的方式。

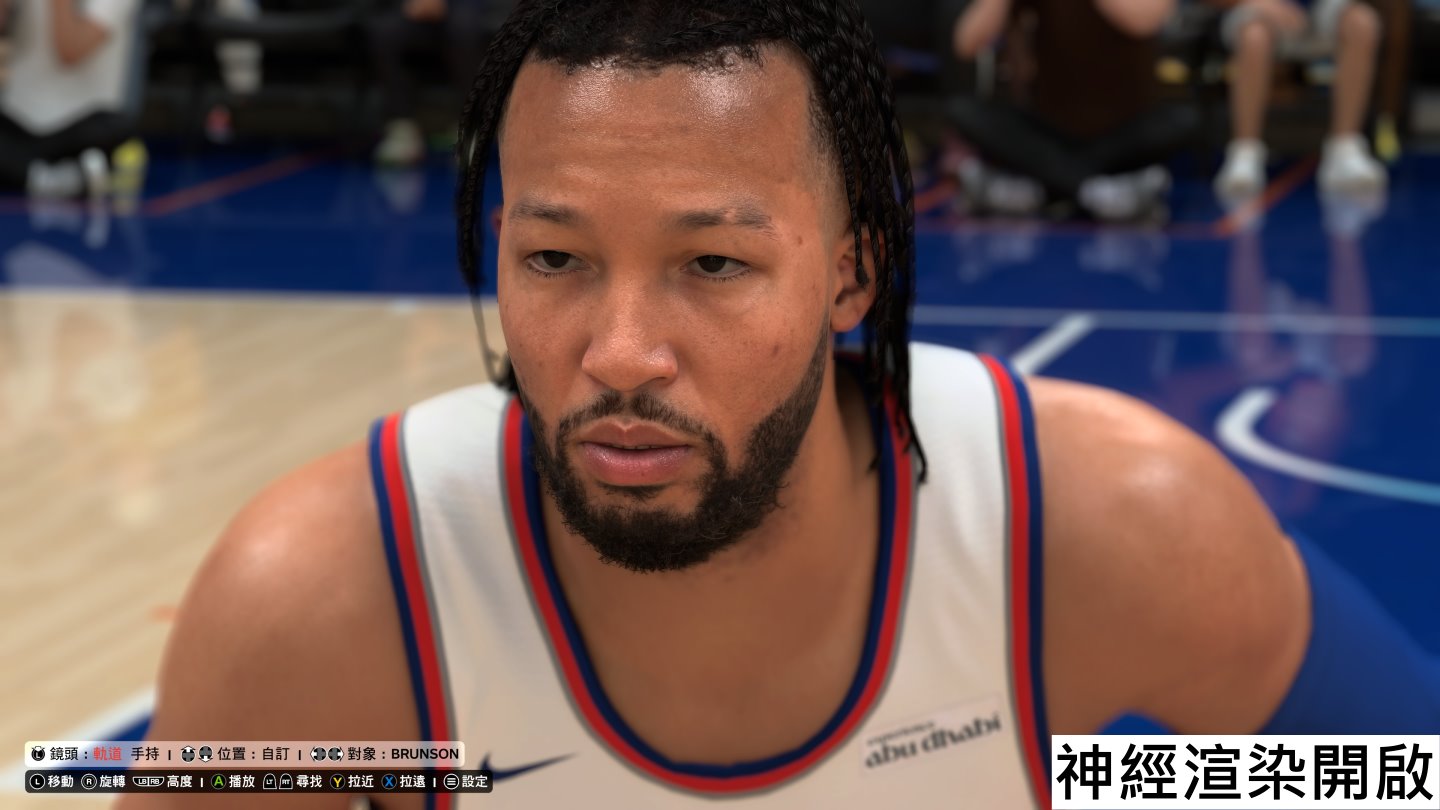
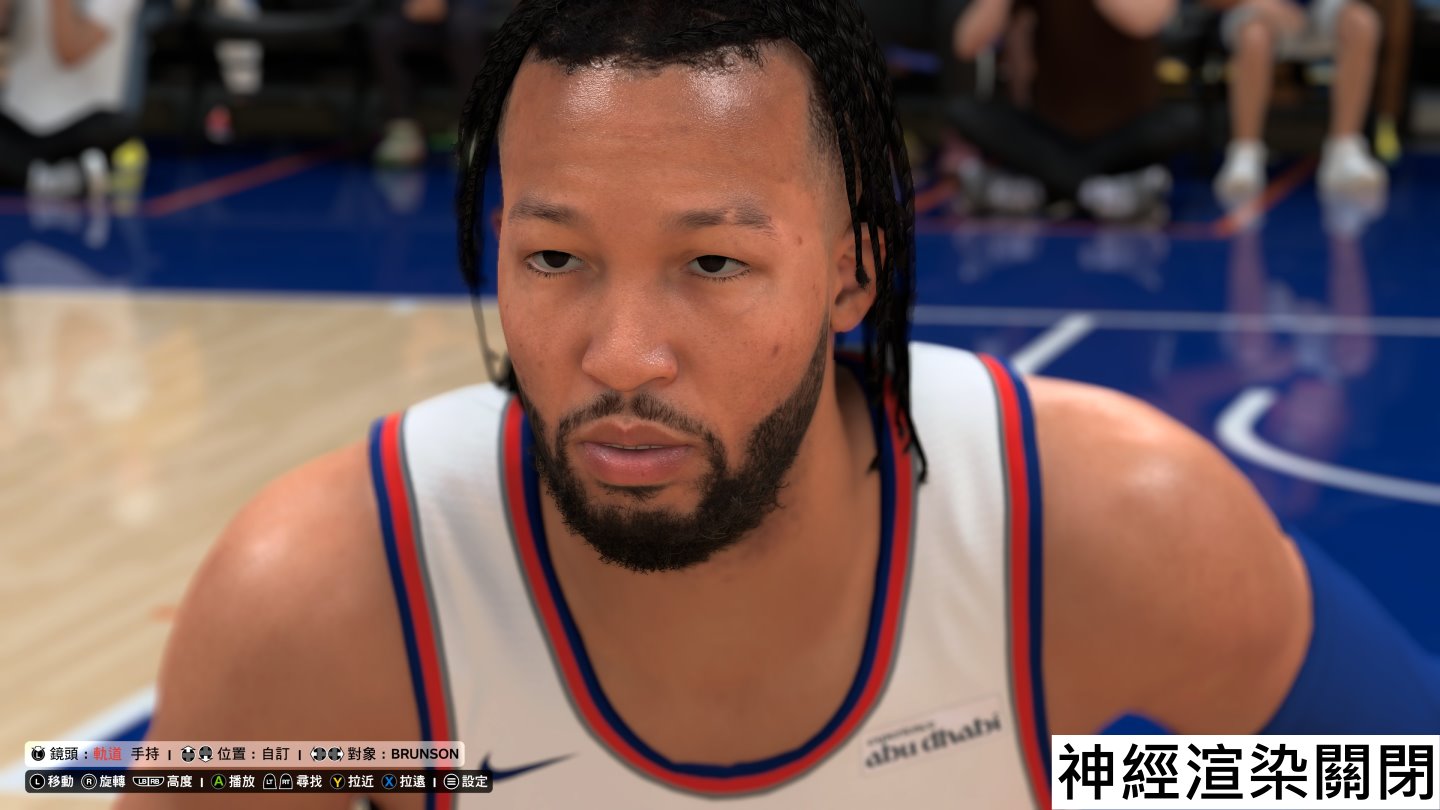
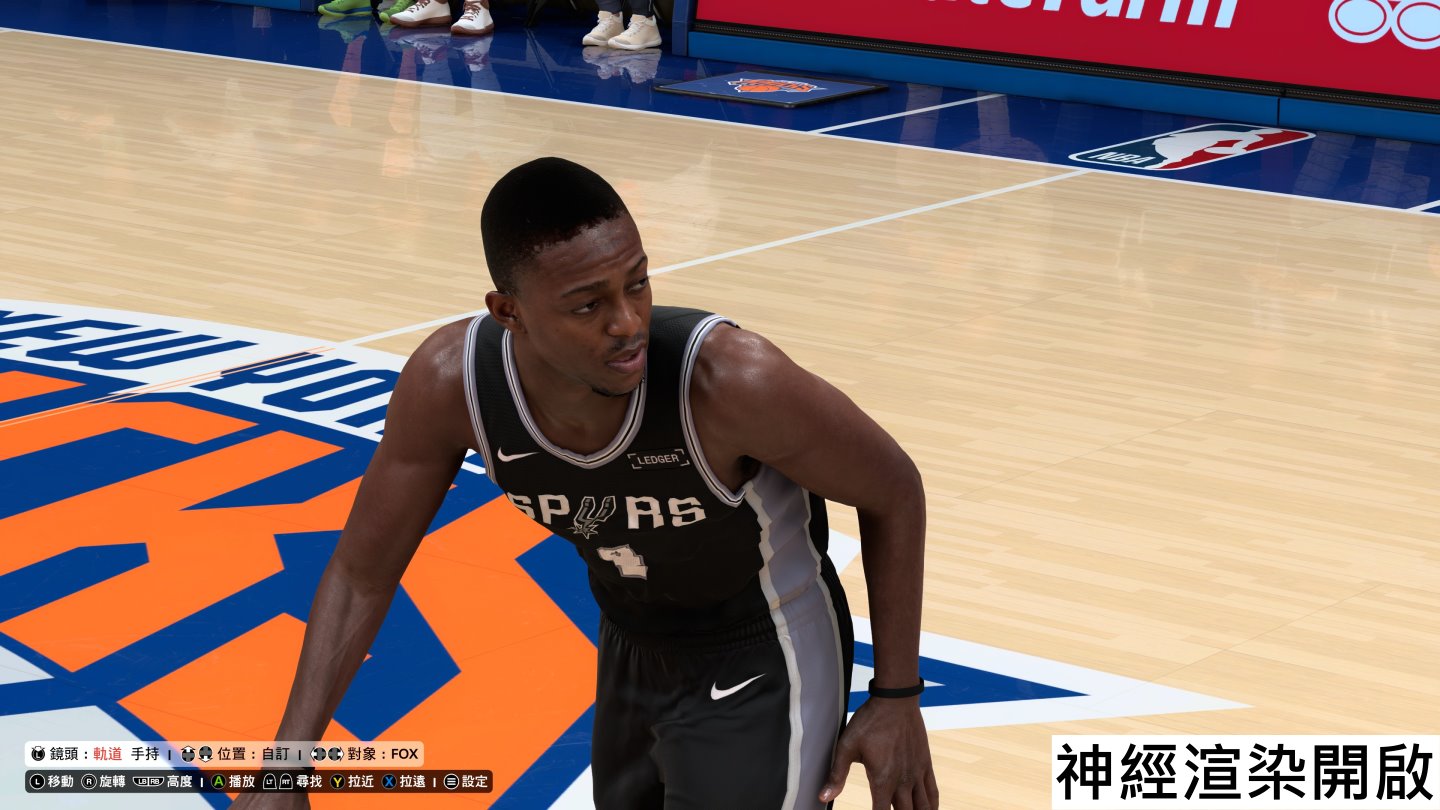
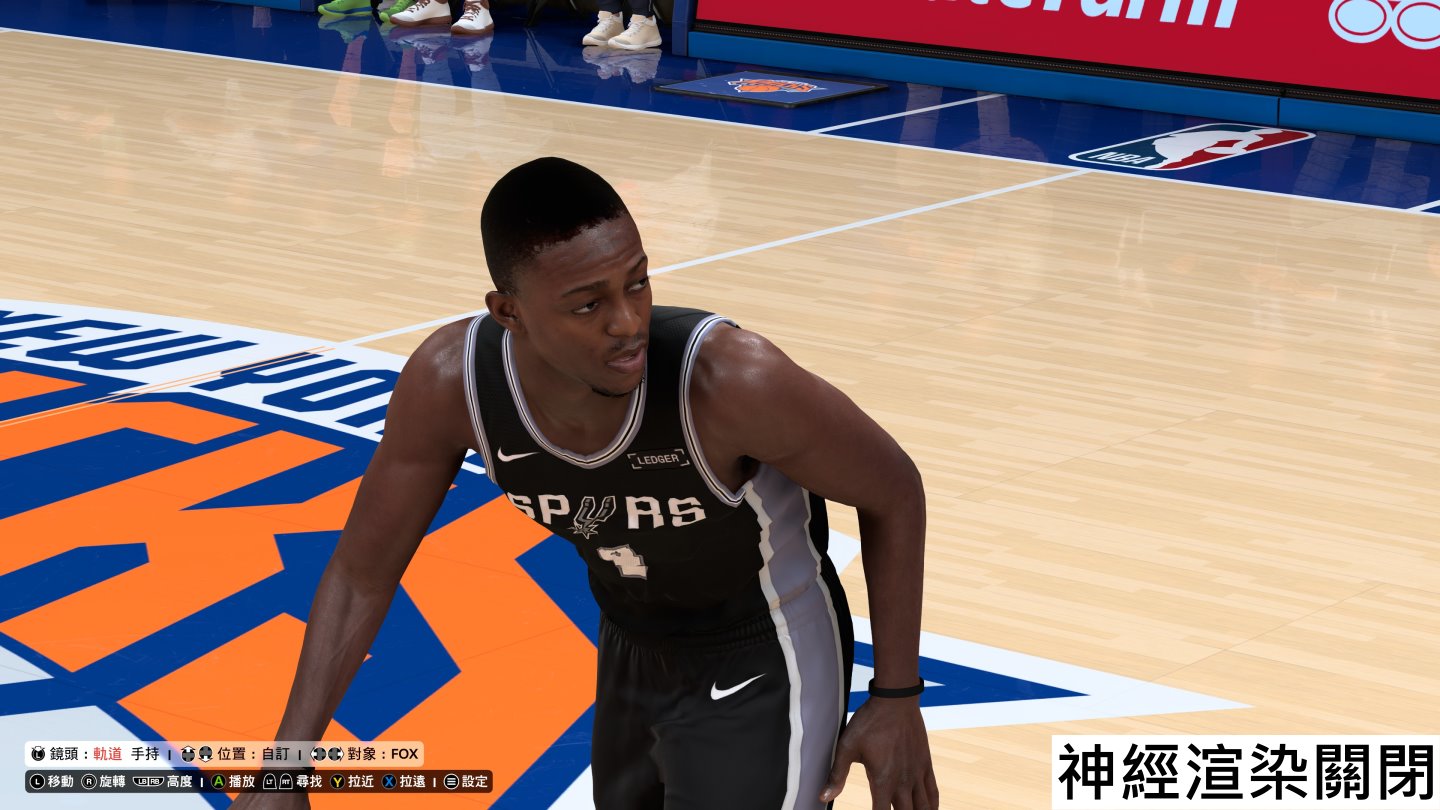
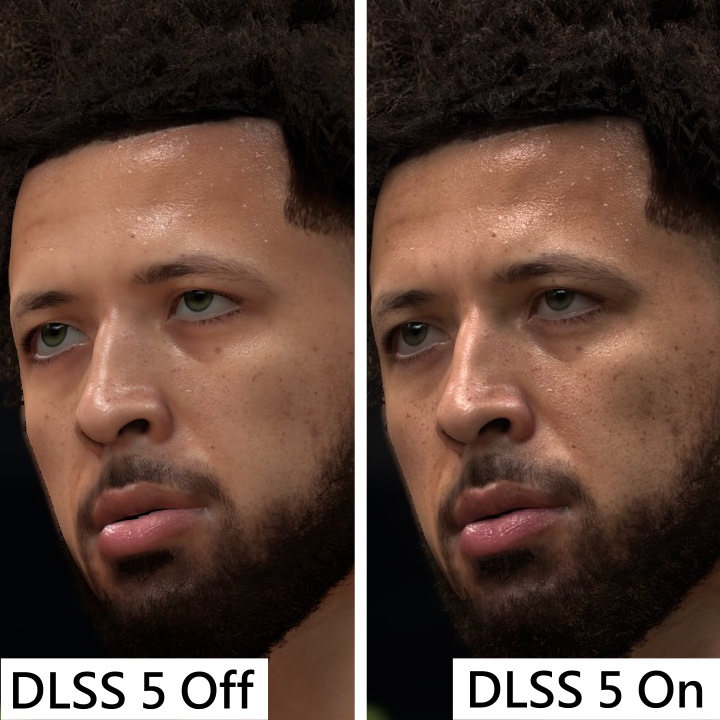
開啟神經渲染之後,人物皮膚、頭髮、鬍鬚等紋理以及光影等細節都有明顯提升。

在關閉神經渲染的時候,人物的細膩度有明顯差異。

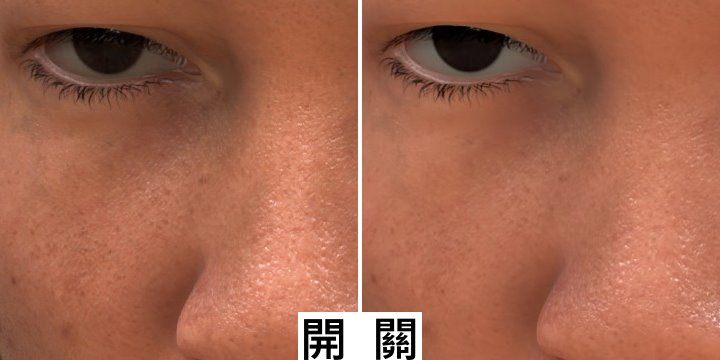
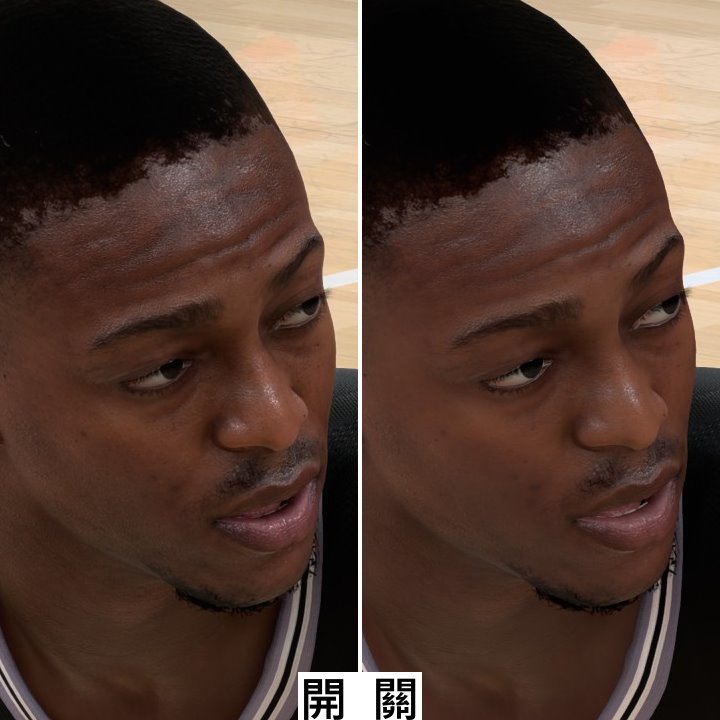
使用1:1方式裁切圖片,可以看到皮膚毛孔紋理的差異。

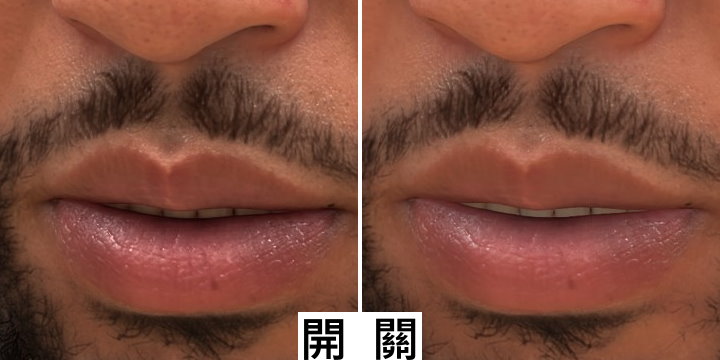
鬍鬚、嘴唇的差異也是肉眼就能分辨。

接著看另一個範例,可以將觀察重點放在整體的光影感受。

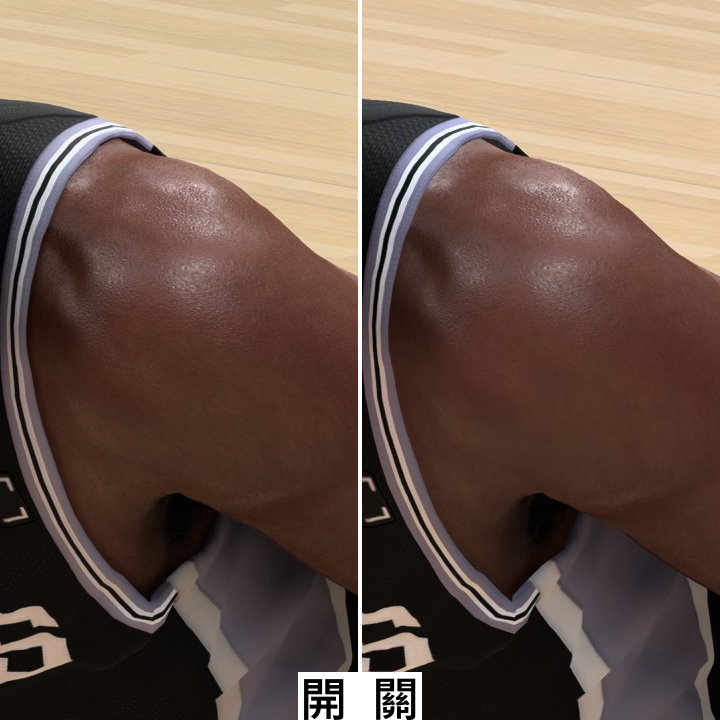
開、關神經渲染之間,可以看到AI模型修釋光影的效果。

開啟神經渲染後,額頭與嘴唇等部分的光線反射感覺更生動。

手臂部分的汗水反光感覺也比較真實。

在DLSS超解析度(自動)與多重畫格生成(6X)的加持下,關閉神經渲染的平均FPS效能可達793.33幀。雖然開啟神經渲染後效能驟降52.15%,剩下大約一半,但是仍有379.64幀,足以呈現流暢的視覺體驗。

如同筆者在技術解析專題中講到的,神經渲染不像超解與畫格生成等功能只需在遊戲引擎或開發工具中開啟、導入,就能明顯提高FPS效能。神經渲染更加依賴遊戲開發者與美術人員針對遊戲的畫面風格調整AI模型與參數,才能達到比較理想的視覺效果,不但代表著會提高開發商所投入的人力資源與成本,也可能會降低導入意願。

另一方面,目前如AMD與Intel等其他廠牌的繪圖處理器(GPU)並不支援神經渲染,日後就算加入此功能也可能與NVIDIA的技術不相容,造成遊戲導入神經渲染後,僅能在搭載GeForce RTX顯示卡的電腦上啟用該功能,而在其他顯示卡、遊戲主機上則無法使用,對續遊戲導入神經渲染的普及度也是一項挑戰。

目前神經渲染功能僅相容於GeForce RTX 50系列顯示卡,且對FPS效能的衝擊較大。NVIDIA表示DLSS 5是至今運算需求最高的模型,自2026年3月公布以來已將效能提升至原本的5 倍,後續將持序進行最佳化,預計於秋季稍晚推出針對GeForce RTX 50系列顯示卡的模型更新,隨後也會著手進行GeForce RTX 40 系列顯示卡的官方支援。

加入T客邦Facebook粉絲團

NVIDIA DLSS 5技術解析:不再只是效能禁藥,AI美肌強化紋理與光影效果

2026年9月1日 21:00
繼日前NVIDIA推出DLSS 4.5升頻技術後,這次則是進一步推出包含神經渲染功能的DLSS 5,並宣佈功能將於2026年9月3日正式推出。99973316472c62b6824349b9b5fe4080


繼日前NVIDIA推出DLSS 4.5升頻技術後,這次則是進一步推出包含神經渲染功能的DLSS 5,並宣佈功能將於2026年9月3日正式推出。

以圖生圖方式進行AI推論渲染

回顧過去第1至4代DLSS技術主要功能為超解析度(Super Resolution)與畫格生成(Frame Generation),前者為降低遊戲實際繪製的解析度,並透過AI演算法將解析度提高,舉例來說以1920 x 1080解析度繪製遊戲畫面,並以DLSS技術提升至3840 x 2160後再輸至螢幕,而後者則是參考1幀實際繪製的畫格,並透過AI演算法產生最多5幀生成畫格,舉例來說能讓原本FPS為20幀的畫面提升至120幀,這2項功能都能大幅改善遊戲的FPS效能與視覺流暢度。更多DLSS的技術說明請參考下列文章。

延伸閱讀:
玩遊戲不再有鬼影!NVIDIA 推出 DLSS 4.5 光線重建功能 全系列 RTX 顯卡都能戰
【CES 2026】NVIDIA發表DLSS 4.5效能禁藥,第2代超解析度Transformer模型、6X多重動態畫格生成,強化遊戲畫質與效能
【CES 2025】 - NVIDIA編輯日(下):RTX 50系列顯示卡獨有DLSS 4多重畫格生成超級效能禁藥與Reflex低延遲技術

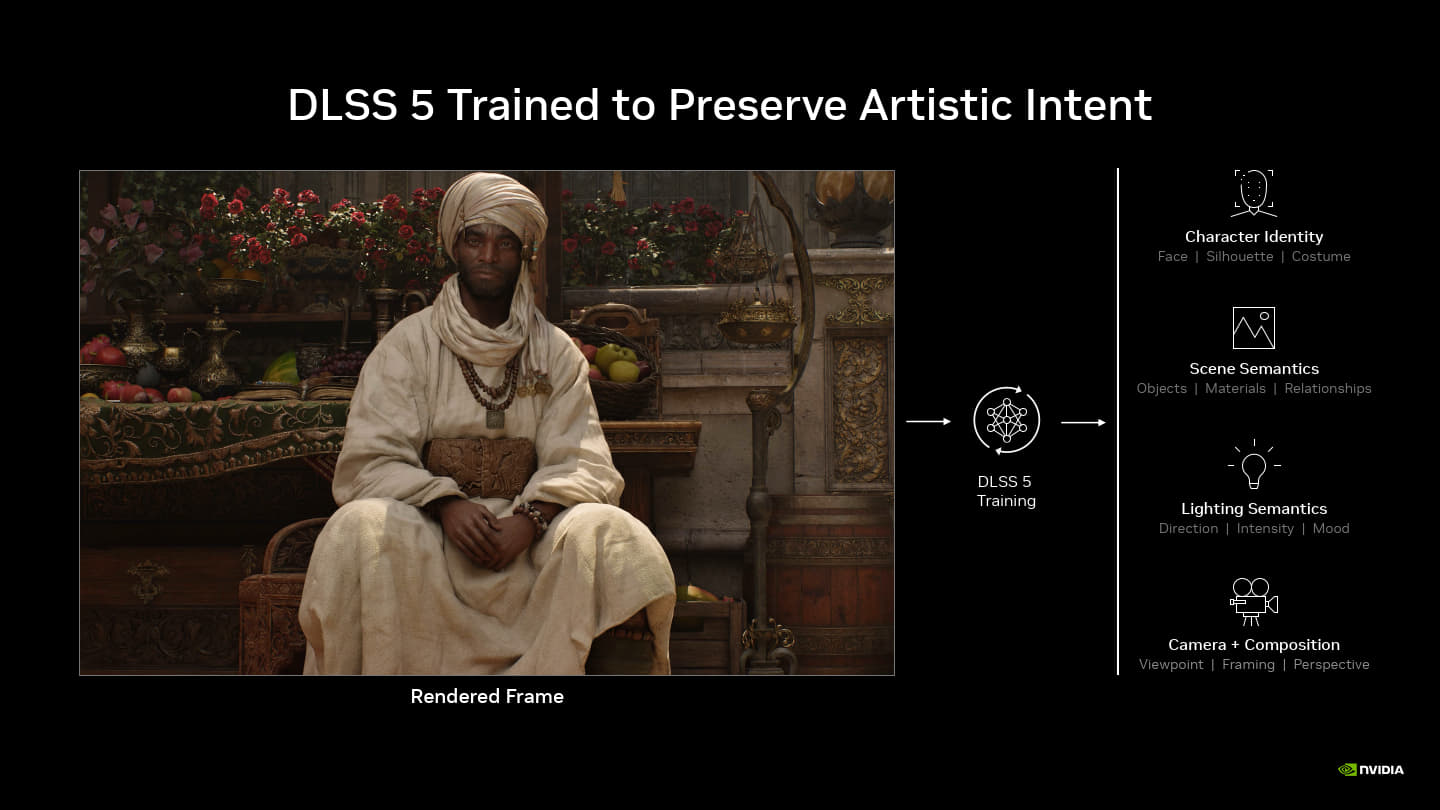
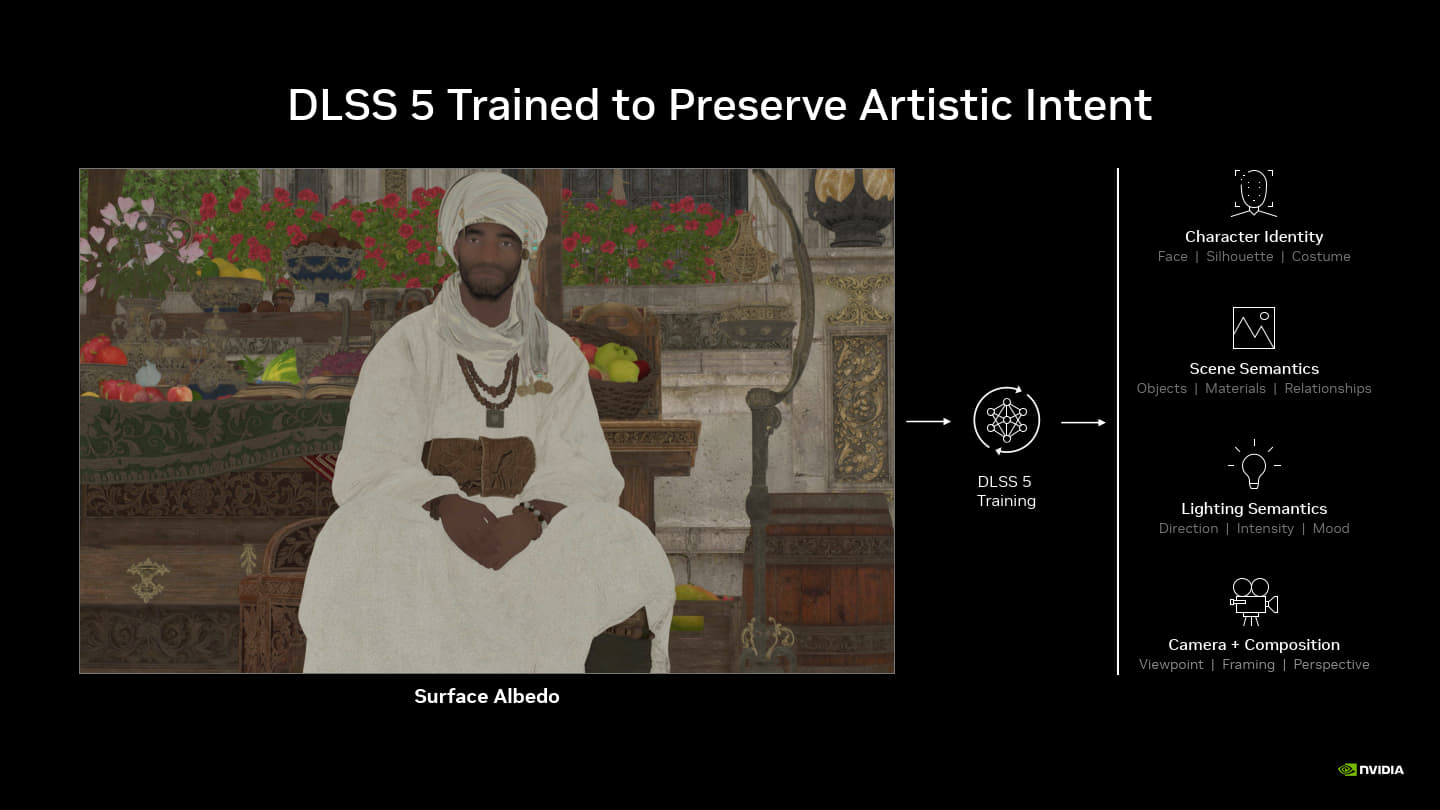
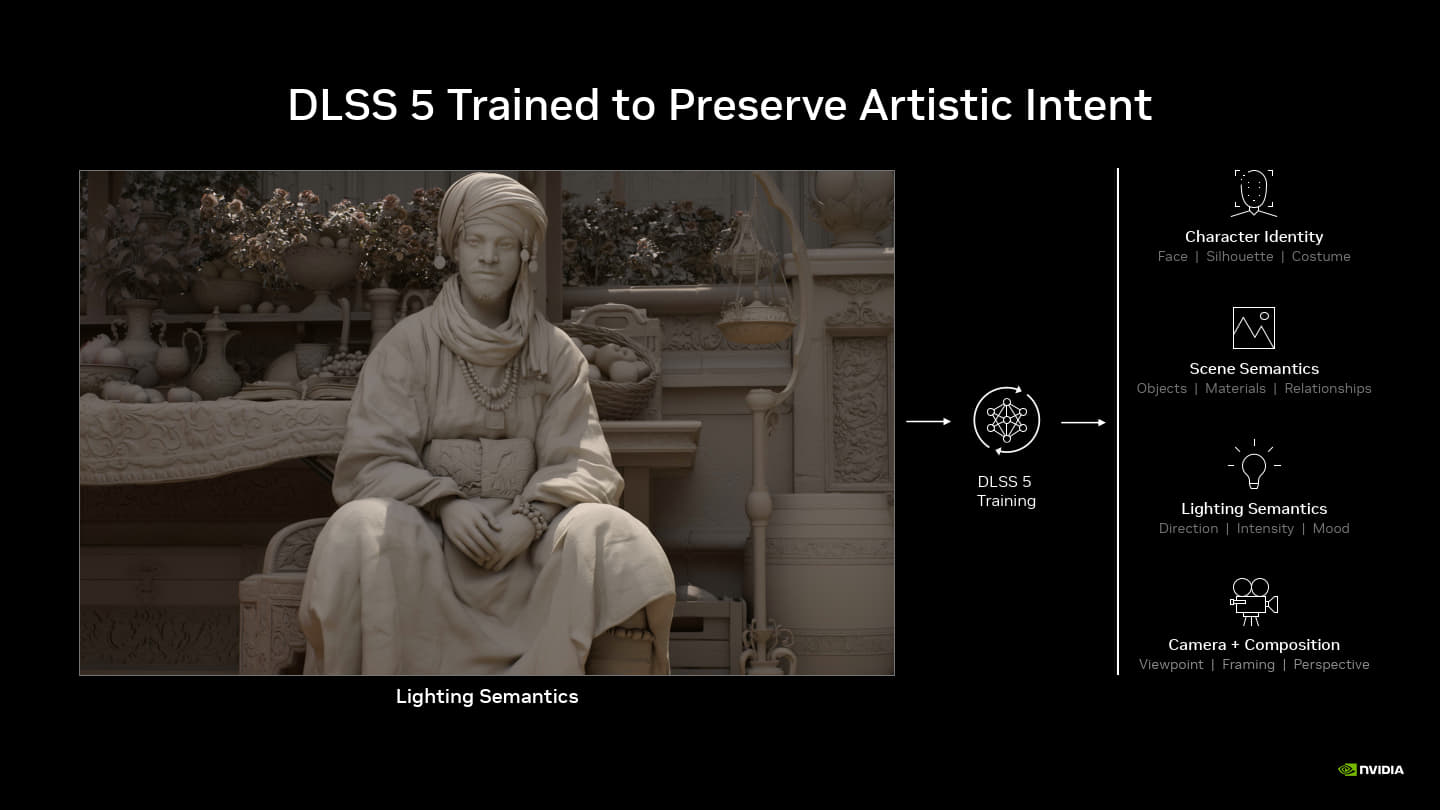
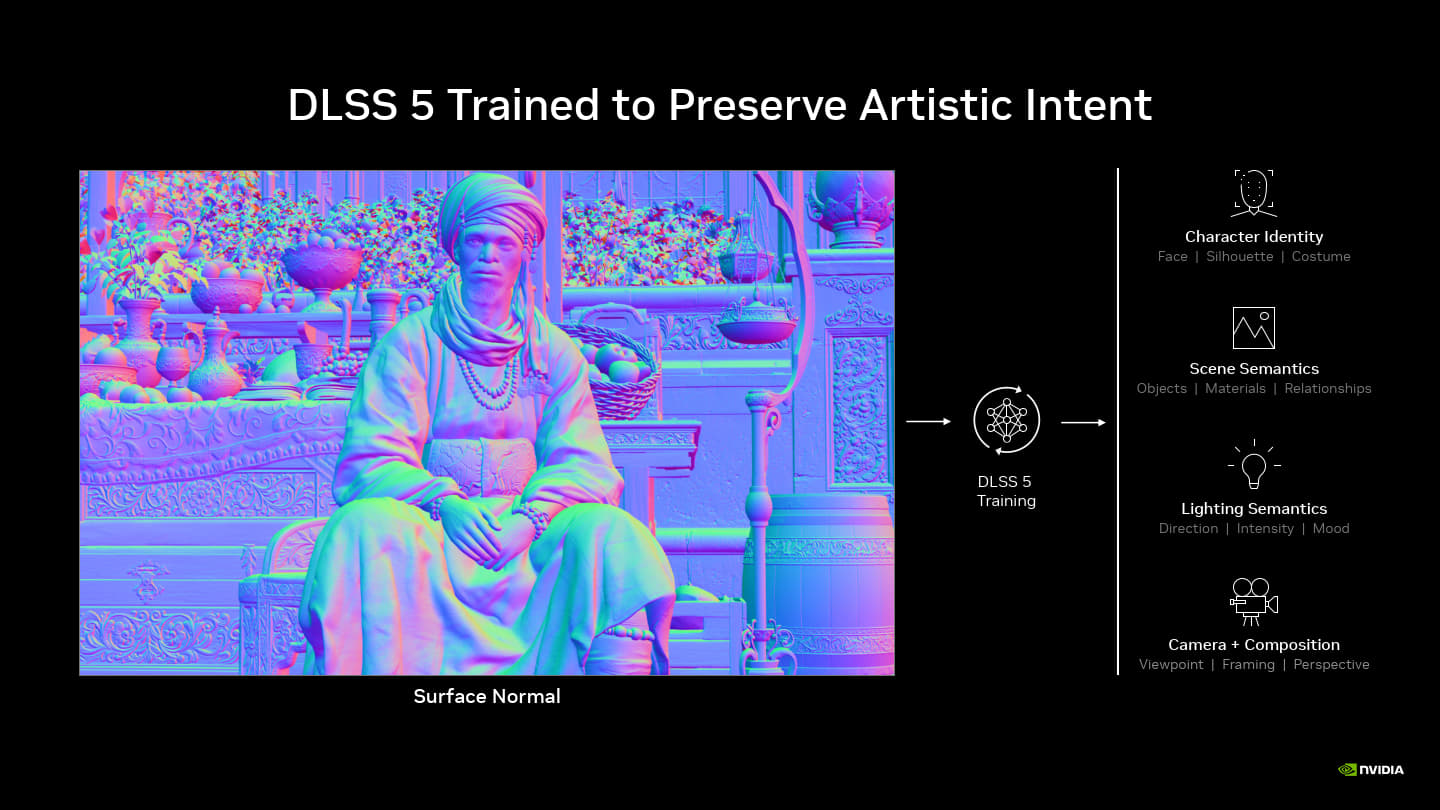
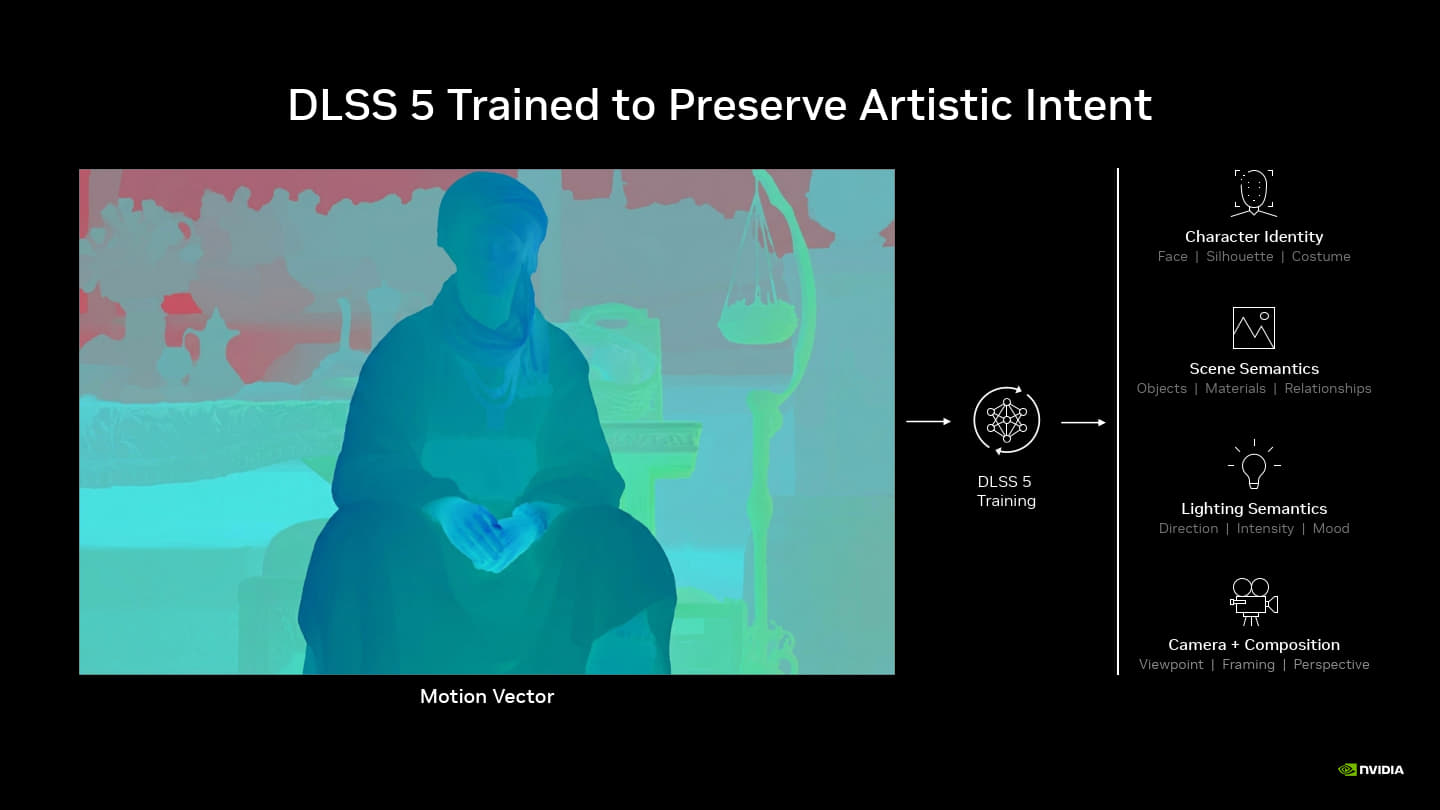
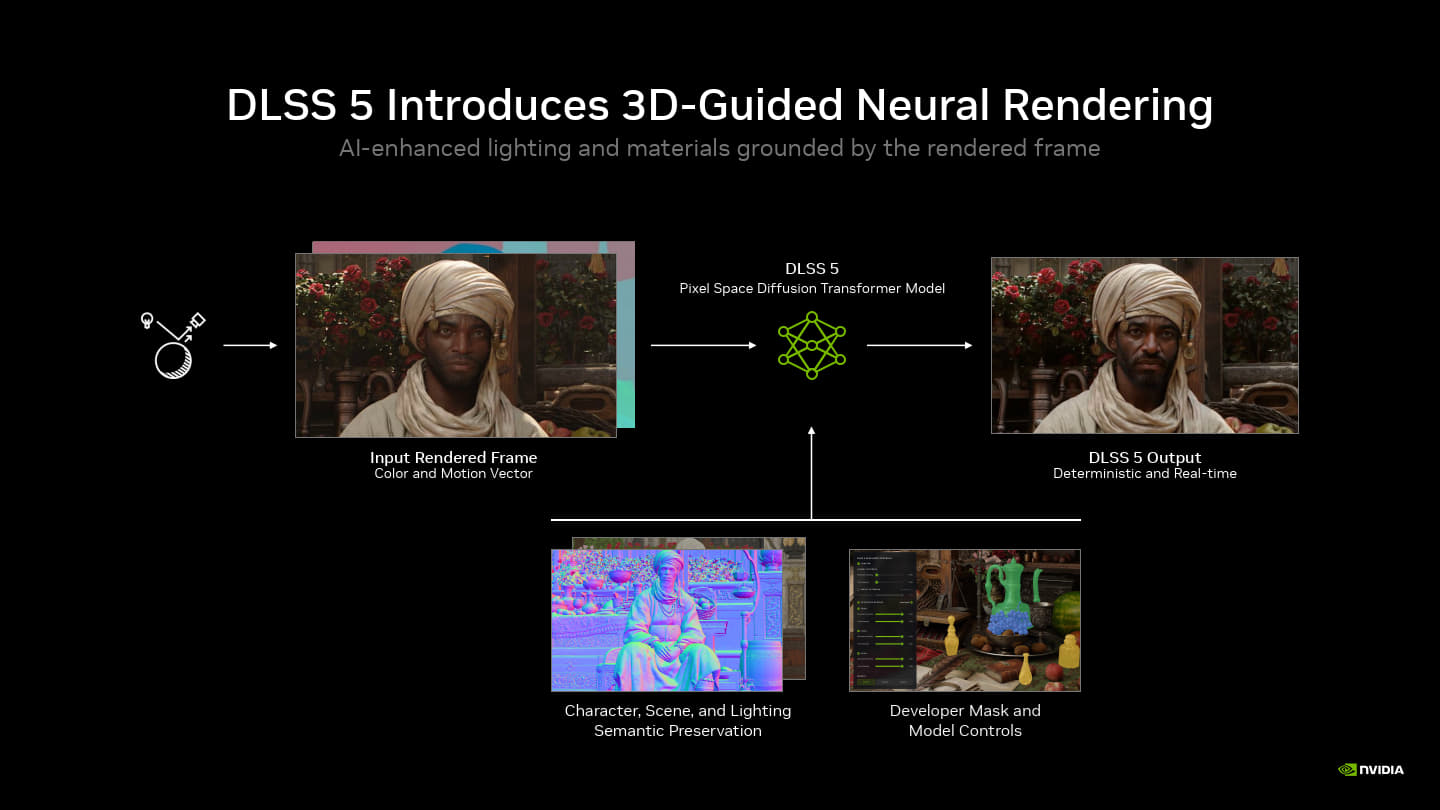
DLSS 5除了延續先前既有功能之外,還加入了全新的神經渲染(Neural Rendering)功能,透過AI演算法生成畫面上指定物件或區域的材質紋理與光照效果。它的概念比較類似使用AI圖像生成的「圖生圖」(Image to Image)功能,能夠先讓遊戲引擎繪製紋理與光影較為粗糙的「3D草稿」,然後再讓AI模型參考草稿搭配遊戲引擎提供表面反射率(Surface Albedo)、光照資訊、表面法線、動態向量等資訊,生成具有更細緻肌膚紋理、布料材質、光影反射等要素的圖像,在透過「美肌修圖」方式強化逼真度與視覺效果的同時,平衡繪圖運算資源的消耗與效能衝擊。

值得注意的是,當遊戲影引擎能夠提供更多畫面資訊,神經渲染就能生成更理的圖像品質,因此適度提高遊戲畫質並開啟光線追蹤,有助於能帶來最佳畫面品質。

與超解析度不同的是,超解析度的核心概念是降低繪製的解析度以降低運算量,達到提升FPS的效過,本身並不需要介入遊戲開發過程,就能取得理想的效能增益效果。

而神經渲染則更依賴遊戲的美術設計人員在開發過程中調整神經渲染應用的區域與強度,在不同的物件上微調設定參數以取得較理想的視覺體驗,而不是只單純在遊戲開發環境中「啟用 RTX On」。整體而言,神經渲染能在兼顧效能的前提下強化遊戲畫質體驗,但可能會佔用更多人力與成本進行美術設計與調整。

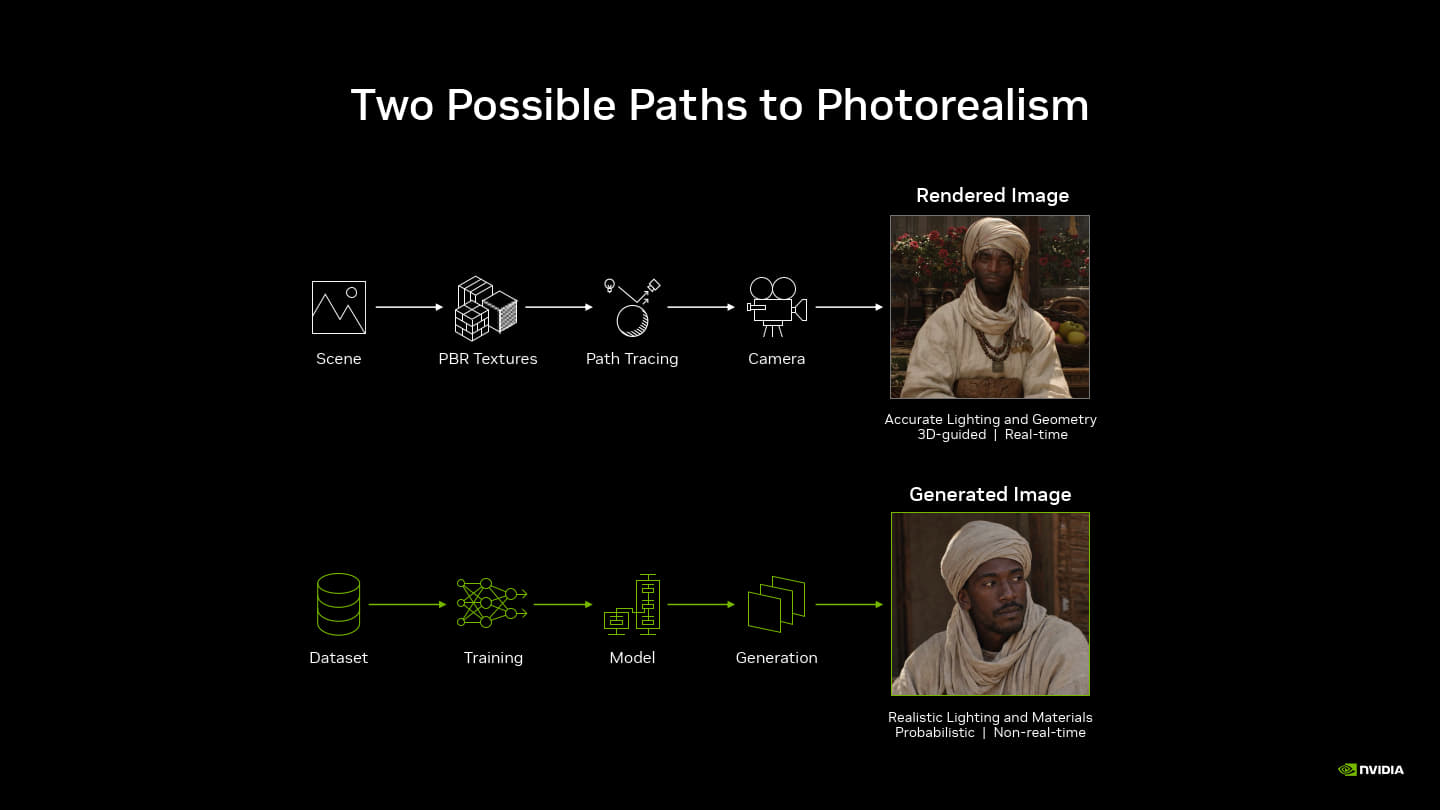
傳統3D繪圖使用光柵化搭配光線追蹤等技術繪製遊戲畫面,AI圖像生成則透以大量資料訓練模型,並使用模型進行推論運算得到圖像。

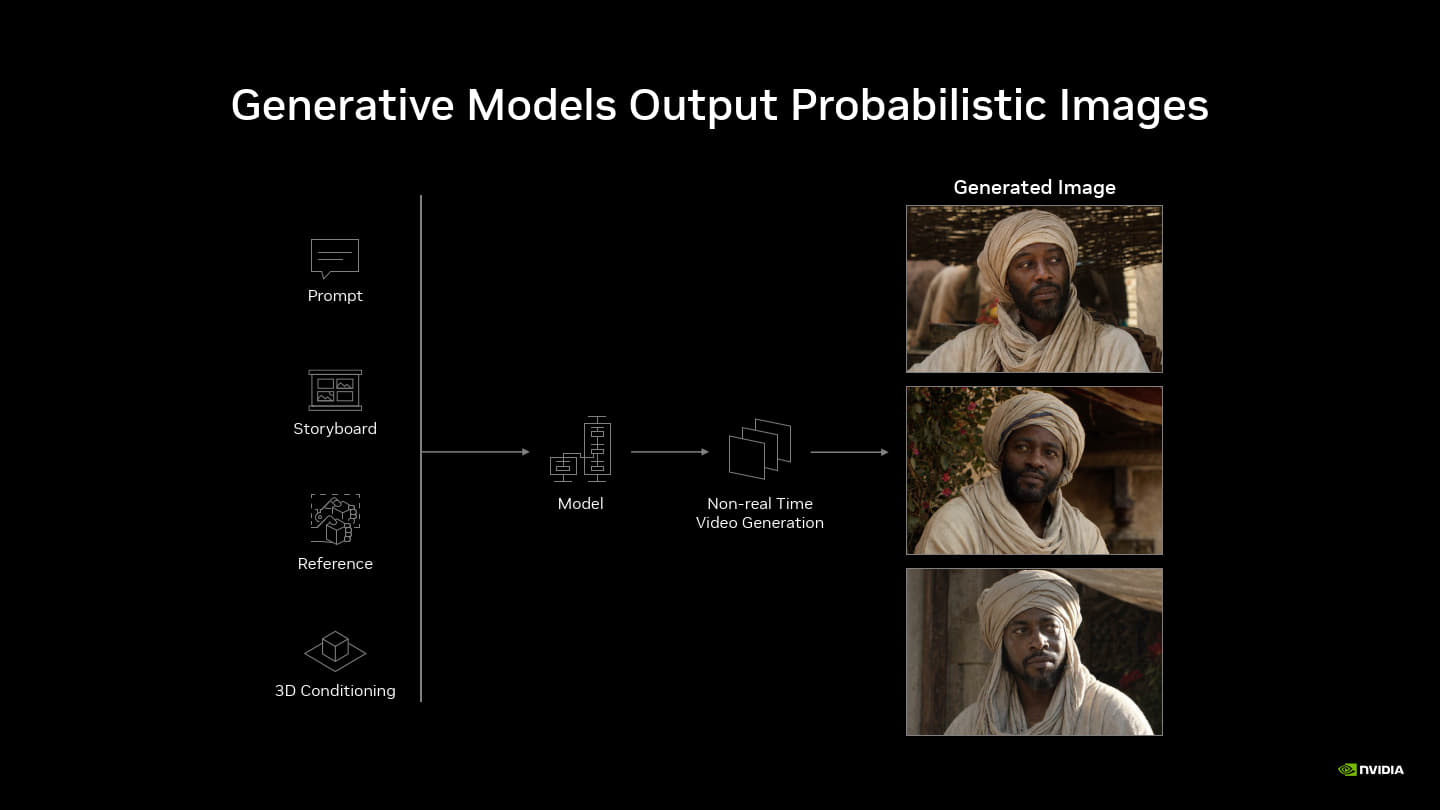
然而AI圖像生成存在一定隨機性,如果單純使用「文生圖」(Text to Image)的方式容易造成生成的角色、物件、背景前後不一致。

DLSS 5神經渲染採用類似「圖生圖」的概念,使用遊戲引擎繪製的圖像為基礎,再讓AI模行進行「美肌修圖」。

除此之外,神經渲染的AI模型還會參考遊戲引擎提供的多種資料強化圖像生成的效果。此範例為表面反射率。

遊戲引擎也會將場景中的光照資訊提供給AI模型參考,以強化光影效果。

場景的表面法線有助於讓AI模型判斷物件表面型狀,以判斷光線反射的方向。

動態向量則記錄物件的移動行為,可以改善生成畫面的動態穩定性。

DLSS 5神經渲染會使用上述多種資訊引導AI模型進行圖像生成,以確保生成圖像的一致性與品質。

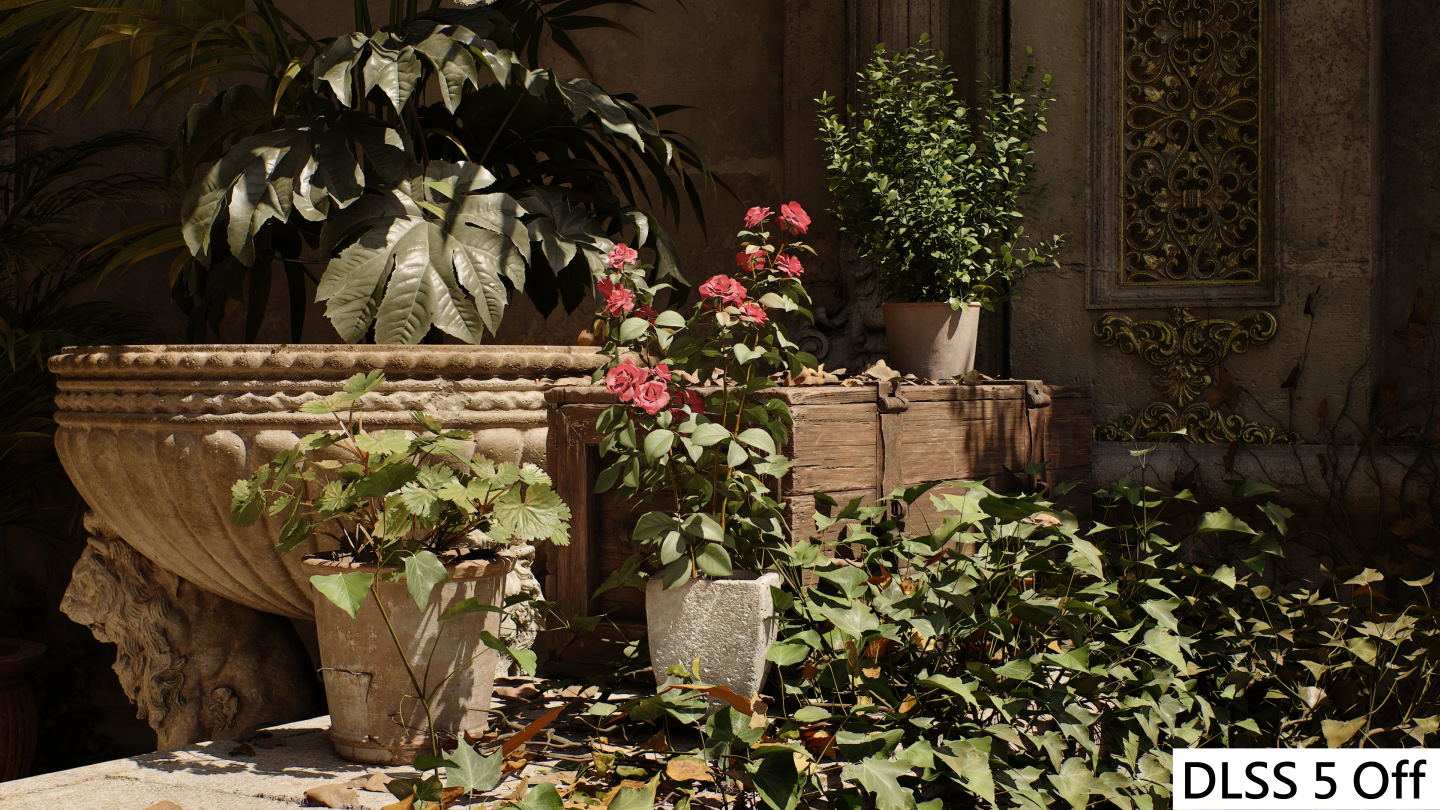
不使用DLSS 5技術的基本參考畫面。

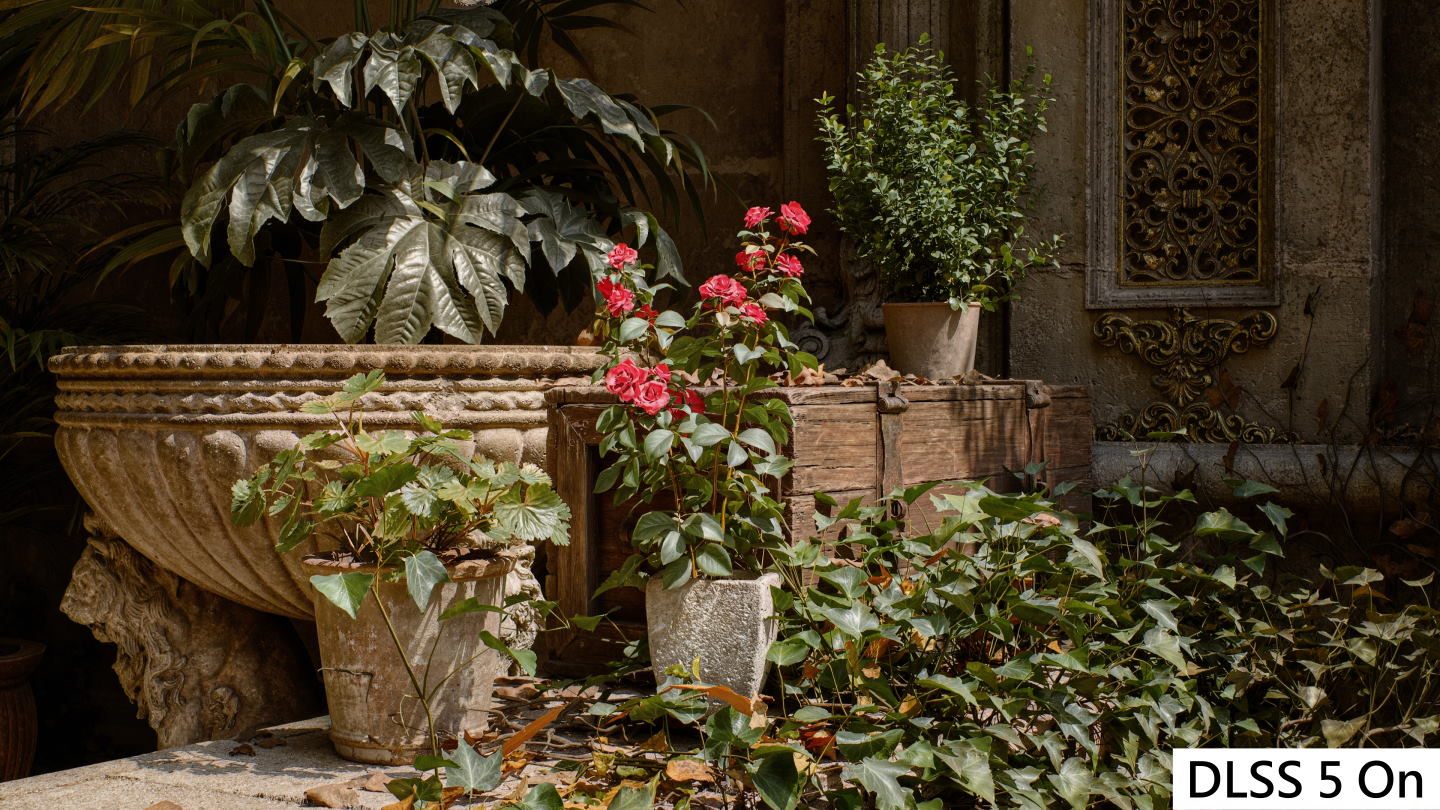
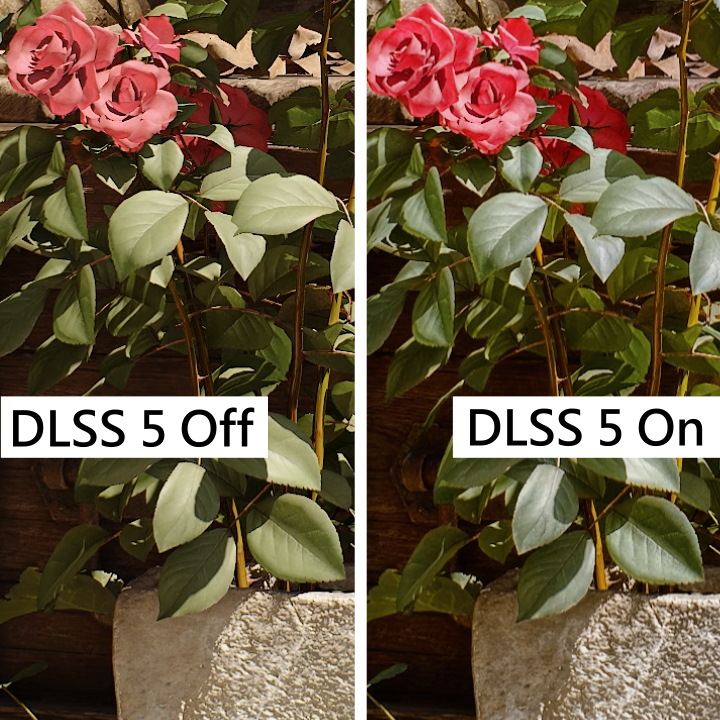
開啟DLSS 5之後,畫面的紋理與光照細節都有所改善。

開啟DLSS 5之後,花瓣間的複雜光影表現更加真實,右下角花盆的石材紋理也更細膩。

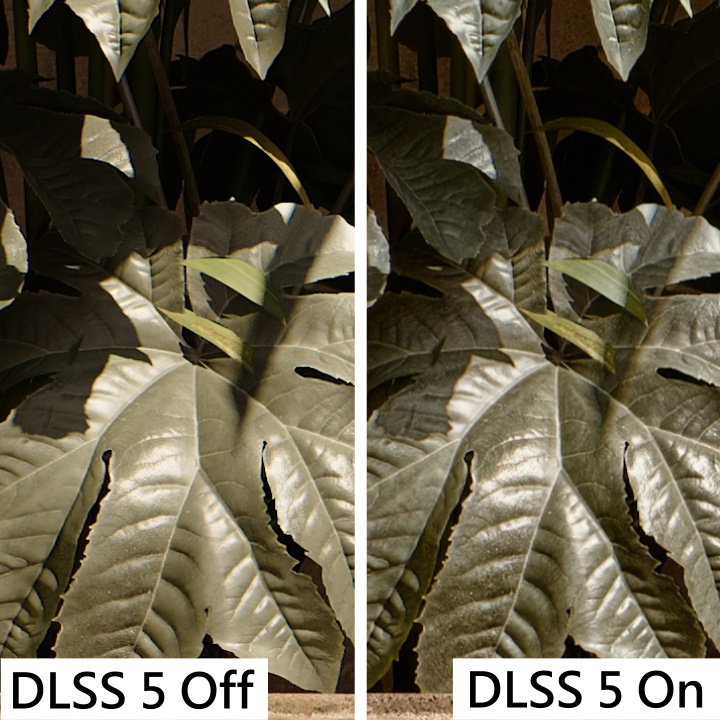
DLSS 5也改善了樹葉的葉脈紋理與光線反射的質感。

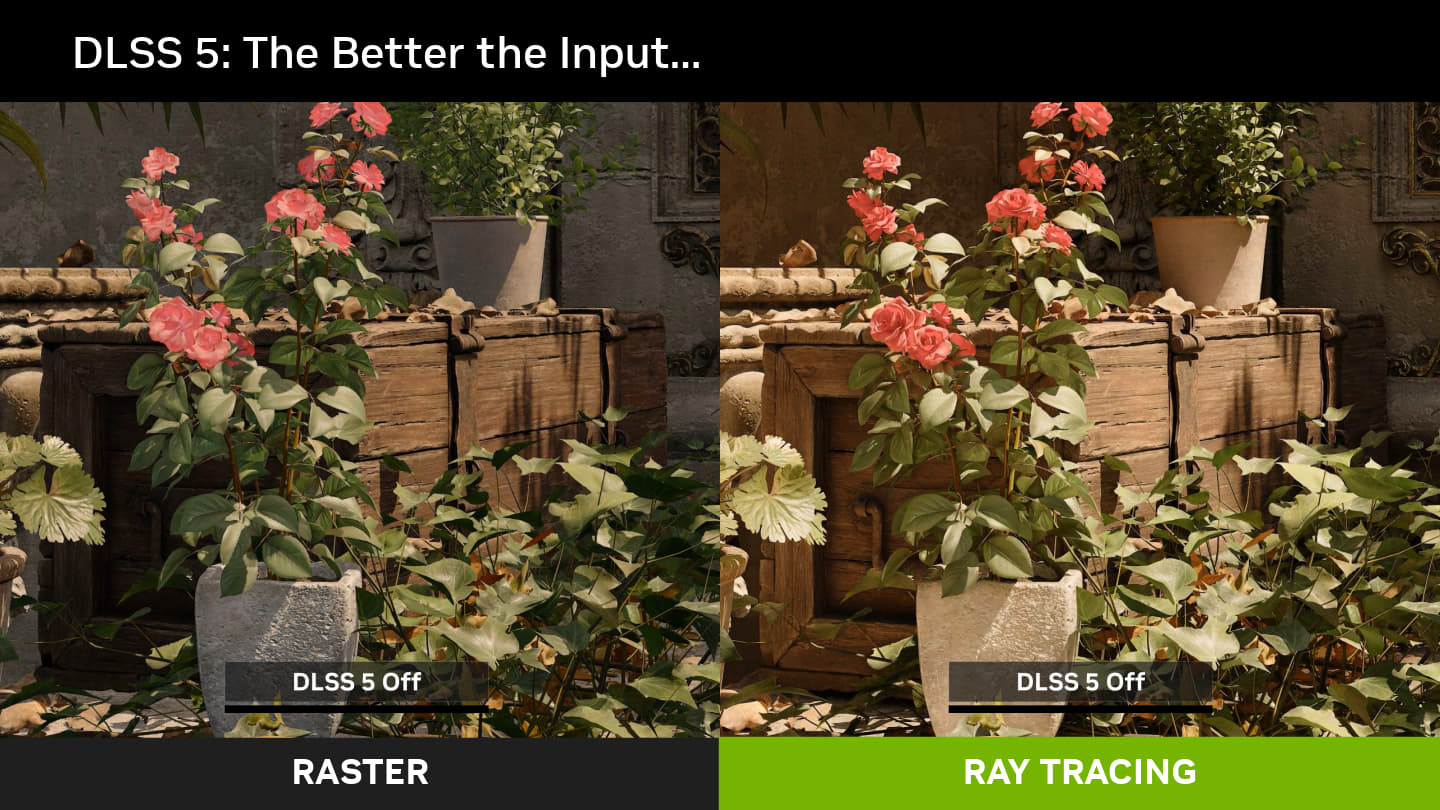
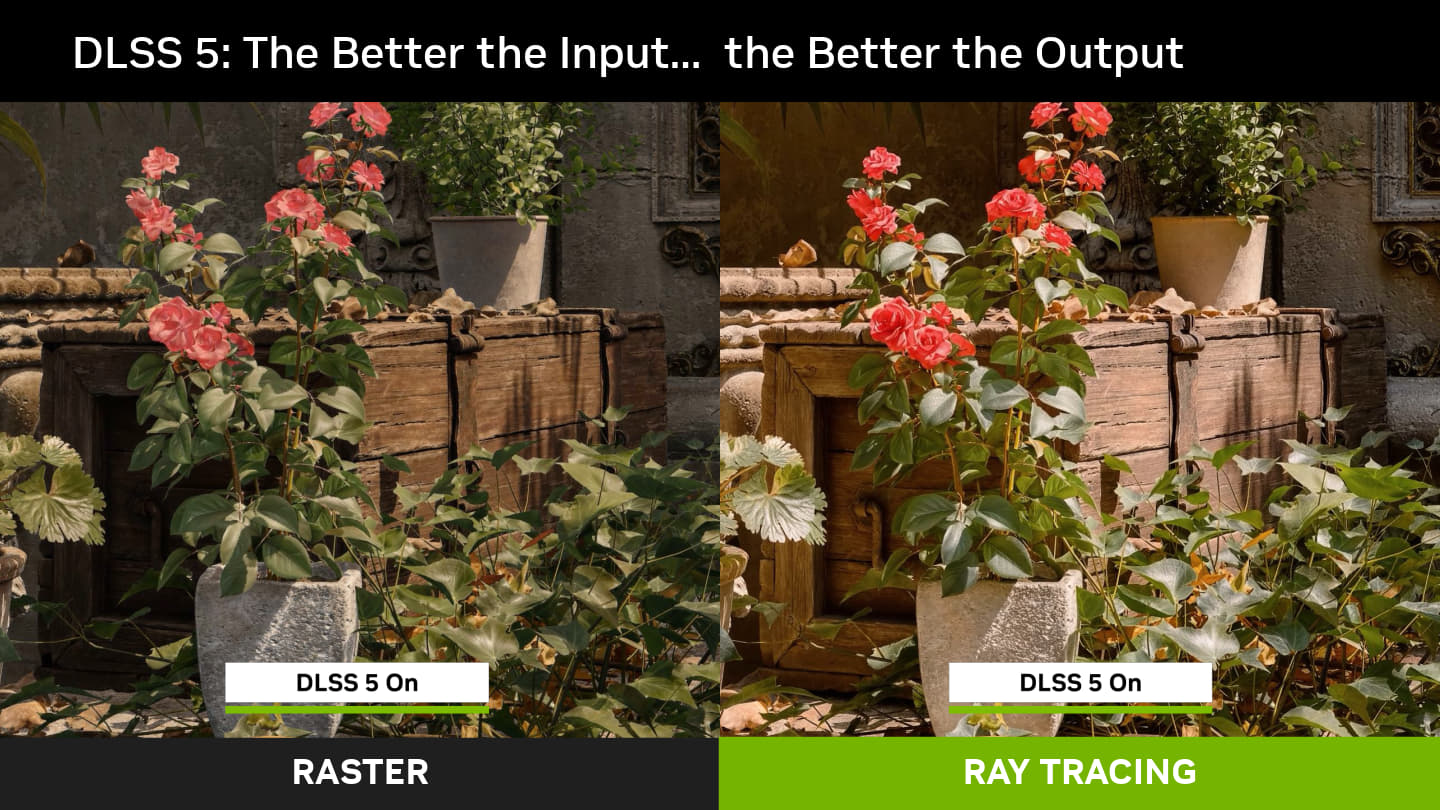
值得注意的是,如果遊戲影引擎能夠提供更多畫面資訊,仍然能提升神經渲染的效果與品質。圖片左側為關閉光線追蹤的畫面,右側開啟光線追蹤後,具有更多光影細節。

2者開啟神經渲染後,開啟光線追蹤的情況能帶來最佳畫面品質。

開發工具賦予高度控制權

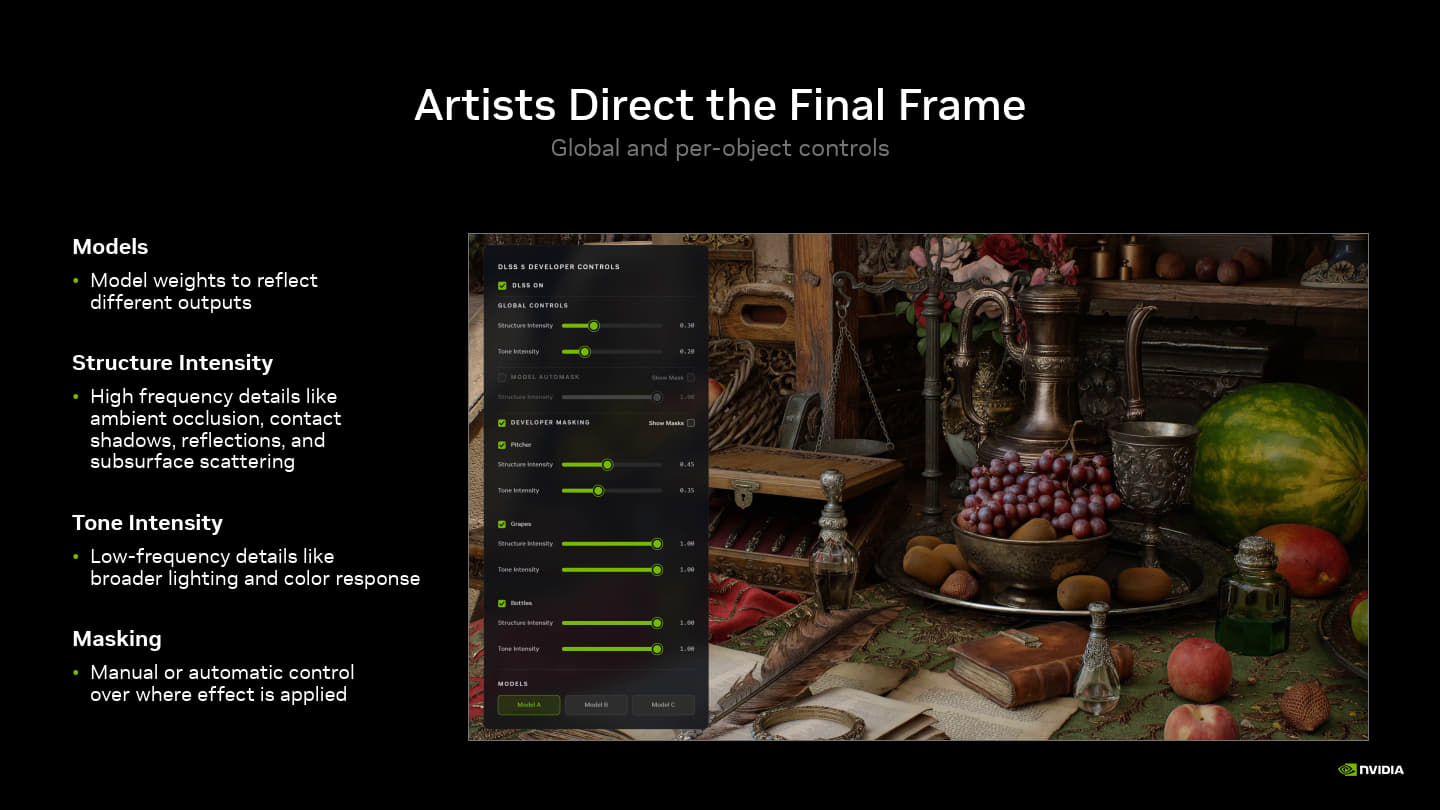
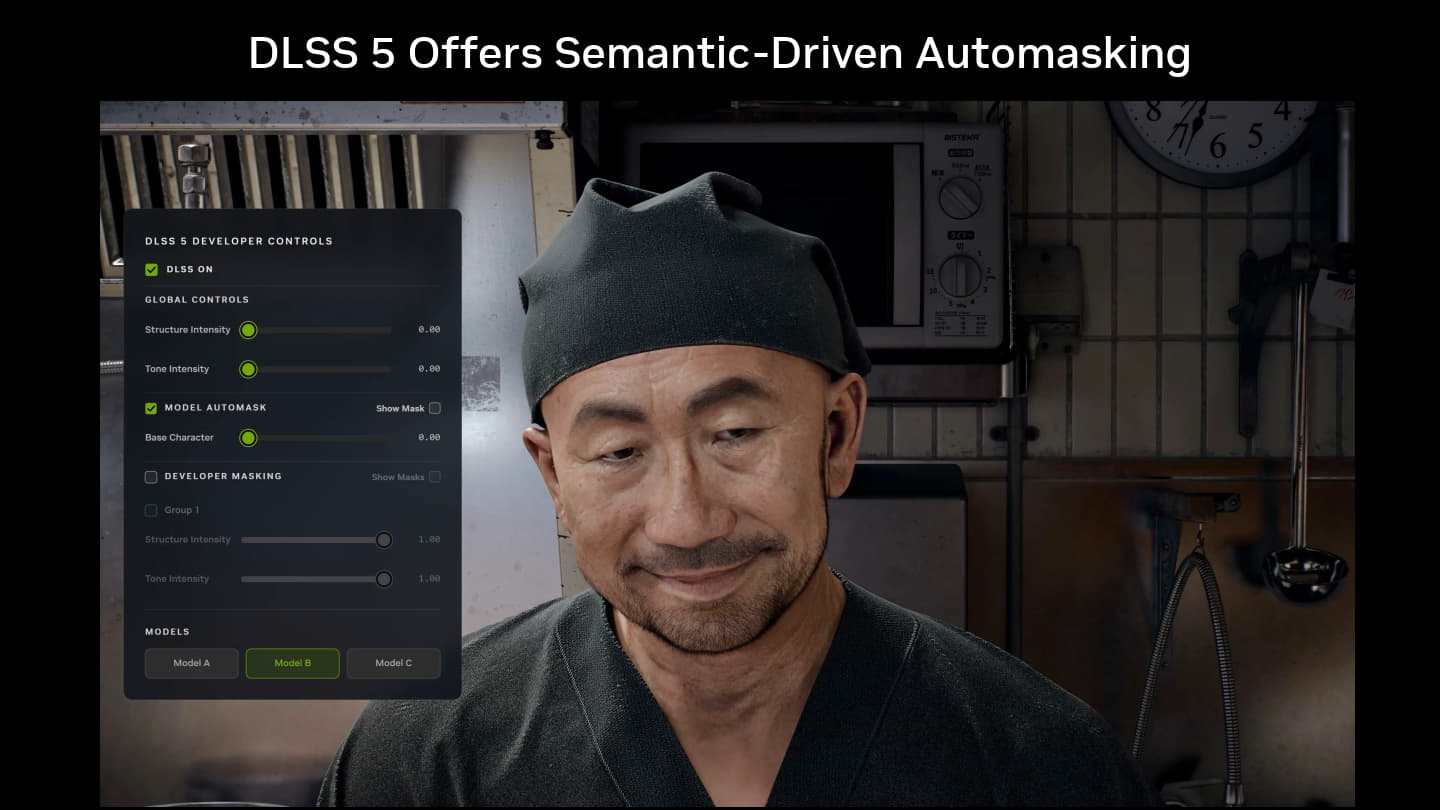
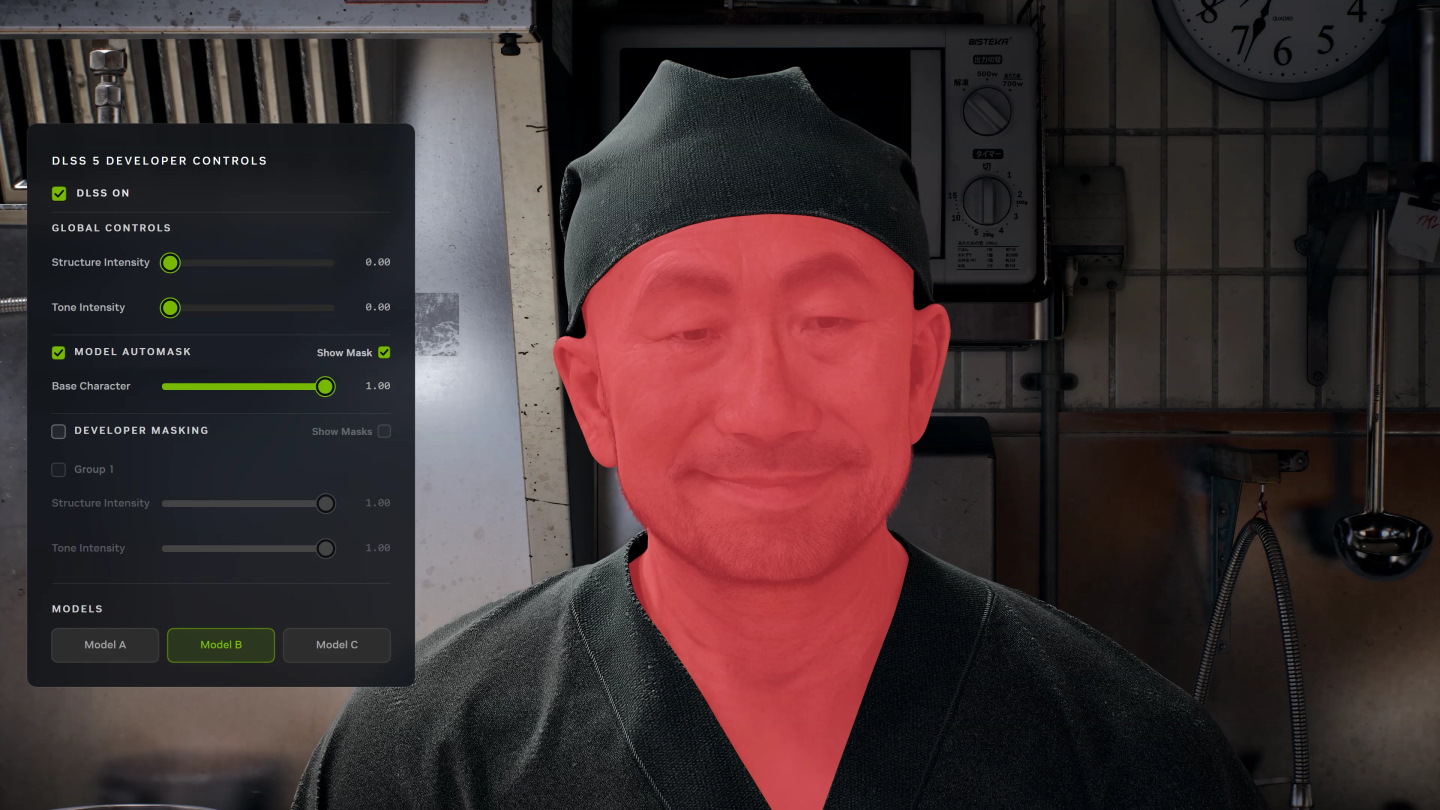
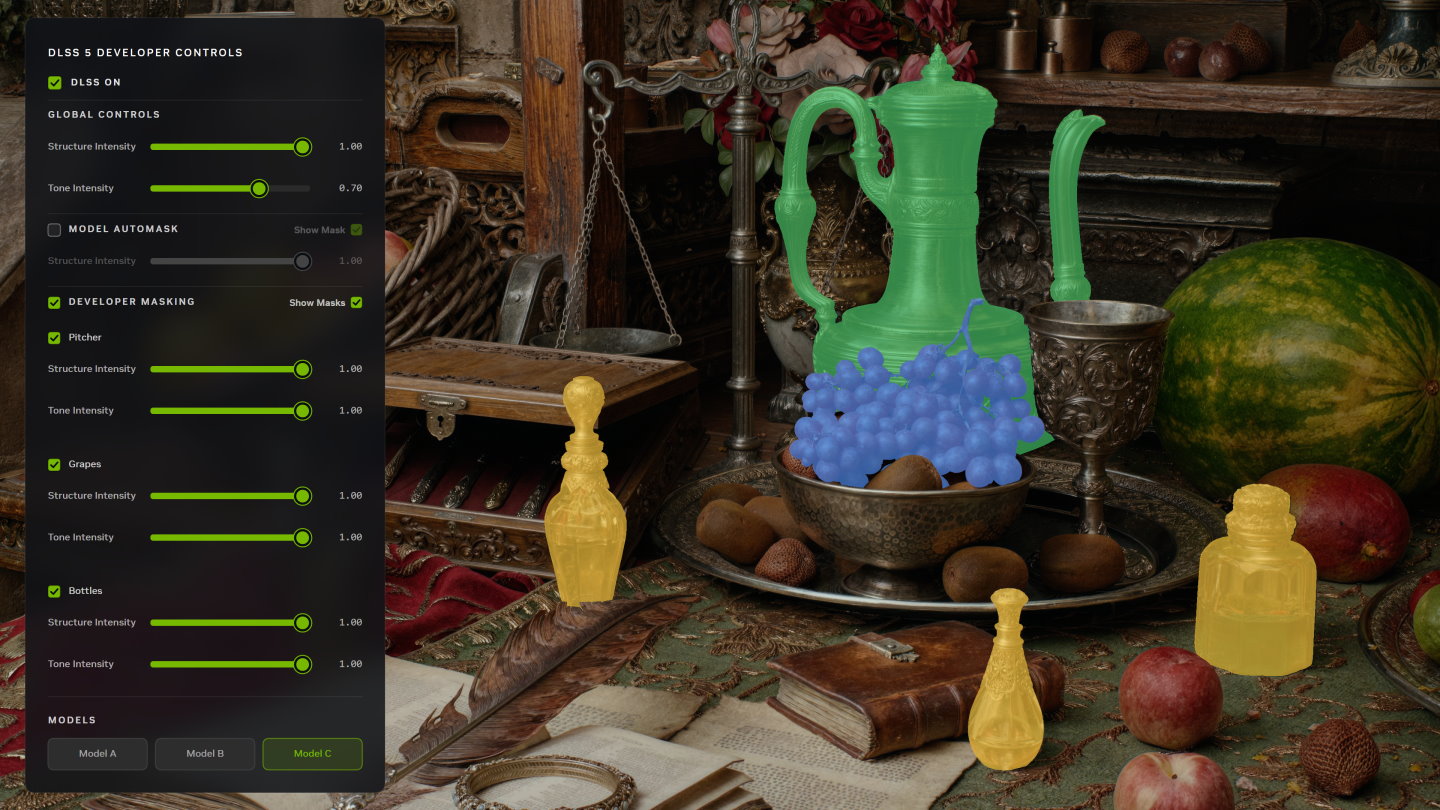
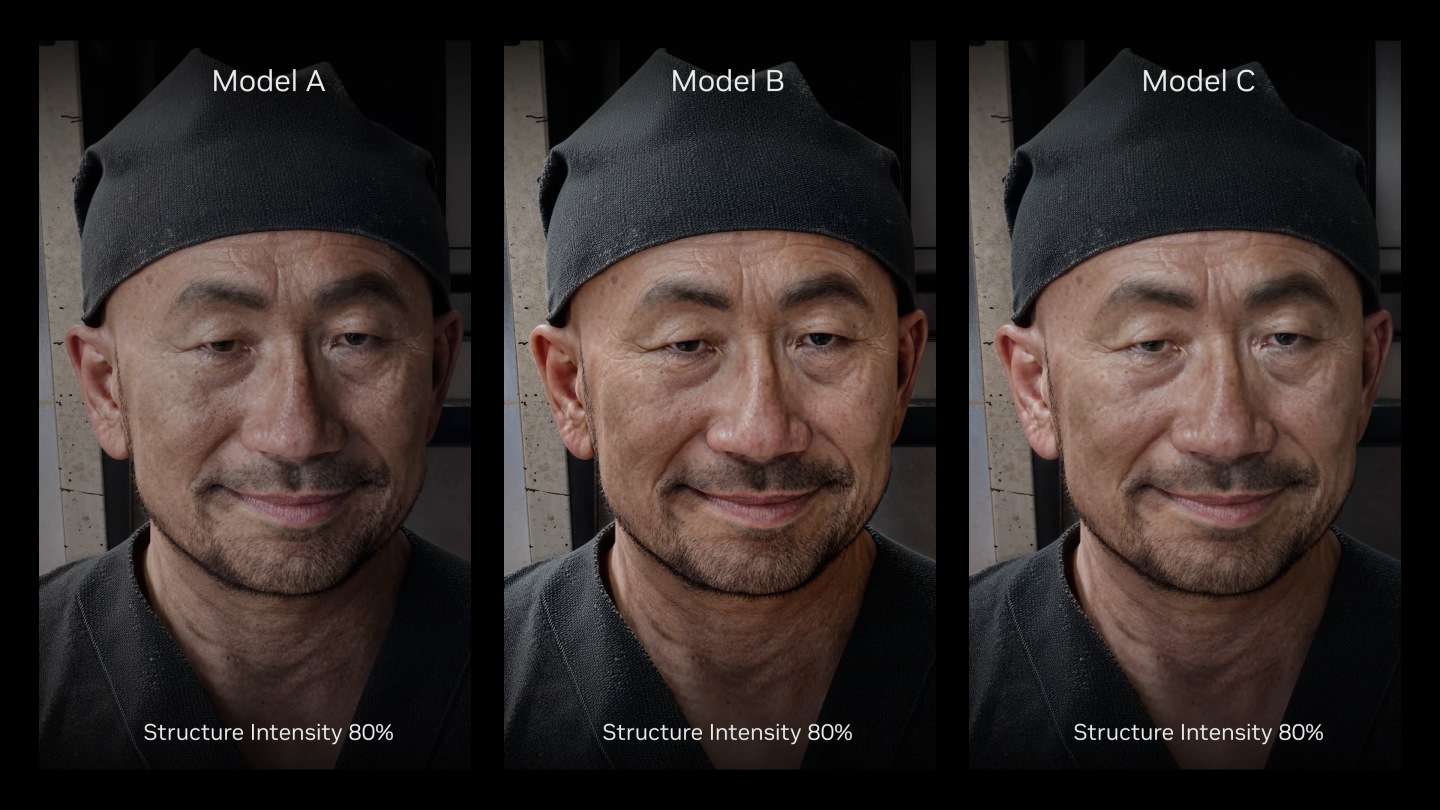
NVIDIA在Gamescom 2026的展示中說明許多神經渲染對於遊戲開發者的設定細節,它提供AI模型、結構強度、色調強度、遮罩等豐富的設定功能,讓開發者能夠在導入神經渲染的同時,將遊戲畫面控制在自己設定的範圍之內,而不會因為讓AI模型把「美肌功能」開過頭,而造成畫風崩壞。

詳細的設定功能與效果比較,請參考下方圖文說明。比較可惜的是,NVIDIA並沒有提供開、關DLSS 5的效能對照數據,僅提供開啟的效能表現做為參考,但是可以放心的是,即便是GeForce RTX 5060也能提供理想且流暢的遊戲體驗。

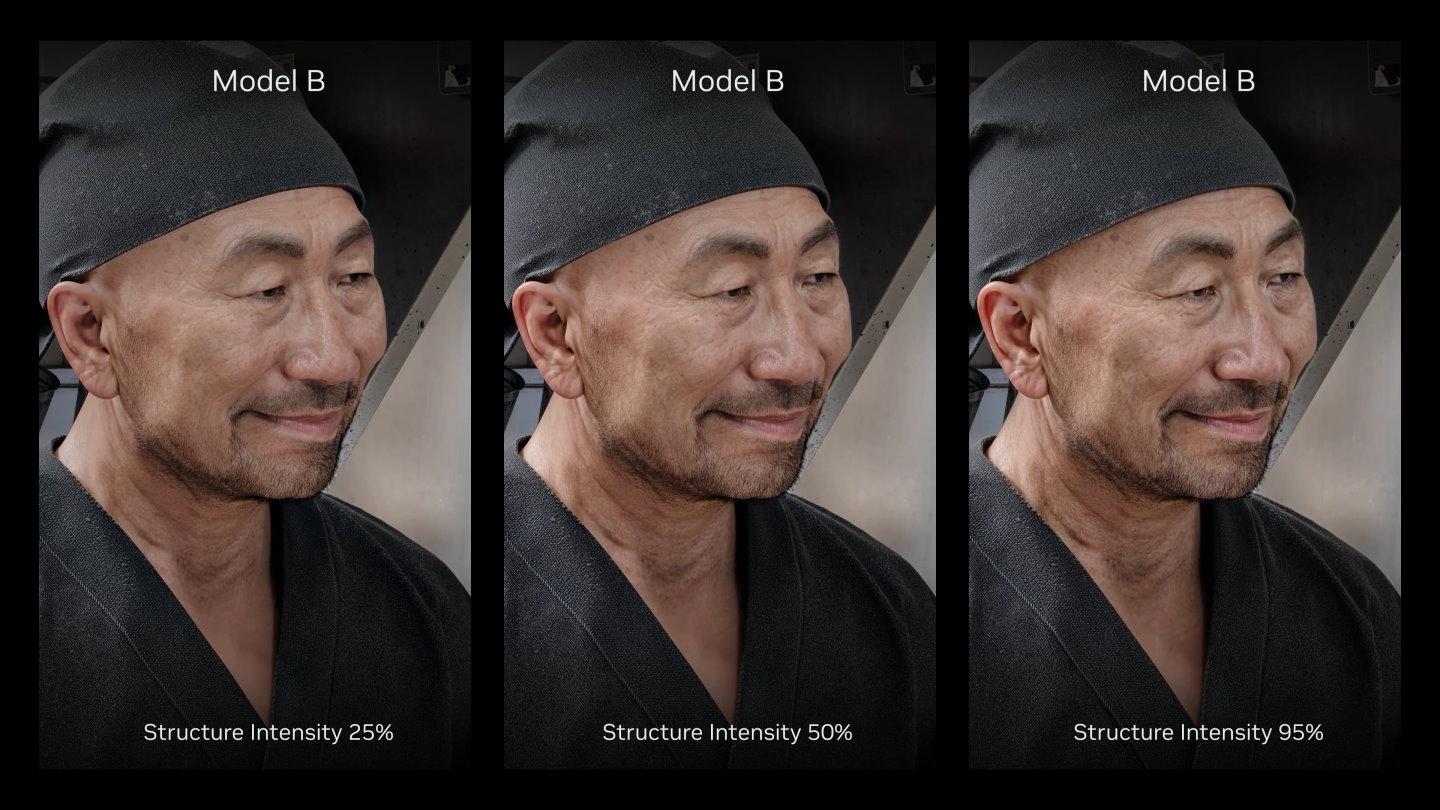
1神經渲染提供詳細的設定功能,可以調整AI模型、結構強度、色調強度、遮罩等等,給與遊戲開發者相當大的自由度調整出理想的畫面效果。

NVIDIA透過調整開發工具中的設定參數,展示神經渲染的效果。

首先開發者可以設定多組遮罩,方便進行圖層式的強度設定。

遮罩的層數並不會以影響神經渲染的效能表現,開發者可以對不同物件進行精細微調。

舉例來說,套用不同的AI模型會得到不同的圖像,開發者可以選擇適合的AI模型。

確定AI模型後,還可以調整強度,達到適中的畫面強化效果,而不至於影響畫面風格。

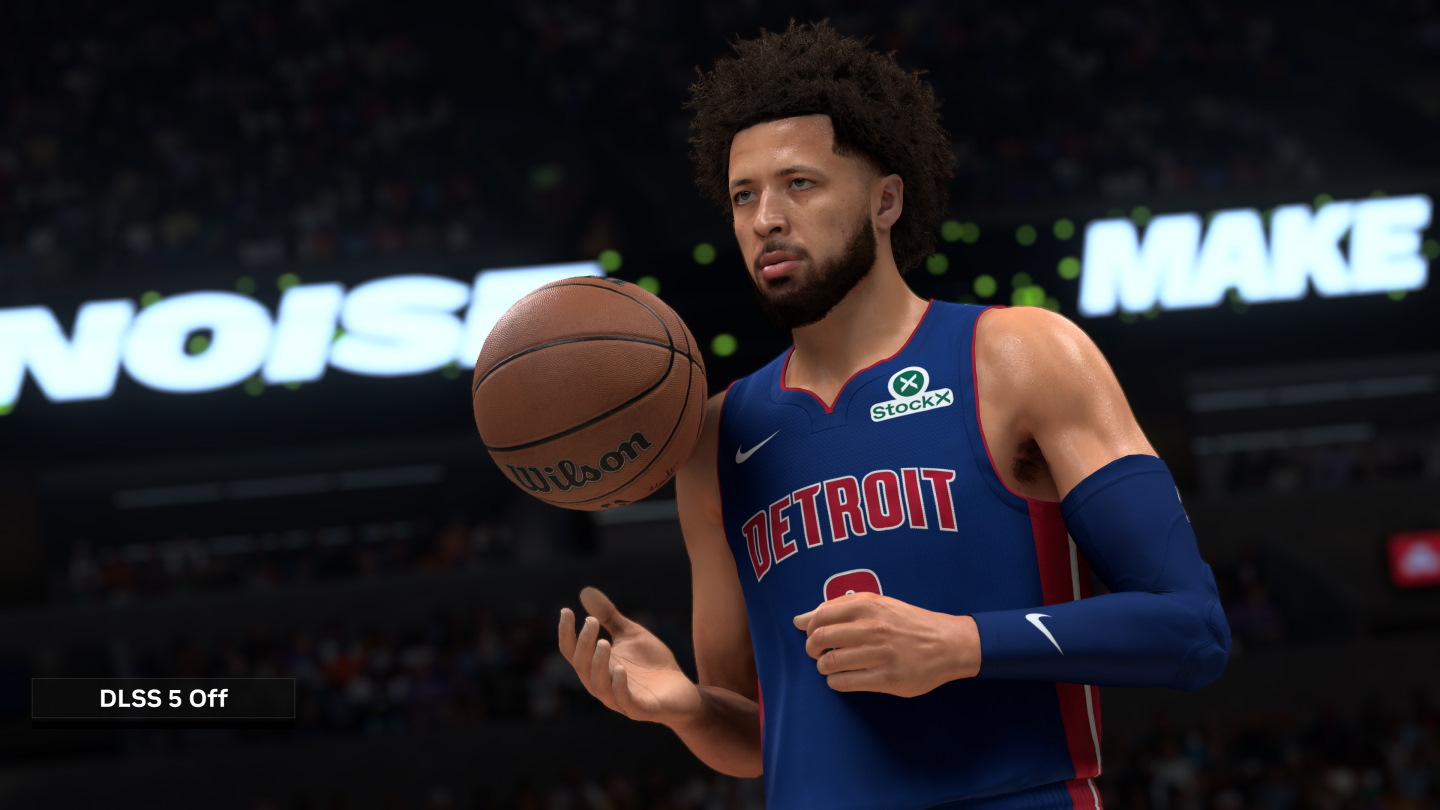
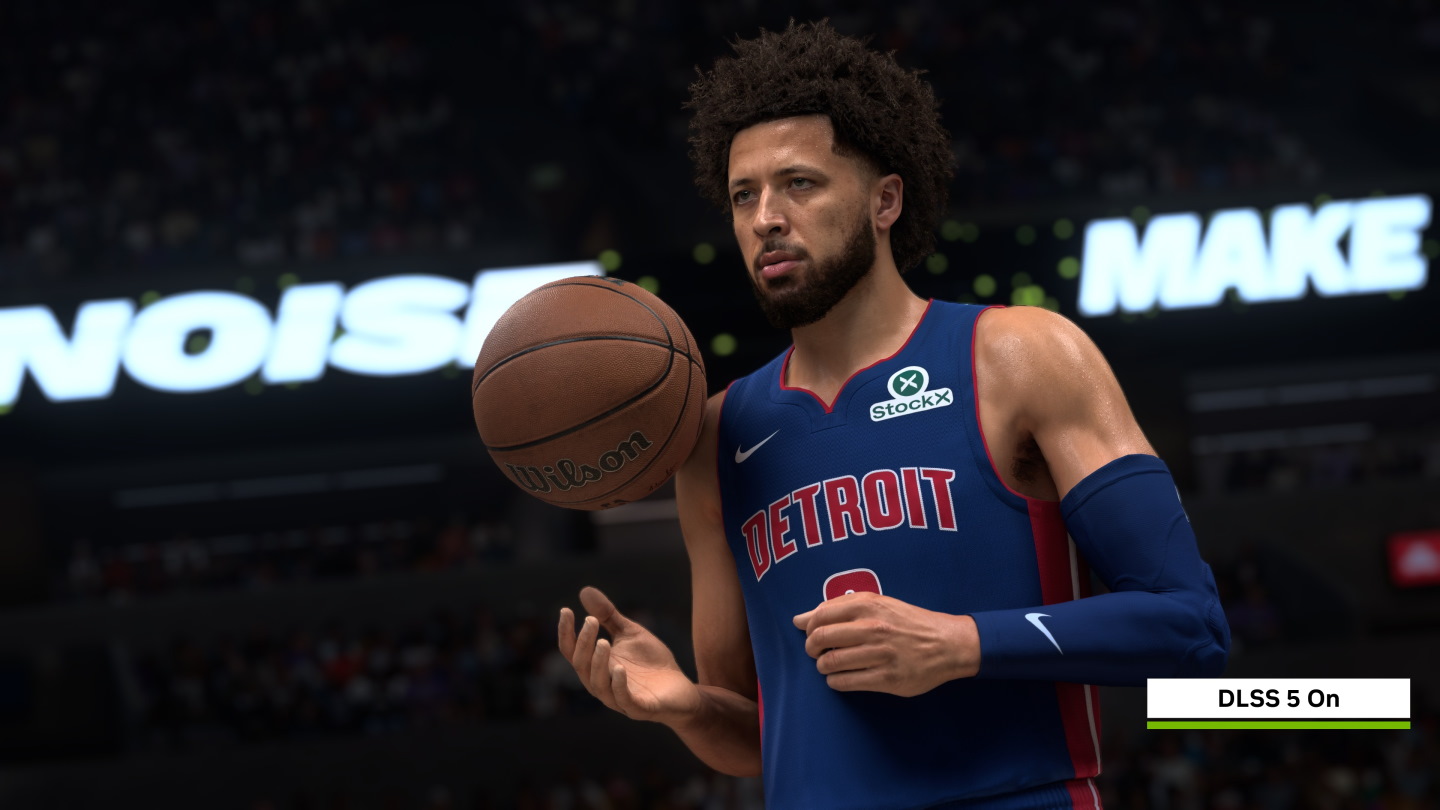
最後我們看到DLSS 5在實際遊戲NBA 2K27的效果,圖為關閉DLSS 5的情況。

開啟DLSS 5之後,人物的肌膚更細膩,手臂上汗水的反光效果也更加逼真。

仔細查看細節,可以看到DLSS 5的神經渲染功能可以明顯改善眼珠、毛孔、鬍鬚等部位的視覺效果。

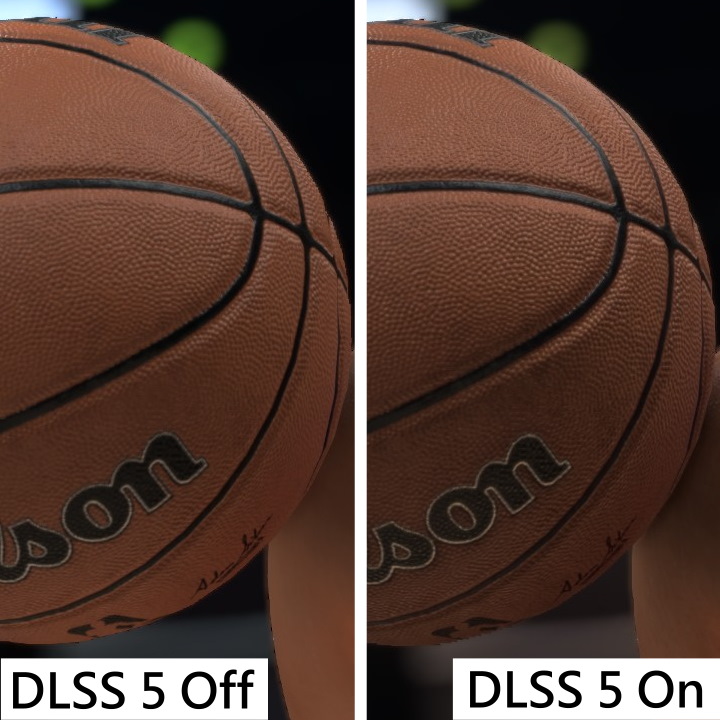
籃球表面的顆粒感也獲得明顯提升。

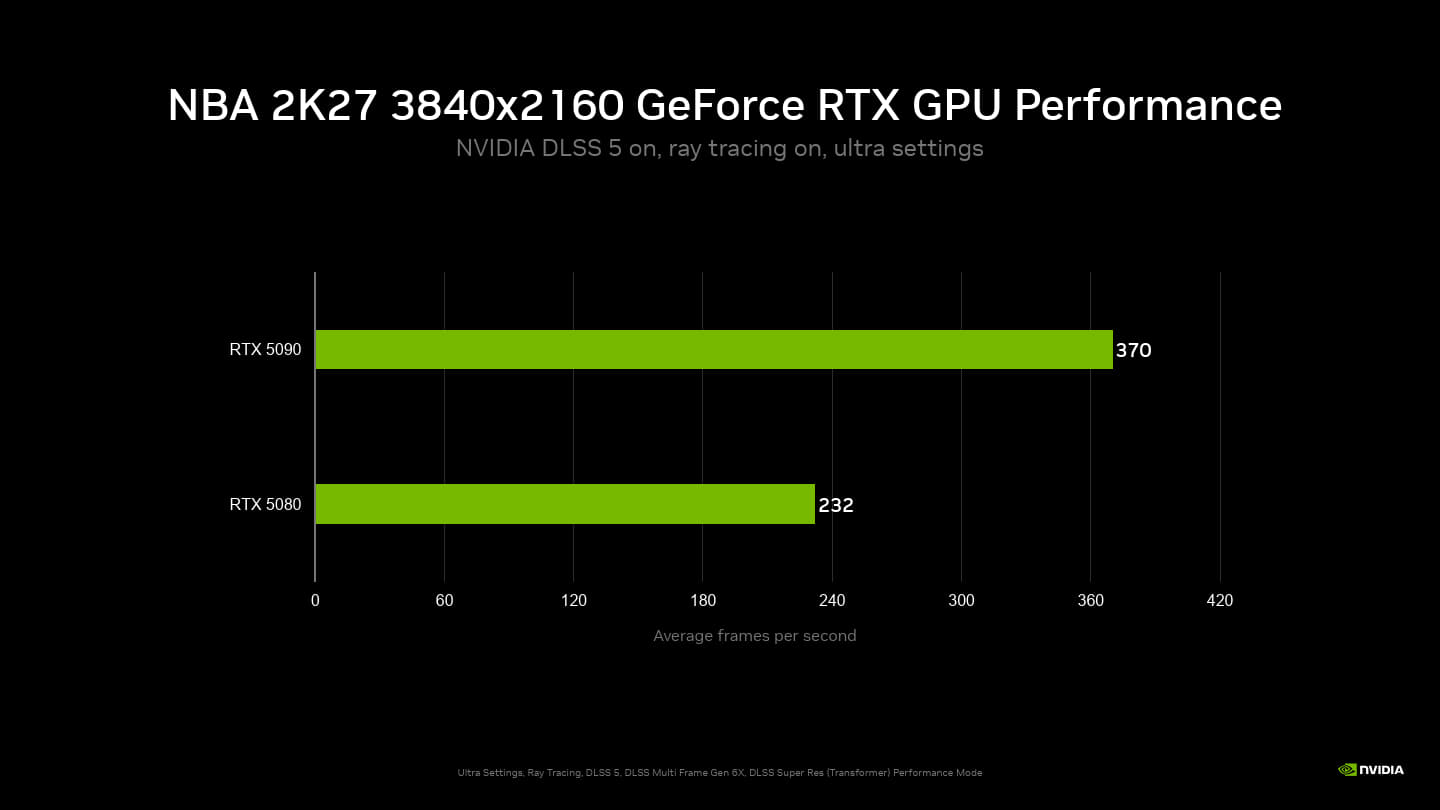
GeForce RTX 5090 / 5080能在4K解析度並開啟最高畫質、光線追蹤、DLSS 5的情況下,讓NBA 2K27的平均FPS達到370幀、232幀。

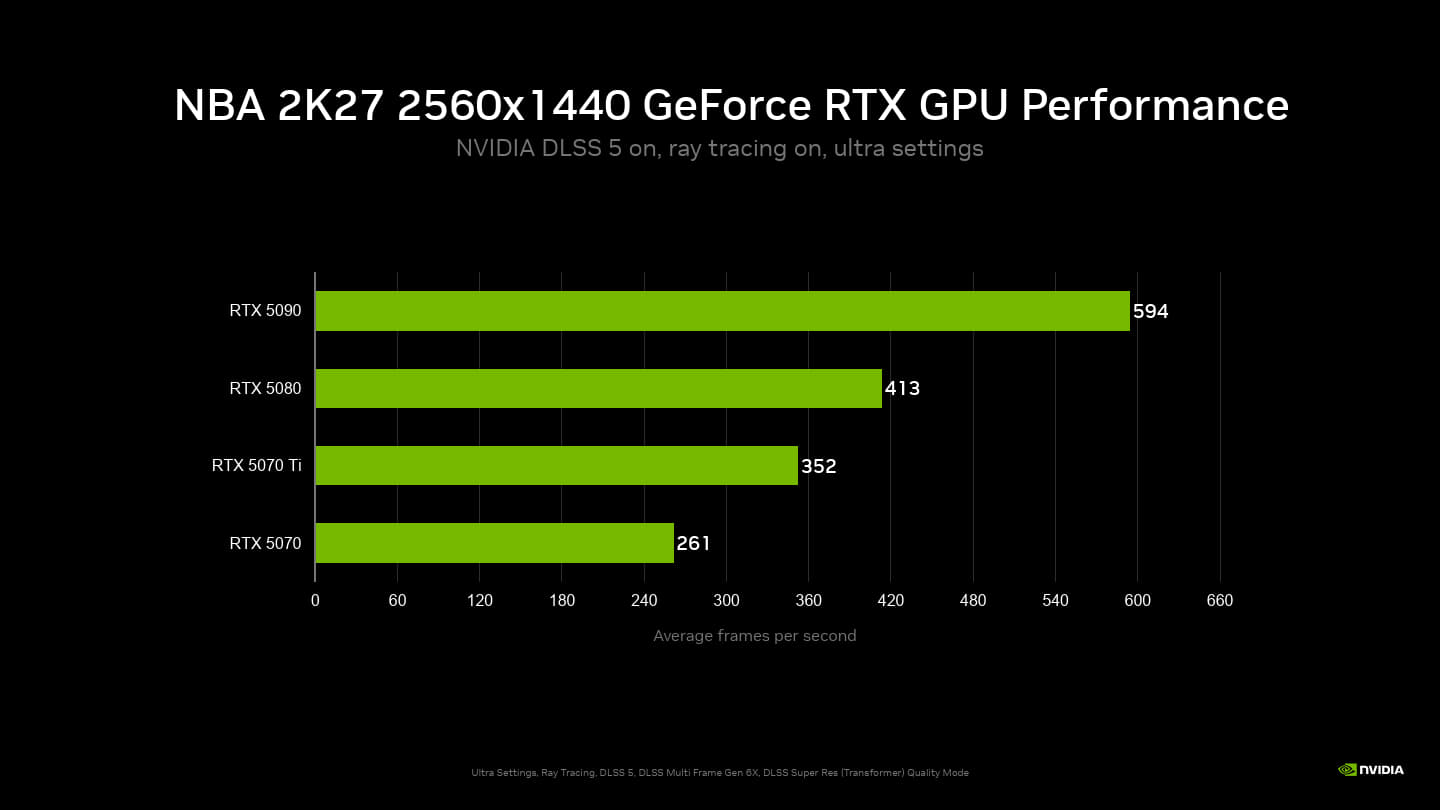
多張顯示卡在2K解析度並開啟最高畫質、光線追蹤、DLSS 5,也都能提供流暢的遊戲體驗。

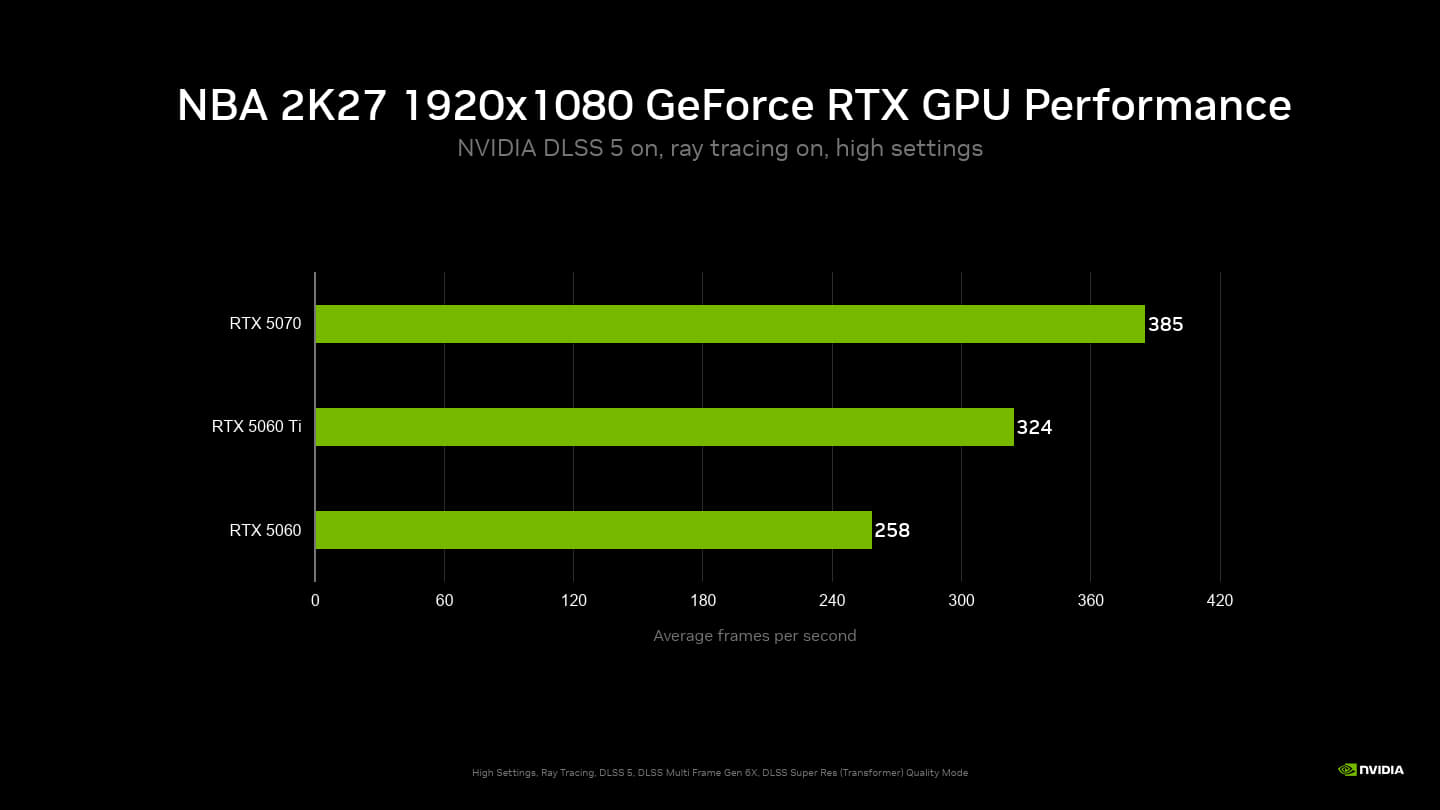
在1080p解析度將畫質調至「高」,同樣開啟光線追蹤、DLSS 5,GeForce RTX 5060仍能提供258幀的平均FPS。

GeForce RTX 50系列顯示卡使用者可以透過更新驅動程式的方式取得DLSS 5功能,而開發者則可以透過Streamline SDK或Unreal Engine 5的外掛程式將DLSS 5整合至遊戲中。

加入T客邦Facebook粉絲團

NVIDIA DLSS 4.5光線重建實測,強化光線追蹤畫質效能不打折

2026年9月1日 09:00
NVIDIA先前於Computex台北國際電腦展2026發表DLSS 4.5光線重建功能,並在Gamescom 2026大會正式推出,我們一起來看看它的效果如何。E14ded7da2b83c4bc43040402e1dc7f6

NVIDIA先前於Computex台北國際電腦展2026發表DLSS 4.5光線重建功能,並在Gamescom 2026大會正式推出,我們一起來看看它的效果如何。

升級模型強化光線重建效果

NVIDIA DLSS 4.5升頻技術整合第2代Transformer模型、6X多重畫格生成、動態畫格生成、強化畫格生成模型等等。這次推出的新功能為在上述基礎將光線重建功能所使用的模型也升級至第2代Transformer模型,強化光線追蹤與路徑追蹤遊戲的畫質表現。

延伸閱讀:
《電馭叛客2077:自由幻局》資料片加入全新任務與地區,NVDIA DLSS 3.5光線重建技術強化畫質且效能更好
【CES 2026】NVIDIA發表DLSS 4.5效能禁藥,第2代超解析度Transformer模型、6X多重動態畫格生成,強化遊戲畫質與效能
NVIDIA DLSS 4.5效能禁藥實測,6X多重畫格生成效能突破天際

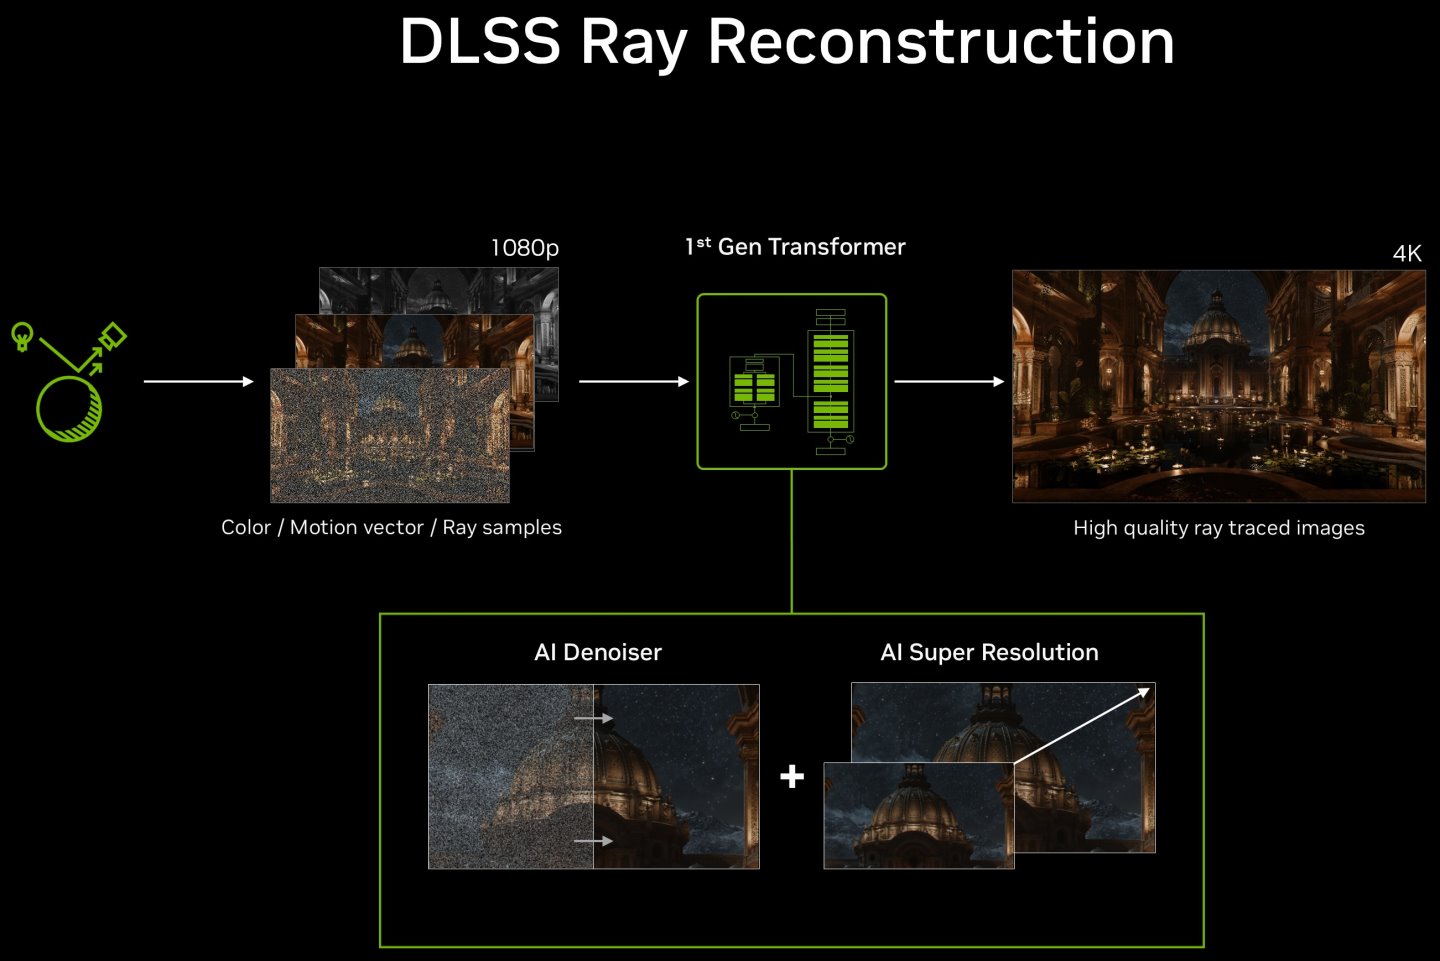
光線重建功能首次由DLSS 3.5開始提供,DLSS 4.5光線重建功能使用的模型整合降噪與超解析度等技術,透過AI推論的方式取代傳統降噪器,以改善畫面中未被光線取樣的雜訊問題,以提升畫質並降低鬼影等瑕疵,重大改進項目如下:

高效降噪器:新模型的參數量增加20%,運算能力提升35%,能夠維持與前代接近的效能

強化超解析度:具有更深入的空間感知能力,並能更聰明運用遊戲引擎提供的像素取樣與動態向量等資料,有助於提升光線追蹤精確度,帶來更穩定、清晰的畫面

擴展訓練資料集:新模型使用更大型的資料集進行AI模型訓練,具備更強的感知能力,能夠挑選最精確的引擎資料,以重建更接近實際情況的場景

更精細的開發者控制機制:提供更詳細的選項讓開發者精準調校模型的回應行為,進一步提升影像畫質

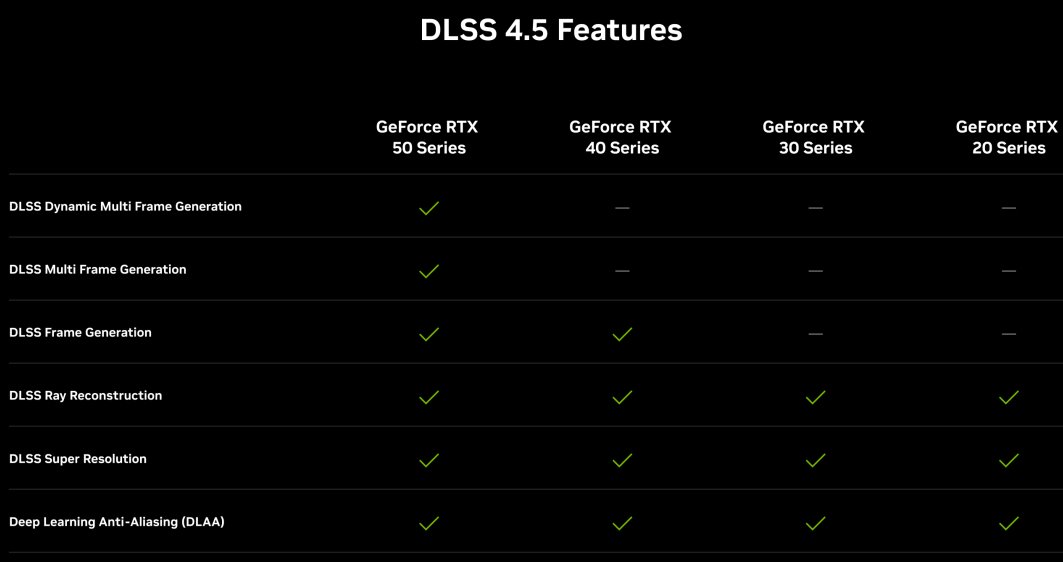
DLSS 4.5光線重建功能可在RTX 20世代之後的所有GeForce RTX顯示卡上執行,玩家只需更新驅動程式即可使用此項新功能。

DLSS 4.5光線重建功能將降噪與超解析度技術整合為單一模型,能夠分析遊戲引擎的時域(Temporal)與空間(Spatial)資料,重建出更銳利、更穩定且準確度更高的高解析度遊戲畫面。

RTX功能與歷代顯示卡的相容性對照表,DLSS 4.5光線重建可在所有GeForce RTX顯示卡上執行。

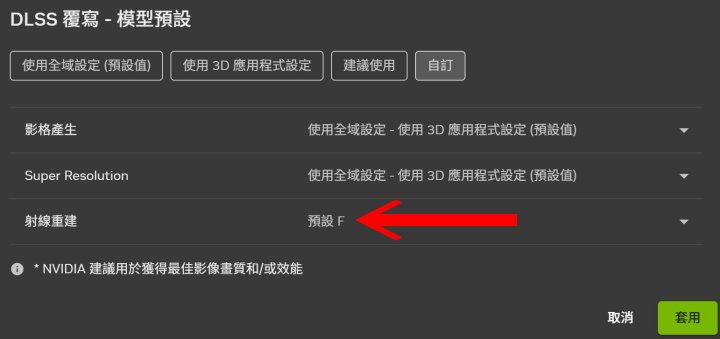
更新NVIDIA顯示卡驅動程式後,玩家從NVIDIA App內的DLSS模型覆寫選擇Preset F模型即可啟用DLSS 4.5光線重建。

DLSS 4.5光線重建效果實測

筆者使用《PRAGMATA》與《惡靈古堡 安魂曲》等遊戲,並參考NVIDIA提供的測試指南,針對DLSS 4.5光線重建與舊版模型差異較為明顯的場景進行測試,遊戲的畫質設定皆為開啟路徑追蹤與光線重建,並於NVIDIA App內的DLSS模型覆寫選擇Preset F模型。

筆者以4K解析度進行測試,所有畫質相關選項皆調至最高(部份設定值與測試指南建議不同),並開啟4X多重畫格生成。請點擊連結查看《PRAGMATA》與《惡靈古堡 安魂曲》的詳細設定。


2款遊戲的測試方式為參考下列展示影片的流程手動操作2輪並使用NVIDIA FrameView工具測量FPS數據並取平均。

測試平台:
處理器:AMD Ryzen 7 9800X3D
散熱器:MSI MEG Coreliquid S360
主機板:ASRock X870E Taichi(UEFI版號:4.03.TS04 – AMD AGESA ComboAm5PI 1.2.7.1)
記憶體: G.Skill Trident Z5 Neo RGB 16GBx2(@DDR5-7200)
顯示卡:NVIDIA GeForce RTX 5090 Founders Edition
儲存裝置:Samsung 9100 Pro 1TB(系統碟)、Solidigm P41 Plus 1TB(遊戲碟)
電源供應器:MSI MEG Ai1300P PCIE5
軟體環境:Windows 11專業版25H2(Build 26200.9168),GeForce Game Ready 610.88測試版

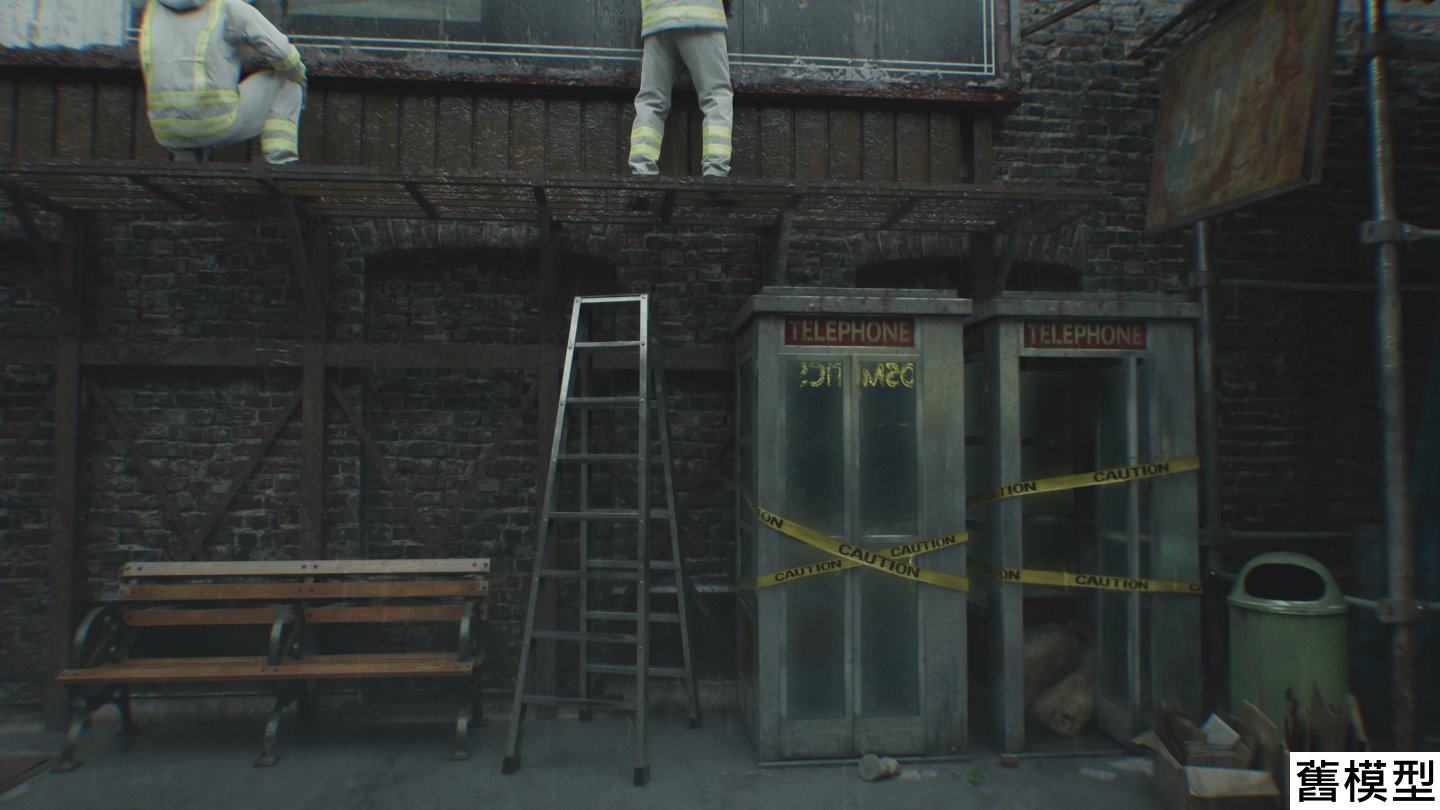
▲在《PRAGMATA》中使用舊版光線重建模型的話,可以看到畫面中本應消失的雷射光產生鬼影。

▲透過NVIDIA App選擇代表DLSS 4.5光線重建功能的Preset F模型後,雷射光就不再有鬼影問題。

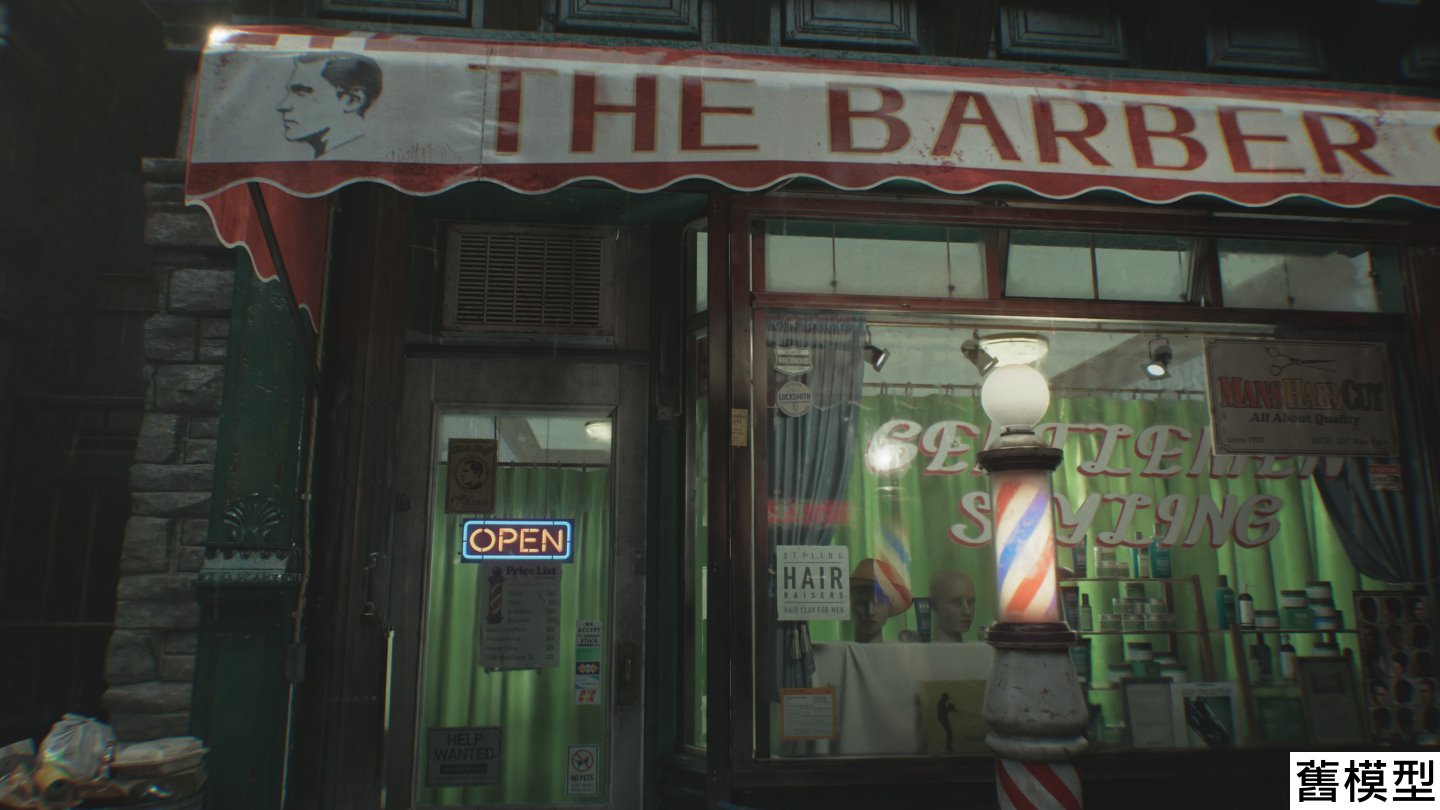
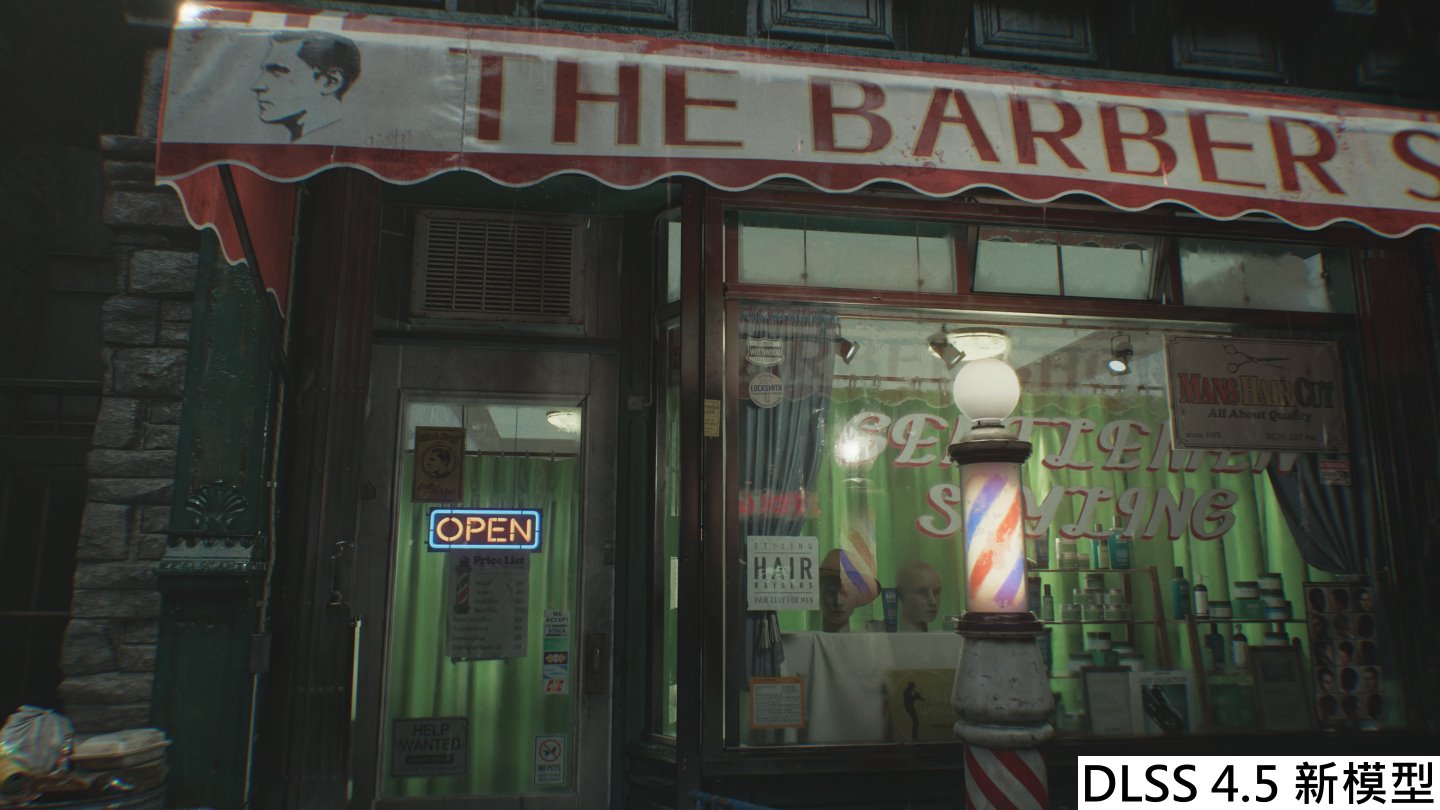
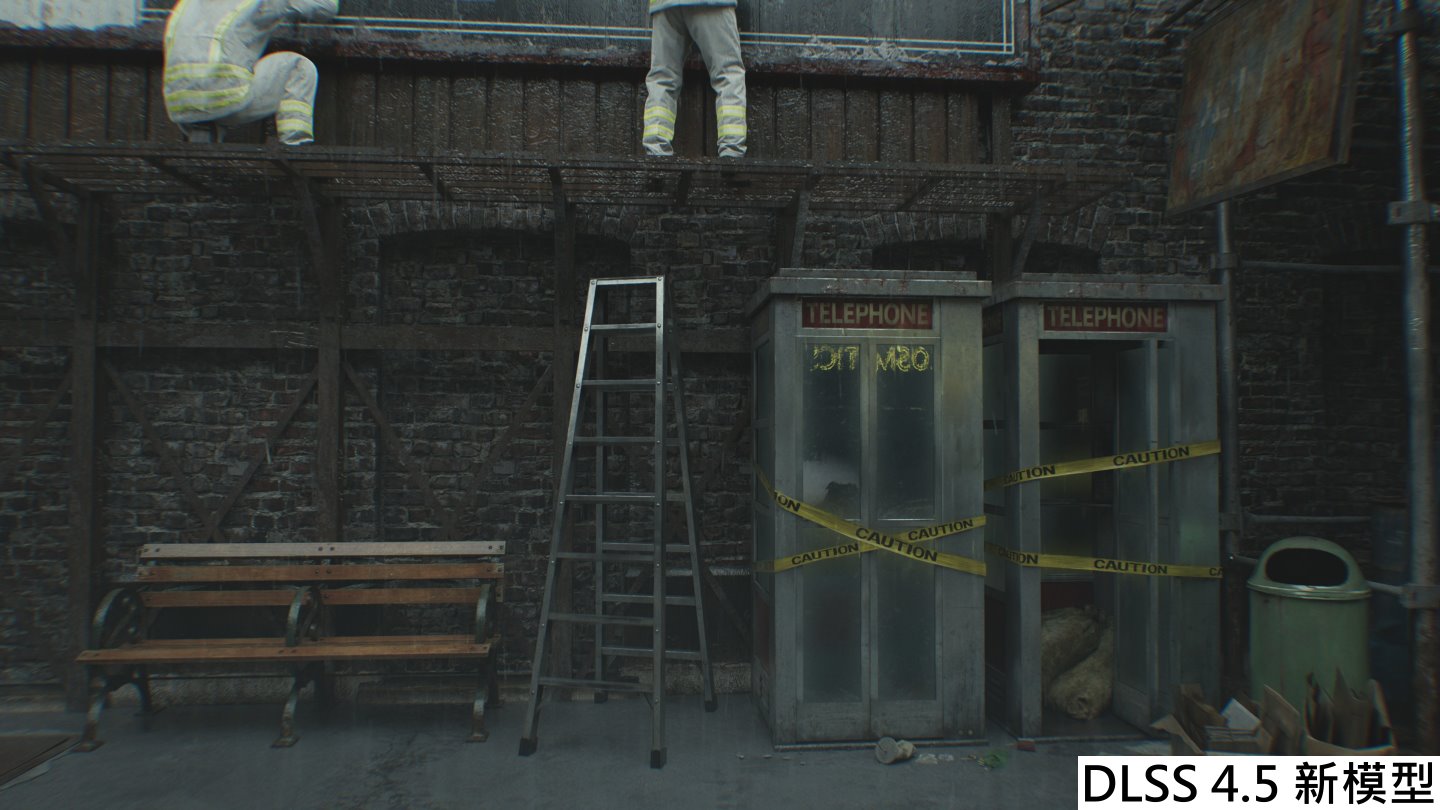
看到《惡靈古堡 安魂曲》的部分,舊版光線重建模型處理玻璃上倒影的效果比較差。

DLSS 4.5光線重建則能帶來較為清晰的倒影。

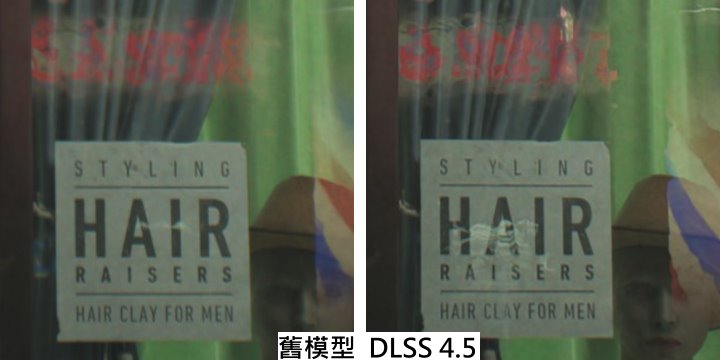
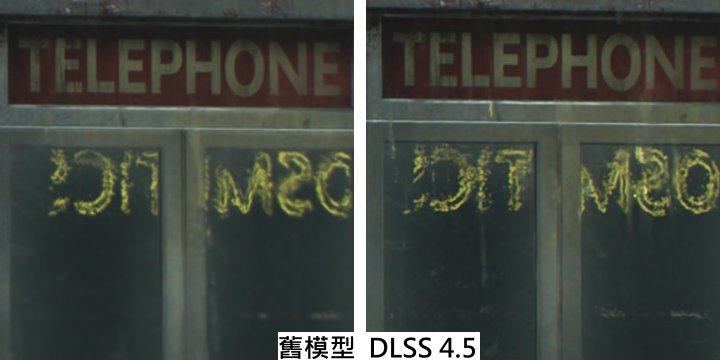
觀察玻璃上的紅色霓虹燈倒影,可以看到DLSS 4.5光線重建保留較多細節。(圖為1:1裁切4K解析度之遊戲擷圖,下同)

接下來在另一個場景中看到雨中的電話亭的倒影,DLSS需要同時處理雨滴與霓虹燈倒影等圖像變因。

啟用DLSS 4.5光線重建後可以看到較為清晰的雨滴效果。

新舊模型的1:1裁切對照圖。

▲《惡靈古堡 安魂曲》使用舊版光線重建模型的動態效果展示。

▲《惡靈古堡 安魂曲》啟用DLSS 4.5光線重建後能夠改善升頻後光線追蹤的準確度。

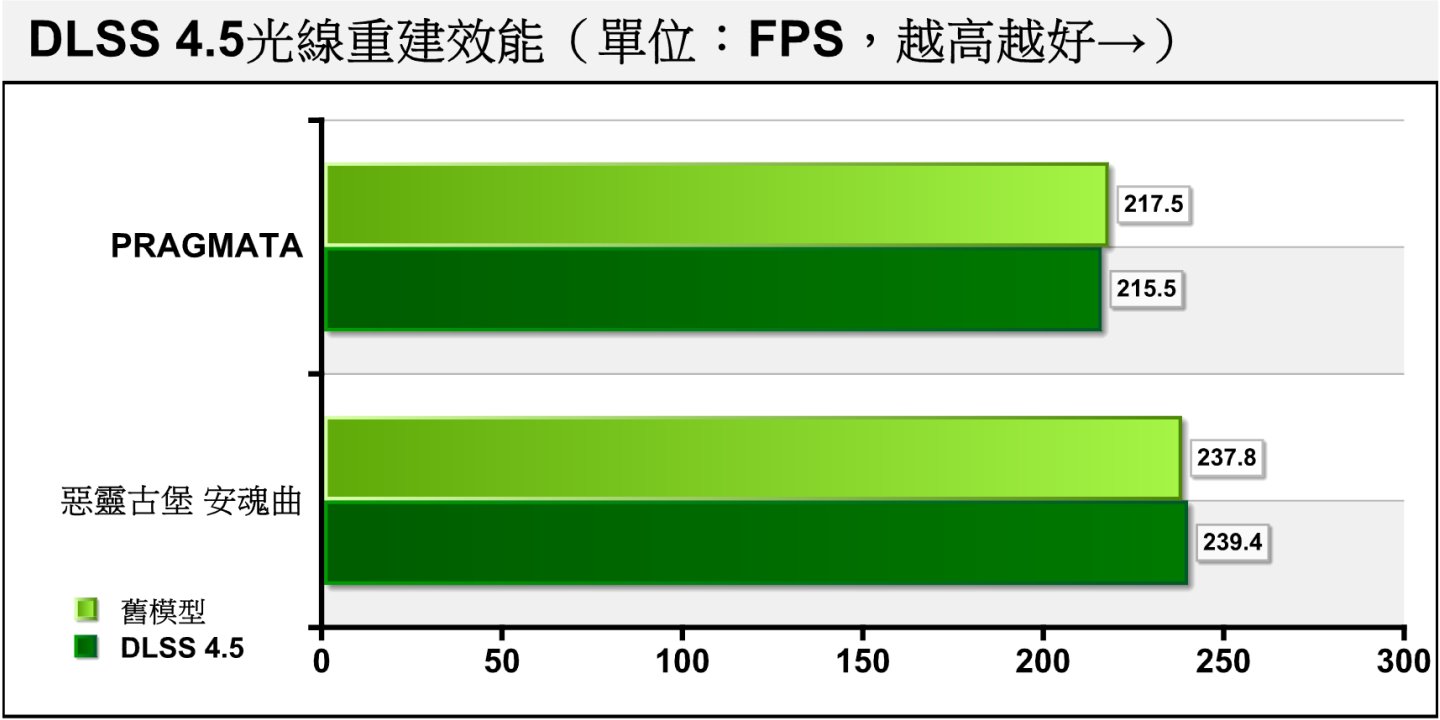
新舊模型的效能對照,DLSS 4.5光線重建的FPS效能表現幾乎與舊版模型相同。

由於DLSS 4.5光線重建功能是依附於DLSS超解析度之下的功能,所以無論是RTX 20、RTX 30、RTX 40、RTX 50世代的GeForce RTX系列顯示卡都能在更新驅動程式之後使用此功能,且根據測試結論可以看到對效能的影響微乎其微,因此相當推薦玩家升級以取得此功能。

加入T客邦Facebook粉絲團

31年之後,聯電傳奇主機 Super A'Can 模擬器終於完美達成,重溫 1995 年國產 16 位元巔峰榮光

2026年8月31日 15:30
1995年上市的遊戲主機Super A'Can在經歷31年的時光後,終於具備高完成度的模擬器,讓這款主機的數位內容能以不同方式保存、執行。E89e4f62cb1192a4de894b8b5c0885d4

1995年上市的遊戲主機Super A'Can在經歷31年的時光後,終於具備高完成度的模擬器,讓這款主機的數位內容能以不同方式保存、執行。

台灣之光遊戲主機

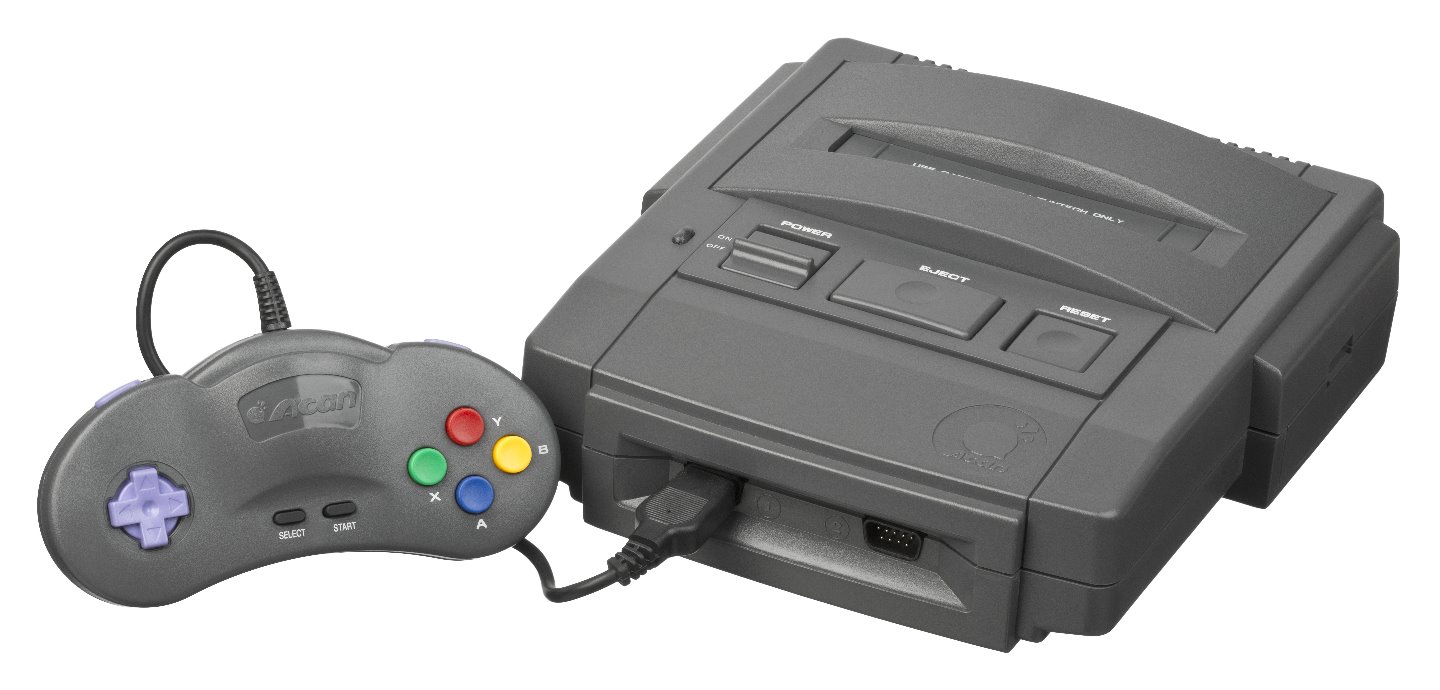
UMC(聯華電子)的子公司敦煌科技於1995年推出代號為F-16的Super A'can遊戲主機,其發售時間晚於1989年上市的Sega Mega Drive以及1990年上市的Nintendo Super Famicom,可歸類於第4世代的16 Bit遊戲主機,並以台灣研發的中文遊戲軟體為主要賣點,打破當年中文電視遊樂器遊戲相當希少的窘境。

延伸閱讀:
【模擬器改造】Mega Drive ( MD)篇:日式精神,美式風格
【模擬器改造】SUPER Famicom 超任:2D主機最後一道夕陽餘暉
儲存介面如何影響遊戲聲光效果?從卡匣、磁片到現代媒介的遊戲演化

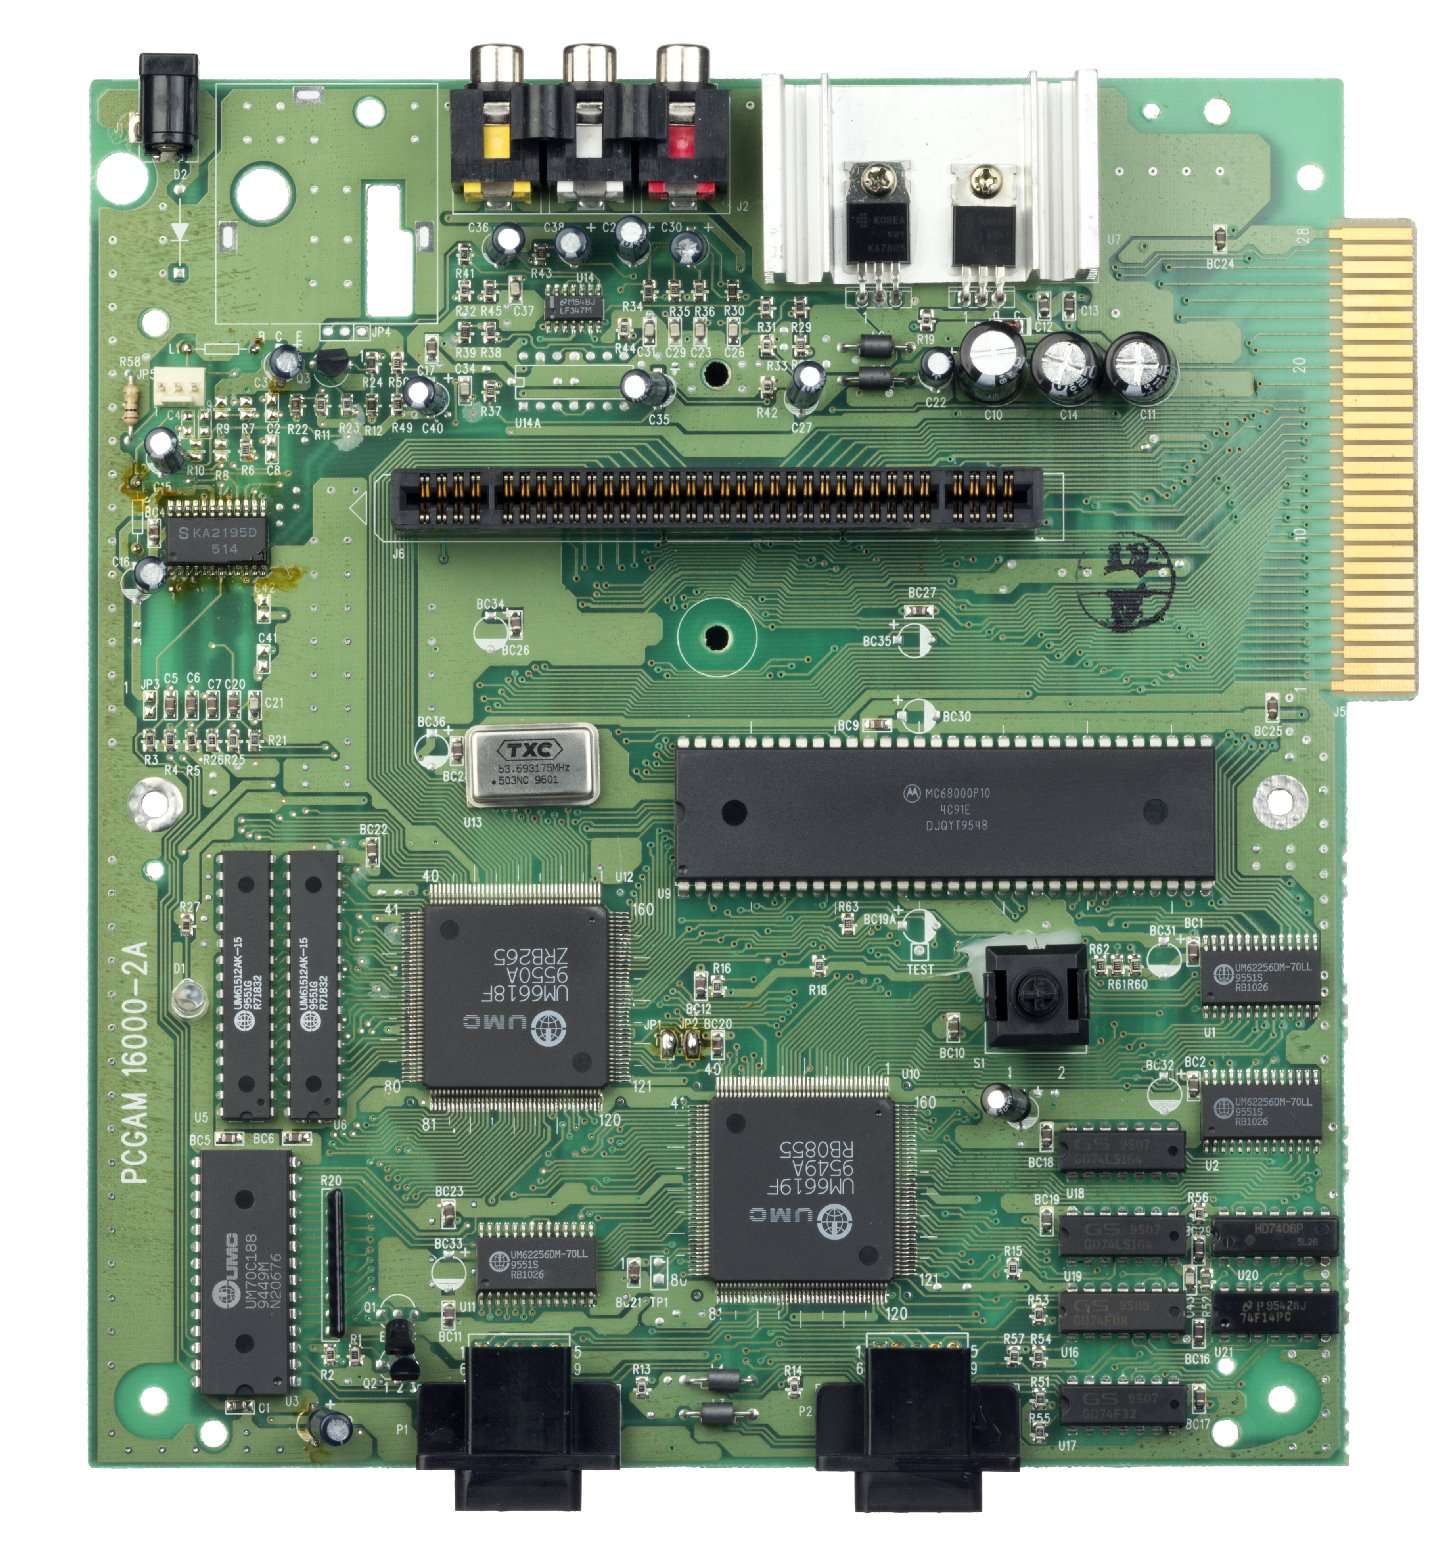
Super A'can搭載時脈為10.6 MHz的Motorola 68000與3.58 MHz的MOS 6502雙處理器,搭配容量為64 KB的工作記憶體、32 KB次要記憶體、128 KB顯示記憶體。

圖像處理器採用UMC UM6618顯示能力為640 x 480解析度、能夠同時顯示32768色中的256色,支援4層背景,可動角色圖層(Sprite)解析度可達256 x 256,並支援透明、旋轉、放縮、馬賽克等特效。音效處理器採用UMC UM6619,支援16組PCM音源。

然而Super A'can並沒有取得商業上的成功,生命週期中僅推出12款遊戲,加上11款開發中、未上市的遊戲,就黯然退出遊戲主機爭霸戰的舞台。

Super A'can的主機硬體與遊戲軟體都是由台灣研發、製作,在遊戲發展史算是比較特別的存在。

Super A'can採用許多UMC生產的機晶片,包含UM6618圖像處理器與UM6619音效處理器。值得注意的是主機板右側的金手指功能為連接周邊擴充裝置之用,但是Super A'can並沒有撐到擴充裝置上市就結束生命。

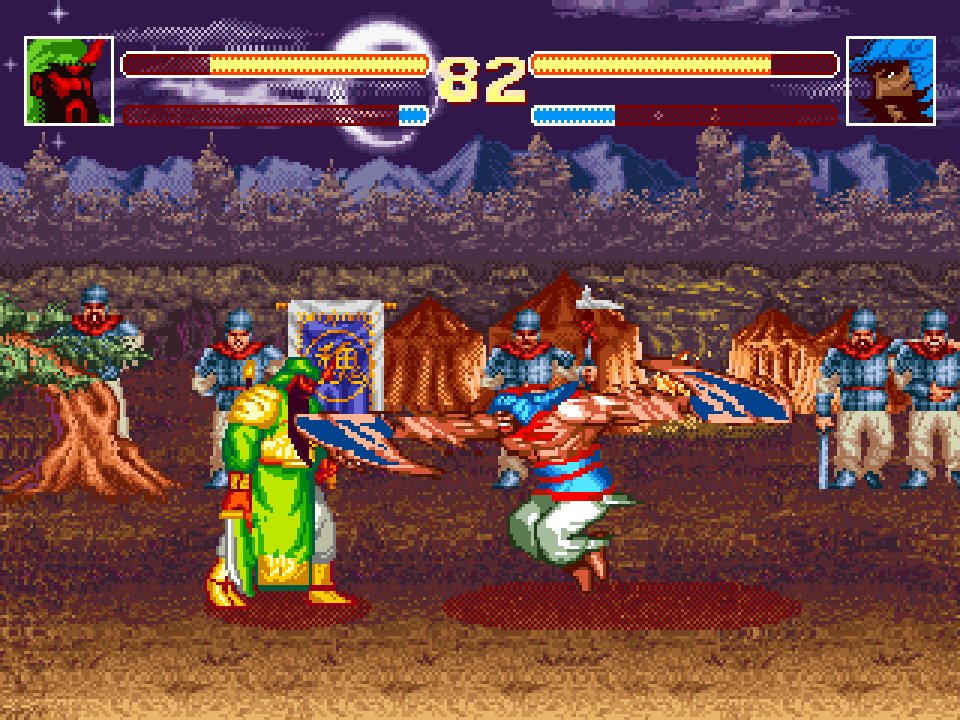
Super A'can的遊戲皆為鉅崴科技、熊貓軟體、敦煌科技在內的台灣廠商研發,故皆為中文遊戲。

模擬器動手玩

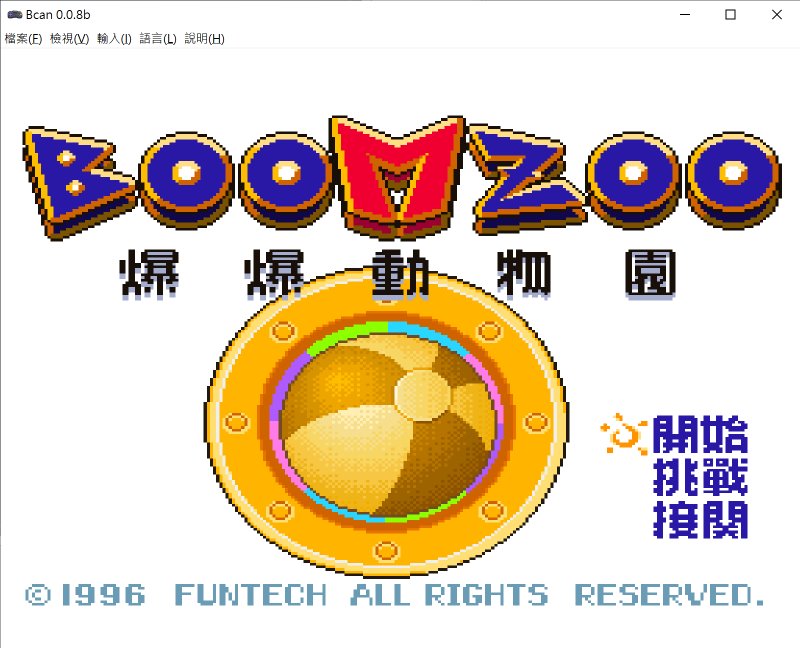
模擬器界的台灣傳奇人物Billy Jr先前就曾著手開發Super A'Can模擬器,並在2004年推出第一版模擬器,並在2010年正式納入MESS(Multi Emulator Super System)多系統模擬器,但是一直到2026年8月30日才由Billy Jr釋出高度完成的Super A'Can模擬器「Bcan」。

Super A'Can模擬器開發過程相關的故事,可以參考Billy Jr於Facebook粉絲團的貼文,文章的回覆也提供Bcan模擬器0.08b版的下載連結(Mega空間載點)。

Bcan模擬器0.0.8b版的功能相當完整,提供多種螢幕縮放、濾鏡效果以及即時存檔等功能,並支援手把操作。筆者隨意測試幾款遊戲,執行狀況皆相當理想,畫面與音效準確度也相當高,果然高手出手就是不一樣。

Bcan模擬器採用僅支援Super A'Can系統的獨立式設計,操作上相對比較簡單。

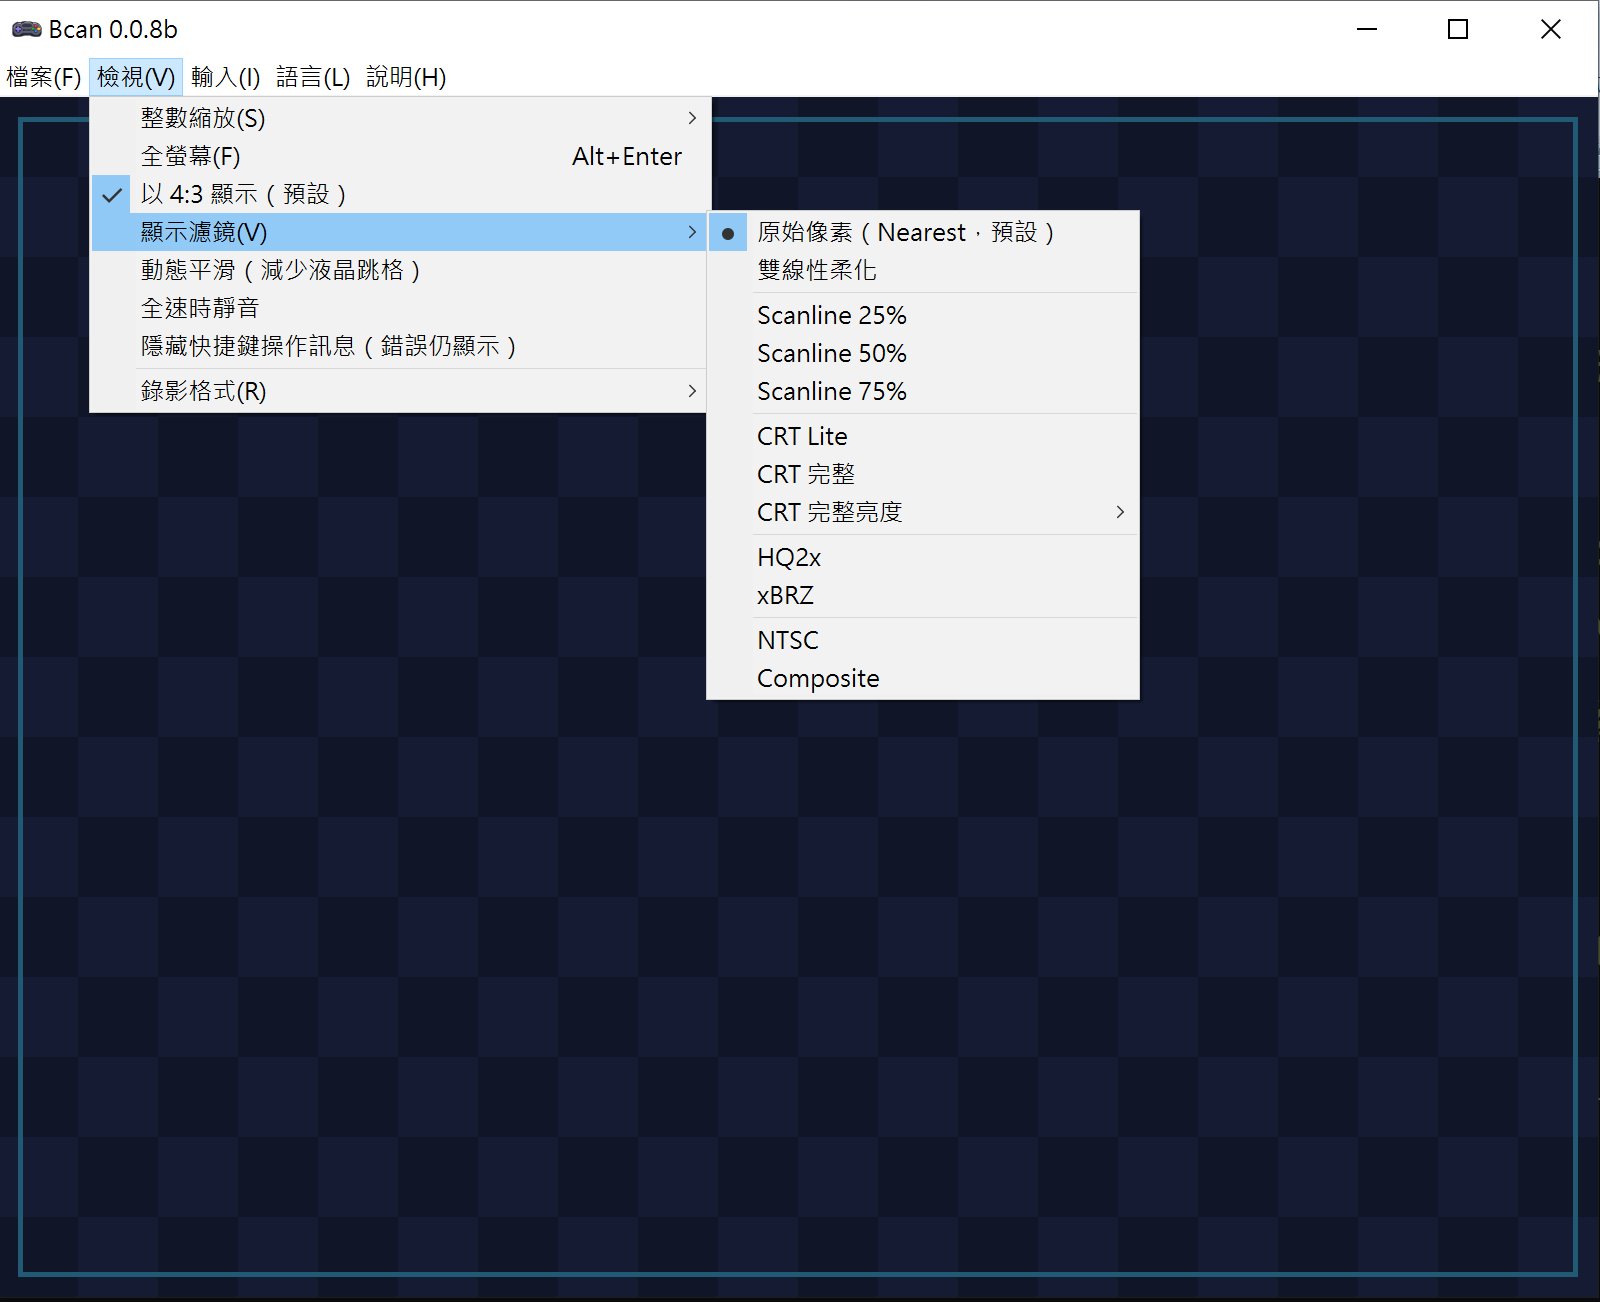
Bcan模擬器0.0.8b版提供多種濾鏡效果,可以模擬映像管電視的效果。

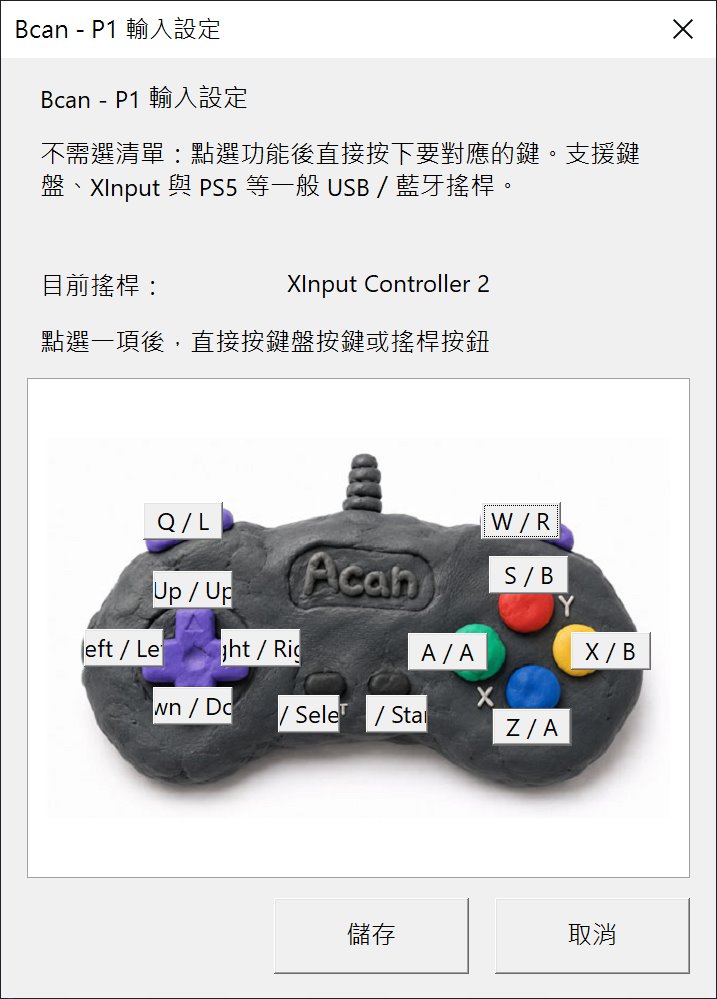
玩家可以設定使用鍵盤或是手把進行操作。

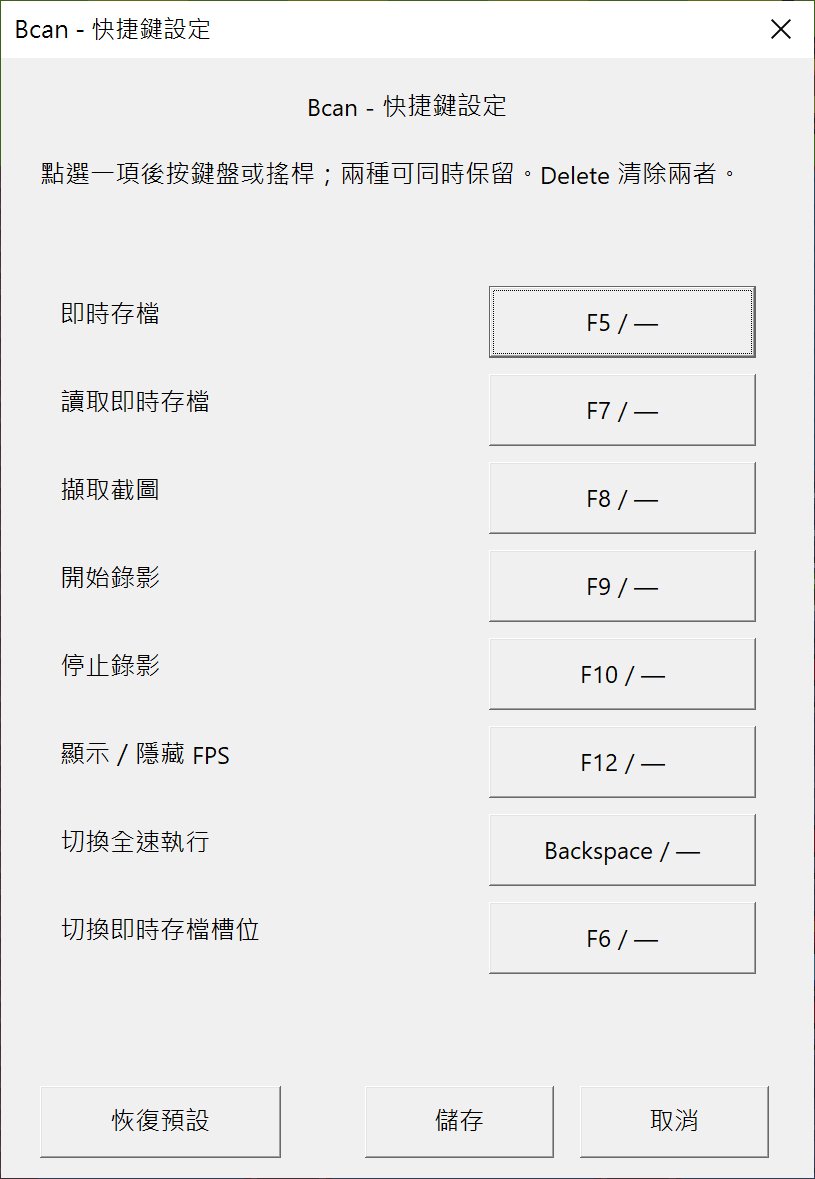
模擬器的多種功能也能自行設定熱鍵。

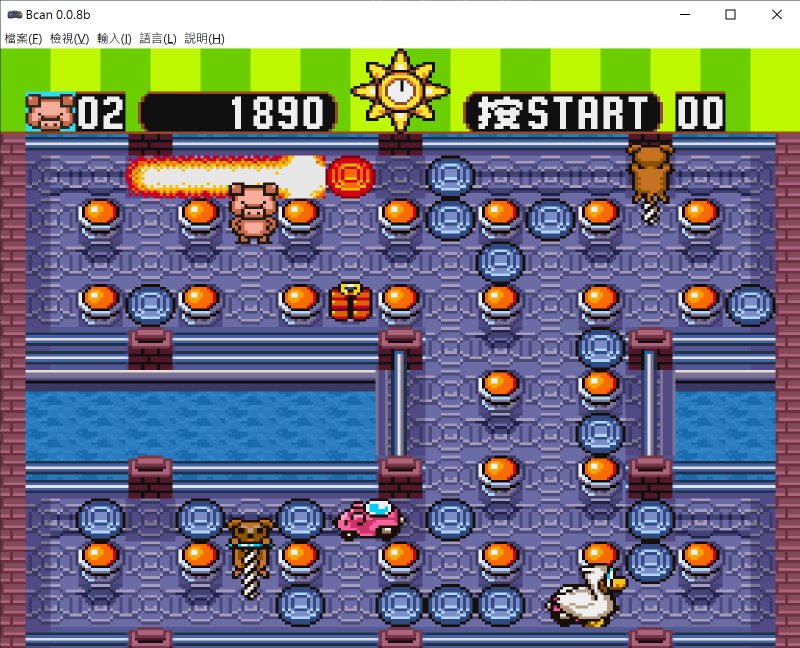
首先看到《爆爆動物園》遊戲的執行狀況。

它是款仿製《轟炸超人》(Bomberman)的遊戲。

▲《爆爆動物園》的畫面與音效一切正常。

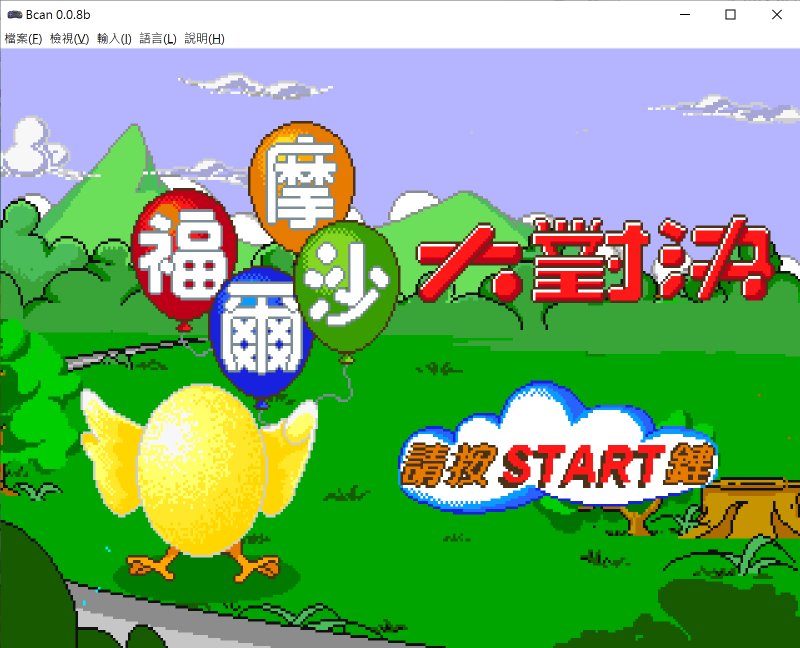
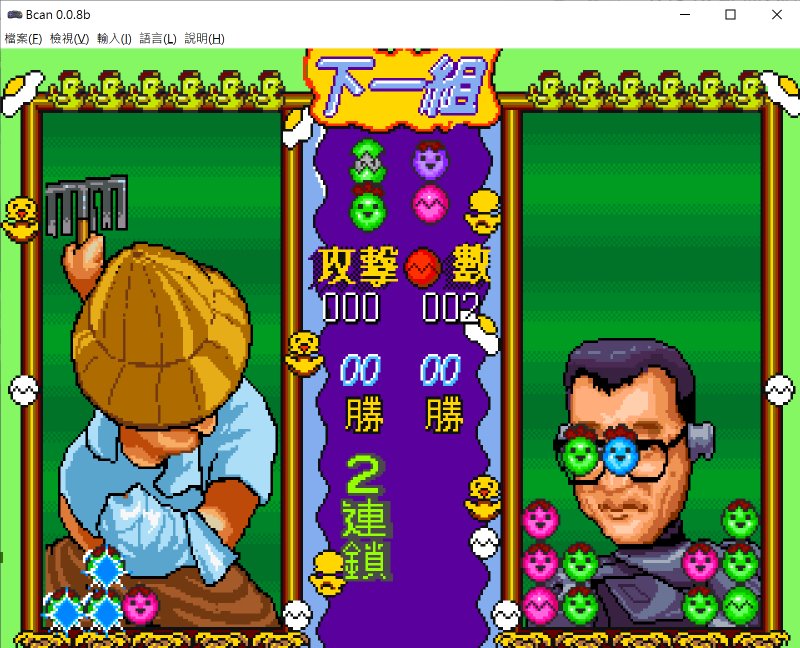
接下來看到《福爾摩沙大對決》。

它是款與《對戰方塊》(Battle Puzzle Dama)類似的落下型方塊遊戲。

▲《福爾摩沙大對決》的特色是具有語音演出,甚至能夠聽到親切的台語配音。

從Bcan模擬器終於問世,可以從中看到模擬器開發工作並不簡單,尤其是Super A'Can中使用多款UMC客製化的晶片並沒有可以參考的規格與資料,有興趣瞭解更多開發秘辛可以參考參與Bcan模擬器測試工作的低分少年所製作的《台灣國產遊戲機 A'Can 模擬器正式完成!》影片。

加入T客邦Facebook粉絲團

Intel於Hot Chips 2026展示代理式AI與企業級產品,Diamond Rapids導入Intel 18A-P製程與扇出拓樸

2026年8月27日 14:45
Intel展示代號為Diamond Rapids的次世代Xeon處理器,它除了採用最新Intel 18A-P節點製程,也搭配Foveros Direct 3D先進封裝與UCIe-S互連技術。90b34fd570e5ccb081f69891f2d748fc

Intel展示代號為Diamond Rapids的次世代Xeon處理器,它除了採用最新Intel 18A-P節點製程,也搭配Foveros Direct 3D先進封裝與UCIe-S互連技術。

256核心搭1.28 GB LLC

Intel於Hot Chips 2026大會展示Diamond Rapids處理器、Crescent Island GPU(繪圖處理器)等針對企業用戶規劃的代理式AI產品,以及針對消費級應用設計的Wildcat Lake處理器,並詳細介紹這些產品的特色。首先我們先看到Diamond Rapids的部分,並於後續文章中繼續探討。

延伸閱讀:
Intel於IFS Direct Connect 2024宣布與聯電合作,並發表Intel 14A與多項「4年5節點」之後發展路線圖
Intel說明Xeon 6處理器與Gaudi 3加速器優勢,雙路處理器給你滿滿192條PCIe Gen 5通道
Intel推出新款Xeon 6處理器,強化AI運算效能與效益還能跑DeepSeek

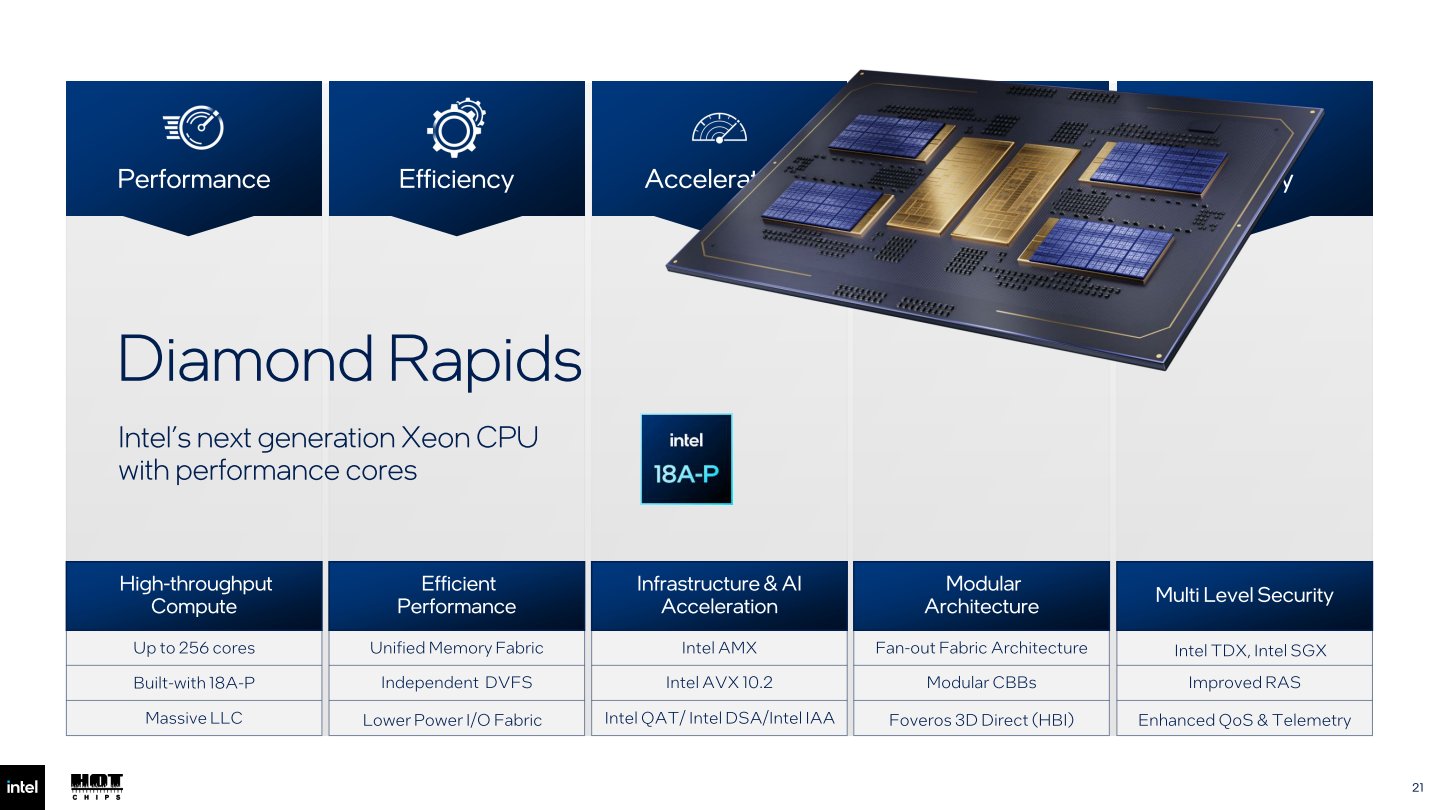
代號為Diamond Rapids的次世代Xeon處理器針對包含企業級代理式AI在內的多種用途設計,導入全新架構,結合可靈活配置的運算模組、統一記憶體互連架構與彈性I/O,並採用進一步強化的Intel 18A-P節點製程,搭配Foveros Direct 3D先進封裝與UCIe-S互連技術,提供穩定的高效能、高效率與可擴展性。

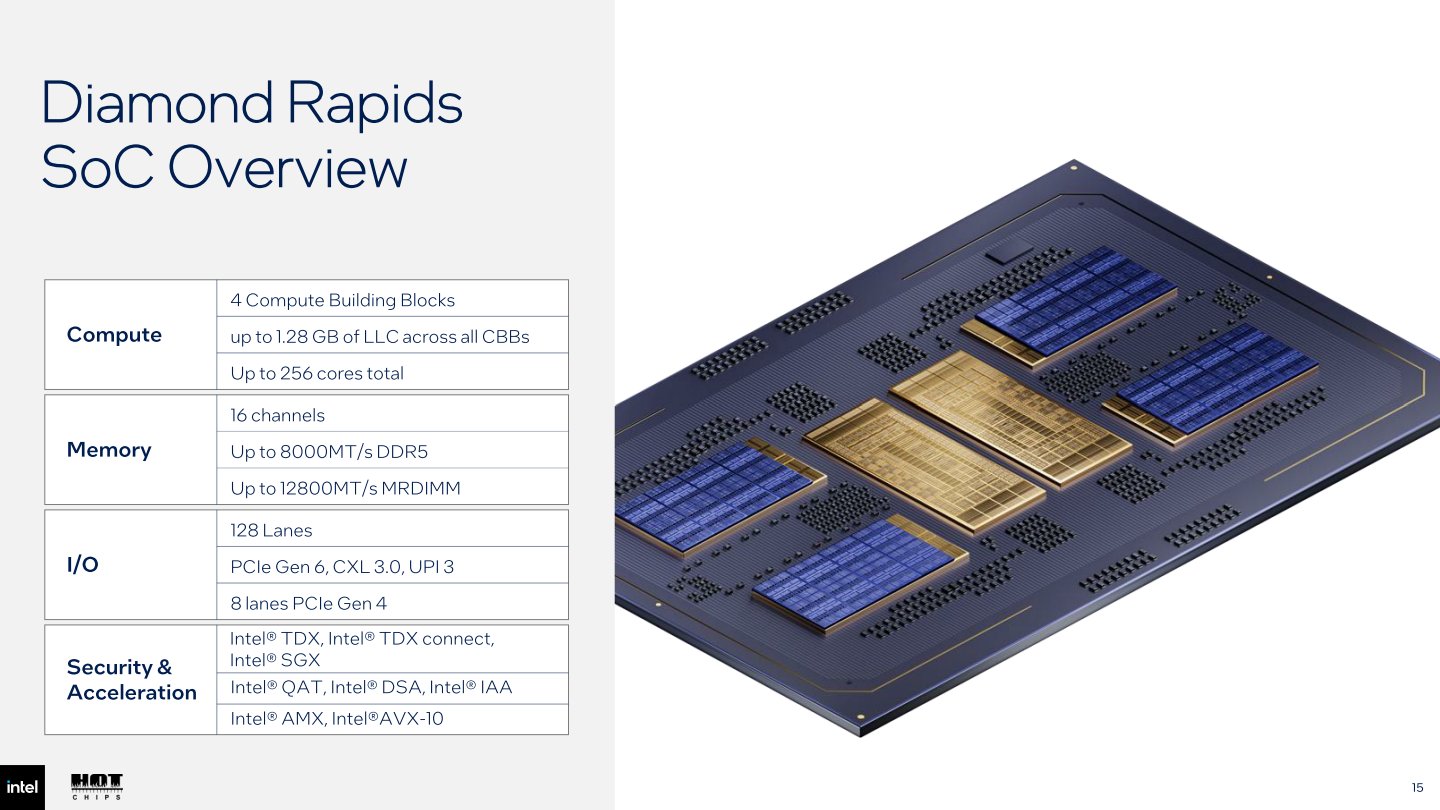
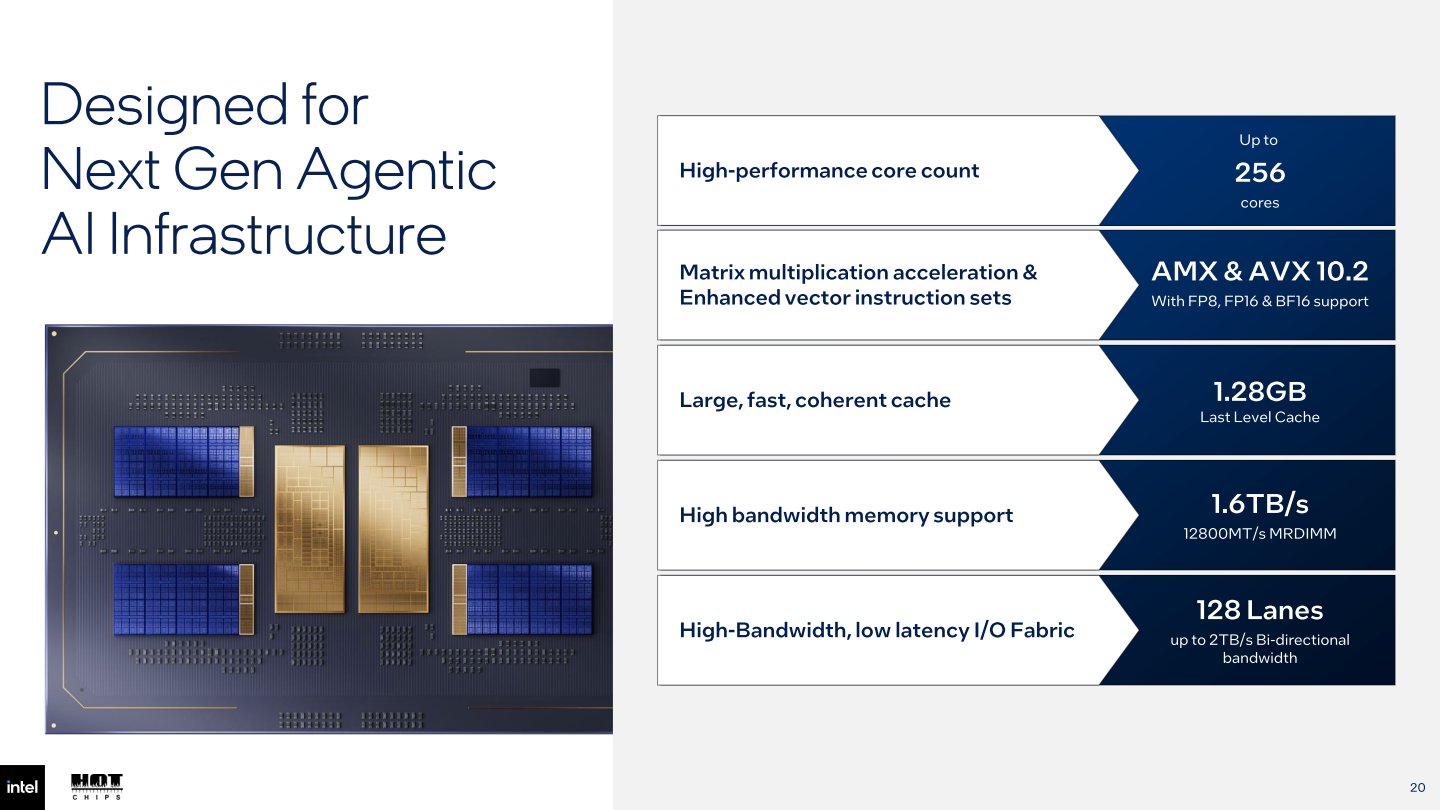
Diamond Rapids處理器最多可以容納4組運算建置模塊(Compute Building Block),每組模塊又可以容納4組運算小晶片(Compute Chiplet),而每組小晶片又能容納16組處理器核心,因此單一處理器最高可達256核心組態,並具有最高1.28 GB最後階快取記憶體(LLC,Last Level Cache)。

Diamond Rapids支援DDR5-8000 RDIMM或DDR5-12800 MRDIMM(Multiplexed Rank DIMM,多工階級雙行記憶體模組),最高可組成16通道記憶體組態。擴充能力部分則提供128組PCIe Gen 6通道與8組PCIe Gen 4通道,並支援UPI 3(Ultra Path Interconnect)與CXL 3.0(Compute Express Link)等互連技術,強化多處理器之間的資料交換,以及擴充記憶體、記憶體池化等彈性擴充功能。

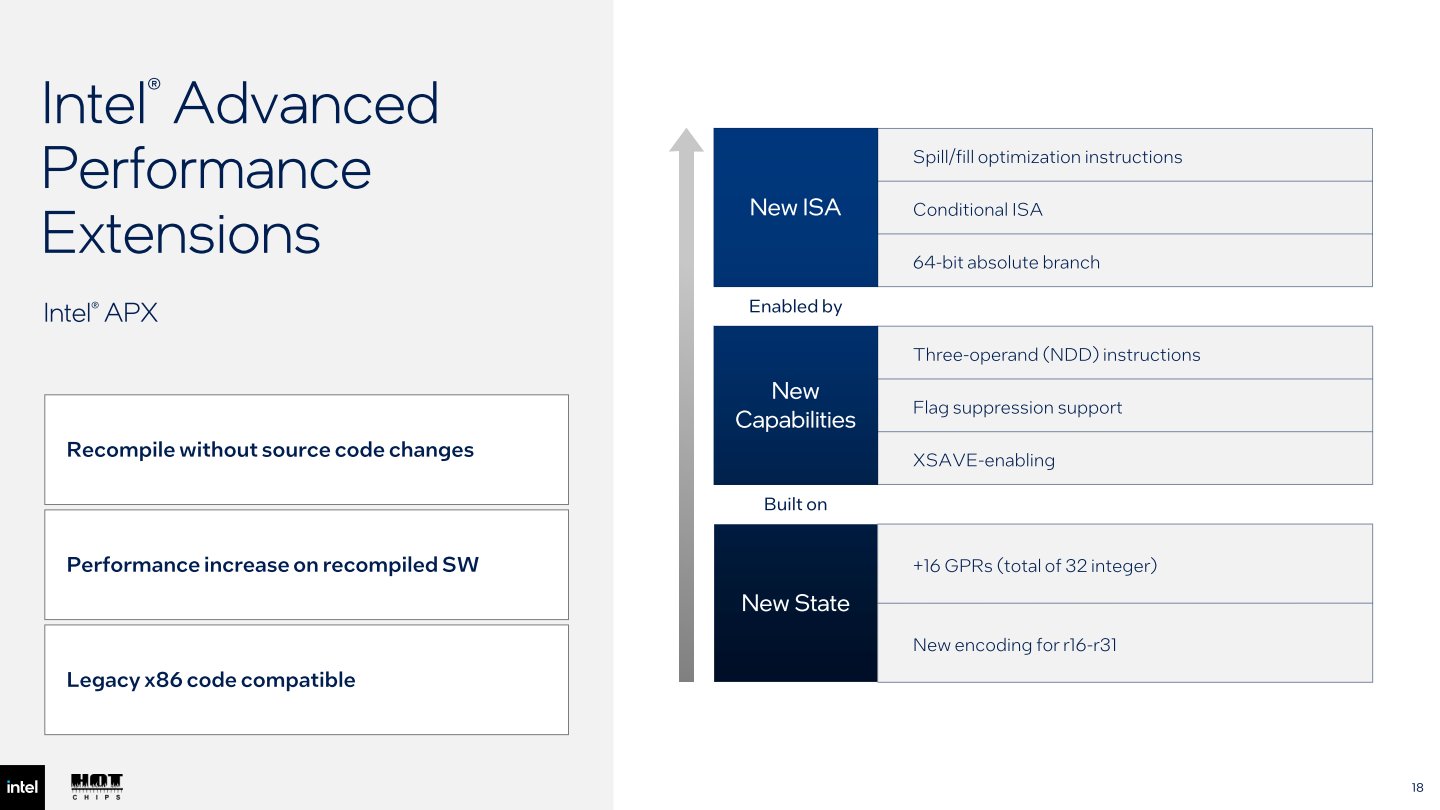
此外Diamond Rapids也支援APX延伸指令集(Advanced Performance Extensions)與AMX進階矩陣延伸指令集(Advanced Matrix Extensions),以加速處理器上執行AI應用程式的效能。

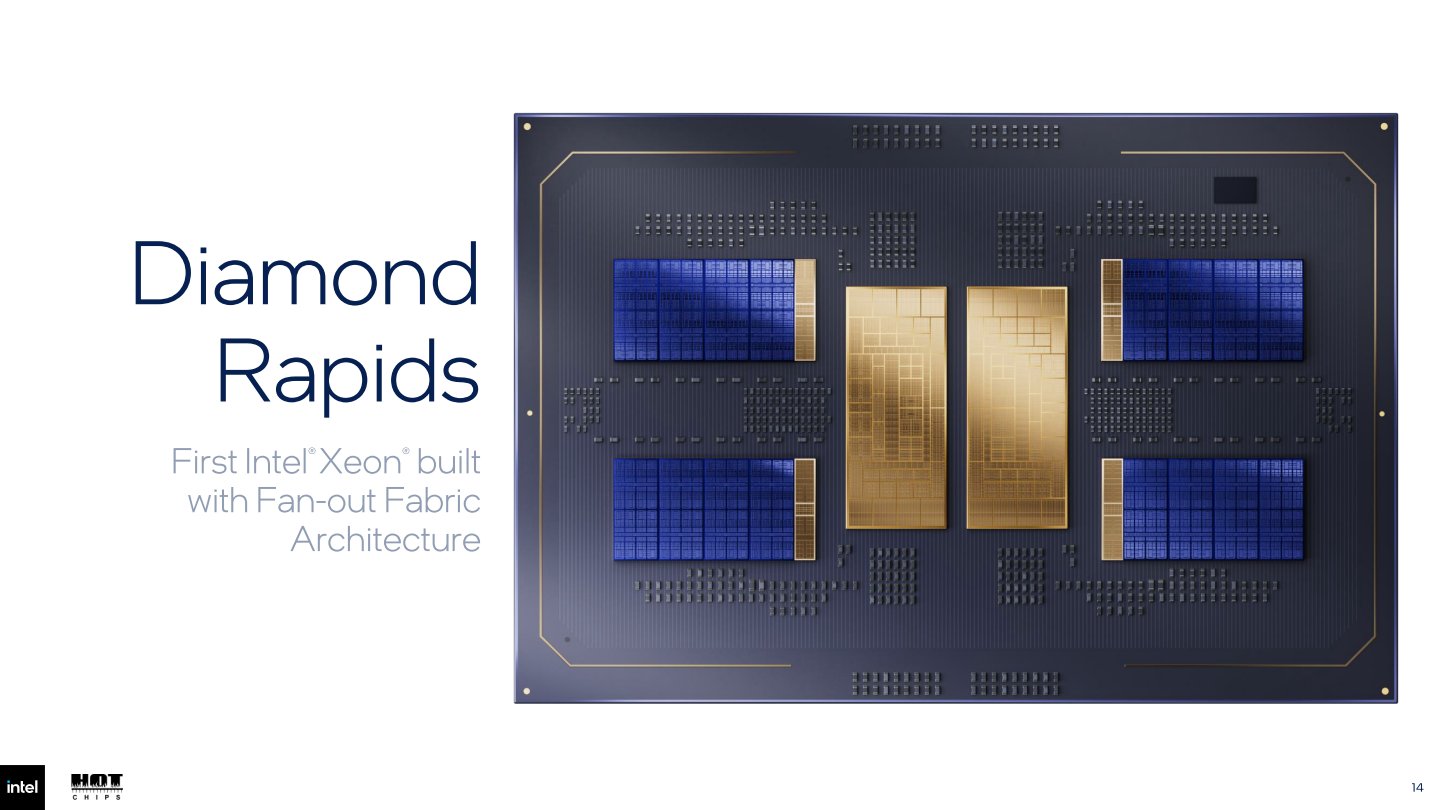
Intel於Hot Chips 2026大會展示Diamond Rapids處理器,並說明其架構特色。

Diamond Rapids最高可達256核心組態,並具有最高1.28 GB最後階快取記憶體。

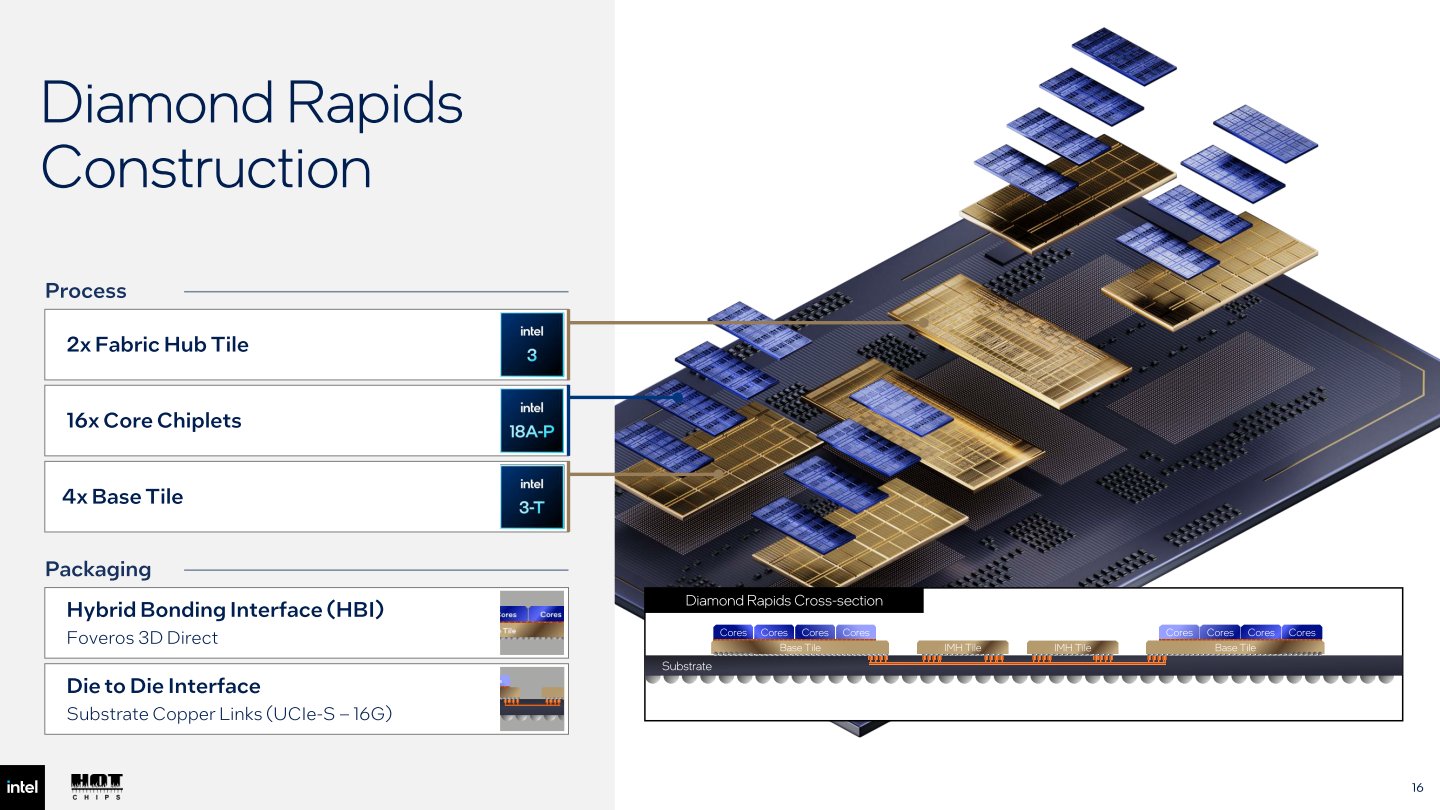
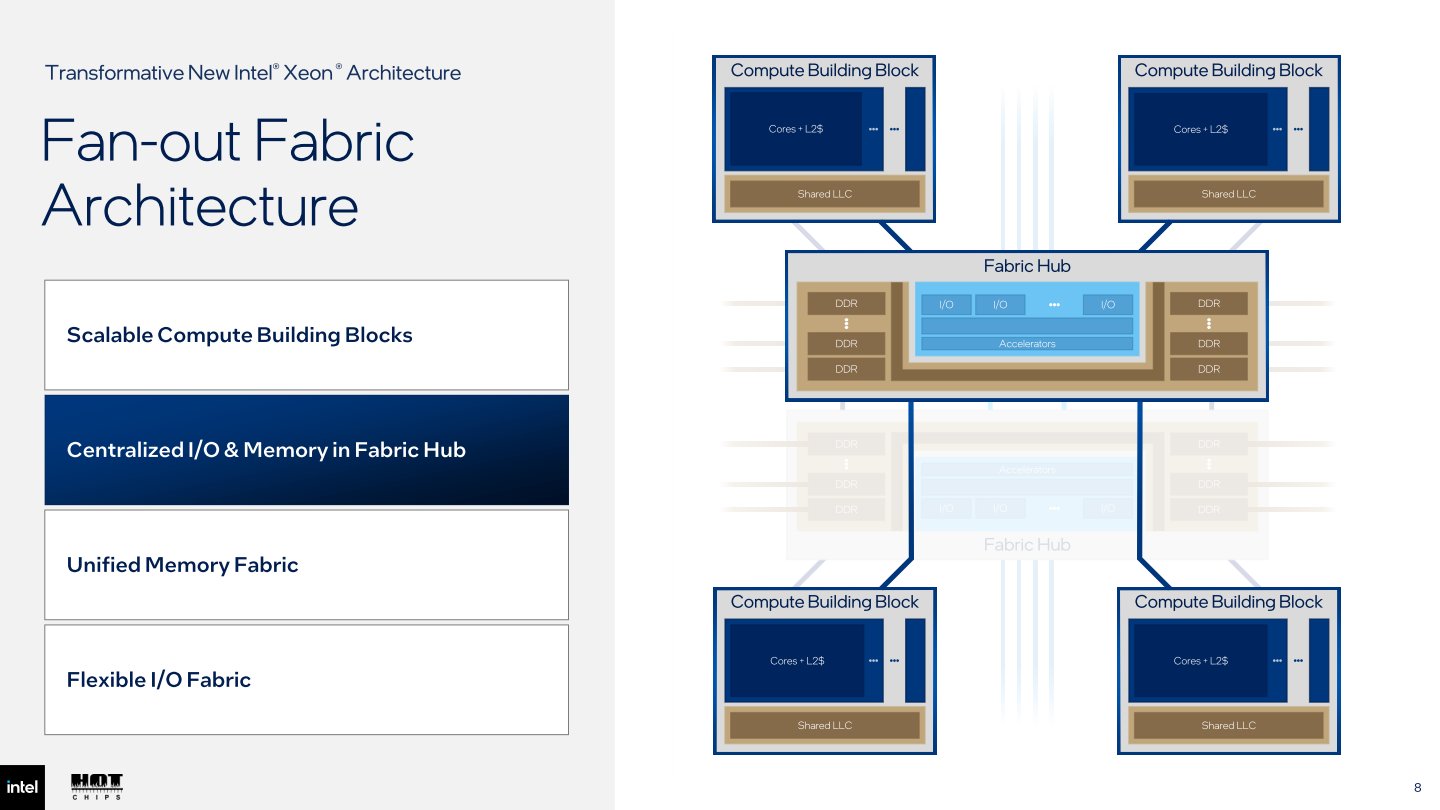
其處理器核心分散在4組運算建置模塊上,而承載核心的運算小晶片採用Intel 18A-P節點製程。此外處理器還有2組互連集線器模塊(Fabric Hub Tile)負責記憶體存取與I/O功能。

在16通道DDR5-12800 MRDIMM記憶體的加持下,頻寬可達1.6 TB/s。

Diamond Rapids不但支援AVX10.2、AMX等指令,也加入新的APX延伸指令集(Advanced Performance Extensions),在相容x86架構的同時強化AI運算效能表現。

Diamond Rapids能夠兼顧效能與電力效率表現,並具有加速AI運算的能力,同時提供多層資安防護功能。

18A-P節點製程初登板

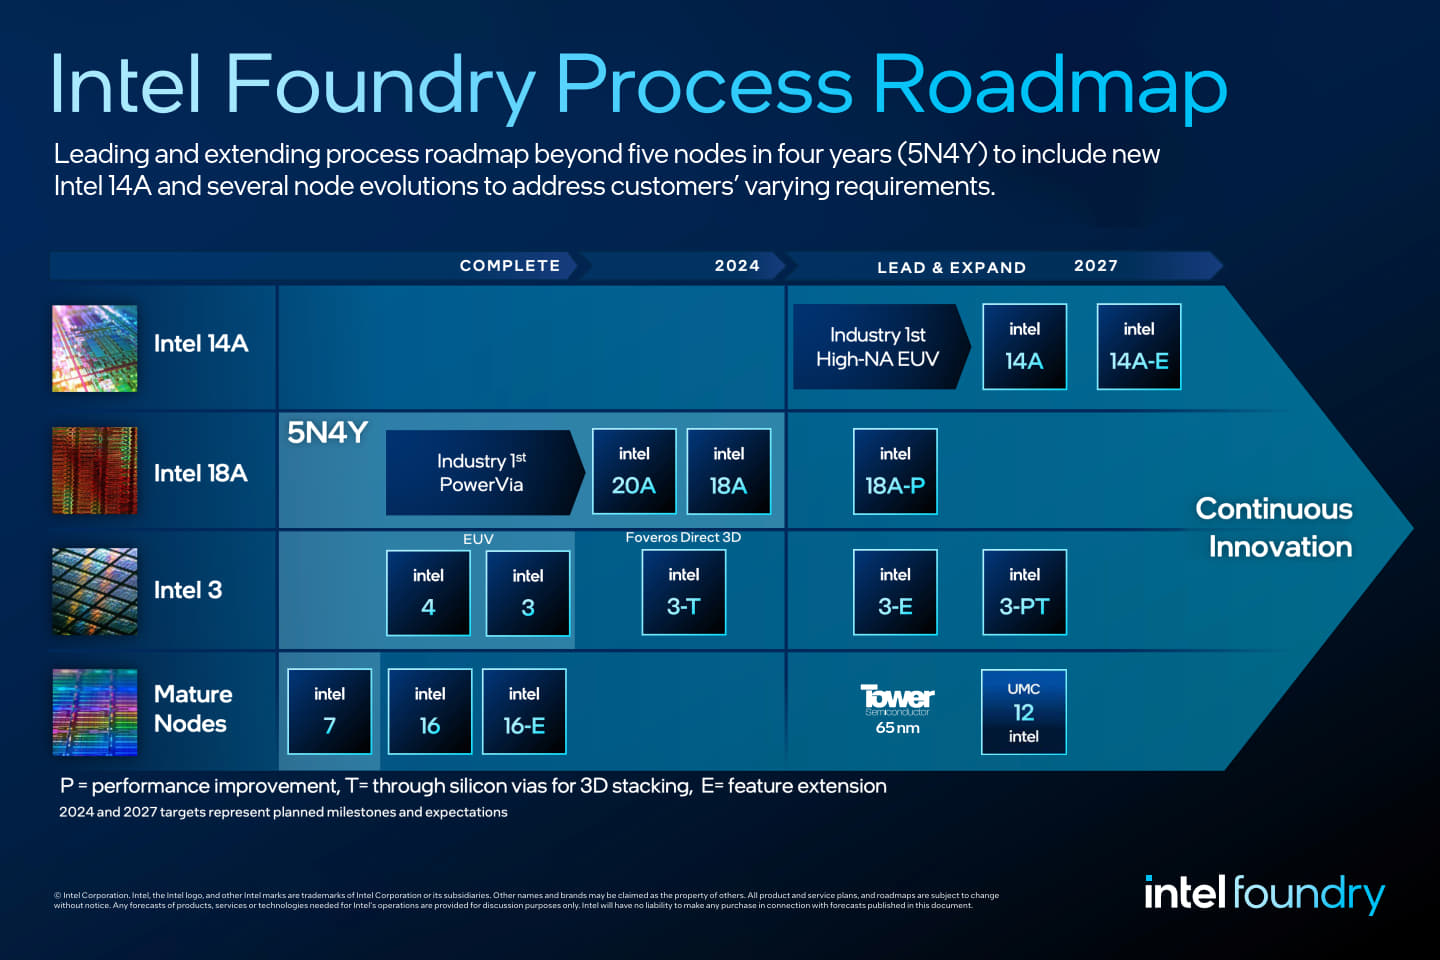
回顧Intel先前於IFS Direct Connect 2024大會上宣佈「4年5節點」的Intel 7、4、3、20A、18A節點開發進度都符合預期時程,同時也發表往後的發展路線圖。而Diamond Rapids的運算小晶片則是首款採用Intel 18A-P節點製程的產品,它維持先前RibbonFET環繞式閘極(即GAA)與PowerVia晶背供電等技術,並改善電晶體的效能表現。

值得注意的是,承載4組運算小晶片的基礎模塊(Base Tile)採用導入TSV矽穿孔(Through-Silicon Via)的Intel 3-T節點製程,搭配Foveros 3D Direct技術之混合鍵結(Hybrid Bonding)方式封裝,能讓小晶片與模塊上的金屬接點直接互相連接,以改善訊號品質與阻抗,達到更高傳輸速度並節省電力。 而運算建置模塊、互連集線器模塊則是使用UCIe-S互連技術,同樣採用銅線進行連接。

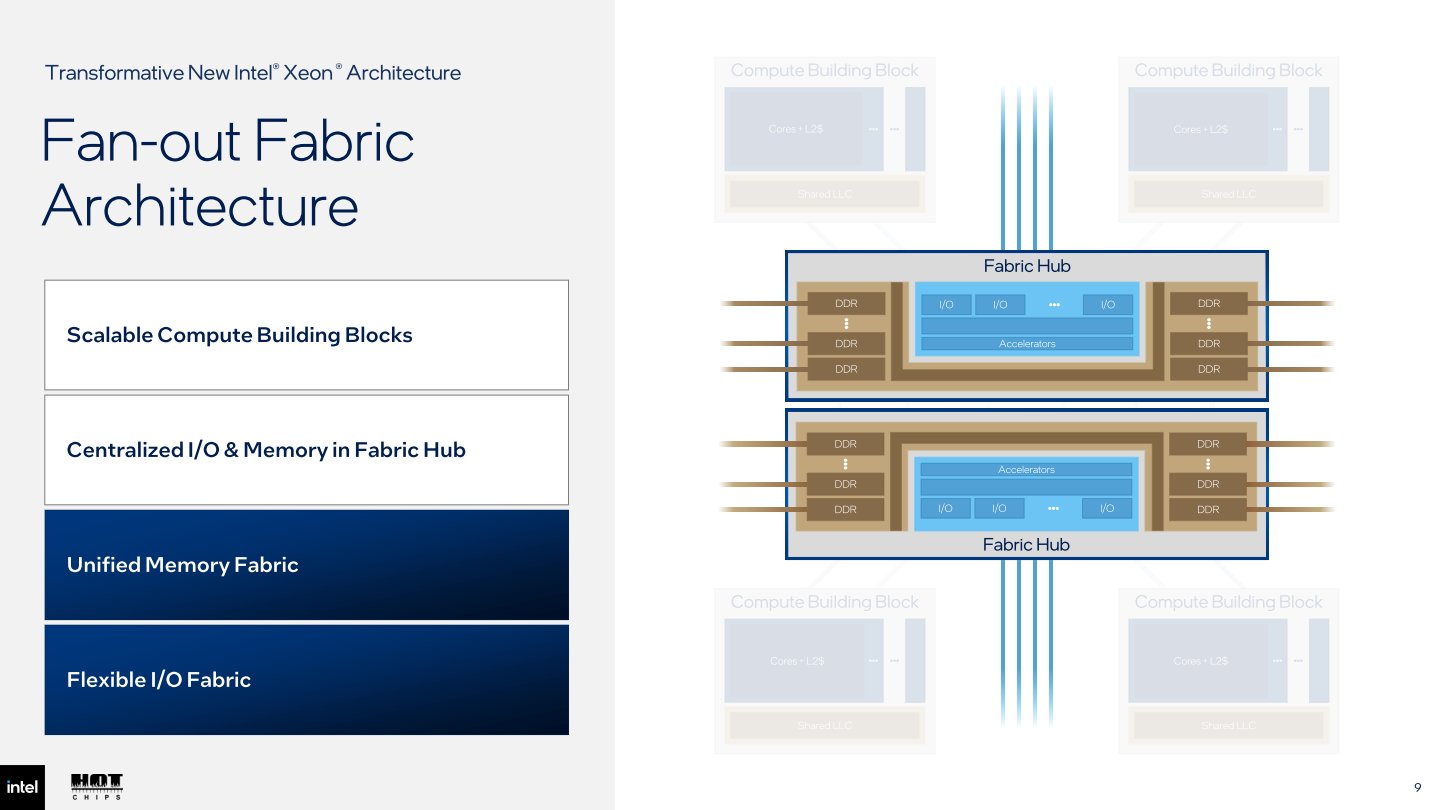
另一方面作為處理器SoC中樞的互連集線器模塊,也透過扇出拓樸(Fan-Out)的方式,直接與運算建置模塊、記憶體等元件的接點相連,同樣能夠改善傳輸速度與電力消耗。

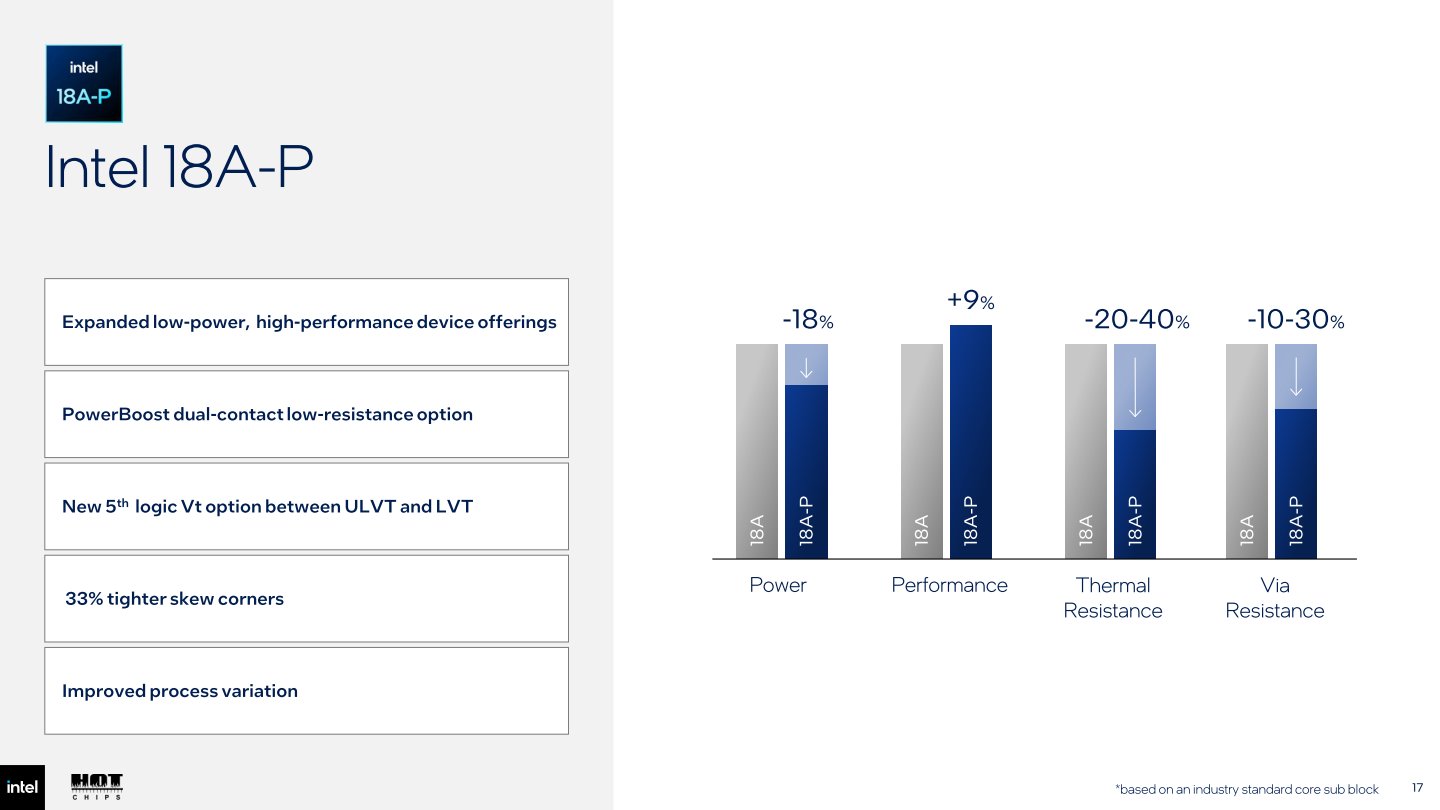
Intel於IFS Direct Connect 2024就預告以18A節點製程為基礎強化的18A-P節點製程,其中P代表效能提升,而3T節點製程則是以3節點製程並導入TSV。

根據Intel提供的數據,18A-P節點製程能較18A提升9%效能,並節省18%電力消耗。

Diamond Rapids的另一個特色就是在互連集線器模塊與運算建置模塊、記憶體之間的通訊採用扇出拓樸,改善傳輸頻寬與延遲。

記憶體通訊分也由互連集線器模塊的記憶體控制器進行連接,同樣採用扇出拓樸。

筆者將在後續文章中繼續分析Crescent Island GPU、Wildcat Lake處理器的架構與特色,請讀者參考下列目錄。

Intel Hot Chips 2026系列報導目錄
Intel於Hot Chips 2026展示代理式AI與企業級產品,Diamond Rapids導入扇出拓樸與Intel 18A-P製程(本文)
Crescent Island GPU架構與特色介紹(暫定,工作中)
Wildcat Lake處理器架構與特色介紹(暫定,工作中)

加入T客邦Facebook粉絲團
❌
❌