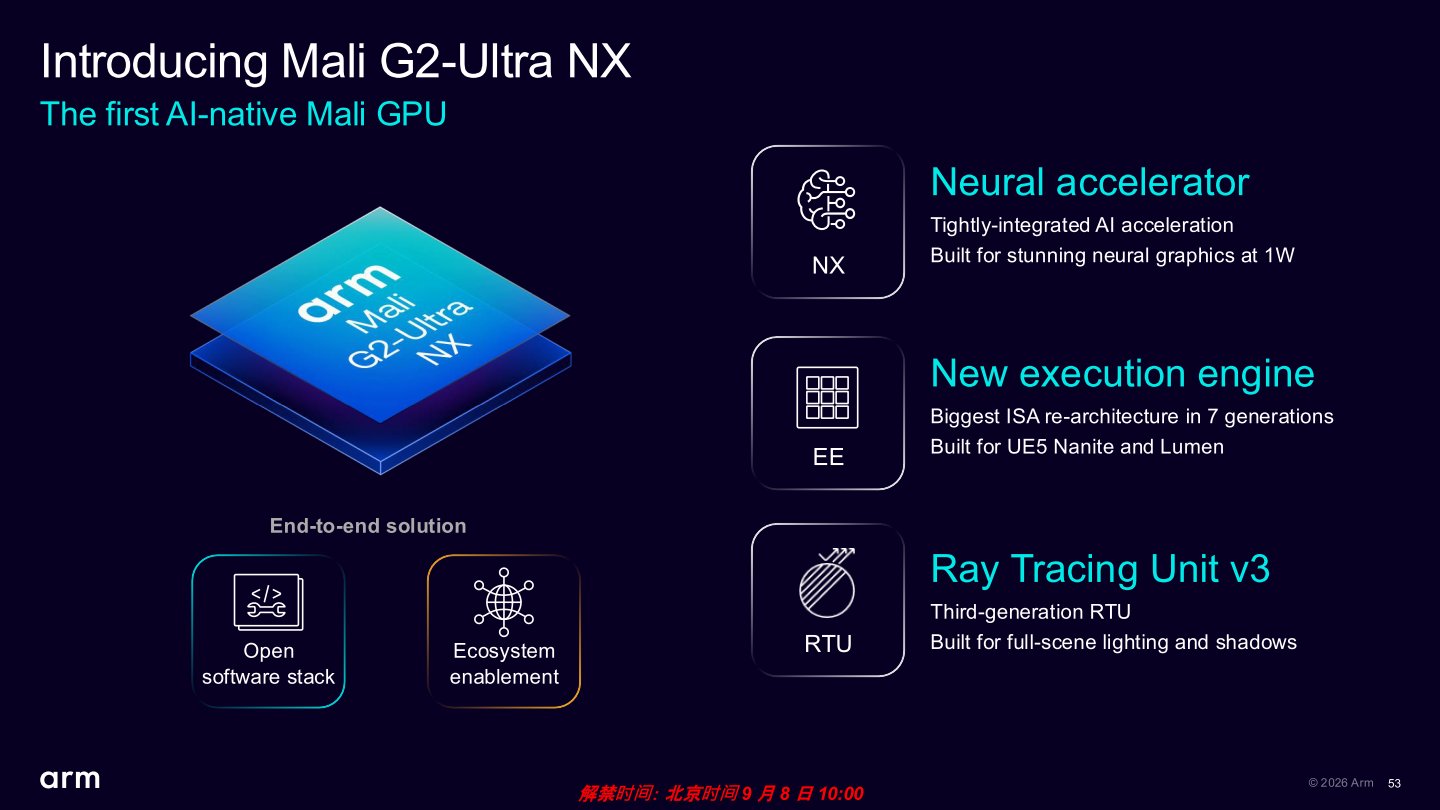
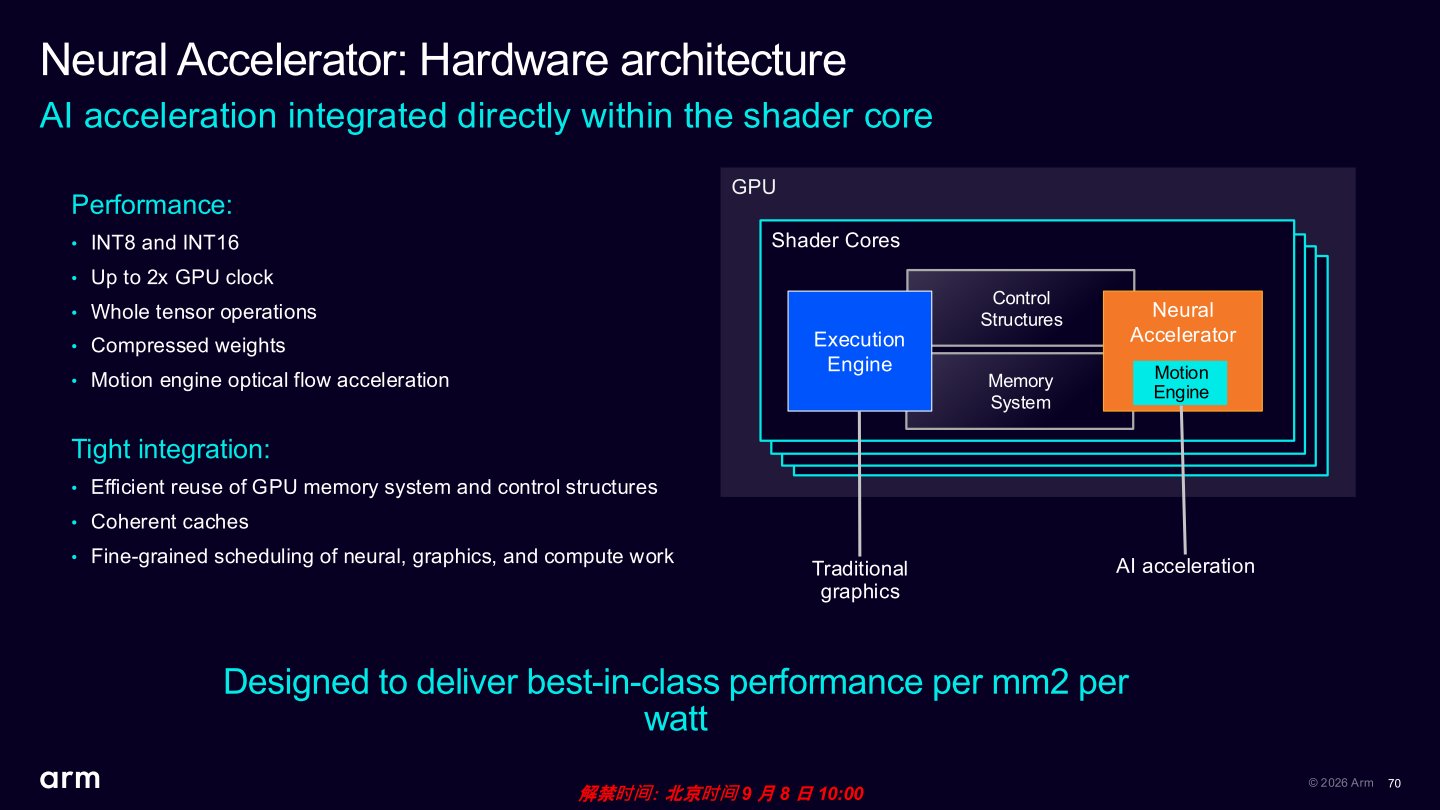
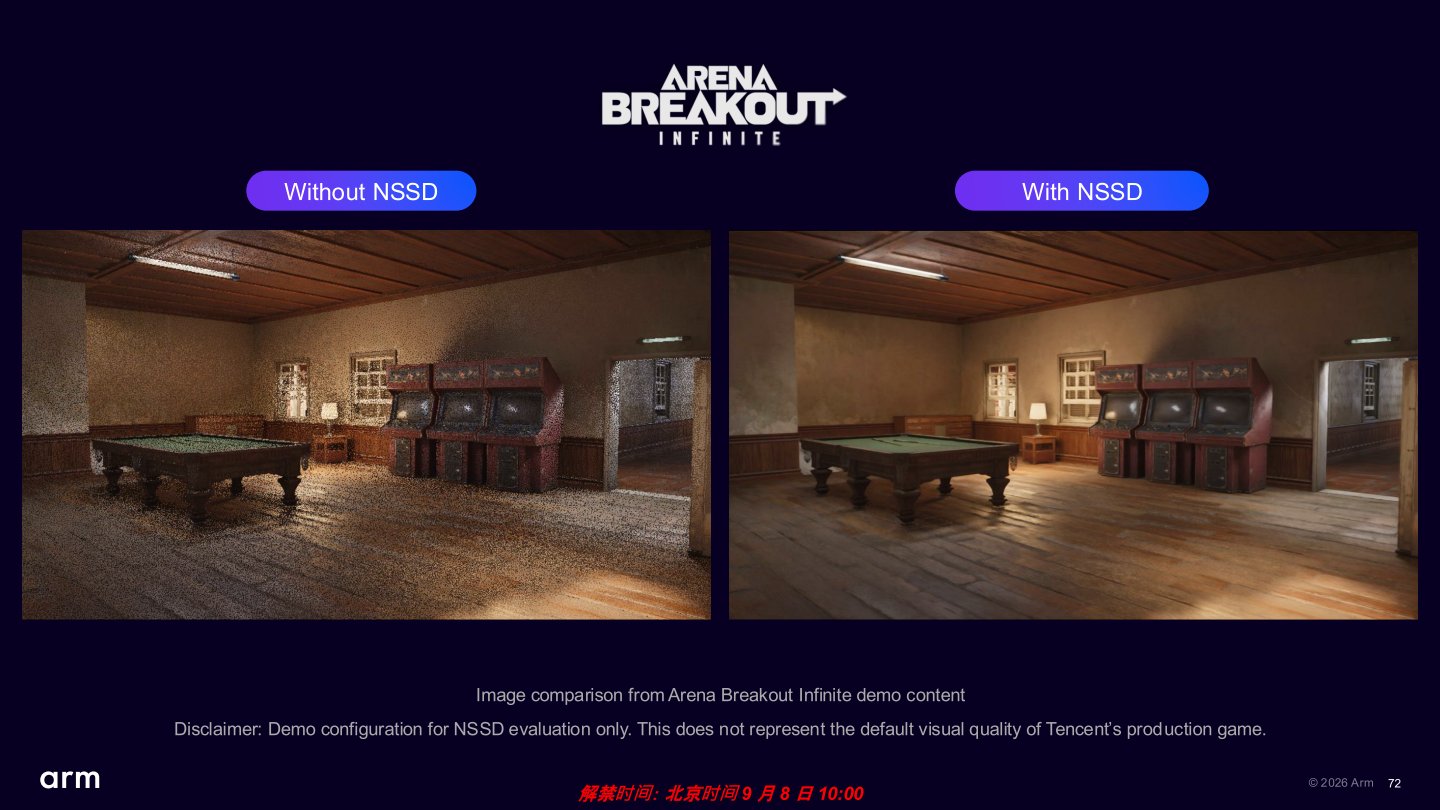
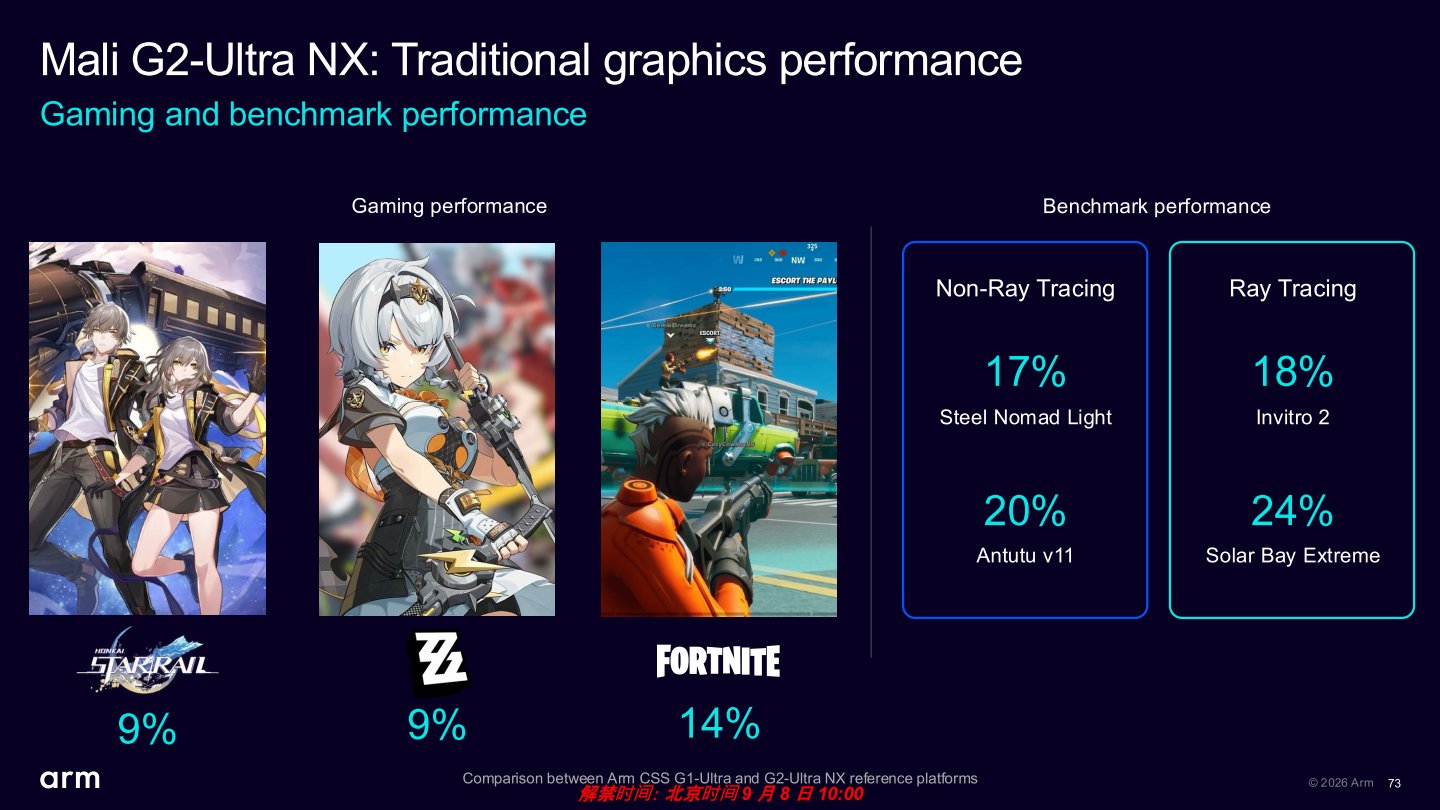
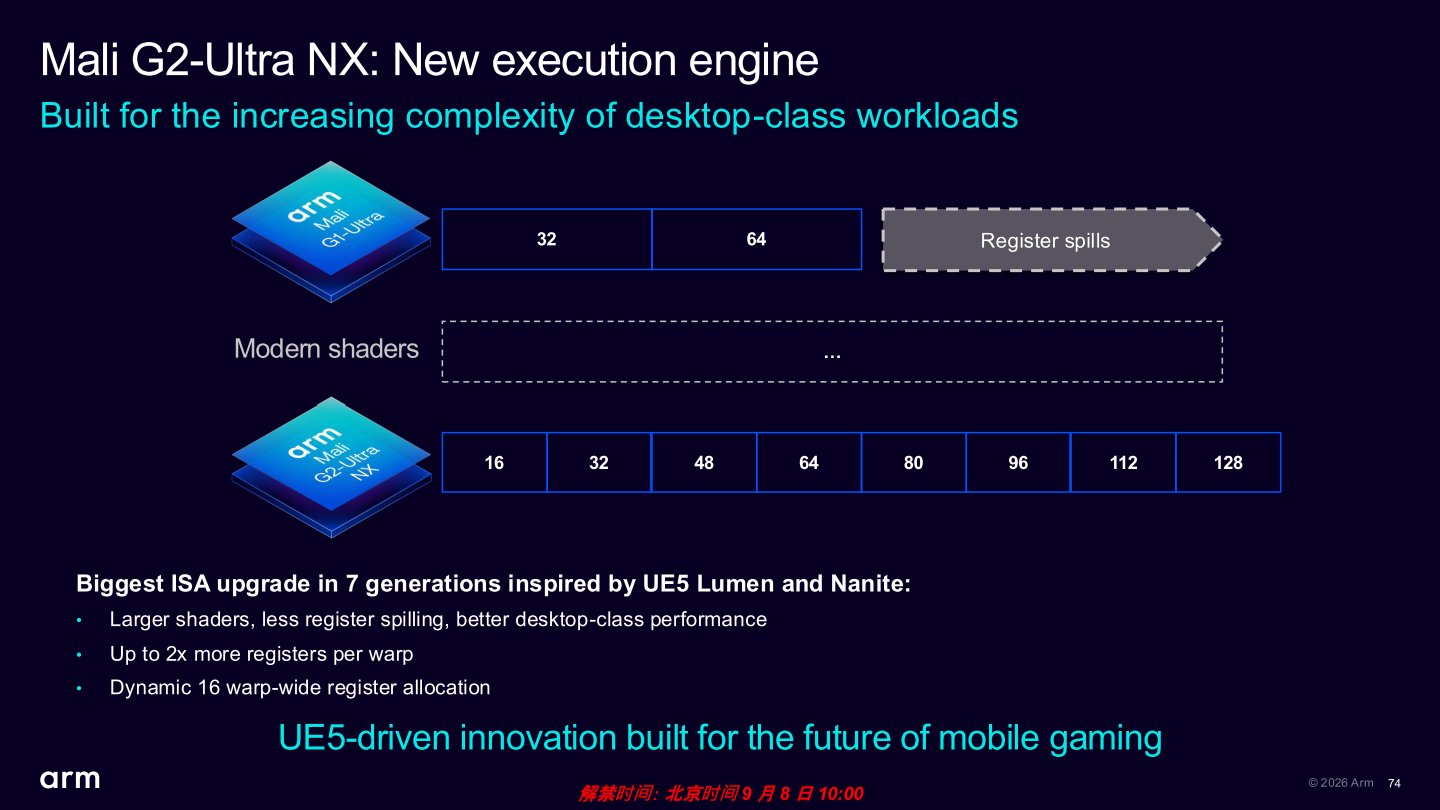
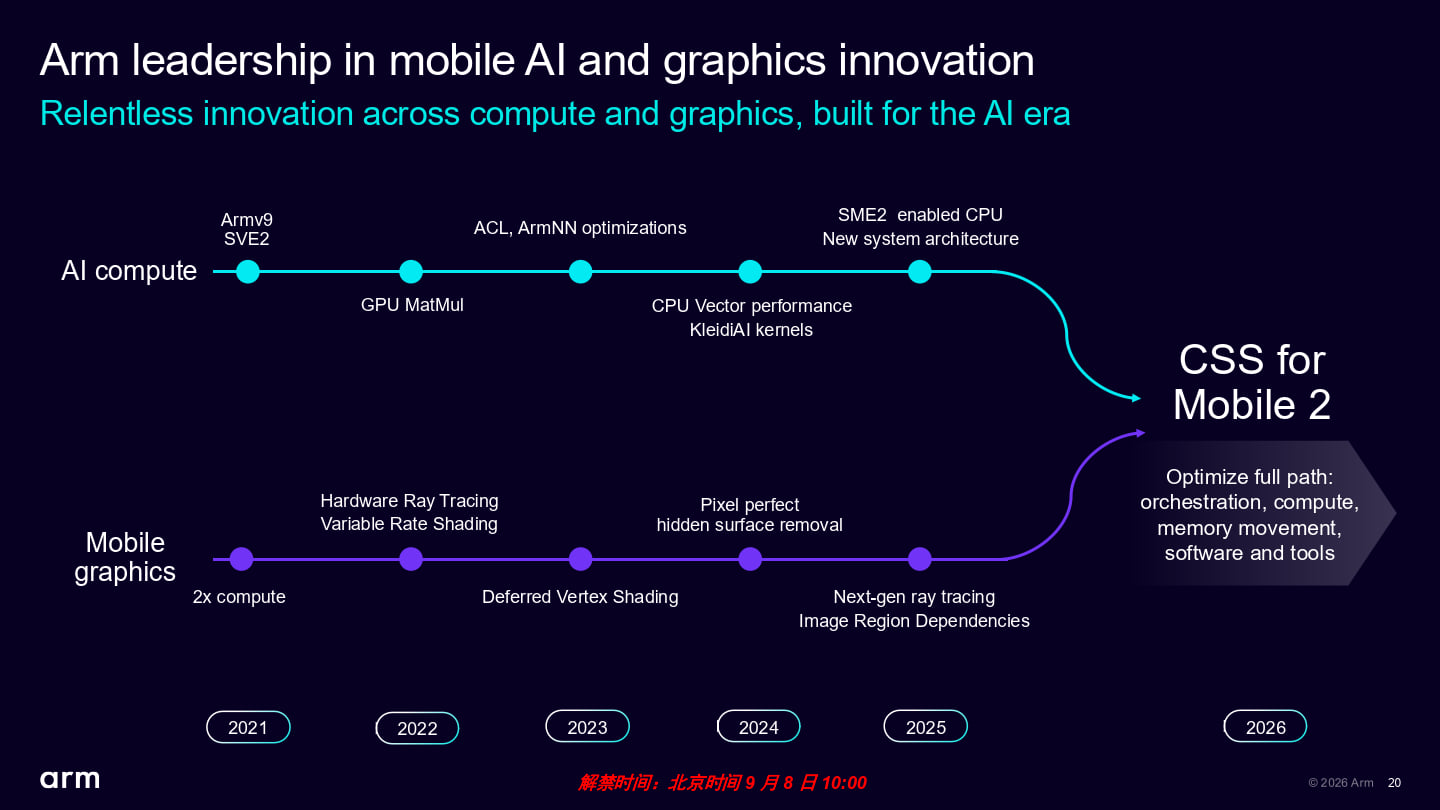
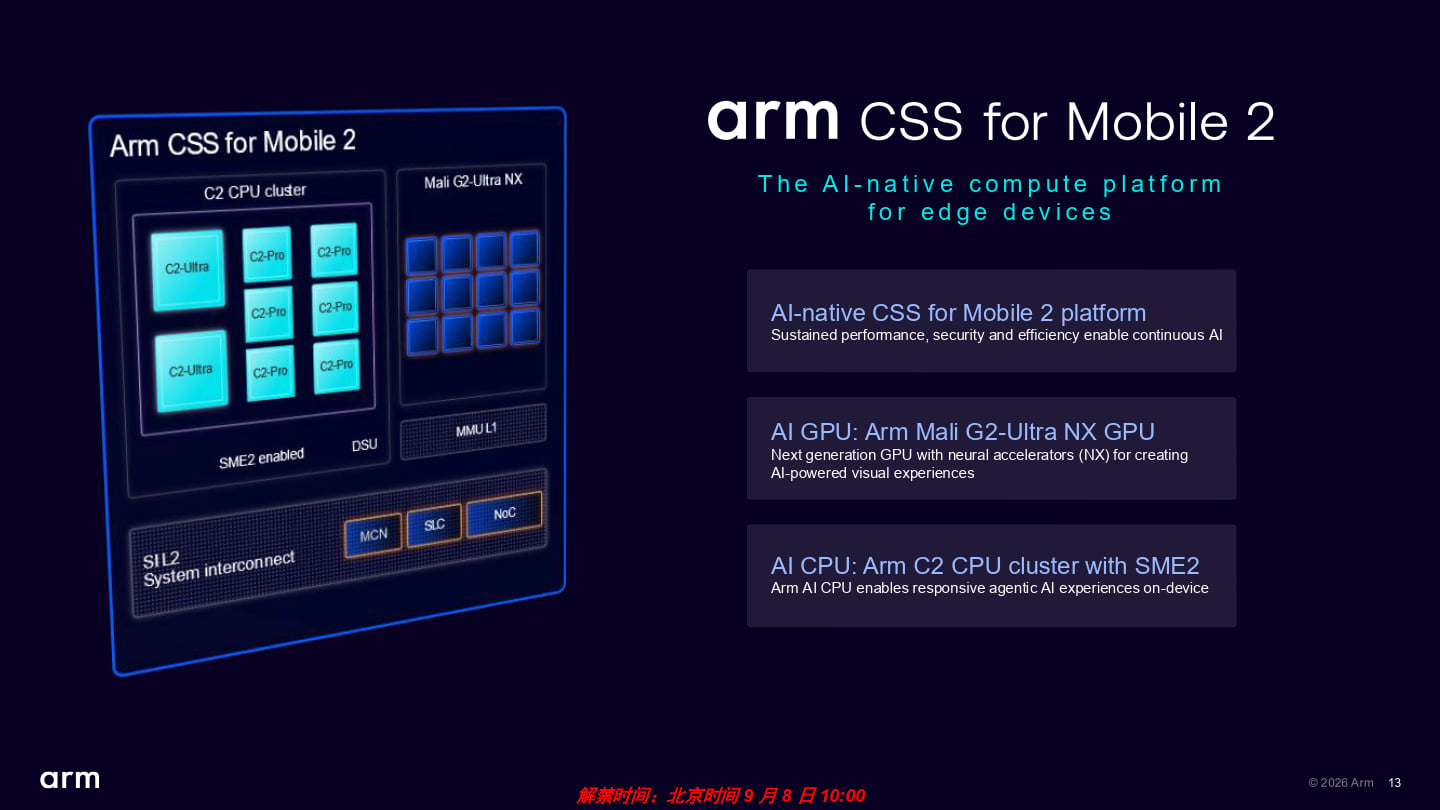
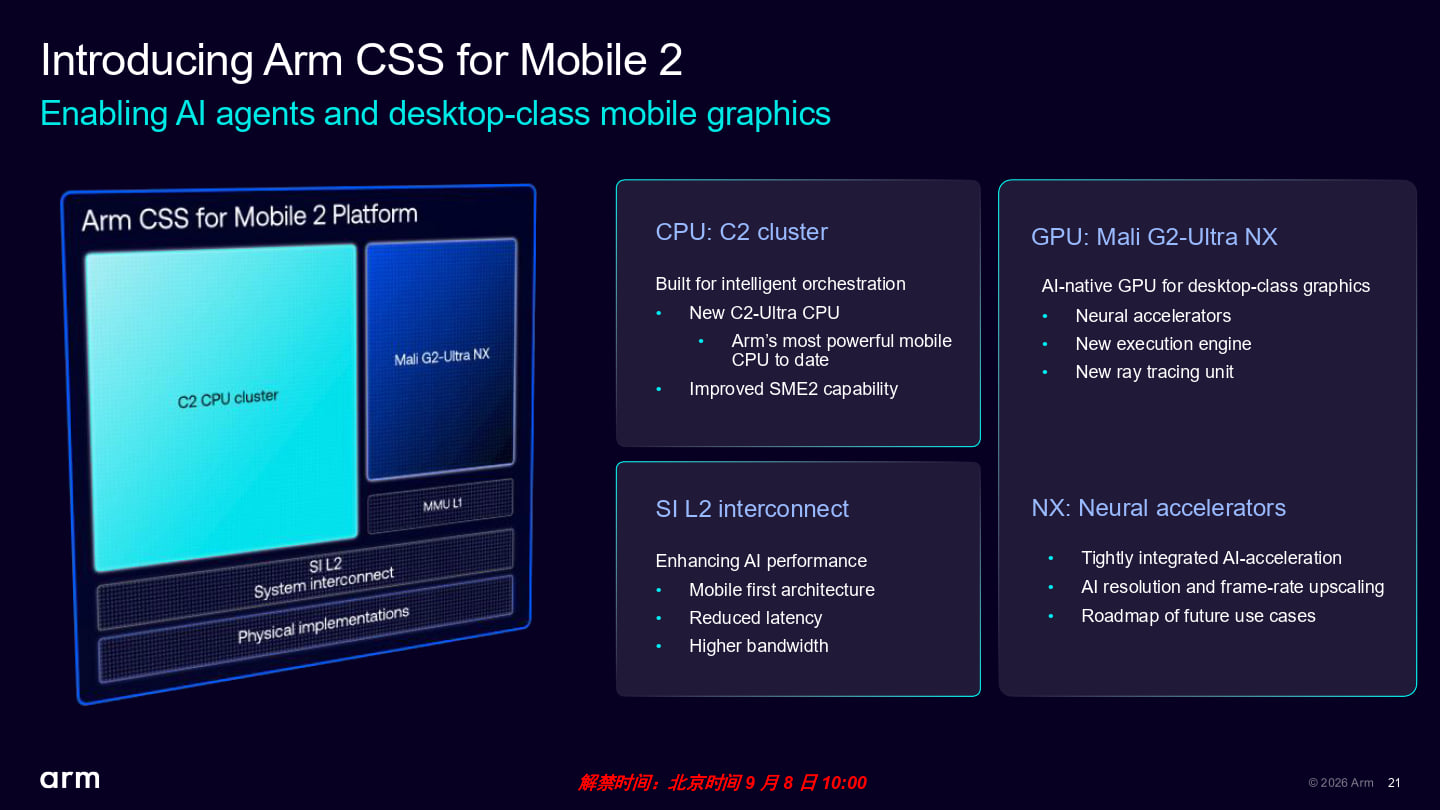
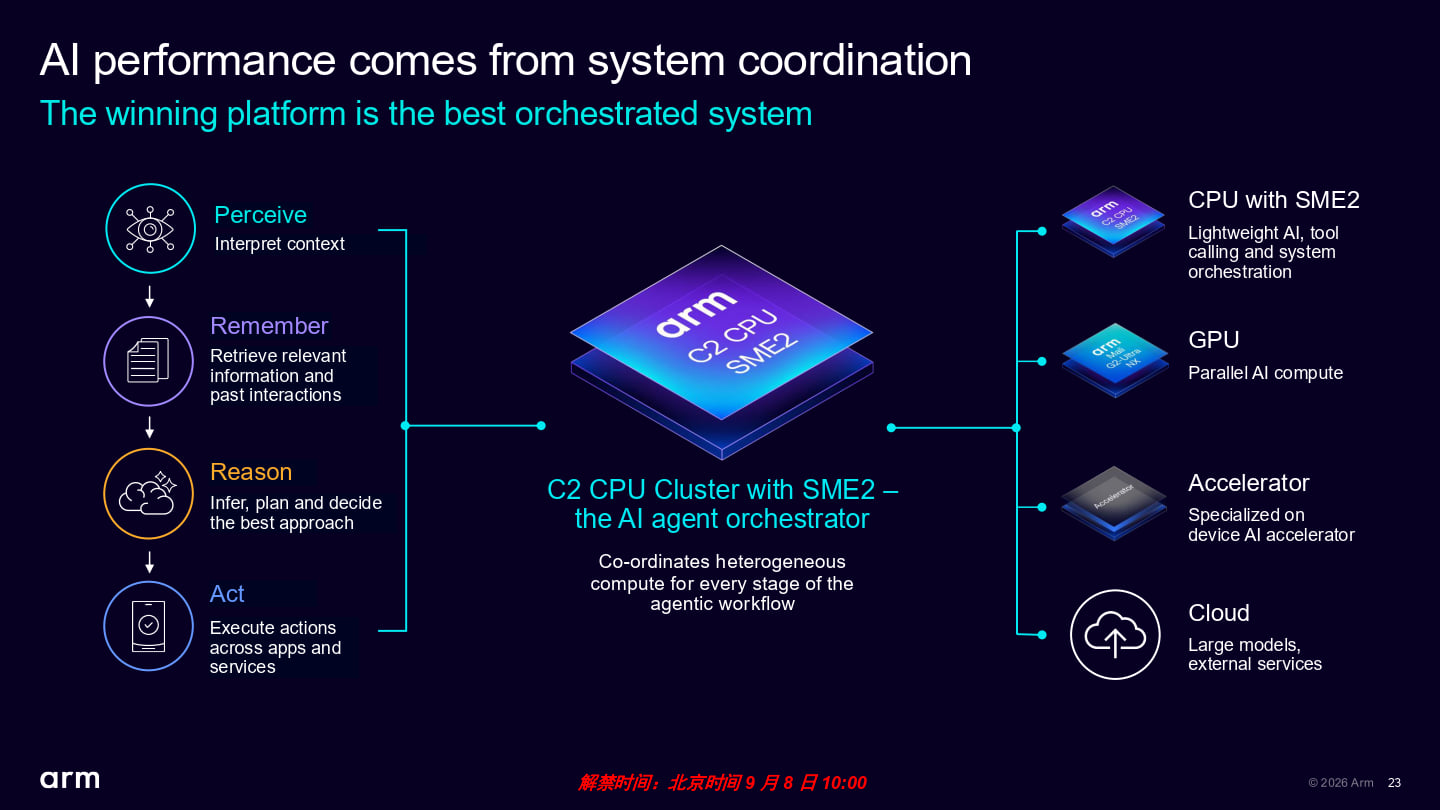
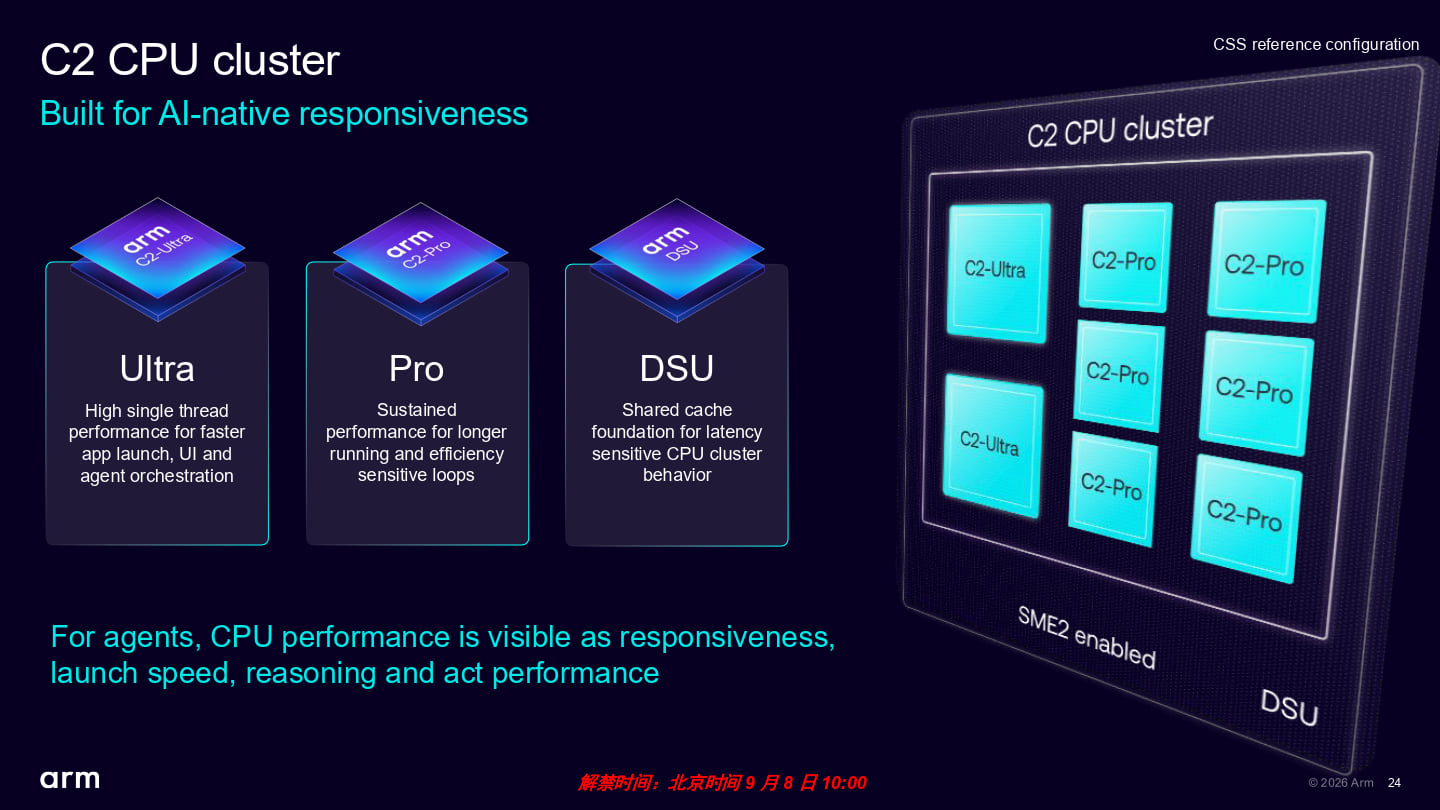
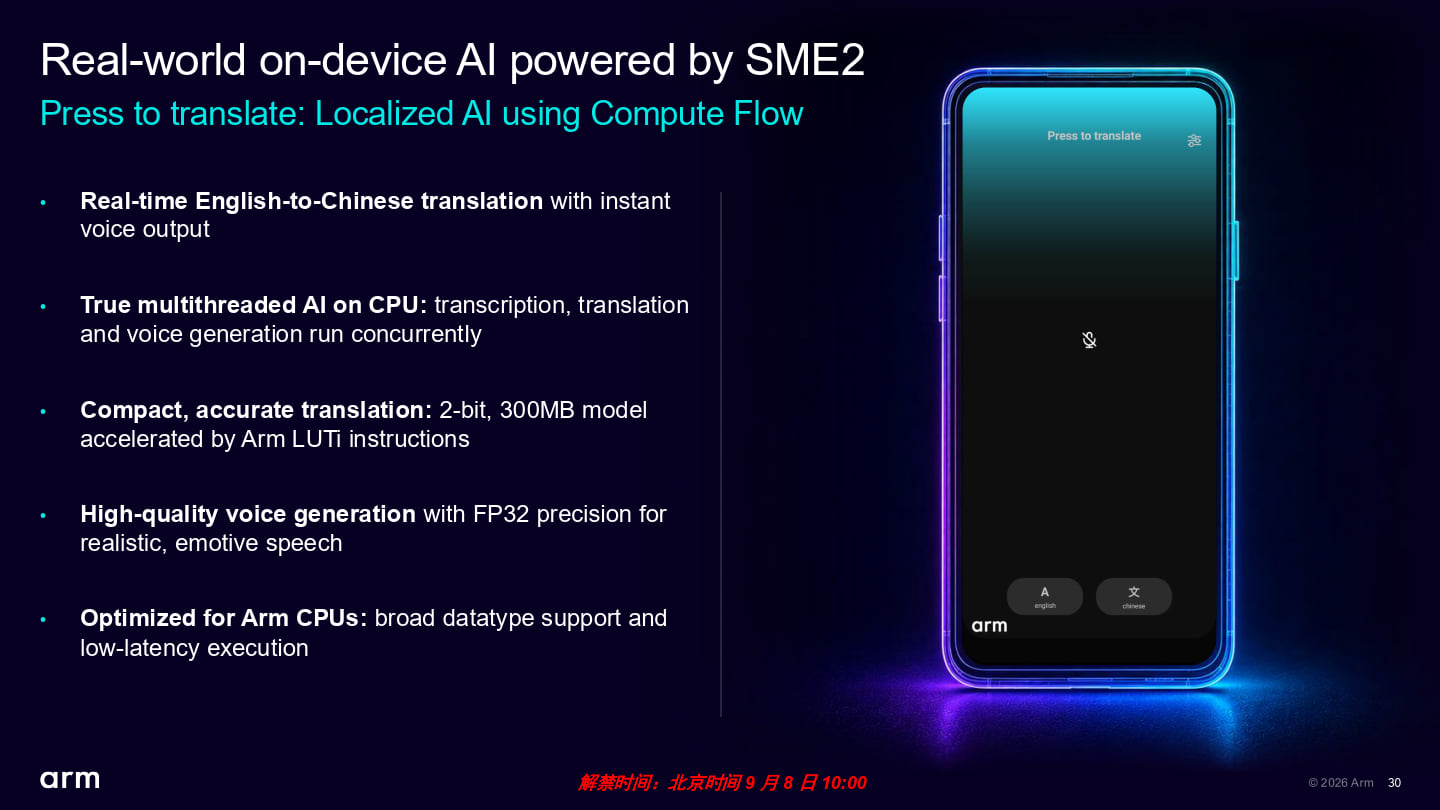
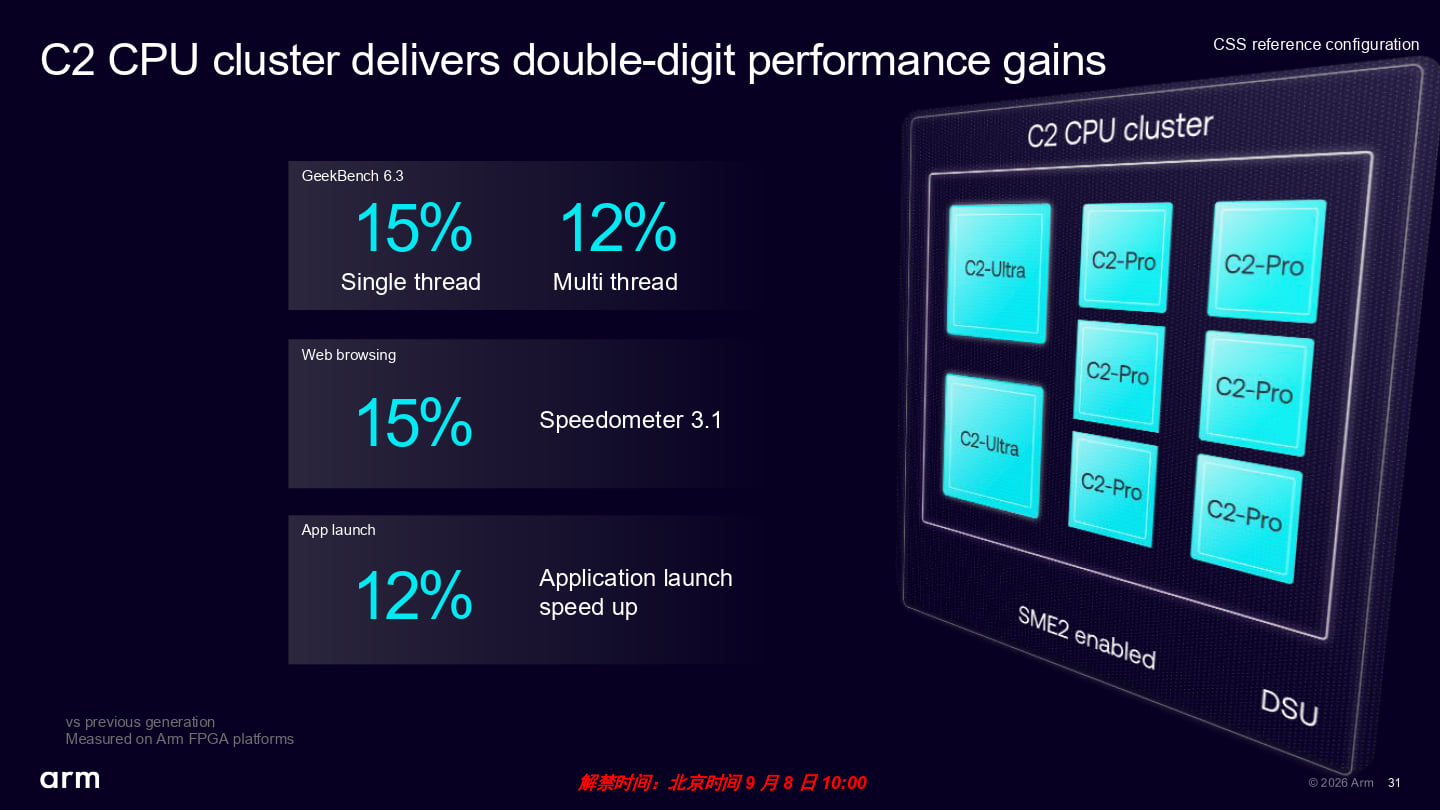
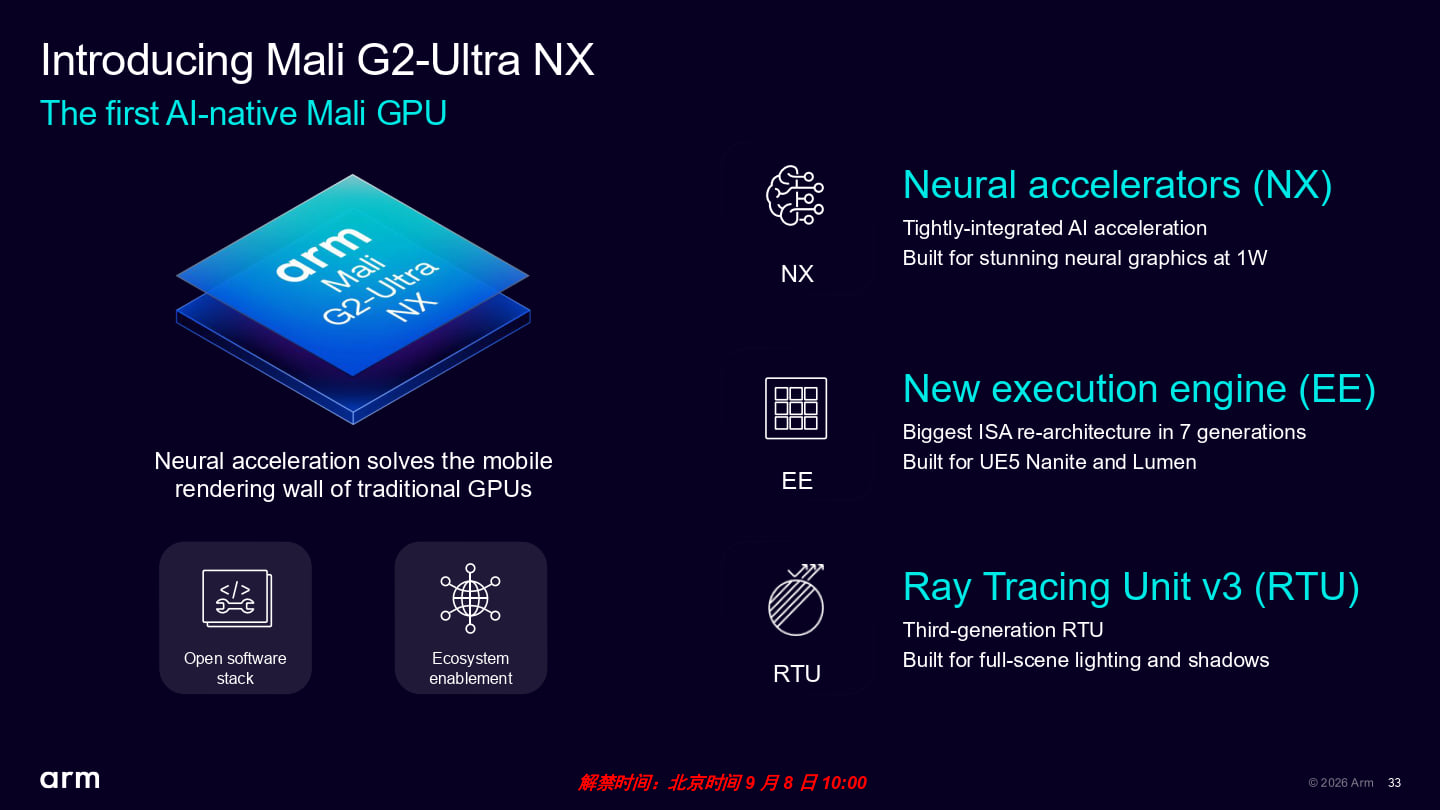
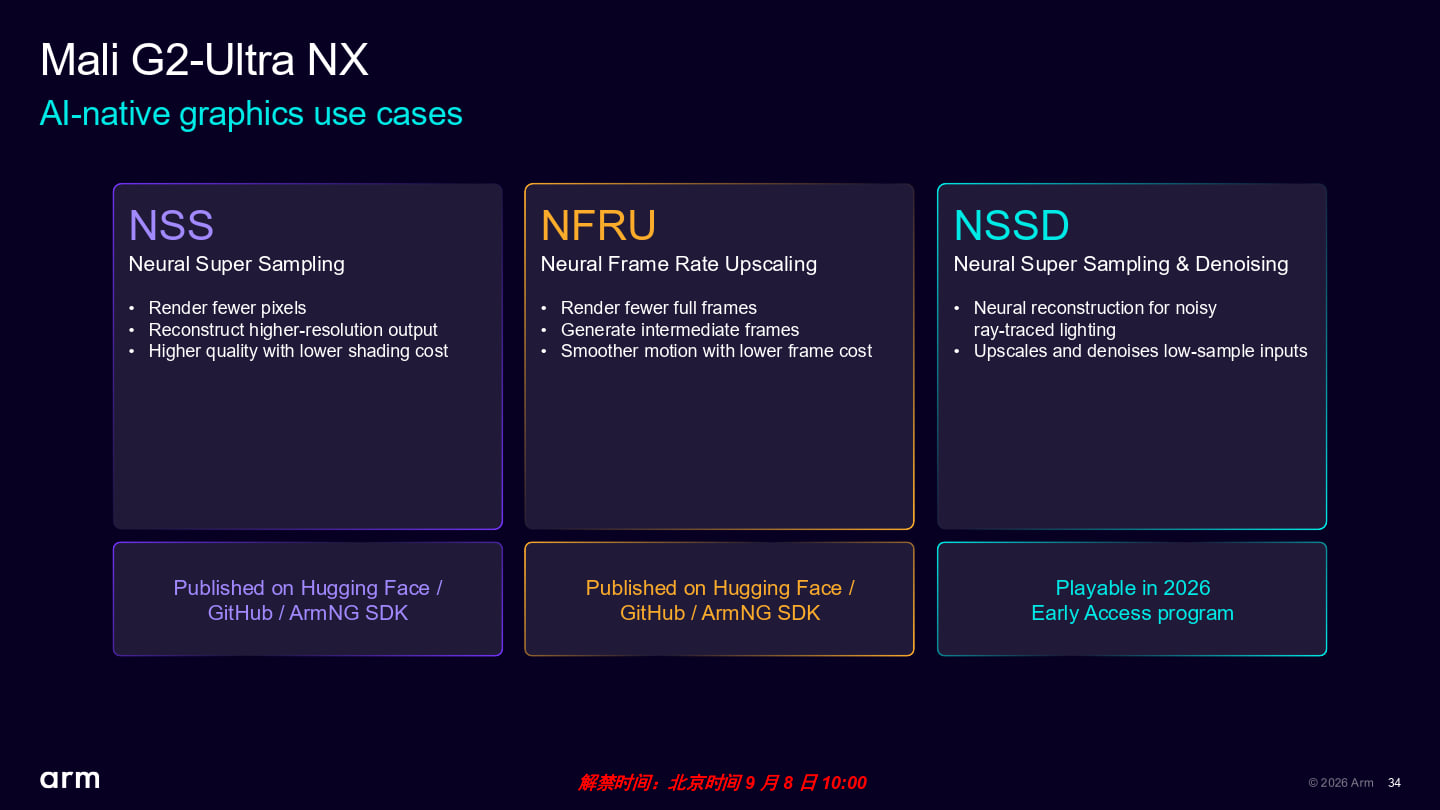
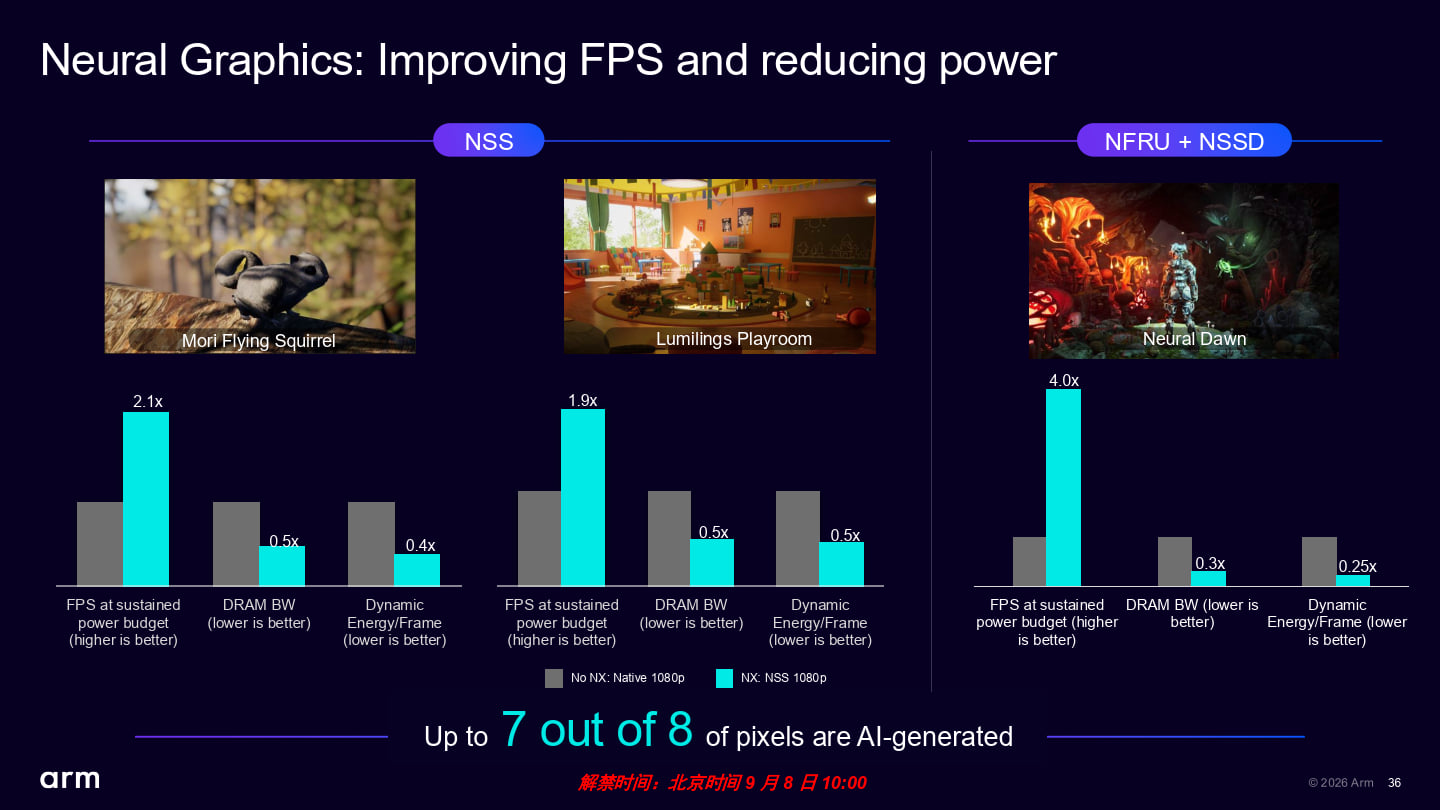
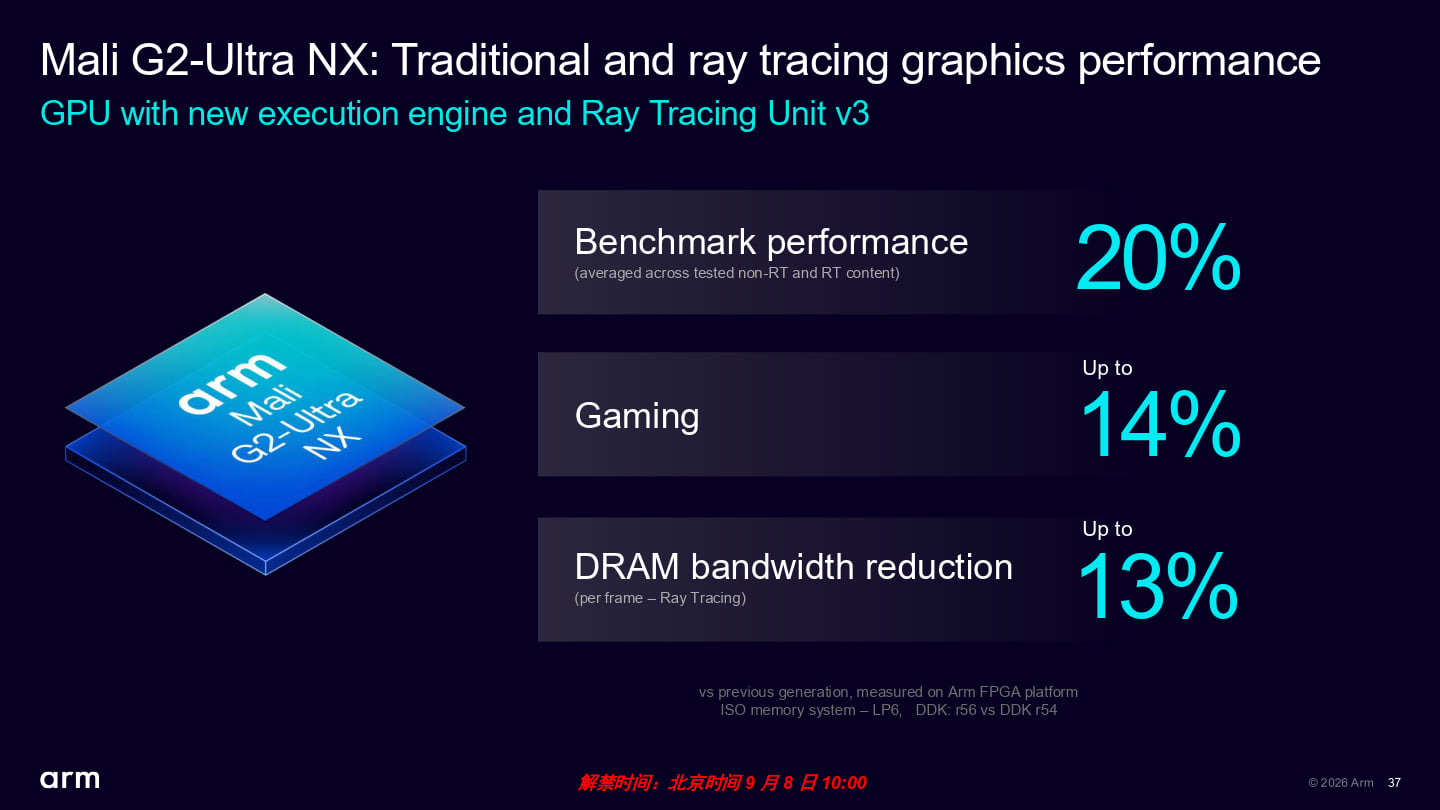
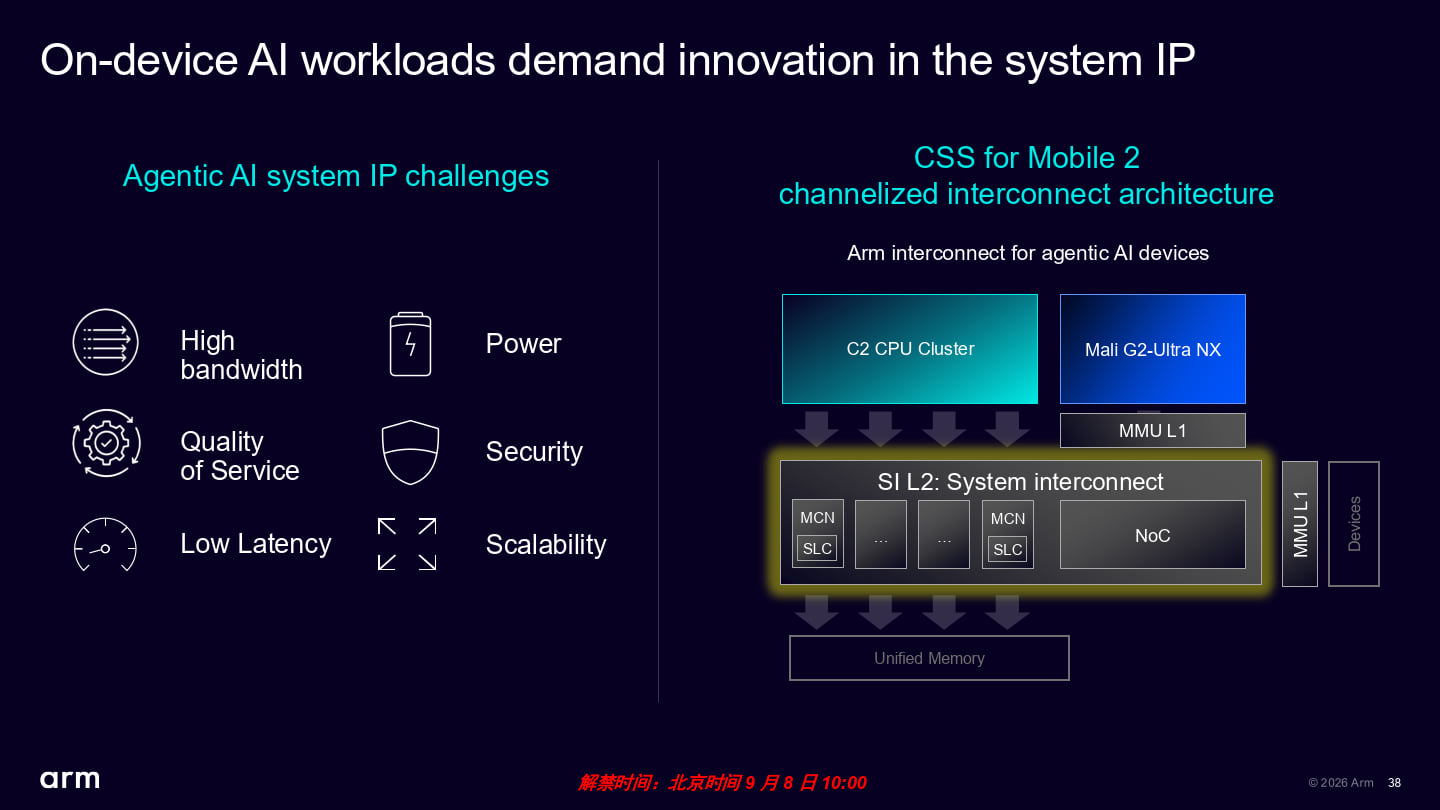
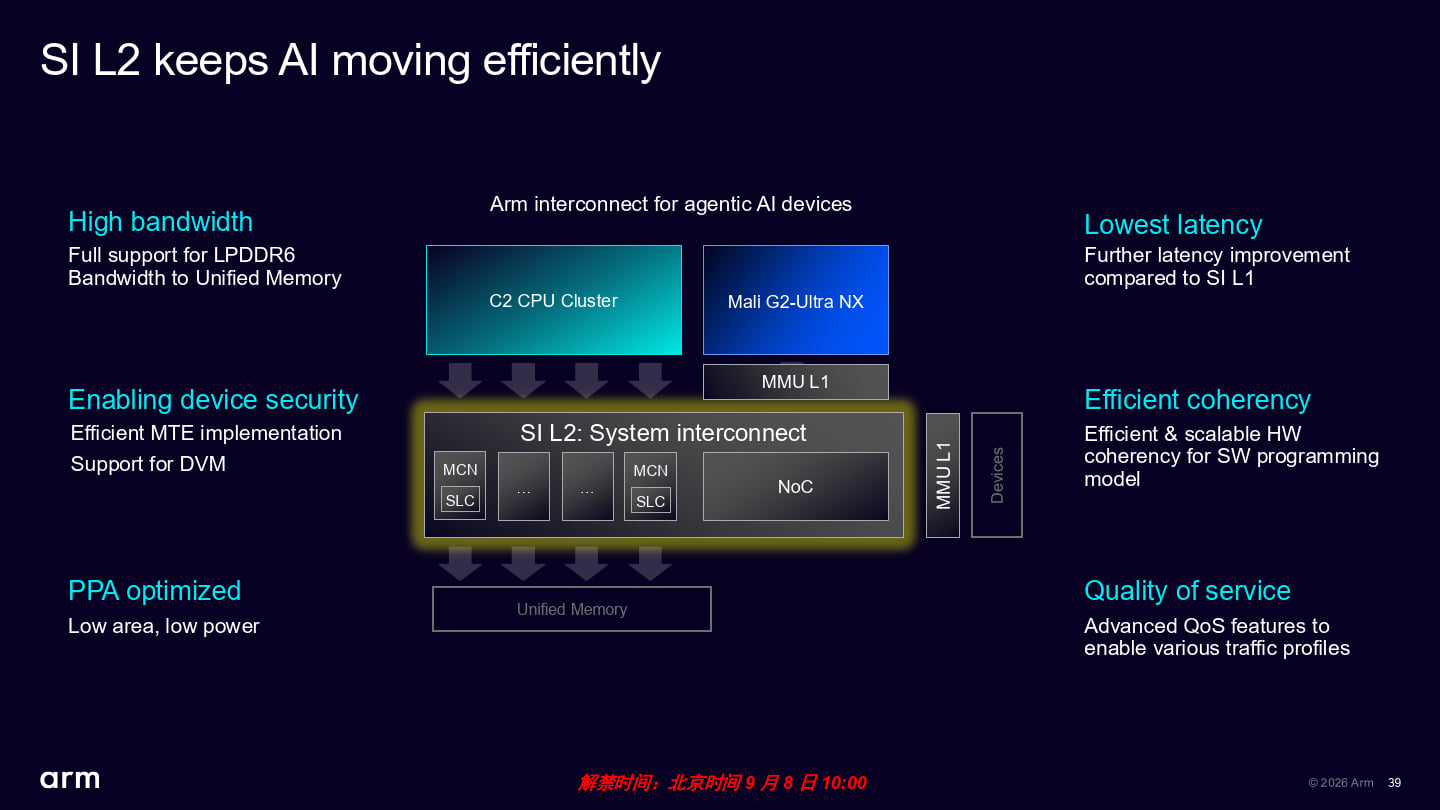
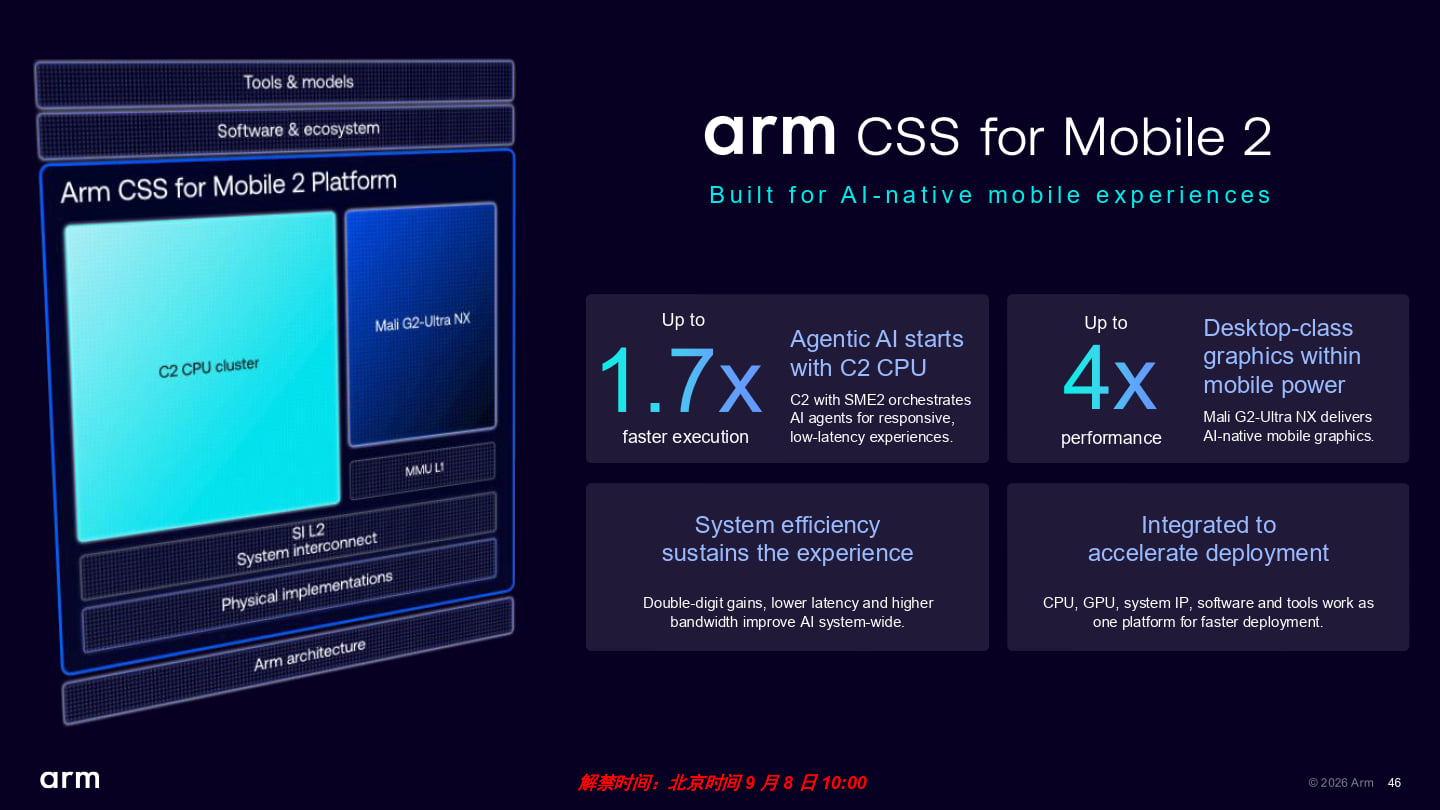
Arm CSS for Mobile 2運算子系統包含C2-Ultra、C2-Pro等CPU、G2-Ultra NX GPU、系統 IP、軟體及開發者工具,以完整平台的型式改善代理式AI應用體驗。
Arm CSS for Mobile 2運算子系統包含C2-Ultra、C2-Pro等CPU(處理器),以及G2-Ultra NX GPU(繪圖處理器)、系統 IP、軟體及開發者工具,以完整平台的型式改善代理式AI應用體驗。
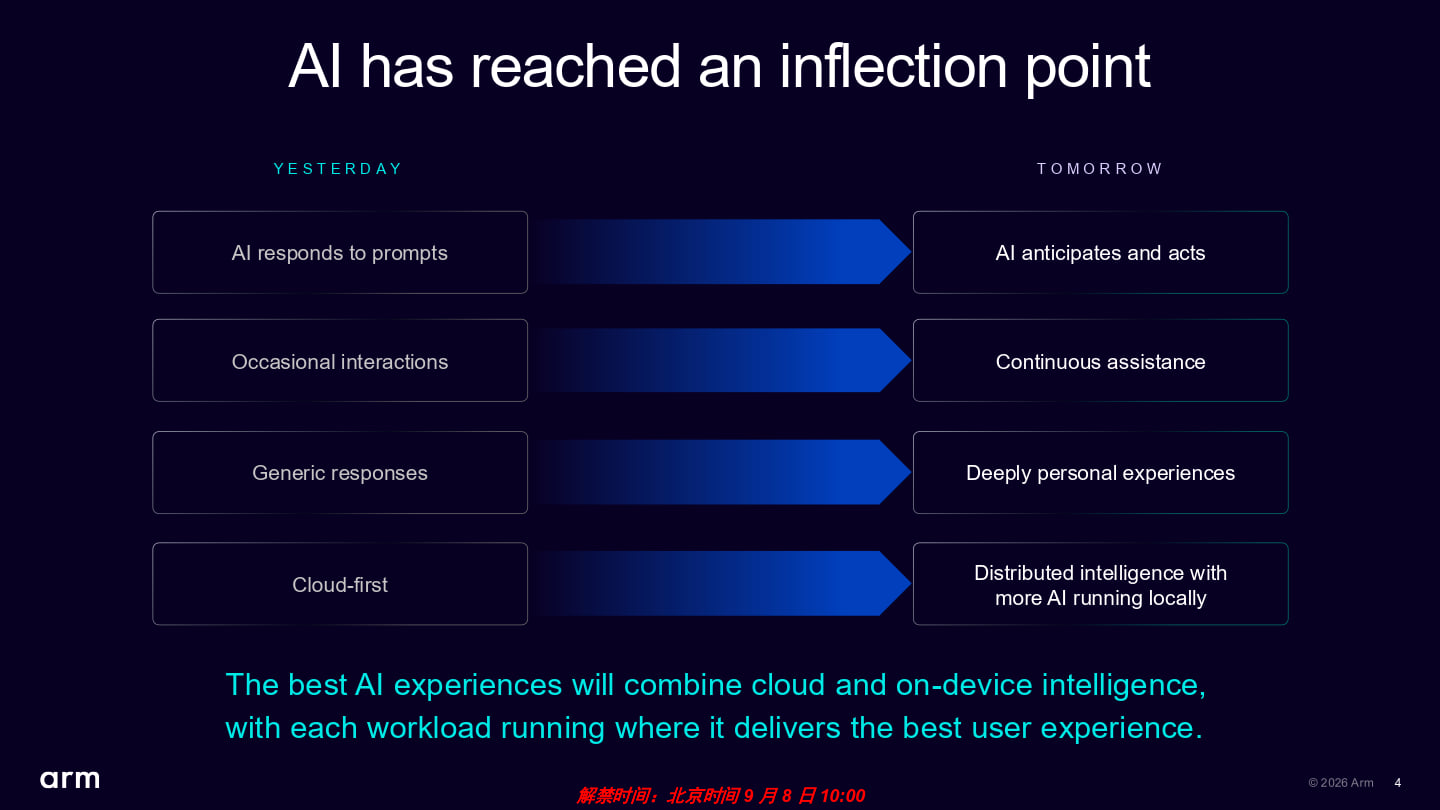
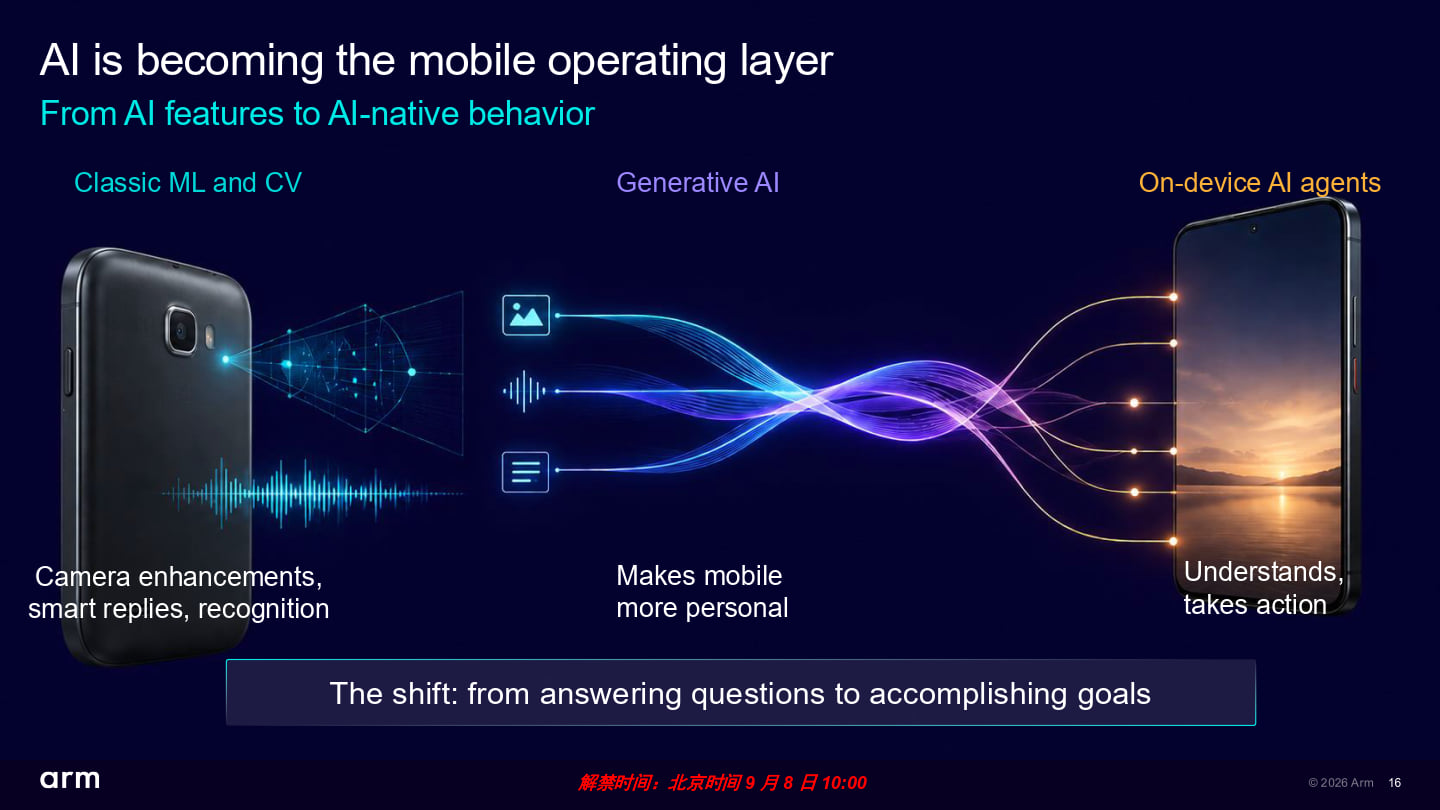
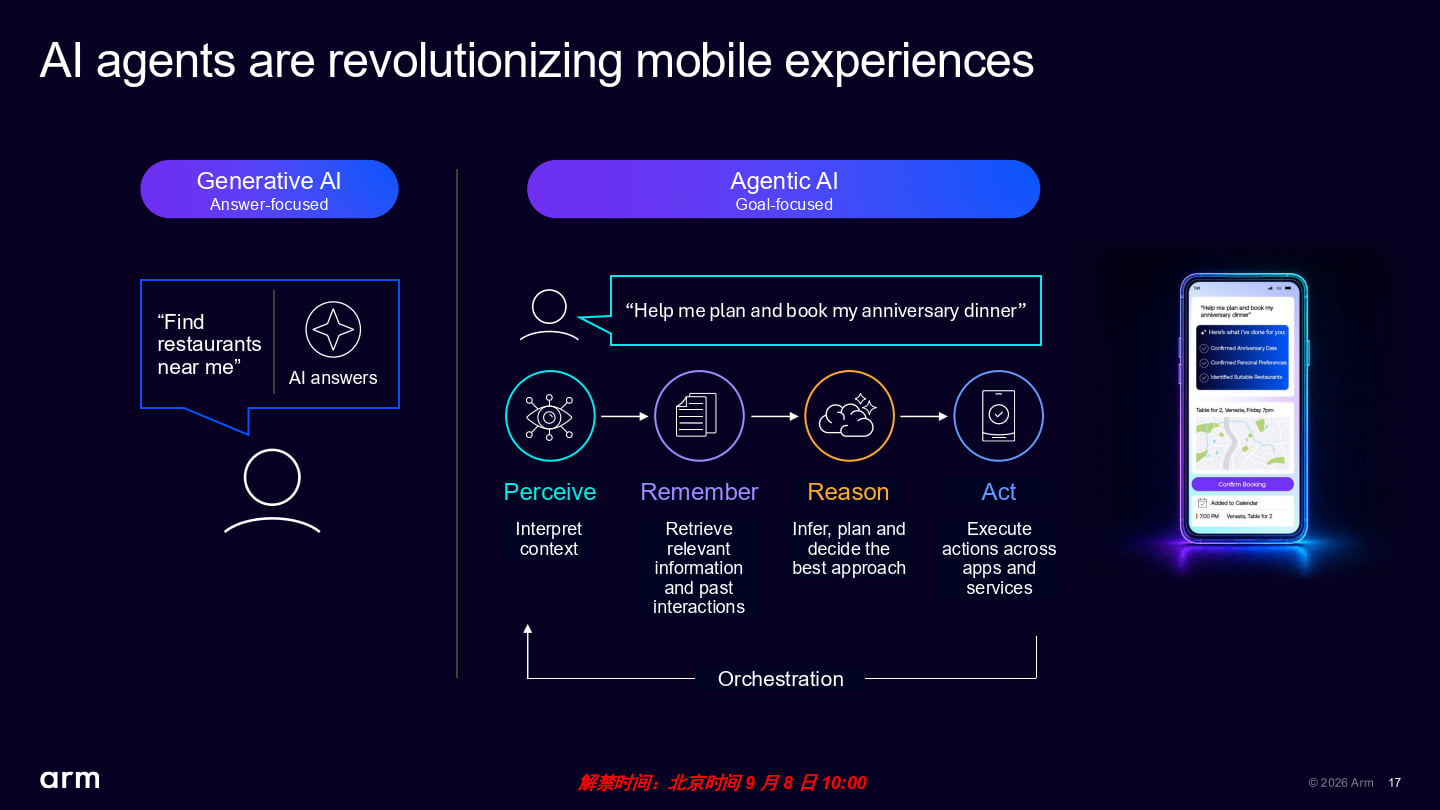
手機成為AI代理助手
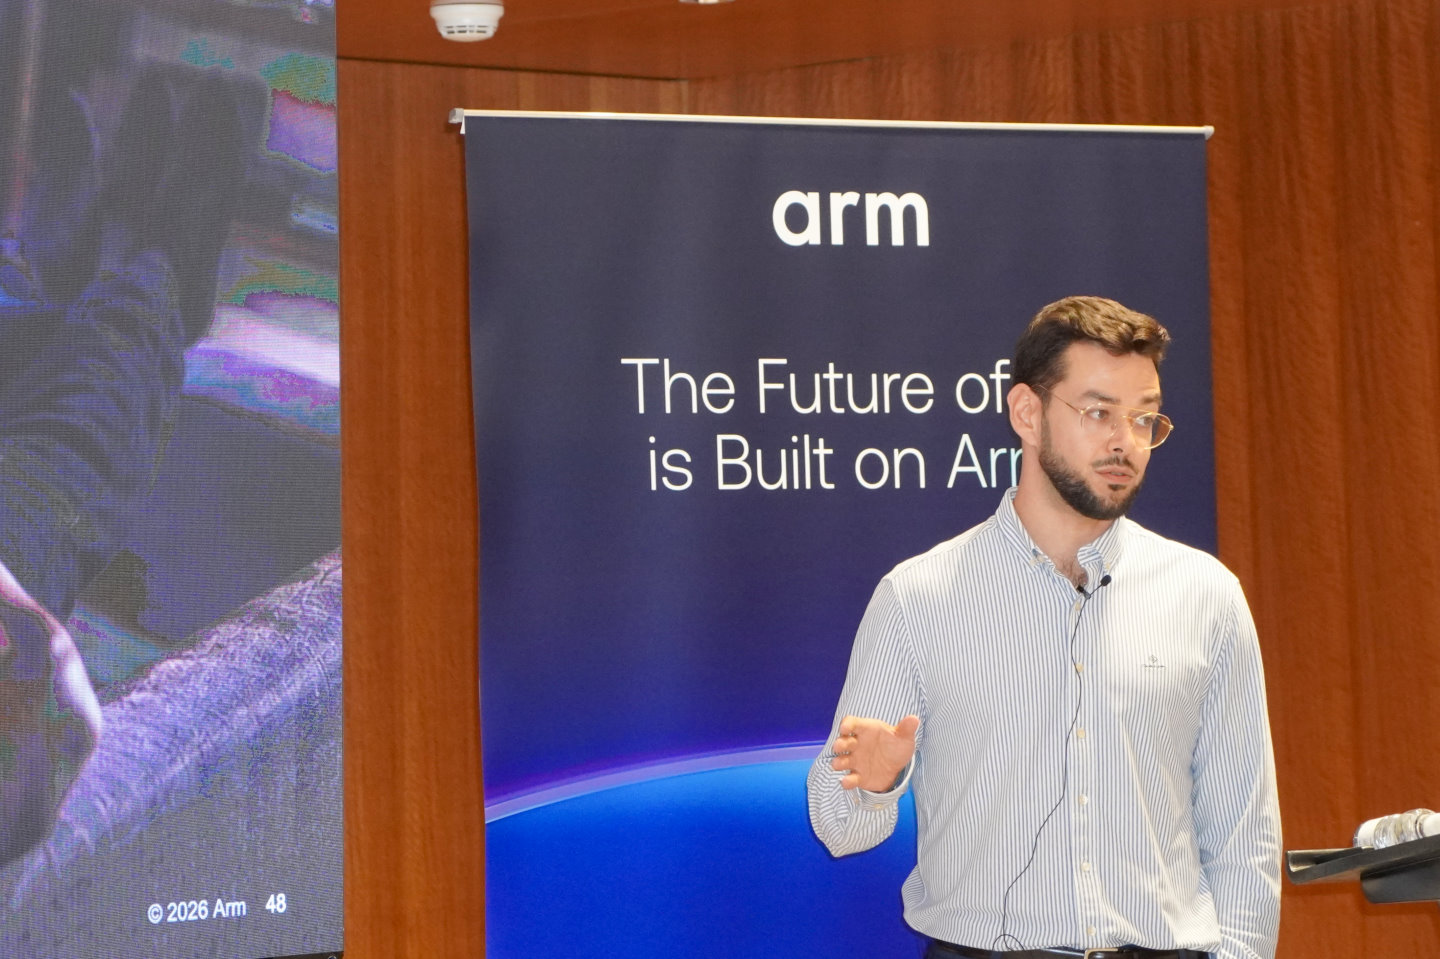
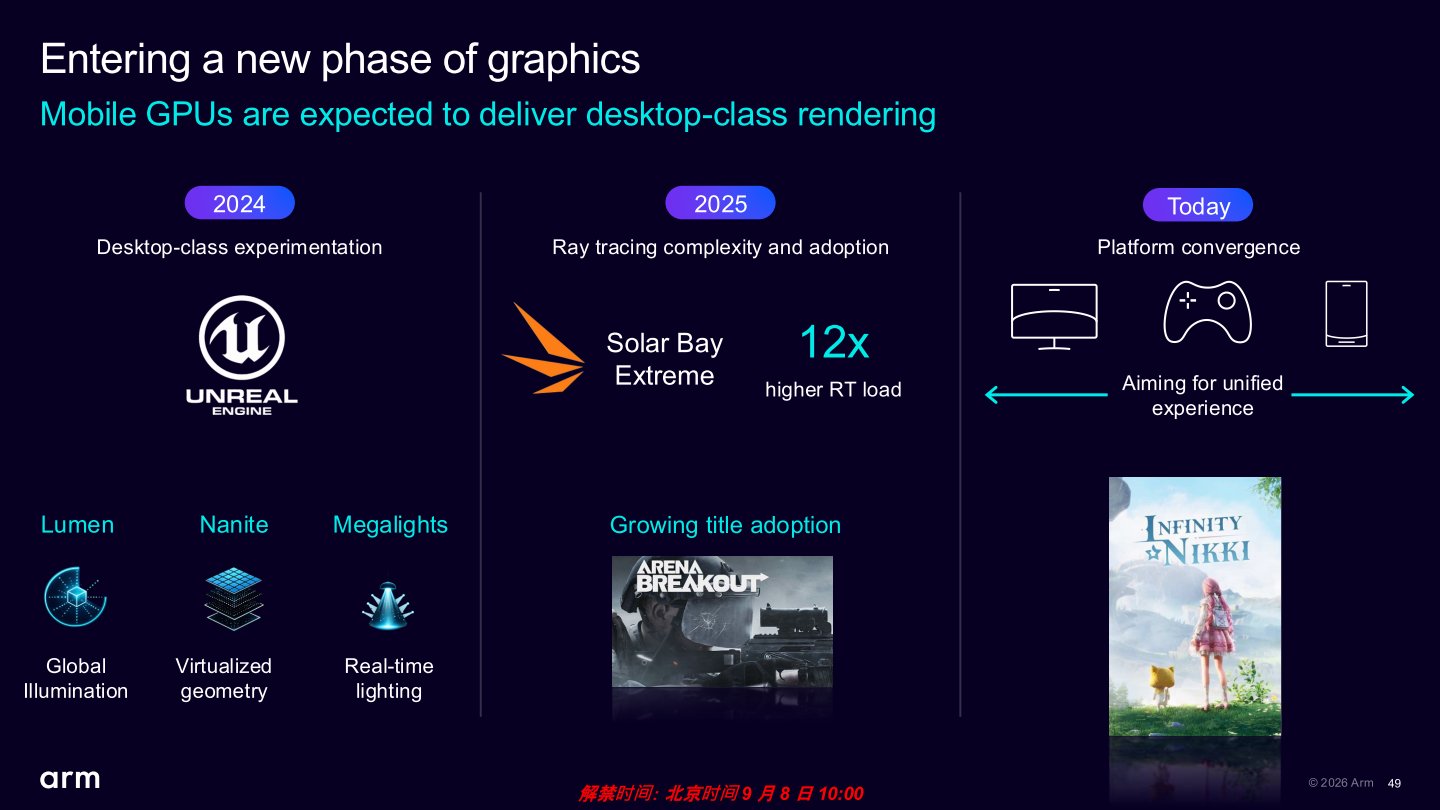
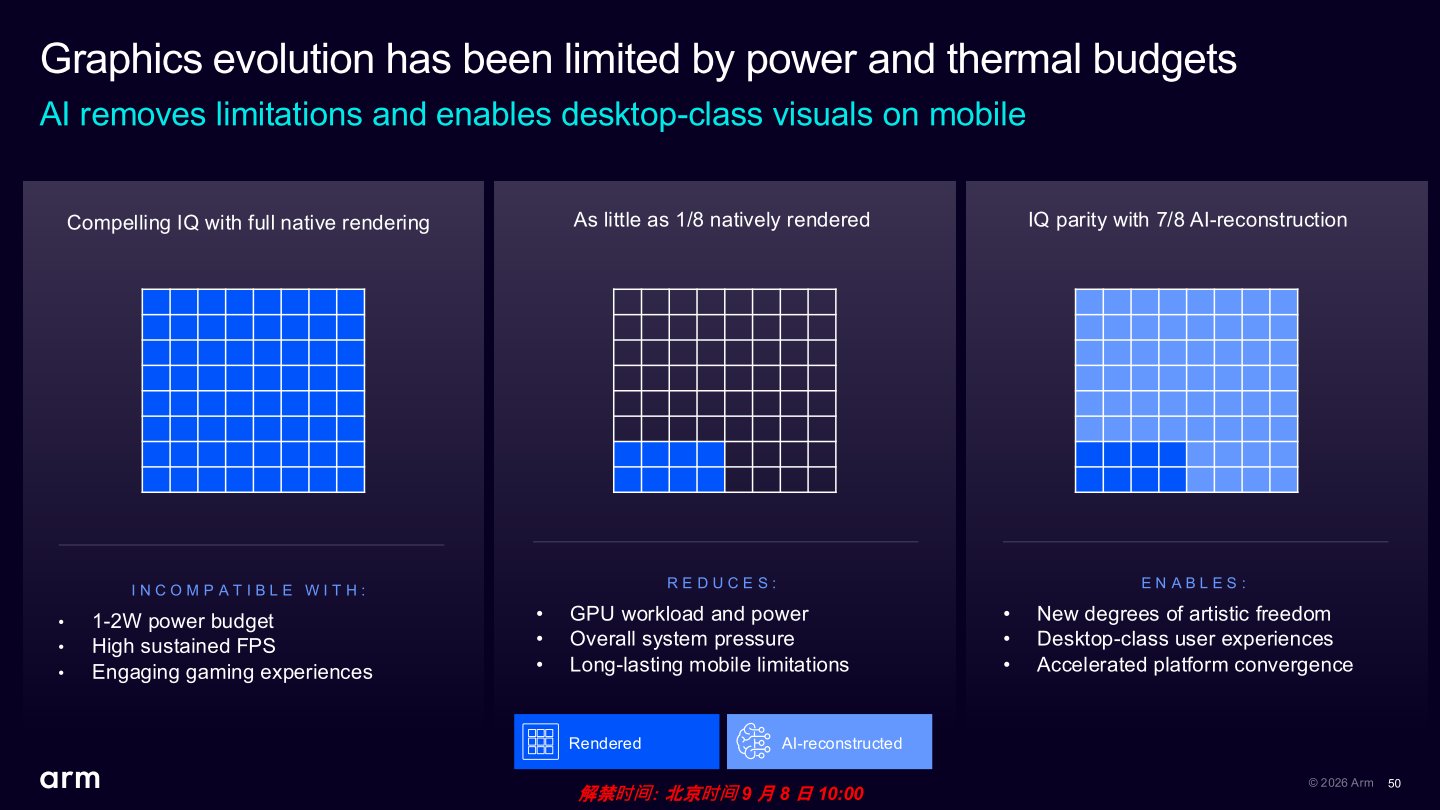
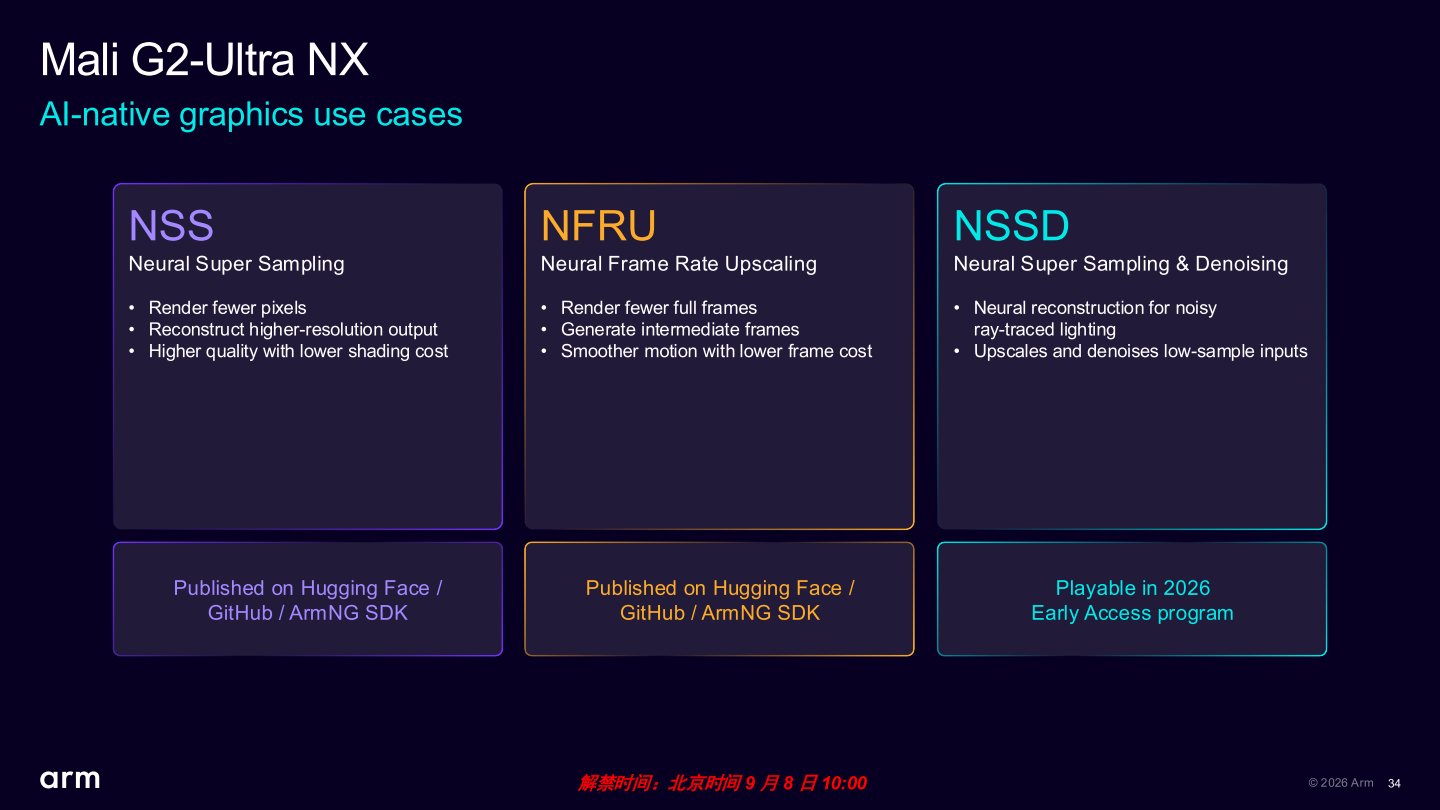
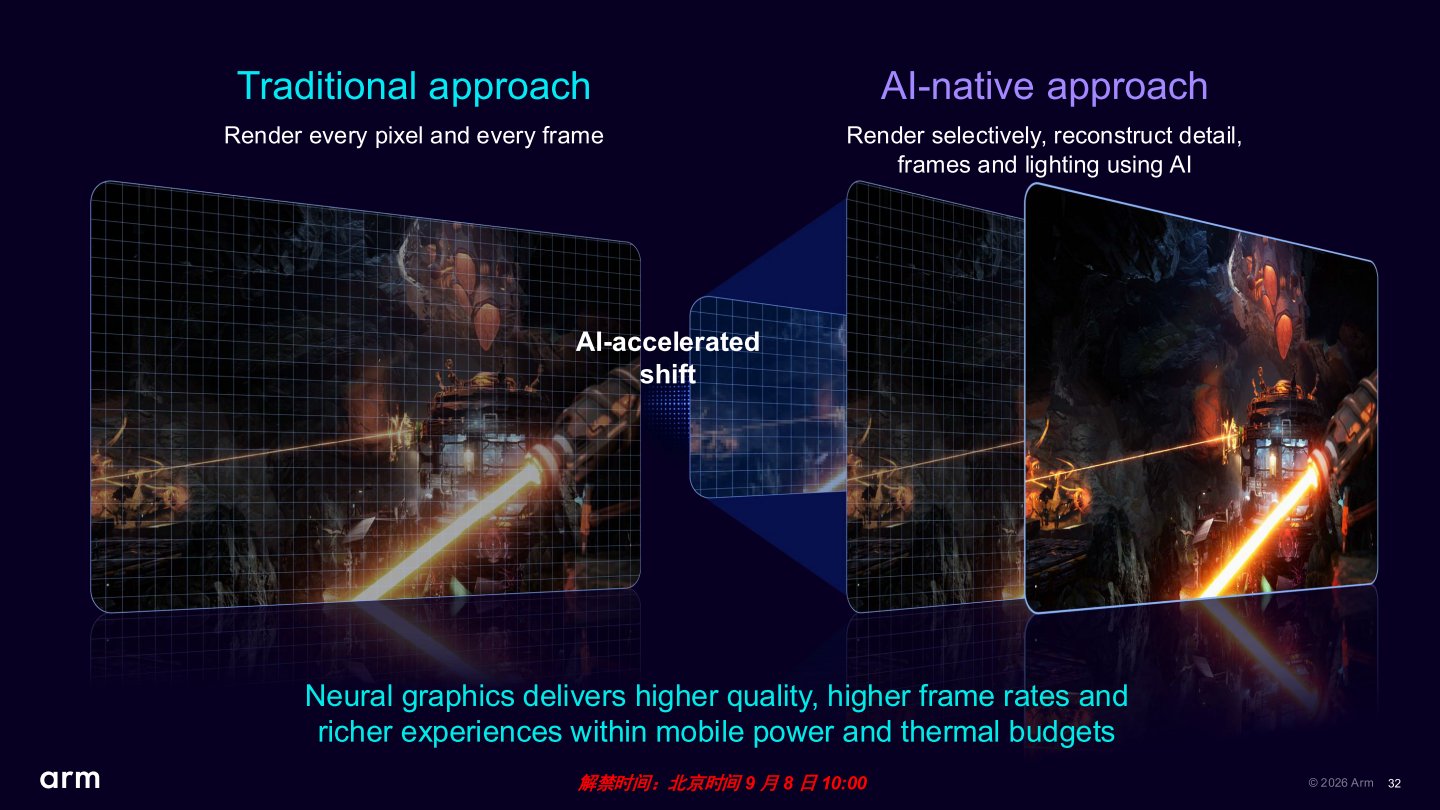
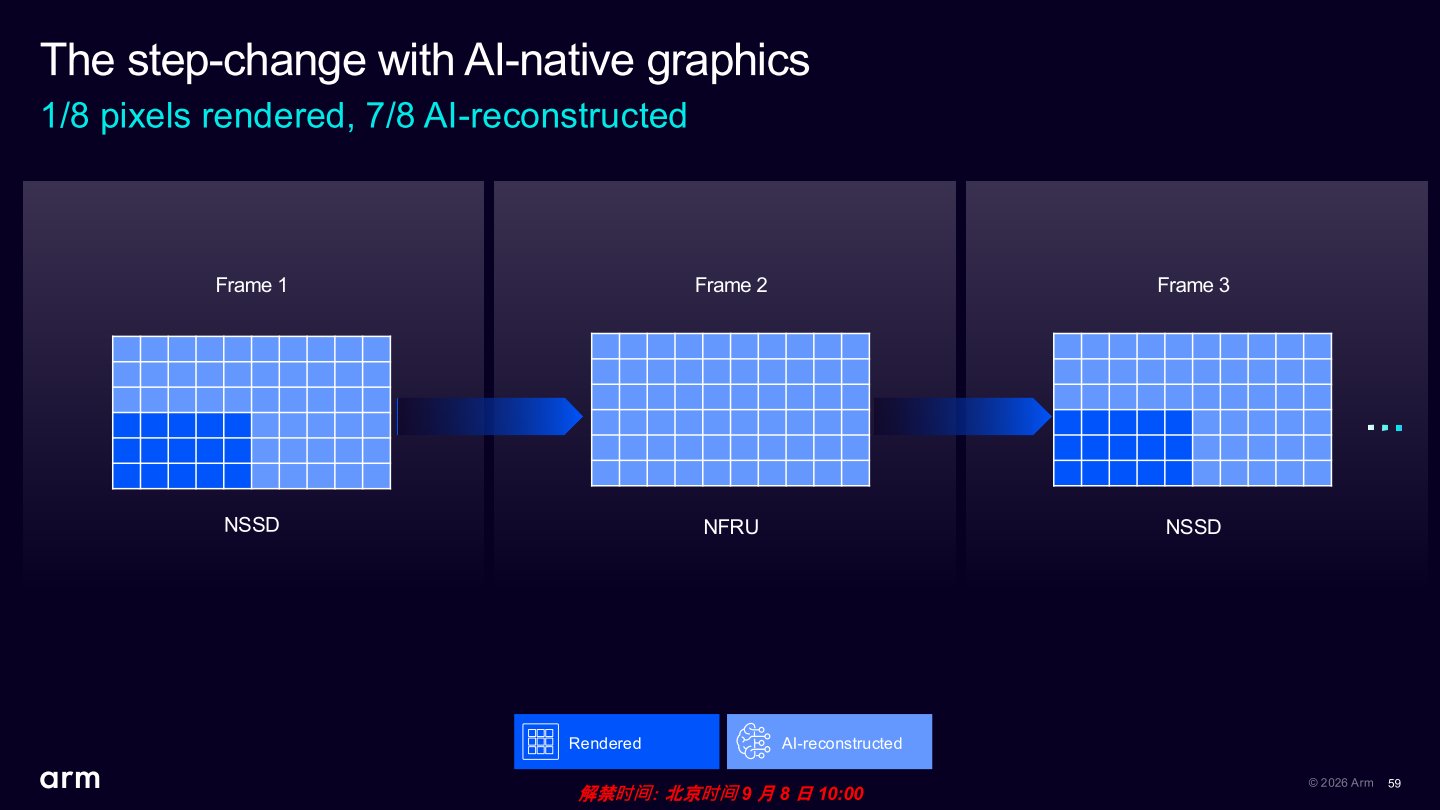
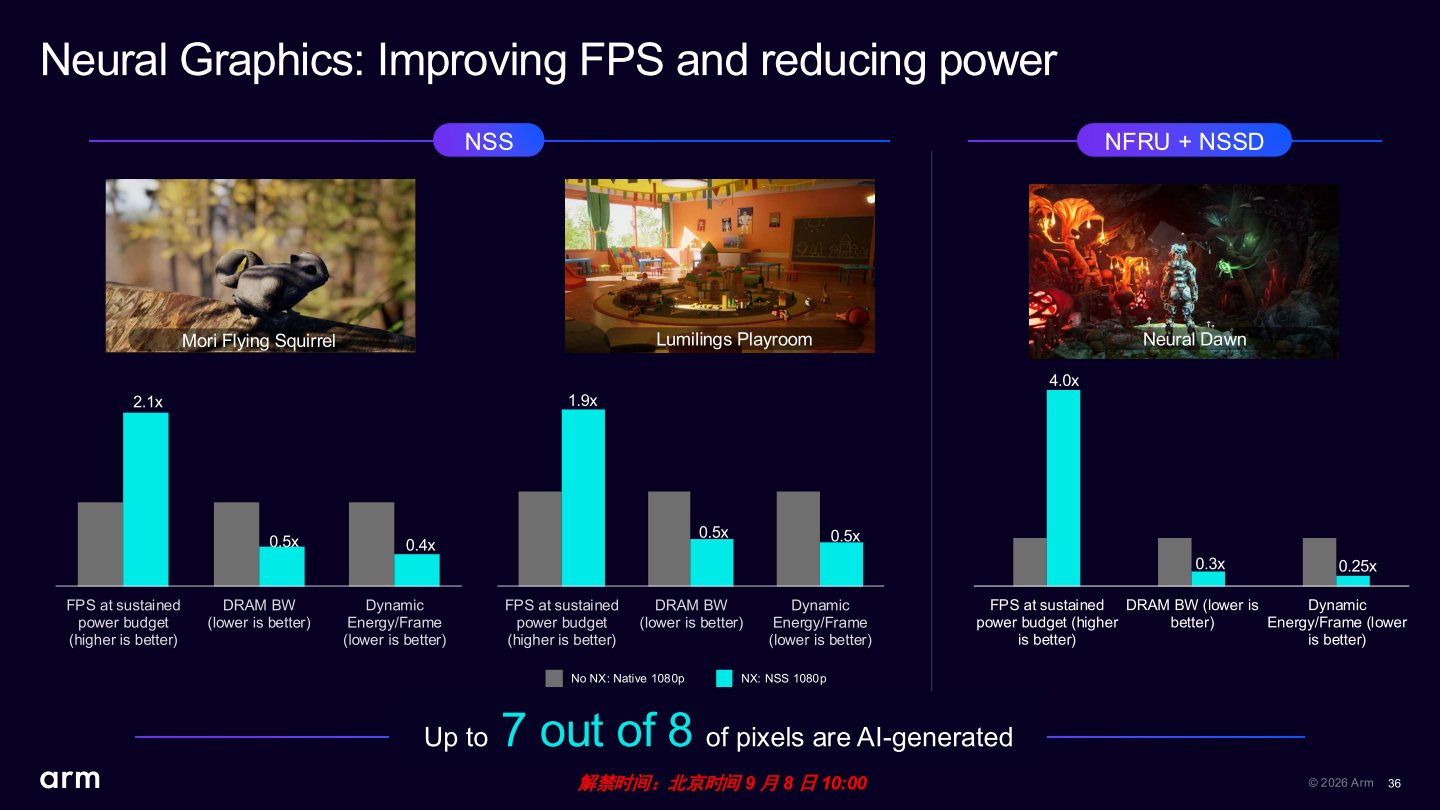
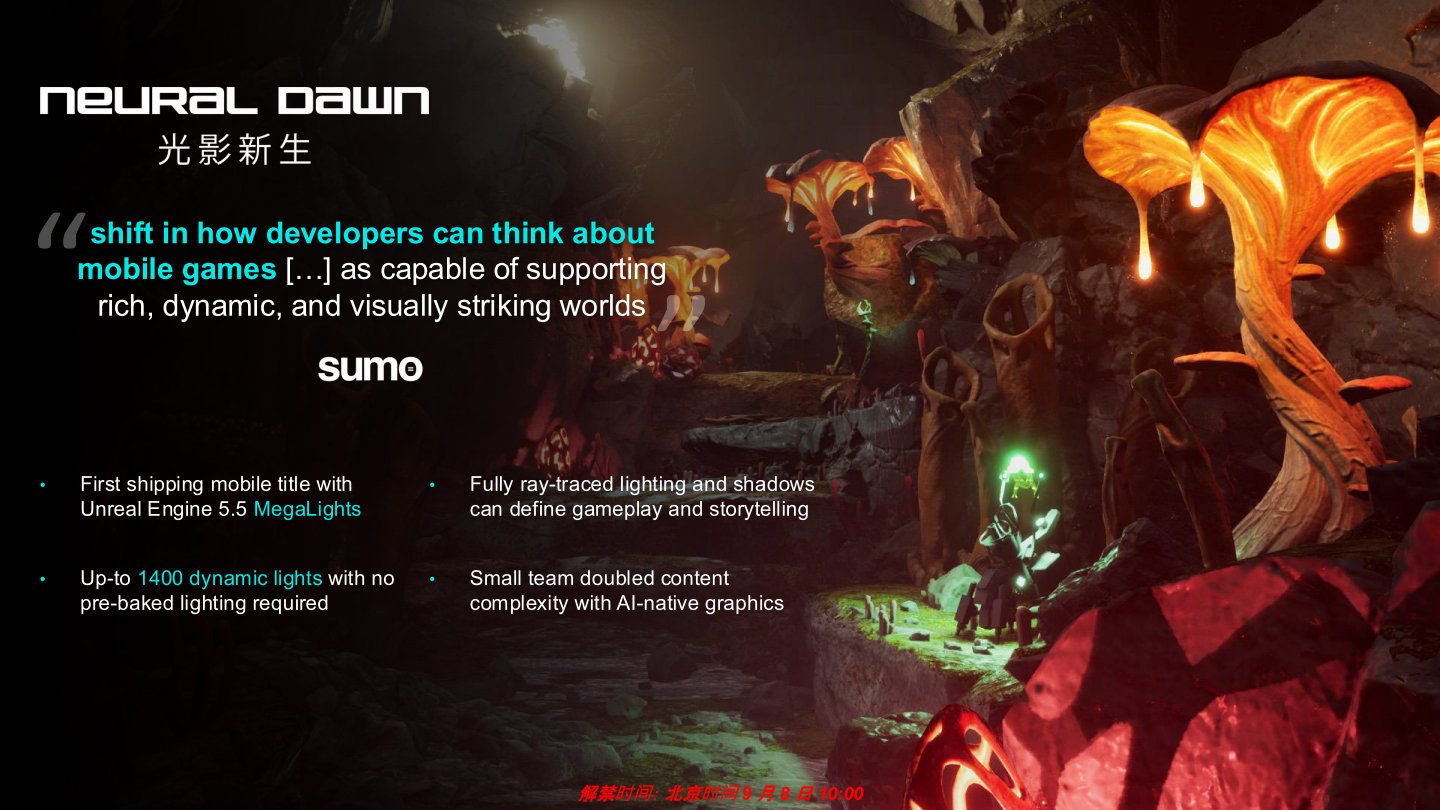
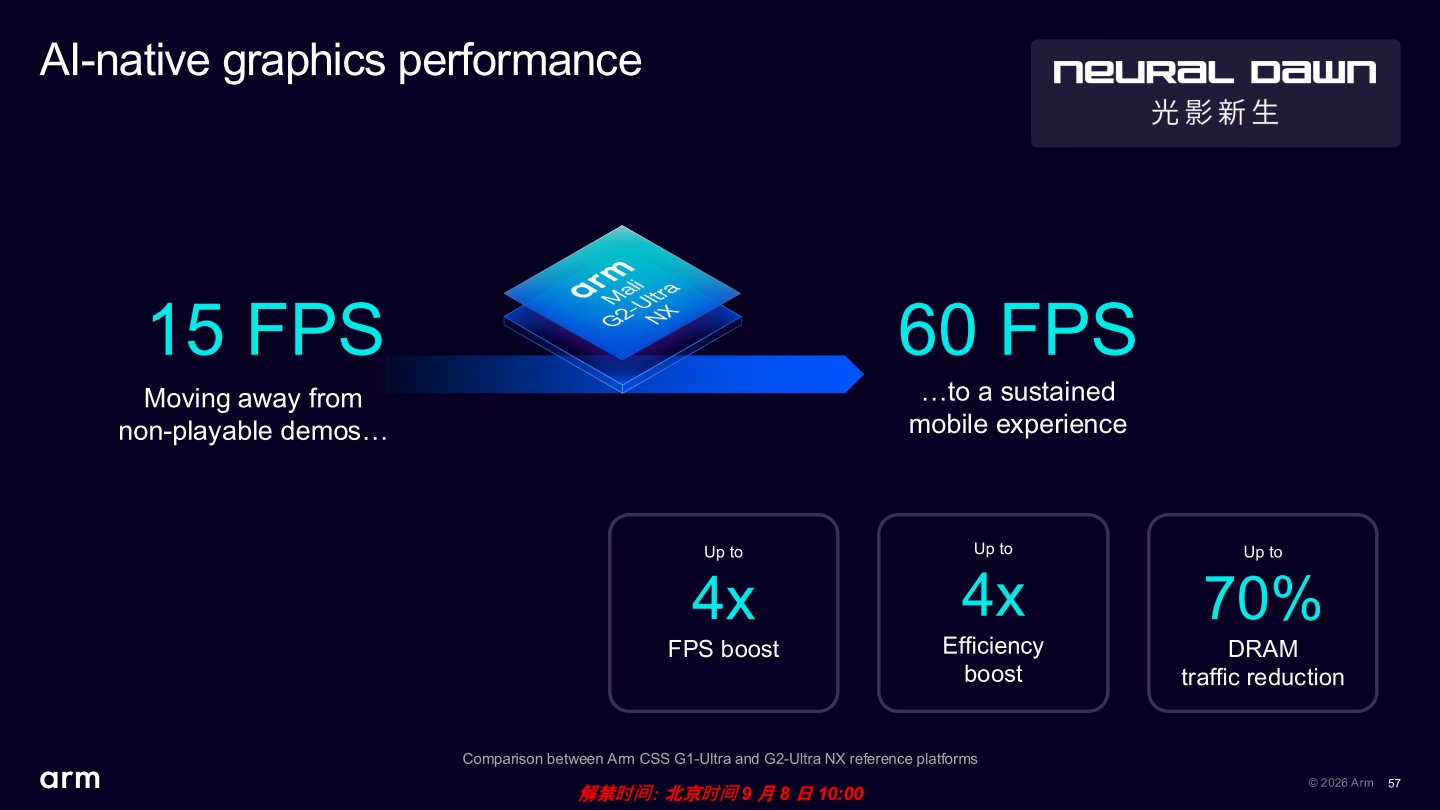
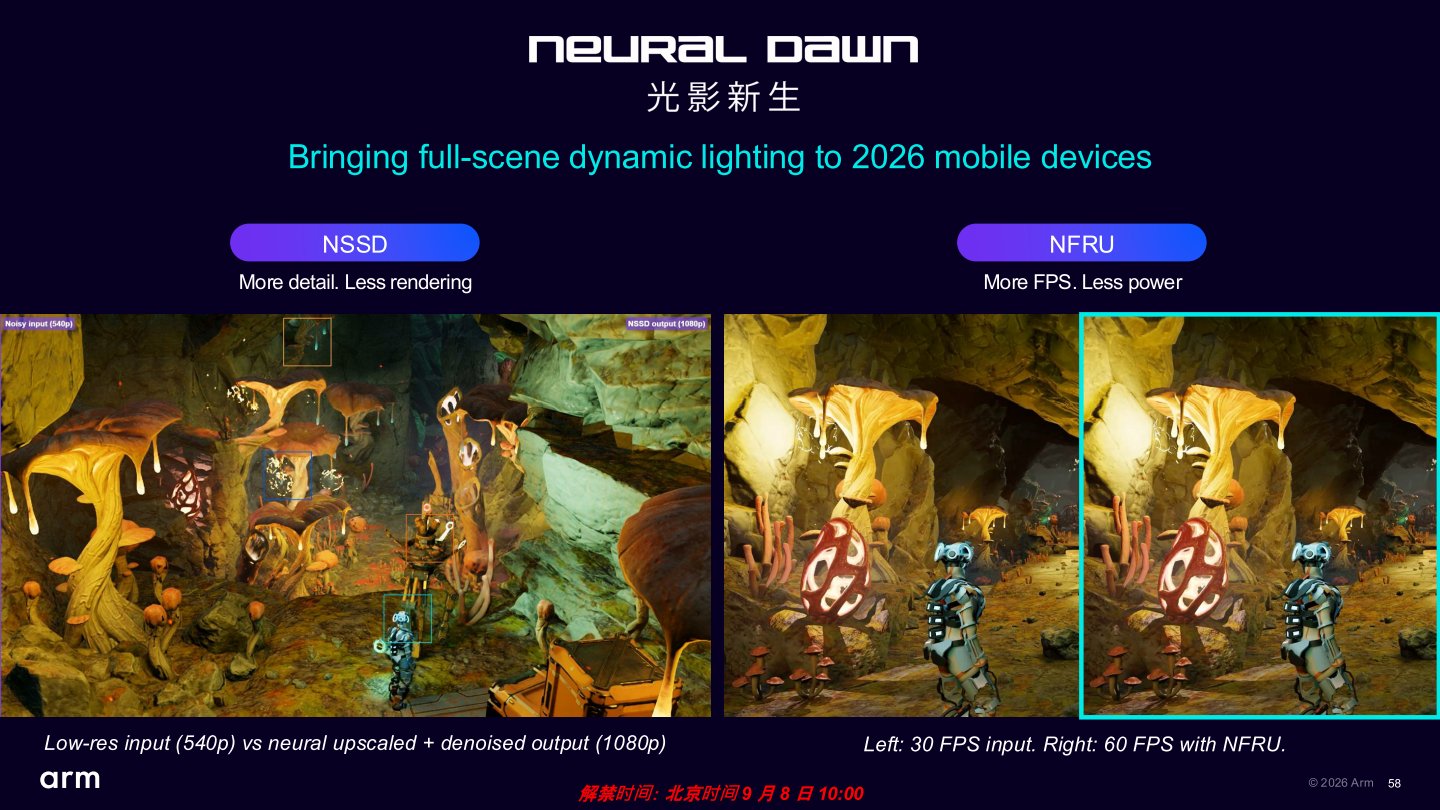
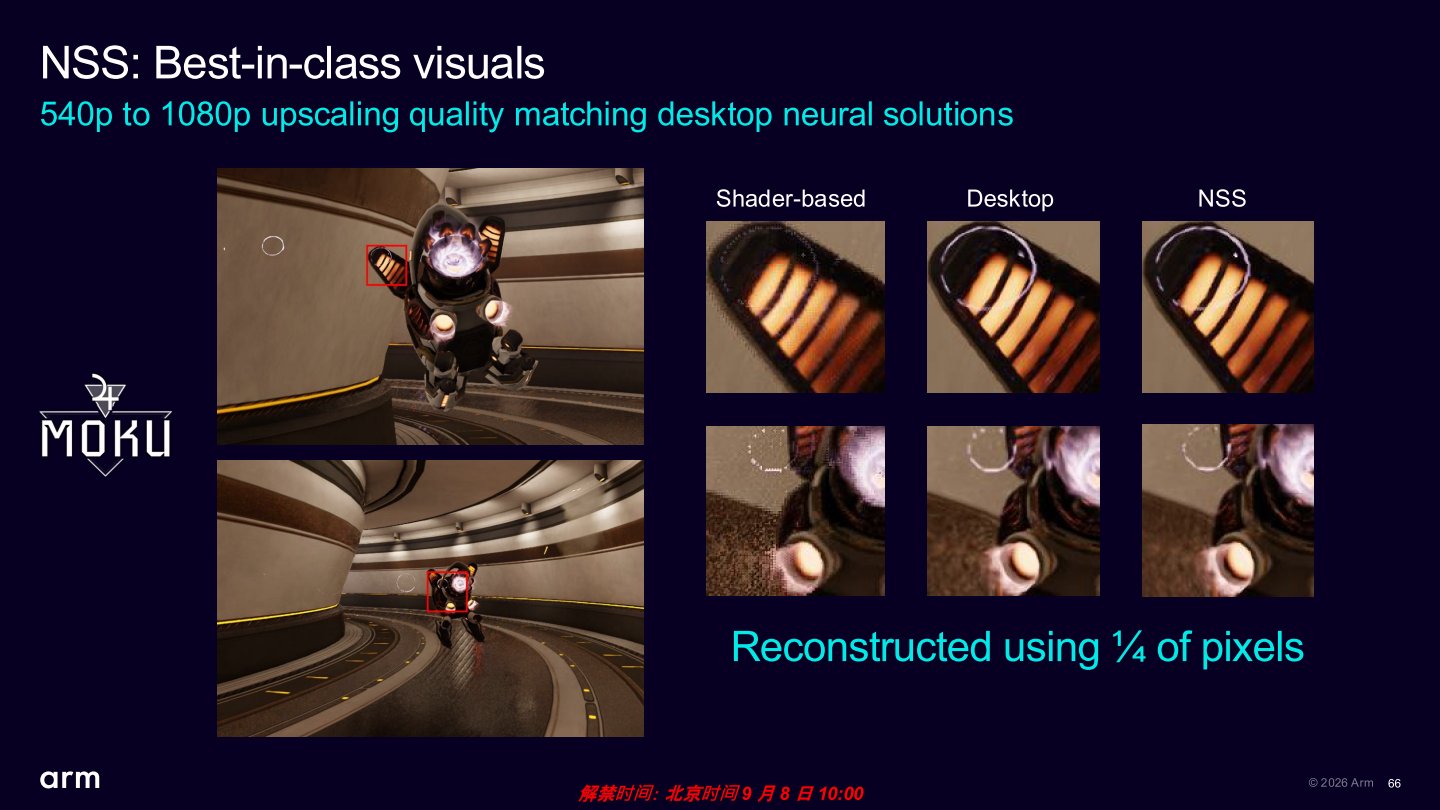
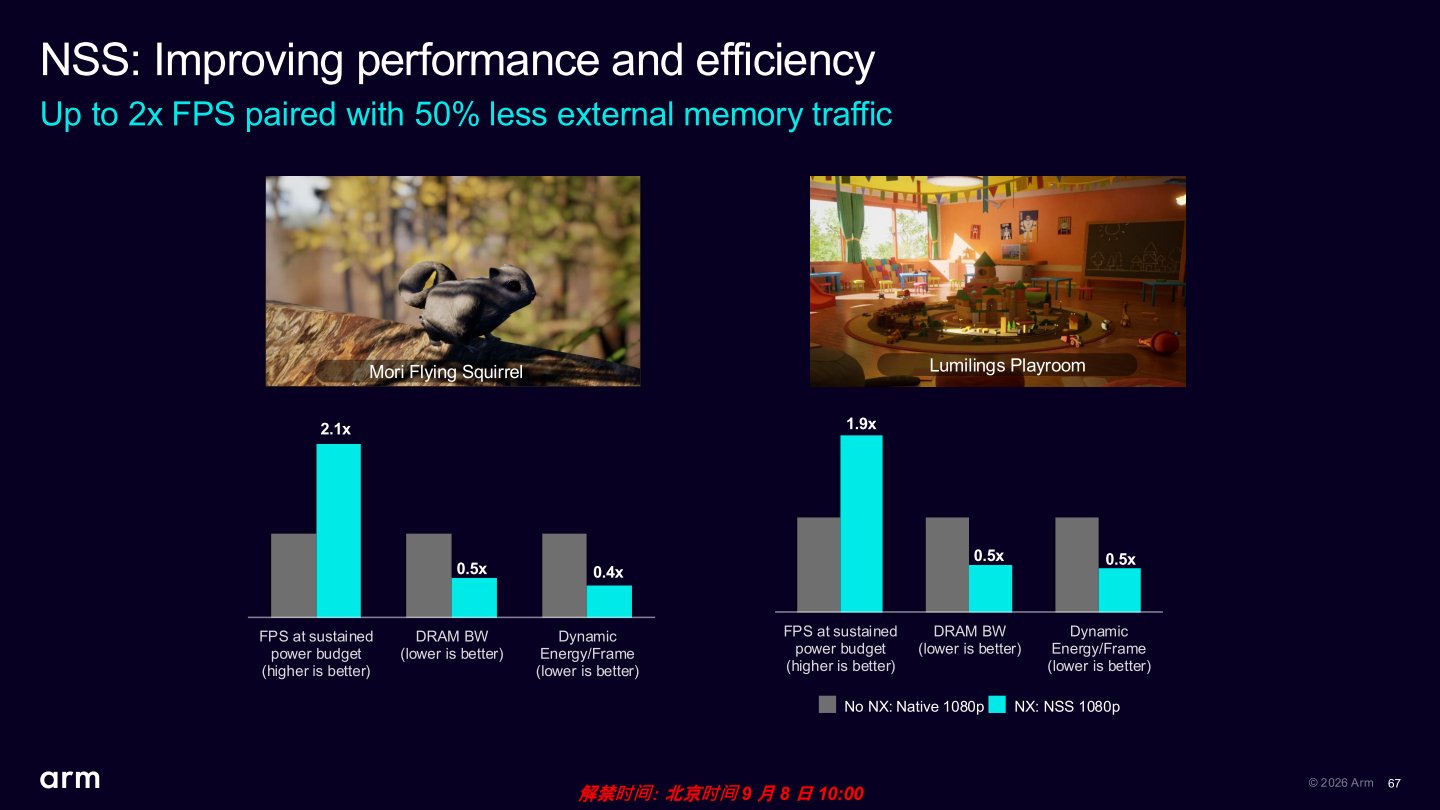
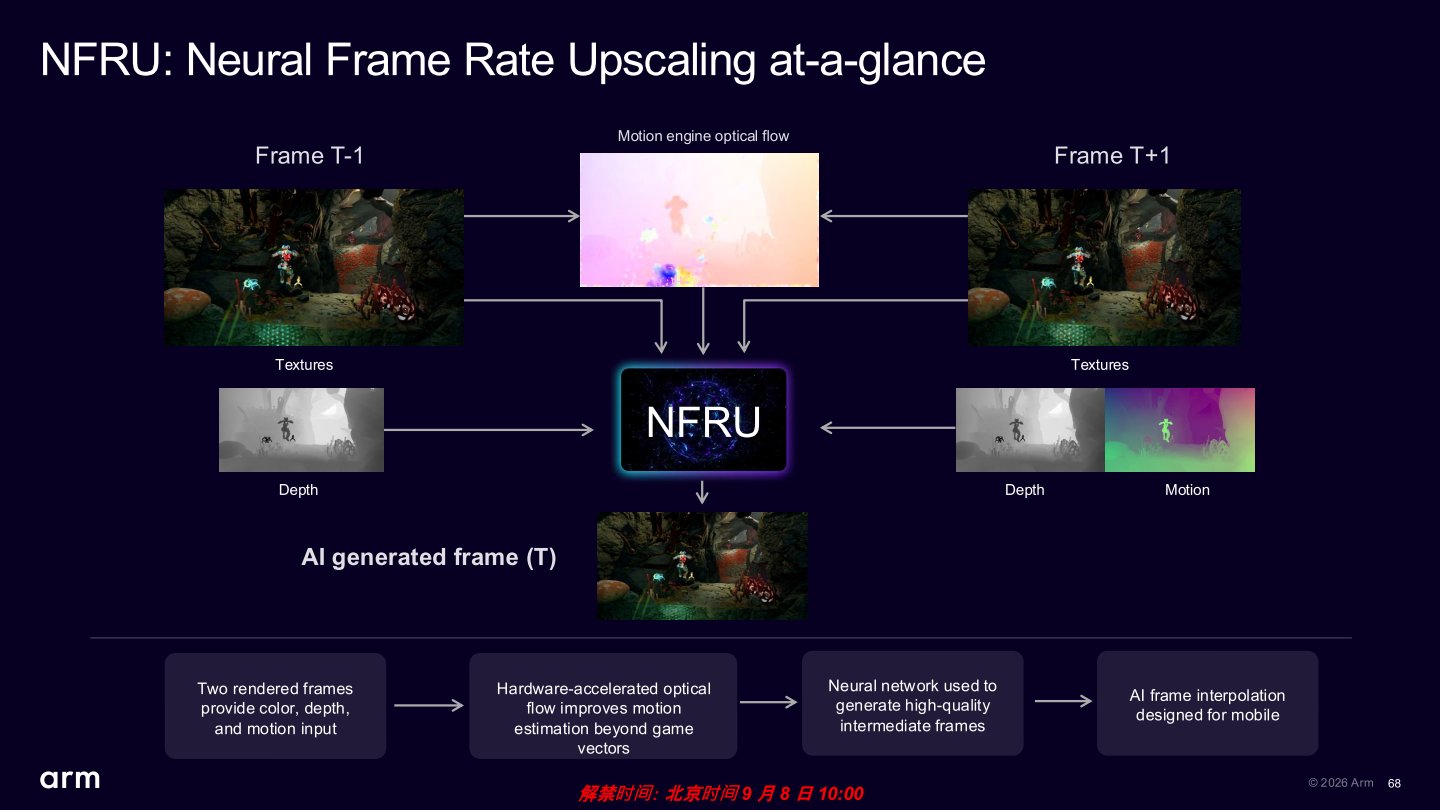
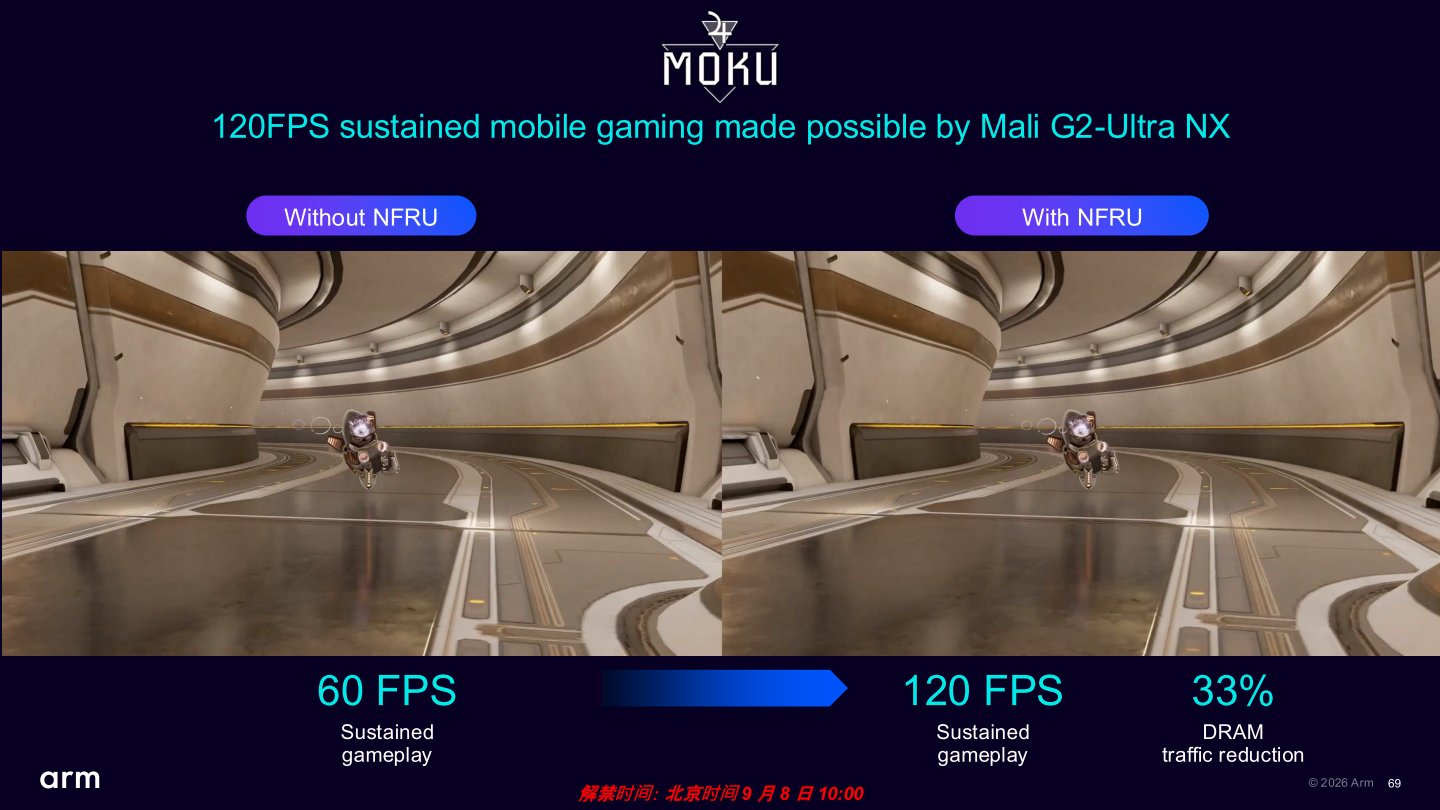
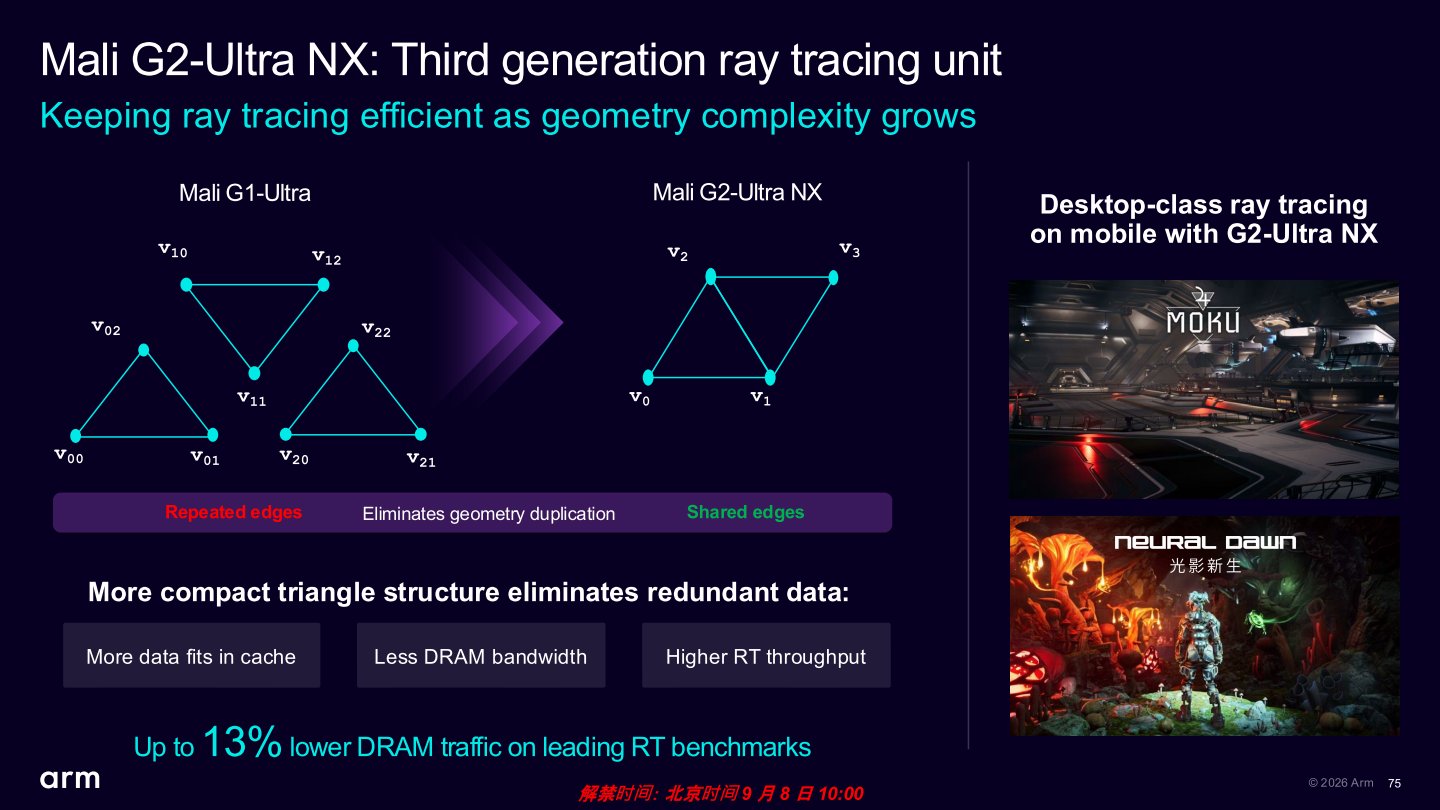
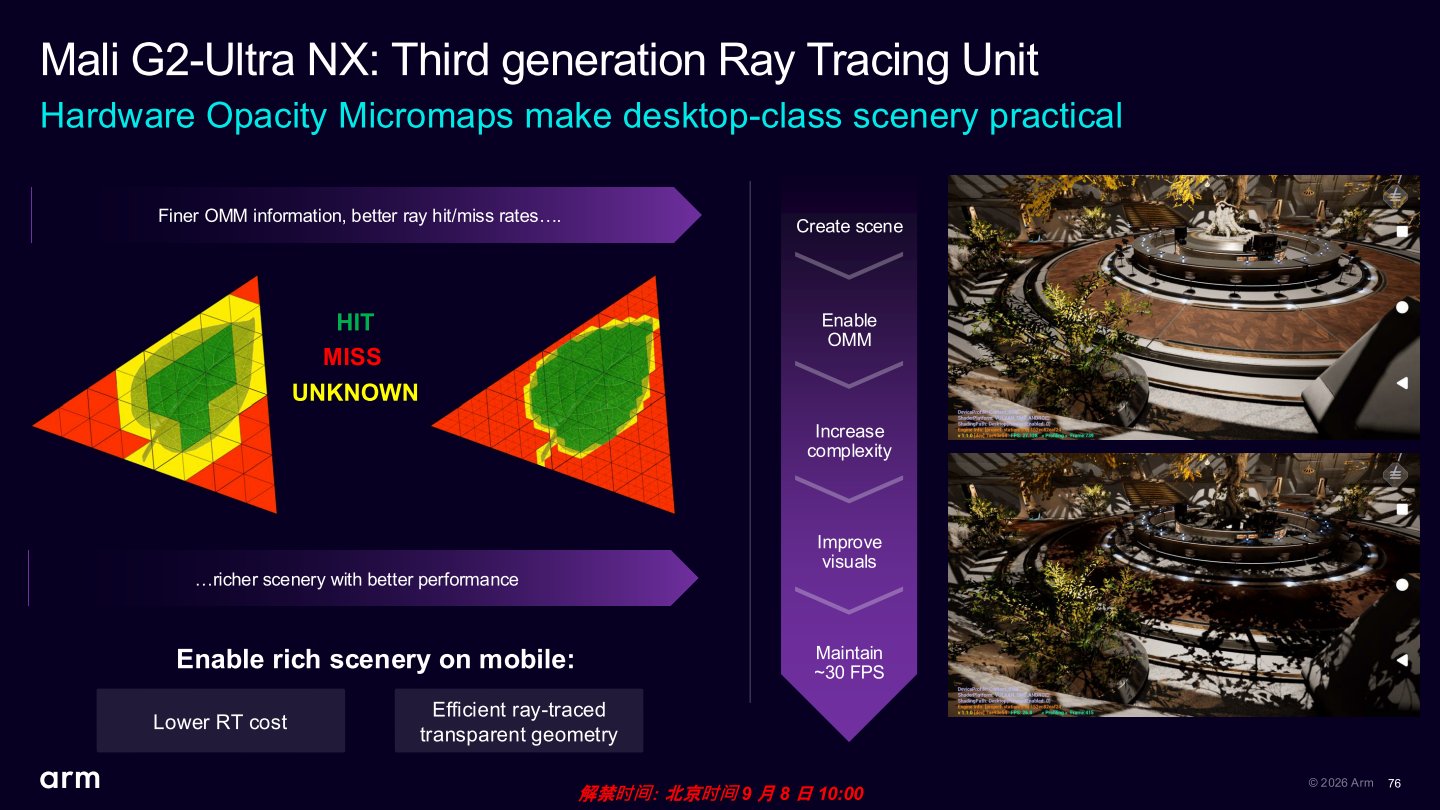
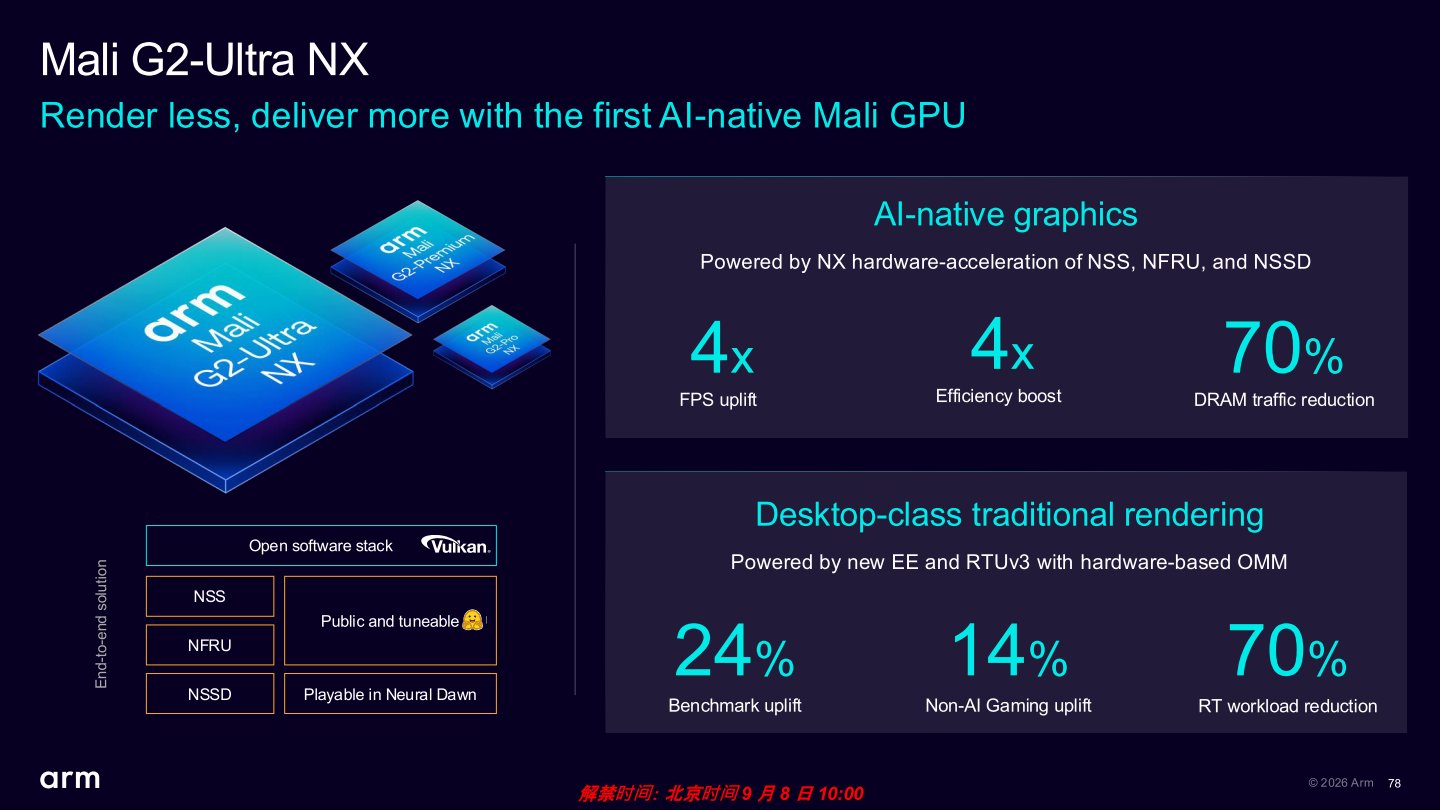
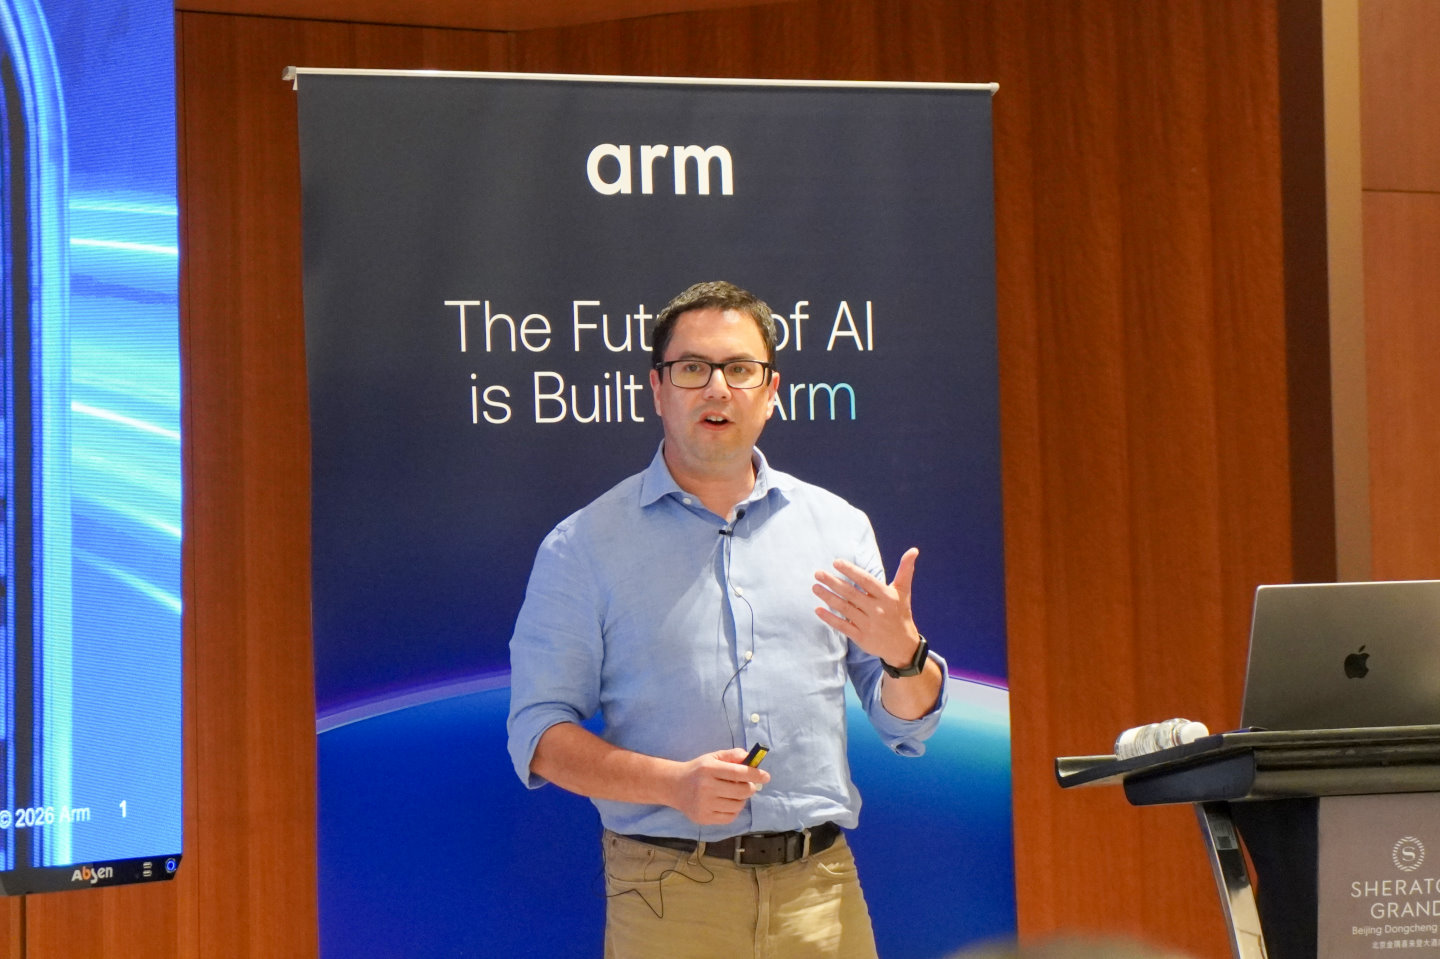
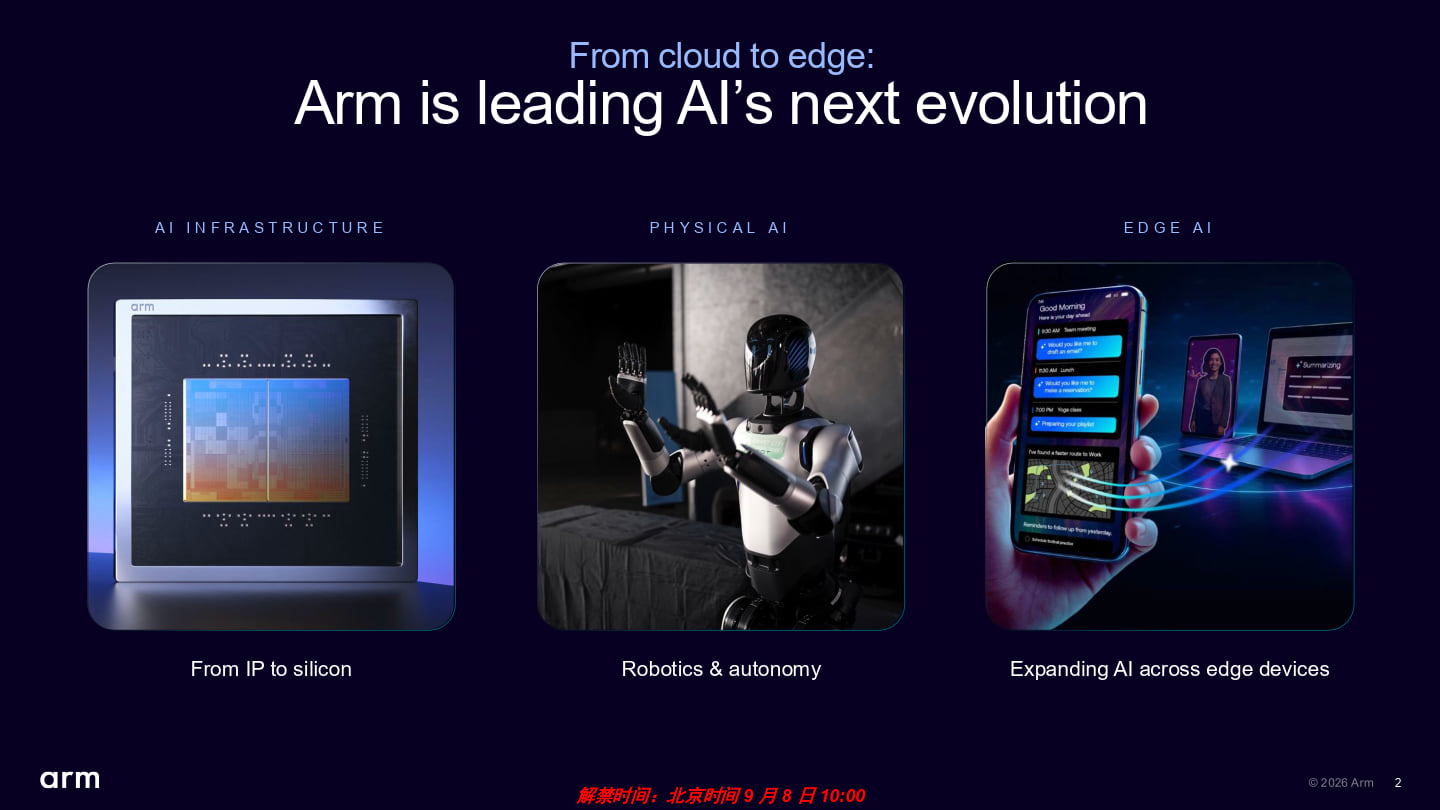
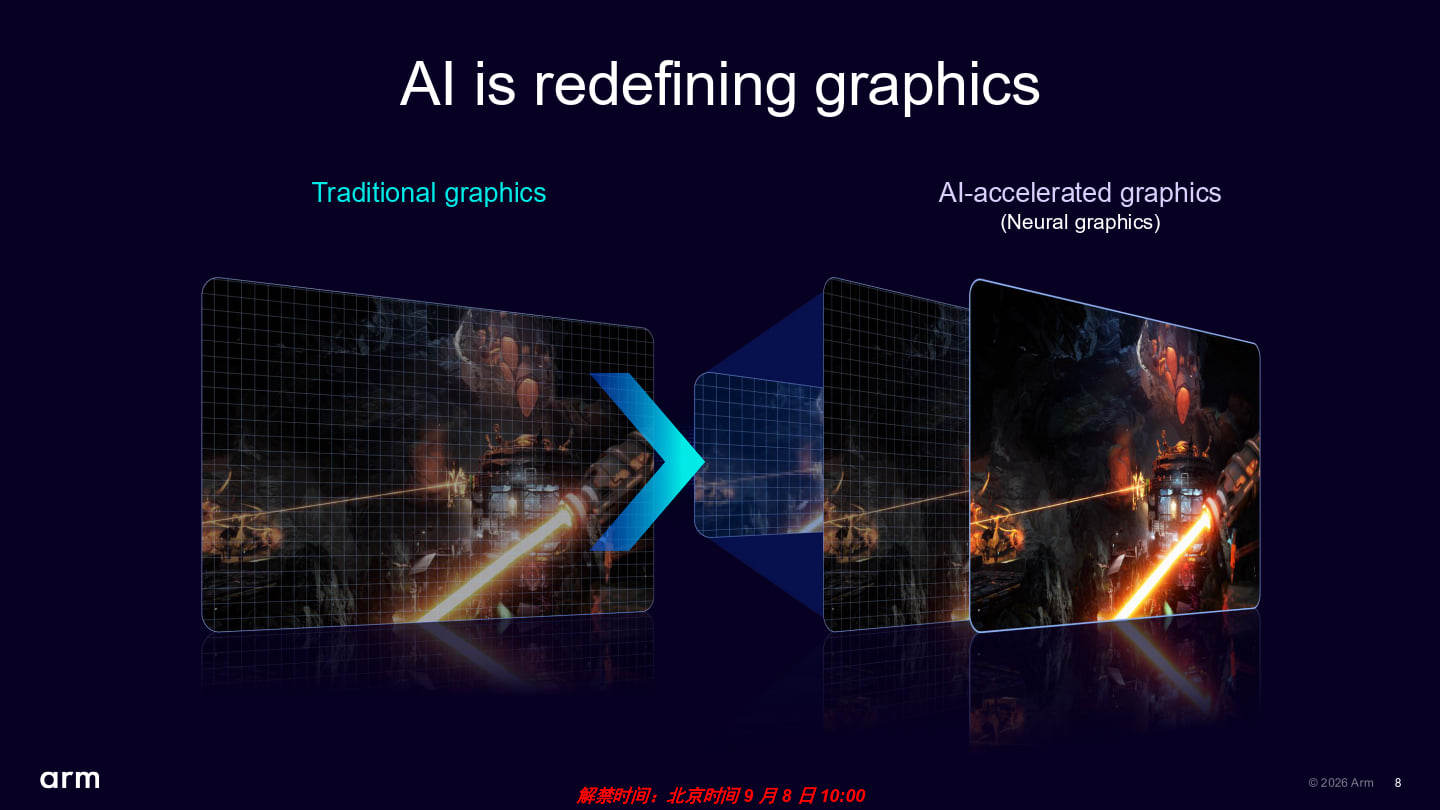
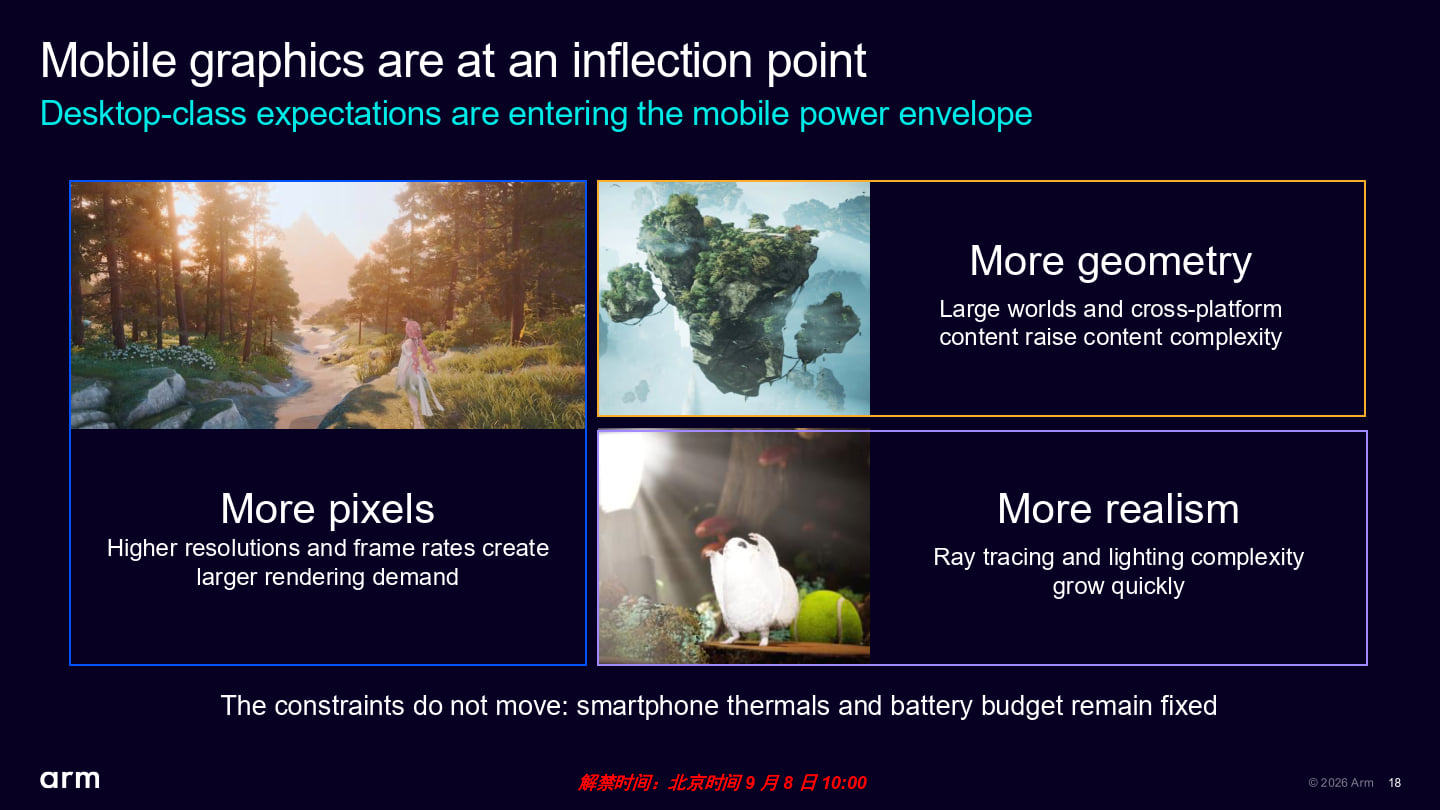
Arm於北京舉辦的Arm Tech Day 2026說明會中發表為智慧型手機、平板電腦等 行動裝置設計的CSS for Mobile 2運算子系統,透過從整體系統層面進行最佳化設計的運算平台,在有限的電力與散熱預算下提供充沛的通用運算、AI、繪圖效能,以滿足代理式AI以及遊戲主機等級的光線追蹤遊戲體驗。
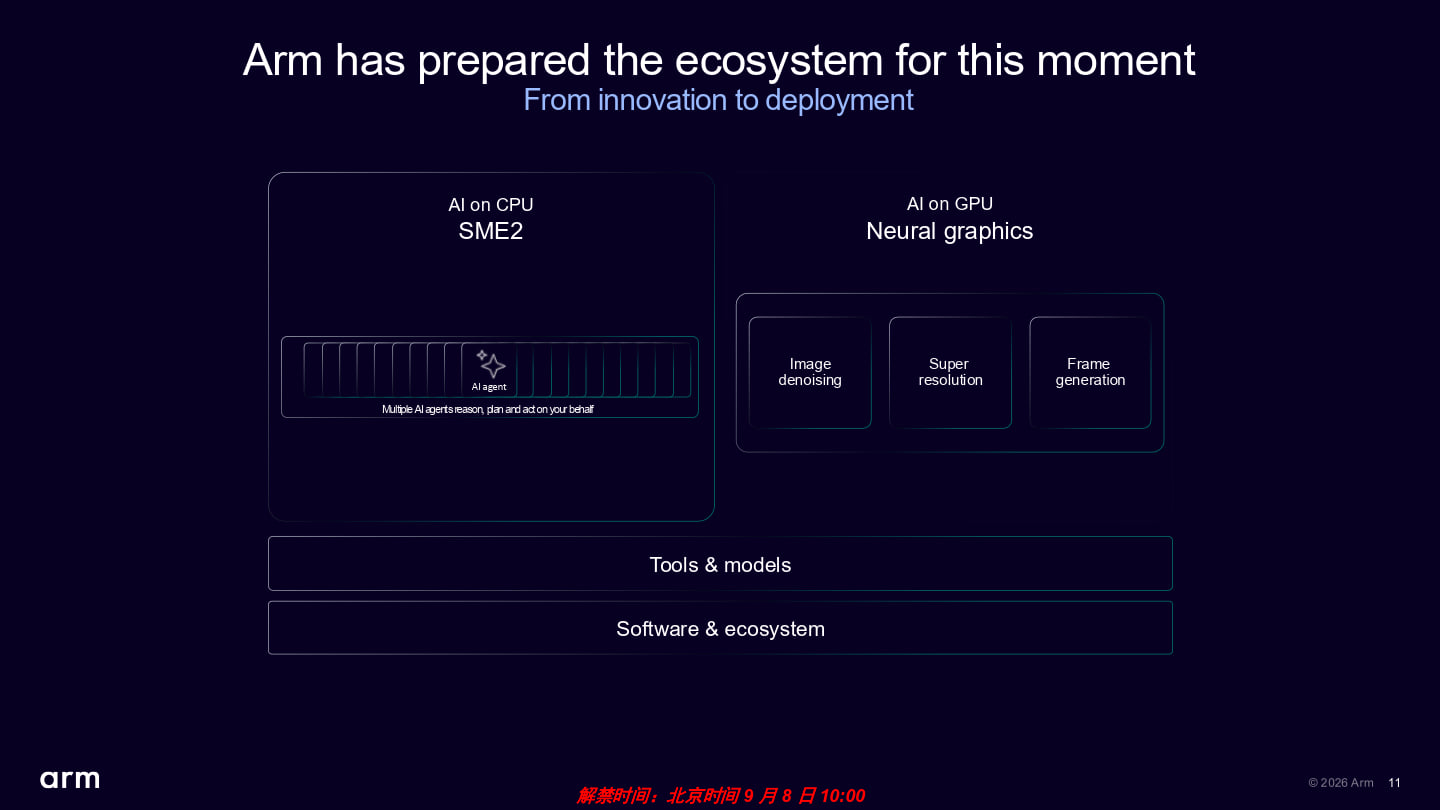
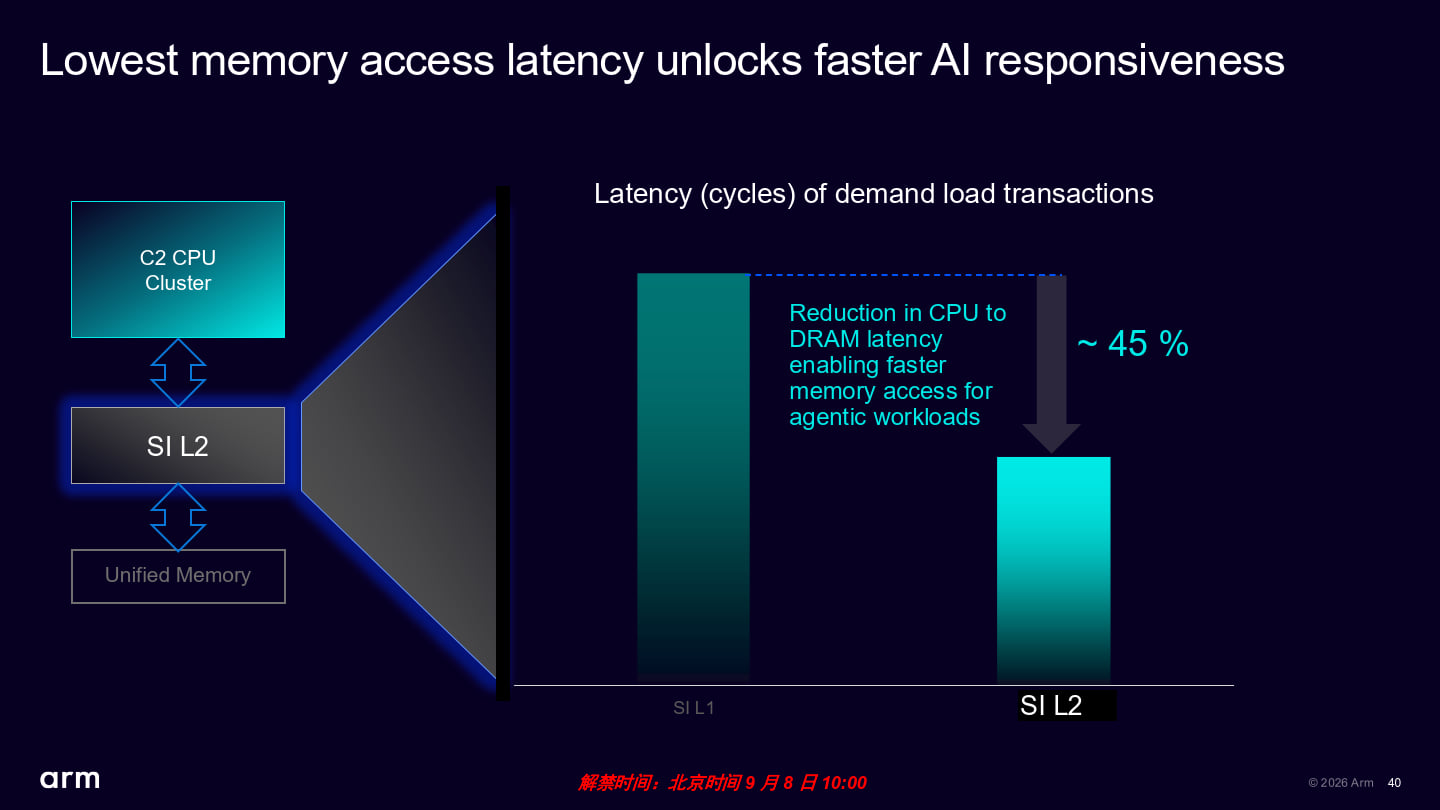
James McNiven再次說明CPU在行動裝置執行AI應用程式的重要性。首先他提到目前有99%的行動裝置搭載Arm架構CPU,因此在CPU上進行AI推論運算有著明顯的相容性優勢,再加上CPU具有最高的可程式化性質,能夠透過軟體方式支援所有資料類型的浮點數運算,且因為資料可以直接在CPU完成運算,不需搬移至外部GPU或NPU(神經處理器),因此具有延遲較短的優勢。
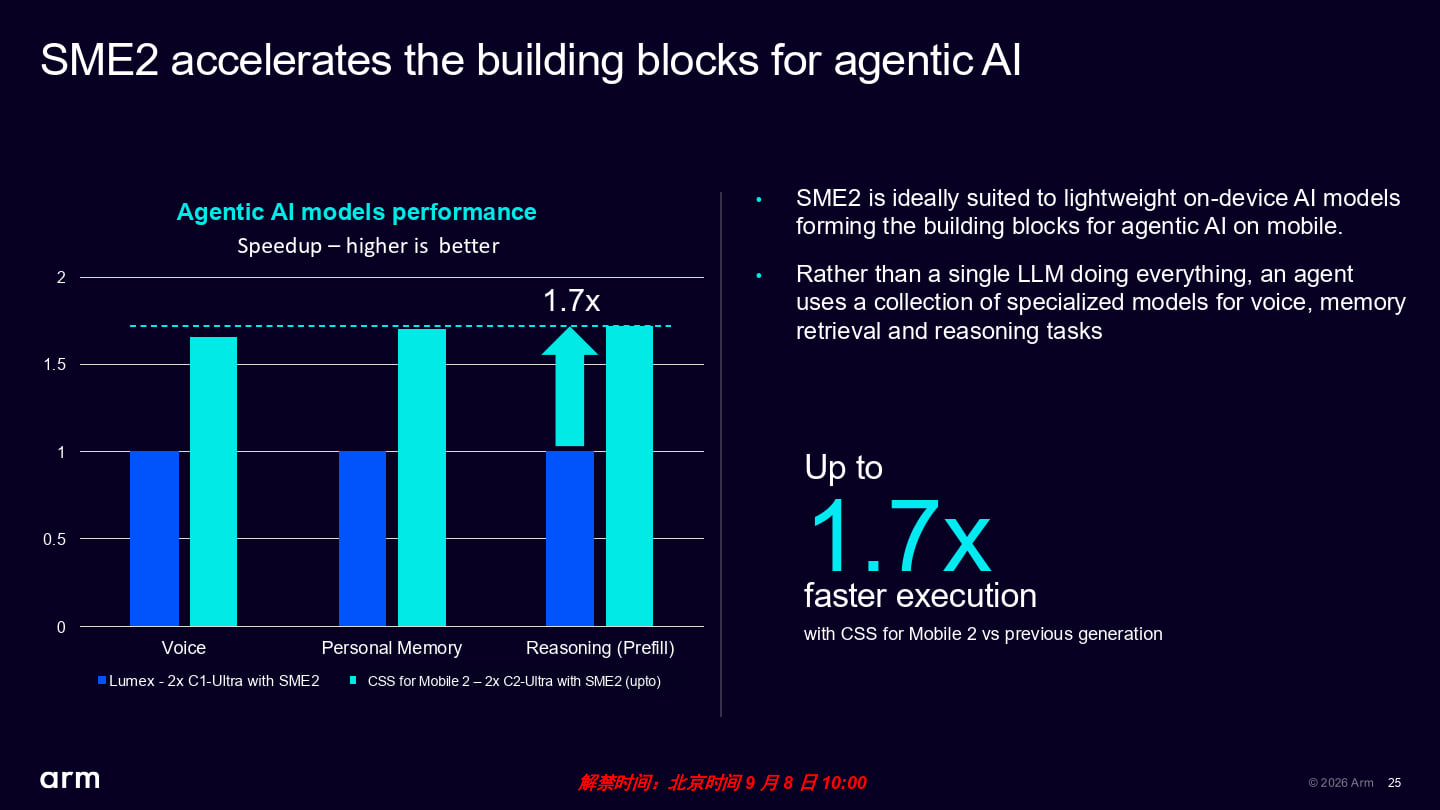
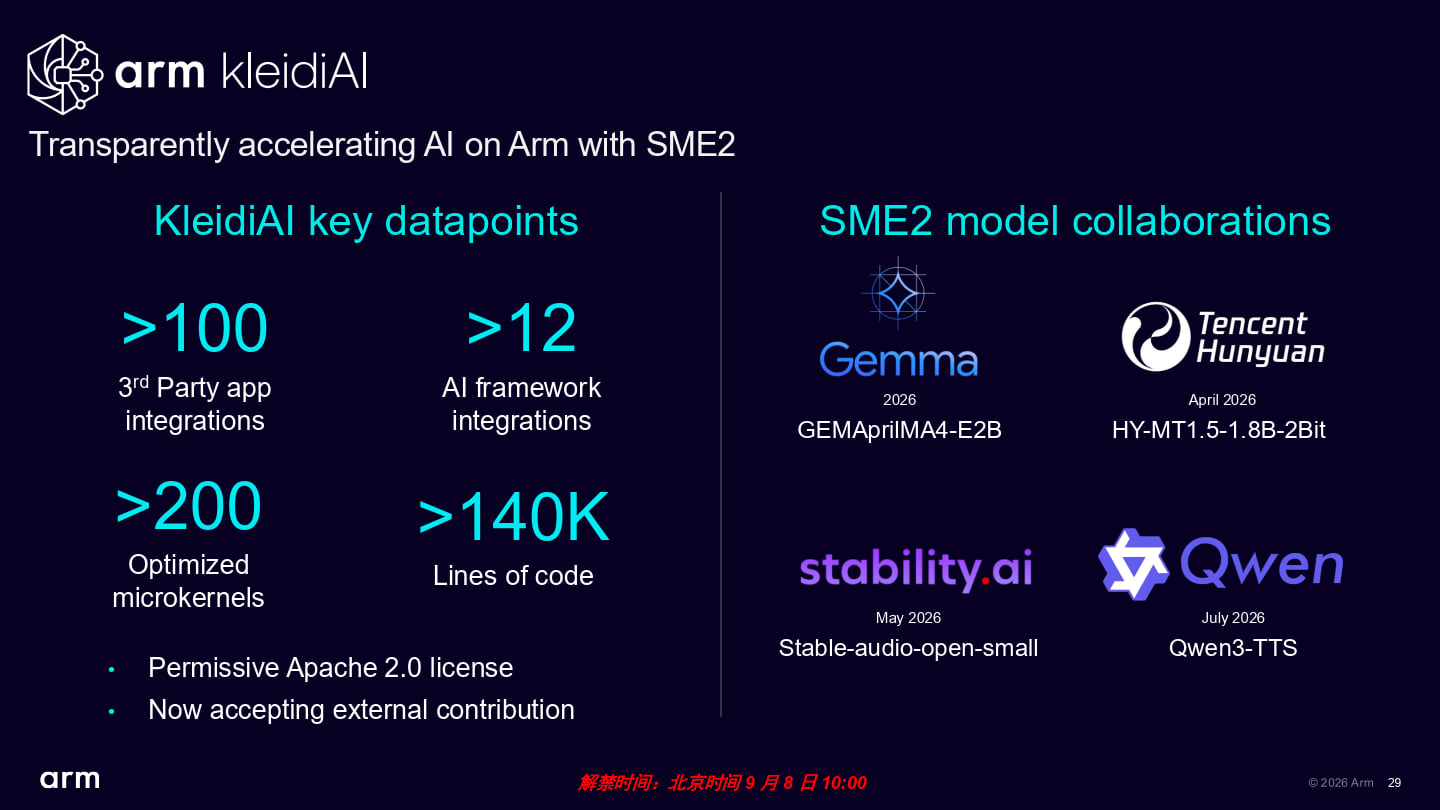
Arm在CSS for Mobile 2中整合2組SME2引擎(Scalable Matrix Extension 2,第2代可擴展矩陣延伸指令集,主要功能為強化AI運算效能),較前代提供2倍的運算能量,對於AI應用程式有著絕對的助益。
在這篇文章中瞭解CSS for Mobile 2的特色後,筆者也會在後續文章中繼續介紹C2-Ultra、C2-Pro等CPU以及G2-Ultra NX GPU,請讀者參考下方目錄繼續閱讀。
Arm Tech Day 2026系列文章目錄 CSS for Mobile 2帶來全新C2-Ultra CPU、G2-Ultra NX GPU,強化手機代理式AI與主機級光線追蹤遊戲體驗(本文) C2-Ultra CPU進化支援台積電2奈米製程,強化更接地氣的代理式AI助手功能(工作中) G2-Ultra NX GPU搭配多種神經繪圖升頻技術,在2 W功耗條件下帶來電腦級遊戲體驗(工作中)
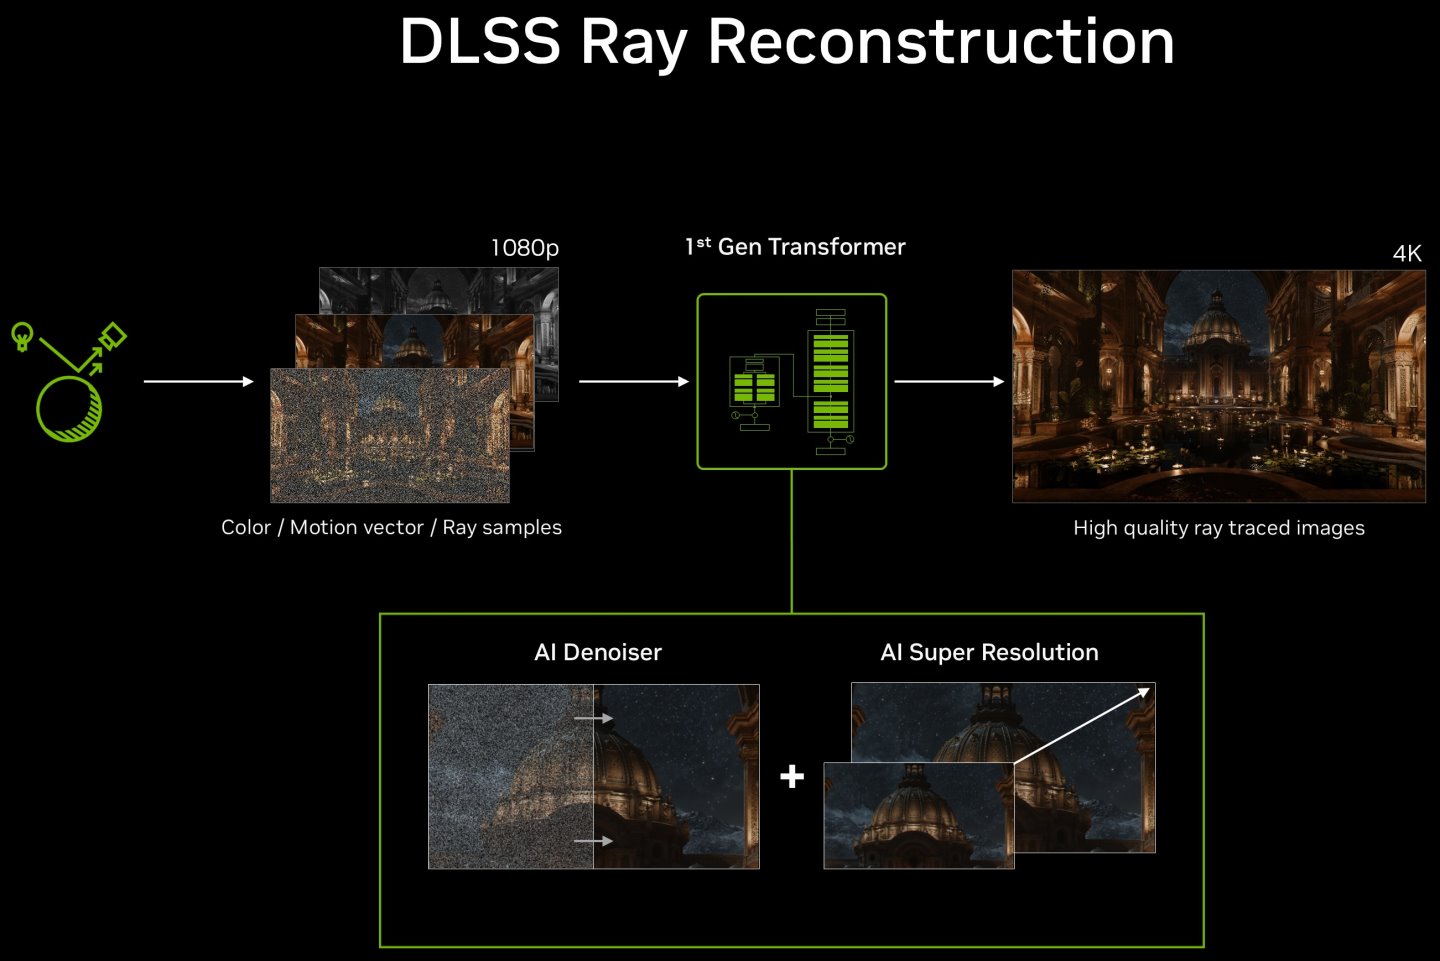
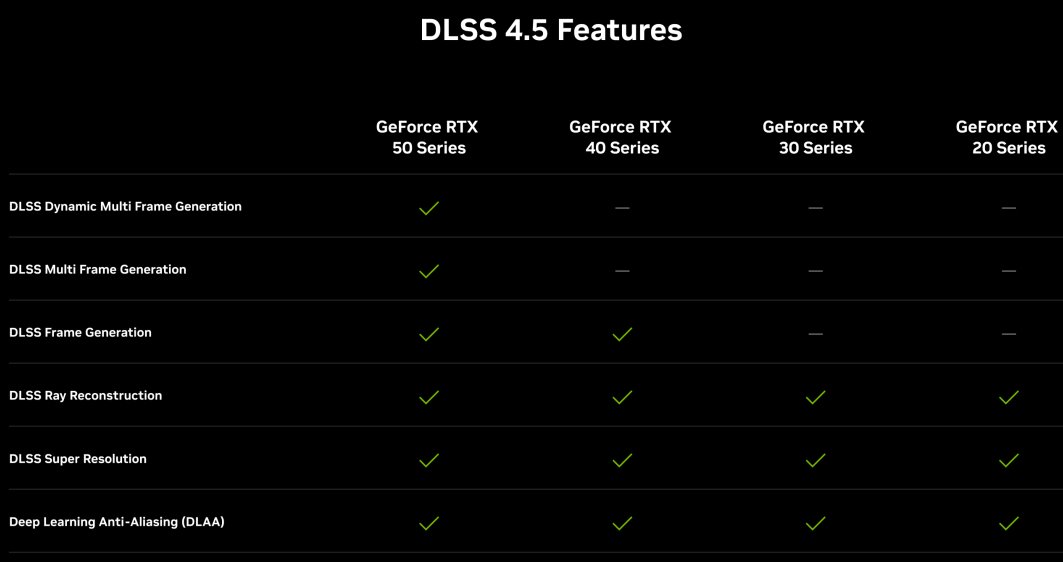
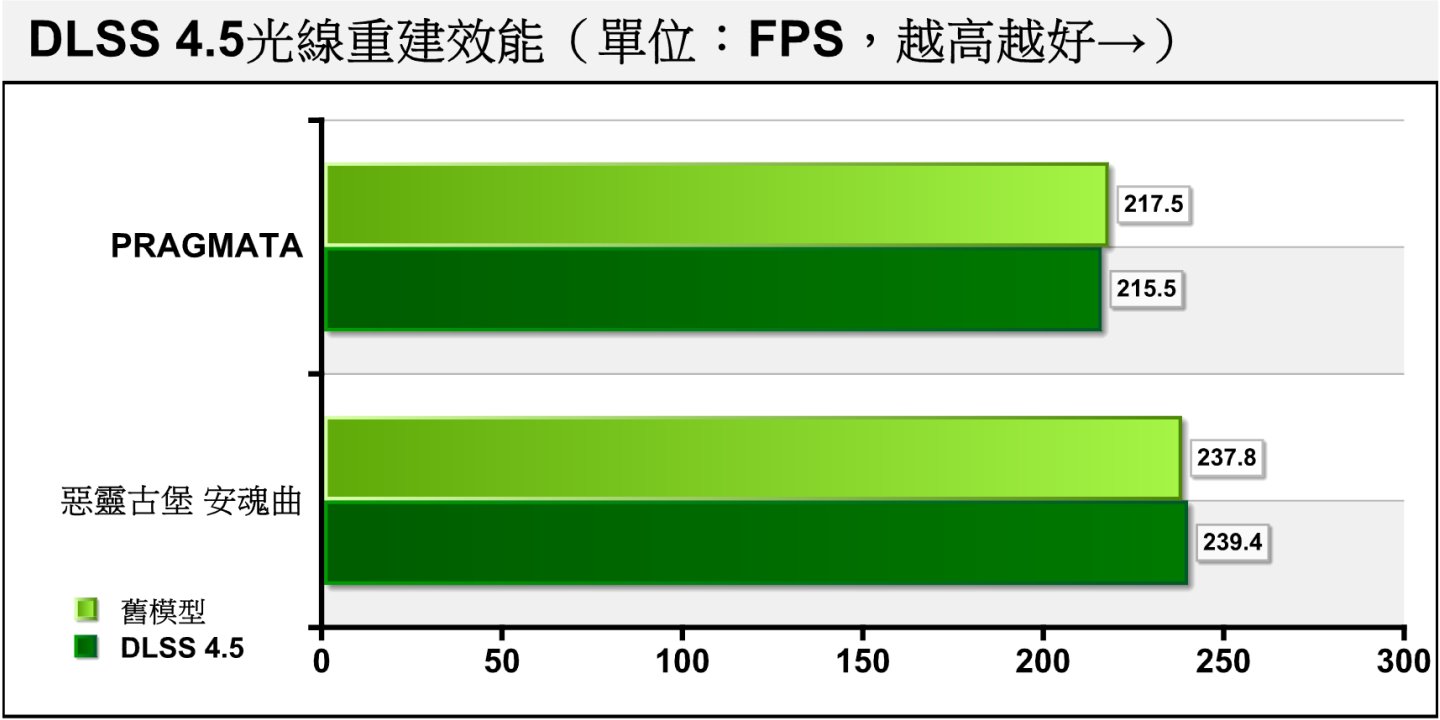
回顧過去第1至4代DLSS技術主要功能為超解析度(Super Resolution)與畫格生成(Frame Generation),前者為降低遊戲實際繪製的解析度,並透過AI演算法將解析度提高,舉例來說以1920 x 1080解析度繪製遊戲畫面,並以DLSS技術提升至3840 x 2160後再輸至螢幕,而後者則是參考1幀實際繪製的畫格,並透過AI演算法產生最多5幀生成畫格,舉例來說能讓原本FPS為20幀的畫面提升至120幀,這2項功能都能大幅改善遊戲的FPS效能與視覺流暢度。更多DLSS的技術說明請參考下列文章。
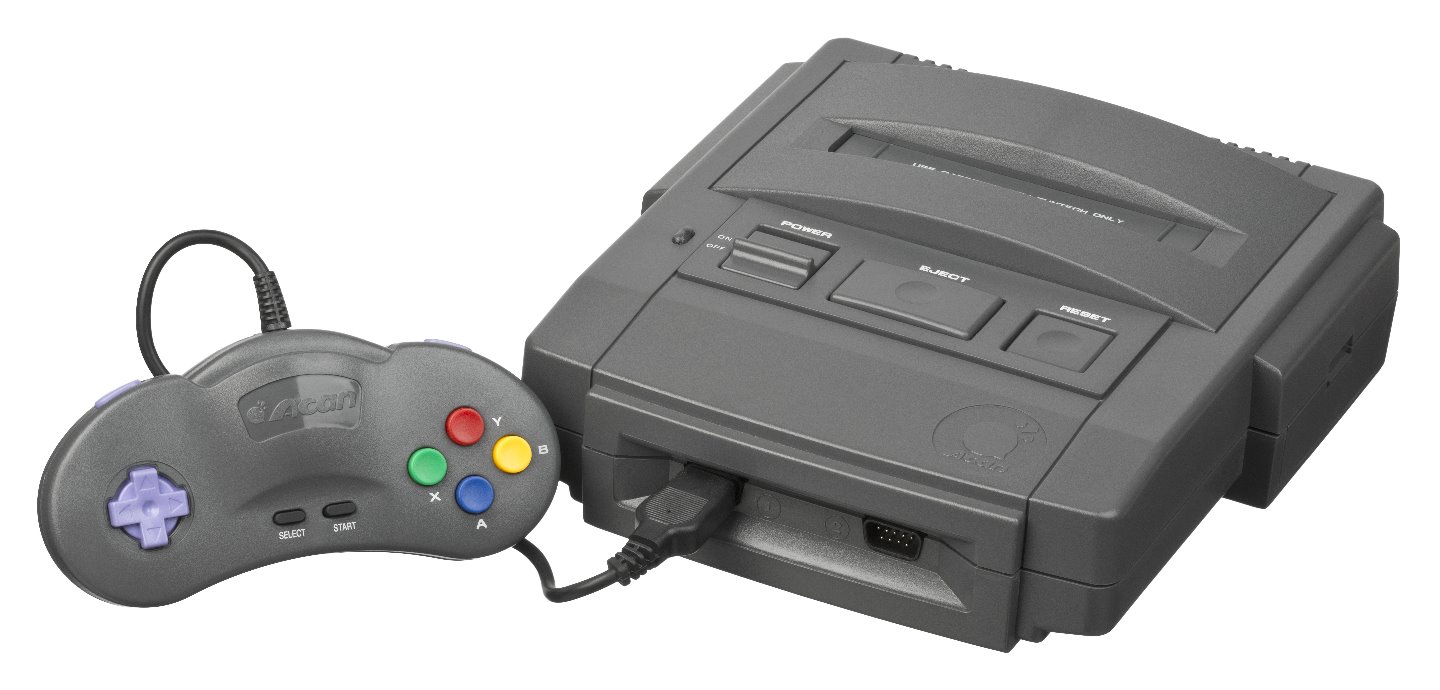
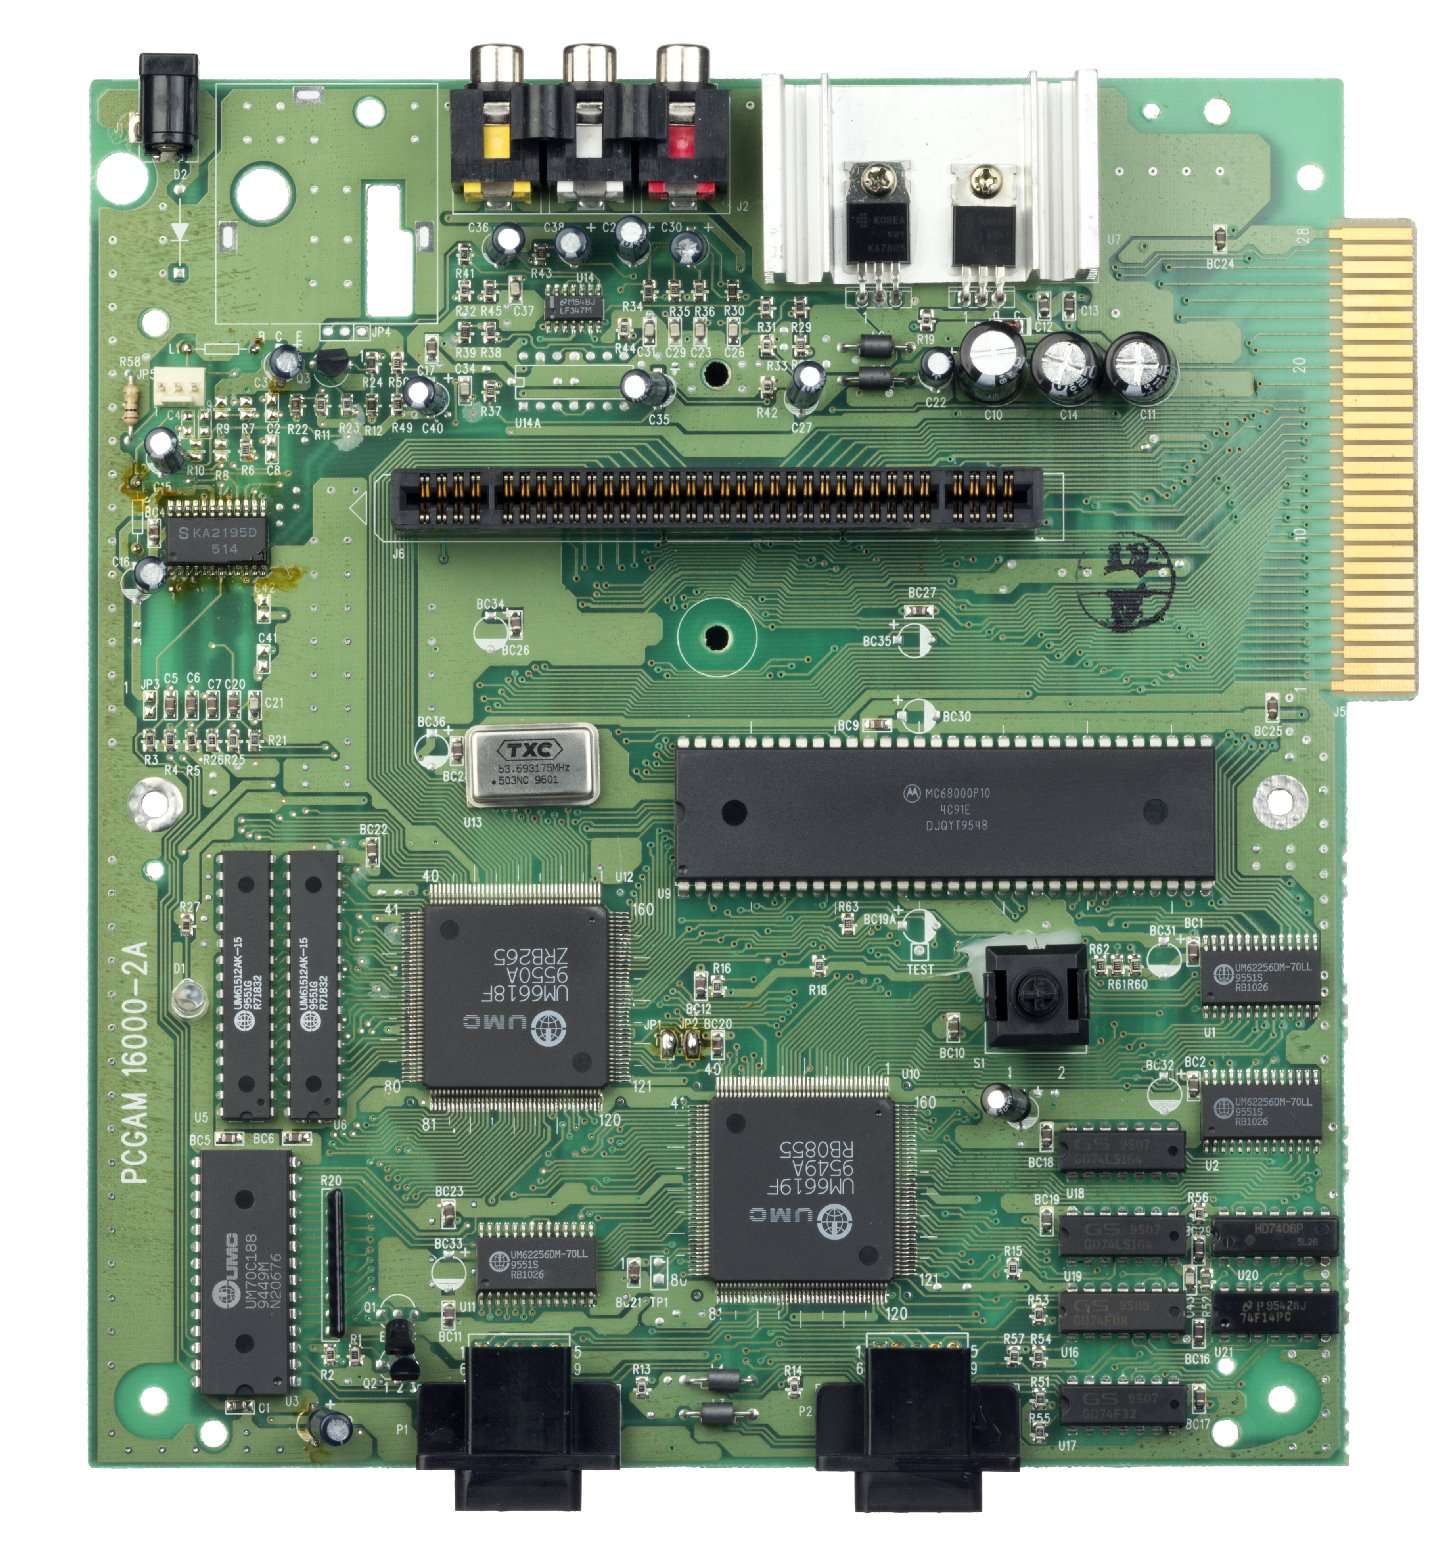
UMC(聯華電子)的子公司敦煌科技於1995年推出代號為F-16的Super A'can遊戲主機,其發售時間晚於1989年上市的Sega Mega Drive以及1990年上市的Nintendo Super Famicom,可歸類於第4世代的16 Bit遊戲主機,並以台灣研發的中文遊戲軟體為主要賣點,打破當年中文電視遊樂器遊戲相當希少的窘境。
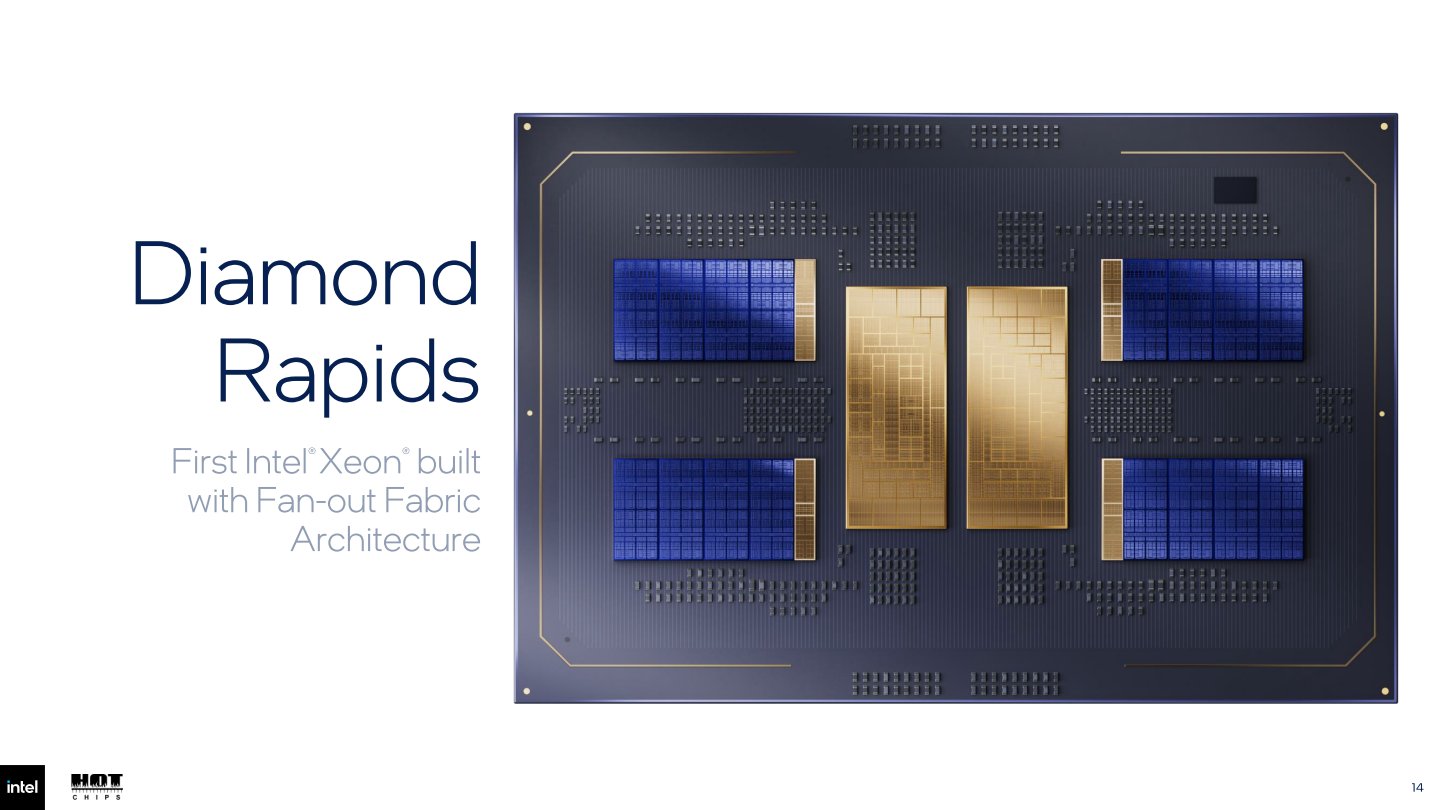
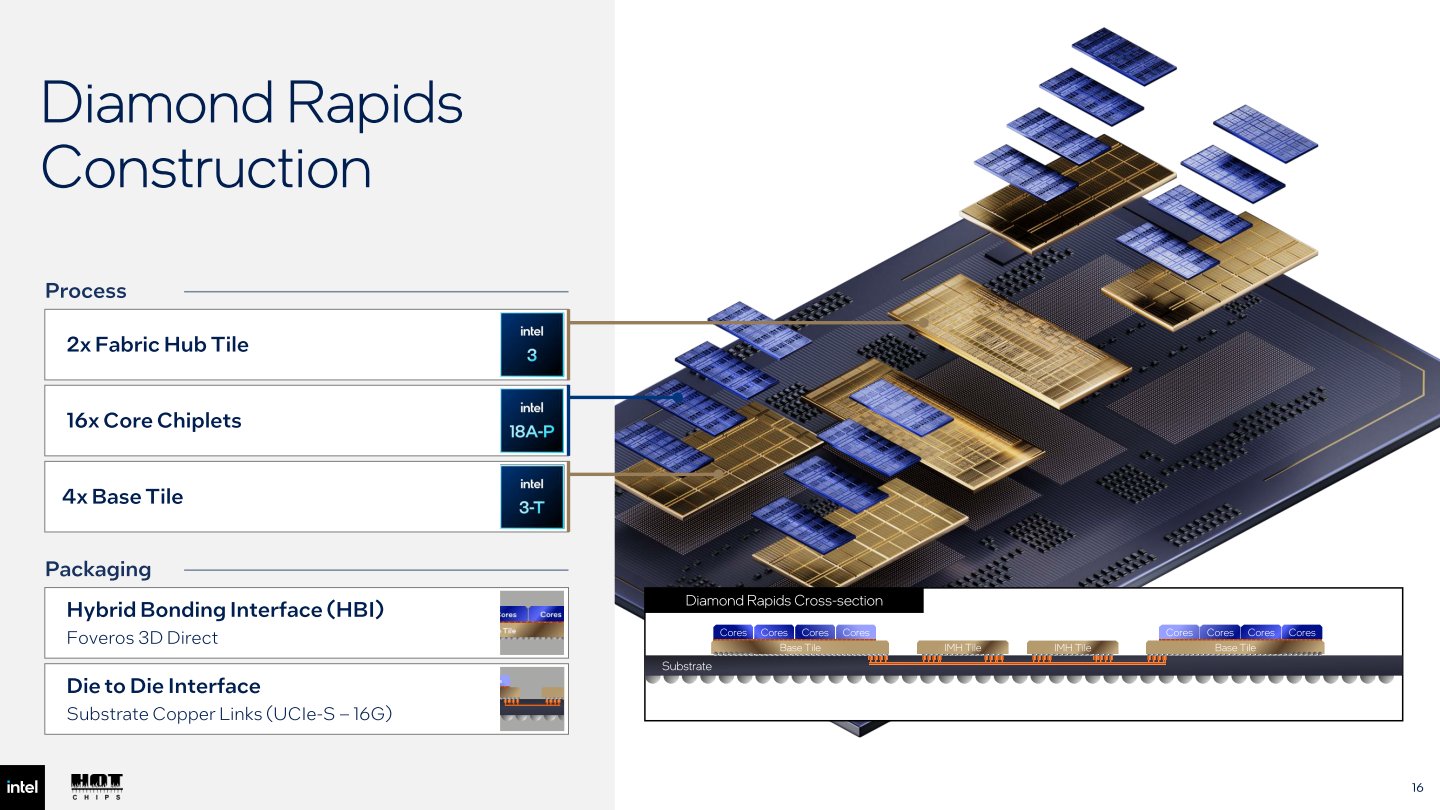
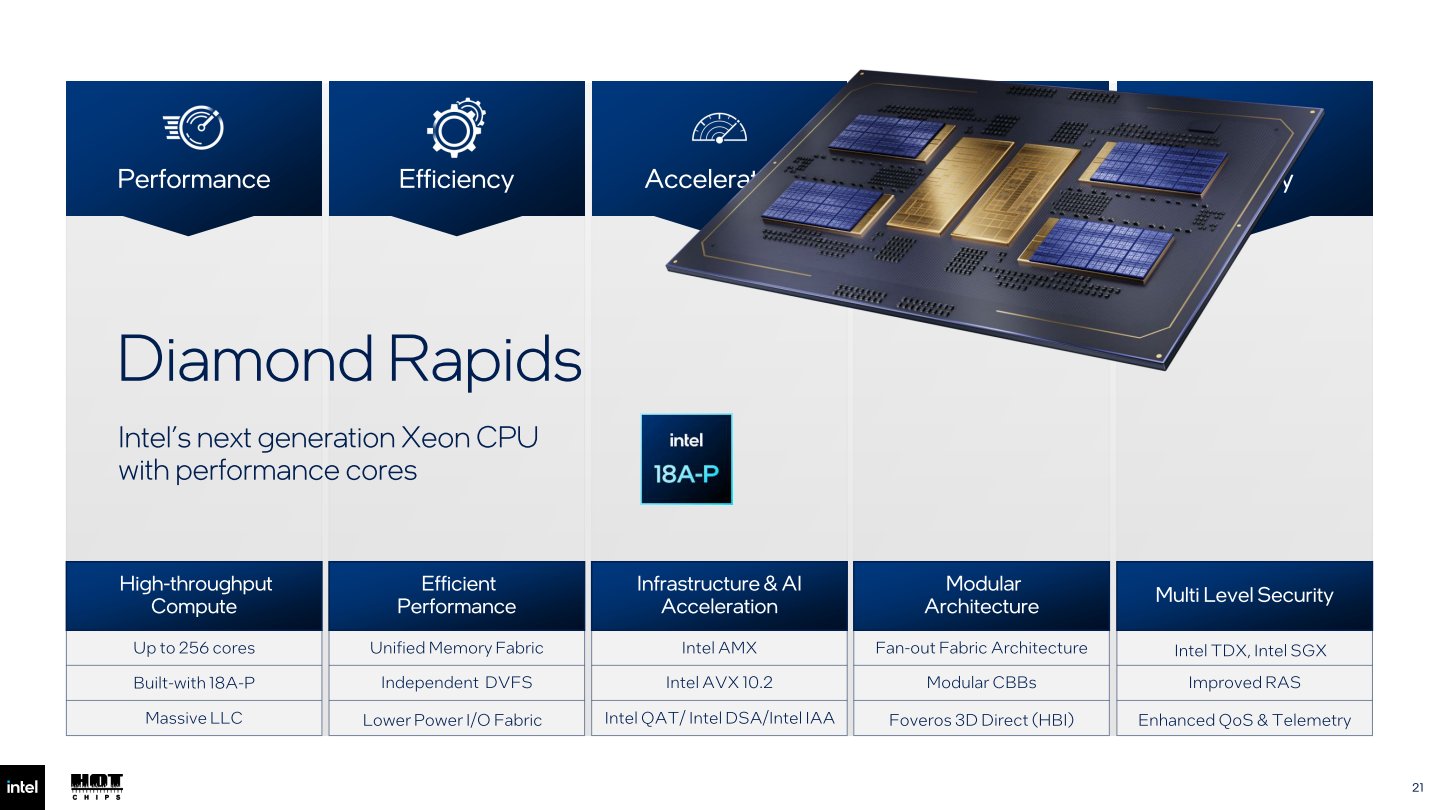
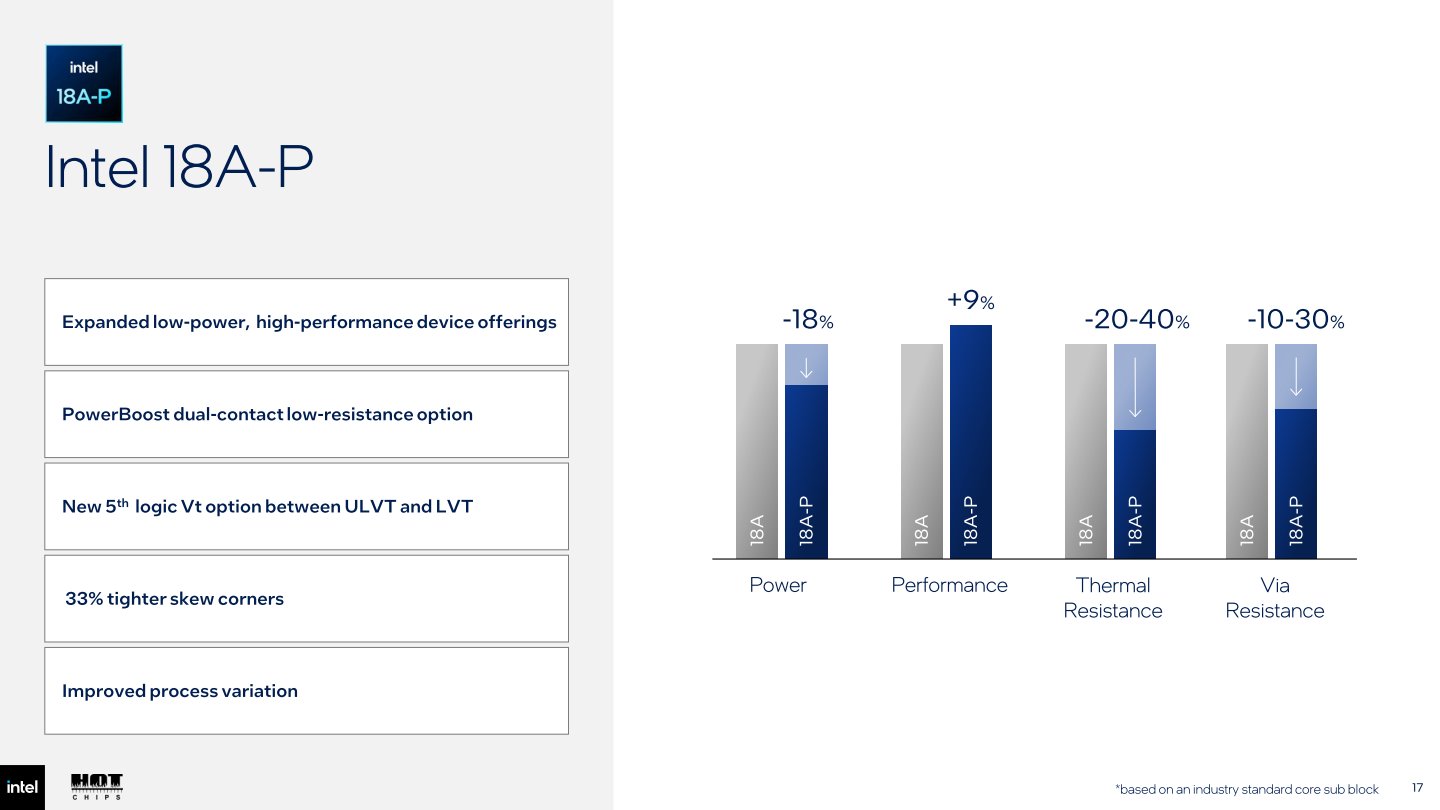
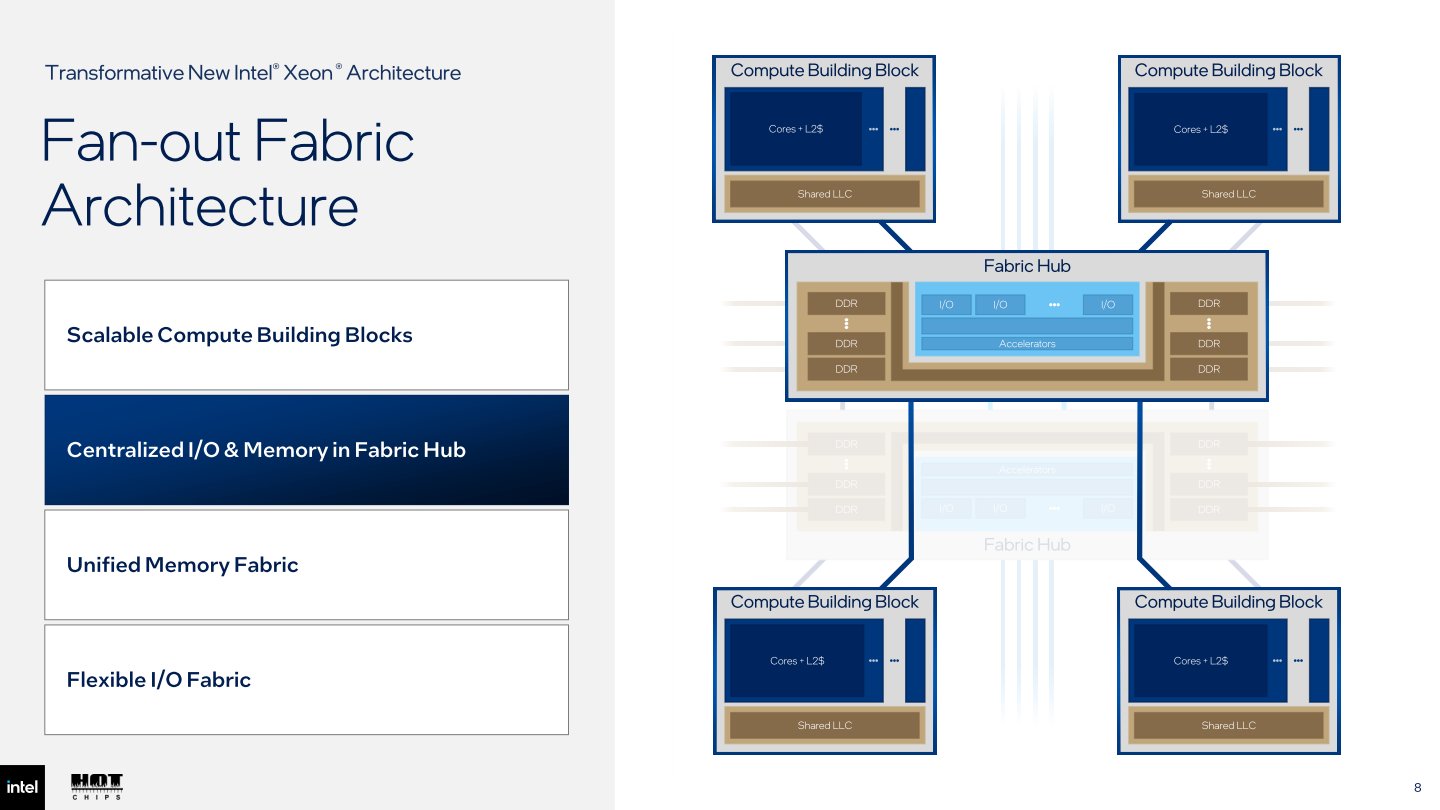
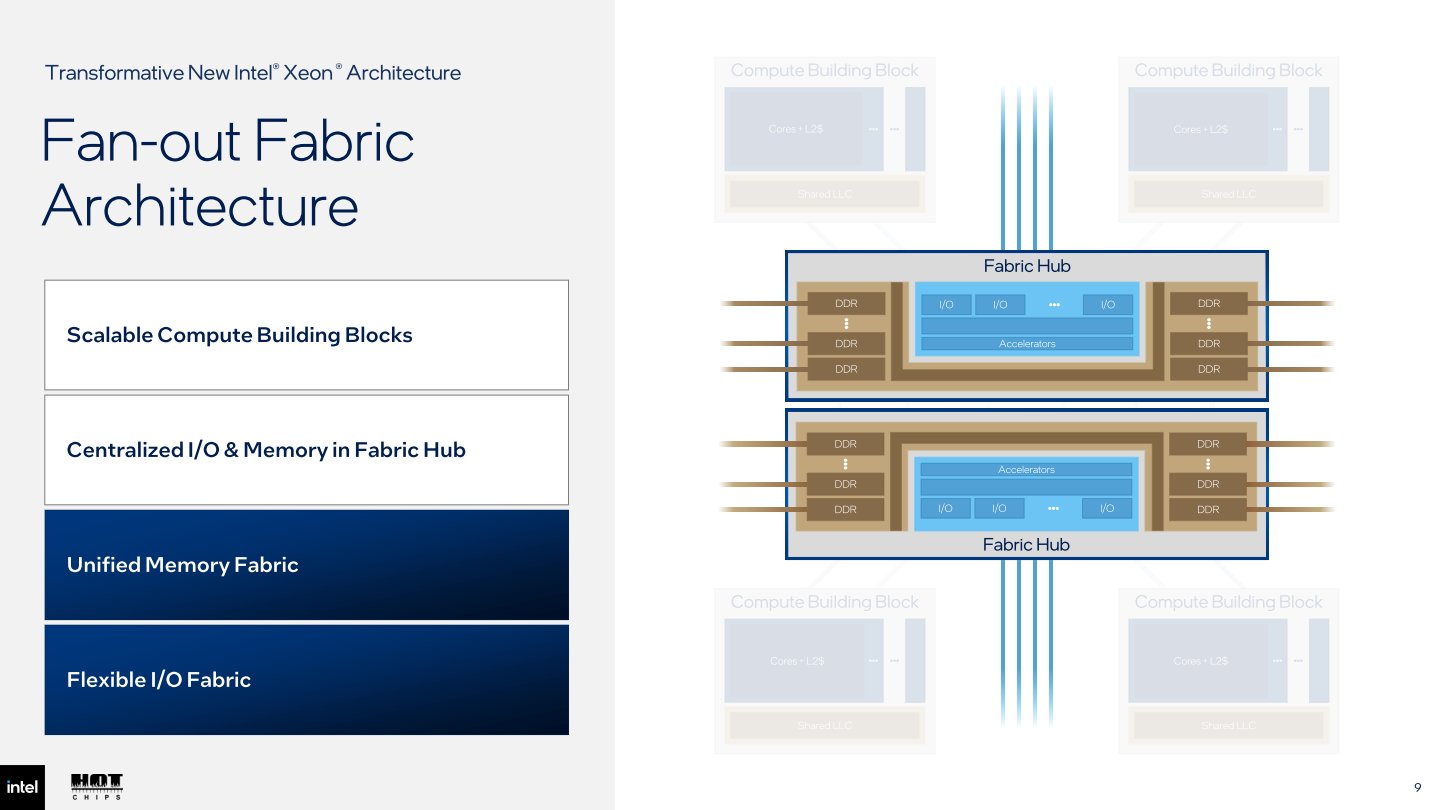
代號為Diamond Rapids的次世代Xeon處理器針對包含企業級代理式AI在內的多種用途設計,導入全新架構,結合可靈活配置的運算模組、統一記憶體互連架構與彈性I/O,並採用進一步強化的Intel 18A-P節點製程,搭配Foveros Direct 3D先進封裝與UCIe-S互連技術,提供穩定的高效能、高效率與可擴展性。
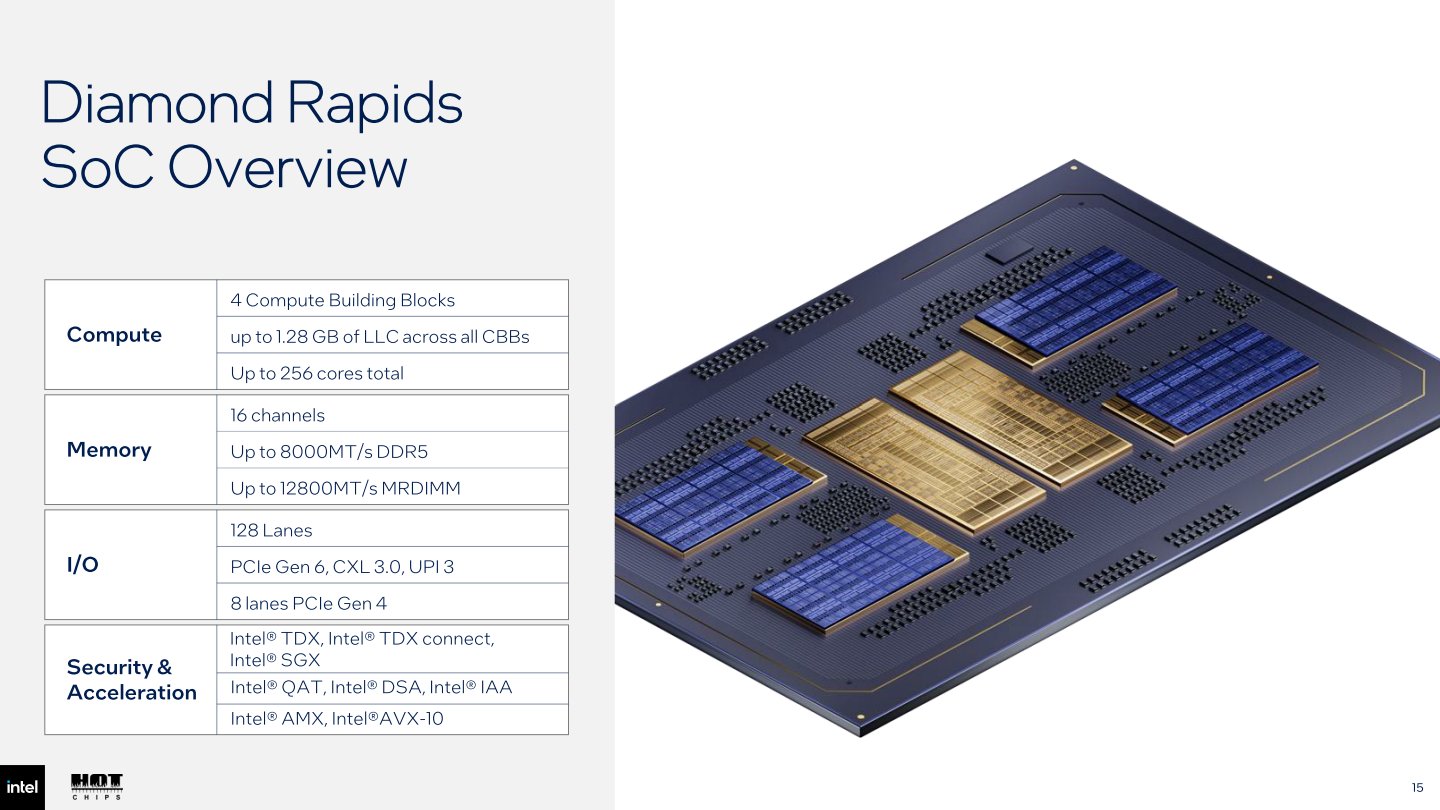
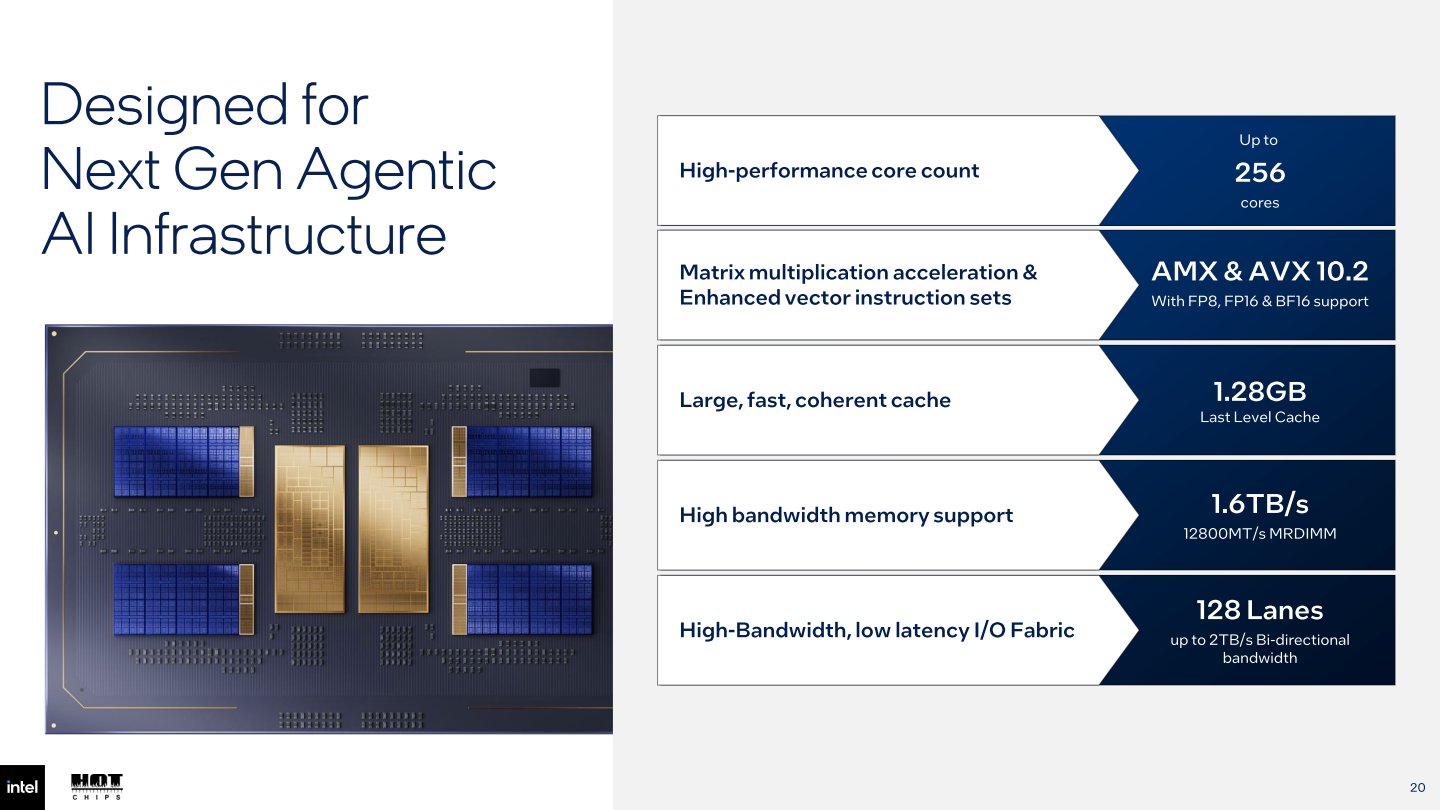
Diamond Rapids處理器最多可以容納4組運算建置模塊(Compute Building Block),每組模塊又可以容納4組運算小晶片(Compute Chiplet),而每組小晶片又能容納16組處理器核心,因此單一處理器最高可達256核心組態,並具有最高1.28 GB最後階快取記憶體(LLC,Last Level Cache)。
Diamond Rapids支援DDR5-8000 RDIMM或DDR5-12800 MRDIMM(Multiplexed Rank DIMM,多工階級雙行記憶體模組),最高可組成16通道記憶體組態。擴充能力部分則提供128組PCIe Gen 6通道與8組PCIe Gen 4通道,並支援UPI 3(Ultra Path Interconnect)與CXL 3.0(Compute Express Link)等互連技術,強化多處理器之間的資料交換,以及擴充記憶體、記憶體池化等彈性擴充功能。
《Lines of EVANGELION 新世紀福音戰士展:線》以「線」作為核心,現場展出由Studio khara提供的畫稿、設定資料及動畫製作素材,其中也包括鶴卷和哉、前田真宏、山下育人等核心創作者的重要作品。參觀者可以近距離欣賞真嗣、零、明日香、真理、薰等5位《新世紀福音戰士》劇中駕駛員的輪廓,以及EVA機體、使徒、背景等設定資料,深入體驗本作獨特的世界觀。
《Lines of EVANGELION 新世紀福音戰士展:線》展覽於2026年8月14日至10月04日在新光三越台北信義新天地A9 9樓宴會展演館舉辦,需要注意的是週一至週四、週日的最後入場時間為18:30,週五、週六及國定假日則為19:30。更多售票與周邊產品資訊請參考展覽官方Facebook與Instagram。
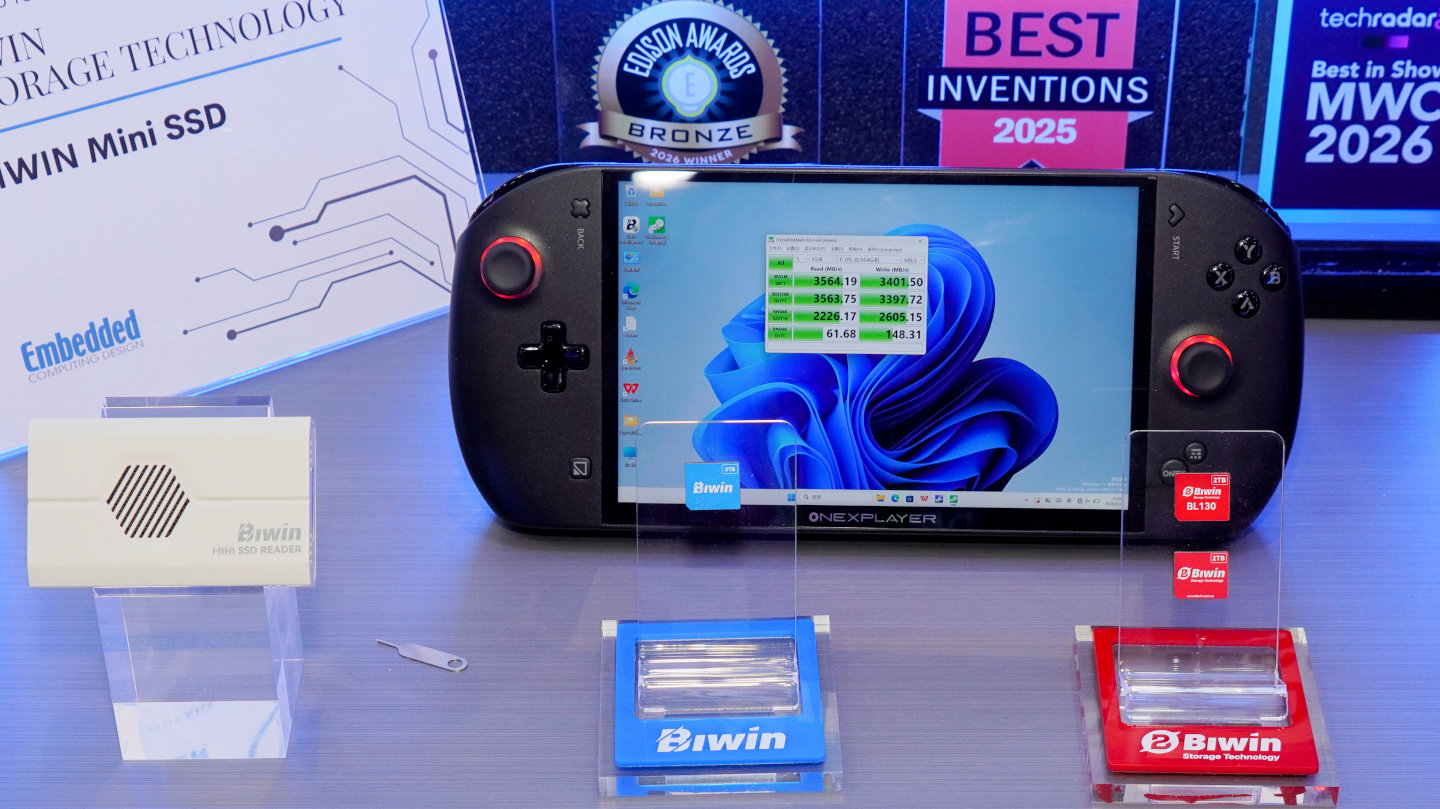
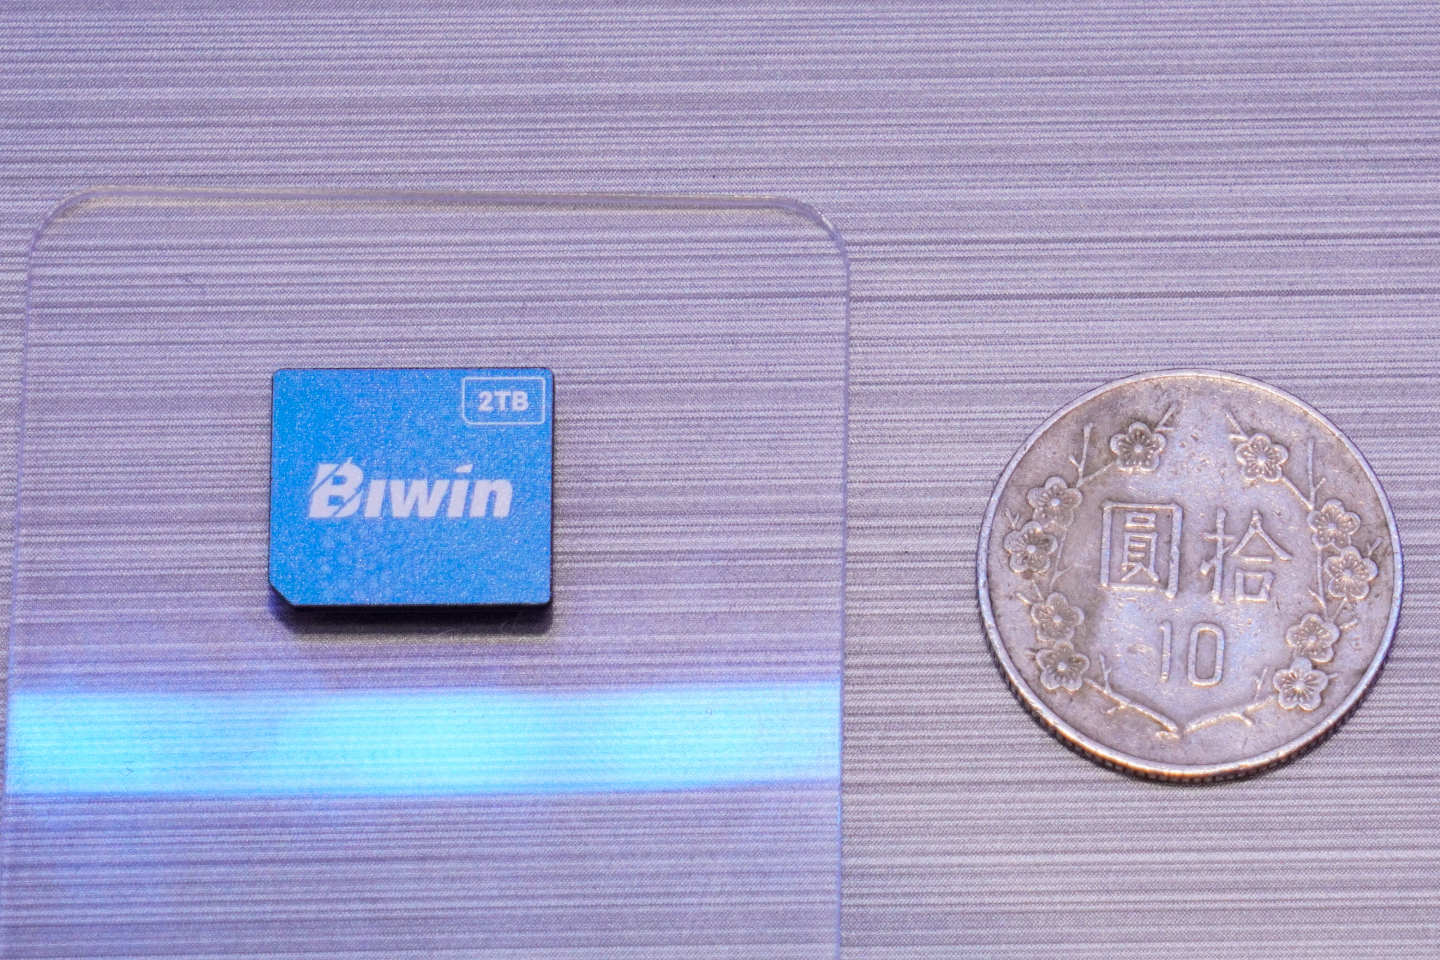
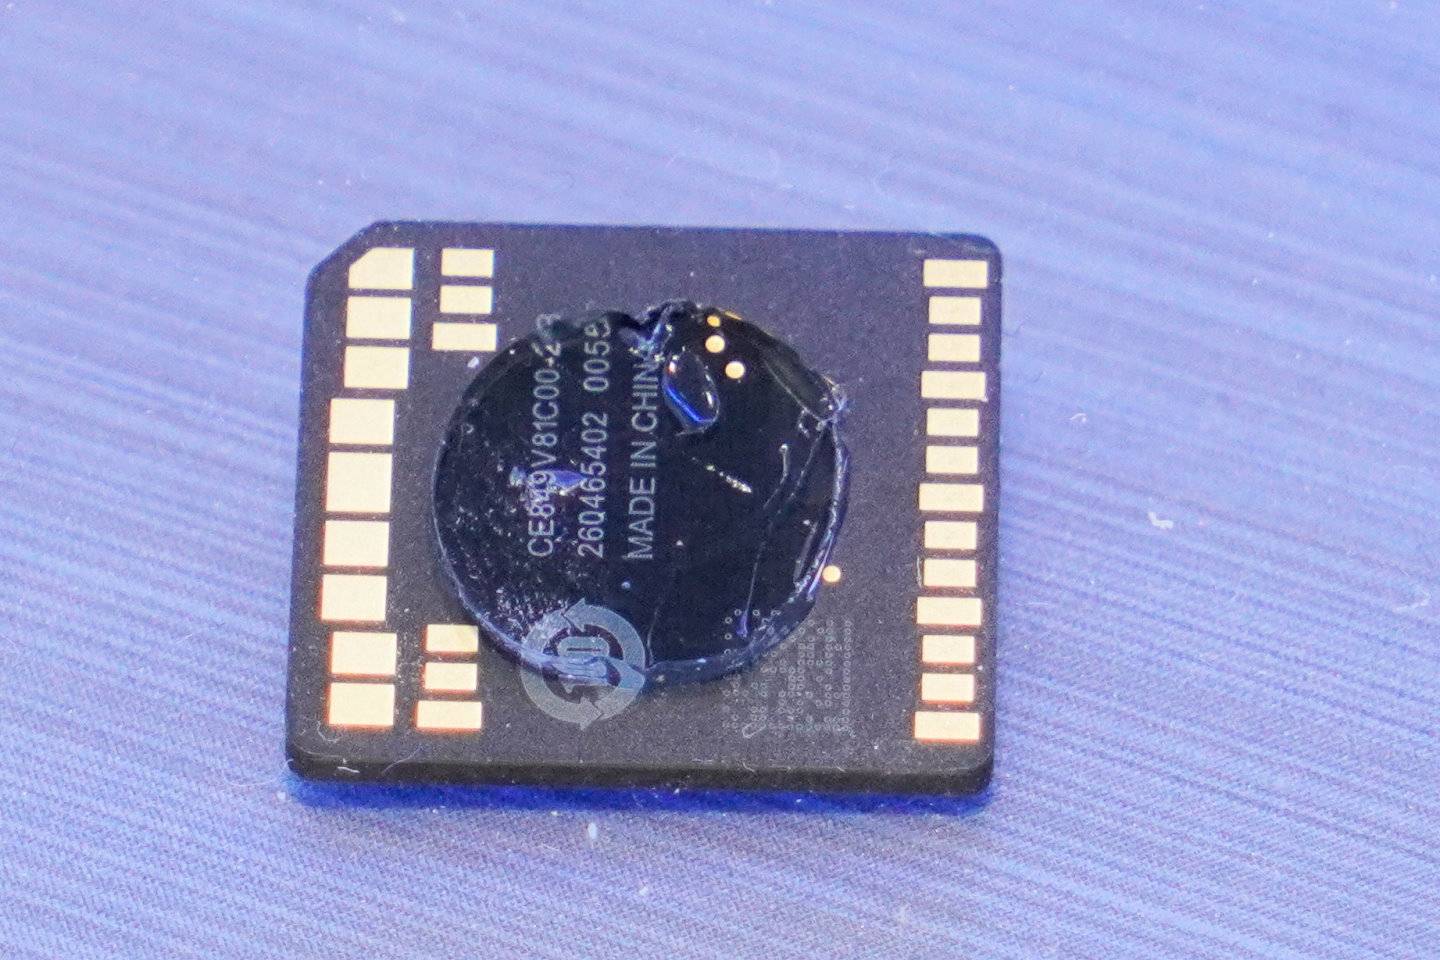
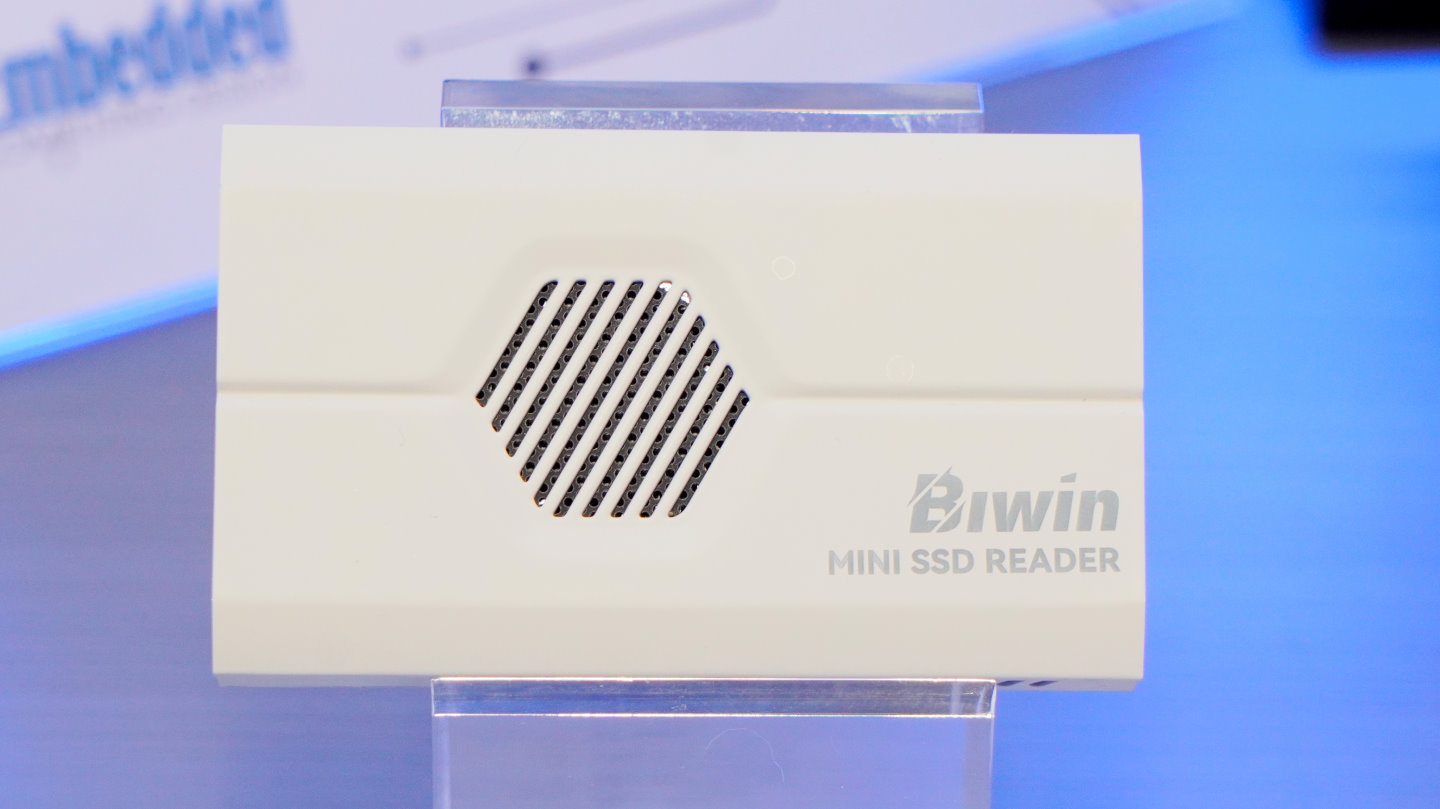
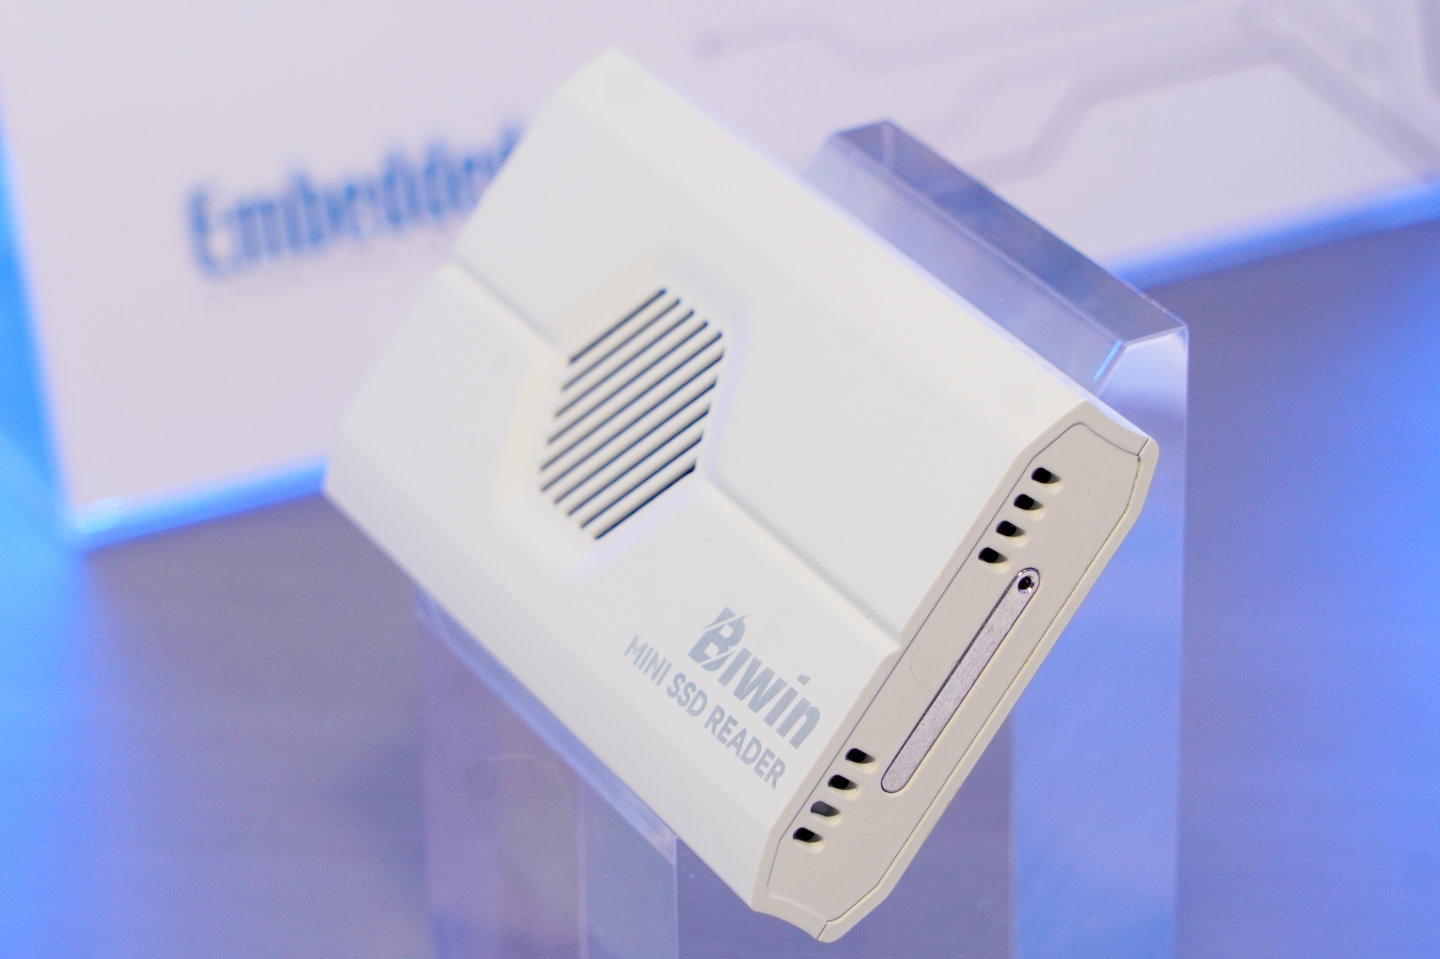
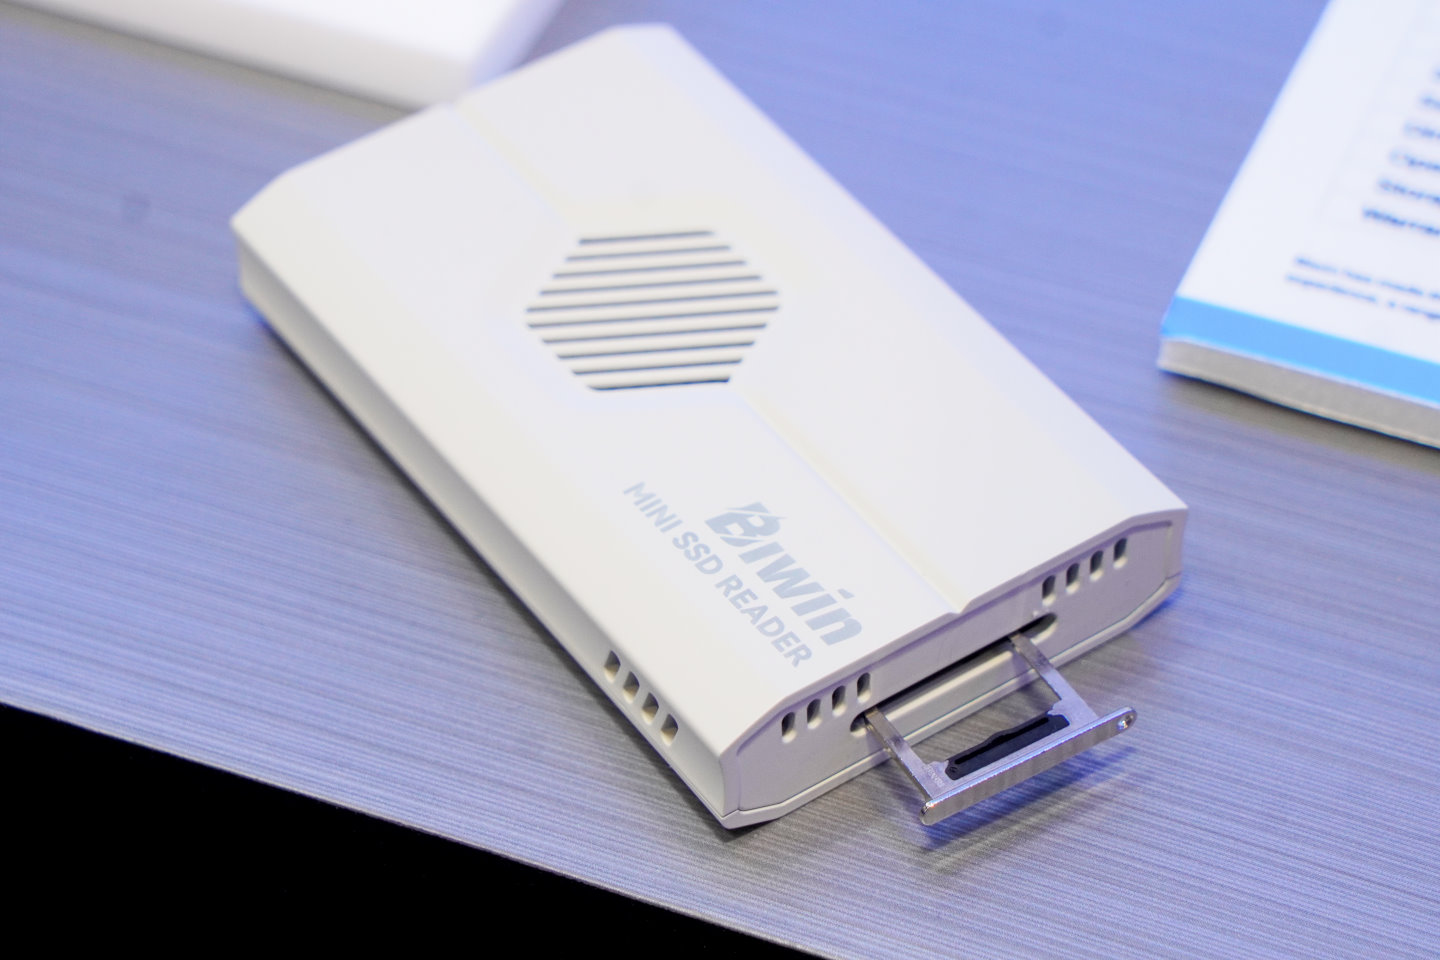
推出的Mini SSD的尺寸為15 x 17 x 1.4 mm,大約與microSD記憶卡接近,它採用Hybrid BGA封裝,安裝方式採用與實體SIM將同的「卡槽式」設計,支援PCIe Gen 4x2匯流排與NVMe 1.4通訊協定,基本上可以視為將常見的M.2 2280尺寸固態硬碟縮小至microSD記憶卡的尺寸,並可提供接近4000 MB/s的理論頻寬。
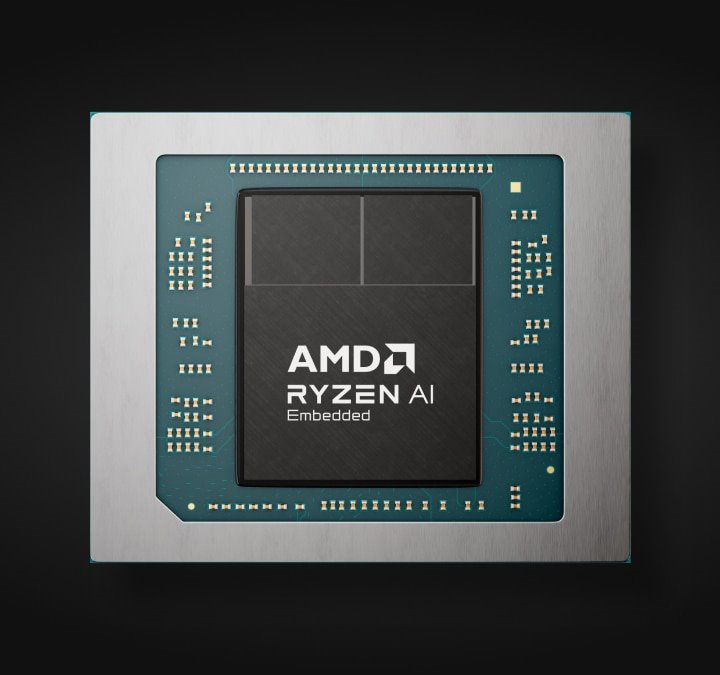
Ryzen AI Embedded X100系列處理器的基本規格與Ryzen AI Max系列處理器接近,以最高規格的Ryzen AI Embedded X199為例,它具有16組最高Turbo時脈達5.1 GHz的Zen 5架構處理器核心(即CPU),支援SMT(Simultaneous Multithreading,同時多執行緒)以達到16核32緒的組態,搭配40組運算單元(CUs)的RDNA 3.5架構內建顯示晶片(即GPU,可加速AI運算),以及AI運算效能達到50 TOPS的Ryzen AI NPU(神經處理器)。
Ryzen AI Embedded X199的標準TDP為55 W,可調整TDP(cTDP)的範圍介於45 ~ 120 W之間,可依使用需求與散熱條件進行調整,其運作溫度範圍為攝氏0 ~ 105度。此外AMD也推出工業用寬溫版Ryzen AI Embedded X199i,將運作溫度範圍放寬至攝氏-40 ~ 105度,並支援在嚴苛環境中7 x 24全天候運作長達10年。
根據AMD提供的數據,Ryzen AI Embedded X100系列處理器與競爭對手NVIDIA Jetson Thor T5000相比,可提供高達3倍的峰值FP32資料類型AI運算效能,在先進醫療超音波波束成形等工作負載中,平均效能甚至達到NVIDIA RTX 4000 Ada等運算卡的1.7倍。
Ryzen AI Embedded X100系列處理器支援開放的軟體堆疊,包涵Linux作業系統、ROCm AI運算軟體堆疊、Xen Hypervisor虛擬化,以及PyTorch、ONNX與TensorFlow等AI框架,讓開發人員能在熟悉的設計環境中快速開發,並可搭配工具將現有程式從CUDA移植至ROCm,以獲得極高的效能與彈性。
整合式平台加速開發
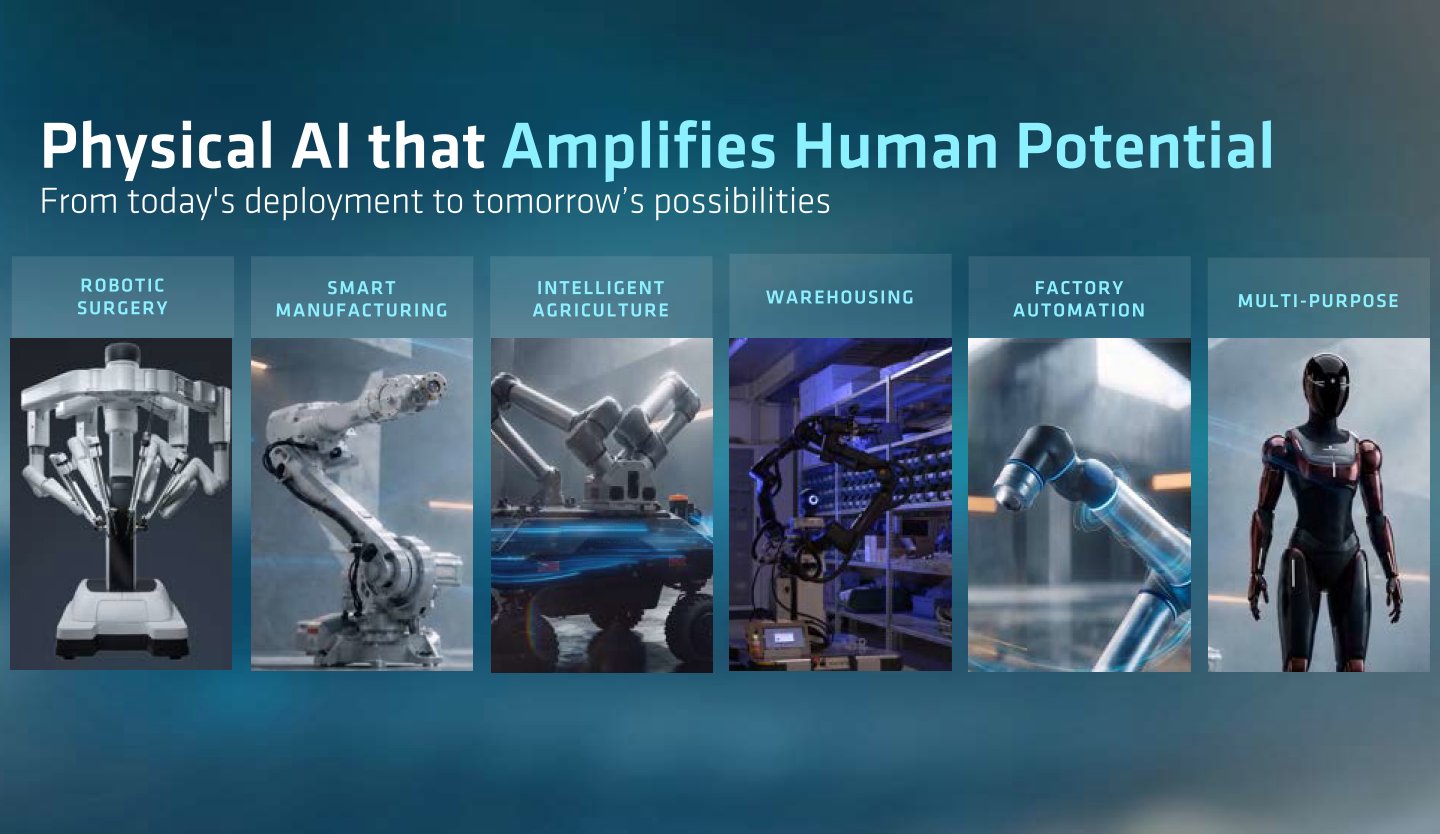
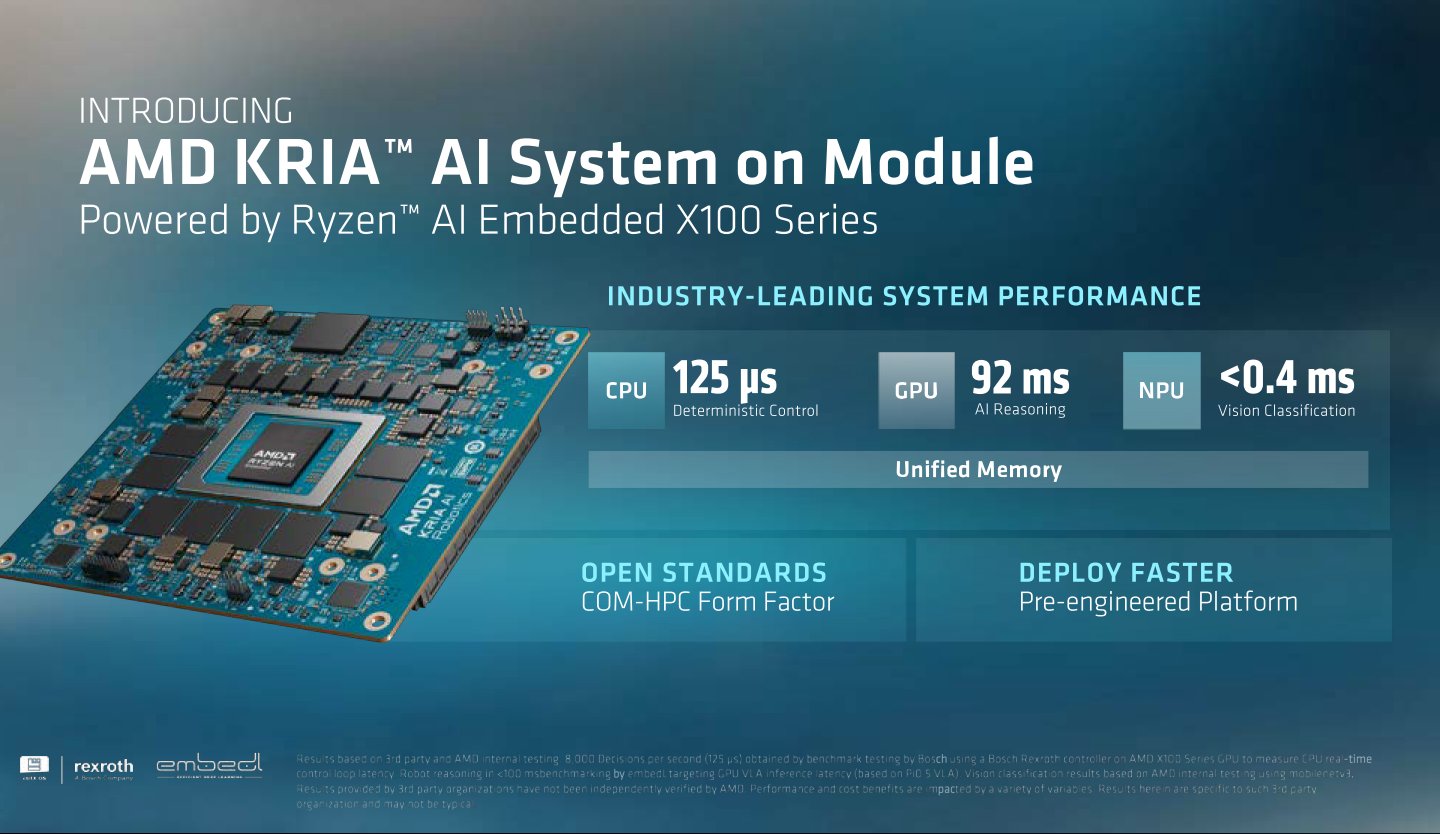
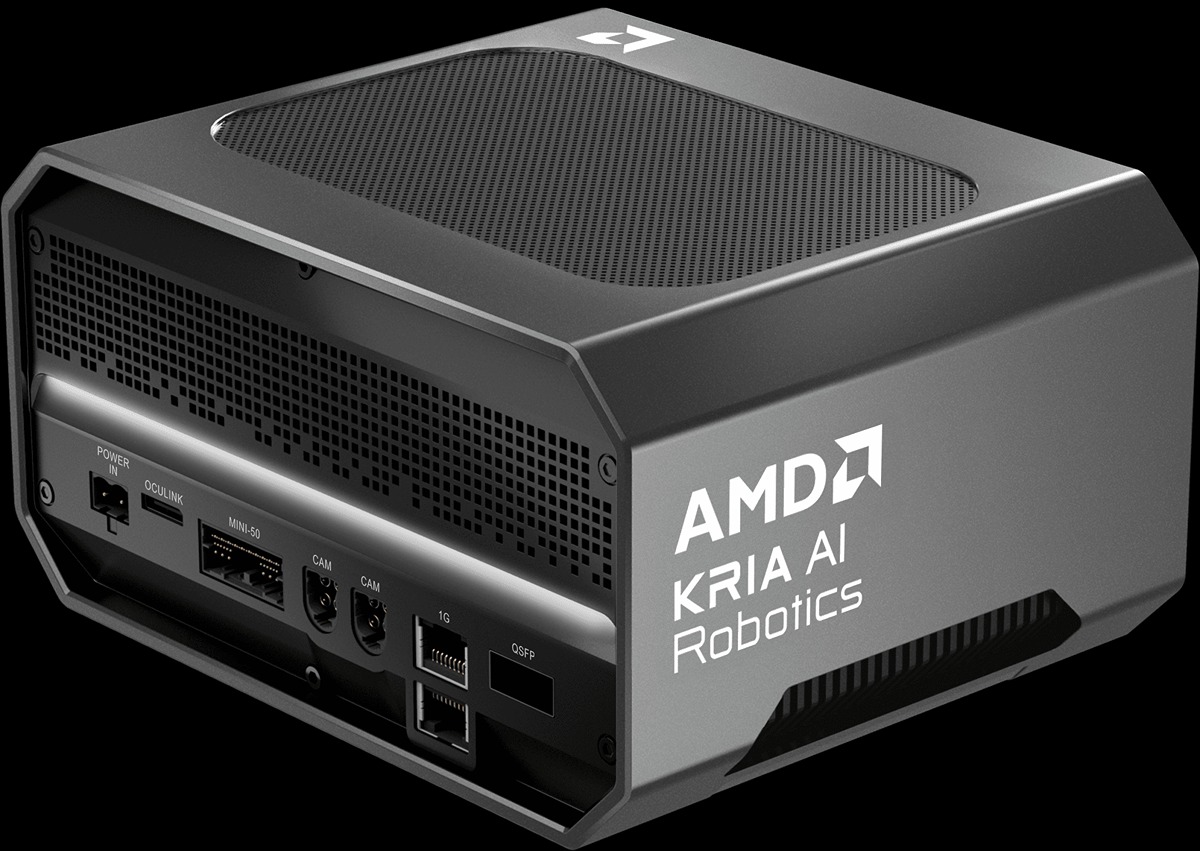
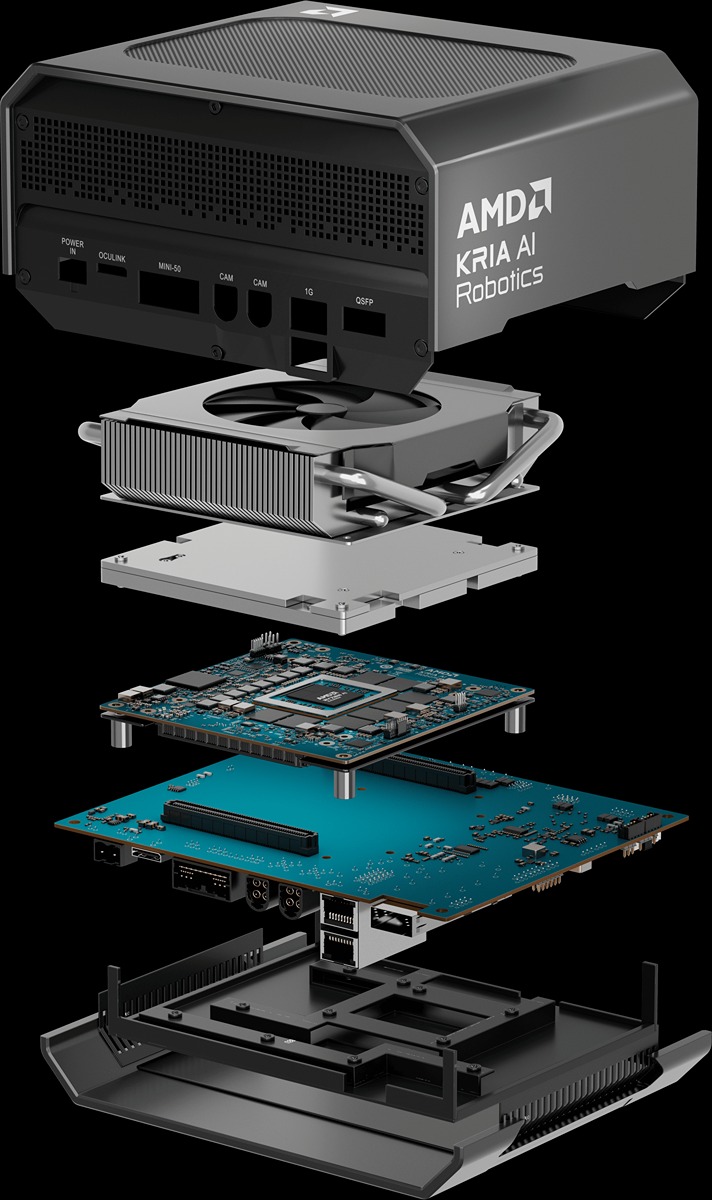
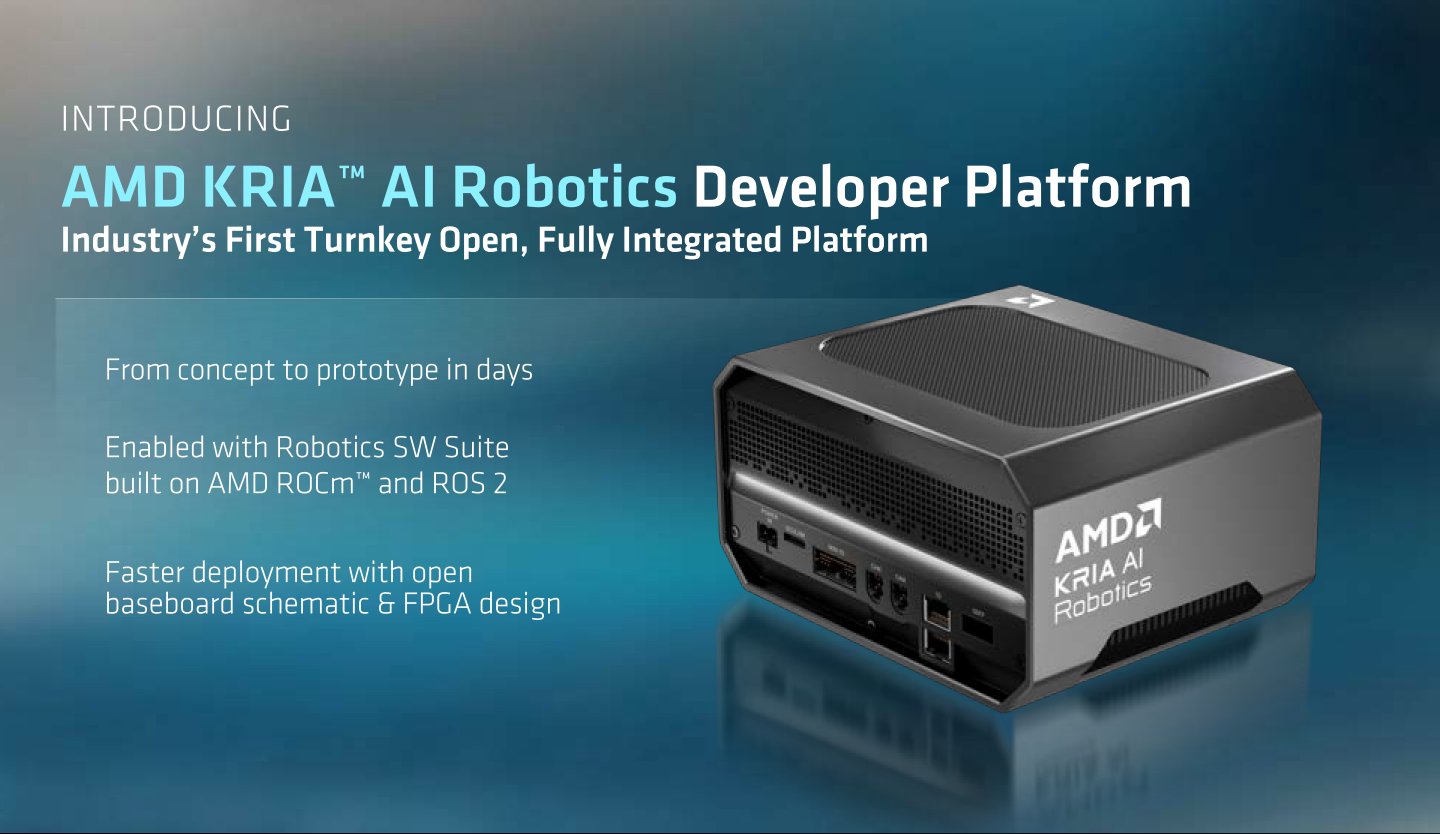
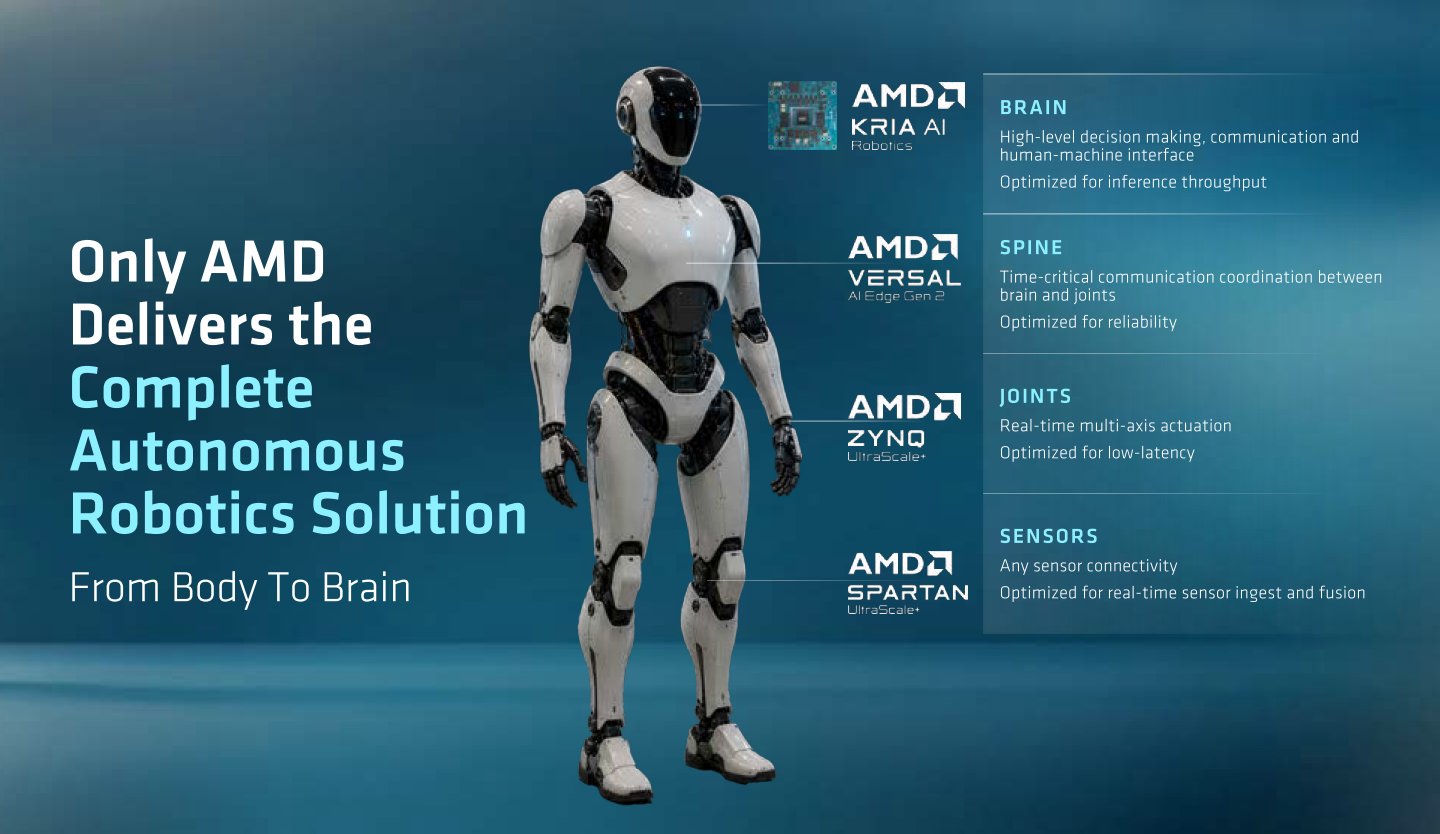
為了協助開發人員加速機器人智慧自主系統所需的AI感知、推論、即時決策、控制能力,AMD也推出搭載Ryzen AI Embedded X100系列處理器的Kria AI SoM(System on Module,系統化模組),提供CPU、GPU、NPU等多種運算單元,統一記憶體架構也有助於減少跨運算運算單元的資料傳輸,並最大化記憶體資源利用率,以差異化的運算能力與特性供低延遲且確定性的效能表現。
Kria AI SOM採用開放標準的COM-HPC尺寸規格,在CPU、GPU、NPU的協同運作下,能夠提供即時決策與控制、AI推論以及平行化運算的的機器人工作負載運算需求,每秒可做出超過8,000次控制決策,達到小於100 ms的VLA(Vision-Language-Action,視覺-語言-行動)AI推理,提供確定性的即時控制能力。
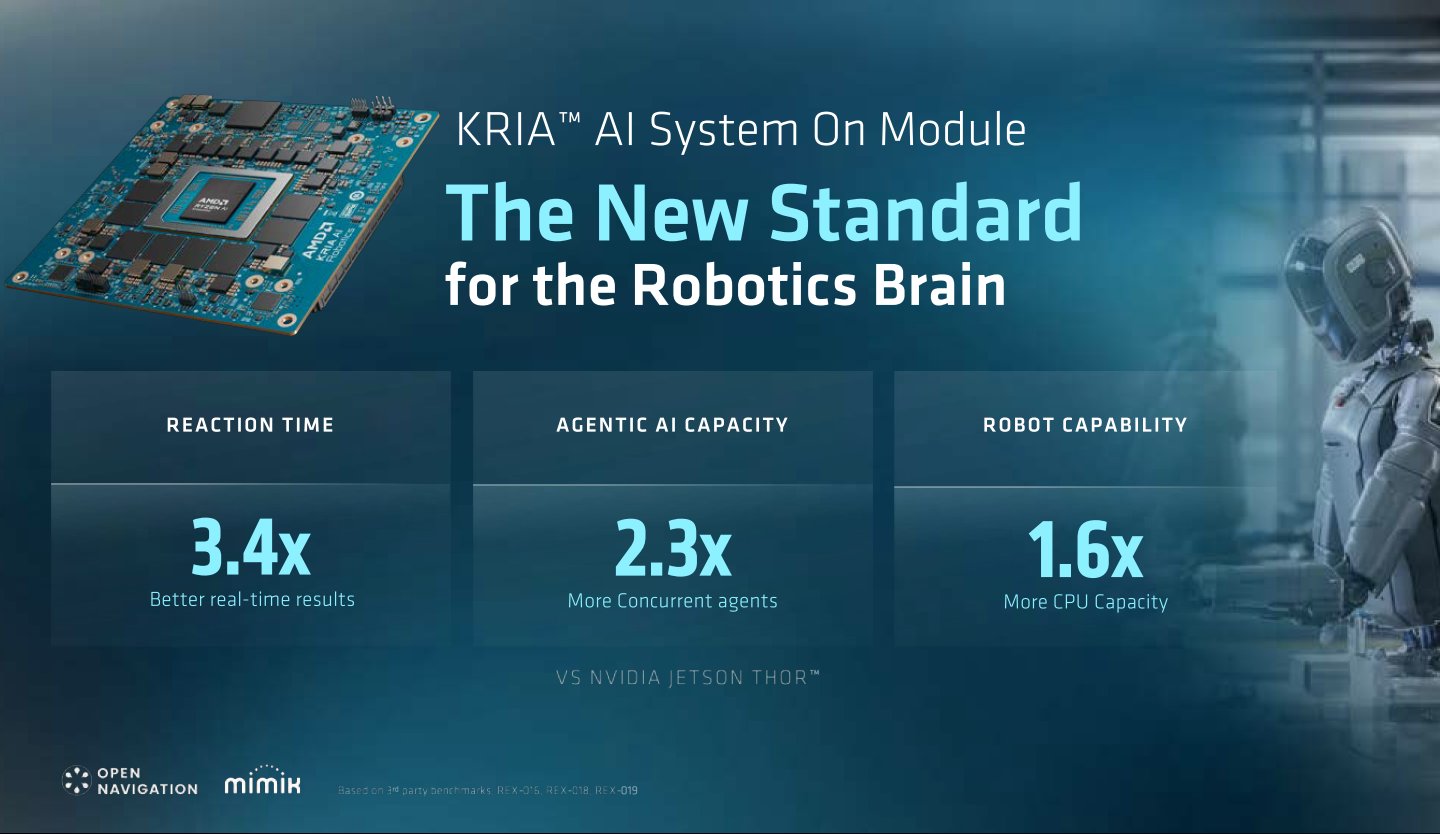
根據AMD提供的數據,與NVIDIA Jetson Thor T5000相比,Kria AI SOM的反應時間改善3.4倍,可執行的AI代理數量達到2.3倍,冗餘CPU核心數(備用運算能力)增加達1.6倍。
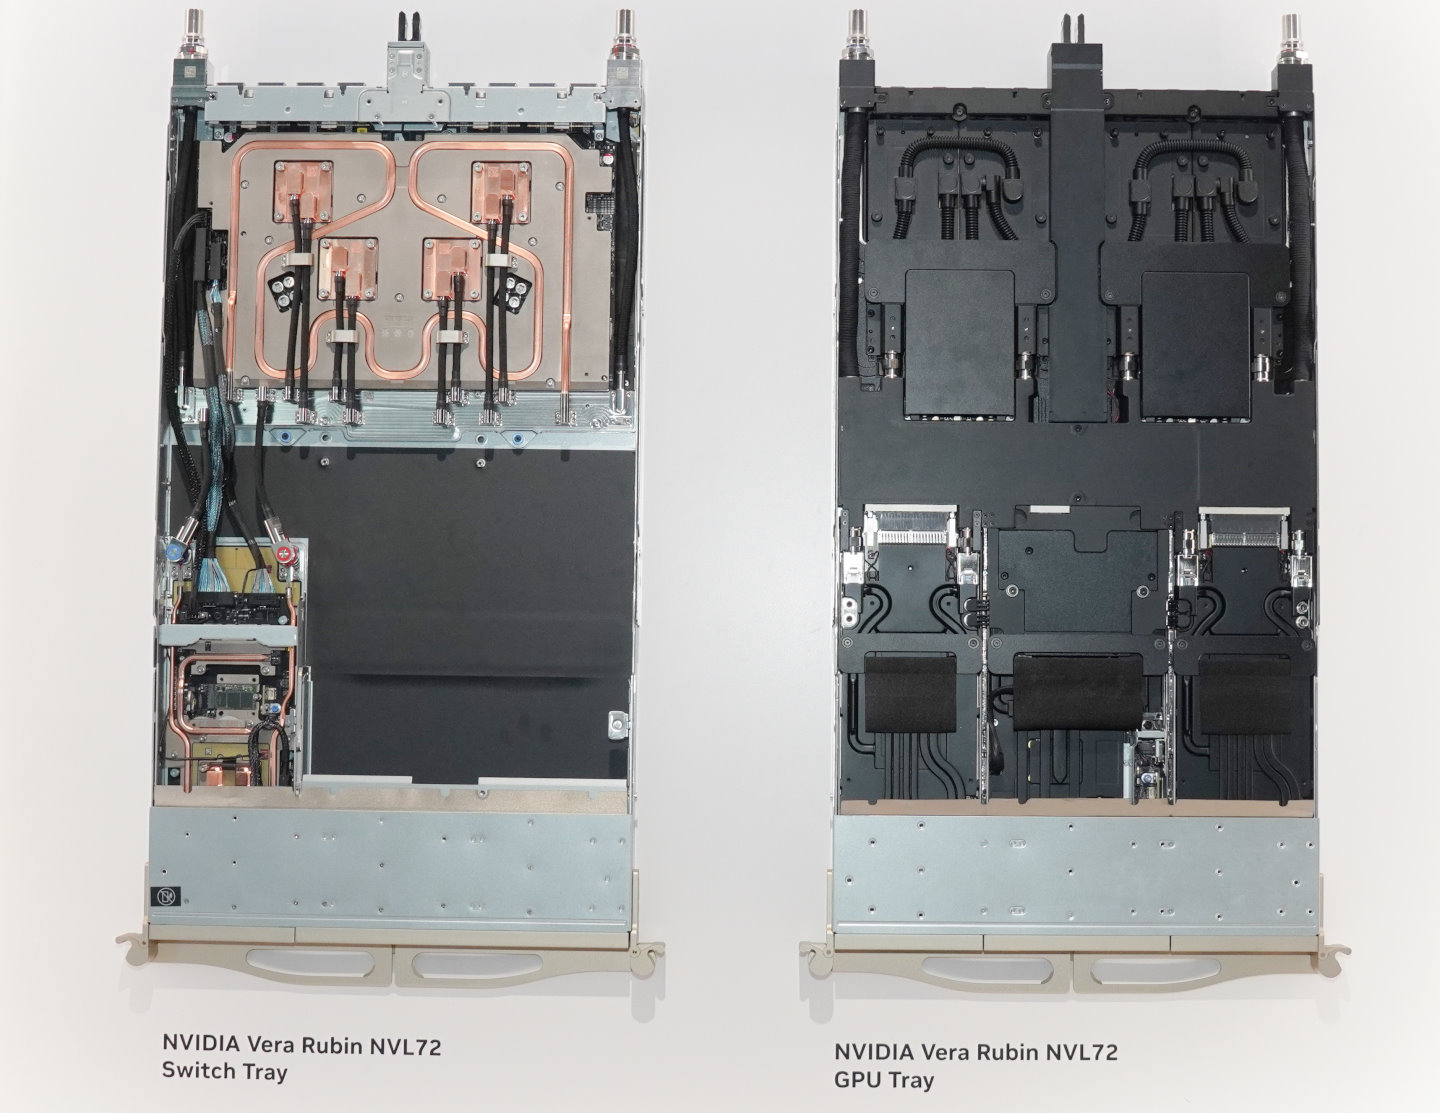
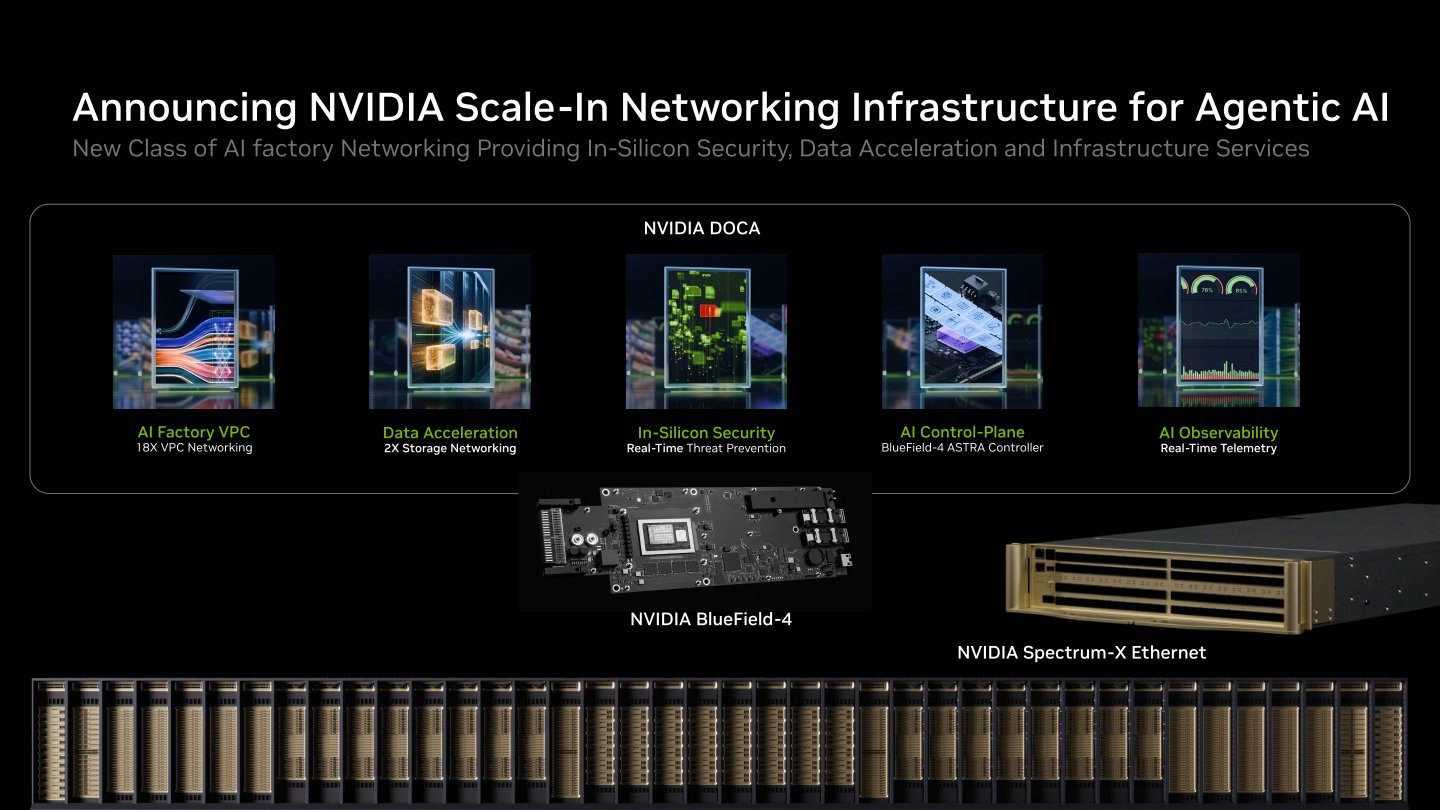
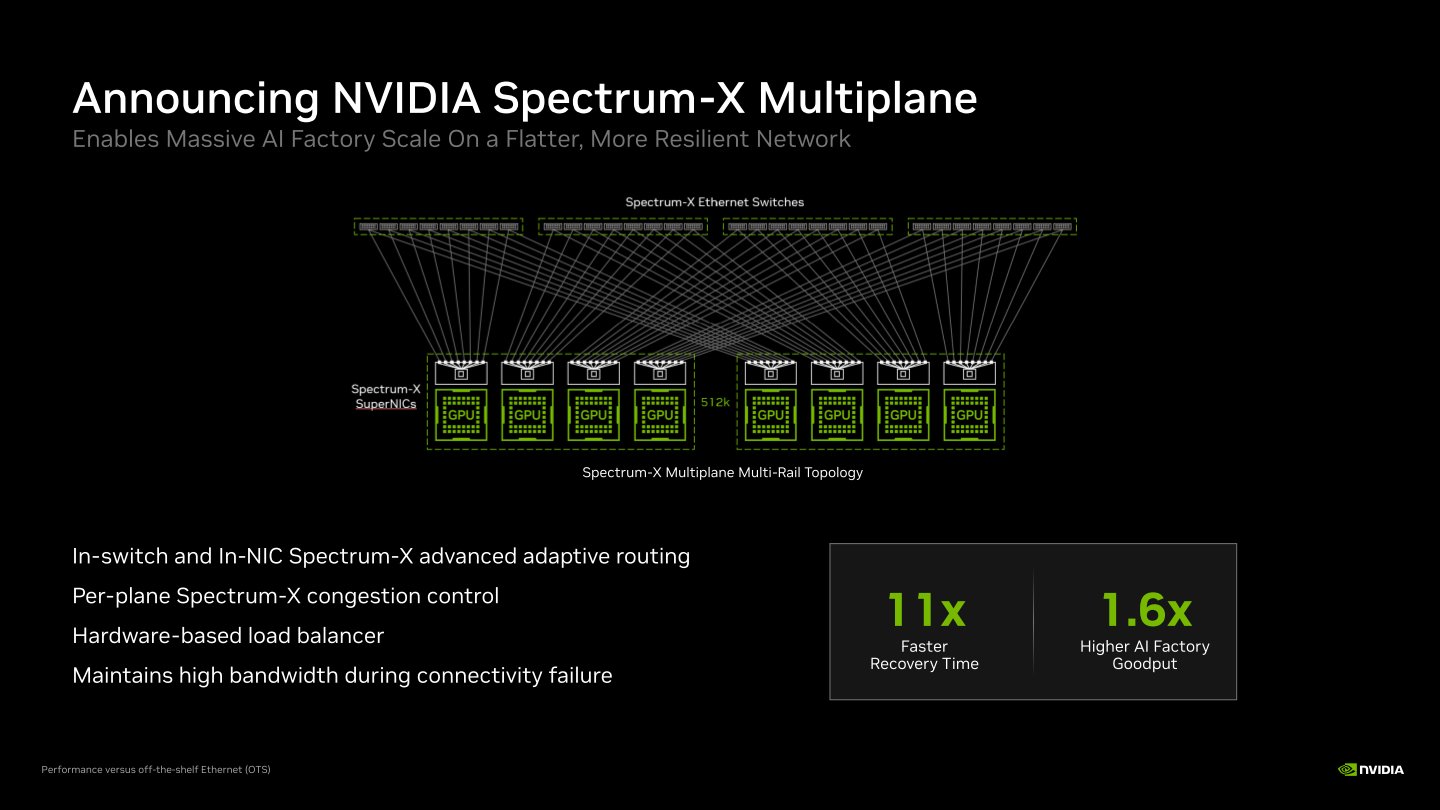
Vera Rubin 平台的整體設計的Spectrum-6交換器晶片與ConnectX-9 SuperNIC網路卡共同構成新一代Spectrum-X乙太網路,其中Spectrum-6支援可插拔式光學元件與共同封裝光學元件,Spectrum-6對應的產品也支援液冷散熱方案,藉由改善散熱的方式,提高AI資料中心的網路電力效率。
 登录