阅读视图

发现新文章,点击刷新页面。
✇T客邦-Techbang

【Arm Tech Day 2026】G2-Ultra NX GPU搭配多種神經繪圖升頻技術,在2 W功耗條件下帶來電腦級遊戲體驗

Arm隨CSS for Mobile 2運算子系統推出全新G2-Ultra NX GPU,帶來更強的繪圖與AI運算效能,並透過多種神經繪圖升頻技術提升遊戲的畫質與流暢度表現。088a12ff5d3e7ed0117b4b054121a10a

Arm隨CSS for Mobile 2運算子系統推出全新G2-Ultra NX GPU,帶來更強的繪圖與AI運算效能,並透過多種神經繪圖升頻技術提升遊戲的畫質與流暢度表現。

AI升頻讓遊戲更流暢

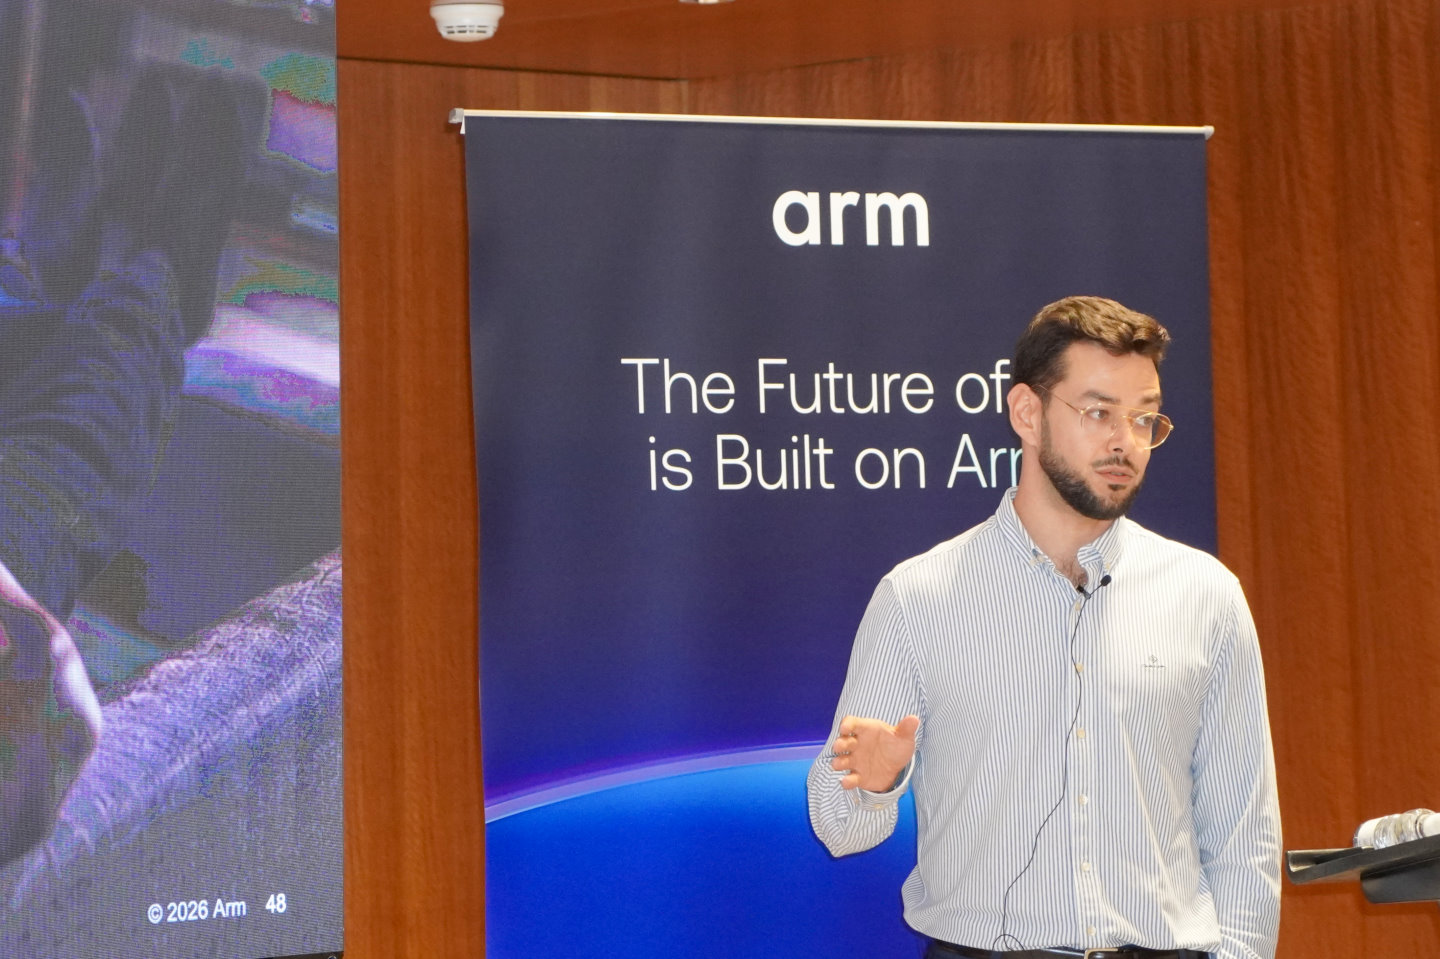
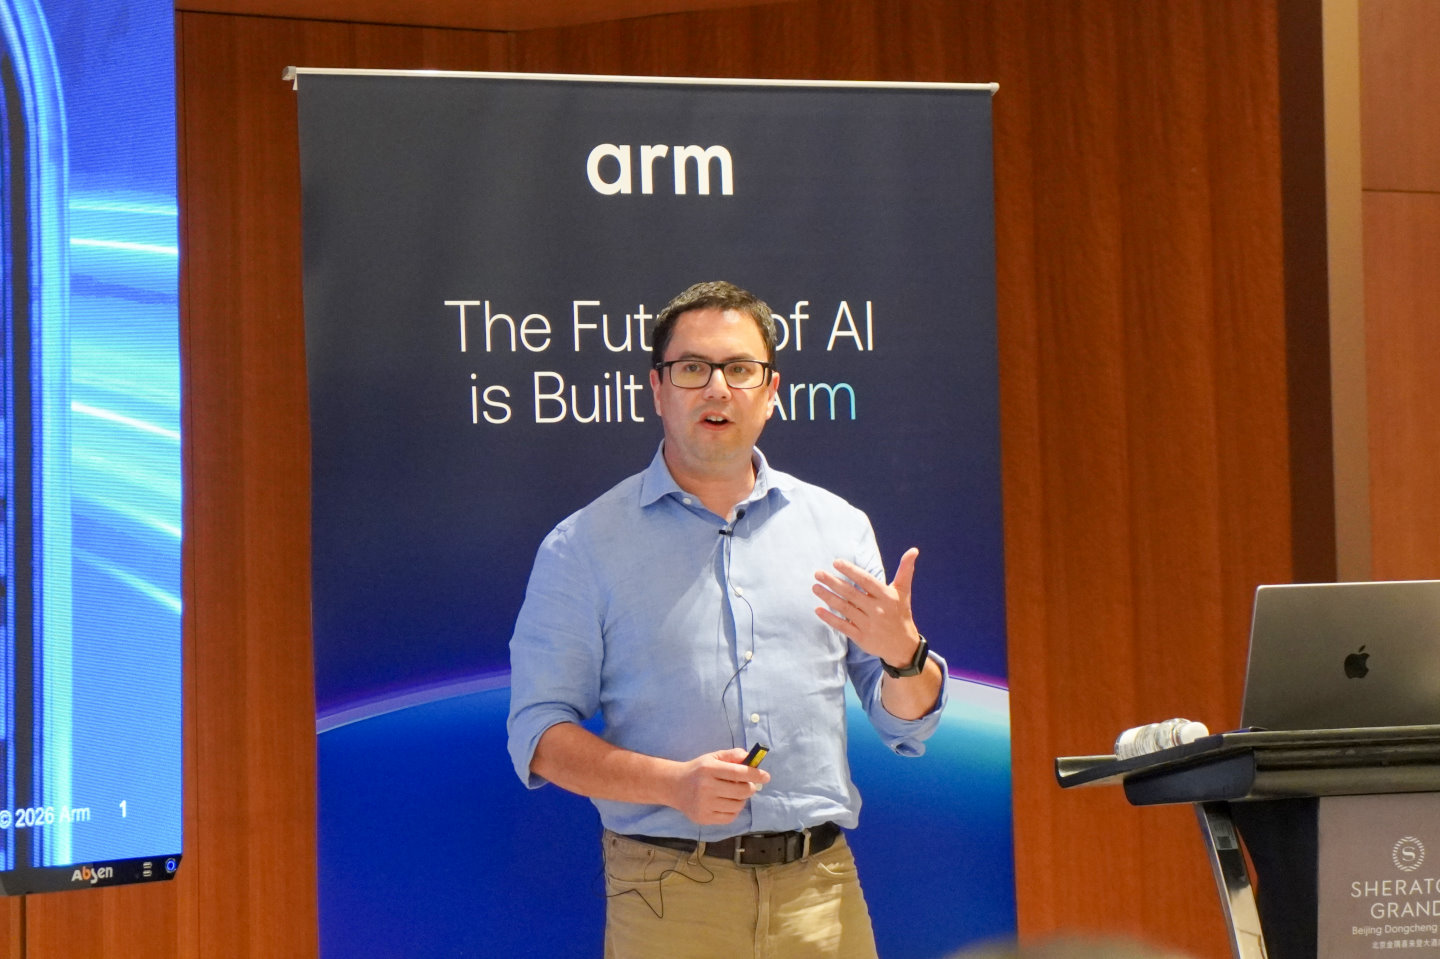
Arm於北京舉辦的Arm Tech Day 2026說明會中,由邊緣AI資深產品經理Deyan Lazarov介紹全新G2-Ultra NX GPU的特色,以及NSS、NFRU、NSSD等透過神經繪圖方式達成的超解析度與畫格生成升頻技術,為行動裝置帶來貼近於桌上型電腦等級的遊戲體驗。

延伸閱讀:
Arm Lumex CSS平台搭配全新C1系列處理器,4種型號隨意混搭最高14核心效能怪獸
Arm發表全新Lumex CSS平台,C1 CPU與Mali G1 GPU為旗艦級手機帶來25%效能增長
Arm發表類神經網路升頻技術,NPU嵌入GPU藉AI提升繪圖效能並節省電力

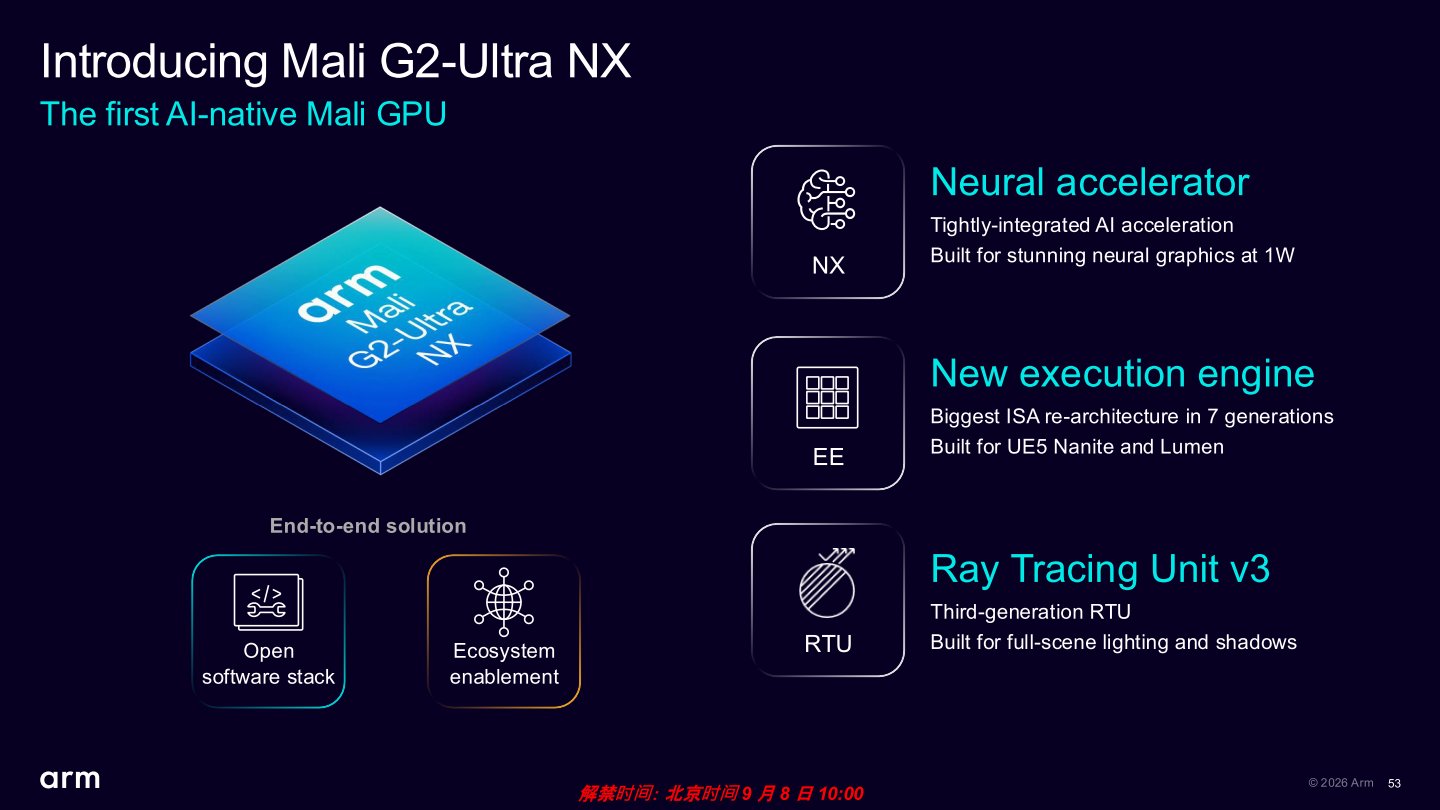
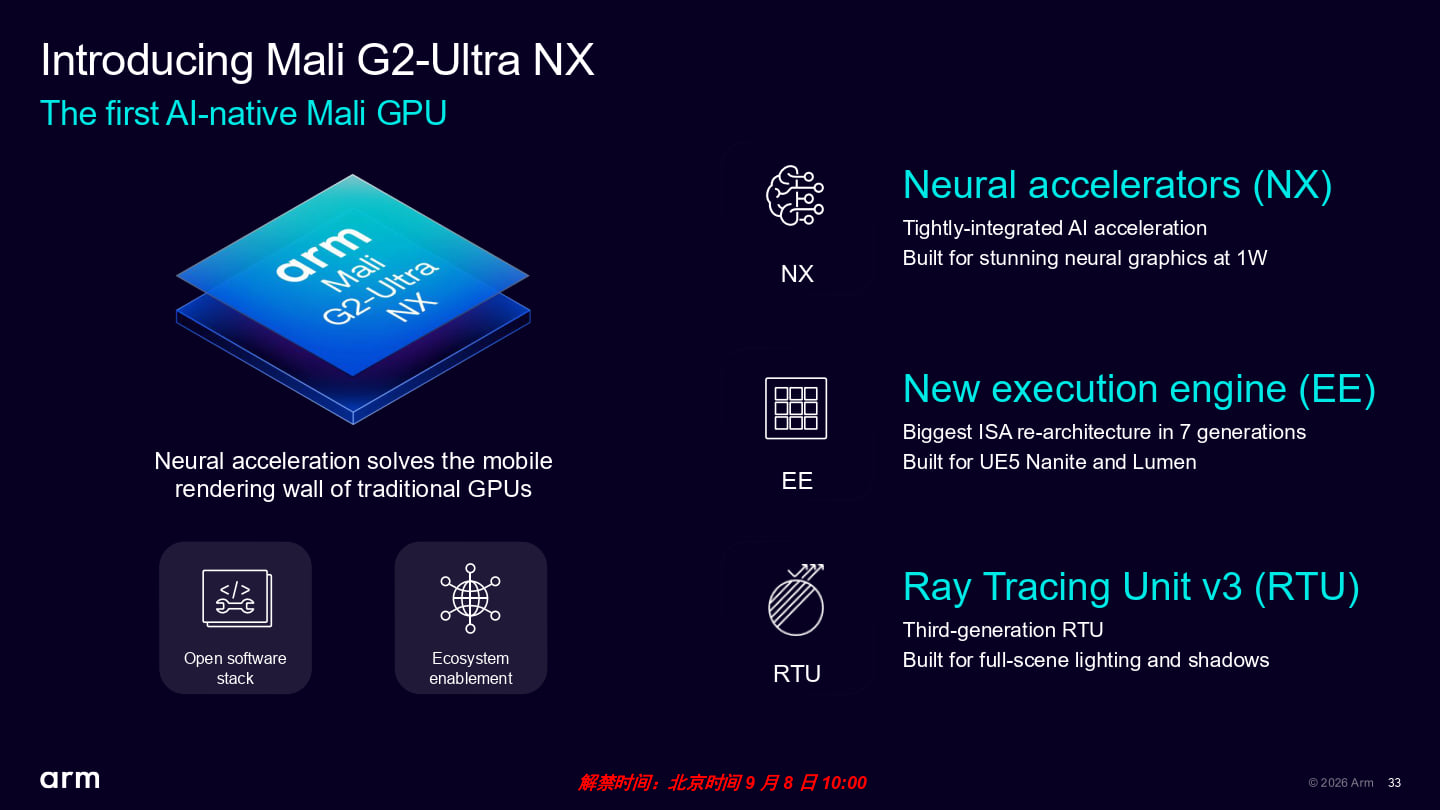
Mali G2-Ultra NX最大的特色就是在設計之初就導入AI原生繪圖的概念,除了具有效能更高的執行單元負責傳統繪圖工作,也加入第3代光線追蹤單元與神經加速器,強化光線追蹤繪圖以及透過AI進行畫面升頻的效能。

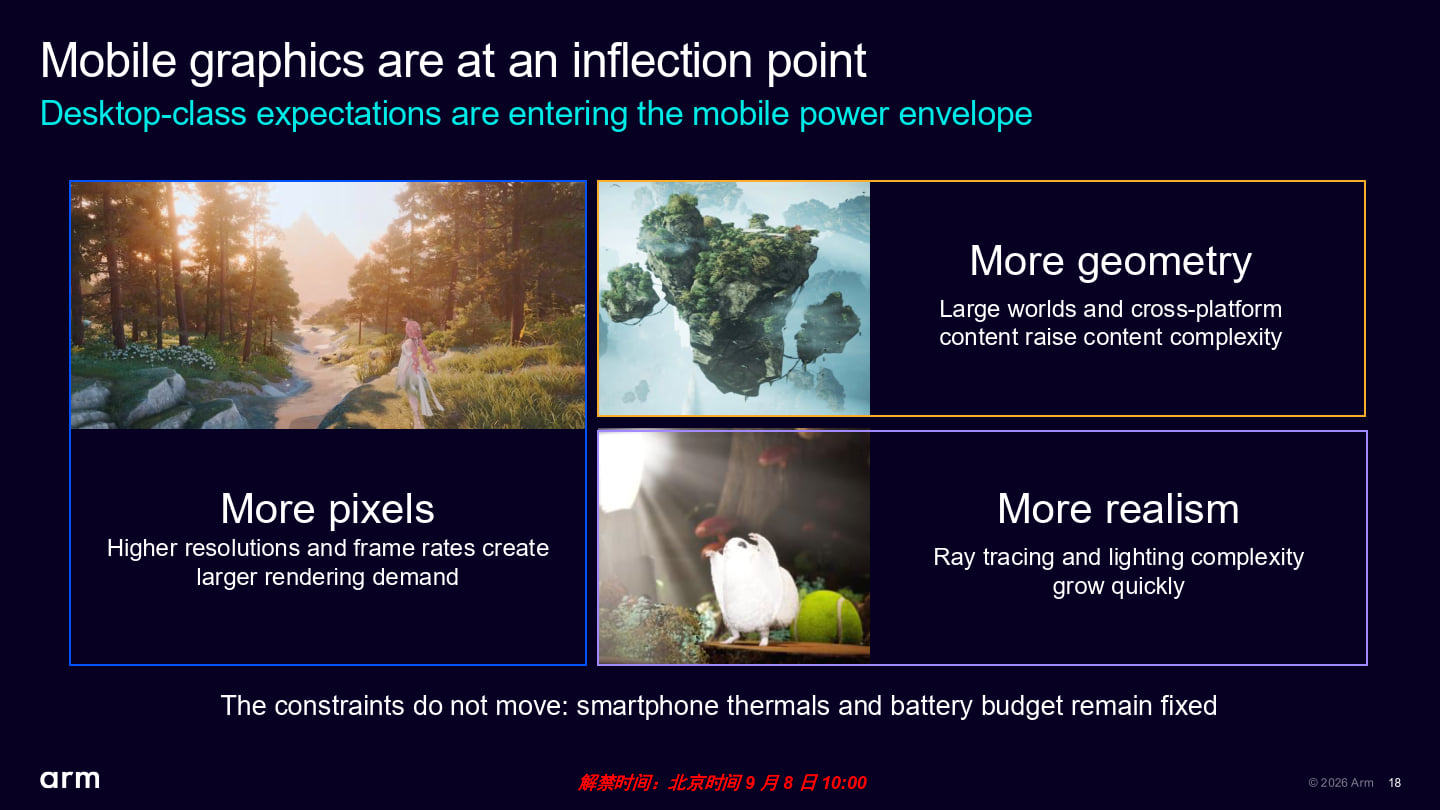
行動裝置受到電池以及散熱條件的限制,許多GPU的功率與散熱預算僅有2 W,而不像桌上型電腦顯示卡的TDP可達575 W以上,因此要如何在有線的電力下繪製遊戲畫面就成了一大挑戰。

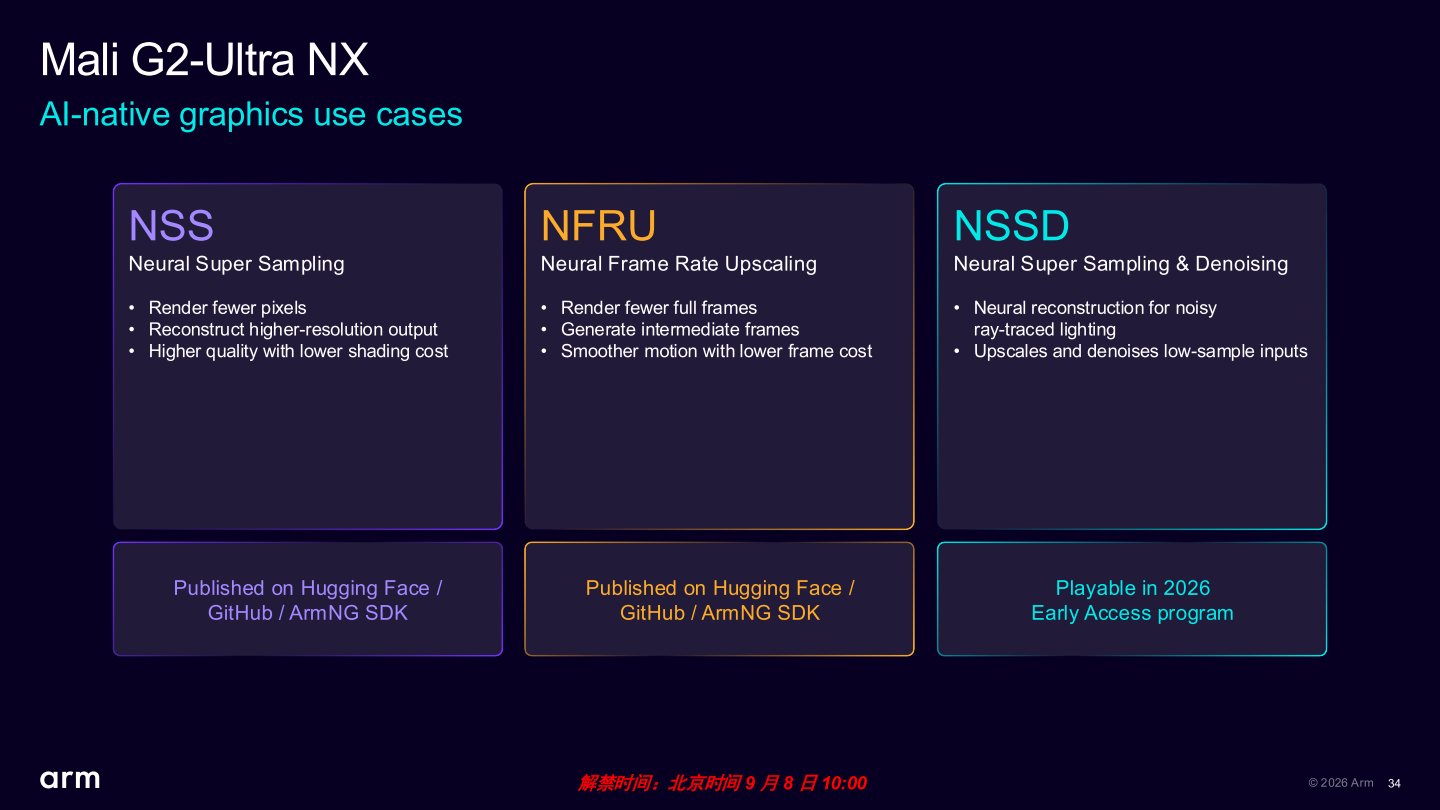
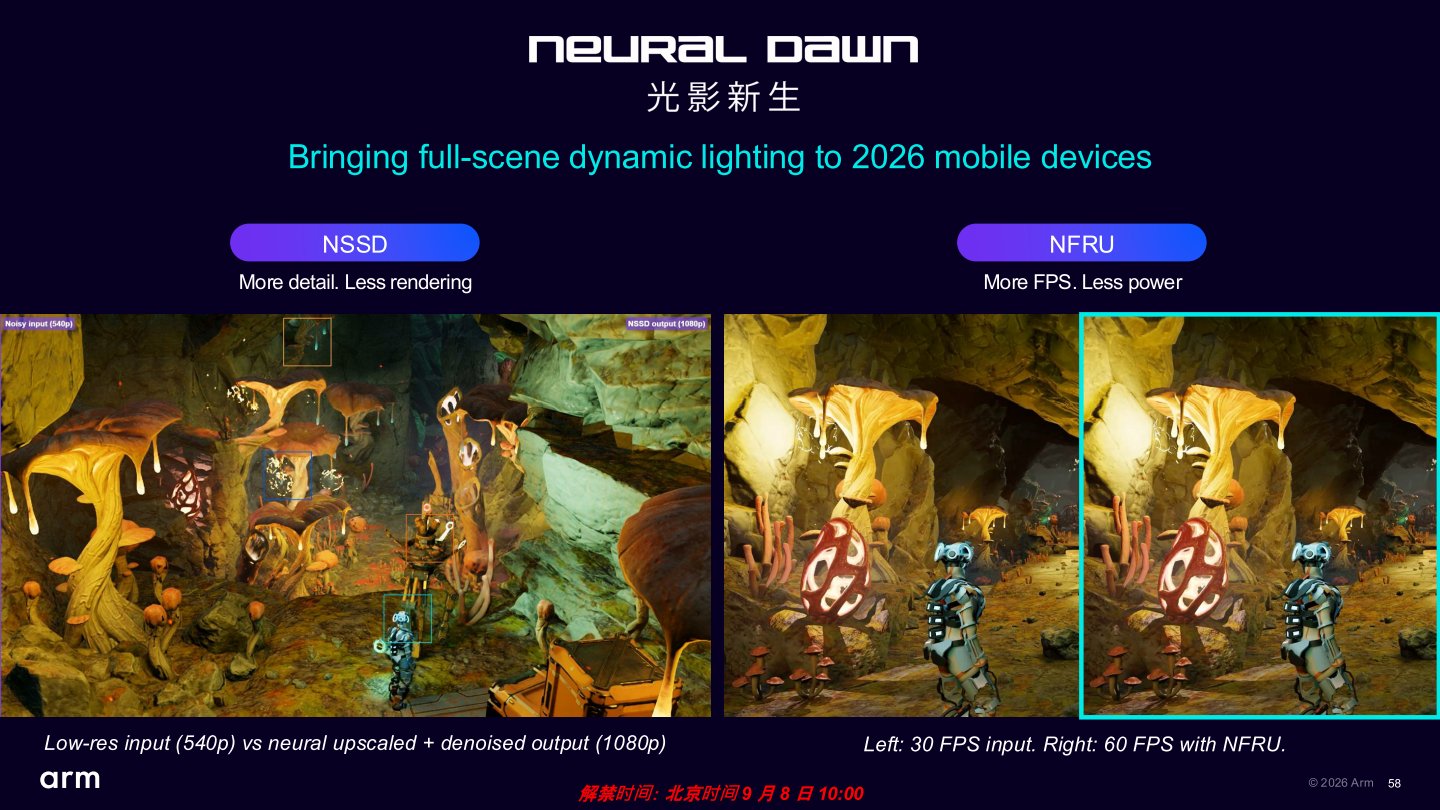
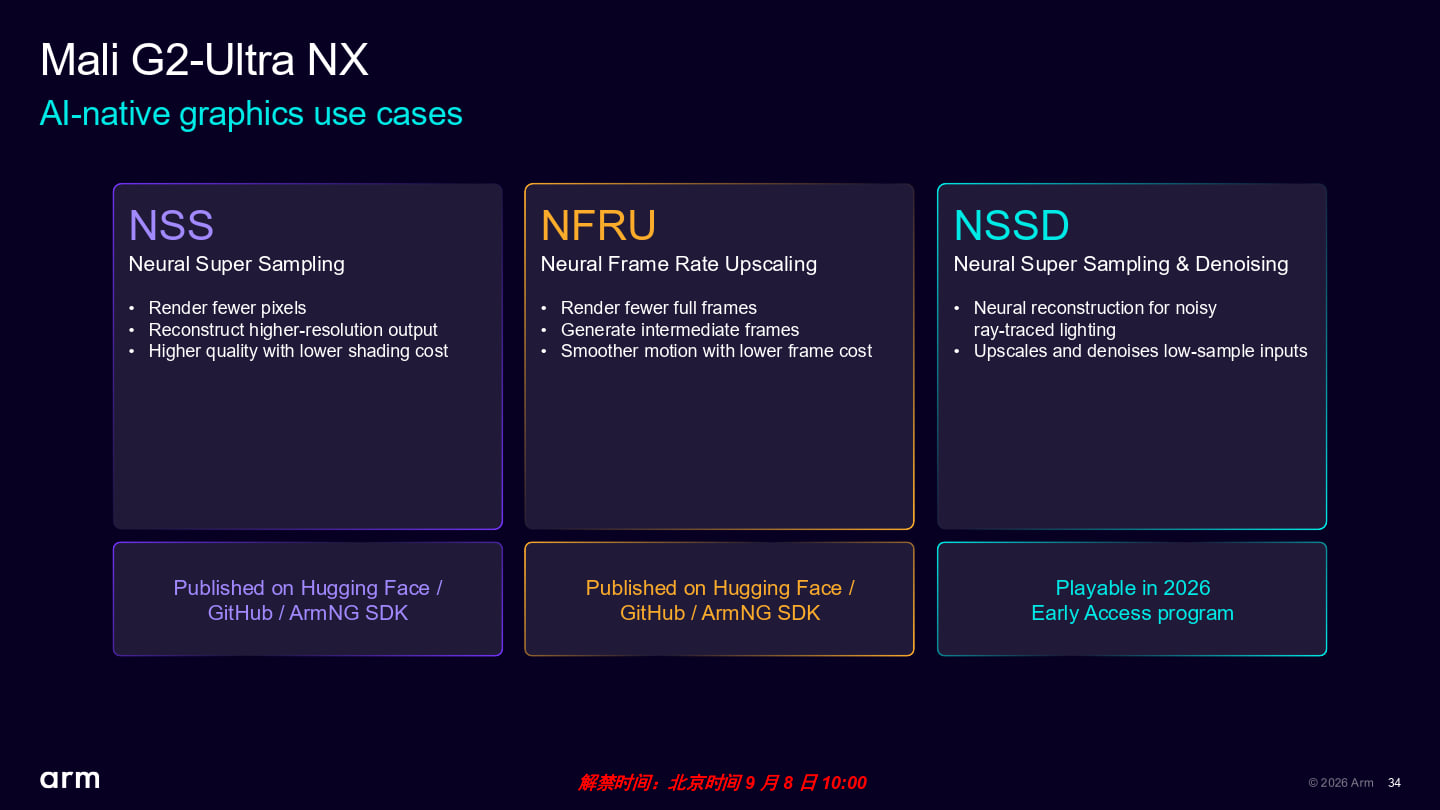
Arm先前推出NSS超解析度(Neural Super Sampling)與NFRU畫格生成(Neural Frame Rate Upscaling)等功能,前者為降低遊戲實際繪製的解析度,並在輸出至螢幕時透過AI演算法提高解析度,功能類似NVIDIA DLSS中的超解析度。後者則是透過AI演算法產生額外1幀生成畫格,對應DLSS的畫格生成等功能,不過目前僅支援2X生成畫格,未來可能會加入3X、4X等更高的生成倍率。

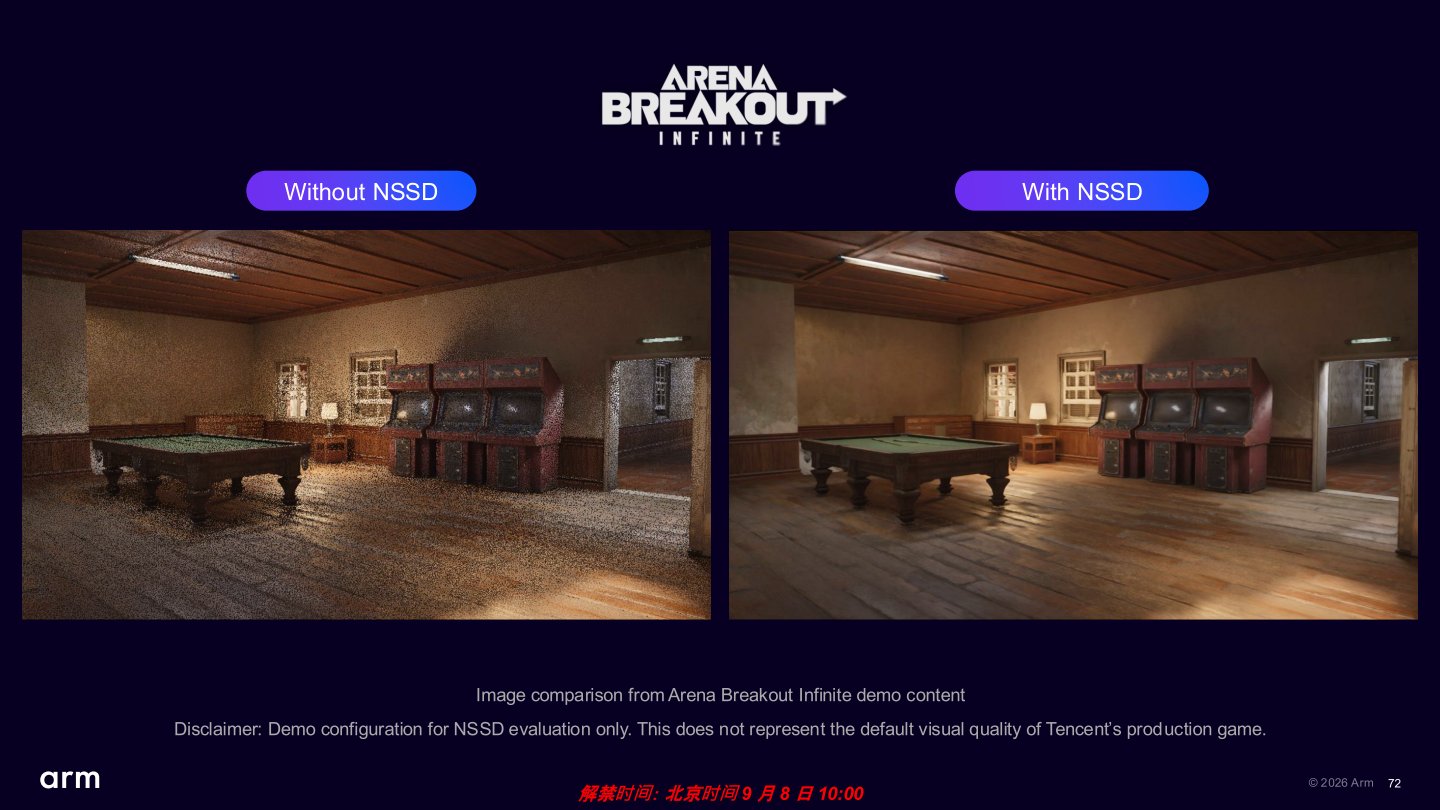
今年推出的NSSD超解析度與降噪(Neural Super Sampling and Denoising)則在NSS的基礎上,結合光線追蹤降噪技術相,能在降低投射光線數量與運算量的同時,維持複雜場景與光照效果的圖像品質,概念類似於DLSS的光線重建。

Arm也於說明會中透過《光影新生》的實際畫面,展示光線追蹤遊戲遊戲的畫質表現,讀者可以在下方影片中親自體驗。

Arm邊緣AI資深產品經理Deyan Lazarov於Arm Tech Day 2026說明會介紹全新G2-Ultra NX GPU的特色。

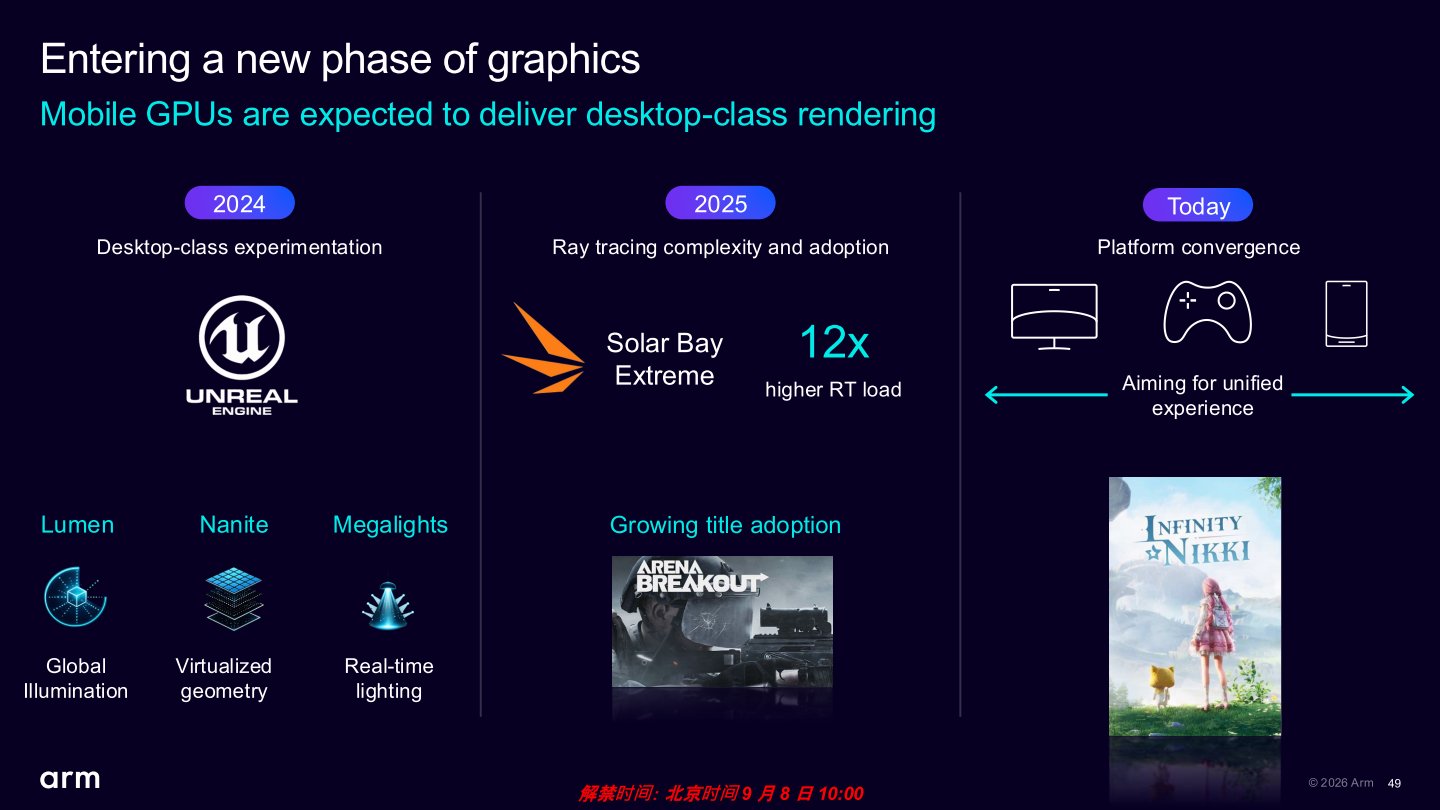
Arm觀察從2024年Unreal遊戲引擎導入Lumen全域照明、Nanite虛擬幾何體、Megalights即時光照等技術,在行動裝置帶來桌上型電腦級遊戲體驗,2025年有越來越多遊戲導入光線追蹤技術,遊戲廠商現今也開始一統電腦、遊戲主機、行動裝置的遊戲體驗。

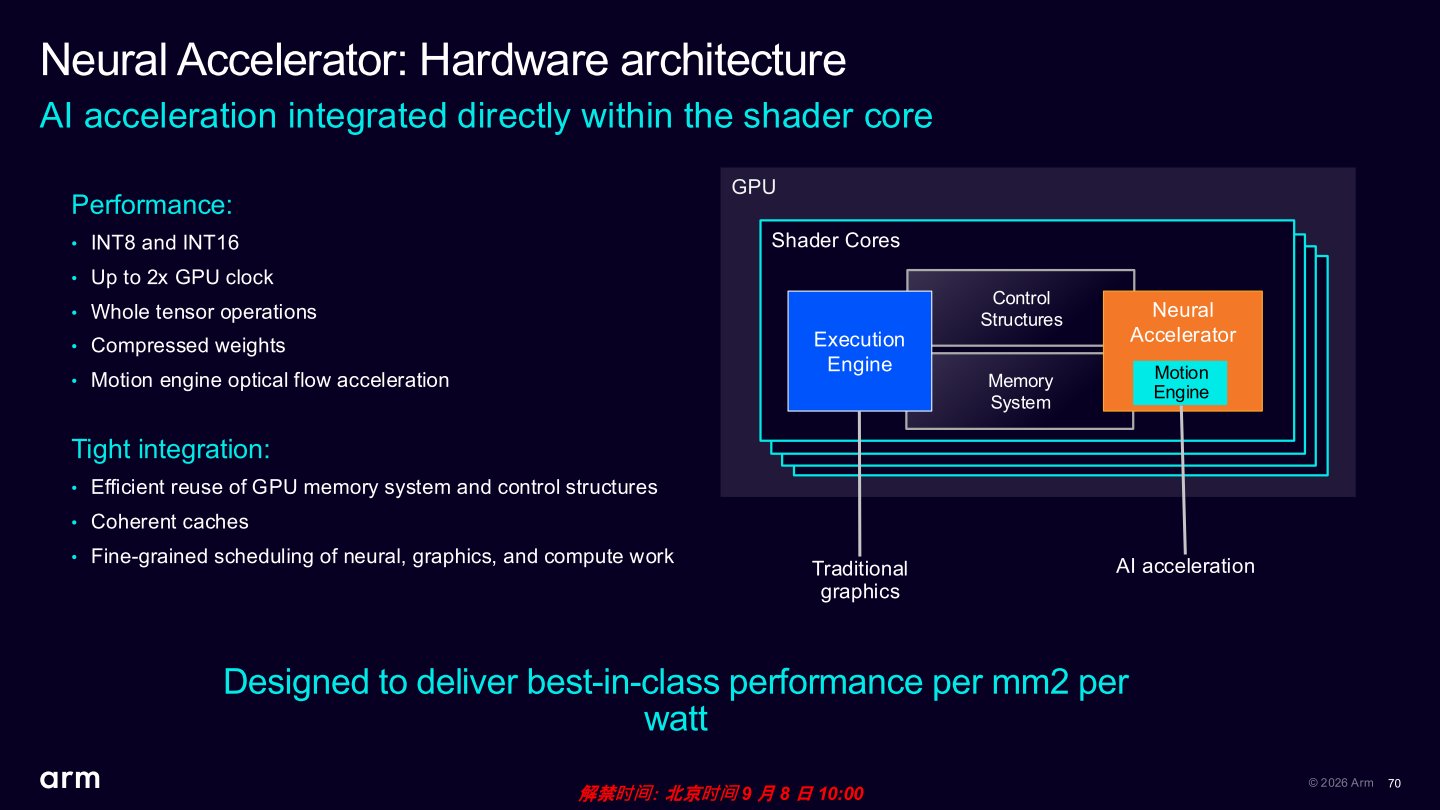
G2-Ultra NX GPU具有全新執行單元、第3代光線追蹤單元、專為在1 W功耗條件下運作的神經加速器,並具有開放的軟體堆疊並賦能生態系。

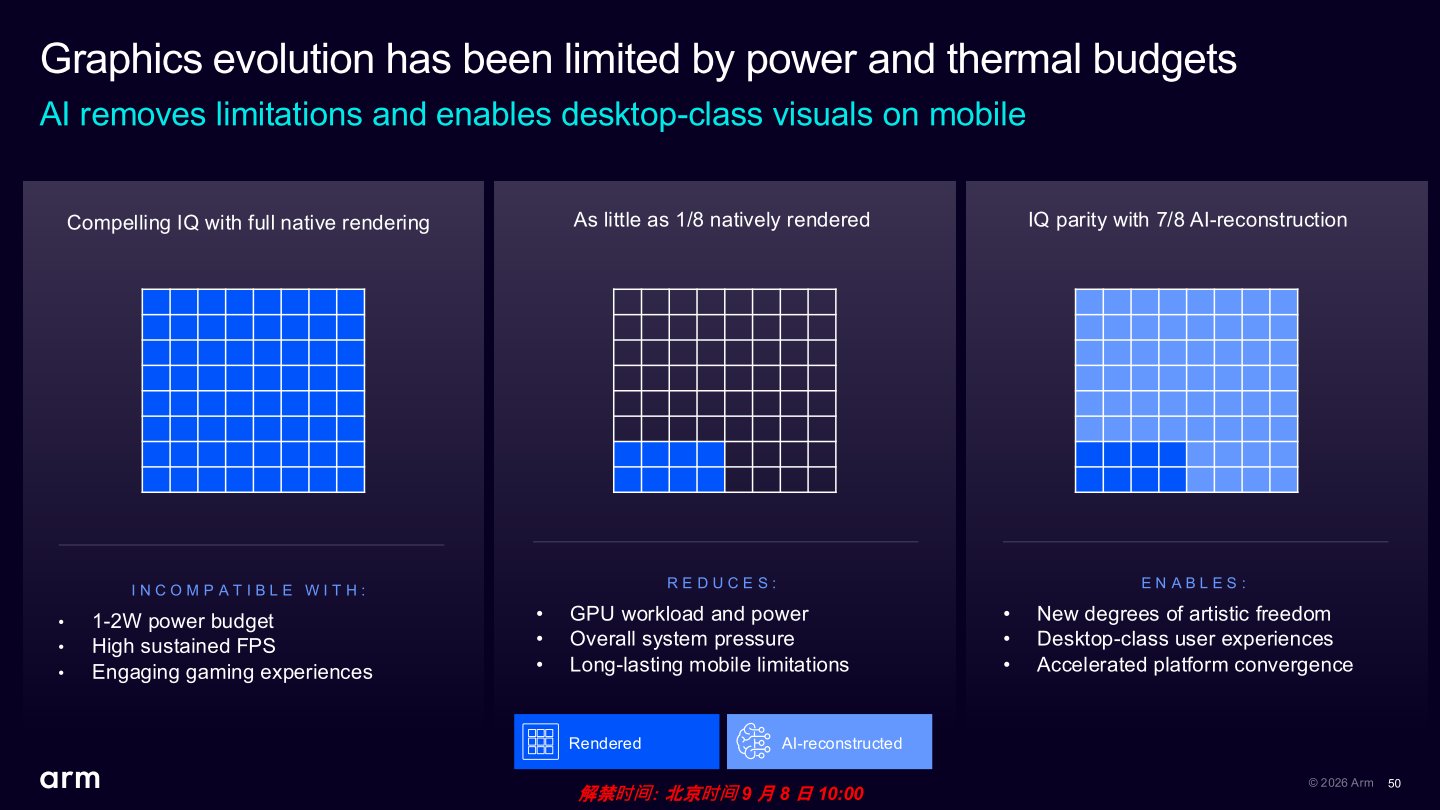
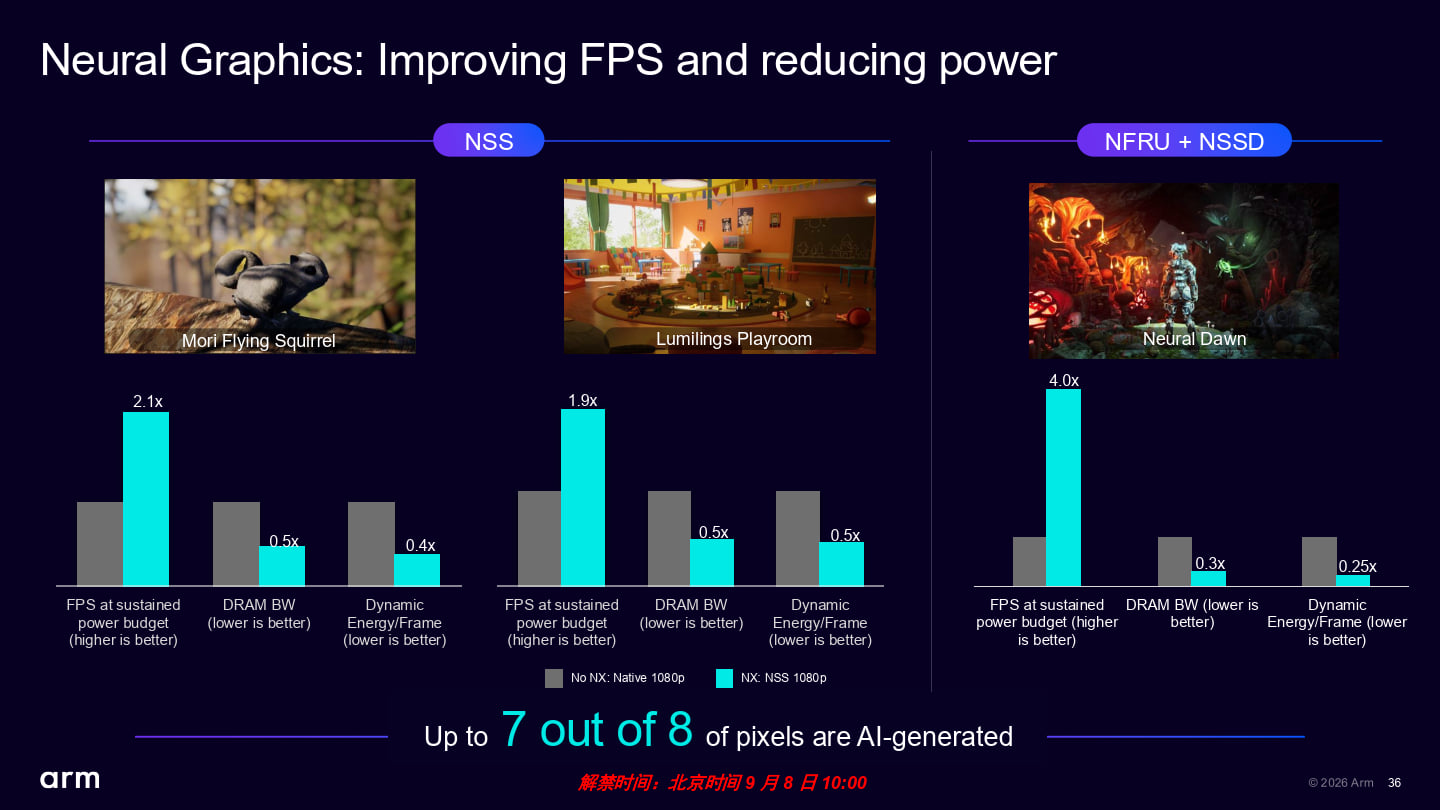
為了要在1~2 W的電力預算中提供穩定高FPS的流暢遊戲體驗,G2-Ultra NX GPU透過超解析度(4倍放大)與畫格生成(2X)等方式,將渲染畫面的實際運算量降低至1/8。

Arm先前推出NSS、NFRU等超解析度、畫格生成等功能,今年將推出強化光線追蹤升頻畫質的NSSD超解析度。

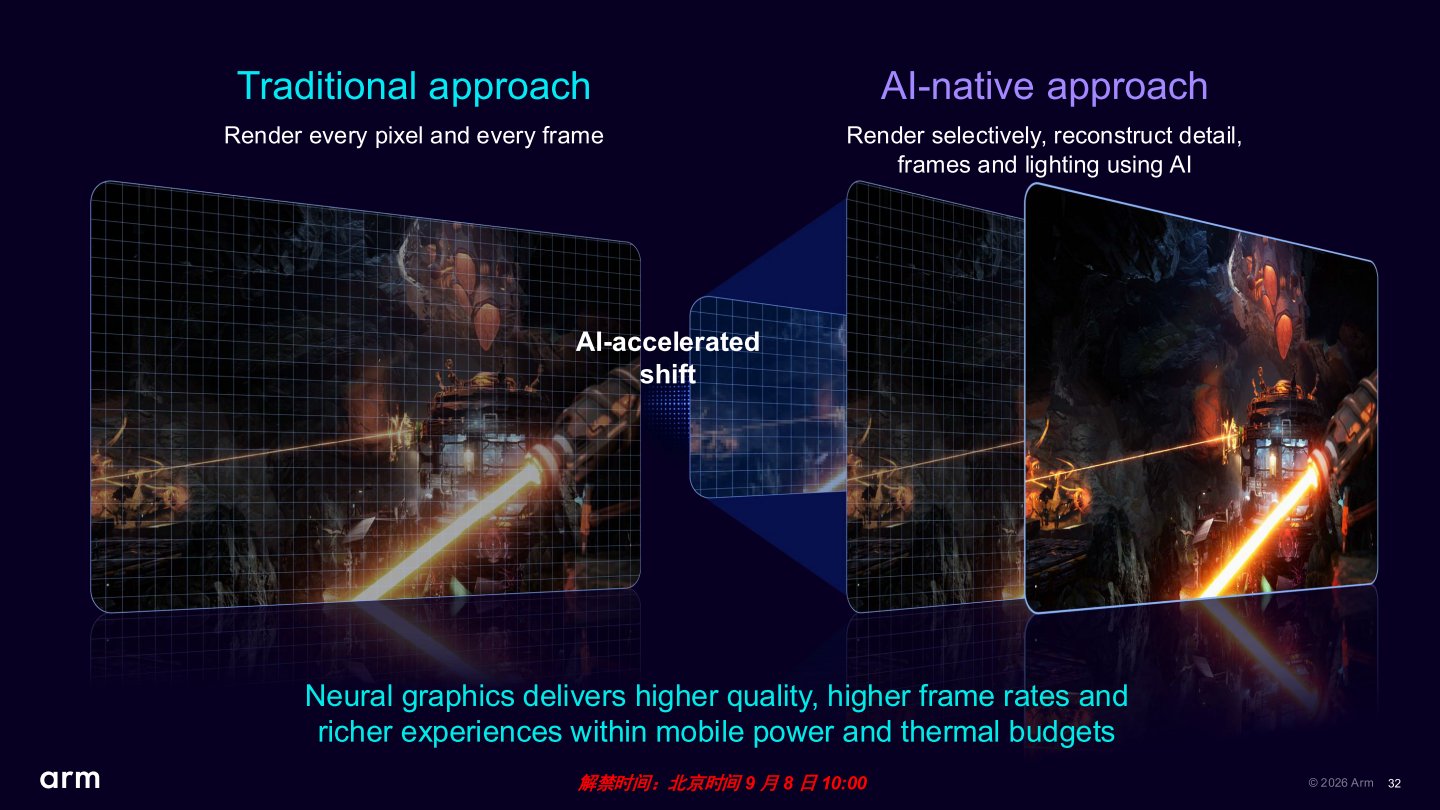
AI原生繪圖的概念是將繪圖資源花在刀口上,繪製最關鍵的圖像資訊,並透過升頻的方式重新構築畫質更高的遊戲畫面。

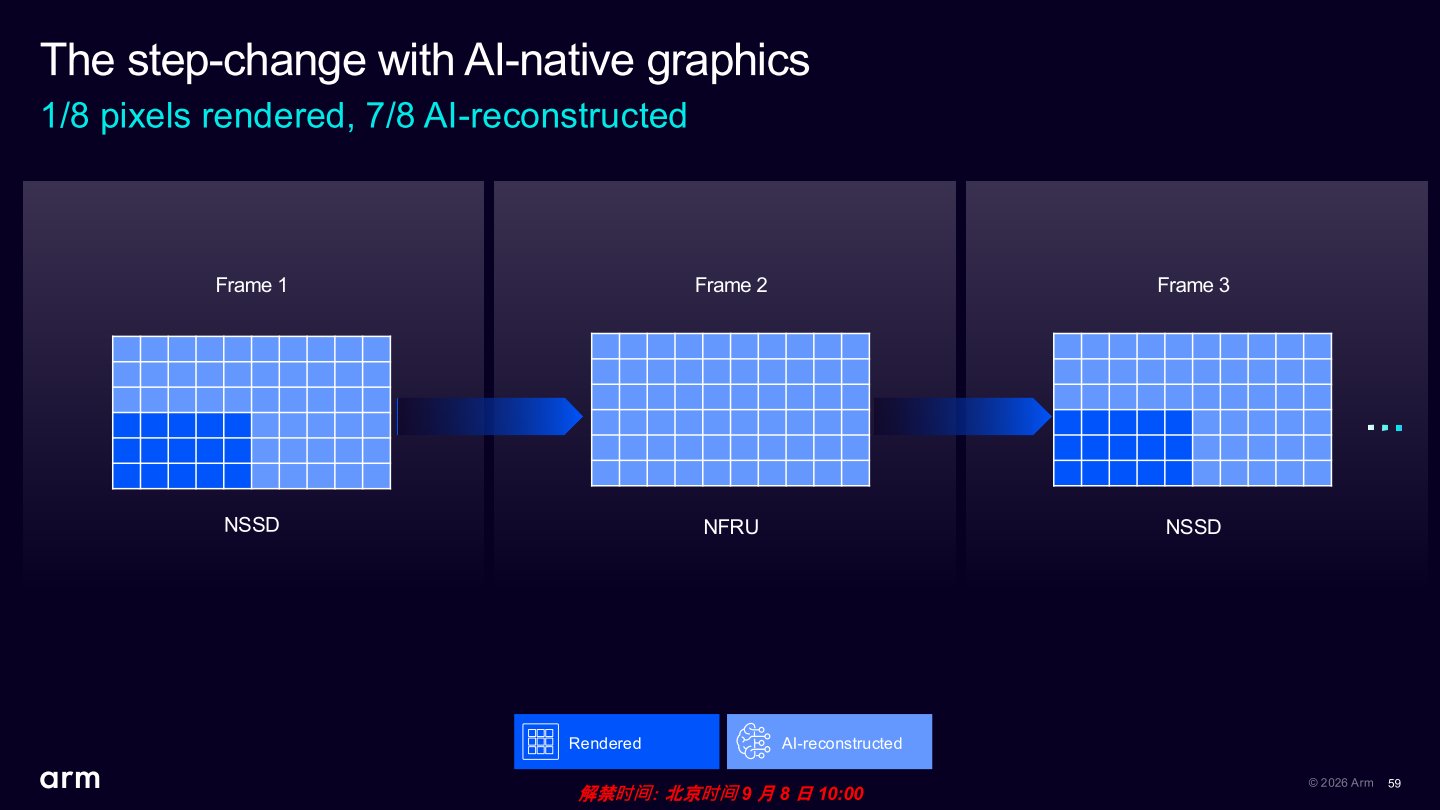
將上述流程的工作量以圖型方式呈現。GPU僅需實際渲染1/4解析度的資訊(Frame 1左下角的深藍色部分),然後透過NSSD超解析度放大至完整解析度(Frame 1淺藍色部分),之後再透過NFRU畫格生成產生下一個畫格(Frame 2淺藍色部分)。如此週而復始就能達到將實際渲染運算量減少至1/8,其於7/8的畫面都是透過AI由神經繪圖方式生成。

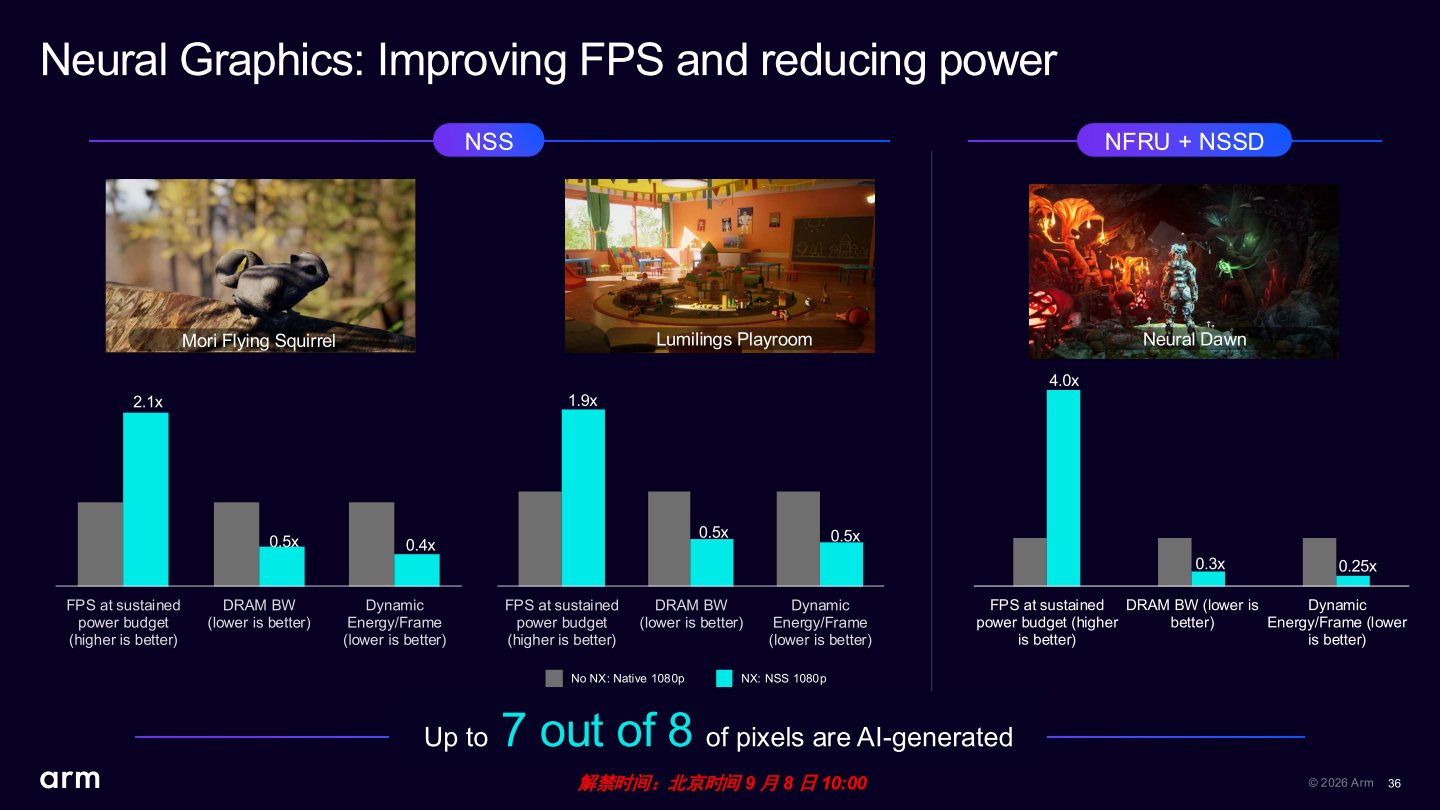
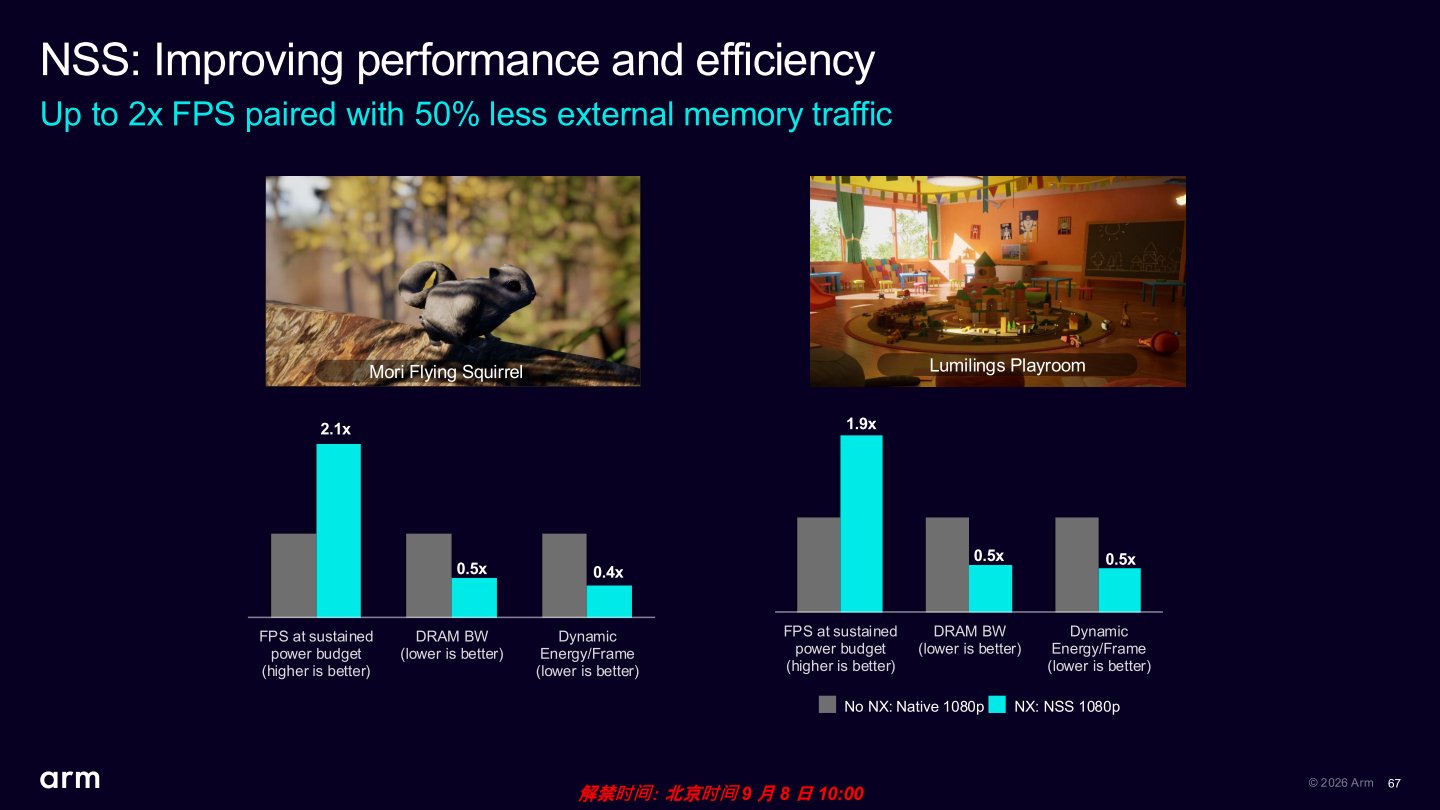
NSS大約可讓FPS效能達到2倍,並節省50%記憶體資料流量,NSSD搭配NFRU則可帶來4倍FPS效能,節省記憶體資料流量高達75%。

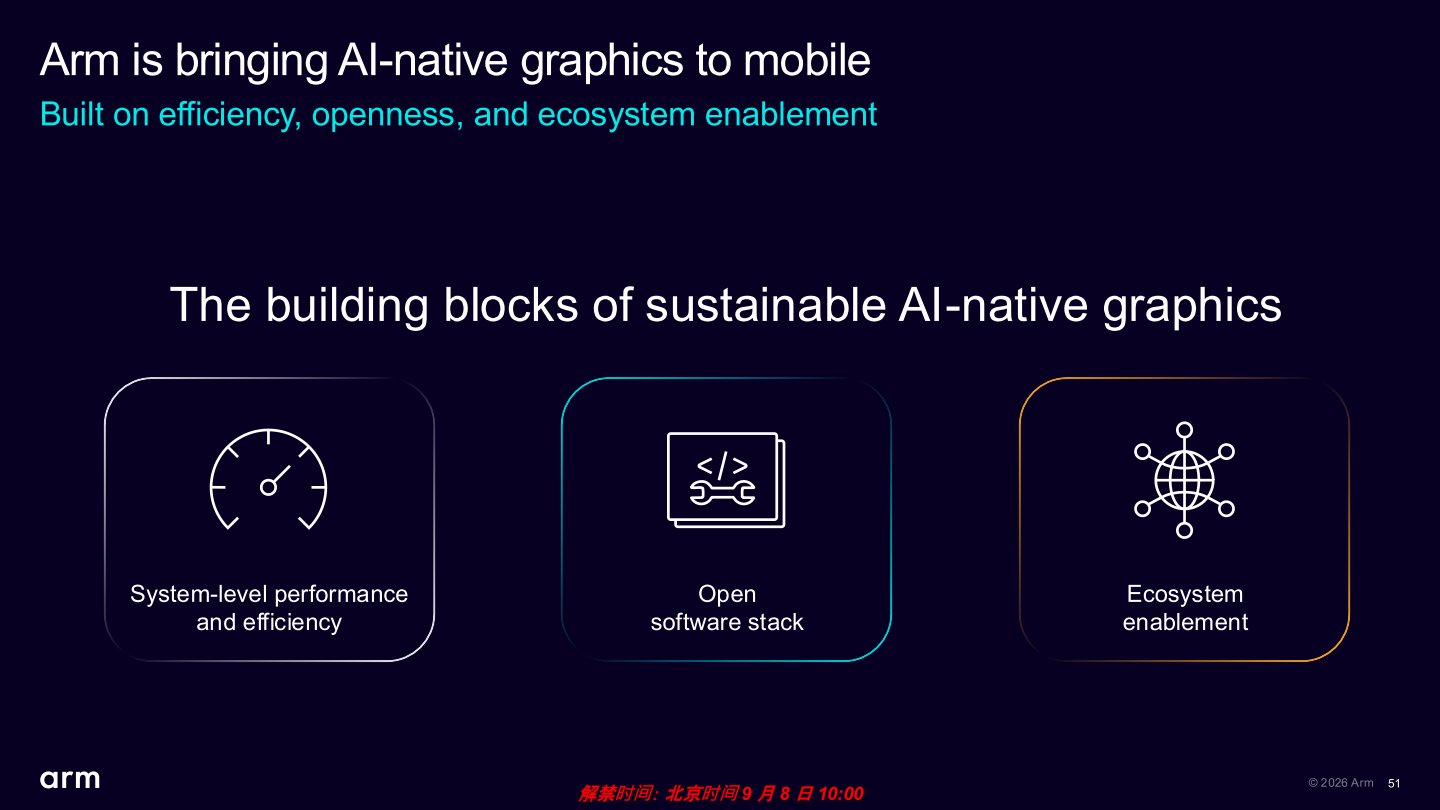
Arm藉由系統級效能與電力效率改善、開放軟體堆疊、賦能生態系等方式,協助打造持續性AI原生繪圖的效能體驗。

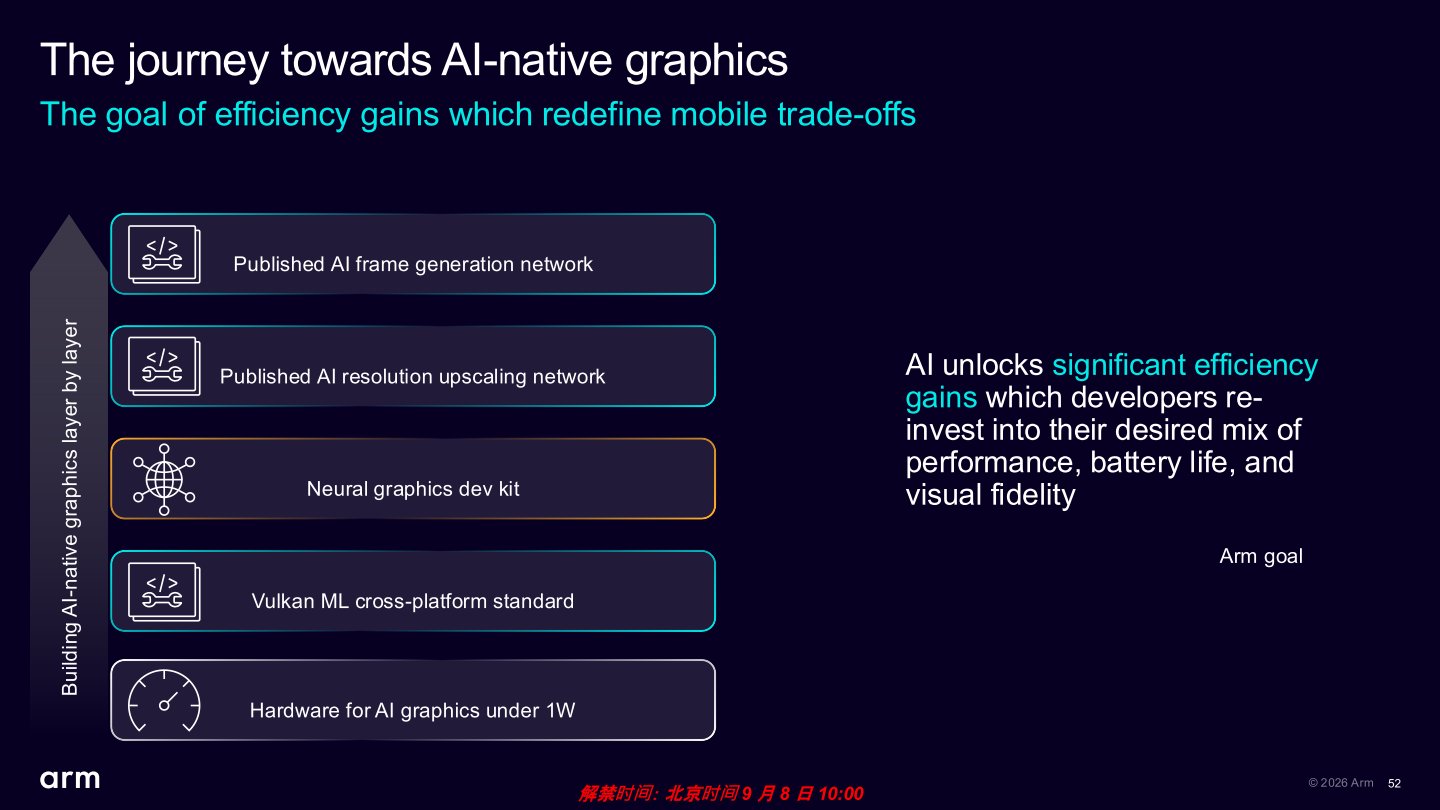
Arm透過消耗1 W以下電力的AI繪圖、跨平台Vulkan ML機器學習API、神經繪圖開發工具、AI超解析度、AI畫格生成的層層架構的技術,達成顯著的電力效率提升,提供遊戲開發者所期望效能、電持續航力、圖像品質等要素的平衡。

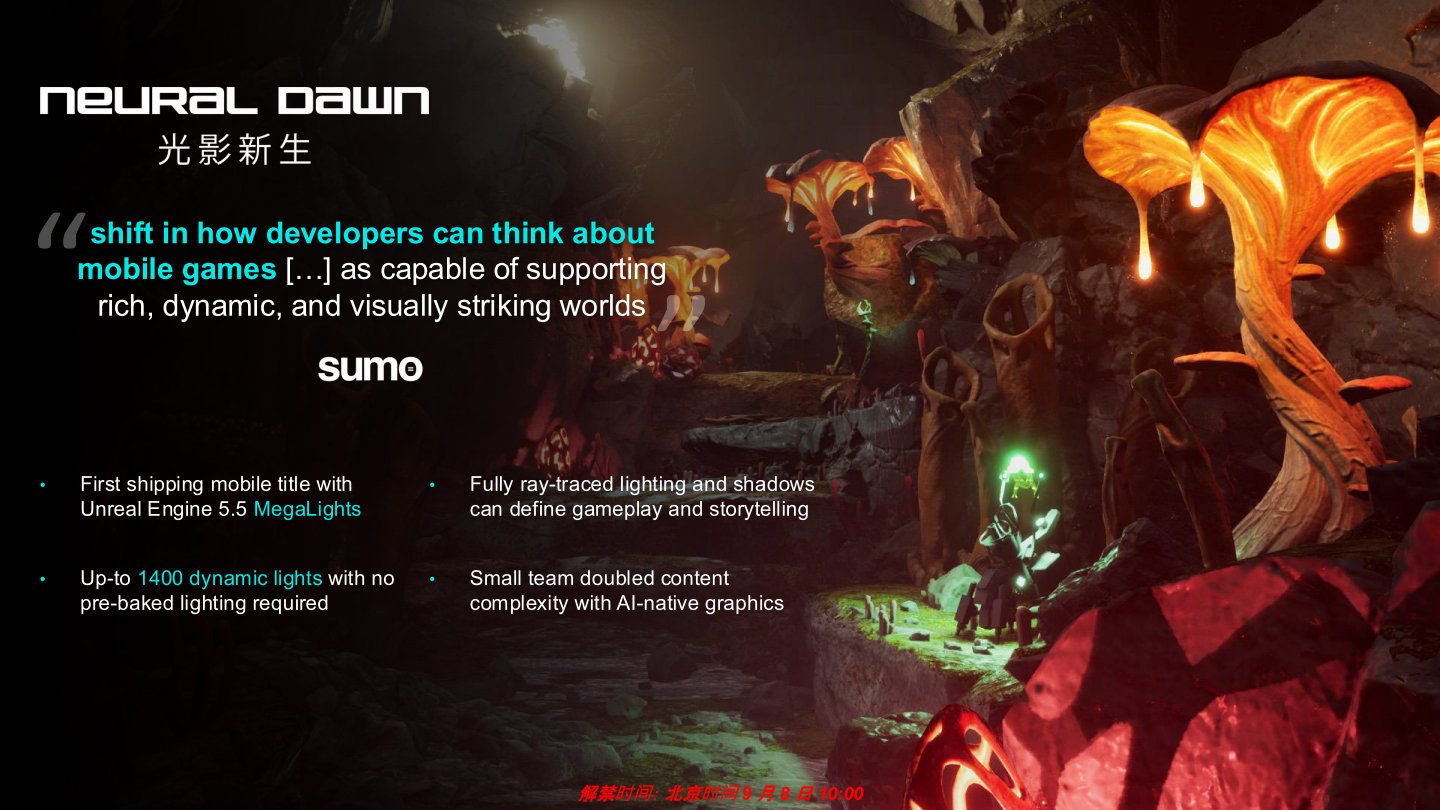
▲光影新生導入是首款導入Arm神經繪圖以及Unreal引擎導入Megalights即時光照技術的手機遊戲。

光影新生支援光線追蹤照明與陰影,最高能夠顯示1400組動態光源。即便遊戲圖像相當複雜,但是在完善開發工具的協助下,20人的團隊從構想到完成遊戲的完整開發流程僅花費18個月。遊戲預計於2026年上市。

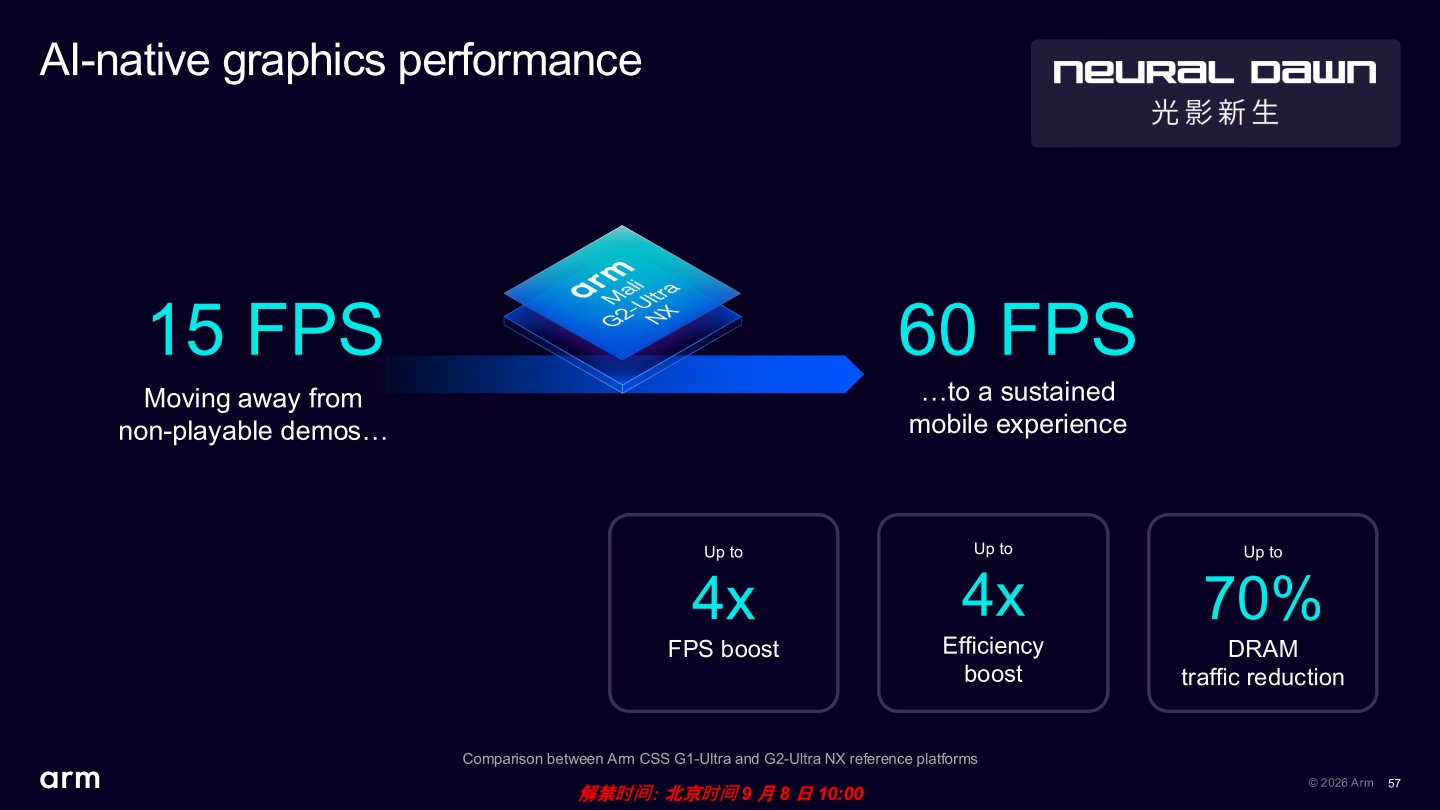
在神經繪圖技術的協助下,光影新生能夠穩定運作於FPS 60幀,達到4倍效能與4倍電力效率提升,並節省70%記憶體資料流量。

光影新生使用NSSD超解析度功能將540p解析度的實際渲染畫面放大至1080p,並透過NFRU畫格生成功能達到產生額外畫格。

下頁還有更多繪圖技術與效能數據說明


多種技術強化手機遊戲體驗

Arm表示GPU的峰值效能只能反映行動裝置上的部分體驗,然而持續效能才能來長時間遊戲過程中穩定的畫面表現,因此除了GPU的「輸出馬力」之外,較佳的電力效率代表GPU能夠在固定的散熱和功耗限制下,帶來穩定、流暢且長電池續航力的在更長時間的遊戲體驗。Mali G2-Ultra NX除了導入神經繪圖架構之外,也透過全新的執行引擎與多項技術應對日益複雜的繪圖運算負載,以改善持續效能表現。

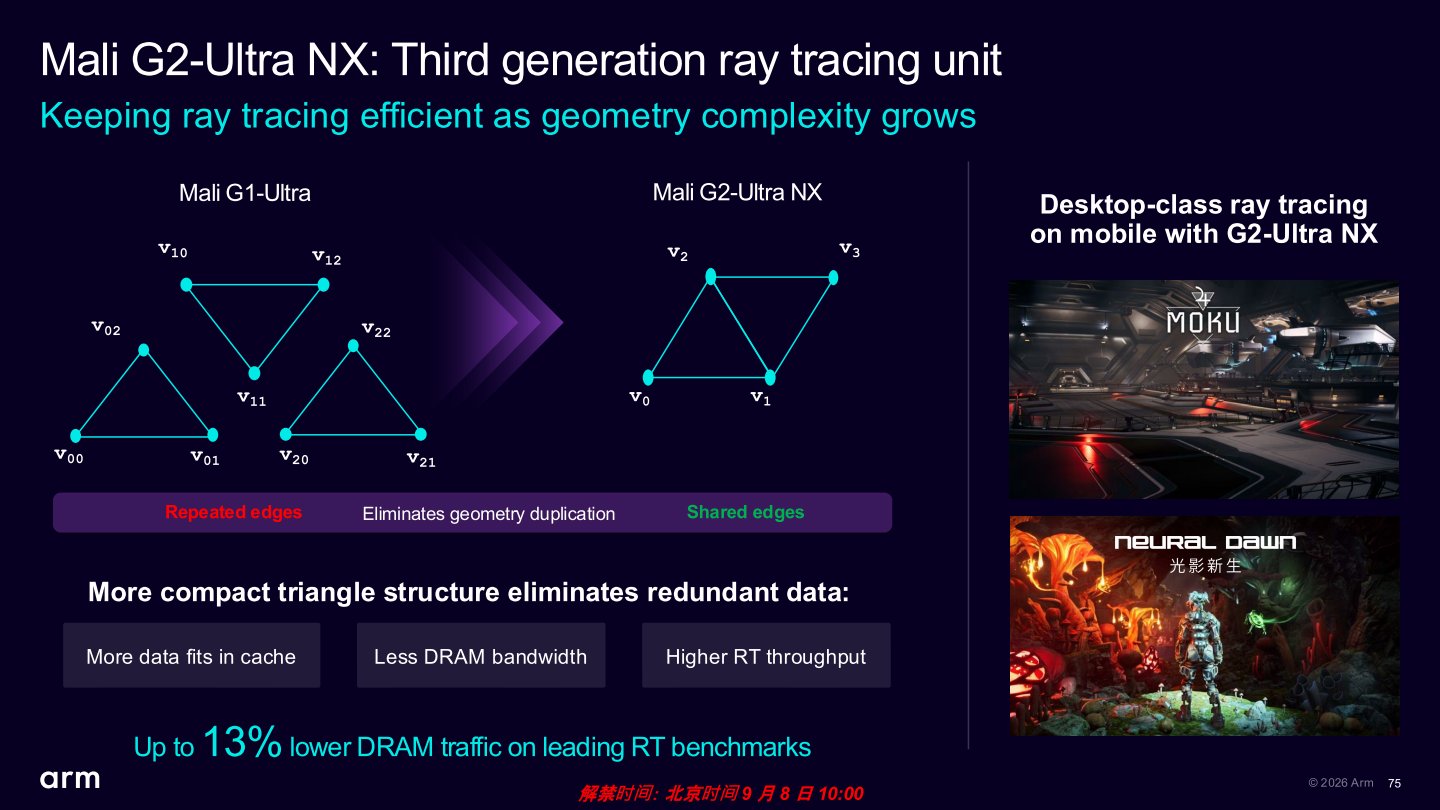
第3代光線追蹤單元支援更複雜的光照、陰影、反射和幾何效果,並透過共用多邊型邊緣繪圖技術降低資料容量,能在主流光線追蹤基準測試中節省13%的記憶體流量,緩解遊戲在複雜場景中的記憶體瓶頸。

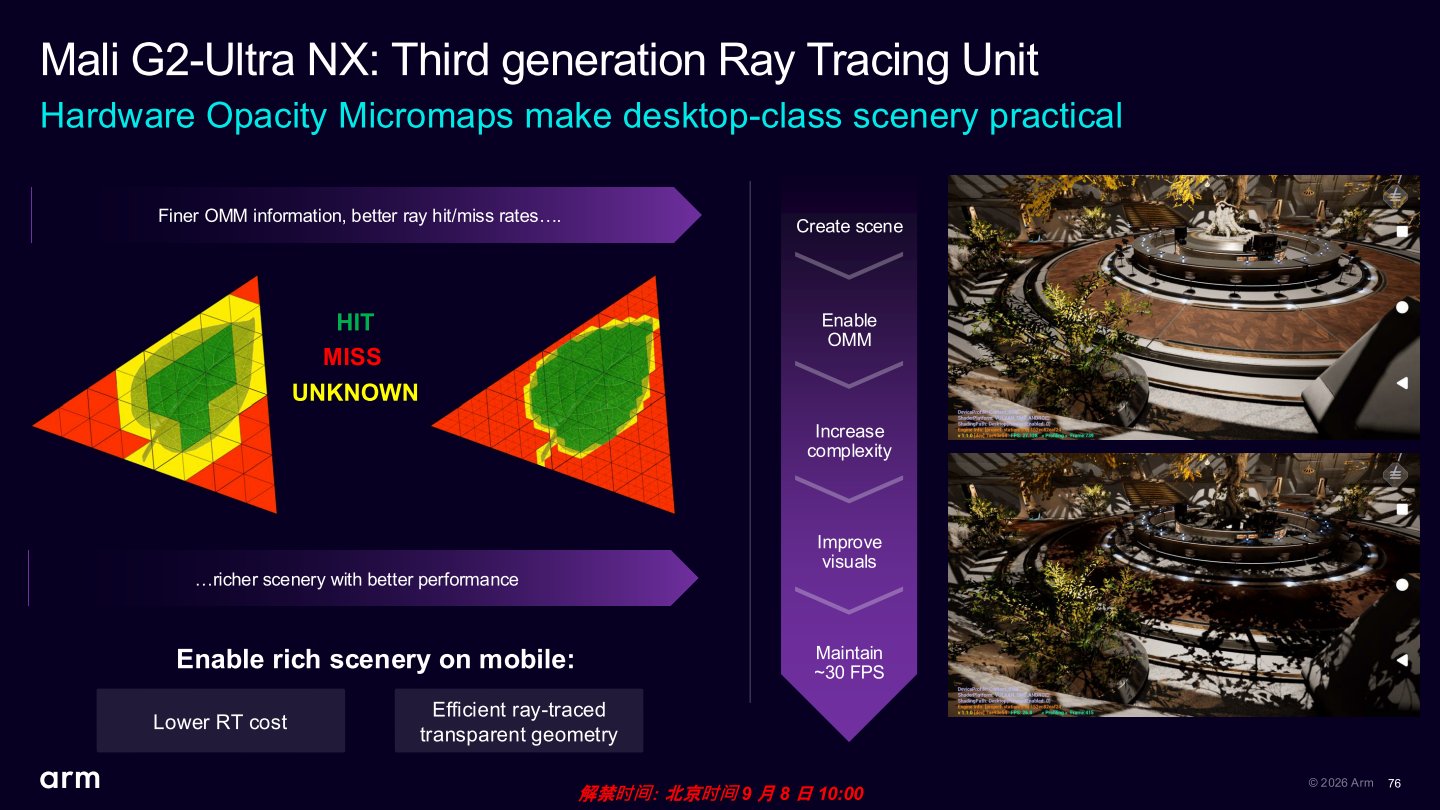
此外它也以硬體方式支援透明度微貼圖(Opacity Micromaps,OMM),能夠提高運算複雜透明幾何物件與光線接觸的效率,帶來30%的FPS效能提升,同時最多降低70%光線追蹤工作負載,進而能夠提供在行動裝置呈現更加豐富的植被、更精細的布料紋理、多層材質表面等複雜場景的能力。

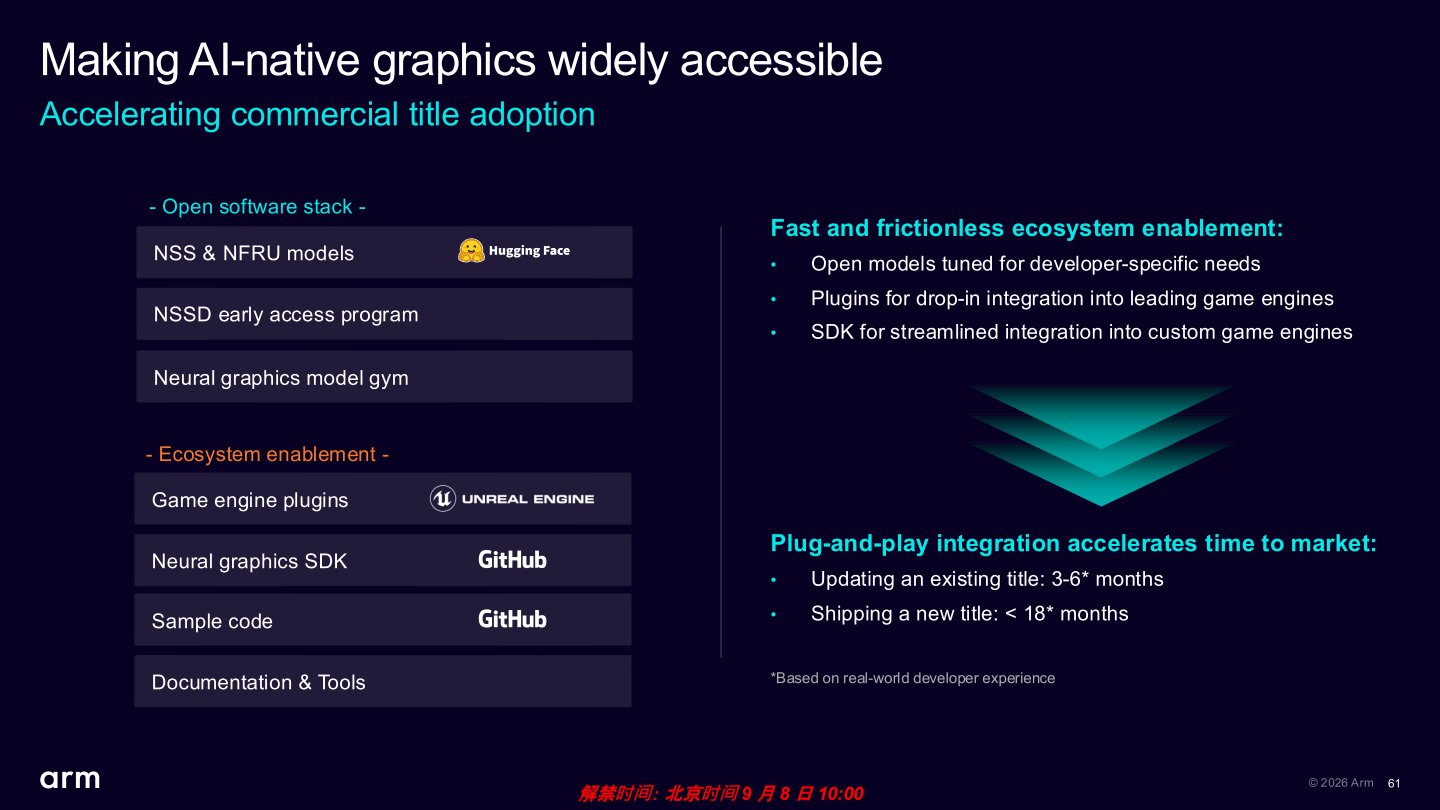
另一個值得注意的重點,是Arm以開源型式提供NSS、NFRU模型以及NSSD的早期預覽版(Early Access)程式,讓遊戲開發者可以針對遊戲的圖像呈現、畫面風格(如擬真或卡通風格)、對應裝置效能等級等等差異進行模型微調或再訓練,給予開發者更大的創作空間。

Arm提供開放的NSS、NFRU模型以及NSSD的早期預覽版(Early Access)程式,開發者可以在Unreal引擎中使用這些功能,或是從GitHub下載相關資源。根據實際開發者回報,大約3~6個月可完成現有遊戲升級光線追蹤,開發全新遊戲也可將開發時程壓縮至18個月以內。

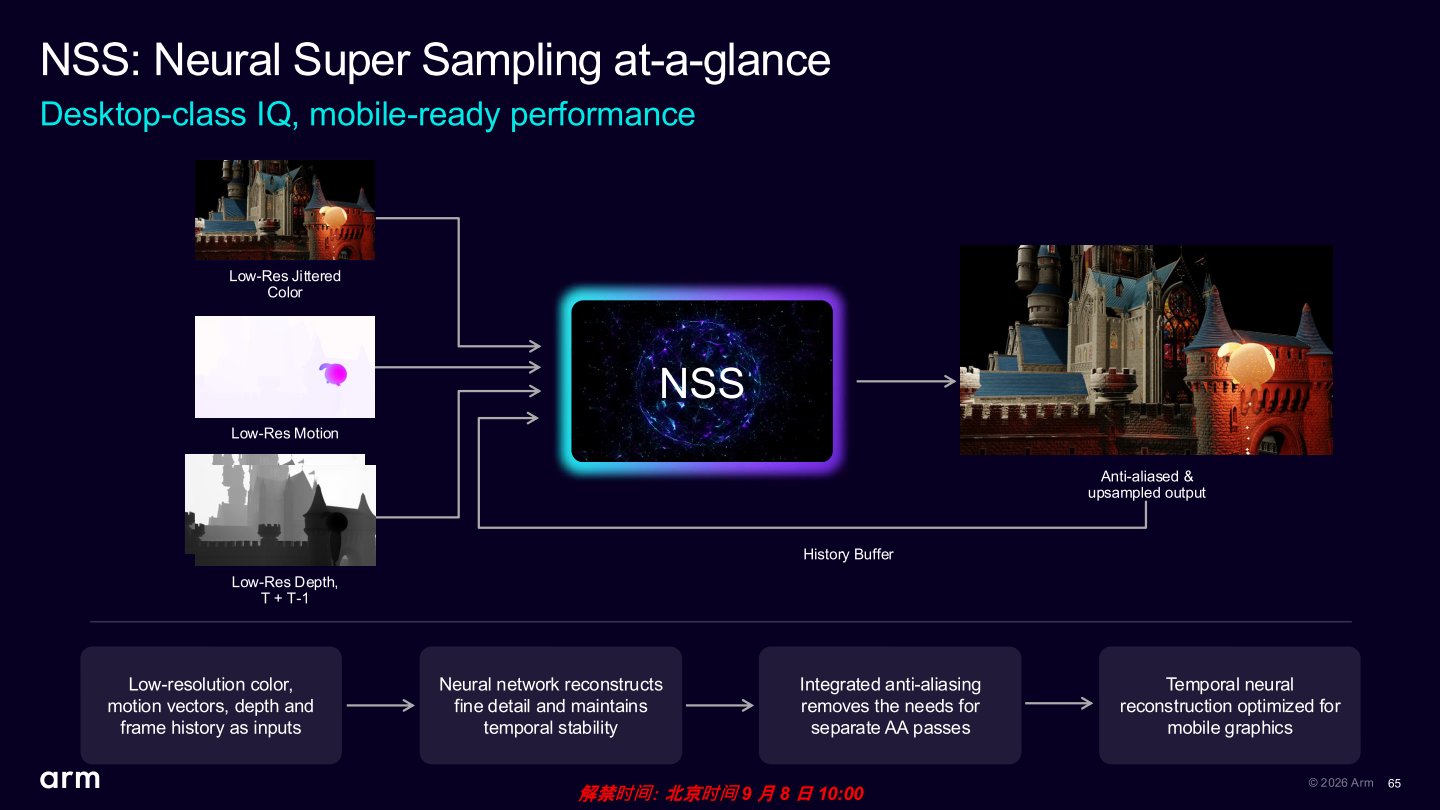
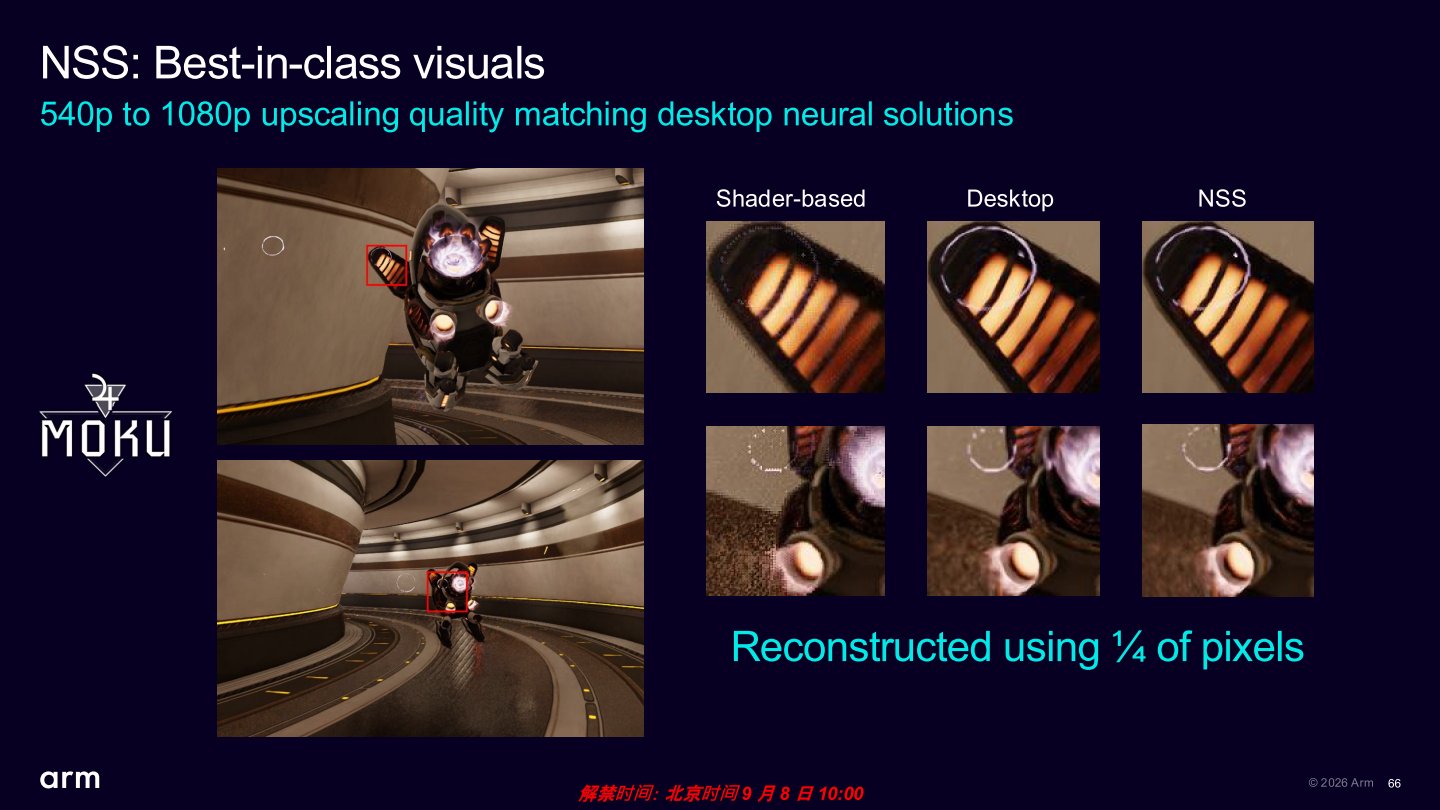
NSS超解析度功能透過降低解析度的實際渲染畫格,以及動態向量、深度圖等資訊,以AI推論方式產生高解析度圖像。

透過NSS升頻的圖像,畫質可以媲美桌上型電腦的表現。

NSS大約可以帶來100% FPS效能提升,並節省50%記憶體資料流量。

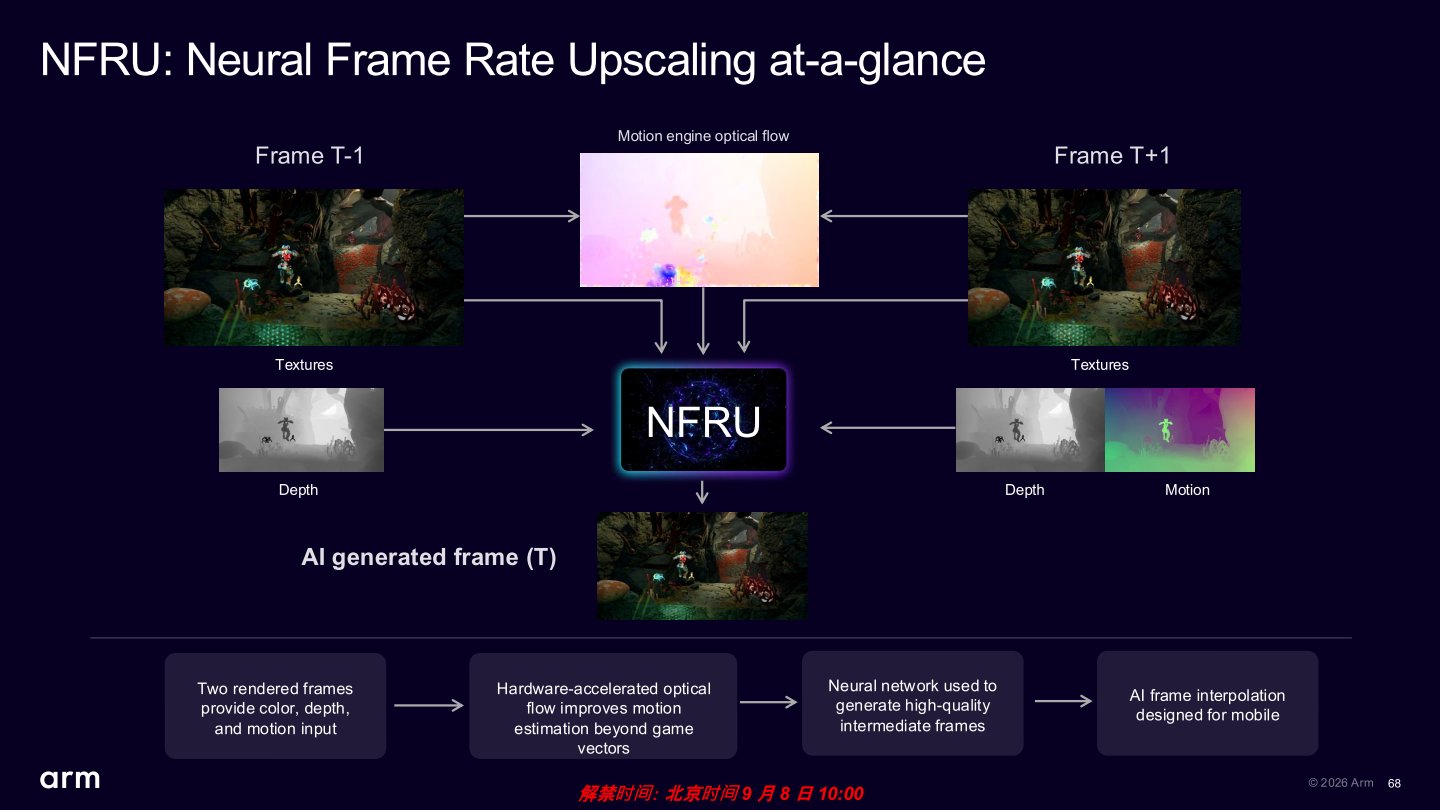
NFRU畫格生成功能則是將前後畫格的材質、深度圖、動態向量以及遊戲引擎提供的光流(Optical Flow)資訊輸入AI模型,以推論方式產生中間畫格。

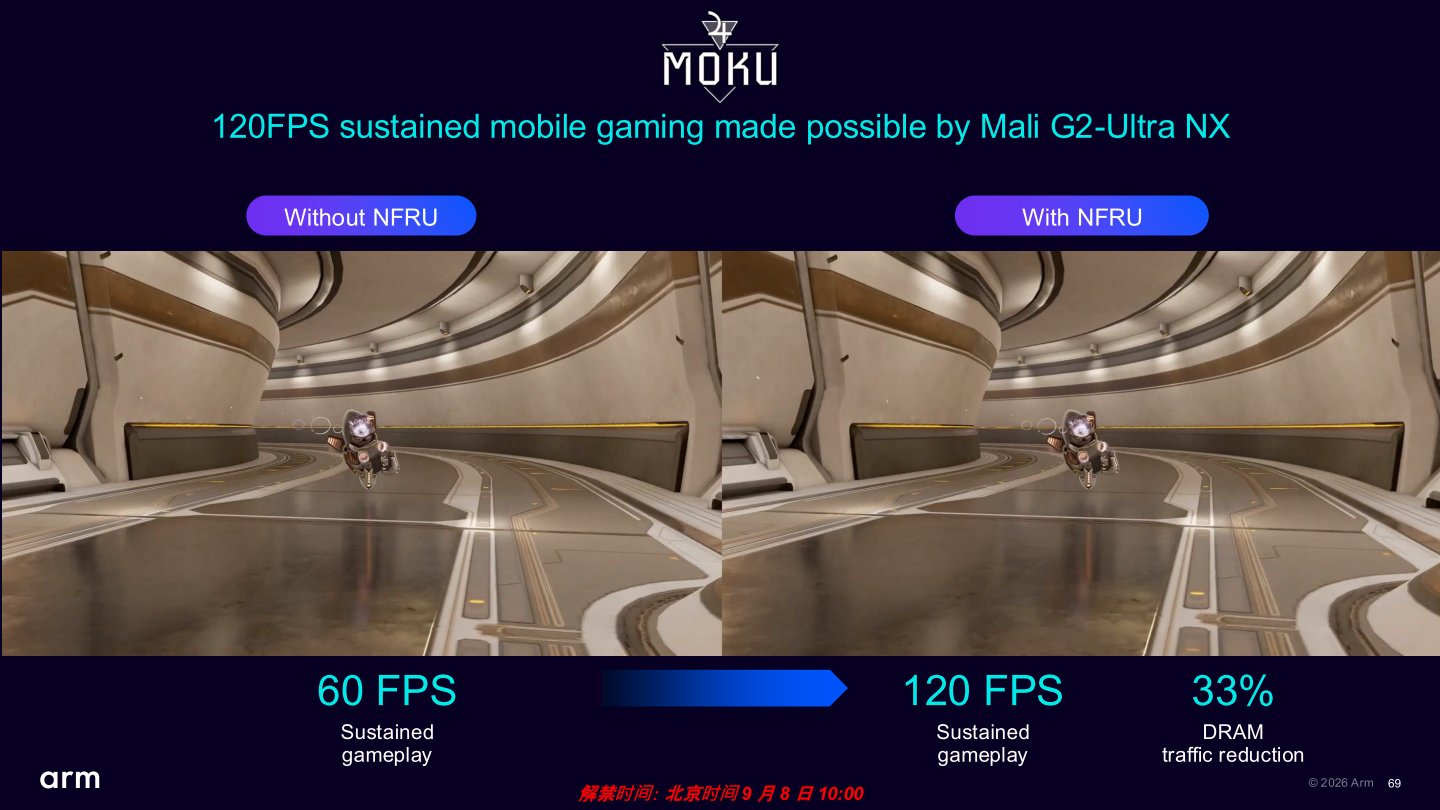
NFRU能夠在帶來2倍的FPS效能的同時,降低33%記憶體資料流量。

G2-Ultra NX GPU內部的執行引擎負責傳統繪圖功能,神經加速器則專門負責AI運算,支援INT8、INT16等資料類型,並內建畫格生成所需的光流加速功能(Motion Engine Optical Flow Acceleration)。

NSSD超解析度功能與NSS接近,但是多出降噪功能,適合應用於光線追蹤遊戲。

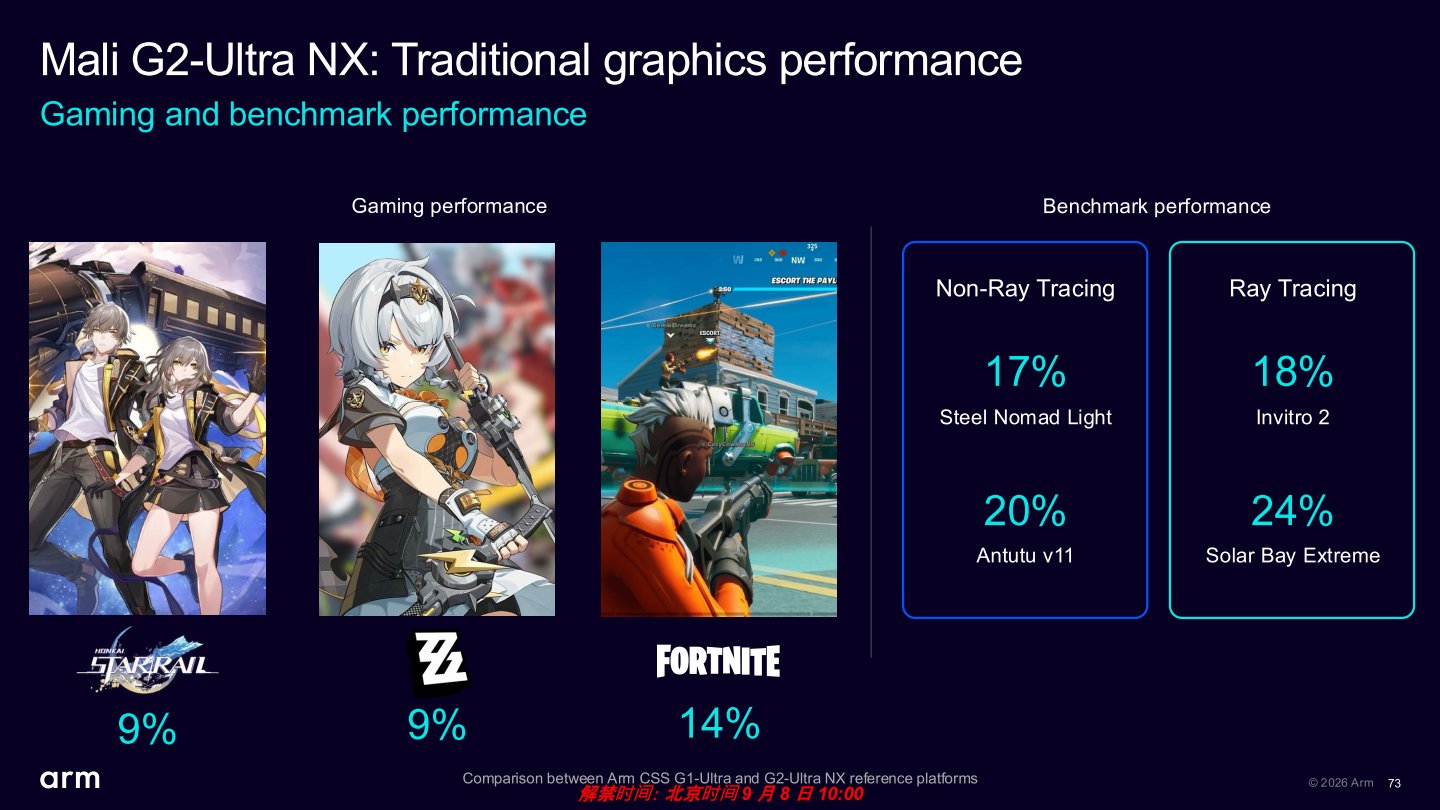
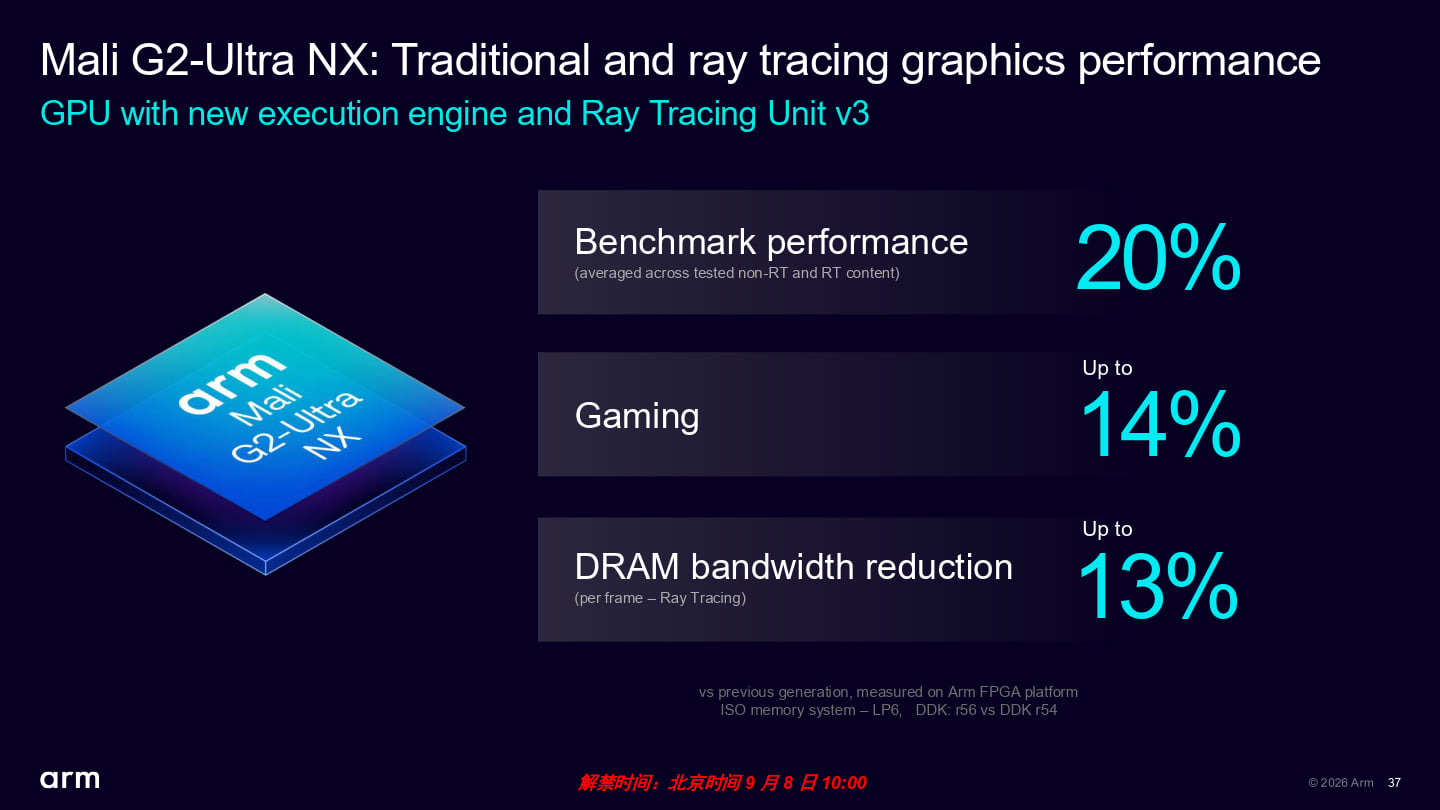
根據Arm提供的數據,G2-Ultra NX在多款遊戲的效能較前代G1-Ultra提高9~14%,效能測試工具成績則提升17~24%。

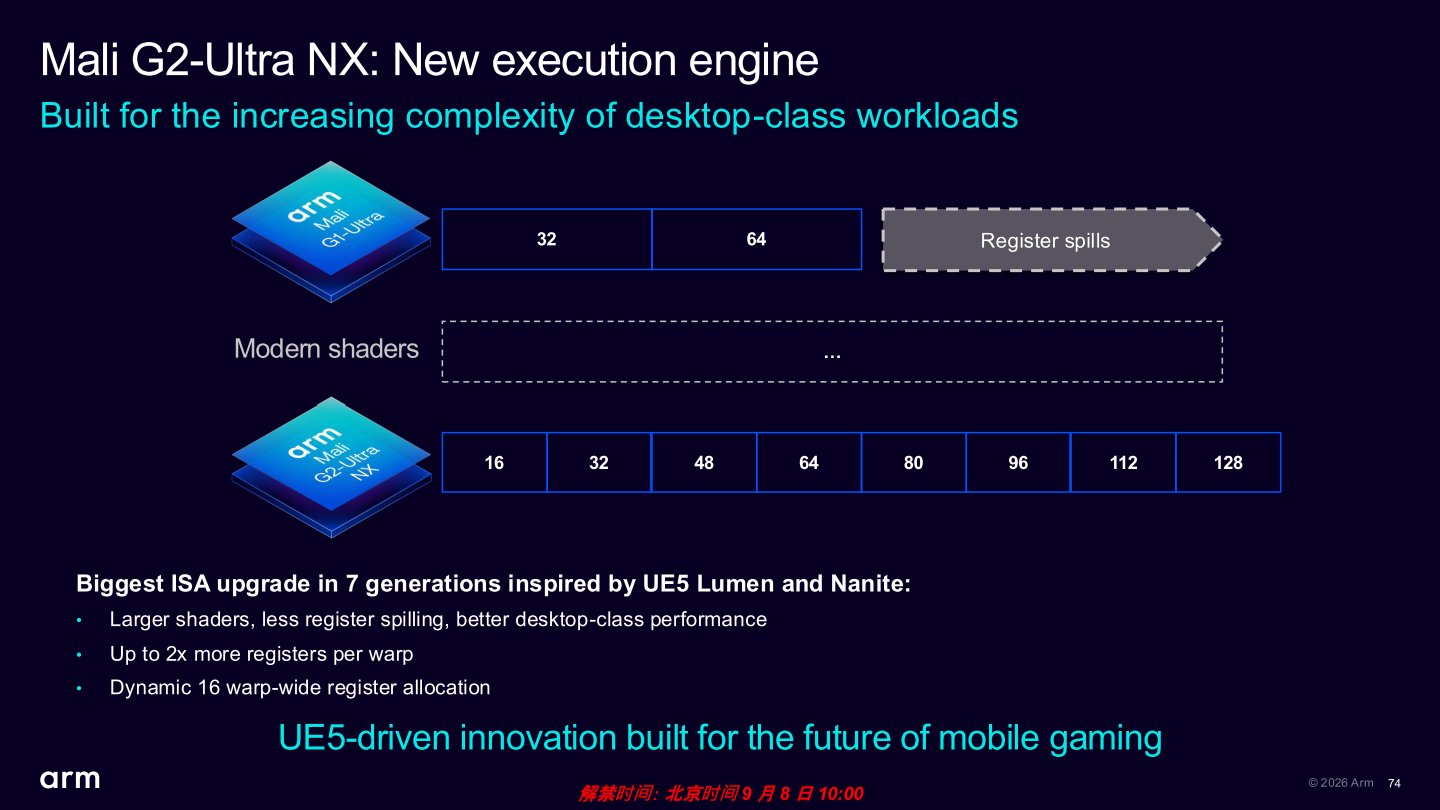
G2-Ultra NX的執行引擎支援更精細的動態暫存器分配機制以減少暫存器溢出,能在著色器(Shader)程式規複雜度提升時減少暫存器溢出,提高資源利用率與整體效能。

G2-Ultra NX的第3代光線追蹤單元支援共用多邊型邊緣繪圖技術,能夠降低資料量並達到更高的光線追蹤吞吐量,在效能實測中能夠節省13%的記憶體流量。

第3代光線追蹤單元也支援透明度微貼圖,提供更精細的光線接觸判定,能夠降低繪圖負擔、提高光線追蹤效率。

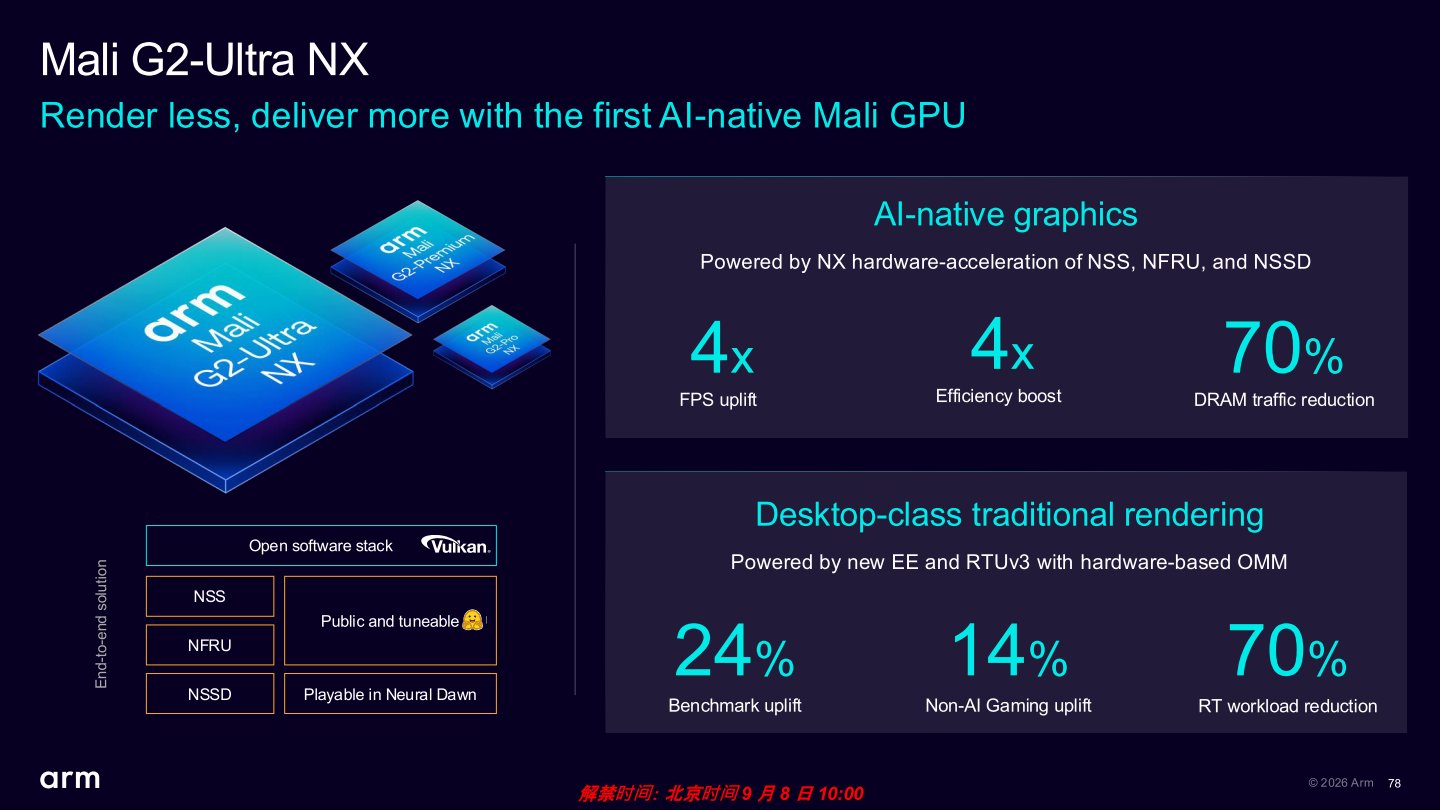
G2-Ultra NX的繪圖效能在測試工具中提高24%,在非AI、神經繪圖的遊戲中提高14。若啟用神經繪圖則可讓FPS效能達到4倍之譜。

Arm透過Mali G2-Ultra NX與多種神經繪圖技術提供開發者更充沛的效能,有助於打造更豐富多元的遊戲作品,也讓玩家能在行動裝置上替驗媲美桌上型電腦等級的遊戲體驗,首款搭載Mali G2-Ultra NX GPU的智慧型手機為於2026年9月10日上市的Xiaomi 18 Fold

Arm Tech Day 2026系列文章目錄

加入T客邦Facebook粉絲團
✇T客邦-Techbang

【Arm Tech Day 2026】CSS for Mobile 2帶來全新C2-Ultra CPU、G2-Ultra NX GPU,強化手機代理式AI與主機級光線追蹤遊戲體驗

Arm CSS for Mobile 2運算子系統包含C2-Ultra、C2-Pro等CPU、G2-Ultra NX GPU、系統 IP、軟體及開發者工具,以完整平台的型式改善代理式AI應用體驗。89b071b9d660234de77a4099fd12d816

Arm CSS for Mobile 2運算子系統包含C2-Ultra、C2-Pro等CPU(處理器),以及G2-Ultra NX GPU(繪圖處理器)、系統 IP、軟體及開發者工具,以完整平台的型式改善代理式AI應用體驗。

手機成為AI代理助手

Arm於北京舉辦的Arm Tech Day 2026說明會中發表為智慧型手機、平板電腦等 行動裝置設計的CSS for Mobile 2運算子系統,透過從整體系統層面進行最佳化設計的運算平台,在有限的電力與散熱預算下提供充沛的通用運算、AI、繪圖效能,以滿足代理式AI以及遊戲主機等級的光線追蹤遊戲體驗。

延伸閱讀:
Arm Lumex CSS平台搭配全新C1系列處理器,4種型號隨意混搭最高14核心效能怪獸
Arm發表全新Lumex CSS平台,C1 CPU與Mali G1 GPU為旗艦級手機帶來25%效能增長
Arm發表類神經網路升頻技術,NPU嵌入GPU藉AI提升繪圖效能並節省電力

Arm邊緣AI客戶端運算副總裁James McNiven在說明會中介紹CSS for Mobile 2的設計功能,隨後則由其他專家介紹全新C2系列CPU與G2系列GPU的架構細節,我們先在這篇文章中瞭解CSS for Mobile 2,並在後續文章中深入分析CPU與GPU。

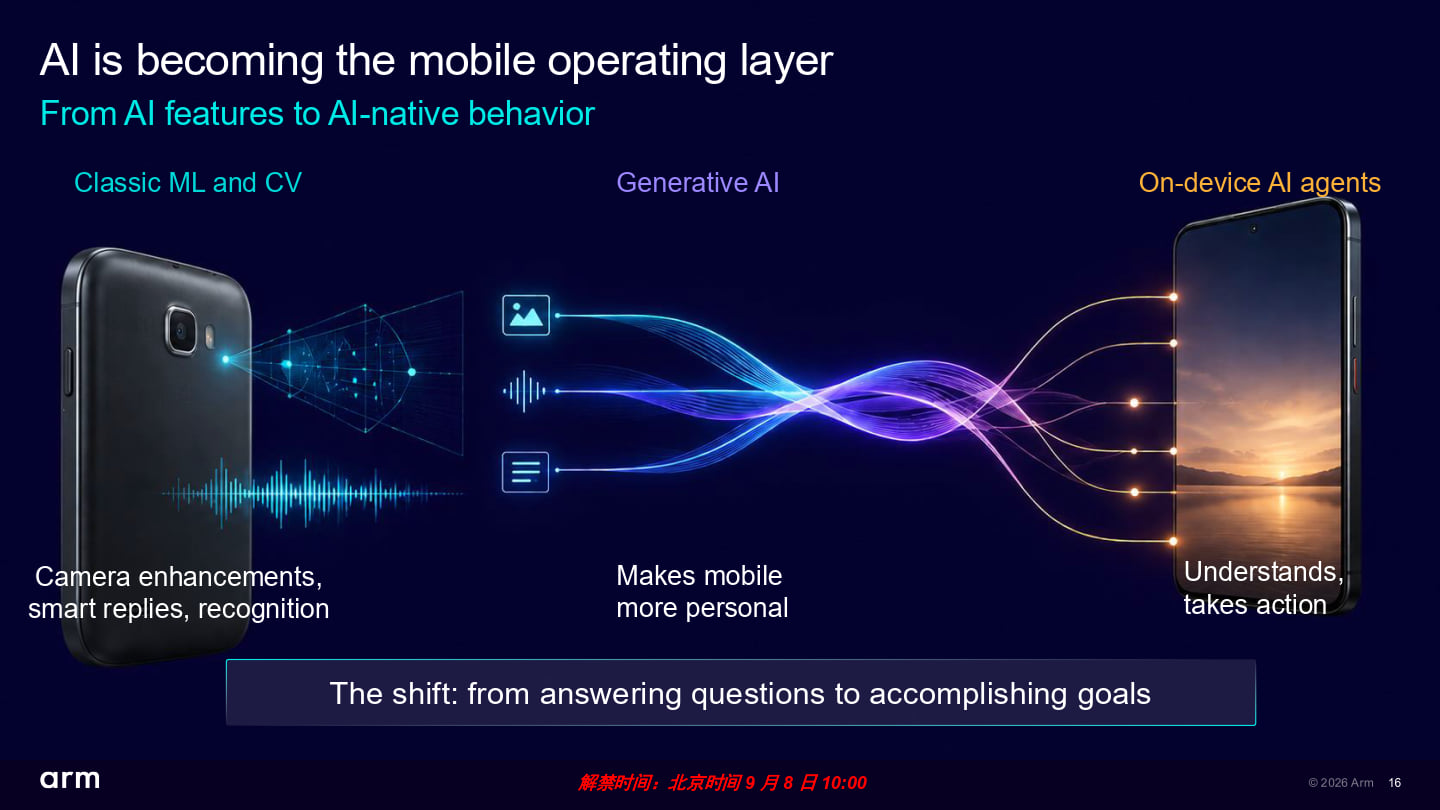
回顧AI技術發展的各個階段,初期階段為功能有限的機器學習應用程式,例如影像辨識、物件分類等等應用,接著到了生成式AI階段,AI應用程式可以透過生成文字的型式回答使用者的問題,或是將參考提示詞進行圖像生成。

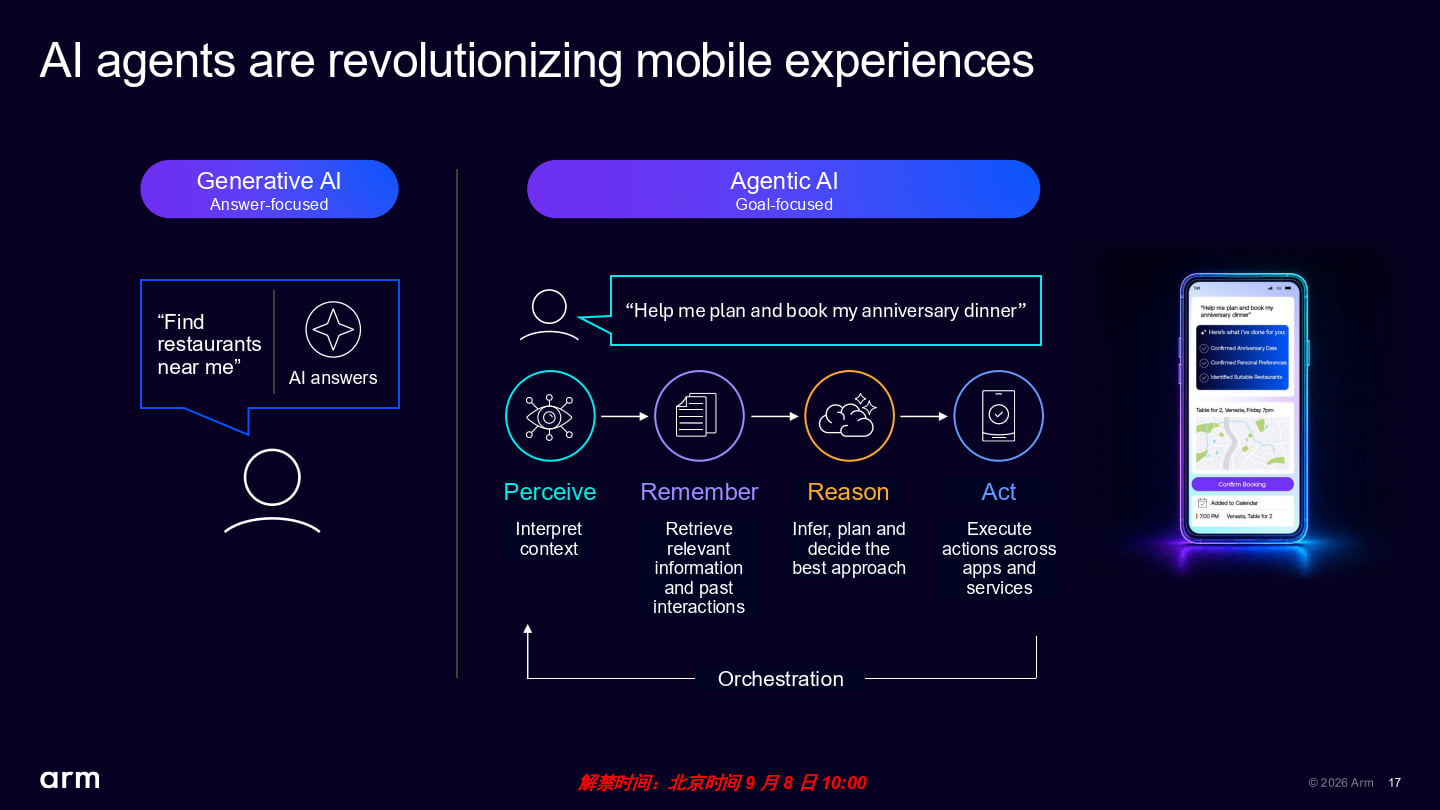
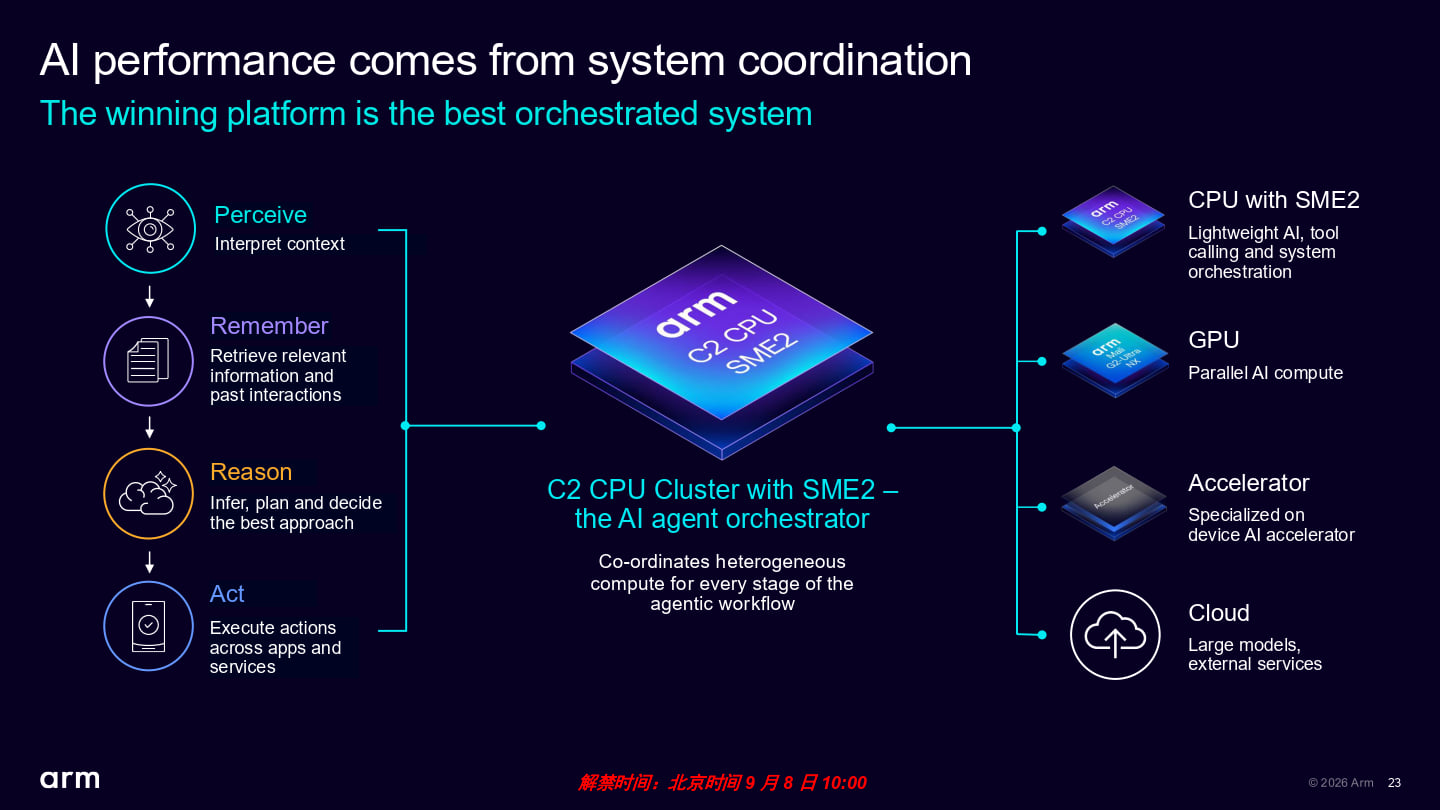
進入代理式AI階段後,AI代理系統進化為能夠自主感知、分析使用者的意圖與需求,並擬定解決方案,接著調用系統中的其他AI應用程式或傳統應用程式完成工作,最終將工作成果彙報給使用者。

為了完成上述工作,代理式AI會在使用者單次下達指令後,調用系統中的多個元件以完成意圖分析、資料檢索與處理、模型執行、記憶體存取以及操作應用程式等環節,因此系統需要具備常時在背景運作、充沛的AI運算效能、更多的處理器核心數等能力,以提供理想的使用體驗。

James McNiven將代理式AI的運作流程拆解為下列4個階段,筆者也將後續演說中提到以丈夫為妻子訂結婚10週年紀念晚餐的任務,整合於下列流程說明。

代理式AI運作流程

  1. 感知(Perceive):接收外界資訊並分析指令。例如使用者對手機說「幫我訂結婚10週年餐廳」
  2. 記憶(Remember):搜尋資訊與過去的互動。系統會搜尋手機中的行事曆、相簿等資料,確定結婚紀念日期,以及從過去的相片分析喜歡的餐廳風格與菜色
  3. 推理(Reason):規劃並決定最佳解決方案。系統自動上網搜尋適合的餐廳,並生成操作提示詞
  4. 行動(Act):自動執行提示詞與任務。系統自動完成餐訂位,將行程新增至行事曆,將活動提醒與導航資訊傳給妻子

在上述流程中,除了會進行AI推論運算之外,還有許多查尋資料、開啟App、操作網頁的工作,都會占用CPU的運算資源,而且統整各階段順利進行的編排(Orchestration)工作也仰賴CPU,另一方面也有部分AI運算也會直接交給CPU處理,因此在CPU在代理式AI的重要性不亞於GPU或NPU等運算單元。

Arm邊緣AI客戶端運算副總裁James McNiven在說明會分享AI技術發展的趨勢,並介紹CSS for Mobile 2運算子系統的設計功能。

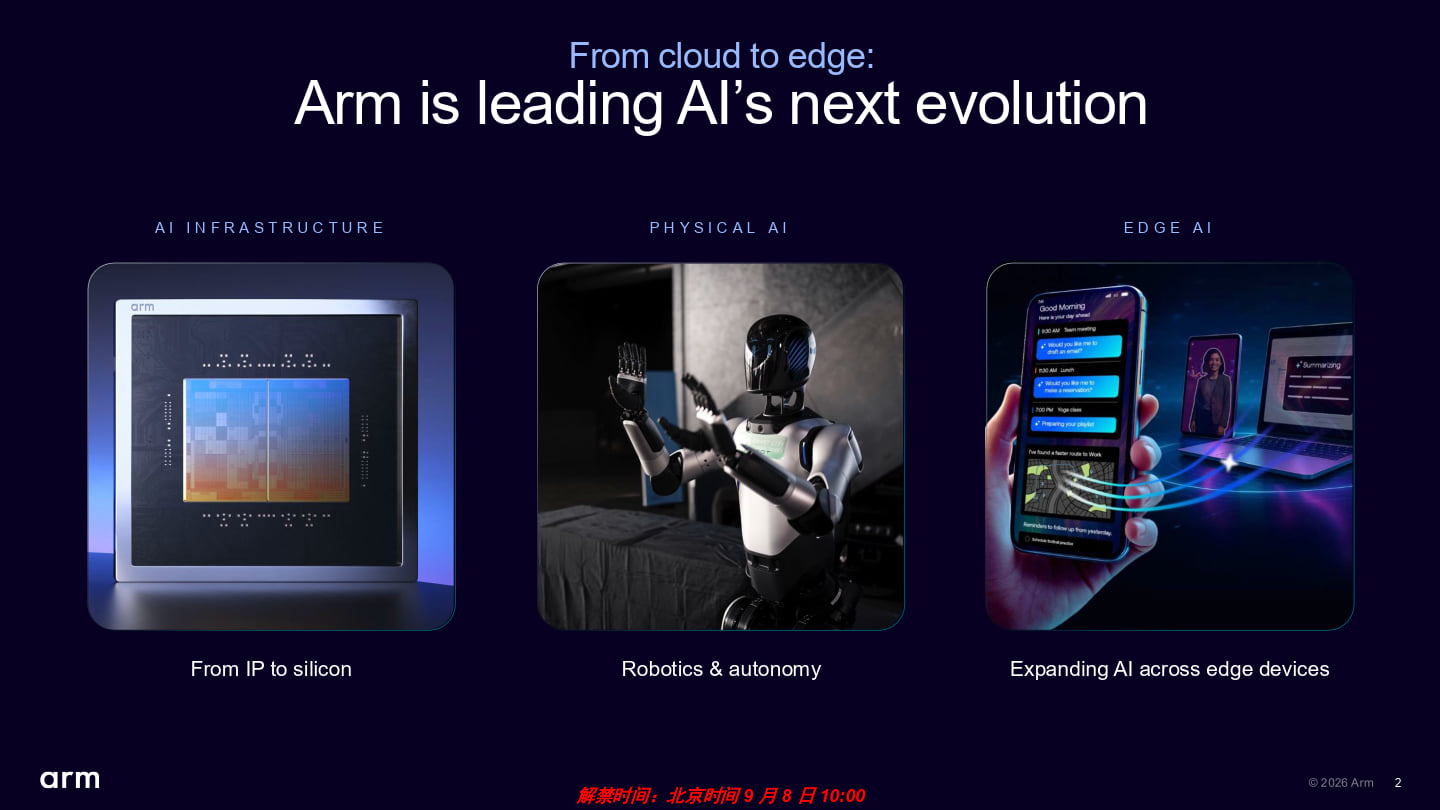
Arm在AI轉型中扮演重要角色,不但有先前針對資料中心推出的Arm AGI CPU,也有適合應於機器人等物理AI與智慧型手機等邊緣AI的相關產品。

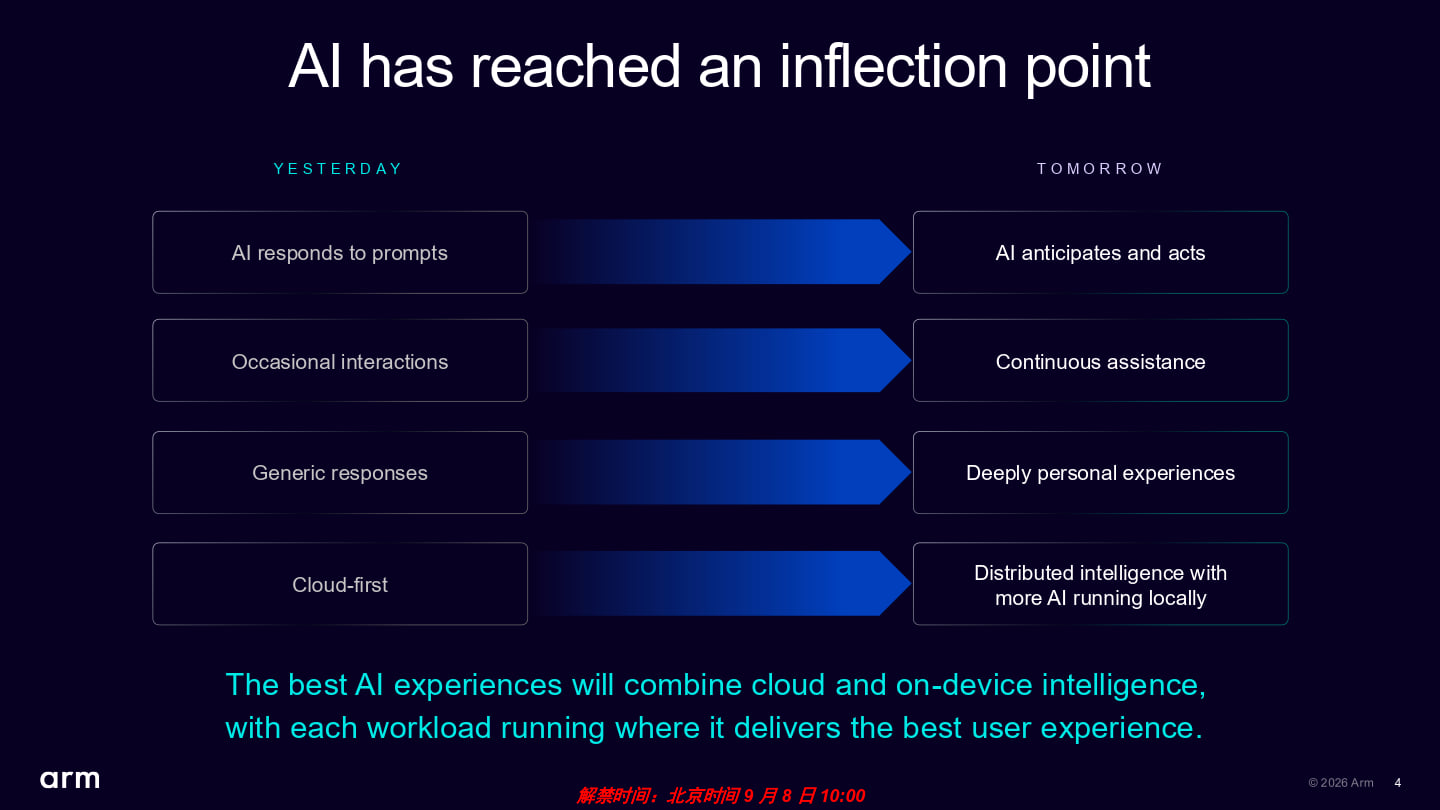
AI沿著單一功能、生成式AI、代理式AI的路徑發展至今,操作模式也由對提升詞反應、偶爾互動、產生回答、雲端優先,轉換為自主行動、持續互動、深度個人化、分散至終端裝置執行。

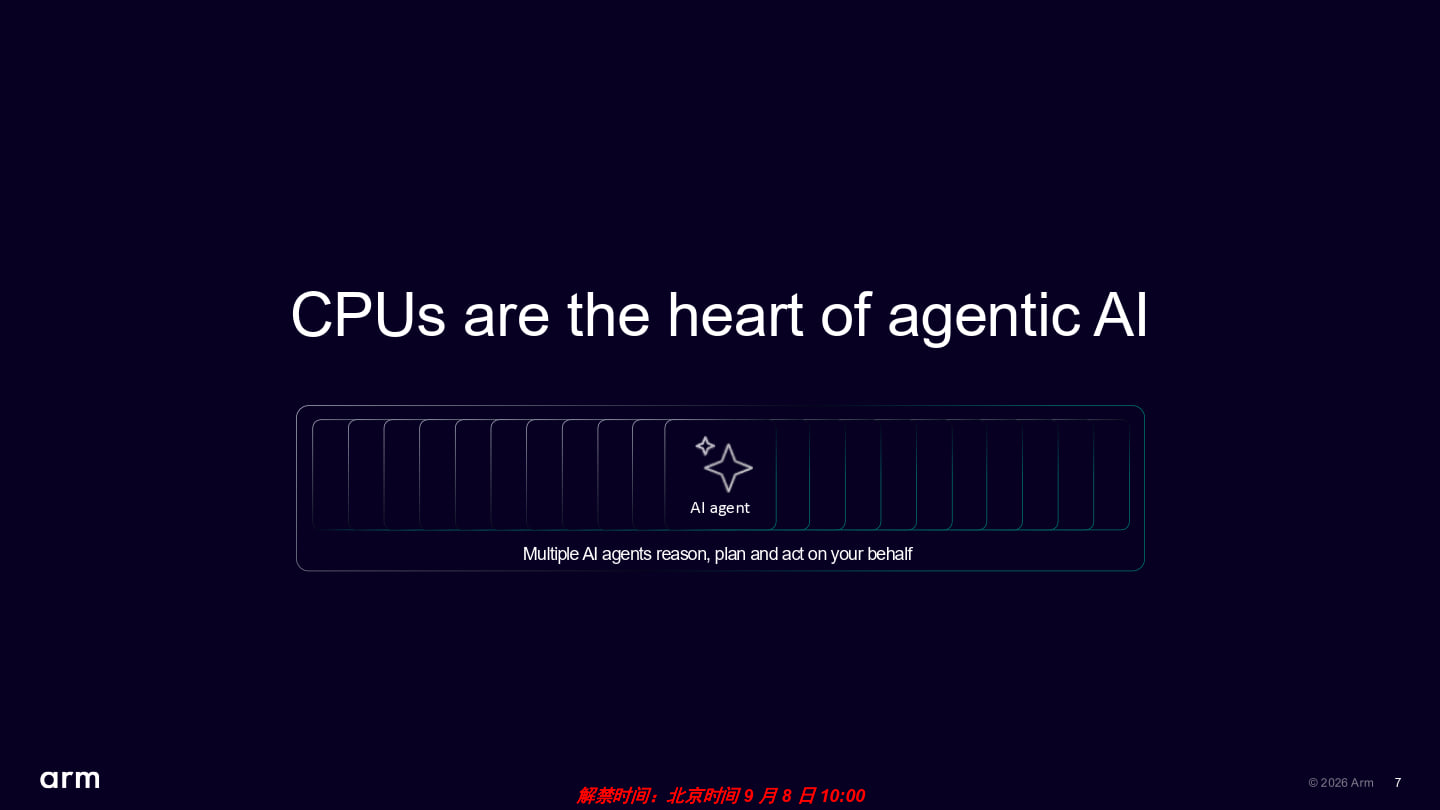
由於代理式AI需要更多「代理人」操作應該程式、AI工具,因此需要更多處理器核心與運算資源,James McNiven提出CPU是代理式AI中心的觀點。

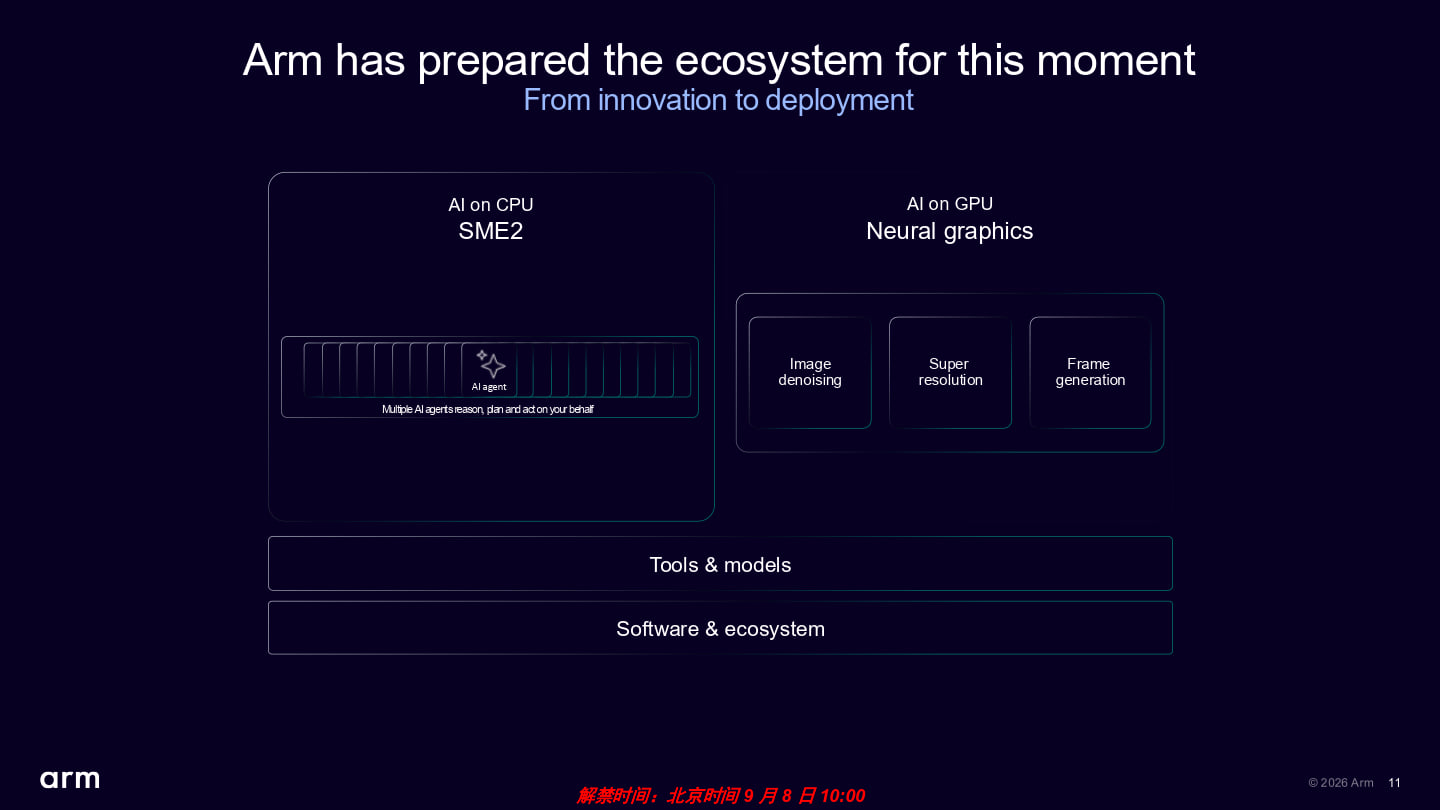
CSS for Mobile 2整合CPU中的SME2引擎、GPU中的AI加速器,以及豐富的工具、AI模型、軟體,透過完整的軟體堆疊協助生態系夥伴加速AI轉型與部署。

行動裝置上的AI功能也從傳統的機器學習影像辨識轉進到生成式AI與代理式AI,讓體驗由「得到答案」進化到「自動完成工作」。

代理式AI的運作流成可以分為感知(Perceive)、記憶(Remember)、推理(Reason)、行動(Act)等階段,對CPU的運算資源需求隨之升高。而其中統整各階段順利進行的編排(Orchestration)工作也仰賴CPU進行。

Arm也推出更多藉由AI加速的神經繪圖功能,筆者將在後續文章中詳細介紹。

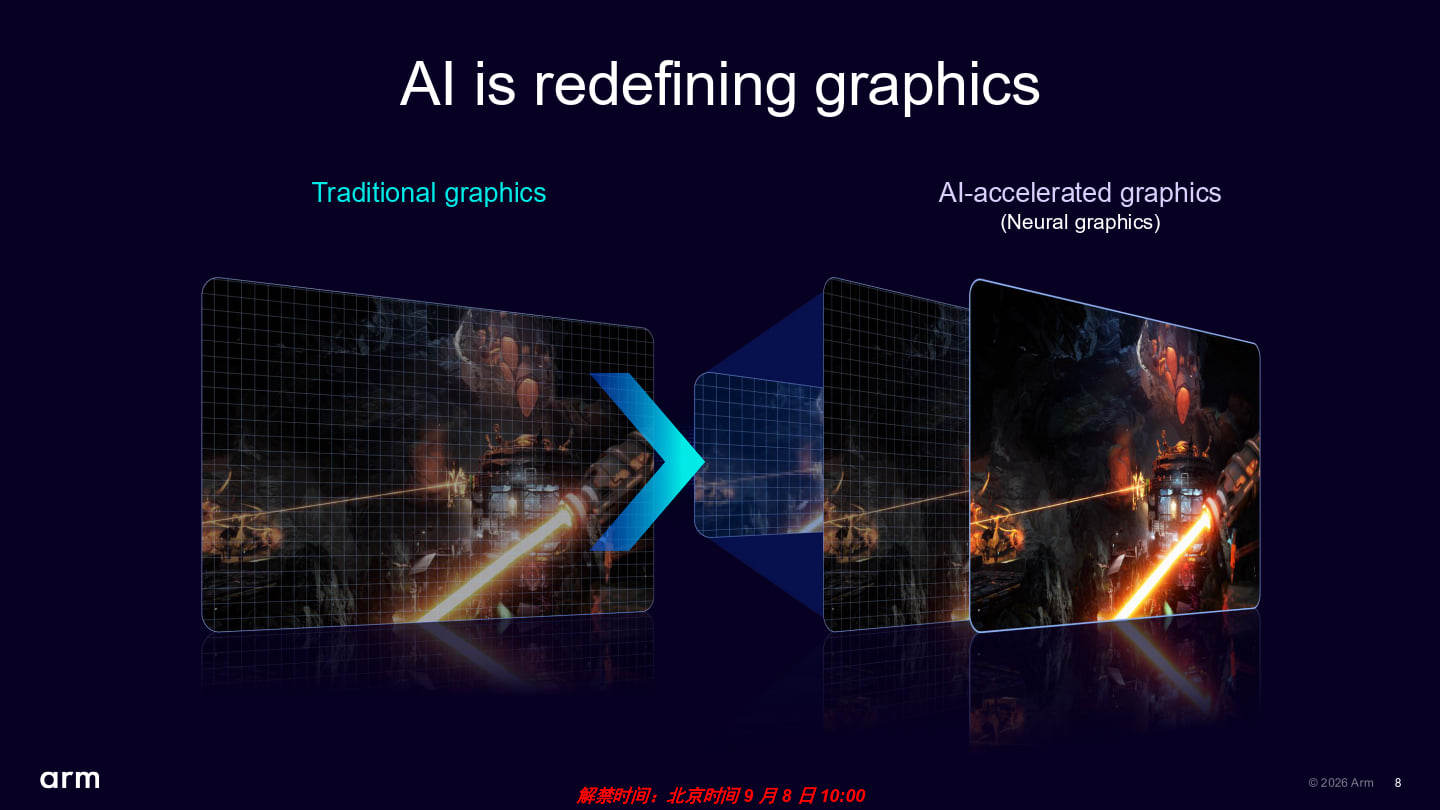
由AI加速的神經繪圖有助於提高遊戲的解析度、複雜幾何、逼真性,將桌上型電腦的遊戲體驗帶至行動裝置。

強化CPU的AI運算效能、也不忘GPU

James McNiven再次說明CPU在行動裝置執行AI應用程式的重要性。首先他提到目前有99%的行動裝置搭載Arm架構CPU,因此在CPU上進行AI推論運算有著明顯的相容性優勢,再加上CPU具有最高的可程式化性質,能夠透過軟體方式支援所有資料類型的浮點數運算,且因為資料可以直接在CPU完成運算,不需搬移至外部GPU或NPU(神經處理器),因此具有延遲較短的優勢。

Arm在CSS for Mobile 2中整合2組SME2引擎(Scalable Matrix Extension 2,第2代可擴展矩陣延伸指令集,主要功能為強化AI運算效能),較前代提供2倍的運算能量,對於AI應用程式有著絕對的助益。

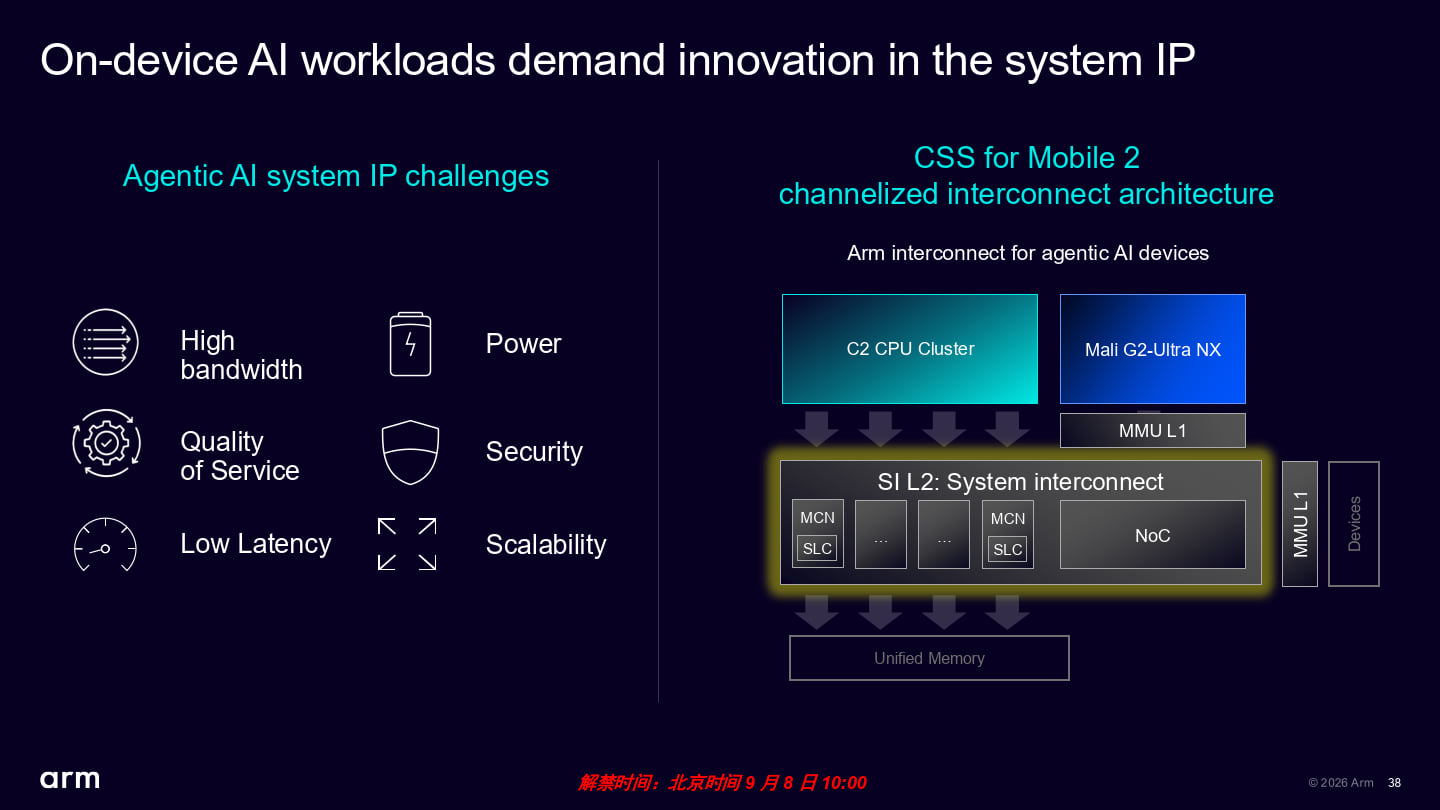
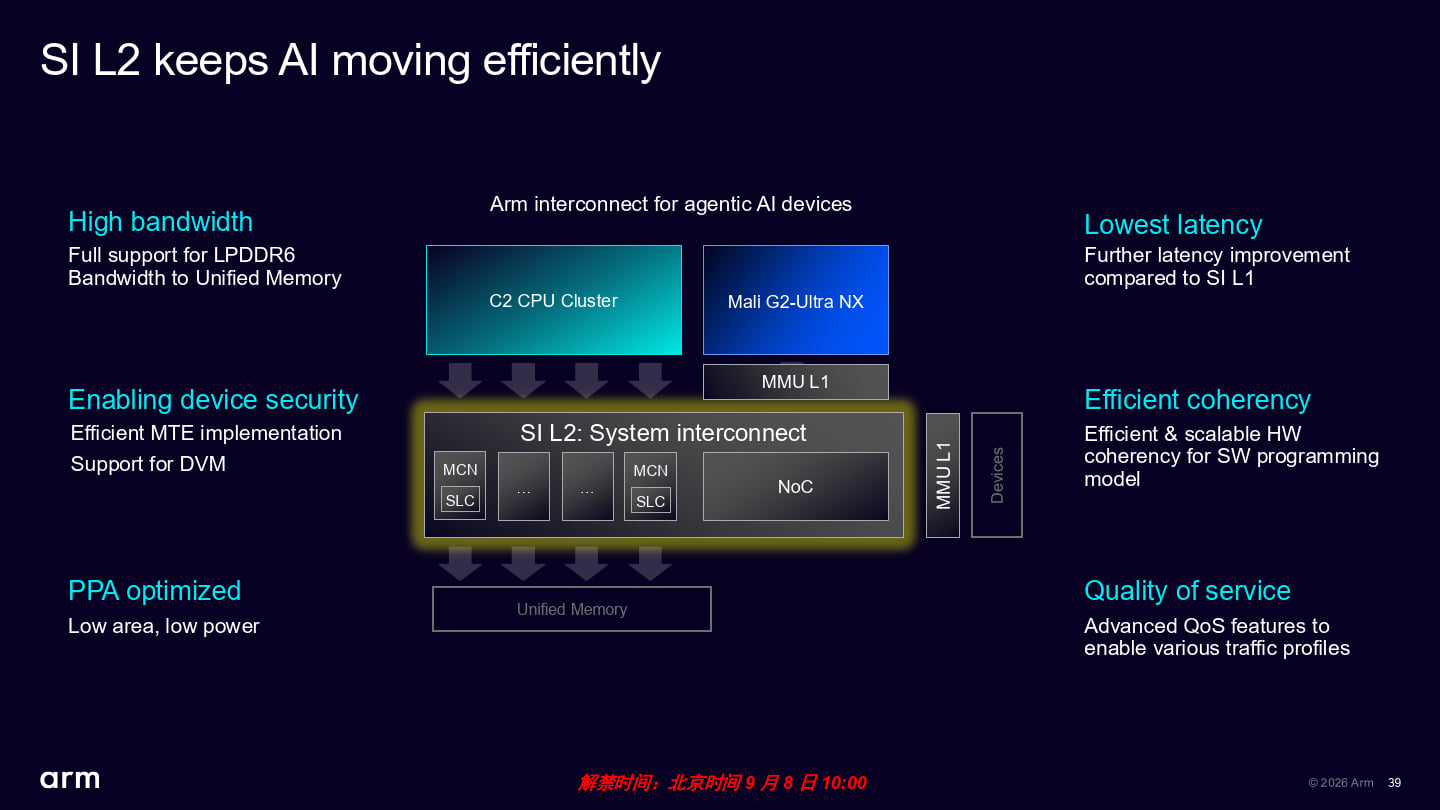
另一方面,代理式AI也將推高系統對記憶體頻寬與延遲的需求,也需要流量控管、功耗、資安、擴展性等功能的改善,對此Arm也推出SI L2系統互連功能因應需求。它最大的改進為在保留支援DDR5、LPDDR5x記憶體的同時新增支援LPDDR6,能為客戶確保硬體搭配的彈性,也能搭配傳輸速度更快的記憶體以改善效能,SI L2也對PPA(Performance效能、Power功耗、Area晶片面積)最佳化,以改善系統的綜合效能並控制成本。

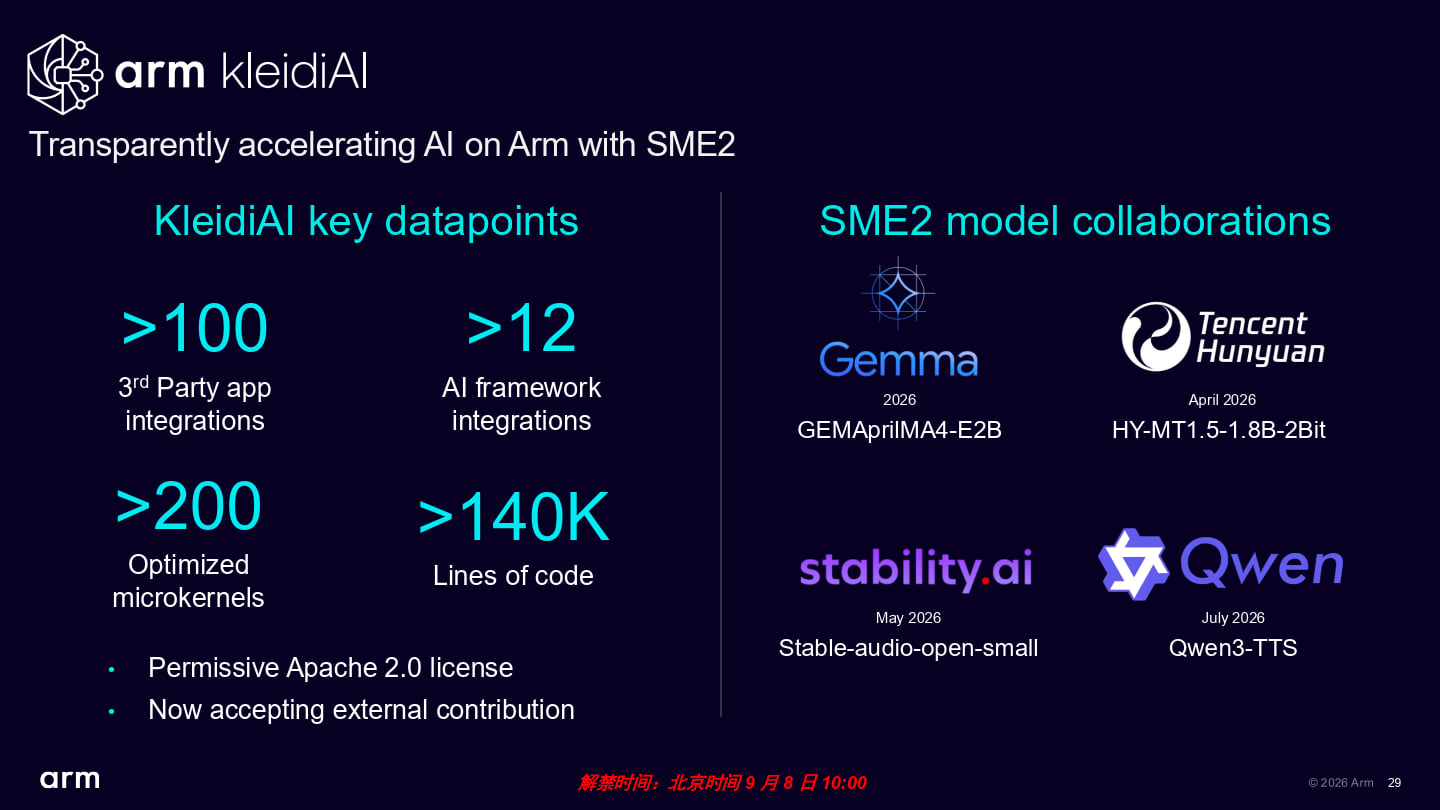
在軟體部分,CSS for Mobile 2同樣支援KleidiAI函數庫,提供與主流AI框架深度整合的開發環境,並可在程式執行時自動調用系統中最適合的CPU、SME2、GPU、NPU等不同的運算單元,充分發揮系統效能。

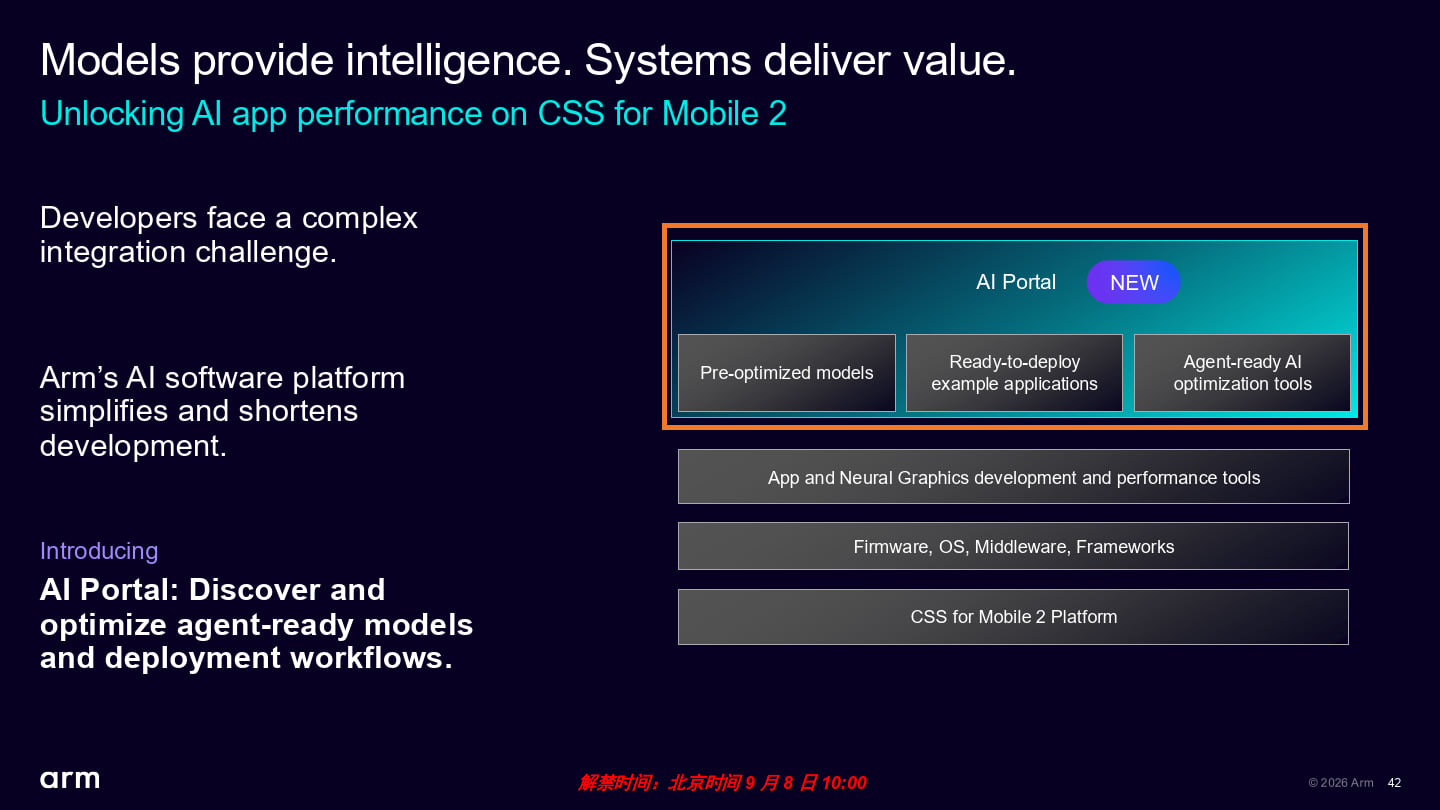
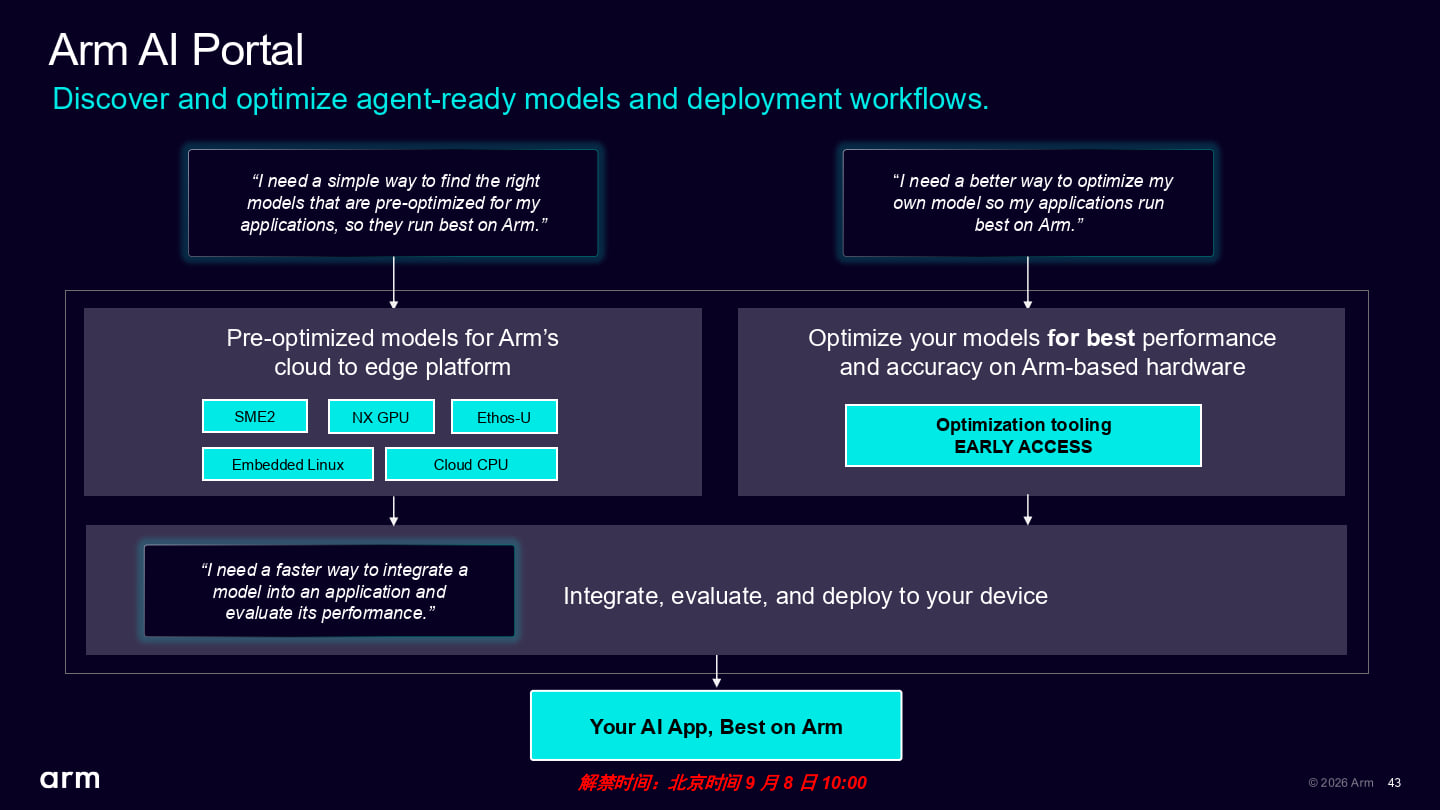
此外Arm也推出全新AI Portal工具,提供經過驗證且預先最佳化模型以及範例程式,協助開發者快速導入AI應用程式,加速從評估到部署的完整開發流程。對於自有模型而言,也可以透過早期預覽版(Early Access)模型最佳化工具,協助開發者對目標裝置進行最佳化。

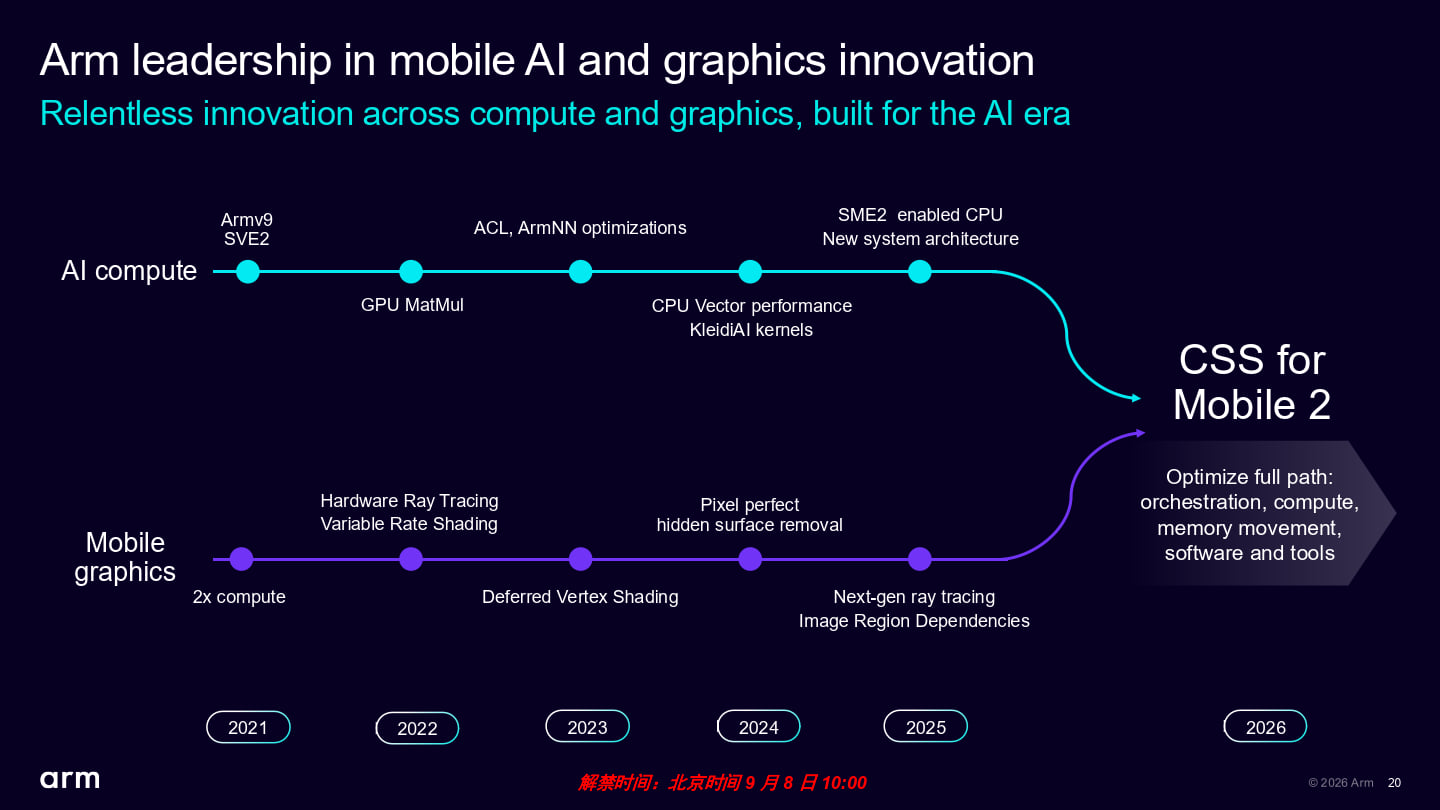
回顧Arm CPU與GPU的發展軌跡,許多AI加速運算與光線追蹤繪圖等技術最終匯流至CSS for Mobile 2。

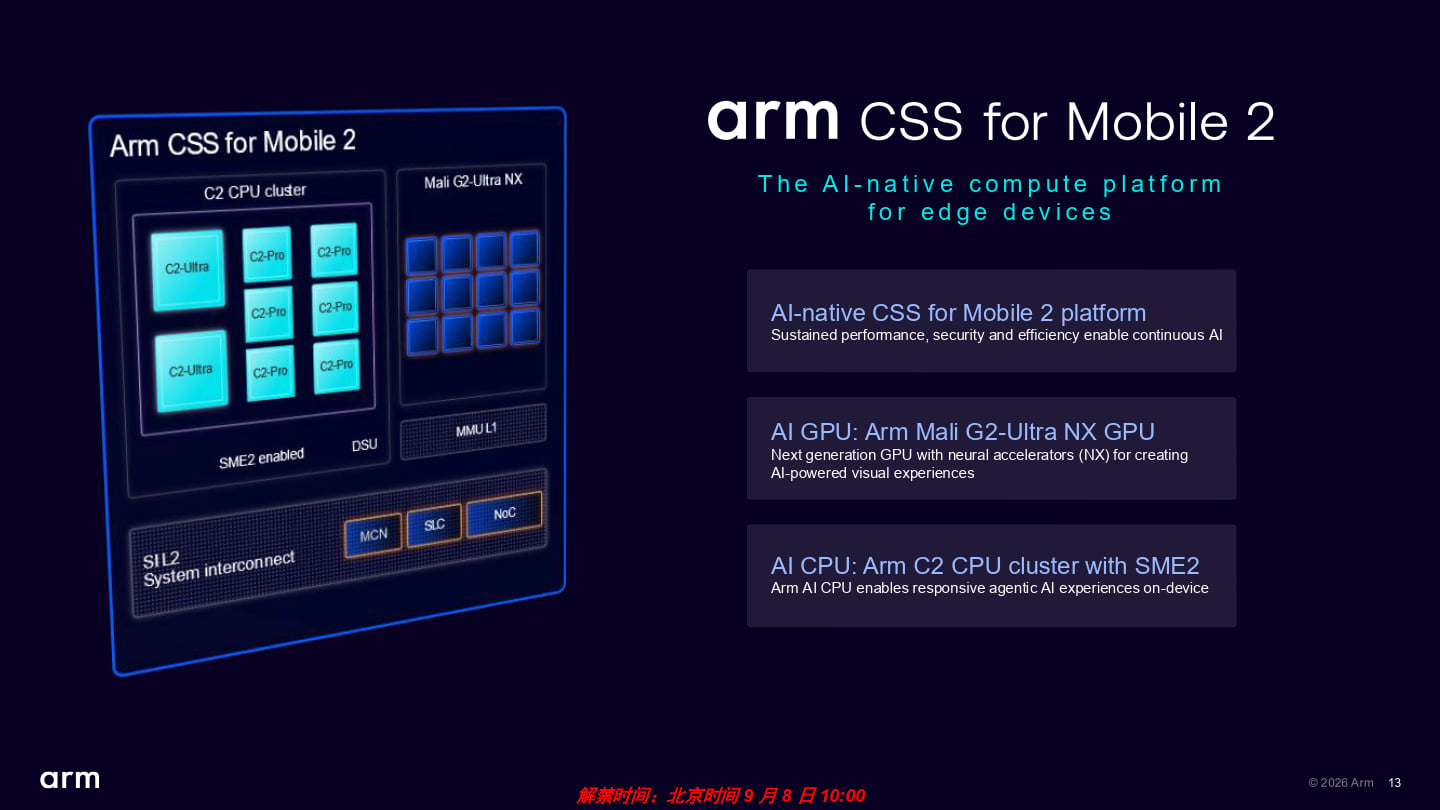
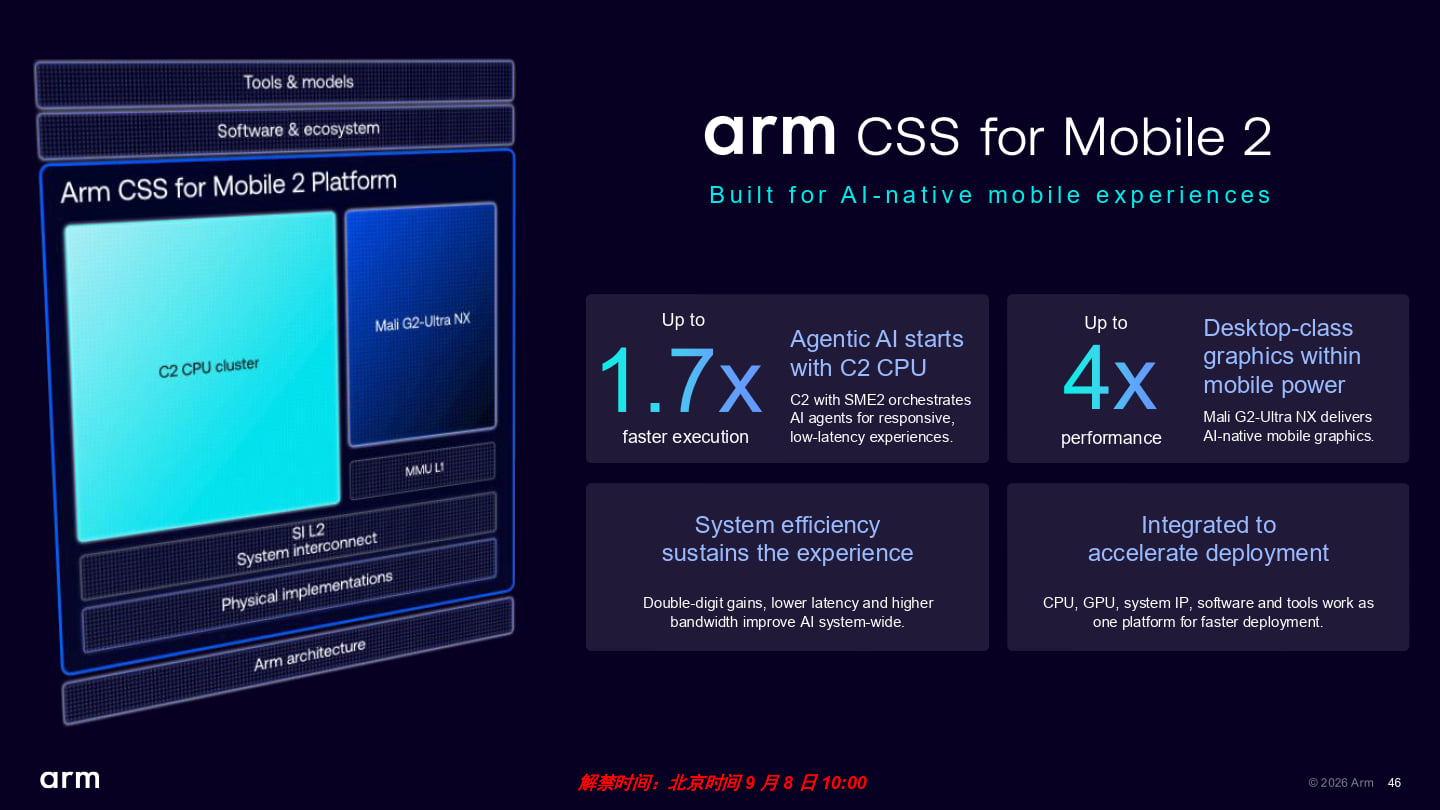
身為AI原生平台,CSS for Mobile 2運具有SME2加速功能的C2 CPU叢集、全新Mail G2-Ultra NX GPU。

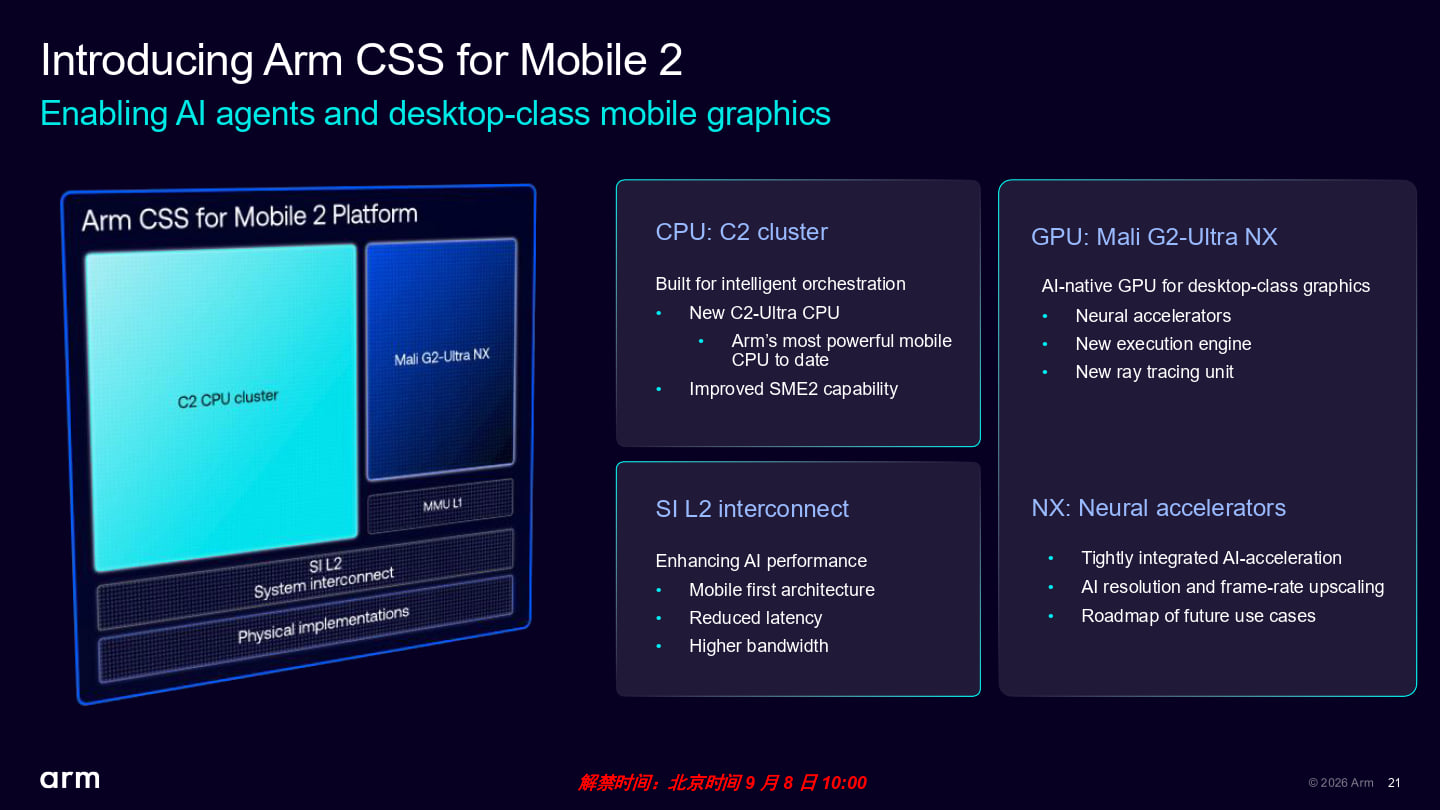
CSS for Mobile 2中的C2 CPU叢集包含最新的處理器以及SME2單元,Mail G2-Ultra NX GPU具有更強大的執行單元、光線追蹤單元、神經加速器。而SI L2互連單元則專為行動裝置設計,帶來更高的頻寬與更低的延遲。

C2 CPU叢集搭配SME2能夠透過異質運的方式完成代理式AI的工作流程,還可搭配GPU、加速器(包含NPU或其他種類)、雲端算力等方式帶來更豐富的AI功能。

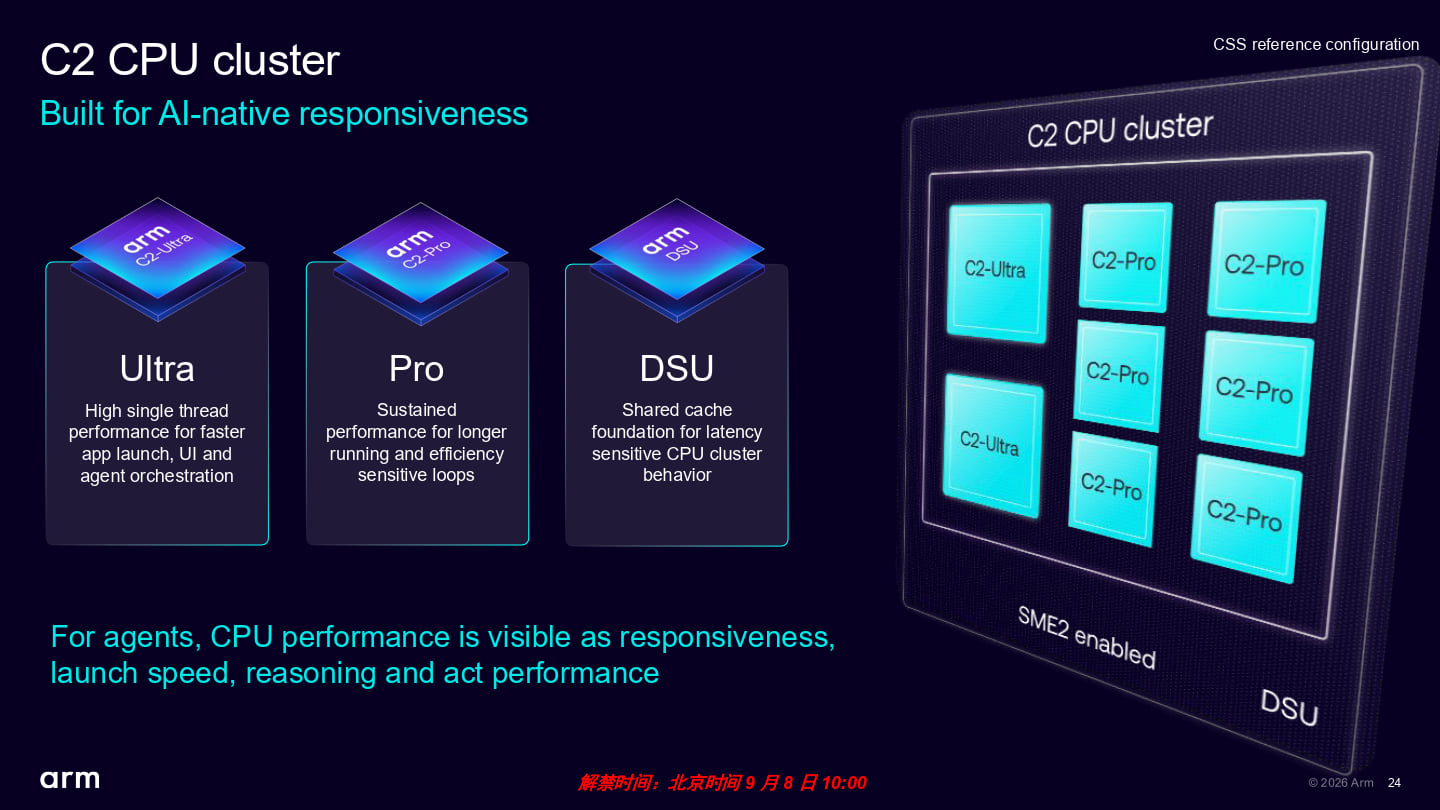
CSS for Mobile 2世代具有全新的C2-Ultra與改良的C2-Pro CPU核心,以及DSU動態分配單元(DynamIQ Shared Unit)。本世代並沒有新款「Nano」等級的輕量核心。

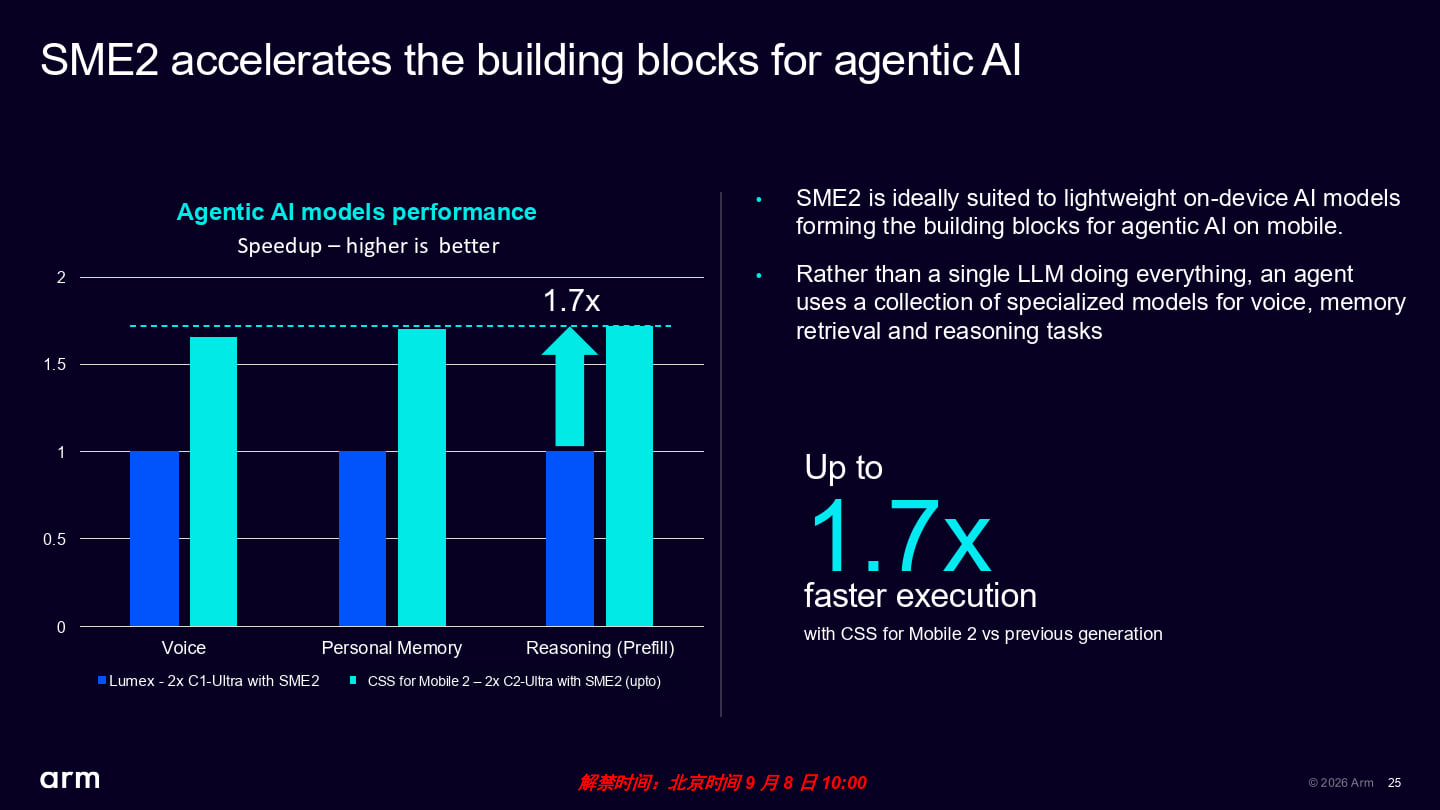
SME2單元相當適合執行裝置端的輕量AI運算,與前代產品相比,在特定運算負載的效能增益達到70%。

SME2能在搭配KleidiAI函數庫開發的AI應用程式發揮最佳化效能,包含GEMAprilMA4-E2B、Hunyuan HY-MT 1.5-1.8B-2Bit等模型也與SME2深度合作。(值得注意的弦外之音是能夠部署參數量達2B以及2Bit精度資料類型的AI模型)

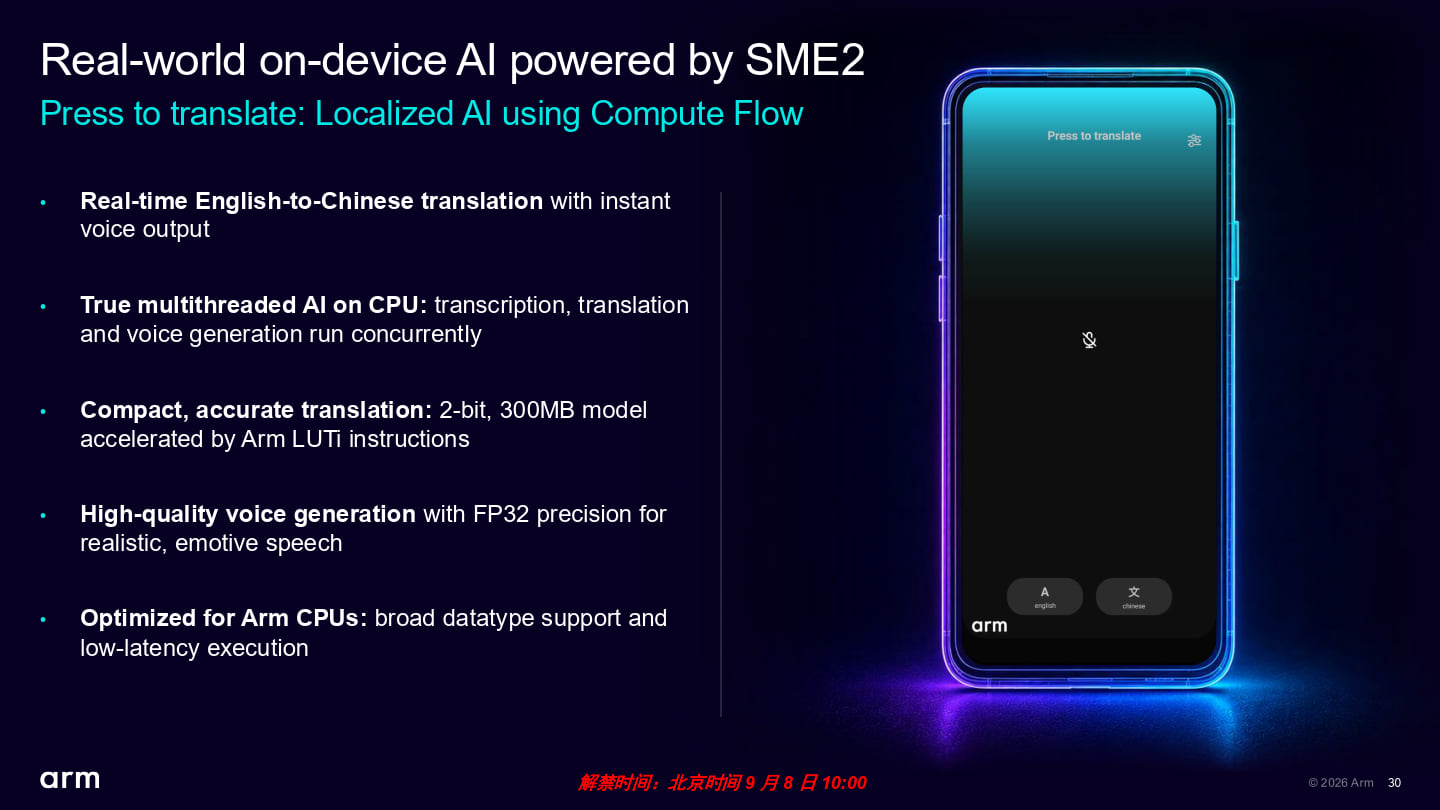
活動中也展示在手機上進行英文語音翻譯為中文語音的展示,使用者對著手機說英文,系統能立刻輸出與原本語調接近的中文語音。過程在CPU上執行語音轉文字、文字翻譯、文字轉語音等3組AI推論運算。

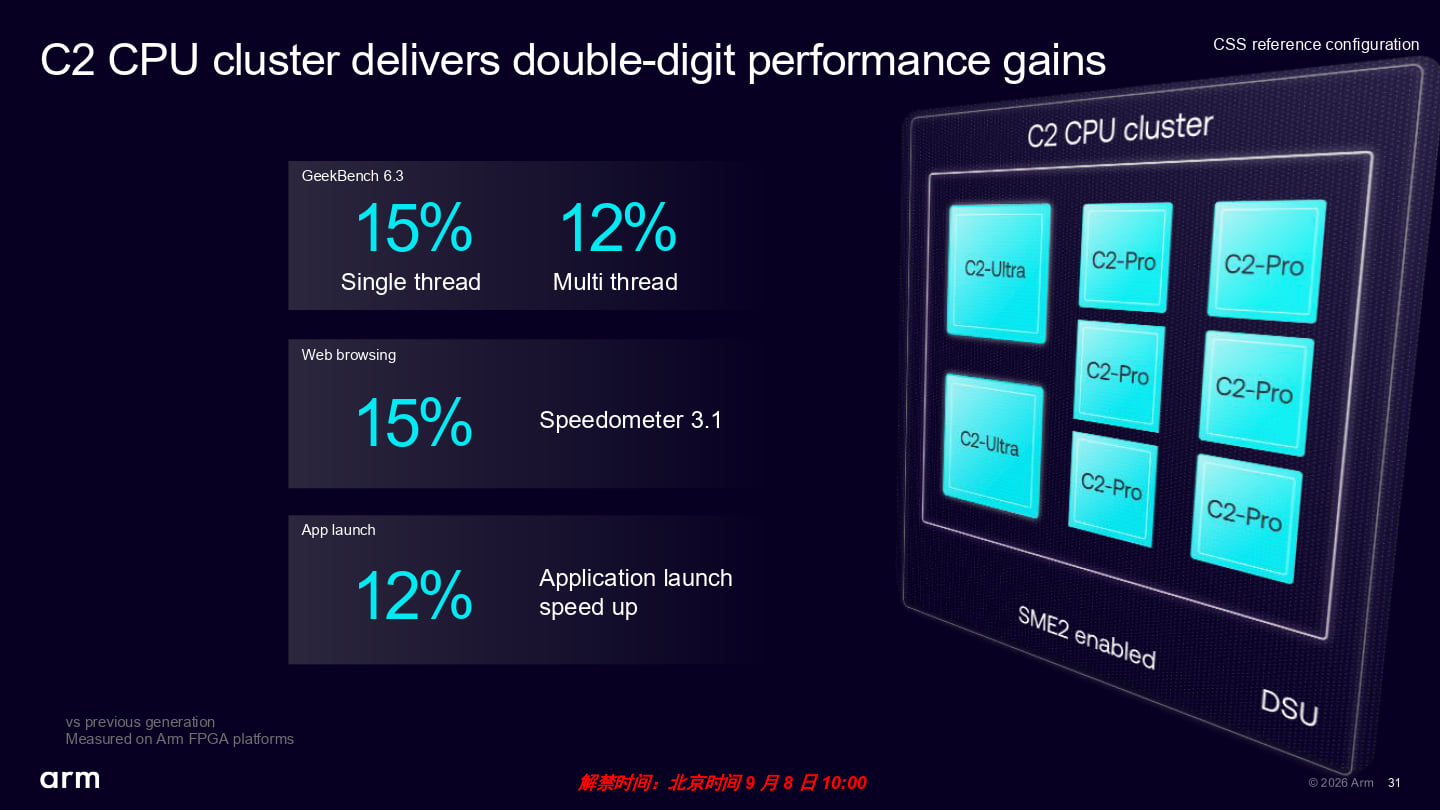
根據Arm提供的數據,搭載2組C2-Ultra核心與8組C2-Pro核心的參考平台與前代產品相比,GeekBench 6.3的單、多核心效能增益達到15%、12%,網頁瀏覽與App啟動效能也提升15%、12%。

CSS for Mobile 2導入首款AI原生的Mali G2-Ultra NX GPU,具有全新執行單元、第3代光線追蹤單元、專為在1 W功耗條件下運作的神經加速器。

Mali G2-Ultra NX GPU提供NSS、NFRU、NSSD等升頻技術,透過超解析度與畫格生成等方式提升遊戲體驗與畫面流暢度。

同時使用NFRU、NSSD升頻技術後,能讓遊戲FPS效能提高至4倍,將記憶體頻寬用量降低至30%,耗電量降低至25%。

根據Arm提供的數據,Mali G2-Ultra NX平均效能提升達20%,遊戲效能提升最高達14%,光線追蹤的記憶體頻寬用量降低13%。

代理式AI會帶來高頻寬、低延遲、流量控管、功耗、資安、擴展性等挑戰,對系統的互連也是一大考驗。

SI L2系統互連針對PPA進行最佳化,除了支援DDR5、LPDDR5x之外,也支援LPDDR6,有助於提高記憶體頻寬。

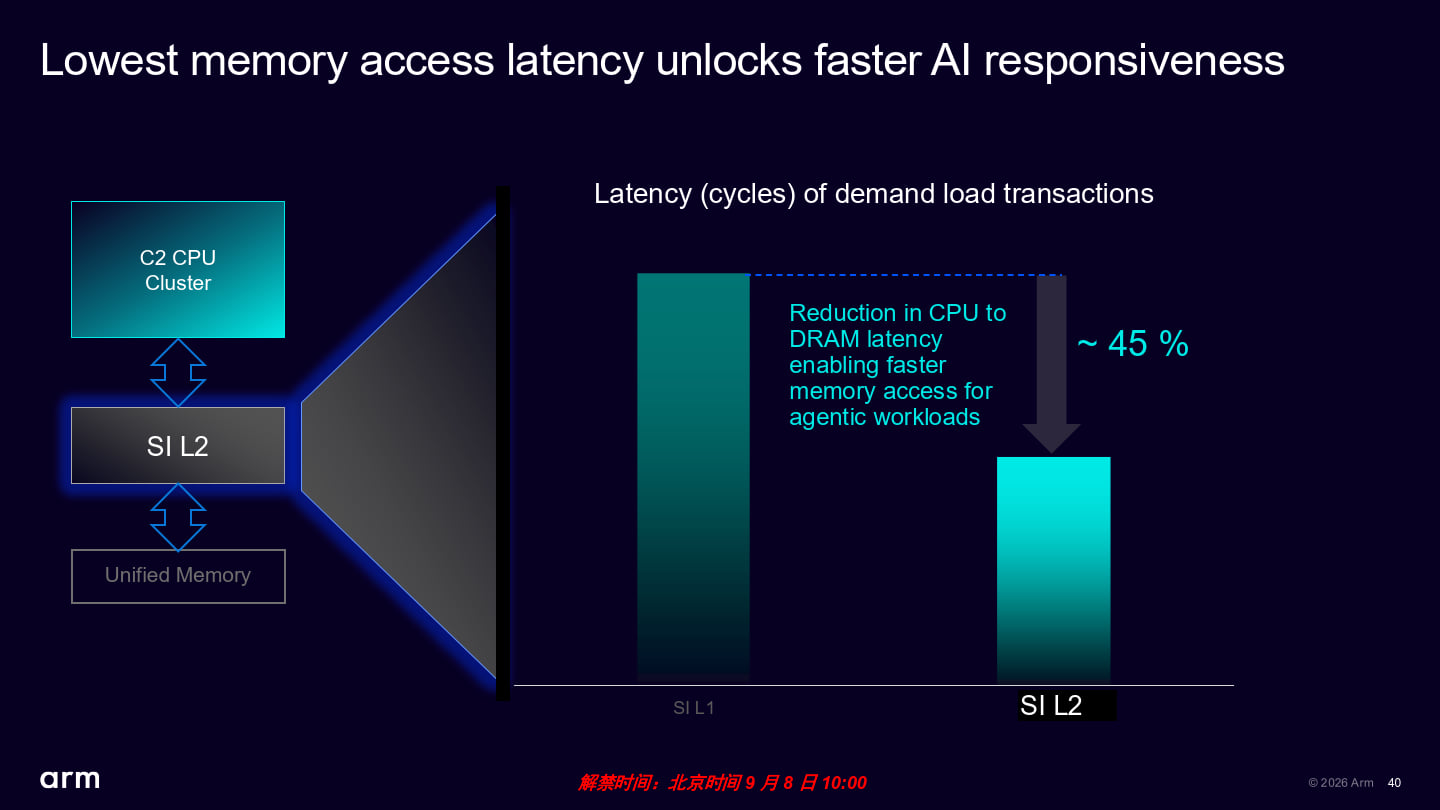
做為CPU與統一架構記憶體中介的SI L2系統互連,能在執行代理式AI時降低45%記憶體延遲,有助於改善效能表現。

Arm也推出AI Portal工具,不但提供預先最佳化模型以及範例程式,也具有代理式AI效能最佳化工具。

開發者可以直接使用AI Portal提供針對SME2、NX GPU、Ethos-U NPU等運算單元最佳化的模型,也可以自行針對不同軟硬體使用情境微調。

整體而言,CSS for Mobile 2帶來最高1.7倍代理式AI效能與4倍遊戲FPS效能,並透過完整軟、硬體堆疊協助生態系夥伴加速AI部署。

在這篇文章中瞭解CSS for Mobile 2的特色後,筆者也會在後續文章中繼續介紹C2-Ultra、C2-Pro等CPU以及G2-Ultra NX GPU,請讀者參考下方目錄繼續閱讀。

Arm Tech Day 2026系列文章目錄
CSS for Mobile 2帶來全新C2-Ultra CPU、G2-Ultra NX GPU,強化手機代理式AI與主機級光線追蹤遊戲體驗(本文)
C2-Ultra CPU進化支援台積電2奈米製程,強化更接地氣的代理式AI助手功能(工作中)
G2-Ultra NX GPU搭配多種神經繪圖升頻技術,在2 W功耗條件下帶來電腦級遊戲體驗(工作中)

加入T客邦Facebook粉絲團
✇T客邦-Techbang

NVIDIA DLSS 5神經渲染效能實測:畫質有感提升但FPS效能砍半

NVIDIA在DLSS 5升頻技術中導入神經渲染功能,可以透過AI圖像生成的方式強化遊戲的紋理與光影等影像細節,讓我們一起來看看它的效果並實測對效能的影響。8a94f70761065402267bd71c4db82ae8

NVIDIA在DLSS 5升頻技術中導入神經渲染功能,可以透過AI圖像生成的方式強化遊戲的紋理與光影等影像細節,讓我們一起來看看它的效果並實測對效能的影響。

(本文使用之《NBA 2K27》序號由NVIDIA提供)

AI幫你開美肌

NVIDIA DLSS是款結合多樣AI與機器學習的升頻技術,能夠提供提升遊戲FPS效能以及強化畫質的效果。在最新推出DLSS 5除了延續先前既有的超解析度(Super Resolution)與畫格生成(Frame Generation)等功能之外,還加入了全新的神經渲染(Neural Rendering)功能,透過AI演算法生成畫面上指定物件或區域的材質紋理與光照效果。更詳細的解說請參考下方專題報導。

延伸閱讀:
NVIDIA DLSS 5技術解析:不再只是效能禁藥,AI美肌強化紋理與光影效果
玩遊戲不再有鬼影!NVIDIA 推出 DLSS 4.5 光線重建功能 全系列 RTX 顯卡都能戰
NVIDIA DLSS 4.5光線重建實測,強化光線追蹤畫質效能不打折

筆者使用《NBA 2K27》進行實際測試,分析神經渲染帶來的畫質提升,以及所產生的效能衝擊。在畫質部分,透過Steam內建的擷圖功能擷取重播模式中的遊戲畫面,並開、關神經渲染功能進行對比。效能則是使用NVIDIA FrameView工具測量30秒遊戲進行中的FPS數據,測試2輪並確認沒有極端值之後,以取平均作為成績。

測試平台:
處理器:AMD Ryzen 7 9800X3D
散熱器:MSI MEG Coreliquid S360
主機板:ASRock X870E Taichi(UEFI版號:4.03.TS04 – AMD AGESA ComboAm5PI 1.2.7.1)
記憶體: G.Skill Trident Z5 Neo RGB 16GBx2(@DDR5-7200)
顯示卡:NVIDIA GeForce RTX 5090 Founders Edition
儲存裝置:Samsung 9100 Pro 1TB(系統碟)、Solidigm P41 Plus 1TB(遊戲碟)
電源供應器:MSI MEG Ai1300P PCIE5
軟體環境:Windows 11專業版25H2(Build 26200.9168),GeForce Game Ready 616.64測試版

▲《NBA 2K27》是款以NBA美國職業籃球為主題的體育遊戲,提供籃球之城、MyCAREER、MyTEAM等多種遊戲模式。

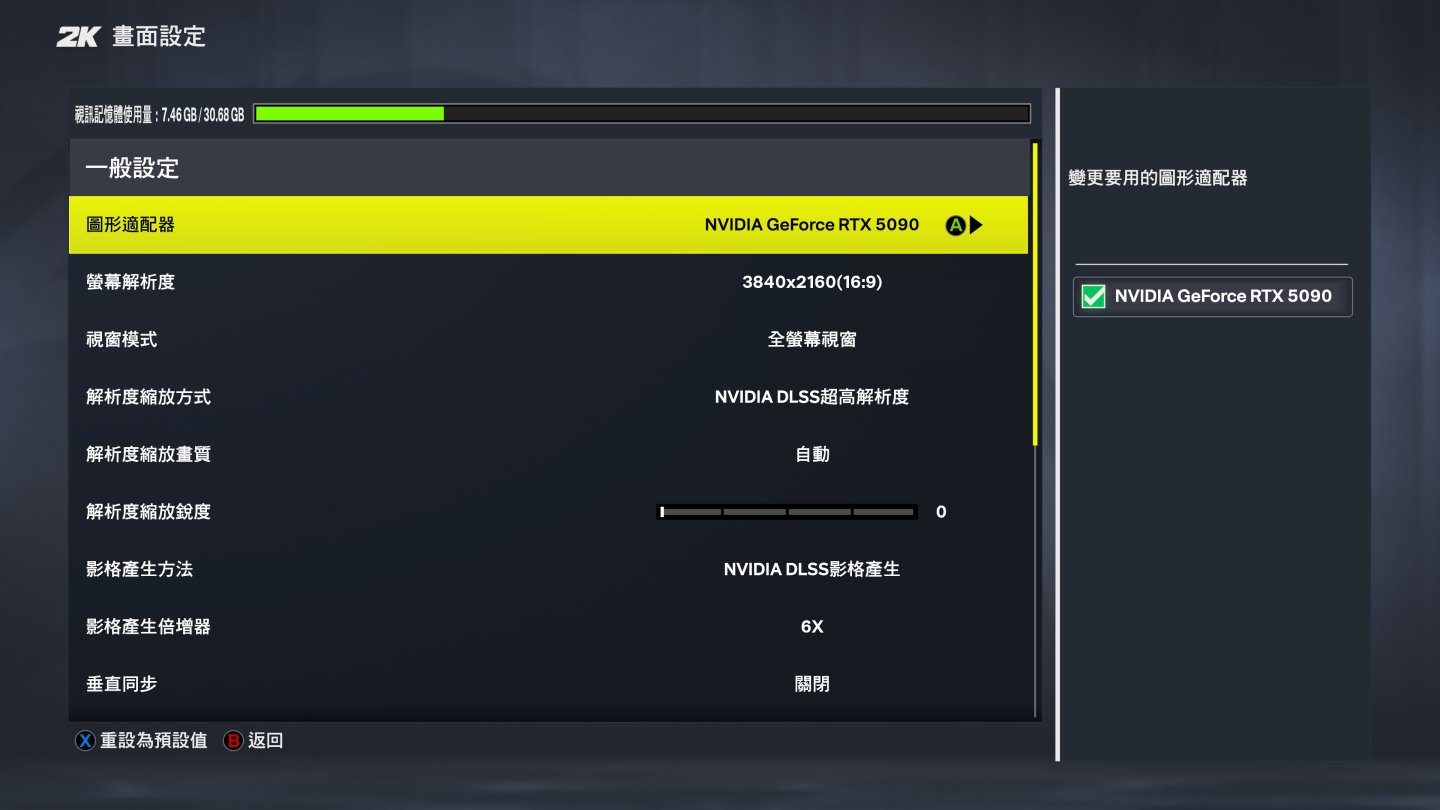
測試平台使用AMD Ryzen 7 9800X3D處理器搭配NVIDIA GeForce RTX 5090 Founders Edition顯示卡。

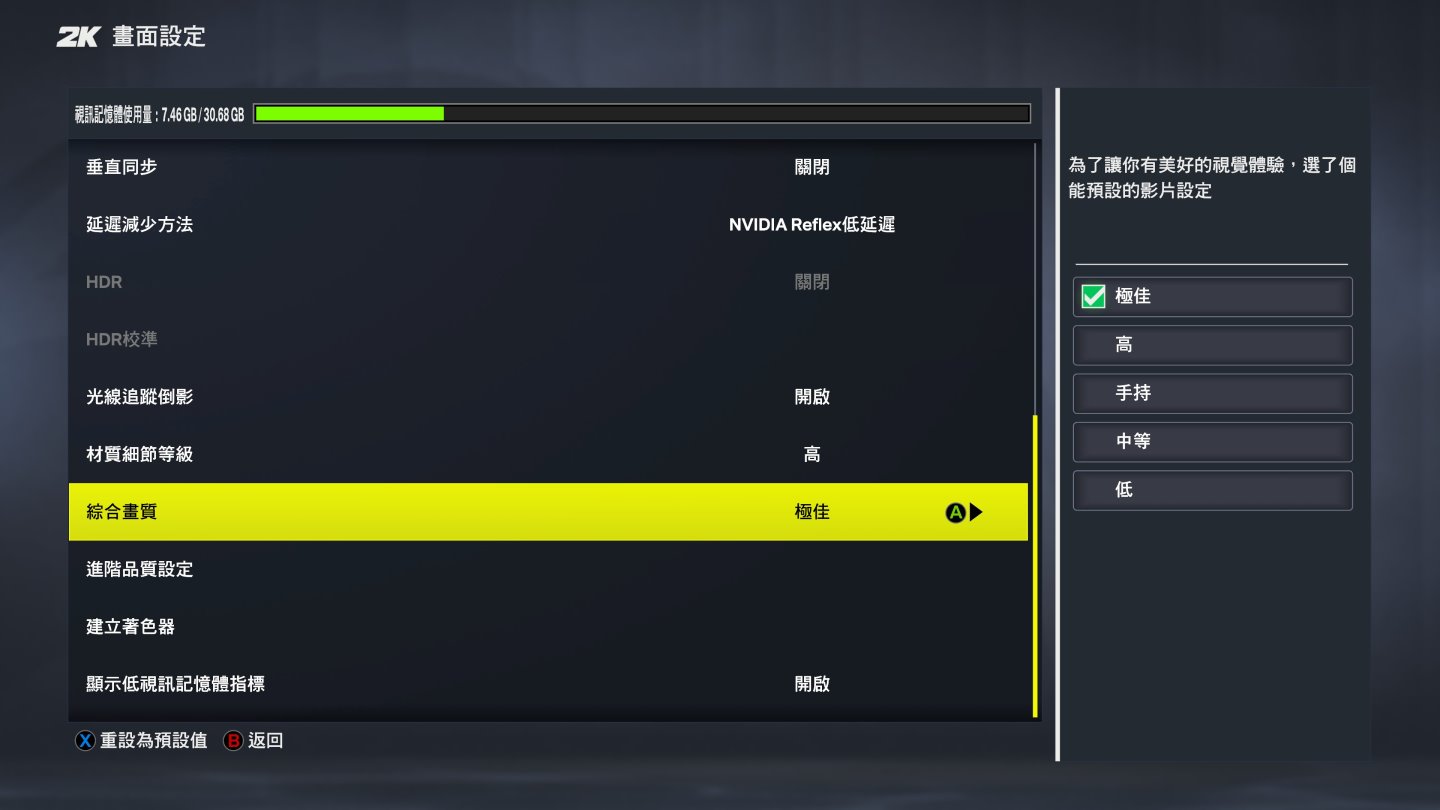
測試過程開啟光線追蹤功能並設定為最高畫質設定。

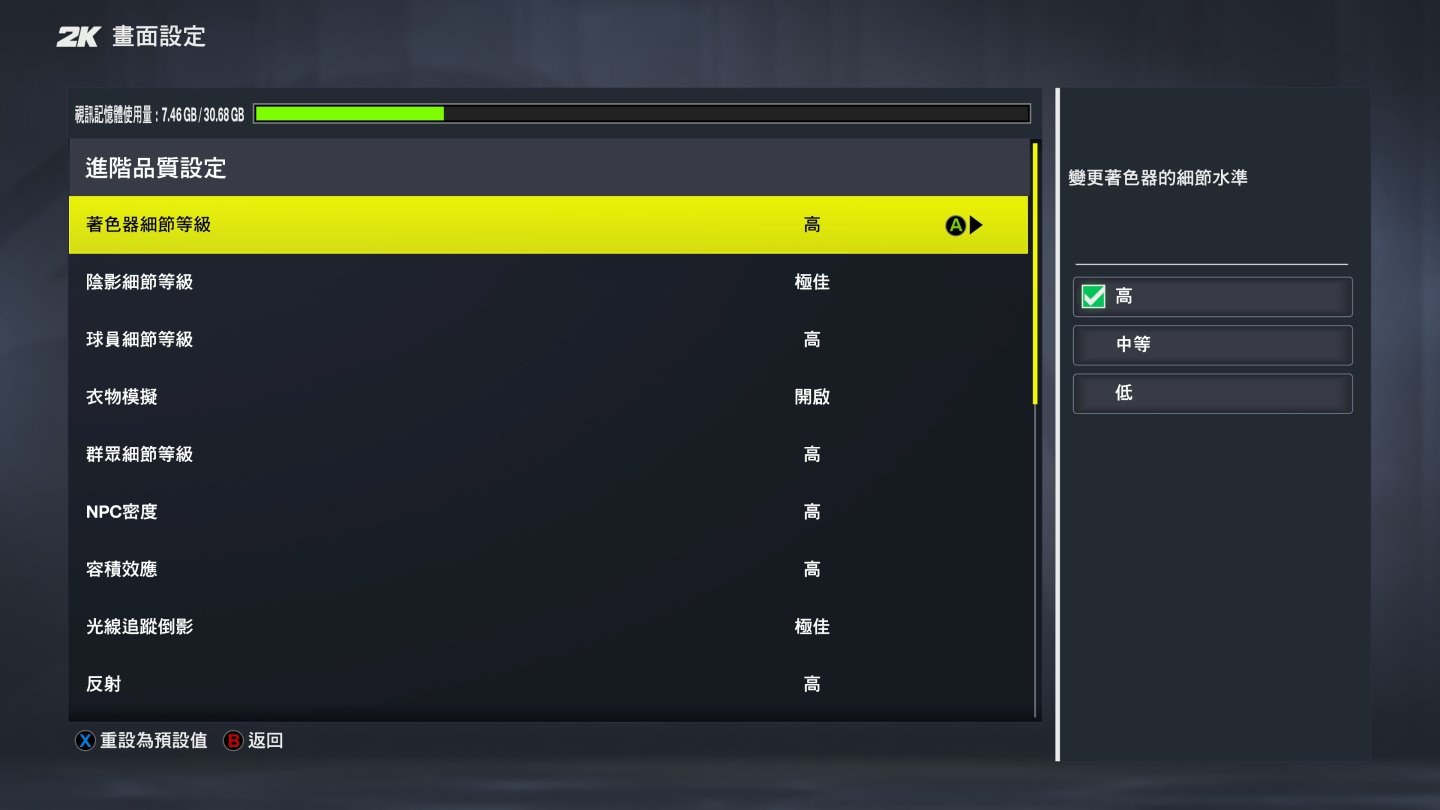
在進階品質設定中,將所有設定選項都調整至最高。

進階品質設定之二,同樣調整至最高。

神經渲染效能實測

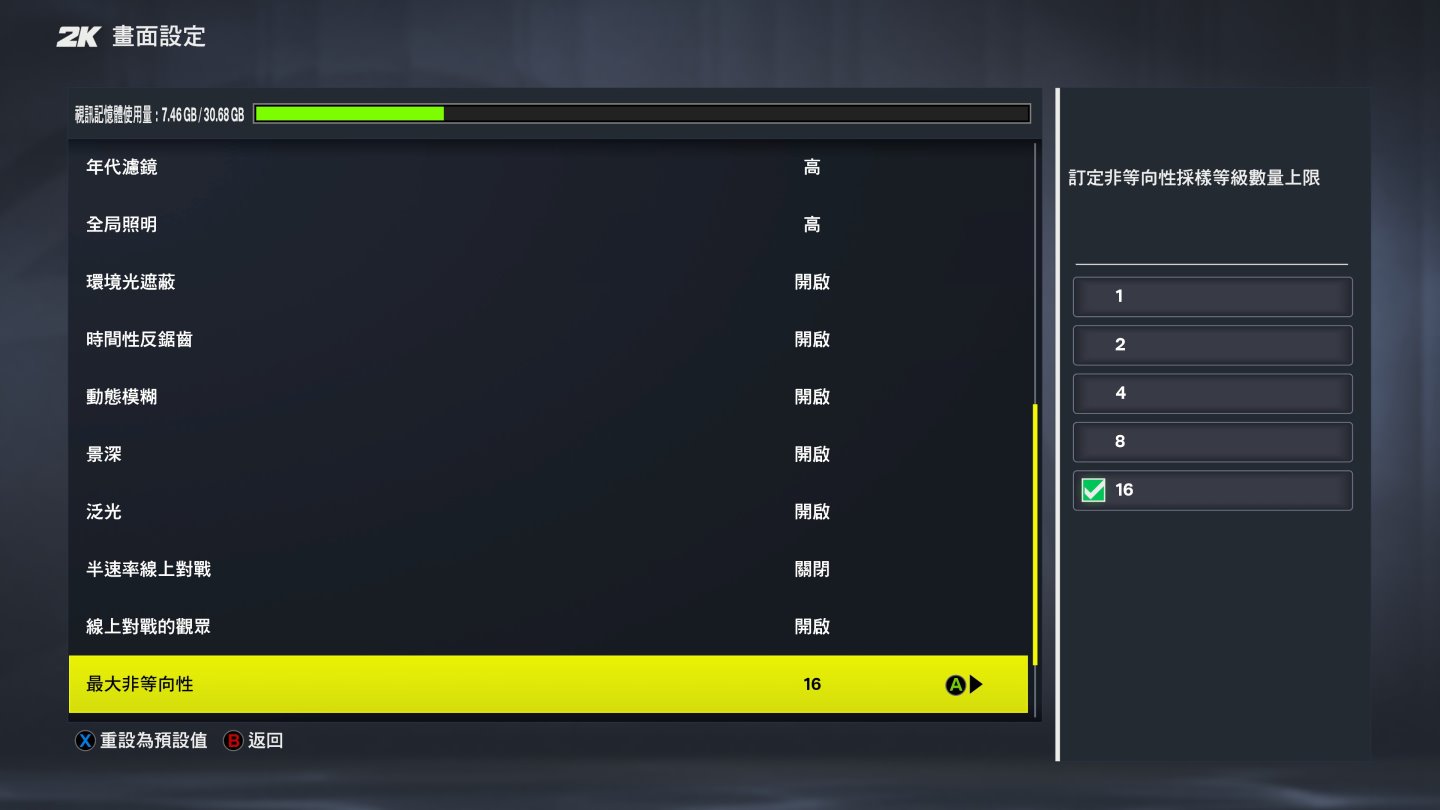
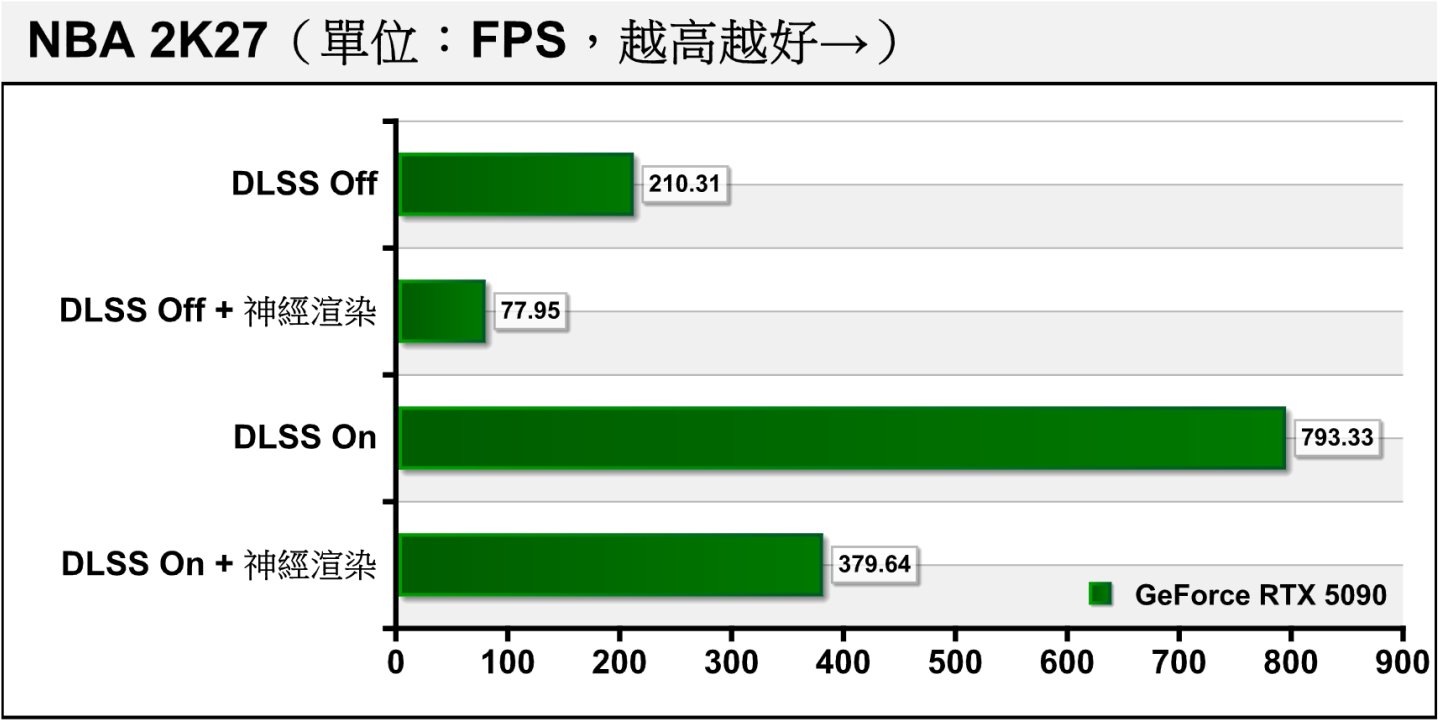
在測試過程中,筆者分別針對開、關超解析度(畫質設定為自動)與多重畫格生成(6X),以及是否啟用神經渲染(Neural Rendering)進行效能測試。並以圖片呈現在開啟超解析度與畫格生成的情況下,神經渲染造成的畫質差異。

值得注意的是,雖然開啟神經渲染會損失大約一半的FPS效能,但是在超解析度、畫格生成的協助下,遊戲的平均FPS仍達379.64幀,已經高於許多顯示器的規格,與其關閉神經渲染讓平均FPS衝上793.33幀,將多餘的效能轉換為肉眼可以分辨的畫質提升,也不失為改善遊戲體驗的方式。

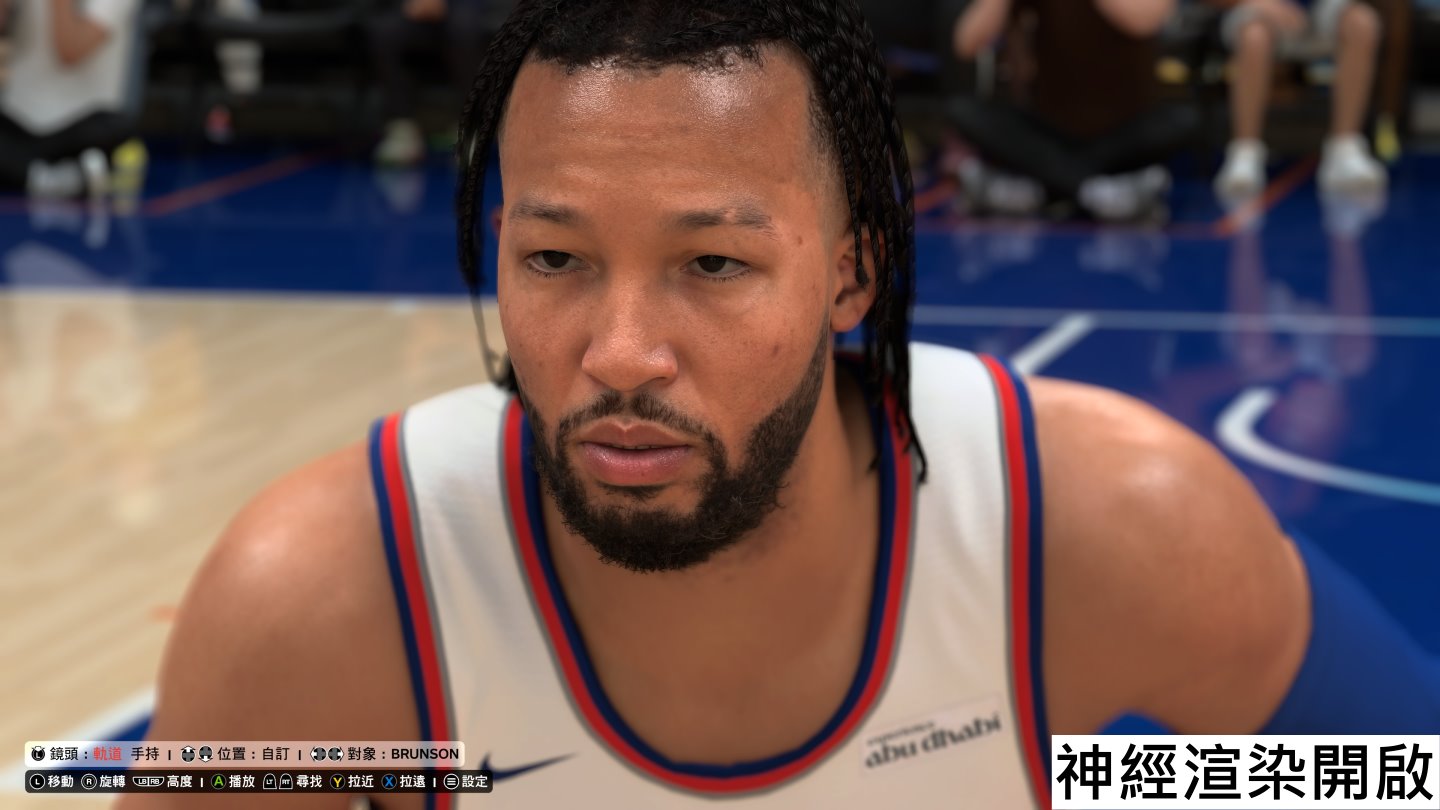
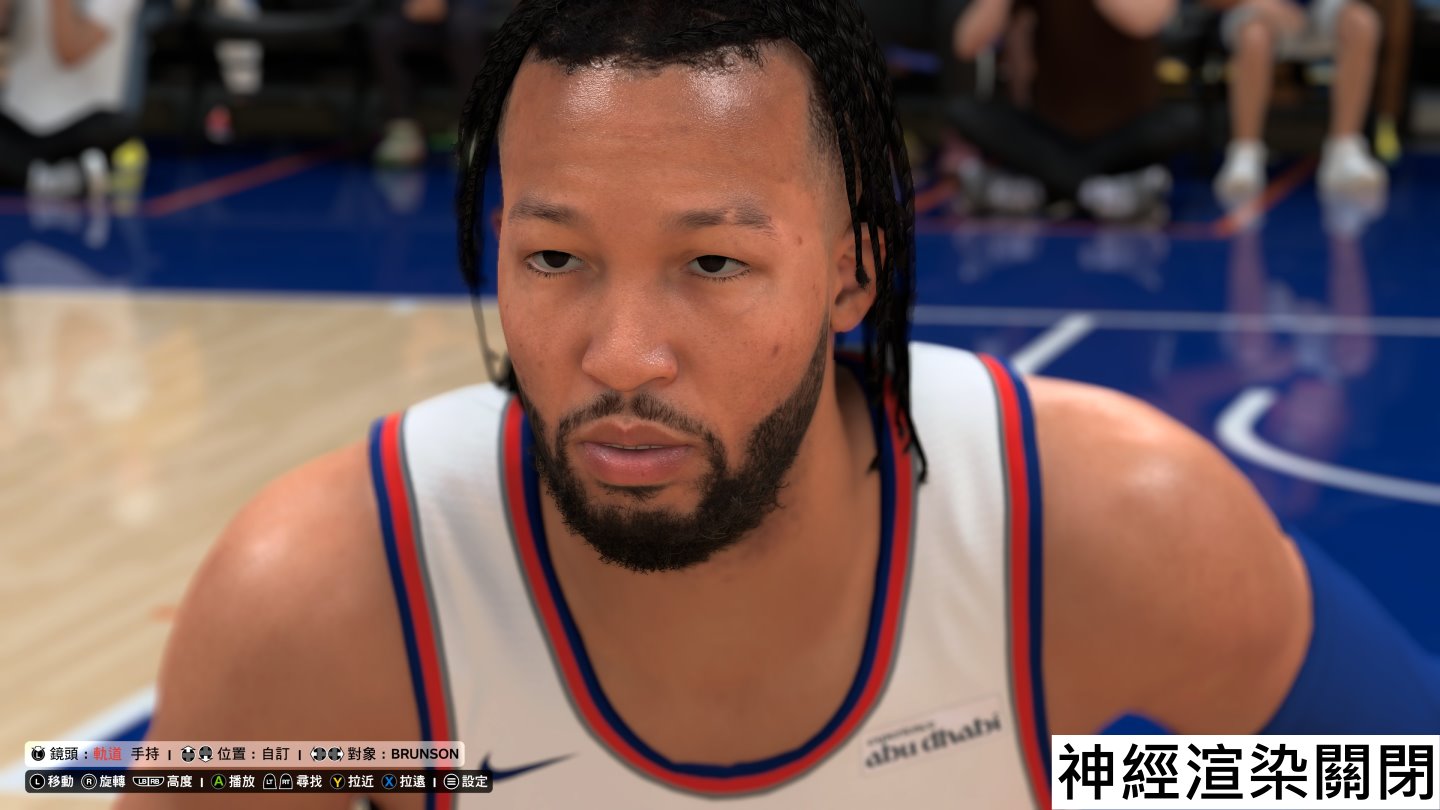
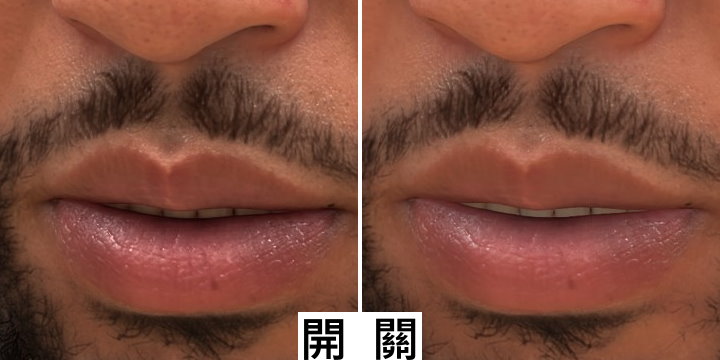
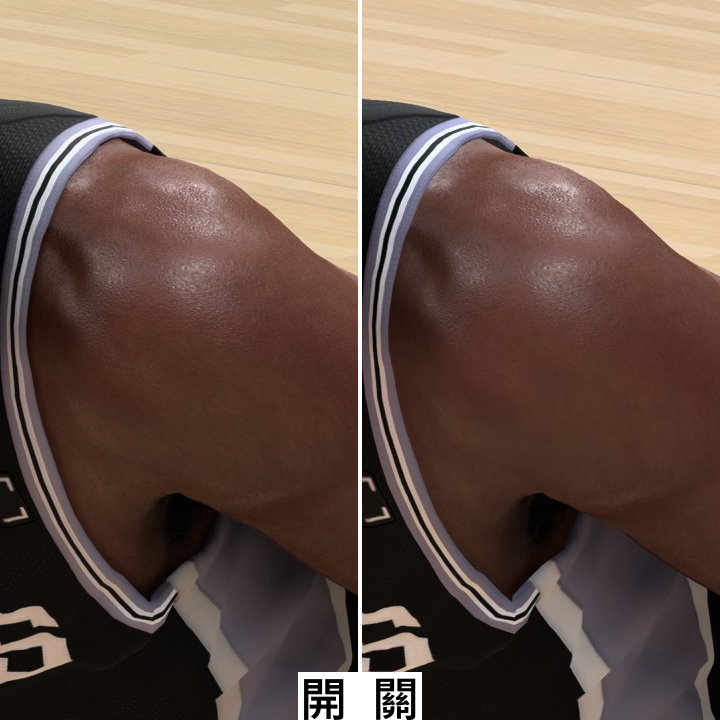
開啟神經渲染之後,人物皮膚、頭髮、鬍鬚等紋理以及光影等細節都有明顯提升。

在關閉神經渲染的時候,人物的細膩度有明顯差異。

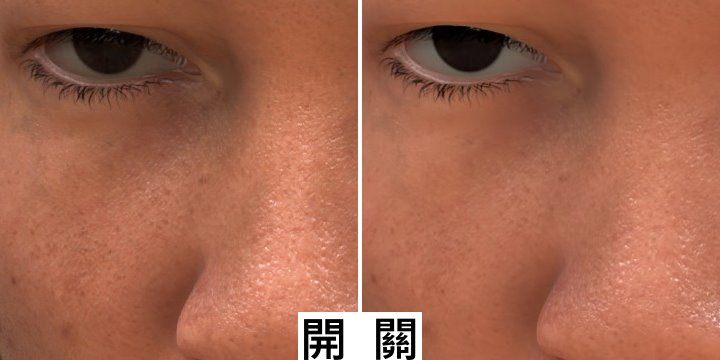
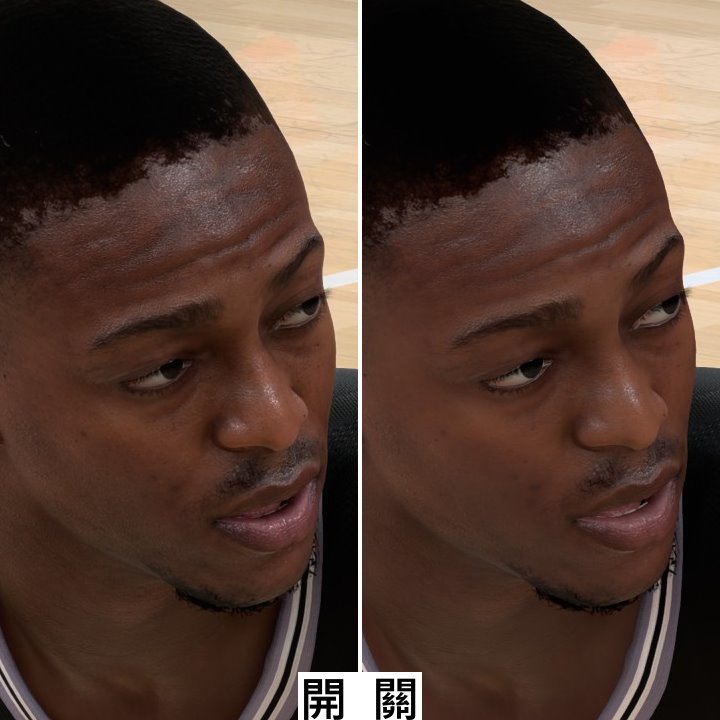
使用1:1方式裁切圖片,可以看到皮膚毛孔紋理的差異。

鬍鬚、嘴唇的差異也是肉眼就能分辨。

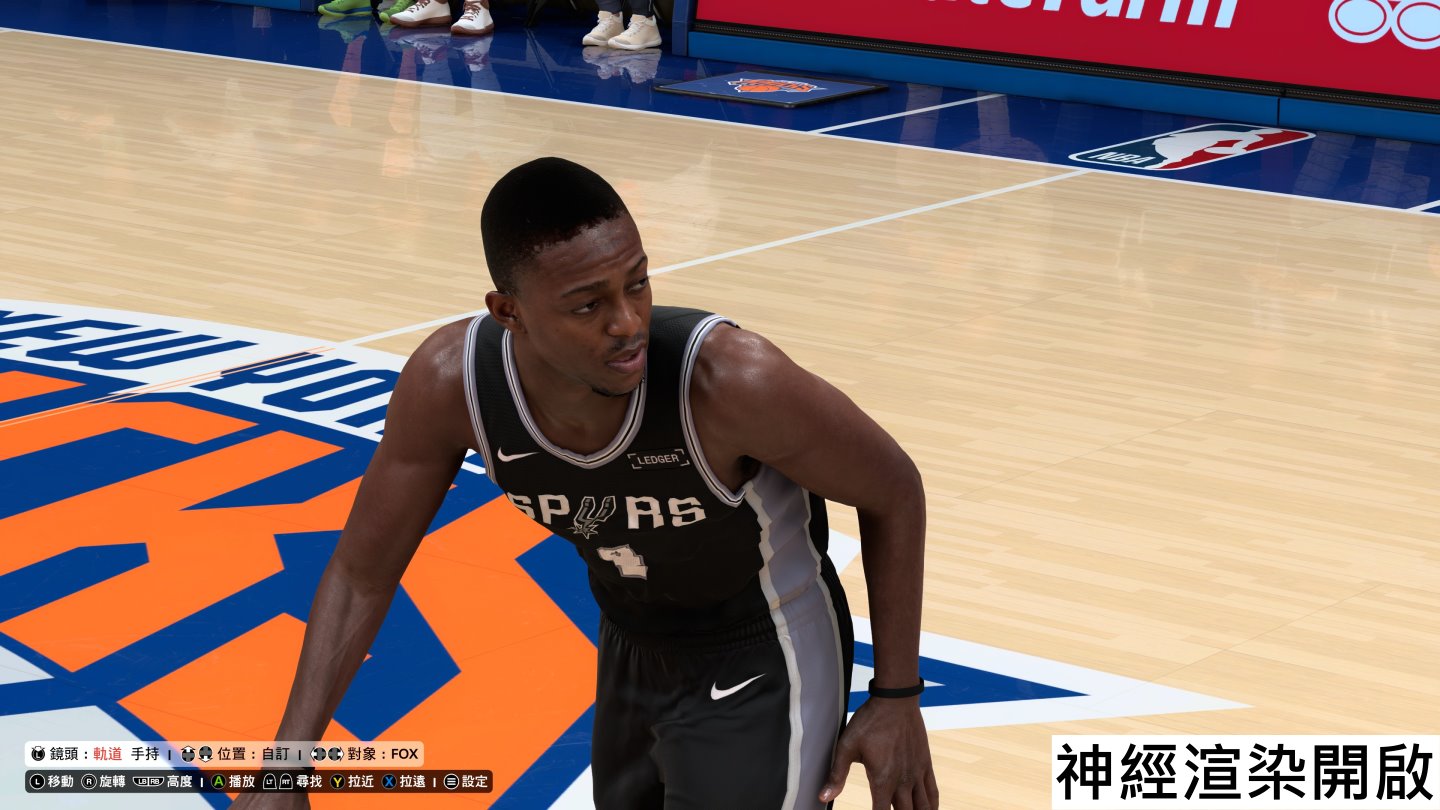
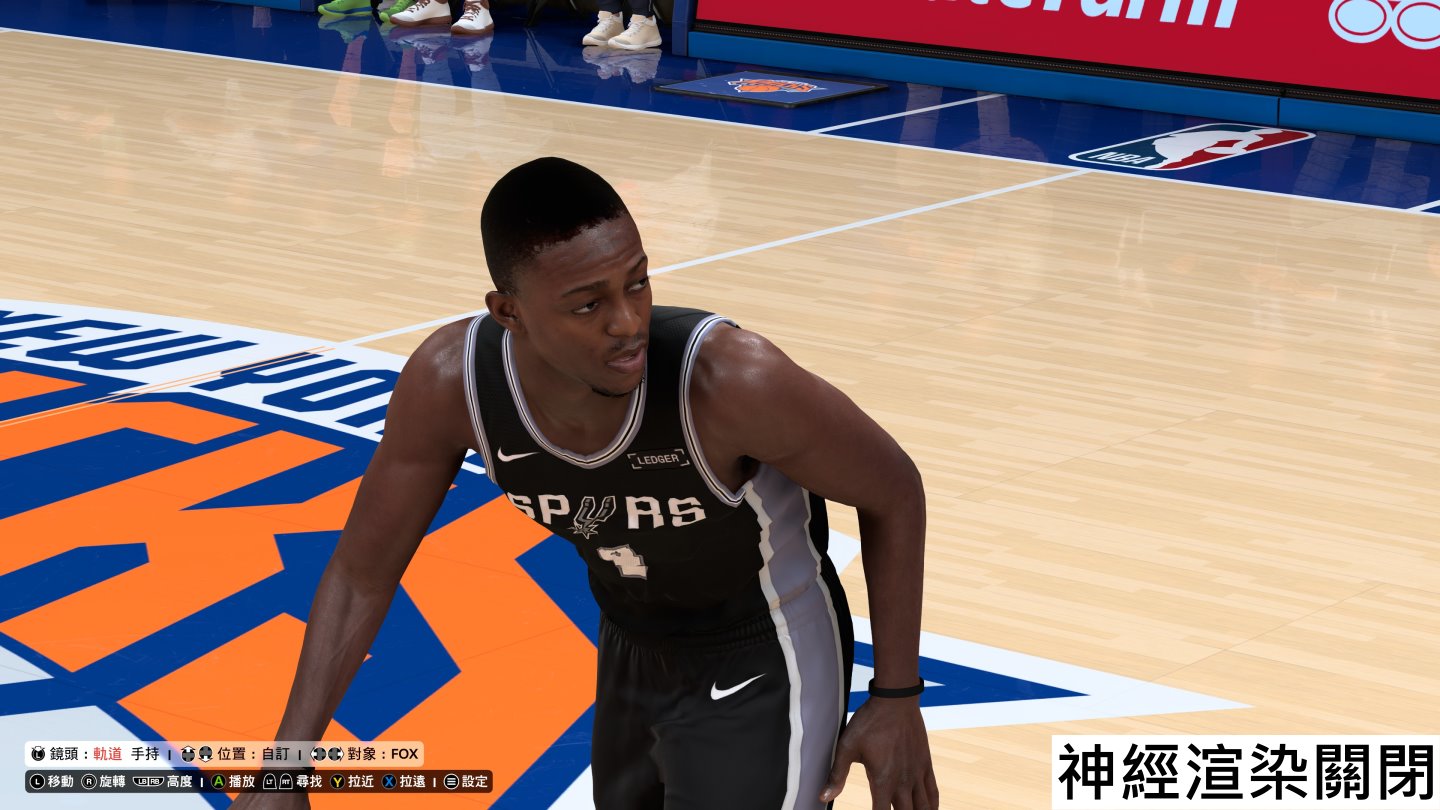
接著看另一個範例,可以將觀察重點放在整體的光影感受。

開、關神經渲染之間,可以看到AI模型修釋光影的效果。

開啟神經渲染後,額頭與嘴唇等部分的光線反射感覺更生動。

手臂部分的汗水反光感覺也比較真實。

在DLSS超解析度(自動)與多重畫格生成(6X)的加持下,關閉神經渲染的平均FPS效能可達793.33幀。雖然開啟神經渲染後效能驟降52.15%,剩下大約一半,但是仍有379.64幀,足以呈現流暢的視覺體驗。

如同筆者在技術解析專題中講到的,神經渲染不像超解與畫格生成等功能只需在遊戲引擎或開發工具中開啟、導入,就能明顯提高FPS效能。神經渲染更加依賴遊戲開發者與美術人員針對遊戲的畫面風格調整AI模型與參數,才能達到比較理想的視覺效果,不但代表著會提高開發商所投入的人力資源與成本,也可能會降低導入意願。

另一方面,目前如AMD與Intel等其他廠牌的繪圖處理器(GPU)並不支援神經渲染,日後就算加入此功能也可能與NVIDIA的技術不相容,造成遊戲導入神經渲染後,僅能在搭載GeForce RTX顯示卡的電腦上啟用該功能,而在其他顯示卡、遊戲主機上則無法使用,對續遊戲導入神經渲染的普及度也是一項挑戰。

目前神經渲染功能僅相容於GeForce RTX 50系列顯示卡,且對FPS效能的衝擊較大。NVIDIA表示DLSS 5是至今運算需求最高的模型,自2026年3月公布以來已將效能提升至原本的5 倍,後續將持序進行最佳化,預計於秋季稍晚推出針對GeForce RTX 50系列顯示卡的模型更新,隨後也會著手進行GeForce RTX 40 系列顯示卡的官方支援。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

NVIDIA DLSS 5技術解析:不再只是效能禁藥,AI美肌強化紋理與光影效果

繼日前NVIDIA推出DLSS 4.5升頻技術後,這次則是進一步推出包含神經渲染功能的DLSS 5,並宣佈功能將於2026年9月3日正式推出。99973316472c62b6824349b9b5fe4080


繼日前NVIDIA推出DLSS 4.5升頻技術後,這次則是進一步推出包含神經渲染功能的DLSS 5,並宣佈功能將於2026年9月3日正式推出。

以圖生圖方式進行AI推論渲染

回顧過去第1至4代DLSS技術主要功能為超解析度(Super Resolution)與畫格生成(Frame Generation),前者為降低遊戲實際繪製的解析度,並透過AI演算法將解析度提高,舉例來說以1920 x 1080解析度繪製遊戲畫面,並以DLSS技術提升至3840 x 2160後再輸至螢幕,而後者則是參考1幀實際繪製的畫格,並透過AI演算法產生最多5幀生成畫格,舉例來說能讓原本FPS為20幀的畫面提升至120幀,這2項功能都能大幅改善遊戲的FPS效能與視覺流暢度。更多DLSS的技術說明請參考下列文章。

延伸閱讀:
玩遊戲不再有鬼影!NVIDIA 推出 DLSS 4.5 光線重建功能 全系列 RTX 顯卡都能戰
【CES 2026】NVIDIA發表DLSS 4.5效能禁藥,第2代超解析度Transformer模型、6X多重動態畫格生成,強化遊戲畫質與效能
【CES 2025】 - NVIDIA編輯日(下):RTX 50系列顯示卡獨有DLSS 4多重畫格生成超級效能禁藥與Reflex低延遲技術

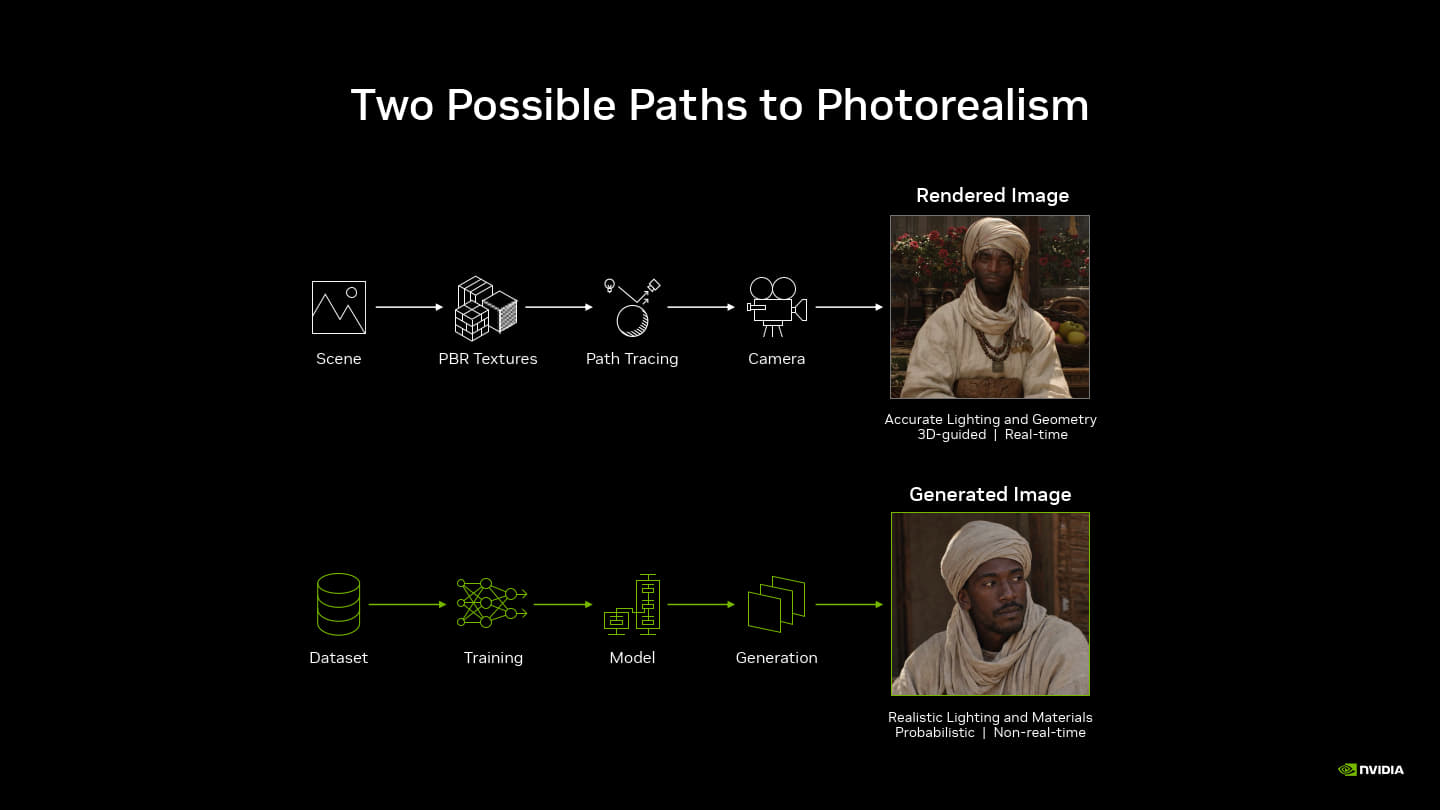
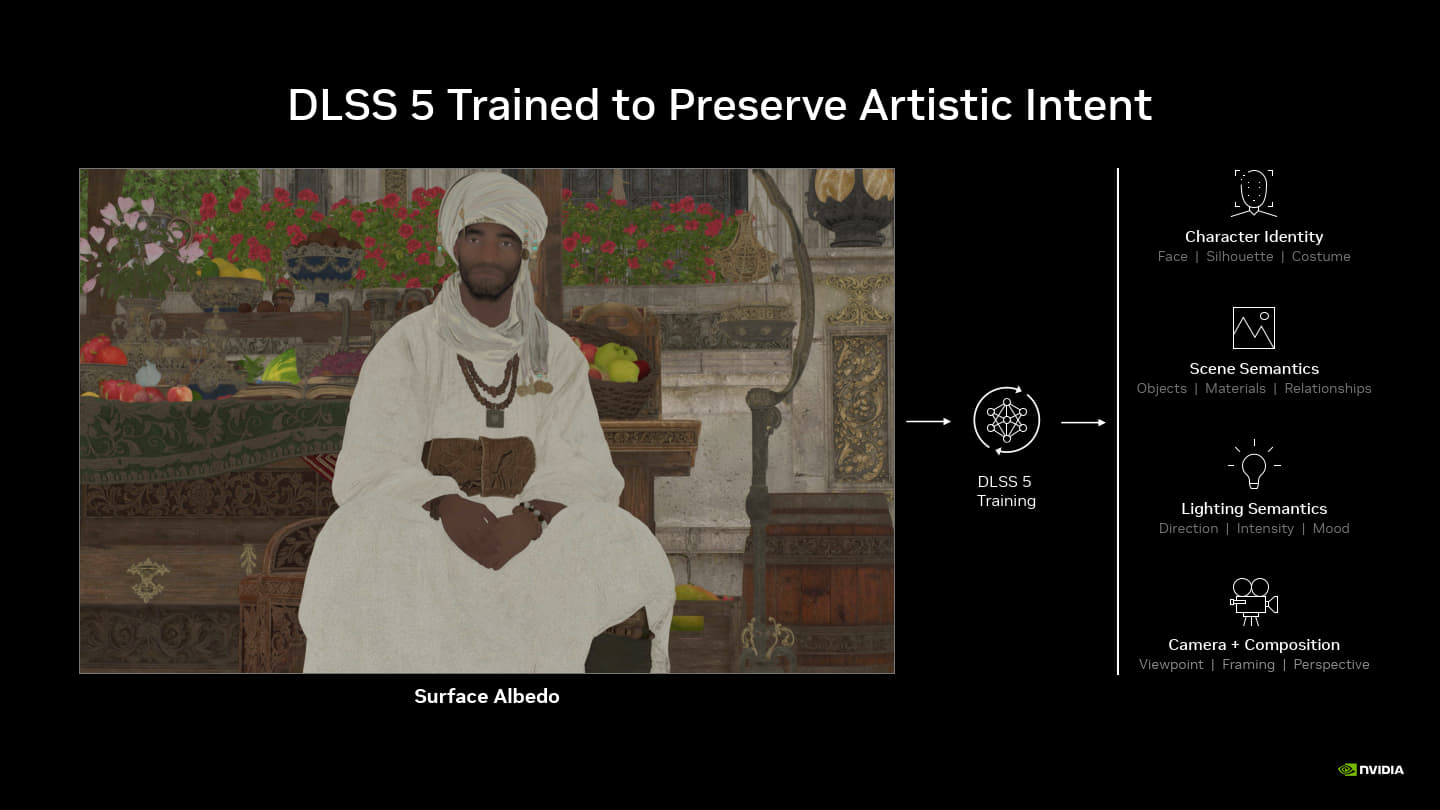
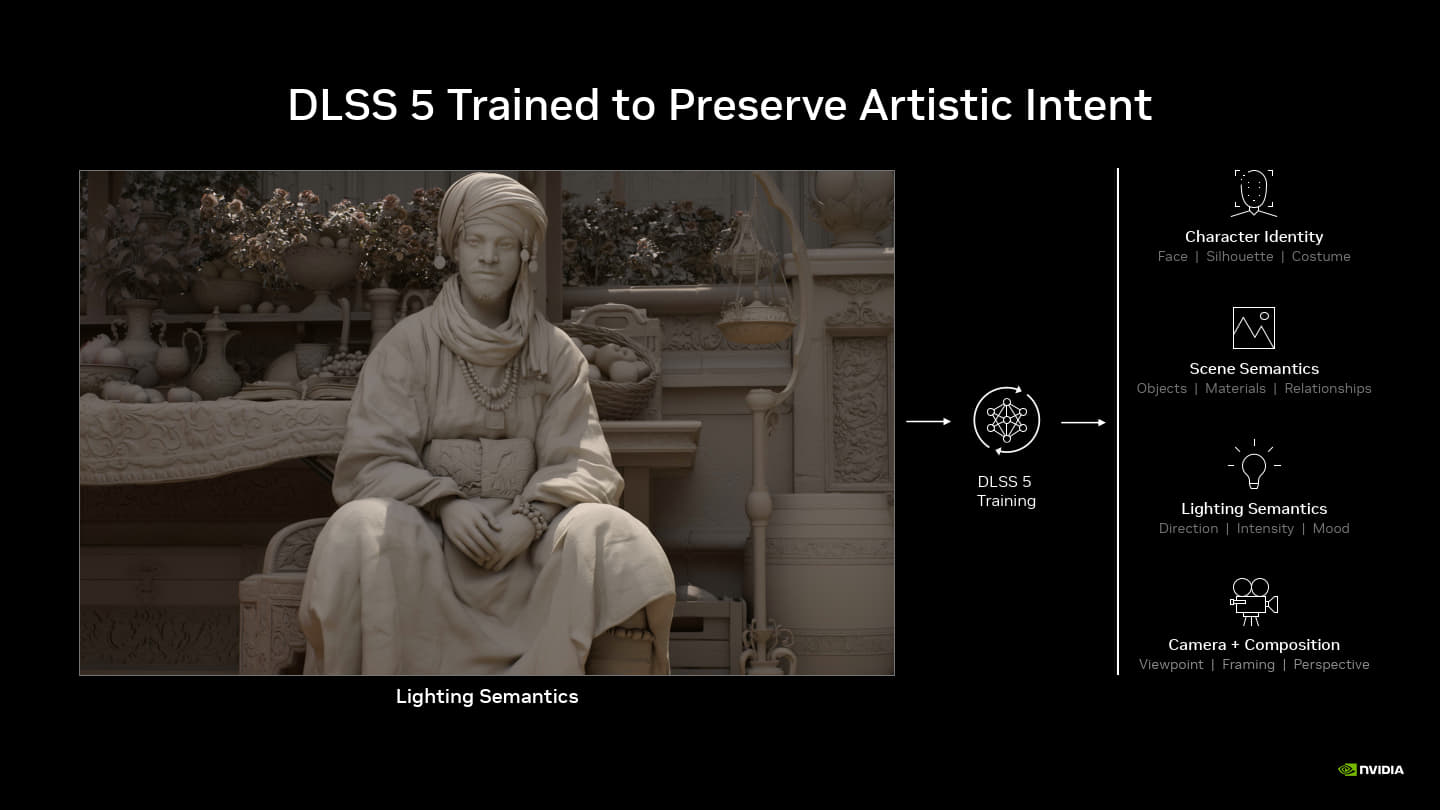
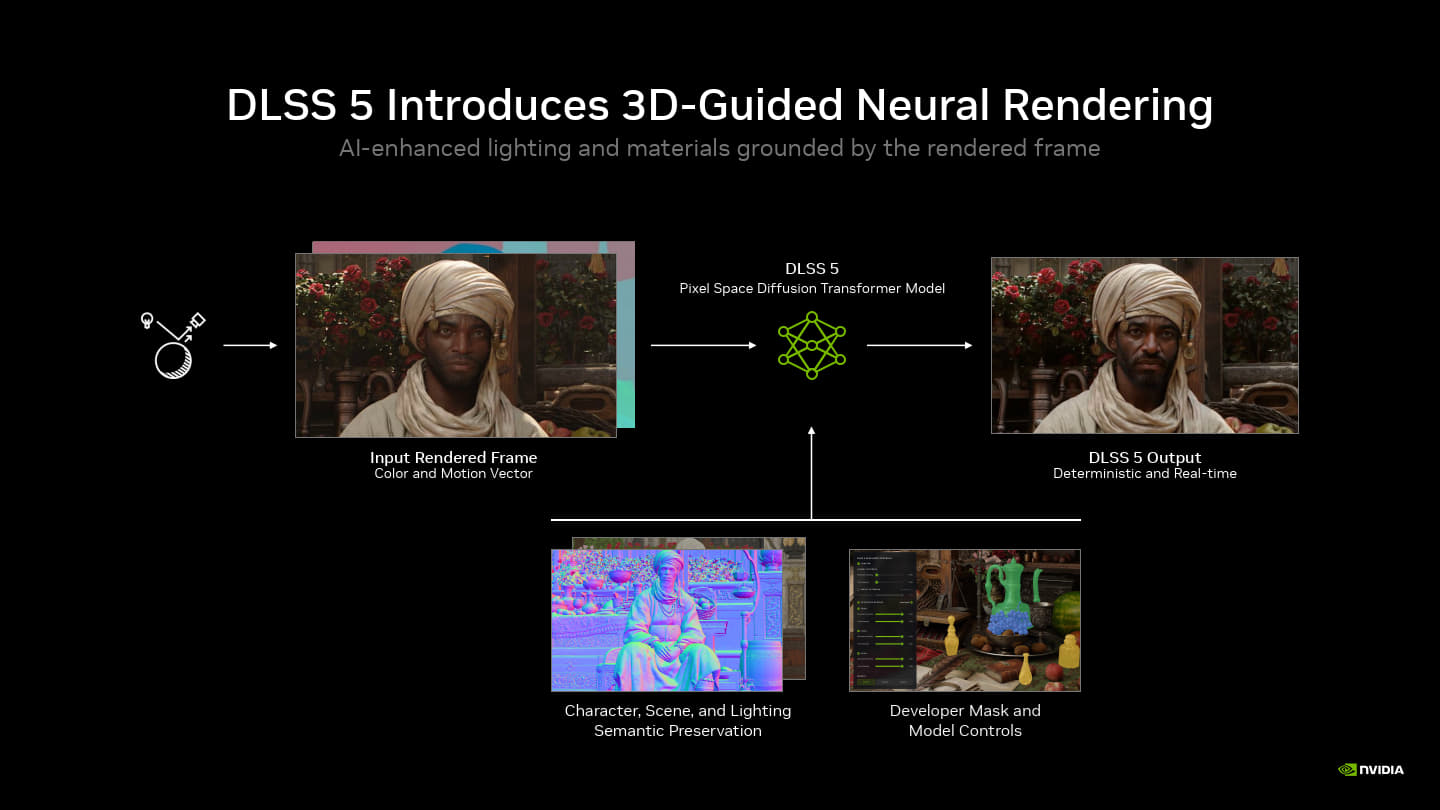
DLSS 5除了延續先前既有功能之外,還加入了全新的神經渲染(Neural Rendering)功能,透過AI演算法生成畫面上指定物件或區域的材質紋理與光照效果。它的概念比較類似使用AI圖像生成的「圖生圖」(Image to Image)功能,能夠先讓遊戲引擎繪製紋理與光影較為粗糙的「3D草稿」,然後再讓AI模型參考草稿搭配遊戲引擎提供表面反射率(Surface Albedo)、光照資訊、表面法線、動態向量等資訊,生成具有更細緻肌膚紋理、布料材質、光影反射等要素的圖像,在透過「美肌修圖」方式強化逼真度與視覺效果的同時,平衡繪圖運算資源的消耗與效能衝擊。

值得注意的是,當遊戲影引擎能夠提供更多畫面資訊,神經渲染就能生成更理的圖像品質,因此適度提高遊戲畫質並開啟光線追蹤,有助於能帶來最佳畫面品質。

與超解析度不同的是,超解析度的核心概念是降低繪製的解析度以降低運算量,達到提升FPS的效過,本身並不需要介入遊戲開發過程,就能取得理想的效能增益效果。

而神經渲染則更依賴遊戲的美術設計人員在開發過程中調整神經渲染應用的區域與強度,在不同的物件上微調設定參數以取得較理想的視覺體驗,而不是只單純在遊戲開發環境中「啟用 RTX On」。整體而言,神經渲染能在兼顧效能的前提下強化遊戲畫質體驗,但可能會佔用更多人力與成本進行美術設計與調整。

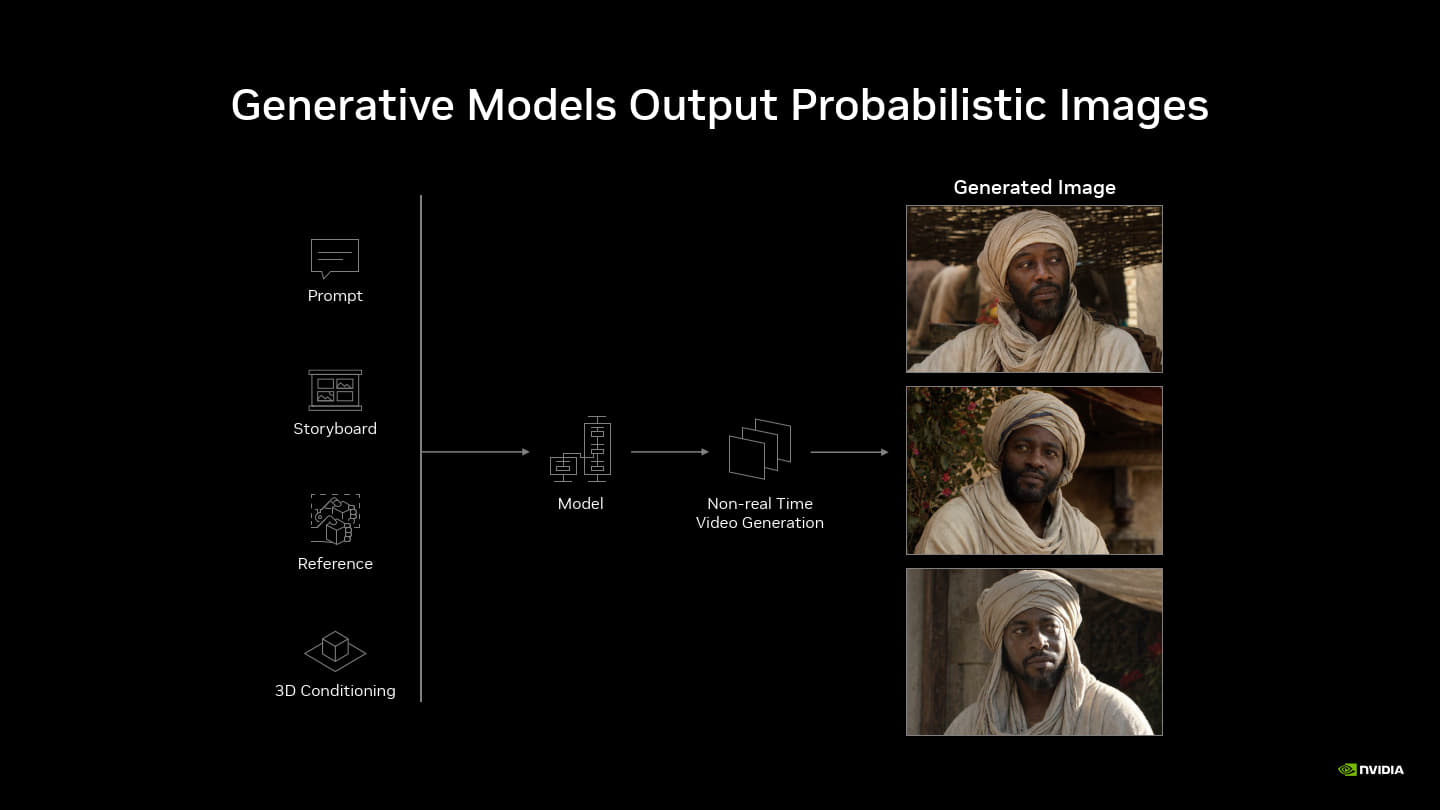
傳統3D繪圖使用光柵化搭配光線追蹤等技術繪製遊戲畫面,AI圖像生成則透以大量資料訓練模型,並使用模型進行推論運算得到圖像。

然而AI圖像生成存在一定隨機性,如果單純使用「文生圖」(Text to Image)的方式容易造成生成的角色、物件、背景前後不一致。

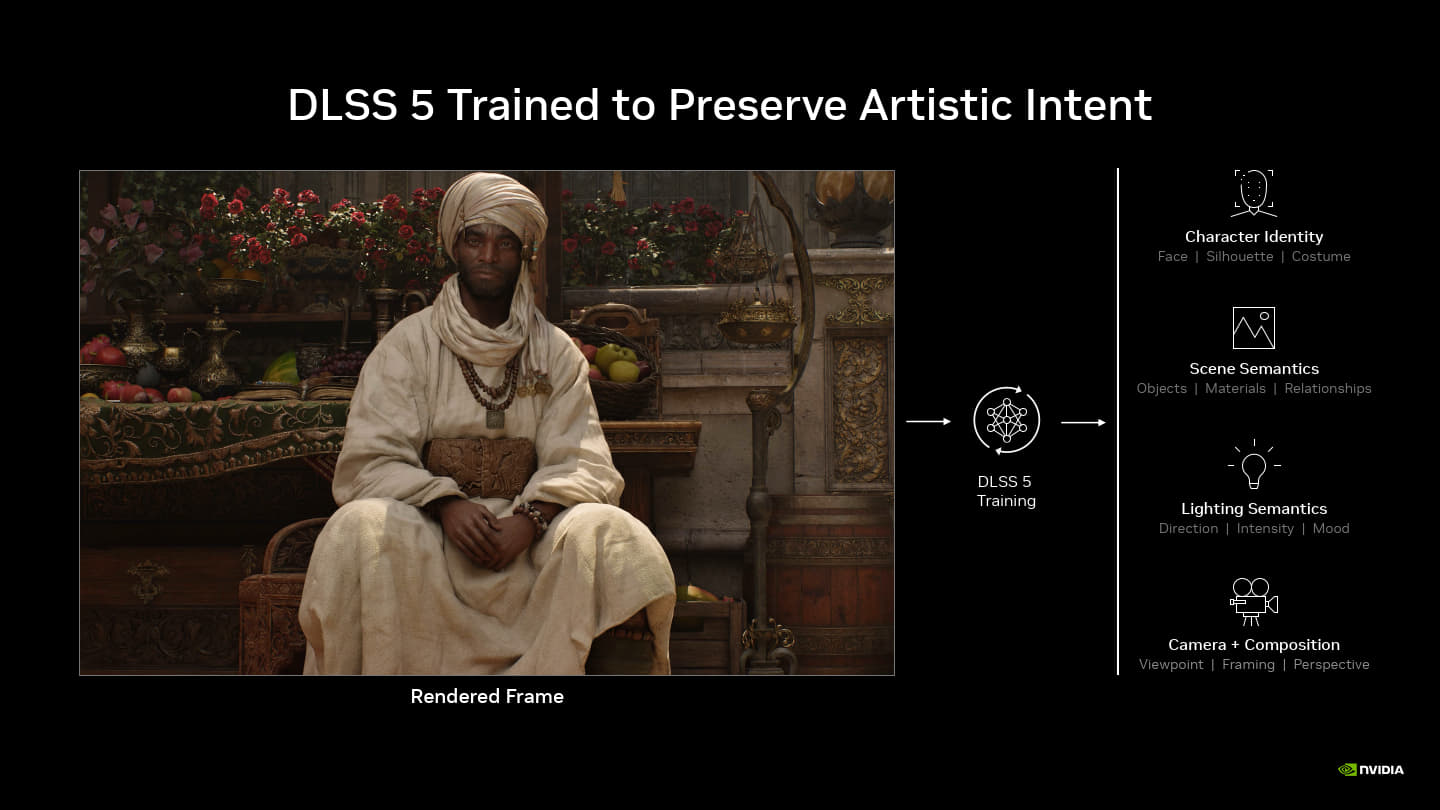
DLSS 5神經渲染採用類似「圖生圖」的概念,使用遊戲引擎繪製的圖像為基礎,再讓AI模行進行「美肌修圖」。

除此之外,神經渲染的AI模型還會參考遊戲引擎提供的多種資料強化圖像生成的效果。此範例為表面反射率。

遊戲引擎也會將場景中的光照資訊提供給AI模型參考,以強化光影效果。

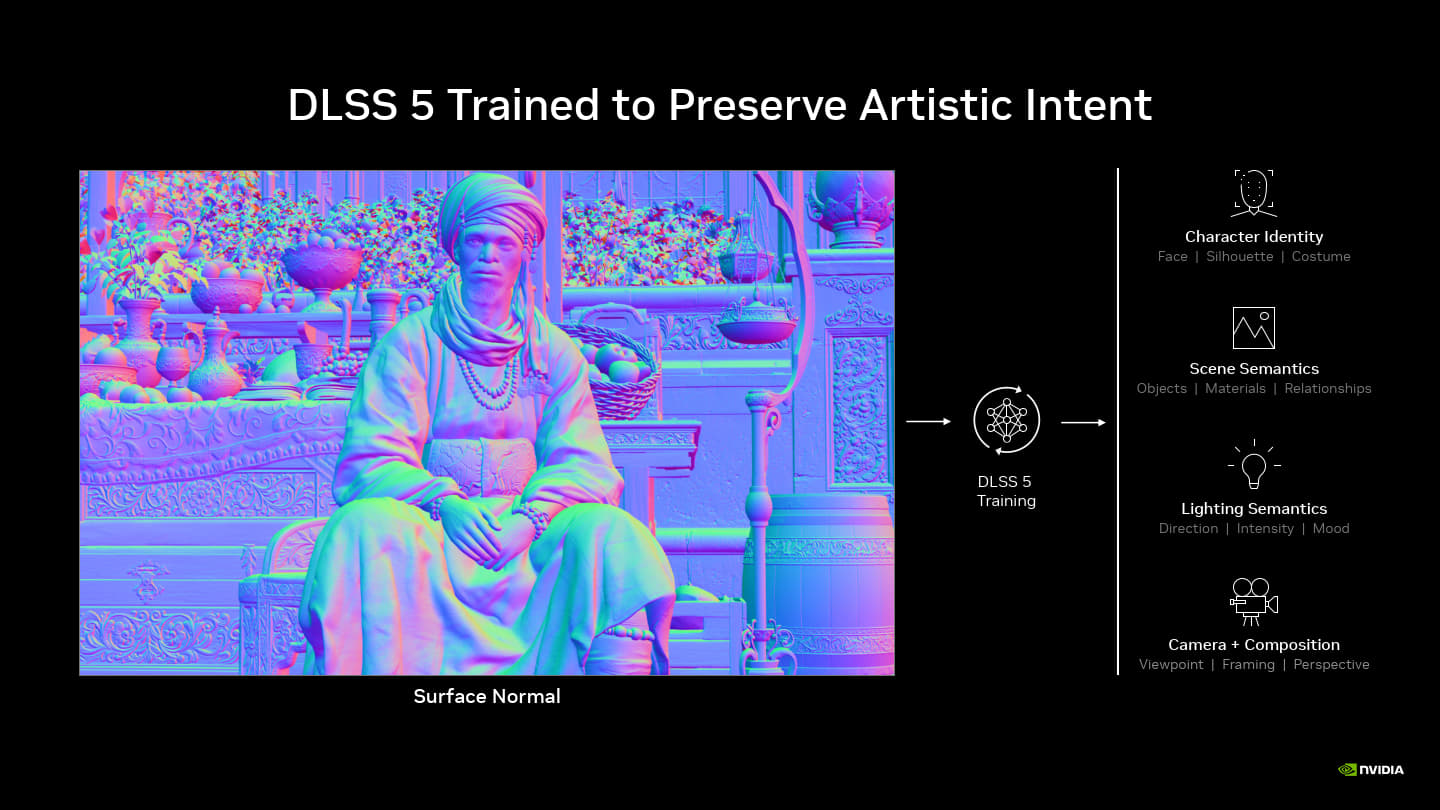
場景的表面法線有助於讓AI模型判斷物件表面型狀,以判斷光線反射的方向。

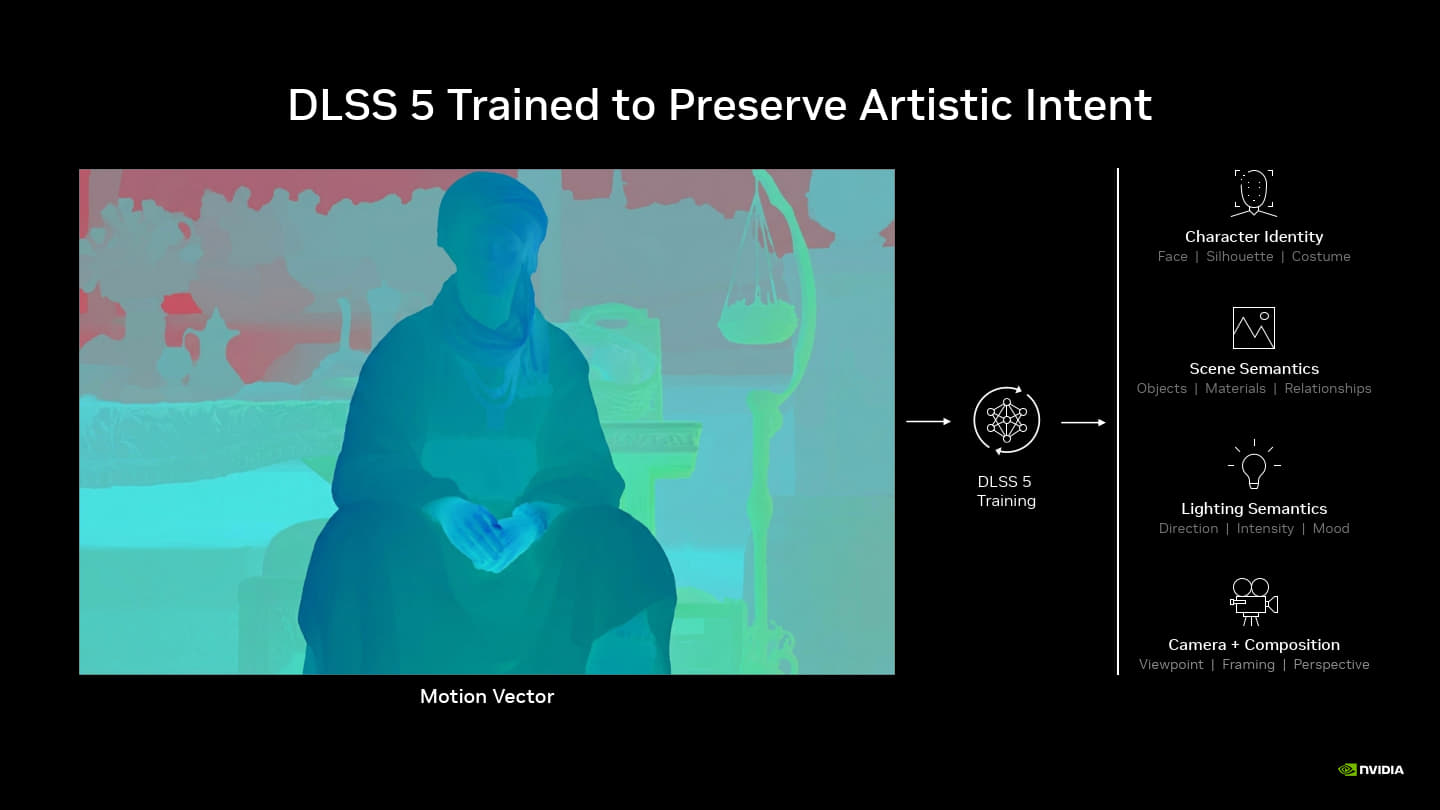
動態向量則記錄物件的移動行為,可以改善生成畫面的動態穩定性。

DLSS 5神經渲染會使用上述多種資訊引導AI模型進行圖像生成,以確保生成圖像的一致性與品質。

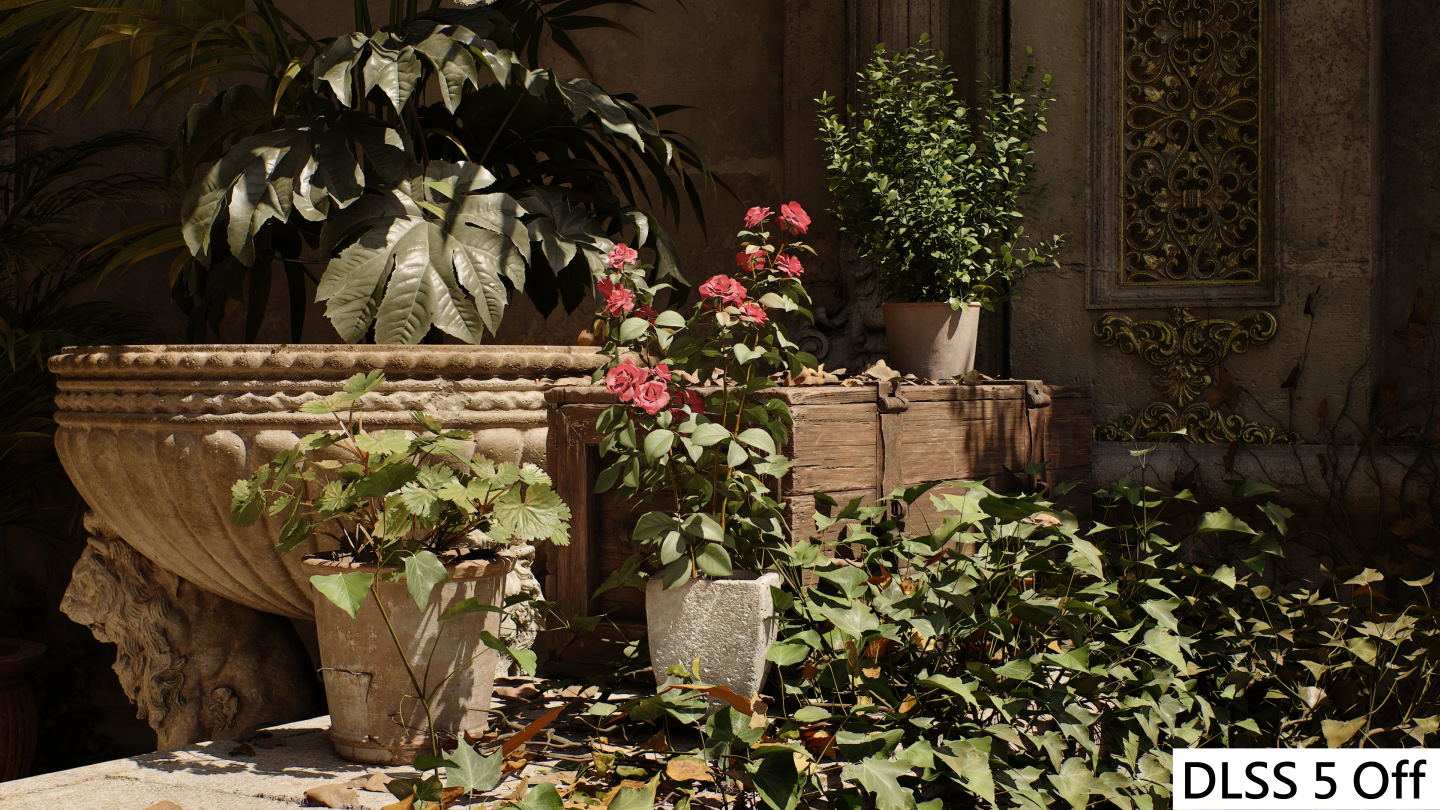
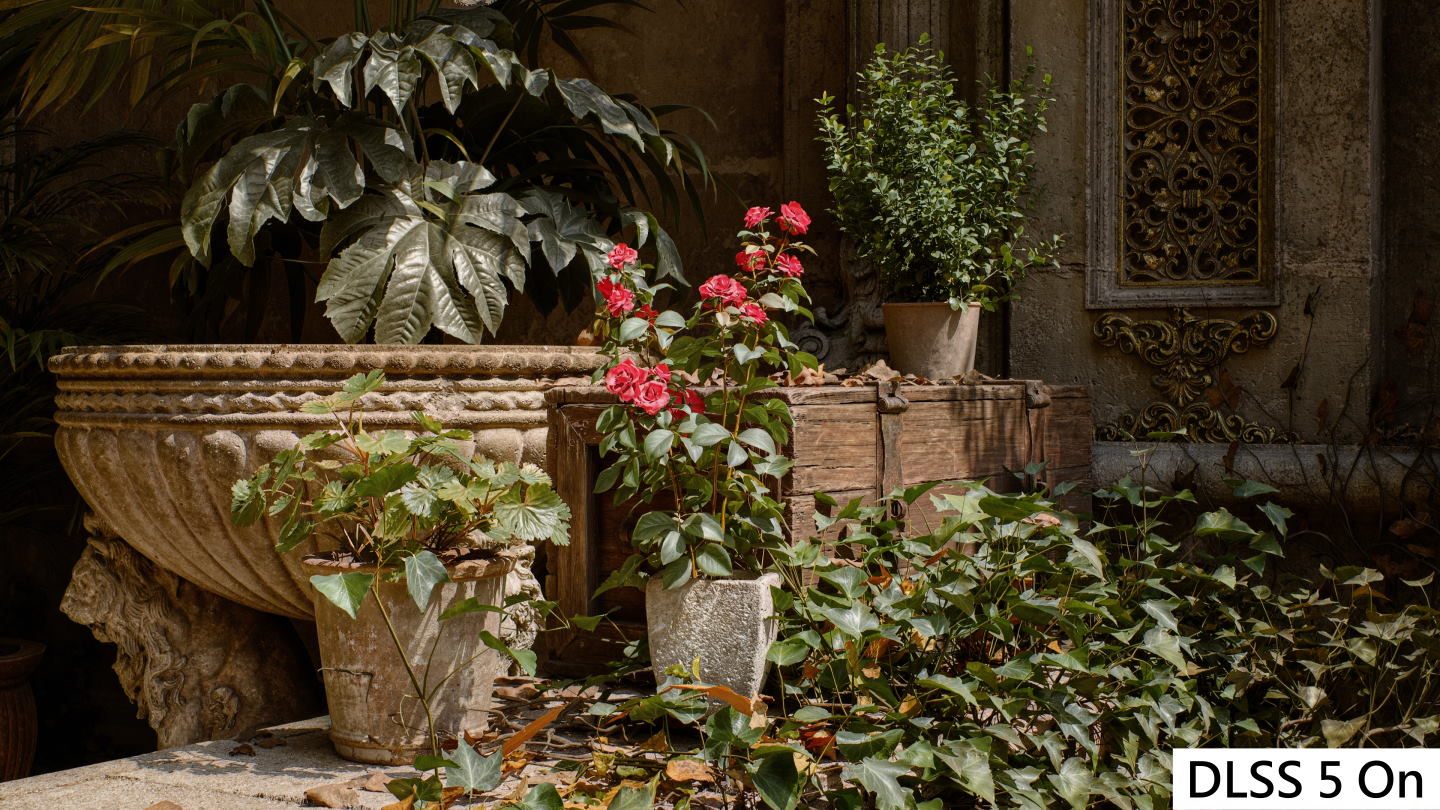
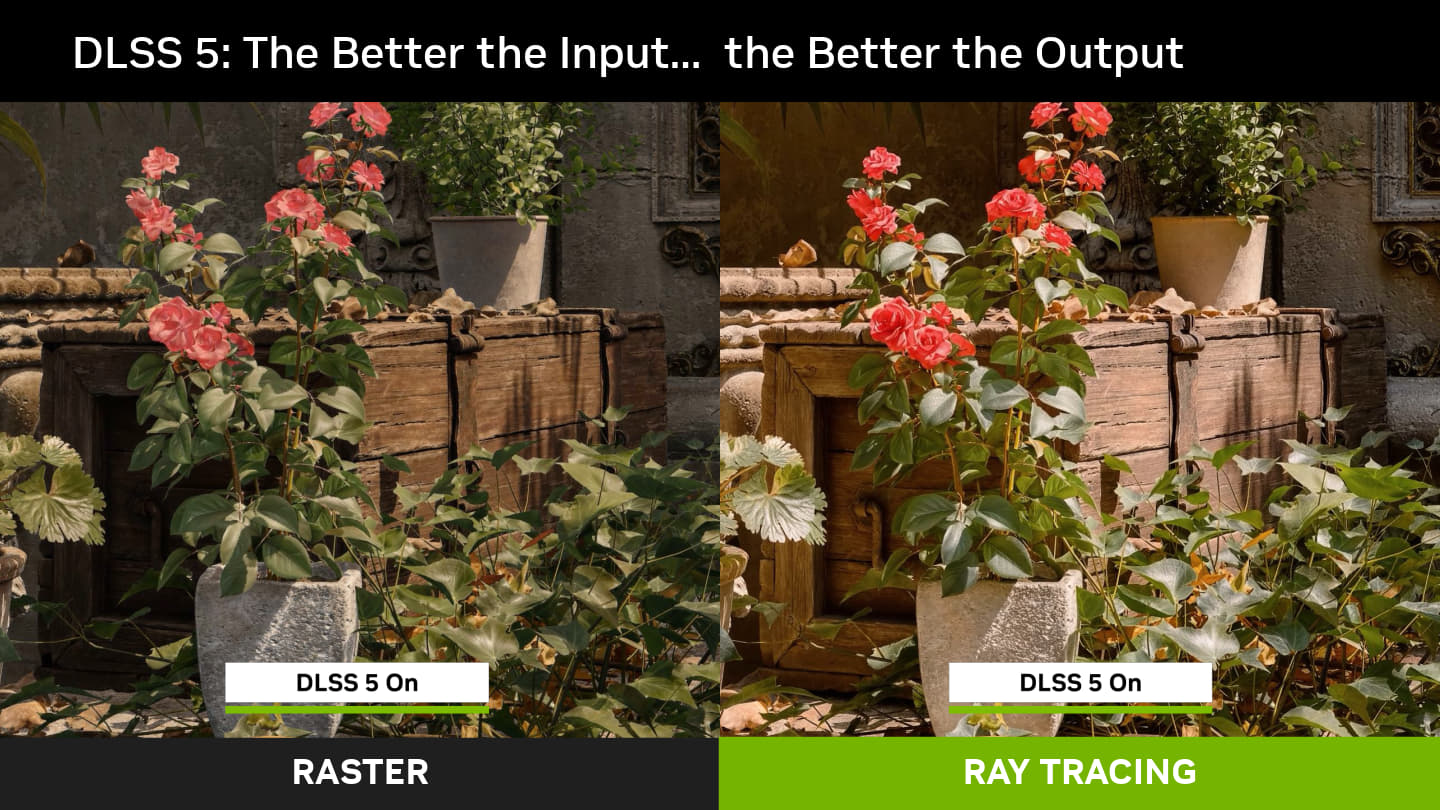
不使用DLSS 5技術的基本參考畫面。

開啟DLSS 5之後,畫面的紋理與光照細節都有所改善。

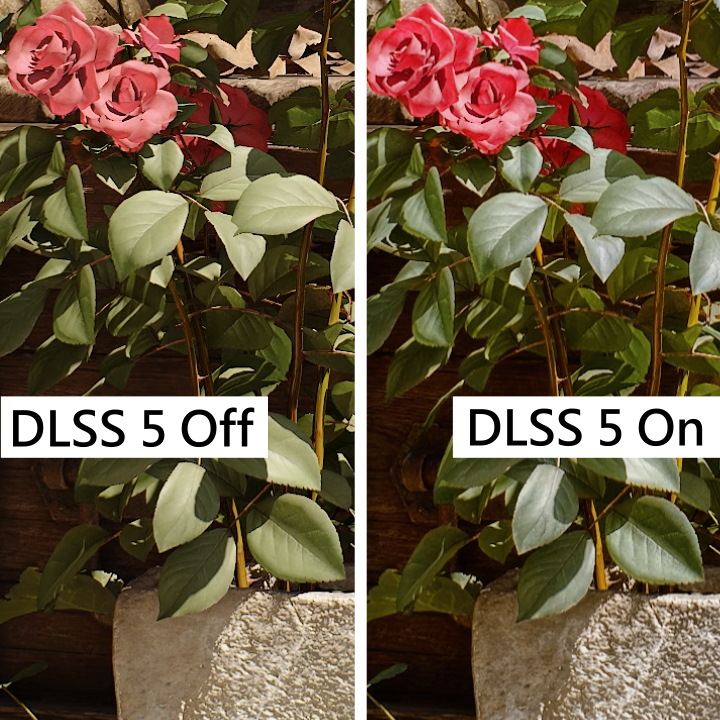
開啟DLSS 5之後,花瓣間的複雜光影表現更加真實,右下角花盆的石材紋理也更細膩。

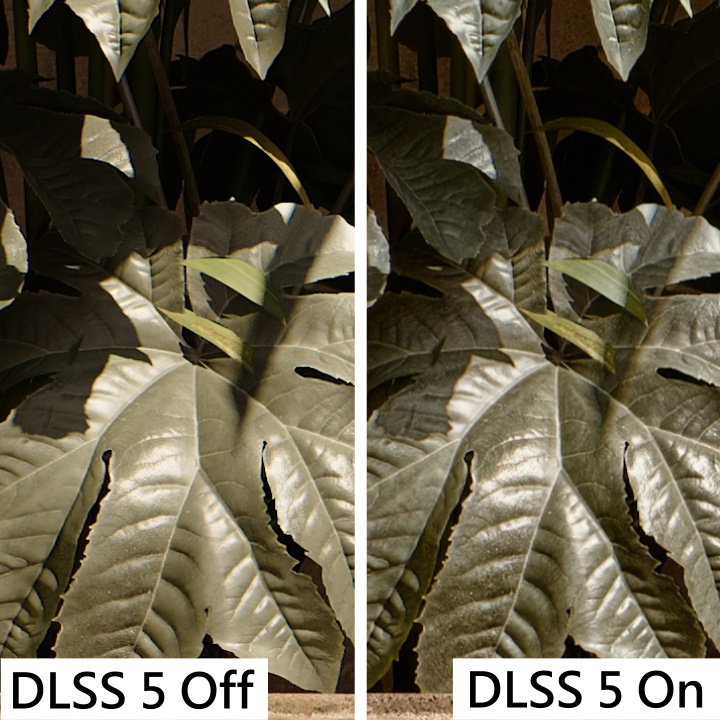
DLSS 5也改善了樹葉的葉脈紋理與光線反射的質感。

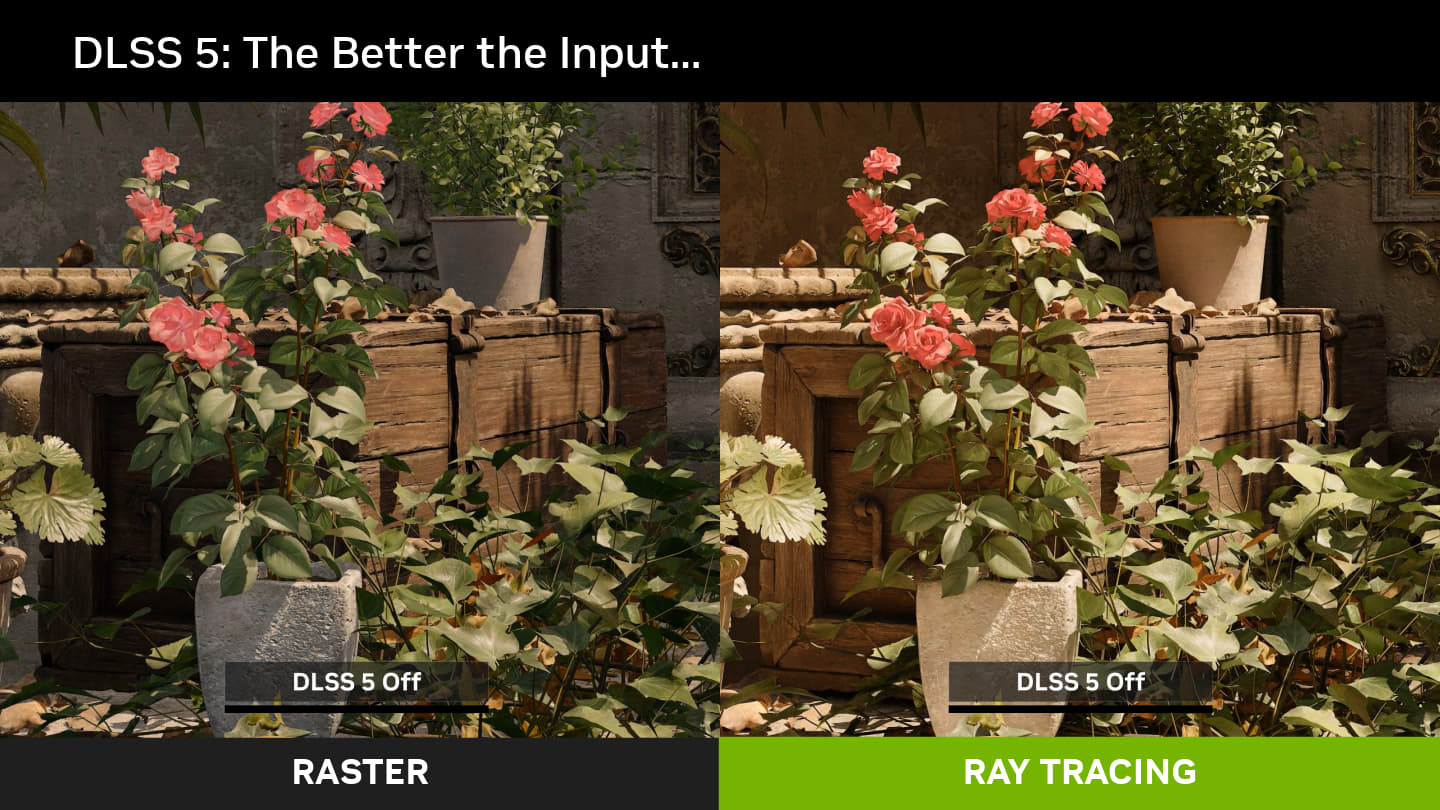
值得注意的是,如果遊戲影引擎能夠提供更多畫面資訊,仍然能提升神經渲染的效果與品質。圖片左側為關閉光線追蹤的畫面,右側開啟光線追蹤後,具有更多光影細節。

2者開啟神經渲染後,開啟光線追蹤的情況能帶來最佳畫面品質。

開發工具賦予高度控制權

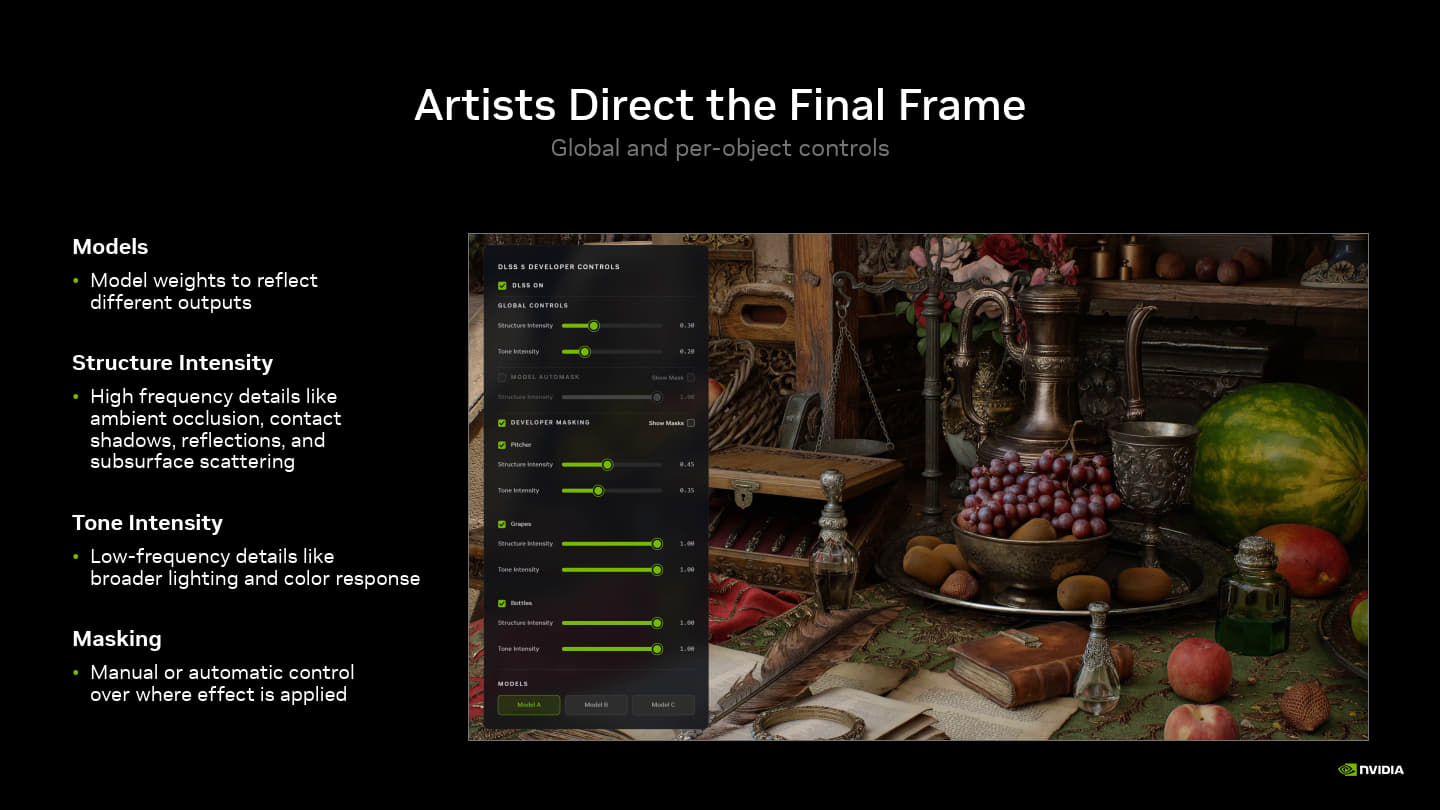
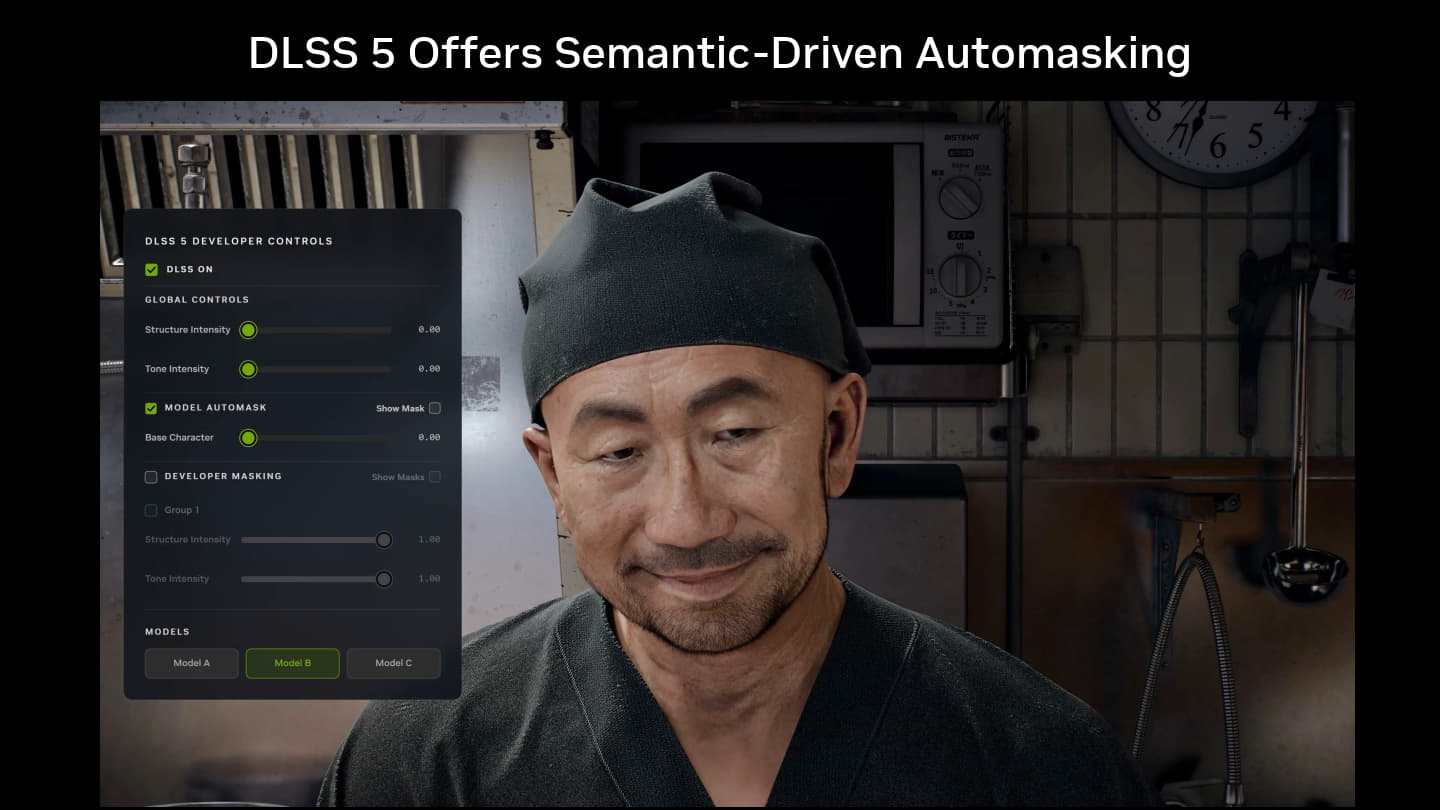
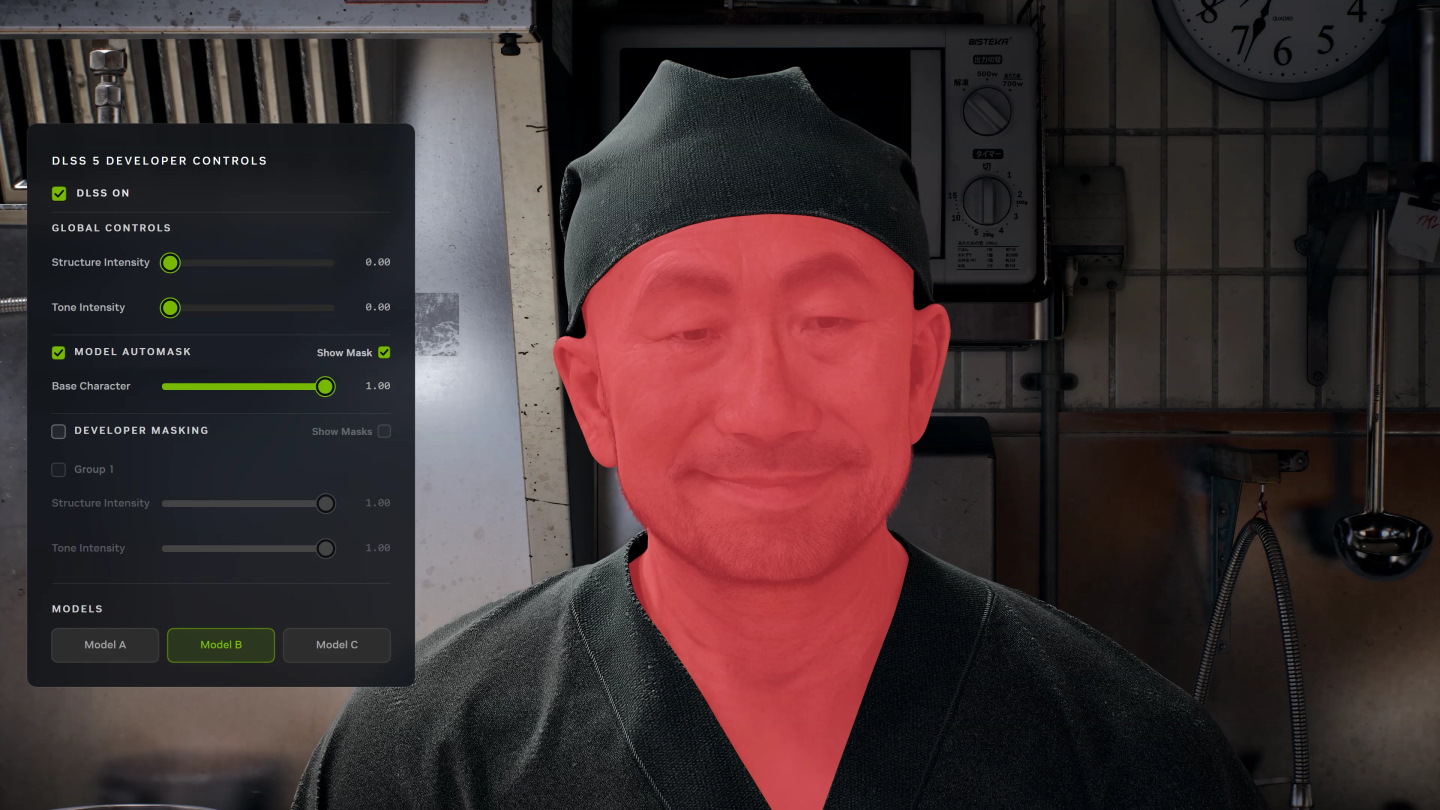
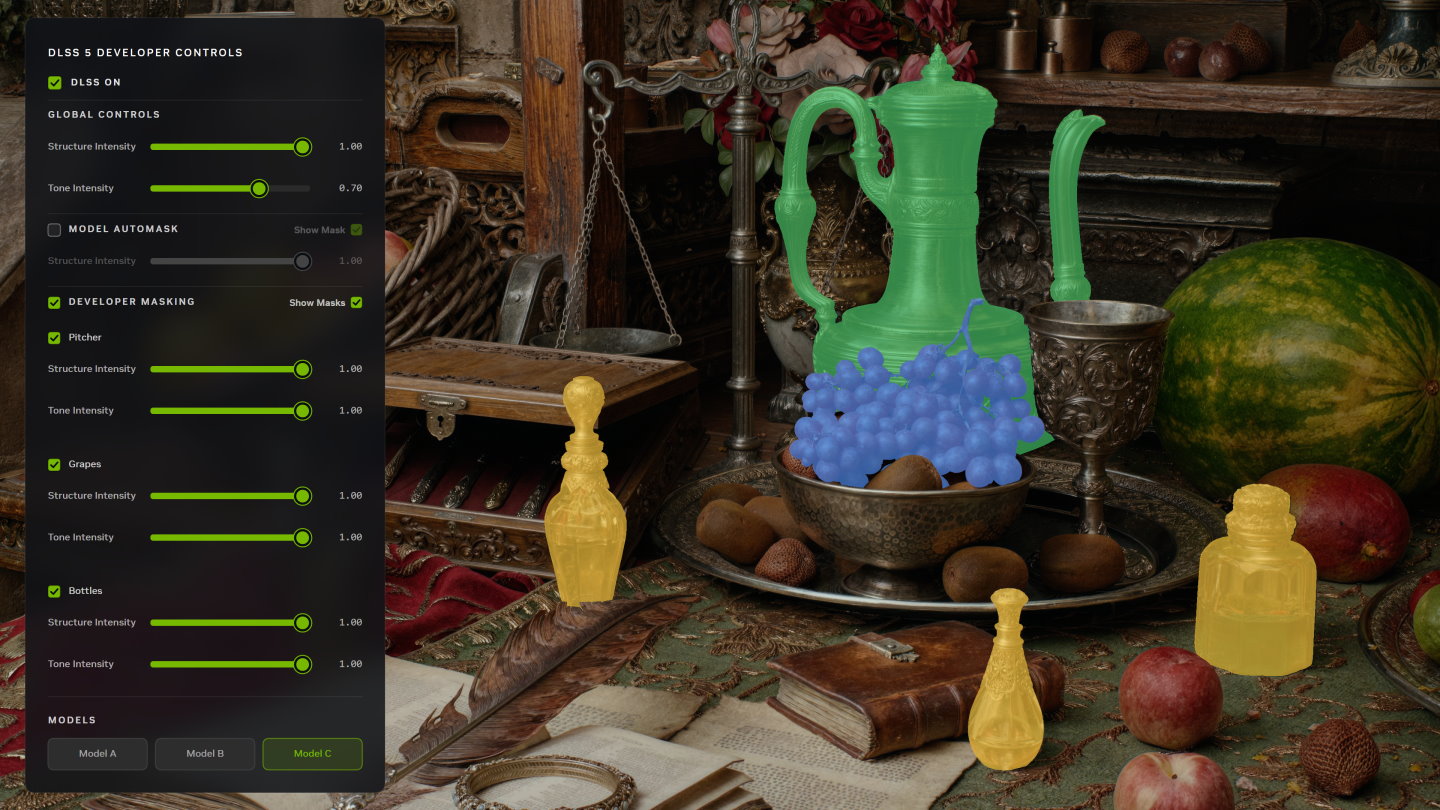
NVIDIA在Gamescom 2026的展示中說明許多神經渲染對於遊戲開發者的設定細節,它提供AI模型、結構強度、色調強度、遮罩等豐富的設定功能,讓開發者能夠在導入神經渲染的同時,將遊戲畫面控制在自己設定的範圍之內,而不會因為讓AI模型把「美肌功能」開過頭,而造成畫風崩壞。

詳細的設定功能與效果比較,請參考下方圖文說明。比較可惜的是,NVIDIA並沒有提供開、關DLSS 5的效能對照數據,僅提供開啟的效能表現做為參考,但是可以放心的是,即便是GeForce RTX 5060也能提供理想且流暢的遊戲體驗。

1神經渲染提供詳細的設定功能,可以調整AI模型、結構強度、色調強度、遮罩等等,給與遊戲開發者相當大的自由度調整出理想的畫面效果。

NVIDIA透過調整開發工具中的設定參數,展示神經渲染的效果。

首先開發者可以設定多組遮罩,方便進行圖層式的強度設定。

遮罩的層數並不會以影響神經渲染的效能表現,開發者可以對不同物件進行精細微調。

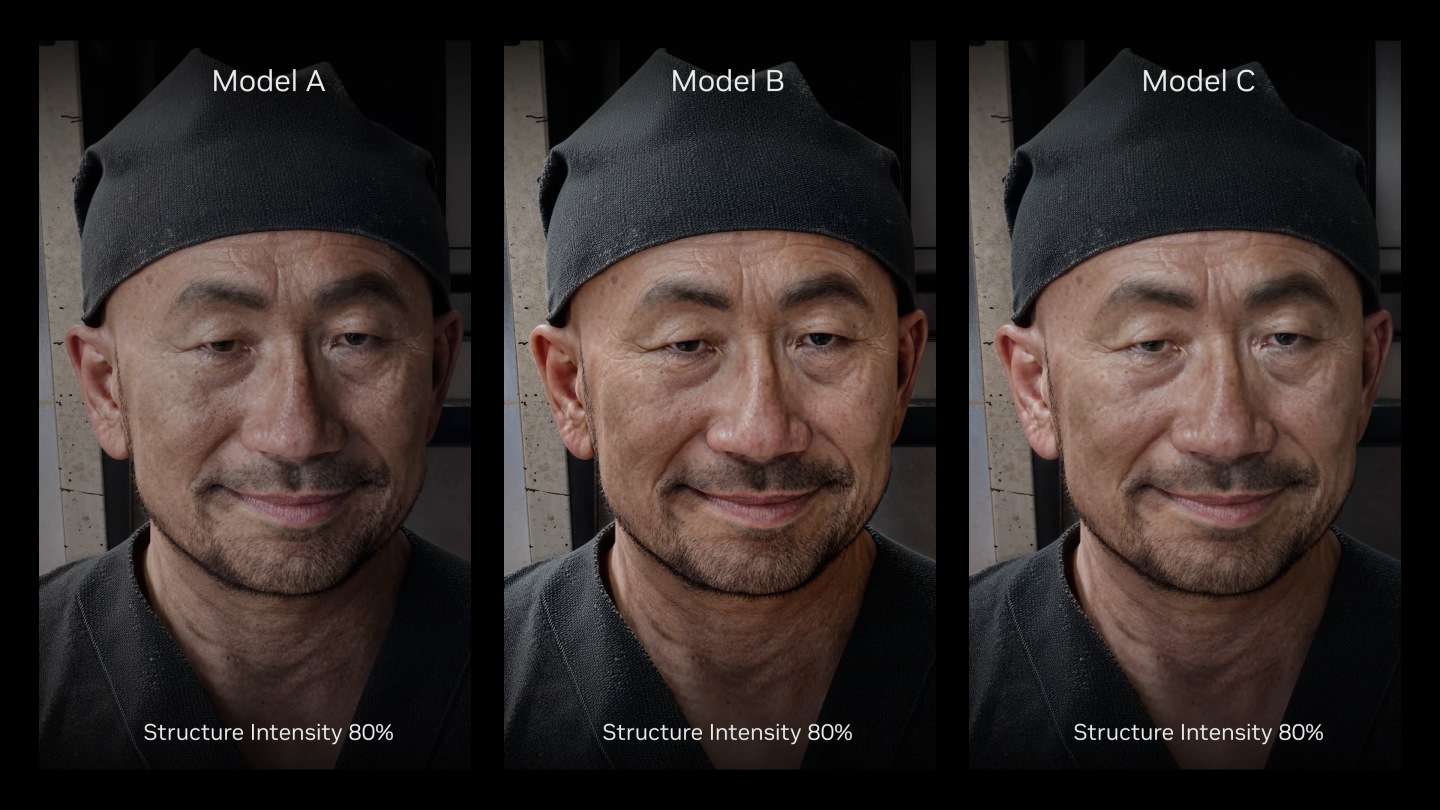
舉例來說,套用不同的AI模型會得到不同的圖像,開發者可以選擇適合的AI模型。

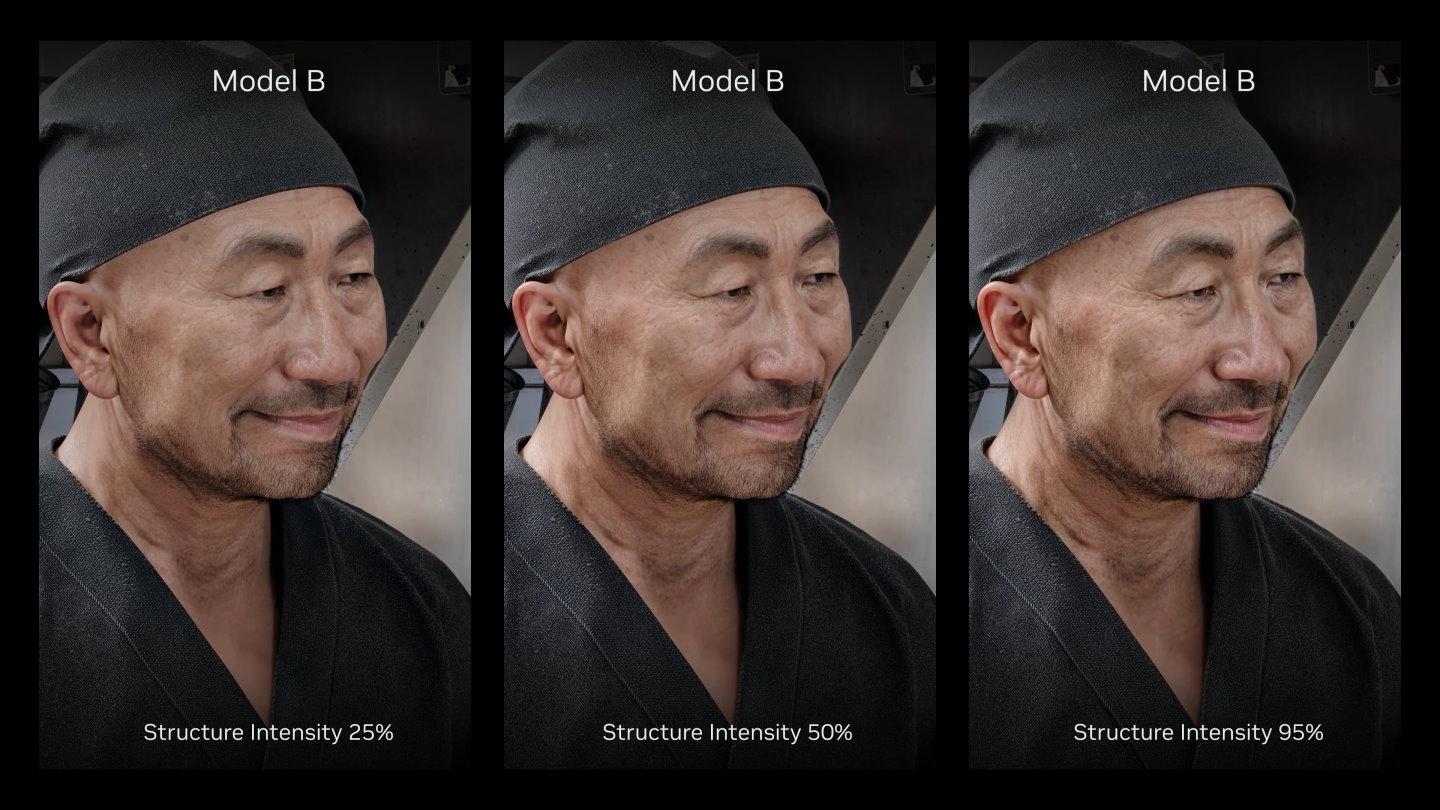
確定AI模型後,還可以調整強度,達到適中的畫面強化效果,而不至於影響畫面風格。

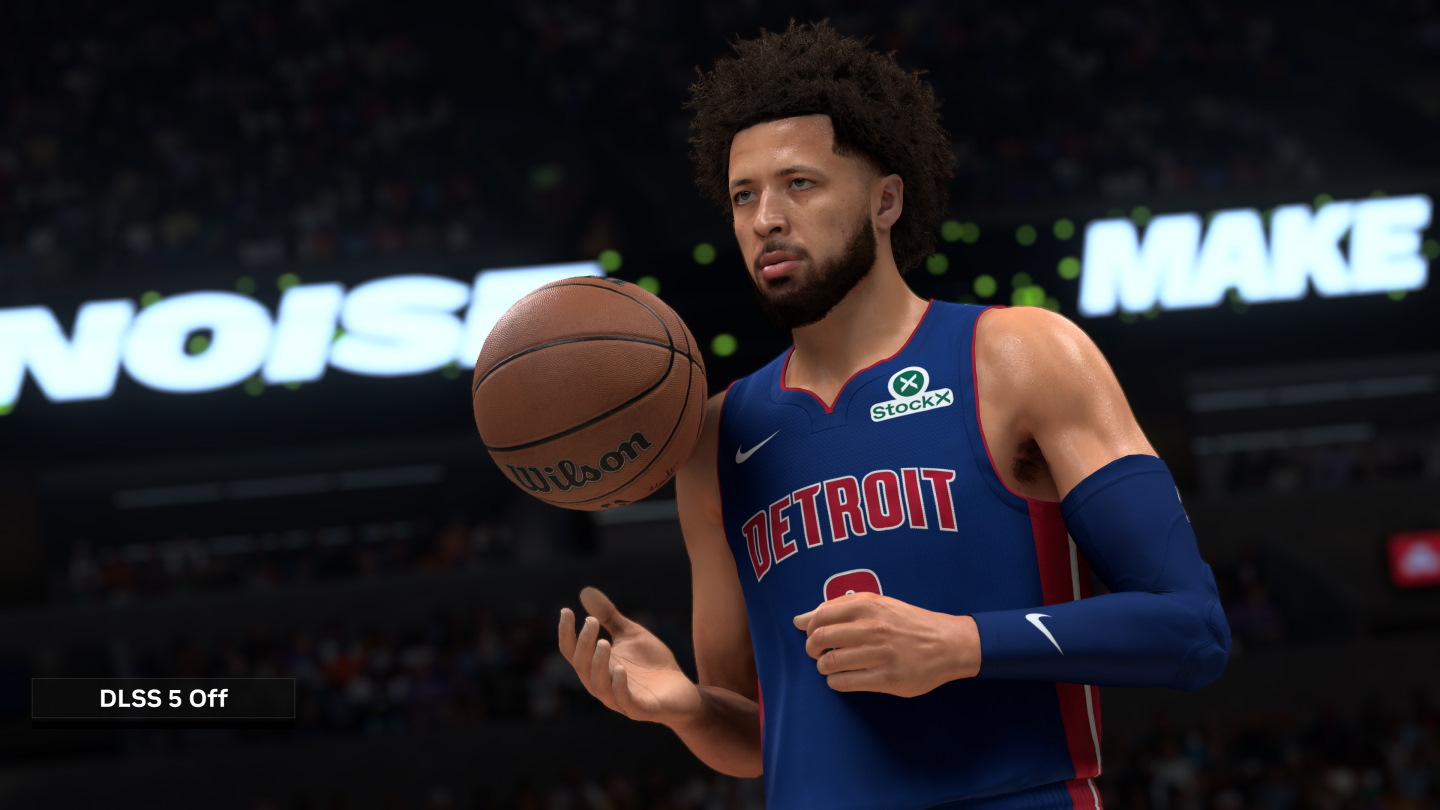
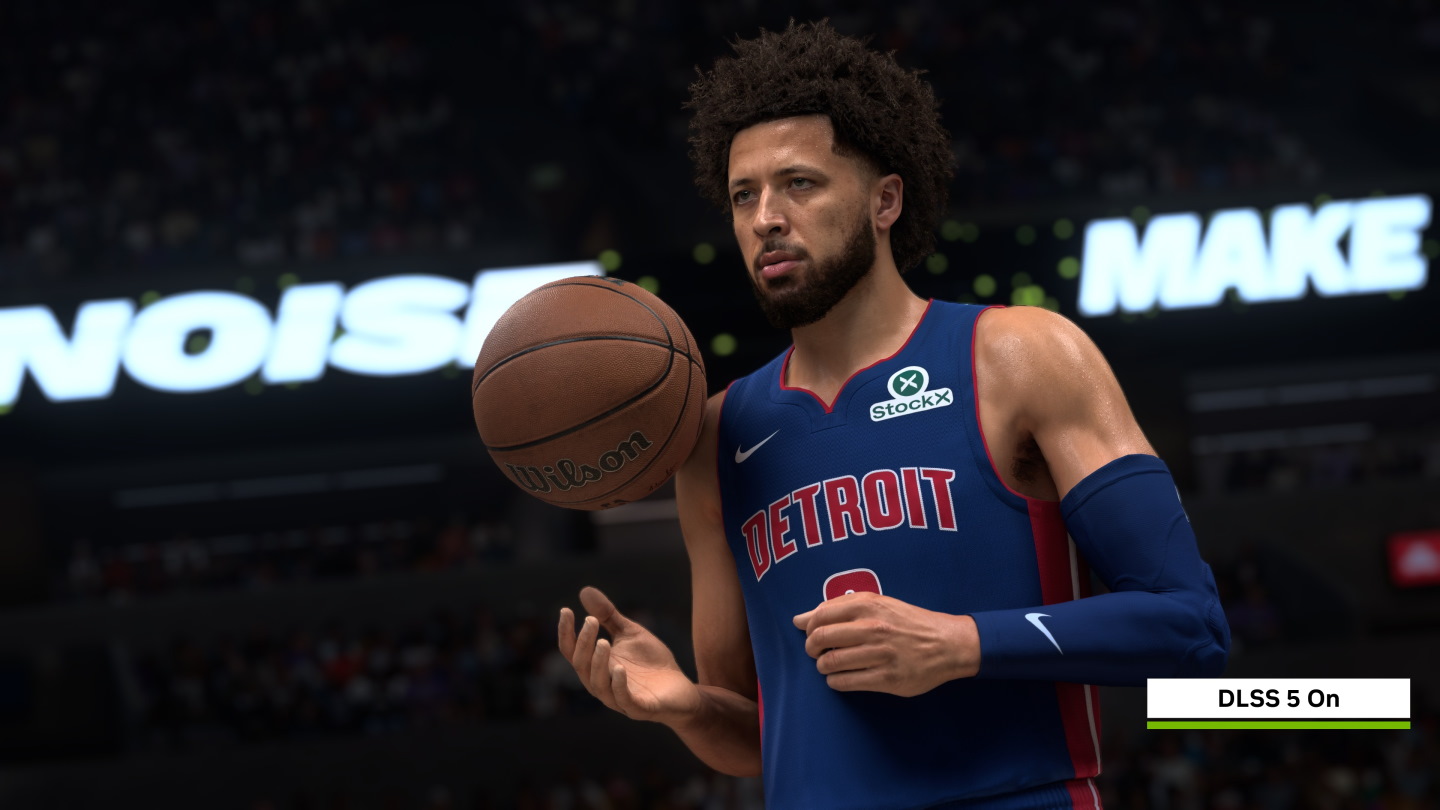
最後我們看到DLSS 5在實際遊戲NBA 2K27的效果,圖為關閉DLSS 5的情況。

開啟DLSS 5之後,人物的肌膚更細膩,手臂上汗水的反光效果也更加逼真。

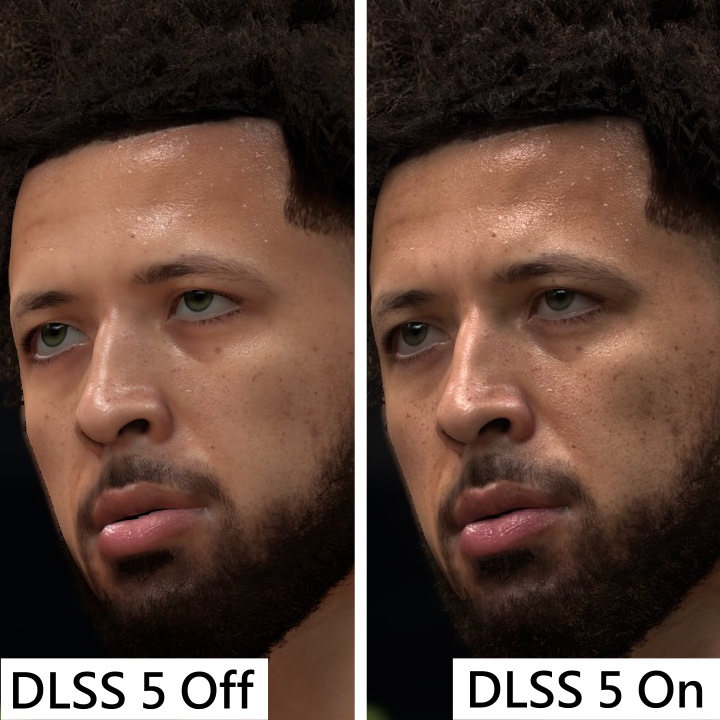
仔細查看細節,可以看到DLSS 5的神經渲染功能可以明顯改善眼珠、毛孔、鬍鬚等部位的視覺效果。

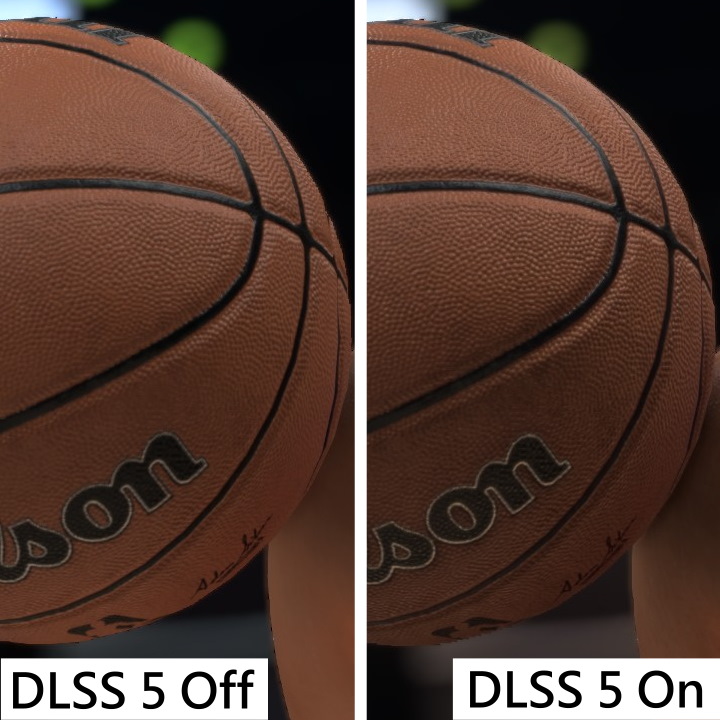
籃球表面的顆粒感也獲得明顯提升。

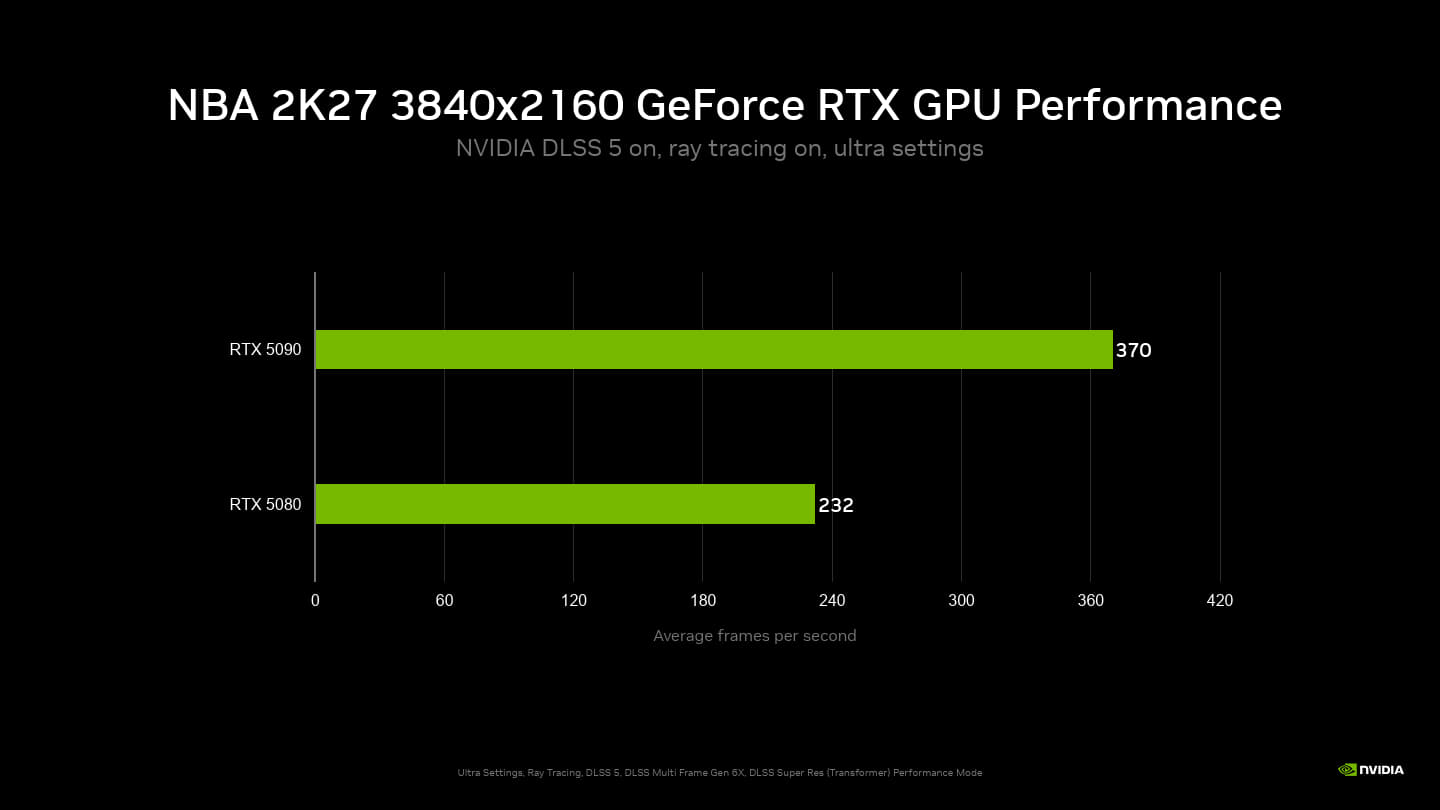
GeForce RTX 5090 / 5080能在4K解析度並開啟最高畫質、光線追蹤、DLSS 5的情況下,讓NBA 2K27的平均FPS達到370幀、232幀。

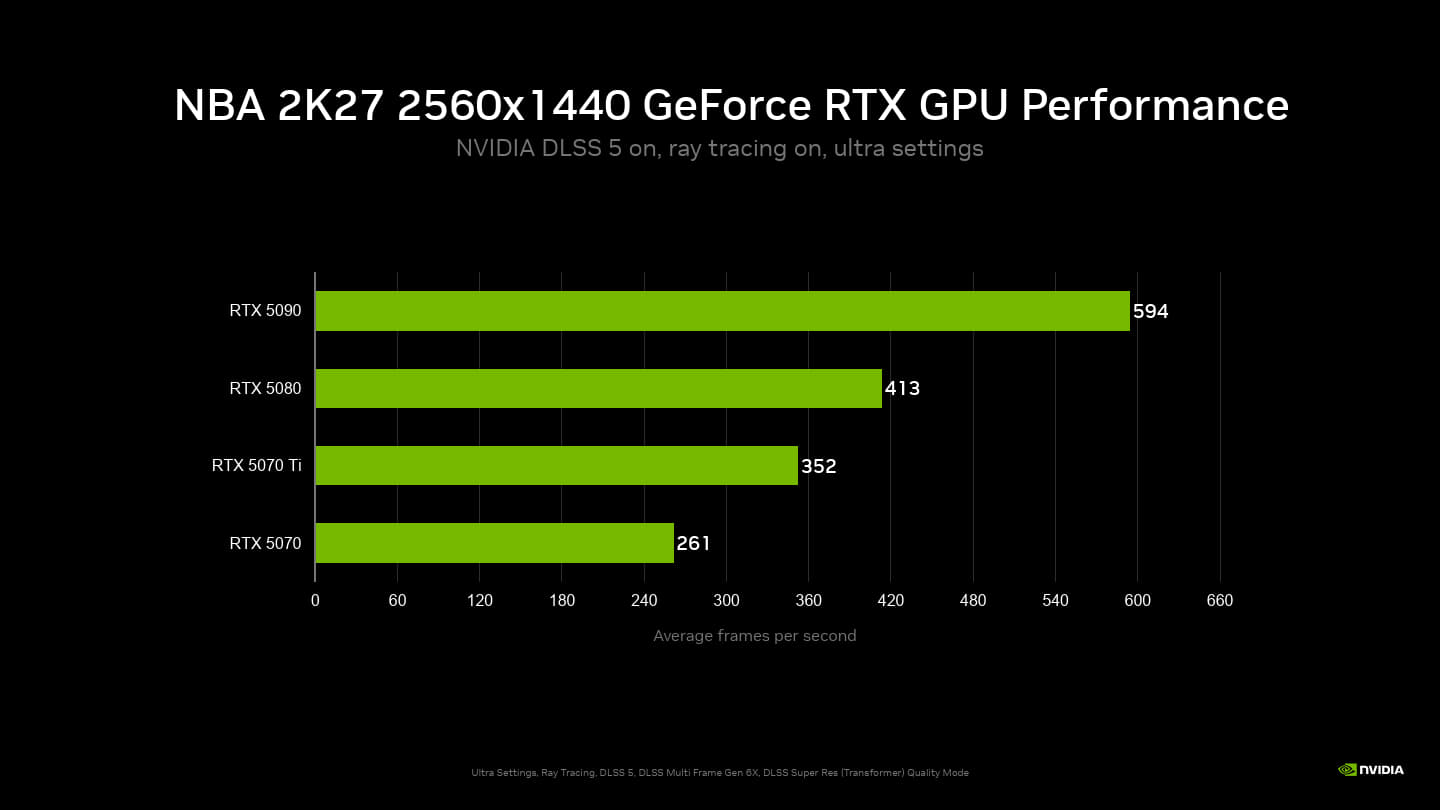
多張顯示卡在2K解析度並開啟最高畫質、光線追蹤、DLSS 5,也都能提供流暢的遊戲體驗。

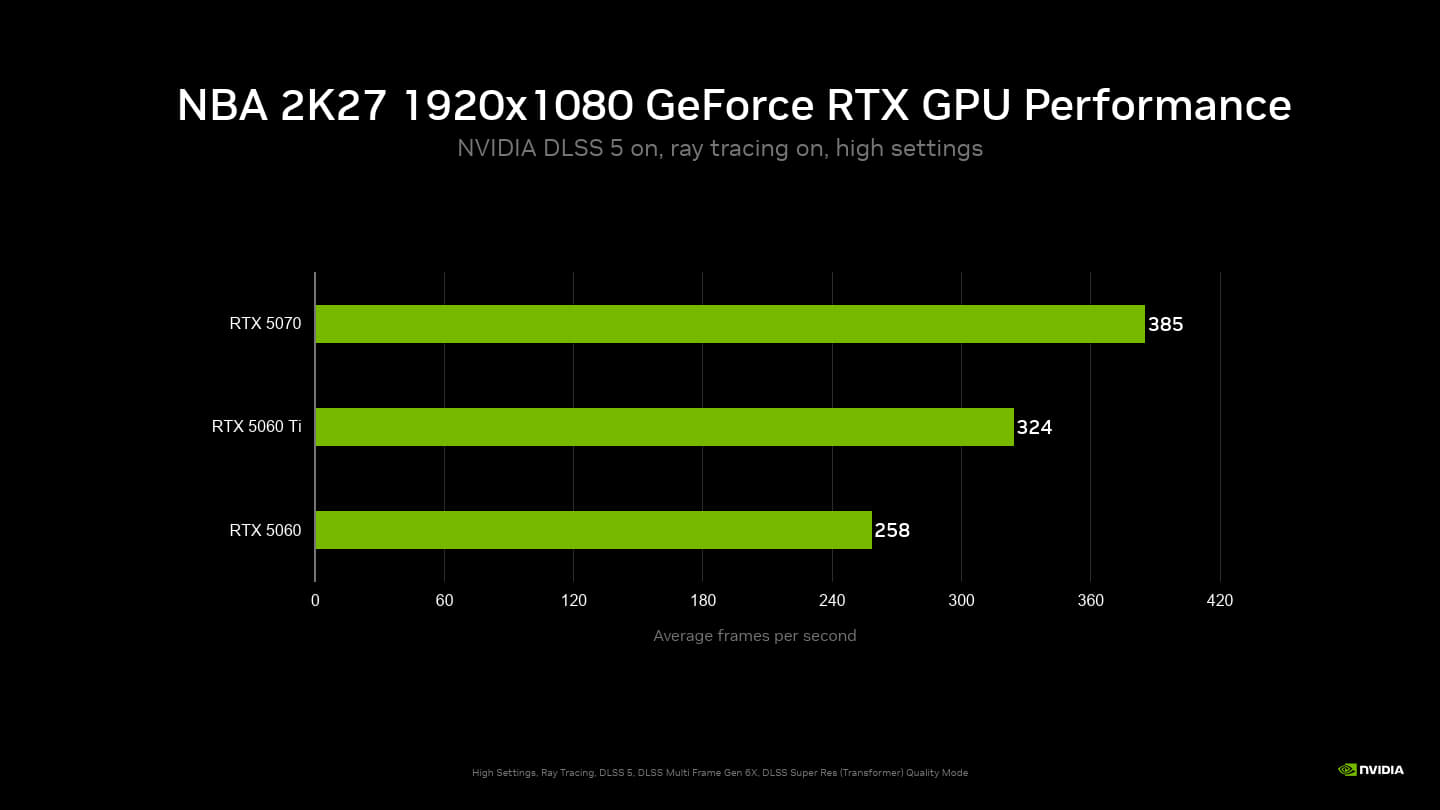
在1080p解析度將畫質調至「高」,同樣開啟光線追蹤、DLSS 5,GeForce RTX 5060仍能提供258幀的平均FPS。

GeForce RTX 50系列顯示卡使用者可以透過更新驅動程式的方式取得DLSS 5功能,而開發者則可以透過Streamline SDK或Unreal Engine 5的外掛程式將DLSS 5整合至遊戲中。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

NVIDIA DLSS 4.5光線重建實測,強化光線追蹤畫質效能不打折

NVIDIA先前於Computex台北國際電腦展2026發表DLSS 4.5光線重建功能,並在Gamescom 2026大會正式推出,我們一起來看看它的效果如何。E14ded7da2b83c4bc43040402e1dc7f6

NVIDIA先前於Computex台北國際電腦展2026發表DLSS 4.5光線重建功能,並在Gamescom 2026大會正式推出,我們一起來看看它的效果如何。

升級模型強化光線重建效果

NVIDIA DLSS 4.5升頻技術整合第2代Transformer模型、6X多重畫格生成、動態畫格生成、強化畫格生成模型等等。這次推出的新功能為在上述基礎將光線重建功能所使用的模型也升級至第2代Transformer模型,強化光線追蹤與路徑追蹤遊戲的畫質表現。

延伸閱讀:
《電馭叛客2077:自由幻局》資料片加入全新任務與地區,NVDIA DLSS 3.5光線重建技術強化畫質且效能更好
【CES 2026】NVIDIA發表DLSS 4.5效能禁藥,第2代超解析度Transformer模型、6X多重動態畫格生成,強化遊戲畫質與效能
NVIDIA DLSS 4.5效能禁藥實測,6X多重畫格生成效能突破天際

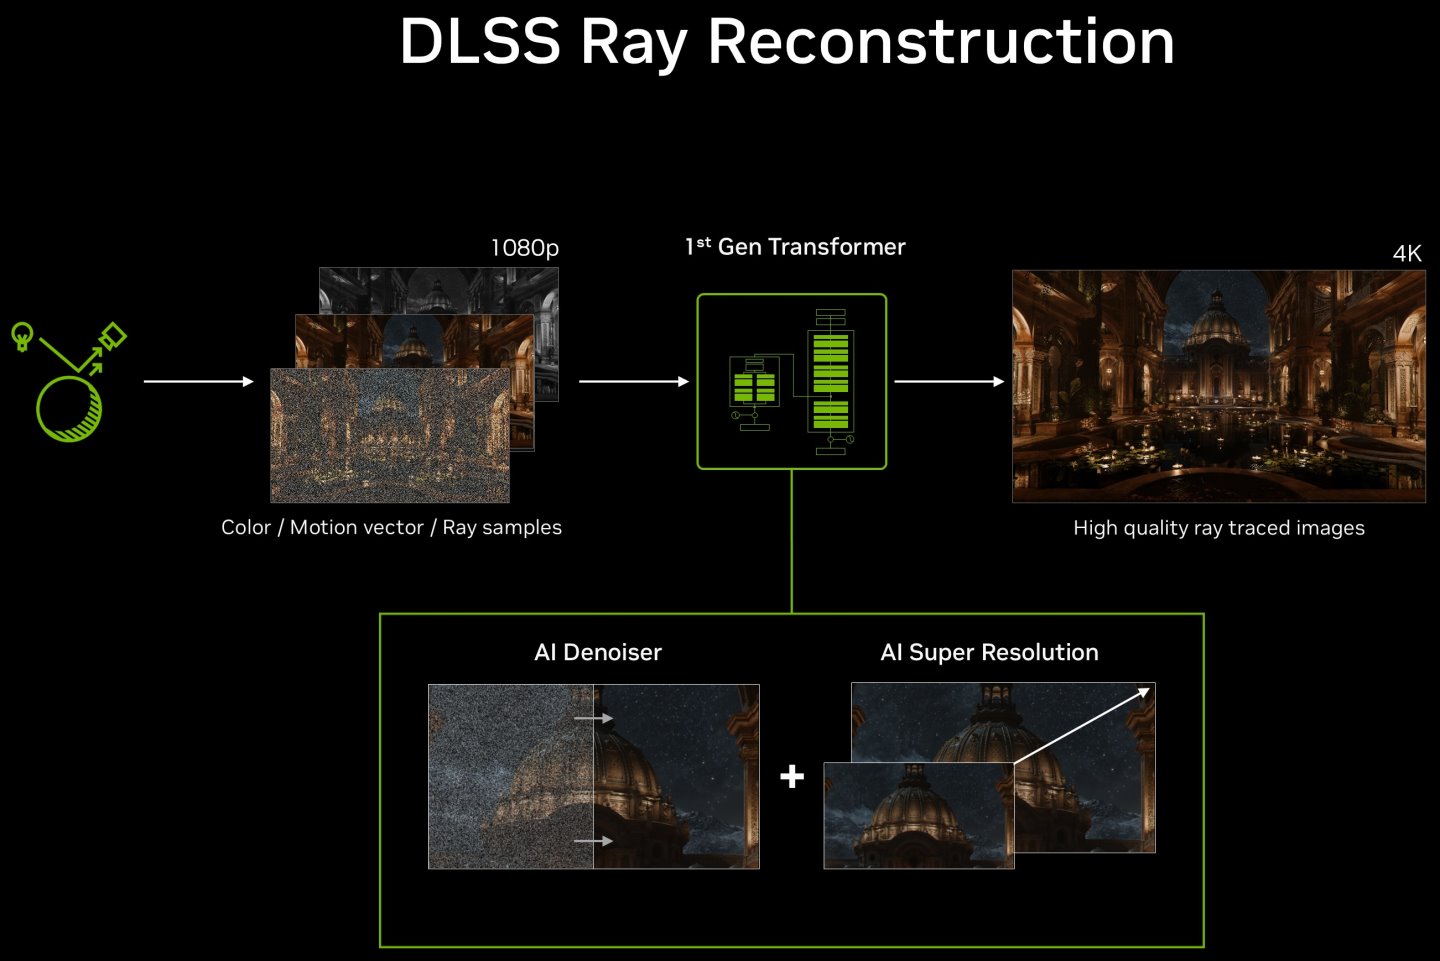
光線重建功能首次由DLSS 3.5開始提供,DLSS 4.5光線重建功能使用的模型整合降噪與超解析度等技術,透過AI推論的方式取代傳統降噪器,以改善畫面中未被光線取樣的雜訊問題,以提升畫質並降低鬼影等瑕疵,重大改進項目如下:

高效降噪器:新模型的參數量增加20%,運算能力提升35%,能夠維持與前代接近的效能

強化超解析度:具有更深入的空間感知能力,並能更聰明運用遊戲引擎提供的像素取樣與動態向量等資料,有助於提升光線追蹤精確度,帶來更穩定、清晰的畫面

擴展訓練資料集:新模型使用更大型的資料集進行AI模型訓練,具備更強的感知能力,能夠挑選最精確的引擎資料,以重建更接近實際情況的場景

更精細的開發者控制機制:提供更詳細的選項讓開發者精準調校模型的回應行為,進一步提升影像畫質

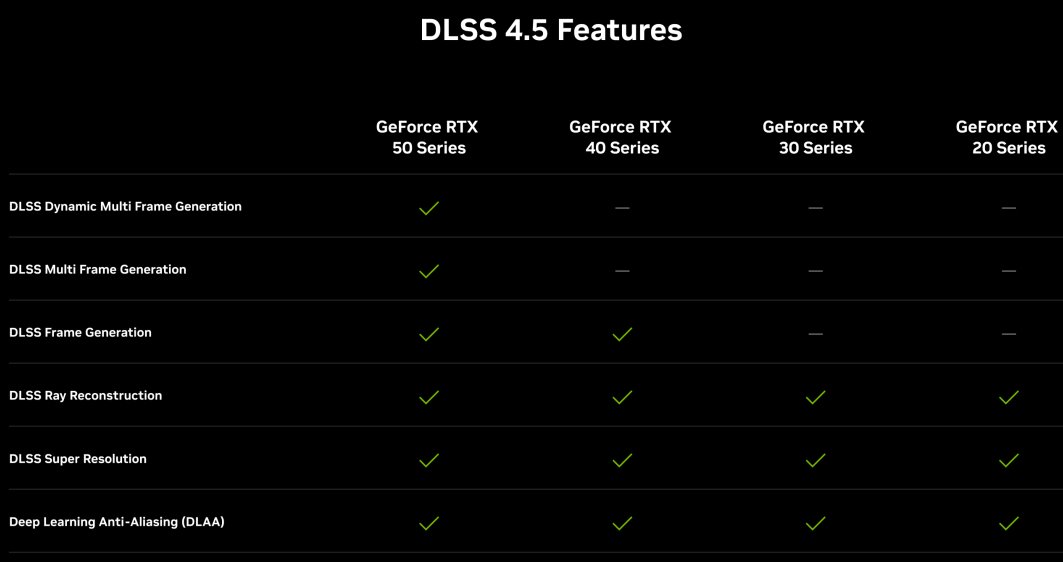
DLSS 4.5光線重建功能可在RTX 20世代之後的所有GeForce RTX顯示卡上執行,玩家只需更新驅動程式即可使用此項新功能。

DLSS 4.5光線重建功能將降噪與超解析度技術整合為單一模型,能夠分析遊戲引擎的時域(Temporal)與空間(Spatial)資料,重建出更銳利、更穩定且準確度更高的高解析度遊戲畫面。

RTX功能與歷代顯示卡的相容性對照表,DLSS 4.5光線重建可在所有GeForce RTX顯示卡上執行。

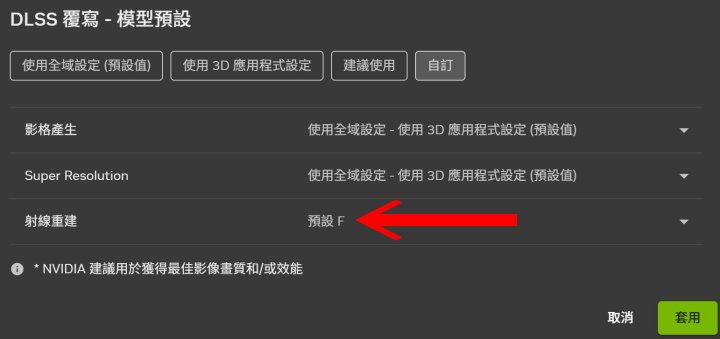
更新NVIDIA顯示卡驅動程式後,玩家從NVIDIA App內的DLSS模型覆寫選擇Preset F模型即可啟用DLSS 4.5光線重建。

DLSS 4.5光線重建效果實測

筆者使用《PRAGMATA》與《惡靈古堡 安魂曲》等遊戲,並參考NVIDIA提供的測試指南,針對DLSS 4.5光線重建與舊版模型差異較為明顯的場景進行測試,遊戲的畫質設定皆為開啟路徑追蹤與光線重建,並於NVIDIA App內的DLSS模型覆寫選擇Preset F模型。

筆者以4K解析度進行測試,所有畫質相關選項皆調至最高(部份設定值與測試指南建議不同),並開啟4X多重畫格生成。請點擊連結查看《PRAGMATA》與《惡靈古堡 安魂曲》的詳細設定。


2款遊戲的測試方式為參考下列展示影片的流程手動操作2輪並使用NVIDIA FrameView工具測量FPS數據並取平均。

測試平台:
處理器:AMD Ryzen 7 9800X3D
散熱器:MSI MEG Coreliquid S360
主機板:ASRock X870E Taichi(UEFI版號:4.03.TS04 – AMD AGESA ComboAm5PI 1.2.7.1)
記憶體: G.Skill Trident Z5 Neo RGB 16GBx2(@DDR5-7200)
顯示卡:NVIDIA GeForce RTX 5090 Founders Edition
儲存裝置:Samsung 9100 Pro 1TB(系統碟)、Solidigm P41 Plus 1TB(遊戲碟)
電源供應器:MSI MEG Ai1300P PCIE5
軟體環境:Windows 11專業版25H2(Build 26200.9168),GeForce Game Ready 610.88測試版

▲在《PRAGMATA》中使用舊版光線重建模型的話,可以看到畫面中本應消失的雷射光產生鬼影。

▲透過NVIDIA App選擇代表DLSS 4.5光線重建功能的Preset F模型後,雷射光就不再有鬼影問題。

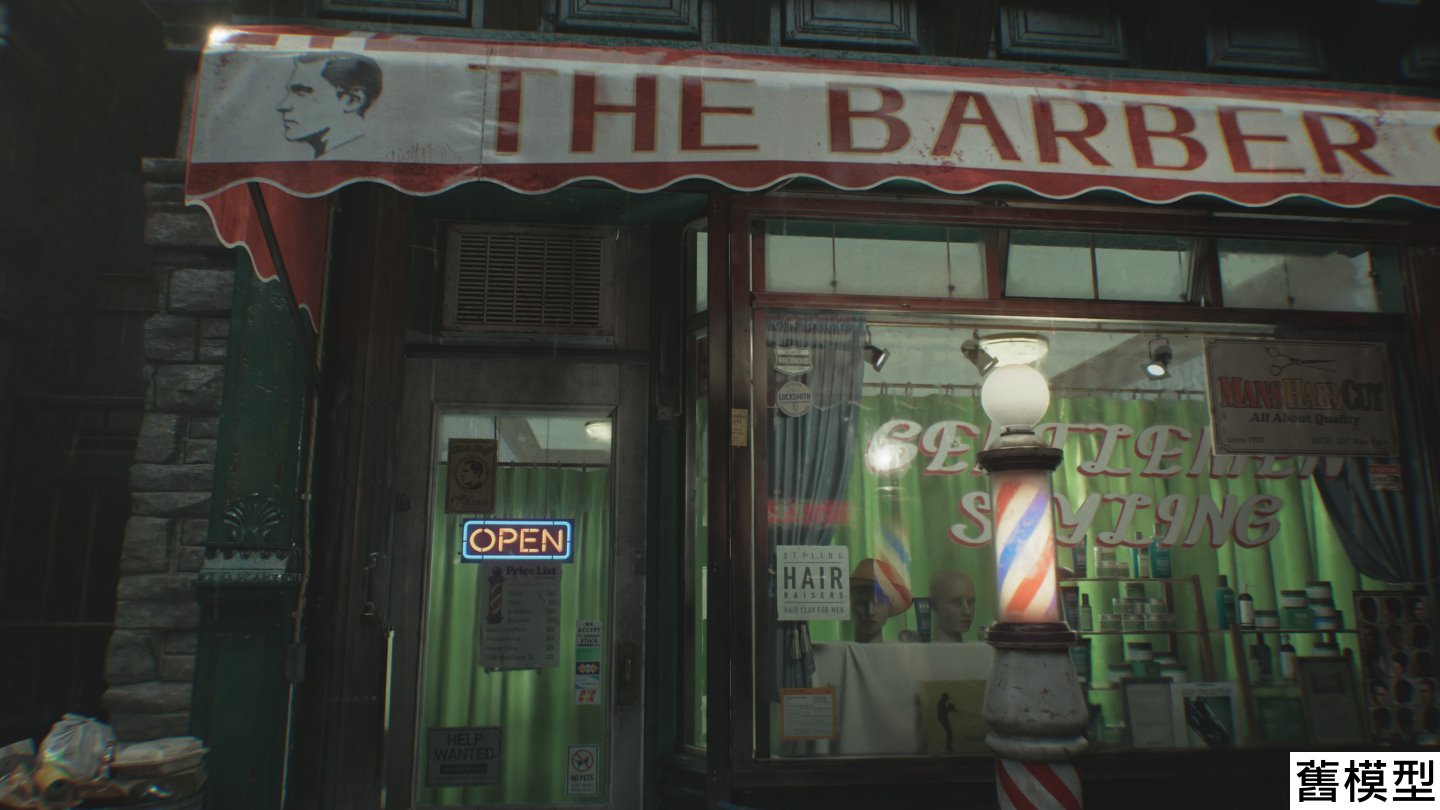
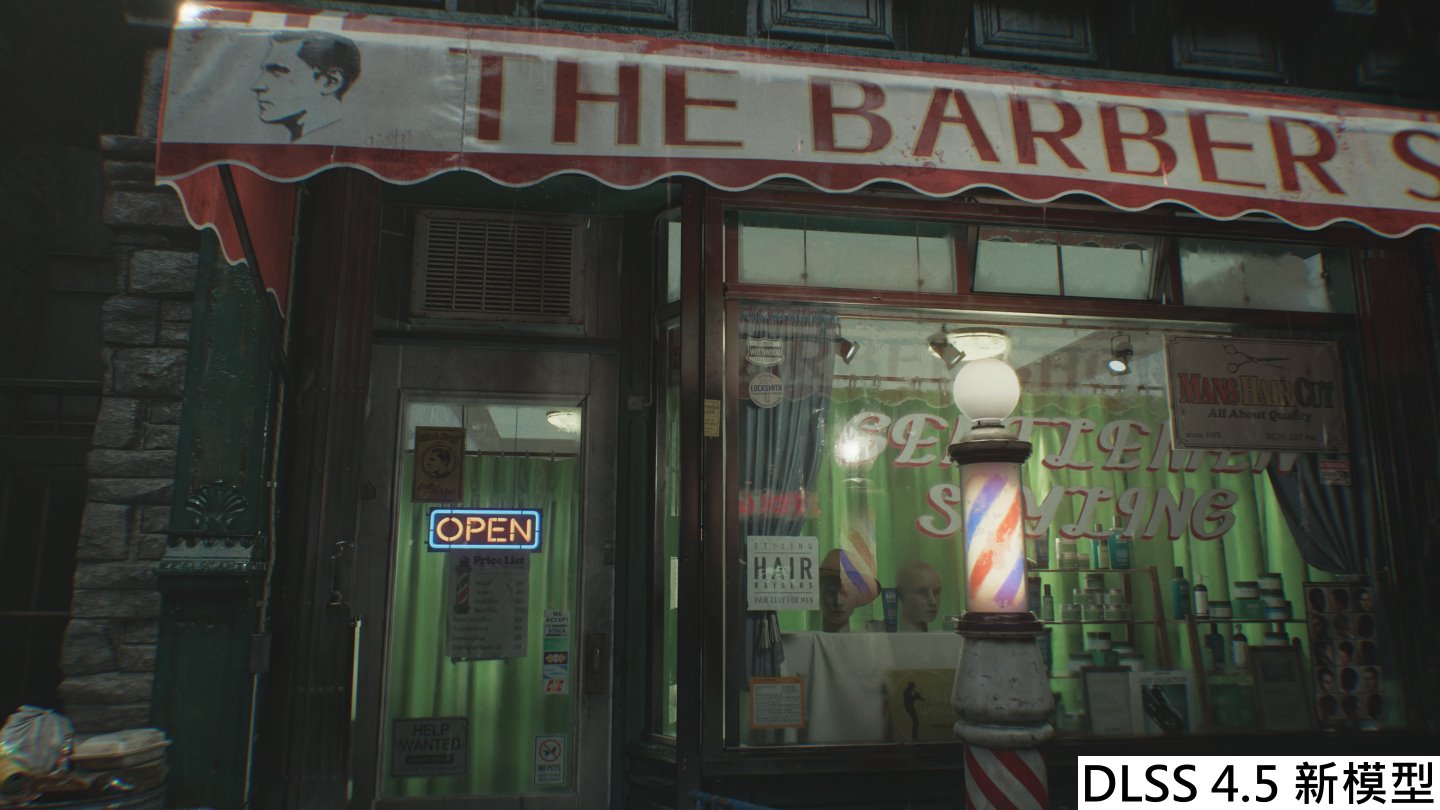
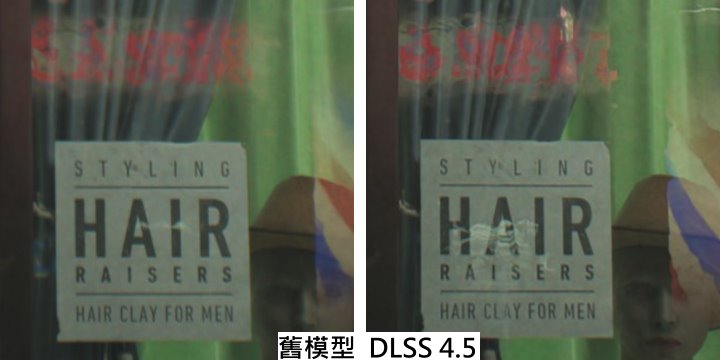
看到《惡靈古堡 安魂曲》的部分,舊版光線重建模型處理玻璃上倒影的效果比較差。

DLSS 4.5光線重建則能帶來較為清晰的倒影。

觀察玻璃上的紅色霓虹燈倒影,可以看到DLSS 4.5光線重建保留較多細節。(圖為1:1裁切4K解析度之遊戲擷圖,下同)

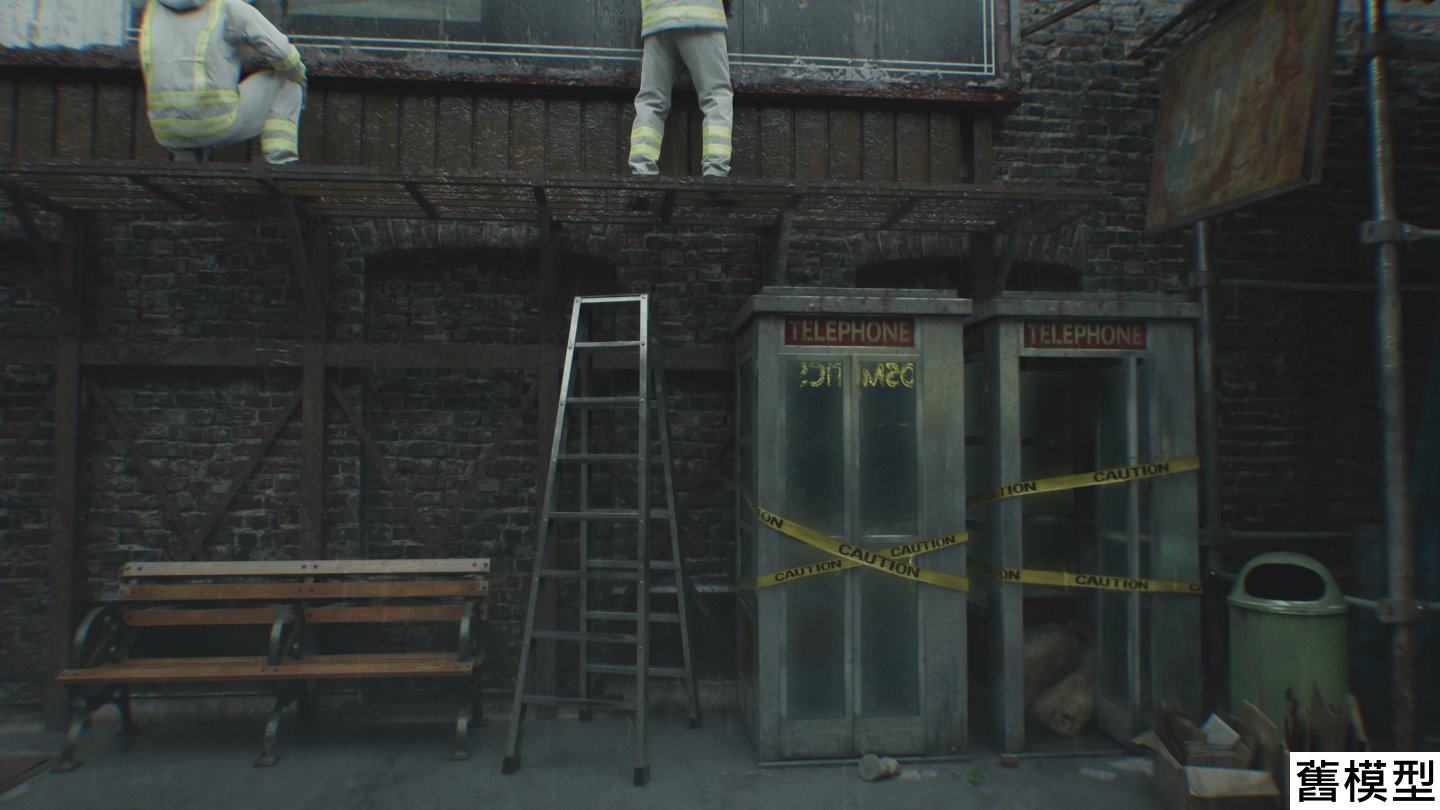
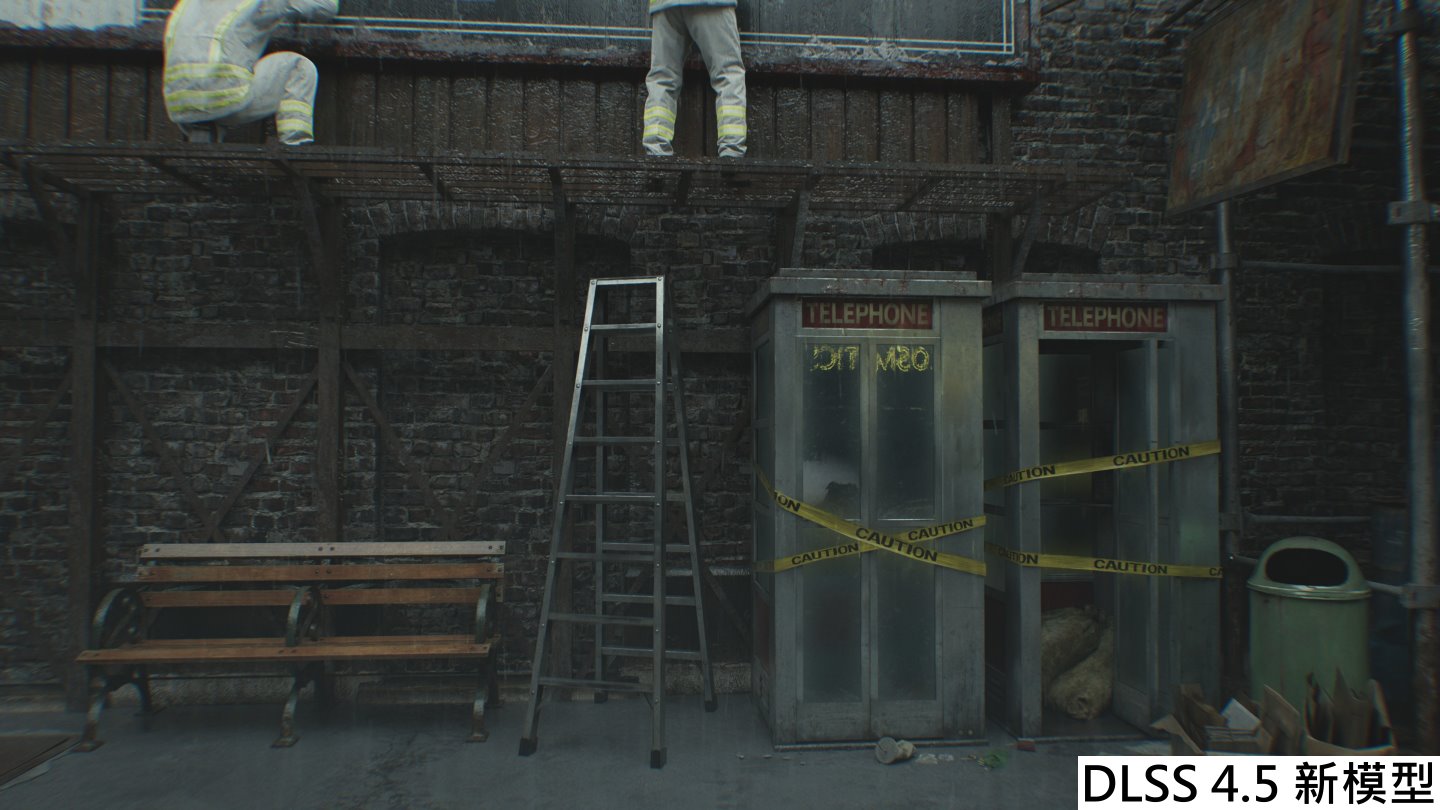
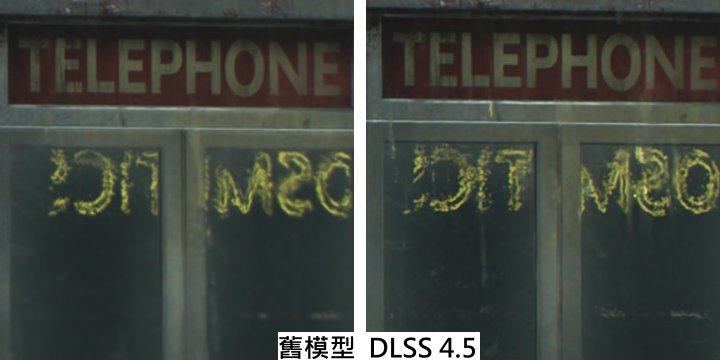
接下來在另一個場景中看到雨中的電話亭的倒影,DLSS需要同時處理雨滴與霓虹燈倒影等圖像變因。

啟用DLSS 4.5光線重建後可以看到較為清晰的雨滴效果。

新舊模型的1:1裁切對照圖。

▲《惡靈古堡 安魂曲》使用舊版光線重建模型的動態效果展示。

▲《惡靈古堡 安魂曲》啟用DLSS 4.5光線重建後能夠改善升頻後光線追蹤的準確度。

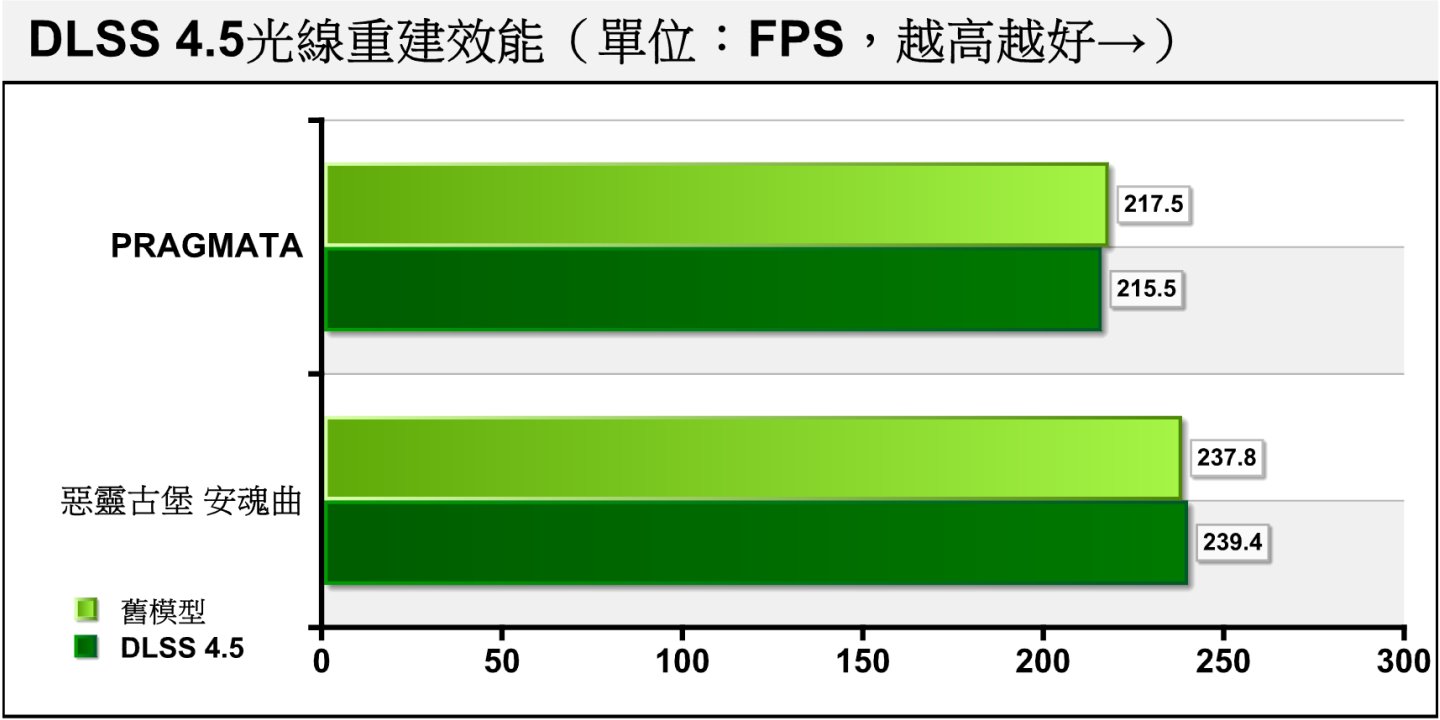
新舊模型的效能對照,DLSS 4.5光線重建的FPS效能表現幾乎與舊版模型相同。

由於DLSS 4.5光線重建功能是依附於DLSS超解析度之下的功能,所以無論是RTX 20、RTX 30、RTX 40、RTX 50世代的GeForce RTX系列顯示卡都能在更新驅動程式之後使用此功能,且根據測試結論可以看到對效能的影響微乎其微,因此相當推薦玩家升級以取得此功能。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

31年之後,聯電傳奇主機 Super A'Can 模擬器終於完美達成,重溫 1995 年國產 16 位元巔峰榮光

1995年上市的遊戲主機Super A'Can在經歷31年的時光後,終於具備高完成度的模擬器,讓這款主機的數位內容能以不同方式保存、執行。E89e4f62cb1192a4de894b8b5c0885d4

1995年上市的遊戲主機Super A'Can在經歷31年的時光後,終於具備高完成度的模擬器,讓這款主機的數位內容能以不同方式保存、執行。

台灣之光遊戲主機

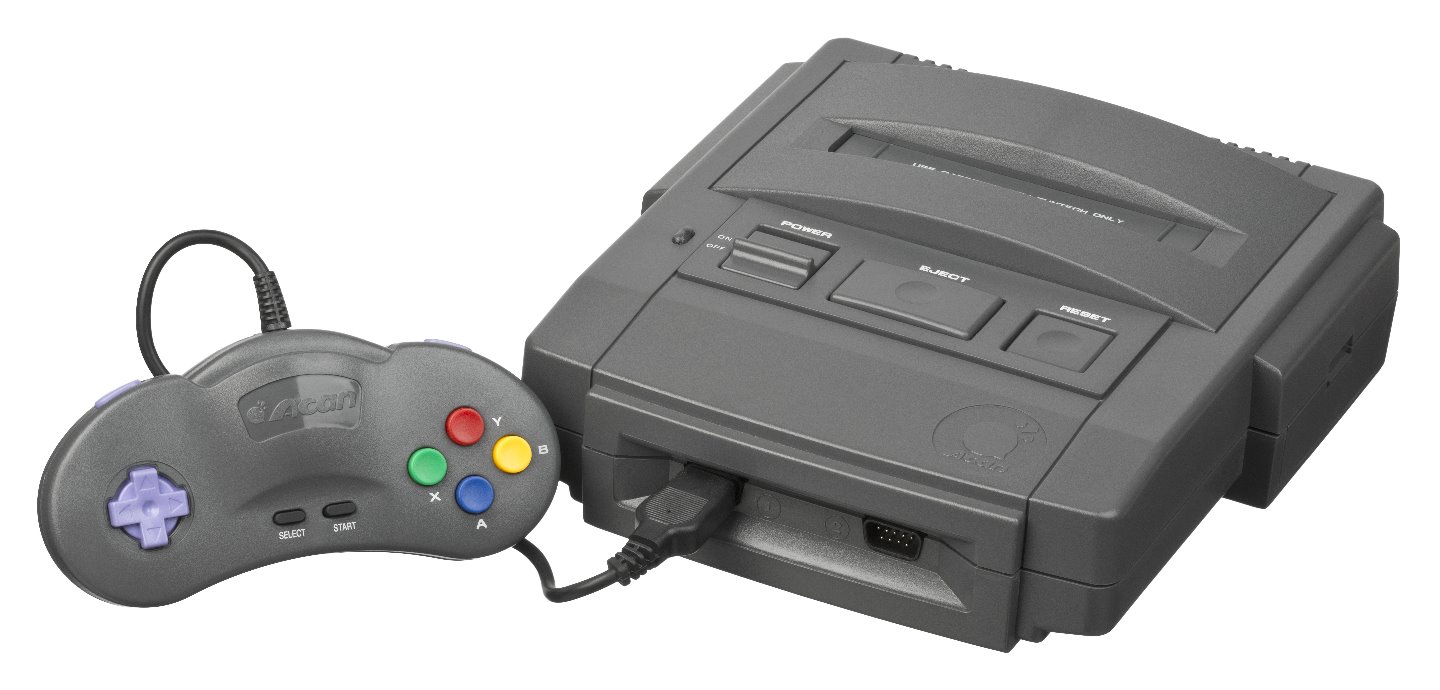
UMC(聯華電子)的子公司敦煌科技於1995年推出代號為F-16的Super A'can遊戲主機,其發售時間晚於1989年上市的Sega Mega Drive以及1990年上市的Nintendo Super Famicom,可歸類於第4世代的16 Bit遊戲主機,並以台灣研發的中文遊戲軟體為主要賣點,打破當年中文電視遊樂器遊戲相當希少的窘境。

延伸閱讀:
【模擬器改造】Mega Drive ( MD)篇:日式精神,美式風格
【模擬器改造】SUPER Famicom 超任:2D主機最後一道夕陽餘暉
儲存介面如何影響遊戲聲光效果?從卡匣、磁片到現代媒介的遊戲演化

Super A'can搭載時脈為10.6 MHz的Motorola 68000與3.58 MHz的MOS 6502雙處理器,搭配容量為64 KB的工作記憶體、32 KB次要記憶體、128 KB顯示記憶體。

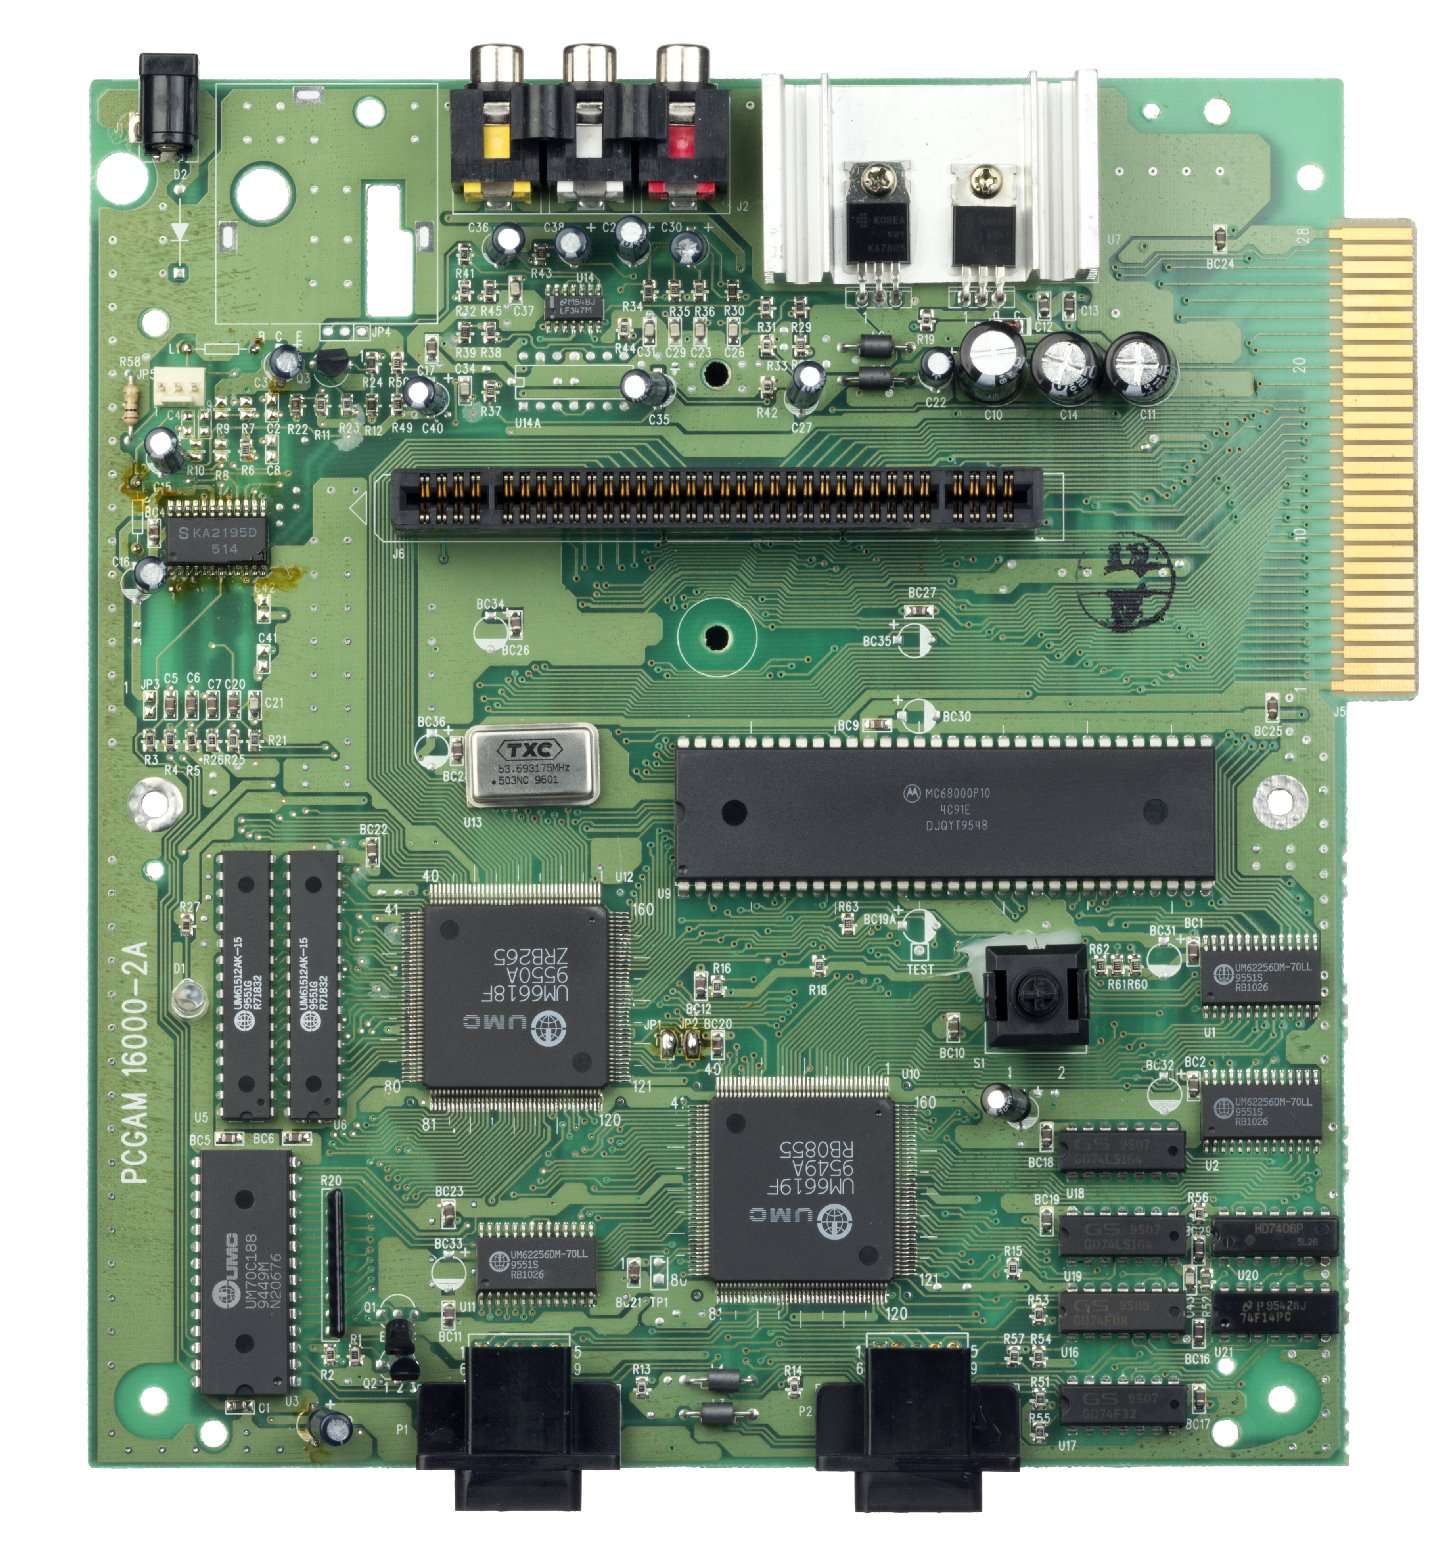
圖像處理器採用UMC UM6618顯示能力為640 x 480解析度、能夠同時顯示32768色中的256色,支援4層背景,可動角色圖層(Sprite)解析度可達256 x 256,並支援透明、旋轉、放縮、馬賽克等特效。音效處理器採用UMC UM6619,支援16組PCM音源。

然而Super A'can並沒有取得商業上的成功,生命週期中僅推出12款遊戲,加上11款開發中、未上市的遊戲,就黯然退出遊戲主機爭霸戰的舞台。

Super A'can的主機硬體與遊戲軟體都是由台灣研發、製作,在遊戲發展史算是比較特別的存在。

Super A'can採用許多UMC生產的機晶片,包含UM6618圖像處理器與UM6619音效處理器。值得注意的是主機板右側的金手指功能為連接周邊擴充裝置之用,但是Super A'can並沒有撐到擴充裝置上市就結束生命。

Super A'can的遊戲皆為鉅崴科技、熊貓軟體、敦煌科技在內的台灣廠商研發,故皆為中文遊戲。

模擬器動手玩

模擬器界的台灣傳奇人物Billy Jr先前就曾著手開發Super A'Can模擬器,並在2004年推出第一版模擬器,並在2010年正式納入MESS(Multi Emulator Super System)多系統模擬器,但是一直到2026年8月30日才由Billy Jr釋出高度完成的Super A'Can模擬器「Bcan」。

Super A'Can模擬器開發過程相關的故事,可以參考Billy Jr於Facebook粉絲團的貼文,文章的回覆也提供Bcan模擬器0.08b版的下載連結(Mega空間載點)。

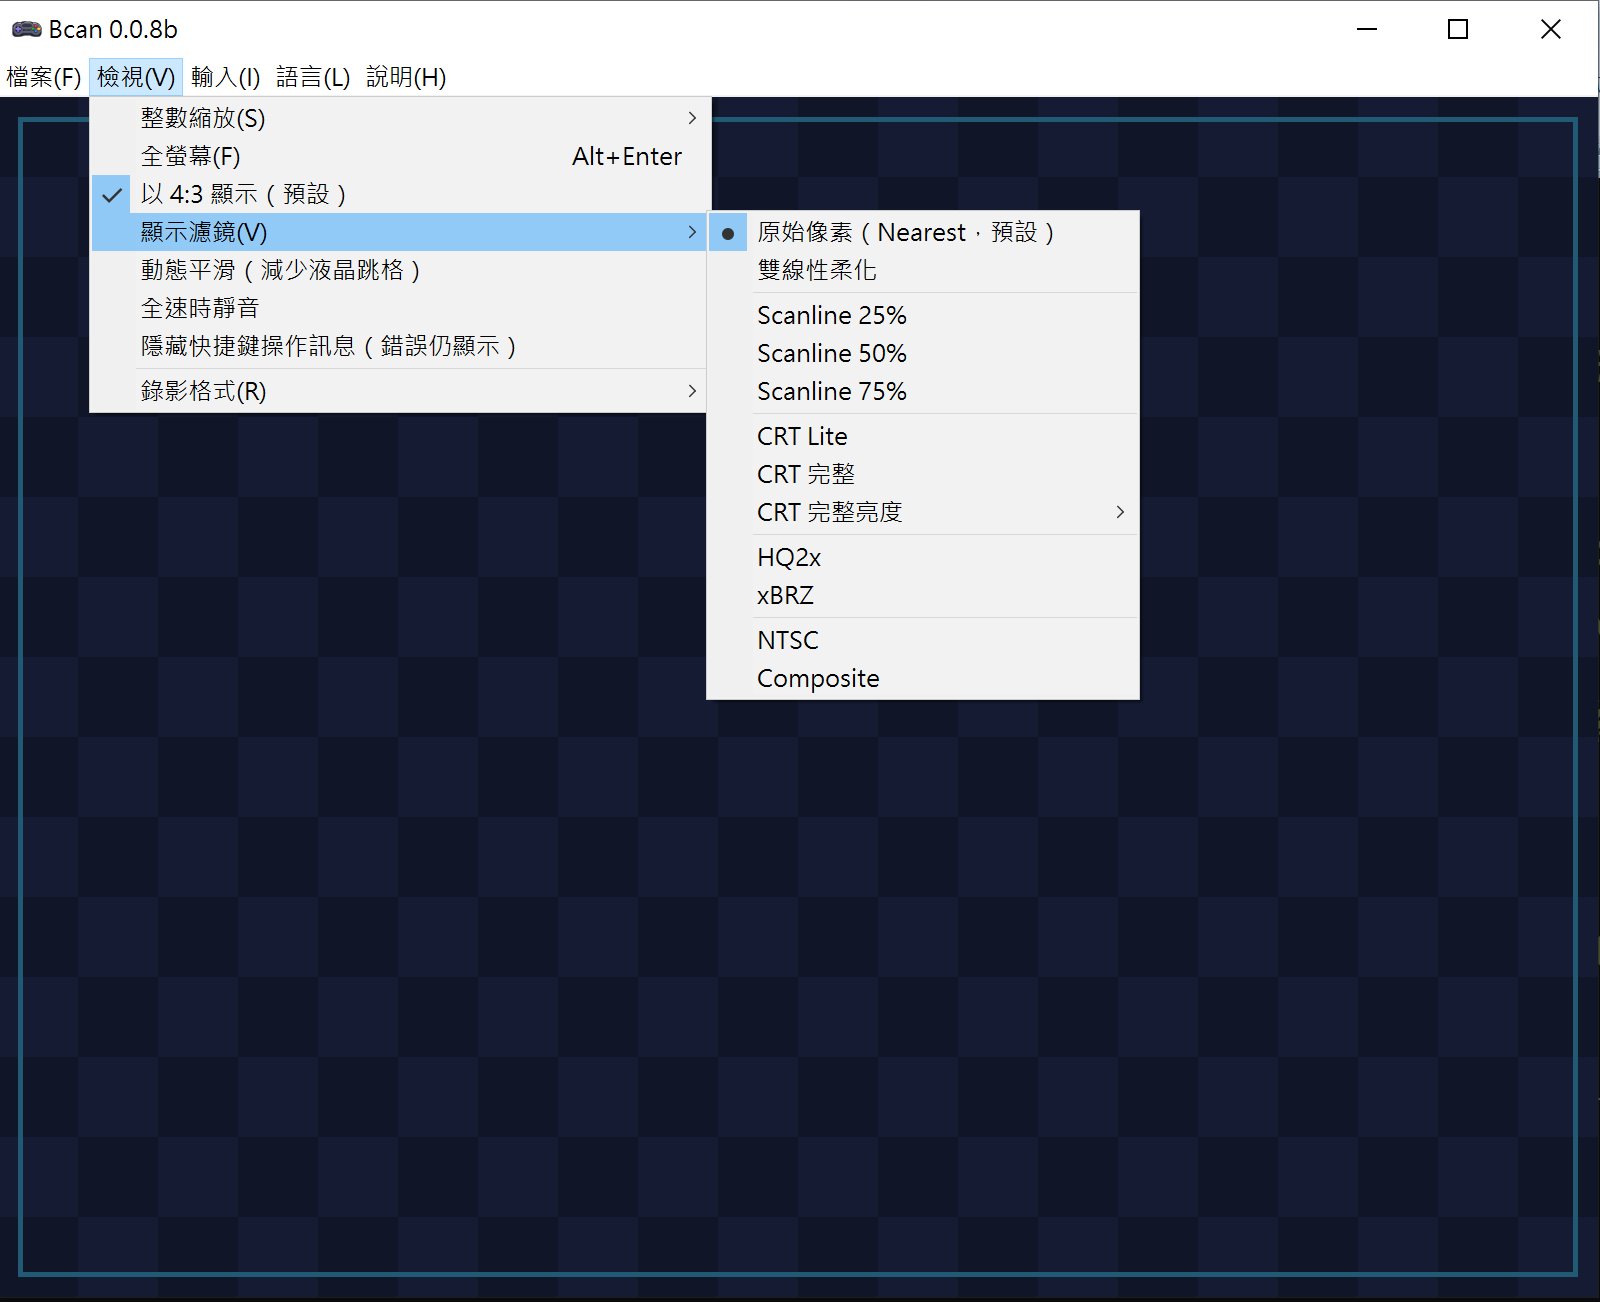
Bcan模擬器0.0.8b版的功能相當完整,提供多種螢幕縮放、濾鏡效果以及即時存檔等功能,並支援手把操作。筆者隨意測試幾款遊戲,執行狀況皆相當理想,畫面與音效準確度也相當高,果然高手出手就是不一樣。

Bcan模擬器採用僅支援Super A'Can系統的獨立式設計,操作上相對比較簡單。

Bcan模擬器0.0.8b版提供多種濾鏡效果,可以模擬映像管電視的效果。

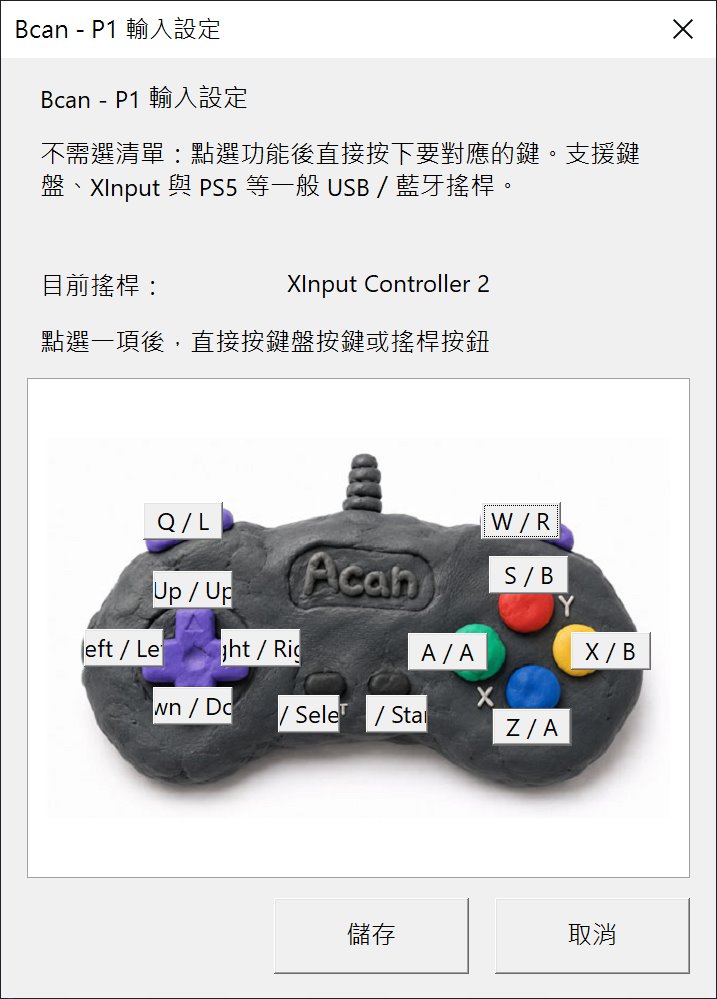
玩家可以設定使用鍵盤或是手把進行操作。

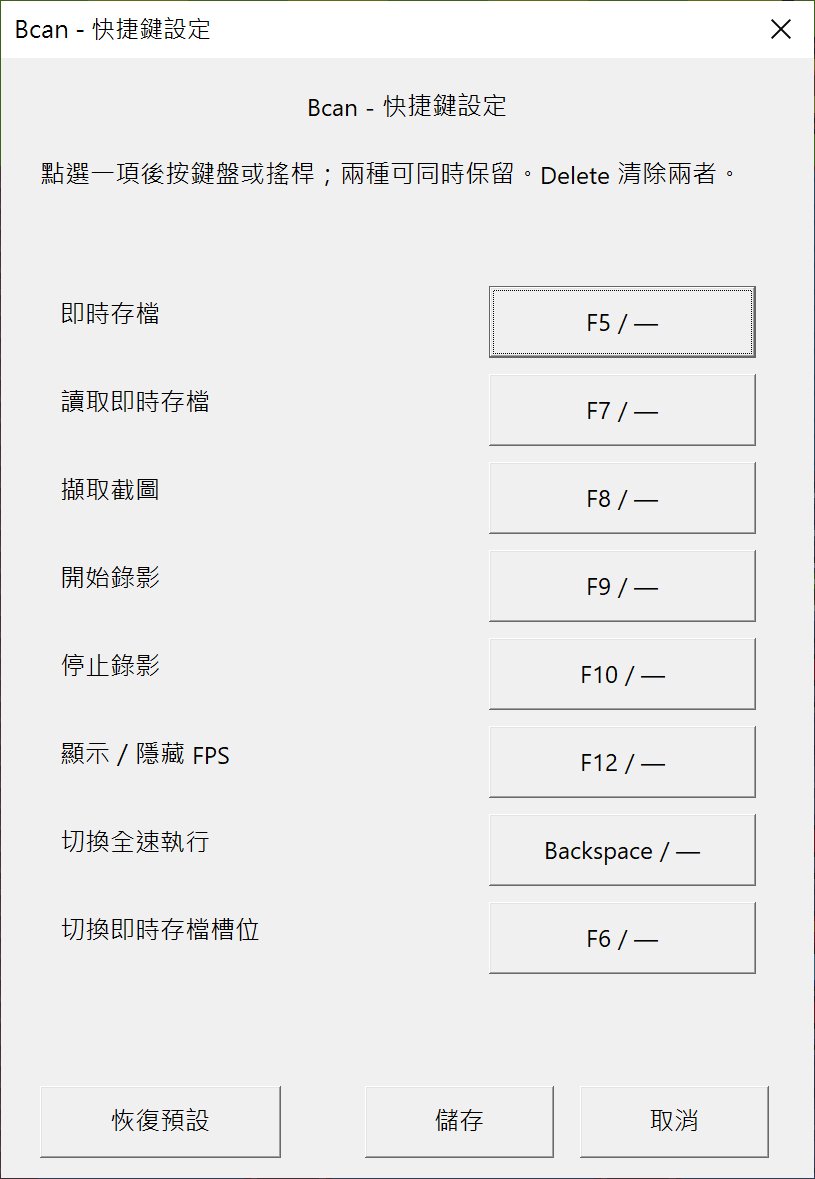
模擬器的多種功能也能自行設定熱鍵。

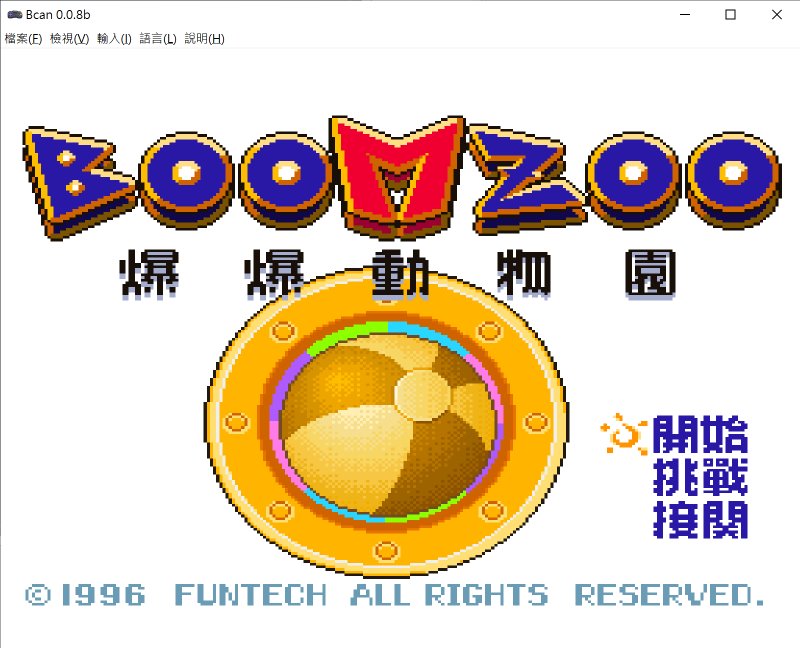
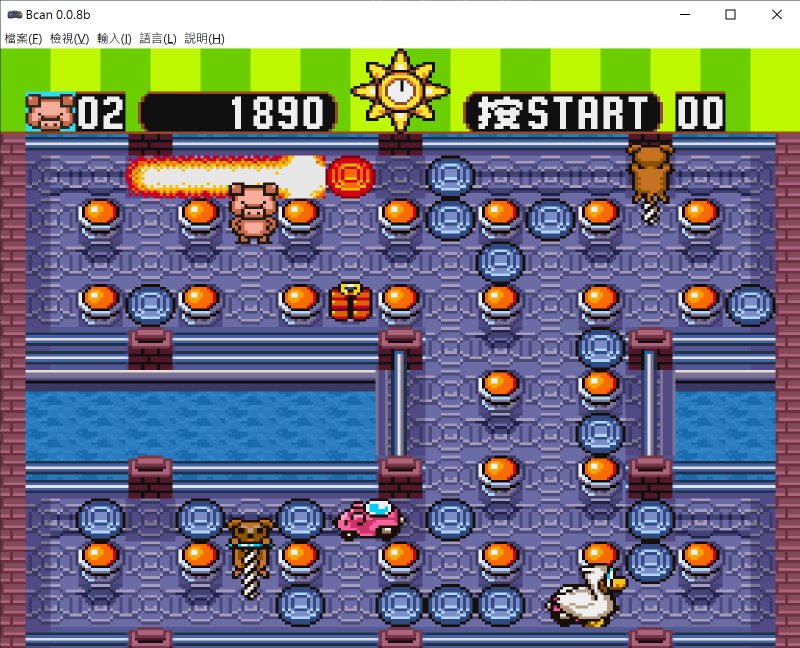
首先看到《爆爆動物園》遊戲的執行狀況。

它是款仿製《轟炸超人》(Bomberman)的遊戲。

▲《爆爆動物園》的畫面與音效一切正常。

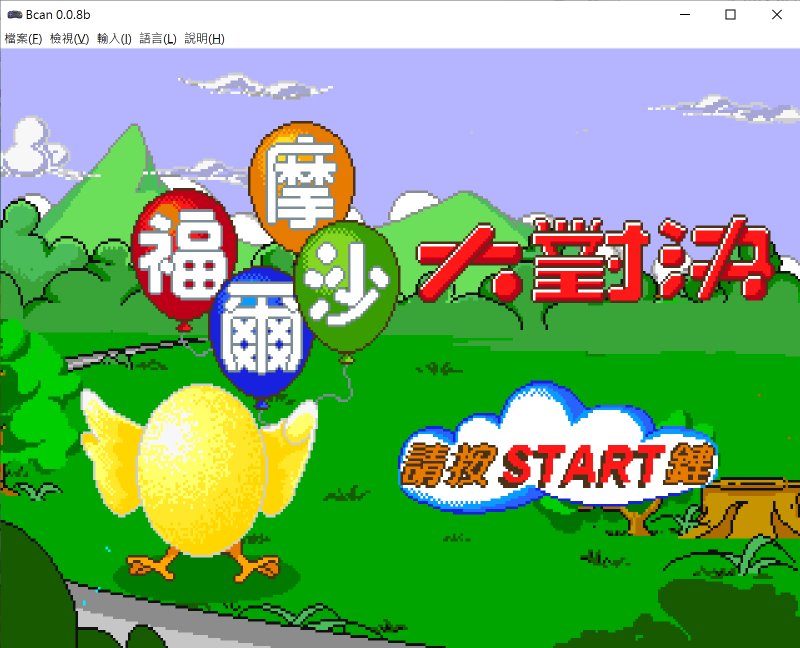
接下來看到《福爾摩沙大對決》。

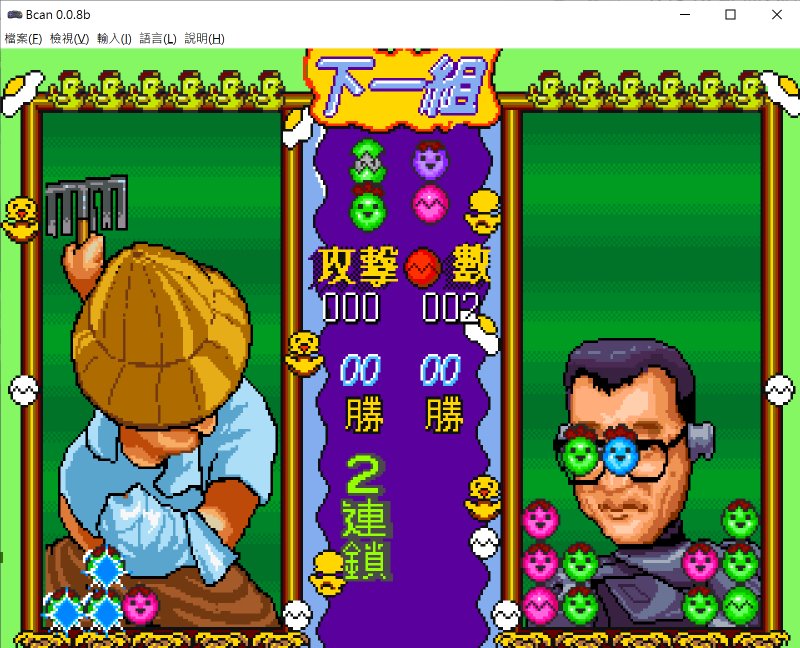
它是款與《對戰方塊》(Battle Puzzle Dama)類似的落下型方塊遊戲。

▲《福爾摩沙大對決》的特色是具有語音演出,甚至能夠聽到親切的台語配音。

從Bcan模擬器終於問世,可以從中看到模擬器開發工作並不簡單,尤其是Super A'Can中使用多款UMC客製化的晶片並沒有可以參考的規格與資料,有興趣瞭解更多開發秘辛可以參考參與Bcan模擬器測試工作的低分少年所製作的《台灣國產遊戲機 A'Can 模擬器正式完成!》影片。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

Intel於Hot Chips 2026展示代理式AI與企業級產品,Diamond Rapids導入Intel 18A-P製程與扇出拓樸

Intel展示代號為Diamond Rapids的次世代Xeon處理器,它除了採用最新Intel 18A-P節點製程,也搭配Foveros Direct 3D先進封裝與UCIe-S互連技術。90b34fd570e5ccb081f69891f2d748fc

Intel展示代號為Diamond Rapids的次世代Xeon處理器,它除了採用最新Intel 18A-P節點製程,也搭配Foveros Direct 3D先進封裝與UCIe-S互連技術。

256核心搭1.28 GB LLC

Intel於Hot Chips 2026大會展示Diamond Rapids處理器、Crescent Island GPU(繪圖處理器)等針對企業用戶規劃的代理式AI產品,以及針對消費級應用設計的Wildcat Lake處理器,並詳細介紹這些產品的特色。首先我們先看到Diamond Rapids的部分,並於後續文章中繼續探討。

延伸閱讀:
Intel於IFS Direct Connect 2024宣布與聯電合作,並發表Intel 14A與多項「4年5節點」之後發展路線圖
Intel說明Xeon 6處理器與Gaudi 3加速器優勢,雙路處理器給你滿滿192條PCIe Gen 5通道
Intel推出新款Xeon 6處理器,強化AI運算效能與效益還能跑DeepSeek

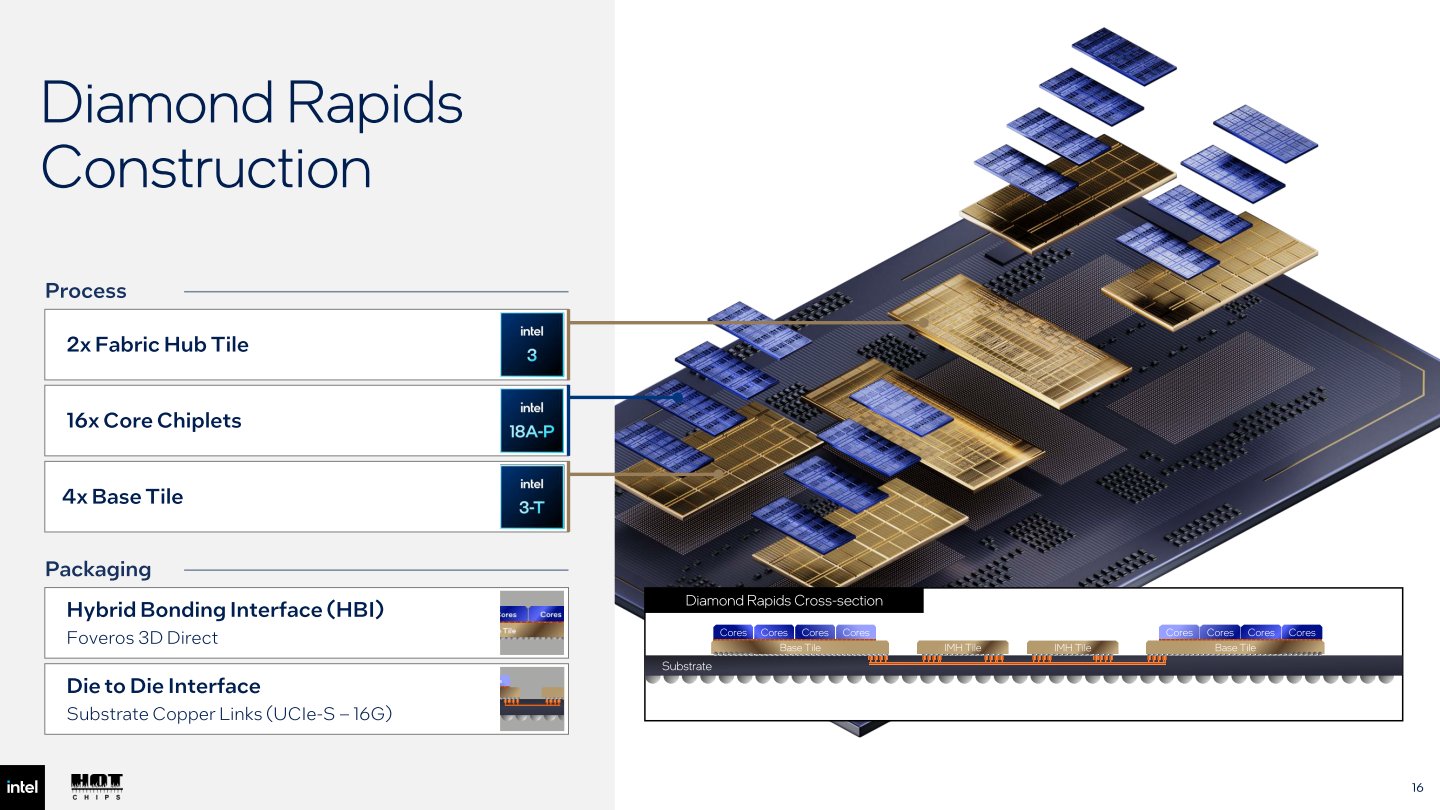
代號為Diamond Rapids的次世代Xeon處理器針對包含企業級代理式AI在內的多種用途設計,導入全新架構,結合可靈活配置的運算模組、統一記憶體互連架構與彈性I/O,並採用進一步強化的Intel 18A-P節點製程,搭配Foveros Direct 3D先進封裝與UCIe-S互連技術,提供穩定的高效能、高效率與可擴展性。

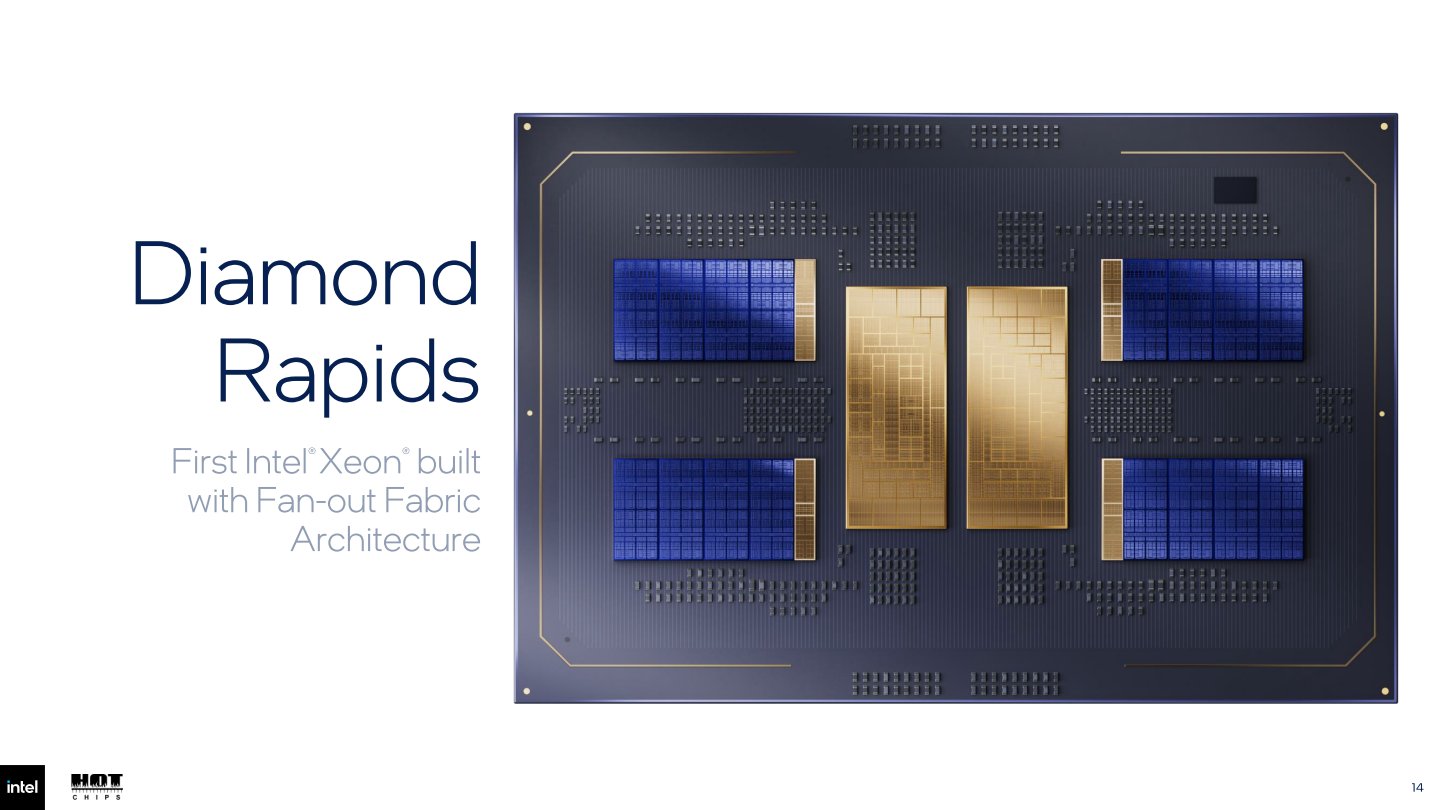
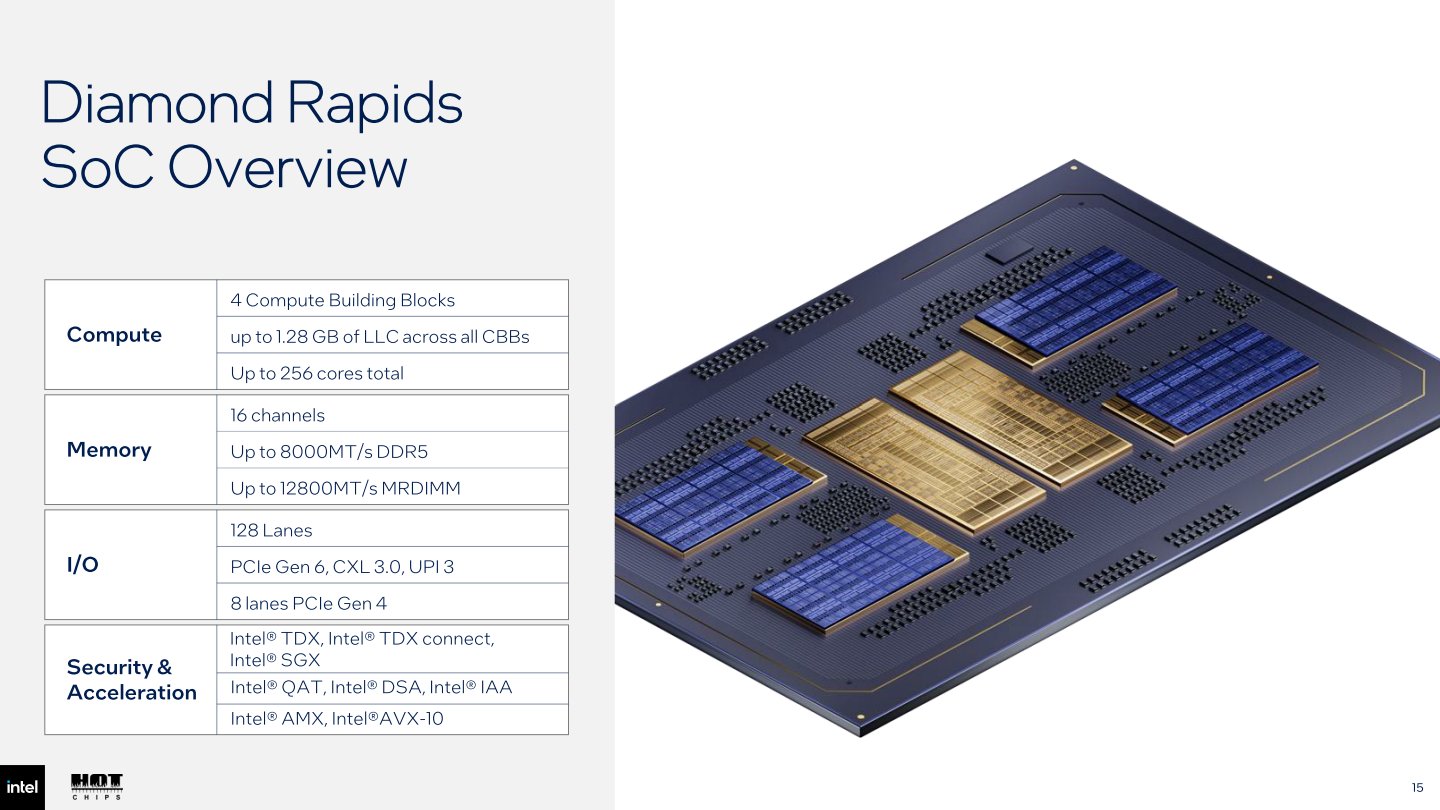
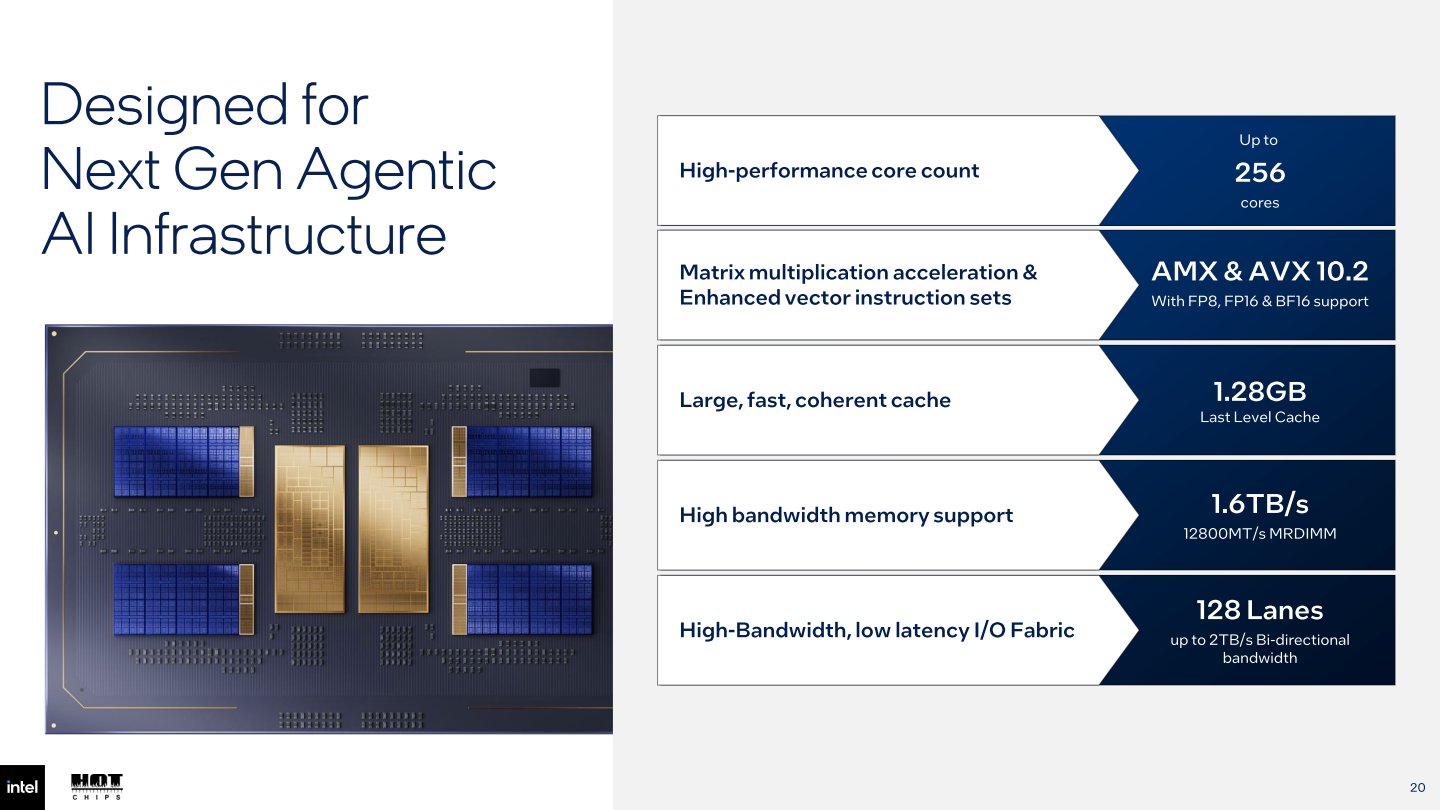
Diamond Rapids處理器最多可以容納4組運算建置模塊(Compute Building Block),每組模塊又可以容納4組運算小晶片(Compute Chiplet),而每組小晶片又能容納16組處理器核心,因此單一處理器最高可達256核心組態,並具有最高1.28 GB最後階快取記憶體(LLC,Last Level Cache)。

Diamond Rapids支援DDR5-8000 RDIMM或DDR5-12800 MRDIMM(Multiplexed Rank DIMM,多工階級雙行記憶體模組),最高可組成16通道記憶體組態。擴充能力部分則提供128組PCIe Gen 6通道與8組PCIe Gen 4通道,並支援UPI 3(Ultra Path Interconnect)與CXL 3.0(Compute Express Link)等互連技術,強化多處理器之間的資料交換,以及擴充記憶體、記憶體池化等彈性擴充功能。

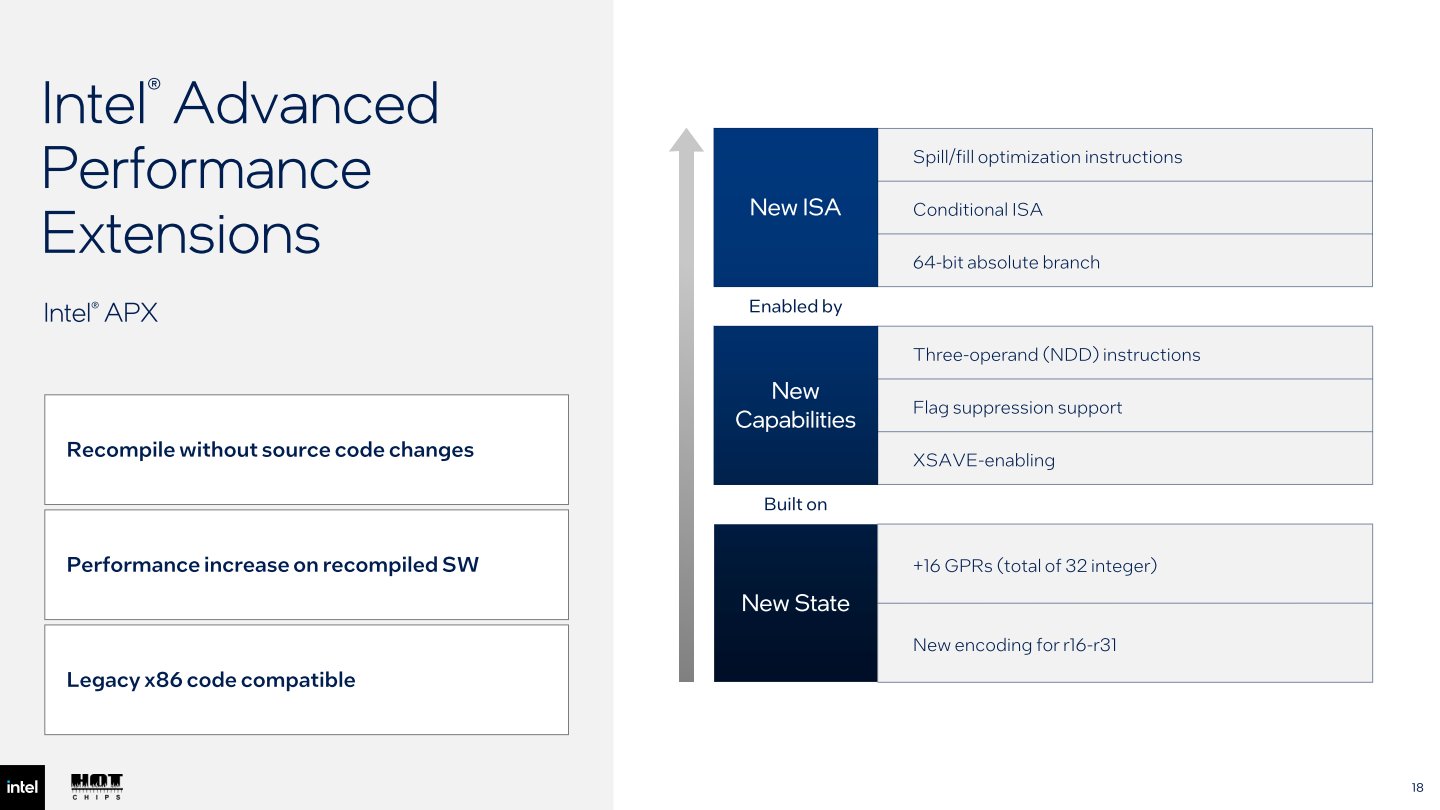
此外Diamond Rapids也支援APX延伸指令集(Advanced Performance Extensions)與AMX進階矩陣延伸指令集(Advanced Matrix Extensions),以加速處理器上執行AI應用程式的效能。

Intel於Hot Chips 2026大會展示Diamond Rapids處理器,並說明其架構特色。

Diamond Rapids最高可達256核心組態,並具有最高1.28 GB最後階快取記憶體。

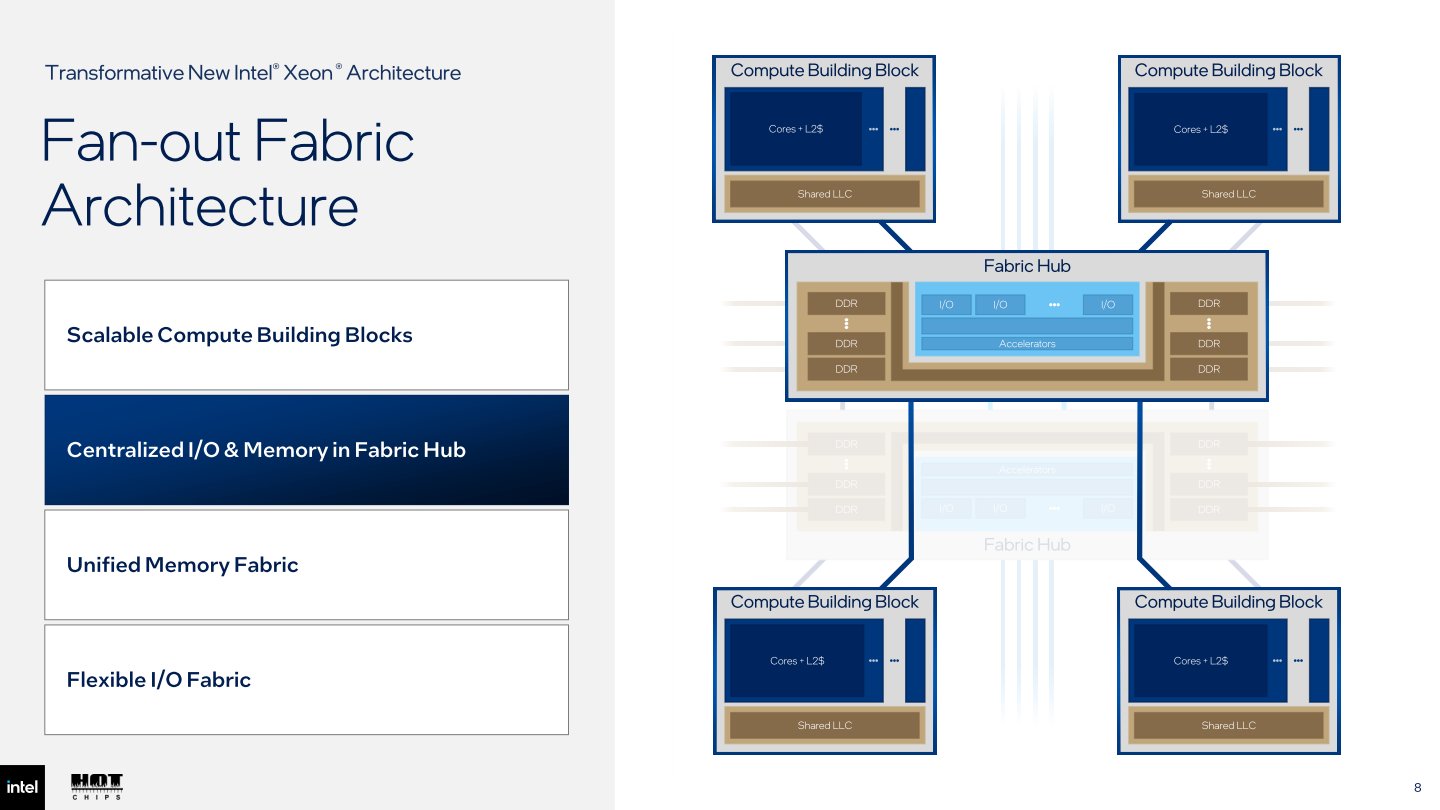
其處理器核心分散在4組運算建置模塊上,而承載核心的運算小晶片採用Intel 18A-P節點製程。此外處理器還有2組互連集線器模塊(Fabric Hub Tile)負責記憶體存取與I/O功能。

在16通道DDR5-12800 MRDIMM記憶體的加持下,頻寬可達1.6 TB/s。

Diamond Rapids不但支援AVX10.2、AMX等指令,也加入新的APX延伸指令集(Advanced Performance Extensions),在相容x86架構的同時強化AI運算效能表現。

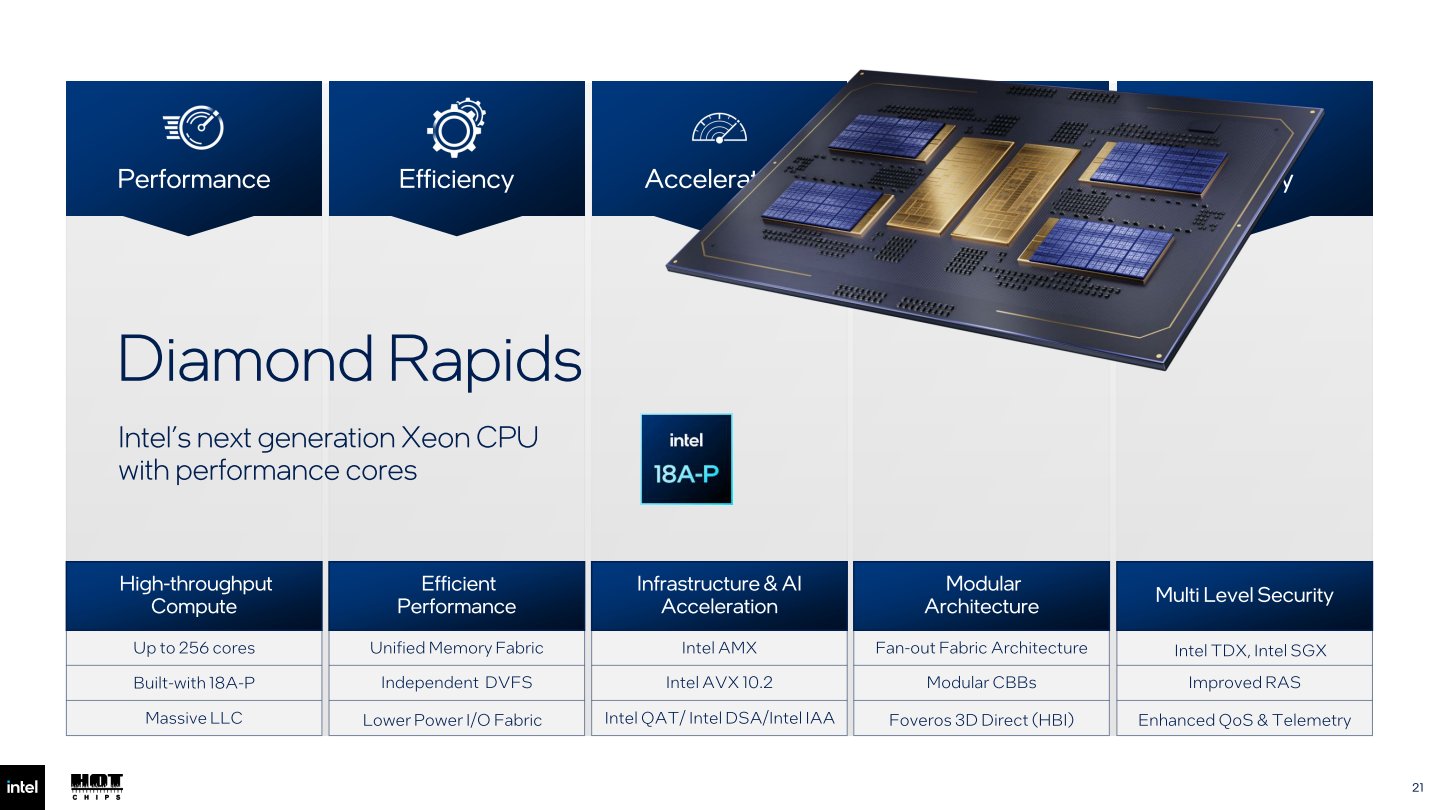
Diamond Rapids能夠兼顧效能與電力效率表現,並具有加速AI運算的能力,同時提供多層資安防護功能。

18A-P節點製程初登板

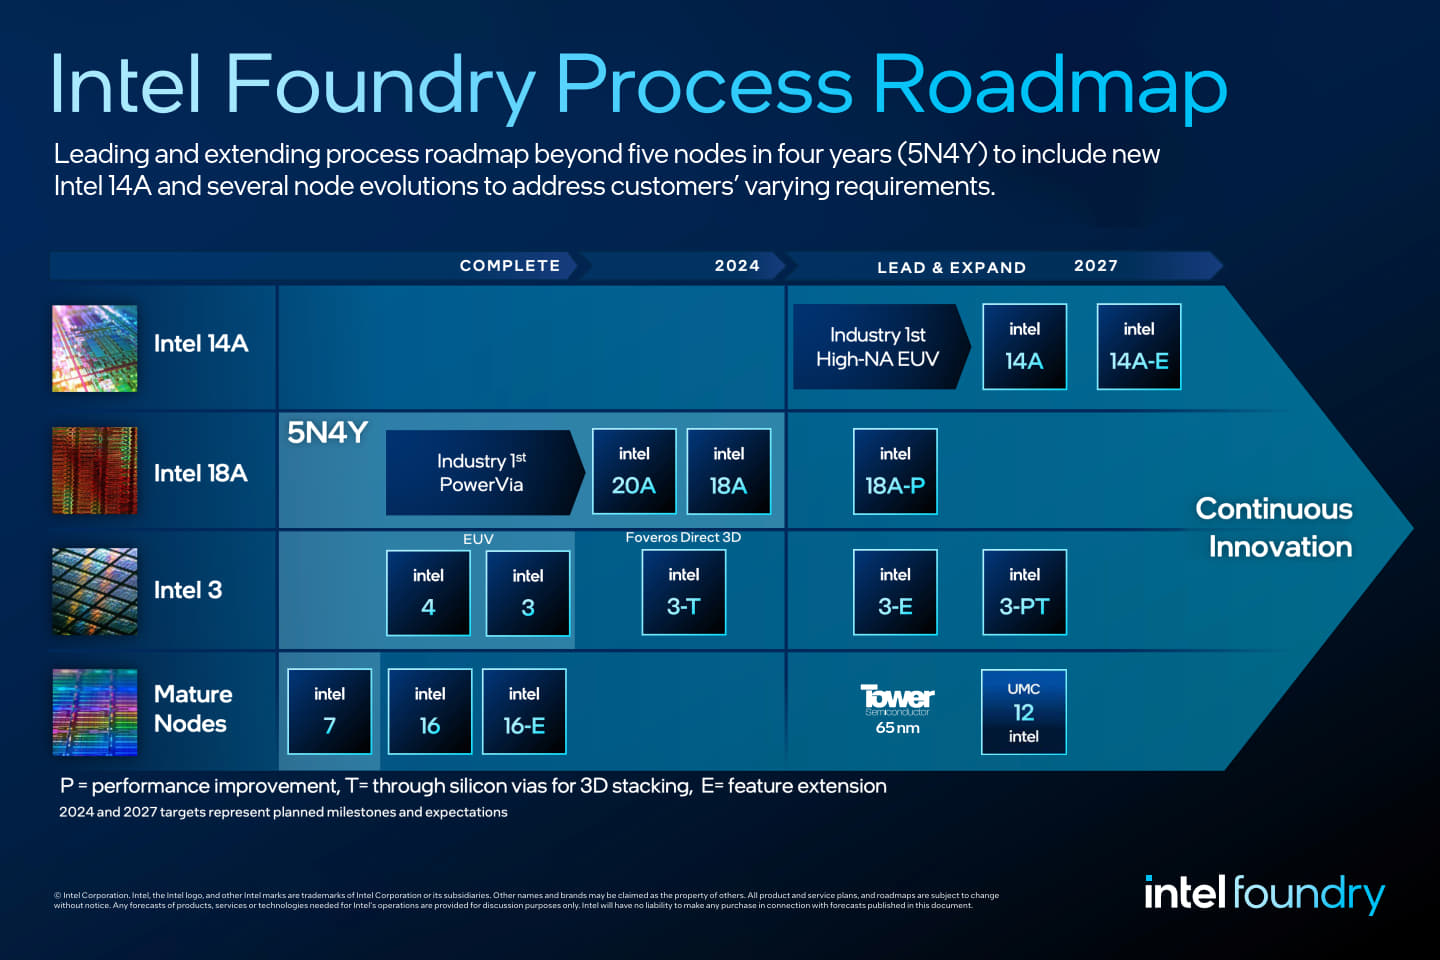
回顧Intel先前於IFS Direct Connect 2024大會上宣佈「4年5節點」的Intel 7、4、3、20A、18A節點開發進度都符合預期時程,同時也發表往後的發展路線圖。而Diamond Rapids的運算小晶片則是首款採用Intel 18A-P節點製程的產品,它維持先前RibbonFET環繞式閘極(即GAA)與PowerVia晶背供電等技術,並改善電晶體的效能表現。

值得注意的是,承載4組運算小晶片的基礎模塊(Base Tile)採用導入TSV矽穿孔(Through-Silicon Via)的Intel 3-T節點製程,搭配Foveros 3D Direct技術之混合鍵結(Hybrid Bonding)方式封裝,能讓小晶片與模塊上的金屬接點直接互相連接,以改善訊號品質與阻抗,達到更高傳輸速度並節省電力。 而運算建置模塊、互連集線器模塊則是使用UCIe-S互連技術,同樣採用銅線進行連接。

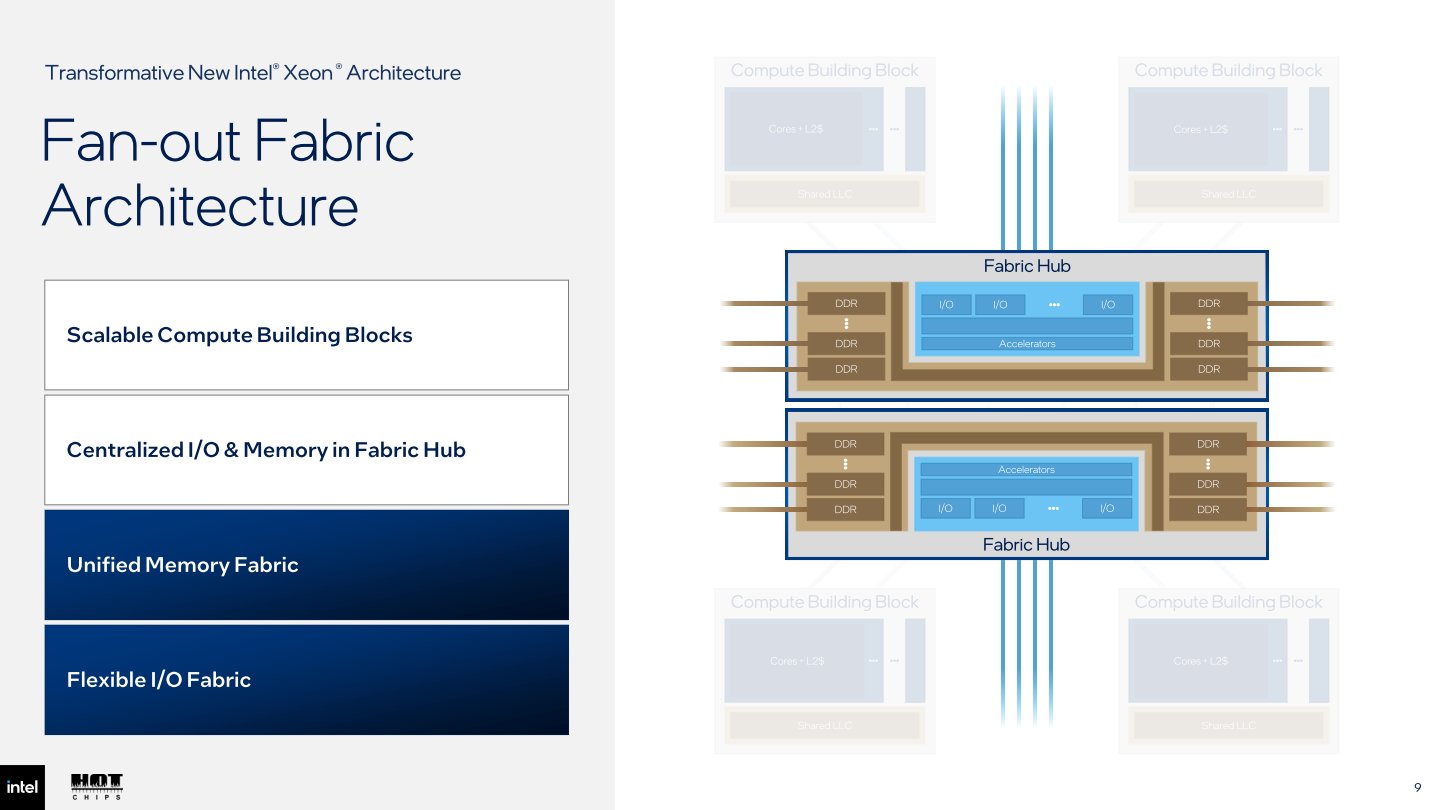
另一方面作為處理器SoC中樞的互連集線器模塊,也透過扇出拓樸(Fan-Out)的方式,直接與運算建置模塊、記憶體等元件的接點相連,同樣能夠改善傳輸速度與電力消耗。

Intel於IFS Direct Connect 2024就預告以18A節點製程為基礎強化的18A-P節點製程,其中P代表效能提升,而3T節點製程則是以3節點製程並導入TSV。

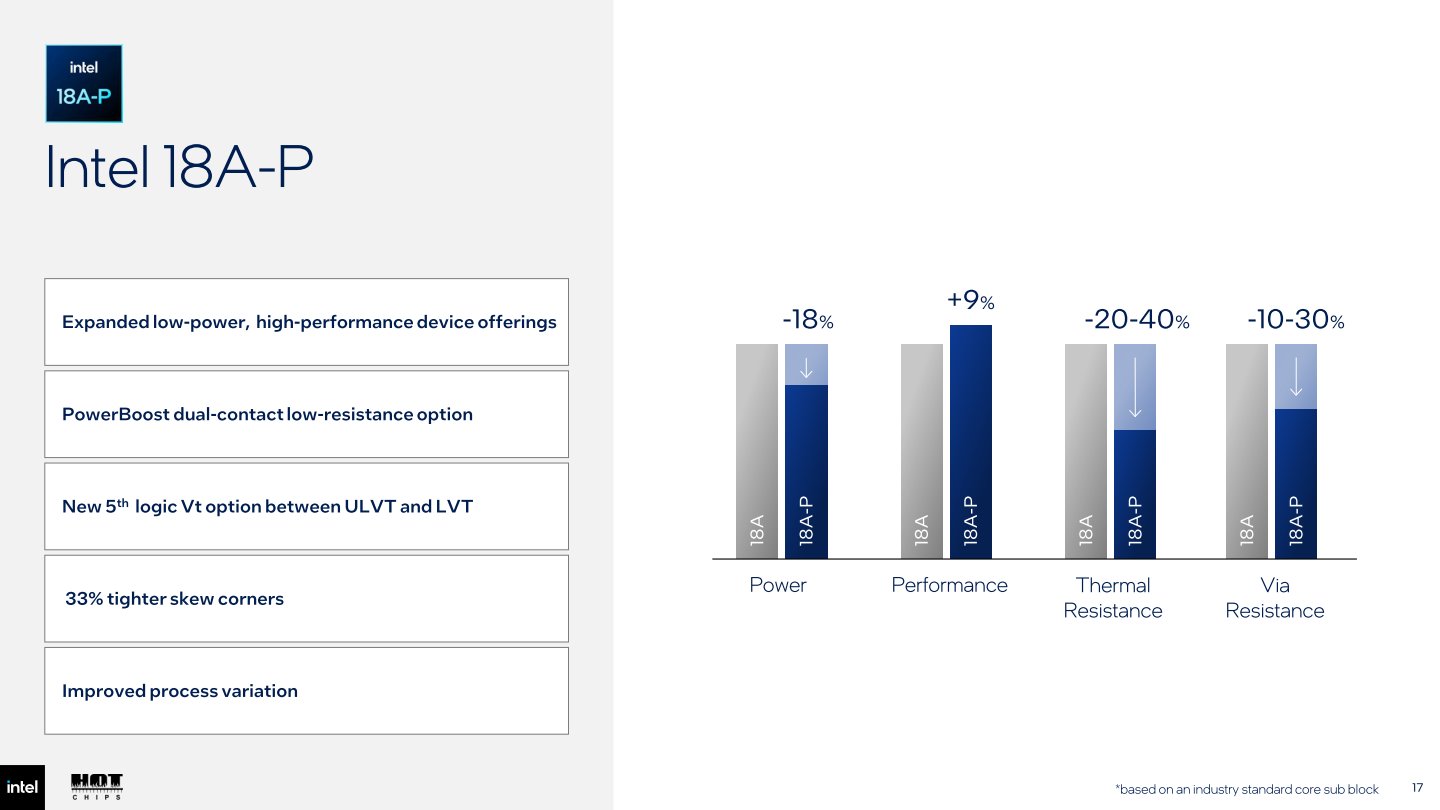
根據Intel提供的數據,18A-P節點製程能較18A提升9%效能,並節省18%電力消耗。

Diamond Rapids的另一個特色就是在互連集線器模塊與運算建置模塊、記憶體之間的通訊採用扇出拓樸,改善傳輸頻寬與延遲。

記憶體通訊分也由互連集線器模塊的記憶體控制器進行連接,同樣採用扇出拓樸。

筆者將在後續文章中繼續分析Crescent Island GPU、Wildcat Lake處理器的架構與特色,請讀者參考下列目錄。

Intel Hot Chips 2026系列報導目錄
Intel於Hot Chips 2026展示代理式AI與企業級產品,Diamond Rapids導入扇出拓樸與Intel 18A-P製程(本文)
Crescent Island GPU架構與特色介紹(暫定,工作中)
Wildcat Lake處理器架構與特色介紹(暫定,工作中)

加入T客邦Facebook粉絲團
✇T客邦-Techbang

NVIDIA於Hot Chips 2026宣佈Gorq 3 LPX創造4倍效能表現,Spectrum-X多層網路架構提升擴展彈性

NVIDIA於Hot Chips 2026大會宣佈Gorq 3 LPX機櫃進入全面生產狀態,在特定條件下可帶來4倍於目前頂尖方案的效能表現,並透過Spectrum-X多層網路架構帶來更強大的連接性。1361bdbb559c5a734e08b191946b8d6f

NVIDIA於Hot Chips 2026大會宣佈Gorq 3 LPX機櫃進入全面生產狀態,在特定條件下可帶來4倍於目前頂尖方案的效能表現,並透過Spectrum-X多層網路架構帶來更強大的連接性,以提升資料中心的Scale-Out擴展彈性。

2階段加速AI運算的加速器

NVIDIA於2026年8月23至25日在美國史丹佛大學舉辦的Hot Chips 2026大會宣佈Gorq 3 LPX機櫃進入全面生產(Full Production)狀態,它能透過Groq 3 LPU(語言處理器)縮短生成Token(字詞)的延遲,進一步改善AI資料中心的整體運算效能。

延伸閱讀:
【GTC 2026】:黃仁勳於開幕演說親自發表Groq 3 LPU,為資料中心帶來10倍收益能力
【GTC 2026】NVIDIA Vera Rubin 世代 7 種晶片與 5 種機櫃打造最強 AI 工廠,還要送晶片上太空
【COMPUTEX 2026】AI Agent時代全面來臨!NVIDIA Vera Rubin平台量產,AI盈利模式確立,引領產業新局

Groq 3 LPX機櫃採用全水冷設計,由256顆LPU構成,具有總容量達128GB的晶片內部SRAM(靜態隨機存取記憶體),傳輸頻寬高達640 TB/s,能夠以大規模部署的方式構成巨型叢集,並視為單一運算單元運作,還能夠與Vera Rubin系統相互搭配,讓Rubin GPU與Groq LPU協同進行AI模型的各層運算,從而提升解碼效能與增加輸出Token,以改善整體系統的運算、記憶體存取、功耗等方面的效率。

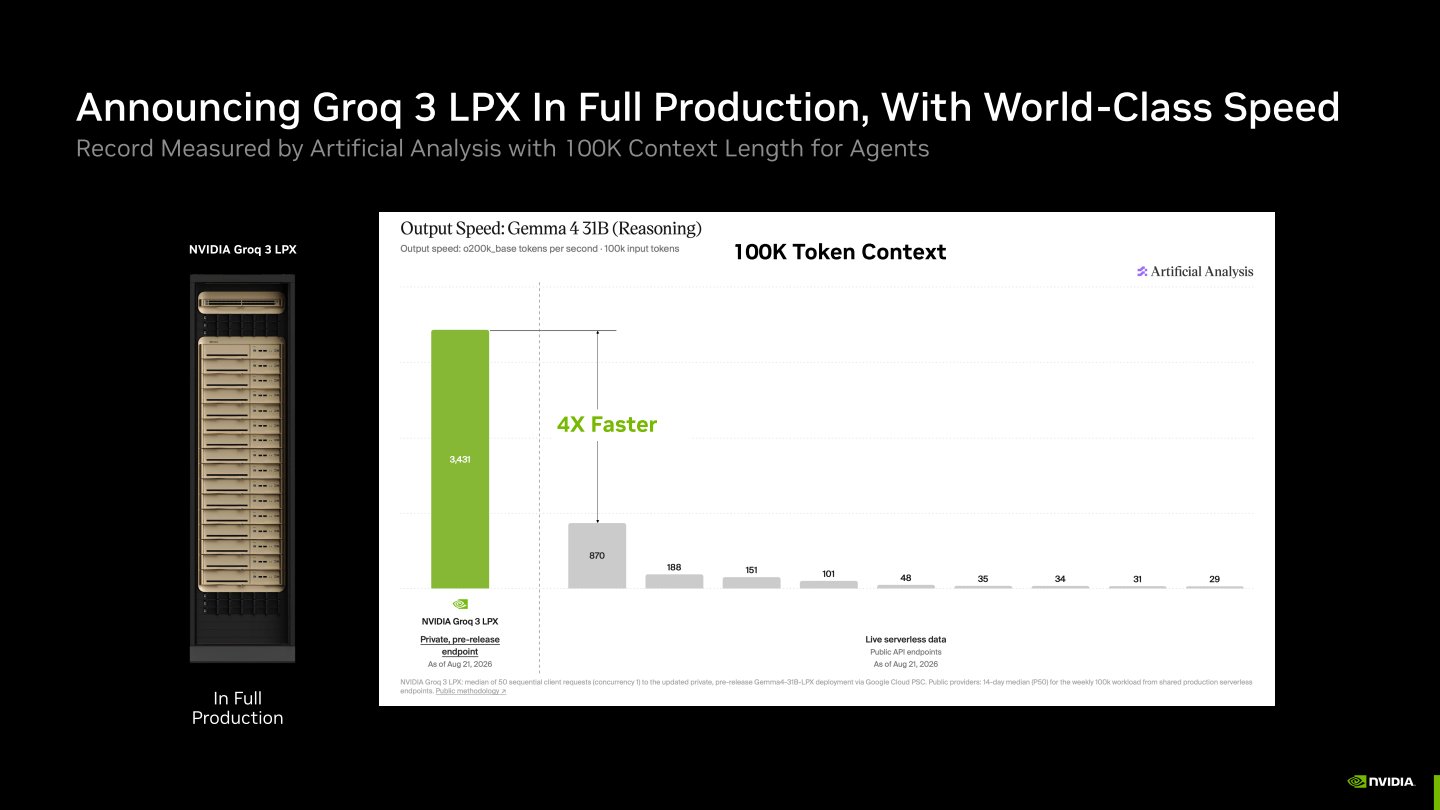
根據NVIDIA提供的數據,在執行上下文長度為100K組Token的Gemma 4 31B模型推理式運算,Gorq 3 LPX的Token輸出速度可以達到每秒3,431組,高於目前公開API服務效能參考指標的870組,效能表現相當驚人,對於提升AI資料中心的整體效能與收益有著相當大的幫助。

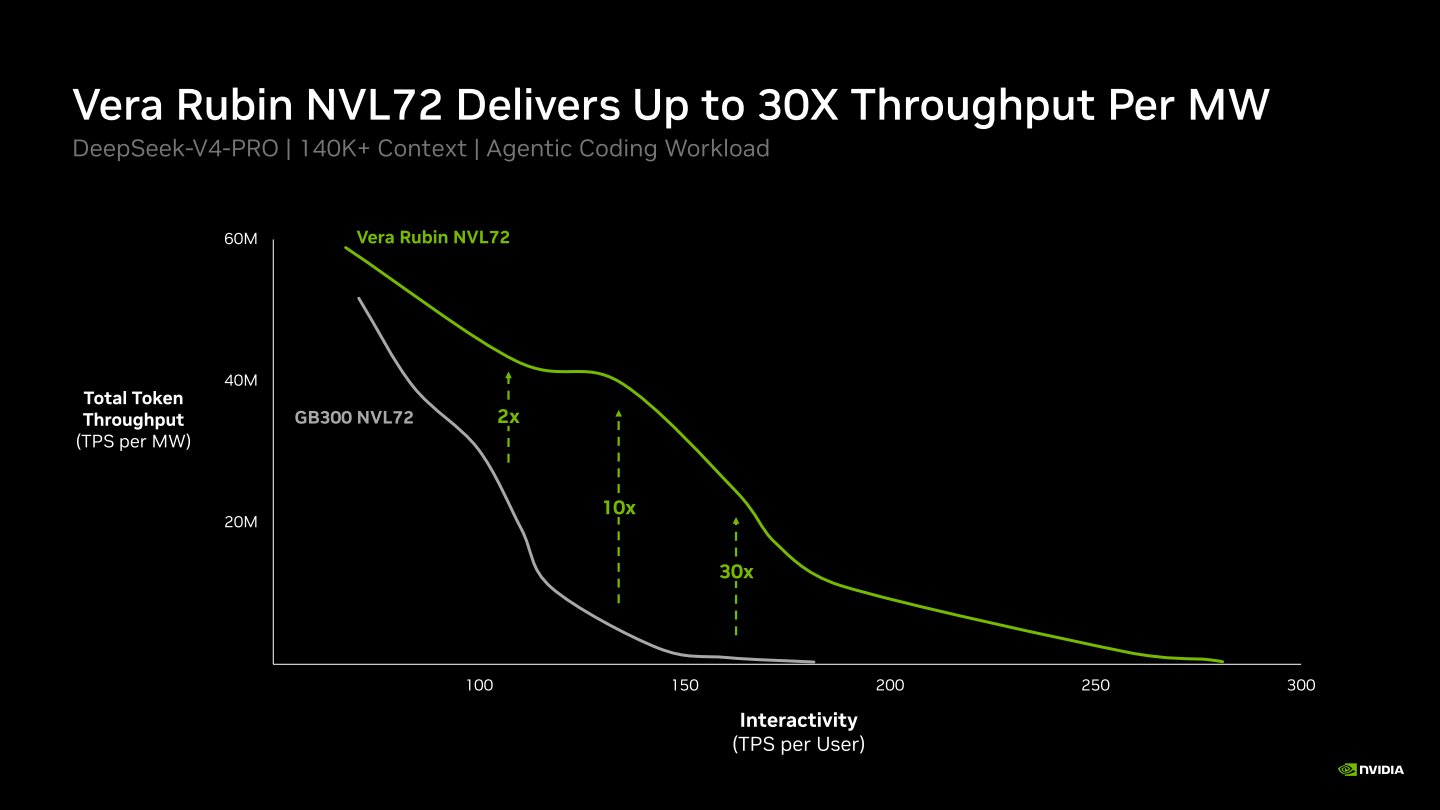
與前代GB300 NVL72相比,Vera Rubin世代的NVL72系統在執行特定工作負載時,消耗相同電力的條件下最高能提生30倍Token吞吐量。

Groq 3 LPX機櫃現已進入全面生產狀態,其Token輸出效能最高可達目前公開API服務的4倍。

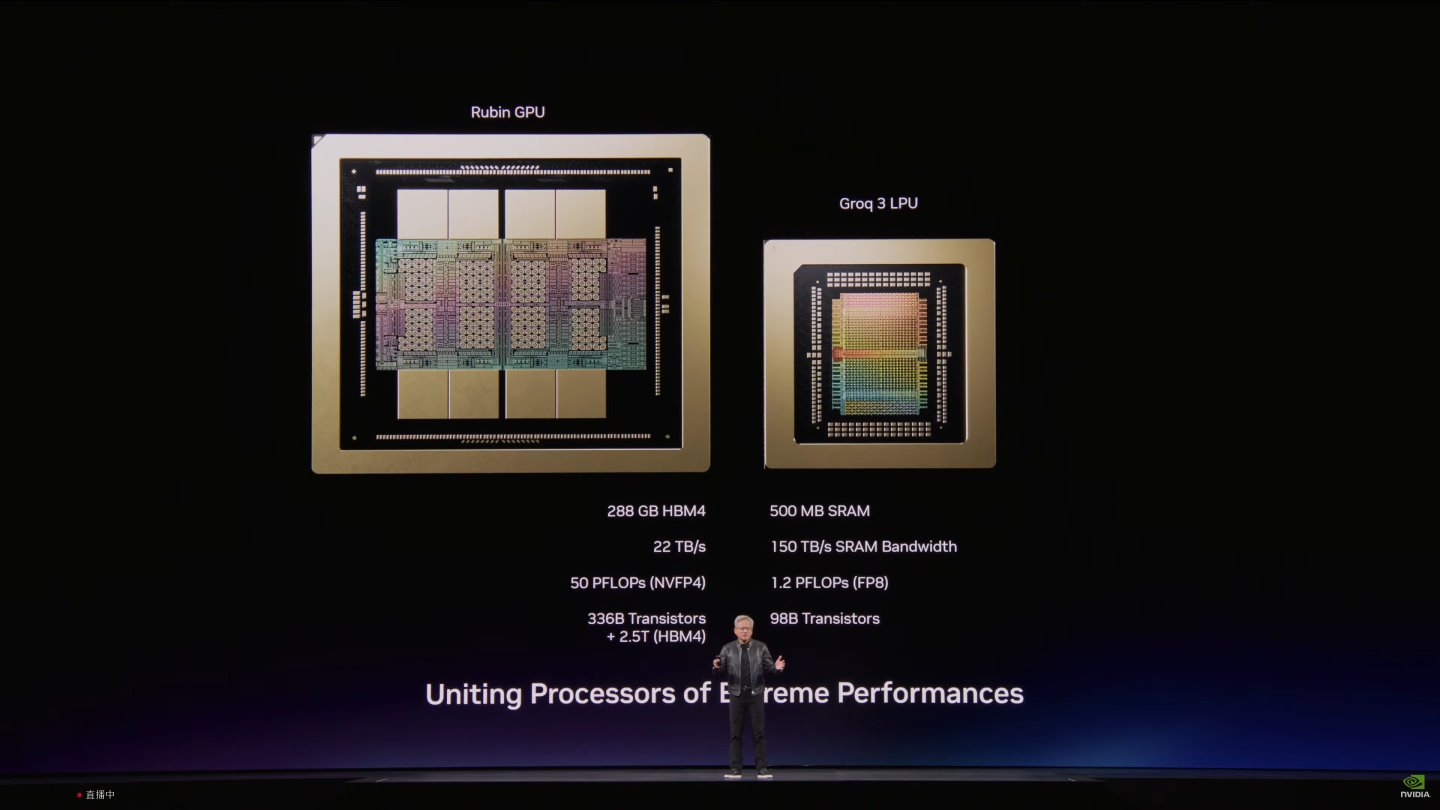
NVIDIA於GTC 2026發表Groq 3 LPU,其特色為每組運算單元上內建容量達500 MB的SRAM,能夠降低AI推論的延遲。

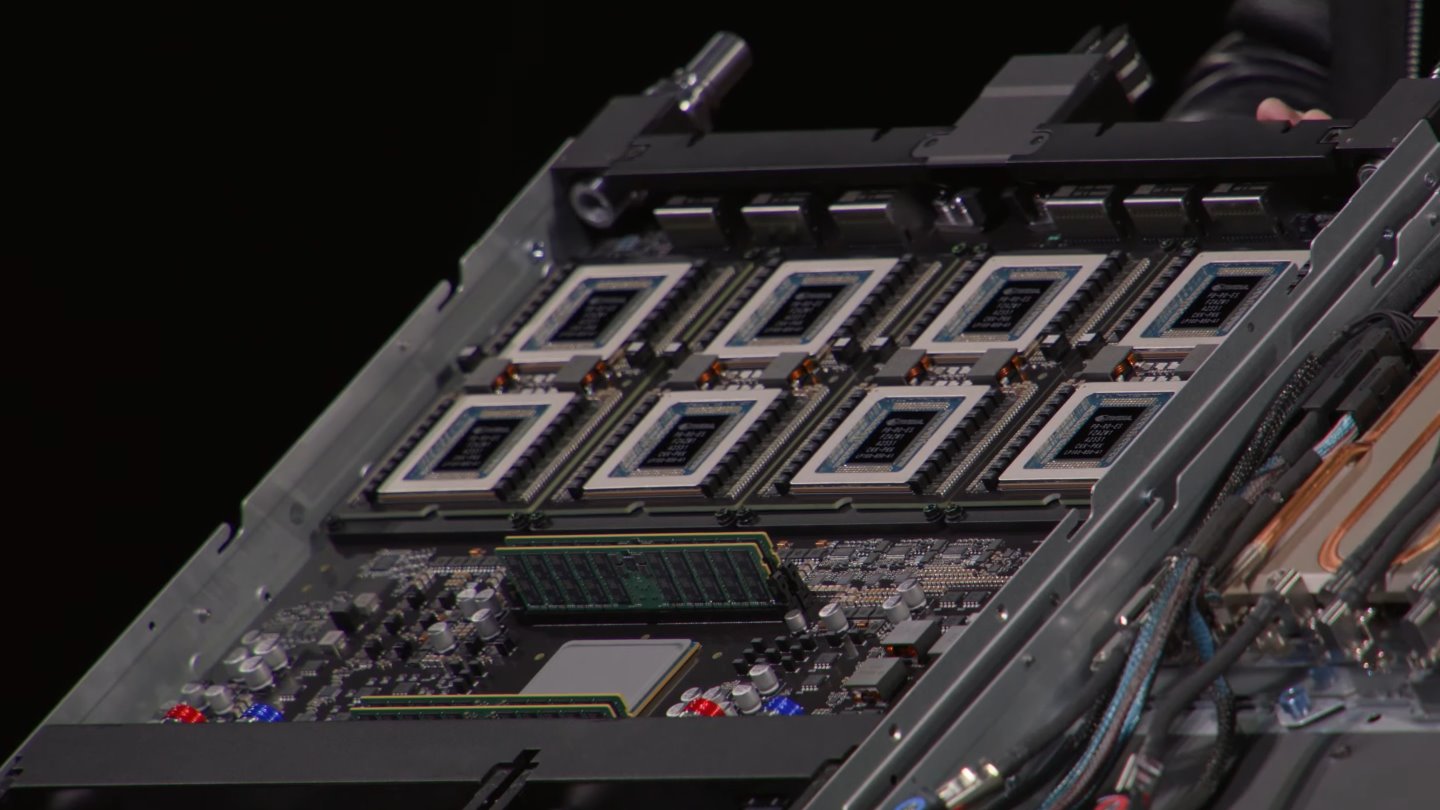
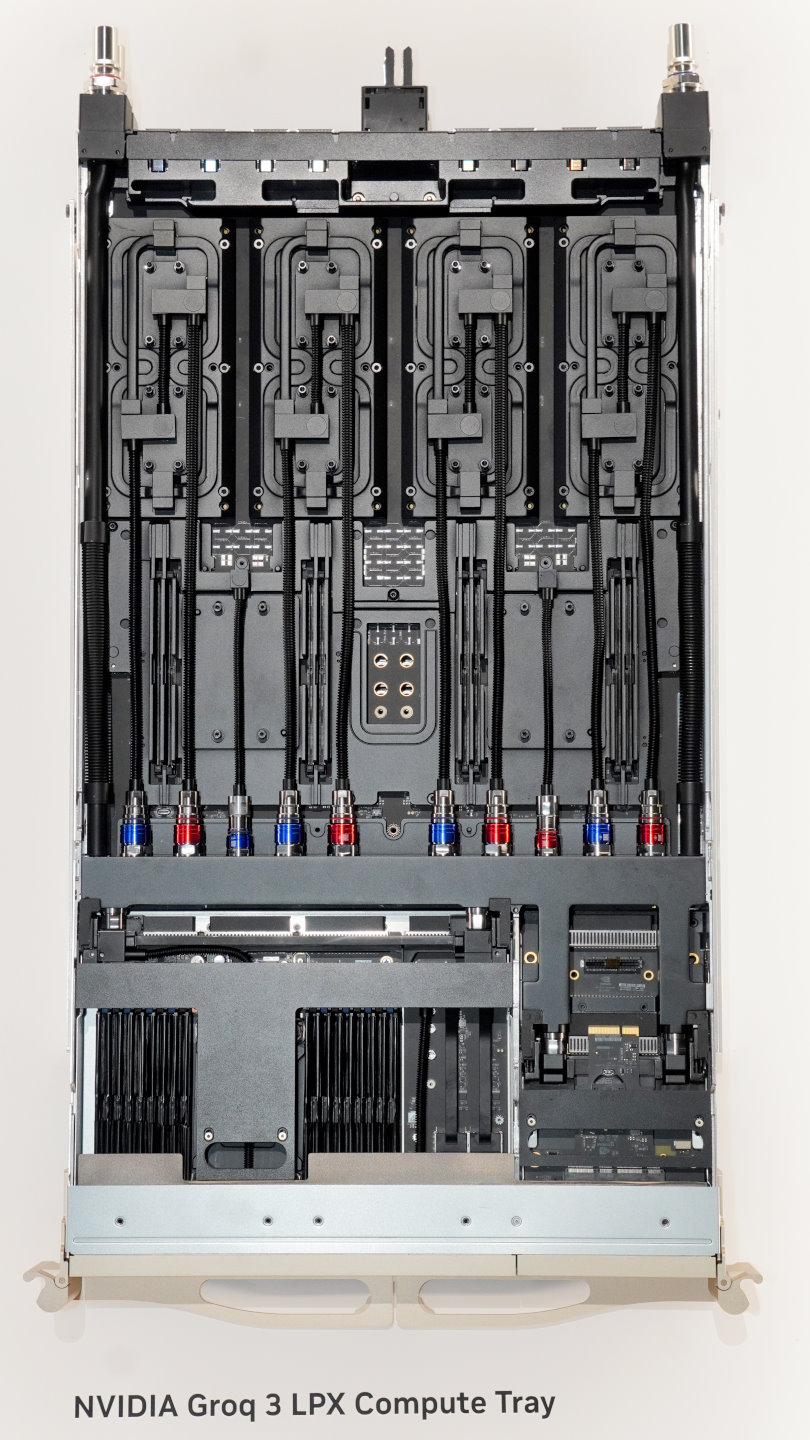
Groq 3 LPX運算托盤上具有8組Groq 3 LPU,圖為拆下散熱模組露出LPU的情況。

Groq 3 LPX運算托盤採用水冷散熱方案,LPU位於圖中上方散熱模組之底部。

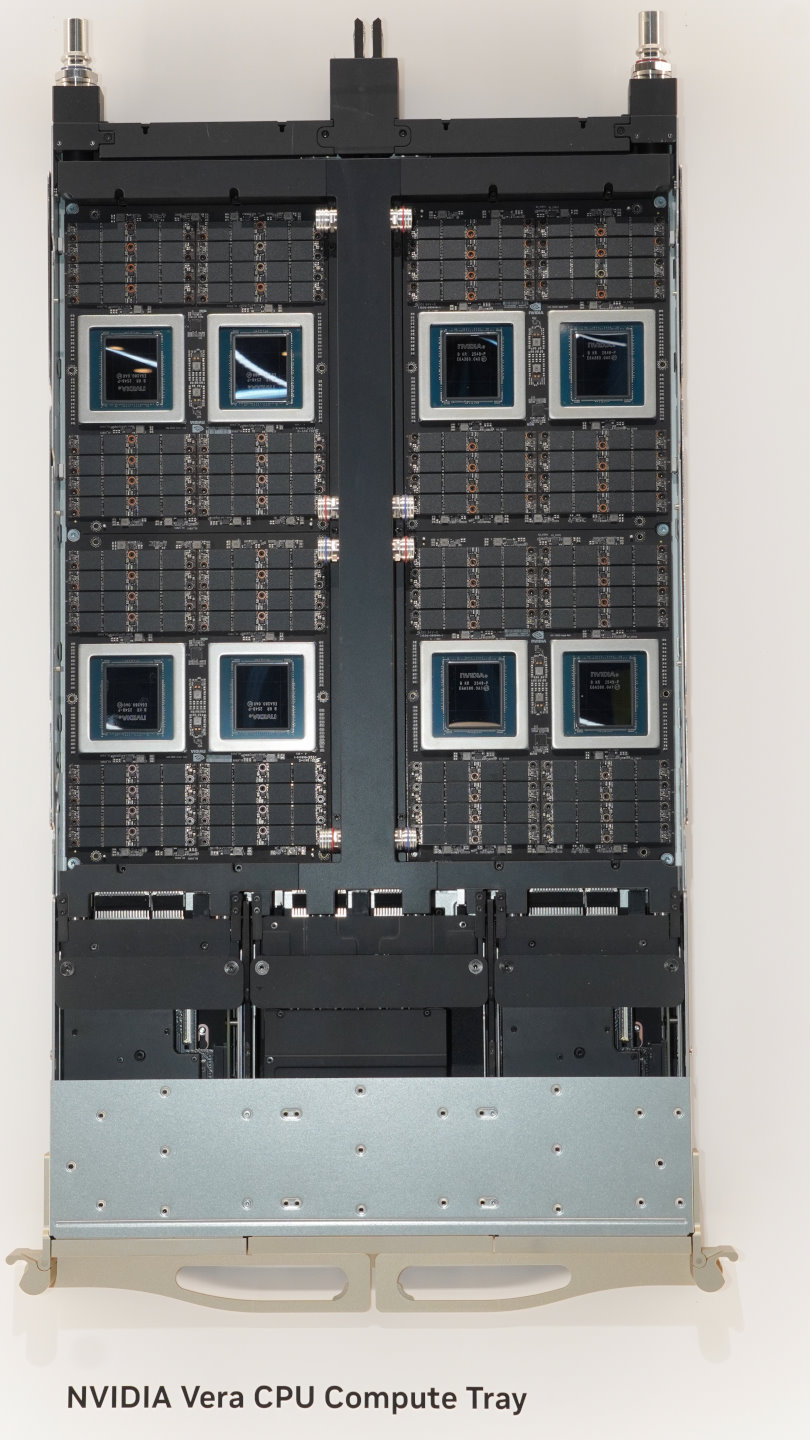
Groq 3 LPX能與Vera Rubin世代的其他運算單元搭配,圖為具有8組處理器且拆下散熱模組的Vera CPU運算托盤。

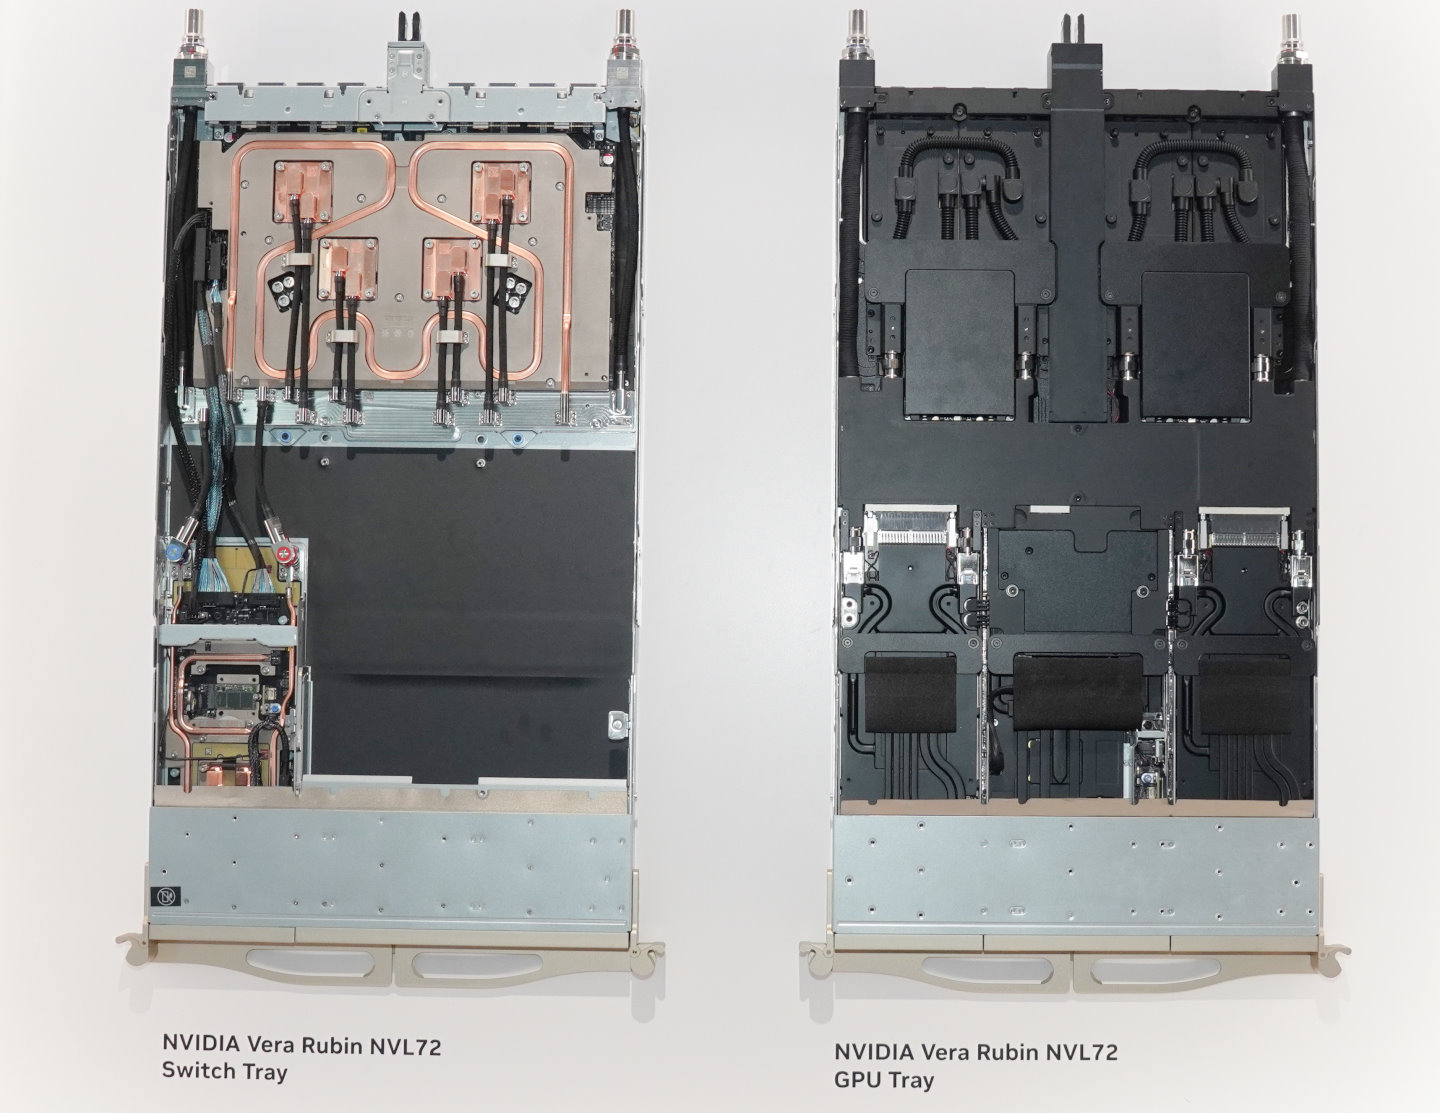
此外也有Rubin GPU托盤與NVL 72系統適用之交換器托盤,上述托盤都採用水冷散熱方案。

強化網路擴展能力

NVIDIA將單一機櫃中透過NVLink技術互連GPU(繪圖處理器)的方式歸類為Scale-Up(縱向擴展),透過網路通訊將多組機櫃互相連接的方式歸類為Scale-Out(橫向擴展),並且提出將多個不同地點的資料中心透過廣域網路連接並合成單一運算節點的Scale-Across概念。

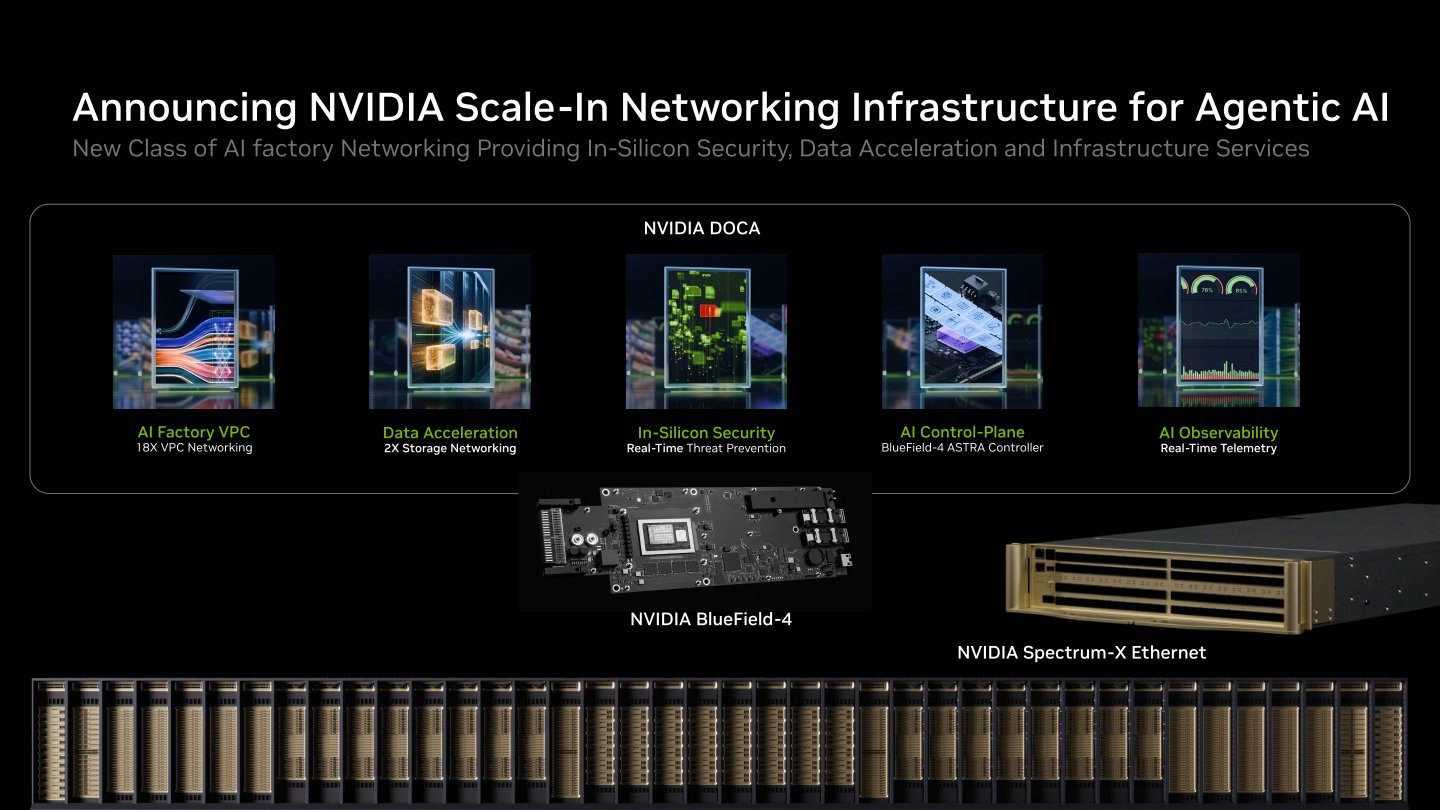
另一方面,業界近年也興起Scale-In概念將原本分散的多個元件的功能整合至單一元件或晶片,透過簡化硬體資源的方式來控制成本、節省空間與並降低資料中心的整體耗電量,同時簡化運作與維護的工作流程。

對此NVIDIA表示BlueField-4網路平台與DOCA API就符合Scale-In概念,能將原本需諸多元件的虛擬私有雲網路、儲存裝置網路連接、資安防護、管理、監控等功能集合至單一智慧型網路卡。

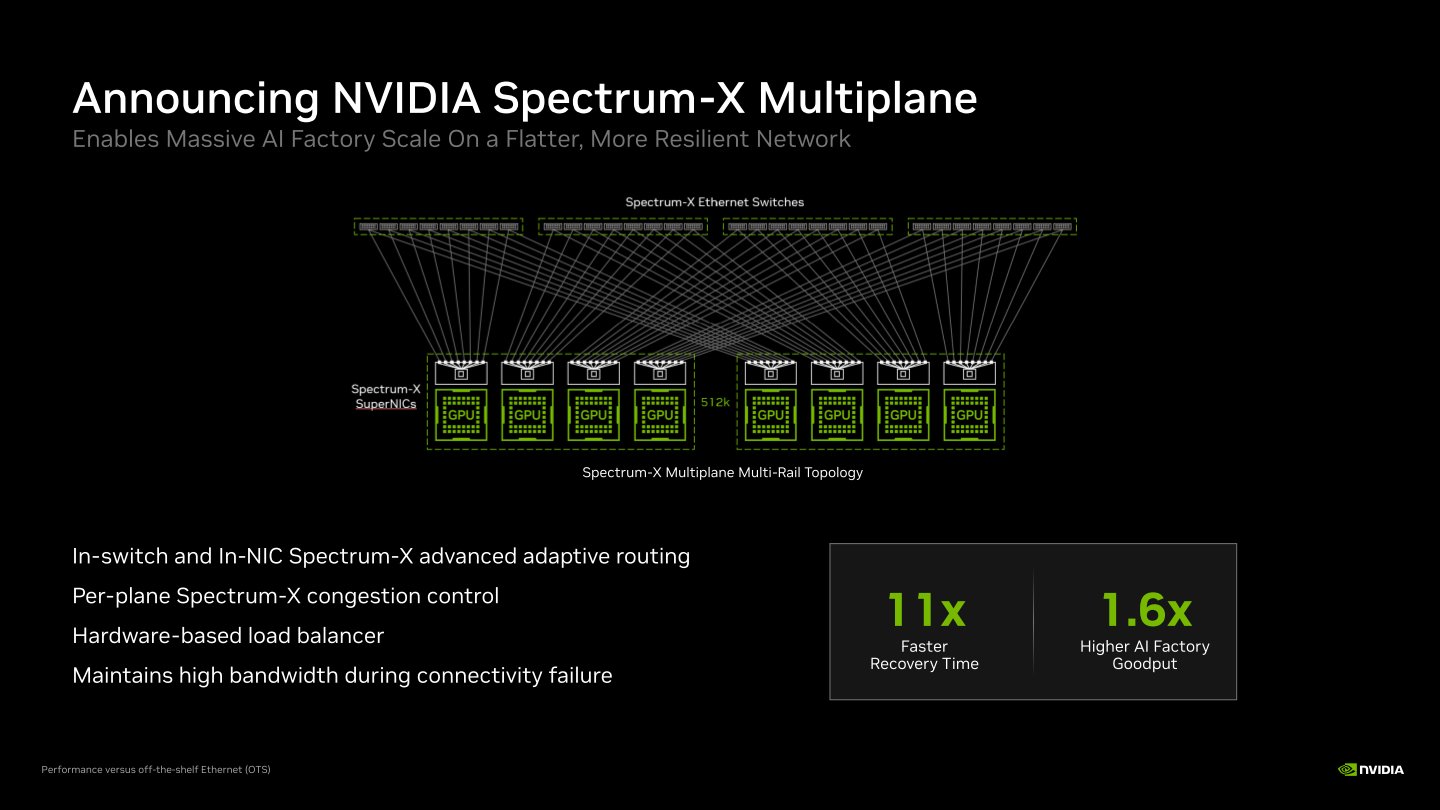
另一方面NVIDIA也提出透過Spectrum-X乙太網路交換器達成的Multi-Rail多層網路架構,能在單一系統中最高同時連接512,000組GPU,大幅超越先前以2層交換器拓樸達連接2,048組GPU的擴展限制,有利於訓練參數量更大的AI模型,以及提高AI推論運算的部署規模。

另一方面,Spectrum-X系統也提供進階最佳化路由功能,平時可以依運作狀況自動調度網路頻寬資源,以改善整體工作效率,並在單一節點失效的狀況下,維持整體網路90%的頻寬,以提高資料中心的可靠度與韌性。

NVIDIA表示透過BlueField-4網路平台與DOCA API達成Scale-In功效,提供高資安防護且高可靠度的擴展網路。

Spectrum-X多層網路架構提供更加可靠的網路擴展方案,單一系統最高可同時連接512,000組GPU。

關於更多Hot Chips 2026的資訊可以參考Hot Chips官方網站,筆者撰稿時入場券已售罄,有興趣參與的讀者可以註冊線上虛擬參加(需收費,美金5元起)。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

Framework Laptop 12模組化翻轉筆電免換機升級Wildcat Lake處理器,還可改裝背光鍵盤與指紋辨識

Framework宣佈推出Laptop 12模組化翻轉筆記型電腦的升級主機板,以及背光鍵盤、指紋辨識、Thunderbolt 4端子I/O模組等零件,方便使用者升級現有筆記型電腦。9f84dc82a172c7c9088ab7c1b7754f71

Framework宣佈推出Laptop 12模組化翻轉筆記型電腦的升級主機板,以及背光鍵盤、指紋辨識、Thunderbolt 4端子I/O模組等零件,方便使用者升級現有筆記型電腦。

5大願望滿足3項

Framework模組化筆記型電腦的特色為主機板、記憶體、儲存裝置、電池、鍵盤、觸控板、顯示器邊框、I/O端子等零組件都採用可自行更換的模組化設計,先前於2025年推出的Laptop 12採用翻轉式機構設計,並可搭配觸控筆作為平板電腦使用。

延伸閱讀:
Framework推出新款Laptop 12客製化筆記型電腦,採瑜珈翻轉式設計
【Computex 2025】 Framework推出最新Desktop與Laptop 12等模組化電腦,還可DIY迷你伺服器
【Computex 2026】 電競筆電顯卡也能升級?Framework Laptop 16實機展示,RTX 5070模組化設計帥翻全場

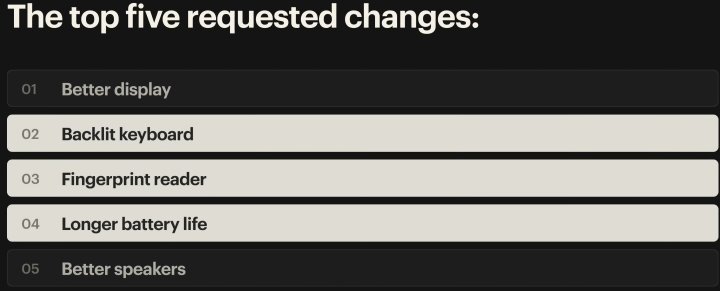
Framework創辦人Nirav Patel在Laptop 12升級套件的發表影片中,提到在消費者意見調查中,最希望改善項目的前5名分別為顯示器畫質、背光鍵盤、指紋辨識、續航力、喇叭音質,而Laptop 12升級套件則包含了其中的第2、3、4項。

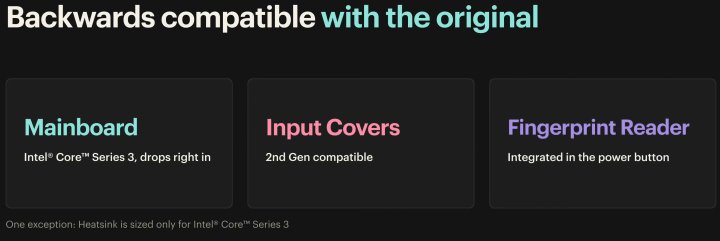
更棒的是升級套件能夠相容於既有Laptop 12,使用者可以自行為手中的筆記型電腦更換新款主機板、背光鍵盤、整合於電源鍵的指紋掃瞄器、Thunderbolt 4端子模組等零件,以升級更多功能。

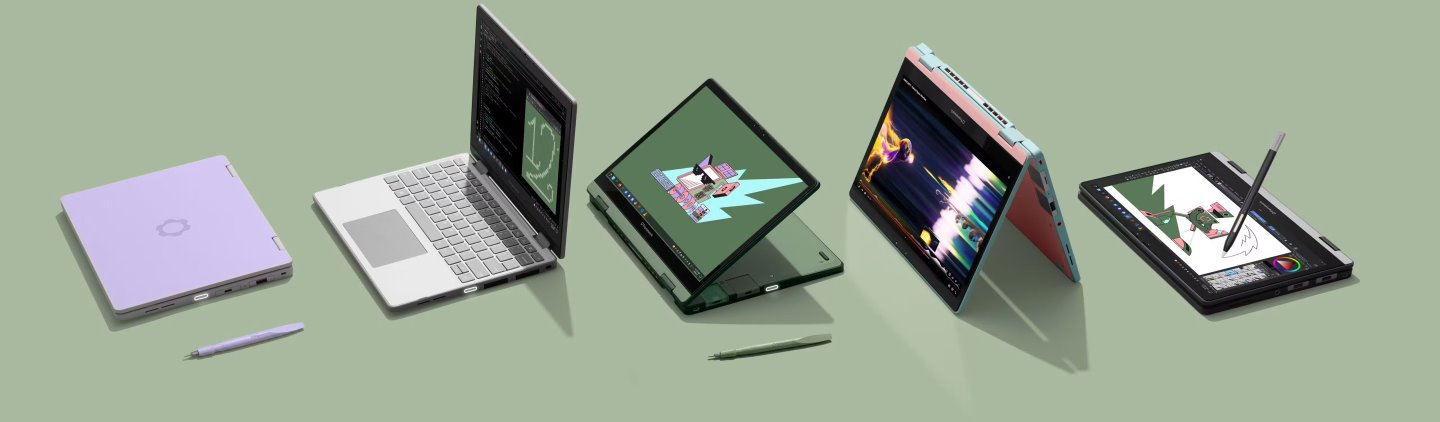
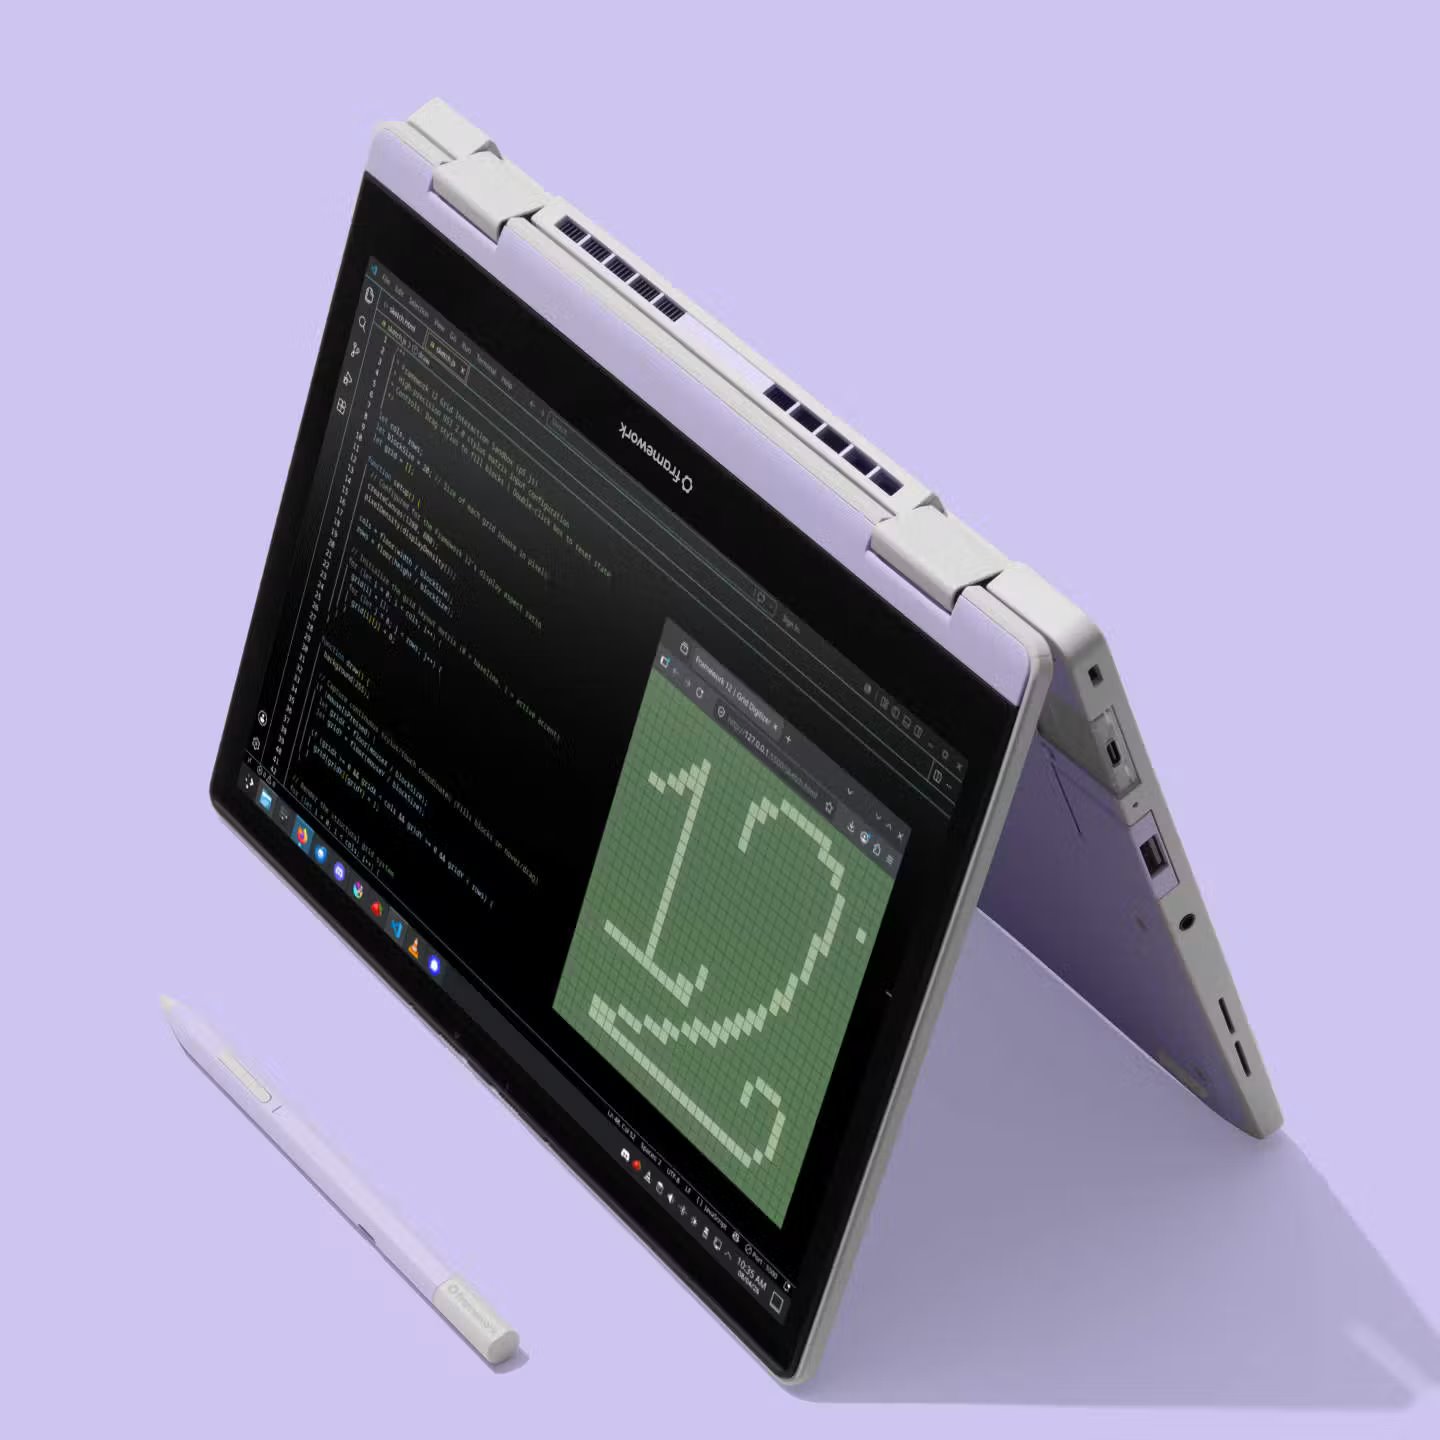
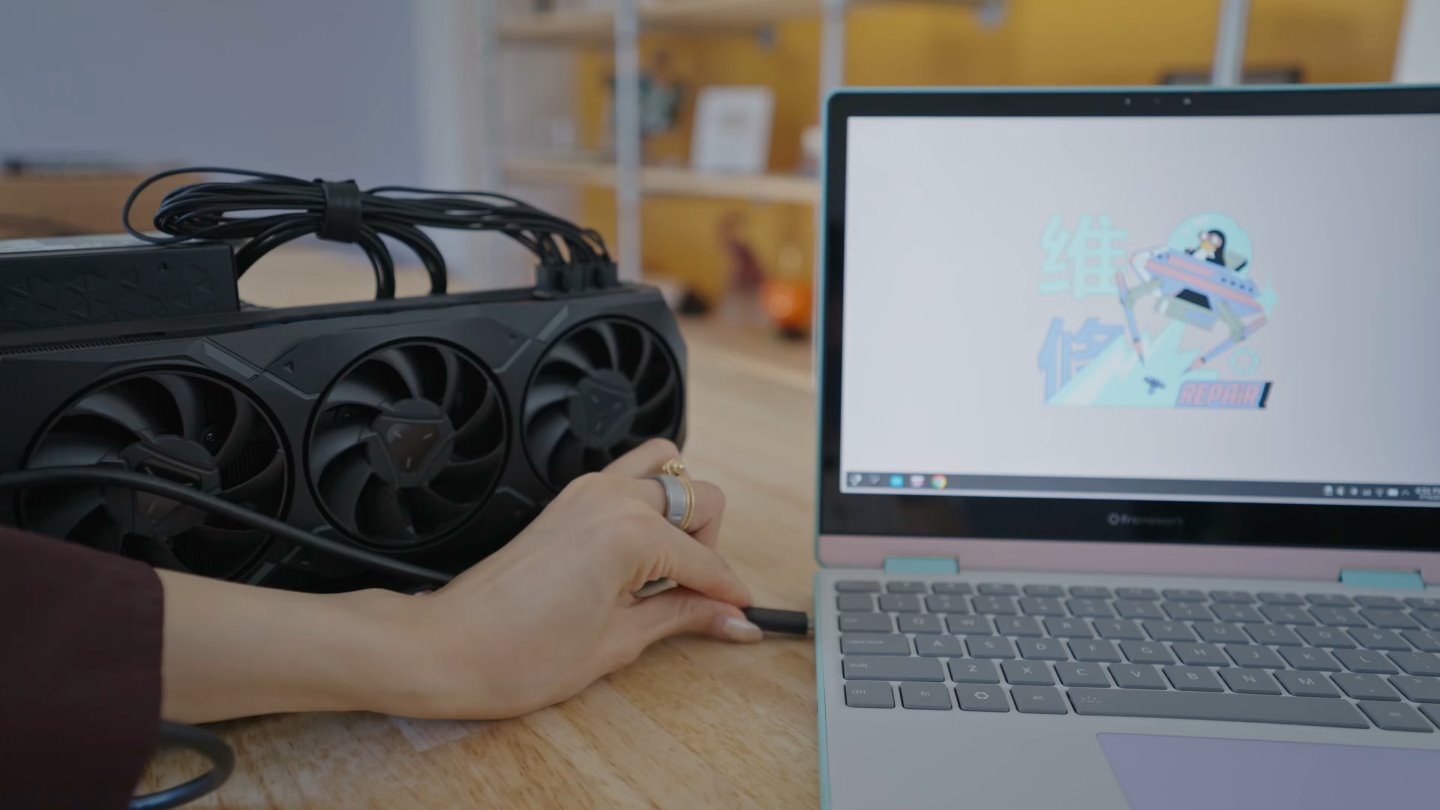
Framework Laptop 12是款採用模組化設計的翻轉筆記型電腦,使用者可以自型更換各種模組進行升級。

翻轉式機構讓Laptop 12能以多種型式擺放,也能將螢幕翻轉後作為平板電腦。

消費者最希望改善項目包含顯示器畫質、背光鍵盤、指紋辨識、續航力、喇叭音質,Laptop 12升級套件則包辦中央3項。

它透過更換Wildcat Lake處理器主機板強化電池續航力,並可更換背光鍵盤、指紋掃瞄器。

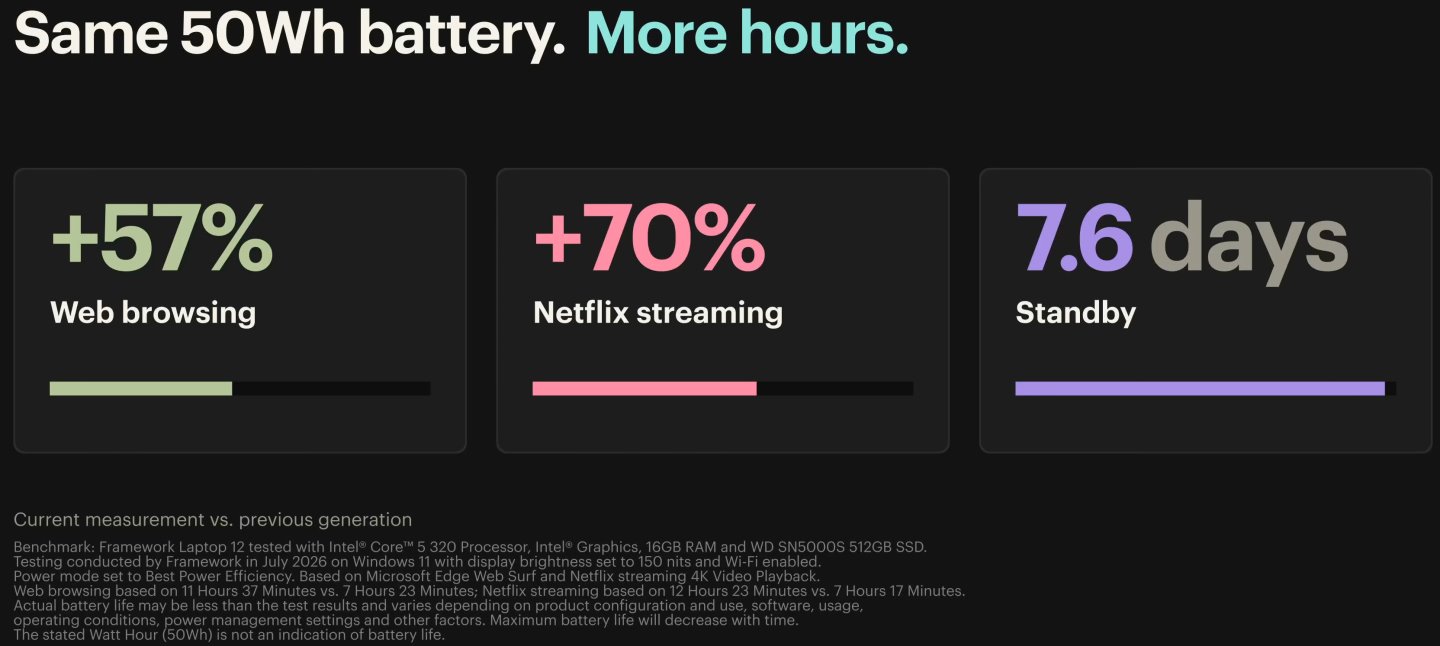
Wildcat Lake處理器讓相同的電池延長57%網頁瀏覽、70%Netflix影片串流的續航力。

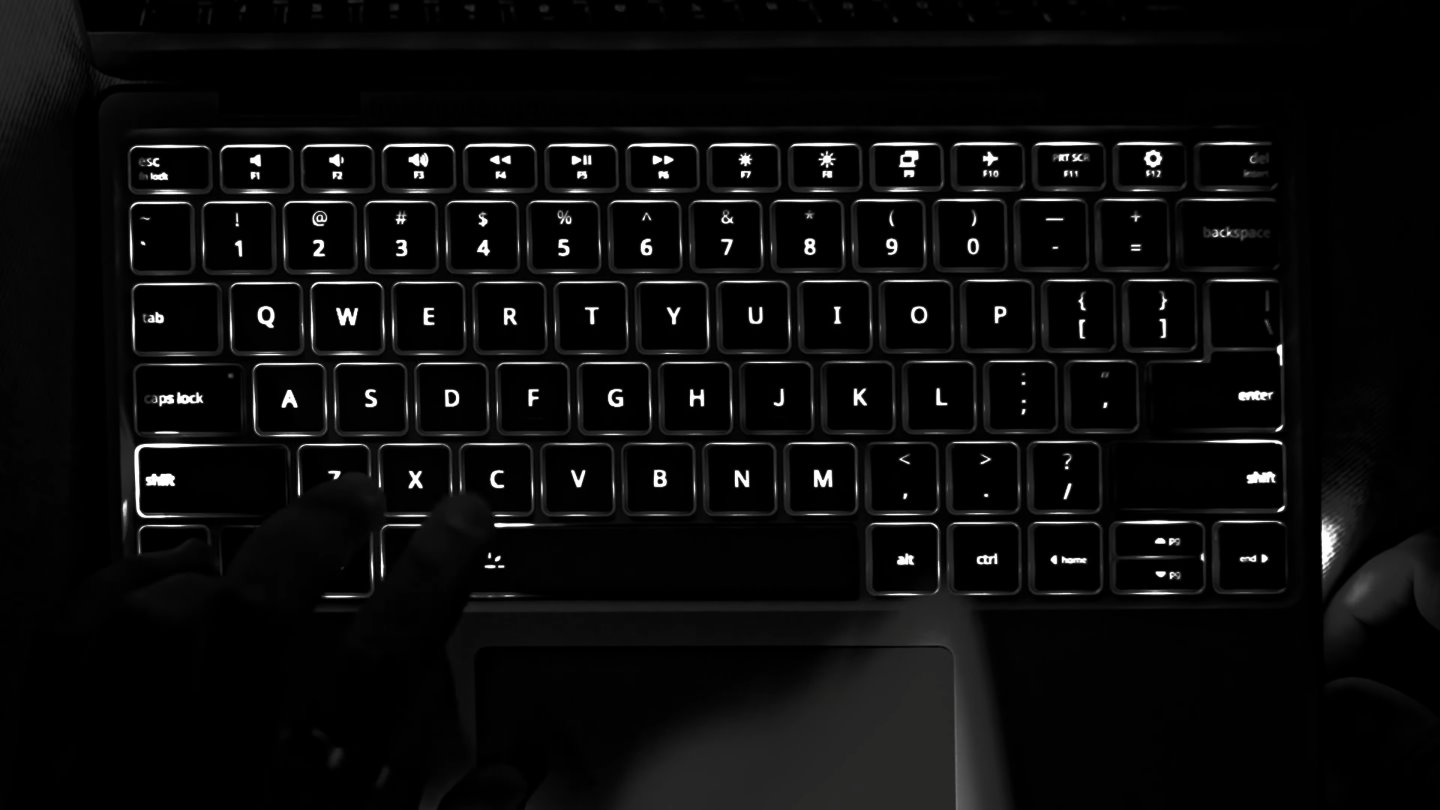
背光鍵盤具有單色背光功能,並搭載開源ZMK韌體,提供一定程度的客製化彈性。

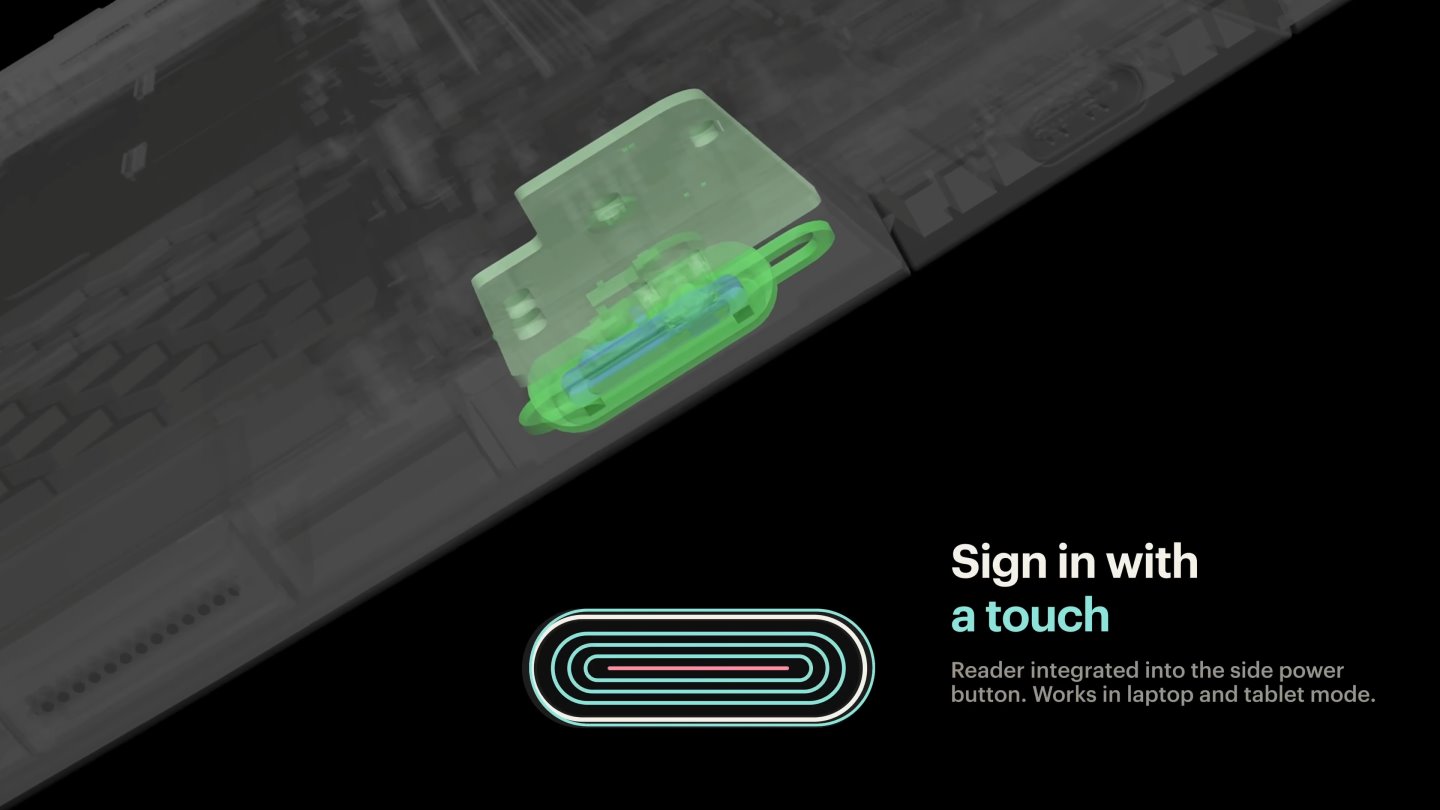
指紋掃瞄器整合於電源鍵中,使用者可以自行更換。

植入野貓更省電

先前Laptop 12搭載代號為Raptor Lake的Intel第12代Core i處理器,這次則是可以透過更換主機板的方式,升級至代號為Wildcat Lake的Intel Core系列3處理器。它與代號為Panther Lake的Intel Core Ultra系列3處理器同為2026年上市的最新世代產品,具有極佳的電力效率,有助於延長筆記型電腦的電池續航力。

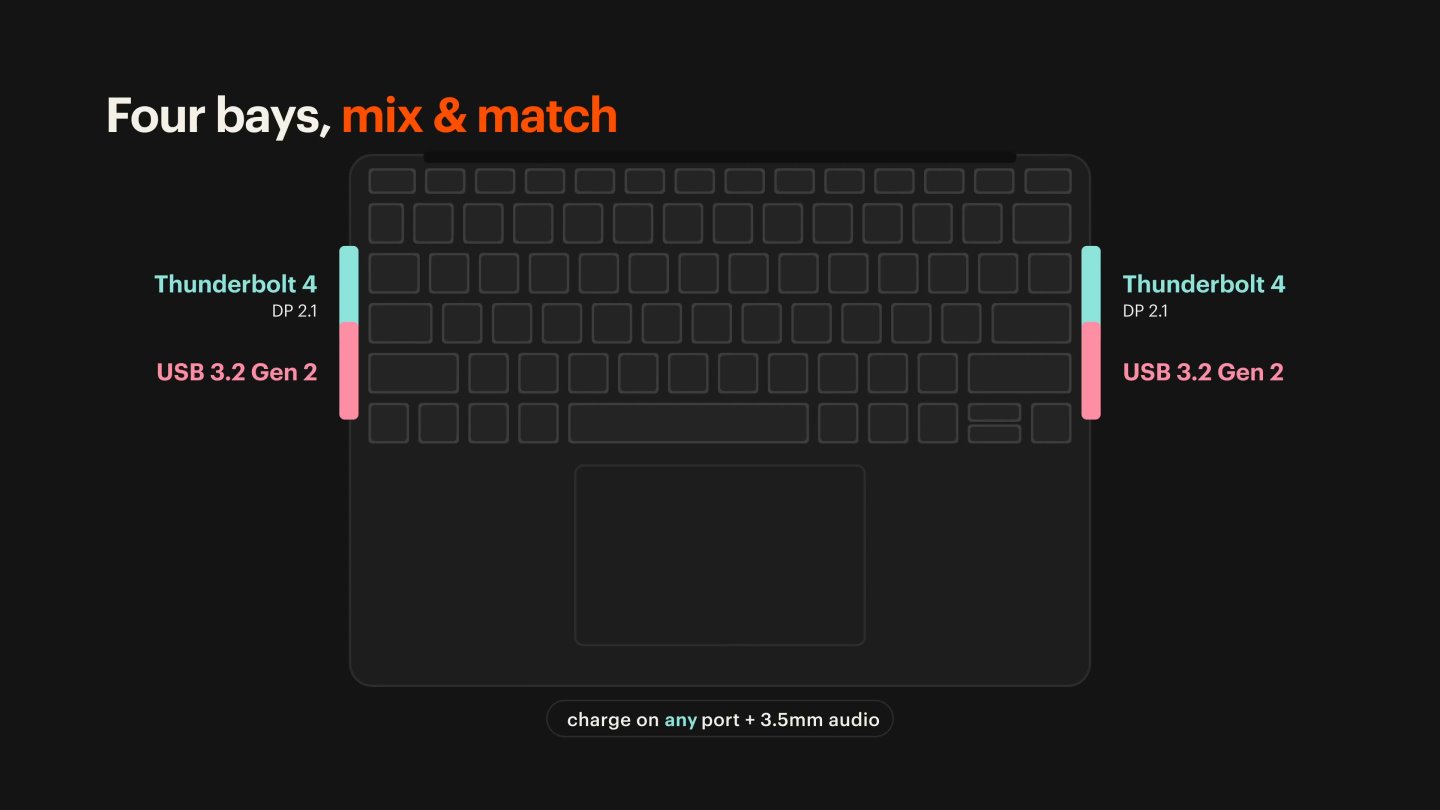
受益於新處理器的功能,Laptop 12在升級主機板之後,也能支援Thunderbolt 4端子I/O模組,讓電腦獲得更高的外接裝置傳輸頻寬、DisplayPort Alternate Mode影音輸出、外接顯示卡等PCIe裝置之功能,大幅強化電腦的擴充彈性。

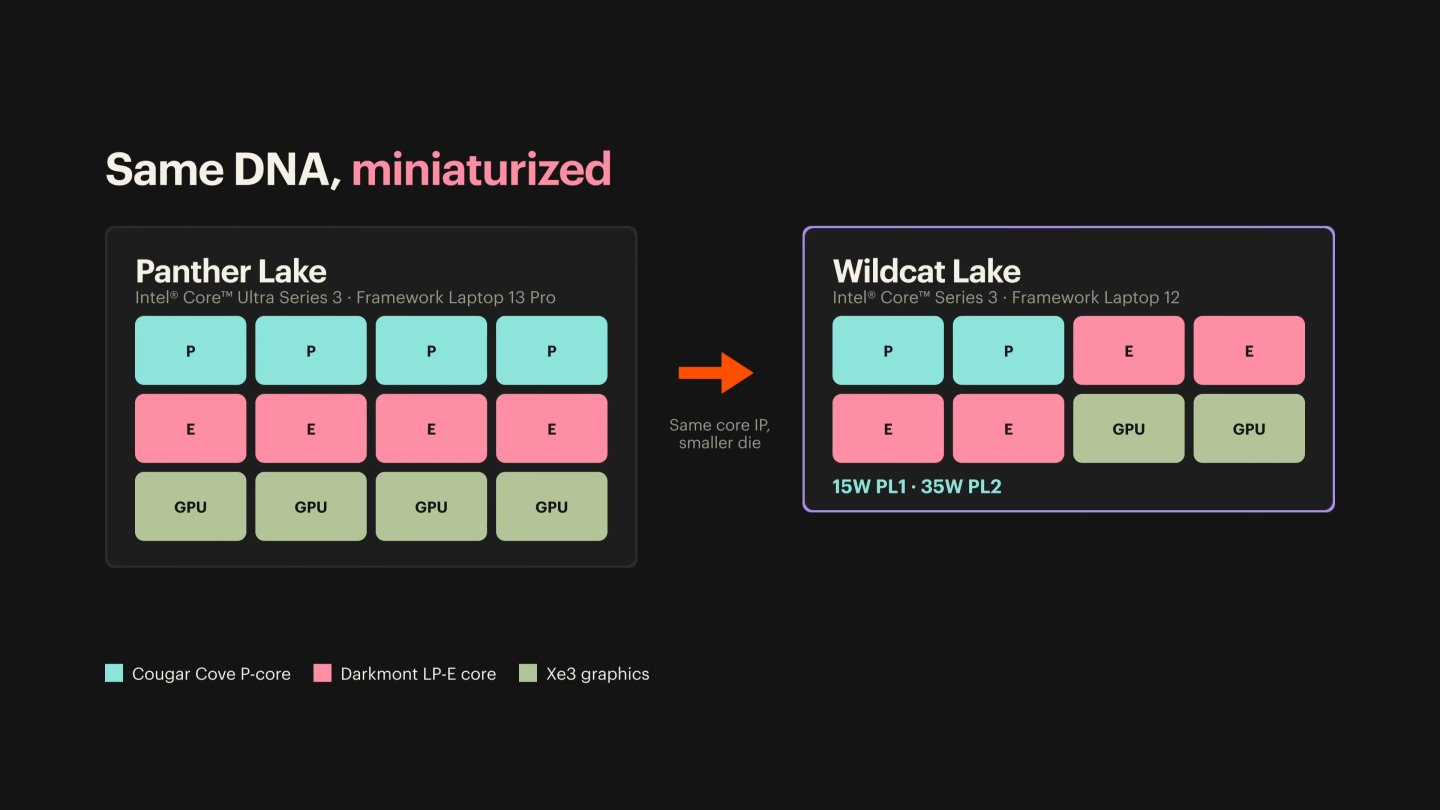
Wildcat Lake處理器採用與Panther Lake處理器相同的P-Core、E-Core與Xe3顯示核心,在數量上略有縮減,同時也降低耗電量。

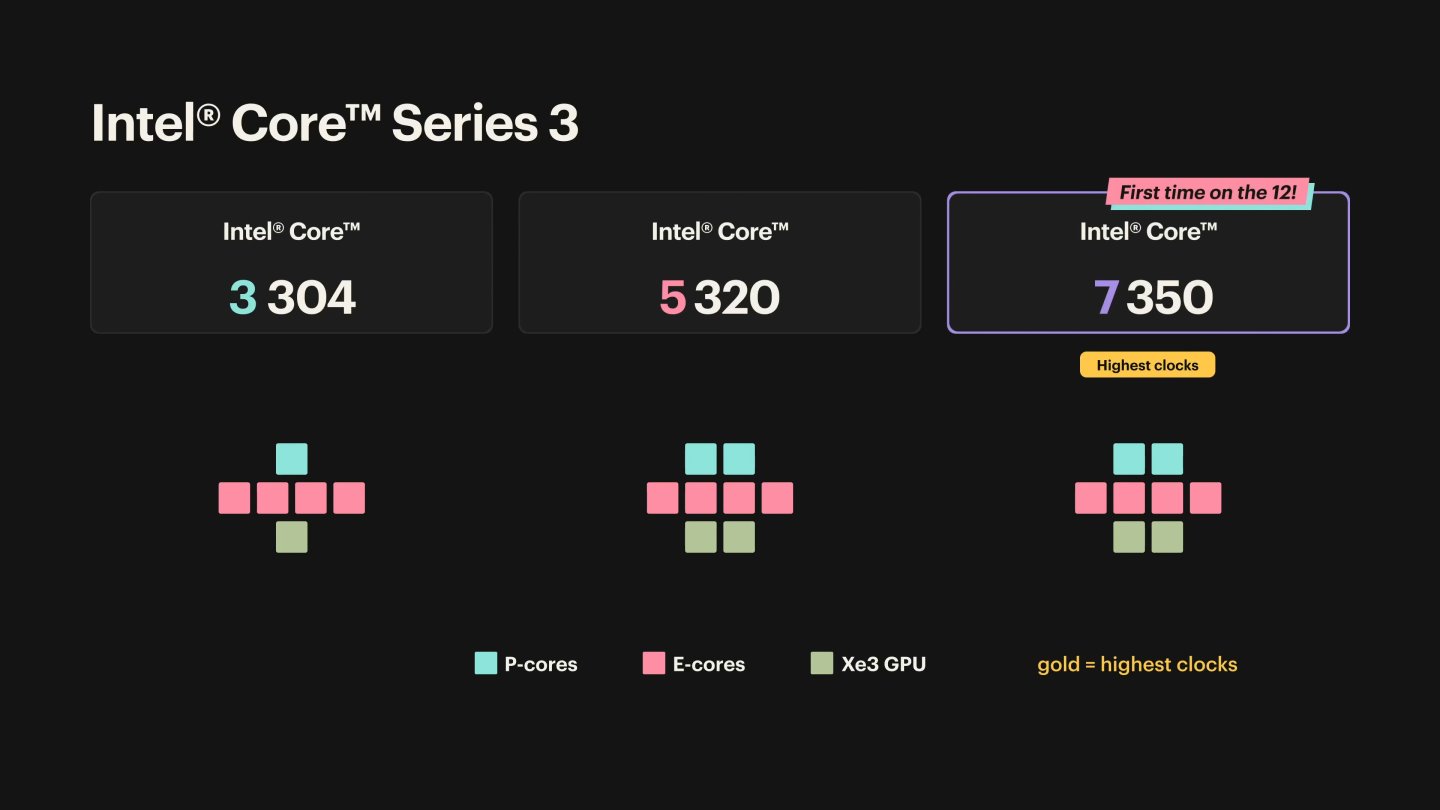
Laptop 12提供Core 3 304、Core 5 320、Core7 350等3種不同版本主機板選擇。Core 3 304核心數較少,後2者皆多1組P-Core且時脈略有落差。

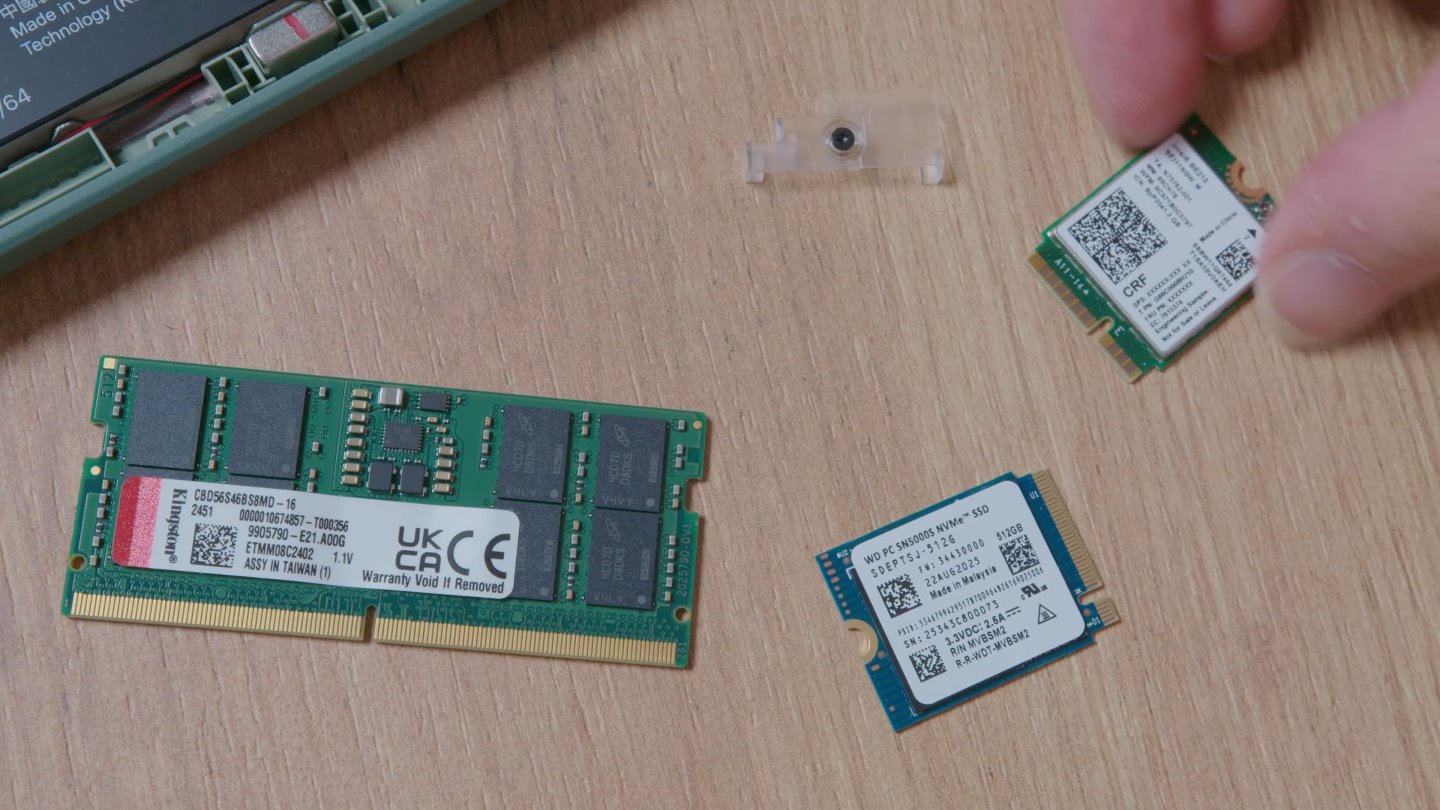
使用者不但能夠透過更換主機板的方式同時升級處理器,記憶體與與儲存裝置也能自由更換。

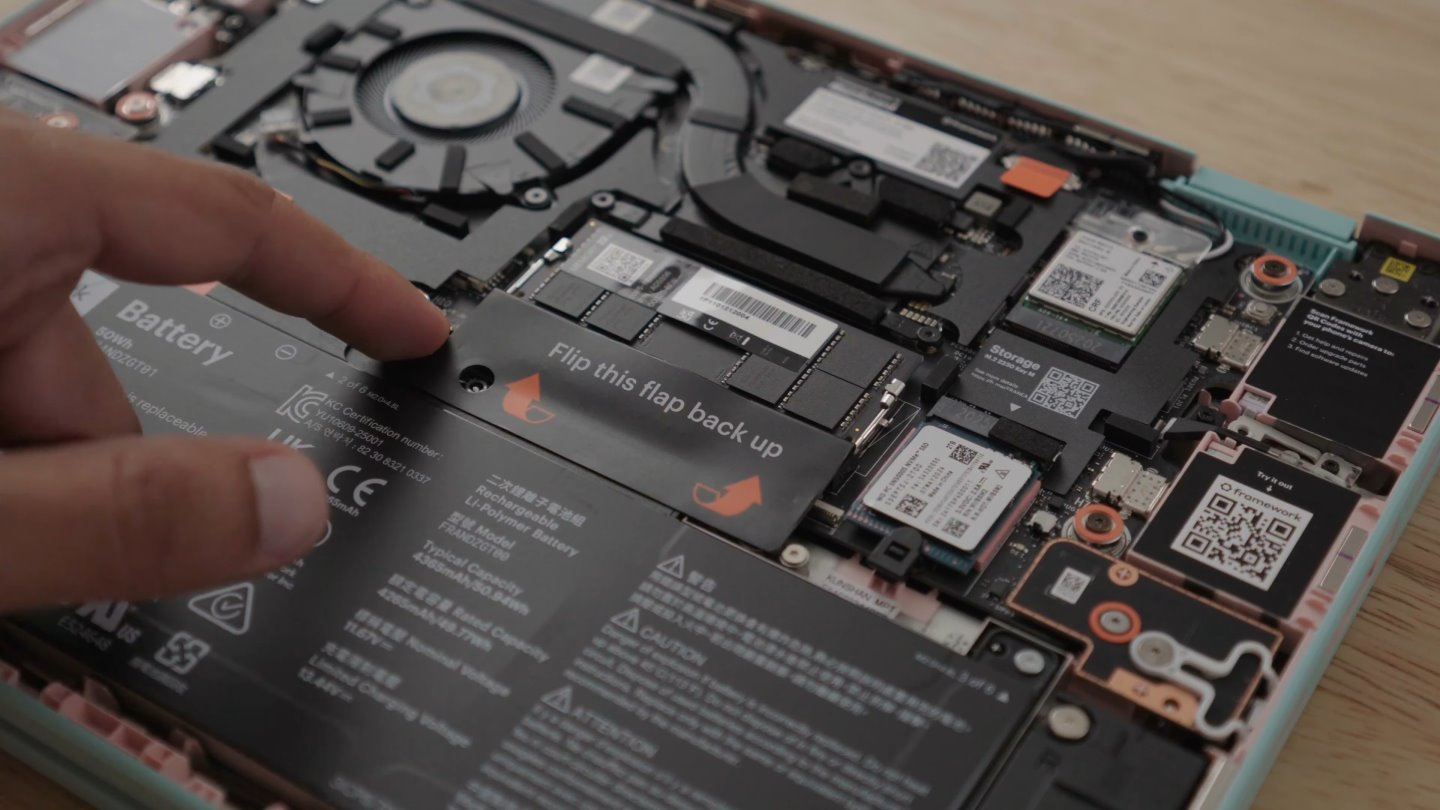
Laptop 12採用SO-DIMM模組記憶體與M.2 2230尺寸固態硬碟,在零售通路都相當容易取得。

電腦2側後方的I/O模組可以更換為Thunderbolt 4端子,提供更強大的擴充性。

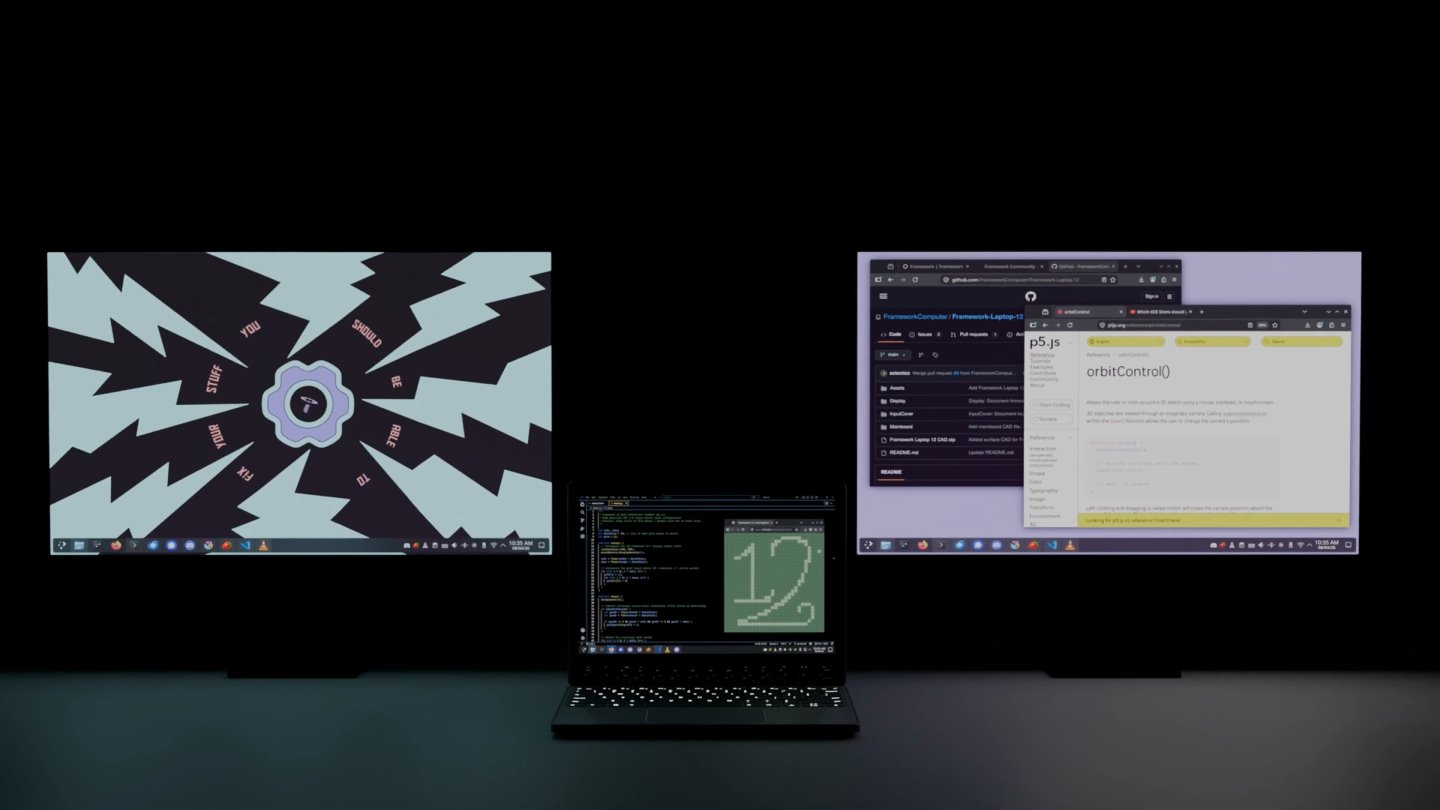
Thunderbolt 4端子能夠擴2組解析度達4K的外接顯示器。

Thunderbolt 4端子也能夠搭配顯示卡外接盒強化顯示、繪圖、AI運算等效能。

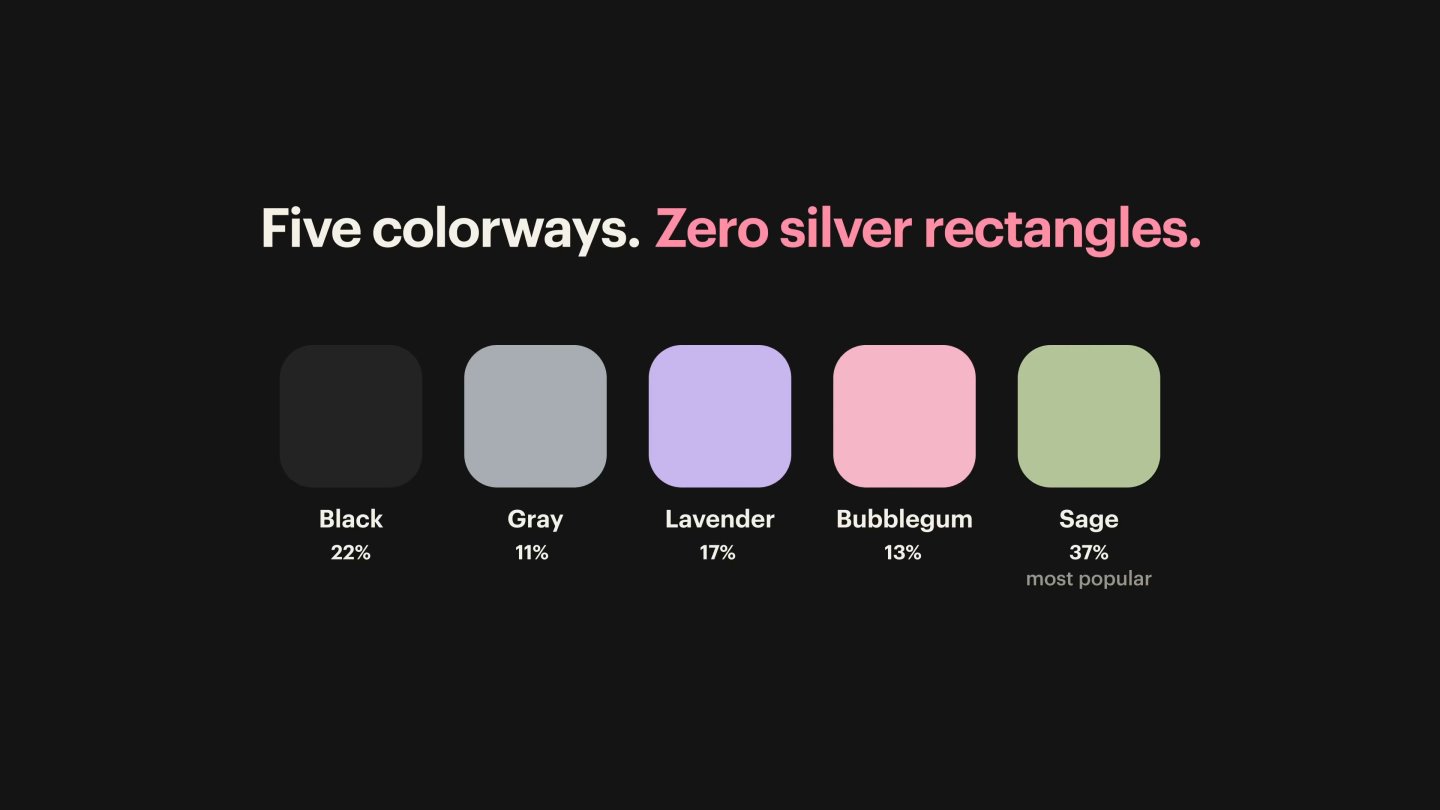
Laptop 12提供5種顏色選擇。

Laptop 12目前已經可以在Framework官方網站訂購,搭配Core 3 304處理器主機板、不含記憶體與儲存裝置的全機價格為新台幣18,400元起,價格隨客製化規格而異。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

Qualcomm Snapdragon C處理器規格分析,平價Windows筆電也能全日持久!

Qualcomm先前發表針對平價Windows on Arm裝置設計的Snapdragon C處理器,提供更具價格競爭力的解決方案,我們來看看它的詳細規格如何。40cf57d3a5280ce03f180d316a777c7a


Qualcomm先前發表針對高階Windows on Arm裝置推出Snapdragon X2處理器,不但將Arm架構處理器的電力效率優勢帶到搭載Windows作業系統的筆記型電腦,也提供旗艦級效能表現。隨後Qualcomm推出的Snapdragon X2 Plus則切入中階價位帶,進一步擴展產品的覆蓋率。

延伸閱讀:
Snapdragon X2處理器架構全解析:12大6小核心是怎麼煉成的?
ASUS ZenBook A16 搭載 Qualcomm Snapdragon X2 Elite Extreme 效能實測:Arm 架構輕薄筆電化身 Windows 效能怪獸
【CES 2026】Qualcomm發表Snapdragon X2 Plus SoC,10核心、6核心型號提供更多平價選擇
Intel Panther Lake處理器架構解析,3種衍生型號最多可選16核搭12組Xe 3核心
【COMPUTEX 2026】不只脫光光秀晶片,Intel展示Panther Lake與Wildcat Lake晶圓,現場直擊Dell XPS 13輕量筆電

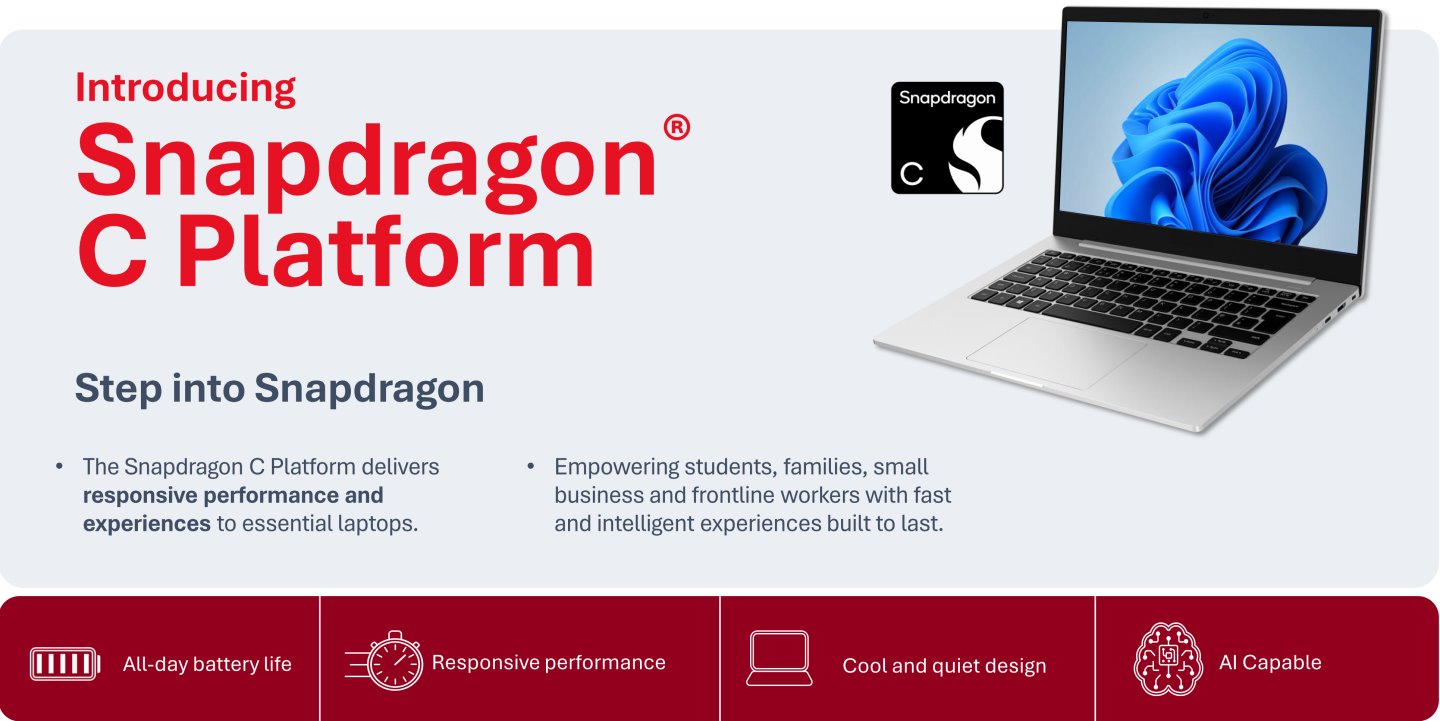
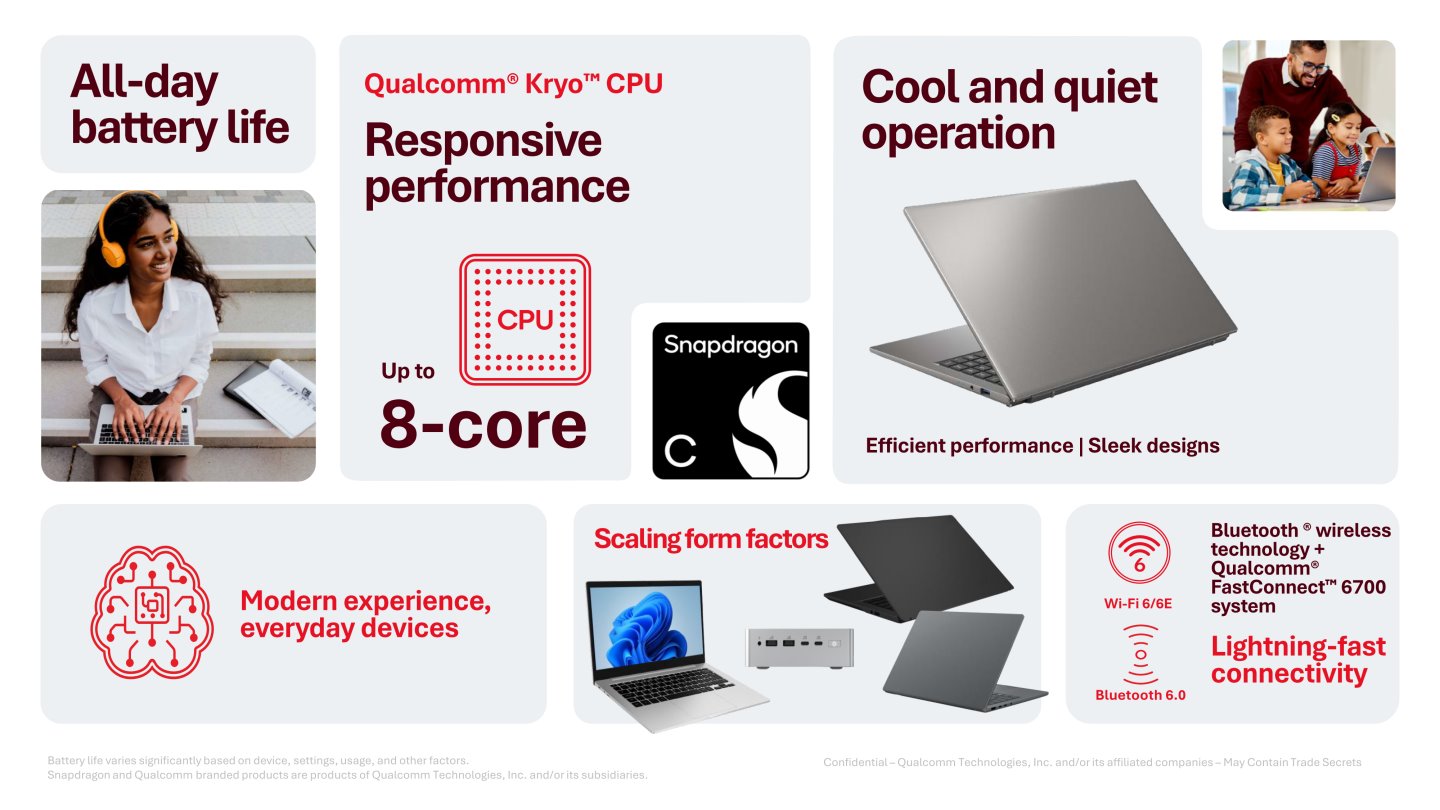
最新推出的Snapdragon C處理器則是瞄準美金300元價位帶的入門級筆記型電腦,滿足學生、新興市場的需求,提供流暢的日常效能、網頁瀏覽、影音串流視訊通話等功能,並具有全日電池續航力,以及低溫且安靜的使用體驗。

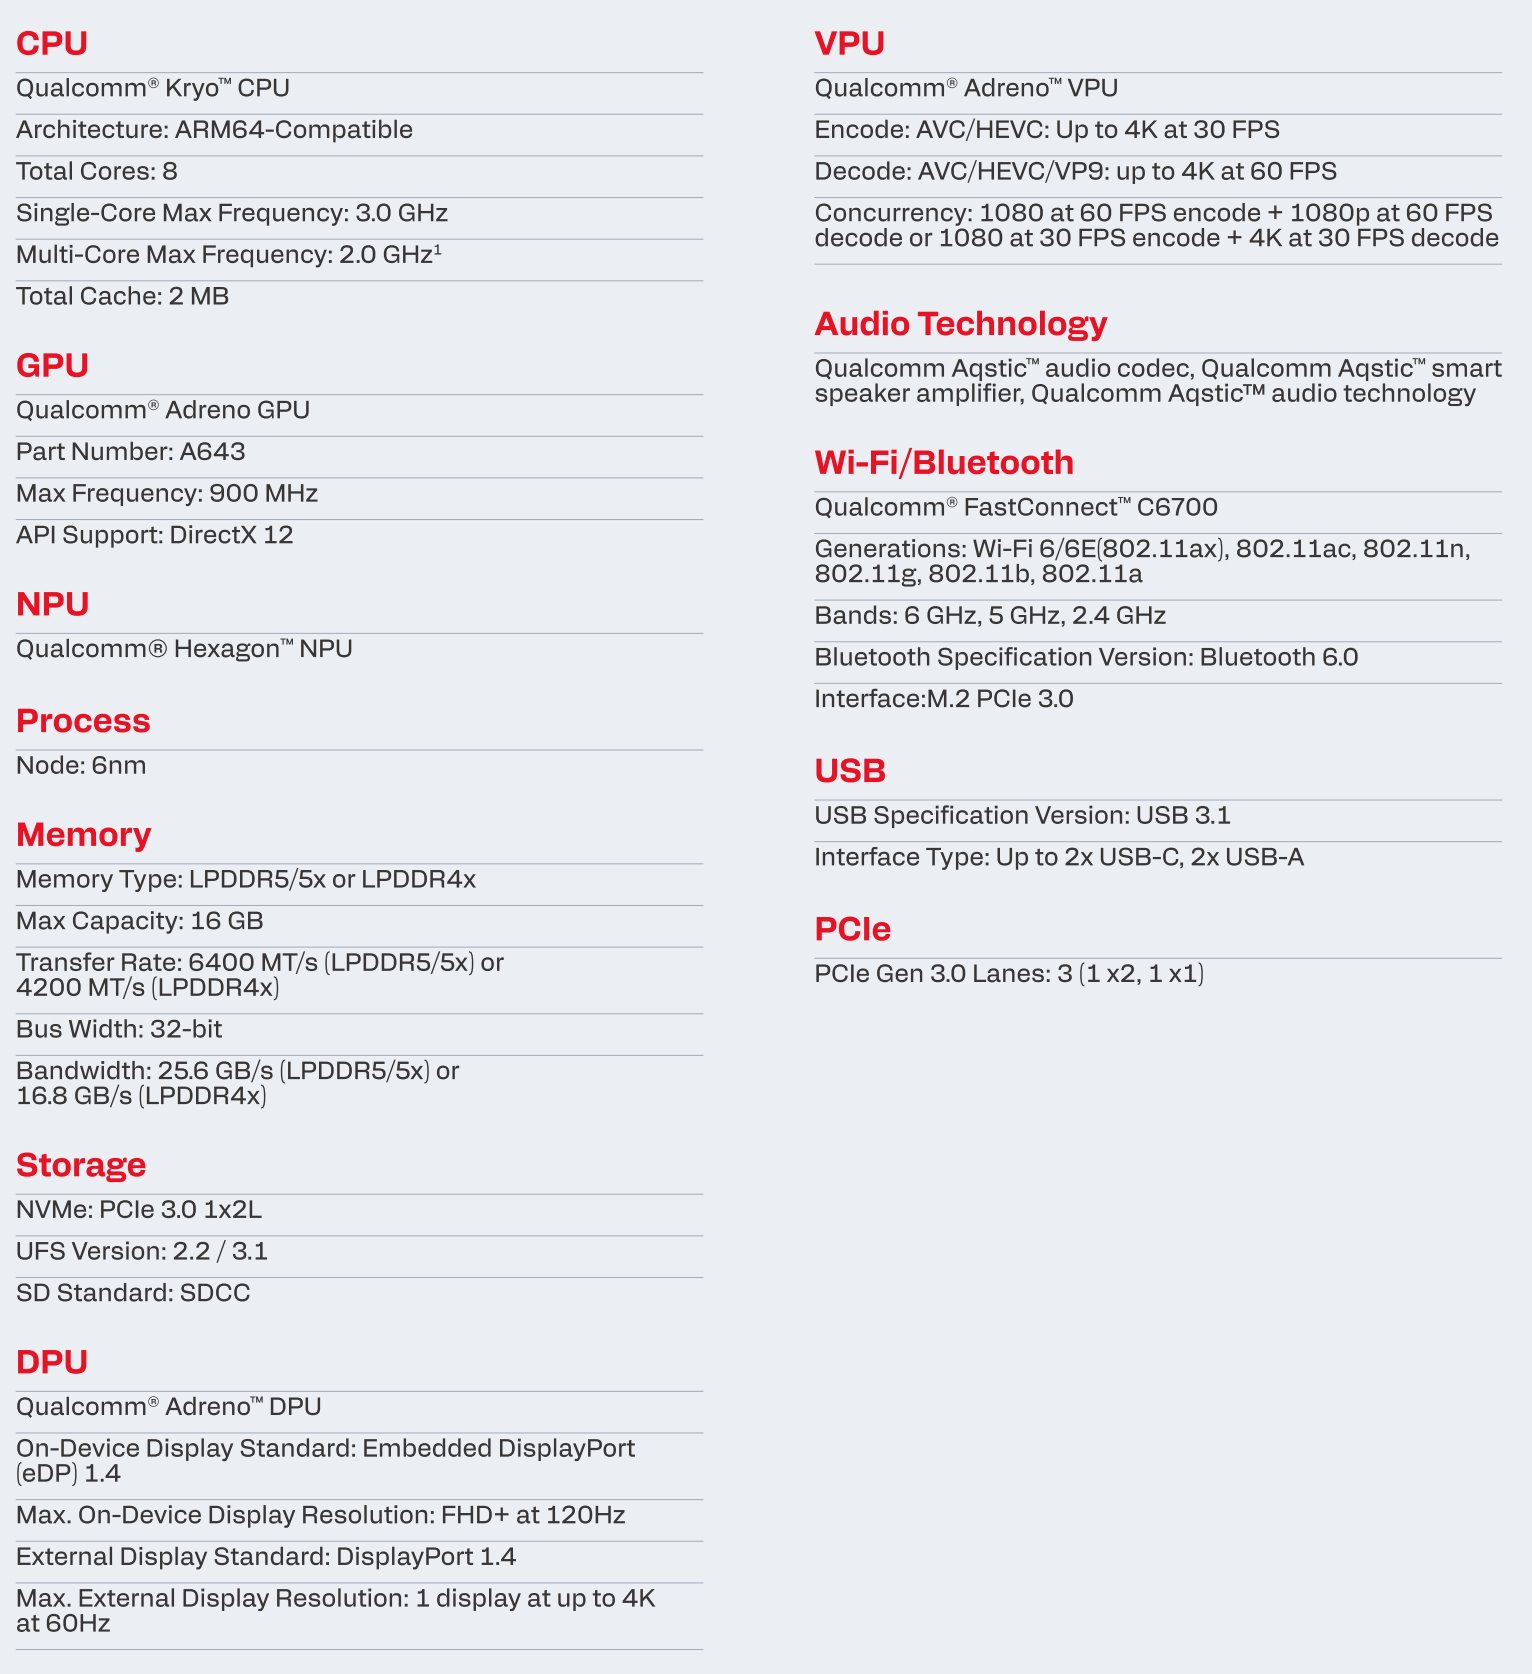
Snapdragon C處理器最高具有8組Kyro架構處理器核心,總快取記憶體容量僅有2 MB,單核心最高時脈可達3.0 GHz,多核心時脈條件為3核心2.6 GHz或4核心2.0 GHz。

它也搭配Adreno A643內建顯示晶片,最高時脈為900 MHz,並且支援Microsoft的DirectX 12繪圖API。在AI功能部分則透過Hexagon NPU(神經處理器)來強化AI運算效能,提供更豐富的AI應用程式使用體驗。

在記憶體相容性部分,Snapdragon C平台支援LPDDR5-6400、LPDDR5x-6400,LPDDR4x-4200等不同種類的記憶體,最高容量為16 GB。儲存裝置方面則提供1組PCIe Gen 3x2的NVMe介面(可用於M.2規格固態硬碟),以及UFS 2.2/3.1儲存媒體,在這個記憶體短缺的時期,多元的相容性有助於提供OEM夥伴更大的產品規劃彈性,以滿足市場上不同價位帶產品的需求。

Snapdragon C平台的設計目標為在300元價位帶的入門級筆記型電腦提供全日電池續航力、靈敏效能、相容AI功能,以及低溫且安靜的使用體驗。

Snapdragon C處理器最高具有8組Kyro架構處理器核心,預計將應用於筆記型電腦與迷你電腦。

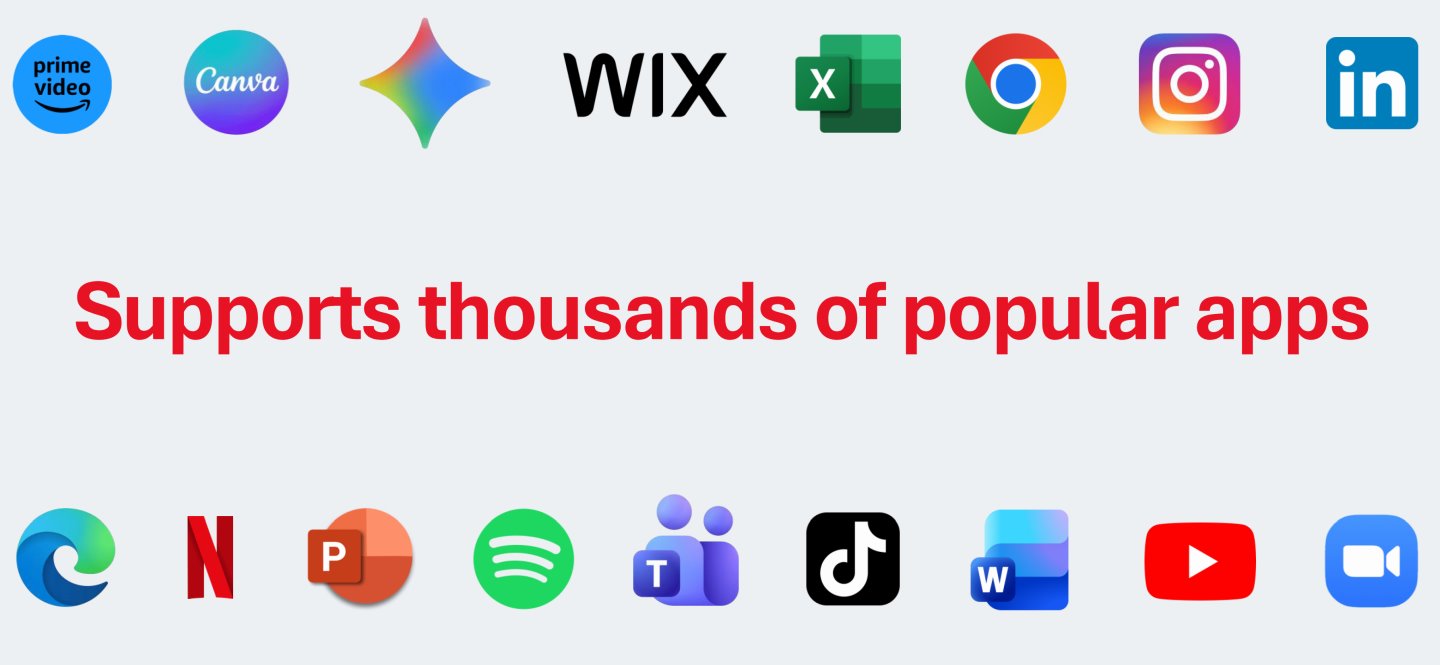
Windows on Arm透過原生軟體與模擬器等方式讓Windows應用程式能在Arm架構處理上運作,現在已能執行上千款熱門應用程式。

Snapdragon C處理器規格一覽。

以輕省筆電為目標

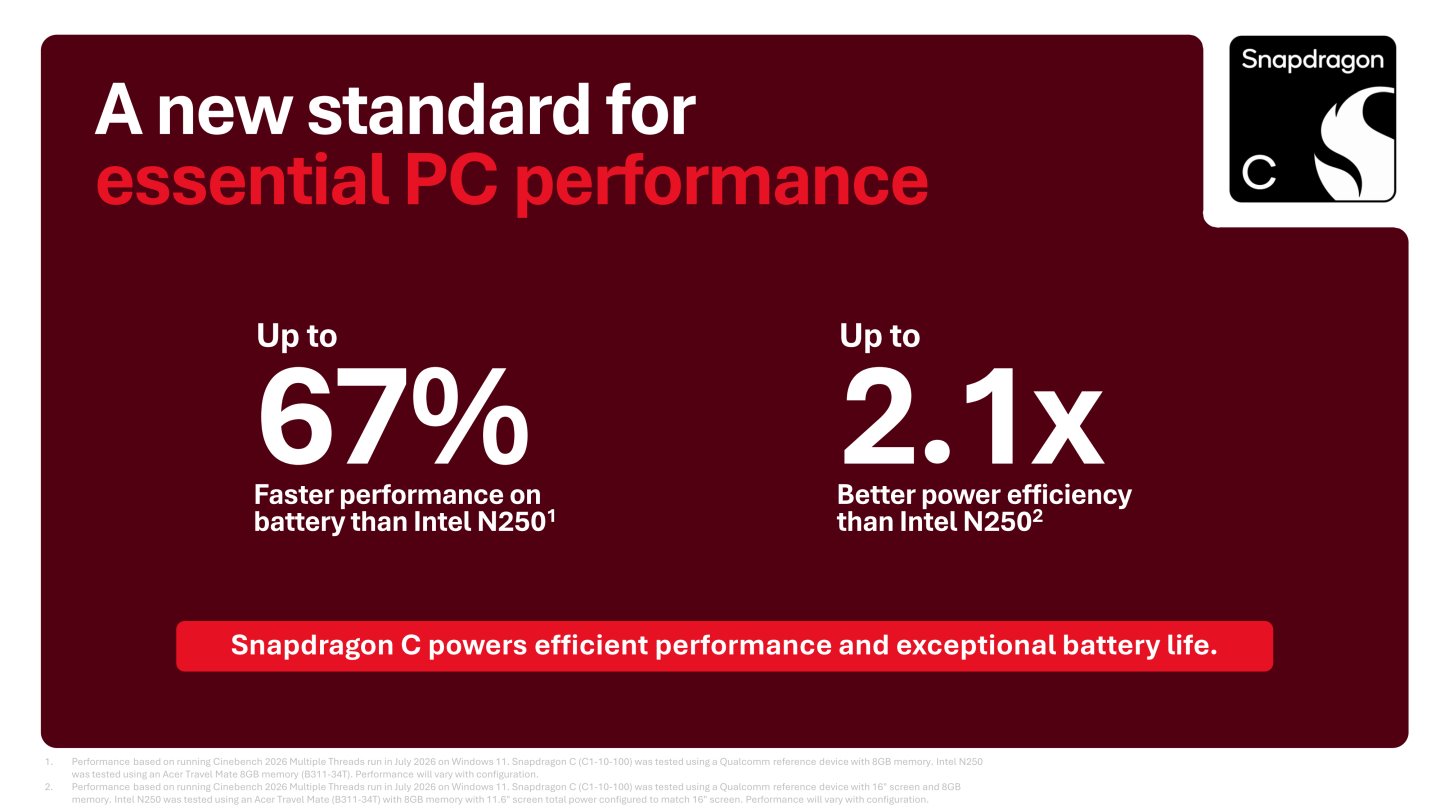
Snapdragon X2處理器採用Oryon架構,Qualcomm將競爭對手設定為代號為Panther Lake的Intel Core Ultra系列3處理器,目標為角逐最強行動處理器,而Snapdragon C處理器則採用Kyro架構,在官方簡報中的對照對手不是今年推出代號為Wildcat Lake的Intel Core系列3處理器,反而設定為2025年第1季推出、採用4核4緒核心配置的Intel N250。

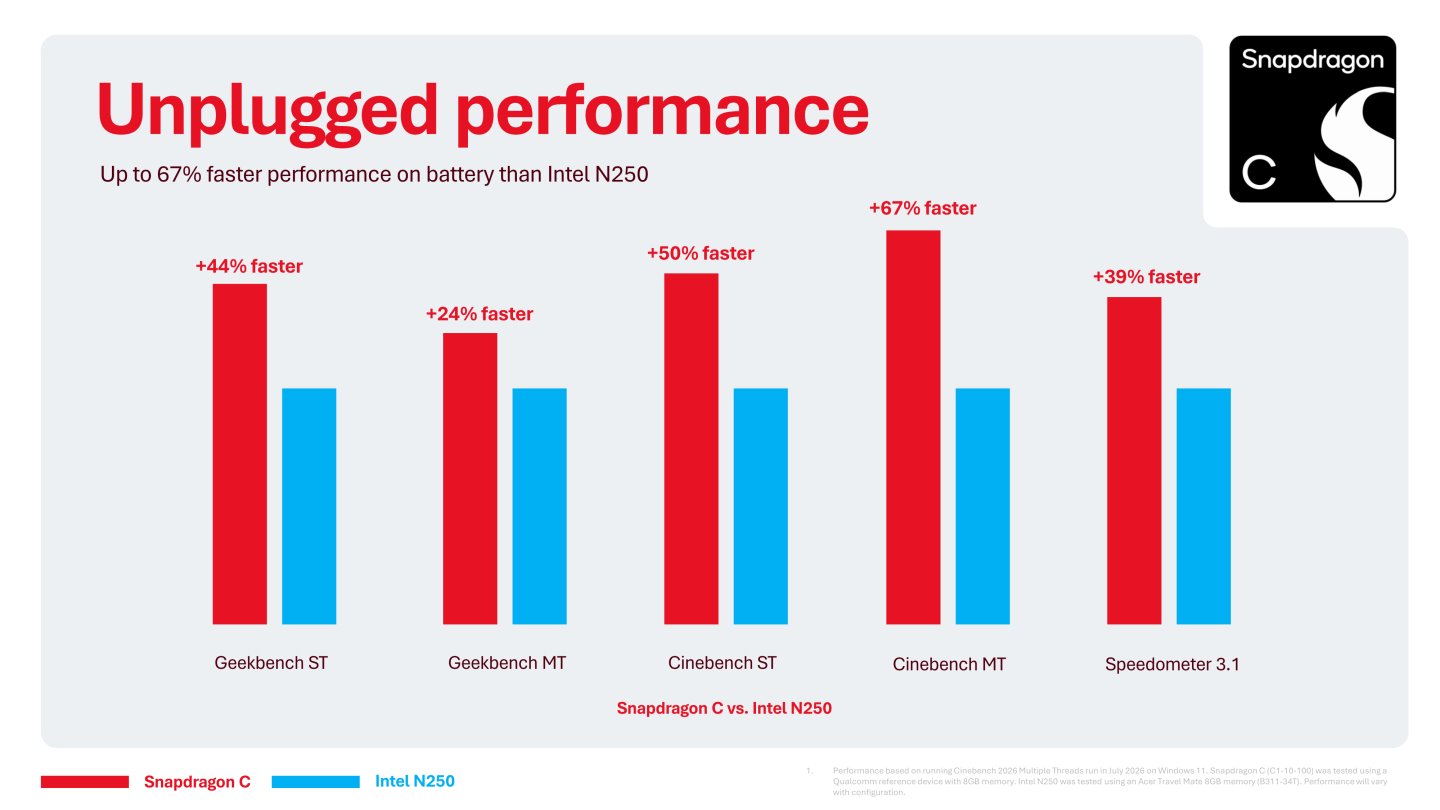
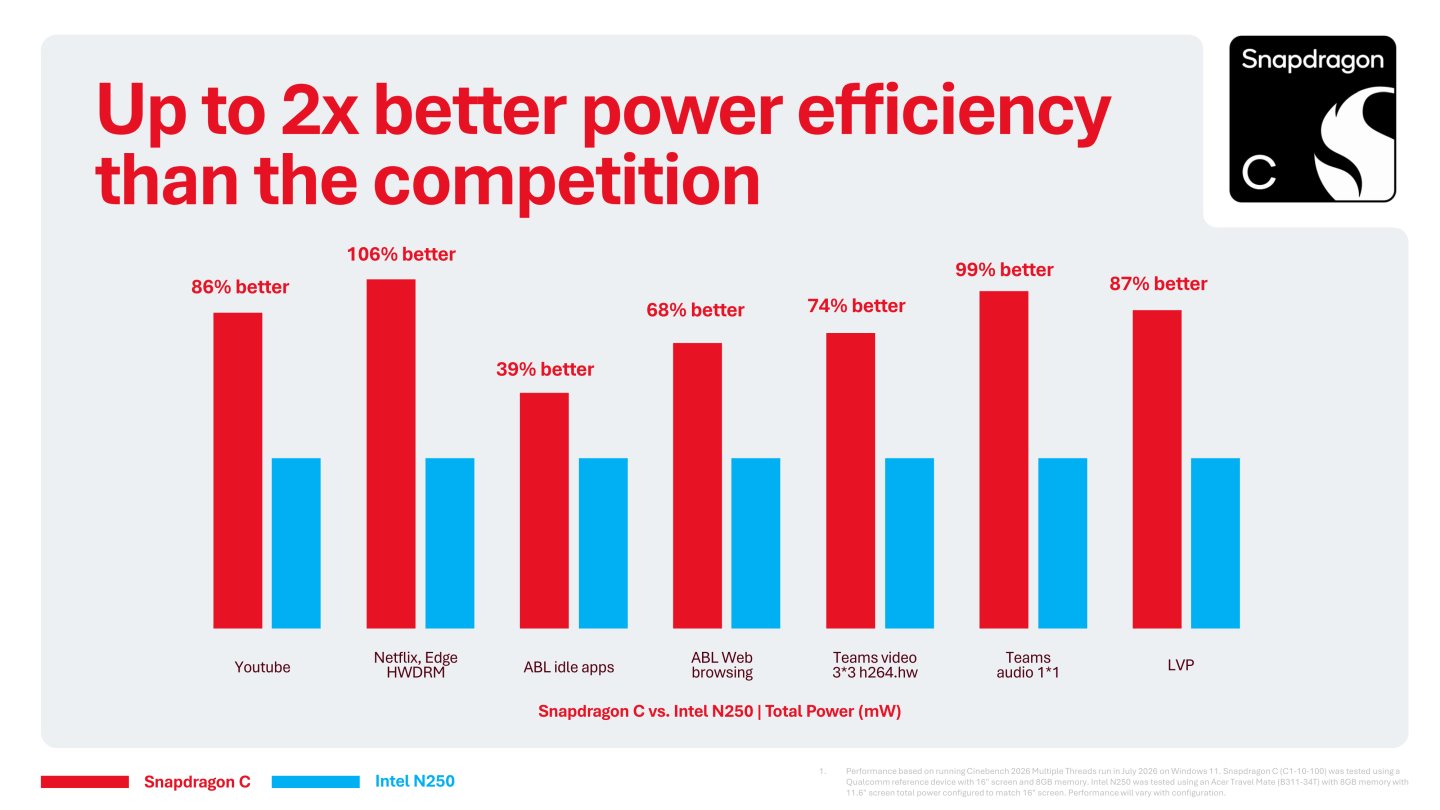
在Qualcomm提供的數據中,與搭配8 GB記憶體的Acer Travelmate B311-34T相比,Snapdragon C1-10-100處理器搭配8 GB記憶體的測試平台的效能表現最高能夠領先67%,電力效率則領先約110%。

Qualcomm將Snapdragon C與競爭對手Intel的N250輕省級處理器進行比較,效能領先67%,電力效率則領先約110%。

Snapdragon C效能領先N250最高的項目為Cinebench多核心測試,領先幅度為67%。

Qualcomm Snapdragon C處理器規格分析,平價Windows筆電也能全日持久!

▲在電力效率部分,觀賞YouTube與Netflix影片的領先幅度分別為86%、106%。

Qualcomm將與Acer、HP、Lenovo等合作夥伴共同推出多款搭載Snapdragon C處理器的產品,然而受到近期記憶體價格大幅飆漲的影響,最終產品的售價可能會有所調整。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

電競筆電顯卡也能升級?Framework Laptop 16實機展示,RTX 5070模組化設計帥翻全場

Framework於Computex台北國際電腦展2026帶來了Laptop 13 Pro、Laptop 16等產品的實體展示,並提供爆炸圖風格的拆解展示,讓大家能夠一窺其內部構造。9461a4eb1e8d718b875167b689fd5750


Framework模組化筆記型電腦的特色為主機板、記憶體、儲存裝置、電池、鍵盤、觸控板、顯示器邊框、I/O端子等零組件都採用可自行更換的模組化設計,筆者先前曾介紹的Laptop 13 Pro搭載全新設計的主機板,搭配代號為Pantner Lake的Core Ultra系列3處理器,提供Core Ultra 5 325、Core Ultra X7 358H、Core Ultra X9 388H等型號選擇,前者為入門款的8核心型號,後2者則為16核心處理器搭配12組Xe核心內建顯示晶片的高階型號。

延伸閱讀:
Framework推出全新Laptop 13 Pro模組化筆電,搭配Core Ultra X9 388H提供20小時續航力
Framework 推出 Laptop 16 適用 GeForce RTX 5070 12 GB 模組,現有筆電遊戲效能再升級
DeepComputing 推出第 3 代 RISC-V 主機板,相容 Framework Laptop 13 模組化筆電

這款主機板採用LPCAMM2介面記憶體,目前提供最高64 GB容量的LPDDR5x模組客製化選項,使用者也能自行升級,而不像過去LPDDR5x記憶體採用焊死的On-Board型式而無法升級。在儲存裝置部分,則提供1組PCIe Gen 5x4 M.2 2280固態硬碟插槽,同樣能夠自行升級。

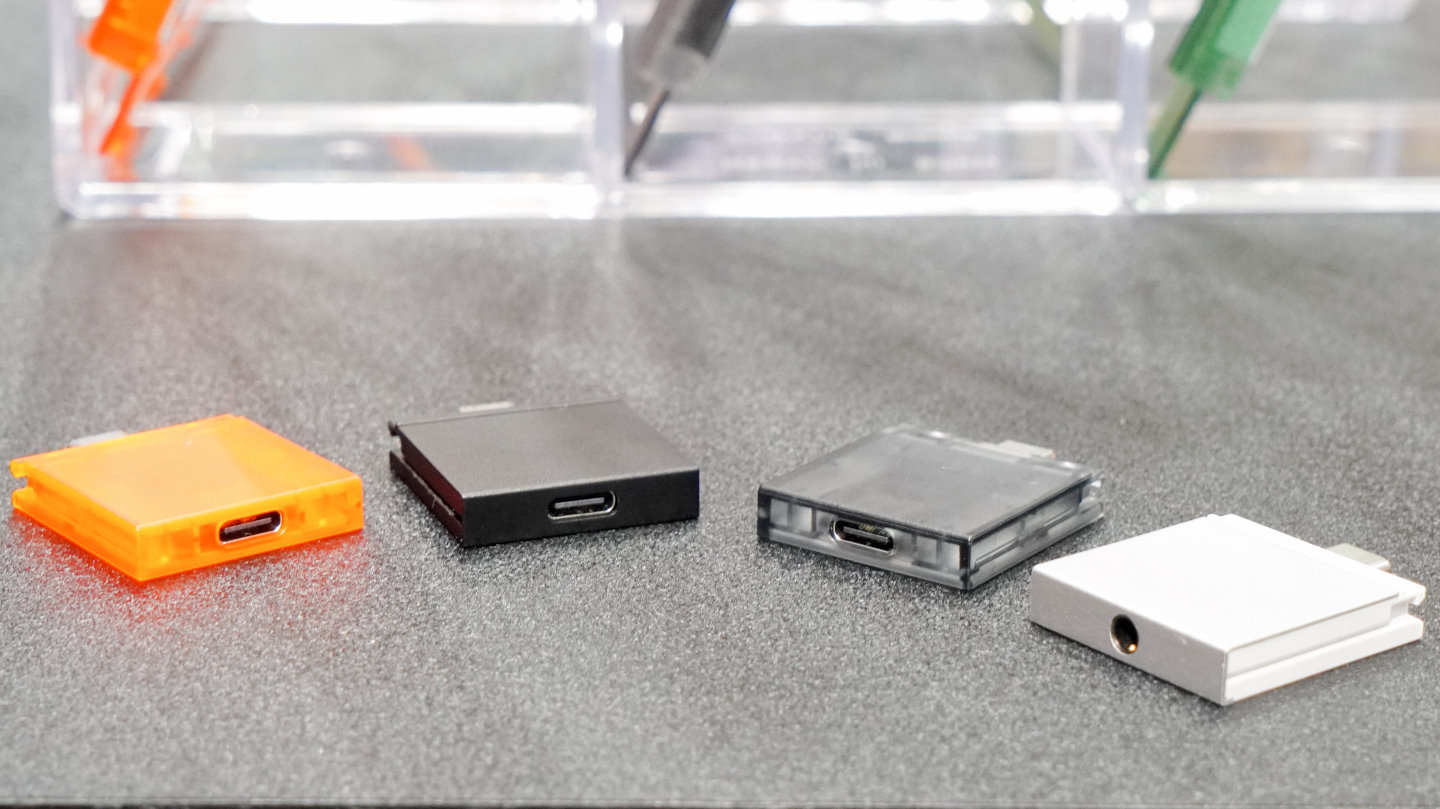
Framework的另一大特色就是模組化I/O端子,使用者可以依需求USB、HDMI、DisplayPort、有線網路、SD讀卡機、micro SD讀卡機等I/O功能,自行安排最適合的使用模式。

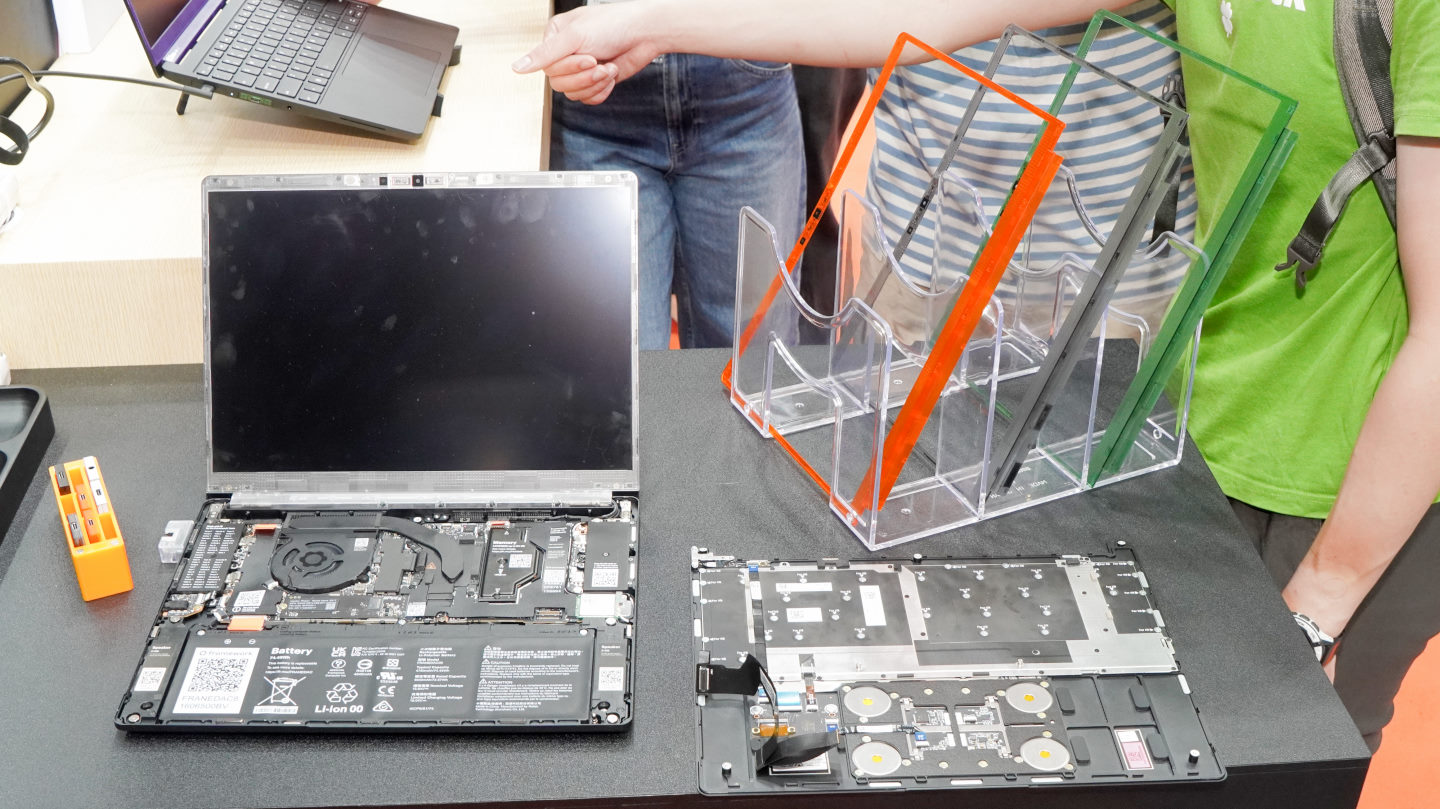
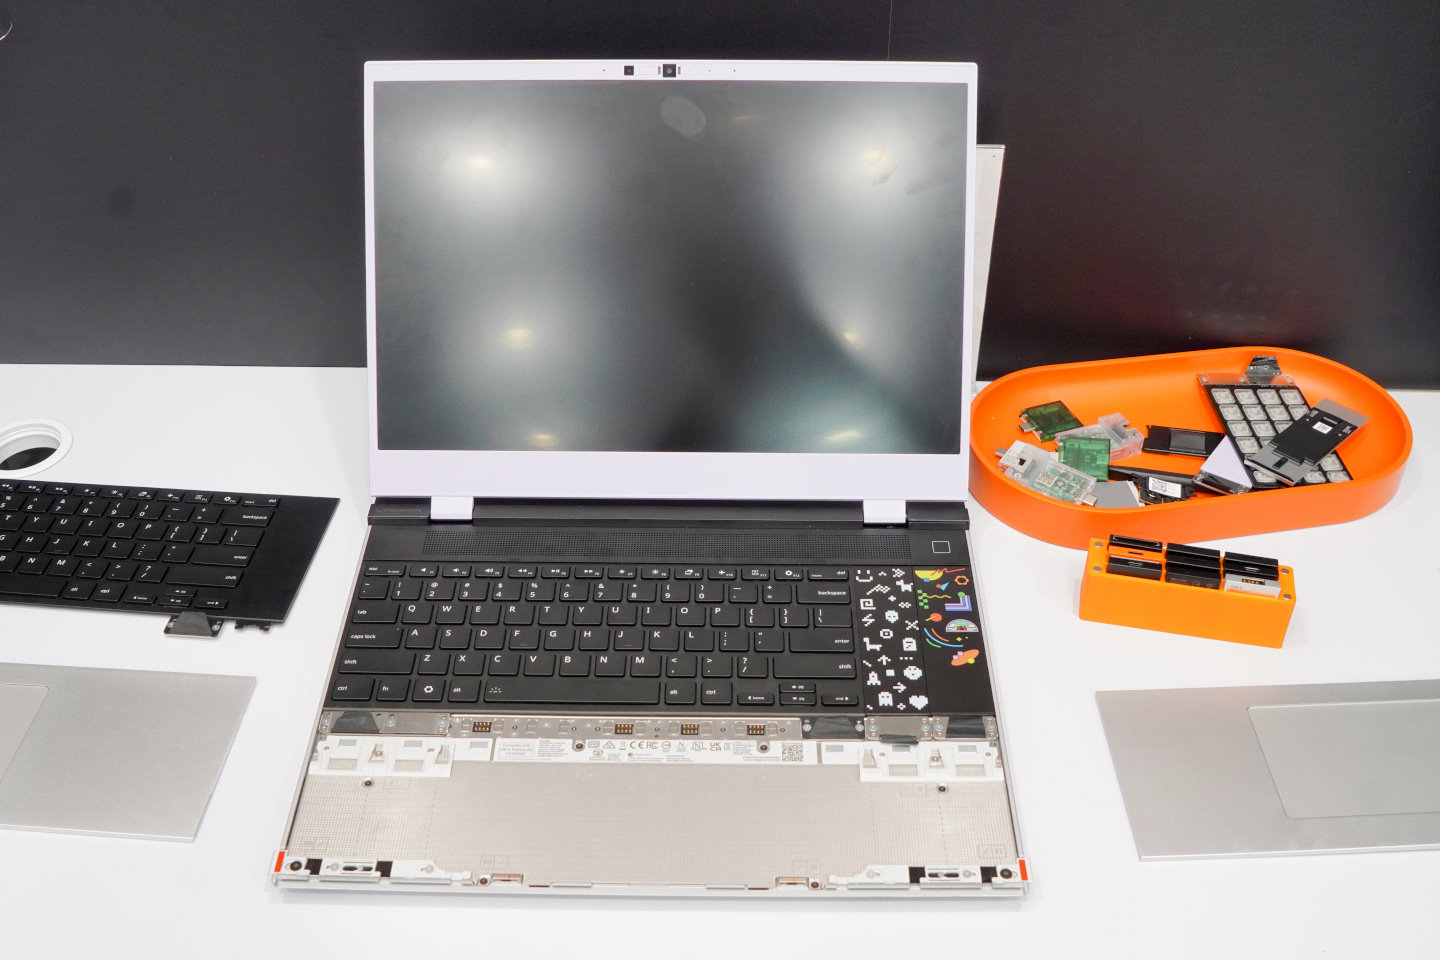
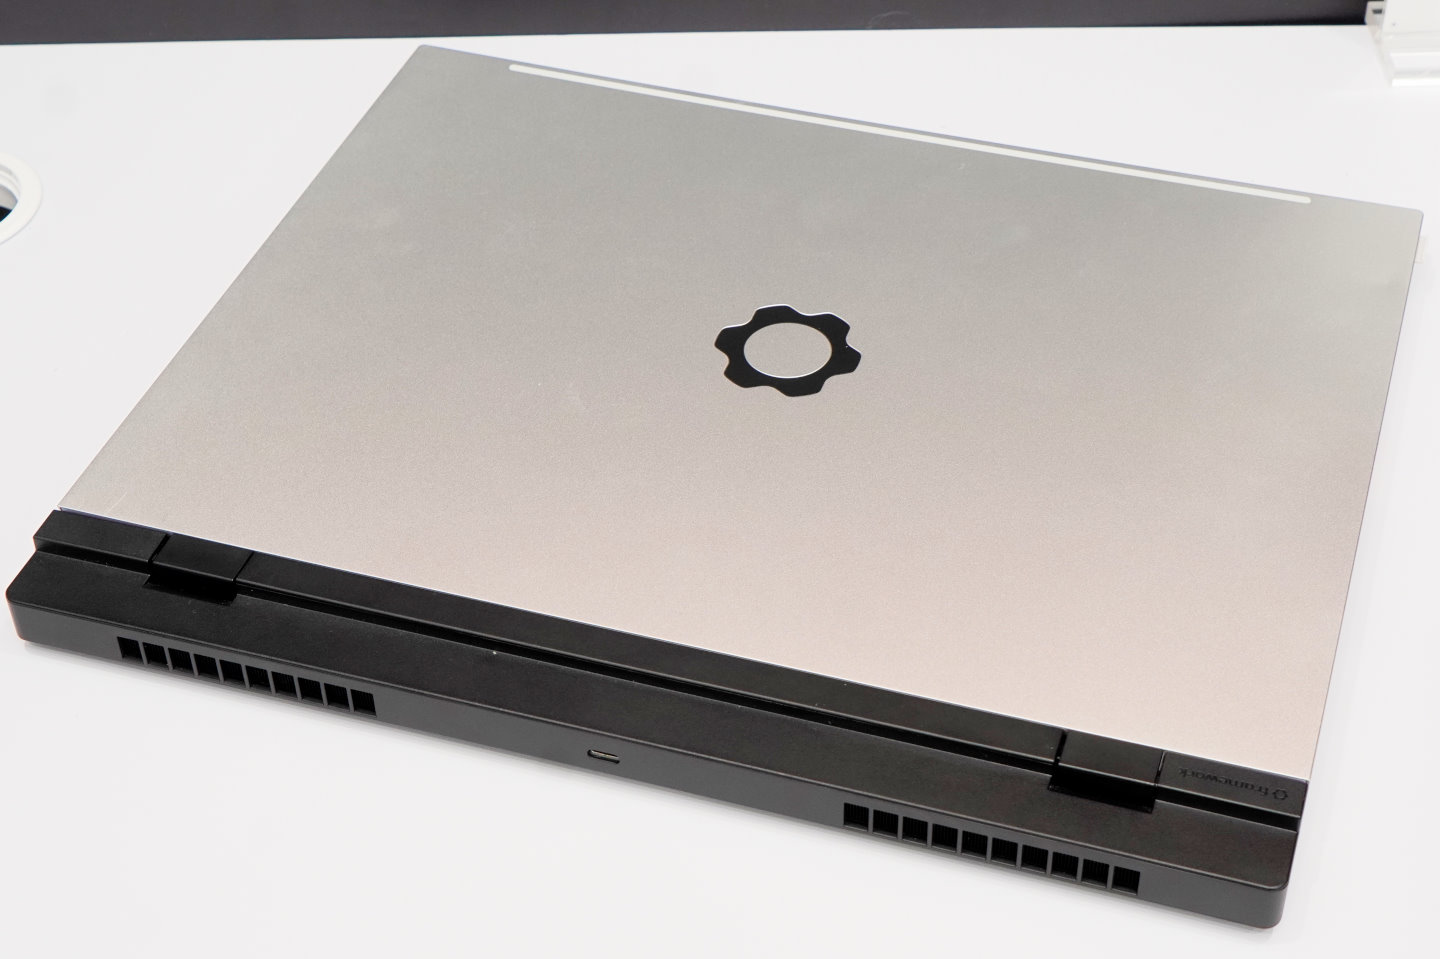
筆者先前介紹過的Framework Laptop 13 Pro是款模組化筆電,機身上許多部位都能輕易拆解、自行更換。

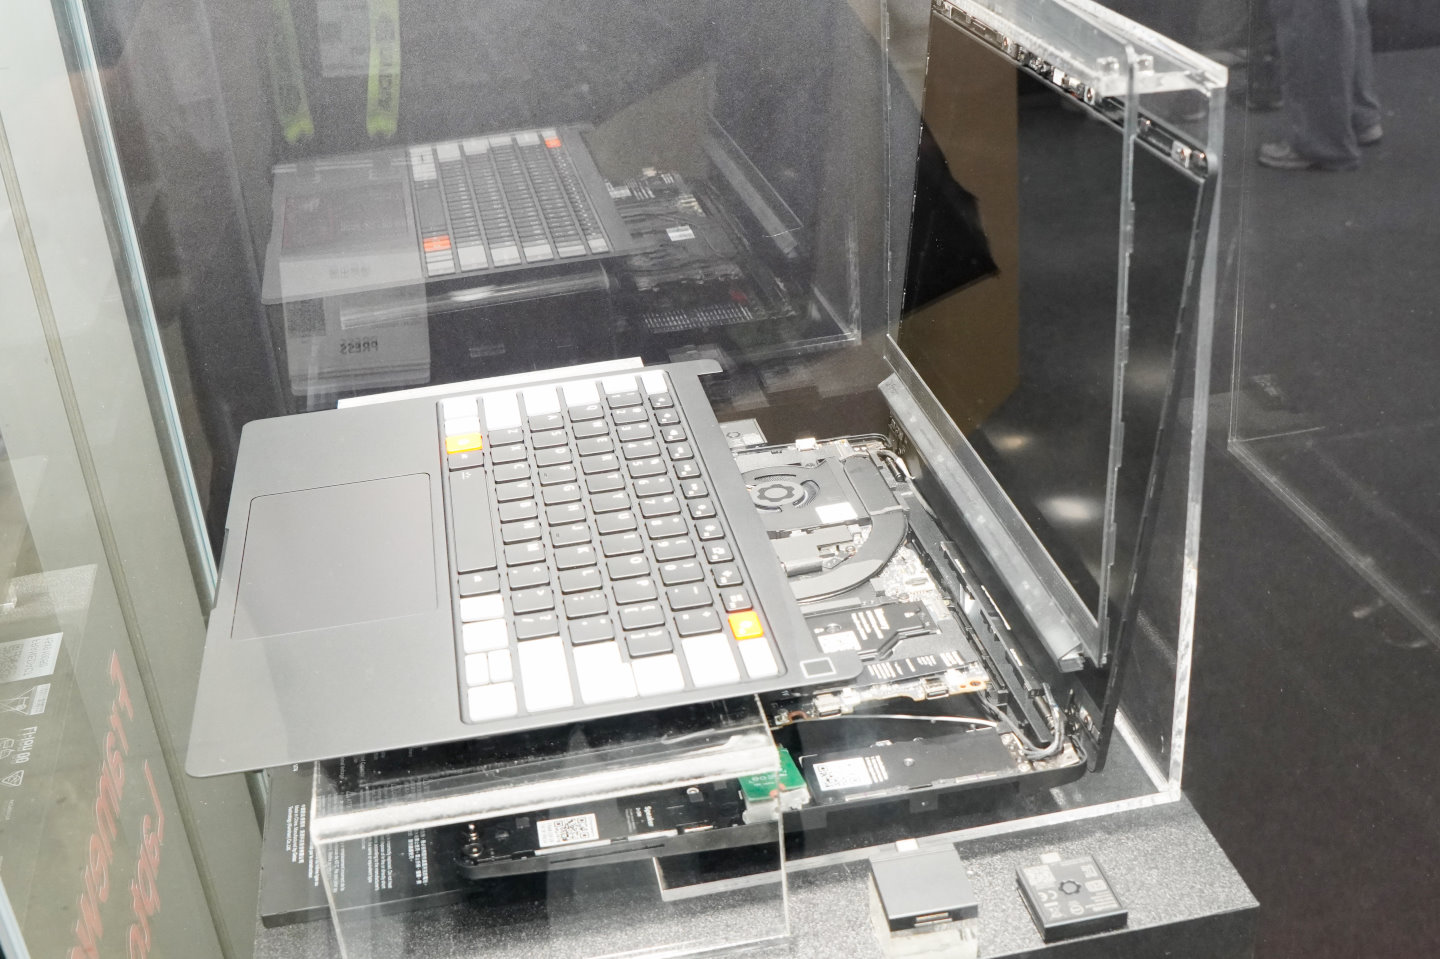
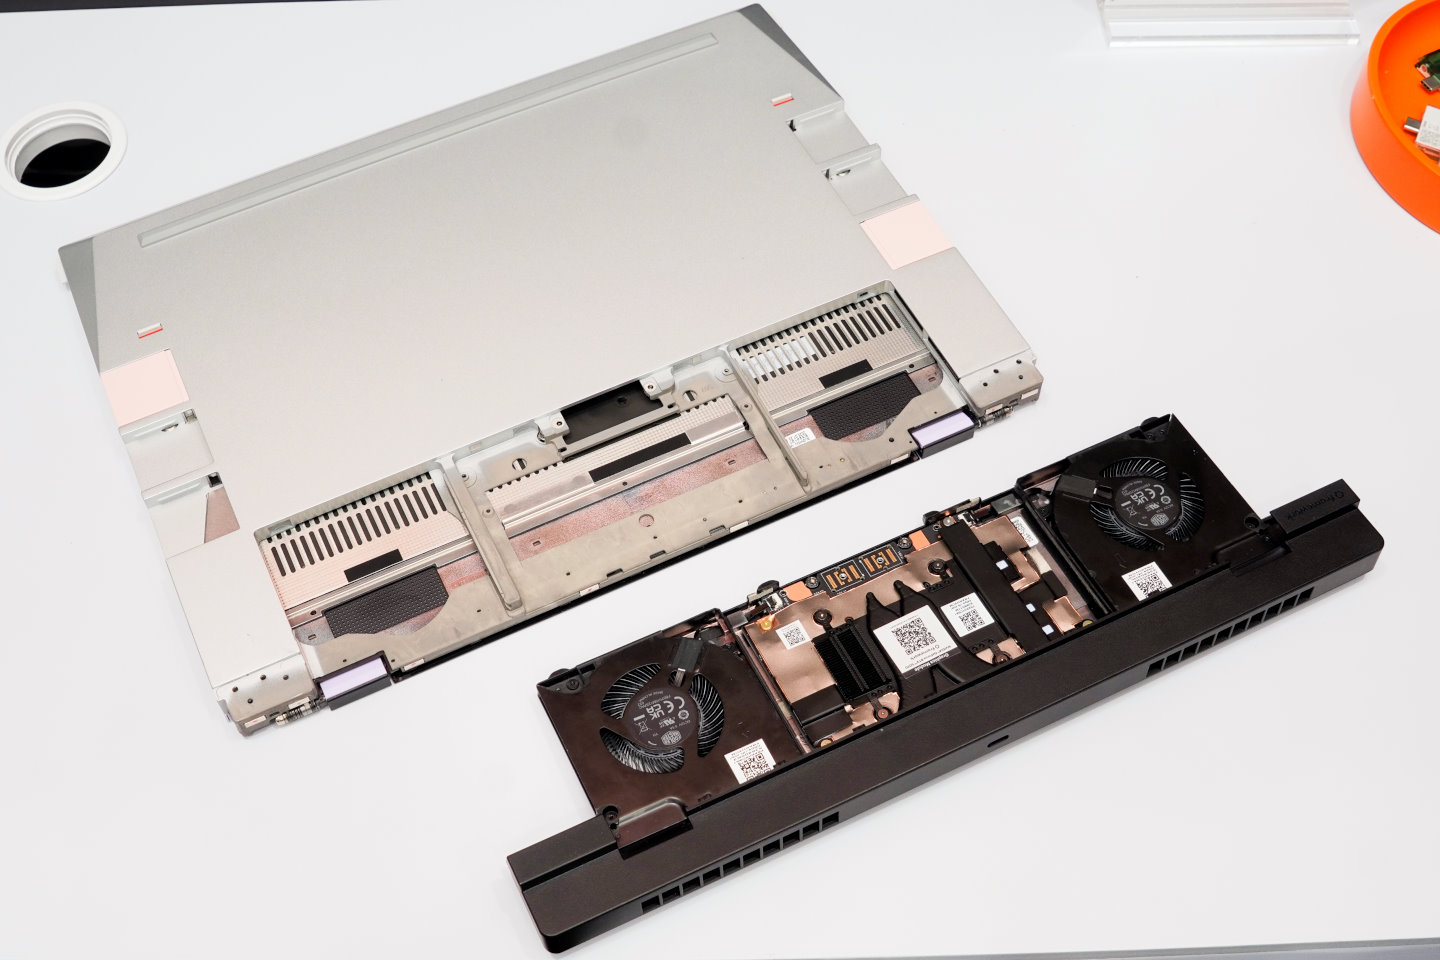
Framework在Computex台北國際電腦展2026會場將展示機拆開,讓大家能夠一睹內部構造。

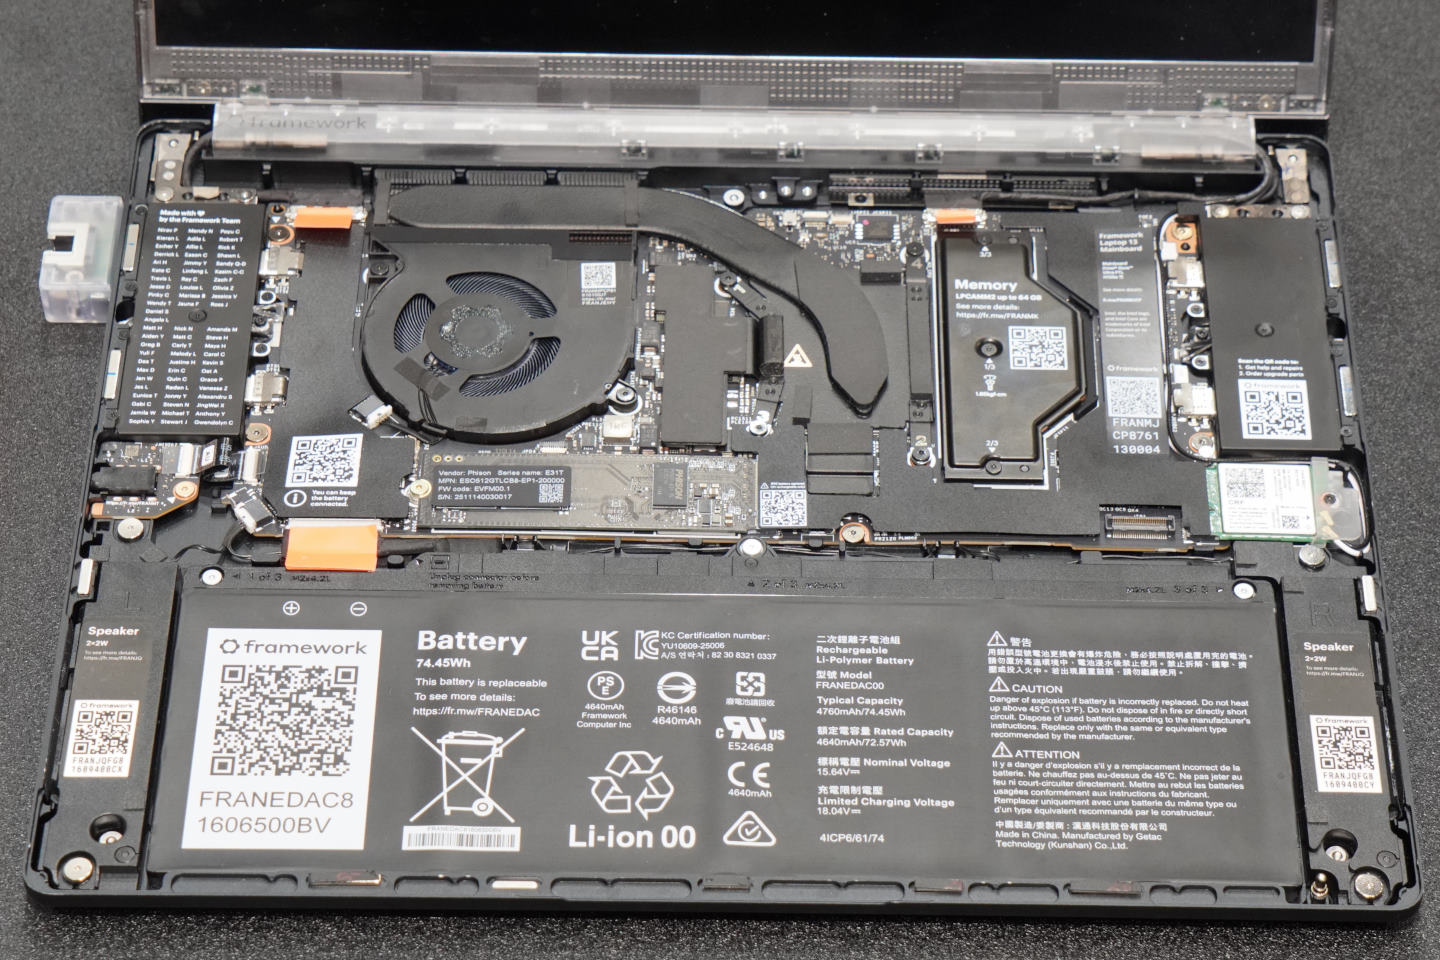
Framework Laptop 13 Pro的機身內部主要空間被電池占據,上方為主機板,以及可自行更換的LPCAMM2記憶體模組、M.2 2280固態硬碟。

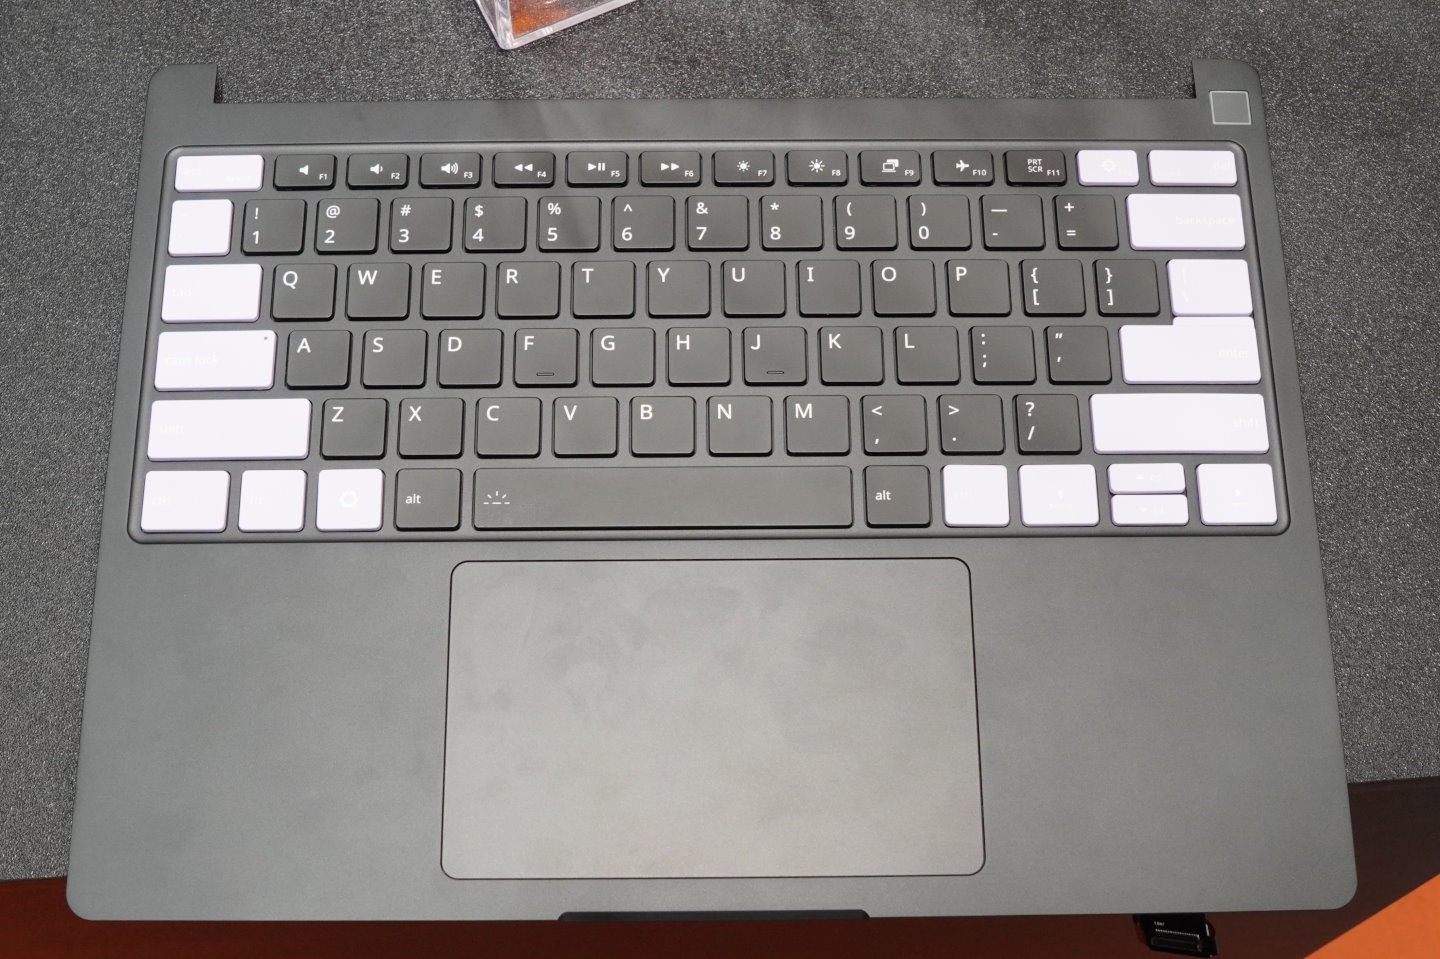
鍵盤、觸控板總成也可自行更換,不但可以挑選自己喜歡的配色,在故障時也能輕鬆替換。

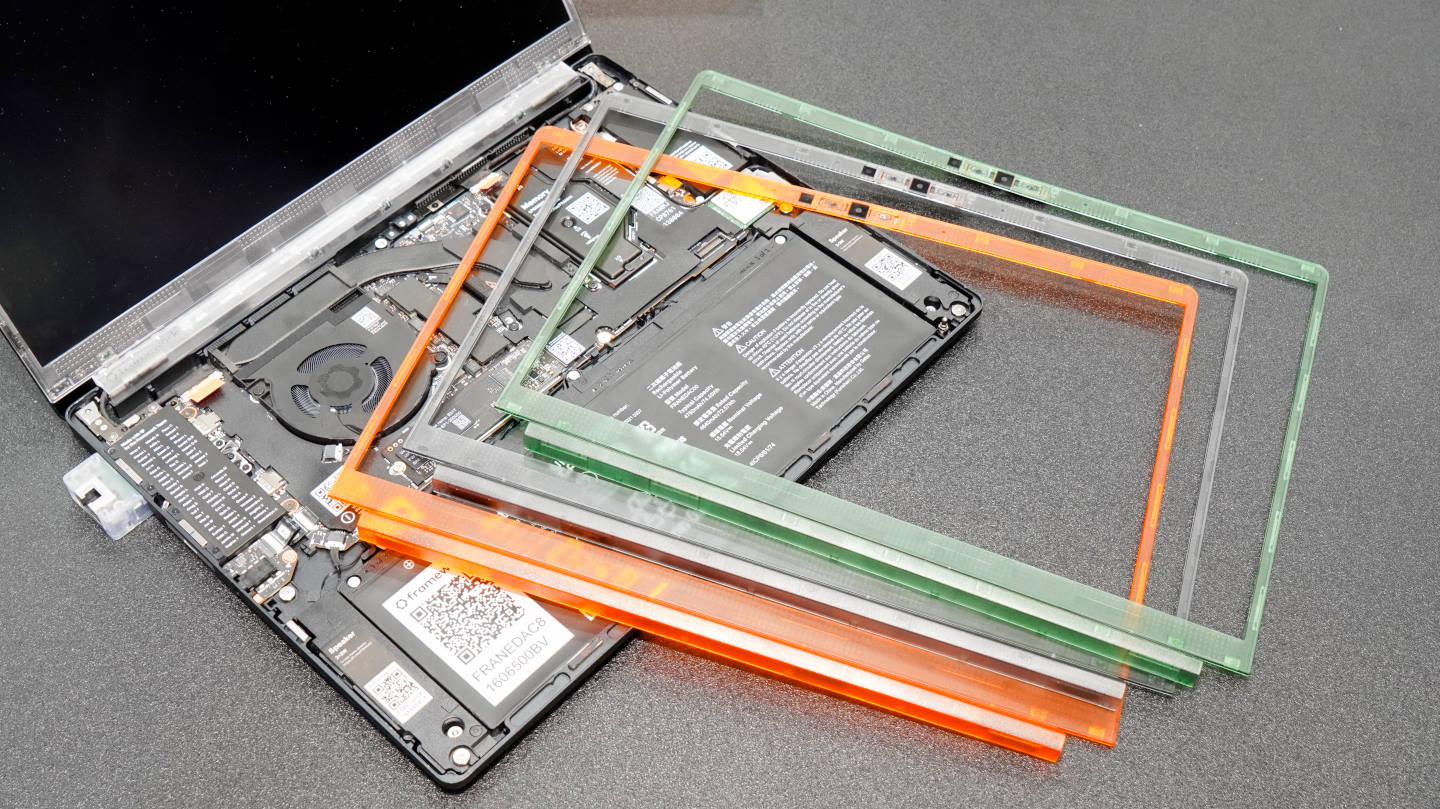
Laptop 13 Pro提供多種不同顏色的螢幕邊框,使用者可以依喜好選擇。

多種I/O模組也提供透橘、黑、透灰、銀色等顏色,並具有USB、HDMI、DisplayPort、有線網路、SD讀卡機、micro SD讀卡機等不同功能的模組可自行替換。

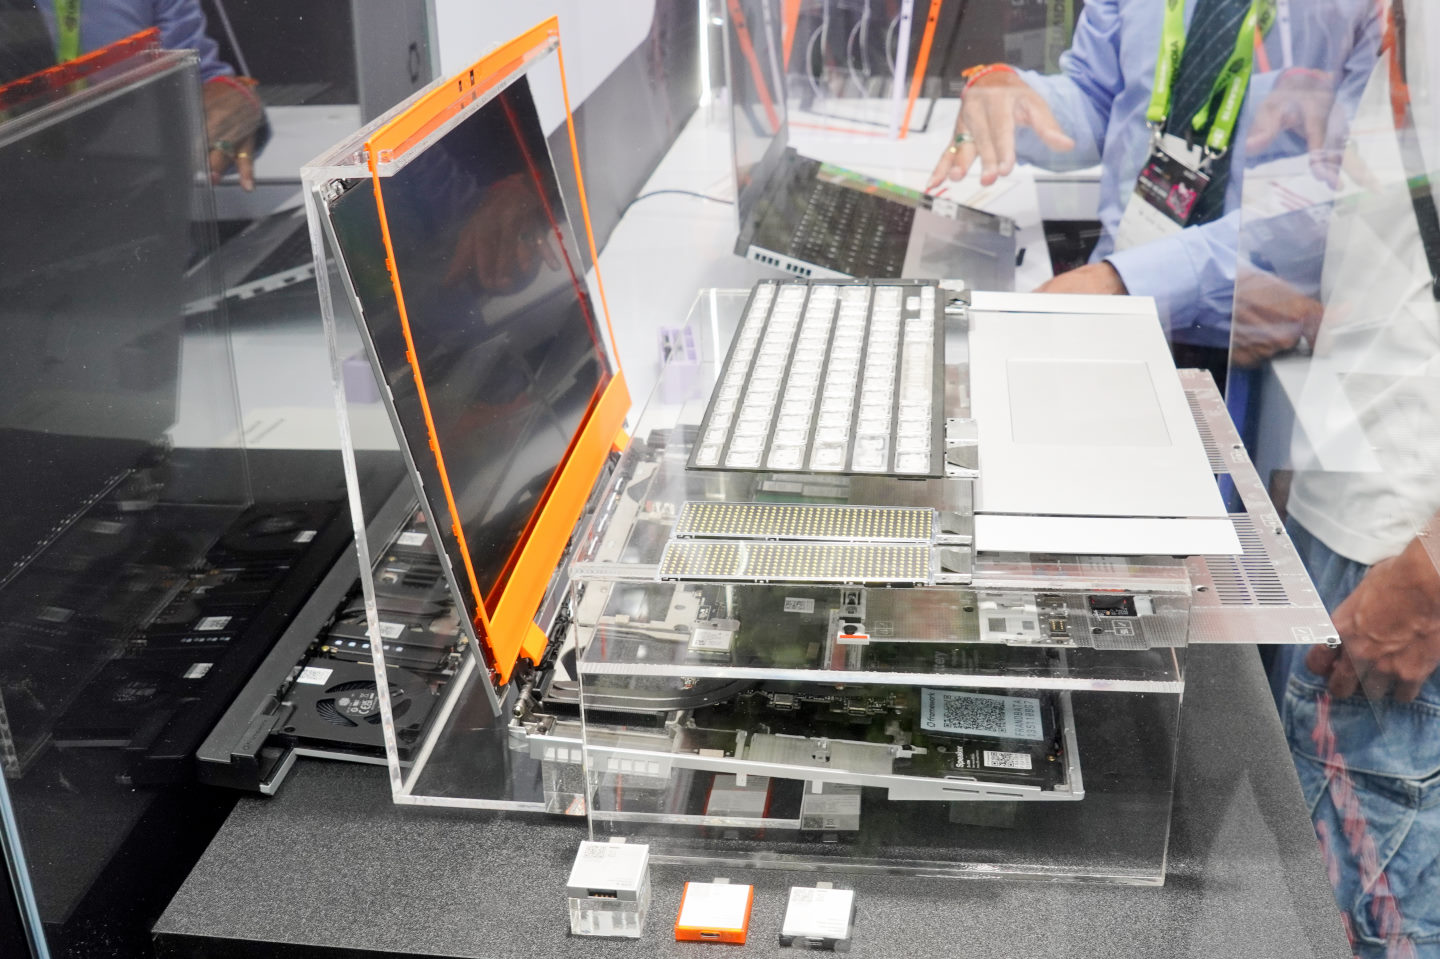
現場展示櫃中也有以爆炸圖方式陳列的Laptop 13 Pro。

可更換顯示晶片的電競筆電

Laptop 16搭載解析度為2560 x 1600的16吋顯示器,提供搭載AMD Ryzen 7040系列與Ryzen AI 300系列處理器的主機板,最高可選Ryzen AI 9 HX 370。顯示晶片部分同樣採用模組化,使用者可以選擇AMD Radeon RX 7700S、NVIDIA GeForce RTX 5070 8GB顯示晶片模組,或是近期推出的GeForce RTX 5070 12 GB,如果不需要獨立顯示晶片,也可以選擇空的擴充槽以減輕全機重量。

Laptop 16因為機身尺寸比較大,具有比較大的客製化彈性,使用者可以選擇無背光或RGB版本鍵盤,以及數字鍵盤或無功能的擋板,並可自由調整鍵盤與數字鍵盤、觸控板的位置,以打造最順手的鍵盤布局。

Framework也把尺寸更大、能安裝獨立顯示晶片模組的Laptop 16帶到現場。

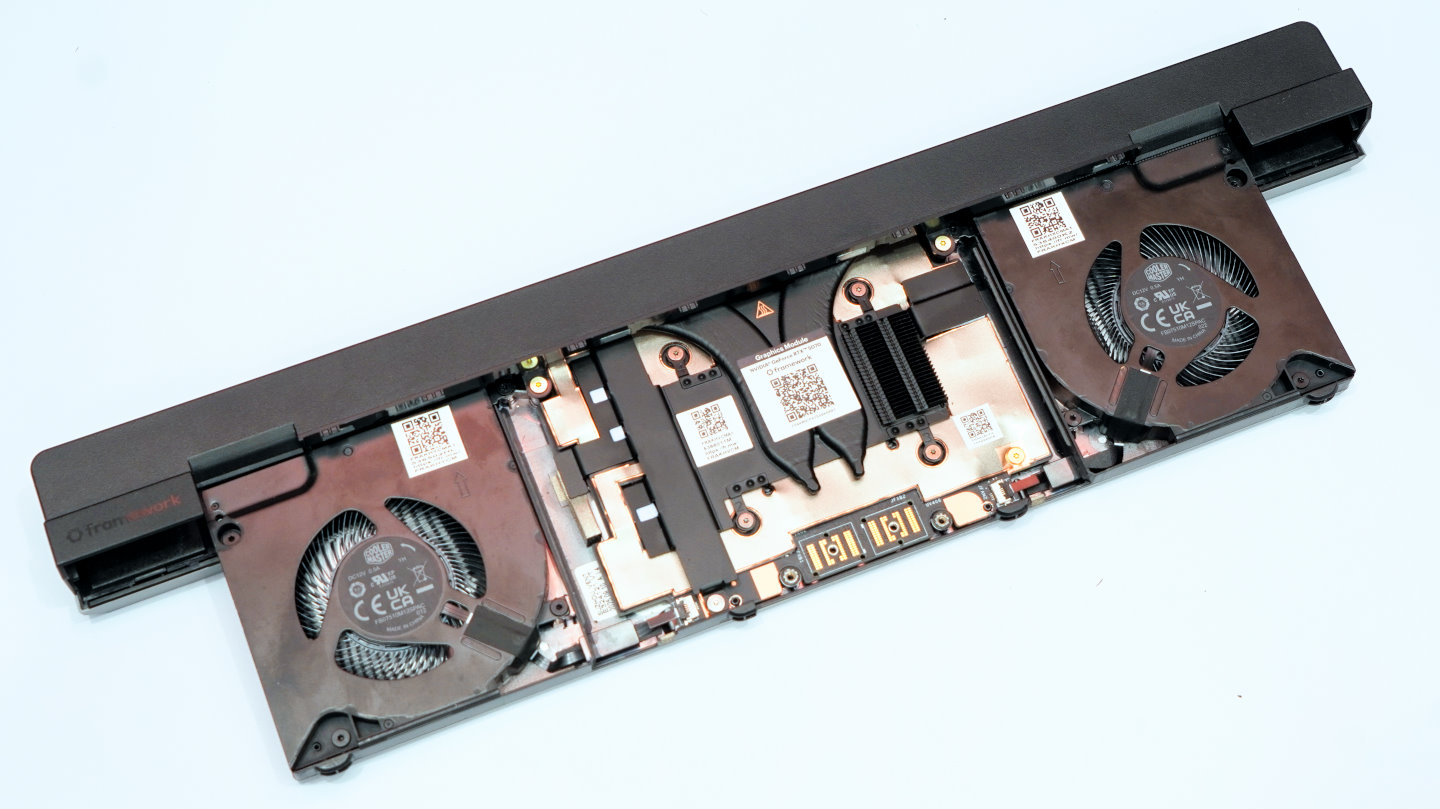
Laptop 16的機身下方後半部為可以拆卸的獨立顯示晶片模組。

使用者可以選擇空的擴充槽模組,或是MD Radeon RX 7700S、NVIDIA GeForce RTX 5070 8GB / 12 GB等獨立顯示晶片模組。

獨立顯示晶片模組上也整合了散熱器,並使用熱導管針對顯示晶片與顯示記憶體加強散熱。


現場同樣展示了Laptop 16的爆炸圖,可以看到圖片左下方的獨立顯示晶片模組,以及最上層的鍵盤與數字鍵盤、觸控板模組。

Framework Laptop 13 Pro、Laptop 16等機種現已上市,價格因選擇的規格而異,有興趣的讀者可以參考官方網站取得更多資訊。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

《Lines of EVANGELION 新世紀福音戰士展:線》登陸台北,體驗動畫師一筆一畫創造AI無法取代的世界觀

《Lines of EVANGELION 新世紀福音戰士展:線》於新光三越台北信義新天地展出,提供超過500件珍貴畫稿、設定資料及動畫製作素材,讓參觀者能夠深入瞭解動畫的製作過程。E41dc9590e890ecfc50267675f359d0e

《Lines of EVANGELION 新世紀福音戰士展:線》於新光三越台北信義新天地展出,提供超過500件珍貴畫稿、設定資料及動畫製作素材,讓參觀者能夠深入瞭解動畫的製作過程。

手繪動畫的堅持

進入21世紀之後,電腦動畫(CG)技術已大幅改變動畫的製作流程,然而這不代表所有的畫面都是由電腦自動產生。仍有許多作品仍是由動畫師透過鉛筆逐幀描繪,賦予角色微妙的表情與感情呈現,搭配細膩的背景,建構出龐大的空想世界。

延伸閱讀:
WirForce 2023活動花絮:根本就是有高橋洋子與貳號機改裝機殼的EVA嘉年華
Asus ROG x Evangelion聯名系列襲來:香爆警戒,開香!
汎用箱型決戰兵器暴走中!MSI《新世紀福音戰士》聯名機殼出擊!
3屆奧斯卡獎得主電腦繪圖資深科學家Jos Stam博士分享,未來電腦繪圖會往哪裡走?

在動畫開始製作之前,創作者會先將重要場景與關鍵鏡頭繪製為概念圖(Image Board),協助與製作團隊建立統一的視察風格與世界觀。然後依劇本與概念圖繪製分鏡稿(一般稱為「絵コンテ」,庵野秀明導演使用「画コンテ」作為正式名稱),並決定每個畫面的構圖、運鏡、長度。接著再由動畫師、導演、作畫監督等人原確認畫面設計(Layout),然後以高度分工的方式,由動畫師負擔角色動作,並由背景與上色等美術人員負責背景、上色等工作,其中背景美術並在現今的製作流程中不局限於傳統手繪,也包含將手繪背景與3DCG結合,或完全以電腦、數位方式等創作方式。

在完成上述前置工作後,動畫師就會以概略的草稿型式繪製呈現角色動作起點、終點、中間重要姿勢的原畫,然後進行清稿(Clean-up),再根據時間表(Timing Sheet)的指示以手繪方式補足2張原畫之間的多張「中間動畫」(日文稱為「動画」)畫面,可想而知一個短短幾秒的鏡頭,需要投入多少時間進行創作,這也是手繪動畫與往往能夠呈現更加深厚情感的秘訣。

《Lines of EVANGELION 新世紀福音戰士展:線》以「線」作為核心,現場展出由Studio khara提供的畫稿、設定資料及動畫製作素材,其中也包括鶴卷和哉、前田真宏、山下育人等核心創作者的重要作品。參觀者可以近距離欣賞真嗣、零、明日香、真理、薰等5位《新世紀福音戰士》劇中駕駛員的輪廓,以及EVA機體、使徒、背景等設定資料,深入體驗本作獨特的世界觀。

筆者將部分展場內容以圖文方式呈現於下。

▲《福音戰士新劇場版》由4部電影構成,沒看過的人不需要懂劇情,反正看過的人也看不懂劇情,我們只要好好享受短片中描繪的場景、角色,以及由歌手宇多田光所演唱的主題曲《Beautiful World》。

首先進入展場可以看到圍繞在真嗣、零、明日香、真理、薰等5位駕駛員的原畫。

往後走可以進入5個不同角色的小房間。

從原畫可以看出身為「公主」形象的明日香細膩的表情、眼神,詮釋角色的性格。

從逐幀中間動畫可以看到角色的連續動作、表情變化。

挑選其中4格,可以看到左方編號A3、A4與右方編號A6、A7的前後連續畫面。

《福音戰士新劇場版》登場的新角色真理也十分具有魅力,豐富的表情是她的一大特色。

帶有濃厚神秘感的薰也是討論度很高的角色,他的一眸一笑都充滿戲劇張力。

不讓主角出現好像也怪怪的。真嗣拿你沒辦法,只好也分享一下你的原畫囉。

展場內也準備了2組大型抽屜燈箱,打開後就能看到好康的!

比方說打開後能看到出自《福音戰士新劇場版:終》的「大人明日香」,香!

印於彩色壓克力上的角色圖案與光影、空間構築出奇幻的視覺感。

壓克力板上的圖案與牆面的影子相互共鳴。

EVA機體的設定稿也是展覽的一大看點,可以看到許多細節。

展場的「Harmony」區域播放真嗣、薰四手聯彈的鋼琴曲目=3EM16=。

牆上也掛著佇立於廢墟鋼琴的場景設定稿。

參觀者能夠一面聆聽鋼琴演奏,一面欣賞彈奏的分鏡。

可以看到每張畫面的細節都相當講究,還原彈奏琴鍵的動態。

打卡、紀念品滿載而歸

展場末端提供3種主題打卡拍照區,參觀者能夠與5位駕駛員的肖像、大型「初號機」模型等展品合照,台北站還帶來獨家的「懷舊阿嬤家」限定拍照區,融合磨石子地板、復古家具與多種生活小物等元素,配合門外的101大樓,打造獨特的台灣意象。

此外展場外也設有紀念品販售區,並提供多種展覽限定周邊產品。

展場末端提供打卡拍照區,能夠與5位駕駛員的肖像合影

後方也有大型「初號機」模型拍照區。

最特別的是台北限定「懷舊阿嬤家」拍照區,除了有5位駕駛員的人型立牌,還有充滿台灣意象的佈景主題。

紀念品區也提供許多以「線」為主題以及展覽限定的周邊產品。

「線」周邊以展覽主視覺擴展至多種不同產品。

「懷舊阿嬤家」相關周邊產品當然也不能少。

AI無法生成的情感

筆者看完展覽最大的感想,就是由動畫師手繪呈現厚重的真實感,無論是詮釋角色的性格與情緒,或是在背景透露的故事細節與世界觀,都具有無法取代的魅力。

筆者也想起多年前與3度獲得奧斯卡科技成就獎的NVIDIA電腦繪圖資深科學家Jos Stam博士訪談時,他提到自己認為AI就像個黑盒子,雖然我們不知道它如何運作,但是它卻實能夠發揮功效,AI的演算法設計參考了人類的思考模式,人類的智慧是將神經訊號收束在一起,AI則是將數位資料收束而成。

爬梳他的演講與訪談脈絡,他闡明就像人類不需理解腦部運作原理,仍然能夠思考,反過來說一般使用者就算不知道AI的原理,仍然可以運用AI來提高自己的生產力。此外AI也只是將數位資料收束而成,至少在現階段的主要功能為「重新組合現有資料」,對於想像、創意等創造全新事物的能力仍相當有限。

而筆者自己使用AI圖像生成的心得,感覺生成的圖像雖然乍看之下可能不容易查覺錯誤,但仔細看仍可發現許多破綻。例如早期容易出錯的手指數目,以及現階段仍不易克服的機械、建築細節錯誤,或是電腦線路不符合實際狀況等科技宅宅才會去注意的小地方。

另一方面,在生成圖像的過程中,AI系統也往往會加入一些無意義的小細節,比方說場景桌面上的小東西,或是角色衣服上的圖案與文字,而這些細節並不一定帶有「創作者」想要傳達的意含。(更何況要將創作者定義為電腦,還是操作電腦的人?)

但反過來看,無論是動畫或真人電影中,許多這類的小細節往往承載劇情中的重要資訊,也可能是暗藏在畫面角落的隱語,輕輕訴說導演不願明講,希望觀眾自行挖掘、與自己的人生體驗共鳴之後,與導演產生跨越時間、空間的對話,這種交流正是機器無法取代,身為人類應該自豪的情感。

從桌上一隅及無線電的細節可以看出動畫師近乎吹毛求疵的態度。

電線桿上的線路與設備描繪得相當逼真。

街景部分帶著實際生活的氛圍感受。

都市的每一棟大樓也都是這樣一筆一畫勾勒出來,細節程度堪稱強迫症(褒揚意味)。

《Lines of EVANGELION 新世紀福音戰士展:線》展覽於2026年8月14日至10月04日在新光三越台北信義新天地A9 9樓宴會展演館舉辦,需要注意的是週一至週四、週日的最後入場時間為18:30,週五、週六及國定假日則為19:30。更多售票與周邊產品資訊請參考展覽官方FacebookInstagram

加入T客邦Facebook粉絲團
✇T客邦-Techbang

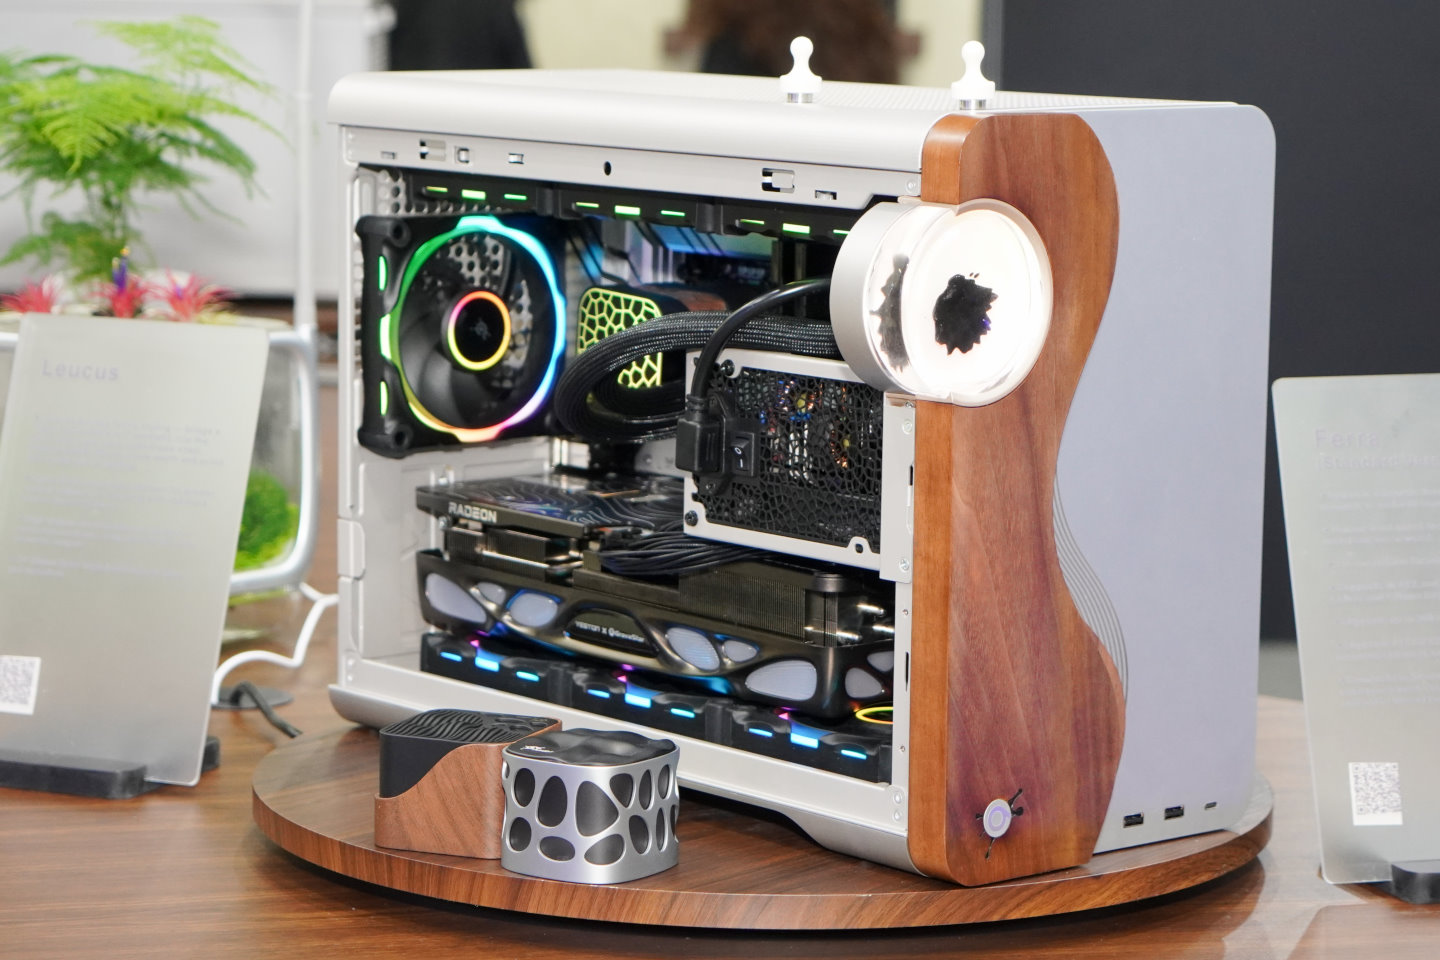
AMiiba推出磁流體裝飾機殼與水冷,讓機殼上的阿米巴原蟲隨音樂起舞

電腦周邊廠商Sama旗下的AMiiba品牌在Computex台北國際電腦展2026展示搭載磁流體裝置的Ferra機殼與Proteus一體式水冷散热器,帶來截然不同的趣味視覺體驗。4de2c49eaca82db3da414efc1abf143f


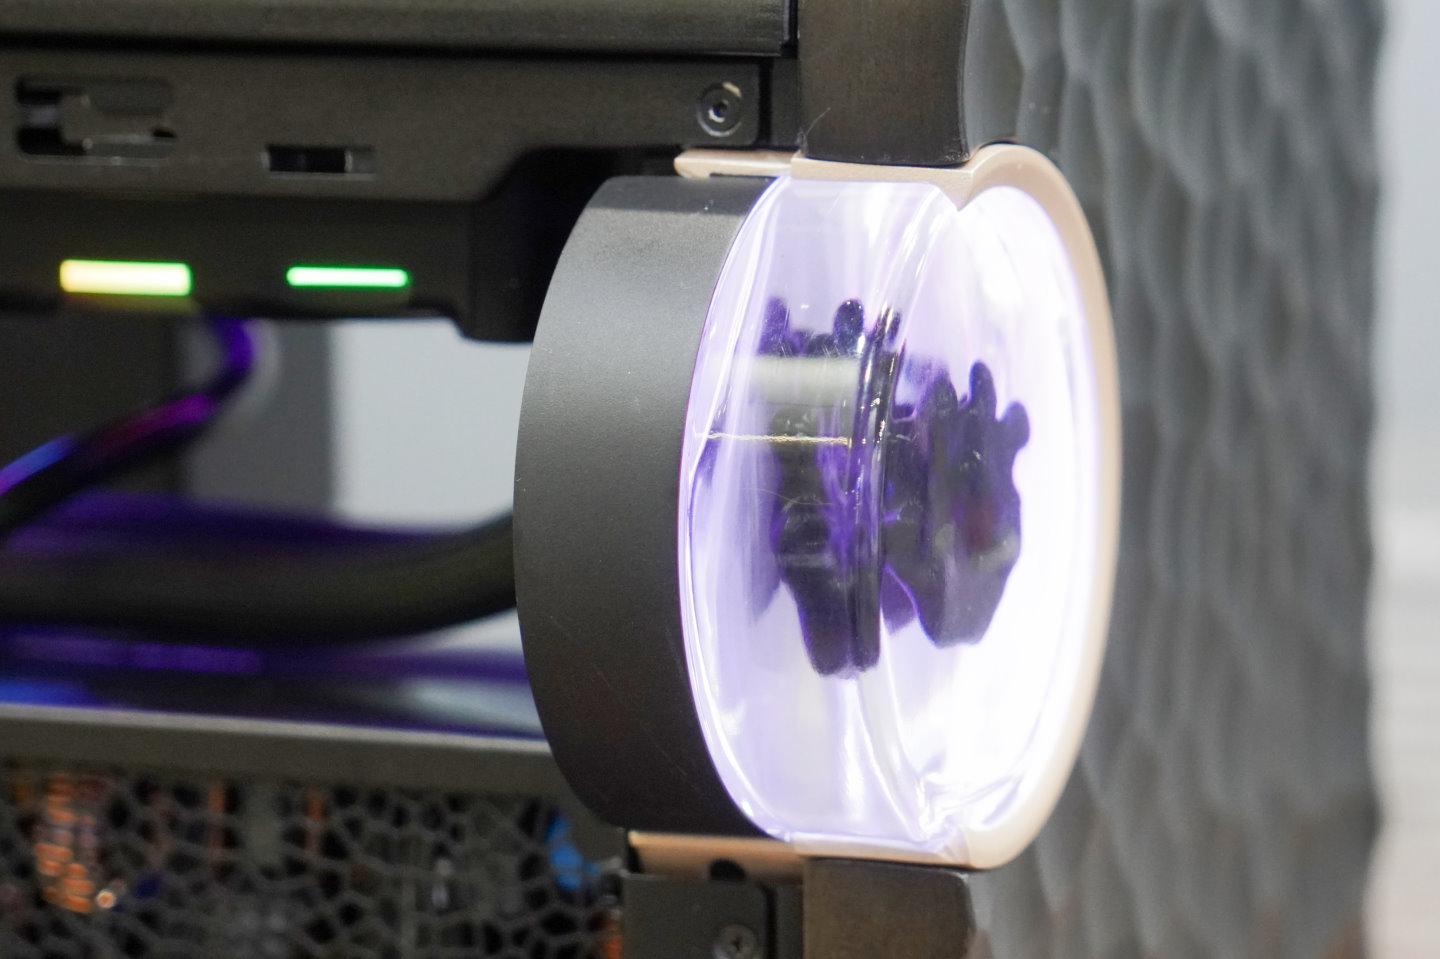
AMiiba推出的Ferra機殼與Proteus一體式水冷散热器搭載獨特的磁流體裝置,它的構造為在充滿液體的展示艙內注入調合煤油與鐵粉的磁流體,並透過電磁鐵控制磁流體,便能讓它做出隨著音樂舞動的效果,看起來相當有趣,並帶來帶有一絲科幻感的視覺體驗。

延伸閱讀:
專業水冷大廠Asetek CEO專訪:專利過期也不怕你抄!你有影印機,我有工程師
山也無線、海也無線!Asus 活用背插技術打造「無線水冷」
技嘉概念主機板 X870E AORUS Infinity Next :超狂 64 相供電、3D 列印金屬散熱片解熱高達 100W

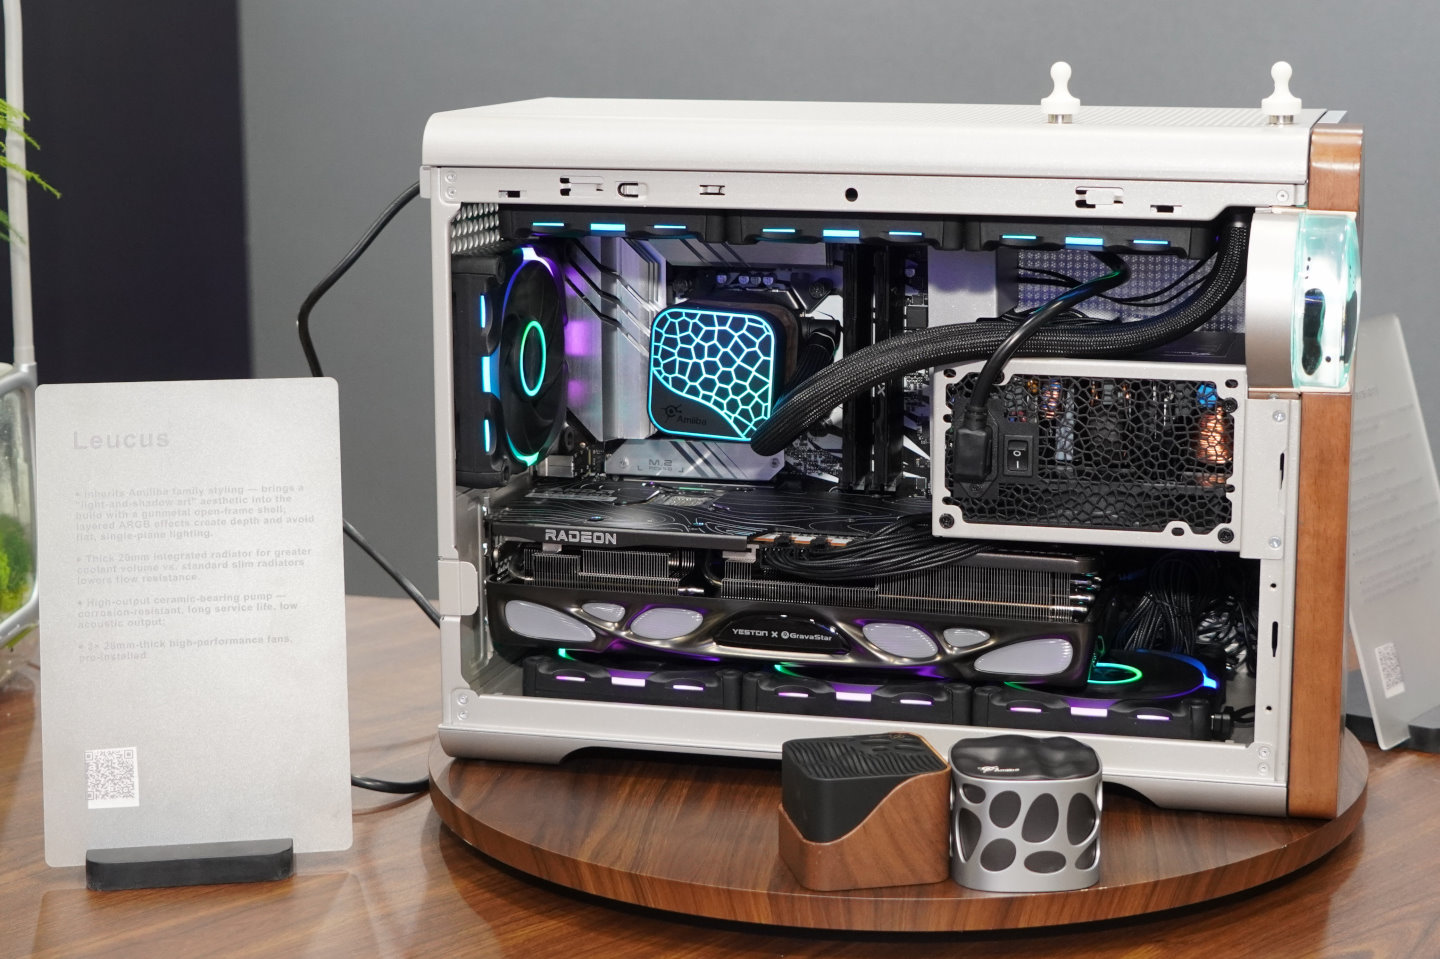
Ferra為Micro ATX尺寸機殼,體積為31 L,磁吸式前面板提供胡桃木搭配氛圍燈以及黑色實木等2種選擇,支援41.8 CM顯示卡、360水冷排等周邊裝置,並可安裝7組12 CM風扇,帶來理想的散熱效果。

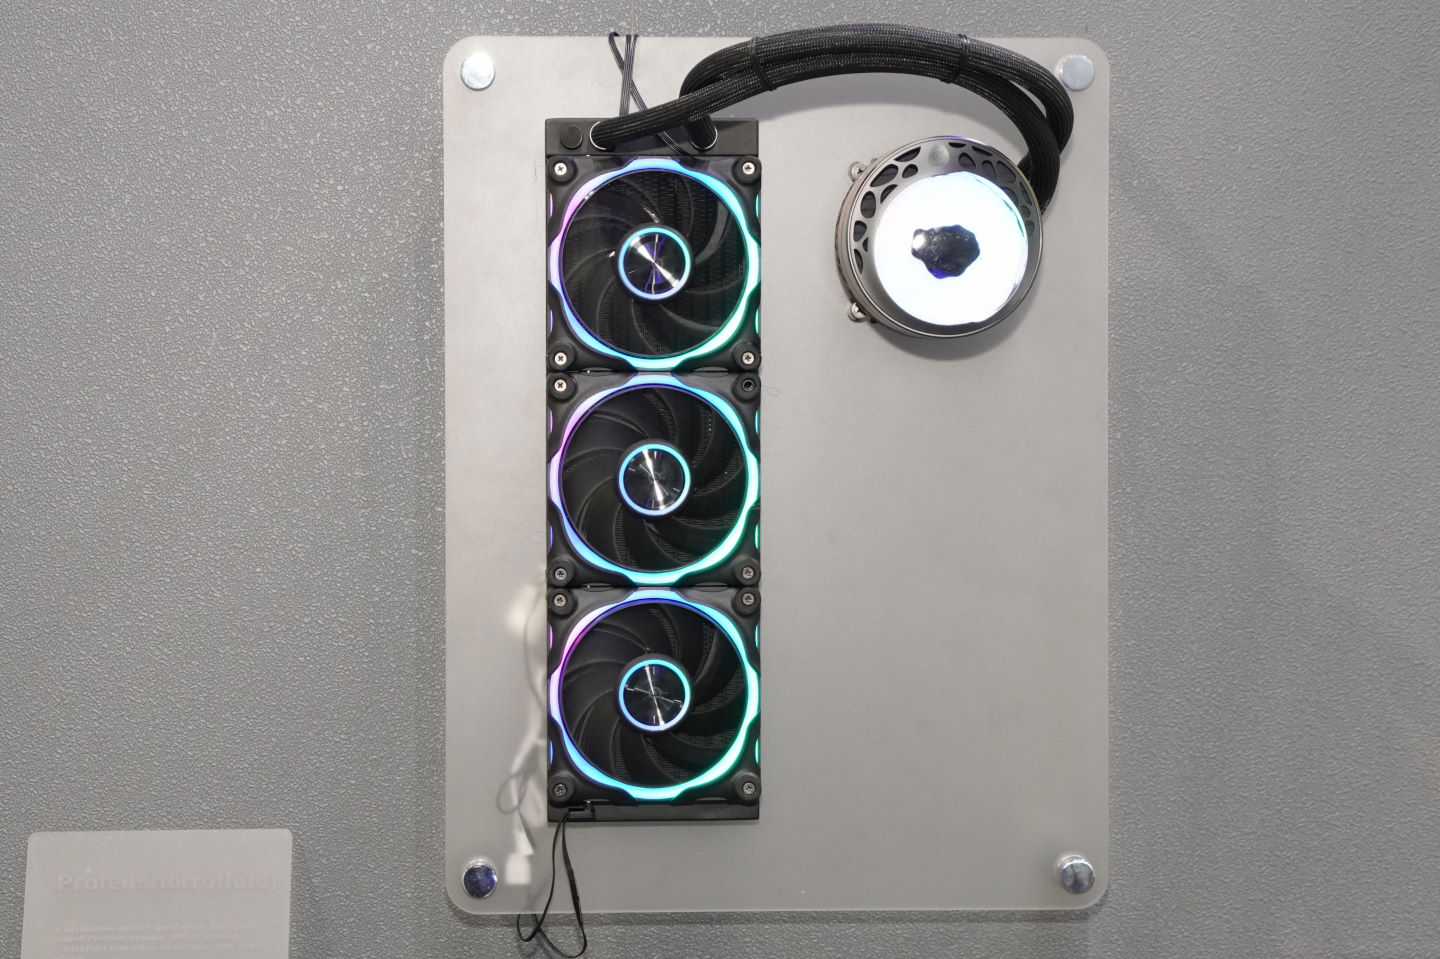
Proteus為搭載3組12 CM風扇的360一體式水冷散熱器,其磁流體裝置與ARGB燈光都可以隨音樂的節奏舞動,帶來更具特色的視覺體驗。

Ferra機殼的特色為採用便於更換的磁吸式前面板,並搭載磁流體裝置。

Ferra支援Micro ATX尺寸主機板與41.8 CM顯示卡。圖中搭配的一體式水冷散熱器為Leuceus。

磁流體為煤油與鐵粉的調合物,可以飄浮在水中,並由電磁鐵控制其運動。

▲磁流體可以在展示艙內隨音樂舞動,看起來相當酷炫。

Proteus為搭載磁流體裝置的360一體式水冷散熱器,水冷頭的金屬骨架也相當有設計感。

▲Proteus水冷頭上的磁流體也會隨音樂起舞。

AMiiba利用磁流體裝置為機殼與水冷散熱器帶來嶄新的視覺效果,本體的造型設計也相當具有質感,提供電腦玩家更多不同的外觀風格選擇。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

Biwin秀出旗下BL130、CL100 Mini SSD固態硬碟,迷你尺寸速度衝破3700 MB/s

Biwin在Computex台北國際電腦展2026展示自家制定的Mini SSD規格迷你固態硬碟,它的尺寸與microSD記憶卡接近,可提供2TB容量與約3700 MB/s的傳輸速度。474f88089a4457fec385706f22b3c354

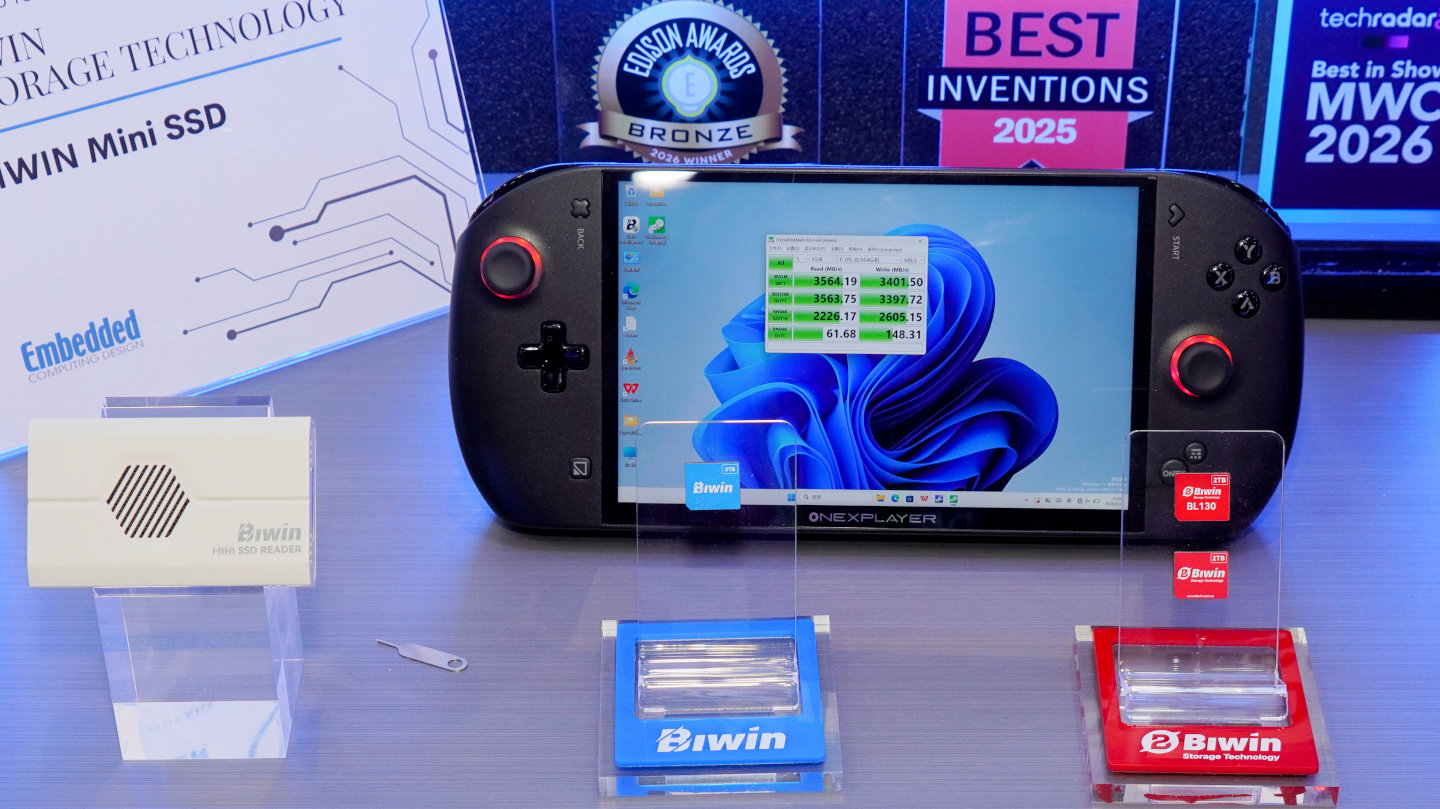
Biwin展示自家制定的Mini SSD規格迷你固態硬碟,它的尺寸與microSD記憶卡接近,可提供2TB容量與約3700 MB/s的傳輸速度。

迷你電腦客製化利器

近年與Asus ROG Ally與MSI Claw類似的掌上型遊戲電腦產品越來越豐富,它們雖然大多能夠透過microSD或microSD Express記憶卡擴充儲存容量,但是即便是效能較高的後者,傳輸速度以僅落在約900 MB/s左右,與內接的固態硬碟有段落差。

延伸閱讀:
中國 Biwin 推出僅 SIM 卡大小的 Mini SSD,以三倍速效能挑戰 microSD 市場
SMI發表SM2524XT固態硬碟控制器,平價、省電、效能一樣頂到天!

SMI SM2508固態硬碟控制器效能實測:速度飆破14 GB/s、溫度壓制58度

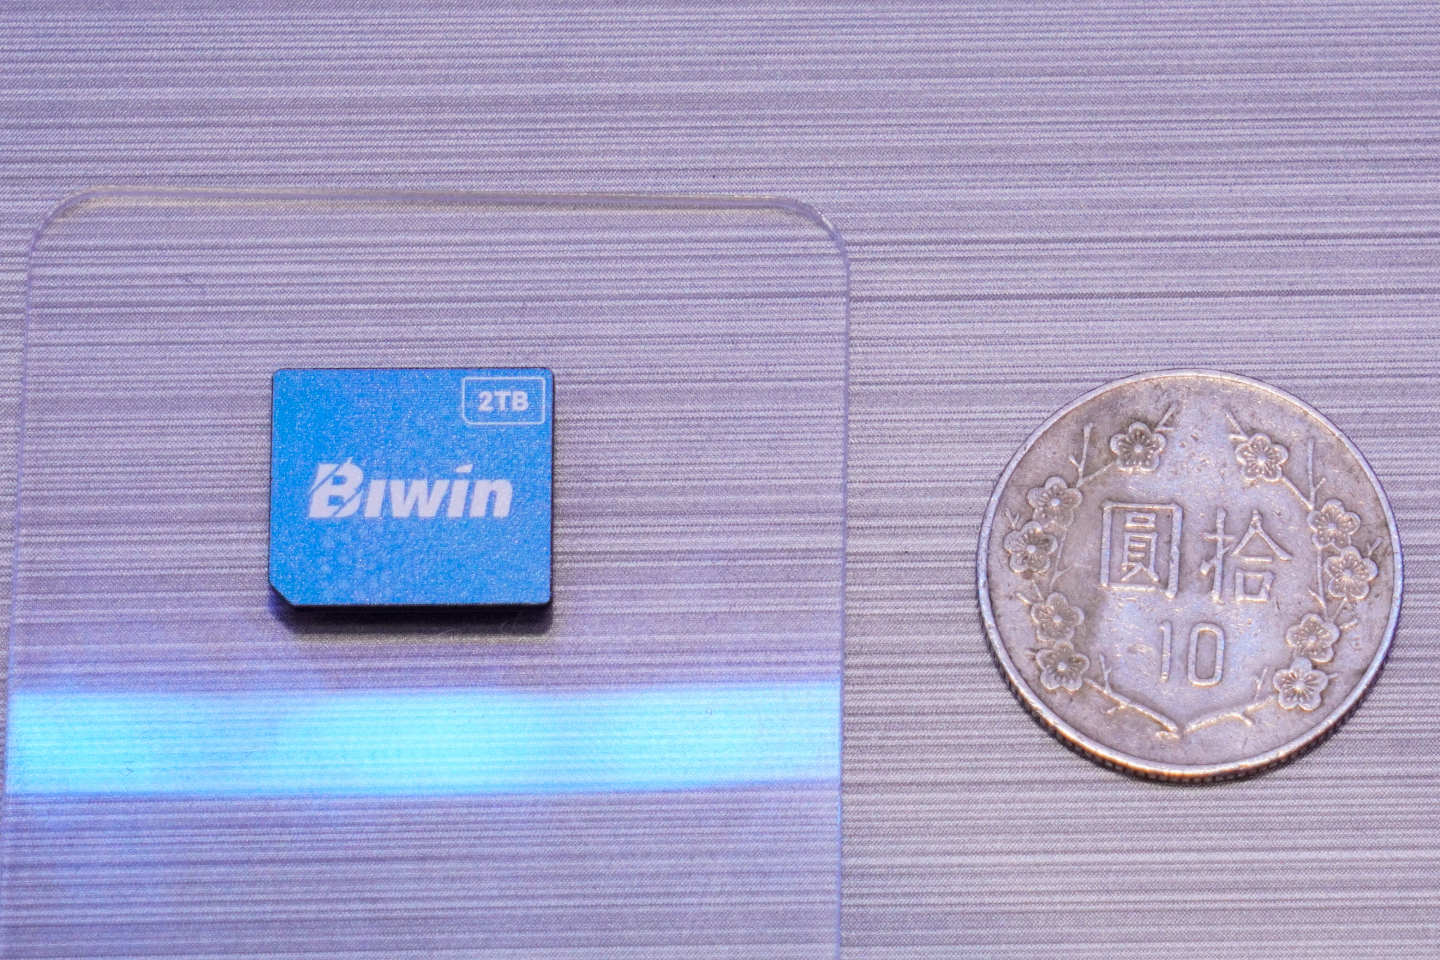
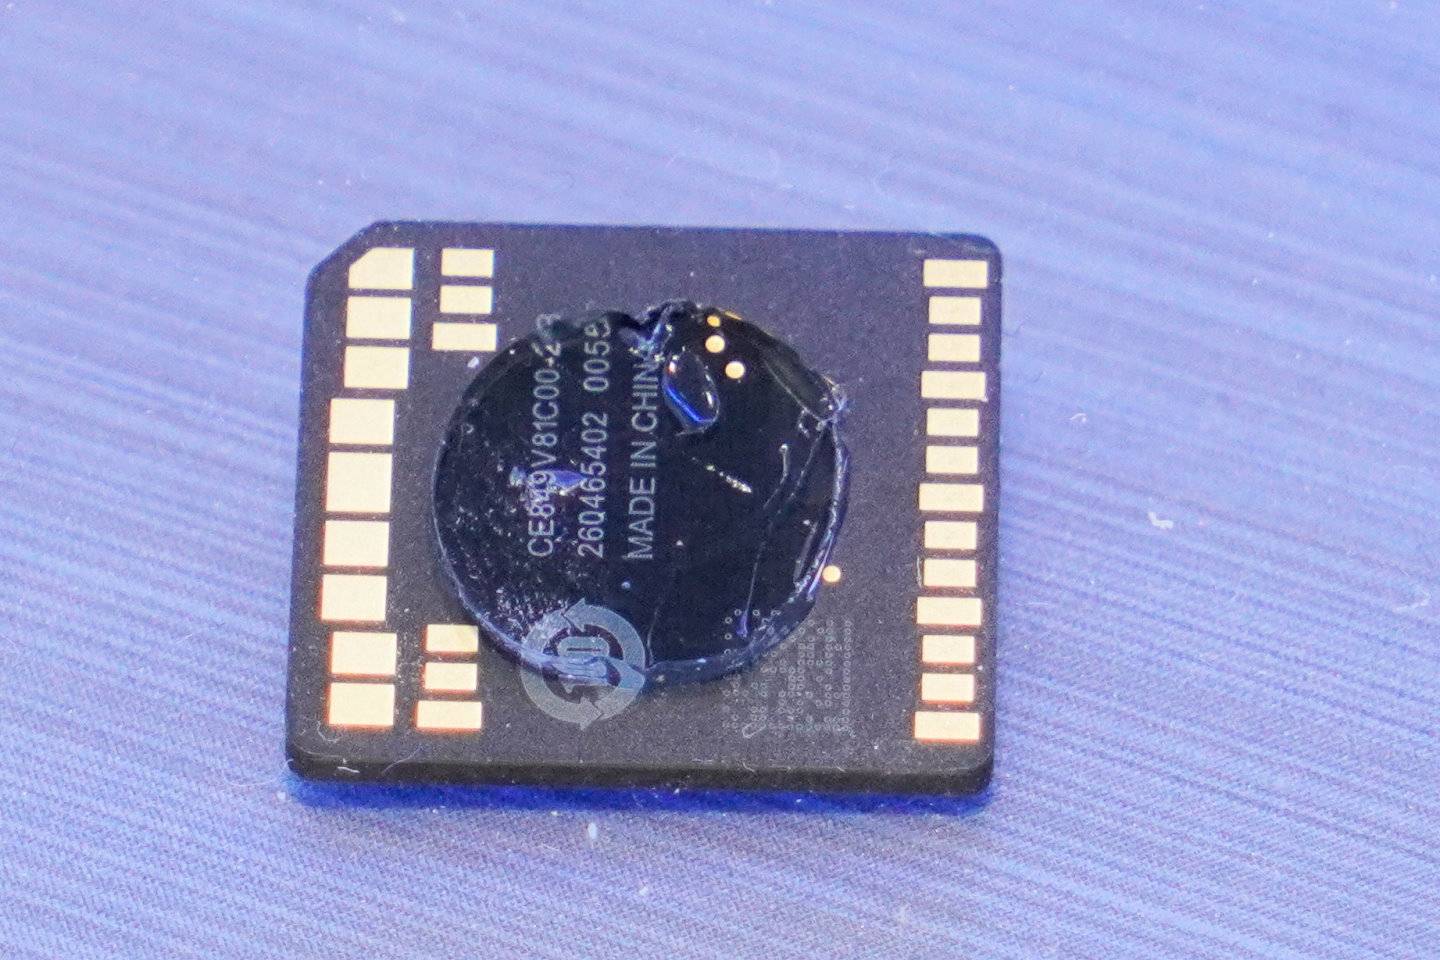
推出的Mini SSD的尺寸為15 x 17 x 1.4 mm,大約與microSD記憶卡接近,它採用Hybrid BGA封裝,安裝方式採用與實體SIM將同的「卡槽式」設計,支援PCIe Gen 4x2匯流排與NVMe 1.4通訊協定,基本上可以視為將常見的M.2 2280尺寸固態硬碟縮小至microSD記憶卡的尺寸,並可提供接近4000 MB/s的理論頻寬。

Biwin在會場展示的BL130、CL100 Mini SSD固態硬碟讀寫速度分別可達

3700 MB/s,相較於microSD常見的100~150 MB/s快上不少,能夠為帶來更快的遊戲載入速度。此外Biwin CL100還通過IP68等級防塵防水認證,可承受最高達3公尺的跌落衝擊,具有更高的耐用度。

Biwin展示BL130、CL100 Mini SSD固態硬碟,在掌上型電腦的效能實測跑出3564.19 MB/s、3401.5 MB/s的連續讀、寫效能。

Mini SSD固態硬碟的尺寸相當小巧,大約只有10元銅板的一半。

Mini SSD採用LGA封裝,內部整合控制器與NAND顆粒。

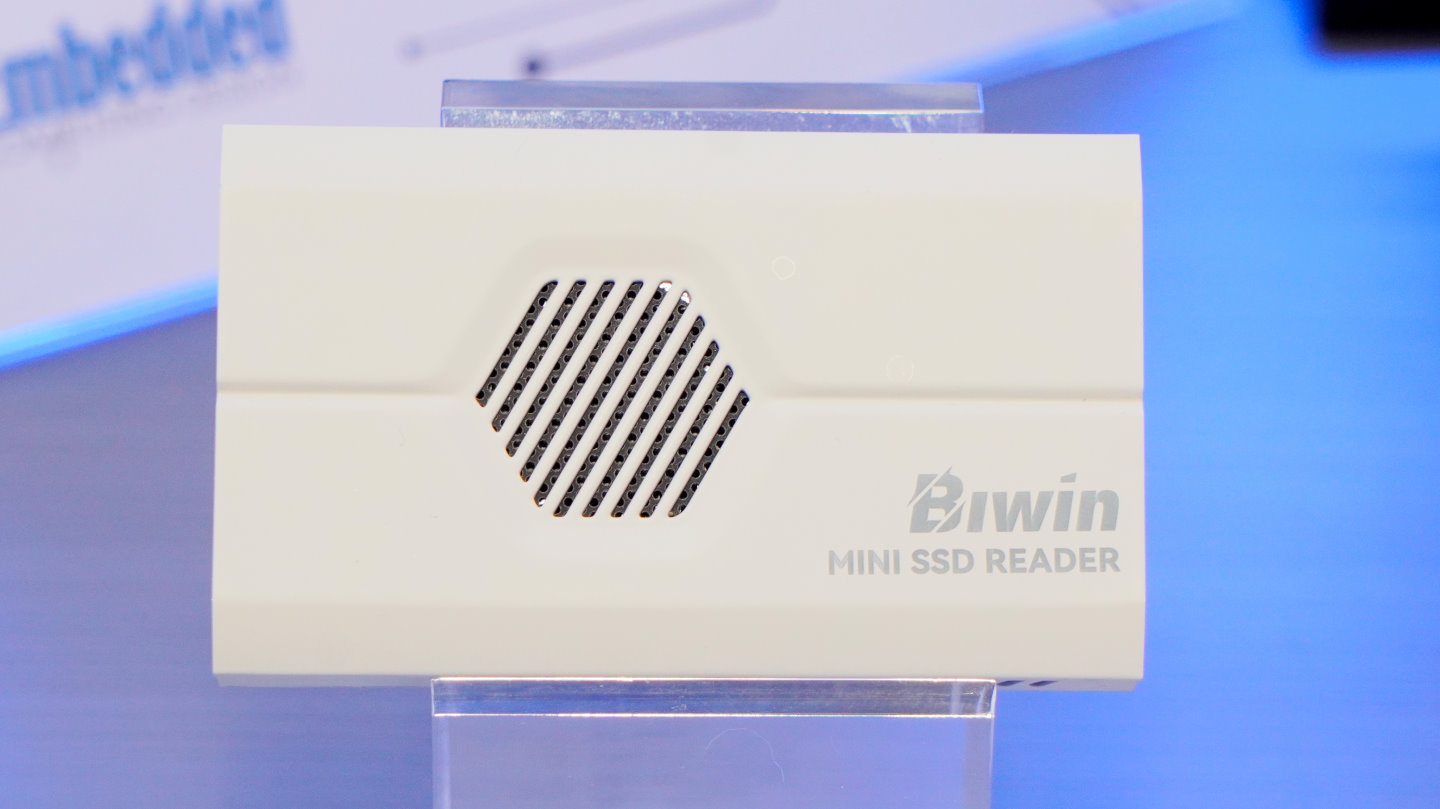
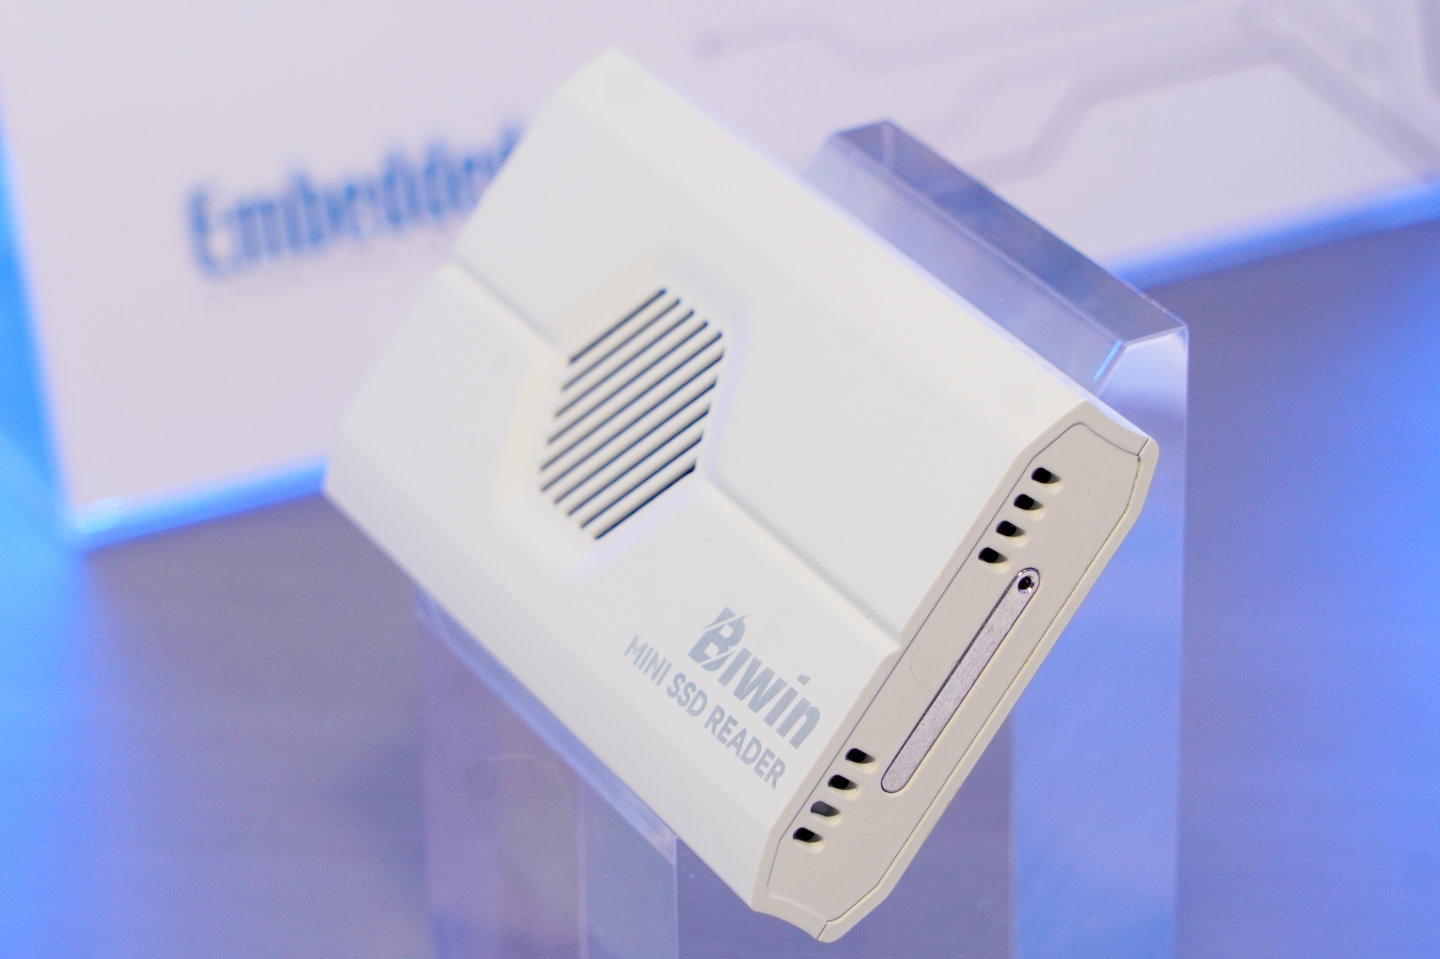
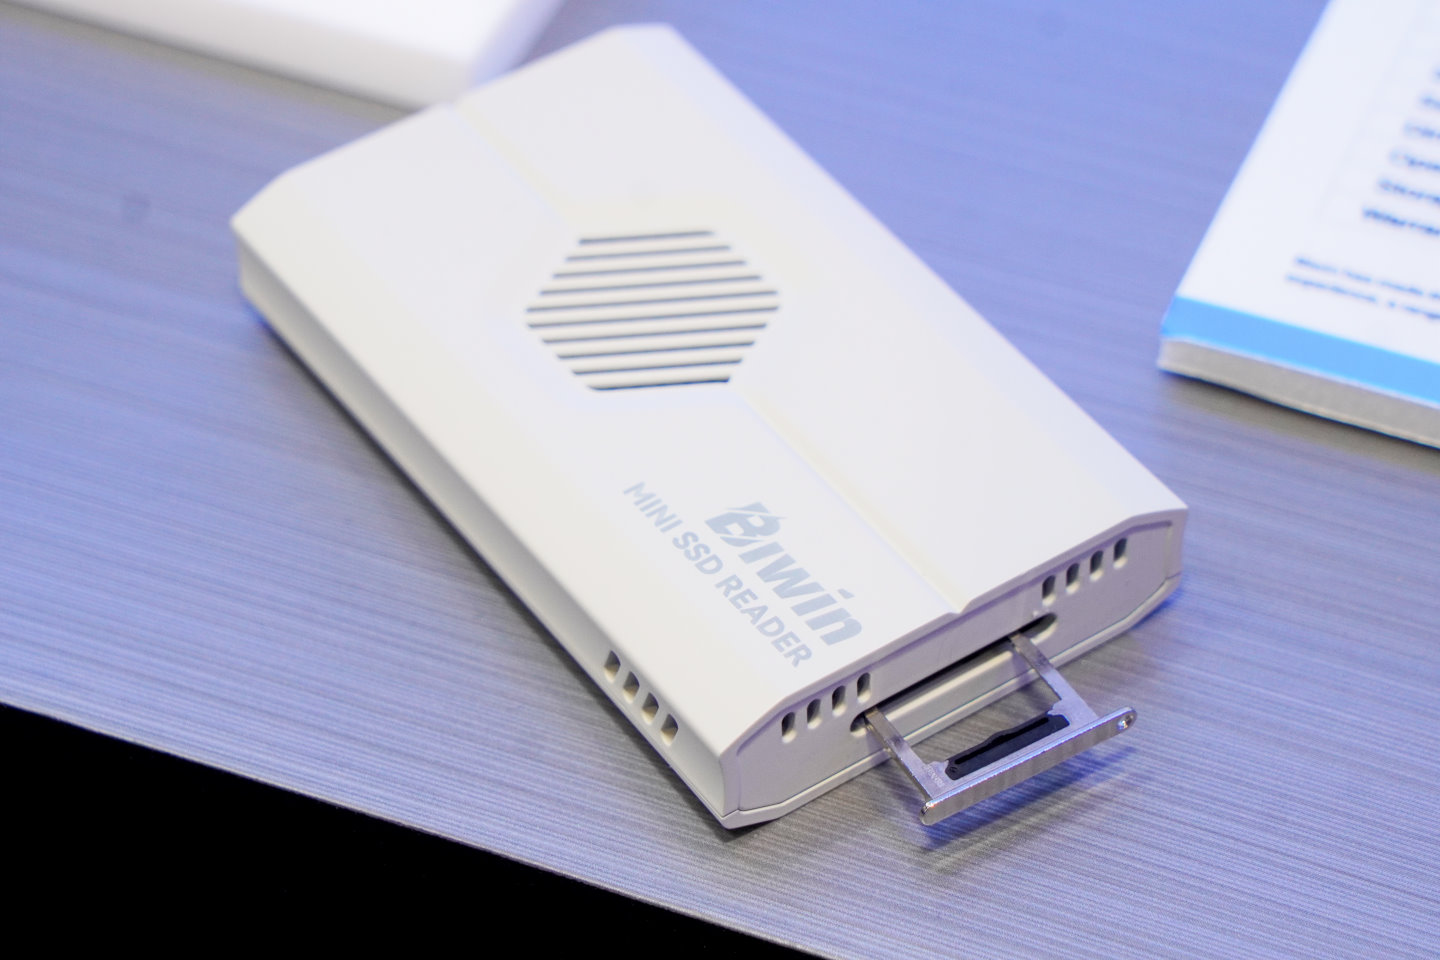
Biwin也推出Mini SSD專用的讀卡機,它採用USB Type-C介面,尺寸有如外接固態硬碟。

使用者可以利用SIM卡的退片針取出專用的卡槽托盤。

取出托盤後,可以像安裝SIM卡般將Mini SSD裝入電腦或讀卡機。

Mini SSD最大的優勢是能在小巧的尺寸提供512 GB ~ 2 TB的充沛儲存容量,以及相對優秀的傳輸速度,且具有容易安裝的特色,相當適合應用於迷你電腦、掌上型電腦等裝置。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

Wooting Knobs旋鈕預計9月上市,現有鍵盤無痛升級可絕對定位多功能旋鈕

以類比鍵盤聞名的Wooting在Computex台北國際電腦展2026展出可搭配自家鍵盤的Knobs旋鈕,使用者可以拆下現有鍵盤的按鍵並裝上Knobs,就可使用旋鈕的旋轉、絕對位置、按鍵等多種功能。E2004bf677df3ceee7540611542161da

以類比鍵盤聞名的Wooting在Computex台北國際電腦展2026展出可搭配自家鍵盤的Knobs旋鈕,使用者可以拆下現有鍵盤的按鍵並裝上Knobs,就可使用旋鈕的旋轉、絕對位置、按鍵等多種功能。

80HE無痛升級

Wooting於去年就台北國際電腦展就曾展出Knobs旋鈕,今年則是公布更多詳細功能,並於攤位上動態展示搭配Wootility專屬軟體進行多種功能設定,其最大的特色就是能搭配現有鍵盤使用,並且具有絕對位置定位功能。

延伸閱讀:
Wooting展示60HE v2類比鍵盤,現有鍵盤也可搭配旋鈕套件
Wooting 推出 60HE v2 類比鍵盤,12 月 4 日前還可搶購創始限定版
Wooting推出8,000 Hz輪詢率80HE類比鍵盤,超低延遲還有特異功能

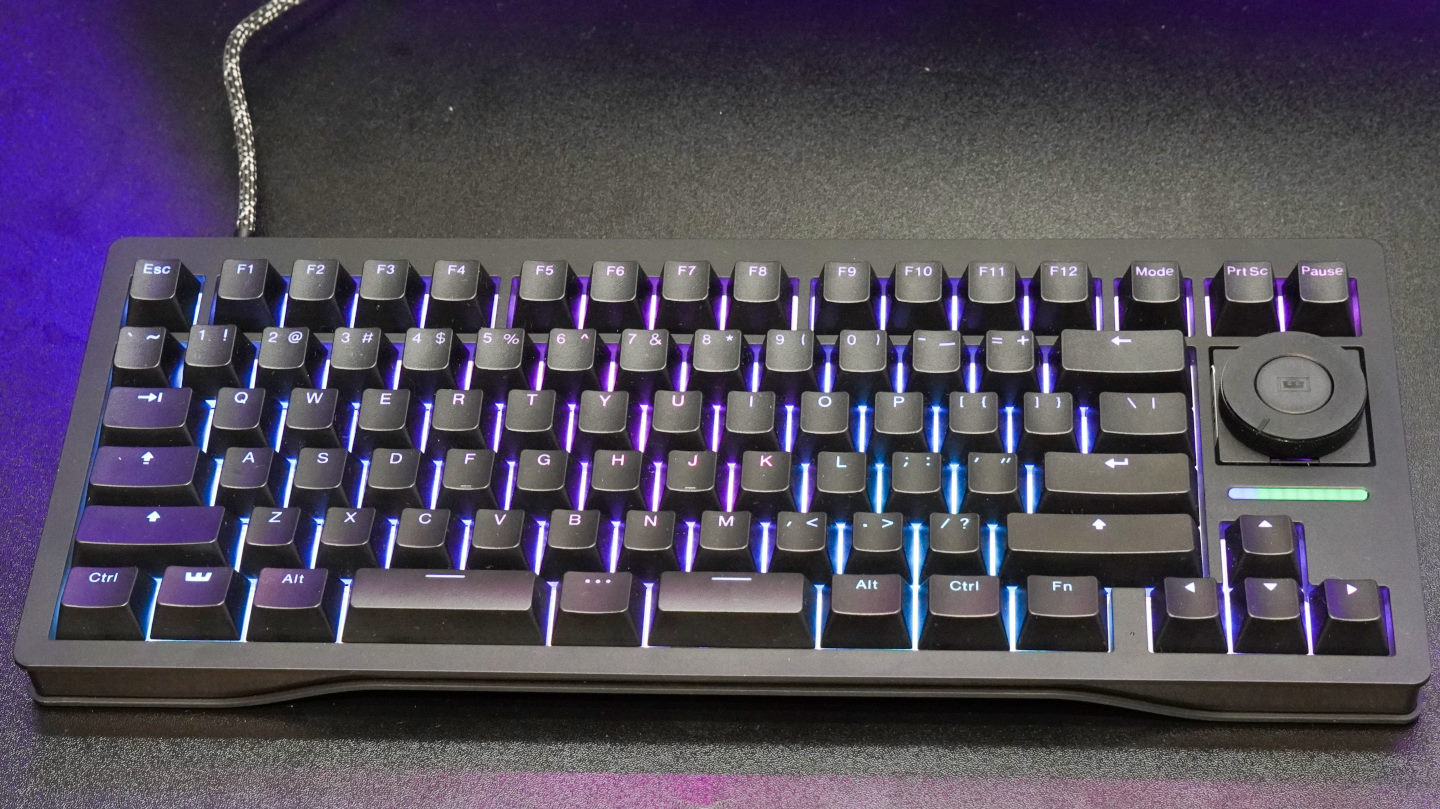
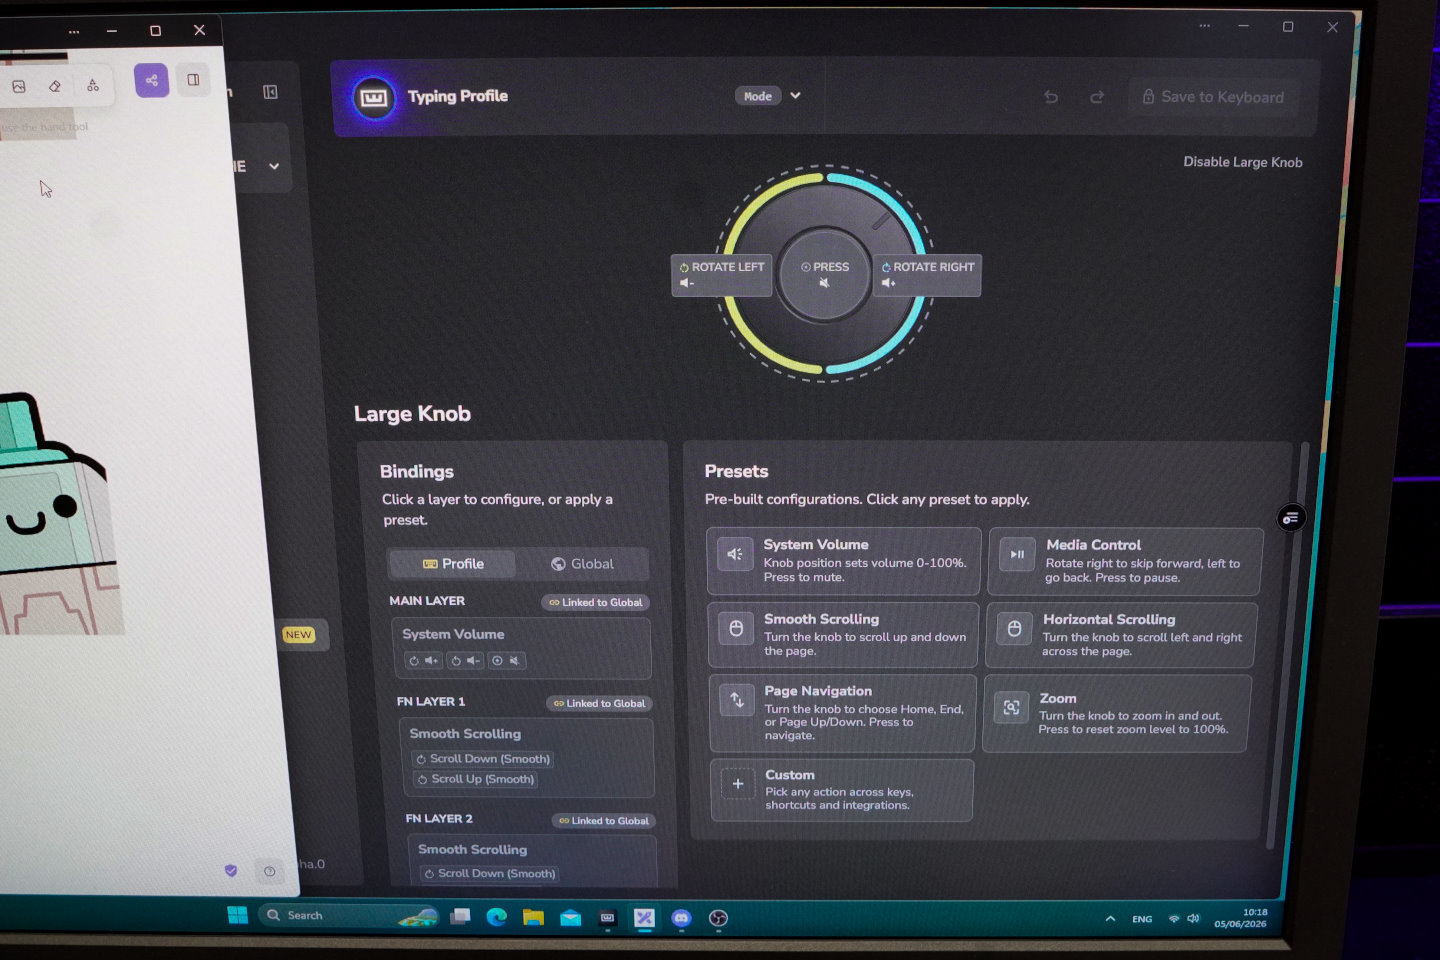
使用者可以將Wooting 80HE等鍵盤導航鍵區的Ins、Del、Pg Up、Pg Dn等按鍵拆下,並更換為Knobs旋鈕,之後就可以利用Wootility專屬軟體設定各種功能。

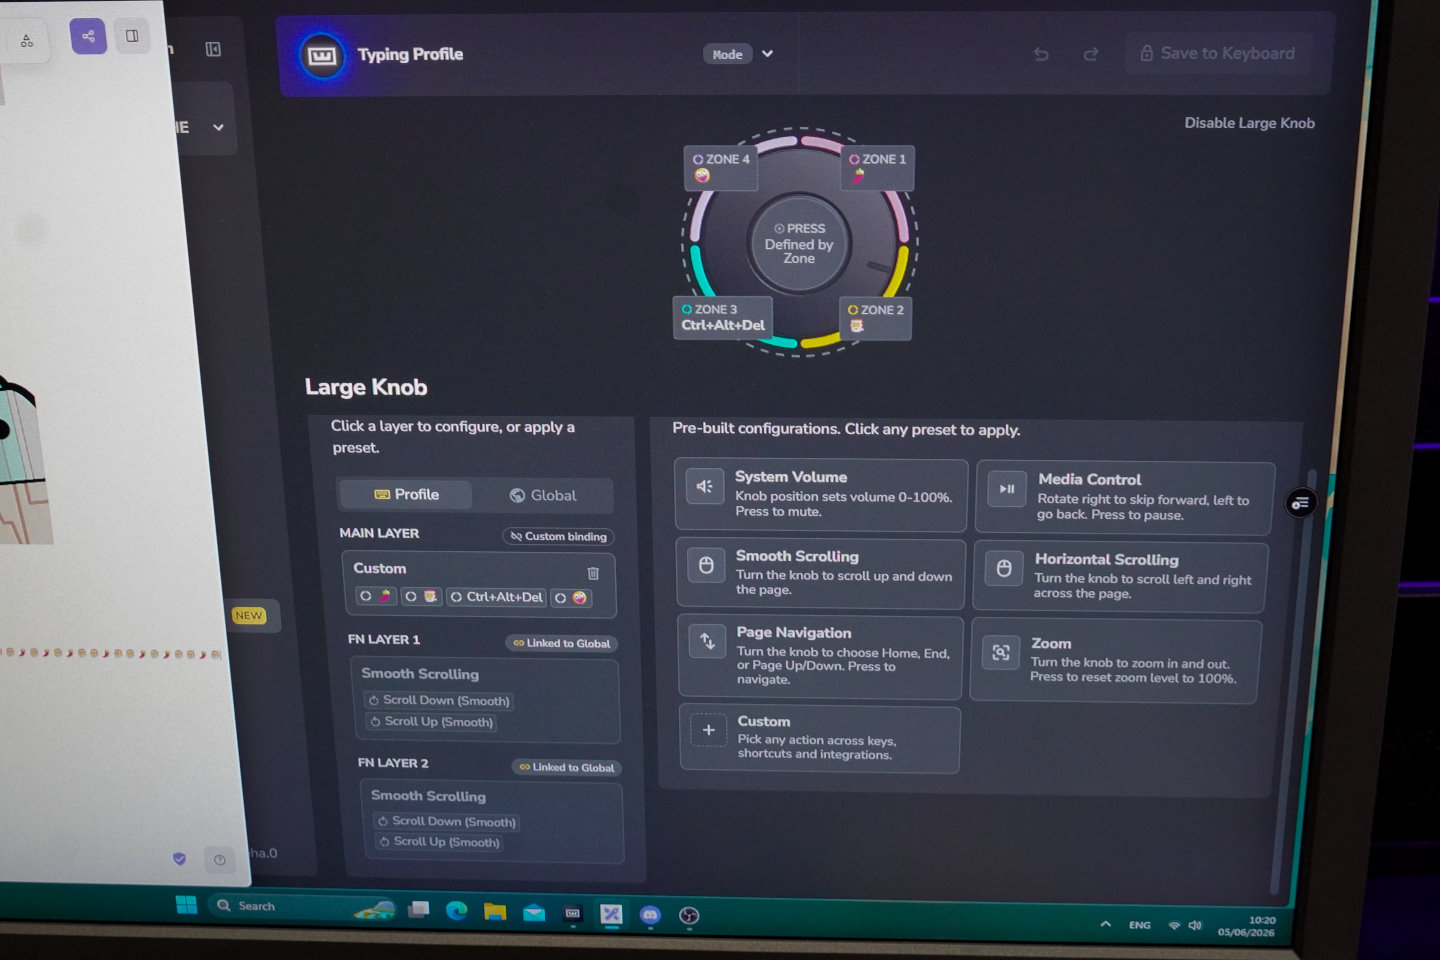
Knobs旋鈕除了具有基本的順、逆時鐘旋轉相對位置感應與按鍵功能之外,比較特別的是它還能感應旋鈕的絕對位置(即旋鈕上「指針」指向的方向),提供更多元使用功能。舉例來說基本的相對位置感應能夠設定為透過旋轉控制系統音量、圖片縮放等,而絕對位置感應則能設定為指針指向不同區域時搭配按鍵開啟程式、輸入字串、巨集等功能。

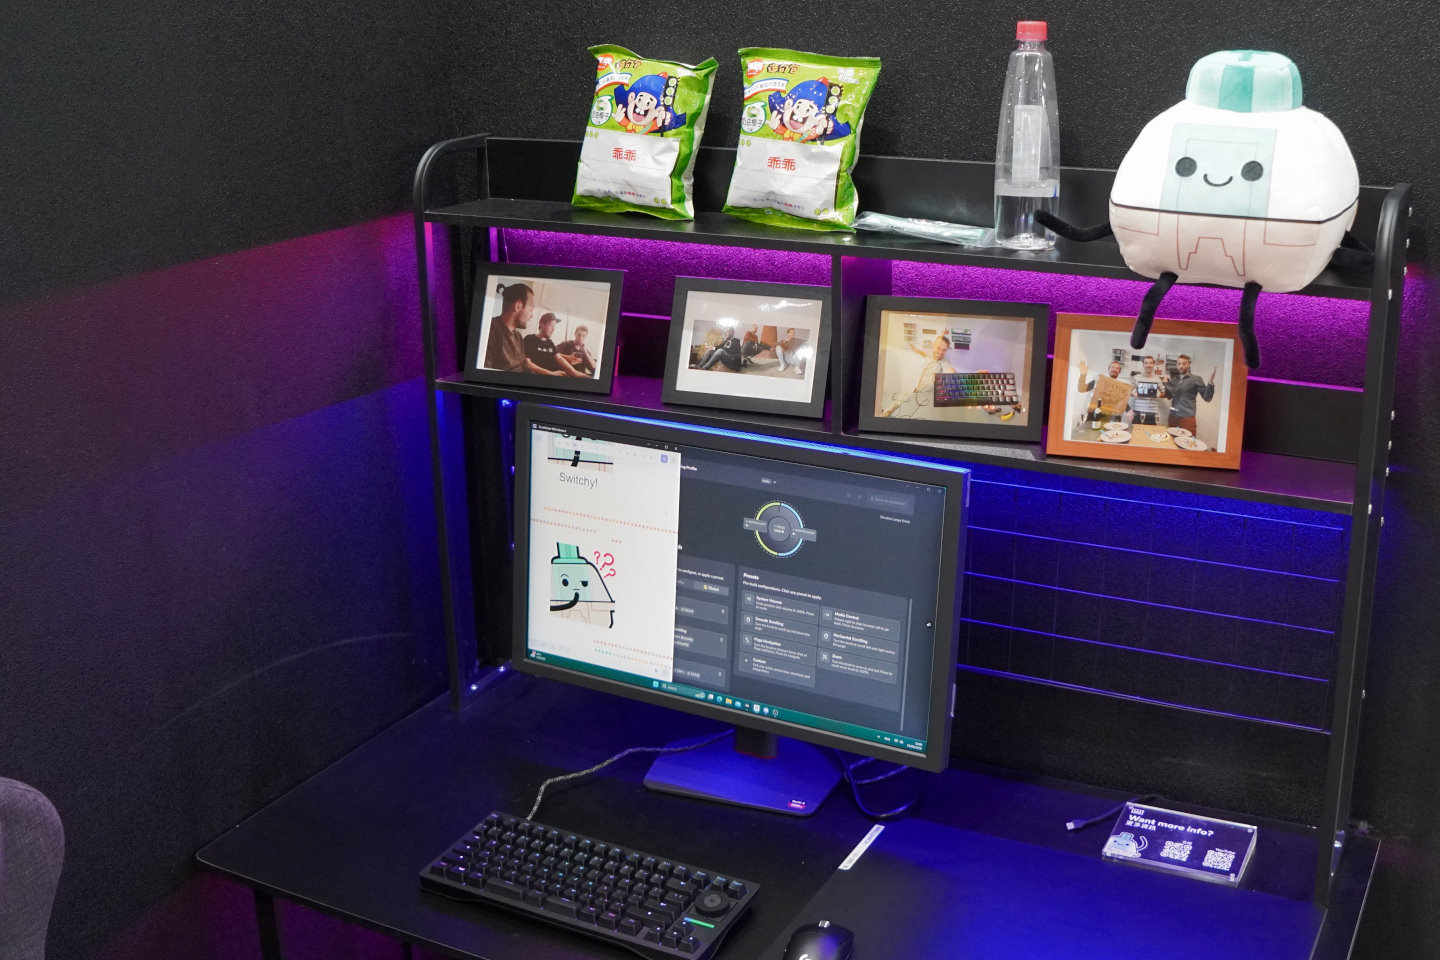
Wooting在Computex台北國際電腦展2026攤位以電競遊戲房的情境,展示最新Knobs旋鈕。

Knobs旋鈕可以直接安裝於現有鍵盤上,圖為搭配Wooting 80HE並將Ins、Del、Pg Up、Pg Dn等按鍵替換為旋鈕。

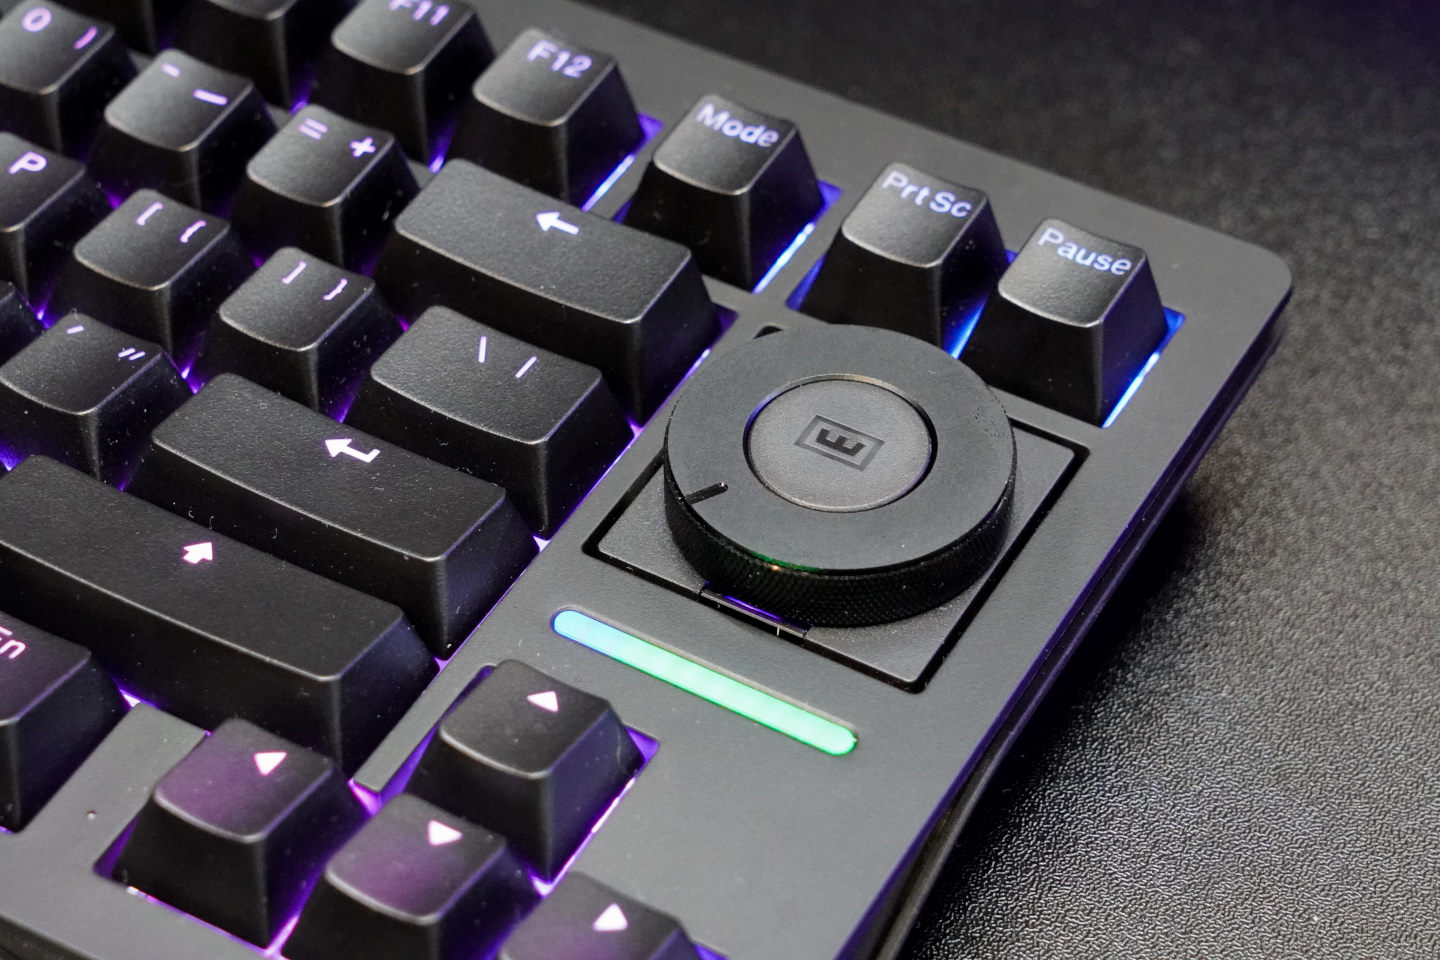
Knobs本體的外圈為旋鈕,並附有能夠顯示絕對位置的指針,中央則為實體按鍵。

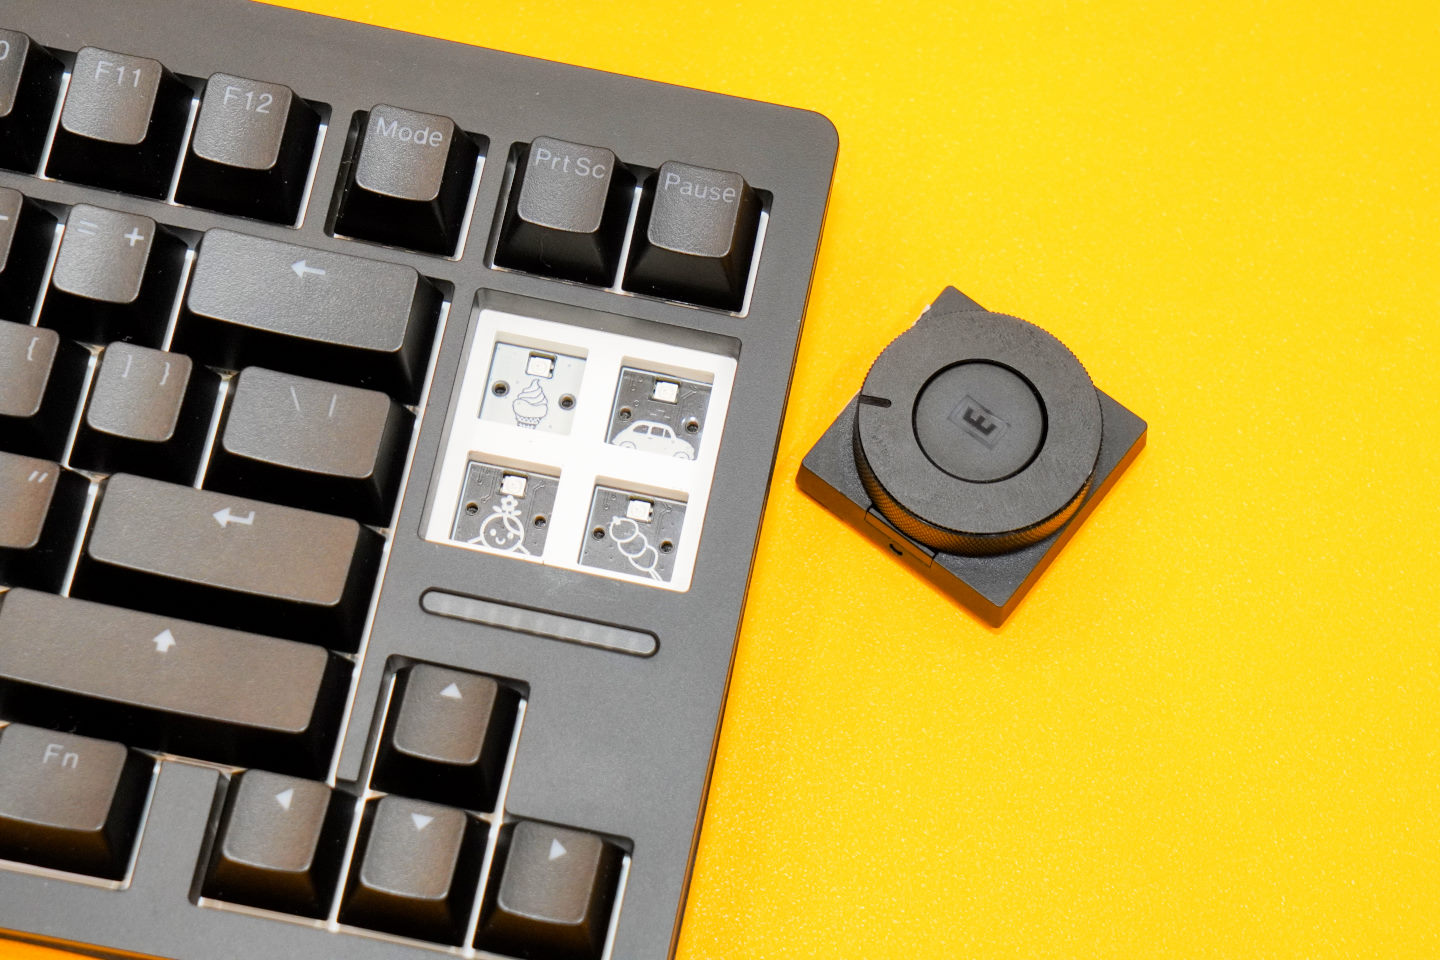
使用者只需將鍵盤上原本的按鍵拆下,並直接裝入Knobs旋鈕即可使用。

Knobs旋鈕可以進行相對位置操作,利如順、逆時鐘旋轉控制系統音量,按下按鍵則為靜音。

在絕對位置操作模式下,可以在指針指向4個不同分區時,按下按鍵執行不同快捷鍵巨集以及貼上顏文字等功能。

Knobs旋鈕原本預計於2026年第1季上市,但Wooting在這次電腦展宣布將延期到9月才會推出,屆時使用者就能搭配現有鍵盤享受便利的旋鈕功能。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

j5Create推出高質感模組化螢幕桌,融入木紋、磁吸元素兼顧美觀與實用

j5Create在Computex台北國際電腦展2026不但展出許多USB、Thunderbolt相關周邊商品,也帶來全新的模組化螢幕桌。5cc2e0765fbd32bbdb76c221b08dd88b

j5Create在Computex台北國際電腦展2026不但展出許多USB、Thunderbolt相關周邊商品,也帶來全新的模組化螢幕桌。

螢幕桌也可自行改裝

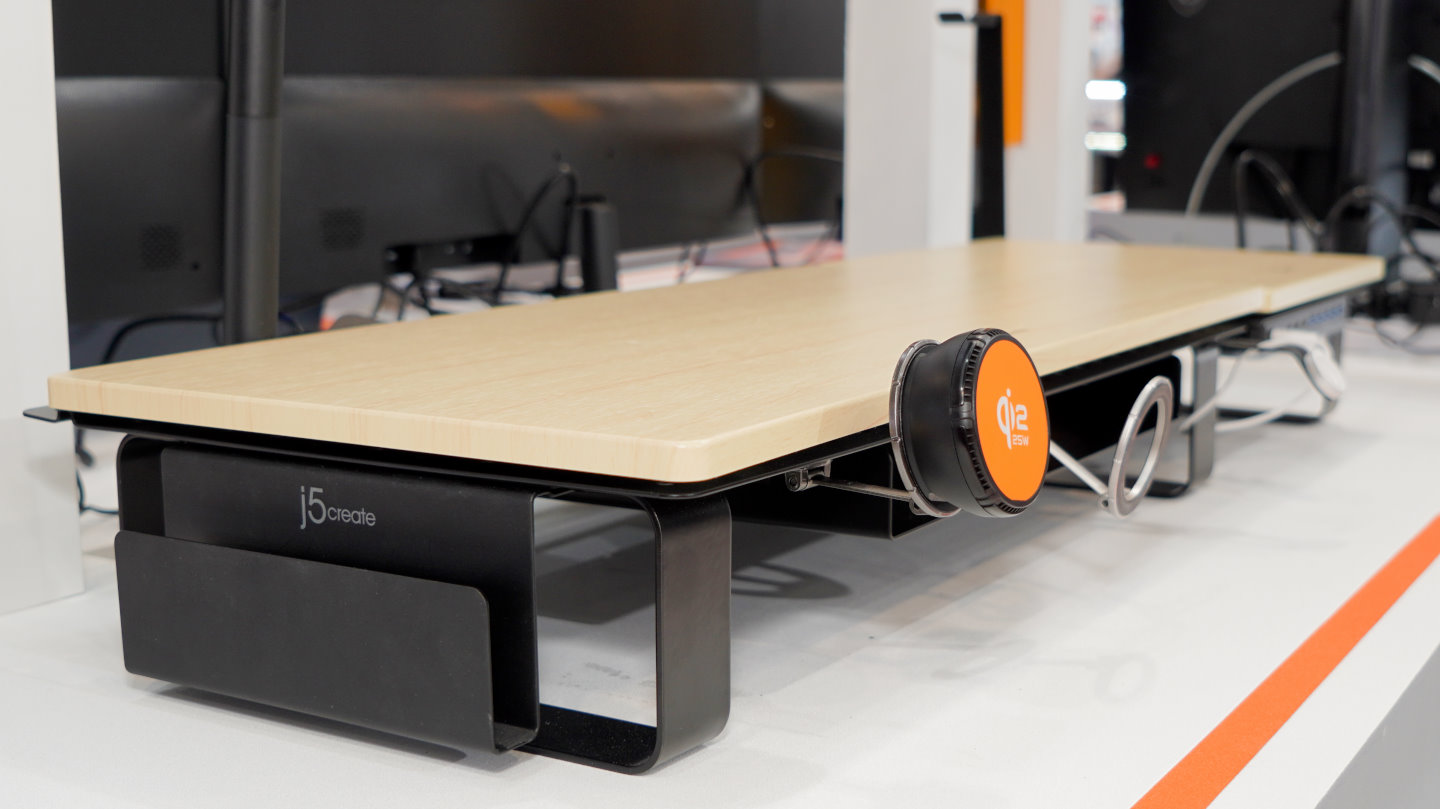
j5Create模組化螢幕桌隸屬於Modular L-Shaped Desktop Organizer Set產品線,採用金屬材質腳架,搭配實木材質的桌板,延續自家產品的設計風格,提供溫潤的質感與視覺體驗,使用者可以依照需求選擇不同尺寸的螢幕桌進行拼接,並選配各種周邊配件擴充功能。

延伸閱讀:
【COMPUTEX 2026】j5create 展出 AI 智慧桌面與 4K 無線影音新品:iPad 變身副螢幕、超低延遲 4K 無線傳輸
j5Create更新無線蟲洞造型,發表多款擴充底座還能整合視訊輸入
j5Create推出全新Thunderbolt 5擴充底座搭載獨立顯示晶片,還有iPhone無線蟲洞等周邊

j5Create在會場展出的配件包含USB集線器、無線充電器、磁吸式手機架、雜誌架、耳機架、WebCam腳架等等,方便使用者根據需求自行搭配,並將這些配件安裝在最順手的位置,具有高度搭配彈性。

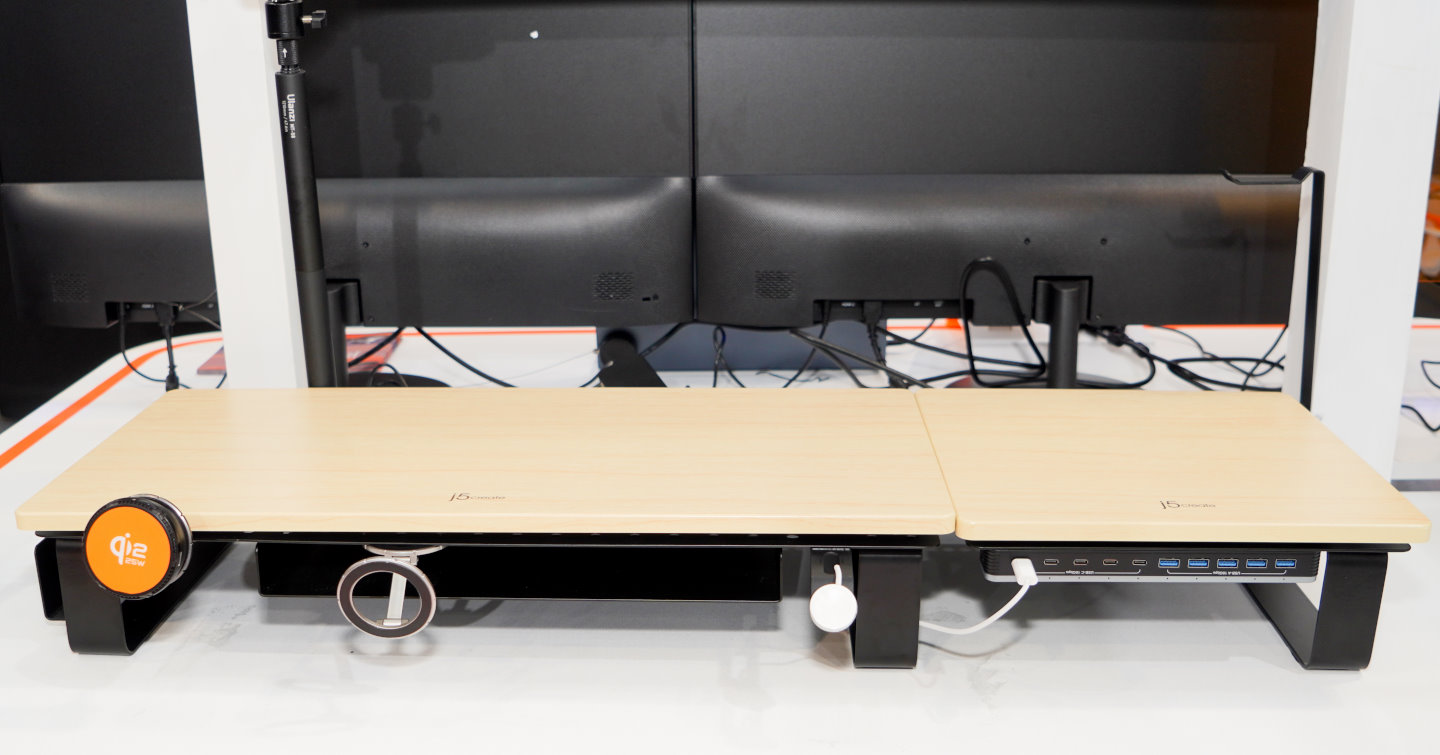
j5Create推出的模組化螢幕桌採用黑色烤漆金屬腳架搭配實木桌板,整體質感相當溫潤。

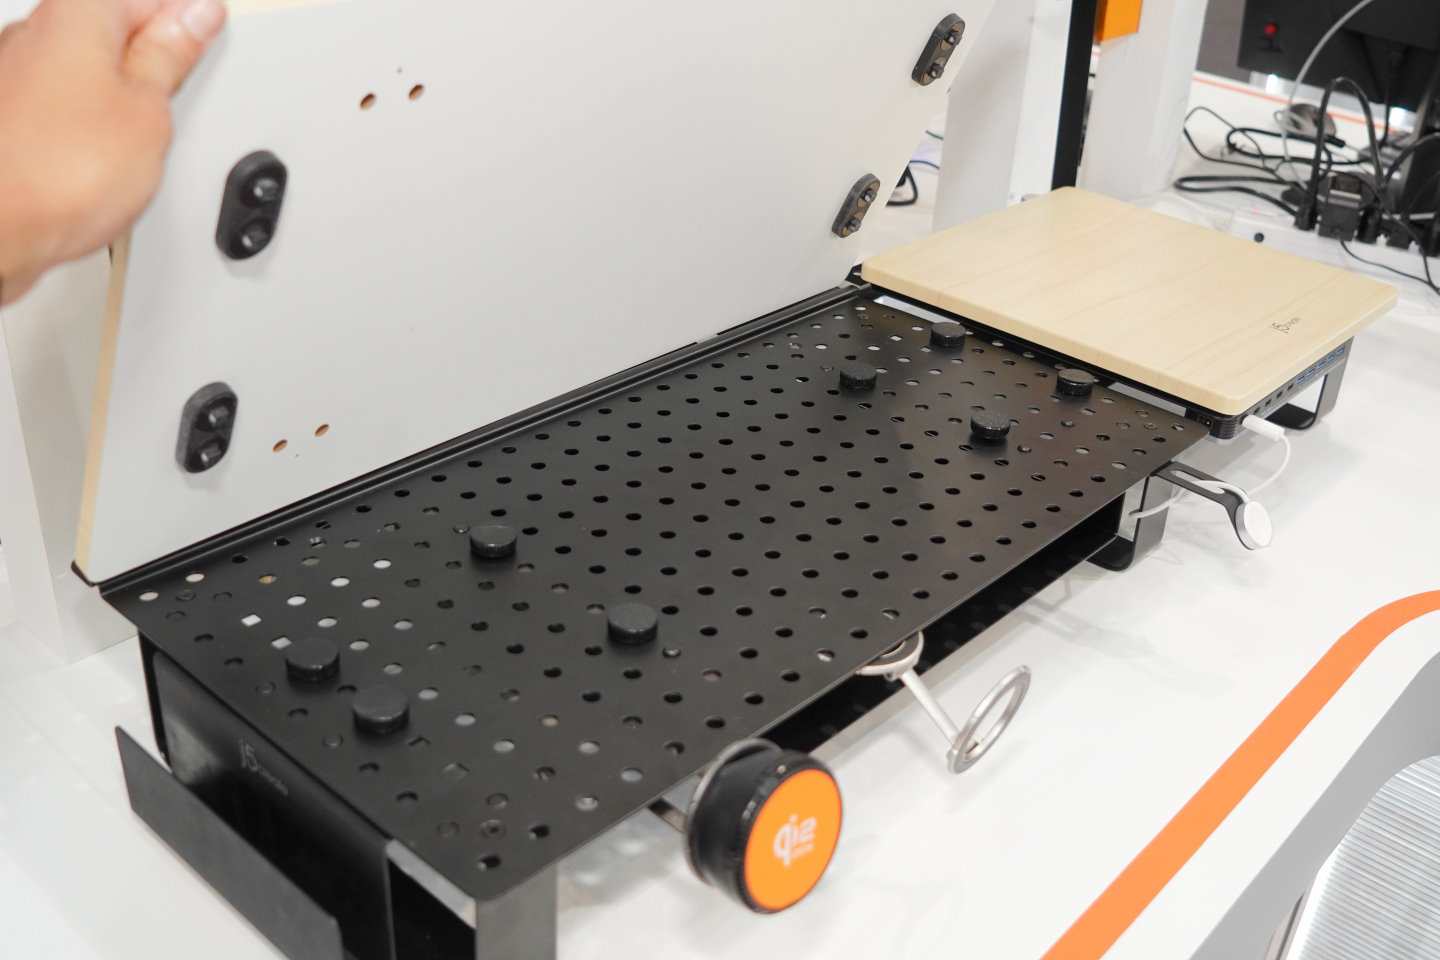
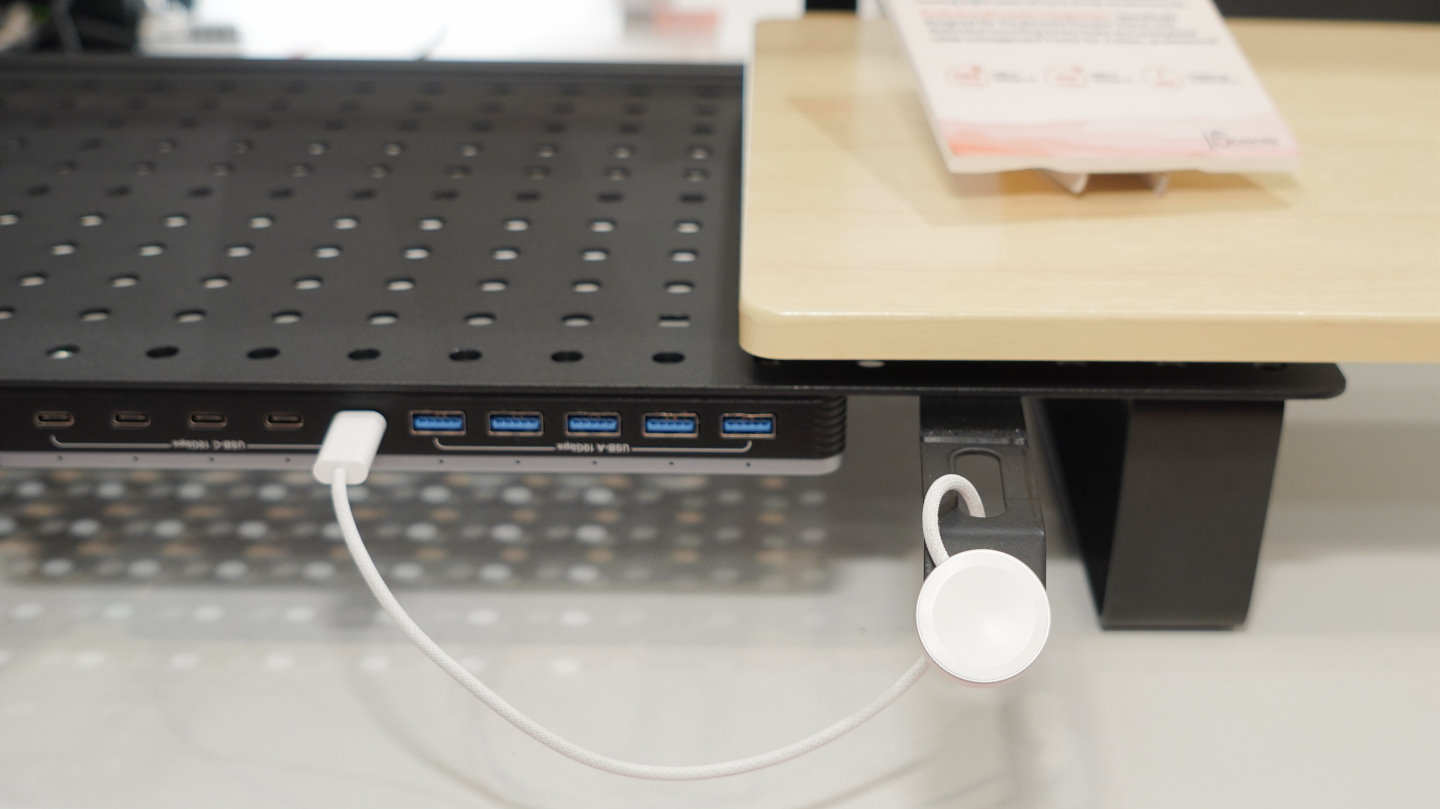
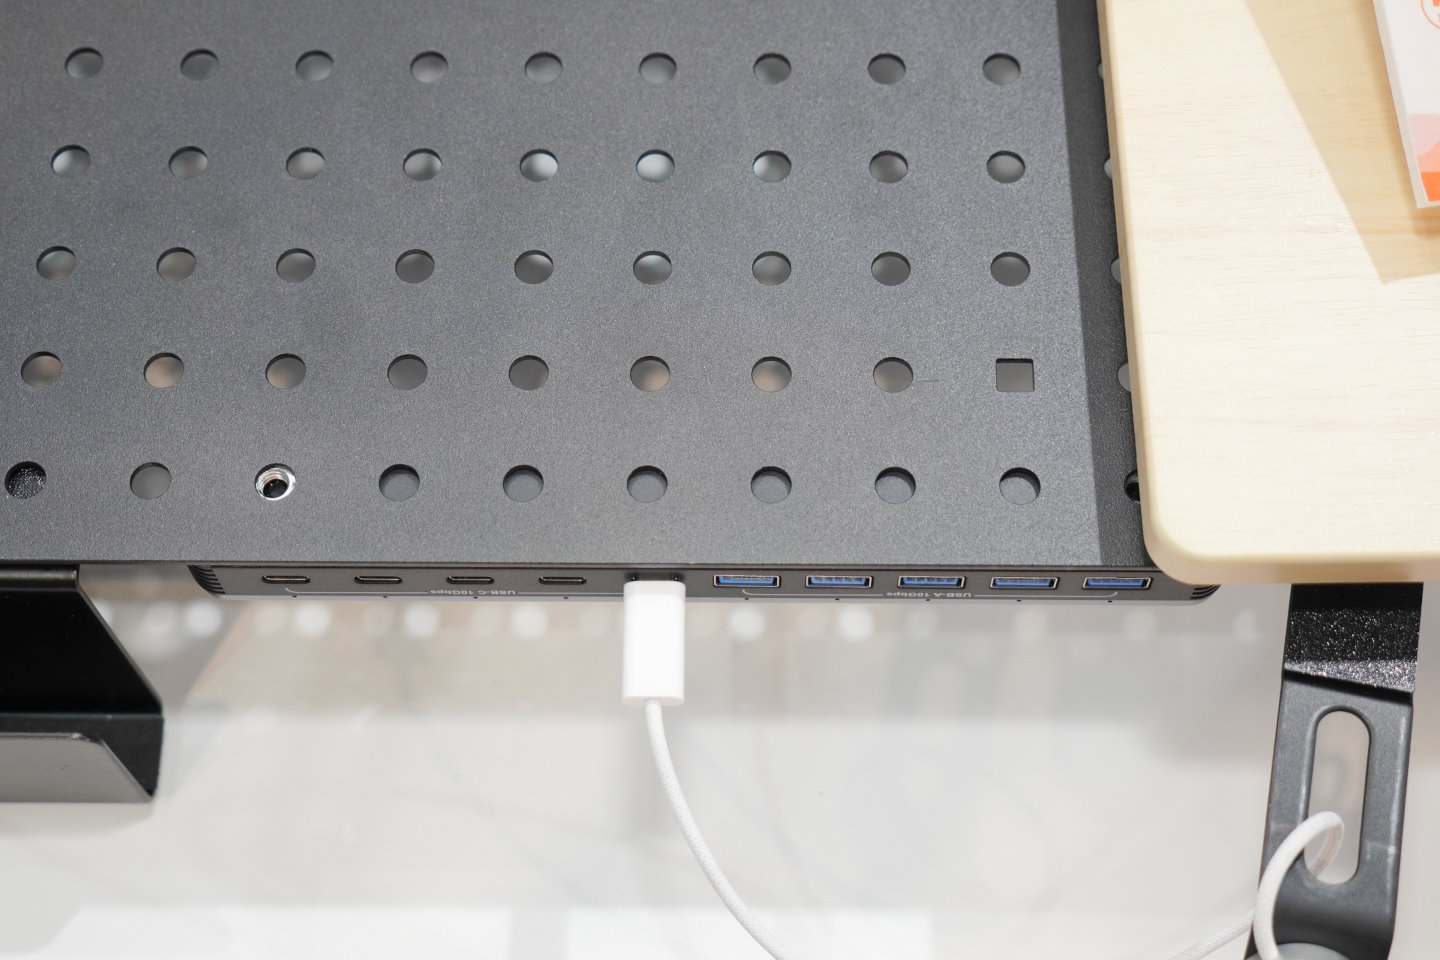
使用者可以依需求組合不同尺寸的螢幕桌,並將桌板可以直接掀起並在洞洞板上安裝各種周邊配件。

舉例來說左起為雜誌架、Qi2無線充電器、磁吸手機架,安裝位置皆可隨需求自由調整。

此外也可搭配USB集線器、小型無線充電器等周邊使用。

USB集線器可以透過螺栓牢固鎖在腳架。(會場展示為了方便說明無鎖螺栓)

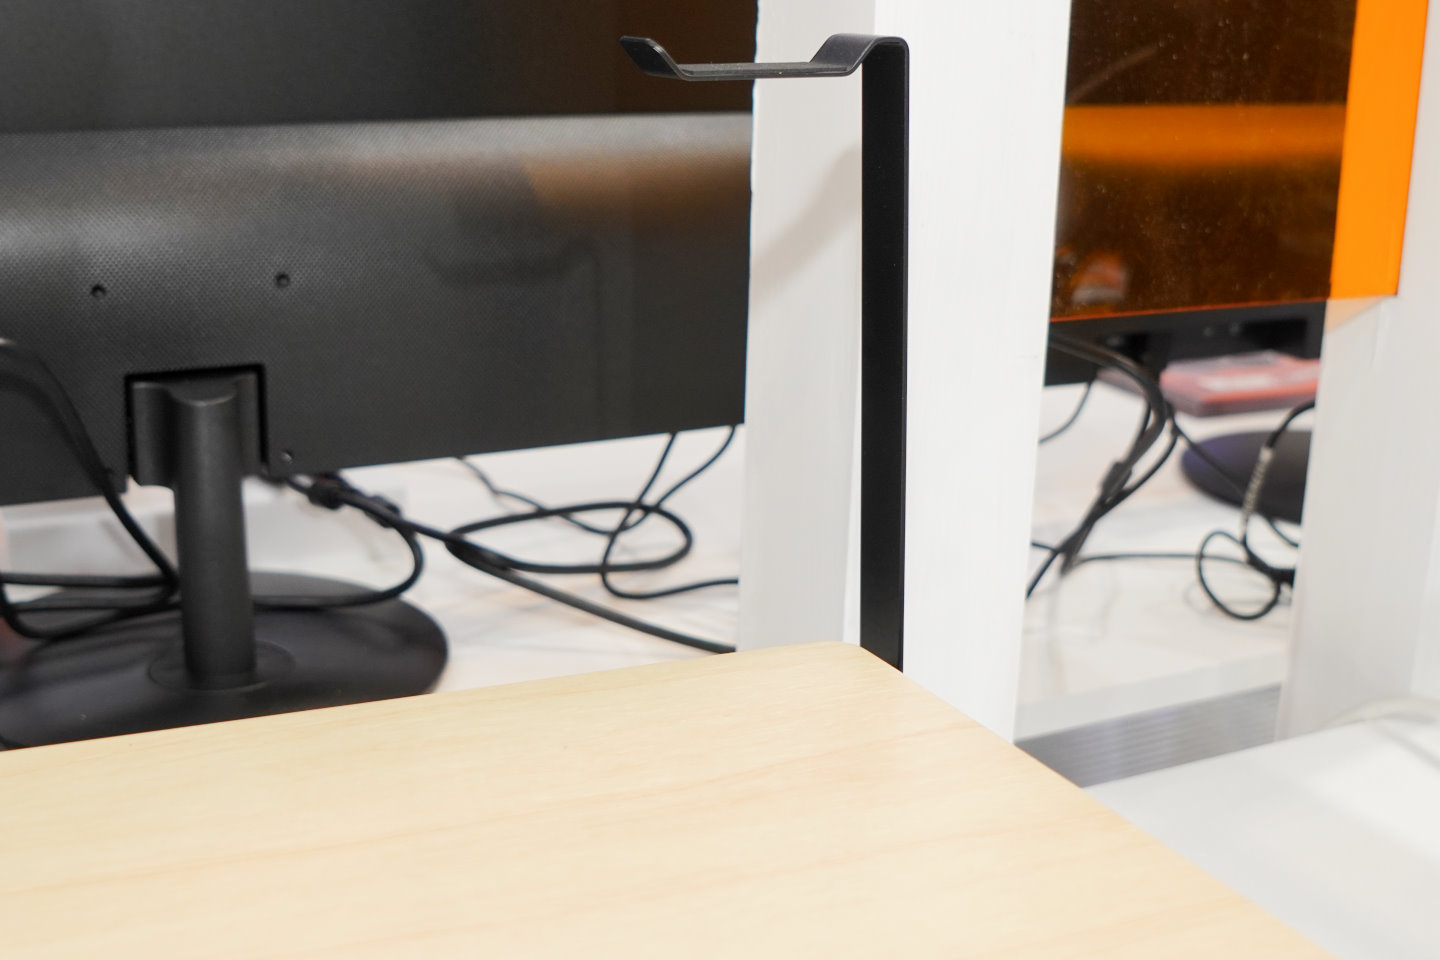
耳機架配件可在螢幕桌邊緣提供耳罩式耳機收納功能。

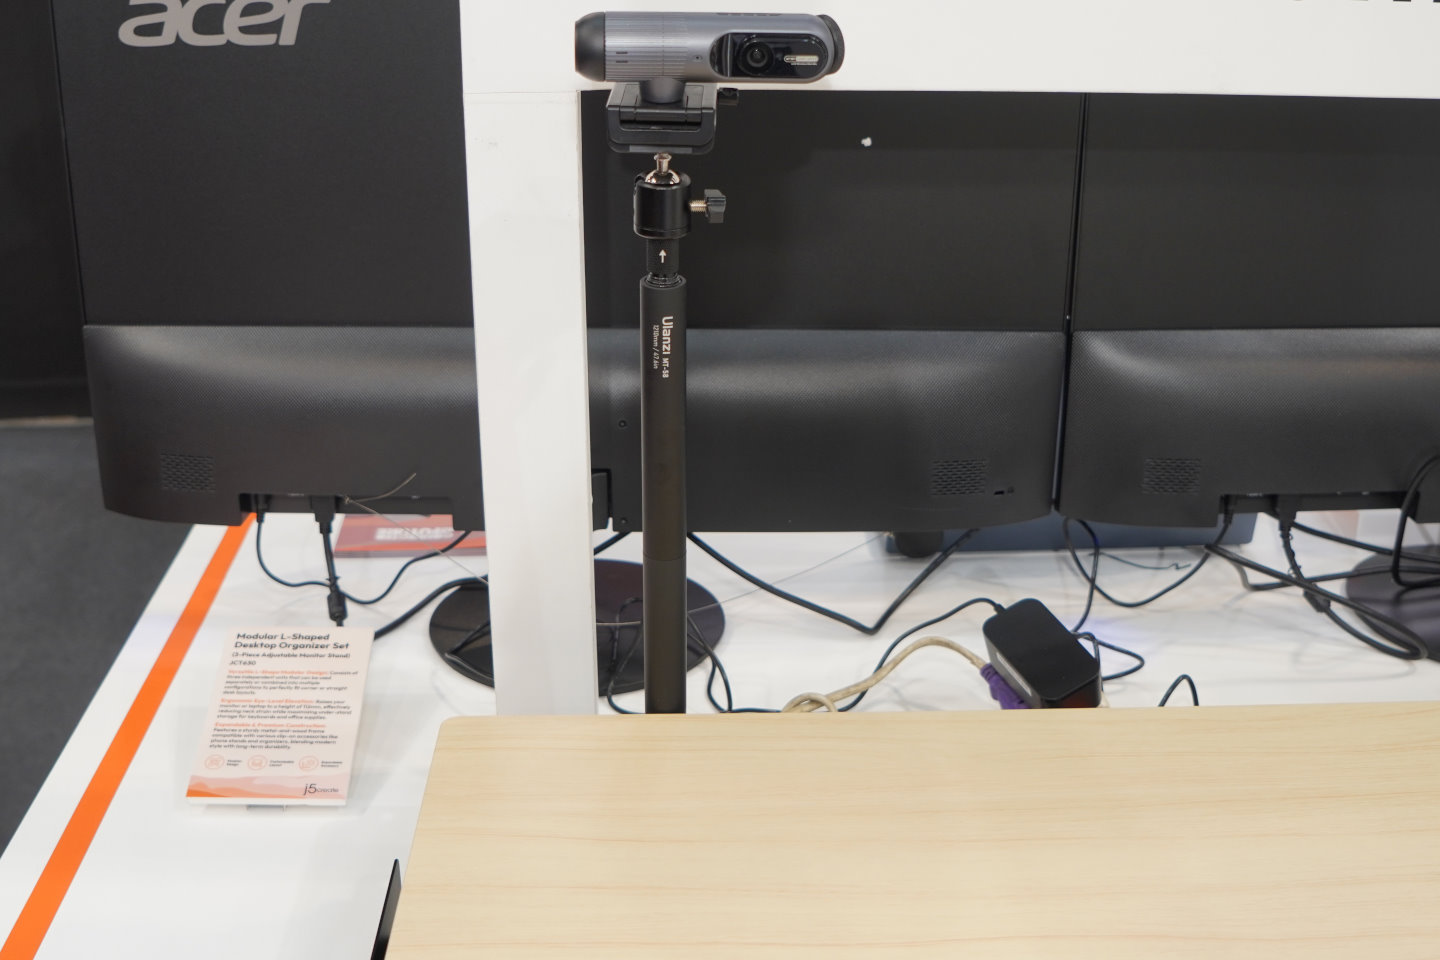
對於需要視訊會議、直播的使用者,也可以透過WebCam支架將鏡頭安裝至最佳拍攝角度。

j5Create預定於2026年第4季推出型號為JCT630、JCT330等大、小尺寸的模組化螢幕桌目前,預定售價未定。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

AMD推出Ryzen AI Embedded X100系列處理器,搭配Kria AI解決方案加速機器人與實體AI發展

AMD在Advancing AI 2026大會介紹Ryzen AI Embedded X100系列處理器,同時也透過Kria AI解決方案將AI感知、推論、代理式決策與控制功能整合至單一平台。1fb3111d447dd846d3e6785dcdb9061f

AMD在Advancing AI 2026大會介紹了整合超大內建GPU、適合應用於邊緣運算與實體AI的Ryzen AI Embedded X100系列處理器,同時也透過Kria AI解決方案將AI感知、推論、代理式決策與控制功能整合至單一平台。

超大內顯轉生嵌入式處理器

Ryzen AI Embedded X100系列處理器能在處理器運算、繪圖與AI運算等負載提供領先業界的運算效能。與競爭對手Intel的Core Ultra X7 358H處理器相比,在CoreMark多執行緒CPU效能表現提升達2.1倍,OpenGL繪圖效能提升1.7倍,Token(字詞)生成吞吐量與首個Token生成時間(Time-to-first-token,TTFT)分別提升3.5倍、加速1.4倍,有助於進行大規模平行處運算、加速實體AI工作負載。

延伸閱讀:
CES2025:AMD發表多款行動版處理器,Ryzen 9 9955HX3D、Ryzen Z2、以及超大內建顯示的Ryzen AI Max
AMD更新驅動程式,Ryzen AI Max+ 395處理器於本機執行128B參數大型語言模型
Intel Panther Lake邊緣運算動態展示,將推出工控寬溫版還有迷你單板電腦
AI機器人大腦升級:NVIDIA Jetson Thor Blackwell架構解析

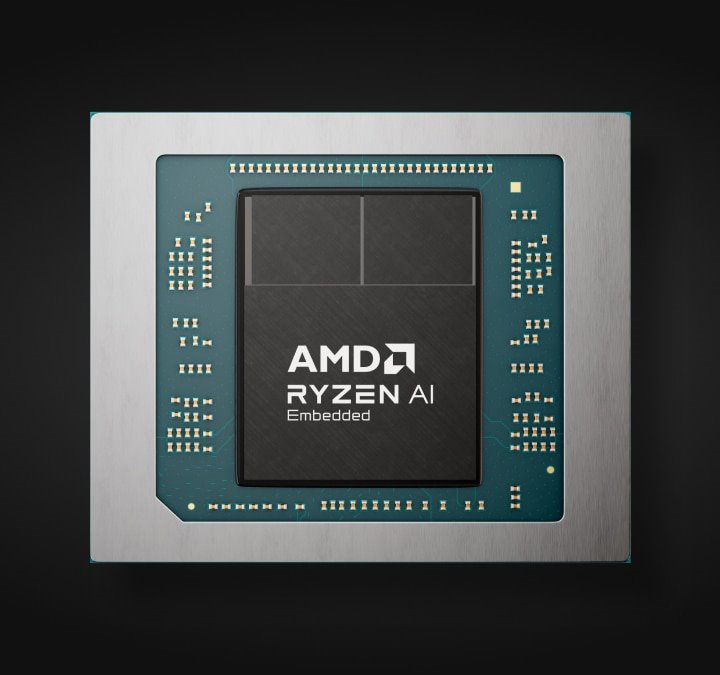
Ryzen AI Embedded X100系列處理器的基本規格與Ryzen AI Max系列處理器接近,以最高規格的Ryzen AI Embedded X199為例,它具有16組最高Turbo時脈達5.1 GHz的Zen 5架構處理器核心(即CPU),支援SMT(Simultaneous Multithreading,同時多執行緒)以達到16核32緒的組態,搭配40組運算單元(CUs)的RDNA 3.5架構內建顯示晶片(即GPU,可加速AI運算),以及AI運算效能達到50 TOPS的Ryzen AI NPU(神經處理器)。

Ryzen AI Embedded X199的標準TDP為55 W,可調整TDP(cTDP)的範圍介於45 ~ 120 W之間,可依使用需求與散熱條件進行調整,其運作溫度範圍為攝氏0 ~ 105度。此外AMD也推出工業用寬溫版Ryzen AI Embedded X199i,將運作溫度範圍放寬至攝氏-40 ~ 105度,並支援在嚴苛環境中7 x 24全天候運作長達10年。

根據AMD提供的數據,Ryzen AI Embedded X100系列處理器與競爭對手NVIDIA Jetson Thor T5000相比,可提供高達3倍的峰值FP32資料類型AI運算效能,在先進醫療超音波波束成形等工作負載中,平均效能甚至達到NVIDIA RTX 4000 Ada等運算卡的1.7倍。

Ryzen AI Embedded X100系列處理器支援開放的軟體堆疊,包涵Linux作業系統、ROCm AI運算軟體堆疊、Xen Hypervisor虛擬化,以及PyTorch、ONNX與TensorFlow等AI框架,讓開發人員能在熟悉的設計環境中快速開發,並可搭配工具將現有程式從CUDA移植至ROCm,以獲得極高的效能與彈性。

Ryzen AI Embedded X100系列處理器與Ryzen AI Max系列處理器相當接近。最高規格的Ryzen AI Embedded X199採16核32緒處理器核心組態,搭配40組運算單元的內建顯示晶片與AI運算效能達到50 TOPS的NPU。

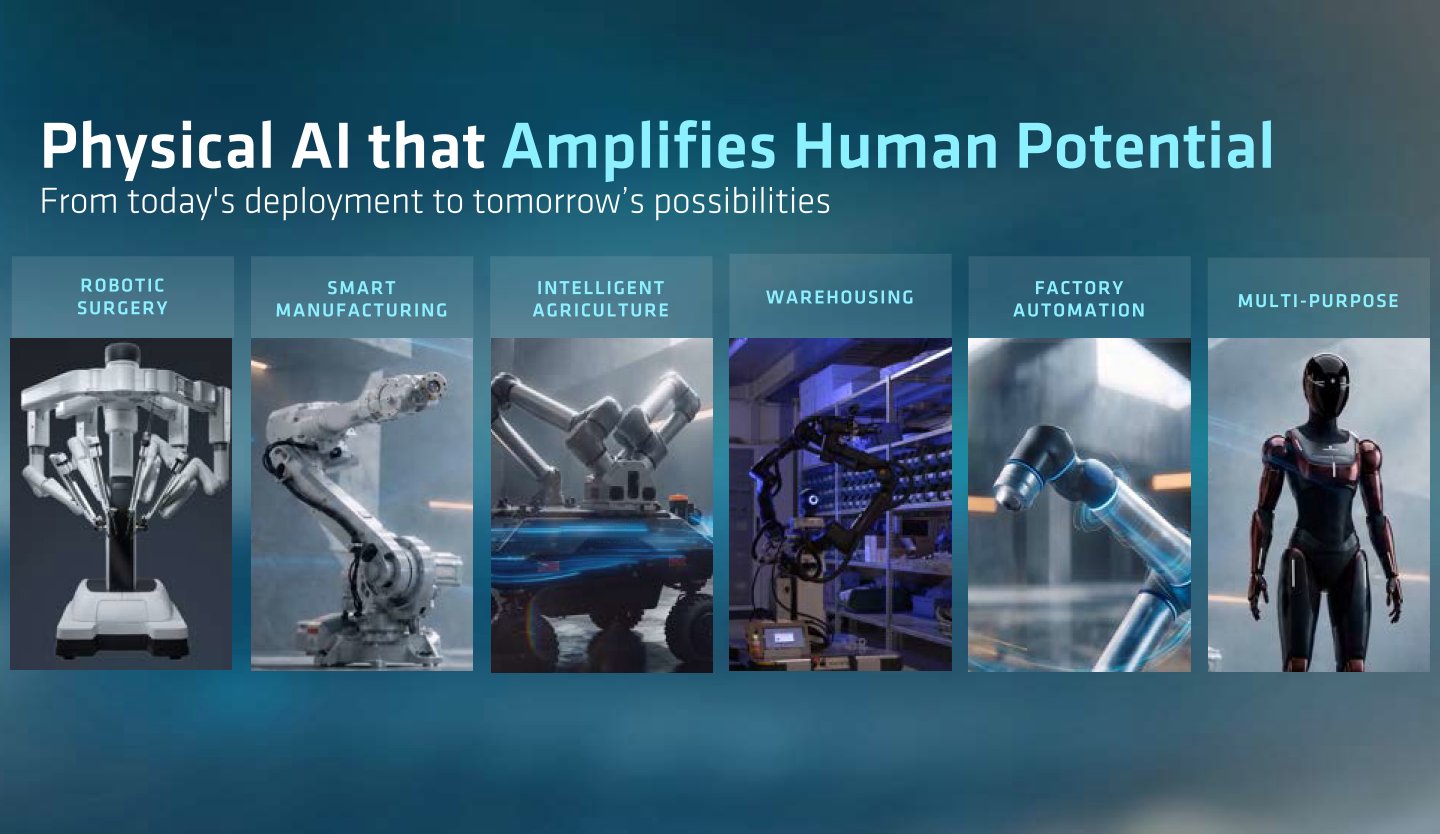
Ryzen AI Embedded X100系列處理器適合應用於手術機械手臂、製造業、建築、倉儲、工廠自動化,多用途人型機器人等情境。

Ryzen AI Embedded X100系列處理器也會應用於Kria AI SoM,且提供CPU、GPU、NPU能夠共享的統一記憶體架構。

整合式平台加速開發

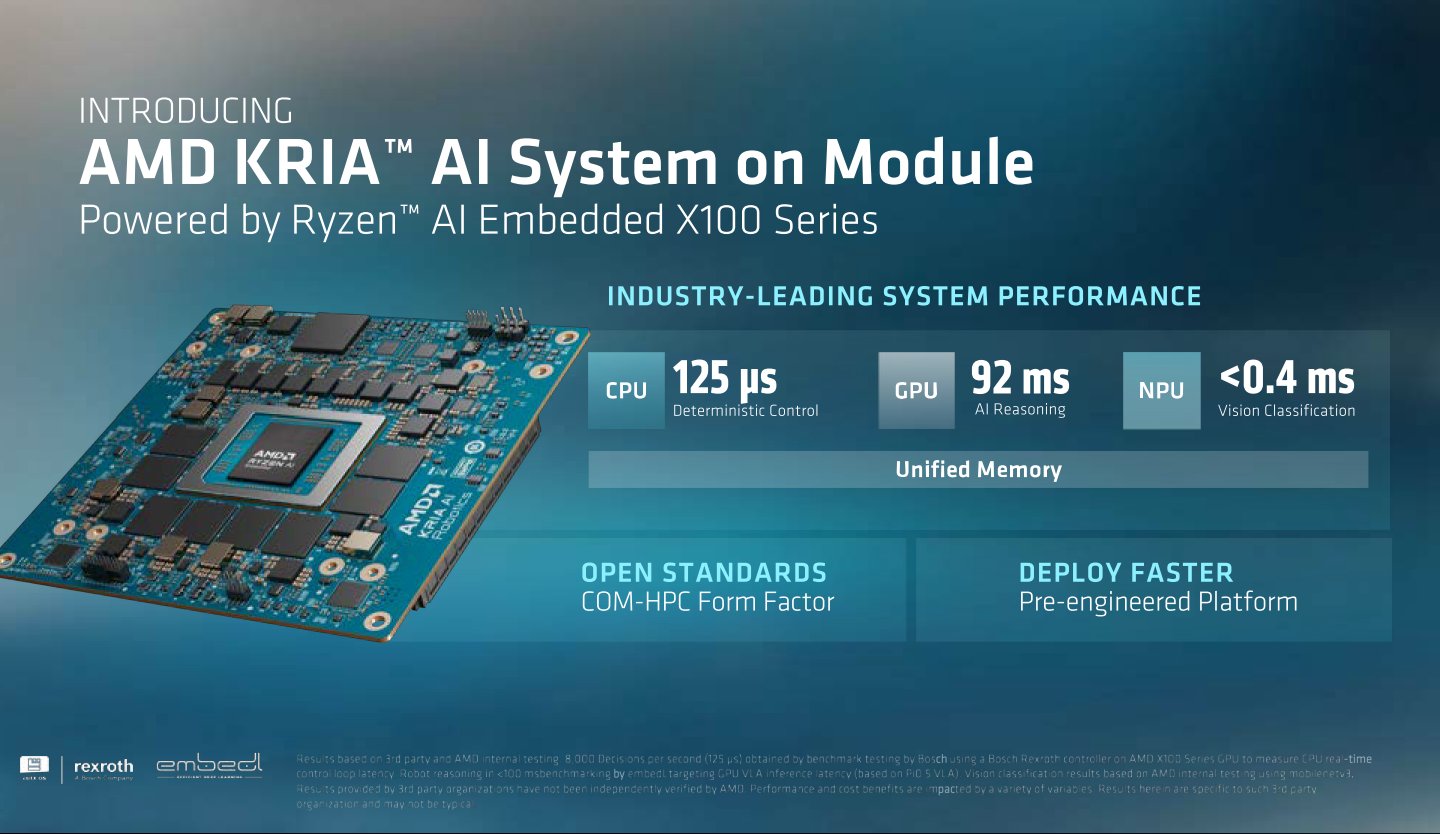
為了協助開發人員加速機器人智慧自主系統所需的AI感知、推論、即時決策、控制能力,AMD也推出搭載Ryzen AI Embedded X100系列處理器的Kria AI SoM(System on Module,系統化模組),提供CPU、GPU、NPU等多種運算單元,統一記憶體架構也有助於減少跨運算運算單元的資料傳輸,並最大化記憶體資源利用率,以差異化的運算能力與特性供低延遲且確定性的效能表現。

Kria AI SOM採用開放標準的COM-HPC尺寸規格,在CPU、GPU、NPU的協同運作下,能夠提供即時決策與控制、AI推論以及平行化運算的的機器人工作負載運算需求,每秒可做出超過8,000次控制決策,達到小於100 ms的VLA(Vision-Language-Action,視覺-語言-行動)AI推理,提供確定性的即時控制能力。

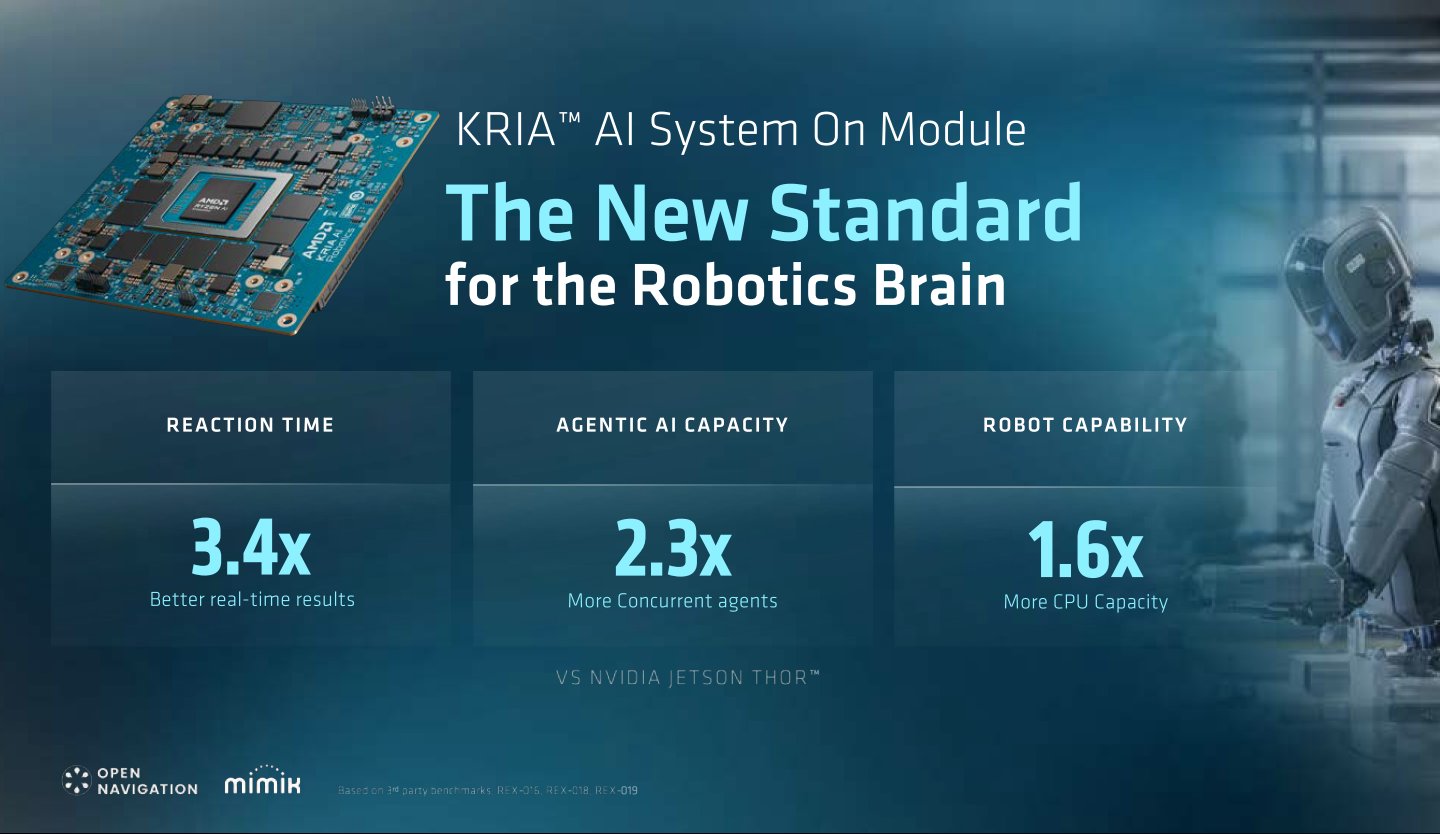
根據AMD提供的數據,與NVIDIA Jetson Thor T5000相比,Kria AI SOM的反應時間改善3.4倍,可執行的AI代理數量達到2.3倍,冗餘CPU核心數(備用運算能力)增加達1.6倍。

Kria AI解決方案支援PyTorch、ONNX、ROS 2與MoveIt等軟體框架與標準架構,並結合ROCm軟體與AMD機器人軟體套件,同時也提供從CUDA到ROCm的程式碼轉移工具,過程開發人員能夠保留平均75%的既有CUDA程式碼,以加速開發與轉移過程。

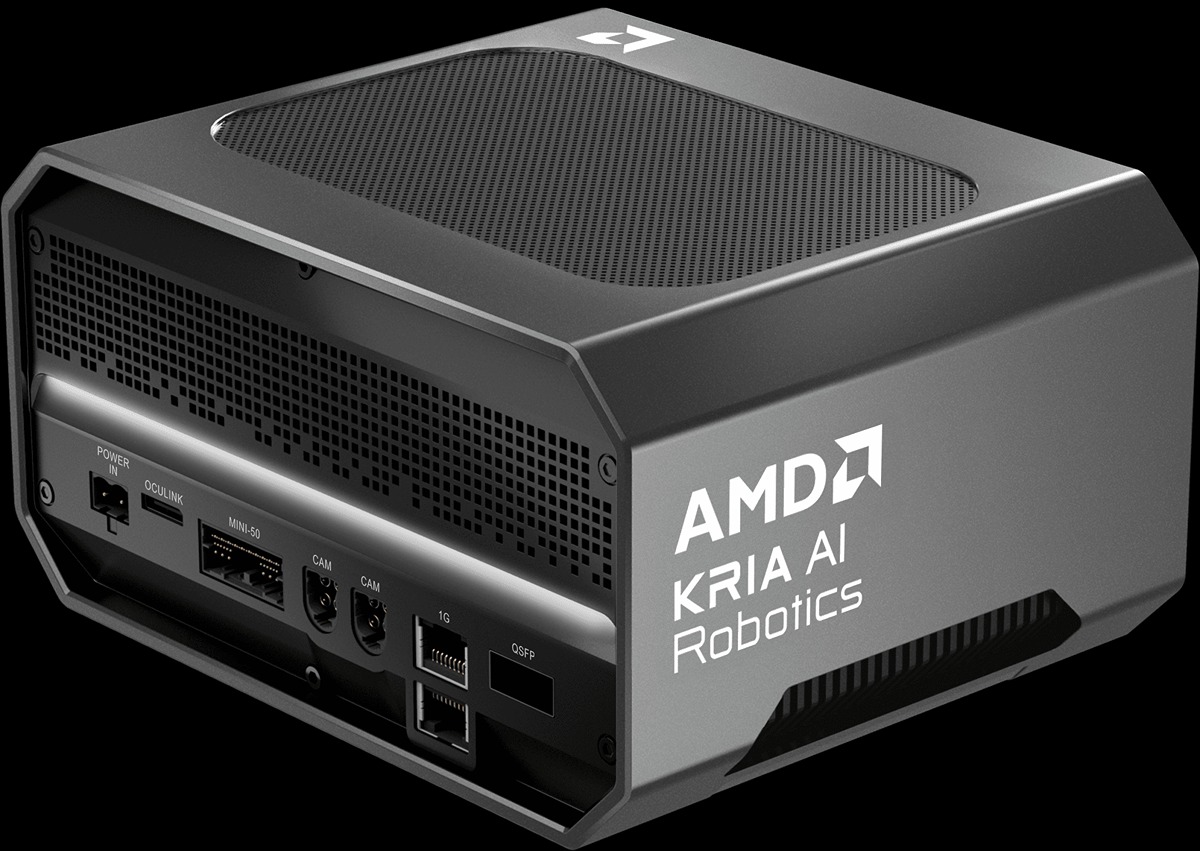
Kria AI 解決方案也提供類似迷你電腦的Kria AI Robotics機器人專用電腦。

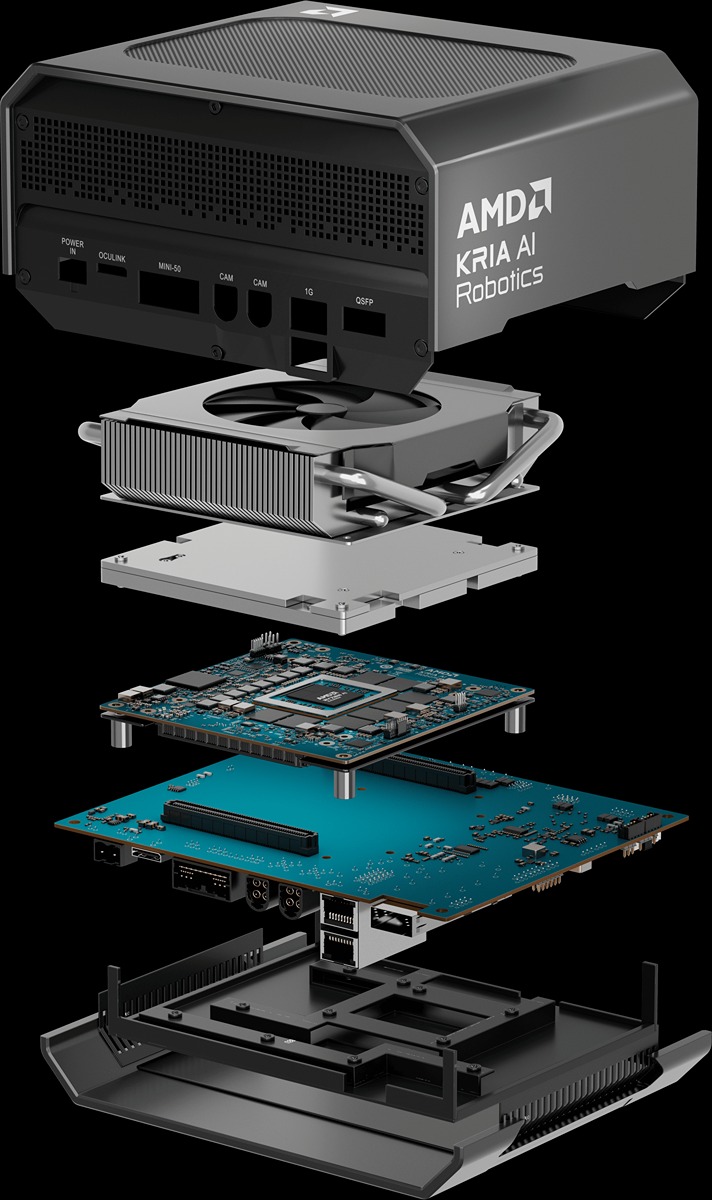
Kria AI Robotics解決方案電腦內部以Kria AI SOM為基礎,搭配擴充I/O母板與機殼、散熱器。

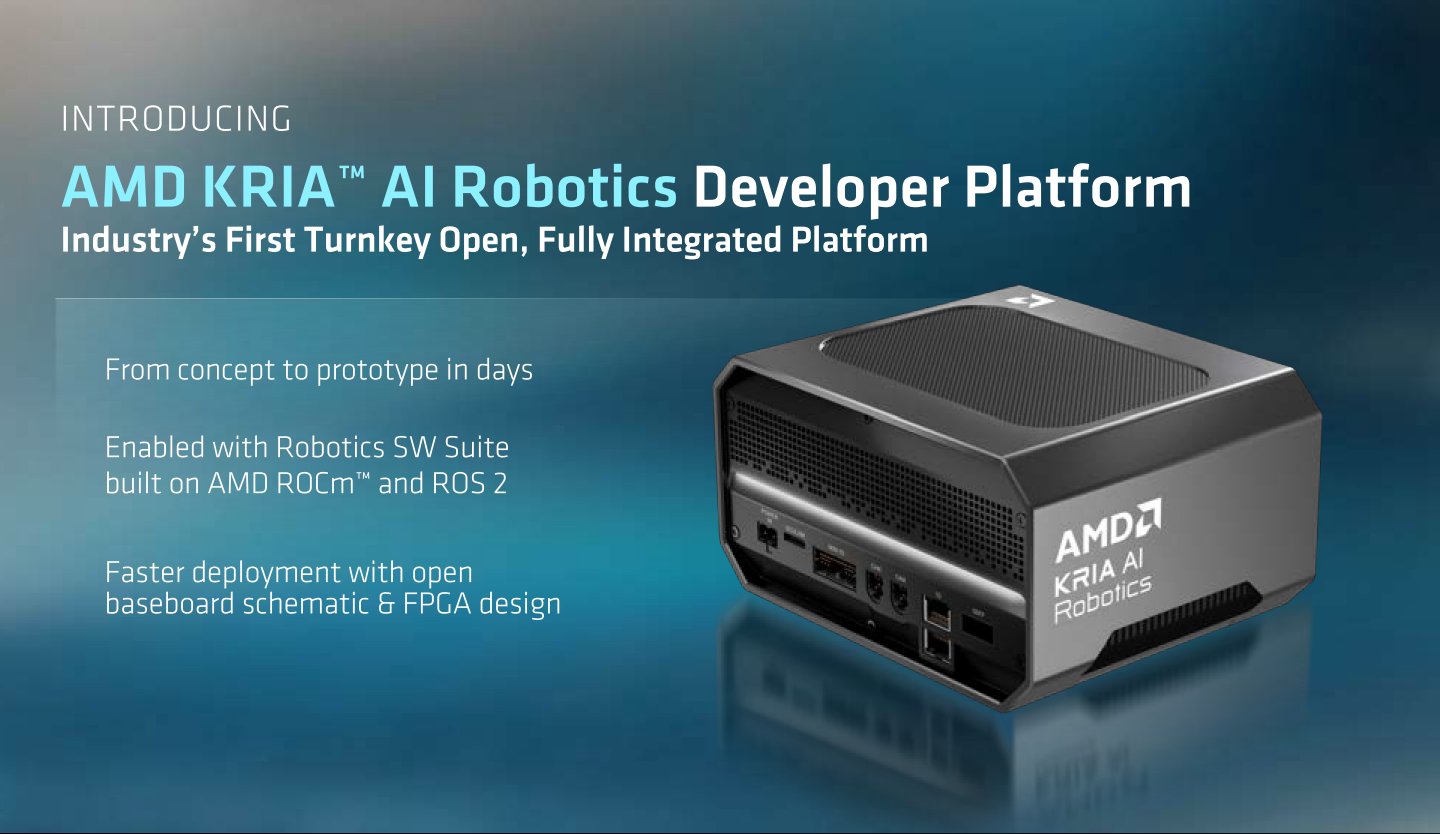
Kria AI Robotics支援ROS 2作業系統與ROCm軟體框架,能夠提供比開放式套件、FPGA解決方案更便捷的開發環境。

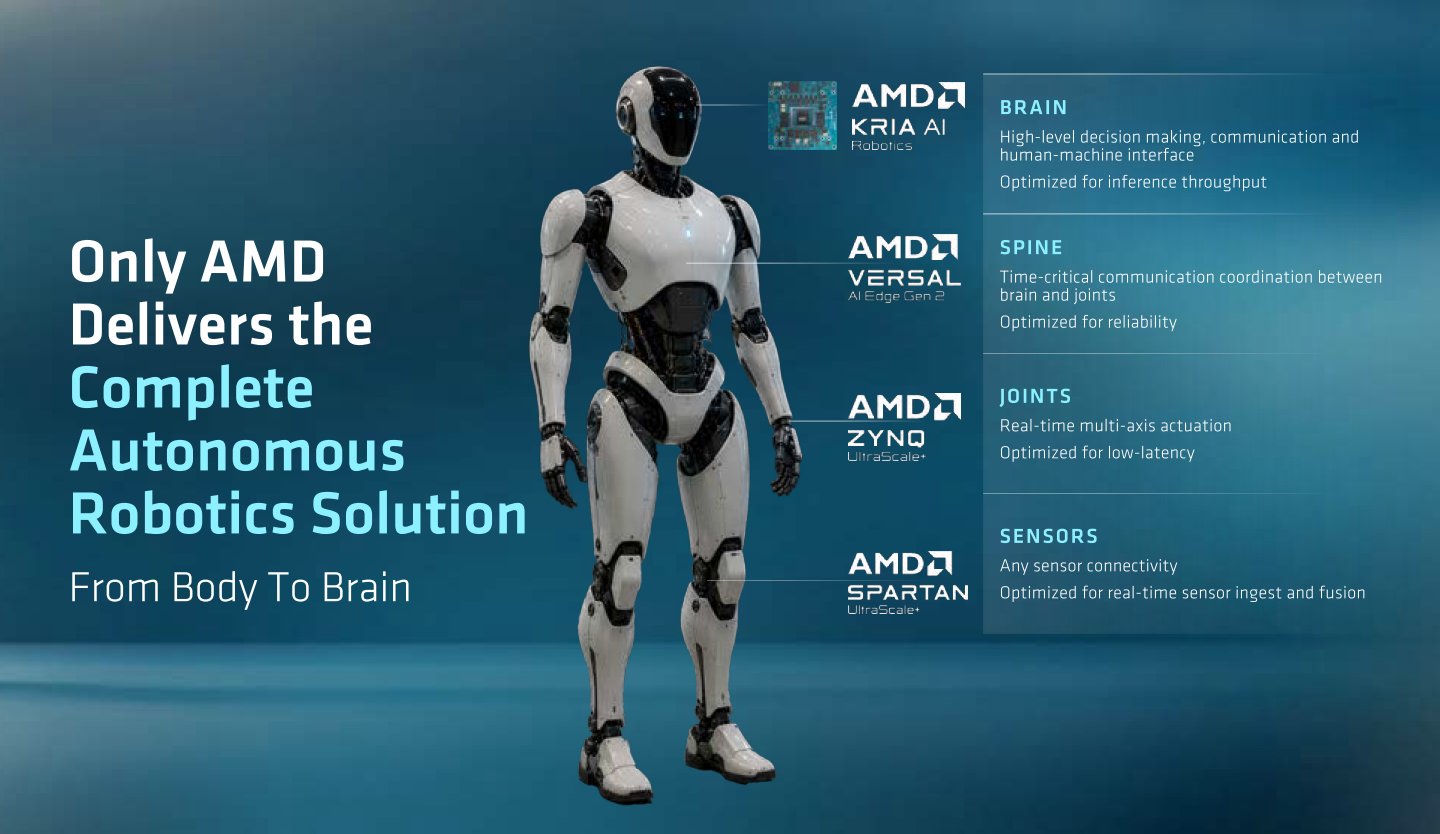
Kria AI Robotics能夠作為機器人的「大腦」,搭配VERSAL作為通訊的「脊柱」、ZYNQ作為控制的「關節」、SPARTAN作為感應器,提供機器人所需的各部零件。

與NVIDIA Jetson Thor相比,搭載Ryzen AI Embedded X100系列處理器的Kria AI SoM反應時間改善3.4倍、可執行的AI代理數量達到2.3倍、冗餘CPU核心數達到1.6倍。

搭載Ryzen AI Embedded X100系列處理器的Kria AI SoM預計於2026年第4季起由ODM合作夥伴開始供貨,Kria AI機器人開發平台目前已向早期客戶提供樣品,預計將於2026年第4季正式供貨

加入T客邦Facebook粉絲團
✇T客邦-Techbang

AMD推出第6代EPYC伺服器CPU,台積電2nm製程節點帶來256核心高密度

隨著AMD Helios機櫃級AI解決方案一同登場的重點產品還有對應的CPU與GPU,我們先來看看代號為Venice的第6代EPYC CPU有什麼特別之處。945bc125de740e079d6dbbe5d955fad6

隨著AMD Helios機櫃級AI解決方案一同登場的重點產品還有對應的CPU與GPU,我們先來看看代號為Venice的第6代EPYC CPU有什麼特別之處。

三層式代理架構

代理式AI的概念為系統能夠像「代理人」一樣,主動規劃、協調、執行多個任務,甚至與其他工具、AI系統互動,自動完全使用者所指派的工作,需要消耗較多CPU(處理器)資源來執行工具程式、連接企業服務、協調AI模型周邊工作,同時也需為GPU(繪圖處理器,可加速AI運算)、加速器存取、處理所需的資料,因此在每個階段選用適合的CPU對於提升日益複雜AI系統的吞吐量、資源利用率與電力效率有著舉足輕重的影響、

延伸閱讀:
AMD Helios平台實力揭秘:從2nm製程到HBM4,如何實現「AI Everywhere」願景?
NVIDIA公布Vera Rubin效能數據,同電力下效能較GB200 NVL72飆升10倍
Arm Everywhere 2026:瞄準代理式AI運算需求,推出Arm AGI CPU自有品牌處理器
Qualcomm於2026投資者日發表Qualcomm Dragonfly AI資料中心產品組合,提出HBC架構對決HBM

AMD指出資料中心的架構正演變為3層式代理架構(Three-Tier Agentic Architecture),分別為

  1. 代理沙盒執行(Agent Sandbox Execution)
  2. AI主節點(AI Host Node)
  3. 通用型伺服器(General-Purpose Server)

代理沙盒中的CPU負責執行與協調代理程式、執行衍生的程式與任務、管理記憶體與系統,並處理GPU之外的資料存取工作。AI主節點中的CPU扮演輔助者的角色,替GPU存取並處理資料,以最大化GPU的AI運算效能輸出。通用型伺服器的CPU則負責執行資料庫、儲存、應用程式服務以及AI支援工作負載等傳統應用程式。

AMD指出資料中心的架構正演變為代理沙盒執行(Agent Sandbox Execution)、AI主節點(AI Host Node)、通用型伺服器(General-Purpose Server)等3層式代理架構。

AMD執行長蘇姿丰在Advancing AI 2026大會演說展示第6代EPYC CPU(右下)、Instinct MI455X GPU(左上)、Salina DPU(資料處理器,右上)、Vulcano AI NIC(網路卡,左下)等晶片。

AMD表示過去5代EPYC CPU皆為世界上最強悍的伺服器CPU。

AMD於Advancing AI 2026大會發表第6代EPYC CPU。

第6代EPYC CPU透過先進封裝技術將多組小晶片整合為單一晶片,讓產品設計更具彈性。

6種處理器分支滿足差異需求

AMD這次推出的第6代EPYC CPU採用Zen 6處理器架構,導入TSMC(台積電)2nm製程節點,具有多種不同子系列產品,其中針對AI主節點使用情境設計的Venice HF由8組可容納12組核心的小晶片(Chiplet)構成,最高可選96核192緒組態,而EPYC 9006 LP的開發代號為Verano,特色為支援LPDDR記憶體,其運作時脈最高可達5 GHz,適合部署於密集型多加速器機櫃中,持續為加速器提供資料以提高系統的資源利用率。

Venice 256c同樣由8組小晶片構成,但每組小晶片可容納的核心提高至32組,最高可選256核512緒組態,提供更高的核心密度。代號為Venice SP7的EPYC 9006 SP7系列處理器專為高密度代理沙盒執行而設計,同樣提供最高256核512緒的組態,運作時脈最高可達5 GHz,並支援PCIe Gen 6匯流排,能夠達到更佳的電力效率與單位成本,並可讓每組機櫃執行更多代理程式,提升櫃代理程式部署效率。

代號為Venice SP8的EPYC 9006 SP8系列處理器則為在關鍵企業工作負載與代理沙盒執行中提供高效率且適當規模的效能,提供8至128核心的高度彈性與低功耗設計,更適合應用於電力供應受限的邊緣運算機櫃、小型叢集與通用型伺服器等環境,能夠提供領先業界的每系統成本效益。

代號為Venice-X的EPYC 9006X SP7系列處理器針對高效能運算(HPC)、專業運算與資料密集型工作負載設計,透過3D V-Cache技術提供3倍於EPYC 9006 SP7的L3快取記憶體容量,且時脈最高可達5.15 GHz,能夠有效提升模擬、建模、大規模分析、檢索、記憶體內分析(In-Memory Analytics)及其他對記憶體延持敏感的工作負載之效能。

代號為Venice的第6代EPYC CPU最高提供256核512緒組態型號,核心數為前代Turin的1.3倍,效能表現可達Turin的1.8倍,導入TSMC 2nm製程節點。

第6代EPYC CPU具有6種子系列產品,滿足差異化的使用需求。

第6代EPYC CPU在多種應用情境的效能表現可以達到競爭對手Intel第6代Xeon CPU最高達2.3倍。

與NVIDIA Vera CPU、Arm AGI CPU等處理器相比,第6代EPYC CPU的效能表現最高更是達到3.3倍。

在SPECint 2026測試中,第6代EPYC CPU的單核心效能領先Vera CPU達20%,吞吐量則是領先120%。

AMD與合作夥伴提供多種不同核心數量的伺服器,以滿足不同需求以及電力限制的使用情境。

AMD表示自家產品優勢在於採用單一架構搭配多樣化CPU的設計理念,能針對特定工作負載選擇代理程式所需的密度或是對應GPU所需的效能與頻寬,或是針對特定工作負載搭配3D V-Cache技術提高快取記憶體容量,以滿足差異化的使用需求。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

Patriot推出無限鏡裝飾記憶體,深邃視覺效果超頻飆上DDR5-9600

Patriot(美商博帝)於Computex台北國際電腦展2026展示搭載無限鏡以呈現獨特視覺效果的Viper Steel 5 Infinite DDR5,提供最高DDR5-8000的高效能規格。Ee2316fc7e38cae8770aa071d1974b2d

Patriot(美商博帝)於Computex台北國際電腦展2026展示搭載無限鏡以呈現獨特視覺效果的Viper Steel 5 Infinite DDR5,提供最高DDR5-8000的高效能規格。

燈鏡一體的無限視覺體驗

Patriot Viper Steel 5 Infinite DDR5最大的特色就是在記憶體模組頂部裝置無限鏡,能夠產生有如隧道般深邃且無限延伸視覺效果,並可透過Viper專屬軟體或搭配ASUS、ASRock、GIGABYTE、MSI等主機板燈光同步系統控制RGB燈效,營造截然不同的獨特視覺體驗。

延伸閱讀:
【COMPUTEX 2026】Ryzen 7 5800X3D 10週年紀念版居然有驚喜!AMD主管於訪談中透露改善3D V-Cache製程技術
Patriot推出40週年紀念黃金閃閃DDR5-8000,以及多款PCIe Gen 5固態硬碟
老兵不死還變貴了!DDR3 每 GB 報價正式超越 DDR5,揭秘記憶體市場「有行無市」的奇特亂象

一般無限鏡的構造需要較深的空間以營造反射效果,但是在尺寸受限的記憶體插槽上難以實現,因此Patriot的研發團隊透過創新的實心光學結構達到效同的視覺效果,讓有限的記憶體模組頂部空間依然能夠投射出深邃的立體隧道燈光效果。

Patriot Viper Steel 5 Infinite DDR5為導入無限鏡視覺效果的記憶體。

從記憶體的正面看,還無法覺得它的奇特之處。

但是從頂部看下去,就可以看到無限鏡產生的立體隧道燈光效果。

裝載至主機板上搭配主機板、水冷散熱器的整體視察效果相當具有科幻感。

在現場展示中,Viper Steel 5 Infinite DDR5超頻至DDR5-9600,時序值為46-58-58-126,展現更高的傳輸速度與效能表現。

Patriot也在會場展示充滿台灣味的「博帝香雞排」改裝主機,可惜這台只是概念展示而不會商品化。

Viper Steel 5 Infinite DDR5提供DDR5-6000、DDR5-6400、DDR5-8000等傳輸速度,以及16 GB x 2、24 GB x 2、32 GB x 2等容量規格選擇,方便消費者能夠依照需求與預算採購。

加入T客邦Facebook粉絲團
✇T客邦-Techbang

NVIDIA公布Vera Rubin效能數據,同電力下效能較GB200 NVL72飆升10倍

NVIDIA表示Vera Rubin運算平台在消耗相同電力的前提下,Token吞吐量較GB200 NVL72提升10倍,Spectrum-6網路交換器的效能也達前代系統的2倍。8cccd1eeeb6161f4608fe2e3d2fa4210

NVIDIA表示Vera Rubin運算平台在消耗相同電力的前提下,Token吞吐量較GB200 NVL72提升10倍,Spectrum-6網路交換器的效能也達前代系統的2倍。

極致協同設計激發效能

Vera Rubin平台從晶片到資料中心節點的設計皆將整體協同運作納入考量,整合包括Vera Rubin NVL72、Vera CPU機架、Groq 3 LPX、Spectrum-6 SPX、Vera BlueField-4 STX等7款晶片與5種機櫃托盤等為單一系統極致協同運作設計的運算單元,以追求最高電力效率與最低Token(字詞)成本。

延伸閱讀:
【COMPUTEX 2026】AI Agent時代全面來臨!NVIDIA Vera Rubin平台量產,AI盈利模式確立,引領產業新局
【GTC 2026】NVIDIA Vera Rubin 世代 7 種晶片與 5 種機櫃打造最強 AI 工廠,還要送晶片上太空
【NVIDIA GTC DC 2025】黃仁勳:當 AI 摩爾定律放緩,就用加速運算與外部擴展解決問題

這套系統以Vera CPU(處理器)為基礎,其客製化的Olympus處理器核心的單執行緒效能較競爭對手的小晶片(chiplet)提升2倍,核心互連頻寬提升3倍,並記憶體延遲降低40%,進而成為市場上AI代理運算負載效率最高的單執行緒CPU。

Vera Rubin平台採用第6代NVLink垂直擴展技術,相較於市面上其他乙太網路解決方案,處理複雜工作負載的頻寬提升超過2倍,延遲降低3倍,封包速率提升10倍。

在AI雲端運算企業CoreWeave針對DeepSeek-R1大型語言模型(Large Language Model,LLM)進行的首次效能測試中,Vera Rubin平台在消耗每百萬瓦的吞吐量為前代Grace Blackwell NVL72平台的10倍,大幅提升資料中心的整體電力效率。

NVIDIA Vera Rubin平台具有高於競爭對手的電力效率,為企業用戶帶來最低Token成本

網路也成AI效能關鍵

NVIDIA表示單純考量GPU的峰值效能已無法反映大型AI資料中心的整體效能。當資料中心在進行大規模AI模型訓練與推論運算時,皆仰賴數以千計的GPU、加速器持續交換資料,這會在運算單元之間產生大量的東西向資料流量(East-West Traffic,伺服器之間的流量),且通常會橫跨多組系統同時傳輸。

由於乙太網路最初設計的目標主要針對企業應用,以及使用者、伺服器與儲存系統之間的南北向流量(North-South Traffic,資料中與外部系統之間的流量)而設計,並非為百萬瓩級AI資料中心所需的同步與集體通訊密集型傳輸模式打造。所以NVIDIA推出專為AI運算打造的Spectrum-X乙太網路,將乙太網路轉化為高效能橫向擴展網路架構,確保每個GPU之間的通訊暢通,並能持續讀取所需資料。

Vera Rubin 平台的整體設計的Spectrum-6交換器晶片與ConnectX-9 SuperNIC網路卡共同構成新一代Spectrum-X乙太網路,其中Spectrum-6支援可插拔式光學元件與共同封裝光學元件,Spectrum-6對應的產品也支援液冷散熱方案,藉由改善散熱的方式,提高AI資料中心的網路電力效率。

Spectrum-X乙太網路平台所有元件皆針對AI運用設計,平台的軟、硬體功能會持續最佳化網路架構,在可用路徑之間智慧平衡流量、迅速繞過故障,並在網路傳輸資料未能抵達目的地時精準復原,平台也支援開放式網路作業系統,並提供多種RDMA傳輸模型選擇,能在不犧牲效能的前提下保持使用彈性。其AI網路效能最高可達通用型乙太網路的1.6倍,並能在超過10萬組GPU的部署環境中,維持最高達95%的網路效率。

Vera Rubin平台的Spectrum-X乙太網路能夠滿足資料中心內東西向資料流量的傳輸需求,帶來更高的可靠度與經濟效益。

對企業而言,Spectrum-6能讓更多GPU同步運作,提升高負載協同運算的使用率,並為長時間執行的工作提供更高韌性,在超大規模環境下更快完成運算,並創造更佳的經濟效益。

加入T客邦Facebook粉絲團
❌